

Kane Crypto
1.3k Publications
Kane Crypto
Signaler
Bloquer l’utilisateur
Chỉ yêu mình $TAO
X: @kane_tdt
Ouvert au trading
Trade régulièrement
5.1 an(s)
6.1K+ Suivis
3.5K+ Abonnés
2.3K+ J’aime
Publications
Portefeuille
Tous
Citations
Vidéos
·
--
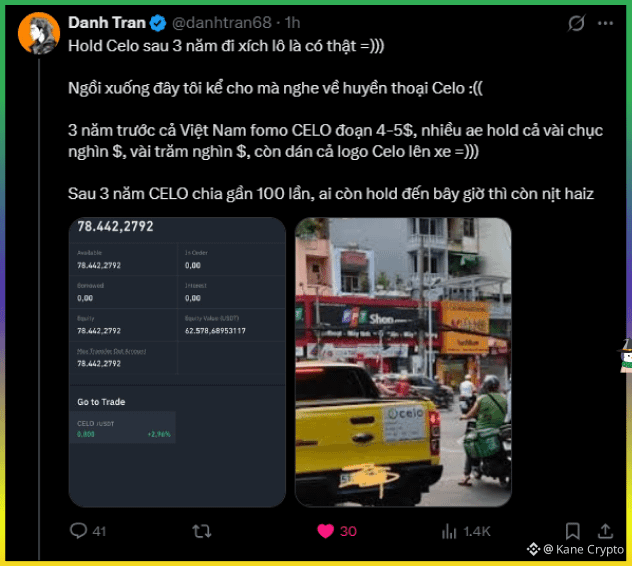
Il y a longtemps, j’ai perdu 500$ à cause de ce Celo
500$ était vraiment précieux, parce qu’à l’époque, j’étais encore étudiant
En donnant des cours particuliers, un soir je gagnais 120k
Triste
Il y a longtemps, j’ai perdu 500$ à cause de ce Celo
500$ était vraiment précieux, parce qu’à l’époque, j’étais encore étudiant
En donnant des cours particuliers, un soir je gagnais 120k
Triste
500$ était vraiment précieux, parce qu’à l’époque, j’étais encore étudiant
En donnant des cours particuliers, un soir je gagnais 120k
Triste
1
4
1.1k
·
--
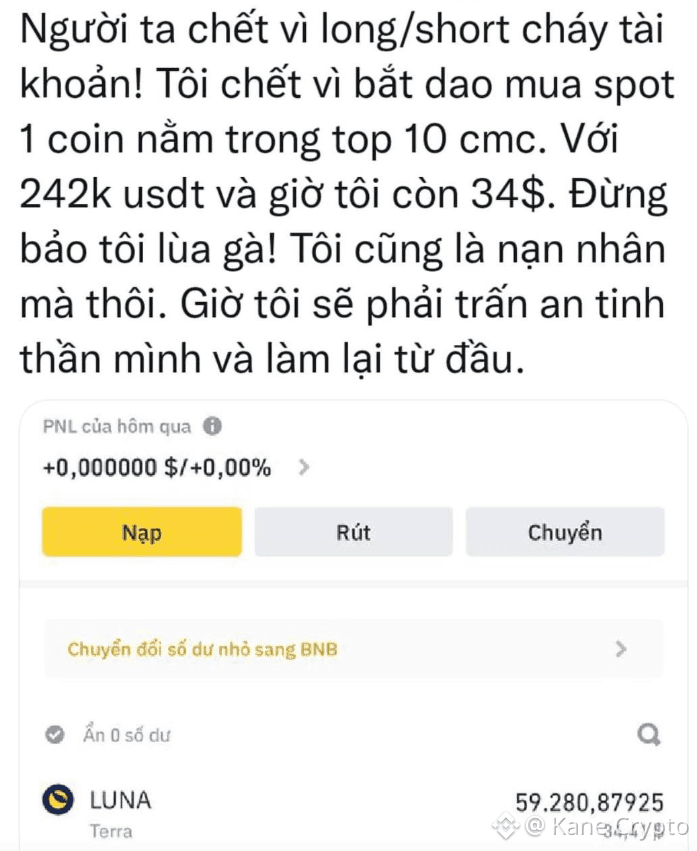
La légende LUNA qui a fait parler de tout le monde pendant une époque
De 242k usdt à seulement 34 usdt
la tendance baissière de l’autre fois, il n’y en a jamais eu une comme ça
je ne sais pas si ça se reproduira cette année encore
La légende LUNA qui a fait parler de tout le monde pendant une époque
De 242k usdt à seulement 34 usdt
la tendance baissière de l’autre fois, il n’y en a jamais eu une comme ça
je ne sais pas si ça se reproduira cette année encore
De 242k usdt à seulement 34 usdt
la tendance baissière de l’autre fois, il n’y en a jamais eu une comme ça
je ne sais pas si ça se reproduira cette année encore
2
356
·
--
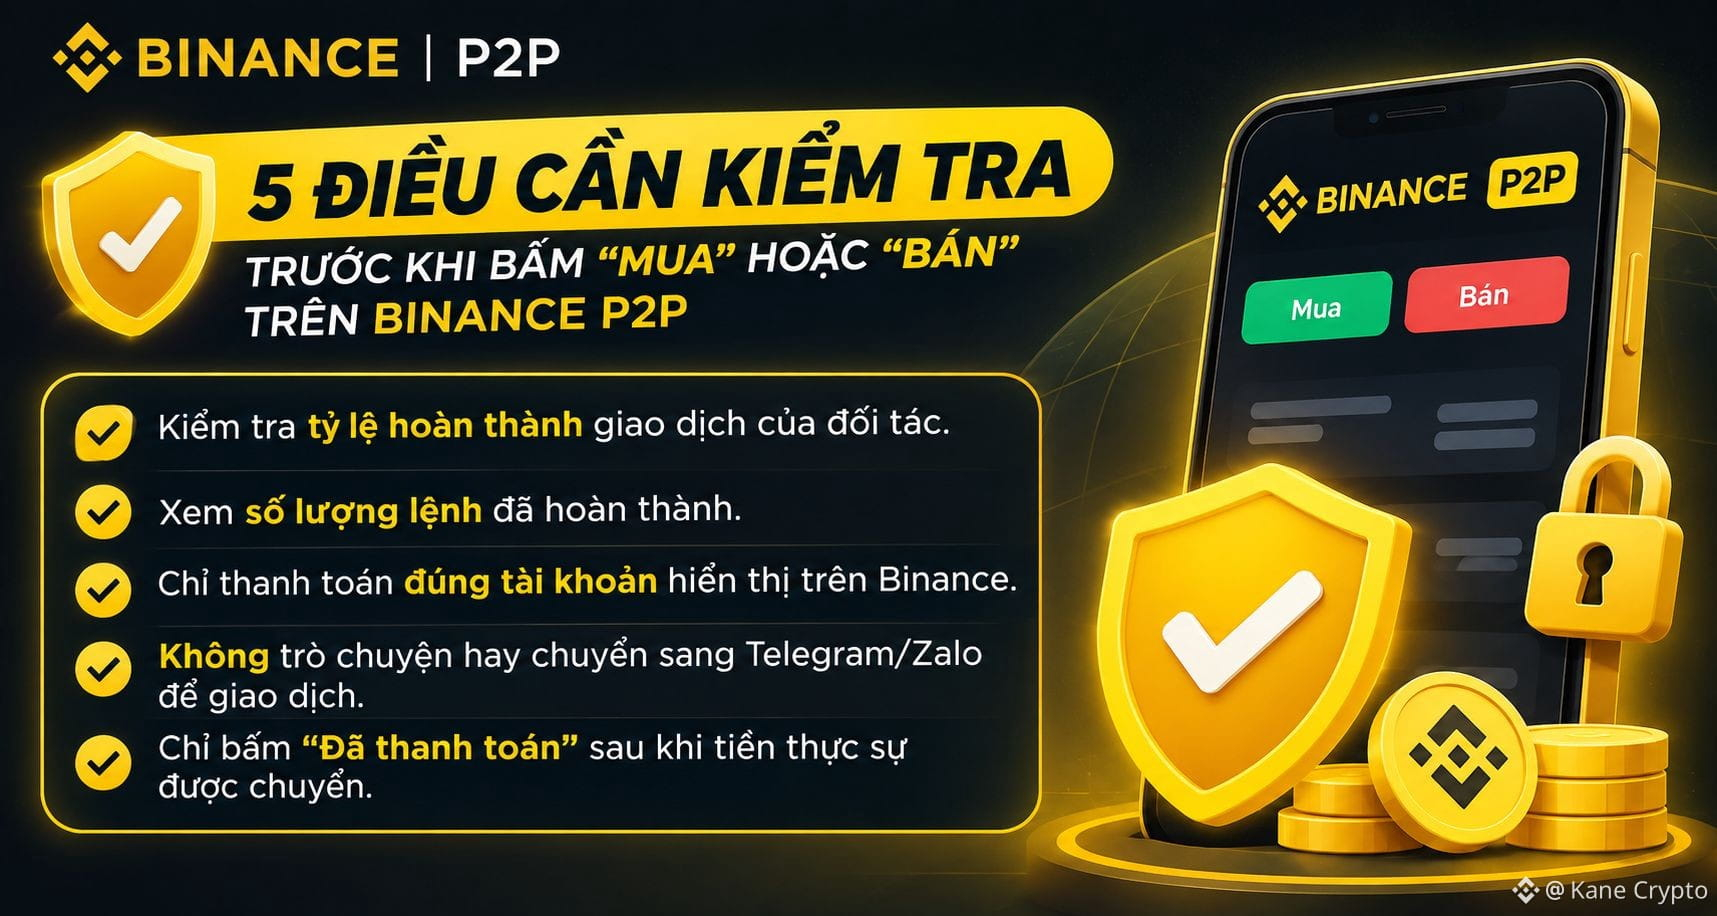
Avant de cliquer sur « Acheter » ou « Vendre » sur Binance P2P, je vérifie toujours ces 5 points :
✅ Vérifier le taux d’achèvement des transactions du partenaire.
✅ Regarder le nombre d’ordres terminés.
✅ Ne payer que sur le compte qui est affiché sur Binance.
✅ Ne pas discuter ni passer sur Telegram/Zalo pour effectuer la transaction.
✅ Ne cliquer sur « Paiement effectué » qu’après que l’argent a réellement été transféré.
Ces 5 étapes peuvent sembler simples, mais elles aident beaucoup les amis à réduire les risques lors des échanges. Pensez à les enregistrer nhé.
@Binance_Vietnam
#BinanceP2PAnToan #BinanceP2P #BNB
Avant de cliquer sur « Acheter » ou « Vendre » sur Binance P2P, je vérifie toujours ces 5 points :
✅ Vérifier le taux d’achèvement des transactions du partenaire.
✅ Regarder le nombre d’ordres terminés.
✅ Ne payer que sur le compte qui est affiché sur Binance.
✅ Ne pas discuter ni passer sur Telegram/Zalo pour effectuer la transaction.
✅ Ne cliquer sur « Paiement effectué » qu’après que l’argent a réellement été transféré.
Ces 5 étapes peuvent sembler simples, mais elles aident beaucoup les amis à réduire les risques lors des échanges. Pensez à les enregistrer nhé.
@Binance Vietnam
#BinanceP2PAnToan #BinanceP2P #BNB
1
213
·
--
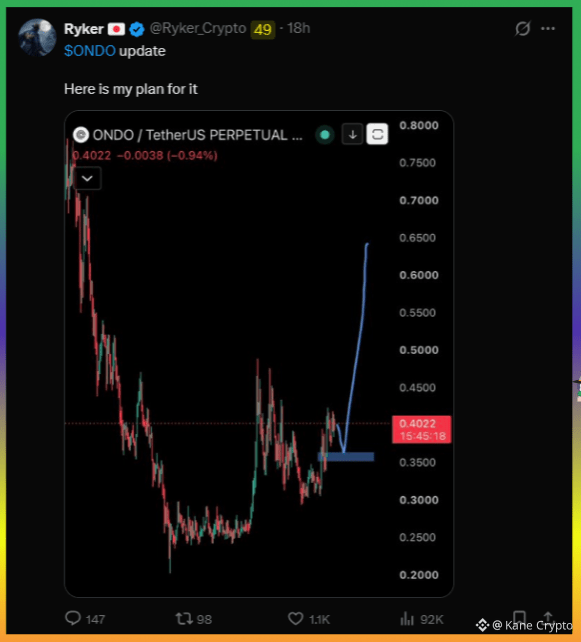
ONDO fait partie de rares altcoins en lesquels j’ai une confiance extrêmement grande
Récemment, l’idole Ryker a présenté le plan d’ONDO
Les amis, vous pouvez jeter un œil :))
Faites vos propres recherches (DYOR)
ONDO fait partie de rares altcoins en lesquels j’ai une confiance extrêmement grande
Récemment, l’idole Ryker a présenté le plan d’ONDO
Les amis, vous pouvez jeter un œil :))
Faites vos propres recherches (DYOR)
Récemment, l’idole Ryker a présenté le plan d’ONDO
Les amis, vous pouvez jeter un œil :))
Faites vos propres recherches (DYOR)
1
1
322
·
--
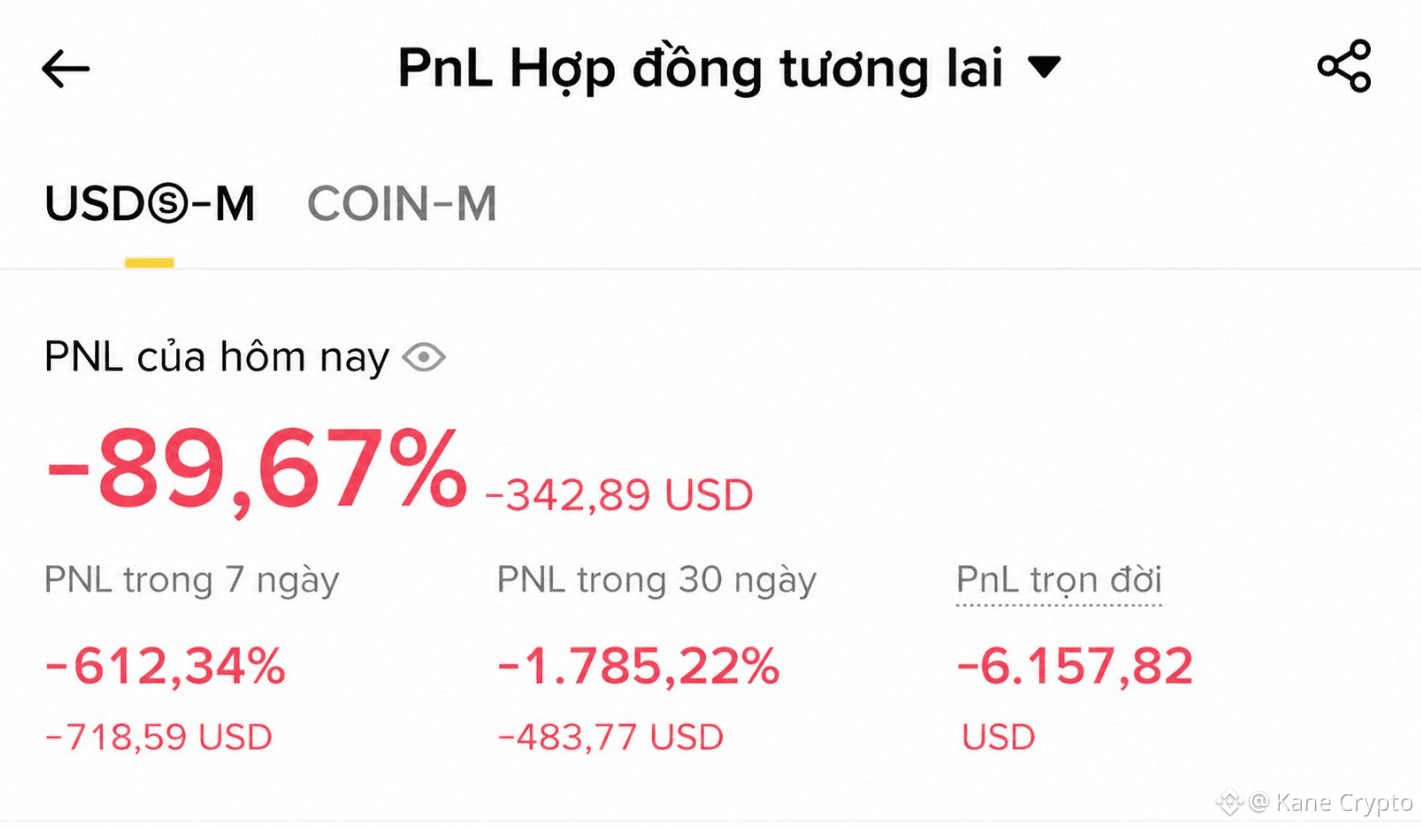
C’est un de mes potes
il est plus doué que moi de $6k
il travaille de bureau, kiếm quelques đồng mais il dépense tout pour faire des offrandes à la plateforme, il assume
C’est un de mes potes
il est plus doué que moi de $6k
il travaille de bureau, kiếm quelques đồng mais il dépense tout pour faire des offrandes à la plateforme, il assume
il est plus doué que moi de $6k
il travaille de bureau, kiếm quelques đồng mais il dépense tout pour faire des offrandes à la plateforme, il assume
1
317
·
--
Chaque mois, mettez 10% de votre revenu de côté pour accumuler de l’ETH
Ça vous va, les gars ?
Le jour où l’ETH atteint 10k et le jour où l’empereur rentre à la maison
Et je ne veux plus travailler pour quelqu’un d’autre non plus, kk
$ETH
{future}(ETHUSDT)
Chaque mois, mettez 10% de votre revenu de côté pour accumuler de l’ETH
Ça vous va, les gars ?
Le jour où l’ETH atteint 10k et le jour où l’empereur rentre à la maison
Et je ne veux plus travailler pour quelqu’un d’autre non plus, kk
$ETH
Ça vous va, les gars ?
Le jour où l’ETH atteint 10k et le jour où l’empereur rentre à la maison
Et je ne veux plus travailler pour quelqu’un d’autre non plus, kk
$ETH
1
5
686
·
--
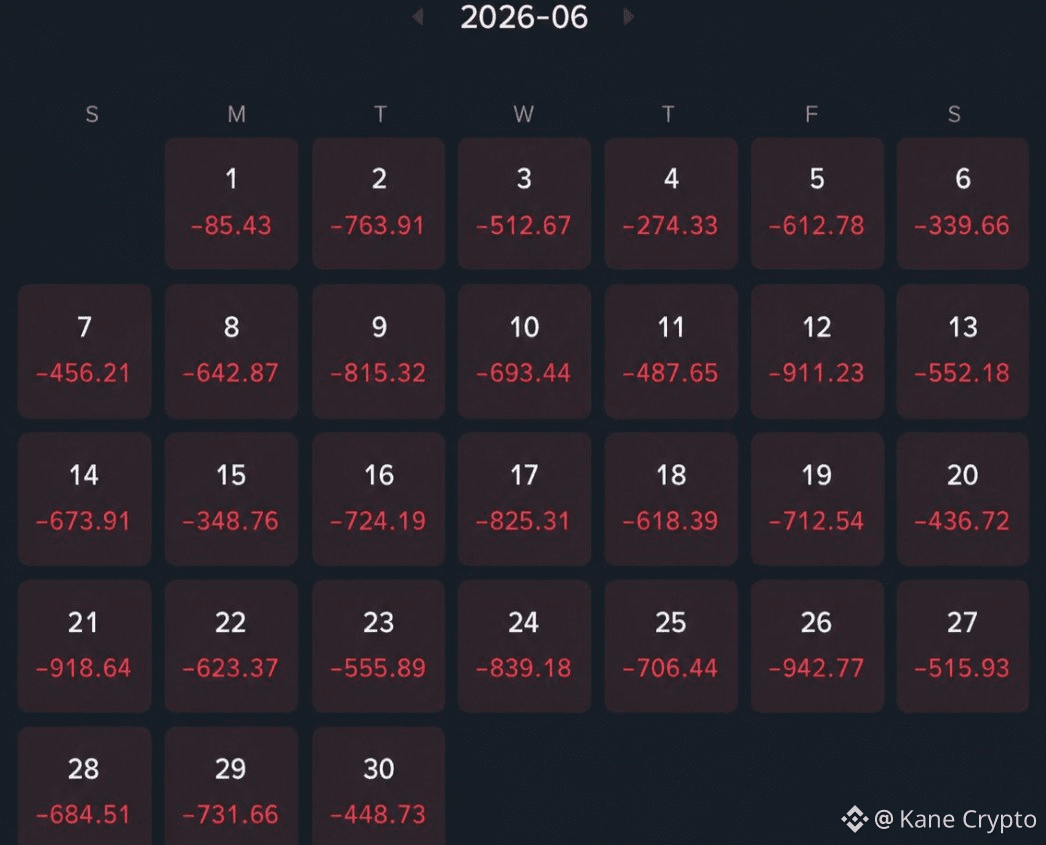
Mon ami trade comme ça, c’est du niveau, les gars ? :))
En juin, il n’a réussi à passer aucune position du tout, haha
Se vanter avec des ordres verts, c’était déjà du passé, haha
Mon ami trade comme ça, c’est du niveau, les gars ? :))
En juin, il n’a réussi à passer aucune position du tout, haha
Se vanter avec des ordres verts, c’était déjà du passé, haha
En juin, il n’a réussi à passer aucune position du tout, haha
Se vanter avec des ordres verts, c’était déjà du passé, haha
2
2
279
·
--
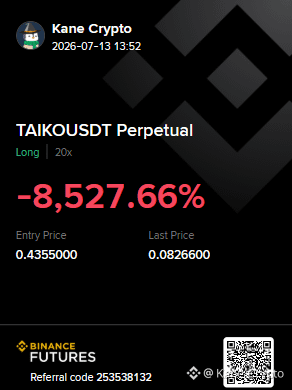
À propos du bord? Vous voulez vraiment?
$TAIKO
{future}(TAIKOUSDT)
À propos du bord? Vous voulez vraiment?
$TAIKO
$TAIKO
2
2
281
·
--
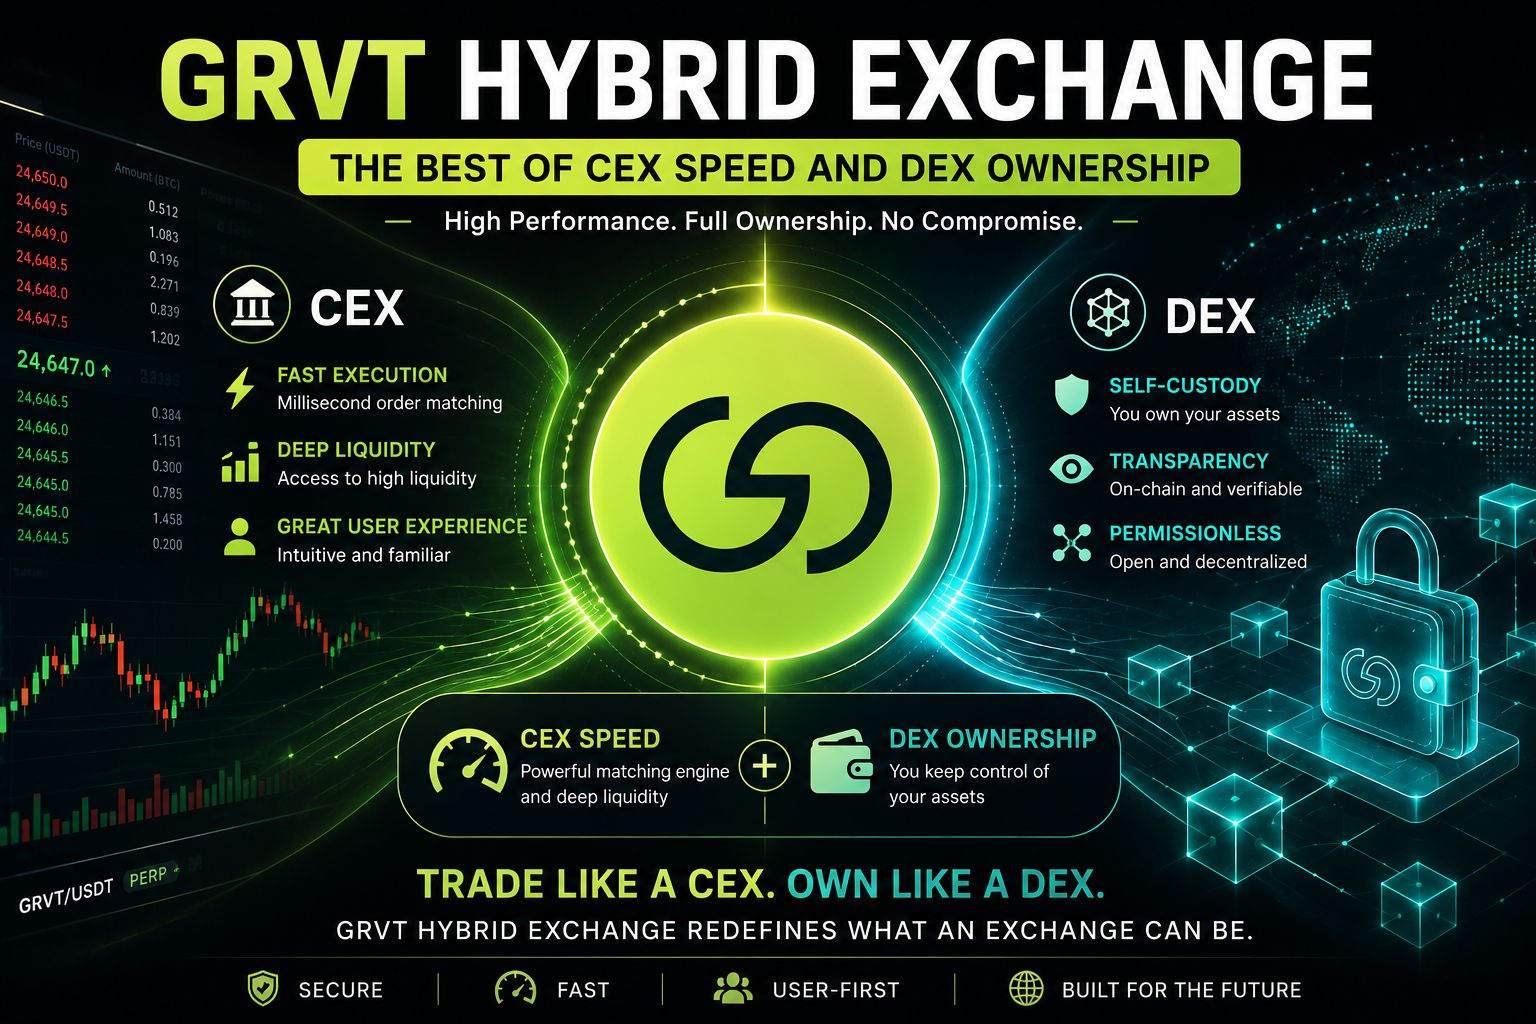
Il y a un détail dans la conception du @grvt_io facile à passer à côté : au lieu d’essayer de remplacer un CEX ou un DEX, le projet a plutôt construit un modèle de Hybrid Exchange pour combiner les deux.
Cela ressemble peut-être juste à une façon de nommer le produit. Mais ce qui est vraiment intéressant n’est pas le fait que GRVT se qualifie de « hybrid », c’est plutôt la raison pour laquelle ils ont choisi cette direction de conception.
Les CEX sont devenus populaires grâce à leur capacité à exécuter les ordres rapidement, à offrir une liquidité élevée et à proposer une expérience de trading fluide. En échange, les utilisateurs doivent déposer leurs actifs sur la plateforme et faire confiance à l’entité qui assure la conservation.
Les DEX permettent aux utilisateurs de conserver le contrôle de leurs actifs. En revanche, l’expérience de trading est souvent moins fluide, la liquidité peut se fragmenter et les performances sont plus difficiles à atteindre que celles des plateformes centralisées.
Le modèle de Hybrid Exchange de GRVT ne semble pas chercher à prouver que l’un est meilleur que l’autre (CEX ou DEX). Au contraire, le projet part d’une hypothèse différente : la vitesse d’exécution et la propriété des actifs ne sont pas forcément deux facteurs qui imposent un compromis.
Bien sûr, ce choix comporte aussi des trade-offs. En combinant l’expérience des CEX avec la gestion autonome des actifs façon DEX, le protocole doit concilier deux modèles basés sur des hypothèses très différentes, ce qui rend la conception plus complexe.
Ce qui m’a le plus marqué après avoir étudié GRVT n’est pas le slogan « combinez CEX et DEX », mais la manière dont le projet aborde le problème.
Au lieu d’accepter que les utilisateurs doivent choisir entre la commodité et la propriété des actifs, GRVT considère cette contrainte comme quelque chose qui vaut la peine d’être repensé. Le succès de ce modèle dépendra de la mise en œuvre, mais la décision de conception elle-même est déjà une perspective assez intéressante.
#grvt
1
179
·
--
Article
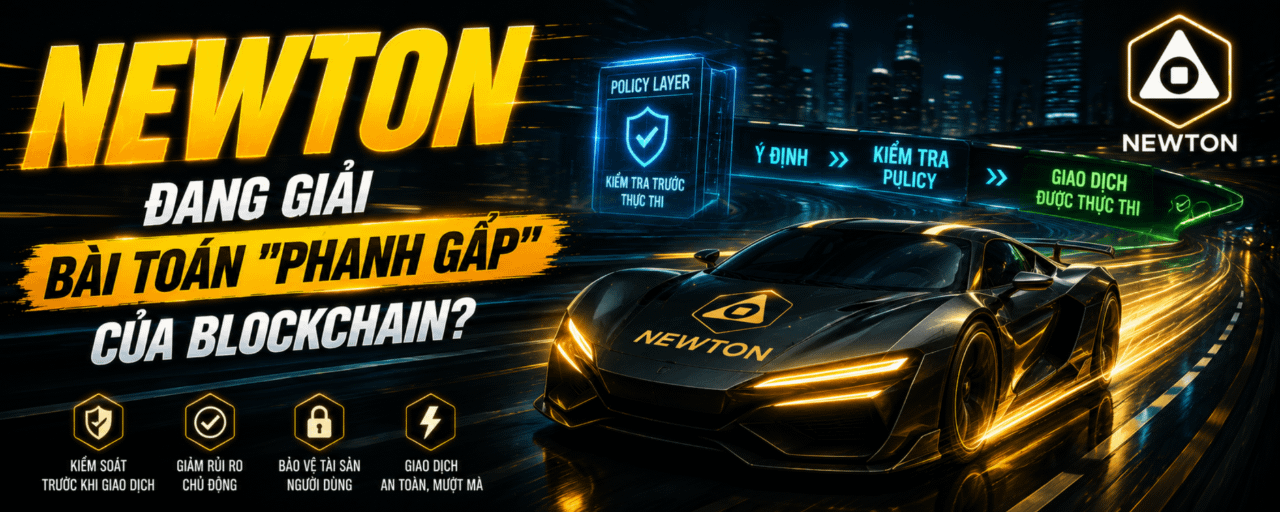
Newton résout le problème du « freinage d’urgence » de la blockchain ?Quand j’apprenais à conduire, mon prof nous a dit cette phrase, elle vaut vraiment la peine d’être retenue :
« Freiner brusquement n’est pas être bon ; c’est le signe que je réagis trop tard. ».
Être un bon conducteur, c’est conduire de façon à ne jamais avoir à appuyer sur les freins.
Regarder loin, anticiper, ralentir progressivement : même la personne assise à l’arrière ne sait même pas que la voiture vient d’éviter une situation dangereuse.
La conformité dans les crypto, c’est exactement pareil.
Les transactions ont déjà commencé avant que l’on découvre le problème ; à ce moment-là seulement, on a freiné : blocage du compte, remboursement, enquête.
Newton résout le problème du « freinage d’urgence » de la blockchain ?
Quand j’apprenais à conduire, mon prof nous a dit cette phrase, elle vaut vraiment la peine d’être retenue :
« Freiner brusquement n’est pas être bon ; c’est le signe que je réagis trop tard. ».
Être un bon conducteur, c’est conduire de façon à ne jamais avoir à appuyer sur les freins.
Regarder loin, anticiper, ralentir progressivement : même la personne assise à l’arrière ne sait même pas que la voiture vient d’éviter une situation dangereuse.
La conformité dans les crypto, c’est exactement pareil.
Les transactions ont déjà commencé avant que l’on découvre le problème ; à ce moment-là seulement, on a freiné : blocage du compte, remboursement, enquête.
3
4
193
·
--
Il y a deux façons de garder une rivière propre.
La première consiste à laisser les ordures dériver, puis à se placer tout au bout de la rivière pour les repêcher.
La seconde consiste à installer un filet au tout début du cours d’eau : les déchets sont bloqués avant même d’avoir le temps de partir.
La crypto, c’est pareil… mais elle applique plutôt la première méthode.
Les transactions passent d’abord ; le piratage ou le blanchiment viennent ensuite.
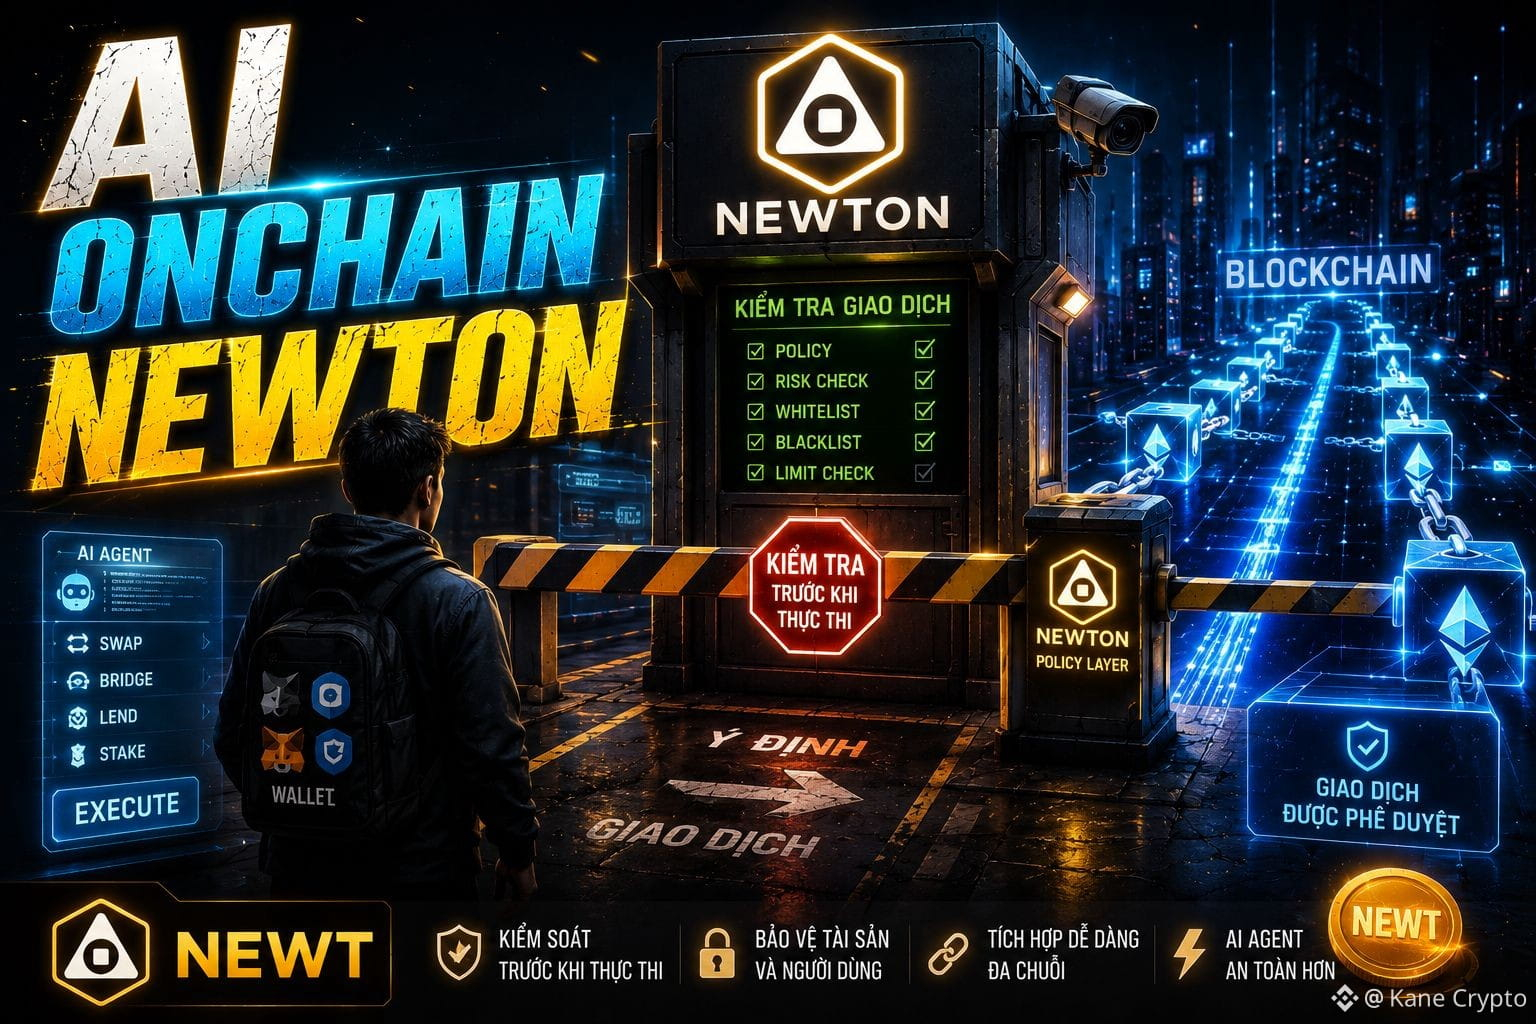
@NewtonProtocol là, au contraire, a choisi la voie inverse.
Ne pas attendre que les transactions soient exécutées pour les vérifier.
Et surtout demander avant :
« Cette commande a-t-elle le droit d’être exécutée ? »
À mon avis, c’est là le point le plus intéressant de Newton.
Newton fait comme un verrou entre l’utilisateur et la blockchain.
Vous voulez transférer de l’argent ?
Vous voulez faire un swap ?
Vous voulez passer le verrou ?
D’accord.
Il faut d’abord vérifier :
S’il n’y a pas violation, on laisse passer
S’il y a violation, on stoppe tout.
Pas besoin de rester là à « colmater » après coup.
Une chose que je trouve assez géniale, c’est que...
Ces dernières années, la crypto s’est acharnée à corriger les bugs des smart contracts.
Alors que dans beaucoup d’affaires, la perte d’argent ne vient pas d’un code erroné.
Mais à cause de...
Quelqu’un avait raison, le code était correct, mais la décision était mauvaise.
Newton ne répare pas la blockchain.
Ils ajoutent une couche « autorisé ou non autorisé » avant même que la blockchain ne se mette au travail.
C’est petit, mais je pense que c’est justement ce dont il y a le plus besoin.
Cependant, il reste un problème.
Plus une policy est facile à créer, plus elle risque d’être détournée.
Aujourd’hui, on bloque les hackers.
Demain, on bloque aussi davantage les utilisateurs dans le pays A.
Le lendemain, on ajoute encore des dizaines d’autres conditions.
À ce moment-là, la blockchain restera décentralisée...
Mais le pouvoir, lui, sera concentré dans un « portail ».
À mon avis, la question importante n’est pas de savoir à quel point Newton filtre vite.
Mais plutôt :
Qui écrit la policy ?
Qui a le droit de la modifier ?
Et si la policy est mauvaise, qui en est responsable ?
J’aime quand même beaucoup l’approche de Newton.
Ils veulent devenir une couche d’autorisation que n’importe quelle chaîne puisse utiliser.
#Newt $NEWT $M $TLM
1
1
331
·
--
Article
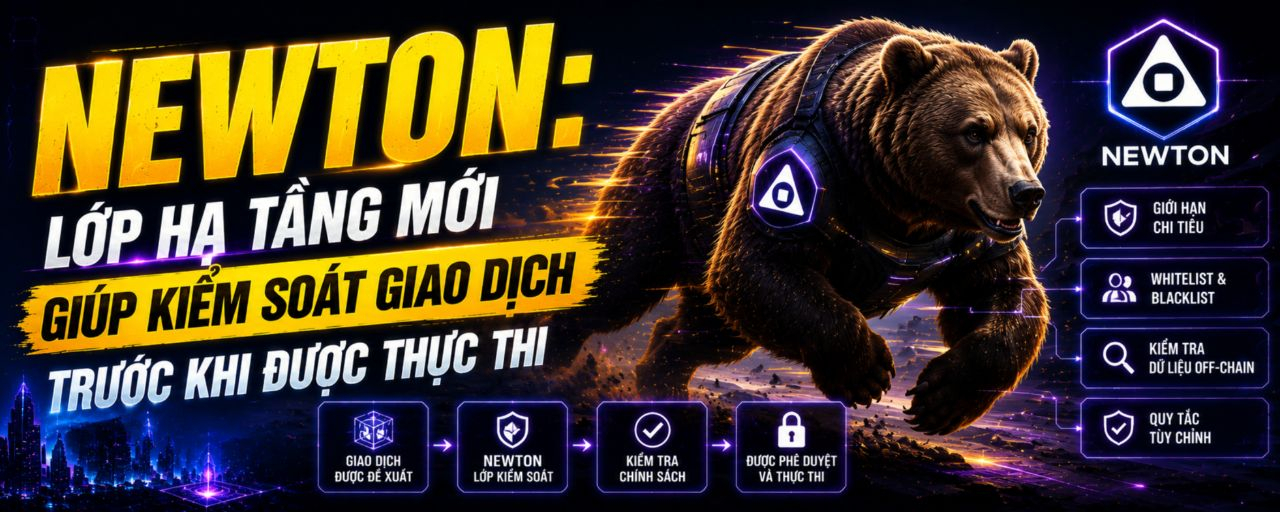
Newton : une nouvelle couche d’infrastructure pour contrôler les transactions avant leur exécutionDans le contexte où les agents d’IA sont de plus en plus utilisés dans la blockchain, Newton adopte une approche assez différente. Au lieu de se concentrer sur le développement d’un modèle d’IA plus intelligent ou sur la création d’une nouvelle blockchain, le projet vise à créer une couche d’infrastructure permettant de contrôler les transactions avant qu’elles ne soient exécutées.
L’élément à noter est que Newton n’exige pas que les développeurs passent à une autre blockchain ou réécrivent l’application existante. Le projet ajoute simplement une couche de vérification juste avant l’étape d’exécution de la transaction.
Newton : une nouvelle couche d’infrastructure pour contrôler les transactions avant leur exécution
Dans le contexte où les agents d’IA sont de plus en plus utilisés dans la blockchain, Newton adopte une approche assez différente. Au lieu de se concentrer sur le développement d’un modèle d’IA plus intelligent ou sur la création d’une nouvelle blockchain, le projet vise à créer une couche d’infrastructure permettant de contrôler les transactions avant qu’elles ne soient exécutées.
L’élément à noter est que Newton n’exige pas que les développeurs passent à une autre blockchain ou réécrivent l’application existante. Le projet ajoute simplement une couche de vérification juste avant l’étape d’exécution de la transaction.
L’élément à noter est que Newton n’exige pas que les développeurs passent à une autre blockchain ou réécrivent l’application existante. Le projet ajoute simplement une couche de vérification juste avant l’étape d’exécution de la transaction.
1
427
·
--
Eh, mec, je suis le protocole Newton depuis un moment déjà, et plus je le lis, plus je vois que beaucoup de gens comprennent mal ce projet.
Beaucoup pensent que Newton n’est qu’un projet d’IA.
Mais, selon moi, ce qu’ils construisent n’est pas de l’IA : c’est une couche de contrôle avant qu’une IA ne soit autorisée à effectuer des transactions.
C’est là que ça devient vraiment intéressant.
La blockchain garantit uniquement que la transaction est exécutée correctement.
Elle ne se soucie pas de savoir si l’IA décide juste ou faux.
Si l’IA lit mal des données et swap au mauvais endroit, la chaîne traitera quand même la transaction normalement.
Newton veut combler précisément ce manque.
Plutôt que laisser l’IA décider toute seule, chaque transaction doit passer par une couche de policy :
contrôle des limites de dépense, whitelist, données off-chain… les conditions suffisantes doivent être réunies avant exécution.
Ce que j’aime, c’est que Newton ne mise pas sur l’idée que l’IA deviendra forcément de plus en plus intelligente.
Ils partent du principe que l’IA peut toujours se tromper, donc ils ajoutent une “couche de frein” avant que l’argent ne soit déplacé.
Mais il y a aussi une question qui mérite réflexion.
La policy est aussi créée par des humains.
Si le marché change et que la policy n’est pas mise à jour à temps, elle peut aussi devenir une faiblesse du système.
À mon avis, Newton ne construit pas seulement une infrastructure pour les agents IA : ils construisent une couche d’autorisation pour l’IA sur la blockchain.
Si les agents IA deviennent une tendance dans quelques années, cela pourrait être un élément très important.
Et toi, qu’en penses ?
L’IA devrait-elle avoir un contrôle total sur les transactions, ou faut-il toujours une couche “de frein” comme Newton au milieu ? 👇
@NewtonProtocol #Newt $NEWT $NFP $BNB
1
1
262
·
--
Article
Newton est en train de résoudre le plus grand problème des agents IA ?Hé, les gars,
Plus je lis sur les agents IA on-chain, plus je trouve ça assez contre-intuitif.
Le plus grand problème, c’est parfois de savoir si l’IA est assez intelligente.
Mais c’est...
Qui a le droit de lui faire appuyer sur le bouton ?
Imagine un peu.
Une IA à qui on confie la gestion de ton portefeuille.
Elle lit les propositions toute seule, cherche le profit, équilibre le portefeuille, transfère les actifs, fait tourner les stablecoins pour générer des intérêts.
Ça a l’air vraiment génial.
Mais si un jour elle décide de travers et fait perdre de l’argent...
Newton est en train de résoudre le plus grand problème des agents IA ?
Hé, les gars,
Plus je lis sur les agents IA on-chain, plus je trouve ça assez contre-intuitif.
Le plus grand problème, c’est parfois de savoir si l’IA est assez intelligente.
Mais c’est...
Qui a le droit de lui faire appuyer sur le bouton ?
Imagine un peu.
Une IA à qui on confie la gestion de ton portefeuille.
Elle lit les propositions toute seule, cherche le profit, équilibre le portefeuille, transfère les actifs, fait tourner les stablecoins pour générer des intérêts.
Ça a l’air vraiment génial.
Mais si un jour elle décide de travers et fait perdre de l’argent...
5
1
242
·
--
Eh,
Hier, j’ai mis 124 USD de marge sur des futures, avec un levier x10.
Une position à 36 USD, et le funding fee clignotait en continu.
Mais en y repensant, ce qui m’a le plus dérangé n’est pas le fait que je sois sur le point d’être liquidé.
C’est… la mémoire.
Si le trade est mauvais, tu peux fermer la position.
Si tu approuves par erreur, tu peux révoquer.
Si tu prends le mauvais itinéraire, si tu perds quelques dollars de frais de gas ou si tu subis du slippage, au moins tu sais clairement où tu t’es trompé.
Mais une mémoire erronée, c’est différent.
Elle ne casse pas tout de suite, mais elle traverse tranquillement toute la chaîne d’extraction → stockage → récupération → inférence, puis l’IA en tire une conclusion qui semble très logique.
Le seul souci, c’est que… elle s’appuie sur l’ancienne version de toi.
Ce qui me fait le plus réfléchir, c’est :
Le danger ne vient pas de données fausses.
Il vient de données qui étaient justes, mais qui sont désormais expirées.
Par exemple, à l’époque, tu gérais 14 wallets, tu faisais du market making, tu trades en continu.
Puis tu as arrêté pendant six mois.
Mais l’IA continue de te considérer comme un trader actif.
TEE ne fait que prouver que ces données existaient un jour.
Elle ne prouve pas que ces données sont encore exactes.
La crypto m’a appris une leçon :
Une vérité qui a expiré, mais qu’on continue parfois de croire, peut être plus dangereuse qu’une phrase fausse dès le départ.
S’il n’y a pas la notion de temps, la semantic search ne fait que remuer le passé.
Si l’utilisateur ne peut pas mettre à jour sa mémoire, les anciennes données deviennent facilement une « vérité vérifiée ».
Et à ce moment-là, oublier ne sera plus une réaction naturelle.
Ça deviendra… une opération.
@NewtonProtocol , tout en construisant un agent IA on-chain, et la mémoire est presque l’âme de l’agent.
Si on ne résout pas le problème de « temporal relevance », l’IA agira sur la version d’avant, pas sur l’humain d’aujourd’hui.
#Newt $NEWT $NFP $BTC
2
1
306
·
--
Article
Newton : une couche de sécurité oubliée, mais potentiellement la plus importanteHé, les cryptos, parlons un peu d’un morceau assez « silencieux » dans la pile de sécurité de Newton.
Quand on parle de la sécurité de Newton, tout le monde a souvent tendance à beaucoup mentionner Chainalysis ou Hexagate, grâce à leur capacité à détecter les risques en temps réel, en interdisant les transactions anormales presque immédiatement.
Mais il y a un nom moins remarqué : Octane.
À mon avis, ne pas tenir compte d’Octane, c’est manquer un peu de recul.
En fait, il résout un problème complètement différent.
Newton : une couche de sécurité oubliée, mais potentiellement la plus importante
Hé, les cryptos, parlons un peu d’un morceau assez « silencieux » dans la pile de sécurité de Newton.
Quand on parle de la sécurité de Newton, tout le monde a souvent tendance à beaucoup mentionner Chainalysis ou Hexagate, grâce à leur capacité à détecter les risques en temps réel, en interdisant les transactions anormales presque immédiatement.
Mais il y a un nom moins remarqué : Octane.
À mon avis, ne pas tenir compte d’Octane, c’est manquer un peu de recul.
En fait, il résout un problème complètement différent.
1
1
95
·
--
Oh, raconte nghe về @NewtonProtocol de Magic Labs nè.
Beaucoup de gens disent : « Magic, c’était surtout un wallet. Maintenant ils passent sur la conformité, sûrement pour suivre la tendance. »
Ça se tient, parce que dans le crypto, il ne manque pas d’équipes qui se lancent sur des narratifs.
Mais en creusant, c’est différent.
Magic fait des wallets intégrés depuis 2018, et aujourd’hui ils comptent plus de 57 millions de wallets, 200.000+ développeurs intégrés, et un volume de stablecoins qui dépasse 10 milliards de dollars. Forbes, Polymarket et Helium les utilisent. Ce sont de vrais utilisateurs, pas des chiffres sortis pour raconter une histoire.
Newton n’est pas un produit dérivé. C’est une étape d’extension depuis la gestion de comptes → la gestion des transactions.
L’idée est que, avant même que la transaction ne s’exécute, le système vérifie des règles comme KYC, AML, des limites de transaction, et même des données hors chaîne + de l’IA.
C’est la partie que les smart contracts « traditionnels » faisaient moins bien.
La technologie qu’ils utilisent, c’est TEE + ZK, pour à la fois aider à la conformité tout en préservant la confidentialité.
Un point à noter :
Le monde dépense plus de 200 milliards de dollars chaque année pour la conformité. Si ces règles sont programmées, Newton pourrait grandement bénéficier de la tendance stablecoins et RWA.
Mais il y a encore des avis en sens inverse.
Le fait d’avoir déjà des utilisateurs, c’est un atout. Mais est-ce que les développeurs les utilisent vraiment ? Trop strict, tu perds des utilisateurs ; trop laxiste, tu perds le sens.
Points positifs : Magic a déjà une bonne base de sécurité et a été validée via des produits concrets comme Polymarket.
En résumé :
Newton ne ressemble pas à un projet qui court après la tendance. C’est plutôt une extension assez logique, du onboarding jusqu’à la couche transactionnelle.
Mais que ce soit un succès ou non, il faudra attendre de voir si les dev votent avec un produit réellement utilisé.
Vous en pensez quoi ? Ape ou pass ? 👇
#Newt $NEWT $SYN
1
257
·
--
Ê camarades crypto, OpenGradient joue une technique de privacy par IA d’un niveau exceptionnel
La plupart des projets d’IA se vantent de « protéger vos données », mais en réalité ce ne sont que des promesses en l’air.
Aujourd’hui ils jurent, demain ils “corrigent” — et s’ils sont contraints par le gouvernement, ils doivent tout remettre, car eux peuvent encore voir ce que tu demandes.
OpenGradient fait carrément autrement : même leur équipe ne sait pas ce que tu demandes.
Toute la procédure de réflexion et de réponse de l’IA tourne entièrement dans le TEE — cette « pièce fermée » matérielle sur le CPU et le GPU.
Les données que tu envoies sont chiffrées avant d’entrer, traitées en interne, et seuls les résultats en sortent.
Pas de clé, pas de logs, pas de chemin pour que quelqu’un puisse voir.
Le gouvernement veut réclamer les données ?
Il n’y a rien à donner.
Le point étrange et surtout le plus intéressant, c’est qu’ils combinent le matériel TEE avec une vérification sur la blockchain.
Tu peux vérifier toi-même que le code tourne correctement, sans avoir à croire la parole de qui que ce soit.
Pendant que d’autres projets se bousculent pour faire des modèles on-chain pour oai, OpenGradient se concentre sur la construction d’une véritable plateforme de calcul secret.
Le token #OPG sert à payer, héberger le modèle et déployer l’agent.
Ils ont déjà fait tourner des millions de fois des inférences privées.
Le TEE n’est pas une technologie nouvelle, mais l’utiliser par défaut pour le chat IA, c’est rare.
Le gros risque, c’est si le CPU d’Intel, d’AMD ou de NVIDIA tombe en panne : alors tout est foutu.
Ils préparent aussi du ZKML pour se protéger, mais ce n’est encore pas 100% parfait.
Plus tard, quand les règles sur l’IA se resserreront, celui qui détient les données des utilisateurs sera le premier à être scruté.
OpenGradient est conçu pour que personne ne puisse obtenir ces données — voilà une façon intelligente de survivre dans le segment crypto-IA.
Les gars, essayez leur app de chat : pas besoin de compte, pas de suivi, et vos questions disparaissent aussi.
L’histoire de la privacy + une vérification par IA est carrément très tendance.
$OPG mérite vraiment qu’on y fasse attention.
#BTC $SYN
1
1
402
·
--
Vérifié
Haha, tu viens de t’en rendre compte un peu tard : les agents IA répètent les vieilles boucles de la DeFi avec la couche 1.
Les gens se contentent de montrer tout ce que leurs agents peuvent faire ; peu demandent comment le système l’incite concrètement à agir. Le problème n’est pas la puissance de l’IA, mais les incitations et la confiance.
Ajouter encore des capacités ne sert à rien si l’utilisateur doit continuer à faire aveuglément confiance à une black box. L’essentiel n’est pas que l’agent décide à ta place, mais que tu puisses vérifier jusqu’où il en est.
@OpenGradient fait différent.
Ils ne suivent pas la tendance de l’agent « super intelligent », ils se concentrent sur une architecture (system design) fiable.
Avec HACA, ils séparent l’exécution et la vérification : l’inférence tourne vite d’abord, puis la preuve est vérifiée ensuite. TEE pour le LLM, ZKML pour les petits modèles.
Ils ont déjà lancé plus de 2 millions d’inférences vérifiables, et 500k+ de preuves.
Le point étrange, c’est qu’ils transforment l’inférence vérifiable en infrastructure : ainsi, quand l’agent décide quoi que ce soit, tout reste traçable — modèle + entrée + sortie.
Un peu comme la DeFi qui est passée de la confiance envers l’équipe à la confiance dans le code.
Mais moi, je continue à argumenter : si la preuve est lente, l’argent s’envole avant ; et le TEE implique toujours une hypothèse de confiance, tandis que les utilisateurs sont souvent trop paresseux pour vérifier.
Le marché récompense souvent ce qui est plus flashy que ce qui est certain.
Je les suis parce qu’ils jouent vraiment la confiance minimisée : ils considèrent l’IA comme un coprocesseur utile pour la chaîne et les agents.
La vraie question n’est pas quel agent est le plus intelligent, mais quel système le rend plus digne de confiance.
C’est exactement pour ça que je me suis intéressé à #OPG
$OPG $SYN $BTC
4
4
843
·
--
Vérifié
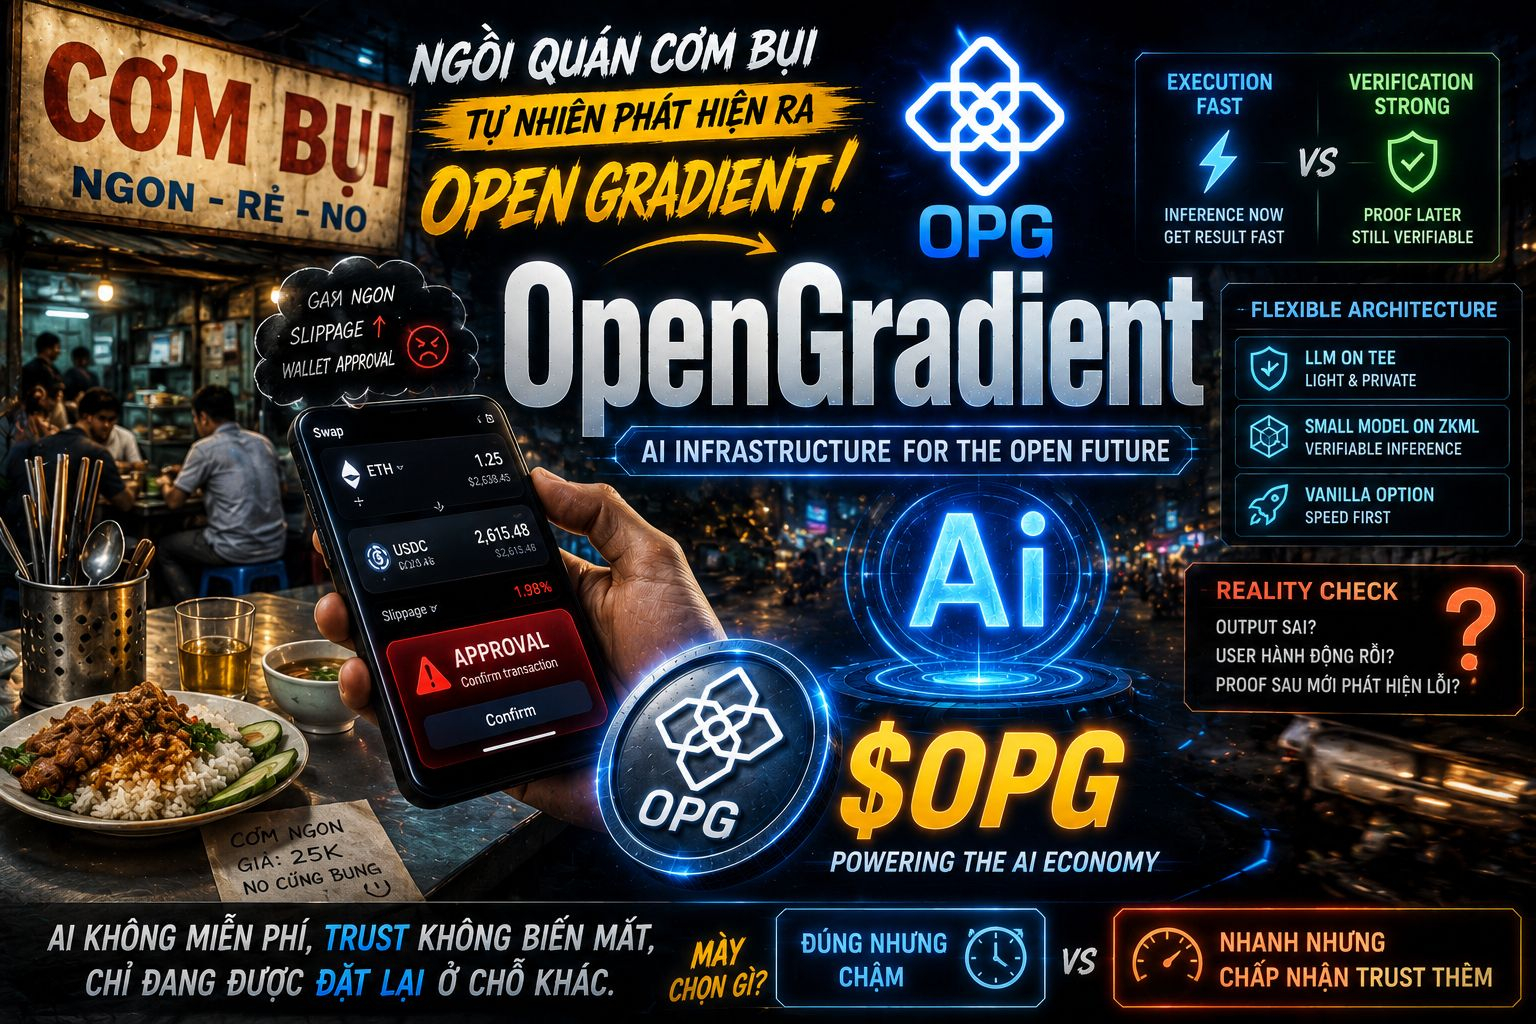
Hier, j’ai mangé dans un petit resto de rue tout en parcourant des routes sur DEX. Puis, d’un coup, le wallet a demandé une approbation : le gas a augmenté un peu, et le slippage s’est envolé d’environ 2 %.
Ça m’a légèrement agacé, puis j’ai pensé à @OpenGradient
Ce n’est pas parce que la bouffe est mauvaise.
Mais dans la crypto, il y a un ressenti très familier : plus j’entends le mot « verifiable », plus j’ai envie de demander : si l’argent s’envole, qui va payer ?
—
Le ZKML sur papier, ça sonne super beau.
L’IA a des preuves, l’inférence peut être vérifiée, tout est transparent.
Mais dans la réalité, le marché n’attend pas.
En DeFi ou pour du trading IA, quelques secondes de retard peuvent suffire à coûter cher.
Ça ne demande pas à quel point la preuve est jolie.
Ça demande juste :
« Le résultat quand j’appuie sur le bouton, ça marche ou pas ? »
C’est pour ça que je trouve qu’OpenGradient est plutôt pragmatique.
Au lieu d’obliger l’IA à tout vérifier avant de rendre le résultat, ils séparent execution et vérification.
L’inférence tourne d’abord pour que l’utilisateur reçoive la sortie rapidement.
La preuve arrive après pour conserver la possibilité de vérification.
Le LLM utilise le TEE pour que ça reste léger.
Les modèles légers utilisent du ZKML.
Si on veut de la vitesse, on choisit le mode vanilla.
Ils ne forcent pas tous les cas d’usage dans un seul compromis.
Mais la question reste.
Si la sortie est fausse, et que l’utilisateur agit déjà, puis que la preuve vient après et découvre l’erreur…
alors, la vérification à ce moment-là, elle a encore quel sens ?
C’est aussi pour ça que je continue de suivre OpenGradient.
Pas parce qu’ils promettent de tout régler.
Mais parce qu’au moins ils osent dire clairement : l’IA n’est pas gratuite, la confiance ne disparaît pas—elle est simplement déplacée ailleurs.
Tu choisis quoi :
c’est juste mais lent, ou rapide mais en acceptant d’ajouter un peu de trust ?
$OPG #opg
2
3
1.3k
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone