

#openledger
openledger
17.3M Aufrufe
202,843 Kommentare
Hot
Zuletzt
·
--
Bullisch
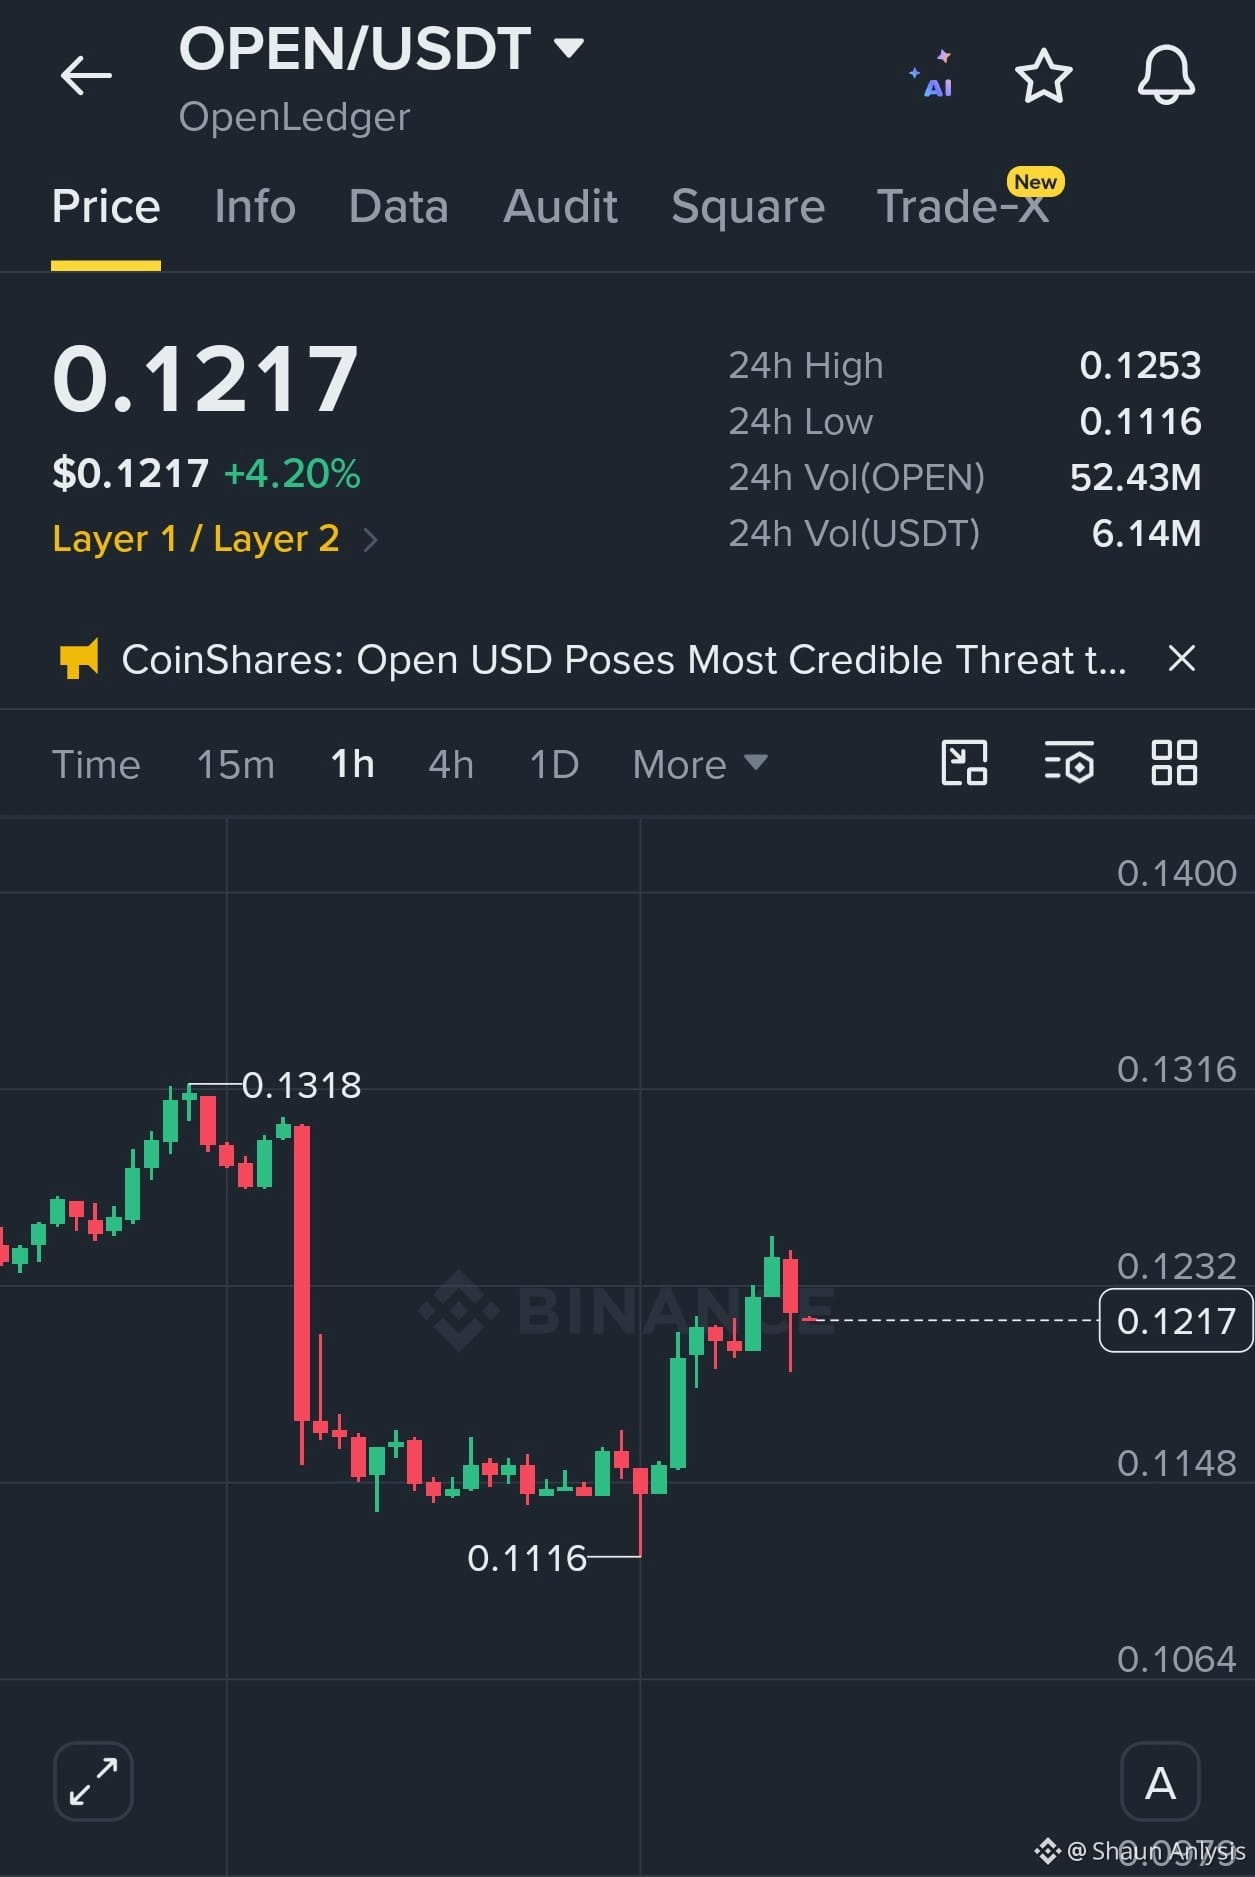
#OpenLedger hat soeben ein Lehrbuch-V-förmiges Comeback gedruckt – verpasst nicht das nächste Hoch.
Nach einem harten Flush auf 0.1116 ist $OPEN stark zurückgesprungen, hat die 0.12-Marke zurückerobert und liegt aktuell bei 0.1217 (+4.20% am Tag). Der 1H-Chart zeigt eine klare Verschiebung der Dynamik: Käufer verteidigen die Tiefs und drängen zurück in Richtung des 24H-Hochs von 0.1253.
Bullisch
Einstieg:0.1180 – 0.1220
SL:0.1100
TP1:0.1318
{future}(OPENUSDT)
#OpenLedger hat soeben ein Lehrbuch-V-förmiges Comeback gedruckt – verpasst nicht das nächste Hoch.
Nach einem harten Flush auf 0.1116 ist $OPEN stark zurückgesprungen, hat die 0.12-Marke zurückerobert und liegt aktuell bei 0.1217 (+4.20% am Tag). Der 1H-Chart zeigt eine klare Verschiebung der Dynamik: Käufer verteidigen die Tiefs und drängen zurück in Richtung des 24H-Hochs von 0.1253.
Bullisch
Einstieg:0.1180 – 0.1220
SL:0.1100
TP1:0.1318
1
94
·
--
Bullisch
Teilweise korrekt
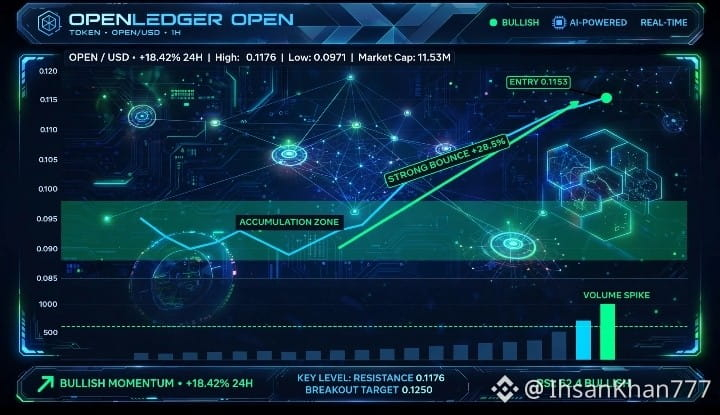
*OPEN: Eine ruhige KI-Chance am unteren Ende*
Während viele sich auf beliebte KI-Coins konzentrieren, wird OpenLedger (OPEN) nahe seinem niedrigsten Preis aller Zeiten gehandelt.
Von 1,84 USD auf 0,11 USD – eine große Korrektur von 94 Prozent. Ist das ein Boden?
Das macht OpenLedger interessant:
OpenLedger baut Infrastruktur für KI auf, bei der Daten, Modelle und KI-Agenten automatisch Zahlungen erhalten. Stell dir vor, KI-Agenten zahlen für verifizierte Daten on-chain. Das nennt man agentische Zahlungen, und OpenLedger will in diesem Bereich führend sein.
Die Marktkapitalisierung liegt bei rund 43 Mio. USD, während das Volumen bei 31 Mio. USD liegt. Das sind über 71 Prozent Umsatzumschlag – ein Zeichen für starkes Interesse und aktives Ansammeln.
Token-Unlocks sind im Gange. Etwa 612k Tokens täglich um den 8. Oktober herum. Kleine Unlocks erzeugen kurzfristigen Druck, bieten aber auch langfristige Chancen.
Es ist an großen Börsen gelistet, darunter Upbit, Bithumb und Binance, mit hoher Liquidität.
Ich habe OPEN bei 0,1153 USD nahe dem Tief gekauft. Das ist keine Finanzberatung, aber frühe Infrastruktur wirkt oft ruhig, bevor es zum Wachstum kommt.
#OpenLedger
#OpenAI
#BestTimeToBuy
#Market_Update
#BullRunTips
$OPEN
$BTC
$BNB
@XG297174
@dengshen
@eggtartcake_grape
@haoge666
@Square-Creator-f92ceb7e7882c
@Square-Creator-d4cc116ea2fe
@SGD852568
@Square-Creator-f0c9a305b41a7
@z12123444
@Square-Creator-9bd28167d172
@NUTS_btc
@heyi
@CZ
@Openledger
@Biswap_Dex
@MagVerse
@EASY7777
@KZG6886
@Z0628
@JavierDot
@oanicai
*OPEN: Eine ruhige KI-Chance am unteren Ende*
Während viele sich auf beliebte KI-Coins konzentrieren, wird OpenLedger (OPEN) nahe seinem niedrigsten Preis aller Zeiten gehandelt.
Von 1,84 USD auf 0,11 USD – eine große Korrektur von 94 Prozent. Ist das ein Boden?
Das macht OpenLedger interessant:
OpenLedger baut Infrastruktur für KI auf, bei der Daten, Modelle und KI-Agenten automatisch Zahlungen erhalten. Stell dir vor, KI-Agenten zahlen für verifizierte Daten on-chain. Das nennt man agentische Zahlungen, und OpenLedger will in diesem Bereich führend sein.
Die Marktkapitalisierung liegt bei rund 43 Mio. USD, während das Volumen bei 31 Mio. USD liegt. Das sind über 71 Prozent Umsatzumschlag – ein Zeichen für starkes Interesse und aktives Ansammeln.
Token-Unlocks sind im Gange. Etwa 612k Tokens täglich um den 8. Oktober herum. Kleine Unlocks erzeugen kurzfristigen Druck, bieten aber auch langfristige Chancen.
Es ist an großen Börsen gelistet, darunter Upbit, Bithumb und Binance, mit hoher Liquidität.
Ich habe OPEN bei 0,1153 USD nahe dem Tief gekauft. Das ist keine Finanzberatung, aber frühe Infrastruktur wirkt oft ruhig, bevor es zum Wachstum kommt.
#OpenLedger
#OpenAI
#BestTimeToBuy
#Market_Update
#BullRunTips
$OPEN
$BTC
$BNB
@K线人生飞哥
@比特币预言家
@Eggtartcake夕
@交易员张张子
@华尔街倩倩子
@猩火Bro
@Flash闪光灯
@乐天eth
@加密大格格
@klxmBobo
@Nuts坚果
@Yi He
@CZ
@OpenLedger
@Qordman crypto
@MagVerse
@EASY喊單哥
@KZG Crypto 口罩哥
@Whale韭阴针鲸0628
@_WHALE_
@Oanic AI
4
860
·
--
📉 $OPEN
— OpenLedger Cooling Off
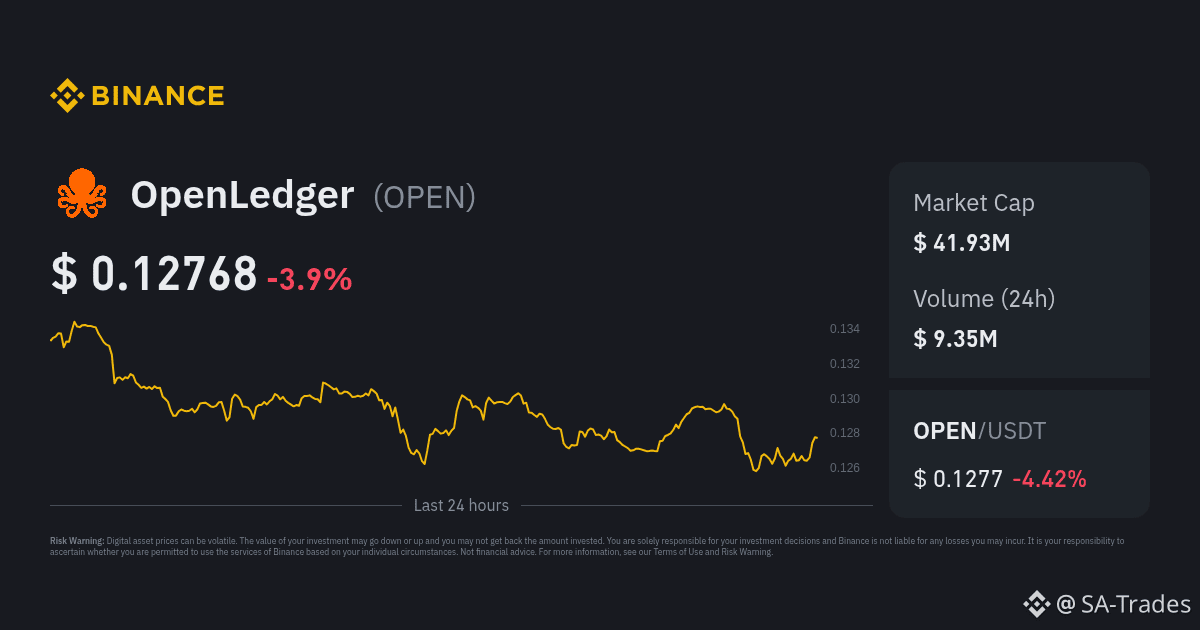
OpenLedger (OPEN) um -3.9% gesunken, wird jetzt bei 0.1277 $ gehandelt.
📊 Marktkapitalisierung: 41.93 Mio. $
📊 24h-Volumen: 9.35 Mio. $
Unruhige Kursbewegungen der letzten 24h — Verkäufer greifen ein, nachdem sie höhere Niveaus nicht halten konnten.
Akkumulationszone oder weiteres Abwärts-Potenzial? 👀
Trade $OPEN hier
{future}(OPENUSDT)
#OPEN #OpenLedger #BinanceSquare #crypto
📉 $OPEN
— OpenLedger Cooling Off
OpenLedger (OPEN) um -3.9% gesunken, wird jetzt bei 0.1277 $ gehandelt.
📊 Marktkapitalisierung: 41.93 Mio. $
📊 24h-Volumen: 9.35 Mio. $
Unruhige Kursbewegungen der letzten 24h — Verkäufer greifen ein, nachdem sie höhere Niveaus nicht halten konnten.
Akkumulationszone oder weiteres Abwärts-Potenzial? 👀
Trade $OPEN hier
#OPEN #OpenLedger #BinanceSquare #crypto
2
4
263
·
--
Jungs $OPEN unter Druck… Kommt es zu einem Rückprall?
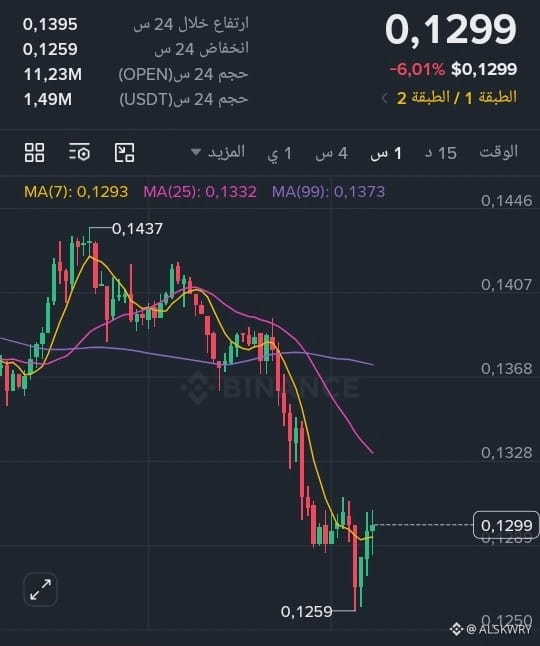
Die OpenLedger-Münze (OPEN) bewegt sich derzeit unter Verkaufsdruck, der Kurs liegt bei etwa $0.1299 nach einem Rückgang von ungefähr 6% in 24 Stunden.
📉 Wichtigste Levels:
🟢 Support: $0.1260
🔴 Widerstand: $0.1328 – $0.1330
🔴 Stärkerer Widerstand: $0.1368 – $0.1375
Wenn der Kurs $0.126 hält und beginnt, höhere Tiefs zu bilden, könnten wir einen Versuch für einen Rückprall sehen. Ein klarer Bruch davon könnte dagegen den Weg für niedrigere Kursniveaus öffnen.
👀 OPEN ist jetzt ein Beobachtungswert, nicht zum Kauf nur weil der Kurs gefallen ist.
Erwartet ihr einen Rückprall bei OPEN oder ein Fortsetzen des Abwärtstrends?
⚠️ Keine Finanzberatung, nur Analyse und Beitrag zur Diskussion.
#OpenLedger #cryptouniverseofficial #BinanceSquare #trading
1
1
228
Ein öffentliches Ledger ist ein transparenter, gemeinsam genutzter Aufzeichnungssystem, in dem jede Transaktion öffentlich sichtbar ist und von jedem überprüft werden kann. Im Gegensatz zu privaten Datenbanken entfällt die Notwendigkeit einer zentralen Instanz, weil das Vertrauen aus einem verteilten Konsens entsteht. Am bekanntesten wird ein öffentliches Ledger in der Blockchain-Technologie eingesetzt: Es erfasst Einträge chronologisch und macht sie nach der Bestätigung manipulationssicher. Diese Transparenz reduziert Betrug, erhöht die Verantwortlichkeit und ermöglicht unabhängige Prüfungen ohne Berechtigung. Unternehmen, Regierungen und Finanzsysteme nutzen öffentliche Ledgers, um Vermögenswerte, Verträge und Zahlungen offen nachzuverfolgen. Auch wenn es das Vertrauen stärkt, muss der Datenschutz sorgfältig gehandhabt werden, da die Daten öffentlich sind. Insgesamt fördern öffentliche Ledgers Fairness, indem sie allen Teilnehmenden den gleichen gleichberechtigten Zugang zu den selben verlässlichen Informationen geben.
#openledger $OPEN @Openledger
Ein öffentliches Ledger ist ein transparenter, gemeinsam genutzter Aufzeichnungssystem, in dem jede Transaktion öffentlich sichtbar ist und von jedem überprüft werden kann. Im Gegensatz zu privaten Datenbanken entfällt die Notwendigkeit einer zentralen Instanz, weil das Vertrauen aus einem verteilten Konsens entsteht. Am bekanntesten wird ein öffentliches Ledger in der Blockchain-Technologie eingesetzt: Es erfasst Einträge chronologisch und macht sie nach der Bestätigung manipulationssicher. Diese Transparenz reduziert Betrug, erhöht die Verantwortlichkeit und ermöglicht unabhängige Prüfungen ohne Berechtigung. Unternehmen, Regierungen und Finanzsysteme nutzen öffentliche Ledgers, um Vermögenswerte, Verträge und Zahlungen offen nachzuverfolgen. Auch wenn es das Vertrauen stärkt, muss der Datenschutz sorgfältig gehandhabt werden, da die Daten öffentlich sind. Insgesamt fördern öffentliche Ledgers Fairness, indem sie allen Teilnehmenden den gleichen gleichberechtigten Zugang zu den selben verlässlichen Informationen geben.
#openledger $OPEN @OpenLedger
#openledger $OPEN @OpenLedger
121
·
--
Früher hatte ich beim Cross-Chain-Trading am meisten Angst vor langsamen Transaktionen, sondern eher vor dem Moment, wenn "du denkst, es läuft nichts, und dann zittert deine Hand und du klickst nochmal", und plötzlich wird aus einem Trade zwei – und wenn das passiert, ist es peinlich, das im Rückblick zuzugeben: War das System nicht klar über den Status oder hast du einfach den Überblick verloren? Je mehr du versuchst, die Brücke in automatisierte Abläufe zu integrieren, desto gefährlicher wird dieser Fehler, denn eine wiederholte Ausführung ist nicht einfach "ein bisschen Verlust", sondern das durcheinanderbringen der Logik.
Deshalb schaue ich mir jetzt die EVM Bridge von @Openledger an und teste sie nach einem ganz einfachen Standard: Kann dieser Brückenschritt zu einem klaren Checkpoint werden, anstatt zu einer „Aktivität ohne klare Grenzen“? Wenn OctoClaw eine Aktion generiert und dieser Schritt ein Cross-Chain ist, möchte ich, dass es diese „Brückenaktion“ an einen eindeutigen Verweis bindet: Wenn du später denselben Trade auslöst, sollte das System nicht einfach stillschweigend die Aktion erneut ausführen, sondern dir klar mitteilen – dieser Trade ist gerade im Gange / bereits abgeschlossen / eine Wiederholung ist nicht erlaubt. Trading-Agenten können gerne weiter an den Verbindungen arbeiten, aber bei so risikobehaften Aktionen wie der Brücke muss zuerst das „Wiederholungsproblem“ beseitigt werden, sonst wird die Automatisierung immer mehr zu einem Minenfeld.
Heute habe ich nur einen Akzeptanzpunkt: Wenn die gleiche Brückenaktion erneut ausgelöst wird, kann das System dann direkt denselben Ausführungsreferenz zurückgeben und einen klaren Status (im Gange / abgeschlossen) anzeigen, während es gleichzeitig die Erstellung einer zweiten Brücke ablehnt? Wenn das funktioniert, betrachte ich die Bridge als fähig zur Ausführung; wenn nicht, lasse ich diesen Schritt lieber manuell bestätigen.
@Openledger $OPEN #OpenLedger
Früher hatte ich beim Cross-Chain-Trading am meisten Angst vor langsamen Transaktionen, sondern eher vor dem Moment, wenn "du denkst, es läuft nichts, und dann zittert deine Hand und du klickst nochmal", und plötzlich wird aus einem Trade zwei – und wenn das passiert, ist es peinlich, das im Rückblick zuzugeben: War das System nicht klar über den Status oder hast du einfach den Überblick verloren? Je mehr du versuchst, die Brücke in automatisierte Abläufe zu integrieren, desto gefährlicher wird dieser Fehler, denn eine wiederholte Ausführung ist nicht einfach "ein bisschen Verlust", sondern das durcheinanderbringen der Logik.
Deshalb schaue ich mir jetzt die EVM Bridge von @OpenLedger an und teste sie nach einem ganz einfachen Standard: Kann dieser Brückenschritt zu einem klaren Checkpoint werden, anstatt zu einer „Aktivität ohne klare Grenzen“? Wenn OctoClaw eine Aktion generiert und dieser Schritt ein Cross-Chain ist, möchte ich, dass es diese „Brückenaktion“ an einen eindeutigen Verweis bindet: Wenn du später denselben Trade auslöst, sollte das System nicht einfach stillschweigend die Aktion erneut ausführen, sondern dir klar mitteilen – dieser Trade ist gerade im Gange / bereits abgeschlossen / eine Wiederholung ist nicht erlaubt. Trading-Agenten können gerne weiter an den Verbindungen arbeiten, aber bei so risikobehaften Aktionen wie der Brücke muss zuerst das „Wiederholungsproblem“ beseitigt werden, sonst wird die Automatisierung immer mehr zu einem Minenfeld.
Heute habe ich nur einen Akzeptanzpunkt: Wenn die gleiche Brückenaktion erneut ausgelöst wird, kann das System dann direkt denselben Ausführungsreferenz zurückgeben und einen klaren Status (im Gange / abgeschlossen) anzeigen, während es gleichzeitig die Erstellung einer zweiten Brücke ablehnt? Wenn das funktioniert, betrachte ich die Bridge als fähig zur Ausführung; wenn nicht, lasse ich diesen Schritt lieber manuell bestätigen.
@OpenLedger $OPEN #OpenLedger
187
·
--
Artikel
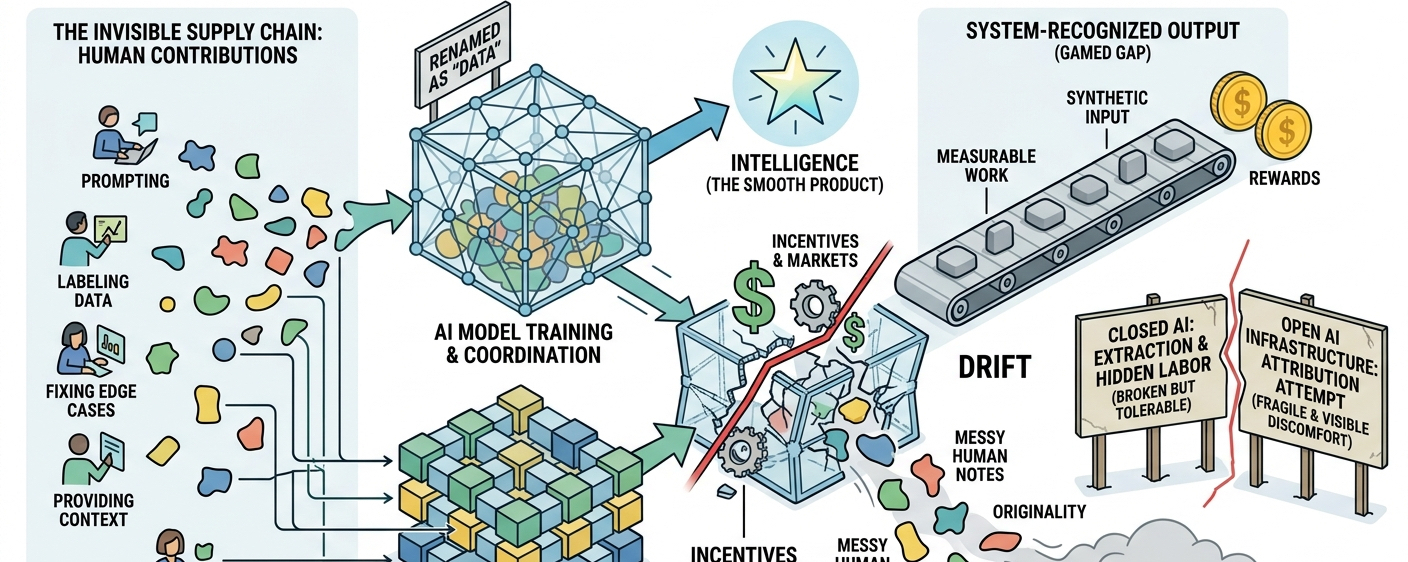
Die Infrastruktur bricht dort, wo Wissen wertvoll wirdIch habe es anfangs nicht ernst genommen.
nicht weil OpenLedger sich leer angehört hat. eher weil ich genug Zyklen der Krypto-Infrastruktur gesehen habe, um zu wissen, wie schnell ernsthafte Ideen zu Erzählungen plattgedrückt werden. einen Monat geht es um Koordination. dann um Besitz. dann um Verifizierung. dann „öffnet“ man alles. und für eine Weile fühlt sich die Sprache sauber genug an, um es zu glauben.
dann trifft das System auf Anreize.
und Anreize sind nie sauber.
Vielleicht ist das zu hart. vielleicht bin ich einfach nur müde davon, dabei zuzusehen, wie Protokolle nach und nach weniger mit ihrem ursprünglichen Problem zu tun haben und mehr mit den Märkten, die sich um sie herum gebildet haben. aber diese Müdigkeit lässt sich nur schwer ausschalten, besonders bei allem, was zwischen KI, Daten, Besitz und wirtschaftlichen Belohnungen sitzt.
Die Infrastruktur bricht dort, wo Wissen wertvoll wird
Ich habe es anfangs nicht ernst genommen.
nicht weil OpenLedger sich leer angehört hat. eher weil ich genug Zyklen der Krypto-Infrastruktur gesehen habe, um zu wissen, wie schnell ernsthafte Ideen zu Erzählungen plattgedrückt werden. einen Monat geht es um Koordination. dann um Besitz. dann um Verifizierung. dann „öffnet“ man alles. und für eine Weile fühlt sich die Sprache sauber genug an, um es zu glauben.
dann trifft das System auf Anreize.
und Anreize sind nie sauber.
Vielleicht ist das zu hart. vielleicht bin ich einfach nur müde davon, dabei zuzusehen, wie Protokolle nach und nach weniger mit ihrem ursprünglichen Problem zu tun haben und mehr mit den Märkten, die sich um sie herum gebildet haben. aber diese Müdigkeit lässt sich nur schwer ausschalten, besonders bei allem, was zwischen KI, Daten, Besitz und wirtschaftlichen Belohnungen sitzt.
2
1
138

·
--
Artikel
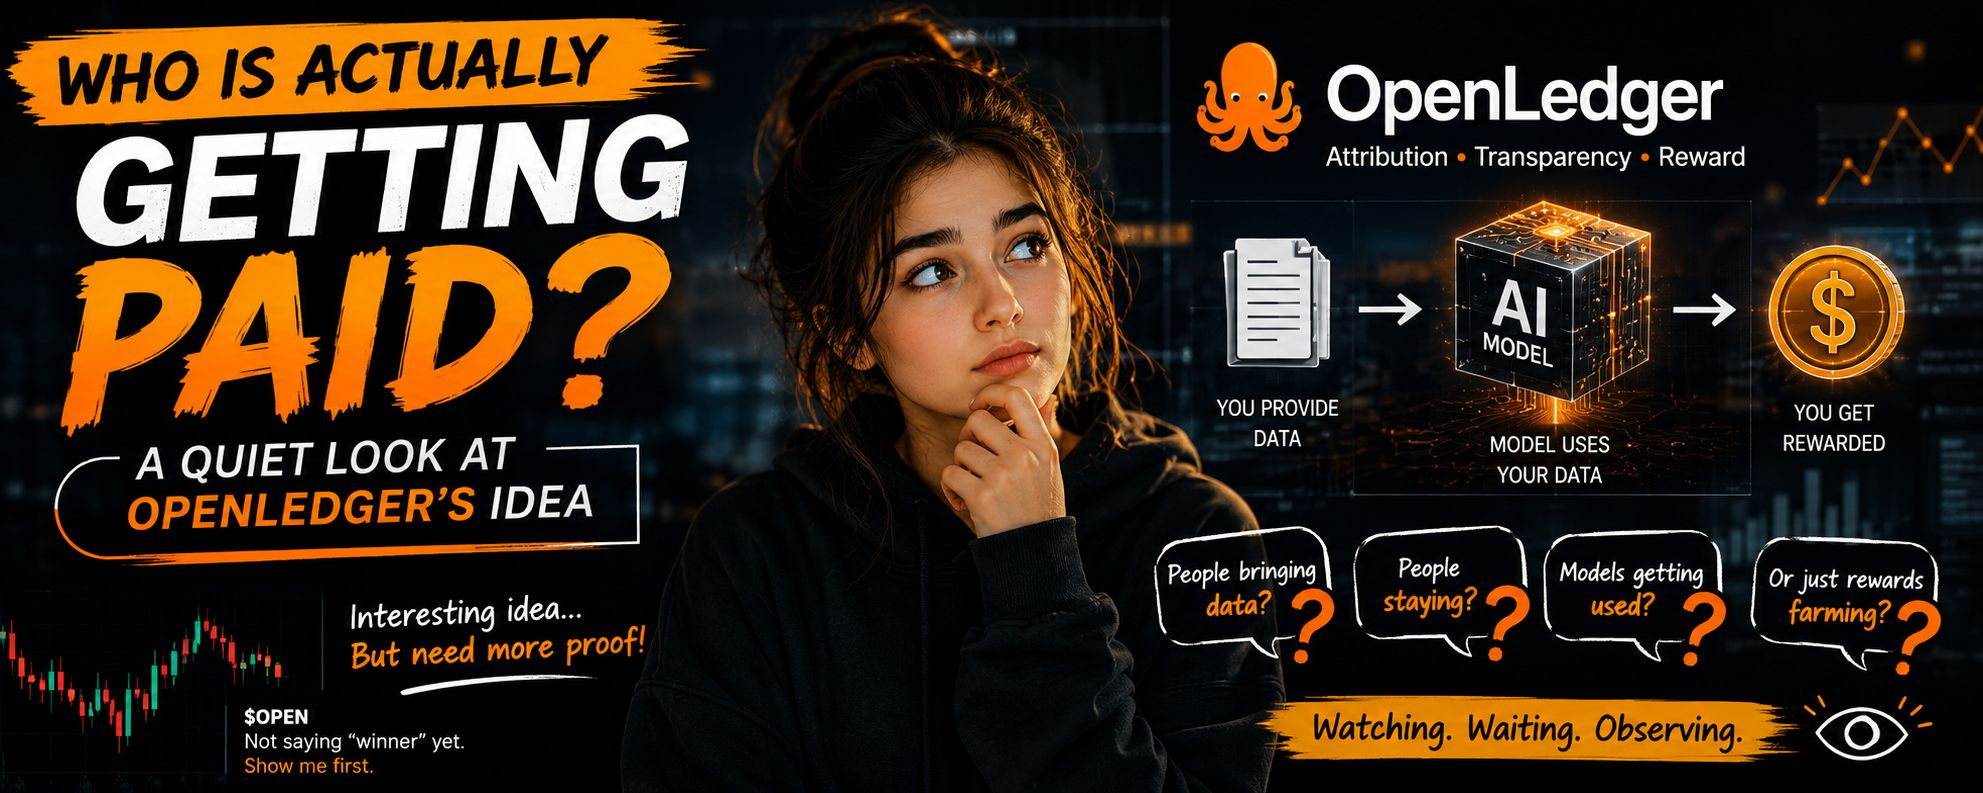
Wer Wird Eigentlich Bezahlt? Ein Ruhiger Blick auf die Idee von OpenLedger @Openledger .. Das hab ich schon mal gesehen… vielleicht vor ein paar Monaten. Der Chart hat einfach sein gewohntes Ding gemacht… hoch runter hoch runter. Aber mein Kopf blieb bei einer seltsamen Frage hängen.
Wer wird eigentlich bezahlt?
Nein, nein, ganz ehrlich… alle reden ständig über KI-Daten, Modelle, große Visionen für die Zukunft. Okay, fair enough. Schöne Worte. Aber wenn das alles wirklich funktioniert… wer verdient dann eigentlich das Geld? Ich schau mir das an, aber die Antwort scheint nicht so klar zu sein.
Dann sah ich #OpenLedger und diese Idee der "Attribution". Klingt nach einem großen fancy Wort… aber vielleicht ist es im Kern ganz einfach.
Wer Wird Eigentlich Bezahlt? Ein Ruhiger Blick auf die Idee von OpenLedger
@OpenLedger .. Das hab ich schon mal gesehen… vielleicht vor ein paar Monaten. Der Chart hat einfach sein gewohntes Ding gemacht… hoch runter hoch runter. Aber mein Kopf blieb bei einer seltsamen Frage hängen.
Wer wird eigentlich bezahlt?
Nein, nein, ganz ehrlich… alle reden ständig über KI-Daten, Modelle, große Visionen für die Zukunft. Okay, fair enough. Schöne Worte. Aber wenn das alles wirklich funktioniert… wer verdient dann eigentlich das Geld? Ich schau mir das an, aber die Antwort scheint nicht so klar zu sein.
Dann sah ich #OpenLedger und diese Idee der "Attribution". Klingt nach einem großen fancy Wort… aber vielleicht ist es im Kern ganz einfach.
14
5
297
#openledger $OPEN Die OpenLedger-Kampagne sorgt in der gesamten Krypto-Community für große Begeisterung – und das aus gutem Grund. Während sich die Blockchain-Technologie weiterentwickelt, positioniert sich OpenLedger als Projekt mit Fokus auf Innovation, Transparenz und ein gemeinschaftsgetriebenes Wachstum.
Die Teilnahme an der Binance OpenLedger-Kampagne bedeutet mehr als nur Aufgaben zu erledigen und Belohnungen zu erhalten – es ist eine Chance, Teil eines wachsenden Ökosystems zu werden, bevor die breitere Einführung stattfindet. Frühe Unterstützer sammeln oft wertvolle Erfahrungen, bauen stärkere Verbindungen innerhalb der Community auf und positionieren sich für zukünftige Möglichkeiten.
Was diese Kampagne besonders attraktiv macht, ist die Kombination aus Lernen, Engagement und Belohnungen. Egal, ob du ein erfahrener Krypto-Enthusiast bist oder gerade erst Web3 entdeckst: OpenLedger bietet eine tolle Möglichkeit, aktiv und informiert zu bleiben und möglicherweise von dem Wachstum des Projekts zu profitieren.
Schau nicht nur von der Seitenlinie zu – bring dich in die Diskussion ein, erledige die Kampagnenaktivitäten und entdecke, warum so viele Nutzer ein besonderes Augenmerk auf OpenLedger richten. Die nächste große Chance könnte näher sein, als du denkst! 🔥
#OpenLedger #BinanceSquare #Crypto #Web3 #Airdrop #Blockchain #BinanceCampaign #CryptoCommunity
81
·
--
#openledger $OPEN @Openledger
Ich selbst gehe davon aus, dass bessere KI-Agenten vor allem besseres Schlussfolgern brauchen. Je mehr ich mir Systeme wie OctoClaw ansah, desto weniger überzeugt war ich.
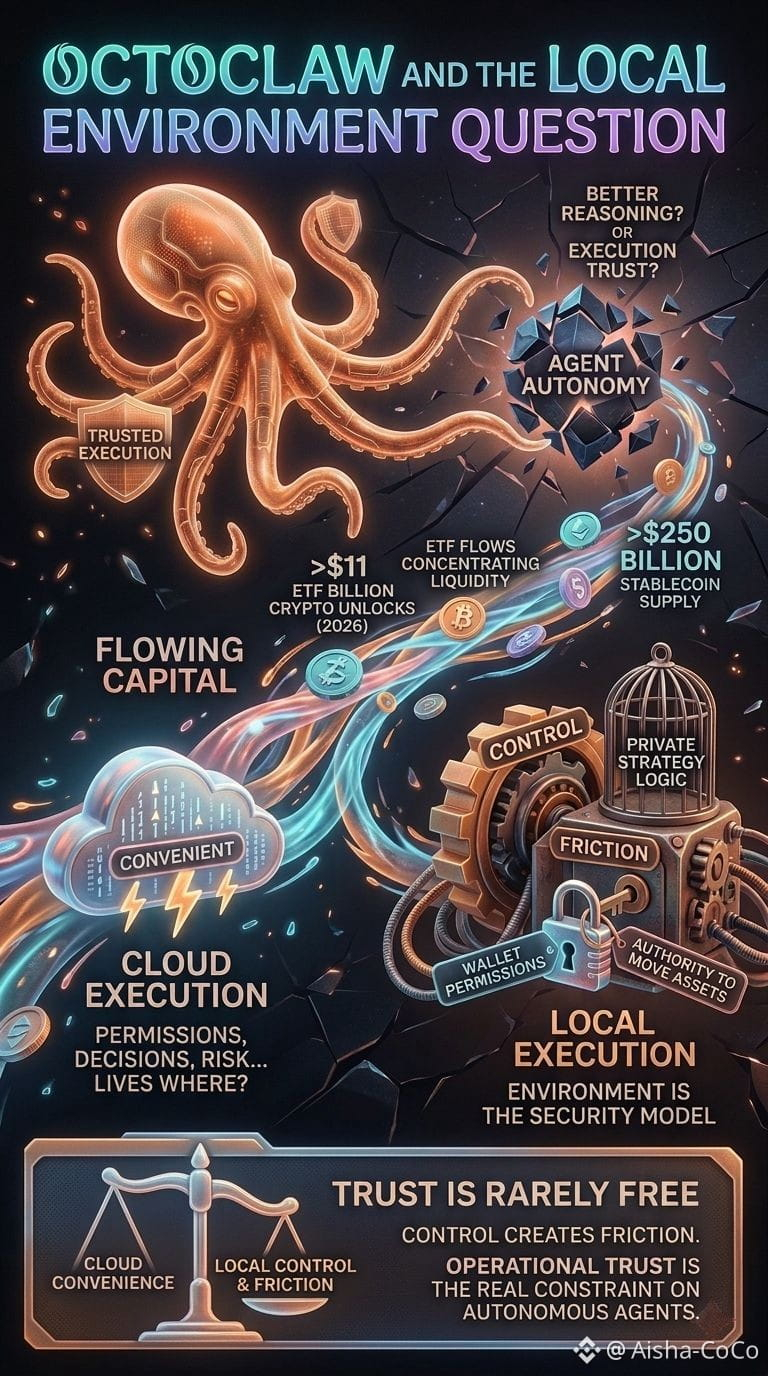
Meine Sicht ist einfach: Agentenautonomie ist weniger wichtig als Ausführungsvertrauen. Auf den ersten Blick wirkt die lokale Ausführung wie eine Datenschutzfunktion. Doch dahinter verlagert sich, wo Entscheidungen, Berechtigungen und das Risiko tatsächlich verortet sind. Wenn ein Agent Wallet-Berechtigungen übernimmt—also die Autorität, Assets zu bewegen oder private StraTegy-Logik—dann wird die Umgebung, in der diese Aktionen ausgeführt werden, Teil des Sicherheitsmodells.
Das wirkt zunehmend relevant, wenn im Jahr 2026 voraussichtlich über 11 Milliarden US-Dollar an Crypto-Token-Freigaben anstehen, ETF-Zuflüsse die Liquidität weiter konzentrieren und das Stablecoin-Angebot über 250 Milliarden US-Dollar gestiegen ist. Diese Zahlen deuten auf größere Kapitalpools und stärker automatisiertes Verhalten hin—nicht zwangsläufig auf bessere Urteilsfähigkeit.
Der Trade-off ist offensichtlich. Cloud-Ausführung ist bequem; lokale Ausführung bietet mehr Kontrolle. Aber Kontrolle schafft Reibung. Operatives Vertrauen ist selten kostenlos, und das könnte die eigentliche Einschränkung für autonome Agenten sein.
{future}(OPENUSDT)
#openledger $OPEN @OpenLedger
Ich selbst gehe davon aus, dass bessere KI-Agenten vor allem besseres Schlussfolgern brauchen. Je mehr ich mir Systeme wie OctoClaw ansah, desto weniger überzeugt war ich.
Meine Sicht ist einfach: Agentenautonomie ist weniger wichtig als Ausführungsvertrauen. Auf den ersten Blick wirkt die lokale Ausführung wie eine Datenschutzfunktion. Doch dahinter verlagert sich, wo Entscheidungen, Berechtigungen und das Risiko tatsächlich verortet sind. Wenn ein Agent Wallet-Berechtigungen übernimmt—also die Autorität, Assets zu bewegen oder private StraTegy-Logik—dann wird die Umgebung, in der diese Aktionen ausgeführt werden, Teil des Sicherheitsmodells.
Das wirkt zunehmend relevant, wenn im Jahr 2026 voraussichtlich über 11 Milliarden US-Dollar an Crypto-Token-Freigaben anstehen, ETF-Zuflüsse die Liquidität weiter konzentrieren und das Stablecoin-Angebot über 250 Milliarden US-Dollar gestiegen ist. Diese Zahlen deuten auf größere Kapitalpools und stärker automatisiertes Verhalten hin—nicht zwangsläufig auf bessere Urteilsfähigkeit.
Der Trade-off ist offensichtlich. Cloud-Ausführung ist bequem; lokale Ausführung bietet mehr Kontrolle. Aber Kontrolle schafft Reibung. Operatives Vertrauen ist selten kostenlos, und das könnte die eigentliche Einschränkung für autonome Agenten sein.
7
8
384
·
--
Vor ein paar Tagen kam mein Cousin, der im E-Commerce arbeitet, mit einer ganzen Menge #OpenLedger -beflissener Werbetext-Geplänkel zu mir an und sagte, wenn man ein bisschen Nutzerverhaltensdaten hineinfüttere, könne man $OPEN eintauschen—und fragte, ob das wirklich garantiert ohne Verluste sei. Ich wollte erst gar kein kaltes Wasser ausschütten. Stattdessen habe ich erst mal eine Charge entsensibilisierte Laden-Transaktionsdaten in DataNet eingespeist, um zu testen. Oberflächlich betrachtet läuft das On-Chain-Rechtsnachweis-Thema tatsächlich ziemlich sauber: Jede relevante Textpassage wird mit einem Attribution-Tag versehen, und das Ledger rechnet klar und nachvollziehbar. Aber nachdem ich einen kompletten Zyklus durchlaufen hatte, wurde mir der Geschmack doch unangenehm bewusst: Du hast überhaupt keine Preisgestaltungsbefugnis.
Das Gemeinste daran ist, dass es nicht du bestimmst, wie viel deine Daten wert sind—sondern ob das Terminal-Large-Model deine eingespeisten Parameter wirklich „verdaut“. Meine vermeintlich extrem wertvollen Konsumpräferenzdaten hatten dann aber leider nicht genau den Nerv der Zeit, was die aktuellen Modell-Feinabstimmungs-Hotspots betrifft. Die Token, die On-Chain ausgeschüttet wurden, zerbröselten jämmerlich, sodass nicht mal die Breitbandkosten für das Betreiben der Nodes aufgebracht werden konnten. Im Vergleich dazu hat der Typ nebenan einfach irgendein Allerwelts-Open-Source-Korpus in die Gegend gekippt—und bekam trotzdem eine deutlich würdigere Ausschüttung, weil es gerade zufällig in die Hochlastphase passte. Das ist keine faire Aufteilung nach Beitrag, sondern schlicht Glückspiel: Wetten darauf, dass der Modellhunger trifft.
$LAB
Noch schockierender ist, dass dein exklusiver Datensatz, sobald er verpackt und eingereicht wurde, im Mainnet-Index-Repository zwangsweise als Feature-Snapshot zwischengespeichert wird. Ganz offen gesagt: Der ganze „Schatz“, den du immer nur für dich behalten wolltest, liegt dann praktisch halb öffentlich auf dem Tisch—für alle im Netz. Die offiziellen Stellen nehmen Zero-Knowledge-Proofs als Ausrede: Daten gäben sie angeblich nie aus dem Local heraus. Aber wenn man der Einreichungslogik folgt, kann man die Schlussfolgerung nur weiter treiben: Die Metadaten-Features müssen trotzdem hochgeladen werden. Du glaubst, du würdest die Souveränität fest verriegeln—tatsächlich wird die Kerninformation längst still und leise abgezogen.
Ganz objektiv betrachtet: Die Idee, mit Kryptographie den Arbeitslohn mit Fälschungsschutz-Markierungen abzusichern, ist tatsächlich ziemlich „hart“. Auch die Attribution-Mechanik eröffnet den Retail-Leuten zumindest eine Tür, um einen Platz am Tisch zu ergattern. Aber das entscheidende Problem bleibt: Die Preisgestaltungsbefugnis steckt fest in den Händen der Algorithmen und der Big Player. Solange das so bleibt, sind Bottom-Contributors für das Modell immer nur billige Wegwerfverbrauchsmittel, die nach Gutdünken vom Modellhunger „geknackt“ werden. Ich rate meinem Cousin: Lass das Gehirn nicht durchbrennen und stürz dich nicht sofort mit einem großen Wurf hinein. Lauf erst mal ein paar Interaktionen, nimm dir ein bisschen Spielgeld, um die Abläufe zu testen. Warte dann auf echte Mainnet-Call-Daten, damit klar wird, wer am Ende tatsächlich Preisentscheidungen trifft—und dann erst wieder nachlegen. #BTC
#OpenLedger $OPEN @Openledger
{alpha}(560x7ec43cf65f1663f820427c62a5780b8f2e25593a)
{spot}(OPENUSDT)
Vor ein paar Tagen kam mein Cousin, der im E-Commerce arbeitet, mit einer ganzen Menge #OpenLedger -beflissener Werbetext-Geplänkel zu mir an und sagte, wenn man ein bisschen Nutzerverhaltensdaten hineinfüttere, könne man $OPEN eintauschen—und fragte, ob das wirklich garantiert ohne Verluste sei. Ich wollte erst gar kein kaltes Wasser ausschütten. Stattdessen habe ich erst mal eine Charge entsensibilisierte Laden-Transaktionsdaten in DataNet eingespeist, um zu testen. Oberflächlich betrachtet läuft das On-Chain-Rechtsnachweis-Thema tatsächlich ziemlich sauber: Jede relevante Textpassage wird mit einem Attribution-Tag versehen, und das Ledger rechnet klar und nachvollziehbar. Aber nachdem ich einen kompletten Zyklus durchlaufen hatte, wurde mir der Geschmack doch unangenehm bewusst: Du hast überhaupt keine Preisgestaltungsbefugnis.
Das Gemeinste daran ist, dass es nicht du bestimmst, wie viel deine Daten wert sind—sondern ob das Terminal-Large-Model deine eingespeisten Parameter wirklich „verdaut“. Meine vermeintlich extrem wertvollen Konsumpräferenzdaten hatten dann aber leider nicht genau den Nerv der Zeit, was die aktuellen Modell-Feinabstimmungs-Hotspots betrifft. Die Token, die On-Chain ausgeschüttet wurden, zerbröselten jämmerlich, sodass nicht mal die Breitbandkosten für das Betreiben der Nodes aufgebracht werden konnten. Im Vergleich dazu hat der Typ nebenan einfach irgendein Allerwelts-Open-Source-Korpus in die Gegend gekippt—und bekam trotzdem eine deutlich würdigere Ausschüttung, weil es gerade zufällig in die Hochlastphase passte. Das ist keine faire Aufteilung nach Beitrag, sondern schlicht Glückspiel: Wetten darauf, dass der Modellhunger trifft.
$LAB
Noch schockierender ist, dass dein exklusiver Datensatz, sobald er verpackt und eingereicht wurde, im Mainnet-Index-Repository zwangsweise als Feature-Snapshot zwischengespeichert wird. Ganz offen gesagt: Der ganze „Schatz“, den du immer nur für dich behalten wolltest, liegt dann praktisch halb öffentlich auf dem Tisch—für alle im Netz. Die offiziellen Stellen nehmen Zero-Knowledge-Proofs als Ausrede: Daten gäben sie angeblich nie aus dem Local heraus. Aber wenn man der Einreichungslogik folgt, kann man die Schlussfolgerung nur weiter treiben: Die Metadaten-Features müssen trotzdem hochgeladen werden. Du glaubst, du würdest die Souveränität fest verriegeln—tatsächlich wird die Kerninformation längst still und leise abgezogen.
Ganz objektiv betrachtet: Die Idee, mit Kryptographie den Arbeitslohn mit Fälschungsschutz-Markierungen abzusichern, ist tatsächlich ziemlich „hart“. Auch die Attribution-Mechanik eröffnet den Retail-Leuten zumindest eine Tür, um einen Platz am Tisch zu ergattern. Aber das entscheidende Problem bleibt: Die Preisgestaltungsbefugnis steckt fest in den Händen der Algorithmen und der Big Player. Solange das so bleibt, sind Bottom-Contributors für das Modell immer nur billige Wegwerfverbrauchsmittel, die nach Gutdünken vom Modellhunger „geknackt“ werden. Ich rate meinem Cousin: Lass das Gehirn nicht durchbrennen und stürz dich nicht sofort mit einem großen Wurf hinein. Lauf erst mal ein paar Interaktionen, nimm dir ein bisschen Spielgeld, um die Abläufe zu testen. Warte dann auf echte Mainnet-Call-Daten, damit klar wird, wer am Ende tatsächlich Preisentscheidungen trifft—und dann erst wieder nachlegen. #BTC
#OpenLedger $OPEN @OpenLedger
数据定价权到底归谁说了算
0%
归因标签是馅饼还是陷阱
100%
1 Stimmen • Abstimmung beendet
1
115
·
--
Bullisch
Ich habe es anfangs nicht ernst genommen.
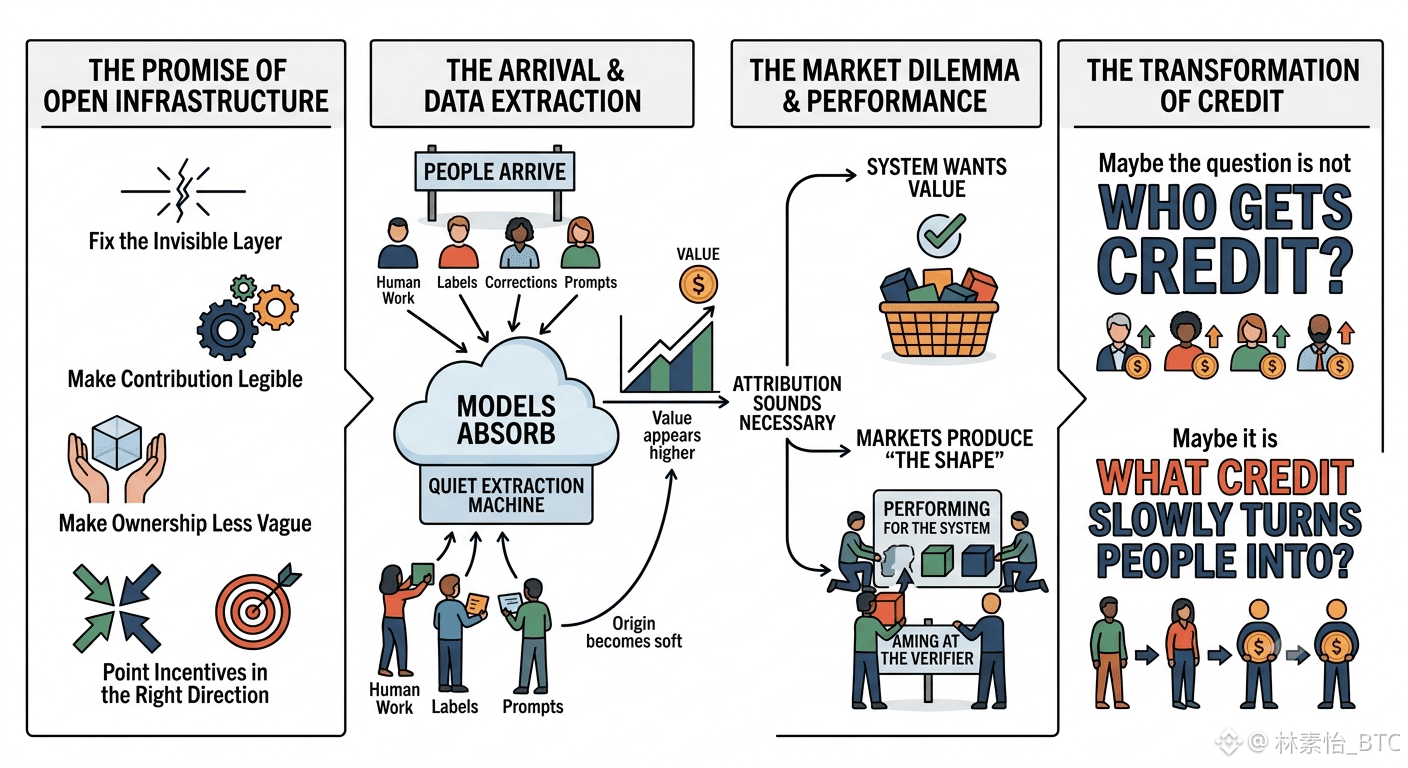
Das ist meistens der Punkt, an dem ich jetzt beginne, nachdem ich genug Infrastruktur-Zyklen gesehen habe, bei denen man dieselbe Zusage mit einem anderen Akzent macht. Die unsichtbare Ebene reparieren. Beiträge lesbar machen. Ownership weniger vage machen. Anreize in die richtige Richtung lenken.
Dann kommen die Leute.
Und Menschen finden immer die Ränder.
OpenLedger ist schwer zu ignorieren, weil sich KI-Daten bereits wie eine stille Entzugsmaschine anfühlen – mit höflicher Sprache darum herum. Menschliche Arbeit taucht als Labels auf, Korrekturen, Prompts, Beispiele, Feedback-Präferenzen, Bewertungen. Kleine Teile, überall verstreut. Dann nehmen Modelle sie auf, der Wert erscheint irgendwo weiter oben, und der Ursprung wird weich genug, um nicht mehr verteidigen zu müssen.
Also klingt Attribution notwendig.
Vielleicht ist das der Grund, warum ich ihr nicht ganz vertraue.
Dann fängt es an, sich unangenehm anzufühlen. Sobald Beiträge finanziell werden, fangen Beiträge an, für das System zu performen. Man richtet sich auf den Verifizierer. Man lernt, was zählt. Man schafft Dinge, die nützlich aussehen – originell genug, menschlich genug. Das System will Wert erkennen, aber Märkte sind sehr gut darin, die Form von Wert ohne Substanz zu erzeugen.
Theoretisch funktioniert es.
Meistens tun die Dinge das.
Das Problem ist nicht wirklich die Technologie. Oder vielleicht wird Technologie zum Problem, sobald Vertrauen in Beweise, Scores, Dashboards, Standards und Liquiditätsrouten komprimiert wird. Offene Systeme re-zentralisieren sich selten laut. Sie verengen sich durch Bequemlichkeit, Voreinstellungen, Schnittstellen – und durch jeden, der unter Druck festlegen darf, was als gültig gilt.
Vielleicht ist das zu hart.
Aber ich komme immer wieder darauf zurück.
Wenn Attribution zur Infrastruktur wird, dann ist die Frage vielleicht nicht, wer Anerkennung bekommt.
Vielleicht ist es das, was Anerkennung langsam mit Menschen macht.
$OPEN @Openledger #openledger
{spot}(OPENUSDT)
Ich habe es anfangs nicht ernst genommen.
Das ist meistens der Punkt, an dem ich jetzt beginne, nachdem ich genug Infrastruktur-Zyklen gesehen habe, bei denen man dieselbe Zusage mit einem anderen Akzent macht. Die unsichtbare Ebene reparieren. Beiträge lesbar machen. Ownership weniger vage machen. Anreize in die richtige Richtung lenken.
Dann kommen die Leute.
Und Menschen finden immer die Ränder.
OpenLedger ist schwer zu ignorieren, weil sich KI-Daten bereits wie eine stille Entzugsmaschine anfühlen – mit höflicher Sprache darum herum. Menschliche Arbeit taucht als Labels auf, Korrekturen, Prompts, Beispiele, Feedback-Präferenzen, Bewertungen. Kleine Teile, überall verstreut. Dann nehmen Modelle sie auf, der Wert erscheint irgendwo weiter oben, und der Ursprung wird weich genug, um nicht mehr verteidigen zu müssen.
Also klingt Attribution notwendig.
Vielleicht ist das der Grund, warum ich ihr nicht ganz vertraue.
Dann fängt es an, sich unangenehm anzufühlen. Sobald Beiträge finanziell werden, fangen Beiträge an, für das System zu performen. Man richtet sich auf den Verifizierer. Man lernt, was zählt. Man schafft Dinge, die nützlich aussehen – originell genug, menschlich genug. Das System will Wert erkennen, aber Märkte sind sehr gut darin, die Form von Wert ohne Substanz zu erzeugen.
Theoretisch funktioniert es.
Meistens tun die Dinge das.
Das Problem ist nicht wirklich die Technologie. Oder vielleicht wird Technologie zum Problem, sobald Vertrauen in Beweise, Scores, Dashboards, Standards und Liquiditätsrouten komprimiert wird. Offene Systeme re-zentralisieren sich selten laut. Sie verengen sich durch Bequemlichkeit, Voreinstellungen, Schnittstellen – und durch jeden, der unter Druck festlegen darf, was als gültig gilt.
Vielleicht ist das zu hart.
Aber ich komme immer wieder darauf zurück.
Wenn Attribution zur Infrastruktur wird, dann ist die Frage vielleicht nicht, wer Anerkennung bekommt.
Vielleicht ist es das, was Anerkennung langsam mit Menschen macht.
$OPEN @OpenLedger #openledger
1
117
·
--
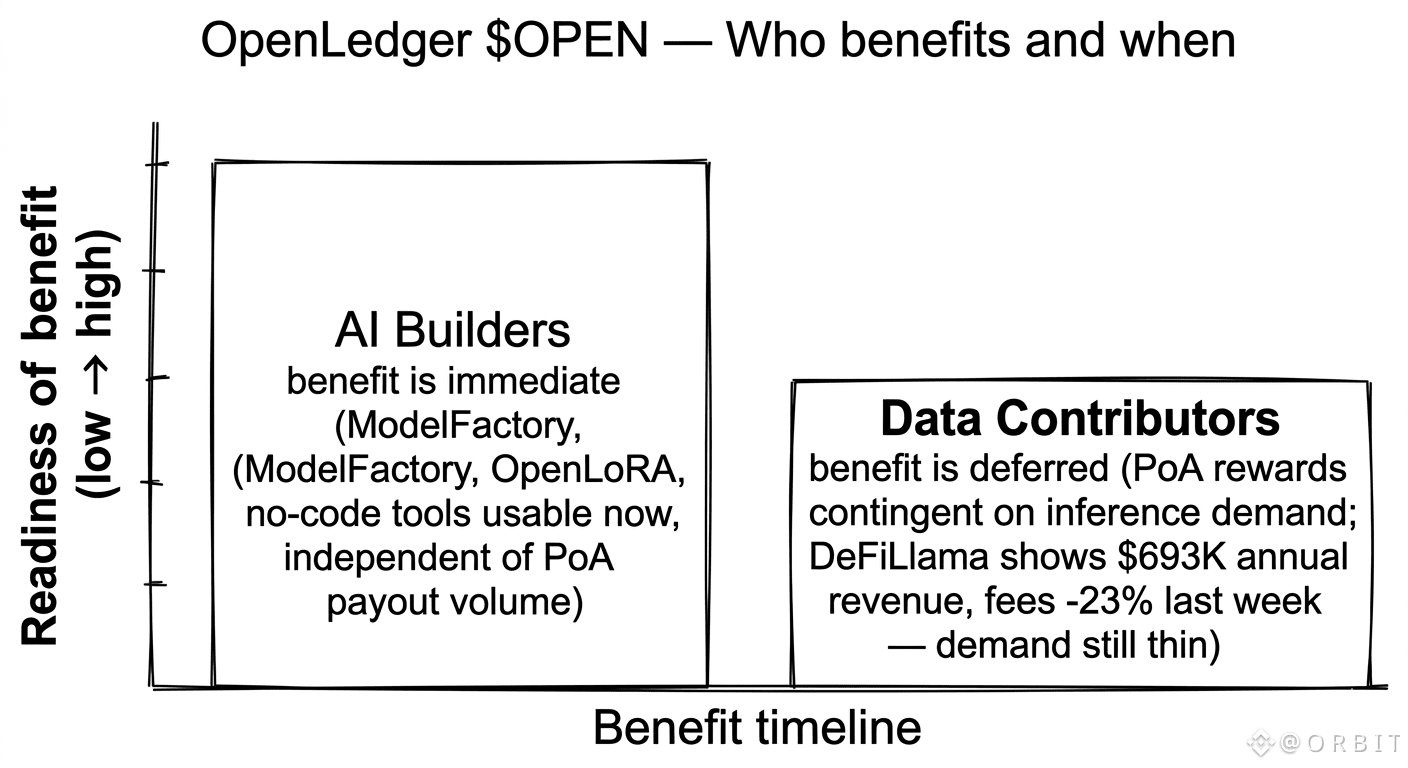
Was mir von der OpenLedger-Aufgabe $OPEN #OpenLedger @Openledger im Gedächtnis geblieben ist: Die beiden Begünstigtengruppen – KI-Entwickler und Datenbeitragende – bewegen sich auf sehr unterschiedlichen Zeitachsen, obwohl der Pitch sie so darstellt, als kämen sie gemeinsam ans Ziel. Entwickler profitieren sofort: ModelFactory funktioniert schon heute, No-Code-Fine-Tuning funktioniert schon heute, und OpenLoRA stellt Modelle ohne großen Infrastrukturaufwand bereit. Dieser Nutzen steht von Anfang an zur Verfügung und hängt nicht davon ab, dass das Proof-of-Attribution-Schwungrad in Gang kommt. Bei den Beitragenden ist das anders. Ihre Belohnungen werden erst dann greifbar, wenn die auf ihren Datanets aufgebauten Modelle in großem Umfang tatsächlich abgefragt werden – doch DeFiLlama weist jährliche Protokolleinnahmen von 693.000 US-Dollar aus, während die Gebühren in der vergangenen Woche um 23 % gesunken sind. Das deutet darauf hin, dass die Nachfrage nach Inferenz noch gering ist. Das Design ist stimmig; der zeitliche Ablauf ist jedoch wichtiger, als es die Darstellung vermuten lässt. Entwickler kommen hinzu, bauen auf der Infrastruktur auf, und die Modelle warten. Die Beitragenden haben bereits Daten hochgeladen, bereits ihren Beitrag geleistet und bereits ihre Attributionsnachweise erhalten … und warten nun auf eine Nachfrage, die noch nicht vollständig da ist. Ob sich diese Lücke schließt, hängt einzig davon ab, ob die Entwickler, die gekommen sind, tatsächlich Produkte auf den Markt bringen, die Menschen nutzen.
Was mir von der OpenLedger-Aufgabe $OPEN #OpenLedger @OpenLedger im Gedächtnis geblieben ist: Die beiden Begünstigtengruppen – KI-Entwickler und Datenbeitragende – bewegen sich auf sehr unterschiedlichen Zeitachsen, obwohl der Pitch sie so darstellt, als kämen sie gemeinsam ans Ziel. Entwickler profitieren sofort: ModelFactory funktioniert schon heute, No-Code-Fine-Tuning funktioniert schon heute, und OpenLoRA stellt Modelle ohne großen Infrastrukturaufwand bereit. Dieser Nutzen steht von Anfang an zur Verfügung und hängt nicht davon ab, dass das Proof-of-Attribution-Schwungrad in Gang kommt. Bei den Beitragenden ist das anders. Ihre Belohnungen werden erst dann greifbar, wenn die auf ihren Datanets aufgebauten Modelle in großem Umfang tatsächlich abgefragt werden – doch DeFiLlama weist jährliche Protokolleinnahmen von 693.000 US-Dollar aus, während die Gebühren in der vergangenen Woche um 23 % gesunken sind. Das deutet darauf hin, dass die Nachfrage nach Inferenz noch gering ist. Das Design ist stimmig; der zeitliche Ablauf ist jedoch wichtiger, als es die Darstellung vermuten lässt. Entwickler kommen hinzu, bauen auf der Infrastruktur auf, und die Modelle warten. Die Beitragenden haben bereits Daten hochgeladen, bereits ihren Beitrag geleistet und bereits ihre Attributionsnachweise erhalten … und warten nun auf eine Nachfrage, die noch nicht vollständig da ist. Ob sich diese Lücke schließt, hängt einzig davon ab, ob die Entwickler, die gekommen sind, tatsächlich Produkte auf den Markt bringen, die Menschen nutzen.
1
340
·
--
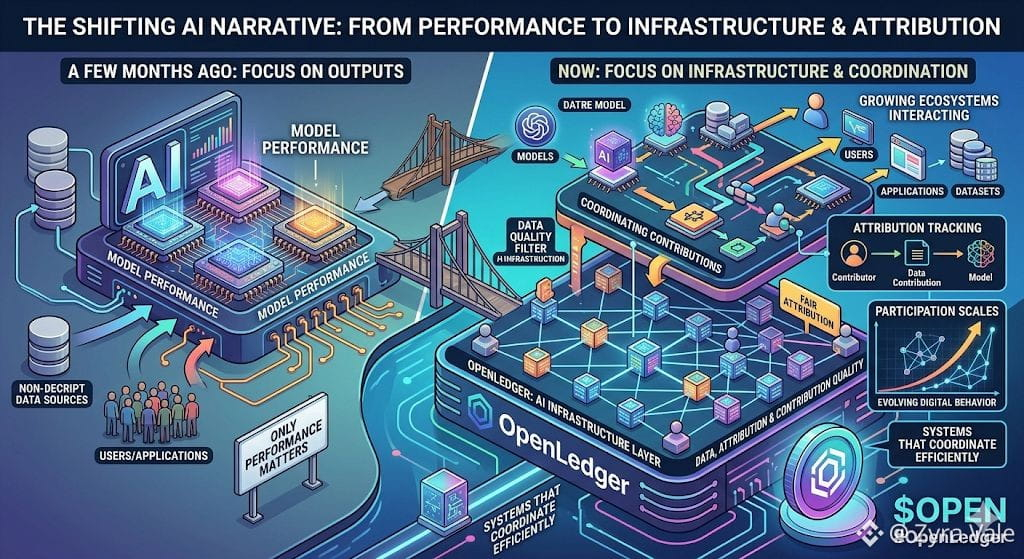
Es fühlt sich so an, als würde sich die KI-Narrative in letzter Zeit langsam verschieben.
Vor ein paar Monaten kümmerten sich die meisten Leute nur um die Modellperformance.
Jetzt bemerke ich mehr Diskussionen über Daten, Attribution und die Qualität der Beiträge.
Das ist zum Teil der Grund, warum mir OpenLedger in letzter Zeit ins Auge gefallen ist.
Das Projekt fühlt sich an, als würde es sich auf eine Schicht der KI-Infrastruktur konzentrieren, die wahrscheinlich wichtiger wird, je mehr Ökosysteme wachsen.
Besonders wenn mehr Nutzer, Anwendungen und Datensätze über Netzwerke interagieren.
Krypto hat bereits gezeigt, wie schnell sich digitales Verhalten entwickelt, sobald die Teilnahme zunimmt.
Also könnten Systeme, die Beiträge und Attribution effizienter koordinieren, später ein ziemlich wichtiger Teil des KI-Ökosystems werden.
Offensichtlich ist es noch früh.
Aber es fühlt sich so an, als würde der Markt allmählich anfangen, mehr Aufmerksamkeit auf die Infrastruktur unterhalb der KI zu richten, anstatt nur auf die Outputs.
Das ist hauptsächlich der Grund, warum ich $OPEN in letzter Zeit beobachtet habe.
#openledger $OPEN @Openledger
Es fühlt sich so an, als würde sich die KI-Narrative in letzter Zeit langsam verschieben.
Vor ein paar Monaten kümmerten sich die meisten Leute nur um die Modellperformance.
Jetzt bemerke ich mehr Diskussionen über Daten, Attribution und die Qualität der Beiträge.
Das ist zum Teil der Grund, warum mir OpenLedger in letzter Zeit ins Auge gefallen ist.
Das Projekt fühlt sich an, als würde es sich auf eine Schicht der KI-Infrastruktur konzentrieren, die wahrscheinlich wichtiger wird, je mehr Ökosysteme wachsen.
Besonders wenn mehr Nutzer, Anwendungen und Datensätze über Netzwerke interagieren.
Krypto hat bereits gezeigt, wie schnell sich digitales Verhalten entwickelt, sobald die Teilnahme zunimmt.
Also könnten Systeme, die Beiträge und Attribution effizienter koordinieren, später ein ziemlich wichtiger Teil des KI-Ökosystems werden.
Offensichtlich ist es noch früh.
Aber es fühlt sich so an, als würde der Markt allmählich anfangen, mehr Aufmerksamkeit auf die Infrastruktur unterhalb der KI zu richten, anstatt nur auf die Outputs.
Das ist hauptsächlich der Grund, warum ich $OPEN in letzter Zeit beobachtet habe.
#openledger $OPEN @OpenLedger
2
183
·
--
Bullisch
Ich schaue mir OpenLedger mit ruhigem Kopf an, weil ich genug Krypto-Zyklen gesehen habe, um zu wissen, dass eine starke Story sehr schnell Aufmerksamkeit erzeugen kann, aber Aufmerksamkeit allein macht ein Projekt nicht automatisch wichtig.
OpenLedger klingt interessant, weil es versucht, ein echtes Problem innerhalb von KI anzugehen. Daten, Modelle, Agents und menschliche Eingaben schaffen überall Mehrwert, aber dieser Wert wird nicht immer klar erfasst. Viele Menschen tragen auf unterschiedliche Weise zu KI-Systemen bei, doch die meisten dieser Beiträge bleiben unsichtbar. OpenLedger will diese Beiträge nützlicher machen, besser nachverfolgbar und besser monetarisierbar.
Diese Idee macht für mich Sinn.
Aber ich komme nicht in Eile, es als Gewinner zu bezeichnen.
Die eigentliche Frage ist nicht, ob OpenLedger gut klingt. Die eigentliche Frage ist, ob Menschen es tatsächlich brauchen.
Bauen Entwickler darauf auf, weil es ein echtes Problem löst?
Bringen Datenbeiträger wertvolle Daten, oder jagen sie nur Belohnungen?
Erzeugen Modelle und Agents echte wirtschaftliche Aktivität, oder wird die meiste Aktivität immer noch von Hype getrieben?
Wird OPEN genutzt, weil das Netzwerk es braucht, oder weil Trader der KI-Story folgen?
Das sind die Fragen, die mich interessieren.
Ich habe bereits DeFi, GameFi, Metaverse-Token, modulare Chains, KI-Coins und viele andere Narrative kommen und gehen sehen. Jeder Zyklus bringt Projekte hervor, die anfangs mächtig klingen. Einige werden zu echter Infrastruktur. Die meisten verblassen, wenn Anreize verschwinden und die Aufmerksamkeit woanders hingeht.
Darum schaue ich mir OpenLedger genau an.
Das Projekt hat Potenzial, weil KI bessere Systeme für Attribution, Datenhoheit, Vertrauen und Koordination brauchen wird. Wenn OpenLedger es schafft, dass Datenbeiträger, Modellbauer und KI-Agents in einer echten Ökonomie zusammenarbeiten können, dann könnte es mehr werden als nur ein weiterer Token.
Doch Potenzial ist kein Beweis.
#OpenLedger @Openledger $OPEN
{future}(OPENUSDT)
Ich schaue mir OpenLedger mit ruhigem Kopf an, weil ich genug Krypto-Zyklen gesehen habe, um zu wissen, dass eine starke Story sehr schnell Aufmerksamkeit erzeugen kann, aber Aufmerksamkeit allein macht ein Projekt nicht automatisch wichtig.
OpenLedger klingt interessant, weil es versucht, ein echtes Problem innerhalb von KI anzugehen. Daten, Modelle, Agents und menschliche Eingaben schaffen überall Mehrwert, aber dieser Wert wird nicht immer klar erfasst. Viele Menschen tragen auf unterschiedliche Weise zu KI-Systemen bei, doch die meisten dieser Beiträge bleiben unsichtbar. OpenLedger will diese Beiträge nützlicher machen, besser nachverfolgbar und besser monetarisierbar.
Diese Idee macht für mich Sinn.
Aber ich komme nicht in Eile, es als Gewinner zu bezeichnen.
Die eigentliche Frage ist nicht, ob OpenLedger gut klingt. Die eigentliche Frage ist, ob Menschen es tatsächlich brauchen.
Bauen Entwickler darauf auf, weil es ein echtes Problem löst?
Bringen Datenbeiträger wertvolle Daten, oder jagen sie nur Belohnungen?
Erzeugen Modelle und Agents echte wirtschaftliche Aktivität, oder wird die meiste Aktivität immer noch von Hype getrieben?
Wird OPEN genutzt, weil das Netzwerk es braucht, oder weil Trader der KI-Story folgen?
Das sind die Fragen, die mich interessieren.
Ich habe bereits DeFi, GameFi, Metaverse-Token, modulare Chains, KI-Coins und viele andere Narrative kommen und gehen sehen. Jeder Zyklus bringt Projekte hervor, die anfangs mächtig klingen. Einige werden zu echter Infrastruktur. Die meisten verblassen, wenn Anreize verschwinden und die Aufmerksamkeit woanders hingeht.
Darum schaue ich mir OpenLedger genau an.
Das Projekt hat Potenzial, weil KI bessere Systeme für Attribution, Datenhoheit, Vertrauen und Koordination brauchen wird. Wenn OpenLedger es schafft, dass Datenbeiträger, Modellbauer und KI-Agents in einer echten Ökonomie zusammenarbeiten können, dann könnte es mehr werden als nur ein weiterer Token.
Doch Potenzial ist kein Beweis.
#OpenLedger @OpenLedger $OPEN
1
134
·
--
Ich arbeite gerade an einem automatisierten Prozess mit mehreren Agenten und je mehr ich darüber nachdenke, desto mehr finde ich die Vision, dass @Openledger "tausende von Agenten automatisch miteinander interagieren und abwickeln", echt sexy klingt. Wenn man es dann aber umsetzt, gibt's ein großes Risiko: die Kaskadierung von Fehlern.
Lass mich dir mein reales Szenario schildern. Ich habe drei Microservices: A, das die On-Chain-Daten abgreift, B, das die Daten in strukturierte Reports aufbereitet, und C, das basierend auf den Reports Entscheidungen trifft. In einem zentralisierten System kann ich jeder Stufe Timeout, Retries und Circuit Breaker hinzufügen. Wenn A ausfällt, kann C sofort reagieren und degradieren, sodass es nicht mit schmutzigen Daten herumläuft. Diese Fehlertoleranz-Mechanismen habe ich lokal lange optimiert, bis sie stabil waren.
Jetzt versuche ich, das Ganze ins dezentrale Netzwerk von OpenLedger zu bringen, und die Schwierigkeiten sind einfach durch die Decke gegangen. Wenn Agent C automatisch von Agent B Reports kauft und B dann automatisch an A die Datengebühr bezahlt, läuft die gesamte Kette vollautomatisch und unbemannt. Und jetzt kommt das Problem: Was passiert, wenn bei A plötzlich der Strom ausfällt, das Internet weg ist oder der Server crasht?
Die schlimmste Situation wäre, dass A nicht komplett ausfällt, sondern ein "normal aussehendes, tatsächlich aber schmutziges Ergebnis" zurückgibt. B würde nichts hinterfragen, sondern alles abnehmen und in einen Report umwandeln. C würde mit diesem Report, der auf schmutzigen Daten basiert, ohne zu zögern eine echte Transaktion auf der Chain ausführen. Wenn du es bemerkst, sind die Verluste bereits entstanden und da alles vollautomatisch abläuft, kann niemand rechtzeitig den Pauseknopf drücken. $LAB
In einem zentralisierten System kann ich jederzeit den Markt überwachen, unterbrechen oder zurückrollen. Aber in einem vollautomatischen, Black-Box-DeFi-Netzwerk kann niemand "chirurgisch" an dieser rasenden Kette arbeiten. Selbst wenn das System später über Smart Contracts A's Einzahlung beschlagnahmt (Slash), um zu kompensieren, ist mein Geschäft bereits durch diesen Kaskadenfehler in eine katastrophale Stilllegung geraten.
Also, objektiv betrachtet, ist der modulare Ansatz der Agenten in OpenLedger richtig und trifft tatsächlich den Trend der Maschinenwirtschaft. Aber "wenn Daten verloren gehen, kann man dafür entschädigt werden" ist weit davon entfernt, genug zu sein. Für ernsthafte kommerzielle Anwendungen ist es entscheidend, dass "die Kette keine Sekunde falsch sein darf". Schau nicht nur auf die coole automatische Abwicklung, sondern analysiere auch das echte Design zur Fehlertoleranz und Kaskadierungsunterbrechung. Sei neutral, schau zu, und DYOR. #BTC
#OpenLedger $OPEN @Openledger
{future}(LABUSDT)
{spot}(OPENUSDT)
Ich arbeite gerade an einem automatisierten Prozess mit mehreren Agenten und je mehr ich darüber nachdenke, desto mehr finde ich die Vision, dass @OpenLedger "tausende von Agenten automatisch miteinander interagieren und abwickeln", echt sexy klingt. Wenn man es dann aber umsetzt, gibt's ein großes Risiko: die Kaskadierung von Fehlern.
Lass mich dir mein reales Szenario schildern. Ich habe drei Microservices: A, das die On-Chain-Daten abgreift, B, das die Daten in strukturierte Reports aufbereitet, und C, das basierend auf den Reports Entscheidungen trifft. In einem zentralisierten System kann ich jeder Stufe Timeout, Retries und Circuit Breaker hinzufügen. Wenn A ausfällt, kann C sofort reagieren und degradieren, sodass es nicht mit schmutzigen Daten herumläuft. Diese Fehlertoleranz-Mechanismen habe ich lokal lange optimiert, bis sie stabil waren.
Jetzt versuche ich, das Ganze ins dezentrale Netzwerk von OpenLedger zu bringen, und die Schwierigkeiten sind einfach durch die Decke gegangen. Wenn Agent C automatisch von Agent B Reports kauft und B dann automatisch an A die Datengebühr bezahlt, läuft die gesamte Kette vollautomatisch und unbemannt. Und jetzt kommt das Problem: Was passiert, wenn bei A plötzlich der Strom ausfällt, das Internet weg ist oder der Server crasht?
Die schlimmste Situation wäre, dass A nicht komplett ausfällt, sondern ein "normal aussehendes, tatsächlich aber schmutziges Ergebnis" zurückgibt. B würde nichts hinterfragen, sondern alles abnehmen und in einen Report umwandeln. C würde mit diesem Report, der auf schmutzigen Daten basiert, ohne zu zögern eine echte Transaktion auf der Chain ausführen. Wenn du es bemerkst, sind die Verluste bereits entstanden und da alles vollautomatisch abläuft, kann niemand rechtzeitig den Pauseknopf drücken. $LAB
In einem zentralisierten System kann ich jederzeit den Markt überwachen, unterbrechen oder zurückrollen. Aber in einem vollautomatischen, Black-Box-DeFi-Netzwerk kann niemand "chirurgisch" an dieser rasenden Kette arbeiten. Selbst wenn das System später über Smart Contracts A's Einzahlung beschlagnahmt (Slash), um zu kompensieren, ist mein Geschäft bereits durch diesen Kaskadenfehler in eine katastrophale Stilllegung geraten.
Also, objektiv betrachtet, ist der modulare Ansatz der Agenten in OpenLedger richtig und trifft tatsächlich den Trend der Maschinenwirtschaft. Aber "wenn Daten verloren gehen, kann man dafür entschädigt werden" ist weit davon entfernt, genug zu sein. Für ernsthafte kommerzielle Anwendungen ist es entscheidend, dass "die Kette keine Sekunde falsch sein darf". Schau nicht nur auf die coole automatische Abwicklung, sondern analysiere auch das echte Design zur Fehlertoleranz und Kaskadierungsunterbrechung. Sei neutral, schau zu, und DYOR. #BTC
#OpenLedger $OPEN @OpenLedger
自动调用链断了怎么办
50%
Agent 协作扛得住故障吗
50%
2 Stimmen • Abstimmung beendet
2
1
452
·
--
Das Value-Flywheel von OpenLedgerBei der Bewertung der langfristigen Tragfähigkeit eines Decentralized Physical Infrastructure Network (DePIN) muss das Tokenomics-Modell robust genug sein, um Beiträge für physische Hardware dauerhaft zu ermöglichen. Ein Projekt kann sich nicht allein auf Hype verlassen; es benötigt eine sich selbst tragende Feedback-Schleife. Genau deshalb weckt der wirtschaftliche Bauplan von @Openledger derzeit erhebliches Entwicklerinteresse.
Die Beziehung zwischen dem Netzwerk und seinem nativen Asset, dem $OPEN token, basiert auf harter Nutzbarkeit. Während dezentrale Anwendungen und Unternehmen das Netzwerk für die sichere Datenspeicherung und verifizierbare Rechenleistung nutzen, verwenden sie aktiv $OPEN to, um Transaktionskosten zu begleichen und die betriebliche Bandbreite abzusichern. Diese kontinuierliche Nachfrage belohnt die Node-Anbieter, die die Infrastruktur sicher halten, und bildet so eine gesunde Wachstumsschleife. Da die weltweite Datenerzeugung weiterhin exponentiell wächst, etabliert die Schaffung eines dezentralen Marktes zur Verarbeitung dieser Daten dieses Protokoll an der absoluten Spitze der Web3-Innovation. #OpenLedger
Das Value-Flywheel von OpenLedger
Bei der Bewertung der langfristigen Tragfähigkeit eines Decentralized Physical Infrastructure Network (DePIN) muss das Tokenomics-Modell robust genug sein, um Beiträge für physische Hardware dauerhaft zu ermöglichen. Ein Projekt kann sich nicht allein auf Hype verlassen; es benötigt eine sich selbst tragende Feedback-Schleife. Genau deshalb weckt der wirtschaftliche Bauplan von @OpenLedger derzeit erhebliches Entwicklerinteresse.
Die Beziehung zwischen dem Netzwerk und seinem nativen Asset, dem $OPEN token, basiert auf harter Nutzbarkeit. Während dezentrale Anwendungen und Unternehmen das Netzwerk für die sichere Datenspeicherung und verifizierbare Rechenleistung nutzen, verwenden sie aktiv $OPEN to, um Transaktionskosten zu begleichen und die betriebliche Bandbreite abzusichern. Diese kontinuierliche Nachfrage belohnt die Node-Anbieter, die die Infrastruktur sicher halten, und bildet so eine gesunde Wachstumsschleife. Da die weltweite Datenerzeugung weiterhin exponentiell wächst, etabliert die Schaffung eines dezentralen Marktes zur Verarbeitung dieser Daten dieses Protokoll an der absoluten Spitze der Web3-Innovation. #OpenLedger
Die Beziehung zwischen dem Netzwerk und seinem nativen Asset, dem $OPEN token, basiert auf harter Nutzbarkeit. Während dezentrale Anwendungen und Unternehmen das Netzwerk für die sichere Datenspeicherung und verifizierbare Rechenleistung nutzen, verwenden sie aktiv $OPEN to, um Transaktionskosten zu begleichen und die betriebliche Bandbreite abzusichern. Diese kontinuierliche Nachfrage belohnt die Node-Anbieter, die die Infrastruktur sicher halten, und bildet so eine gesunde Wachstumsschleife. Da die weltweite Datenerzeugung weiterhin exponentiell wächst, etabliert die Schaffung eines dezentralen Marktes zur Verarbeitung dieser Daten dieses Protokoll an der absoluten Spitze der Web3-Innovation. #OpenLedger
1
85
·
--
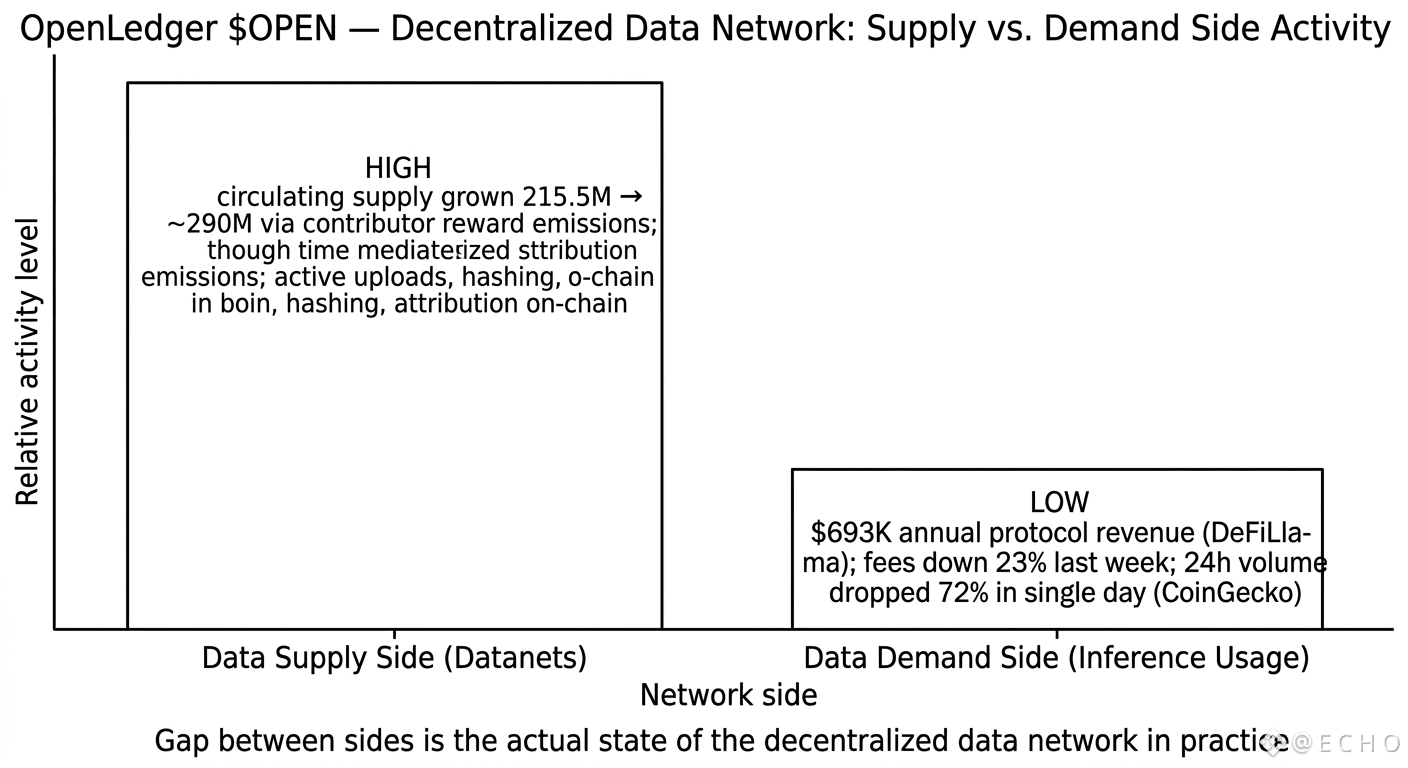
Was mich während der OpenLedger $OPEN #OpenLedger @Openledger Aufgabe gefangen hat, war nicht die Infrastruktur – die ist wirklich interessant – sondern zu erkennen, welcher Teil des Datennetzwerks tatsächlich läuft. Datanets wachsen. Contributor laden hoch, taggen, hashen. Die Angebotsseite der dezentralen Datenstory ist aktiv und wird durch Token-Emissionen belohnt – das zirkulierende Angebot hat sich seit dem TGE von 215,5M auf ungefähr 290M OPEN laut CoinMarketCap erhöht. Dieses Wachstum ist echt und zeigt, dass die Leute aktiv werden.
Die Nachfrageseite sieht anders aus. DeFiLlama schätzt die jährlichen Protokoll-Einnahmen auf 693K $, wobei die Gebühren in der letzten Woche um 23% gesunken sind. Und CoinGecko zeigt, dass das Handelsvolumen in den letzten 24 Stunden an einem einzigen Tag um 72% gefallen ist, was selbst nach Krypto-Standards volatil ist. Die Datanets existieren, die Daten sind dort attribuiert und gehasht, aber die Nachfrage nach Inferenz, die eigentlich fließen und die Contributor proportional entschädigen sollte… ist noch nicht im großen Maßstab angekommen.
Ich habe immer wieder an die frühen Jahre des Ocean Protocol gedacht. Das gleiche Problem – reich an Angebotsinfrastruktur, wartend auf Nachfrage. Die Frage, die OpenLedger noch nicht beantwortet hat, ist nicht, ob dezentrale Datennetzwerke wichtig sind. Es ist, was tatsächlich die Builder dazu bringt, diese spezifischen Datanets über billigere, schnellere, zentralisierte Alternativen abzufragen.
Was mich während der OpenLedger $OPEN #OpenLedger @OpenLedger Aufgabe gefangen hat, war nicht die Infrastruktur – die ist wirklich interessant – sondern zu erkennen, welcher Teil des Datennetzwerks tatsächlich läuft. Datanets wachsen. Contributor laden hoch, taggen, hashen. Die Angebotsseite der dezentralen Datenstory ist aktiv und wird durch Token-Emissionen belohnt – das zirkulierende Angebot hat sich seit dem TGE von 215,5M auf ungefähr 290M OPEN laut CoinMarketCap erhöht. Dieses Wachstum ist echt und zeigt, dass die Leute aktiv werden.
Die Nachfrageseite sieht anders aus. DeFiLlama schätzt die jährlichen Protokoll-Einnahmen auf 693K $, wobei die Gebühren in der letzten Woche um 23% gesunken sind. Und CoinGecko zeigt, dass das Handelsvolumen in den letzten 24 Stunden an einem einzigen Tag um 72% gefallen ist, was selbst nach Krypto-Standards volatil ist. Die Datanets existieren, die Daten sind dort attribuiert und gehasht, aber die Nachfrage nach Inferenz, die eigentlich fließen und die Contributor proportional entschädigen sollte… ist noch nicht im großen Maßstab angekommen.
Ich habe immer wieder an die frühen Jahre des Ocean Protocol gedacht. Das gleiche Problem – reich an Angebotsinfrastruktur, wartend auf Nachfrage. Die Frage, die OpenLedger noch nicht beantwortet hat, ist nicht, ob dezentrale Datennetzwerke wichtig sind. Es ist, was tatsächlich die Builder dazu bringt, diese spezifischen Datanets über billigere, schnellere, zentralisierte Alternativen abzufragen.
1
415
·
--
#openledger $OPEN Open data und dezentralisierte KI können neue Möglichkeiten für die gesamte Blockchain-Branche eröffnen. @OpenLedger baut Infrastruktur, die dabei hilft, Datenanbieter und KI-Anwendungen miteinander zu verbinden und echten Nutzen für das Ökosystem zu schaffen. Ich freue mich auf die Zukunft von $OPEN. #OpenLedger
#openledger $OPEN Open data und dezentralisierte KI können neue Möglichkeiten für die gesamte Blockchain-Branche eröffnen. @OpenLedger baut Infrastruktur, die dabei hilft, Datenanbieter und KI-Anwendungen miteinander zu verbinden und echten Nutzen für das Ökosystem zu schaffen. Ich freue mich auf die Zukunft von $OPEN . #OpenLedger
61
·
--
@Openledger Wachstum, das mich am meisten „packt“, ist nicht, wie stark es die aktiven Wallets nach oben treibt, sondern dass sein Wachstum überhaupt nicht „gleichmäßig“ ist.$LAB
Ich habe diese Woche die Abrufdaten verschiedener Datanet einmal komplett durchgespult – die Unterschiede sind so krass, dass man es kaum glauben kann. Bei den Finanzdaten und den On-Chain-Daten liegen die Abrufhäufigkeiten meilenweit vor allen anderen Richtungen, während viele Bereiche so kühl und verlassen sind, als wäre dort ein Geisterstadt-Szenario: Es hängt einfach da, und niemand kümmert sich.#BTC
Zuerst dachte ich, das sei ein Problem. Dann merkte ich: Nein – gerade diese extreme Ungleichverteilung ist das eigentliche gesunde Signal. Der Markt stimmt mit echtem, hartem Geld ab: Wer Daten hat, nach denen gesucht wird, zieht Beitragende an wie ein Magnet. Das ist kein Scheinboom, der von den Projektverantwortlichen mit Ressourcen „erzwungen“ wird, sondern das Ergebnis einer natürlichen Selektion. Hart, aber wahr.
Proof of Attribution: Diese Logik der Ausschüttung zieht die Aufmerksamkeit der Beitragenden zwangsweise von „Datenmüll/„Scraping der Masse“ hin zu „wirklich Nützlichem“ – und zwar durch blanken ökonomischen Anreiz, nicht durch Community-Parolen. Wenn du eine ganze Ladung Mülldaten wirfst, werden die @Openledger -Belohnungen, die du bekommst, im Grunde bei null liegen; wenn deine Daten häufig abgerufen werden, fließt die Belohnung kontinuierlich. Die Effizienz beider Mechanismen unterscheidet sich so stark, dass die meisten Projekte es bis heute nicht verstanden haben.
Aber das, was mich jetzt am meisten beunruhigt, ist genau der „Stachel“ Datenqualität.
Ich habe noch keine wirklich wirksame Lösung für das Problem, dass Datanet in Qualität stark schwanken. Wenn sich minderwertige Daten dazwischenmischen, wird das langsam aber sicher den Ruf der gesamten Plattform aufreiben. Wenn Abrufer ein paar Mal hintereinander auf diese Art von Problemen stoßen, ziehen sie beim nächsten Mal sehr wahrscheinlich einfach weiter – und kommen nicht wieder. Das ist meine größte Sorge: nicht der kurzfristige Kurs, sondern ob die durchschnittliche Datenqualität beim gleichzeitigen Ausbau der Größe überhaupt standhält.
Und dann steckt hier noch eine tödliche Spirale: Je spezieller/unerforschter ein Datanet ist, desto weniger wird es abgerufen. Je weniger es abgerufen wird, desto weniger ist jemand bereit, hochwertige Daten beizusteuern. Am Ende bleibt nur ein Haufen Müll zurück, der dort verrottet. Die beliebten Richtungen fressen die ganze Aufmerksamkeit auf, während die Long-Tail-Richtungen direkt verhungern.
$OPEN Das, was man eigentlich will, ist ein Daten-freier Markt – aber ein freier Markt polarisiert von Natur aus.
In den nächsten sechs Monaten wird die echte Ausfallquote der Datanet mehr aussagen als jede Zahl aktiver Wallets. Ob es gelingt, ein Gleichgewicht zwischen „natürlicher Selektion“ und „Long-Tail-Verwelkung“ zu finden, ist die Hürde, an der es nicht vorbeikommt.
#OpenLedger
{alpha}(560x7ec43cf65f1663f820427c62a5780b8f2e25593a)
{spot}(OPENUSDT)
@OpenLedger Wachstum, das mich am meisten „packt“, ist nicht, wie stark es die aktiven Wallets nach oben treibt, sondern dass sein Wachstum überhaupt nicht „gleichmäßig“ ist.$LAB
Ich habe diese Woche die Abrufdaten verschiedener Datanet einmal komplett durchgespult – die Unterschiede sind so krass, dass man es kaum glauben kann. Bei den Finanzdaten und den On-Chain-Daten liegen die Abrufhäufigkeiten meilenweit vor allen anderen Richtungen, während viele Bereiche so kühl und verlassen sind, als wäre dort ein Geisterstadt-Szenario: Es hängt einfach da, und niemand kümmert sich.#BTC
Zuerst dachte ich, das sei ein Problem. Dann merkte ich: Nein – gerade diese extreme Ungleichverteilung ist das eigentliche gesunde Signal. Der Markt stimmt mit echtem, hartem Geld ab: Wer Daten hat, nach denen gesucht wird, zieht Beitragende an wie ein Magnet. Das ist kein Scheinboom, der von den Projektverantwortlichen mit Ressourcen „erzwungen“ wird, sondern das Ergebnis einer natürlichen Selektion. Hart, aber wahr.
Proof of Attribution: Diese Logik der Ausschüttung zieht die Aufmerksamkeit der Beitragenden zwangsweise von „Datenmüll/„Scraping der Masse“ hin zu „wirklich Nützlichem“ – und zwar durch blanken ökonomischen Anreiz, nicht durch Community-Parolen. Wenn du eine ganze Ladung Mülldaten wirfst, werden die @OpenLedger -Belohnungen, die du bekommst, im Grunde bei null liegen; wenn deine Daten häufig abgerufen werden, fließt die Belohnung kontinuierlich. Die Effizienz beider Mechanismen unterscheidet sich so stark, dass die meisten Projekte es bis heute nicht verstanden haben.
Aber das, was mich jetzt am meisten beunruhigt, ist genau der „Stachel“ Datenqualität.
Ich habe noch keine wirklich wirksame Lösung für das Problem, dass Datanet in Qualität stark schwanken. Wenn sich minderwertige Daten dazwischenmischen, wird das langsam aber sicher den Ruf der gesamten Plattform aufreiben. Wenn Abrufer ein paar Mal hintereinander auf diese Art von Problemen stoßen, ziehen sie beim nächsten Mal sehr wahrscheinlich einfach weiter – und kommen nicht wieder. Das ist meine größte Sorge: nicht der kurzfristige Kurs, sondern ob die durchschnittliche Datenqualität beim gleichzeitigen Ausbau der Größe überhaupt standhält.
Und dann steckt hier noch eine tödliche Spirale: Je spezieller/unerforschter ein Datanet ist, desto weniger wird es abgerufen. Je weniger es abgerufen wird, desto weniger ist jemand bereit, hochwertige Daten beizusteuern. Am Ende bleibt nur ein Haufen Müll zurück, der dort verrottet. Die beliebten Richtungen fressen die ganze Aufmerksamkeit auf, während die Long-Tail-Richtungen direkt verhungern.
$OPEN Das, was man eigentlich will, ist ein Daten-freier Markt – aber ein freier Markt polarisiert von Natur aus.
In den nächsten sechs Monaten wird die echte Ausfallquote der Datanet mehr aussagen als jede Zahl aktiver Wallets. Ob es gelingt, ein Gleichgewicht zwischen „natürlicher Selektion“ und „Long-Tail-Verwelkung“ zu finden, ist die Hürde, an der es nicht vorbeikommt.
#OpenLedger
不均衡到底是好是坏
50%
数据质量这关怎么过
0%
冷门方向会被饿死吗
0%
我也想上传数据试试
50%
2 Stimmen • Abstimmung beendet
2
1
229
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
1
#BinancePick
3.2M Aufrufe
158,946 Kommentare
2
#EarningsSeason
5.4M Aufrufe
26,344 Kommentare
3
#BitmineAdds10452ETH
862 Aufrufe
34 Kommentare
4
#SouthKoreaConsidersEducationTaxOnCryptoExchanges
1,193 Aufrufe
54 Kommentare
5
#OCCUrgesCommunityBanksToEnterStablecoinPayments
661 Aufrufe
36 Kommentare
6
#RippleWinsFullApprovalAsNationalTrustBank
696 Aufrufe
34 Kommentare
7
#AkashSelectsSolanaAsMigrationTarget
428 Aufrufe
8 Kommentare
8
#OndoToOpenSubscriptionsForOpenAIPreIPOTokenizedNotes
40 Aufrufe
3 Kommentare
9
#AnthropicTTMRevenueGrewAbout1200%
45,350 Aufrufe
517 Kommentare
10
#AnthropicS1ExpectedToday
36,926 Aufrufe
406 Kommentare