

Ich habe es anfangs nicht ernst genommen.
nicht weil OpenLedger sich leer angehört hat. eher weil ich genug Zyklen der Krypto-Infrastruktur gesehen habe, um zu wissen, wie schnell ernsthafte Ideen zu Erzählungen plattgedrückt werden. einen Monat geht es um Koordination. dann um Besitz. dann um Verifizierung. dann „öffnet“ man alles. und für eine Weile fühlt sich die Sprache sauber genug an, um es zu glauben.
dann trifft das System auf Anreize.
und Anreize sind nie sauber.
Vielleicht ist das zu hart. vielleicht bin ich einfach nur müde davon, dabei zuzusehen, wie Protokolle nach und nach weniger mit ihrem ursprünglichen Problem zu tun haben und mehr mit den Märkten, die sich um sie herum gebildet haben. aber diese Müdigkeit lässt sich nur schwer ausschalten, besonders bei allem, was zwischen KI, Daten, Besitz und wirtschaftlichen Belohnungen sitzt.
weil das hier nicht nur abstrakt ist.
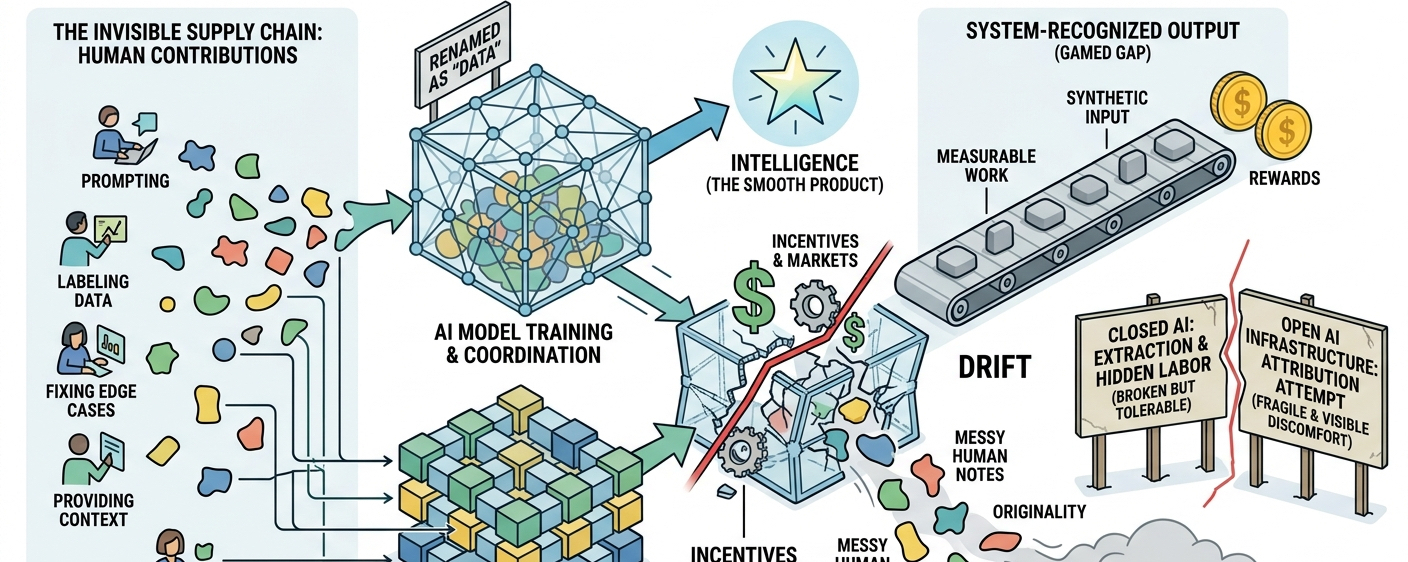
KI-Systeme werden bereits aus menschlichen Spuren gebaut: Prompts, Korrekturen, Labels, Beispiele, Feedback, Präferenzsignale, Domänenwissen, kleine Stücke Urteilsvermögen. Das meiste davon wirkt fast unsichtbar, während es passiert. Jemand behebt einen Edge Case. Jemand labelt etwas sorgfältiger. Jemand liefert Kontext, den das Modell allein nie verstanden hätte.
Dann wird das Modell besser.
Dann nennt es am Ende jeder Intelligenz.
und der menschliche Teil wird umbenannt in Daten.
Ich komme immer wieder zur Zuordnung zurück.
Da ist etwas Notwendiges—selbst wenn ich nicht ganz darauf vertraue, wohin es führt. Wenn Intelligenz eine Lieferkette hat, sollte diese Lieferkette vielleicht nicht in geschlossenen Systemen verborgen bleiben. Vielleicht sollten Beiträge nicht in dem Moment verschwinden, in dem ihr Input wirtschaftlich nützlich wird. Vielleicht ist ein System wie OpenLedger wichtig, weil es versucht, dieses Verschwinden schwerer zu machen.
nicht perfekt.
nicht sauber.
Aber genug, um die Unbehaglichkeit sichtbar zu machen.
Genau da beginnt meine Neugier. Dann kommt fast sofort die alte Skepsis zurück.
weil sich die Zuordnung ändert, sobald sie finanziell wird. bevor das Geld reinkommt, klingt es fair. Merke dir, wer geholfen hat. Verfolge, was wichtig war. Belohne nützliche Beiträge. Mach die Koordination des Modells weniger undurchsichtig.
nachdem das Geld reinkommt, studieren die Leute die Gedächtnisschicht.
Sie lernen, was gezählt wird. Sie lernen den Verifizierer. Sie produzieren in Richtung des Punktesystems. Nützliche Arbeit und messbare Arbeit beginnen sich still voneinander zu trennen—zuerst langsam, dann schneller, sobald die Belohnungen groß genug sind, um das Ausspielen der Lücke zu rechtfertigen.
Es funktioniert im Prinzip. Die meisten Dinge tun das.
Das Problem ist nicht wirklich die Technologie… oder nicht nur die Technologie. Das Problem ist, dass menschliche Beiträge an den Rändern weich sind. Kontext ist weich. Originalität ist weich. Nützlichkeit kann spät ankommen—nachdem sich das Modell geändert hat, nachdem andere Inputs es umgeben, nachdem niemand mehr weiß, welche kleine Korrektur tatsächlich den Unterschied gemacht hat.
Eine chaotische Notiz eines Menschen könnte wertvoller sein als ein polierter Datensatz.
Synthetischer Input könnte sauberer wirken als echte Beurteilung.
Kopierte Arbeit könnte sich besser in das Zuordnungssystem einfügen als das originale Ding, das sie kopiert hat.
Also wer wird erinnert?
Die Person, die geholfen hat—oder die Person, die das System erkennen könnte?
Dieser Teil lässt mich mehr beunruhigen, als er sollte.
Und dann gibt es diese alte Web3-Trägheit. Offene Systeme zentralisieren sich selten mit einer dramatischen Ankündigung neu. Sie verengen sich durch Bequemlichkeit. Durch Erschöpfung. Durch Dashboards, Indizes, Qualitätsbewertungen, durch Streit über Schichten seitens der Betreiber—und durch all die unsichtbare Infrastruktur, die niemand für immer auditieren will.
KI-Infrastruktur wirkt dort besonders fragil, weil die unsichtbaren Schichten die eigentlichen Schichten sind: Logik der Zuordnung, Bewertung von Beiträgen, Filterung, Koordination des Modells. Diese Schichten entscheiden, was zählt. Und wenn sie entschieden haben, was zählt, entscheiden sie, wer wirtschaftlich existiert.
Trotzdem kann ich OpenLedger nicht einfach abtun.
Zentralisierte KI hat sich diese Art von Komfort auch nicht verdient. Geschlossene Datensätze, unklare Besitzverhältnisse, unsichtbare Arbeit, Extraktion hinter glatten Produkten versteckt. Diese Version fühlt sich schon kaputt an—nur leichter zu ertragen, weil die Maschinerie privat bleibt.
Vielleicht macht OpenLedger die Maschinerie schwerer, zu verstecken.
Vielleicht ist das entscheidend.
oder vielleicht erinnert das System, das gebaut wurde, um menschliche Beiträge zu speichern, sobald Anreize scharf genug werden, nur noch an die Teile, die sich ordentlich in seine Buchführung einfügen, während der Rest in das Modell zurückrutscht—nützlich und ohne Namen.

