
MR-Zero-X
2.2k منشورات
MR-Zero-X
إبلاغ
حظر المُستخدم
高风险,高回报|精准分析|用数据说话. High risk, high reward | Precise analysis | Let data speak
260 تتابع
11.9K+ المتابعون
1.7K+ إعجاب
منشورات
الحافظة الاستثمارية
الكل
اقتباسات
Live
·
--
#dusk $DUSK
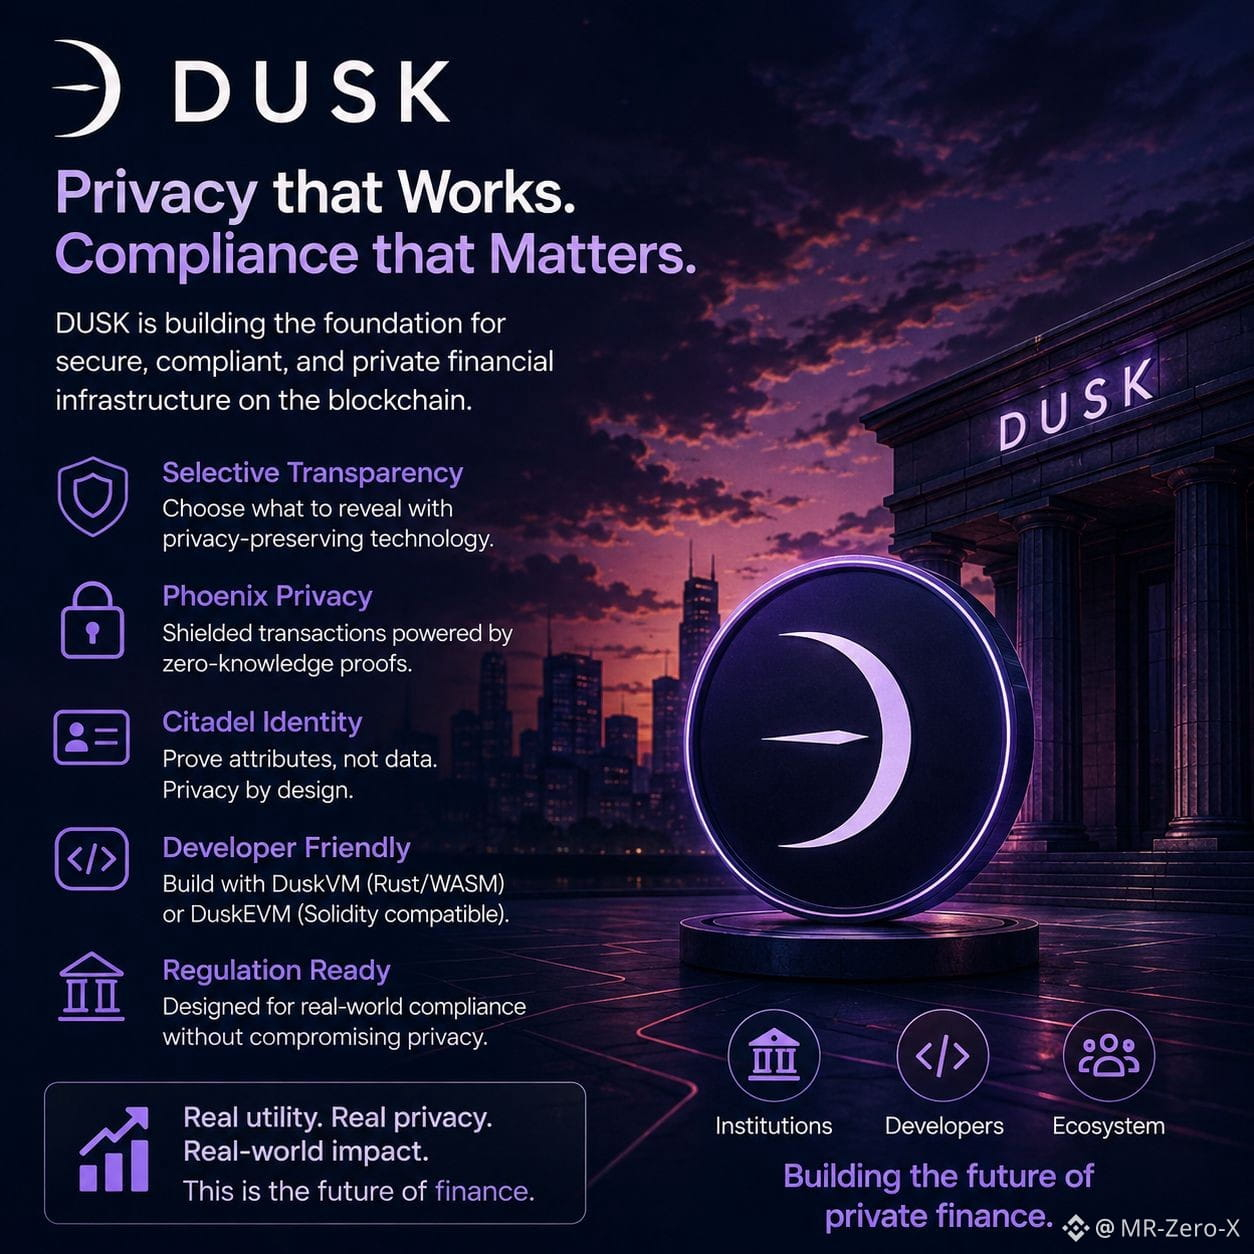
ما لفت انتباهي في DUSK لم يكن كونها سلسلة بلوكشين أخرى تدّعي حل الخصوصية.
بل كان سؤالًا أبسط بكثير: من الذي يحتاج فعلًا إلى رؤية ماذا؟
كلما استكشفت DUSK أكثر، زادت إعجابي بهذا النوع من التفكير.
بدلًا من التعامل مع الخصوصية بوصفها “إخفاء كل شيء”، تفصل DUSK بين أنواع مختلفة من “الوضوح/إمكانية الرؤية”. نموذج Moonlight يتعامل مع المعاملات الشفافة، بينما تستخدم Phoenix إثباتات المعرفة الصفرية للحفاظ على تفاصيل المعاملات الحساسة خاصةً مع الاستمرار في إثبات صحتها.
هذا التمييز يبدو مهمًا بالنسبة لي.
الأسواق المالية ليست عامة بالكامل ولا خاصة بالكامل. قد تحتاج المؤسسات إلى السرية بشأن معلومات معيّنة، بينما يحتاج المنظمون أو المشاركون المصرّح لهم إلى أدلة موثوقة ما يزال.
وهنا أصبحت مقاربة DUSK أكثر إثارة للاهتمام بالنسبة لي.
كما اطلعت أيضًا على طبقة الهوية الخاصة بها، Citadel. ما لفت انتباهي هو فكرة إثبات سمات محددة دون تعريض المعلومات الأساسية دون داعٍ. بالنسبة لي، هذا أقرب بكثير إلى كيفية عمل الخصوصية في الأنظمة المالية الواقعية.
ثم يوجد جانب المطورين.
تدعم DUSK DuskVM لتطبيقات Rust/WASM، كما توفر توافق DuskEVM للمطورين الذين يعرفون Solidity وVyper وأدوات EVM.
لست آخذ أيًا من هذا كضمان للنجاح.
ما أراقبه الآن هو شيء أكثر عملية: هل يمكن للمطورين فعلًا بناء تطبيقات مالية مفيدة اعتمادًا على مبادئ الخصوصية والامتثال هذه؟
هذه هي الجزئية من DUSK الأكثر فضولًا بالنسبة لي لمشاهدتها وهي تتكشف.
@Dusk_Foundation #DUSK $DUSK
#dusk $DUSK
ما لفت انتباهي في DUSK لم يكن كونها سلسلة بلوكشين أخرى تدّعي حل الخصوصية.
بل كان سؤالًا أبسط بكثير: من الذي يحتاج فعلًا إلى رؤية ماذا؟
كلما استكشفت DUSK أكثر، زادت إعجابي بهذا النوع من التفكير.
بدلًا من التعامل مع الخصوصية بوصفها “إخفاء كل شيء”، تفصل DUSK بين أنواع مختلفة من “الوضوح/إمكانية الرؤية”. نموذج Moonlight يتعامل مع المعاملات الشفافة، بينما تستخدم Phoenix إثباتات المعرفة الصفرية للحفاظ على تفاصيل المعاملات الحساسة خاصةً مع الاستمرار في إثبات صحتها.
هذا التمييز يبدو مهمًا بالنسبة لي.
الأسواق المالية ليست عامة بالكامل ولا خاصة بالكامل. قد تحتاج المؤسسات إلى السرية بشأن معلومات معيّنة، بينما يحتاج المنظمون أو المشاركون المصرّح لهم إلى أدلة موثوقة ما يزال.
وهنا أصبحت مقاربة DUSK أكثر إثارة للاهتمام بالنسبة لي.
كما اطلعت أيضًا على طبقة الهوية الخاصة بها، Citadel. ما لفت انتباهي هو فكرة إثبات سمات محددة دون تعريض المعلومات الأساسية دون داعٍ. بالنسبة لي، هذا أقرب بكثير إلى كيفية عمل الخصوصية في الأنظمة المالية الواقعية.
ثم يوجد جانب المطورين.
تدعم DUSK DuskVM لتطبيقات Rust/WASM، كما توفر توافق DuskEVM للمطورين الذين يعرفون Solidity وVyper وأدوات EVM.
لست آخذ أيًا من هذا كضمان للنجاح.
ما أراقبه الآن هو شيء أكثر عملية: هل يمكن للمطورين فعلًا بناء تطبيقات مالية مفيدة اعتمادًا على مبادئ الخصوصية والامتثال هذه؟
هذه هي الجزئية من DUSK الأكثر فضولًا بالنسبة لي لمشاهدتها وهي تتكشف.
@Dusk #DUSK $DUSK
ما لفت انتباهي في DUSK لم يكن كونها سلسلة بلوكشين أخرى تدّعي حل الخصوصية.
بل كان سؤالًا أبسط بكثير: من الذي يحتاج فعلًا إلى رؤية ماذا؟
كلما استكشفت DUSK أكثر، زادت إعجابي بهذا النوع من التفكير.
بدلًا من التعامل مع الخصوصية بوصفها “إخفاء كل شيء”، تفصل DUSK بين أنواع مختلفة من “الوضوح/إمكانية الرؤية”. نموذج Moonlight يتعامل مع المعاملات الشفافة، بينما تستخدم Phoenix إثباتات المعرفة الصفرية للحفاظ على تفاصيل المعاملات الحساسة خاصةً مع الاستمرار في إثبات صحتها.
هذا التمييز يبدو مهمًا بالنسبة لي.
الأسواق المالية ليست عامة بالكامل ولا خاصة بالكامل. قد تحتاج المؤسسات إلى السرية بشأن معلومات معيّنة، بينما يحتاج المنظمون أو المشاركون المصرّح لهم إلى أدلة موثوقة ما يزال.
وهنا أصبحت مقاربة DUSK أكثر إثارة للاهتمام بالنسبة لي.
كما اطلعت أيضًا على طبقة الهوية الخاصة بها، Citadel. ما لفت انتباهي هو فكرة إثبات سمات محددة دون تعريض المعلومات الأساسية دون داعٍ. بالنسبة لي، هذا أقرب بكثير إلى كيفية عمل الخصوصية في الأنظمة المالية الواقعية.
ثم يوجد جانب المطورين.
تدعم DUSK DuskVM لتطبيقات Rust/WASM، كما توفر توافق DuskEVM للمطورين الذين يعرفون Solidity وVyper وأدوات EVM.
لست آخذ أيًا من هذا كضمان للنجاح.
ما أراقبه الآن هو شيء أكثر عملية: هل يمكن للمطورين فعلًا بناء تطبيقات مالية مفيدة اعتمادًا على مبادئ الخصوصية والامتثال هذه؟
هذه هي الجزئية من DUSK الأكثر فضولًا بالنسبة لي لمشاهدتها وهي تتكشف.
@Dusk #DUSK $DUSK
1
1
273
·
--
#dusk $DUSK
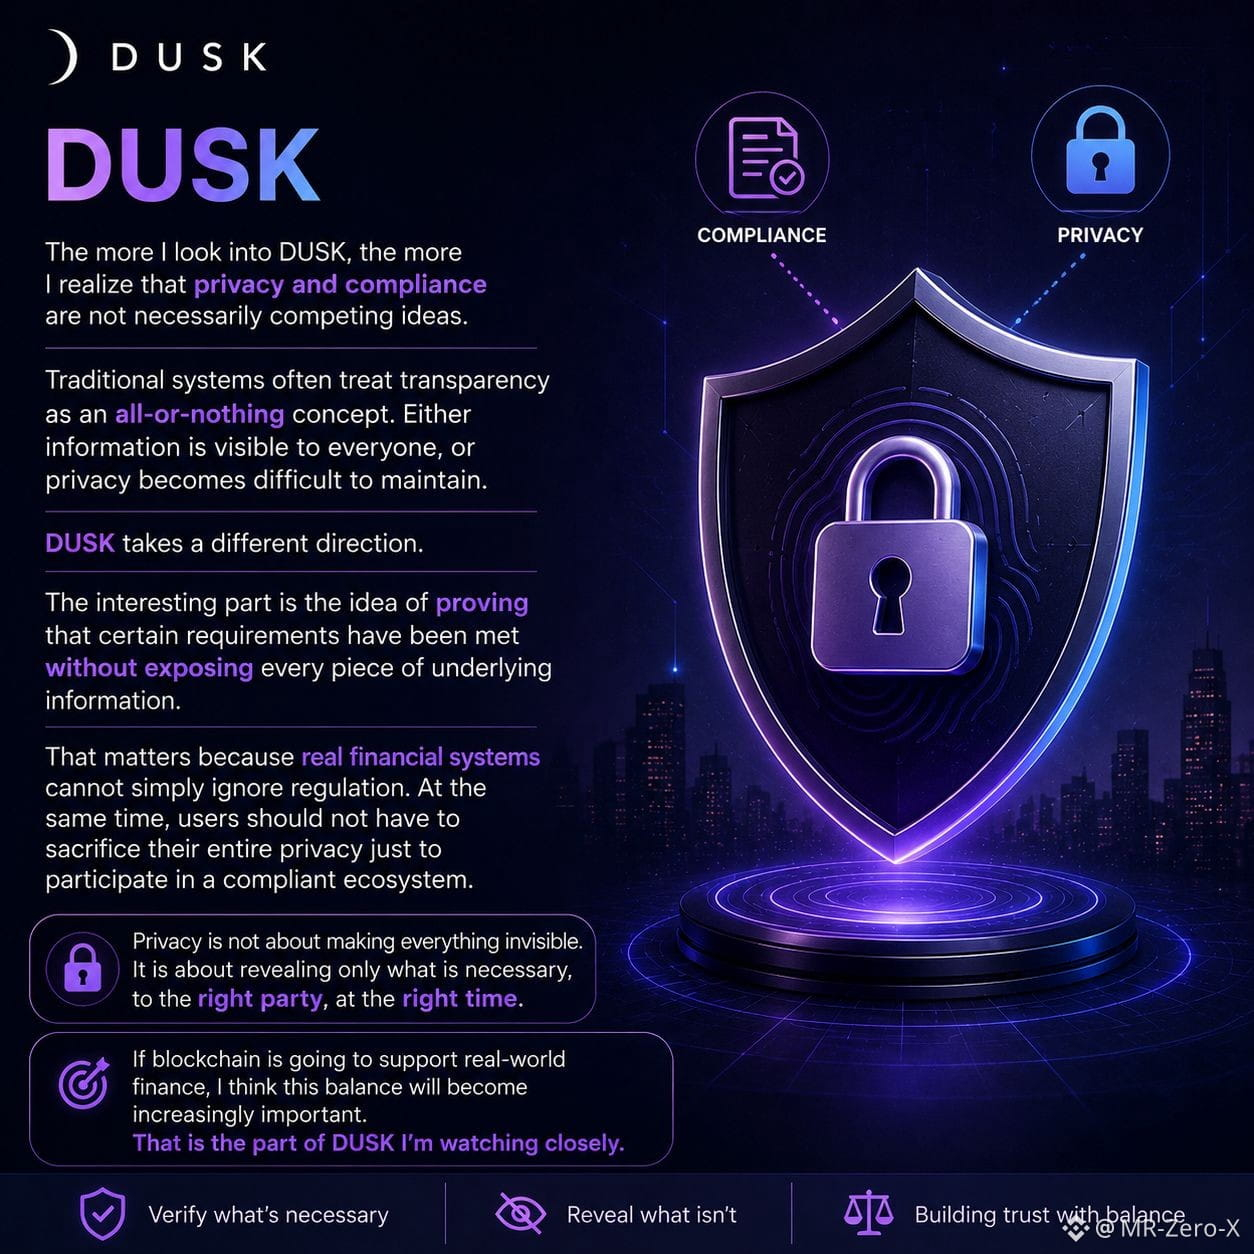
@Dusk_Foundation كلما نظرت أكثر إلى DUSK، أدركت أكثر أن الخصوصية والامتثال ليست بالضرورة أفكارًا متنافسة.
غالبًا ما تعامل الأنظمة التقليدية الشفافية بوصفها مفهومًا إما/أو. إما أن تكون المعلومات مرئية للجميع، أو يصبح الحفاظ على الخصوصية أمرًا صعبًا.
$DUSK تتجه في اتجاه مختلف.
الجزء المثير للاهتمام هو فكرة إثبات أن بعض المتطلبات قد تم الوفاء بها دون كشف كل قطعة من المعلومات الكامنة.
يهم ذلك لأن الأنظمة المالية الحقيقية لا يمكنها تجاهل التنظيم ببساطة. وفي الوقت نفسه، لا ينبغي للمستخدمين أن يضطروا إلى التضحية بخصوصيتهم بالكامل فقط للمشاركة في نظام بيئي متوافق.
بالنسبة لي، هنا تصبح المحادثة أكثر عملية.
الخصوصية ليست عن جعل كل شيء غير مرئي.
إنها عن الكشف فقط عن ما هو ضروري، للطرف المناسب، وفي الوقت المناسب.
إذا كانت تقنية البلوك تشين ستدعم التمويل في العالم الحقيقي، فأعتقد أن هذا التوازن سيصبح أكثر أهمية بشكل متزايد.
هذه هي النقطة من DUSK التي أتابعها عن كثب.
#DUSK $DUSK
#dusk $DUSK
@Dusk كلما نظرت أكثر إلى DUSK، أدركت أكثر أن الخصوصية والامتثال ليست بالضرورة أفكارًا متنافسة.
غالبًا ما تعامل الأنظمة التقليدية الشفافية بوصفها مفهومًا إما/أو. إما أن تكون المعلومات مرئية للجميع، أو يصبح الحفاظ على الخصوصية أمرًا صعبًا.
$DUSK تتجه في اتجاه مختلف.
الجزء المثير للاهتمام هو فكرة إثبات أن بعض المتطلبات قد تم الوفاء بها دون كشف كل قطعة من المعلومات الكامنة.
يهم ذلك لأن الأنظمة المالية الحقيقية لا يمكنها تجاهل التنظيم ببساطة. وفي الوقت نفسه، لا ينبغي للمستخدمين أن يضطروا إلى التضحية بخصوصيتهم بالكامل فقط للمشاركة في نظام بيئي متوافق.
بالنسبة لي، هنا تصبح المحادثة أكثر عملية.
الخصوصية ليست عن جعل كل شيء غير مرئي.
إنها عن الكشف فقط عن ما هو ضروري، للطرف المناسب، وفي الوقت المناسب.
إذا كانت تقنية البلوك تشين ستدعم التمويل في العالم الحقيقي، فأعتقد أن هذا التوازن سيصبح أكثر أهمية بشكل متزايد.
هذه هي النقطة من DUSK التي أتابعها عن كثب.
#DUSK $DUSK
@Dusk كلما نظرت أكثر إلى DUSK، أدركت أكثر أن الخصوصية والامتثال ليست بالضرورة أفكارًا متنافسة.
غالبًا ما تعامل الأنظمة التقليدية الشفافية بوصفها مفهومًا إما/أو. إما أن تكون المعلومات مرئية للجميع، أو يصبح الحفاظ على الخصوصية أمرًا صعبًا.
$DUSK تتجه في اتجاه مختلف.
الجزء المثير للاهتمام هو فكرة إثبات أن بعض المتطلبات قد تم الوفاء بها دون كشف كل قطعة من المعلومات الكامنة.
يهم ذلك لأن الأنظمة المالية الحقيقية لا يمكنها تجاهل التنظيم ببساطة. وفي الوقت نفسه، لا ينبغي للمستخدمين أن يضطروا إلى التضحية بخصوصيتهم بالكامل فقط للمشاركة في نظام بيئي متوافق.
بالنسبة لي، هنا تصبح المحادثة أكثر عملية.
الخصوصية ليست عن جعل كل شيء غير مرئي.
إنها عن الكشف فقط عن ما هو ضروري، للطرف المناسب، وفي الوقت المناسب.
إذا كانت تقنية البلوك تشين ستدعم التمويل في العالم الحقيقي، فأعتقد أن هذا التوازن سيصبح أكثر أهمية بشكل متزايد.
هذه هي النقطة من DUSK التي أتابعها عن كثب.
#DUSK $DUSK
178
·
--
@Dusk_Foundation $DUSK
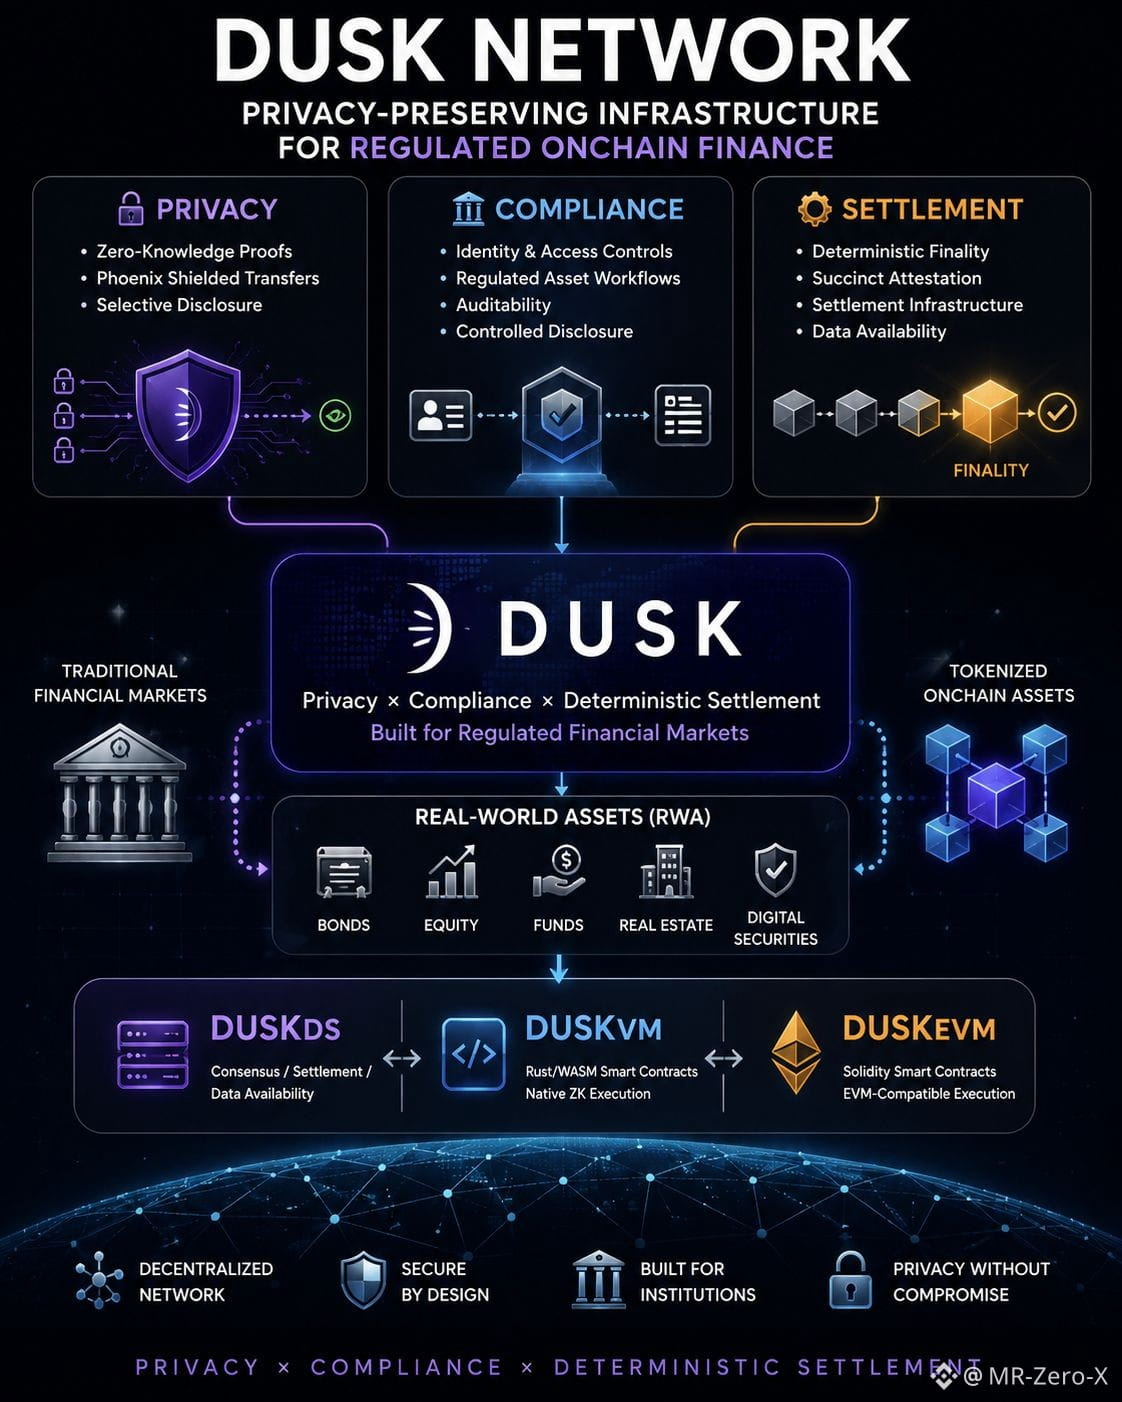
كنت أنظر إلى Dusk من سؤال بسيط:
هل يمكن للبنية التحتية لسلسلة الكتل أن تمنح المؤسسات الخصوصية دون التضحية بالامتثال؟
هنا تصبح Dusk مثيرة للاهتمام بالنسبة لي.
🔐 الخصوصية
• تقنية المعرفة الصفرية
• معاملات مُشفّفة
• إفصاح انتقائي
🏛️ الامتثال
• الهوية وضوابط الوصول
• سير عمل للأصول الخاضعة للتنظيم
• خصوصية مع قابلية التحقق
⚙️ التسوية
• حتمية نهائية
• إجماع التحقق المختصر
• بنية تحتية مصممة للتطبيقات المالية
🌍 الأصول الواقعية (RWA)
الفكرة الأكبر ليست مجرد وضع الأصول الحقيقية في سلسلة كتل.
بل هي بناء البنية التحتية لإصدار الأصول وملكيّتها ونقلها وتسويتها مع إبقاء الخصوصية والمتطلبات التنظيمية ضمن الصورة.
وهذا هو الجزء الذي سأتابعه عن كثب.
👇 هل تعتقد أن الخصوصية + الامتثال يمكن أن تصبح القطعة الناقصة لاعتماد سلاسل الكتل المؤسسية؟
#Dusk #RWA #Privacy #Layer1 #BinanceSquare
@Dusk $DUSK
كنت أنظر إلى Dusk من سؤال بسيط:
هل يمكن للبنية التحتية لسلسلة الكتل أن تمنح المؤسسات الخصوصية دون التضحية بالامتثال؟
هنا تصبح Dusk مثيرة للاهتمام بالنسبة لي.
🔐 الخصوصية
• تقنية المعرفة الصفرية
• معاملات مُشفّفة
• إفصاح انتقائي
🏛️ الامتثال
• الهوية وضوابط الوصول
• سير عمل للأصول الخاضعة للتنظيم
• خصوصية مع قابلية التحقق
⚙️ التسوية
• حتمية نهائية
• إجماع التحقق المختصر
• بنية تحتية مصممة للتطبيقات المالية
🌍 الأصول الواقعية (RWA)
الفكرة الأكبر ليست مجرد وضع الأصول الحقيقية في سلسلة كتل.
بل هي بناء البنية التحتية لإصدار الأصول وملكيّتها ونقلها وتسويتها مع إبقاء الخصوصية والمتطلبات التنظيمية ضمن الصورة.
وهذا هو الجزء الذي سأتابعه عن كثب.
👇 هل تعتقد أن الخصوصية + الامتثال يمكن أن تصبح القطعة الناقصة لاعتماد سلاسل الكتل المؤسسية؟
#Dusk #RWA #Privacy #Layer1 #BinanceSquare
كنت أنظر إلى Dusk من سؤال بسيط:
هل يمكن للبنية التحتية لسلسلة الكتل أن تمنح المؤسسات الخصوصية دون التضحية بالامتثال؟
هنا تصبح Dusk مثيرة للاهتمام بالنسبة لي.
🔐 الخصوصية
• تقنية المعرفة الصفرية
• معاملات مُشفّفة
• إفصاح انتقائي
🏛️ الامتثال
• الهوية وضوابط الوصول
• سير عمل للأصول الخاضعة للتنظيم
• خصوصية مع قابلية التحقق
⚙️ التسوية
• حتمية نهائية
• إجماع التحقق المختصر
• بنية تحتية مصممة للتطبيقات المالية
🌍 الأصول الواقعية (RWA)
الفكرة الأكبر ليست مجرد وضع الأصول الحقيقية في سلسلة كتل.
بل هي بناء البنية التحتية لإصدار الأصول وملكيّتها ونقلها وتسويتها مع إبقاء الخصوصية والمتطلبات التنظيمية ضمن الصورة.
وهذا هو الجزء الذي سأتابعه عن كثب.
👇 هل تعتقد أن الخصوصية + الامتثال يمكن أن تصبح القطعة الناقصة لاعتماد سلاسل الكتل المؤسسية؟
#Dusk #RWA #Privacy #Layer1 #BinanceSquare
1
154
·
--
#baby $BABY
@Babylon شيء واحد لاحظته أثناء متابعة الإقراض/التخزين (Staking) الخاص بـ Bitcoin هو أن جذب رأس المال هو مجرد الخطوة الأولى.
التحدي الأصعب هو إبقاء هذا رأس المال نشطًا على المدى الطويل.
لهذا السبب أتابع عن كثب منظومة Babylon و $BABY .
إذا استمر Staking الخاص بالـ Bitcoin في تأمين عدة شبكات، فسيقوم المشاركون ببناء سجلّ على السلسلة يمكن لأي شخص التحقق منه. ومع مرور الوقت، قد يصبح هذا السجل إشارة قيمة على الموثوقية.
قد يساهم المُصدِّق (Validator) الذي ينجز بشكل متسق وبجودة عالية عبر ظروف سوق مختلفة في تعزيز ثقة الشبكة أكثر من مُصدِّق يبدو فقط بحصة كبيرة لفترة قصيرة.
وبالطبع، يعمل ذلك فقط إذا استمرت الشبكة في خلق طلب حقيقي.
يحتاج المطورون إلى بنية تحتية مفيدة.
يحتاج الـ Stakers إلى مكافآت مستدامة.
تحتاج الـ Validators إلى نشاط اقتصادي كافٍ لتبرير البقاء متصلين.
بالنسبة لي، أهم المقاييس ليست الضجة اليومية أو تحركات الأسعار. أنا أراقب Staking المتكرر لـ BTC، والمشاركة من الـ Validators، ونمو النظام البيئي، وتوليد الرسوم (الـ fees)، وما إذا كان نشاط الشبكة يستمر في التعزيز بعد أن تخبو الحماسة الأولية.
القصص/السرديات القوية تجذب الانتباه.
المنفعة طويلة الأجل هي ما يحدد عادةً ما إذا كان النظام البيئي سيواصل النمو.
ما رأيك: ما الذي سيهم أكثر بالنسبة لـ Babylon خلال السنوات القليلة القادمة—مزيد من الـ BTC stakers أم مزيد من التطبيقات الحقيقية المبنية فوق الشبكة؟ 👇
#Babylon #baby #bitcoin #BTC
{spot}(BTCUSDT)
{future}(SOLUSDT)
{spot}(BABYUSDT)
#baby $BABY
@Babylon شيء واحد لاحظته أثناء متابعة الإقراض/التخزين (Staking) الخاص بـ Bitcoin هو أن جذب رأس المال هو مجرد الخطوة الأولى.
التحدي الأصعب هو إبقاء هذا رأس المال نشطًا على المدى الطويل.
لهذا السبب أتابع عن كثب منظومة Babylon و $BABY .
إذا استمر Staking الخاص بالـ Bitcoin في تأمين عدة شبكات، فسيقوم المشاركون ببناء سجلّ على السلسلة يمكن لأي شخص التحقق منه. ومع مرور الوقت، قد يصبح هذا السجل إشارة قيمة على الموثوقية.
قد يساهم المُصدِّق (Validator) الذي ينجز بشكل متسق وبجودة عالية عبر ظروف سوق مختلفة في تعزيز ثقة الشبكة أكثر من مُصدِّق يبدو فقط بحصة كبيرة لفترة قصيرة.
وبالطبع، يعمل ذلك فقط إذا استمرت الشبكة في خلق طلب حقيقي.
يحتاج المطورون إلى بنية تحتية مفيدة.
يحتاج الـ Stakers إلى مكافآت مستدامة.
تحتاج الـ Validators إلى نشاط اقتصادي كافٍ لتبرير البقاء متصلين.
بالنسبة لي، أهم المقاييس ليست الضجة اليومية أو تحركات الأسعار. أنا أراقب Staking المتكرر لـ BTC، والمشاركة من الـ Validators، ونمو النظام البيئي، وتوليد الرسوم (الـ fees)، وما إذا كان نشاط الشبكة يستمر في التعزيز بعد أن تخبو الحماسة الأولية.
القصص/السرديات القوية تجذب الانتباه.
المنفعة طويلة الأجل هي ما يحدد عادةً ما إذا كان النظام البيئي سيواصل النمو.
ما رأيك: ما الذي سيهم أكثر بالنسبة لـ Babylon خلال السنوات القليلة القادمة—مزيد من الـ BTC stakers أم مزيد من التطبيقات الحقيقية المبنية فوق الشبكة؟ 👇
#Babylon #baby #bitcoin #BTC
@Babylon شيء واحد لاحظته أثناء متابعة الإقراض/التخزين (Staking) الخاص بـ Bitcoin هو أن جذب رأس المال هو مجرد الخطوة الأولى.
التحدي الأصعب هو إبقاء هذا رأس المال نشطًا على المدى الطويل.
لهذا السبب أتابع عن كثب منظومة Babylon و $BABY .
إذا استمر Staking الخاص بالـ Bitcoin في تأمين عدة شبكات، فسيقوم المشاركون ببناء سجلّ على السلسلة يمكن لأي شخص التحقق منه. ومع مرور الوقت، قد يصبح هذا السجل إشارة قيمة على الموثوقية.
قد يساهم المُصدِّق (Validator) الذي ينجز بشكل متسق وبجودة عالية عبر ظروف سوق مختلفة في تعزيز ثقة الشبكة أكثر من مُصدِّق يبدو فقط بحصة كبيرة لفترة قصيرة.
وبالطبع، يعمل ذلك فقط إذا استمرت الشبكة في خلق طلب حقيقي.
يحتاج المطورون إلى بنية تحتية مفيدة.
يحتاج الـ Stakers إلى مكافآت مستدامة.
تحتاج الـ Validators إلى نشاط اقتصادي كافٍ لتبرير البقاء متصلين.
بالنسبة لي، أهم المقاييس ليست الضجة اليومية أو تحركات الأسعار. أنا أراقب Staking المتكرر لـ BTC، والمشاركة من الـ Validators، ونمو النظام البيئي، وتوليد الرسوم (الـ fees)، وما إذا كان نشاط الشبكة يستمر في التعزيز بعد أن تخبو الحماسة الأولية.
القصص/السرديات القوية تجذب الانتباه.
المنفعة طويلة الأجل هي ما يحدد عادةً ما إذا كان النظام البيئي سيواصل النمو.
ما رأيك: ما الذي سيهم أكثر بالنسبة لـ Babylon خلال السنوات القليلة القادمة—مزيد من الـ BTC stakers أم مزيد من التطبيقات الحقيقية المبنية فوق الشبكة؟ 👇
#Babylon #baby #bitcoin #BTC
110
·
--
تمّ التحقق
$OPG @OpenGradient
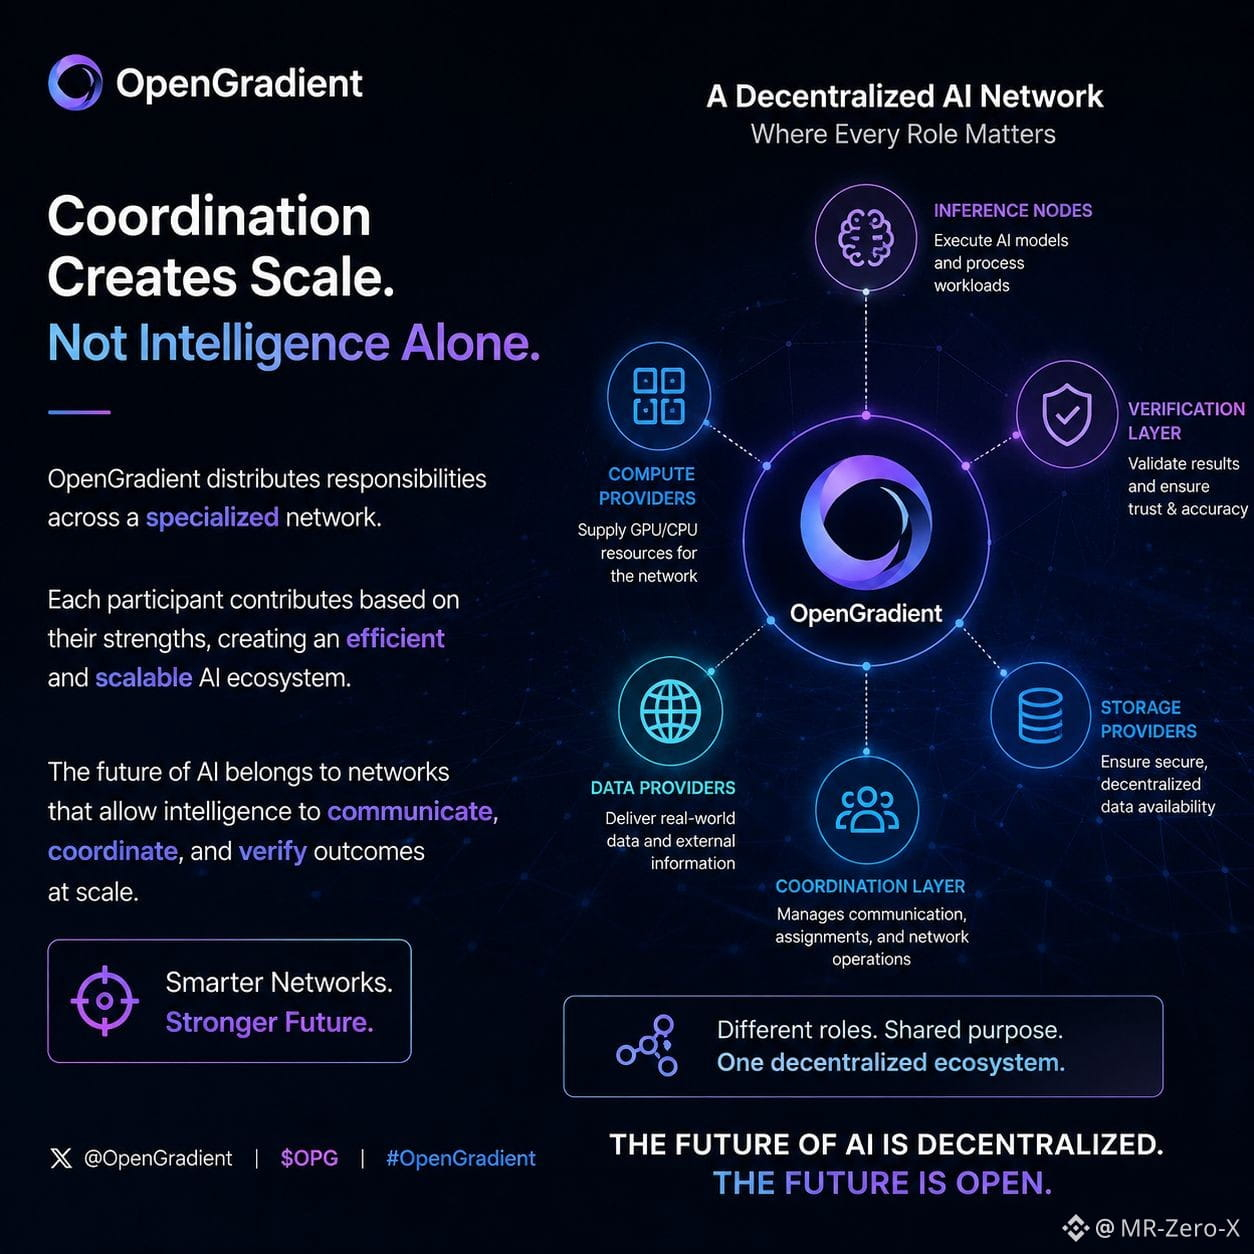
كلما فكرت أكثر في OpenGradient، أدركت أكثر أن التنسيق لا يعمل إلا عندما يكون لكل مشارك في الشبكة دور واضح.
ومن أبرز الجوانب في هذه البنية بالنسبة لي هو كيفية توزيع المسؤوليات بدلاً من إجبار كل عقدة على تنفيذ المهمة نفسها.
غالباً ما لا تكون أحمال الذكاء الاصطناعي متشابهة. فبعض العمليات تتطلب حسابات مكثفة، بينما يركز بعضها الآخر على التحقق أو الوصول إلى البيانات أو التخزين.
يتعامل OpenGradient مع هذا التحدي عبر فصل هذه الوظائف بين مشاركين متخصصين.
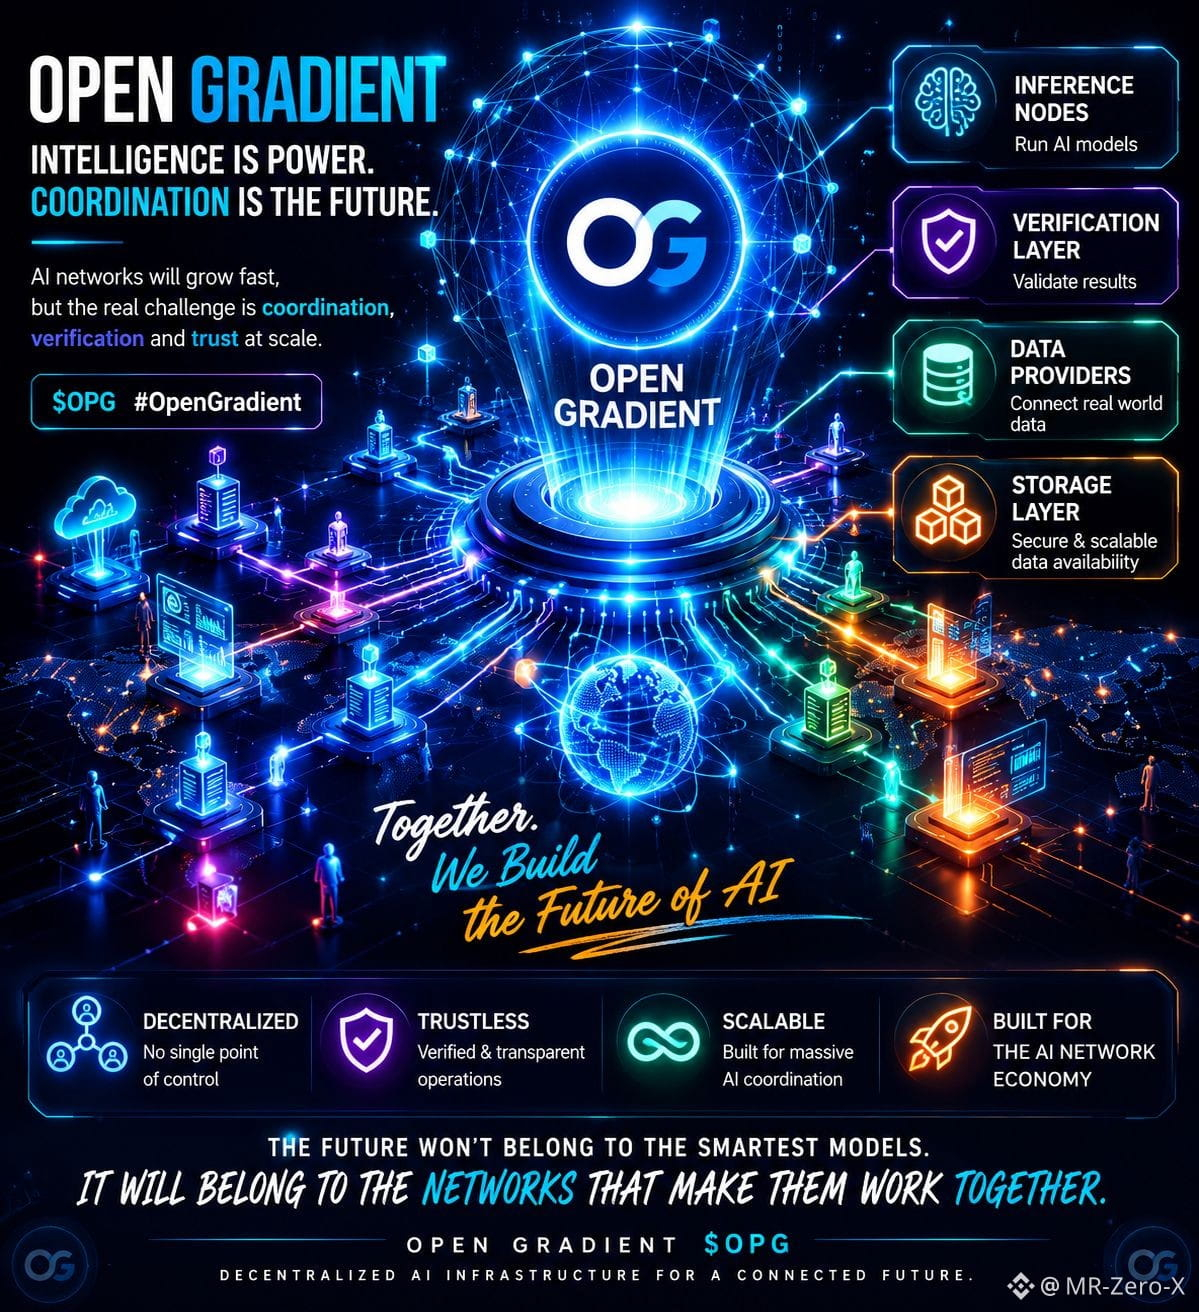
تقوم عقد الاستدلال بتنفيذ نماذج الذكاء الاصطناعي، وتساعد طبقات التحقق في التحقق من النتائج، ويقوم مزودو البيانات بربط المعلومات الخارجية، وتدير بنية التخزين توافر البيانات على المدى الطويل.
ما يثير اهتمامي أكثر هو الكفاءة التي يخلقها ذلك. فبدلاً من بناء شبكة يؤدي فيها كل مشارك كل شيء، صُمم النظام ليشبه أكثر نظاماً بيئياً يساهم فيه كل مكوّن وفقاً لنقاط قوته.
ومع استمرار نمو شبكات الذكاء الاصطناعي، قد تعتمد قابلية التوسع بدرجة أقل على القوة الحاسوبية الخام وأكثر على مدى فعالية تنسيق الموارد عبر النظام.
قد تصبح المشاريع التي تحل مشكلات التنسيق والتحقق وتخصيص الموارد بنفس أهمية النماذج نفسها.
وهذا سبب واحد يجعل OpenGradient ما زال يلفت انتباهي.
@OpenGradient $OPG #OpenGradient
#opg
$OPG @OpenGradient
كلما فكرت أكثر في OpenGradient، أدركت أكثر أن التنسيق لا يعمل إلا عندما يكون لكل مشارك في الشبكة دور واضح.
ومن أبرز الجوانب في هذه البنية بالنسبة لي هو كيفية توزيع المسؤوليات بدلاً من إجبار كل عقدة على تنفيذ المهمة نفسها.
غالباً ما لا تكون أحمال الذكاء الاصطناعي متشابهة. فبعض العمليات تتطلب حسابات مكثفة، بينما يركز بعضها الآخر على التحقق أو الوصول إلى البيانات أو التخزين.
يتعامل OpenGradient مع هذا التحدي عبر فصل هذه الوظائف بين مشاركين متخصصين.
تقوم عقد الاستدلال بتنفيذ نماذج الذكاء الاصطناعي، وتساعد طبقات التحقق في التحقق من النتائج، ويقوم مزودو البيانات بربط المعلومات الخارجية، وتدير بنية التخزين توافر البيانات على المدى الطويل.
ما يثير اهتمامي أكثر هو الكفاءة التي يخلقها ذلك. فبدلاً من بناء شبكة يؤدي فيها كل مشارك كل شيء، صُمم النظام ليشبه أكثر نظاماً بيئياً يساهم فيه كل مكوّن وفقاً لنقاط قوته.
ومع استمرار نمو شبكات الذكاء الاصطناعي، قد تعتمد قابلية التوسع بدرجة أقل على القوة الحاسوبية الخام وأكثر على مدى فعالية تنسيق الموارد عبر النظام.
قد تصبح المشاريع التي تحل مشكلات التنسيق والتحقق وتخصيص الموارد بنفس أهمية النماذج نفسها.
وهذا سبب واحد يجعل OpenGradient ما زال يلفت انتباهي.
@OpenGradient $OPG #OpenGradient
#opg
كلما فكرت أكثر في OpenGradient، أدركت أكثر أن التنسيق لا يعمل إلا عندما يكون لكل مشارك في الشبكة دور واضح.
ومن أبرز الجوانب في هذه البنية بالنسبة لي هو كيفية توزيع المسؤوليات بدلاً من إجبار كل عقدة على تنفيذ المهمة نفسها.
غالباً ما لا تكون أحمال الذكاء الاصطناعي متشابهة. فبعض العمليات تتطلب حسابات مكثفة، بينما يركز بعضها الآخر على التحقق أو الوصول إلى البيانات أو التخزين.
يتعامل OpenGradient مع هذا التحدي عبر فصل هذه الوظائف بين مشاركين متخصصين.
تقوم عقد الاستدلال بتنفيذ نماذج الذكاء الاصطناعي، وتساعد طبقات التحقق في التحقق من النتائج، ويقوم مزودو البيانات بربط المعلومات الخارجية، وتدير بنية التخزين توافر البيانات على المدى الطويل.
ما يثير اهتمامي أكثر هو الكفاءة التي يخلقها ذلك. فبدلاً من بناء شبكة يؤدي فيها كل مشارك كل شيء، صُمم النظام ليشبه أكثر نظاماً بيئياً يساهم فيه كل مكوّن وفقاً لنقاط قوته.
ومع استمرار نمو شبكات الذكاء الاصطناعي، قد تعتمد قابلية التوسع بدرجة أقل على القوة الحاسوبية الخام وأكثر على مدى فعالية تنسيق الموارد عبر النظام.
قد تصبح المشاريع التي تحل مشكلات التنسيق والتحقق وتخصيص الموارد بنفس أهمية النماذج نفسها.
وهذا سبب واحد يجعل OpenGradient ما زال يلفت انتباهي.
@OpenGradient $OPG #OpenGradient
#opg
4
4
338
·
--
@OpenGradient
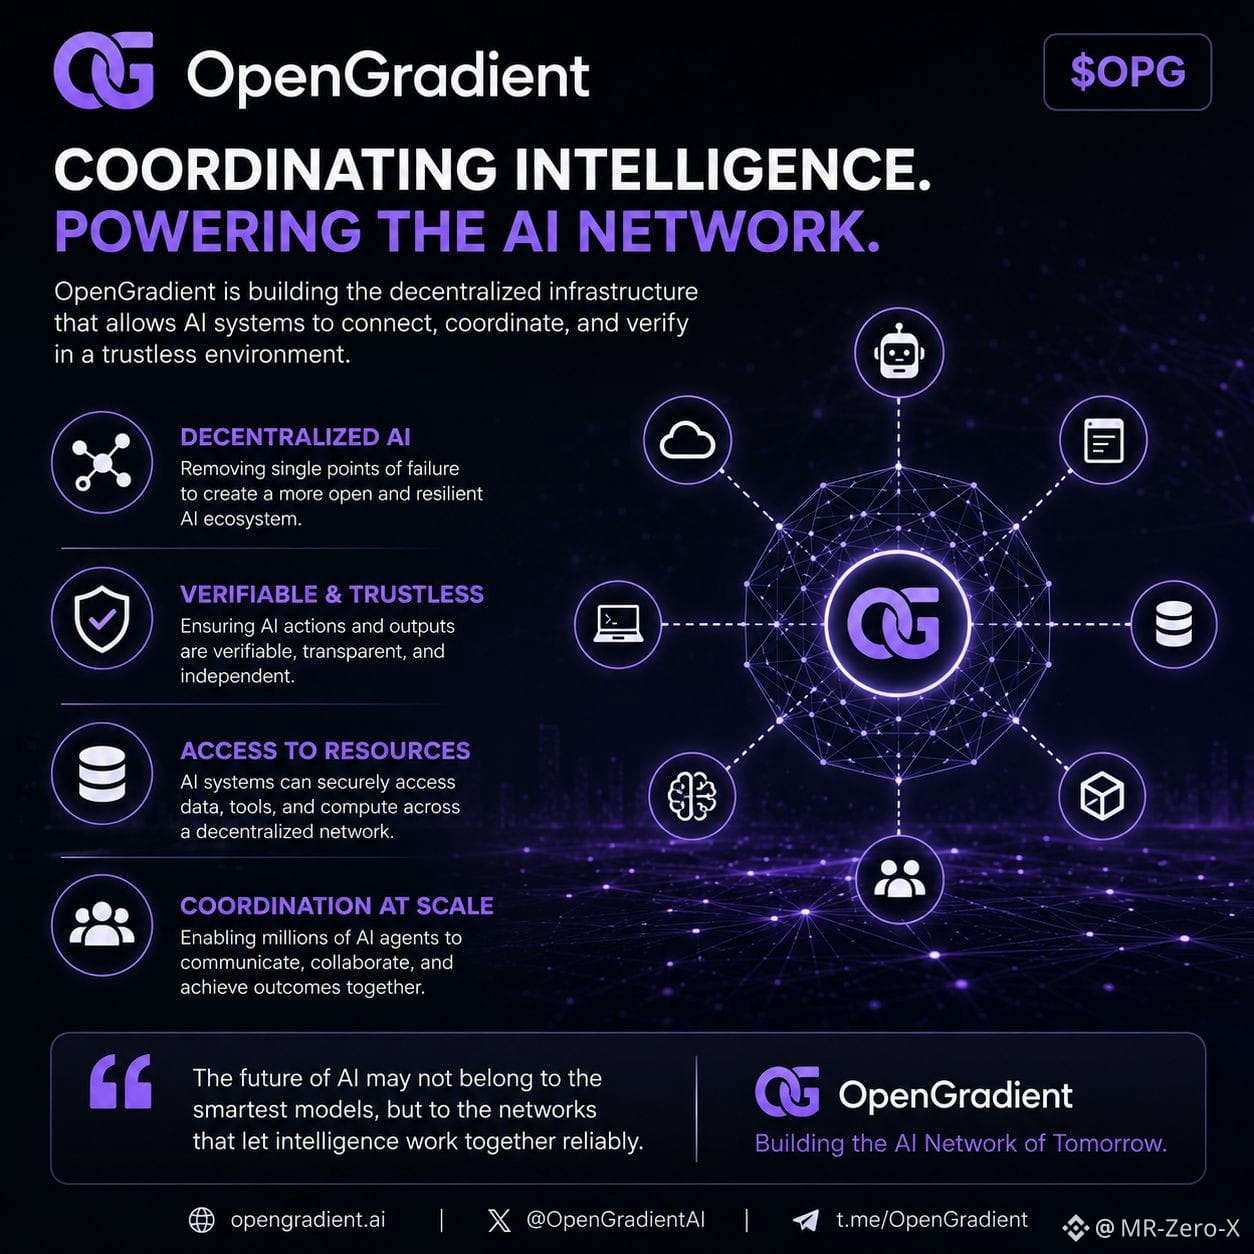
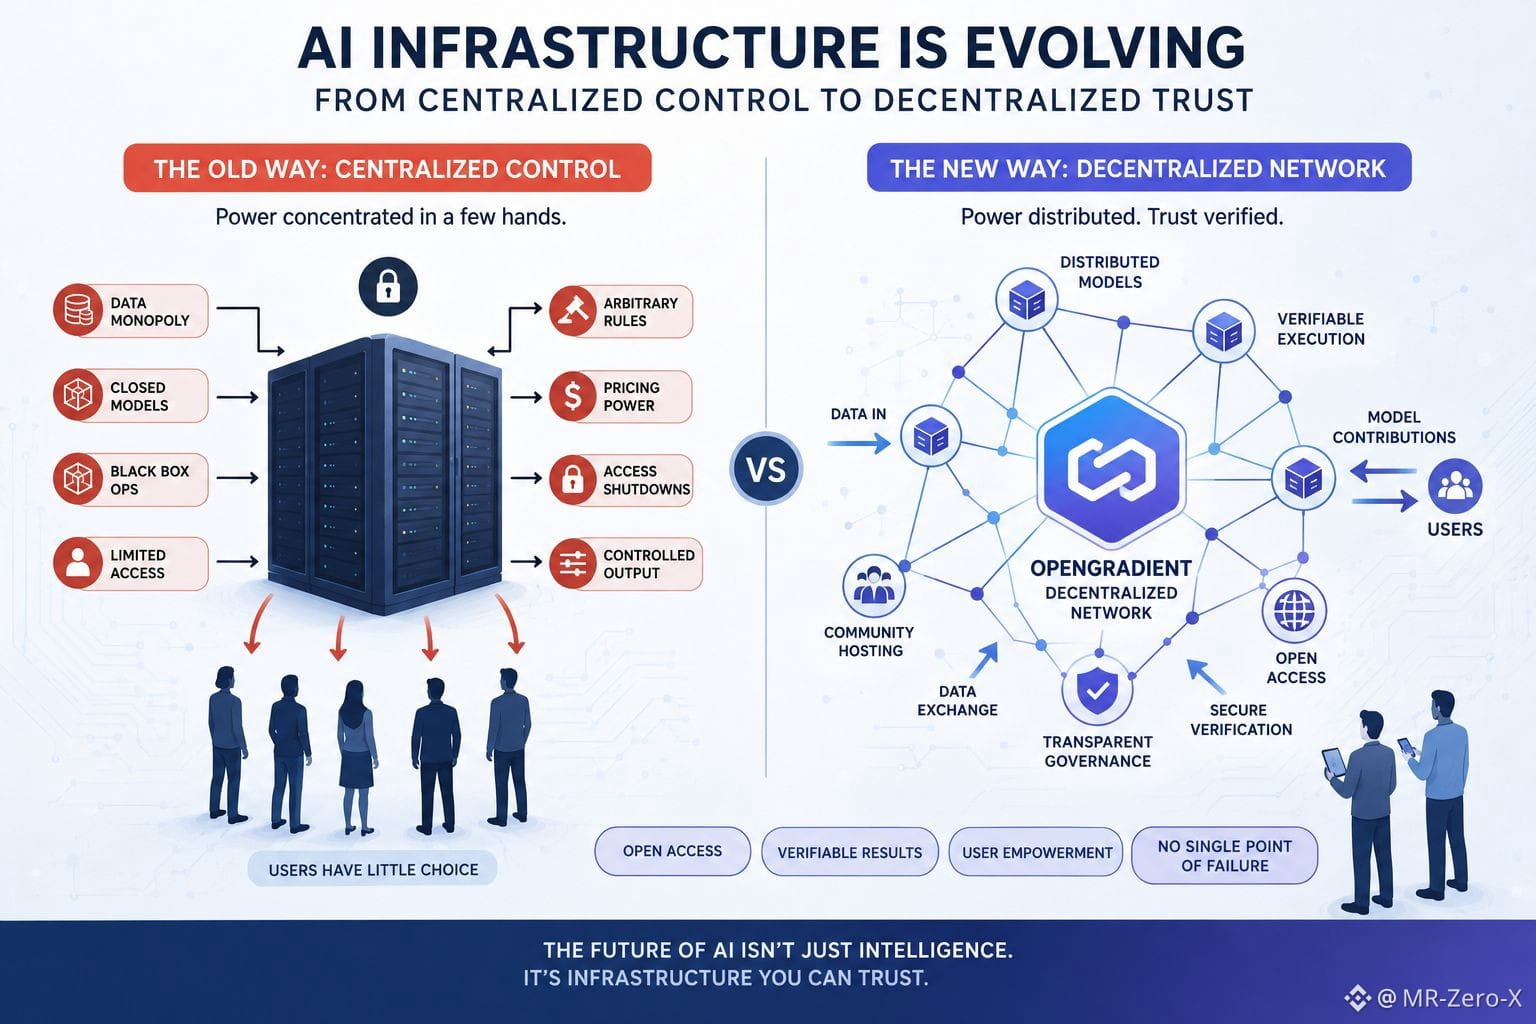
كلما قرأت عن OpenGradient، أدركت أن الذكاء الاصطناعي قد يواجه في النهاية تحديًا يتجاوز ذكاء النماذج.
بناء أنظمة ذكية شيء واحد.
السماح للذكاء بالتنسيق على نطاق واسع شيء آخر تمامًا.
$OPG
لا تزال معظم المحادثات تركز على قدرات النماذج، وجودة الاستدلال، وسرعة الاستنتاج. تلك التحسينات مهمة، لكنني أظل أتساءل ماذا يحدث عندما تحتاج أعداد كبيرة من أنظمة الذكاء الاصطناعي إلى التفاعل مع بعضها البعض، والوصول إلى موارد خارجية، واتخاذ قرارات عبر بيئات لامركزية.
كيف يمكنهم التنسيق؟
كيف يمكنهم التحقق من المعلومات؟
كيف يمكنهم العمل دون الاعتماد على سلطة مركزية واحدة؟
هنا تصبح OpenGradient مثيرة للاهتمام بالنسبة لي.
المشروع ينقل الانتباه من نماذج الذكاء الاصطناعي الفردية إلى البنية التحتية التي تمكن الذكاء من العمل كجزء من شبكة أوسع.
كلما استكشفت الذكاء الاصطناعي اللامركزي، كلما اعتقدت أن المستقبل قد يعتمد ليس فقط على نماذج أكثر ذكاءً ولكن أيضًا على أنظمة تدعم التنسيق، والشفافية، والتحقق على نطاق واسع.
قد لا تُعرف المرحلة التالية من الذكاء الاصطناعي من خلال إنجاز واحد.
قد تُعرف من خلال الشبكات التي تسمح للذكاء بالعمل معًا بشكل موثوق.
هذه واحدة من الأسباب التي تجعل OpenGradient لا تزال على راداري.
@OpenGradient
$OPG #OpenGradient #OPG
@OpenGradient
كلما قرأت عن OpenGradient، أدركت أن الذكاء الاصطناعي قد يواجه في النهاية تحديًا يتجاوز ذكاء النماذج.
بناء أنظمة ذكية شيء واحد.
السماح للذكاء بالتنسيق على نطاق واسع شيء آخر تمامًا.
$OPG
لا تزال معظم المحادثات تركز على قدرات النماذج، وجودة الاستدلال، وسرعة الاستنتاج. تلك التحسينات مهمة، لكنني أظل أتساءل ماذا يحدث عندما تحتاج أعداد كبيرة من أنظمة الذكاء الاصطناعي إلى التفاعل مع بعضها البعض، والوصول إلى موارد خارجية، واتخاذ قرارات عبر بيئات لامركزية.
كيف يمكنهم التنسيق؟
كيف يمكنهم التحقق من المعلومات؟
كيف يمكنهم العمل دون الاعتماد على سلطة مركزية واحدة؟
هنا تصبح OpenGradient مثيرة للاهتمام بالنسبة لي.
المشروع ينقل الانتباه من نماذج الذكاء الاصطناعي الفردية إلى البنية التحتية التي تمكن الذكاء من العمل كجزء من شبكة أوسع.
كلما استكشفت الذكاء الاصطناعي اللامركزي، كلما اعتقدت أن المستقبل قد يعتمد ليس فقط على نماذج أكثر ذكاءً ولكن أيضًا على أنظمة تدعم التنسيق، والشفافية، والتحقق على نطاق واسع.
قد لا تُعرف المرحلة التالية من الذكاء الاصطناعي من خلال إنجاز واحد.
قد تُعرف من خلال الشبكات التي تسمح للذكاء بالعمل معًا بشكل موثوق.
هذه واحدة من الأسباب التي تجعل OpenGradient لا تزال على راداري.
@OpenGradient
$OPG #OpenGradient #OPG
كلما قرأت عن OpenGradient، أدركت أن الذكاء الاصطناعي قد يواجه في النهاية تحديًا يتجاوز ذكاء النماذج.
بناء أنظمة ذكية شيء واحد.
السماح للذكاء بالتنسيق على نطاق واسع شيء آخر تمامًا.
$OPG
لا تزال معظم المحادثات تركز على قدرات النماذج، وجودة الاستدلال، وسرعة الاستنتاج. تلك التحسينات مهمة، لكنني أظل أتساءل ماذا يحدث عندما تحتاج أعداد كبيرة من أنظمة الذكاء الاصطناعي إلى التفاعل مع بعضها البعض، والوصول إلى موارد خارجية، واتخاذ قرارات عبر بيئات لامركزية.
كيف يمكنهم التنسيق؟
كيف يمكنهم التحقق من المعلومات؟
كيف يمكنهم العمل دون الاعتماد على سلطة مركزية واحدة؟
هنا تصبح OpenGradient مثيرة للاهتمام بالنسبة لي.
المشروع ينقل الانتباه من نماذج الذكاء الاصطناعي الفردية إلى البنية التحتية التي تمكن الذكاء من العمل كجزء من شبكة أوسع.
كلما استكشفت الذكاء الاصطناعي اللامركزي، كلما اعتقدت أن المستقبل قد يعتمد ليس فقط على نماذج أكثر ذكاءً ولكن أيضًا على أنظمة تدعم التنسيق، والشفافية، والتحقق على نطاق واسع.
قد لا تُعرف المرحلة التالية من الذكاء الاصطناعي من خلال إنجاز واحد.
قد تُعرف من خلال الشبكات التي تسمح للذكاء بالعمل معًا بشكل موثوق.
هذه واحدة من الأسباب التي تجعل OpenGradient لا تزال على راداري.
@OpenGradient
$OPG #OpenGradient #OPG
22
11
276
·
--
كلما قرأت أكثر عن Open Gradient، أدركت أكثر أن الذكاء الاصطناعي قد يواجه في النهاية نفس التحديات التي واجهتها العديد من الشبكات من قبل.
بناء الذكاء شيء.
تنسيق الذكاء شيء آخر تمامًا.
$OPG
لا تزال معظم المناقشات تركز على النماذج والقدرات. استنتاج أفضل، نوافذ سياق أكبر، استدلال أسرع. هذه التحسينات مهمة، لكنني أستمر في التساؤل عن ما يحدث عندما تحتاج الآلاف أو حتى الملايين من أنظمة الذكاء الاصطناعي إلى التفاعل مع بعضها البعض ومع الموارد الخارجية.
كيف يمكنها التنسيق؟
كيف يمكنها الوصول إلى البيانات؟
كيف تتحقق من الأفعال؟
كيف تعمل دون الاعتماد على نقطة تحكم مركزية واحدة؟
هنا يصبح OpenGradient مثيرًا للاهتمام بالنسبة لي.
يجعلني المشروع أفكر أقل في نماذج الذكاء الاصطناعي الفردية وأكثر في البنية التحتية التي تسمح للذكاء بالعمل كجزء من شبكة أكبر.
كلما درست الذكاء الاصطناعي اللامركزي، زادت شعوري أن الذكاء وحده قد لا يكون الوجهة النهائية.
يمكن أن يتمثل التحدي الحقيقي في إنشاء أنظمة حيث يمكن للذكاء التواصل، والتنسيق، والتحقق من النتائج على نطاق واسع.
ما زلت أستكشف البنية وأتعلم كيف تتناسب الأجزاء معًا، لكن فكرة واحدة تبرز باستمرار.
قد لا ينتمي مستقبل الذكاء الاصطناعي فقط إلى أذكى النماذج.
قد ينتمي إلى الشبكات التي تسمح للذكاء بالعمل معًا بشكل موثوق.
هذا واحد من الأسباب التي تجعل OpenGradient يبقى على راداري.
@OpenGradient $OPG #OpenGradient #OPG
كلما قرأت أكثر عن Open Gradient، أدركت أكثر أن الذكاء الاصطناعي قد يواجه في النهاية نفس التحديات التي واجهتها العديد من الشبكات من قبل.
بناء الذكاء شيء.
تنسيق الذكاء شيء آخر تمامًا.
$OPG
لا تزال معظم المناقشات تركز على النماذج والقدرات. استنتاج أفضل، نوافذ سياق أكبر، استدلال أسرع. هذه التحسينات مهمة، لكنني أستمر في التساؤل عن ما يحدث عندما تحتاج الآلاف أو حتى الملايين من أنظمة الذكاء الاصطناعي إلى التفاعل مع بعضها البعض ومع الموارد الخارجية.
كيف يمكنها التنسيق؟
كيف يمكنها الوصول إلى البيانات؟
كيف تتحقق من الأفعال؟
كيف تعمل دون الاعتماد على نقطة تحكم مركزية واحدة؟
هنا يصبح OpenGradient مثيرًا للاهتمام بالنسبة لي.
يجعلني المشروع أفكر أقل في نماذج الذكاء الاصطناعي الفردية وأكثر في البنية التحتية التي تسمح للذكاء بالعمل كجزء من شبكة أكبر.
كلما درست الذكاء الاصطناعي اللامركزي، زادت شعوري أن الذكاء وحده قد لا يكون الوجهة النهائية.
يمكن أن يتمثل التحدي الحقيقي في إنشاء أنظمة حيث يمكن للذكاء التواصل، والتنسيق، والتحقق من النتائج على نطاق واسع.
ما زلت أستكشف البنية وأتعلم كيف تتناسب الأجزاء معًا، لكن فكرة واحدة تبرز باستمرار.
قد لا ينتمي مستقبل الذكاء الاصطناعي فقط إلى أذكى النماذج.
قد ينتمي إلى الشبكات التي تسمح للذكاء بالعمل معًا بشكل موثوق.
هذا واحد من الأسباب التي تجعل OpenGradient يبقى على راداري.
@OpenGradient $OPG #OpenGradient #OPG
بناء الذكاء شيء.
تنسيق الذكاء شيء آخر تمامًا.
$OPG
لا تزال معظم المناقشات تركز على النماذج والقدرات. استنتاج أفضل، نوافذ سياق أكبر، استدلال أسرع. هذه التحسينات مهمة، لكنني أستمر في التساؤل عن ما يحدث عندما تحتاج الآلاف أو حتى الملايين من أنظمة الذكاء الاصطناعي إلى التفاعل مع بعضها البعض ومع الموارد الخارجية.
كيف يمكنها التنسيق؟
كيف يمكنها الوصول إلى البيانات؟
كيف تتحقق من الأفعال؟
كيف تعمل دون الاعتماد على نقطة تحكم مركزية واحدة؟
هنا يصبح OpenGradient مثيرًا للاهتمام بالنسبة لي.
يجعلني المشروع أفكر أقل في نماذج الذكاء الاصطناعي الفردية وأكثر في البنية التحتية التي تسمح للذكاء بالعمل كجزء من شبكة أكبر.
كلما درست الذكاء الاصطناعي اللامركزي، زادت شعوري أن الذكاء وحده قد لا يكون الوجهة النهائية.
يمكن أن يتمثل التحدي الحقيقي في إنشاء أنظمة حيث يمكن للذكاء التواصل، والتنسيق، والتحقق من النتائج على نطاق واسع.
ما زلت أستكشف البنية وأتعلم كيف تتناسب الأجزاء معًا، لكن فكرة واحدة تبرز باستمرار.
قد لا ينتمي مستقبل الذكاء الاصطناعي فقط إلى أذكى النماذج.
قد ينتمي إلى الشبكات التي تسمح للذكاء بالعمل معًا بشكل موثوق.
هذا واحد من الأسباب التي تجعل OpenGradient يبقى على راداري.
@OpenGradient $OPG #OpenGradient #OPG
11
6
101
·
--
#opg $OPG @OpenGradient
كلما قضيت وقتًا أطول في الاطلاع على OpenGradient، كلما وجدت نفسي أفكر في شيء لا يتم الحديث عنه بما فيه الكفاية.
تبدو معظم المحادثات حول الذكاء الاصطناعي وكأنها تبدأ بالنماذج.
نماذج أذكى.
نماذج أسرع.
نماذج أكبر.
لكنني أعود دائمًا إلى سؤال مختلف.
ماذا يحدث بعد أن يولد النموذج إجابة؟
من أين تأتي المعلومات؟
كيف يمكن التحقق منها؟
كيف يتفاعل النظام مع الموارد المحيطة به؟
السبب الذي يجعلني أواصل الانتباه لـ OpenGradient هو أنه يدفعني للتفكير في الطبقات تحت الذكاء الاصطناعي بدلاً من المخرجات في الأعلى.
لا أرى قيمة طويلة الأجل تأتي فقط من الذكاء.
أعتقد أن الوصول، والتنسيق، والتحقق ستكون بنفس القدر من الأهمية.
ربما حتى أكثر.
لا زلت أتعلم وأربط الأمور معًا، لكن شيء واحد يبدو لي بشكل متزايد واضحًا.
قد لا يتم تعريف مستقبل الذكاء الاصطناعي من خلال نموذج اختراق واحد.
قد يتم تشكيله من خلال البنية التحتية التي تسمح للذكاء بالعمل بطريقة موثوقة وقابلة للتحقق.
هذا هو الجزء الذي أراقبه عن كثب في الوقت الحالي.
#OpenGradient $OPG @OpenGradient
#opg $OPG @OpenGradient
كلما قضيت وقتًا أطول في الاطلاع على OpenGradient، كلما وجدت نفسي أفكر في شيء لا يتم الحديث عنه بما فيه الكفاية.
تبدو معظم المحادثات حول الذكاء الاصطناعي وكأنها تبدأ بالنماذج.
نماذج أذكى.
نماذج أسرع.
نماذج أكبر.
لكنني أعود دائمًا إلى سؤال مختلف.
ماذا يحدث بعد أن يولد النموذج إجابة؟
من أين تأتي المعلومات؟
كيف يمكن التحقق منها؟
كيف يتفاعل النظام مع الموارد المحيطة به؟
السبب الذي يجعلني أواصل الانتباه لـ OpenGradient هو أنه يدفعني للتفكير في الطبقات تحت الذكاء الاصطناعي بدلاً من المخرجات في الأعلى.
لا أرى قيمة طويلة الأجل تأتي فقط من الذكاء.
أعتقد أن الوصول، والتنسيق، والتحقق ستكون بنفس القدر من الأهمية.
ربما حتى أكثر.
لا زلت أتعلم وأربط الأمور معًا، لكن شيء واحد يبدو لي بشكل متزايد واضحًا.
قد لا يتم تعريف مستقبل الذكاء الاصطناعي من خلال نموذج اختراق واحد.
قد يتم تشكيله من خلال البنية التحتية التي تسمح للذكاء بالعمل بطريقة موثوقة وقابلة للتحقق.
هذا هو الجزء الذي أراقبه عن كثب في الوقت الحالي.
#OpenGradient $OPG @OpenGradient
كلما قضيت وقتًا أطول في الاطلاع على OpenGradient، كلما وجدت نفسي أفكر في شيء لا يتم الحديث عنه بما فيه الكفاية.
تبدو معظم المحادثات حول الذكاء الاصطناعي وكأنها تبدأ بالنماذج.
نماذج أذكى.
نماذج أسرع.
نماذج أكبر.
لكنني أعود دائمًا إلى سؤال مختلف.
ماذا يحدث بعد أن يولد النموذج إجابة؟
من أين تأتي المعلومات؟
كيف يمكن التحقق منها؟
كيف يتفاعل النظام مع الموارد المحيطة به؟
السبب الذي يجعلني أواصل الانتباه لـ OpenGradient هو أنه يدفعني للتفكير في الطبقات تحت الذكاء الاصطناعي بدلاً من المخرجات في الأعلى.
لا أرى قيمة طويلة الأجل تأتي فقط من الذكاء.
أعتقد أن الوصول، والتنسيق، والتحقق ستكون بنفس القدر من الأهمية.
ربما حتى أكثر.
لا زلت أتعلم وأربط الأمور معًا، لكن شيء واحد يبدو لي بشكل متزايد واضحًا.
قد لا يتم تعريف مستقبل الذكاء الاصطناعي من خلال نموذج اختراق واحد.
قد يتم تشكيله من خلال البنية التحتية التي تسمح للذكاء بالعمل بطريقة موثوقة وقابلة للتحقق.
هذا هو الجزء الذي أراقبه عن كثب في الوقت الحالي.
#OpenGradient $OPG @OpenGradient
45
22
490
·
--
تمّ التحقق
#opg $OPG @OpenGradient
لقد قضيت الكثير من الوقت في دراسة مشاريع الذكاء الاصطناعي، وهناك شيء واحد يبرز لي. معظم المحادثات تركز على الذكاء. الجميع يريد نماذج أكثر ذكاءً، استجابات أسرع، وقدرات أكبر. ولكن مع تحول الذكاء الاصطناعي إلى جزء من الأنظمة الواقعية، أعتقد أن عاملاً آخر يصبح بنفس الأهمية: الثقة.
هذه واحدة من الأسباب التي جعلت شبكة OpenGradient تلفت انتباهي.
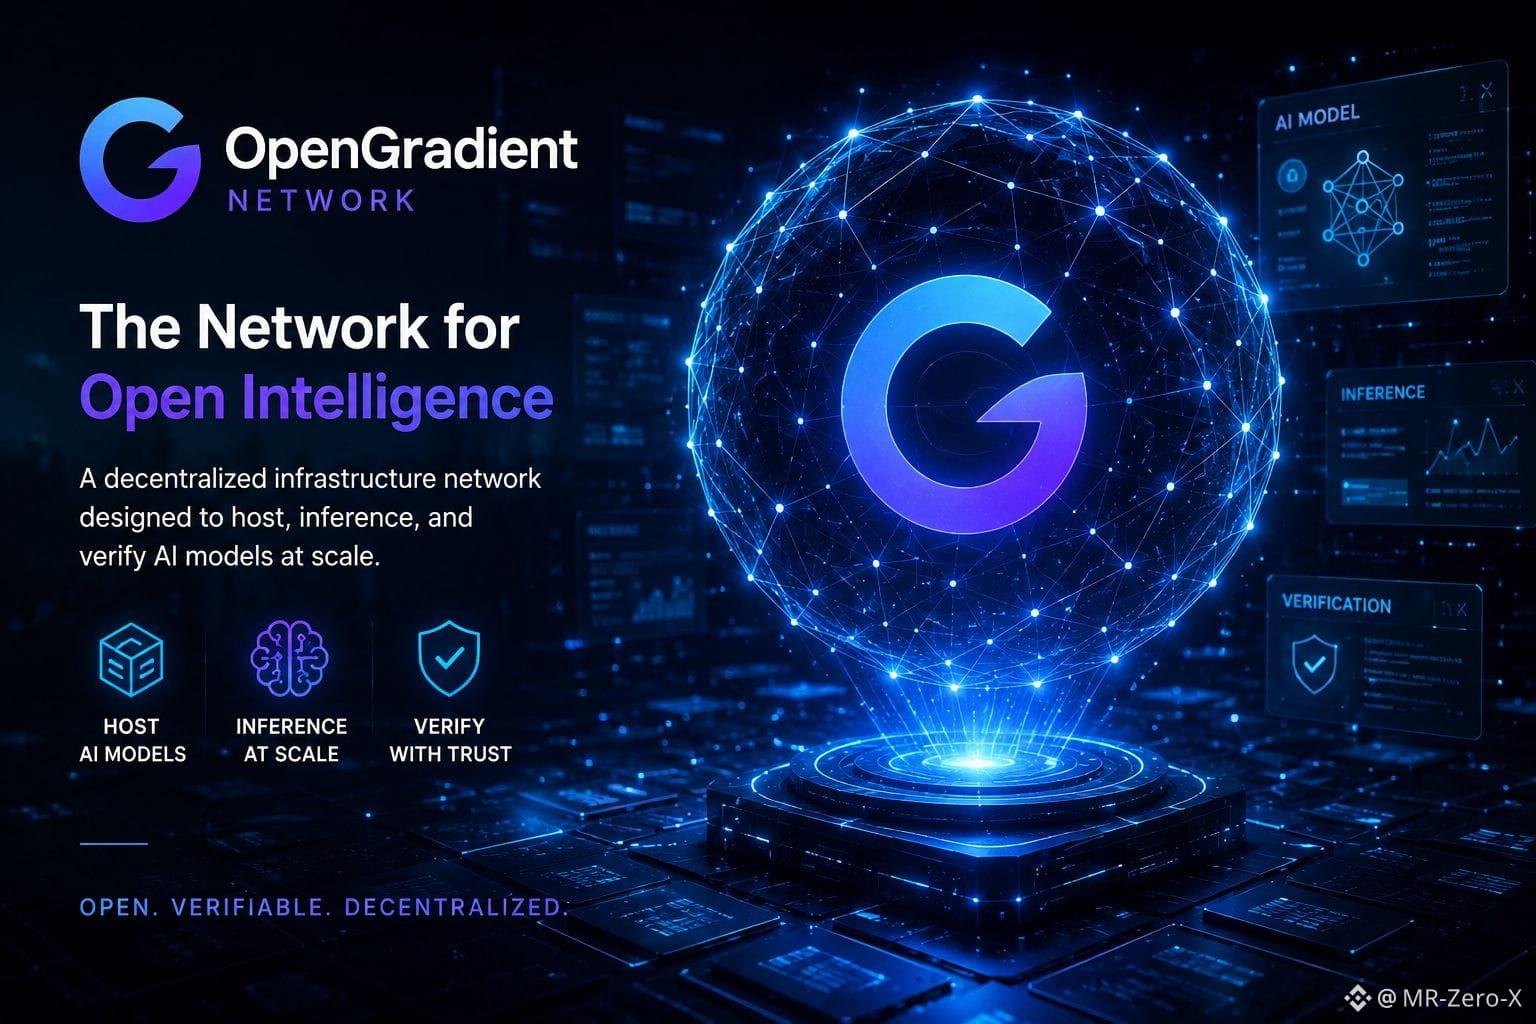
عندما أنظر إلى بنية الذكاء الاصطناعي، لا أكتفي بسؤال ما يمكن أن تفعله نموذج. أطرح أيضًا سؤالًا حول ما إذا كان يمكن التحقق من مخرجاته. تبني OpenGradient شبكة لامركزية مصممة لاستضافة وتشغيل استنتاجات والتحقق من نماذج الذكاء الاصطناعي على نطاق واسع. يبدو أن هذا التركيز يصبح أكثر صلة مع استمرار اعتماد الذكاء الاصطناعي.
لا تزال العديد من أنظمة الذكاء الاصطناعي تعتمد على المستخدمين ببساطة في الثقة بالنتائج التي يتلقونها. هذا يعمل إلى حد ما، ولكن قد يتطلب الاعتماد على المدى الطويل مزيدًا من الشفافية والمساءلة. قد يصبح التحقق جزءًا حاسمًا من بنية الذكاء الاصطناعي بدلاً من ميزة اختيارية.
لا أتعامل مع هذا على أنه مشكلة تم حلها. تبقى القابلية للتوسع، والكفاءة، والاعتماد تحديات مهمة لأي شبكة ذكاء اصطناعي لامركزية. لكن أعتقد أن الاتجاه يستحق الانتباه.
قد يعتمد مستقبل الذكاء الاصطناعي على أكثر من مجرد الذكاء وحده. قد يعتمد أيضًا على ما إذا كان يمكن التحقق من الذكاء والثقة به. لهذا السبب تظل شبكة OpenGradient مشروعًا مثيرًا للاهتمام بالنسبة لي لمتابعته.
@OpenGradient $OPG #OpenGradient
#opg $OPG @OpenGradient
لقد قضيت الكثير من الوقت في دراسة مشاريع الذكاء الاصطناعي، وهناك شيء واحد يبرز لي. معظم المحادثات تركز على الذكاء. الجميع يريد نماذج أكثر ذكاءً، استجابات أسرع، وقدرات أكبر. ولكن مع تحول الذكاء الاصطناعي إلى جزء من الأنظمة الواقعية، أعتقد أن عاملاً آخر يصبح بنفس الأهمية: الثقة.
هذه واحدة من الأسباب التي جعلت شبكة OpenGradient تلفت انتباهي.
عندما أنظر إلى بنية الذكاء الاصطناعي، لا أكتفي بسؤال ما يمكن أن تفعله نموذج. أطرح أيضًا سؤالًا حول ما إذا كان يمكن التحقق من مخرجاته. تبني OpenGradient شبكة لامركزية مصممة لاستضافة وتشغيل استنتاجات والتحقق من نماذج الذكاء الاصطناعي على نطاق واسع. يبدو أن هذا التركيز يصبح أكثر صلة مع استمرار اعتماد الذكاء الاصطناعي.
لا تزال العديد من أنظمة الذكاء الاصطناعي تعتمد على المستخدمين ببساطة في الثقة بالنتائج التي يتلقونها. هذا يعمل إلى حد ما، ولكن قد يتطلب الاعتماد على المدى الطويل مزيدًا من الشفافية والمساءلة. قد يصبح التحقق جزءًا حاسمًا من بنية الذكاء الاصطناعي بدلاً من ميزة اختيارية.
لا أتعامل مع هذا على أنه مشكلة تم حلها. تبقى القابلية للتوسع، والكفاءة، والاعتماد تحديات مهمة لأي شبكة ذكاء اصطناعي لامركزية. لكن أعتقد أن الاتجاه يستحق الانتباه.
قد يعتمد مستقبل الذكاء الاصطناعي على أكثر من مجرد الذكاء وحده. قد يعتمد أيضًا على ما إذا كان يمكن التحقق من الذكاء والثقة به. لهذا السبب تظل شبكة OpenGradient مشروعًا مثيرًا للاهتمام بالنسبة لي لمتابعته.
@OpenGradient $OPG #OpenGradient
لقد قضيت الكثير من الوقت في دراسة مشاريع الذكاء الاصطناعي، وهناك شيء واحد يبرز لي. معظم المحادثات تركز على الذكاء. الجميع يريد نماذج أكثر ذكاءً، استجابات أسرع، وقدرات أكبر. ولكن مع تحول الذكاء الاصطناعي إلى جزء من الأنظمة الواقعية، أعتقد أن عاملاً آخر يصبح بنفس الأهمية: الثقة.
هذه واحدة من الأسباب التي جعلت شبكة OpenGradient تلفت انتباهي.
عندما أنظر إلى بنية الذكاء الاصطناعي، لا أكتفي بسؤال ما يمكن أن تفعله نموذج. أطرح أيضًا سؤالًا حول ما إذا كان يمكن التحقق من مخرجاته. تبني OpenGradient شبكة لامركزية مصممة لاستضافة وتشغيل استنتاجات والتحقق من نماذج الذكاء الاصطناعي على نطاق واسع. يبدو أن هذا التركيز يصبح أكثر صلة مع استمرار اعتماد الذكاء الاصطناعي.
لا تزال العديد من أنظمة الذكاء الاصطناعي تعتمد على المستخدمين ببساطة في الثقة بالنتائج التي يتلقونها. هذا يعمل إلى حد ما، ولكن قد يتطلب الاعتماد على المدى الطويل مزيدًا من الشفافية والمساءلة. قد يصبح التحقق جزءًا حاسمًا من بنية الذكاء الاصطناعي بدلاً من ميزة اختيارية.
لا أتعامل مع هذا على أنه مشكلة تم حلها. تبقى القابلية للتوسع، والكفاءة، والاعتماد تحديات مهمة لأي شبكة ذكاء اصطناعي لامركزية. لكن أعتقد أن الاتجاه يستحق الانتباه.
قد يعتمد مستقبل الذكاء الاصطناعي على أكثر من مجرد الذكاء وحده. قد يعتمد أيضًا على ما إذا كان يمكن التحقق من الذكاء والثقة به. لهذا السبب تظل شبكة OpenGradient مشروعًا مثيرًا للاهتمام بالنسبة لي لمتابعته.
@OpenGradient $OPG #OpenGradient
9
6
291
·
--
#opg $OPG @OpenGradient
ألاحظ أن معظم المحادثات حول الذكاء الاصطناعي تبدأ بنفس الافتراض:
الذكاء هو المورد النادر.
بعد قضاء بعض الوقت في دراسة أنظمة الذكاء الاصطناعي اللامركزية، بدأت أعتقد أن هذا الافتراض قد يكون خاطئًا.
النماذج أصبحت أرخص وأسرع وأكثر وصولًا كل ربع سنة. ما يبقى نادرًا هو شيء أقل مناقشة: التحقق.
تلك الفكرة كانت تتكرر أثناء فحصي لهندسة OpenGradient. معظم أنظمة الذكاء الاصطناعي تطلب من المستخدمين الثقة في المخرجات دون رؤية كيفية حدوث الحساب، من أين جاءت البيانات، أو ما إذا كانت التنفيذ قد حدث كما زُعم. النظام يعمل حتى تبدأ القرارات في حمل عواقب اقتصادية حقيقية.
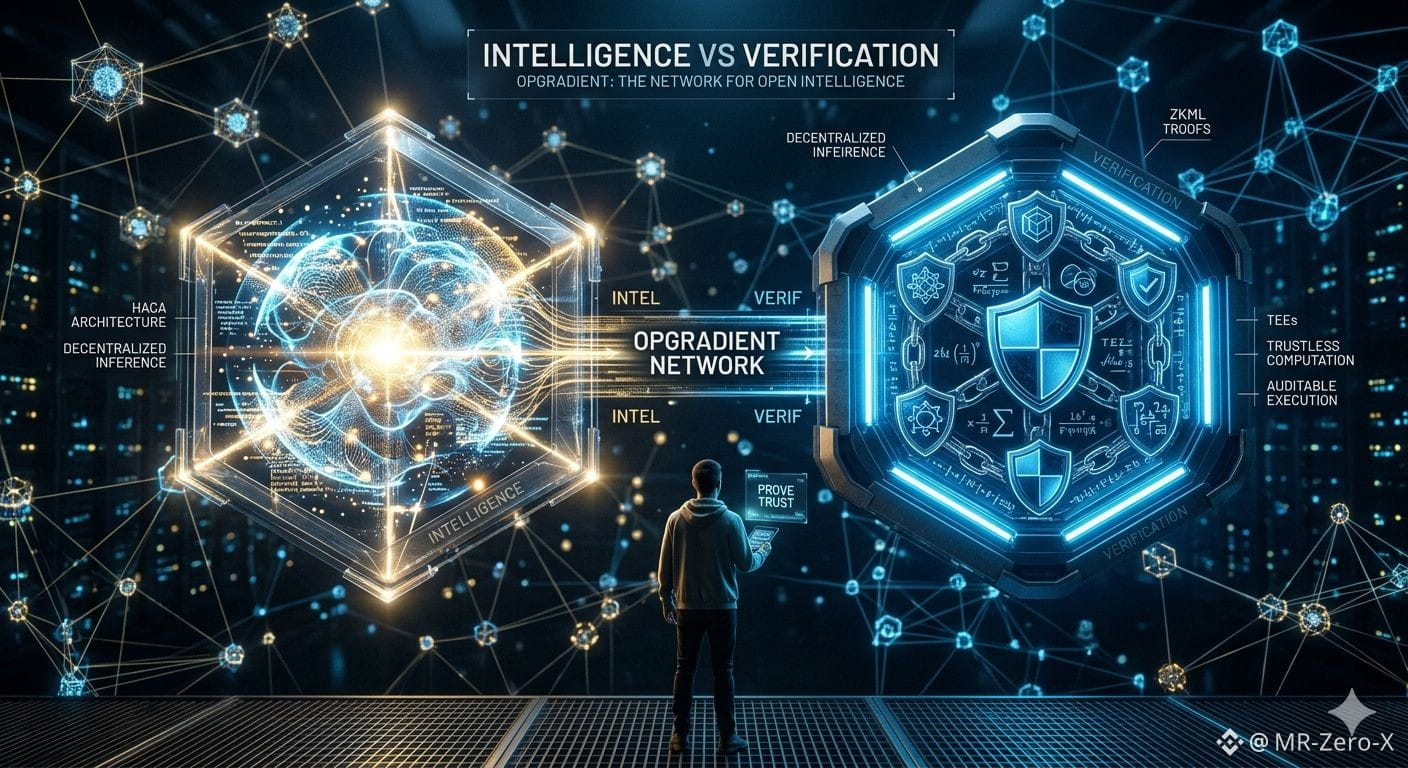
أرى الذكاء الاصطناعي بشكل متزايد من خلال إطار عمل بسيط: الذكاء مقابل التحقق.
الذكاء ينتج إجابات. التحقق ينتج ثقة.
ما يجعل OpenGradient مثيرًا للاهتمام هو أنه لا يحاول بناء نماذج أذكى، بل يستكشف آليات مثل بيئات التنفيذ الموثوقة، zkML، أصول البيانات، والحسابات التي تحافظ على الخصوصية لجعل تنفيذ الذكاء الاصطناعي قابلًا للتدقيق دون الكشف عن كل شيء تحت السطح.
القوة الخفية قد تكون التنسيق. التحقق ينشئ نقطة مرجعية مشتركة بين الأطراف التي لا تعرف أو تثق ببعضها البعض.
التحدي غير المحلول مهم بنفس القدر. أنظمة الإثبات تضيف تكلفة وتعقيد وزمن استجابة. إذا أصبح التحقق مكلفًا جدًا، هل سيظل المستخدمون يطلبونه؟
مع توسع الذكاء الاصطناعي، ما الذي يصبح أكثر قيمة: النموذج الذي يولد إجابة، أم الشبكة التي تثبت أن الإجابة يمكن الوثوق بها؟
$OPG #trades @OpenGradient
#opg $OPG @OpenGradient
ألاحظ أن معظم المحادثات حول الذكاء الاصطناعي تبدأ بنفس الافتراض:
الذكاء هو المورد النادر.
بعد قضاء بعض الوقت في دراسة أنظمة الذكاء الاصطناعي اللامركزية، بدأت أعتقد أن هذا الافتراض قد يكون خاطئًا.
النماذج أصبحت أرخص وأسرع وأكثر وصولًا كل ربع سنة. ما يبقى نادرًا هو شيء أقل مناقشة: التحقق.
تلك الفكرة كانت تتكرر أثناء فحصي لهندسة OpenGradient. معظم أنظمة الذكاء الاصطناعي تطلب من المستخدمين الثقة في المخرجات دون رؤية كيفية حدوث الحساب، من أين جاءت البيانات، أو ما إذا كانت التنفيذ قد حدث كما زُعم. النظام يعمل حتى تبدأ القرارات في حمل عواقب اقتصادية حقيقية.
أرى الذكاء الاصطناعي بشكل متزايد من خلال إطار عمل بسيط: الذكاء مقابل التحقق.
الذكاء ينتج إجابات. التحقق ينتج ثقة.
ما يجعل OpenGradient مثيرًا للاهتمام هو أنه لا يحاول بناء نماذج أذكى، بل يستكشف آليات مثل بيئات التنفيذ الموثوقة، zkML، أصول البيانات، والحسابات التي تحافظ على الخصوصية لجعل تنفيذ الذكاء الاصطناعي قابلًا للتدقيق دون الكشف عن كل شيء تحت السطح.
القوة الخفية قد تكون التنسيق. التحقق ينشئ نقطة مرجعية مشتركة بين الأطراف التي لا تعرف أو تثق ببعضها البعض.
التحدي غير المحلول مهم بنفس القدر. أنظمة الإثبات تضيف تكلفة وتعقيد وزمن استجابة. إذا أصبح التحقق مكلفًا جدًا، هل سيظل المستخدمون يطلبونه؟
مع توسع الذكاء الاصطناعي، ما الذي يصبح أكثر قيمة: النموذج الذي يولد إجابة، أم الشبكة التي تثبت أن الإجابة يمكن الوثوق بها؟
$OPG #trades @OpenGradient
ألاحظ أن معظم المحادثات حول الذكاء الاصطناعي تبدأ بنفس الافتراض:
الذكاء هو المورد النادر.
بعد قضاء بعض الوقت في دراسة أنظمة الذكاء الاصطناعي اللامركزية، بدأت أعتقد أن هذا الافتراض قد يكون خاطئًا.
النماذج أصبحت أرخص وأسرع وأكثر وصولًا كل ربع سنة. ما يبقى نادرًا هو شيء أقل مناقشة: التحقق.
تلك الفكرة كانت تتكرر أثناء فحصي لهندسة OpenGradient. معظم أنظمة الذكاء الاصطناعي تطلب من المستخدمين الثقة في المخرجات دون رؤية كيفية حدوث الحساب، من أين جاءت البيانات، أو ما إذا كانت التنفيذ قد حدث كما زُعم. النظام يعمل حتى تبدأ القرارات في حمل عواقب اقتصادية حقيقية.
أرى الذكاء الاصطناعي بشكل متزايد من خلال إطار عمل بسيط: الذكاء مقابل التحقق.
الذكاء ينتج إجابات. التحقق ينتج ثقة.
ما يجعل OpenGradient مثيرًا للاهتمام هو أنه لا يحاول بناء نماذج أذكى، بل يستكشف آليات مثل بيئات التنفيذ الموثوقة، zkML، أصول البيانات، والحسابات التي تحافظ على الخصوصية لجعل تنفيذ الذكاء الاصطناعي قابلًا للتدقيق دون الكشف عن كل شيء تحت السطح.
القوة الخفية قد تكون التنسيق. التحقق ينشئ نقطة مرجعية مشتركة بين الأطراف التي لا تعرف أو تثق ببعضها البعض.
التحدي غير المحلول مهم بنفس القدر. أنظمة الإثبات تضيف تكلفة وتعقيد وزمن استجابة. إذا أصبح التحقق مكلفًا جدًا، هل سيظل المستخدمون يطلبونه؟
مع توسع الذكاء الاصطناعي، ما الذي يصبح أكثر قيمة: النموذج الذي يولد إجابة، أم الشبكة التي تثبت أن الإجابة يمكن الوثوق بها؟
$OPG #trades @OpenGradient
2
217
·
--
تمّ التحقق
#opg $OPG @OpenGradient
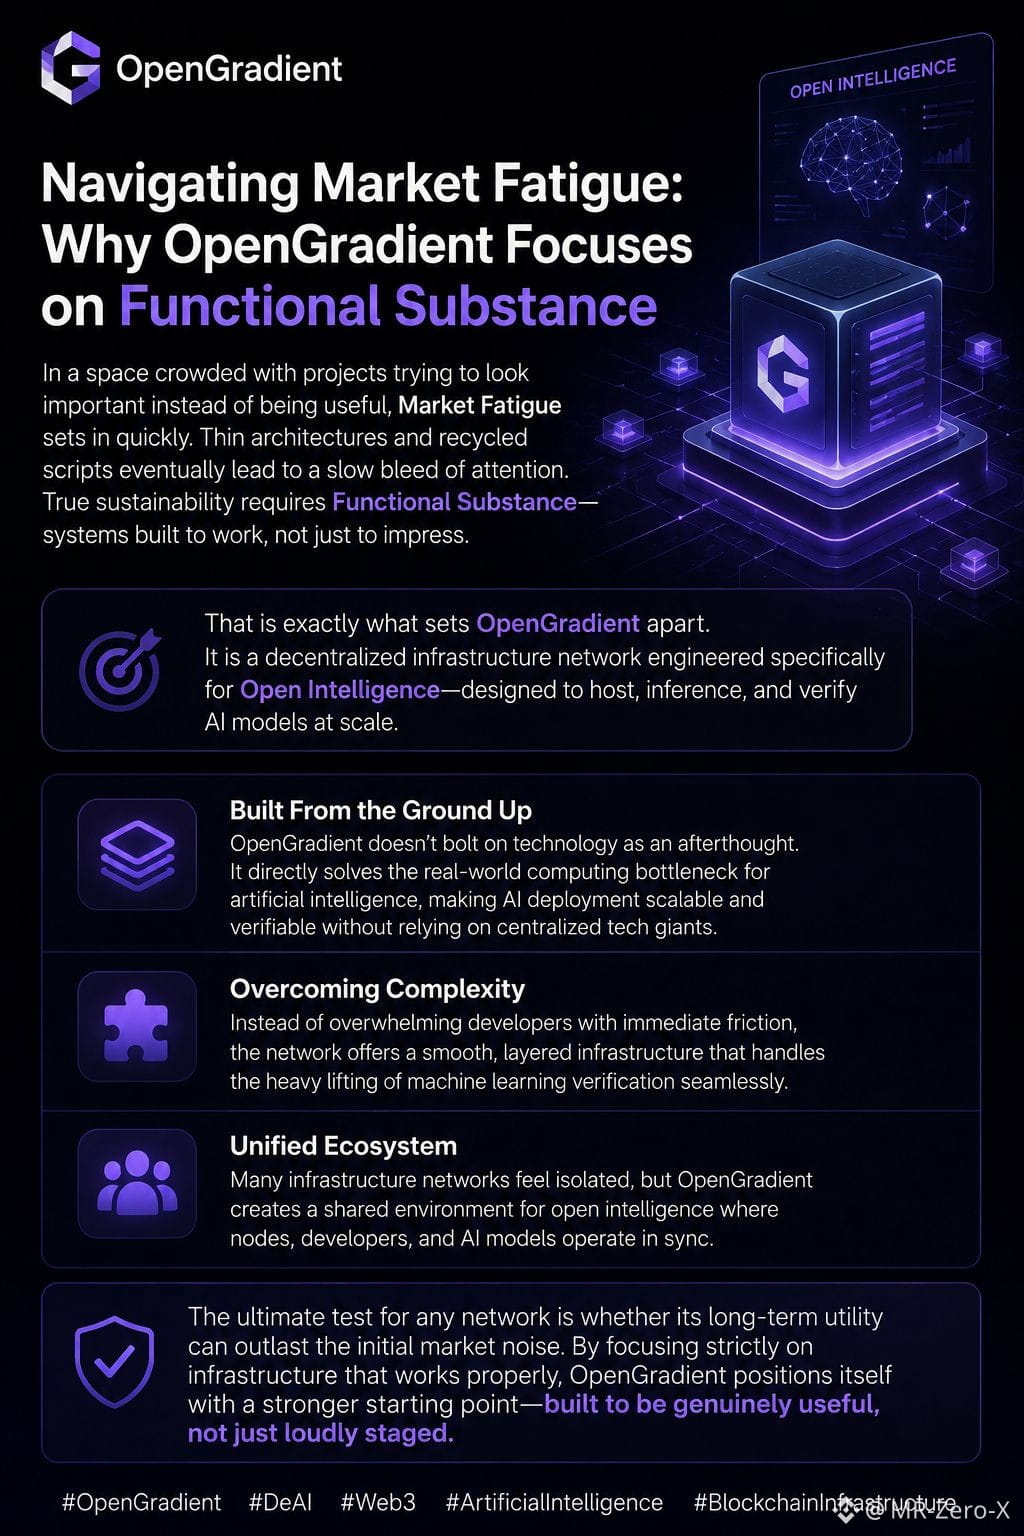
أعتقد أن واحدة من أكبر الأخطاء في عالم الكريبتو الآن هي الخلط بين الرؤية والقيمة.
المشاريع تقضي شهورًا في مطاردة الانتباه، لكن الانتباه وحده لا يخلق الاستدامة.
لهذا السبب لفت انتباهي OpenGradient. بينما تركز العديد من الشبكات على السرد القصصي، فإن OpenGradient تركز على البنية التحتية. الهدف ليس أن تبدو مهمة—بل هو جعل نشر الذكاء الاصطناعي، والاستدلال، والتحقق يعمل فعليًا على نطاق واسع.
$OPG
ما يبرز لي هو أن الشبكة تعالج عنق الزجاجة الحقيقي. بدلاً من الاعتماد على مقدمي الخدمات المركزيين، فإنها تخلق بيئة يمكن فيها للذكاء المفتوح أن يعمل من خلال بنية تحتية لامركزية.
إرهاق السوق يكشف في النهاية عن الأسس الضعيفة. يتلاشى الضجيج. تبقى الفائدة. لهذا السبب أنا مهتم أكثر بالشبكات التي تبني جوهرًا وظيفيًا بدلاً من المشاريع التي تبني حماسًا مؤقتًا.
#OpenGradient #DeAI #Web3 #ArtificialIntelligence
#opg $OPG @OpenGradient
أعتقد أن واحدة من أكبر الأخطاء في عالم الكريبتو الآن هي الخلط بين الرؤية والقيمة.
المشاريع تقضي شهورًا في مطاردة الانتباه، لكن الانتباه وحده لا يخلق الاستدامة.
لهذا السبب لفت انتباهي OpenGradient. بينما تركز العديد من الشبكات على السرد القصصي، فإن OpenGradient تركز على البنية التحتية. الهدف ليس أن تبدو مهمة—بل هو جعل نشر الذكاء الاصطناعي، والاستدلال، والتحقق يعمل فعليًا على نطاق واسع.
$OPG
ما يبرز لي هو أن الشبكة تعالج عنق الزجاجة الحقيقي. بدلاً من الاعتماد على مقدمي الخدمات المركزيين، فإنها تخلق بيئة يمكن فيها للذكاء المفتوح أن يعمل من خلال بنية تحتية لامركزية.
إرهاق السوق يكشف في النهاية عن الأسس الضعيفة. يتلاشى الضجيج. تبقى الفائدة. لهذا السبب أنا مهتم أكثر بالشبكات التي تبني جوهرًا وظيفيًا بدلاً من المشاريع التي تبني حماسًا مؤقتًا.
#OpenGradient #DeAI #Web3 #ArtificialIntelligence
أعتقد أن واحدة من أكبر الأخطاء في عالم الكريبتو الآن هي الخلط بين الرؤية والقيمة.
المشاريع تقضي شهورًا في مطاردة الانتباه، لكن الانتباه وحده لا يخلق الاستدامة.
لهذا السبب لفت انتباهي OpenGradient. بينما تركز العديد من الشبكات على السرد القصصي، فإن OpenGradient تركز على البنية التحتية. الهدف ليس أن تبدو مهمة—بل هو جعل نشر الذكاء الاصطناعي، والاستدلال، والتحقق يعمل فعليًا على نطاق واسع.
$OPG
ما يبرز لي هو أن الشبكة تعالج عنق الزجاجة الحقيقي. بدلاً من الاعتماد على مقدمي الخدمات المركزيين، فإنها تخلق بيئة يمكن فيها للذكاء المفتوح أن يعمل من خلال بنية تحتية لامركزية.
إرهاق السوق يكشف في النهاية عن الأسس الضعيفة. يتلاشى الضجيج. تبقى الفائدة. لهذا السبب أنا مهتم أكثر بالشبكات التي تبني جوهرًا وظيفيًا بدلاً من المشاريع التي تبني حماسًا مؤقتًا.
#OpenGradient #DeAI #Web3 #ArtificialIntelligence
5
3
310
·
--
تمّ التحقق
#opg $OPG
معظم الناس يركزون على نماذج الذكاء الاصطناعي.
أنا أركز أكثر على البنية التحتية التي تدعمها.
لأن التكنولوجيا الرائعة نادراً ما تفوز بناءً على القدرات فقط.
تفوز عندما يستطيع البناؤون استخدامها فعليًا.
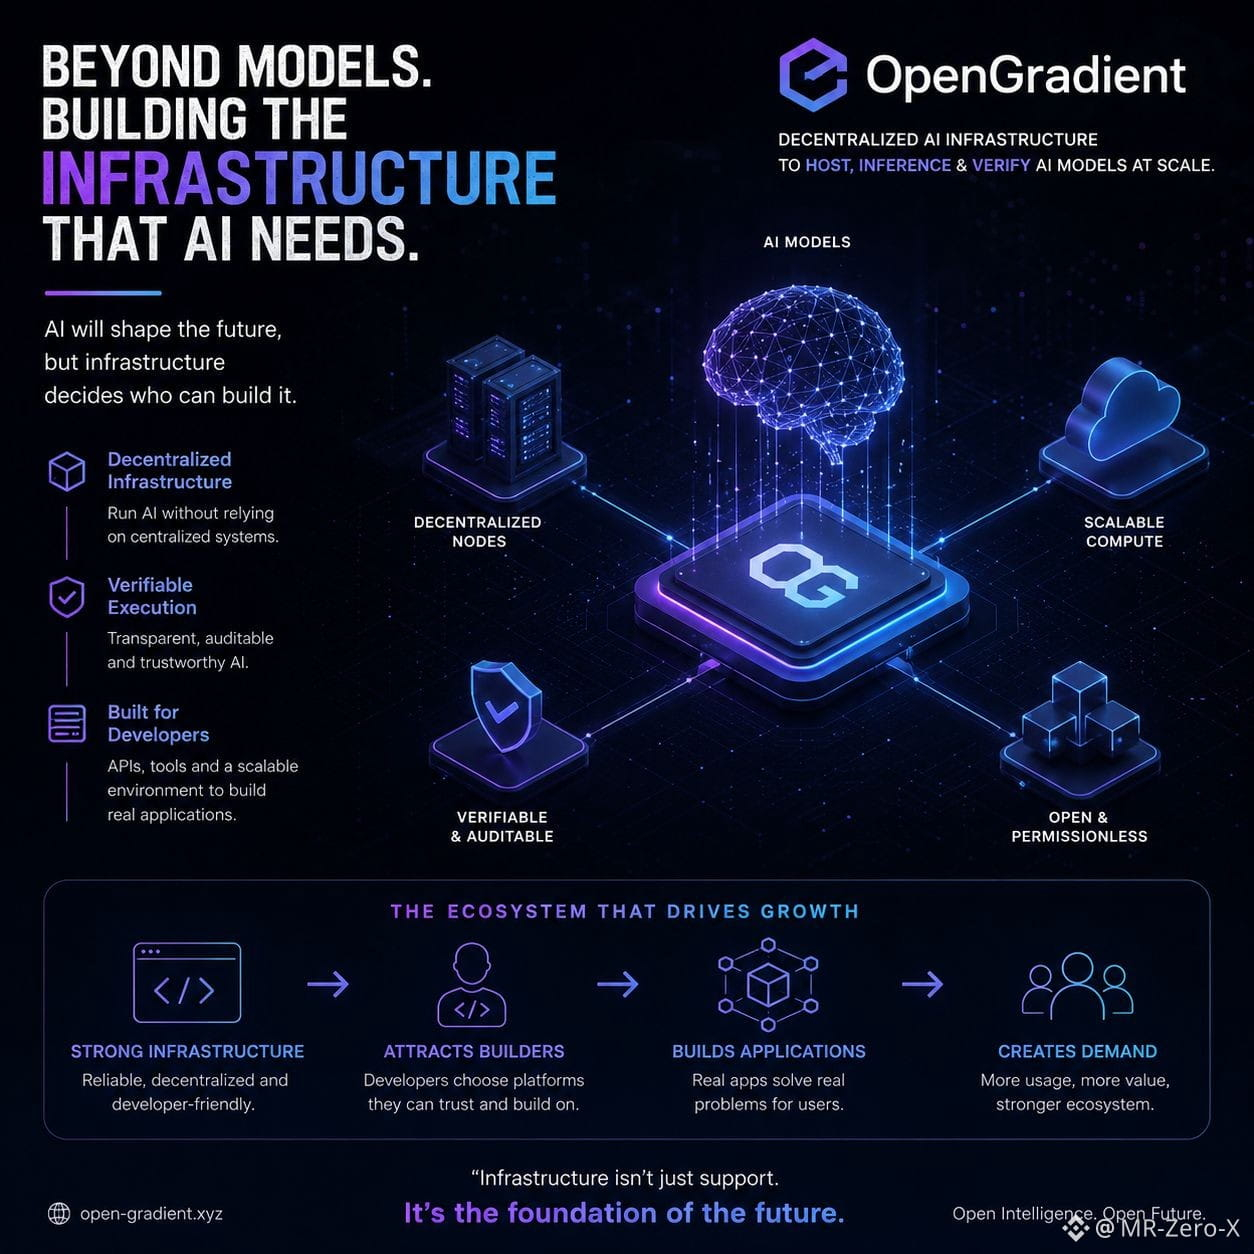
هذه واحدة من الأسباب التي تجعل OpenGradient تهمني.
الكثير من مشاريع الذكاء الاصطناعي تتحدث عن اللامركزية، لكن القليل جداً يركز على جعل نشر الذكاء الاصطناعي عمليًا للمطورين. بدون بنية تحتية قابلة للاستخدام، حتى أفضل الأفكار تكافح للانتقال إلى ما بعد العروض التوضيحية.
ما أجده مثيرًا للاهتمام هو محاولة OpenGradient لإنشاء بيئة يمكن فيها استضافة نماذج الذكاء الاصطناعي، وتنفيذها، والتحقق منها من خلال بنية تحتية لامركزية بدلاً من الاعتماد بالكامل على الأنظمة المركزية.
الاختبار الحقيقي ليس التكنولوجيا نفسها.
إنه ما إذا كان المطورون يختارون البناء عليها.
البنية التحتية القوية تجذب البنائين.
البناؤون يخلقون التطبيقات.
التطبيقات تخلق الطلب.
هذه الدورة هي ما يحول فكرة إلى نظام بيئي.
حتى الآن، هذه هي المقياس الذي أراقبه عن كثب مع OpenGradient.
ليس العناوين.
تقبل المطورين.
#OpenGradient @OpenGradient $OPG
#opg $OPG
معظم الناس يركزون على نماذج الذكاء الاصطناعي.
أنا أركز أكثر على البنية التحتية التي تدعمها.
لأن التكنولوجيا الرائعة نادراً ما تفوز بناءً على القدرات فقط.
تفوز عندما يستطيع البناؤون استخدامها فعليًا.
هذه واحدة من الأسباب التي تجعل OpenGradient تهمني.
الكثير من مشاريع الذكاء الاصطناعي تتحدث عن اللامركزية، لكن القليل جداً يركز على جعل نشر الذكاء الاصطناعي عمليًا للمطورين. بدون بنية تحتية قابلة للاستخدام، حتى أفضل الأفكار تكافح للانتقال إلى ما بعد العروض التوضيحية.
ما أجده مثيرًا للاهتمام هو محاولة OpenGradient لإنشاء بيئة يمكن فيها استضافة نماذج الذكاء الاصطناعي، وتنفيذها، والتحقق منها من خلال بنية تحتية لامركزية بدلاً من الاعتماد بالكامل على الأنظمة المركزية.
الاختبار الحقيقي ليس التكنولوجيا نفسها.
إنه ما إذا كان المطورون يختارون البناء عليها.
البنية التحتية القوية تجذب البنائين.
البناؤون يخلقون التطبيقات.
التطبيقات تخلق الطلب.
هذه الدورة هي ما يحول فكرة إلى نظام بيئي.
حتى الآن، هذه هي المقياس الذي أراقبه عن كثب مع OpenGradient.
ليس العناوين.
تقبل المطورين.
#OpenGradient @OpenGradient $OPG
معظم الناس يركزون على نماذج الذكاء الاصطناعي.
أنا أركز أكثر على البنية التحتية التي تدعمها.
لأن التكنولوجيا الرائعة نادراً ما تفوز بناءً على القدرات فقط.
تفوز عندما يستطيع البناؤون استخدامها فعليًا.
هذه واحدة من الأسباب التي تجعل OpenGradient تهمني.
الكثير من مشاريع الذكاء الاصطناعي تتحدث عن اللامركزية، لكن القليل جداً يركز على جعل نشر الذكاء الاصطناعي عمليًا للمطورين. بدون بنية تحتية قابلة للاستخدام، حتى أفضل الأفكار تكافح للانتقال إلى ما بعد العروض التوضيحية.
ما أجده مثيرًا للاهتمام هو محاولة OpenGradient لإنشاء بيئة يمكن فيها استضافة نماذج الذكاء الاصطناعي، وتنفيذها، والتحقق منها من خلال بنية تحتية لامركزية بدلاً من الاعتماد بالكامل على الأنظمة المركزية.
الاختبار الحقيقي ليس التكنولوجيا نفسها.
إنه ما إذا كان المطورون يختارون البناء عليها.
البنية التحتية القوية تجذب البنائين.
البناؤون يخلقون التطبيقات.
التطبيقات تخلق الطلب.
هذه الدورة هي ما يحول فكرة إلى نظام بيئي.
حتى الآن، هذه هي المقياس الذي أراقبه عن كثب مع OpenGradient.
ليس العناوين.
تقبل المطورين.
#OpenGradient @OpenGradient $OPG
1
181
·
--
تمّ التحقق
#opg $OPG
OpenGradient $OPG:
فصل الضجيج عن الذكاء التنفيذي.
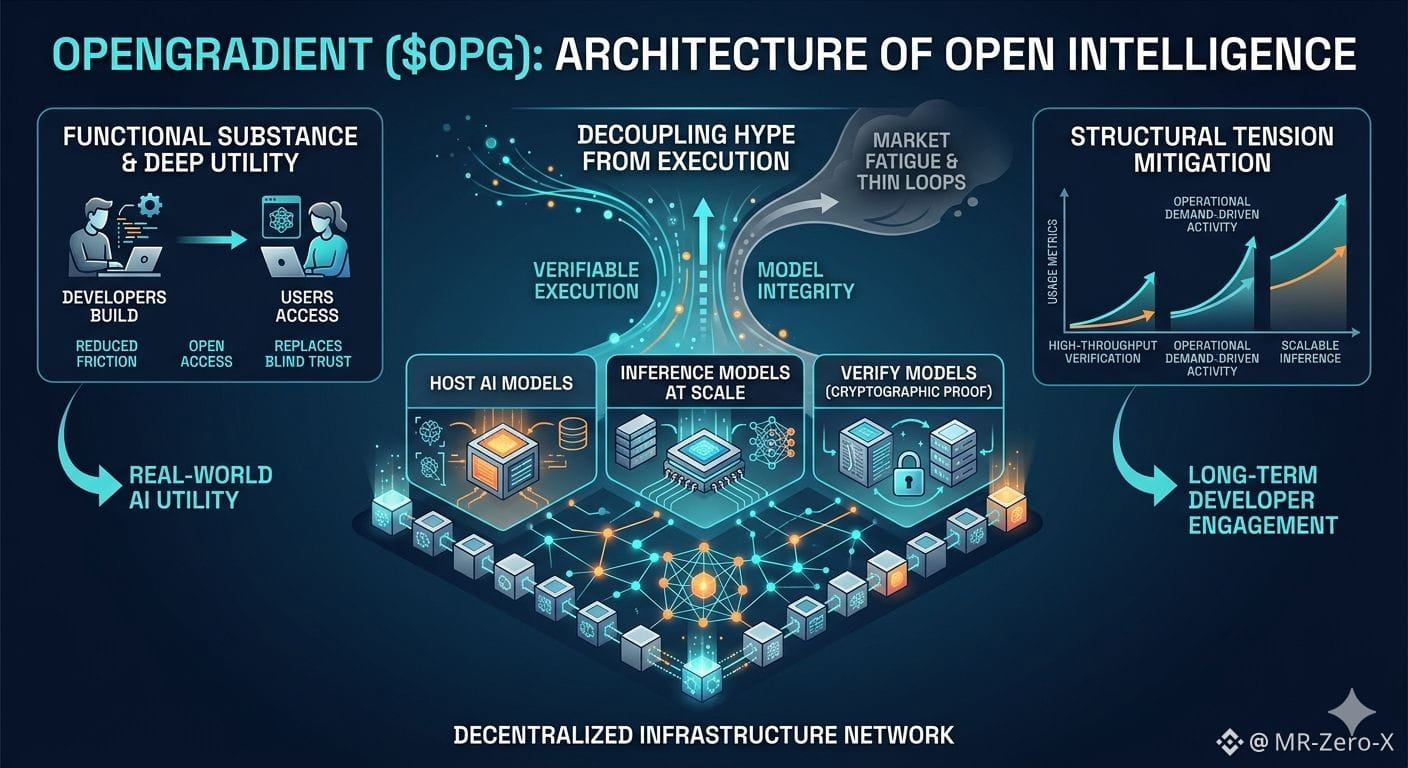
يعاني مشهد بنية تحتية Web3 من إرهاق سوق حاد. نحن غارقون في شبكات تتظاهر بأهمية تقنية - ثقيلة على العروض المدفوعة بالتوكن، ولكنها رقيقة بشكل ملحوظ من حيث الجوهر الوظيفي. عندما تنظر تحت السطح للعديد من منصات الذكاء الاصطناعي اللامركزية (DeAI)، تكون البنية هشة، تعتمد على افتراضات ثقة مركزية أو حلقات حساب غير فعالة تنهار تحت الطلب الحقيقي.
تتميز OpenGradient ($OPG) لأنها تتجنب هذا السيناريو المعاد تدويره. إنها ليست مبنية بشكل عكسي؛ تركز الشبكة تمامًا على العمل بشكل صحيح في طبقة التنفيذ الأساسية. تم تصميمها كشبكة بنية تحتية لامركزية لاستضافة، واستنتاج، والتحقق من نماذج الذكاء الاصطناعي على نطاق واسع. تستبدل OpenGradient الثقة العمياء باليقين التشفيري. بدلاً من إجبار المطورين على الدخول في بيئات صعبة وغير محسّنة، تقدم بنية حساب هجينة حيث يمكن التحقق من سلامة النموذج والتنفيذ سلس.
ما يمنع إرهاق السوق هنا هو التوازن بين الفائدة الخام والاستدامة الهيكلية. من خلال تقليل الاحتكاك المطلوب لنشر والتفاعل مع الذكاء المفتوح، $OPG تضمن أن نشاط الشبكة مدفوع بطلب عمليات حقيقي بدلاً من حلقات حوافز مصطنعة. إنها تخلق بيئة حيث يبدو أن الذكاء الاصطناعي اللامركزي أداة صناعية قوية بدلاً من تجربة مرتبة.
الاختبار الحقيقي لأي بنية تحتية لـ DeAI هو التوتر الهيكلي: هل يمكن للشبكة الحفاظ على التحقق عالي الإنتاجية دون تأخير كبير؟ بينما تنهار العديد من المشاريع تحت الاستخدام المستمر، يوفر تركيز OpenGradient على الاستنتاج القابل للتوسع والقابل للتحقق الأساس التقني العميق المطلوب للحفاظ على مشاركة المطورين على المدى الطويل. إنها لا تحاول جاهدة التأثير بثرثرة سردية، بل تركز على الذكاء التنفيذي.
@OpenGradient $OPG #OpenGradient
#opg $OPG
OpenGradient $OPG :
فصل الضجيج عن الذكاء التنفيذي.
يعاني مشهد بنية تحتية Web3 من إرهاق سوق حاد. نحن غارقون في شبكات تتظاهر بأهمية تقنية - ثقيلة على العروض المدفوعة بالتوكن، ولكنها رقيقة بشكل ملحوظ من حيث الجوهر الوظيفي. عندما تنظر تحت السطح للعديد من منصات الذكاء الاصطناعي اللامركزية (DeAI)، تكون البنية هشة، تعتمد على افتراضات ثقة مركزية أو حلقات حساب غير فعالة تنهار تحت الطلب الحقيقي.
تتميز OpenGradient ($OPG ) لأنها تتجنب هذا السيناريو المعاد تدويره. إنها ليست مبنية بشكل عكسي؛ تركز الشبكة تمامًا على العمل بشكل صحيح في طبقة التنفيذ الأساسية. تم تصميمها كشبكة بنية تحتية لامركزية لاستضافة، واستنتاج، والتحقق من نماذج الذكاء الاصطناعي على نطاق واسع. تستبدل OpenGradient الثقة العمياء باليقين التشفيري. بدلاً من إجبار المطورين على الدخول في بيئات صعبة وغير محسّنة، تقدم بنية حساب هجينة حيث يمكن التحقق من سلامة النموذج والتنفيذ سلس.
ما يمنع إرهاق السوق هنا هو التوازن بين الفائدة الخام والاستدامة الهيكلية. من خلال تقليل الاحتكاك المطلوب لنشر والتفاعل مع الذكاء المفتوح، $OPG تضمن أن نشاط الشبكة مدفوع بطلب عمليات حقيقي بدلاً من حلقات حوافز مصطنعة. إنها تخلق بيئة حيث يبدو أن الذكاء الاصطناعي اللامركزي أداة صناعية قوية بدلاً من تجربة مرتبة.
الاختبار الحقيقي لأي بنية تحتية لـ DeAI هو التوتر الهيكلي: هل يمكن للشبكة الحفاظ على التحقق عالي الإنتاجية دون تأخير كبير؟ بينما تنهار العديد من المشاريع تحت الاستخدام المستمر، يوفر تركيز OpenGradient على الاستنتاج القابل للتوسع والقابل للتحقق الأساس التقني العميق المطلوب للحفاظ على مشاركة المطورين على المدى الطويل. إنها لا تحاول جاهدة التأثير بثرثرة سردية، بل تركز على الذكاء التنفيذي.
@OpenGradient $OPG #OpenGradient
OpenGradient $OPG :
فصل الضجيج عن الذكاء التنفيذي.
يعاني مشهد بنية تحتية Web3 من إرهاق سوق حاد. نحن غارقون في شبكات تتظاهر بأهمية تقنية - ثقيلة على العروض المدفوعة بالتوكن، ولكنها رقيقة بشكل ملحوظ من حيث الجوهر الوظيفي. عندما تنظر تحت السطح للعديد من منصات الذكاء الاصطناعي اللامركزية (DeAI)، تكون البنية هشة، تعتمد على افتراضات ثقة مركزية أو حلقات حساب غير فعالة تنهار تحت الطلب الحقيقي.
تتميز OpenGradient ($OPG ) لأنها تتجنب هذا السيناريو المعاد تدويره. إنها ليست مبنية بشكل عكسي؛ تركز الشبكة تمامًا على العمل بشكل صحيح في طبقة التنفيذ الأساسية. تم تصميمها كشبكة بنية تحتية لامركزية لاستضافة، واستنتاج، والتحقق من نماذج الذكاء الاصطناعي على نطاق واسع. تستبدل OpenGradient الثقة العمياء باليقين التشفيري. بدلاً من إجبار المطورين على الدخول في بيئات صعبة وغير محسّنة، تقدم بنية حساب هجينة حيث يمكن التحقق من سلامة النموذج والتنفيذ سلس.
ما يمنع إرهاق السوق هنا هو التوازن بين الفائدة الخام والاستدامة الهيكلية. من خلال تقليل الاحتكاك المطلوب لنشر والتفاعل مع الذكاء المفتوح، $OPG تضمن أن نشاط الشبكة مدفوع بطلب عمليات حقيقي بدلاً من حلقات حوافز مصطنعة. إنها تخلق بيئة حيث يبدو أن الذكاء الاصطناعي اللامركزي أداة صناعية قوية بدلاً من تجربة مرتبة.
الاختبار الحقيقي لأي بنية تحتية لـ DeAI هو التوتر الهيكلي: هل يمكن للشبكة الحفاظ على التحقق عالي الإنتاجية دون تأخير كبير؟ بينما تنهار العديد من المشاريع تحت الاستخدام المستمر، يوفر تركيز OpenGradient على الاستنتاج القابل للتوسع والقابل للتحقق الأساس التقني العميق المطلوب للحفاظ على مشاركة المطورين على المدى الطويل. إنها لا تحاول جاهدة التأثير بثرثرة سردية، بل تركز على الذكاء التنفيذي.
@OpenGradient $OPG #OpenGradient
9
1
260
·
--
تمّ التحقق
#opg $OPG لقد شاهدت السرد حول "DeAI" يتحول إلى مجرد لعبة تسويقية.
تدعي معظم المشاريع الذكاء الاصطناعي اللامركزي، لكن الاستنتاج الفعلي لا يزال يعمل من خلال واجهات برمجة التطبيقات المركزية Web2. أضف رمزًا، أنشئ ضجة، وكرر.
@OpenGradient لفتت انتباهي لأنها تهاجم المشكلة الحقيقية: الحوسبة.
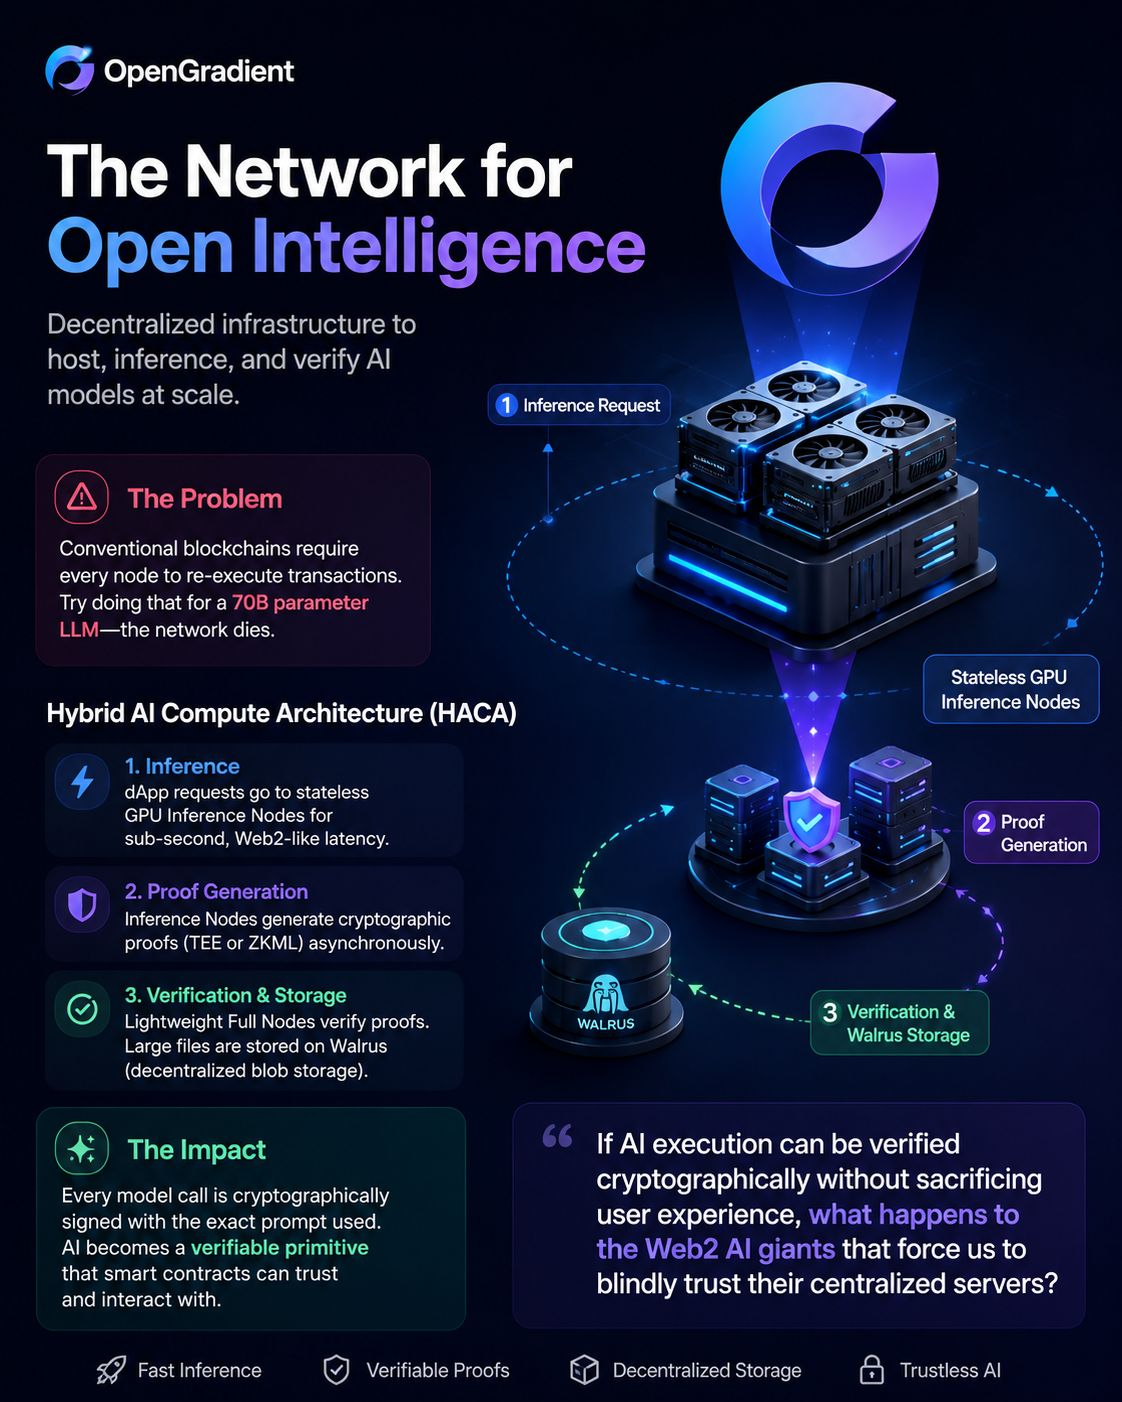
تتطلب سلاسل الكتل التقليدية من كل عقدة إعادة تنفيذ المعاملات. ينكسر هذا النموذج تمامًا عند التعامل مع أنظمة الذكاء الاصطناعي الكبيرة. لا أحد يقوم بتشغيل LLM بـ 70 مليار معلمة عبر كل مدقق دون تدمير الأداء.
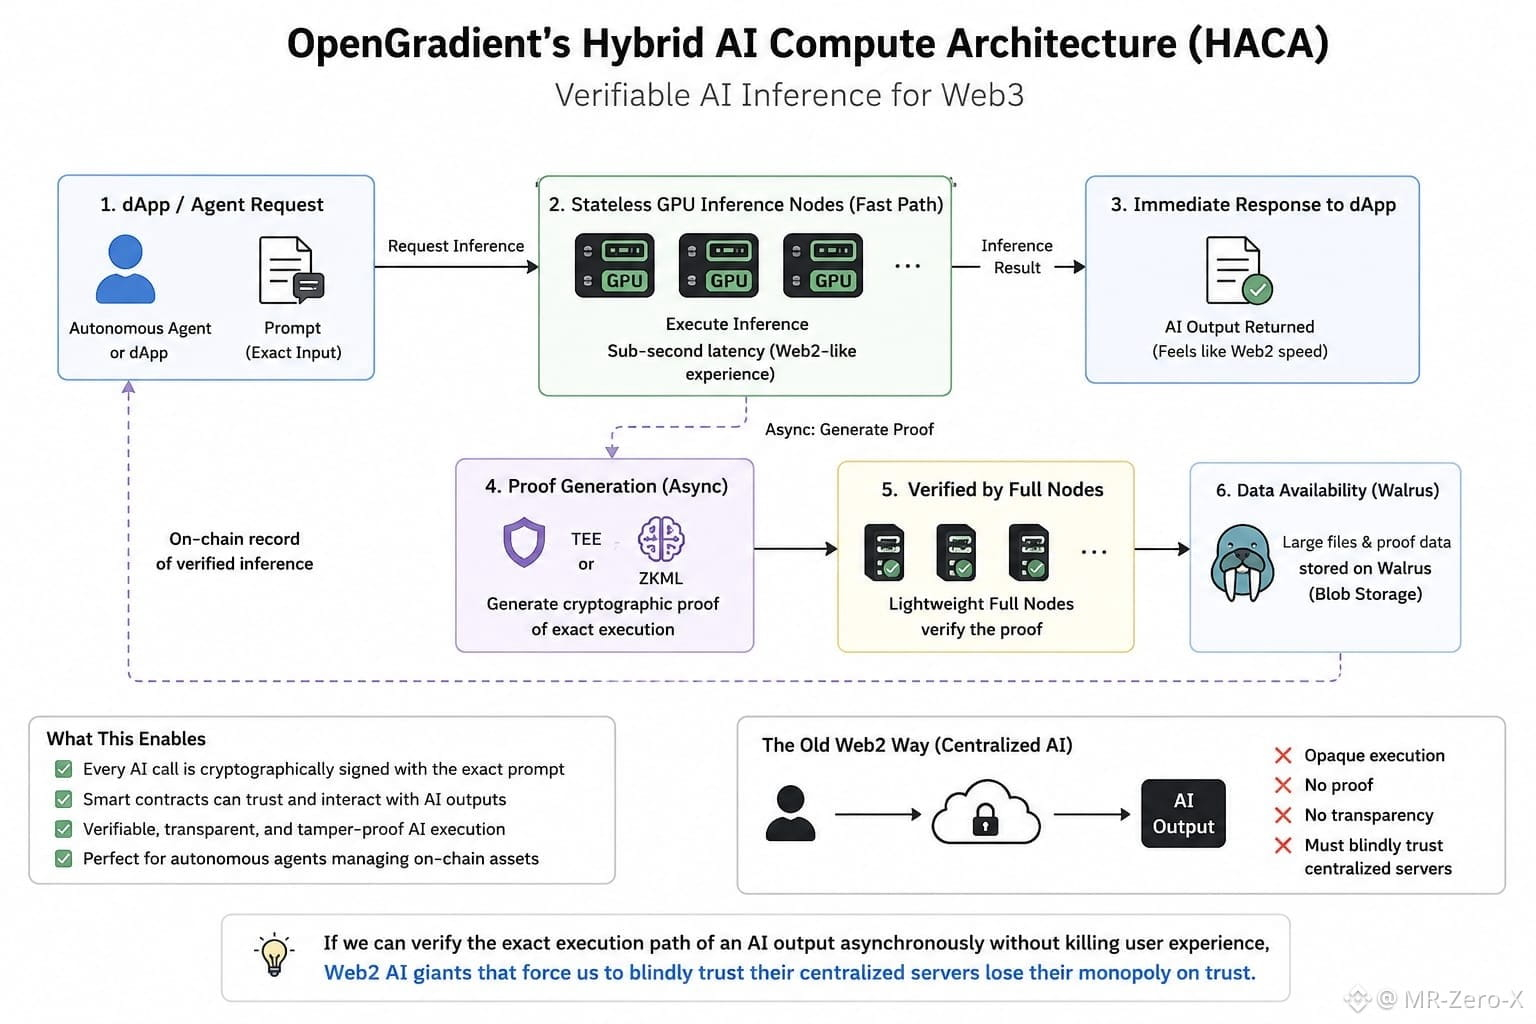
معمارية الحوسبة الهجينة للذكاء الاصطناعي (HACA) تتبنى نهجًا مختلفًا.
يتم معالجة طلبات الاستنتاج مباشرة بواسطة عقد GPU غير الحالة، مما يوفر زمن انتقال قريب من مستوى Web2. في الوقت نفسه، يتم إنشاء الأدلة التشفيرية (TEE أو ZKML) بشكل غير متزامن ويتم التحقق منها بواسطة عقد كاملة خفيفة الوزن، بينما يتم تخزين الكائنات الكبيرة عبر Walrus.
النتيجة؟
تصبح مخرجات الذكاء الاصطناعي قابلة للتحقق.
يمكن ربط كل استدعاء نموذج بتشفير بالطلب الدقيق وبيئة التنفيذ المستخدمة. بدلاً من الثقة في أوراكل صندوق أسود لاتخاذ القرارات أو تحريك الأصول، تكتسب العقود الذكية وسيلة للتحقق من سلوك الذكاء الاصطناعي.
هذا تغيير كبير لوكلاء مستقلين وتطبيقات الذكاء الاصطناعي على السلسلة.
ما زلت مهتمًا برؤية كيفية أداء الشبكة تحت الطلب المتزامن المستمر، لكن المعمارية تبدو مركزة على الفائدة بدلاً من السرد.
السؤال الأكبر هو:
إذا كان يمكن التحقق من تنفيذ الذكاء الاصطناعي تشفيرياً دون التضحية بتجربة المستخدم، ماذا يحدث لمنصات الذكاء الاصطناعي المركزية التي تعتمد تمامًا على الثقة؟
OpenGradient تبني بنية تحتية لامركزية لاستضافة وتشغيل والتحقق من نماذج الذكاء الاصطناعي على نطاق واسع.
$OPG #OpenGradient @OpenGradient
#opg $OPG لقد شاهدت السرد حول "DeAI" يتحول إلى مجرد لعبة تسويقية.
تدعي معظم المشاريع الذكاء الاصطناعي اللامركزي، لكن الاستنتاج الفعلي لا يزال يعمل من خلال واجهات برمجة التطبيقات المركزية Web2. أضف رمزًا، أنشئ ضجة، وكرر.
@OpenGradient لفتت انتباهي لأنها تهاجم المشكلة الحقيقية: الحوسبة.
تتطلب سلاسل الكتل التقليدية من كل عقدة إعادة تنفيذ المعاملات. ينكسر هذا النموذج تمامًا عند التعامل مع أنظمة الذكاء الاصطناعي الكبيرة. لا أحد يقوم بتشغيل LLM بـ 70 مليار معلمة عبر كل مدقق دون تدمير الأداء.
معمارية الحوسبة الهجينة للذكاء الاصطناعي (HACA) تتبنى نهجًا مختلفًا.
يتم معالجة طلبات الاستنتاج مباشرة بواسطة عقد GPU غير الحالة، مما يوفر زمن انتقال قريب من مستوى Web2. في الوقت نفسه، يتم إنشاء الأدلة التشفيرية (TEE أو ZKML) بشكل غير متزامن ويتم التحقق منها بواسطة عقد كاملة خفيفة الوزن، بينما يتم تخزين الكائنات الكبيرة عبر Walrus.
النتيجة؟
تصبح مخرجات الذكاء الاصطناعي قابلة للتحقق.
يمكن ربط كل استدعاء نموذج بتشفير بالطلب الدقيق وبيئة التنفيذ المستخدمة. بدلاً من الثقة في أوراكل صندوق أسود لاتخاذ القرارات أو تحريك الأصول، تكتسب العقود الذكية وسيلة للتحقق من سلوك الذكاء الاصطناعي.
هذا تغيير كبير لوكلاء مستقلين وتطبيقات الذكاء الاصطناعي على السلسلة.
ما زلت مهتمًا برؤية كيفية أداء الشبكة تحت الطلب المتزامن المستمر، لكن المعمارية تبدو مركزة على الفائدة بدلاً من السرد.
السؤال الأكبر هو:
إذا كان يمكن التحقق من تنفيذ الذكاء الاصطناعي تشفيرياً دون التضحية بتجربة المستخدم، ماذا يحدث لمنصات الذكاء الاصطناعي المركزية التي تعتمد تمامًا على الثقة؟
OpenGradient تبني بنية تحتية لامركزية لاستضافة وتشغيل والتحقق من نماذج الذكاء الاصطناعي على نطاق واسع.
$OPG #OpenGradient @OpenGradient
تدعي معظم المشاريع الذكاء الاصطناعي اللامركزي، لكن الاستنتاج الفعلي لا يزال يعمل من خلال واجهات برمجة التطبيقات المركزية Web2. أضف رمزًا، أنشئ ضجة، وكرر.
@OpenGradient لفتت انتباهي لأنها تهاجم المشكلة الحقيقية: الحوسبة.
تتطلب سلاسل الكتل التقليدية من كل عقدة إعادة تنفيذ المعاملات. ينكسر هذا النموذج تمامًا عند التعامل مع أنظمة الذكاء الاصطناعي الكبيرة. لا أحد يقوم بتشغيل LLM بـ 70 مليار معلمة عبر كل مدقق دون تدمير الأداء.
معمارية الحوسبة الهجينة للذكاء الاصطناعي (HACA) تتبنى نهجًا مختلفًا.
يتم معالجة طلبات الاستنتاج مباشرة بواسطة عقد GPU غير الحالة، مما يوفر زمن انتقال قريب من مستوى Web2. في الوقت نفسه، يتم إنشاء الأدلة التشفيرية (TEE أو ZKML) بشكل غير متزامن ويتم التحقق منها بواسطة عقد كاملة خفيفة الوزن، بينما يتم تخزين الكائنات الكبيرة عبر Walrus.
النتيجة؟
تصبح مخرجات الذكاء الاصطناعي قابلة للتحقق.
يمكن ربط كل استدعاء نموذج بتشفير بالطلب الدقيق وبيئة التنفيذ المستخدمة. بدلاً من الثقة في أوراكل صندوق أسود لاتخاذ القرارات أو تحريك الأصول، تكتسب العقود الذكية وسيلة للتحقق من سلوك الذكاء الاصطناعي.
هذا تغيير كبير لوكلاء مستقلين وتطبيقات الذكاء الاصطناعي على السلسلة.
ما زلت مهتمًا برؤية كيفية أداء الشبكة تحت الطلب المتزامن المستمر، لكن المعمارية تبدو مركزة على الفائدة بدلاً من السرد.
السؤال الأكبر هو:
إذا كان يمكن التحقق من تنفيذ الذكاء الاصطناعي تشفيرياً دون التضحية بتجربة المستخدم، ماذا يحدث لمنصات الذكاء الاصطناعي المركزية التي تعتمد تمامًا على الثقة؟
OpenGradient تبني بنية تحتية لامركزية لاستضافة وتشغيل والتحقق من نماذج الذكاء الاصطناعي على نطاق واسع.
$OPG #OpenGradient @OpenGradient
1
385
·
--
تمّ التحقق
#opg $OPG لقد شاهدت قطاع "DeAI" يتحول إلى تمرين تسويقي مكلف. الفرق تعد بتقديم استدلال لامركزي لكنهم فقط يقومون بتوجيه الطلبات إلى واجهات برمجة التطبيقات Web2 بينما يضعون فوقها رمز ERC-20 لإحداث ضجة. إنه حلقة فارغة.
@OpenGradient يبدو مختلفًا لأنه يتعامل مع عنق الزجاجة في الحوسبة. الشبكات التقليدية تجبر كل عقدة على إعادة تنفيذ المعاملات—جرب ذلك مع نموذج LLM بـ 70 مليار معلمة والشبكة ستنهار.
بنيتهم التحتية الهجينة لحوسبة الذكاء الاصطناعي (HACA) تقسم الحمل. عندما تطلب dApp استدلالًا، تذهب مباشرة إلى عقد استدلال GPU بدون حالة للحصول على زمن استجابة أقل من ثانية، مثل Web2. بشكل غير متزامن، تولد العقدة دليلًا تشفيرياً (TEE أو ZKML) يتم التحقق منه بواسطة عقد كاملة خفيفة الوزن، مما يخفف الملفات الثقيلة إلى تخزين Walrus.
هذا يغير كل شيء بالنسبة للوكلاء المستقلين. بدلاً من الثقة العمياء في Oracle غير الشفاف لنقل أموال الخزانة، يتم توقيع كل استدعاء نموذج تشفيرياً مع الطلب المستخدم بالضبط. إنه يحول التعلم الآلي إلى عنصر يمكن التحقق منه يمكن للعقود الذكية التفاعل معه بشكل طبيعي.
أنا أراقب كيف يتعامل مع ذروة المرور تحت أحمال متزامنة ثقيلة، لكن الأساس الهيكلي مبني بالفعل من أجل الفائدة بدلاً من الضوضاء.
إذا استطعنا التحقق من مسار التنفيذ الدقيق لمخرجات الذكاء الاصطناعي بشكل غير متزامن دون قتل تجربة المستخدم، ماذا سيحدث لعمالقة الذكاء الاصطناعي في Web2 الذين يجبروننا على الثقة عمياء في خوادمهم المركزية؟
@OpenGradient #opg
#opg $OPG لقد شاهدت قطاع "DeAI" يتحول إلى تمرين تسويقي مكلف. الفرق تعد بتقديم استدلال لامركزي لكنهم فقط يقومون بتوجيه الطلبات إلى واجهات برمجة التطبيقات Web2 بينما يضعون فوقها رمز ERC-20 لإحداث ضجة. إنه حلقة فارغة.
@OpenGradient يبدو مختلفًا لأنه يتعامل مع عنق الزجاجة في الحوسبة. الشبكات التقليدية تجبر كل عقدة على إعادة تنفيذ المعاملات—جرب ذلك مع نموذج LLM بـ 70 مليار معلمة والشبكة ستنهار.
بنيتهم التحتية الهجينة لحوسبة الذكاء الاصطناعي (HACA) تقسم الحمل. عندما تطلب dApp استدلالًا، تذهب مباشرة إلى عقد استدلال GPU بدون حالة للحصول على زمن استجابة أقل من ثانية، مثل Web2. بشكل غير متزامن، تولد العقدة دليلًا تشفيرياً (TEE أو ZKML) يتم التحقق منه بواسطة عقد كاملة خفيفة الوزن، مما يخفف الملفات الثقيلة إلى تخزين Walrus.
هذا يغير كل شيء بالنسبة للوكلاء المستقلين. بدلاً من الثقة العمياء في Oracle غير الشفاف لنقل أموال الخزانة، يتم توقيع كل استدعاء نموذج تشفيرياً مع الطلب المستخدم بالضبط. إنه يحول التعلم الآلي إلى عنصر يمكن التحقق منه يمكن للعقود الذكية التفاعل معه بشكل طبيعي.
أنا أراقب كيف يتعامل مع ذروة المرور تحت أحمال متزامنة ثقيلة، لكن الأساس الهيكلي مبني بالفعل من أجل الفائدة بدلاً من الضوضاء.
إذا استطعنا التحقق من مسار التنفيذ الدقيق لمخرجات الذكاء الاصطناعي بشكل غير متزامن دون قتل تجربة المستخدم، ماذا سيحدث لعمالقة الذكاء الاصطناعي في Web2 الذين يجبروننا على الثقة عمياء في خوادمهم المركزية؟
@OpenGradient #opg
@OpenGradient يبدو مختلفًا لأنه يتعامل مع عنق الزجاجة في الحوسبة. الشبكات التقليدية تجبر كل عقدة على إعادة تنفيذ المعاملات—جرب ذلك مع نموذج LLM بـ 70 مليار معلمة والشبكة ستنهار.
بنيتهم التحتية الهجينة لحوسبة الذكاء الاصطناعي (HACA) تقسم الحمل. عندما تطلب dApp استدلالًا، تذهب مباشرة إلى عقد استدلال GPU بدون حالة للحصول على زمن استجابة أقل من ثانية، مثل Web2. بشكل غير متزامن، تولد العقدة دليلًا تشفيرياً (TEE أو ZKML) يتم التحقق منه بواسطة عقد كاملة خفيفة الوزن، مما يخفف الملفات الثقيلة إلى تخزين Walrus.
هذا يغير كل شيء بالنسبة للوكلاء المستقلين. بدلاً من الثقة العمياء في Oracle غير الشفاف لنقل أموال الخزانة، يتم توقيع كل استدعاء نموذج تشفيرياً مع الطلب المستخدم بالضبط. إنه يحول التعلم الآلي إلى عنصر يمكن التحقق منه يمكن للعقود الذكية التفاعل معه بشكل طبيعي.
أنا أراقب كيف يتعامل مع ذروة المرور تحت أحمال متزامنة ثقيلة، لكن الأساس الهيكلي مبني بالفعل من أجل الفائدة بدلاً من الضوضاء.
إذا استطعنا التحقق من مسار التنفيذ الدقيق لمخرجات الذكاء الاصطناعي بشكل غير متزامن دون قتل تجربة المستخدم، ماذا سيحدث لعمالقة الذكاء الاصطناعي في Web2 الذين يجبروننا على الثقة عمياء في خوادمهم المركزية؟
@OpenGradient #opg
207
·
--
#genius $GENIUS @GeniusOfficial
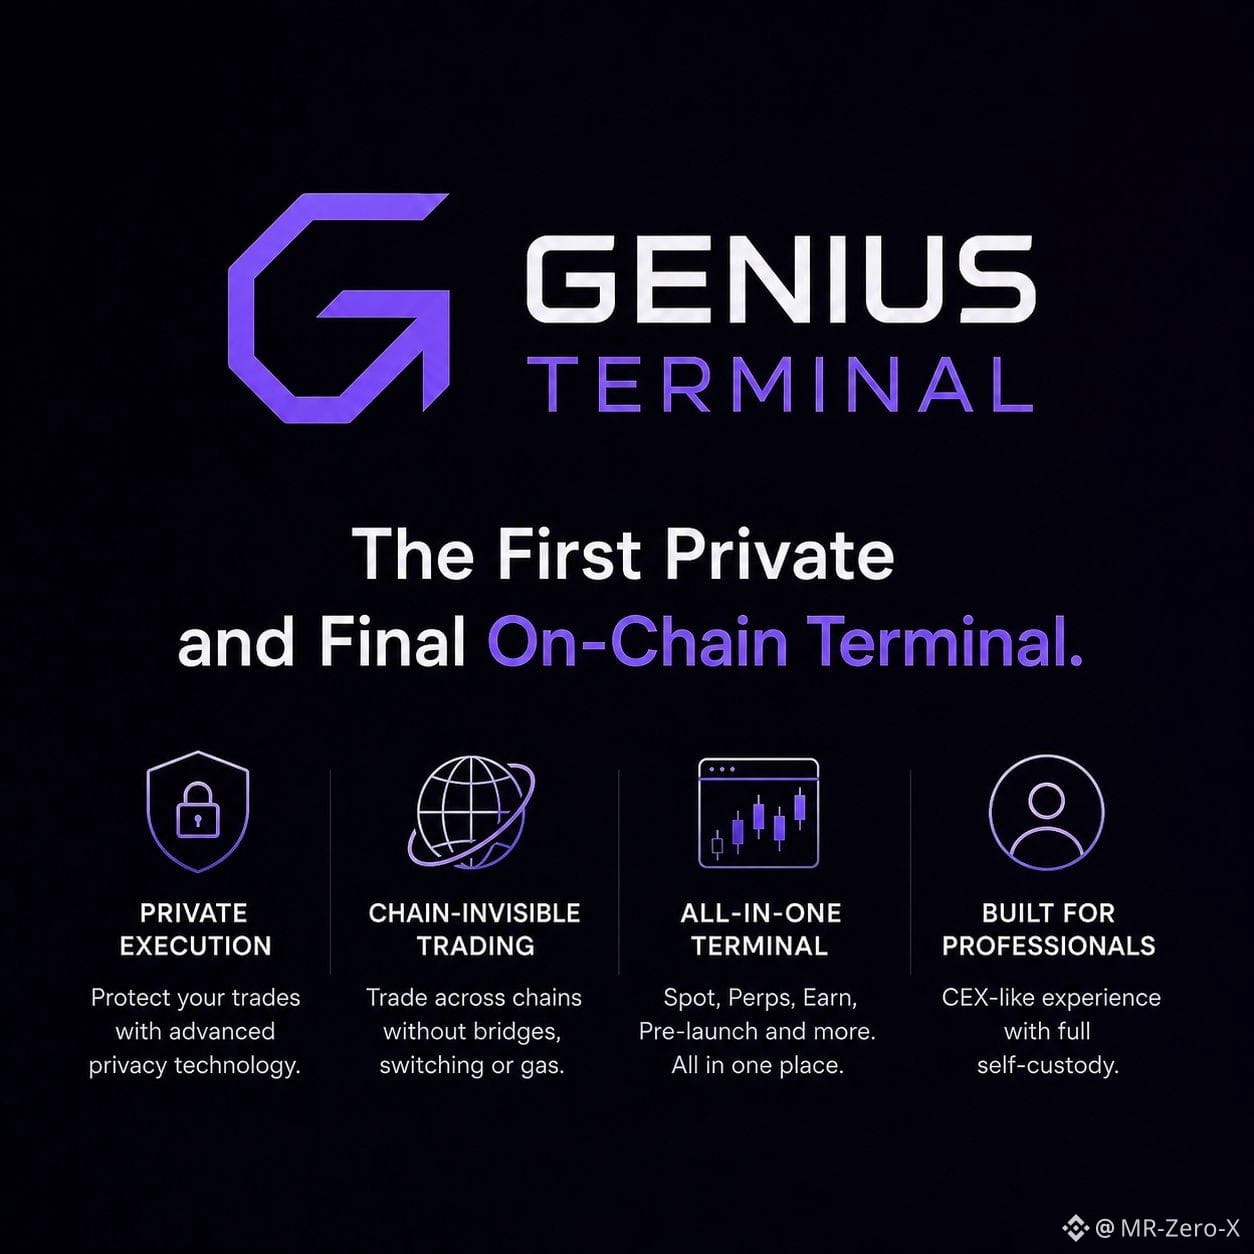
جينياس تيرمينال تدعي أنها أول تيرمينال خاص ونهائي على السلسلة.
ادعاء كبير.
لكن عندما تتعمق، تصبح الفكرة مثيرة للاهتمام.
━━━━━━━━━━━━━━━
الطبقة 1: التنفيذ
معظم المتداولين لا يزالون يقفزون بين المحافظ، والجسور، والمجمعات، وسلاسل متعددة.
هذه الاحتكاك يكلف الوقت.
وفي عالم الكريبتو، الوقت غالبًا ما يكون ربحًا.
جينياس تحاول ضغط تجربة التداول بالكامل في تيرمينال واحد.
---
الطبقة 2: الخصوصية
أحد أكبر المشاكل في الأسواق على السلسلة هو الرؤية.
الطلبات الكبيرة يمكن أن تجذب الانتباه قبل التنفيذ.
تركز المشروع على تدفق الطلبات الخاص بهدف تقليل تلك الرؤية.
فكر في الأمر بعناية.
الخصوصية ليست مجرد ميزة.
بالنسبة لرأس المال الجاد، يمكن أن تصبح بنية تحتية.
---
الطبقة 3: تجريد عبر السلاسل
تجار التجزئة غالبًا ما يرون السلاسل.
المحترفون يرون السيولة.
الرؤية طويلة الأمد تبدو وكأنها تزيل تعقيد الجسور، وإدارة الغاز، والتبديل بين الشبكات.
إذا نجحت، سيتفاعل المستخدمون مع الفرص بدلاً من السلاسل.
━━━━━━━━━━━━━━━
المخاطر / الضعف
الرؤية طموحة.
مخاطر التنفيذ لا تزال عالية.
بناء طبقة تداول خاصة، سلسة، ومتعددة السلاسل أصعب بكثير من تسويقها.
ليس الجميع سيثق في تيرمينال جديد على الفور.
التبني سيكون الاختبار الحقيقي.
━━━━━━━━━━━━━━━
السؤال بسيط:
هل تبني جينياس تيرمينال الجيل القادم من بنية تداول على السلسلة،
أم أنها تحل مشكلة لا يفهمها معظم المستخدمين بعد؟
ما رأيك؟
#genius
#genius $GENIUS @GeniusOfficial
جينياس تيرمينال تدعي أنها أول تيرمينال خاص ونهائي على السلسلة.
ادعاء كبير.
لكن عندما تتعمق، تصبح الفكرة مثيرة للاهتمام.
━━━━━━━━━━━━━━━
الطبقة 1: التنفيذ
معظم المتداولين لا يزالون يقفزون بين المحافظ، والجسور، والمجمعات، وسلاسل متعددة.
هذه الاحتكاك يكلف الوقت.
وفي عالم الكريبتو، الوقت غالبًا ما يكون ربحًا.
جينياس تحاول ضغط تجربة التداول بالكامل في تيرمينال واحد.
---
الطبقة 2: الخصوصية
أحد أكبر المشاكل في الأسواق على السلسلة هو الرؤية.
الطلبات الكبيرة يمكن أن تجذب الانتباه قبل التنفيذ.
تركز المشروع على تدفق الطلبات الخاص بهدف تقليل تلك الرؤية.
فكر في الأمر بعناية.
الخصوصية ليست مجرد ميزة.
بالنسبة لرأس المال الجاد، يمكن أن تصبح بنية تحتية.
---
الطبقة 3: تجريد عبر السلاسل
تجار التجزئة غالبًا ما يرون السلاسل.
المحترفون يرون السيولة.
الرؤية طويلة الأمد تبدو وكأنها تزيل تعقيد الجسور، وإدارة الغاز، والتبديل بين الشبكات.
إذا نجحت، سيتفاعل المستخدمون مع الفرص بدلاً من السلاسل.
━━━━━━━━━━━━━━━
المخاطر / الضعف
الرؤية طموحة.
مخاطر التنفيذ لا تزال عالية.
بناء طبقة تداول خاصة، سلسة، ومتعددة السلاسل أصعب بكثير من تسويقها.
ليس الجميع سيثق في تيرمينال جديد على الفور.
التبني سيكون الاختبار الحقيقي.
━━━━━━━━━━━━━━━
السؤال بسيط:
هل تبني جينياس تيرمينال الجيل القادم من بنية تداول على السلسلة،
أم أنها تحل مشكلة لا يفهمها معظم المستخدمين بعد؟
ما رأيك؟
#genius
جينياس تيرمينال تدعي أنها أول تيرمينال خاص ونهائي على السلسلة.
ادعاء كبير.
لكن عندما تتعمق، تصبح الفكرة مثيرة للاهتمام.
━━━━━━━━━━━━━━━
الطبقة 1: التنفيذ
معظم المتداولين لا يزالون يقفزون بين المحافظ، والجسور، والمجمعات، وسلاسل متعددة.
هذه الاحتكاك يكلف الوقت.
وفي عالم الكريبتو، الوقت غالبًا ما يكون ربحًا.
جينياس تحاول ضغط تجربة التداول بالكامل في تيرمينال واحد.
---
الطبقة 2: الخصوصية
أحد أكبر المشاكل في الأسواق على السلسلة هو الرؤية.
الطلبات الكبيرة يمكن أن تجذب الانتباه قبل التنفيذ.
تركز المشروع على تدفق الطلبات الخاص بهدف تقليل تلك الرؤية.
فكر في الأمر بعناية.
الخصوصية ليست مجرد ميزة.
بالنسبة لرأس المال الجاد، يمكن أن تصبح بنية تحتية.
---
الطبقة 3: تجريد عبر السلاسل
تجار التجزئة غالبًا ما يرون السلاسل.
المحترفون يرون السيولة.
الرؤية طويلة الأمد تبدو وكأنها تزيل تعقيد الجسور، وإدارة الغاز، والتبديل بين الشبكات.
إذا نجحت، سيتفاعل المستخدمون مع الفرص بدلاً من السلاسل.
━━━━━━━━━━━━━━━
المخاطر / الضعف
الرؤية طموحة.
مخاطر التنفيذ لا تزال عالية.
بناء طبقة تداول خاصة، سلسة، ومتعددة السلاسل أصعب بكثير من تسويقها.
ليس الجميع سيثق في تيرمينال جديد على الفور.
التبني سيكون الاختبار الحقيقي.
━━━━━━━━━━━━━━━
السؤال بسيط:
هل تبني جينياس تيرمينال الجيل القادم من بنية تداول على السلسلة،
أم أنها تحل مشكلة لا يفهمها معظم المستخدمين بعد؟
ما رأيك؟
#genius
1
1
203
·
--
تمّ التحقق
#bedrock $BR @Bedrock شعرت أن هناك شيئًا غير صحيح بينما كنت أشاهد تطور DeFi.
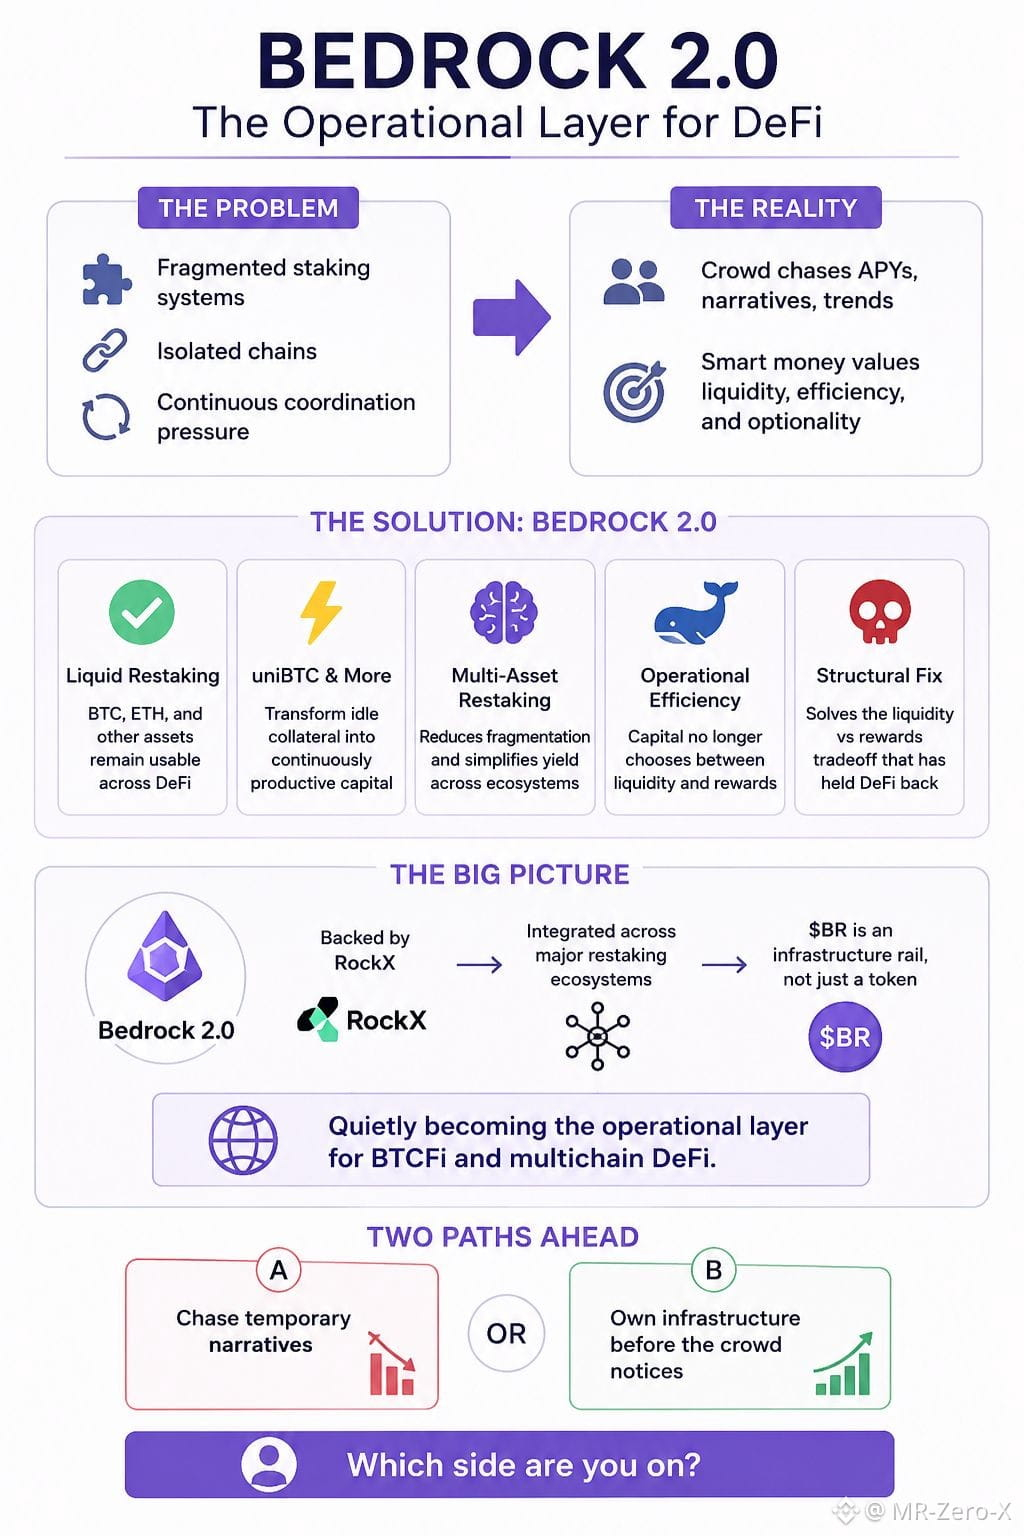
استمرت الصناعة في مطاردة العوائد العالية، لكن رأس المال ظل محاصرًا خلف أنظمة الستاكينغ المجزأة، وسلاسل معزولة، وضغوط تنسيق مستمرة.
أصبح الوضوح نفسه مرهقًا.
تركز الحشود على معدلات العائد السنوي، وسرديات الرموز، وأي اتجاه يهيمن على الجدول الزمني لمدة أسبوع.
تحت السطح، ما يهم حقًا هو الحفاظ على الخيارات.
المال الذكي يهتم بالسيولة، وكفاءة رأس المال، والبنية التحتية التي تبقي الأصول منتجة دون التضحية بالمرونة.
هذا ما لفت انتباهي حول Bedrock 2.0 و @Bedrock_DeFi.
بدلاً من إجبار رأس المال على الدخول في صوامع الستاكينغ المعزولة، تقوم Bedrock بتحويل BTC و ETH وأصول أخرى إلى مراكز إعادة الستاكينغ السائلة التي تظل قابلة للاستخدام عبر DeFi.
تحول uniBTC والأصول السائلة الأخرى إلى رأس مال منتج بشكل مستمر من الضمانات الخاملة.
تقلل إعادة الستاكينغ متعددة الأصول من التجزئة بينما تبسط توليد العائد عبر عدة أنظمة بيئية.
الميزة الحقيقية هي الكفاءة التشغيلية. لم يعد رأس المال يختار بين السيولة والمكافآت.
💀 لقد كانت هذه المقايضة مشكلة هيكلية لسنوات.
السبب الذي بدأ يبرز لي هو أن Bedrock أصبحت بهدوء طبقة تشغيلية لـ BTCFi و DeFi متعددة السلاسل.
مدعومة بشراكات بنية تحتية تشمل RockX ومتكاملة عبر أنظمة إعادة الستاكينغ الرئيسية، $BR تشعر أقل كأصل مضارب وأكثر كخط بنية تحتية لا مفر منه.
لا أرى سوى مسارين من هنا:
A) مطاردة السرديات المؤقتة
B) امتلاك البنية التحتية قبل أن تلاحظ الحشود
على أي جانب أنت؟
#bedrock $BR @Bedrock شعرت أن هناك شيئًا غير صحيح بينما كنت أشاهد تطور DeFi.
استمرت الصناعة في مطاردة العوائد العالية، لكن رأس المال ظل محاصرًا خلف أنظمة الستاكينغ المجزأة، وسلاسل معزولة، وضغوط تنسيق مستمرة.
أصبح الوضوح نفسه مرهقًا.
تركز الحشود على معدلات العائد السنوي، وسرديات الرموز، وأي اتجاه يهيمن على الجدول الزمني لمدة أسبوع.
تحت السطح، ما يهم حقًا هو الحفاظ على الخيارات.
المال الذكي يهتم بالسيولة، وكفاءة رأس المال، والبنية التحتية التي تبقي الأصول منتجة دون التضحية بالمرونة.
هذا ما لفت انتباهي حول Bedrock 2.0 و @Bedrock_DeFi.
بدلاً من إجبار رأس المال على الدخول في صوامع الستاكينغ المعزولة، تقوم Bedrock بتحويل BTC و ETH وأصول أخرى إلى مراكز إعادة الستاكينغ السائلة التي تظل قابلة للاستخدام عبر DeFi.
تحول uniBTC والأصول السائلة الأخرى إلى رأس مال منتج بشكل مستمر من الضمانات الخاملة.
تقلل إعادة الستاكينغ متعددة الأصول من التجزئة بينما تبسط توليد العائد عبر عدة أنظمة بيئية.
الميزة الحقيقية هي الكفاءة التشغيلية. لم يعد رأس المال يختار بين السيولة والمكافآت.
💀 لقد كانت هذه المقايضة مشكلة هيكلية لسنوات.
السبب الذي بدأ يبرز لي هو أن Bedrock أصبحت بهدوء طبقة تشغيلية لـ BTCFi و DeFi متعددة السلاسل.
مدعومة بشراكات بنية تحتية تشمل RockX ومتكاملة عبر أنظمة إعادة الستاكينغ الرئيسية، $BR تشعر أقل كأصل مضارب وأكثر كخط بنية تحتية لا مفر منه.
لا أرى سوى مسارين من هنا:
A) مطاردة السرديات المؤقتة
B) امتلاك البنية التحتية قبل أن تلاحظ الحشود
على أي جانب أنت؟
استمرت الصناعة في مطاردة العوائد العالية، لكن رأس المال ظل محاصرًا خلف أنظمة الستاكينغ المجزأة، وسلاسل معزولة، وضغوط تنسيق مستمرة.
أصبح الوضوح نفسه مرهقًا.
تركز الحشود على معدلات العائد السنوي، وسرديات الرموز، وأي اتجاه يهيمن على الجدول الزمني لمدة أسبوع.
تحت السطح، ما يهم حقًا هو الحفاظ على الخيارات.
المال الذكي يهتم بالسيولة، وكفاءة رأس المال، والبنية التحتية التي تبقي الأصول منتجة دون التضحية بالمرونة.
هذا ما لفت انتباهي حول Bedrock 2.0 و @Bedrock_DeFi.
بدلاً من إجبار رأس المال على الدخول في صوامع الستاكينغ المعزولة، تقوم Bedrock بتحويل BTC و ETH وأصول أخرى إلى مراكز إعادة الستاكينغ السائلة التي تظل قابلة للاستخدام عبر DeFi.
تحول uniBTC والأصول السائلة الأخرى إلى رأس مال منتج بشكل مستمر من الضمانات الخاملة.
تقلل إعادة الستاكينغ متعددة الأصول من التجزئة بينما تبسط توليد العائد عبر عدة أنظمة بيئية.
الميزة الحقيقية هي الكفاءة التشغيلية. لم يعد رأس المال يختار بين السيولة والمكافآت.
💀 لقد كانت هذه المقايضة مشكلة هيكلية لسنوات.
السبب الذي بدأ يبرز لي هو أن Bedrock أصبحت بهدوء طبقة تشغيلية لـ BTCFi و DeFi متعددة السلاسل.
مدعومة بشراكات بنية تحتية تشمل RockX ومتكاملة عبر أنظمة إعادة الستاكينغ الرئيسية، $BR تشعر أقل كأصل مضارب وأكثر كخط بنية تحتية لا مفر منه.
لا أرى سوى مسارين من هنا:
A) مطاردة السرديات المؤقتة
B) امتلاك البنية التحتية قبل أن تلاحظ الحشود
على أي جانب أنت؟
90
·
--
تمّ التحقق
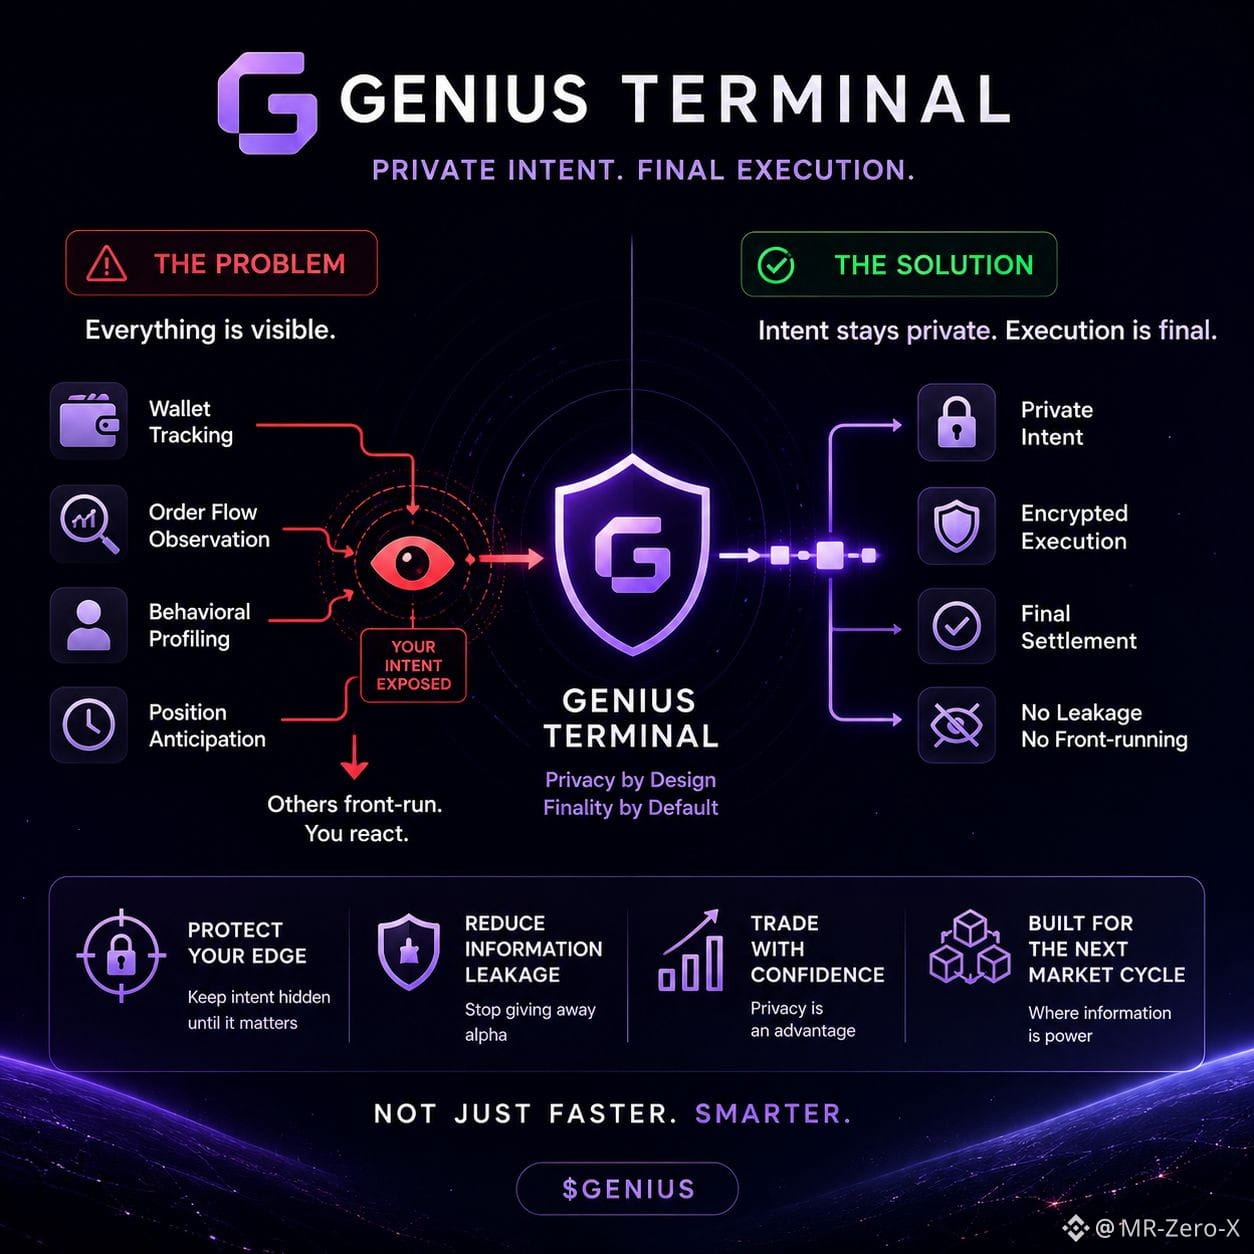
#genius $GENIUS @GeniusOfficial أتذكر أنني أدركت أن معظم المتداولين لم يكونوا يخسرون بسبب تنفيذ ضعيف. بل كانوا يخسرون لأن السوق كان يستطيع رؤيتهم قادمين. في بيئة شفافة، غالباً ما يصبح النية إشارة قبل وقت طويل من تأكيد الصفقة.
الصناعة تحب التركيز على السرعة، الرسوم، ومعدل المعاملات، لكن السؤال الأكثر أهمية هو من يتحكم في المعلومات. تتبع المحافظ، تحليل السلوك، ومراقبة تدفق الطلبات حولت الشفافية إلى ميزة تنافسية للمراقبين بدلاً من المشاركين.
هذا ما يجعل Genius Terminal مثيرًا للاهتمام. بدلاً من السعي وراء تحسينات هامشية في التنفيذ، يركز على الخصوصية والنهائية. القيمة المضافة ليست مجرد التحرك بشكل أسرع، بل الحفاظ على النية الاستراتيجية وتقليل تسرب المعلومات غير الضرورية.
بالطبع، منتج جذاب لا يترجم تلقائيًا إلى شبكة مستدامة. جودة التبني، احتفاظ المستخدمين، ديناميات فتح الرموز، والطلب الحقيقي ستحدد في النهاية ما إذا كان النموذج يمكن أن يستمر بعد السرد الأولي.
تُدفع الأسواق بالقصص على المدى القصير، لكن القيمة على المدى الطويل تُخلق من خلال سلوك المستخدم المتسق. يمكن للاهتمام أن يخلق زخمًا، لكن الاستخدام المتكرر هو ما يحول البنية التحتية إلى أصل دائم.
$GENIUS #GeniusTerminal #DeFi
#genius $GENIUS @GeniusOfficial أتذكر أنني أدركت أن معظم المتداولين لم يكونوا يخسرون بسبب تنفيذ ضعيف. بل كانوا يخسرون لأن السوق كان يستطيع رؤيتهم قادمين. في بيئة شفافة، غالباً ما يصبح النية إشارة قبل وقت طويل من تأكيد الصفقة.
الصناعة تحب التركيز على السرعة، الرسوم، ومعدل المعاملات، لكن السؤال الأكثر أهمية هو من يتحكم في المعلومات. تتبع المحافظ، تحليل السلوك، ومراقبة تدفق الطلبات حولت الشفافية إلى ميزة تنافسية للمراقبين بدلاً من المشاركين.
هذا ما يجعل Genius Terminal مثيرًا للاهتمام. بدلاً من السعي وراء تحسينات هامشية في التنفيذ، يركز على الخصوصية والنهائية. القيمة المضافة ليست مجرد التحرك بشكل أسرع، بل الحفاظ على النية الاستراتيجية وتقليل تسرب المعلومات غير الضرورية.
بالطبع، منتج جذاب لا يترجم تلقائيًا إلى شبكة مستدامة. جودة التبني، احتفاظ المستخدمين، ديناميات فتح الرموز، والطلب الحقيقي ستحدد في النهاية ما إذا كان النموذج يمكن أن يستمر بعد السرد الأولي.
تُدفع الأسواق بالقصص على المدى القصير، لكن القيمة على المدى الطويل تُخلق من خلال سلوك المستخدم المتسق. يمكن للاهتمام أن يخلق زخمًا، لكن الاستخدام المتكرر هو ما يحول البنية التحتية إلى أصل دائم.
$GENIUS #GeniusTerminal #DeFi
الصناعة تحب التركيز على السرعة، الرسوم، ومعدل المعاملات، لكن السؤال الأكثر أهمية هو من يتحكم في المعلومات. تتبع المحافظ، تحليل السلوك، ومراقبة تدفق الطلبات حولت الشفافية إلى ميزة تنافسية للمراقبين بدلاً من المشاركين.
هذا ما يجعل Genius Terminal مثيرًا للاهتمام. بدلاً من السعي وراء تحسينات هامشية في التنفيذ، يركز على الخصوصية والنهائية. القيمة المضافة ليست مجرد التحرك بشكل أسرع، بل الحفاظ على النية الاستراتيجية وتقليل تسرب المعلومات غير الضرورية.
بالطبع، منتج جذاب لا يترجم تلقائيًا إلى شبكة مستدامة. جودة التبني، احتفاظ المستخدمين، ديناميات فتح الرموز، والطلب الحقيقي ستحدد في النهاية ما إذا كان النموذج يمكن أن يستمر بعد السرد الأولي.
تُدفع الأسواق بالقصص على المدى القصير، لكن القيمة على المدى الطويل تُخلق من خلال سلوك المستخدم المتسق. يمكن للاهتمام أن يخلق زخمًا، لكن الاستخدام المتكرر هو ما يحول البنية التحتية إلى أصل دائم.
$GENIUS #GeniusTerminal #DeFi
599
سجّل الدخول لاستكشاف المزيد من المُحتوى
انضم إلى مُستخدمي العملات الرقمية حول العالم على Binance Square
⚡️ احصل على أحدث المعلومات المفيدة عن العملات الرقمية.
💬 موثوقة من قبل أكبر منصّة لتداول العملات الرقمية في العالم.
👍 اكتشف الرؤى الحقيقية من صنّاع المُحتوى الموثوقين.
البريد الإلكتروني / رقم الهاتف
المواضيع الرائجة
SouthKoreaDraftLawTargets15To20%ShareholderCap
99 مشاهدات
17 يقومون بالنقاش
#SouthKoreaDraftLawTargets15To20%ShareholderCap
🇰🇷 كوريا الجنوبية تدرس فرض سقف على ملكية منصات تداول العملات المشفرة 🚨
تتصاعد جهود كوريا الجنوبية للحد من ملكية كبار المساهمين في منصات تداول العملات المشفرة. 🔥 طرحت لجنة الخدمات المالية في البداية سقفًا يتراوح بين 15% و20% لتجنب تضارب المصالح. 📉 وتشير تقارير لاحقة إلى أن الجهات التنظيمية والمشرعين اتفقوا على سقف بنسبة 20%، مع السماح بحصص تصل إلى 34% في بعض الاستثناءات. ⚖️ (Yahoo Finance) (theblock)
وسيُدرج هذا القانون ضمن قانون الأصول الرقمية الأساسي، ومن المرجح أن تحتاج شركتا Bithumb وGopax إلى إجراء تغييرات كبيرة على هيكل الملكية. 🏦 ويعارض العاملون في القطاع هذه الخطوة بشدة. 💬 (theblock)
هل سيجعل هذا السوق أكثر إنصافًا، أم سيضر بالابتكار؟ 🤔
#SouthKorea #Upbit #Bithumb 🚀
#Nadeemgujjar143
@aasho @长风Nova @Eşsiz kimi @Fatima SheRazi Official @Ayeza998
$BTC
$BNB
$ETH
NADEEM Gujjar143
·0 إعجاب
·29 مشاهدات
KeplrAdvisesSocialLoginUsersToTransferAssets
4,722 مشاهدات
152 يقومون بالنقاش
TetherPlans€28.8MForJuventusCapitalIncrease
2,821 مشاهدات
122 يقومون بالنقاش