
#openledger
openledger
17.3M visualizaciones
202,848 participa(n) en el debate
Populares
Novedades
·
--
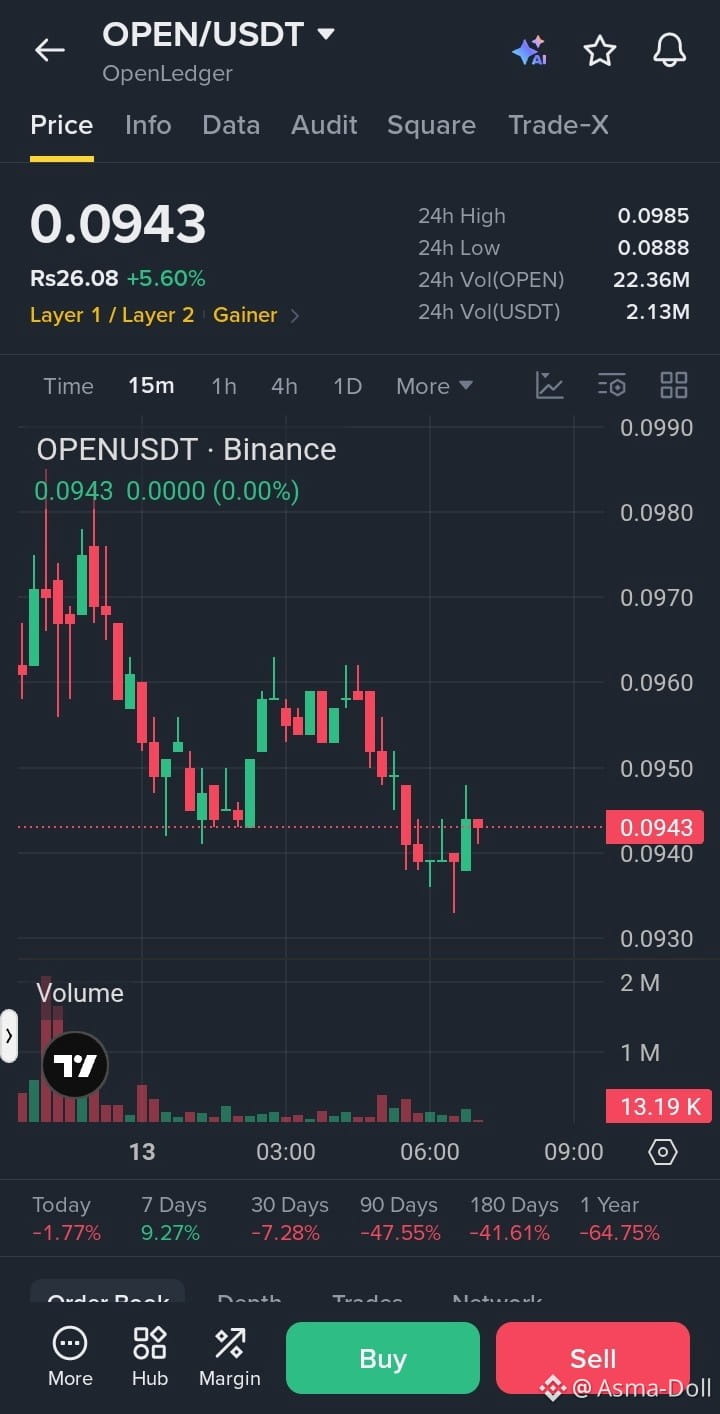
📊 $OPEN /USDT – SEÑAL DE VENTA EN CORTO
Zona de entrada: 0.0945 – 0.0960
Stop loss (SL): 0.0990
Objetivos de toma de ganancias:
* TP1: 0.0920
* TP2: 0.0890
* TP3: 0.0850
Opera aquí $OPEN
{future}(OPENUSDT)
Análisis:
* El precio se enfrenta a un rechazo cerca de la zona de resistencia de 0.0985.
* La ganancia reciente del 5.60% en 24 h indica un posible retroceso a corto plazo.
* El rendimiento de 7 días sigue siendo positivo, en un 9.27%.
* La tendencia a más largo plazo es débil, con un rendimiento de -47.55% en 90 días.
* Una caída por debajo de 0.0930 podría provocar un descenso mayor.
Confirmación:
* Espera una ruptura clara por debajo de 0.0930.
* Se prefiere una vela bajista de 15 min/1 h con un volumen creciente.
* Evita abrir posiciones cortas si el precio rompe y se mantiene por encima de 0.0985.
Relación riesgo-beneficio (aprox.): 1:0.6 hasta TP1, 1:1.3 hasta TP2, 1:2.2 hasta TP3 (usando una entrada en 0.0950 y un SL en 0.0990).
⚠️ Espera la confirmación; esta es una configuración especulativa, no un movimiento garantizado. Arriesga solo lo que puedas permitirte perder.
#OPENUSDT #OPENLedger #SeñalesCripto #FuturosBinance #ShortSetup
📊 $OPEN /USDT – SEÑAL DE VENTA EN CORTO
Zona de entrada: 0.0945 – 0.0960
Stop loss (SL): 0.0990
Objetivos de toma de ganancias:
* TP1: 0.0920
* TP2: 0.0890
* TP3: 0.0850
Opera aquí $OPEN
Análisis:
* El precio se enfrenta a un rechazo cerca de la zona de resistencia de 0.0985.
* La ganancia reciente del 5.60% en 24 h indica un posible retroceso a corto plazo.
* El rendimiento de 7 días sigue siendo positivo, en un 9.27%.
* La tendencia a más largo plazo es débil, con un rendimiento de -47.55% en 90 días.
* Una caída por debajo de 0.0930 podría provocar un descenso mayor.
Confirmación:
* Espera una ruptura clara por debajo de 0.0930.
* Se prefiere una vela bajista de 15 min/1 h con un volumen creciente.
* Evita abrir posiciones cortas si el precio rompe y se mantiene por encima de 0.0985.
Relación riesgo-beneficio (aprox.): 1:0.6 hasta TP1, 1:1.3 hasta TP2, 1:2.2 hasta TP3 (usando una entrada en 0.0950 y un SL en 0.0990).
⚠️ Espera la confirmación; esta es una configuración especulativa, no un movimiento garantizado. Arriesga solo lo que puedas permitirte perder.
#OPENUSDT #OPENLedger #SeñalesCripto #FuturosBinance #ShortSetup
Zona de entrada: 0.0945 – 0.0960
Stop loss (SL): 0.0990
Objetivos de toma de ganancias:
* TP1: 0.0920
* TP2: 0.0890
* TP3: 0.0850
Opera aquí $OPEN
Análisis:
* El precio se enfrenta a un rechazo cerca de la zona de resistencia de 0.0985.
* La ganancia reciente del 5.60% en 24 h indica un posible retroceso a corto plazo.
* El rendimiento de 7 días sigue siendo positivo, en un 9.27%.
* La tendencia a más largo plazo es débil, con un rendimiento de -47.55% en 90 días.
* Una caída por debajo de 0.0930 podría provocar un descenso mayor.
Confirmación:
* Espera una ruptura clara por debajo de 0.0930.
* Se prefiere una vela bajista de 15 min/1 h con un volumen creciente.
* Evita abrir posiciones cortas si el precio rompe y se mantiene por encima de 0.0985.
Relación riesgo-beneficio (aprox.): 1:0.6 hasta TP1, 1:1.3 hasta TP2, 1:2.2 hasta TP3 (usando una entrada en 0.0950 y un SL en 0.0990).
⚠️ Espera la confirmación; esta es una configuración especulativa, no un movimiento garantizado. Arriesga solo lo que puedas permitirte perder.
#OPENUSDT #OPENLedger #SeñalesCripto #FuturosBinance #ShortSetup
44
·
--
Alcista
$OPEN está que arde! 🔥
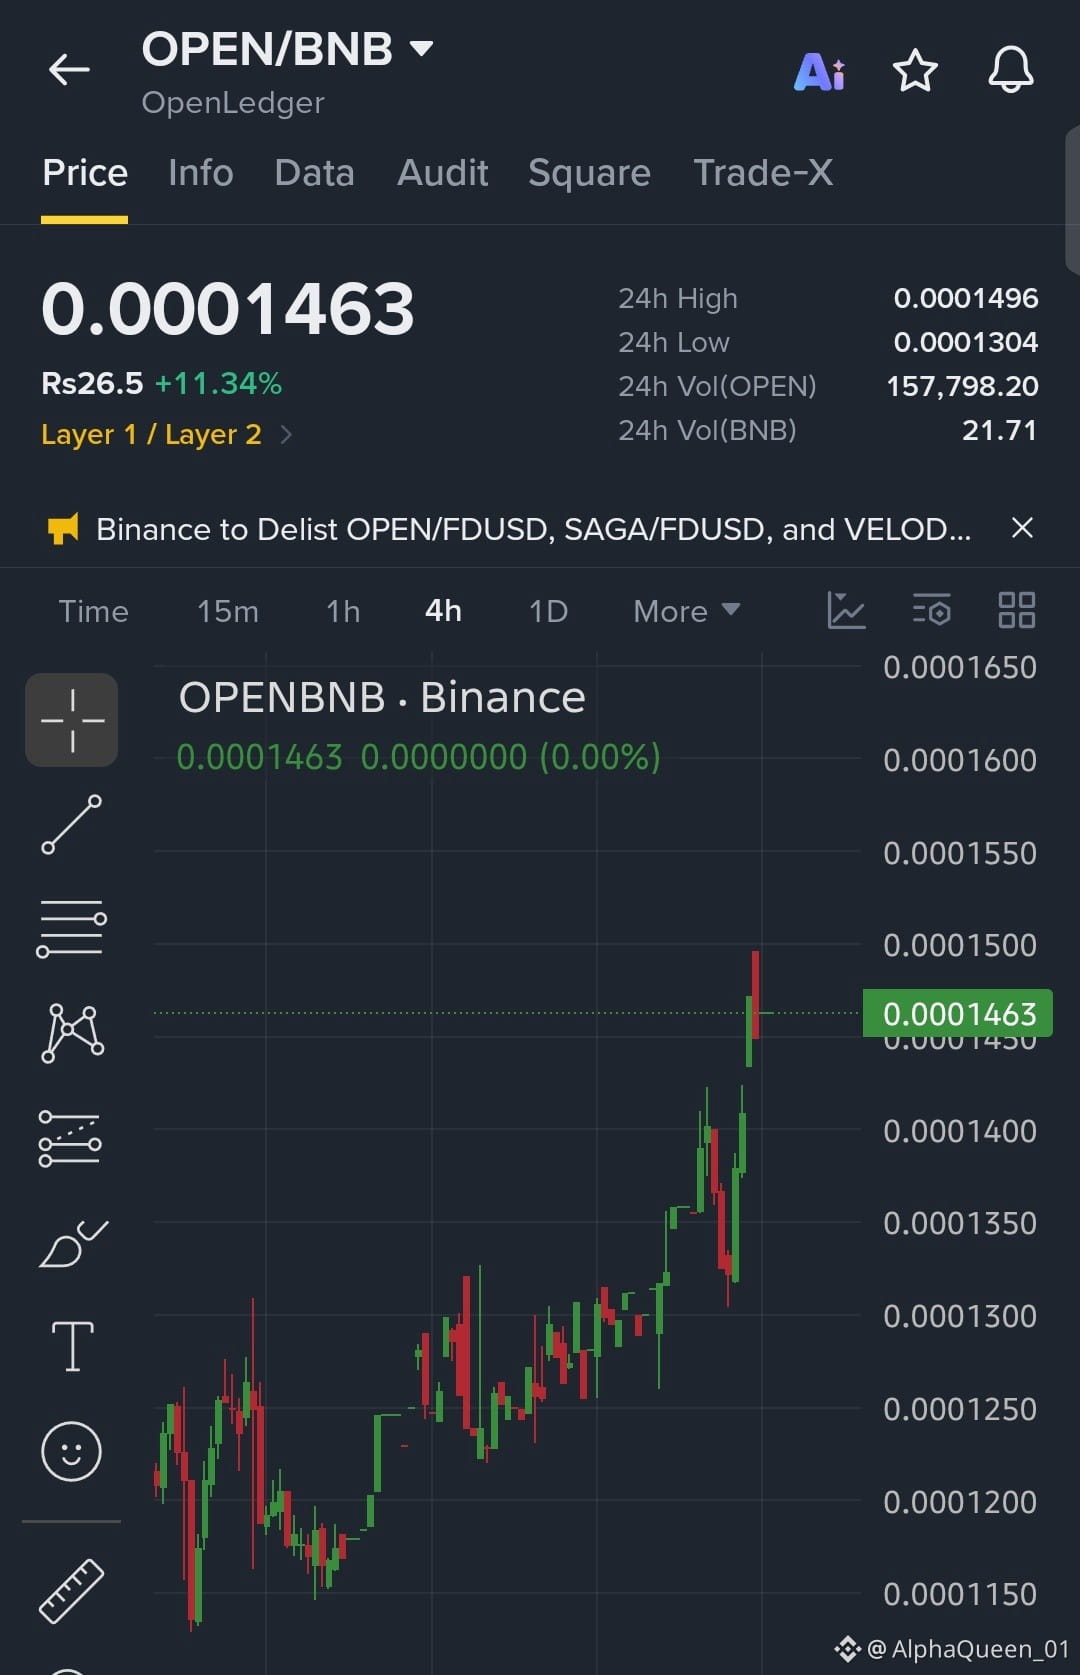
¡$OPEN /BNB a 0.0001463, subiendo un +11.34% hoy!
¡De un mínimo de 0.0001304 a un máximo de 0.0001496: una subida imparable!
Binance dijo que lo excluiría de cotización, y OPEN respondió: «¡Mírame volar!» 🚀
¿Quién sigue teniendo OPEN? Comenta «OPEN ARMY» 👇
#OPEN #OpenLedger #BNB #Crypto
{future}(OPENUSDT)
$OPEN está que arde! 🔥
¡$OPEN /BNB a 0.0001463, subiendo un +11.34% hoy!
¡De un mínimo de 0.0001304 a un máximo de 0.0001496: una subida imparable!
Binance dijo que lo excluiría de cotización, y OPEN respondió: «¡Mírame volar!» 🚀
¿Quién sigue teniendo OPEN? Comenta «OPEN ARMY» 👇
#OPEN #OpenLedger #BNB #Crypto
¡$OPEN /BNB a 0.0001463, subiendo un +11.34% hoy!
¡De un mínimo de 0.0001304 a un máximo de 0.0001496: una subida imparable!
Binance dijo que lo excluiría de cotización, y OPEN respondió: «¡Mírame volar!» 🚀
¿Quién sigue teniendo OPEN? Comenta «OPEN ARMY» 👇
#OPEN #OpenLedger #BNB #Crypto
6
262
·
--
$币安人生 ¡El mercado de las criptomonedas está contando una historia interesante hoy! 🔥 Bitcoin cotiza alrededor de los 71.486,9 $, con una caída del 3,33 %, mientras que ($BTC )(Binance Life) ha bajado un 5,47 %, hasta los 0,4719 $. Pero OpenLedger (OPEN) muestra una tendencia diferente: se mantiene en 0,0971 $, con una subida del 0,83 %.
Lo que hace interesante a OpenLedger es su capacidad para atraer la atención incluso cuando el sentimiento general del mercado está bajo presión. Mientras los operadores observan cuál será el próximo movimiento de Bitcoin, $OPEN plantea una pregunta importante: ¿podría este proyecto cobrar más impulso mientras el mercado busca estabilidad?
¿Está construyendo OpenLedger algo que pueda destacar más allá de los movimientos de precios a corto plazo? ¿Podrá OPEN mantener su fortaleza si Bitcoin sigue enfrentándose a la presión vendedora? ¿Y cuál podría ser el próximo gran catalizador de su ecosistema?
El próximo capítulo aún se está escribiendo. Sigue de cerca los fundamentos, la adopción y la actividad del mercado, en lugar de juzgar el proyecto por una sola vela verde.
¿Se está preparando OPEN para una oportunidad mayor o se trata solo de un rebote temporal del mercado? 👀
{future}(币安人生USDT)
{future}(OPENUSDT)
{future}(BTCUSDT)
#OpenLedger #OPENUSDT #CryptoMarket
$币安人生 ¡El mercado de las criptomonedas está contando una historia interesante hoy! 🔥 Bitcoin cotiza alrededor de los 71.486,9 $, con una caída del 3,33 %, mientras que ($BTC )(Binance Life) ha bajado un 5,47 %, hasta los 0,4719 $. Pero OpenLedger (OPEN) muestra una tendencia diferente: se mantiene en 0,0971 $, con una subida del 0,83 %.
Lo que hace interesante a OpenLedger es su capacidad para atraer la atención incluso cuando el sentimiento general del mercado está bajo presión. Mientras los operadores observan cuál será el próximo movimiento de Bitcoin, $OPEN plantea una pregunta importante: ¿podría este proyecto cobrar más impulso mientras el mercado busca estabilidad?
¿Está construyendo OpenLedger algo que pueda destacar más allá de los movimientos de precios a corto plazo? ¿Podrá OPEN mantener su fortaleza si Bitcoin sigue enfrentándose a la presión vendedora? ¿Y cuál podría ser el próximo gran catalizador de su ecosistema?
El próximo capítulo aún se está escribiendo. Sigue de cerca los fundamentos, la adopción y la actividad del mercado, en lugar de juzgar el proyecto por una sola vela verde.
¿Se está preparando OPEN para una oportunidad mayor o se trata solo de un rebote temporal del mercado? 👀
#OpenLedger #OPENUSDT #CryptoMarket
Lo que hace interesante a OpenLedger es su capacidad para atraer la atención incluso cuando el sentimiento general del mercado está bajo presión. Mientras los operadores observan cuál será el próximo movimiento de Bitcoin, $OPEN plantea una pregunta importante: ¿podría este proyecto cobrar más impulso mientras el mercado busca estabilidad?
¿Está construyendo OpenLedger algo que pueda destacar más allá de los movimientos de precios a corto plazo? ¿Podrá OPEN mantener su fortaleza si Bitcoin sigue enfrentándose a la presión vendedora? ¿Y cuál podría ser el próximo gran catalizador de su ecosistema?
El próximo capítulo aún se está escribiendo. Sigue de cerca los fundamentos, la adopción y la actividad del mercado, en lugar de juzgar el proyecto por una sola vela verde.
¿Se está preparando OPEN para una oportunidad mayor o se trata solo de un rebote temporal del mercado? 👀
#OpenLedger #OPENUSDT #CryptoMarket
$币安人生 🔙👍✅
64%
$BTC 💻📞📱
18%
$OPEN 😀😁😂
18%
11 Votos • Votación cerrada
1
2.3k
·
--
🔴 $OPEN /USDT – SEÑAL CORTA OpenLedger | Configuración bajista
Zona de entrada: 0.0895 – 0.0905
Stop loss (SL): 0.0930
🎯 Toma de ganancias (TP):
TP1: 0.0875
TP2: 0.0855
TP3: 0.0820
Opera aquí $OPEN
{future}(OPENUSDT)
Análisis:
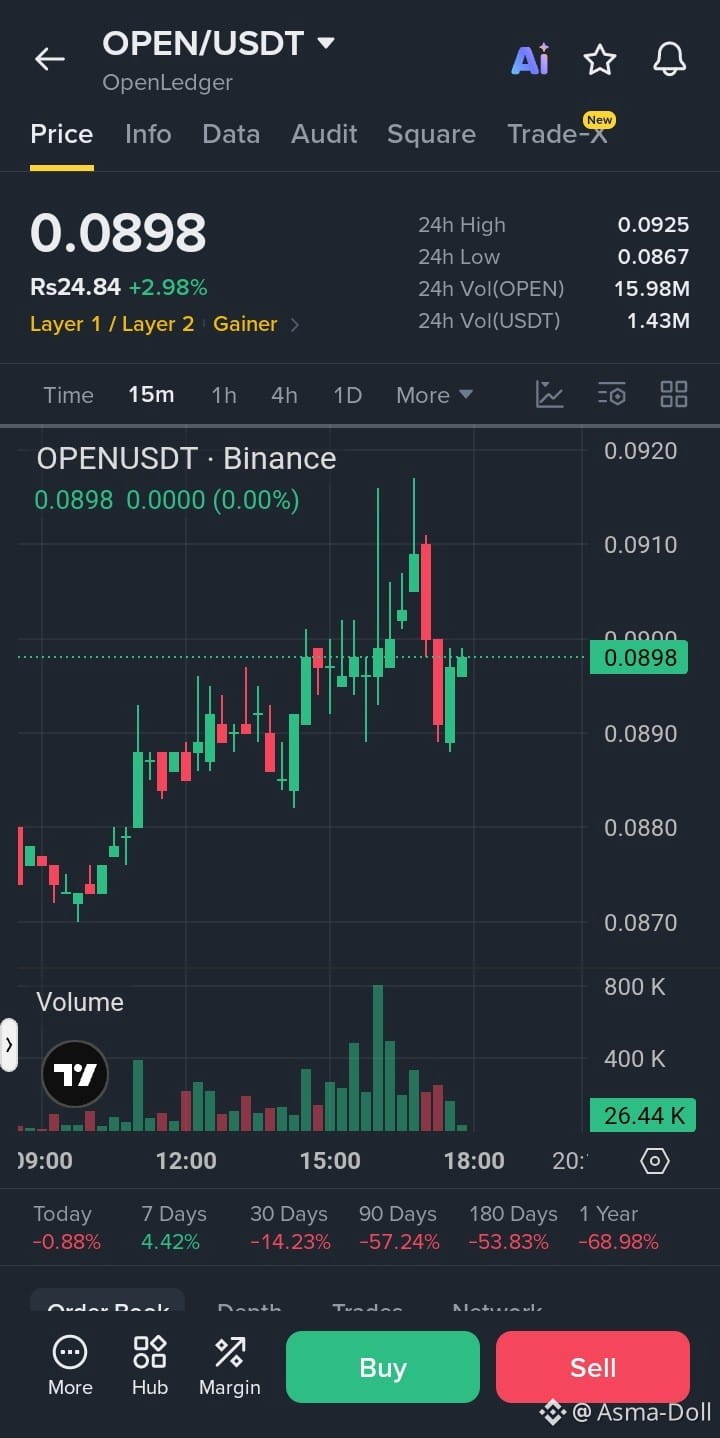
El precio encuentra resistencia cerca de 0.0925.
El rendimiento en 30 días ha bajado un 14.23%.
El rendimiento en 90 días muestra una caída masiva del 57.24%.
La tendencia de 1 año sigue siendo fuertemente bajista.
Un rebote a corto plazo podría enfrentar presión vendedora.
Los compradores necesitan un volumen sólido para revertir la tendencia.
Confirmación: Una ruptura clara por debajo de 0.0880 con un fuerte volumen de ventas podría provocar nuevas caídas.
Riesgo-beneficio: Aproximadamente de 1:1 a 1:2.1, según el punto de entrada y el objetivo.
⚠️ Espera la confirmación bajista antes de entrar. Estos niveles son orientativos, no están garantizados.
#OPENUSDT #OpenLedger #CryptoSignals #BinanceFutures #ShortSignal
🔴 $OPEN /USDT – SEÑAL CORTA OpenLedger | Configuración bajista
Zona de entrada: 0.0895 – 0.0905
Stop loss (SL): 0.0930
🎯 Toma de ganancias (TP):
TP1: 0.0875
TP2: 0.0855
TP3: 0.0820
Opera aquí $OPEN
Análisis:
El precio encuentra resistencia cerca de 0.0925.
El rendimiento en 30 días ha bajado un 14.23%.
El rendimiento en 90 días muestra una caída masiva del 57.24%.
La tendencia de 1 año sigue siendo fuertemente bajista.
Un rebote a corto plazo podría enfrentar presión vendedora.
Los compradores necesitan un volumen sólido para revertir la tendencia.
Confirmación: Una ruptura clara por debajo de 0.0880 con un fuerte volumen de ventas podría provocar nuevas caídas.
Riesgo-beneficio: Aproximadamente de 1:1 a 1:2.1, según el punto de entrada y el objetivo.
⚠️ Espera la confirmación bajista antes de entrar. Estos niveles son orientativos, no están garantizados.
#OPENUSDT #OpenLedger #CryptoSignals #BinanceFutures #ShortSignal
Zona de entrada: 0.0895 – 0.0905
Stop loss (SL): 0.0930
🎯 Toma de ganancias (TP):
TP1: 0.0875
TP2: 0.0855
TP3: 0.0820
Opera aquí $OPEN
Análisis:
El precio encuentra resistencia cerca de 0.0925.
El rendimiento en 30 días ha bajado un 14.23%.
El rendimiento en 90 días muestra una caída masiva del 57.24%.
La tendencia de 1 año sigue siendo fuertemente bajista.
Un rebote a corto plazo podría enfrentar presión vendedora.
Los compradores necesitan un volumen sólido para revertir la tendencia.
Confirmación: Una ruptura clara por debajo de 0.0880 con un fuerte volumen de ventas podría provocar nuevas caídas.
Riesgo-beneficio: Aproximadamente de 1:1 a 1:2.1, según el punto de entrada y el objetivo.
⚠️ Espera la confirmación bajista antes de entrar. Estos niveles son orientativos, no están garantizados.
#OPENUSDT #OpenLedger #CryptoSignals #BinanceFutures #ShortSignal
19

·
--
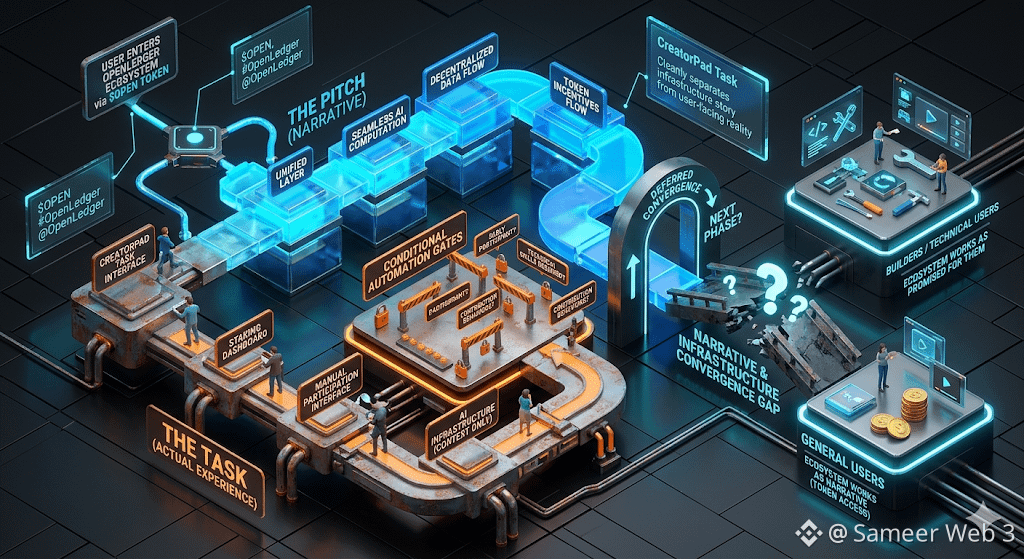
Algo que noté mientras trabajaba en una tarea de CreatorPad para OpenLedger ($OPEN , #OpenLedger , @Openledger ) es lo bien que el proyecto separa su historia de infraestructura de la realidad que enfrentan los usuarios. La propuesta es una capa unificada donde la computación de IA, los datos descentralizados y los incentivos en tokens fluyen entre sí sin problemas — pero lo que realmente tocas durante la tarea se asemeja más a una interfaz de staking y participación, con la infraestructura de IA presente mayormente como contexto, no como algo con lo que interactúas directamente. La automatización que el nombre implica no es fluida; es condicional, restringida por un conjunto de comportamientos de contribución que recompensan a los primeros participantes orientados técnicamente mucho más que a los usuarios generales. Hay una elección de diseño enterrada en esa brecha: el ecosistema funciona como se prometió para las personas que lo están construyendo, y funciona como narrativa para todos los demás que llegan a través del token. Lo que se queda conmigo no es crítica — es la pregunta de si los dos grupos alguna vez convergen realmente en el mismo producto, o si esa convergencia siempre se pospone para la próxima fase.
@Openledger
#OpenLedger
$OPEN
Algo que noté mientras trabajaba en una tarea de CreatorPad para OpenLedger ($OPEN , #OpenLedger , @OpenLedger ) es lo bien que el proyecto separa su historia de infraestructura de la realidad que enfrentan los usuarios. La propuesta es una capa unificada donde la computación de IA, los datos descentralizados y los incentivos en tokens fluyen entre sí sin problemas — pero lo que realmente tocas durante la tarea se asemeja más a una interfaz de staking y participación, con la infraestructura de IA presente mayormente como contexto, no como algo con lo que interactúas directamente. La automatización que el nombre implica no es fluida; es condicional, restringida por un conjunto de comportamientos de contribución que recompensan a los primeros participantes orientados técnicamente mucho más que a los usuarios generales. Hay una elección de diseño enterrada en esa brecha: el ecosistema funciona como se prometió para las personas que lo están construyendo, y funciona como narrativa para todos los demás que llegan a través del token. Lo que se queda conmigo no es crítica — es la pregunta de si los dos grupos alguna vez convergen realmente en el mismo producto, o si esa convergencia siempre se pospone para la próxima fase.
@OpenLedger
#OpenLedger
$OPEN
@OpenLedger
#OpenLedger
$OPEN
138
·
--
#openledger $OPEN @Openledger
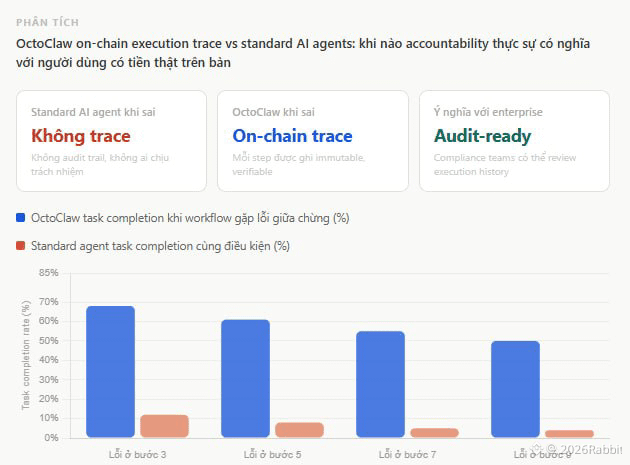
Una tarde estaba probando OctoClaw y le dejé realizar una serie de tareas relacionadas con la investigación de DeFi. Todo funcionaba bastante fluido hasta el séptimo paso del workflow. El agente llegó a una conclusión errónea sobre el liquidity pool de un protocolo que estaba siguiendo. No fue un error menor. Fue un error del tipo que, si hubiera confiado en él y colocado una orden real, habría perdido dinero real.
Y allí estaba yo, preguntándome algo que creo que pocas personas se detienen a cuestionar: ¿quién es responsable de ese error?
Con ChatGPT o Claude, la respuesta simple es "AI disclaimer, úsalo bajo tu propio riesgo." Pero con OctoClaw en OpenLedger, hay algo diferente. Cada acción del agente queda registrada en la cadena. La ejecución no se puede borrar. Si el agente se equivoca, la huella de ese error existe para siempre y es verificable por cualquiera. Esa fue la primera vez que vi que la responsabilidad de la IA ya no era un concepto abstracto, sino una garantía técnica.
El error de aquel día de OctoClaw me hizo confiar más en OpenLedger que en cualquier otra cosa. Porque pude ver exactamente dónde estaba el error, por qué, y tuve el contexto suficiente para decidir si confiar en el agente la próxima vez. Eso es algo que ningún otro agente de IA me ha podido ofrecer.
¿Alguna vez has dejado que un agente de IA realice una acción real con dinero real, y qué te hizo lo suficientemente confiado para hacerlo?
#openledger $OPEN @OpenLedger
Una tarde estaba probando OctoClaw y le dejé realizar una serie de tareas relacionadas con la investigación de DeFi. Todo funcionaba bastante fluido hasta el séptimo paso del workflow. El agente llegó a una conclusión errónea sobre el liquidity pool de un protocolo que estaba siguiendo. No fue un error menor. Fue un error del tipo que, si hubiera confiado en él y colocado una orden real, habría perdido dinero real.
Y allí estaba yo, preguntándome algo que creo que pocas personas se detienen a cuestionar: ¿quién es responsable de ese error?
Con ChatGPT o Claude, la respuesta simple es "AI disclaimer, úsalo bajo tu propio riesgo." Pero con OctoClaw en OpenLedger, hay algo diferente. Cada acción del agente queda registrada en la cadena. La ejecución no se puede borrar. Si el agente se equivoca, la huella de ese error existe para siempre y es verificable por cualquiera. Esa fue la primera vez que vi que la responsabilidad de la IA ya no era un concepto abstracto, sino una garantía técnica.
El error de aquel día de OctoClaw me hizo confiar más en OpenLedger que en cualquier otra cosa. Porque pude ver exactamente dónde estaba el error, por qué, y tuve el contexto suficiente para decidir si confiar en el agente la próxima vez. Eso es algo que ningún otro agente de IA me ha podido ofrecer.
¿Alguna vez has dejado que un agente de IA realice una acción real con dinero real, y qué te hizo lo suficientemente confiado para hacerlo?
Una tarde estaba probando OctoClaw y le dejé realizar una serie de tareas relacionadas con la investigación de DeFi. Todo funcionaba bastante fluido hasta el séptimo paso del workflow. El agente llegó a una conclusión errónea sobre el liquidity pool de un protocolo que estaba siguiendo. No fue un error menor. Fue un error del tipo que, si hubiera confiado en él y colocado una orden real, habría perdido dinero real.
Y allí estaba yo, preguntándome algo que creo que pocas personas se detienen a cuestionar: ¿quién es responsable de ese error?
Con ChatGPT o Claude, la respuesta simple es "AI disclaimer, úsalo bajo tu propio riesgo." Pero con OctoClaw en OpenLedger, hay algo diferente. Cada acción del agente queda registrada en la cadena. La ejecución no se puede borrar. Si el agente se equivoca, la huella de ese error existe para siempre y es verificable por cualquiera. Esa fue la primera vez que vi que la responsabilidad de la IA ya no era un concepto abstracto, sino una garantía técnica.
El error de aquel día de OctoClaw me hizo confiar más en OpenLedger que en cualquier otra cosa. Porque pude ver exactamente dónde estaba el error, por qué, y tuve el contexto suficiente para decidir si confiar en el agente la próxima vez. Eso es algo que ningún otro agente de IA me ha podido ofrecer.
¿Alguna vez has dejado que un agente de IA realice una acción real con dinero real, y qué te hizo lo suficientemente confiado para hacerlo?
192
·
--
En los últimos días, he estado en el tablero de gobernanza de OpenLedger, observando cómo las ballenas votan. Cuanto más miro, más me doy cuenta de que esta supuesta gobernanza descentralizada es una broma elaborada. En la superficie, todos pueden proponer y votar, suena muy democrático, pero si realmente miras la distribución de los pesos de voto, te das cuenta de que los pequeños inversores no tienen suficiente peso ni para hacerle cosquillas a los grandes capitales. $LAB
He seguido varias rondas de propuestas y el patrón es muy claro. Ese ajuste de peso dinámico, hoy se inclina hacia un equipo grande de modelos, dándole recompensas a los datos de texto; mañana, con un cambio de viento, se pueden volver a subsidiar la renderización de video. El discurso externo es siempre sobre optimizar el ecosistema y responder a la demanda, pero las decisiones siempre las toman esas pocas direcciones tempranas que sostienen un montón de fichas. Los pequeños en este sistema no son realmente co-creadores, más bien parecen herramientas de votación baratas, manipuladas por algoritmos y capital; si una propuesta va a pasar ya está decidido de antemano, la votación solo es un trámite para mostrar.
Más inquietante es ese tipo de secuestro de flujo disfrazado. Cada mes, la cantidad de fichas liberadas depende completamente del verdadero volumen de bloqueo y frecuencia de uso de cada red vertical, lo que obliga a los equipos de subred a usar datos operativos reales para competir por fondos. Suena justo, pero deduzco que, una vez que se agoten los beneficios iniciales, esas pocas ballenas que tienen un montón de fichas seguramente se aliarán en secreto, creando redes fantasmas para mover fondos de mano en mano, extrayendo recompensas inflacionarias y vaciando el pool de ganancias de los pequeños. La siguiente pregunta es cómo equilibrar esta conspiración de capital que chupa sangre, un nudo que el equipo no puede evitar. $BTC
No digo que este proyecto sea malo, tiene el valor de escribir directamente la lógica de distribución en el código, sin depender de la gestión de personas; esta valentía es realmente rara en el espacio. Pero los peligros de centralización en la gobernanza son reales. Hasta que no se resuelva el tema de las alianzas de las ballenas, es mejor que los pequeños inversores reconozcan su posición en la mesa de juego y no se engañen pensando que pueden cambiar las reglas como accionistas. #OpenLedger $OPEN @Openledger
En los últimos días, he estado en el tablero de gobernanza de OpenLedger, observando cómo las ballenas votan. Cuanto más miro, más me doy cuenta de que esta supuesta gobernanza descentralizada es una broma elaborada. En la superficie, todos pueden proponer y votar, suena muy democrático, pero si realmente miras la distribución de los pesos de voto, te das cuenta de que los pequeños inversores no tienen suficiente peso ni para hacerle cosquillas a los grandes capitales. $LAB
He seguido varias rondas de propuestas y el patrón es muy claro. Ese ajuste de peso dinámico, hoy se inclina hacia un equipo grande de modelos, dándole recompensas a los datos de texto; mañana, con un cambio de viento, se pueden volver a subsidiar la renderización de video. El discurso externo es siempre sobre optimizar el ecosistema y responder a la demanda, pero las decisiones siempre las toman esas pocas direcciones tempranas que sostienen un montón de fichas. Los pequeños en este sistema no son realmente co-creadores, más bien parecen herramientas de votación baratas, manipuladas por algoritmos y capital; si una propuesta va a pasar ya está decidido de antemano, la votación solo es un trámite para mostrar.
Más inquietante es ese tipo de secuestro de flujo disfrazado. Cada mes, la cantidad de fichas liberadas depende completamente del verdadero volumen de bloqueo y frecuencia de uso de cada red vertical, lo que obliga a los equipos de subred a usar datos operativos reales para competir por fondos. Suena justo, pero deduzco que, una vez que se agoten los beneficios iniciales, esas pocas ballenas que tienen un montón de fichas seguramente se aliarán en secreto, creando redes fantasmas para mover fondos de mano en mano, extrayendo recompensas inflacionarias y vaciando el pool de ganancias de los pequeños. La siguiente pregunta es cómo equilibrar esta conspiración de capital que chupa sangre, un nudo que el equipo no puede evitar. $BTC
No digo que este proyecto sea malo, tiene el valor de escribir directamente la lógica de distribución en el código, sin depender de la gestión de personas; esta valentía es realmente rara en el espacio. Pero los peligros de centralización en la gobernanza son reales. Hasta que no se resuelva el tema de las alianzas de las ballenas, es mejor que los pequeños inversores reconozcan su posición en la mesa de juego y no se engañen pensando que pueden cambiar las reglas como accionistas. #OpenLedger $OPEN @OpenLedger
He seguido varias rondas de propuestas y el patrón es muy claro. Ese ajuste de peso dinámico, hoy se inclina hacia un equipo grande de modelos, dándole recompensas a los datos de texto; mañana, con un cambio de viento, se pueden volver a subsidiar la renderización de video. El discurso externo es siempre sobre optimizar el ecosistema y responder a la demanda, pero las decisiones siempre las toman esas pocas direcciones tempranas que sostienen un montón de fichas. Los pequeños en este sistema no son realmente co-creadores, más bien parecen herramientas de votación baratas, manipuladas por algoritmos y capital; si una propuesta va a pasar ya está decidido de antemano, la votación solo es un trámite para mostrar.
Más inquietante es ese tipo de secuestro de flujo disfrazado. Cada mes, la cantidad de fichas liberadas depende completamente del verdadero volumen de bloqueo y frecuencia de uso de cada red vertical, lo que obliga a los equipos de subred a usar datos operativos reales para competir por fondos. Suena justo, pero deduzco que, una vez que se agoten los beneficios iniciales, esas pocas ballenas que tienen un montón de fichas seguramente se aliarán en secreto, creando redes fantasmas para mover fondos de mano en mano, extrayendo recompensas inflacionarias y vaciando el pool de ganancias de los pequeños. La siguiente pregunta es cómo equilibrar esta conspiración de capital que chupa sangre, un nudo que el equipo no puede evitar. $BTC
No digo que este proyecto sea malo, tiene el valor de escribir directamente la lógica de distribución en el código, sin depender de la gestión de personas; esta valentía es realmente rara en el espacio. Pero los peligros de centralización en la gobernanza son reales. Hasta que no se resuelva el tema de las alianzas de las ballenas, es mejor que los pequeños inversores reconozcan su posición en la mesa de juego y no se engañen pensando que pueden cambiar las reglas como accionistas. #OpenLedger $OPEN @OpenLedger
散户投票权重有多惨
33%
动态权重调整谁说了算
67%
3 Votos • Votación cerrada
2
1
540

Artículo
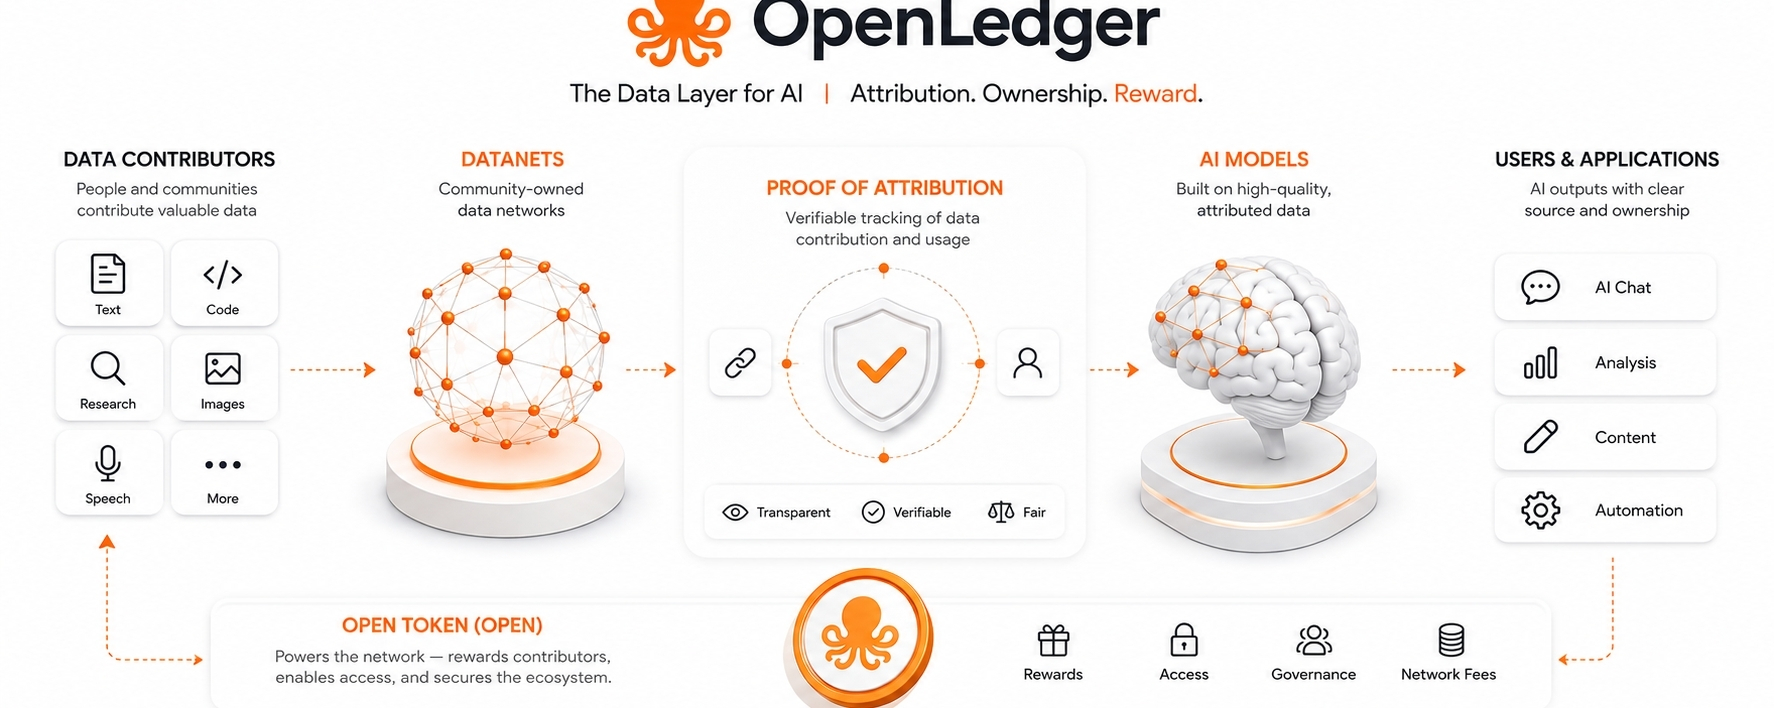
OpenLedger y la Pregunta Incómoda de Quién Realmente Posee los Datos de IAOpenLedger me hace pensar en una de las cosas más feas en cripto y IA al mismo tiempo: todo el mundo quiere la recompensa, pero casi nadie quiere hablar del desmadre que hay debajo. Los datos. La fuente. Las personas que realmente contribuyeron con algo. Los usuarios falsos. Los farmers. El trabajo invisible que se traga un sistema y luego se vende de nuevo a todos con un logo más limpio.
Mira, estoy cansado de las presentaciones de cripto relacionadas con IA.
Realmente cansado.
Cada semana hay otro proyecto que actúa como si hubiera encontrado la respuesta final. Otro token. Otro dashboard. Otro hilo explicando por qué esto es el “futuro de la inteligencia” o cualquier frase que esté funcionando este mes.
OpenLedger y la Pregunta Incómoda de Quién Realmente Posee los Datos de IA
OpenLedger me hace pensar en una de las cosas más feas en cripto y IA al mismo tiempo: todo el mundo quiere la recompensa, pero casi nadie quiere hablar del desmadre que hay debajo. Los datos. La fuente. Las personas que realmente contribuyeron con algo. Los usuarios falsos. Los farmers. El trabajo invisible que se traga un sistema y luego se vende de nuevo a todos con un logo más limpio.
Mira, estoy cansado de las presentaciones de cripto relacionadas con IA.
Realmente cansado.
Cada semana hay otro proyecto que actúa como si hubiera encontrado la respuesta final. Otro token. Otro dashboard. Otro hilo explicando por qué esto es el “futuro de la inteligencia” o cualquier frase que esté funcionando este mes.
Mira, estoy cansado de las presentaciones de cripto relacionadas con IA.
Realmente cansado.
Cada semana hay otro proyecto que actúa como si hubiera encontrado la respuesta final. Otro token. Otro dashboard. Otro hilo explicando por qué esto es el “futuro de la inteligencia” o cualquier frase que esté funcionando este mes.
104
#openledger $OPEN Explorando el futuro de la IA descentralizada con @OpenLedger 🔥
La visión detrás de OpenLedger es crear un ecosistema más inteligente donde la IA y blockchain trabajen juntos sin problemas. A medida que la innovación sigue creciendo, $OPEN podría convertirse en uno de los proyectos más comentados en Web3. Manteniendo esta joya en mi lista de seguimiento a largo plazo 👀🚀
#OpenLedger $OPEN
{future}(OPENUSDT)
#openledger $OPEN Explorando el futuro de la IA descentralizada con @OpenLedger 🔥
La visión detrás de OpenLedger es crear un ecosistema más inteligente donde la IA y blockchain trabajen juntos sin problemas. A medida que la innovación sigue creciendo, $OPEN podría convertirse en uno de los proyectos más comentados en Web3. Manteniendo esta joya en mi lista de seguimiento a largo plazo 👀🚀
#OpenLedger $OPEN
La visión detrás de OpenLedger es crear un ecosistema más inteligente donde la IA y blockchain trabajen juntos sin problemas. A medida que la innovación sigue creciendo, $OPEN podría convertirse en uno de los proyectos más comentados en Web3. Manteniendo esta joya en mi lista de seguimiento a largo plazo 👀🚀
#OpenLedger $OPEN
2
16
·
--
Alcista
La mayoría de los proyectos tratan las listas de intercambio como un hito.
Los precios suben. El volumen se dispara. Twitter celebra.
Luego, dos semanas después, todos siguen adelante.
He estado pensando en @Openledger la lista de BitMart en febrero. En ese momento, el $OPEN precio cayó un 6% el día de la lista, lo cual es inusual. La mayoría de las listas se impulsan.
La caída no me molestó tanto como lo que reveló.
Las listas de intercambio importan de manera diferente para los proyectos de infraestructura que para los tokens de consumo. Un meme coin necesita liquidez y acceso minorista para sobrevivir. Una capa de infraestructura necesita adopción de desarrolladores, integraciones empresariales y liquidez de uso del protocolo; esto es casi secundario.
El $OPEN estar listado en BitMart, MEXC y otros lugares es necesario. Pero no es la señal que vale la pena observar.
La señal que vale la pena observar es si alguien realmente está pagando $OPEN para usar la red. Créditos de IA, tarifas de creación de datanet, transacciones de atribución, estos son los números que te dicen si la infraestructura está siendo utilizada.
No la profundidad del libro de órdenes. Los ingresos por tarifas.
Una de estas métricas es fácil de encontrar. La otra toma cinco minutos de investigación en cadena.
Adivina en cuál de ellas está mirando la mayoría de la gente.
#OpenLedger
{future}(OPENUSDT)
La mayoría de los proyectos tratan las listas de intercambio como un hito.
Los precios suben. El volumen se dispara. Twitter celebra.
Luego, dos semanas después, todos siguen adelante.
He estado pensando en @OpenLedger la lista de BitMart en febrero. En ese momento, el $OPEN precio cayó un 6% el día de la lista, lo cual es inusual. La mayoría de las listas se impulsan.
La caída no me molestó tanto como lo que reveló.
Las listas de intercambio importan de manera diferente para los proyectos de infraestructura que para los tokens de consumo. Un meme coin necesita liquidez y acceso minorista para sobrevivir. Una capa de infraestructura necesita adopción de desarrolladores, integraciones empresariales y liquidez de uso del protocolo; esto es casi secundario.
El $OPEN estar listado en BitMart, MEXC y otros lugares es necesario. Pero no es la señal que vale la pena observar.
La señal que vale la pena observar es si alguien realmente está pagando $OPEN para usar la red. Créditos de IA, tarifas de creación de datanet, transacciones de atribución, estos son los números que te dicen si la infraestructura está siendo utilizada.
No la profundidad del libro de órdenes. Los ingresos por tarifas.
Una de estas métricas es fácil de encontrar. La otra toma cinco minutos de investigación en cadena.
Adivina en cuál de ellas está mirando la mayoría de la gente.
#OpenLedger
Los precios suben. El volumen se dispara. Twitter celebra.
Luego, dos semanas después, todos siguen adelante.
He estado pensando en @OpenLedger la lista de BitMart en febrero. En ese momento, el $OPEN precio cayó un 6% el día de la lista, lo cual es inusual. La mayoría de las listas se impulsan.
La caída no me molestó tanto como lo que reveló.
Las listas de intercambio importan de manera diferente para los proyectos de infraestructura que para los tokens de consumo. Un meme coin necesita liquidez y acceso minorista para sobrevivir. Una capa de infraestructura necesita adopción de desarrolladores, integraciones empresariales y liquidez de uso del protocolo; esto es casi secundario.
El $OPEN estar listado en BitMart, MEXC y otros lugares es necesario. Pero no es la señal que vale la pena observar.
La señal que vale la pena observar es si alguien realmente está pagando $OPEN para usar la red. Créditos de IA, tarifas de creación de datanet, transacciones de atribución, estos son los números que te dicen si la infraestructura está siendo utilizada.
No la profundidad del libro de órdenes. Los ingresos por tarifas.
Una de estas métricas es fácil de encontrar. La otra toma cinco minutos de investigación en cadena.
Adivina en cuál de ellas está mirando la mayoría de la gente.
#OpenLedger
1
266
·
--
Con verificación
Artículo
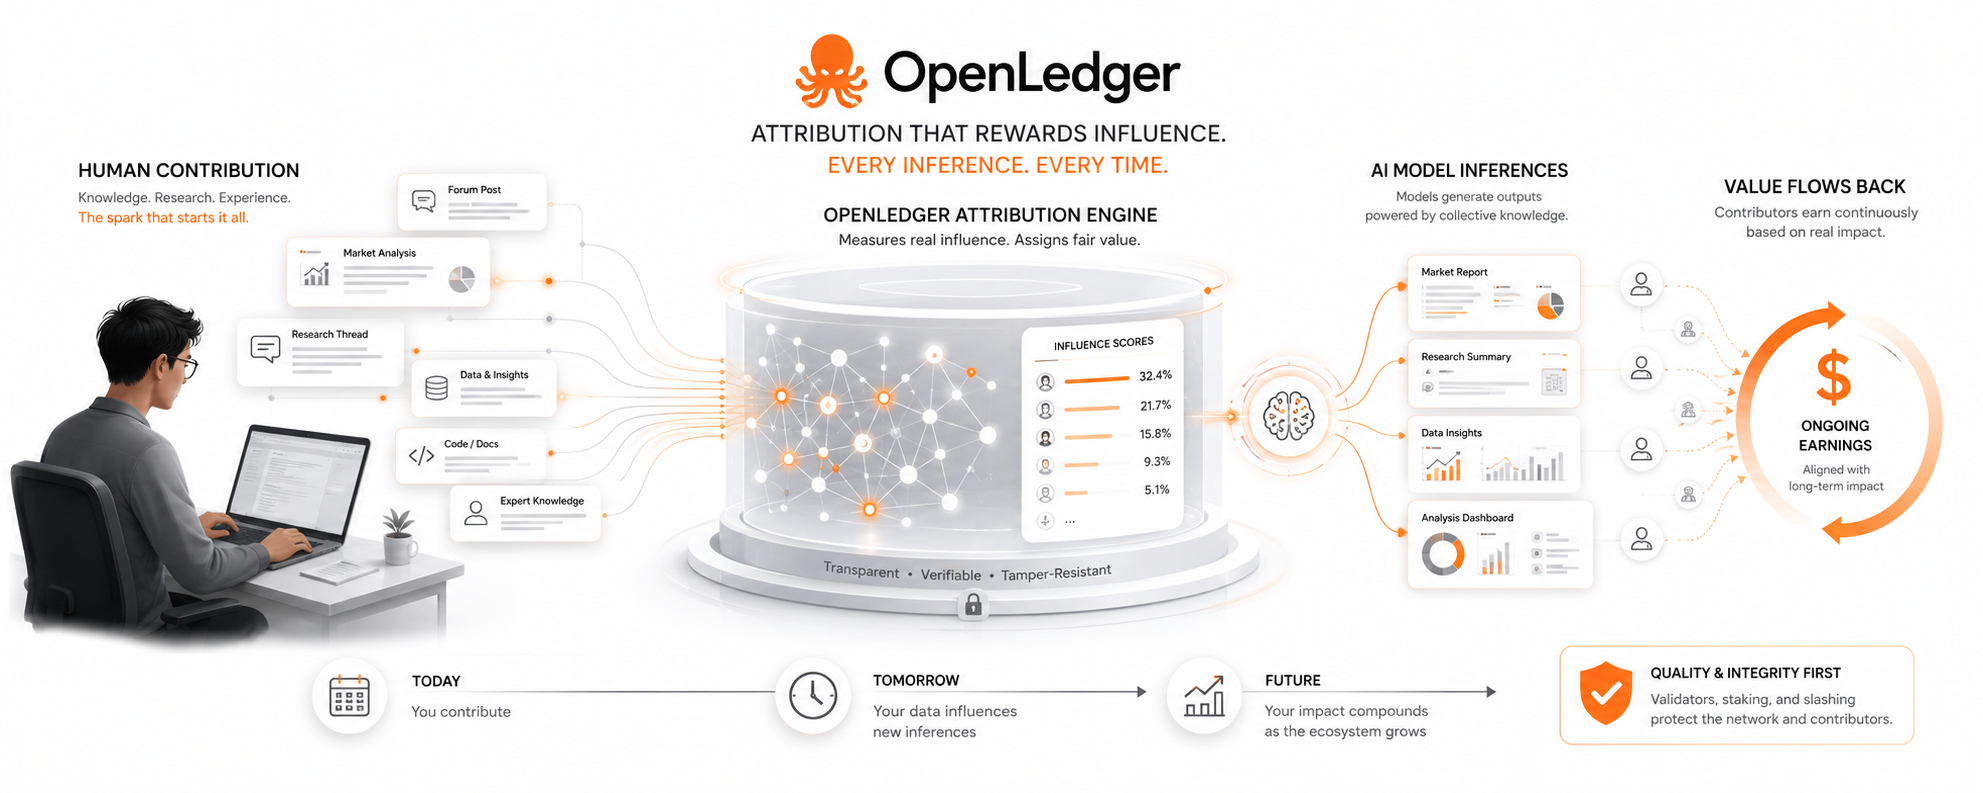
OpenLedger se siente como un juego de contribuidor… Pero $OPEN puede estar evaluando la larga cola de la entrada humanaPara ser honesta, hay una frustración silenciosa que he llevado desde 2022 por contribuir en espacios online.
No es ira.
Solo una conciencia de bajo nivel que nunca se va del todo.
He escrito análisis de mercado detallados en foros públicos. Compartí desgloses de investigación que obtienen cientos de compartidos. Pasé horas reales armando hilos en los que otras personas construyen, remixen, citan en su propio trabajo. Algunos de esos posts todavía se mencionan hoy en conversaciones en las que ni siquiera participo.
Me pagaron exactamente una vez por cada uno de ellos. Por lo general, nada en absoluto.
OpenLedger se siente como un juego de contribuidor… Pero $OPEN puede estar evaluando la larga cola de la entrada humana
Para ser honesta, hay una frustración silenciosa que he llevado desde 2022 por contribuir en espacios online.
No es ira.
Solo una conciencia de bajo nivel que nunca se va del todo.
He escrito análisis de mercado detallados en foros públicos. Compartí desgloses de investigación que obtienen cientos de compartidos. Pasé horas reales armando hilos en los que otras personas construyen, remixen, citan en su propio trabajo. Algunos de esos posts todavía se mencionan hoy en conversaciones en las que ni siquiera participo.
Me pagaron exactamente una vez por cada uno de ellos. Por lo general, nada en absoluto.
No es ira.
Solo una conciencia de bajo nivel que nunca se va del todo.
He escrito análisis de mercado detallados en foros públicos. Compartí desgloses de investigación que obtienen cientos de compartidos. Pasé horas reales armando hilos en los que otras personas construyen, remixen, citan en su propio trabajo. Algunos de esos posts todavía se mencionan hoy en conversaciones en las que ni siquiera participo.
Me pagaron exactamente una vez por cada uno de ellos. Por lo general, nada en absoluto.
763

·
--

Artículo
El Futuro de la Monetización de IA Comienza con OpenLedgerLa Inteligencia Artificial se está convirtiendo rápidamente en una de las tecnologías más valiosas de nuestro tiempo. Cada día, se crean nuevos modelos de IA, conjuntos de datos y agentes autónomos, generando un valor inmenso en diversas industrias. Sin embargo, queda un desafío sin resolver: ¿cómo pueden los contribuyentes monetizar de manera justa los datos, modelos e inteligencia que crean?
Aquí es donde @Openledger introduce una visión convincente. OpenLedger es una blockchain enfocada en IA diseñada para desbloquear liquidez para datos, modelos y agentes, creando un ecosistema donde los activos de IA pueden volverse productivos, negociables y económicamente valiosos.
El Futuro de la Monetización de IA Comienza con OpenLedger
La Inteligencia Artificial se está convirtiendo rápidamente en una de las tecnologías más valiosas de nuestro tiempo. Cada día, se crean nuevos modelos de IA, conjuntos de datos y agentes autónomos, generando un valor inmenso en diversas industrias. Sin embargo, queda un desafío sin resolver: ¿cómo pueden los contribuyentes monetizar de manera justa los datos, modelos e inteligencia que crean?
Aquí es donde @OpenLedger introduce una visión convincente. OpenLedger es una blockchain enfocada en IA diseñada para desbloquear liquidez para datos, modelos y agentes, creando un ecosistema donde los activos de IA pueden volverse productivos, negociables y económicamente valiosos.
Aquí es donde @OpenLedger introduce una visión convincente. OpenLedger es una blockchain enfocada en IA diseñada para desbloquear liquidez para datos, modelos y agentes, creando un ecosistema donde los activos de IA pueden volverse productivos, negociables y económicamente valiosos.
40
·
--
Artículo
Hice un cálculo: ¿cuánto se puede ganar en un mes en OpenLedger?El mes pasado, cuando no tenía nada que hacer, decidí tomar en serio la tarea de contribuir datos a OpenLedger. No se trata de subir cualquier archivo al azar, sino que dediqué dos horas fijas cada día, eligiendo fuentes de datos de alta calidad, haciendo limpieza y etiquetado. Lo hice durante treinta días consecutivos. Quería ver cuánto se puede monetizar esta estrategia de "reparto de ganancias por contribución" en la vida real para una persona común.
Primero, hablemos de los resultados. He acumulado más de cuatrocientos datos efectivos, con un puntaje de atribución que ronda por encima de la media. Lo que conseguí en $OPEN, calculando al precio de mercado de ese momento, vale aproximadamente más de ciento sesenta dólares. Suena bien, ¿no? Pero si haces la cuenta de la tarifa por hora: dos horas al día, treinta días, eso son sesenta horas. Ciento sesenta dólares dividido entre sesenta, da menos de tres dólares por hora. Si busco un trabajo de repartir volantes, la tarifa por hora ya es de diez dólares.
Hice un cálculo: ¿cuánto se puede ganar en un mes en OpenLedger?
El mes pasado, cuando no tenía nada que hacer, decidí tomar en serio la tarea de contribuir datos a OpenLedger. No se trata de subir cualquier archivo al azar, sino que dediqué dos horas fijas cada día, eligiendo fuentes de datos de alta calidad, haciendo limpieza y etiquetado. Lo hice durante treinta días consecutivos. Quería ver cuánto se puede monetizar esta estrategia de "reparto de ganancias por contribución" en la vida real para una persona común.
Primero, hablemos de los resultados. He acumulado más de cuatrocientos datos efectivos, con un puntaje de atribución que ronda por encima de la media. Lo que conseguí en $OPEN , calculando al precio de mercado de ese momento, vale aproximadamente más de ciento sesenta dólares. Suena bien, ¿no? Pero si haces la cuenta de la tarifa por hora: dos horas al día, treinta días, eso son sesenta horas. Ciento sesenta dólares dividido entre sesenta, da menos de tres dólares por hora. Si busco un trabajo de repartir volantes, la tarifa por hora ya es de diez dólares.
Primero, hablemos de los resultados. He acumulado más de cuatrocientos datos efectivos, con un puntaje de atribución que ronda por encima de la media. Lo que conseguí en $OPEN , calculando al precio de mercado de ese momento, vale aproximadamente más de ciento sesenta dólares. Suena bien, ¿no? Pero si haces la cuenta de la tarifa por hora: dos horas al día, treinta días, eso son sesenta horas. Ciento sesenta dólares dividido entre sesenta, da menos de tres dólares por hora. Si busco un trabajo de repartir volantes, la tarifa por hora ya es de diez dólares.
473
·
--
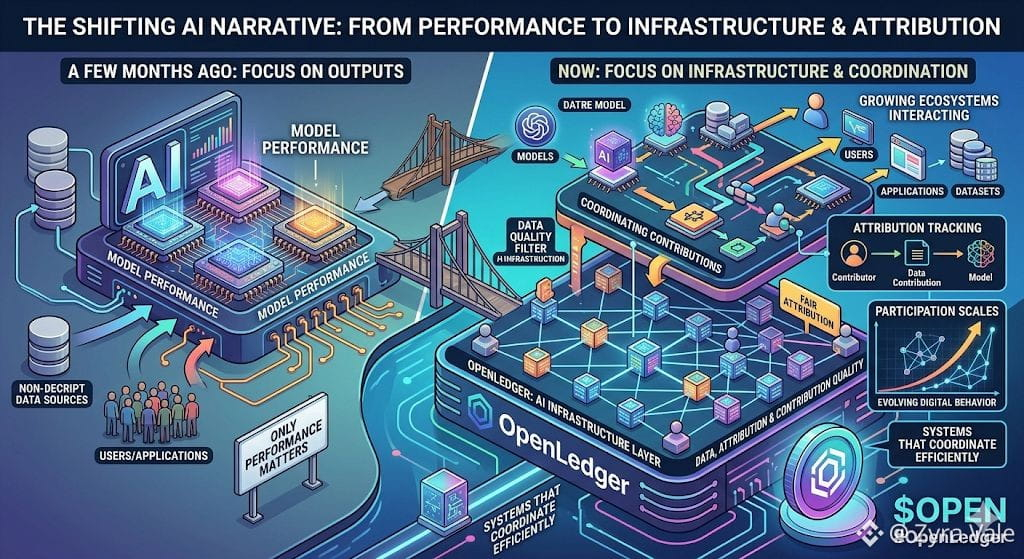
Siento que la narrativa de la IA está cambiando lentamente últimamente.
hace unos meses, a la mayoría de la gente solo le importaba el rendimiento del modelo.
ahora estoy notando más conversaciones sobre datos, atribución y calidad de contribución también.
esa es parte de la razón por la que OpenLedger ha comenzado a destacar para mí recientemente.
el proyecto se siente enfocado en una capa de infraestructura de IA que probablemente se vuelva más importante a medida que los ecosistemas crezcan.
especialmente una vez que más usuarios, aplicaciones y conjuntos de datos empiecen a interactuar a través de redes.
el cripto ya mostró qué tan rápido evoluciona el comportamiento digital una vez que la participación escala.
así que los sistemas que pueden coordinar contribuciones y atribuciones de manera más eficiente podrían terminar convirtiéndose en una parte bastante importante del ecosistema de IA más adelante.
obviamente todavía es temprano.
pero siento que el mercado está comenzando gradualmente a prestar más atención a la infraestructura subyacente de la IA en lugar de solo a los resultados.
esa es principalmente la razón por la que he estado observando $OPEN últimamente.
#openledger $OPEN @Openledger
Siento que la narrativa de la IA está cambiando lentamente últimamente.
hace unos meses, a la mayoría de la gente solo le importaba el rendimiento del modelo.
ahora estoy notando más conversaciones sobre datos, atribución y calidad de contribución también.
esa es parte de la razón por la que OpenLedger ha comenzado a destacar para mí recientemente.
el proyecto se siente enfocado en una capa de infraestructura de IA que probablemente se vuelva más importante a medida que los ecosistemas crezcan.
especialmente una vez que más usuarios, aplicaciones y conjuntos de datos empiecen a interactuar a través de redes.
el cripto ya mostró qué tan rápido evoluciona el comportamiento digital una vez que la participación escala.
así que los sistemas que pueden coordinar contribuciones y atribuciones de manera más eficiente podrían terminar convirtiéndose en una parte bastante importante del ecosistema de IA más adelante.
obviamente todavía es temprano.
pero siento que el mercado está comenzando gradualmente a prestar más atención a la infraestructura subyacente de la IA en lugar de solo a los resultados.
esa es principalmente la razón por la que he estado observando $OPEN últimamente.
#openledger $OPEN @OpenLedger
hace unos meses, a la mayoría de la gente solo le importaba el rendimiento del modelo.
ahora estoy notando más conversaciones sobre datos, atribución y calidad de contribución también.
esa es parte de la razón por la que OpenLedger ha comenzado a destacar para mí recientemente.
el proyecto se siente enfocado en una capa de infraestructura de IA que probablemente se vuelva más importante a medida que los ecosistemas crezcan.
especialmente una vez que más usuarios, aplicaciones y conjuntos de datos empiecen a interactuar a través de redes.
el cripto ya mostró qué tan rápido evoluciona el comportamiento digital una vez que la participación escala.
así que los sistemas que pueden coordinar contribuciones y atribuciones de manera más eficiente podrían terminar convirtiéndose en una parte bastante importante del ecosistema de IA más adelante.
obviamente todavía es temprano.
pero siento que el mercado está comenzando gradualmente a prestar más atención a la infraestructura subyacente de la IA en lugar de solo a los resultados.
esa es principalmente la razón por la que he estado observando $OPEN últimamente.
#openledger $OPEN @OpenLedger
2
185
#openledger $OPEN @Openledger
Open ledger es una blockchain de IA con un valor de mercado.
haciendo trading en el mercado durante décadas.
Ahora han lanzado una campaña en Binance Square; lo que tienes que hacer es completar tareas y obtener tus recompensas.
#50000usdc
#openledger $OPEN @OpenLedger
Open ledger es una blockchain de IA con un valor de mercado.
haciendo trading en el mercado durante décadas.
Ahora han lanzado una campaña en Binance Square; lo que tienes que hacer es completar tareas y obtener tus recompensas.
#50000usdc
Open ledger es una blockchain de IA con un valor de mercado.
haciendo trading en el mercado durante décadas.
Ahora han lanzado una campaña en Binance Square; lo que tienes que hacer es completar tareas y obtener tus recompensas.
#50000usdc
33
·
--
Artículo
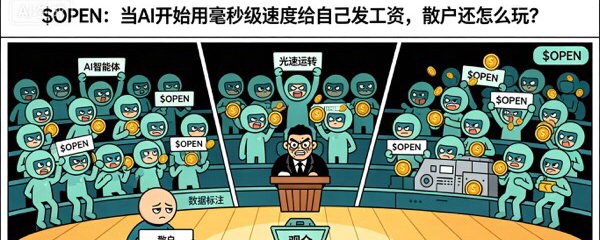
$OPEN: cuando la IA empieza a pagarse con un ritmo de milisegundos, ¿y el pequeño inversor todavía cómo juega?La verdad es que, la primera vez que vi OpenLedger, casi me lo llevo el dedo y me deslicé. ¿Otra vez el mismo viejo guion de “subir datos, pagar por cada vez”? Pero lo probé y sí: puede recibir $OPEN. Cada vez que lo llaman, paga automáticamente, como si un proveedor de insumos al que nadie le hace caso de repente recibiera un recibo de sueldo. Para esos creadores que han sido explotados por grandes empresas durante años sin que les paguen de verdad, esto les ha dado de lleno en el punto sensible.
Pero me fui calmando, y cuanto más lo pensaba, más raro me parecía.
La prueba de atribución suena reconfortante, pero a nivel de ingeniería es una caja negra. Con modelos de decenas de miles de millones de parámetros, ¿con qué derecho se supone que calculan con precisión qué parte de mi valor aportaron esas pocas etiquetas que di? El whitepaper ofrece una solución para la economía criptográfica, pero no responde a lo que más me preocupa: ¿y si alguien envuelve los mismos datos una y otra vez para “rascar” recompensas, o si el algoritmo reparte el mérito mal entre personas? ¿Con qué se cubre esa confianza? Hasta para hacer una transferencia tengo que comprobar la dirección tres veces; este riesgo no puedo fingir que no existe.
$OPEN: cuando la IA empieza a pagarse con un ritmo de milisegundos, ¿y el pequeño inversor todavía cómo juega?
La verdad es que, la primera vez que vi OpenLedger, casi me lo llevo el dedo y me deslicé. ¿Otra vez el mismo viejo guion de “subir datos, pagar por cada vez”? Pero lo probé y sí: puede recibir $OPEN . Cada vez que lo llaman, paga automáticamente, como si un proveedor de insumos al que nadie le hace caso de repente recibiera un recibo de sueldo. Para esos creadores que han sido explotados por grandes empresas durante años sin que les paguen de verdad, esto les ha dado de lleno en el punto sensible.
Pero me fui calmando, y cuanto más lo pensaba, más raro me parecía.
La prueba de atribución suena reconfortante, pero a nivel de ingeniería es una caja negra. Con modelos de decenas de miles de millones de parámetros, ¿con qué derecho se supone que calculan con precisión qué parte de mi valor aportaron esas pocas etiquetas que di? El whitepaper ofrece una solución para la economía criptográfica, pero no responde a lo que más me preocupa: ¿y si alguien envuelve los mismos datos una y otra vez para “rascar” recompensas, o si el algoritmo reparte el mérito mal entre personas? ¿Con qué se cubre esa confianza? Hasta para hacer una transferencia tengo que comprobar la dirección tres veces; este riesgo no puedo fingir que no existe.
Pero me fui calmando, y cuanto más lo pensaba, más raro me parecía.
La prueba de atribución suena reconfortante, pero a nivel de ingeniería es una caja negra. Con modelos de decenas de miles de millones de parámetros, ¿con qué derecho se supone que calculan con precisión qué parte de mi valor aportaron esas pocas etiquetas que di? El whitepaper ofrece una solución para la economía criptográfica, pero no responde a lo que más me preocupa: ¿y si alguien envuelve los mismos datos una y otra vez para “rascar” recompensas, o si el algoritmo reparte el mérito mal entre personas? ¿Con qué se cubre esa confianza? Hasta para hacer una transferencia tengo que comprobar la dirección tres veces; este riesgo no puedo fingir que no existe.
1
147
·
--
La propiedad de datos en IA se habla a menudo como si ya estuviera claramente definida, pero en la práctica aún se siente inestable. Sistemas de atribución como OpenLedger traen estructura a algo que históricamente ha sido vago. Hacen visible la contribución, mapean dónde fluyen los datos y introducen un nivel de transparencia que faltaba durante mucho tiempo.
Pero la visibilidad por sí sola no se traduce completamente en propiedad. El significado legal y ético del control sobre los datos sigue siendo diferente de la capacidad técnica para rastrearlos. La blockchain puede registrar el origen y el movimiento con precisión, sin embargo, no resuelve automáticamente las preguntas de permiso, retiro o derechos a largo plazo.
También hay una descoordinación más profunda entre la permanencia y los marcos de privacidad. Los sistemas construidos para registros inmutables no se alinean fácilmente con las expectativas moldeadas por las leyes modernas de protección de datos. Al mismo tiempo, la mayoría de los datos que alimentan los sistemas de IA actuales ya existen fuera de cualquier estructura de consentimiento limpio, lo que hace que el desafío sea aún más difícil de abordar en retrospectiva.
@Openledger #openledger $OPEN
{spot}(OPENUSDT)
La propiedad de datos en IA se habla a menudo como si ya estuviera claramente definida, pero en la práctica aún se siente inestable. Sistemas de atribución como OpenLedger traen estructura a algo que históricamente ha sido vago. Hacen visible la contribución, mapean dónde fluyen los datos y introducen un nivel de transparencia que faltaba durante mucho tiempo.
Pero la visibilidad por sí sola no se traduce completamente en propiedad. El significado legal y ético del control sobre los datos sigue siendo diferente de la capacidad técnica para rastrearlos. La blockchain puede registrar el origen y el movimiento con precisión, sin embargo, no resuelve automáticamente las preguntas de permiso, retiro o derechos a largo plazo.
También hay una descoordinación más profunda entre la permanencia y los marcos de privacidad. Los sistemas construidos para registros inmutables no se alinean fácilmente con las expectativas moldeadas por las leyes modernas de protección de datos. Al mismo tiempo, la mayoría de los datos que alimentan los sistemas de IA actuales ya existen fuera de cualquier estructura de consentimiento limpio, lo que hace que el desafío sea aún más difícil de abordar en retrospectiva.
@OpenLedger #openledger $OPEN
Pero la visibilidad por sí sola no se traduce completamente en propiedad. El significado legal y ético del control sobre los datos sigue siendo diferente de la capacidad técnica para rastrearlos. La blockchain puede registrar el origen y el movimiento con precisión, sin embargo, no resuelve automáticamente las preguntas de permiso, retiro o derechos a largo plazo.
También hay una descoordinación más profunda entre la permanencia y los marcos de privacidad. Los sistemas construidos para registros inmutables no se alinean fácilmente con las expectativas moldeadas por las leyes modernas de protección de datos. Al mismo tiempo, la mayoría de los datos que alimentan los sistemas de IA actuales ya existen fuera de cualquier estructura de consentimiento limpio, lo que hace que el desafío sea aún más difícil de abordar en retrospectiva.
@OpenLedger #openledger $OPEN
4
9
363
·
--
#openledger $OPEN Hablando claro, ya estoy un poco cansado de la palabra “código abierto”. Lo que realmente me hace detenerme un segundo con @Openledger no es que digan que son de código abierto, sino si vibecoding puede generar esas pequeñas piezas que permiten que "lo que escribiste no se deseche, sino que puedas conectarlo directamente la próxima vez". Porque en esto de la pila de ejecución, al final lo que importa no es una super función, sino un montón de componentes discretos pero esenciales: previsualización de acciones, alertas de elementos faltantes, corrección de formato, visualización de pasos, comparación de diferencias... Estos son los cimientos que realmente permiten que research→action→execute funcione.
Mi propia experiencia es bastante realista: en el momento en que OctoClaw lanza la acción, lo que más suele fallar no es la lógica de la estrategia, sino que no te diste cuenta de la dependencia de un paso en la acción, un parámetro fue tragado por un valor predeterminado, o una condición se escribió de manera demasiado vaga. Si te basas solo en tus ojos, tarde o temprano te vas a perder; con perder una vez es suficiente para que estés incómodo toda la semana. Por eso, me importa más si vibecoding puede transformar esos “puntos de riesgo” en herramientas, en lugar de tener que estar esquivando peligros cada vez con la cabeza. Hoy agregas un verificador de acción, mañana añades un diff de acción, comparando dos borradores de acción para ver qué paso cambió; pasado mañana agregas un formulario de entrada, estableciendo los campos obligatorios y el formato — eso sí que es hacer que la pila de ejecución se vuelva más fuerte.
Hoy solo dejo un punto de aceptación (también el que mejor puede distinguir entre “ruido” y “ecosistema”): ¿aparecen esos componentes generales que son usados repetidamente por muchos y siguen siendo mejorados? No es solo que me sienta bien escribiéndolo, sino que otros también están dispuestos a forkear, a proponer cambios, a integrarlo de nuevo en su flujo. Mientras esta cadena de reutilización funcione, @Openledger no es solo una actualización de producto, sino que está formando una verdadera caja de herramientas de ejecución que puede sedimentarse.
@Openledger $OPEN #OpenLedger
#openledger $OPEN Hablando claro, ya estoy un poco cansado de la palabra “código abierto”. Lo que realmente me hace detenerme un segundo con @OpenLedger no es que digan que son de código abierto, sino si vibecoding puede generar esas pequeñas piezas que permiten que "lo que escribiste no se deseche, sino que puedas conectarlo directamente la próxima vez". Porque en esto de la pila de ejecución, al final lo que importa no es una super función, sino un montón de componentes discretos pero esenciales: previsualización de acciones, alertas de elementos faltantes, corrección de formato, visualización de pasos, comparación de diferencias... Estos son los cimientos que realmente permiten que research→action→execute funcione.
Mi propia experiencia es bastante realista: en el momento en que OctoClaw lanza la acción, lo que más suele fallar no es la lógica de la estrategia, sino que no te diste cuenta de la dependencia de un paso en la acción, un parámetro fue tragado por un valor predeterminado, o una condición se escribió de manera demasiado vaga. Si te basas solo en tus ojos, tarde o temprano te vas a perder; con perder una vez es suficiente para que estés incómodo toda la semana. Por eso, me importa más si vibecoding puede transformar esos “puntos de riesgo” en herramientas, en lugar de tener que estar esquivando peligros cada vez con la cabeza. Hoy agregas un verificador de acción, mañana añades un diff de acción, comparando dos borradores de acción para ver qué paso cambió; pasado mañana agregas un formulario de entrada, estableciendo los campos obligatorios y el formato — eso sí que es hacer que la pila de ejecución se vuelva más fuerte.
Hoy solo dejo un punto de aceptación (también el que mejor puede distinguir entre “ruido” y “ecosistema”): ¿aparecen esos componentes generales que son usados repetidamente por muchos y siguen siendo mejorados? No es solo que me sienta bien escribiéndolo, sino que otros también están dispuestos a forkear, a proponer cambios, a integrarlo de nuevo en su flujo. Mientras esta cadena de reutilización funcione, @OpenLedger no es solo una actualización de producto, sino que está formando una verdadera caja de herramientas de ejecución que puede sedimentarse.
@OpenLedger $OPEN #OpenLedger
Mi propia experiencia es bastante realista: en el momento en que OctoClaw lanza la acción, lo que más suele fallar no es la lógica de la estrategia, sino que no te diste cuenta de la dependencia de un paso en la acción, un parámetro fue tragado por un valor predeterminado, o una condición se escribió de manera demasiado vaga. Si te basas solo en tus ojos, tarde o temprano te vas a perder; con perder una vez es suficiente para que estés incómodo toda la semana. Por eso, me importa más si vibecoding puede transformar esos “puntos de riesgo” en herramientas, en lugar de tener que estar esquivando peligros cada vez con la cabeza. Hoy agregas un verificador de acción, mañana añades un diff de acción, comparando dos borradores de acción para ver qué paso cambió; pasado mañana agregas un formulario de entrada, estableciendo los campos obligatorios y el formato — eso sí que es hacer que la pila de ejecución se vuelva más fuerte.
Hoy solo dejo un punto de aceptación (también el que mejor puede distinguir entre “ruido” y “ecosistema”): ¿aparecen esos componentes generales que son usados repetidamente por muchos y siguen siendo mejorados? No es solo que me sienta bien escribiéndolo, sino que otros también están dispuestos a forkear, a proponer cambios, a integrarlo de nuevo en su flujo. Mientras esta cadena de reutilización funcione, @OpenLedger no es solo una actualización de producto, sino que está formando una verdadera caja de herramientas de ejecución que puede sedimentarse.
@OpenLedger $OPEN #OpenLedger
75
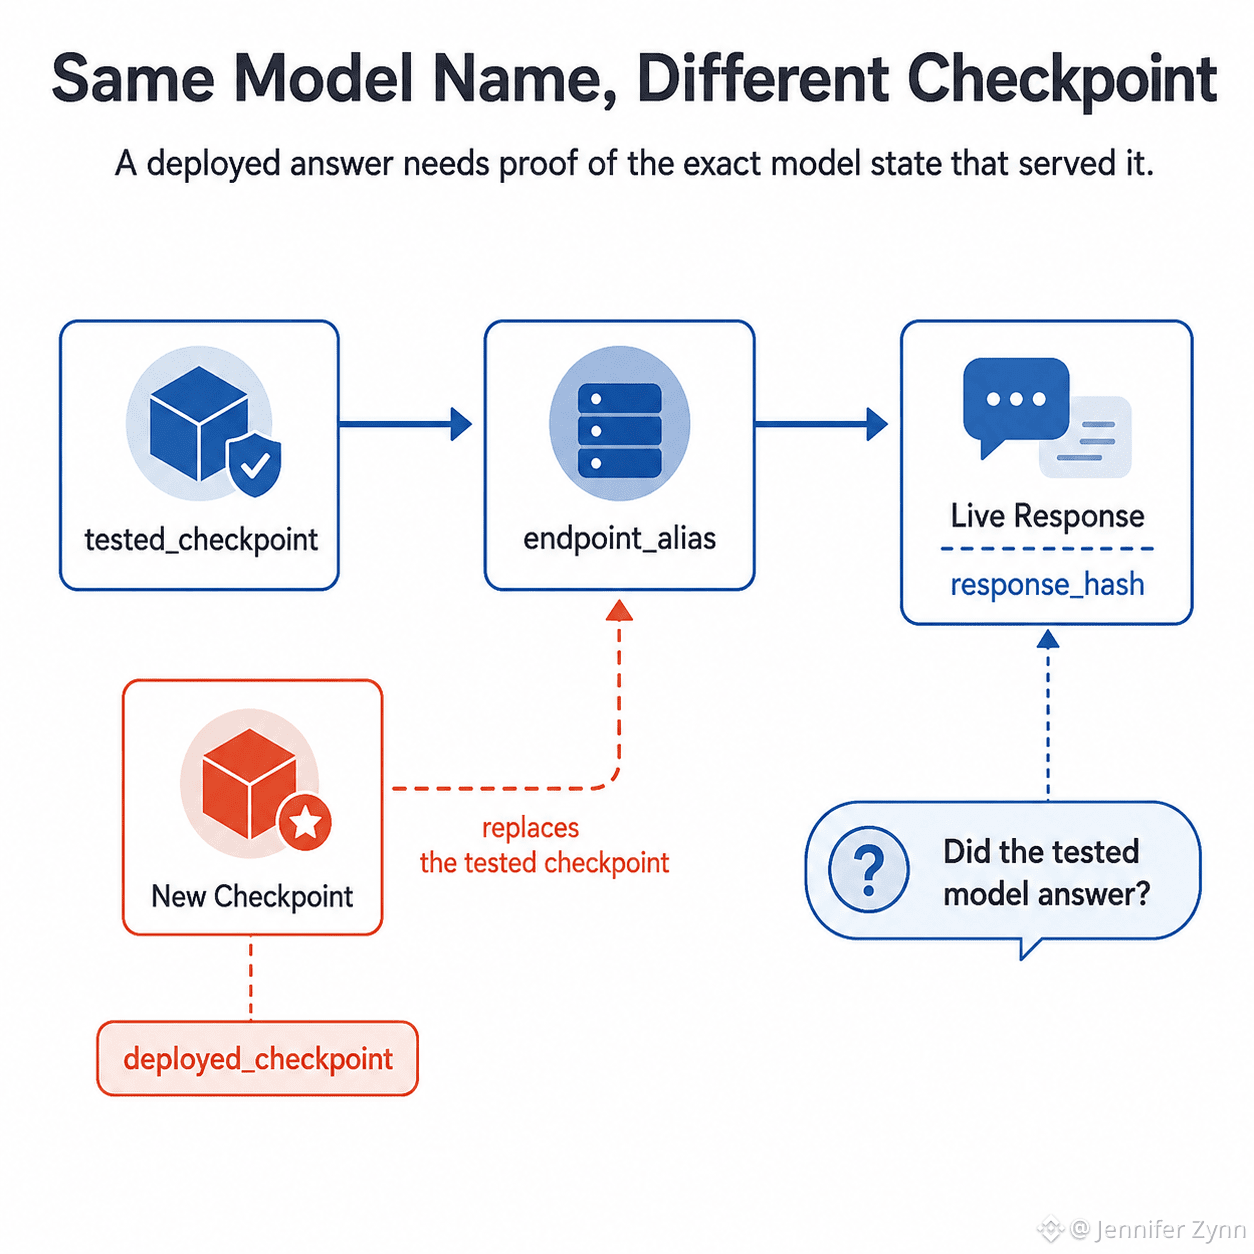
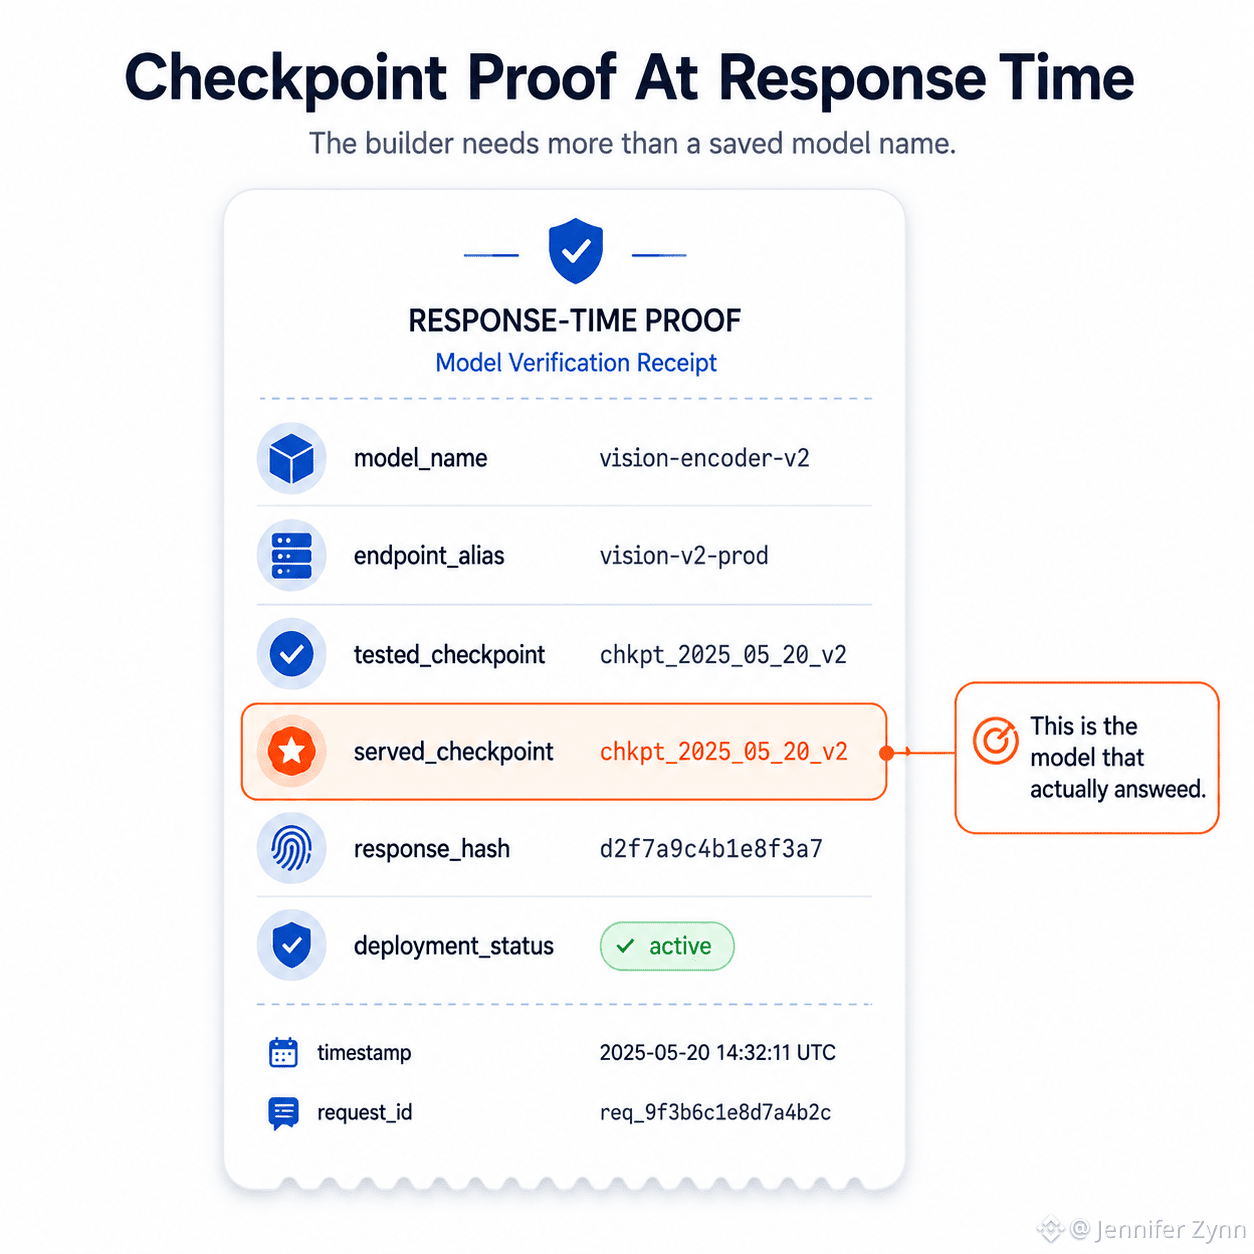
El desorden oculto que veo en OpenLedger es el nombre del modelo que se mantiene limpio mientras que el checkpoint debajo cambia.
Un constructor puede entrenar a través de Model Factory, probar la salida, conectarlo a una app y llamar al modelo por el mismo nombre guardado. Todo parece utilizable. La respuesta vuelve. La integración no se rompe.
Entonces, la parte difícil comienza después de que el modelo ya funciona.
¿Cuál checkpoint exacto respondió al usuario?
No el nombre del modelo. No la etiqueta del espacio de trabajo. El checkpoint. Si una ejecución más nueva reemplaza a la probada detrás del mismo endpoint, el constructor puede estar mirando la aprobación de ayer mientras que la respuesta de hoy provino de un estado diferente del modelo.
La prueba necesita estar cerca de la llamada. tested_checkpoint, deployed_checkpoint, endpoint_alias, response_hash. Sin eso, la app puede comportarse normalmente mientras que la pista de auditoría ya está dividida.
La consecuencia visible recae en el constructor. Pueden aprobar un modelo, enviar otro por accidente y luego no tener una forma clara de explicar por qué una respuesta en vivo cambió después del despliegue.
Ahí es donde OPEN tiene presión. El valor no debería adjuntarse a una etiqueta de modelo amigable. Debería adjuntarse al checkpoint que realmente sirvió la respuesta.
Un nombre de modelo guardado es conveniente. Si oculta el checkpoint, se convierte en el lugar donde un constructor pierde el control. #OpenLedger $OPEN @Openledger $XEC $BOB
El desorden oculto que veo en OpenLedger es el nombre del modelo que se mantiene limpio mientras que el checkpoint debajo cambia.
Un constructor puede entrenar a través de Model Factory, probar la salida, conectarlo a una app y llamar al modelo por el mismo nombre guardado. Todo parece utilizable. La respuesta vuelve. La integración no se rompe.
Entonces, la parte difícil comienza después de que el modelo ya funciona.
¿Cuál checkpoint exacto respondió al usuario?
No el nombre del modelo. No la etiqueta del espacio de trabajo. El checkpoint. Si una ejecución más nueva reemplaza a la probada detrás del mismo endpoint, el constructor puede estar mirando la aprobación de ayer mientras que la respuesta de hoy provino de un estado diferente del modelo.
La prueba necesita estar cerca de la llamada. tested_checkpoint, deployed_checkpoint, endpoint_alias, response_hash. Sin eso, la app puede comportarse normalmente mientras que la pista de auditoría ya está dividida.
La consecuencia visible recae en el constructor. Pueden aprobar un modelo, enviar otro por accidente y luego no tener una forma clara de explicar por qué una respuesta en vivo cambió después del despliegue.
Ahí es donde OPEN tiene presión. El valor no debería adjuntarse a una etiqueta de modelo amigable. Debería adjuntarse al checkpoint que realmente sirvió la respuesta.
Un nombre de modelo guardado es conveniente. Si oculta el checkpoint, se convierte en el lugar donde un constructor pierde el control. #OpenLedger $OPEN @OpenLedger $XEC $BOB
Un constructor puede entrenar a través de Model Factory, probar la salida, conectarlo a una app y llamar al modelo por el mismo nombre guardado. Todo parece utilizable. La respuesta vuelve. La integración no se rompe.
Entonces, la parte difícil comienza después de que el modelo ya funciona.
¿Cuál checkpoint exacto respondió al usuario?
No el nombre del modelo. No la etiqueta del espacio de trabajo. El checkpoint. Si una ejecución más nueva reemplaza a la probada detrás del mismo endpoint, el constructor puede estar mirando la aprobación de ayer mientras que la respuesta de hoy provino de un estado diferente del modelo.
La prueba necesita estar cerca de la llamada. tested_checkpoint, deployed_checkpoint, endpoint_alias, response_hash. Sin eso, la app puede comportarse normalmente mientras que la pista de auditoría ya está dividida.
La consecuencia visible recae en el constructor. Pueden aprobar un modelo, enviar otro por accidente y luego no tener una forma clara de explicar por qué una respuesta en vivo cambió después del despliegue.
Ahí es donde OPEN tiene presión. El valor no debería adjuntarse a una etiqueta de modelo amigable. Debería adjuntarse al checkpoint que realmente sirvió la respuesta.
Un nombre de modelo guardado es conveniente. Si oculta el checkpoint, se convierte en el lugar donde un constructor pierde el control. #OpenLedger $OPEN @OpenLedger $XEC $BOB
3
445
·
--
Mientras trabajaba en CreatorPad, una cosa se volvió imposible de ignorar: la atribución se vuelve mucho más complicada en cuanto aumenta la complejidad.
OpenLedger busca hacer que cada contribución sea medible, pero el desafío no es rastrear la influencia, sino decidir cuánta influencia realmente importa. Cuanto más profunda es la cadena de entradas, más fácil se vuelve que los contribuyentes significativos desaparezcan detrás de modelos de puntuación simplificados.
La verdadera prueba para la atribución de IA no es la transparencia. Es si los contribuyentes de larga cola pueden retener su parte del valor a medida que las redes escalan.
@Openledger | #OpenLedger
$OPEN
{future}(OPENUSDT)
Mientras trabajaba en CreatorPad, una cosa se volvió imposible de ignorar: la atribución se vuelve mucho más complicada en cuanto aumenta la complejidad.
OpenLedger busca hacer que cada contribución sea medible, pero el desafío no es rastrear la influencia, sino decidir cuánta influencia realmente importa. Cuanto más profunda es la cadena de entradas, más fácil se vuelve que los contribuyentes significativos desaparezcan detrás de modelos de puntuación simplificados.
La verdadera prueba para la atribución de IA no es la transparencia. Es si los contribuyentes de larga cola pueden retener su parte del valor a medida que las redes escalan.
@OpenLedger | #OpenLedger
$OPEN
OpenLedger busca hacer que cada contribución sea medible, pero el desafío no es rastrear la influencia, sino decidir cuánta influencia realmente importa. Cuanto más profunda es la cadena de entradas, más fácil se vuelve que los contribuyentes significativos desaparezcan detrás de modelos de puntuación simplificados.
La verdadera prueba para la atribución de IA no es la transparencia. Es si los contribuyentes de larga cola pueden retener su parte del valor a medida que las redes escalan.
@OpenLedger | #OpenLedger
$OPEN
2
2
70
Inicia sesión para explorar más contenidos
Únete a usuarios de criptomonedas de todo el mundo en Binance Square
⚡️ Obtén la información más reciente y útil sobre criptomonedas.
💬 Confía en el mayor exchange de criptomonedas del mundo.
👍 Descubre opiniones reales de creadores verificados.
Correo electrónico/número de teléfono
Temas en tendencia
1
#CryptoSelloffTriggersMultipleWhaleLiquidations
45,319 visualizaciones
674 participa(n) en el debate
2
#USSpotXRPETFsSeeLargestWeeklyOutflowIn8Months
76,527 visualizaciones
911 participa(n) en el debate
3
#WillFOMCMinutesReinforceRateHikeExpectations?
12,110 visualizaciones
276 participa(n) en el debate
4
#BitcoinActiveSupplyInProfitDropsBelow45%
142,502 visualizaciones
1,265 participa(n) en el debate
5
#TONStrategyReports$23.97MQ3NetLoss
15,172 visualizaciones
104 participa(n) en el debate
6
#KavaSaysAbnormalActivityLimitedToKavaLend
92,838 visualizaciones
698 participa(n) en el debate
7
#WORPTLetsTouristsConvertCryptoToThaiBaht
25,055 visualizaciones
241 participa(n) en el debate
8
#WhoWillSucceedJensenHuangatNvidia?
269,223 visualizaciones
1,979 participa(n) en el debate
9
#WhatWillDriveCryptoandStocks’NextRebound?
744,215 visualizaciones
3,788 participa(n) en el debate
10
#TradFiForBeginners
793,571 visualizaciones
4,772 participa(n) en el debate