
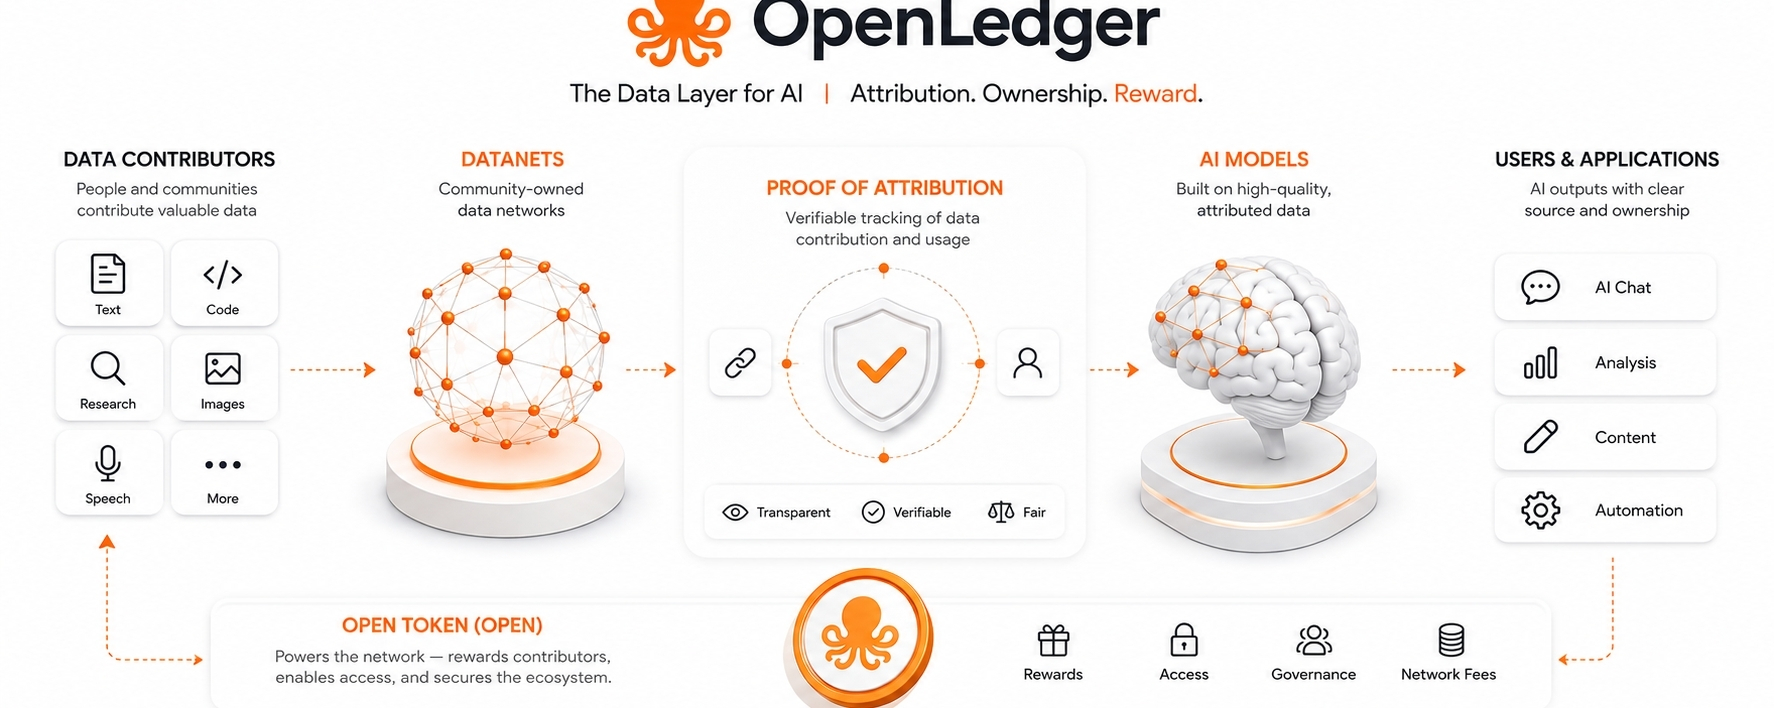

OpenLedger me hace pensar en una de las cosas más feas en cripto y IA al mismo tiempo: todo el mundo quiere la recompensa, pero casi nadie quiere hablar del desmadre que hay debajo. Los datos. La fuente. Las personas que realmente contribuyeron con algo. Los usuarios falsos. Los farmers. El trabajo invisible que se traga un sistema y luego se vende de nuevo a todos con un logo más limpio.
Mira, estoy cansado de las presentaciones de cripto relacionadas con IA.
Realmente cansado.
Cada semana hay otro proyecto que actúa como si hubiera encontrado la respuesta final. Otro token. Otro dashboard. Otro hilo explicando por qué esto es el “futuro de la inteligencia” o cualquier frase que esté funcionando este mes.
En algún momento, dejas de aplaudir.
Solo preguntas: ¿qué está realmente roto aquí?
Con OpenLedger, al menos la parte rota es real.
Los modelos de IA necesitan datos. No magia. No vibras. Datos. Trabajo humano. Conocimiento comunitario. Investigación de nicho. Código. Escritura. Comportamiento de trading. Conocimiento local. Rincones raros de internet que solo importan porque personas reales pasaron tiempo creándolos.
Entonces el modelo se lo come todo.
Y el contribuyente desaparece.
Esa parte me molesta.
Debería molestar a más personas.
OpenLedger está tratando de lidiar con esa capa. No la capa de salida brillante donde todos escriben un prompt y pretenden que la máquina es inteligente por sí sola. Me refiero a la parte bajo el capó. La plomería aburrida. La parte donde los datos vienen de algún lugar, alguien los contribuyó, y tal vez esa contribución no debería desaparecer para siempre.
No es llamativo.
Simplemente es necesario.
Honestamente, por eso lo encuentro más interesante que la mayoría de las monedas de IA. No porque suene perfecto. No lo es. No porque crea que cripto mágicamente arregla la IA. No lo hace. Pero porque OpenLedger se centra en un punto de dolor real: la atribución.
¿Quién dio los datos?
¿Quién ayudó a entrenar el modelo?
¿Quién merece el crédito?
¿Quién recibe pago?
¿Quién es borrado?
Estas preguntas no son limpias. Son incómodas. Y eso es probablemente por lo que la mayoría de los proyectos las evitan.
El asunto es que la gente de cripto ya ha vivido el lado feo de los sistemas de incentivos. Sabemos qué pasa cuando hay recompensas involucradas. Hemos visto airdrops ser explotados hasta el cansancio. Hemos visto usuarios falsos inundar testnets. Hemos visto comunidades actuar leales hasta que se abre la página de reclamo. Hemos visto que la “tracción orgánica” resulta ser billeteras persiguiendo puntos.
Así que cuando OpenLedger habla de recompensar a los contribuyentes de datos, mi primera reacción no es un elogio ciego.
Mi primera reacción es: está bien, pero ¿cómo detienes la basura?
Porque la gente intentará manipularlo.
Siempre lo hacen.
Si hay una recompensa por contribuir datos, algunos usuarios contribuirán datos útiles. Otros arrojarán basura. Contenido duplicado. Material de bajo esfuerzo. Cuentas Sybil. Ruido reciclado. Cualquier cosa que parezca actividad desde afuera.
Ese es el lío que OpenLedger tiene que sobrevivir.
Y es un lío serio.
Aquí es donde el proyecto se vuelve interesante, pero también difícil. La Prueba de Atribución suena como la dirección correcta, pero la atribución de IA no es simple. Un modelo no aprende como una persona leyendo un párrafo y diciendo: 'Gracias, esta idea exacta vino de aquí.' Absorbe patrones. Mezcla fuentes. Comprime información. Se vuelve muy difícil decir quién contribuyó qué de una manera que se sienta justa.
Así que OpenLedger no está resolviendo un problemita fácil de seguimiento.
Es entrar en una de las partes más molestas de la IA.
Quizás por eso respeto el intento.
No el hype a su alrededor. El intento.
La idea de Datanets también tiene sentido para mí porque los datos especializados probablemente sean donde esto tenga una mejor oportunidad. No creo realmente que cada proyecto de IA en cripto necesite luchar directamente contra OpenAI o Google o los grandes laboratorios. Eso generalmente suena como fantasía. Esas compañías tienen dinero, talento, computación, distribución y abogados. Cripto tiene grupos de Telegram discutiendo sobre desbloqueos.
¿Pero redes de datos enfocadas?
Eso se siente más realista.
Una comunidad de nicho construyendo alrededor de un tipo específico de datos. Un modelo entrenado para un caso de uso específico. Contribuyentes siendo rastreados. Valor que no desaparece en una máquina cerrada. Esa no es una historia glamorosa, pero está más cerca de la infraestructura real.
Y cripto necesita más de eso.
Menos teatro.
Más plomería.
Aun así, OpenLedger tiene un camino difícil. Tiene que probar que las personas contribuirán datos de calidad, no solo farmear recompensas. Tiene que probar que a los constructores les importa lo suficiente como para usar el sistema. Tiene que probar que la atribución puede confiarse, incluso si no es perfecta. Tiene que probar que el token está conectado a un uso real, no solo otra razón para que la gente especule durante un ciclo de IA.
Esa última parte importa.
Porque hay un token, y una vez que hay un token, todo cambia.
Las personas dejan de preguntar qué hace el sistema y comienzan a preguntar cuándo se lista, cuándo sube, cuándo comienza la próxima campaña, cuándo caen las próximas recompensas. El proyecto se convierte en un objeto de mercado antes de convertirse en una infraestructura útil. Esa es la enfermedad normal de cripto.
OpenLedger no es inmune a ello.
Ningún proyecto lo es.
OPEN teniendo un papel en tarifas, recompensas y actividad de la red le da algo de lógica. Bien. Eso es mejor que un token que solo existe para el teatro de gobernanza. Pero la utilidad en papel no es suficiente. Si la red no crea una demanda real, el token se convierte en otra máquina circular.
Las recompensas traen usuarios.
Los usuarios crean actividad.
La actividad crea hype.
El hype apoya el token.
Entonces las recompensas disminuyen.
Y de repente todos descubren qué era real.
Hemos visto esa película demasiadas veces.
Por eso no quiero vender demasiado OpenLedger. La idea es lo suficientemente sólida sin pretender que está garantizada. Puede tomar tiempo. Puede ser complicado. Puede que funcione solo en ciertos nichos al principio. Puede que tenga problemas con el control de calidad. Puede que atraiga a más agricultores que constructores al principio.
Eso no me sorprendería.
De hecho, espero algo de eso.
Pero el proyecto sigue tocando algo importante. La IA tiene un problema de extracción de valor. Muchas personas contribuyen a la capa de conocimiento, pero solo unas pocas plataformas capturan la mayor parte de la ganancia. OpenLedger está tratando de hacer que esa capa de contribución sea visible y utilizable.
Eso vale la pena observar.
No adorando.
Observando.
Mira, no necesito que OpenLedger se convierta en algo gigante que cambie el mundo para que importe. A la gente de cripto le encanta dramatizar todo. A veces un proyecto solo necesita arreglar una pieza fea de infraestructura que todos los demás siguen ignorando.
La atribución de datos es una de esas piezas feas.
Nadie quiere pensar en eso cuando la salida del modelo se ve limpia. Nadie quiere preguntar de dónde vino el valor cuando la demostración funciona. Nadie quiere lidiar con la aburrida contabilidad de contribuciones, propiedad y recompensas.
Pero eventualmente, esas cosas importan.
Especialmente si la IA sigue consumiendo más de internet.
La parte difícil para OpenLedger es la confianza. No solo confianza en la cadena. Confianza en el proceso. Confianza en que la contribución se mide de manera justa. Confianza en que el sistema de recompensas no se convierta en un juego de farming. Confianza en que los conjuntos de datos son realmente útiles. Confianza en que los constructores no están allí solo por incentivos. Confianza en que todo esto no es otra narrativa de IA usando ropa de infraestructura.
Eso es mucha confianza para ganar.
Y no se ganará a través de eslóganes.
Se ganará a través de un uso aburrido.
Personas contribuyendo datos reales. Constructores creando modelos que realmente funcionan. Usuarios pagando porque la salida es útil. Comunidades quedándose después de que el hype se enfría. Menos ruido. Más pruebas.
Esa es la única versión de OpenLedger que me importa.
Quizás llegue allí.
Quizás no lo haga.
El asunto es que preferiría ver un proyecto tratando de resolver un problema aburrido y real que otro token de IA brillante pretendiendo que un chatbot necesita una moneda. OpenLedger al menos vive más cerca del verdadero lío: datos, atribución, incentivos, contribuyentes y valor del modelo.
Eso no es limpio.
Eso no es fácil.
Pero se siente más cerca de la realidad.
Y después de suficientes ciclos cripto, la realidad comienza a importar más que la presentación.