
MR-Zero-X
2.2k Beiträge
MR-Zero-X
Melden
Nutzer blockieren
高风险,高回报|精准分析|用数据说话. High risk, high reward | Precise analysis | Let data speak
260 Following
11.9K+ Follower
1.7K+ Like gegeben
Beiträge
Portfolio
Alle
Zitierungen
Live
·
--
Übersetzung ansehen
#dusk $DUSK
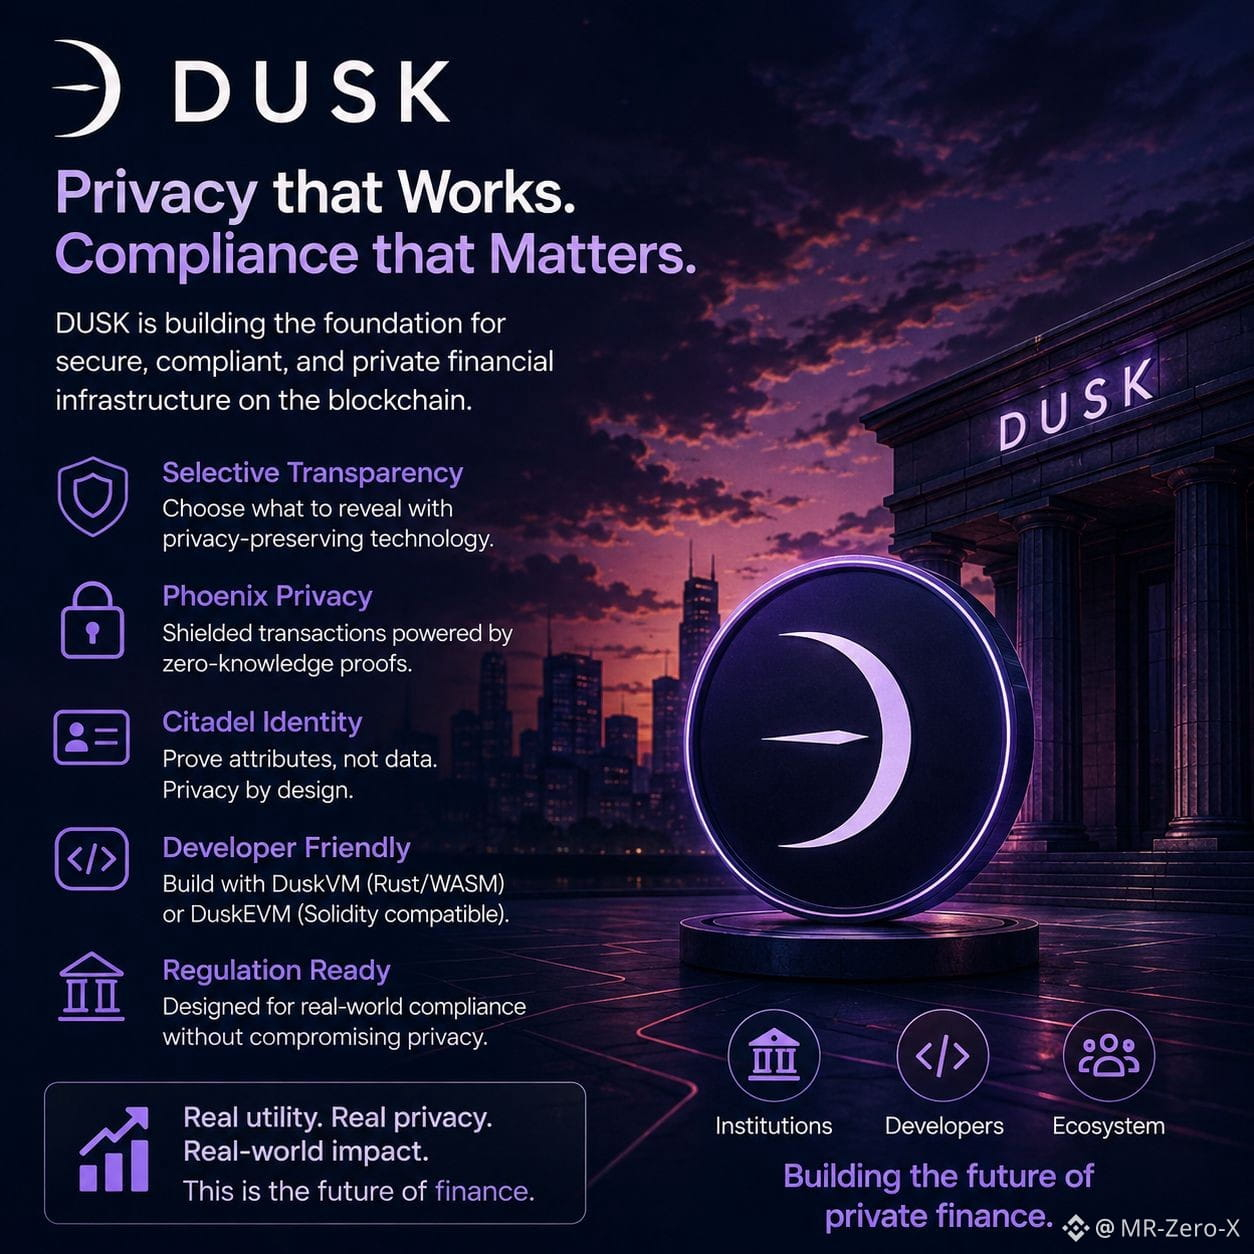
What caught my attention about DUSK wasn’t another blockchain claiming to solve privacy.
It was a much simpler question: who actually needs to see what?
The more I explored DUSK, the more I liked this way of thinking.
Instead of treating privacy as “hide everything,” DUSK separates different types of visibility. Its Moonlight model handles transparent transactions, while Phoenix uses zero-knowledge proofs to keep sensitive transaction details private while still proving validity.
That distinction feels important to me.
Financial markets aren’t completely public or completely private. Institutions may need confidentiality around certain information, while regulators or authorized participants still need reliable proof.
That’s where DUSK’s approach became more interesting for me.
I also looked into its identity layer, Citadel. What stood out is the idea of proving specific attributes without unnecessarily exposing the underlying information. To me, that feels much closer to how privacy could work in real-world financial systems.
Then there’s the developer side.
DUSK supports DuskVM for Rust/WASM applications while also providing DuskEVM compatibility for developers familiar with Solidity, Vyper, and EVM tooling.
I’m not taking any of this as a guarantee of success.
What I’m watching now is much more practical: can developers actually build useful financial applications around these privacy and compliance primitives?
That’s the part of DUSK I’m most curious to see unfold.
@Dusk_Foundation #DUSK $DUSK
#dusk $DUSK
What caught my attention about DUSK wasn’t another blockchain claiming to solve privacy.
It was a much simpler question: who actually needs to see what?
The more I explored DUSK, the more I liked this way of thinking.
Instead of treating privacy as “hide everything,” DUSK separates different types of visibility. Its Moonlight model handles transparent transactions, while Phoenix uses zero-knowledge proofs to keep sensitive transaction details private while still proving validity.
That distinction feels important to me.
Financial markets aren’t completely public or completely private. Institutions may need confidentiality around certain information, while regulators or authorized participants still need reliable proof.
That’s where DUSK’s approach became more interesting for me.
I also looked into its identity layer, Citadel. What stood out is the idea of proving specific attributes without unnecessarily exposing the underlying information. To me, that feels much closer to how privacy could work in real-world financial systems.
Then there’s the developer side.
DUSK supports DuskVM for Rust/WASM applications while also providing DuskEVM compatibility for developers familiar with Solidity, Vyper, and EVM tooling.
I’m not taking any of this as a guarantee of success.
What I’m watching now is much more practical: can developers actually build useful financial applications around these privacy and compliance primitives?
That’s the part of DUSK I’m most curious to see unfold.
@Dusk #DUSK $DUSK
What caught my attention about DUSK wasn’t another blockchain claiming to solve privacy.
It was a much simpler question: who actually needs to see what?
The more I explored DUSK, the more I liked this way of thinking.
Instead of treating privacy as “hide everything,” DUSK separates different types of visibility. Its Moonlight model handles transparent transactions, while Phoenix uses zero-knowledge proofs to keep sensitive transaction details private while still proving validity.
That distinction feels important to me.
Financial markets aren’t completely public or completely private. Institutions may need confidentiality around certain information, while regulators or authorized participants still need reliable proof.
That’s where DUSK’s approach became more interesting for me.
I also looked into its identity layer, Citadel. What stood out is the idea of proving specific attributes without unnecessarily exposing the underlying information. To me, that feels much closer to how privacy could work in real-world financial systems.
Then there’s the developer side.
DUSK supports DuskVM for Rust/WASM applications while also providing DuskEVM compatibility for developers familiar with Solidity, Vyper, and EVM tooling.
I’m not taking any of this as a guarantee of success.
What I’m watching now is much more practical: can developers actually build useful financial applications around these privacy and compliance primitives?
That’s the part of DUSK I’m most curious to see unfold.
@Dusk #DUSK $DUSK
1
1
273
·
--
Übersetzung ansehen
#dusk $DUSK
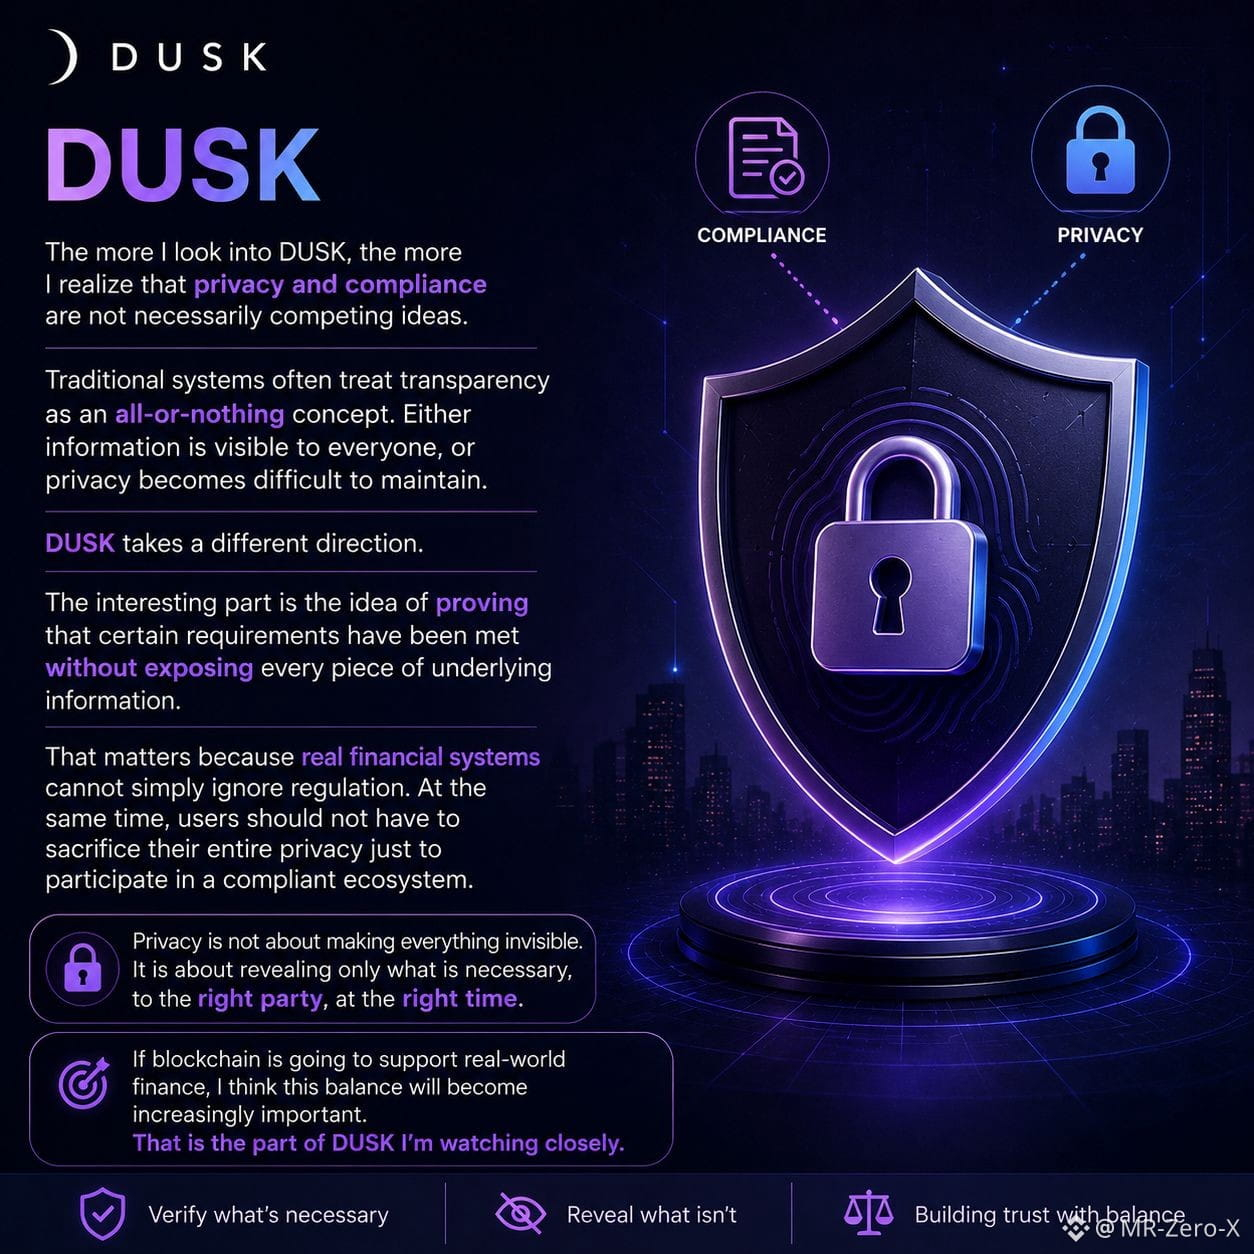
@Dusk_Foundation The more I look into DUSK, the more I realize that privacy and compliance are not necessarily competing ideas.
Traditional systems often treat transparency as an all-or-nothing concept. Either information is visible to everyone, or privacy becomes difficult to maintain.
$DUSK takes a different direction.
The interesting part is the idea of proving that certain requirements have been met without exposing every piece of underlying information.
That matters because real financial systems cannot simply ignore regulation. At the same time, users should not have to sacrifice their entire privacy just to participate in a compliant ecosystem.
For me, this is where the conversation becomes more practical.
Privacy is not about making everything invisible.
It is about revealing only what is necessary, to the right party, at the right time.
If blockchain is going to support real-world finance, I think this balance will become increasingly important.
That is the part of DUSK I’m watching closely.
#DUSK $DUSK
#dusk $DUSK
@Dusk The more I look into DUSK, the more I realize that privacy and compliance are not necessarily competing ideas.
Traditional systems often treat transparency as an all-or-nothing concept. Either information is visible to everyone, or privacy becomes difficult to maintain.
$DUSK takes a different direction.
The interesting part is the idea of proving that certain requirements have been met without exposing every piece of underlying information.
That matters because real financial systems cannot simply ignore regulation. At the same time, users should not have to sacrifice their entire privacy just to participate in a compliant ecosystem.
For me, this is where the conversation becomes more practical.
Privacy is not about making everything invisible.
It is about revealing only what is necessary, to the right party, at the right time.
If blockchain is going to support real-world finance, I think this balance will become increasingly important.
That is the part of DUSK I’m watching closely.
#DUSK $DUSK
@Dusk The more I look into DUSK, the more I realize that privacy and compliance are not necessarily competing ideas.
Traditional systems often treat transparency as an all-or-nothing concept. Either information is visible to everyone, or privacy becomes difficult to maintain.
$DUSK takes a different direction.
The interesting part is the idea of proving that certain requirements have been met without exposing every piece of underlying information.
That matters because real financial systems cannot simply ignore regulation. At the same time, users should not have to sacrifice their entire privacy just to participate in a compliant ecosystem.
For me, this is where the conversation becomes more practical.
Privacy is not about making everything invisible.
It is about revealing only what is necessary, to the right party, at the right time.
If blockchain is going to support real-world finance, I think this balance will become increasingly important.
That is the part of DUSK I’m watching closely.
#DUSK $DUSK
178
·
--
Übersetzung ansehen
@Dusk_Foundation $DUSK
I’ve been looking at Dusk from a simple question:
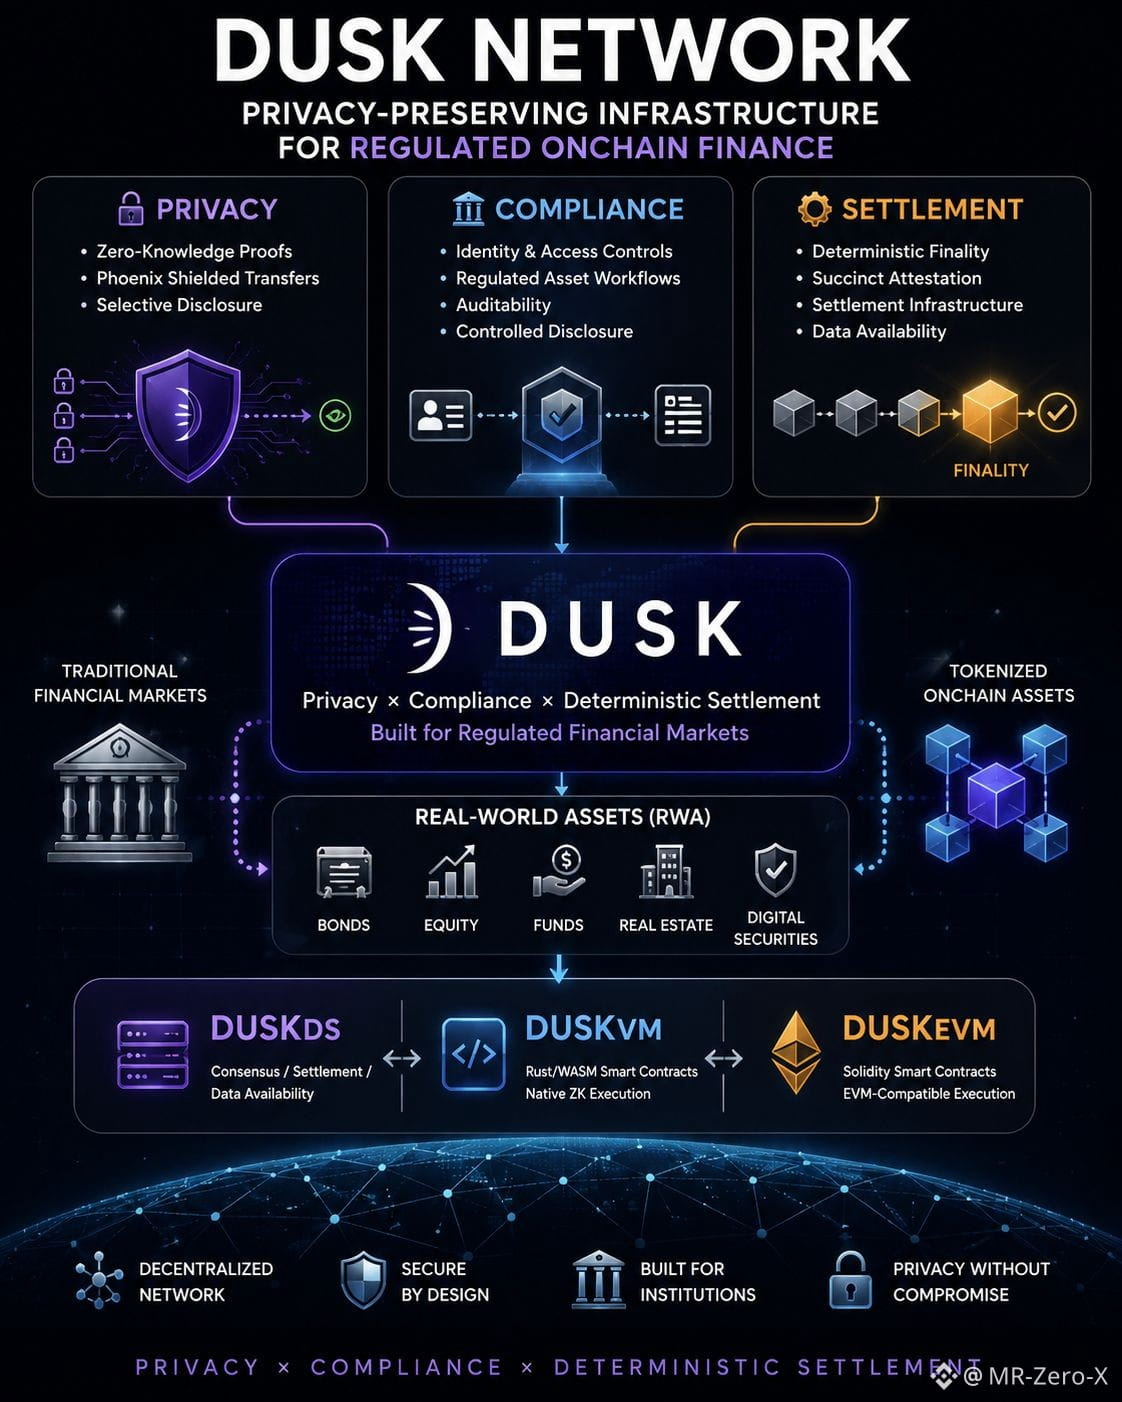
Can blockchain infrastructure give institutions privacy without sacrificing compliance?
That’s where Dusk gets interesting to me.
🔐 PRIVACY
• Zero-knowledge technology
• Shielded transactions
• Selective disclosure
🏛️ COMPLIANCE
• Identity & access controls
• Regulated asset workflows
• Privacy with verifiability
⚙️ SETTLEMENT
• Deterministic finality
• Succinct Attestation consensus
• Infrastructure designed for financial applications
🌍 RWA
The bigger idea isn’t simply putting real-world assets on a blockchain.
It’s building the rails for issuance, ownership, transfer and settlement while keeping privacy and regulatory requirements in the picture.
That’s the part I’ll be watching closely.
👇 Do you think privacy + compliance can become the missing piece for institutional blockchain adoption?
#Dusk #RWA #Privacy #Layer1 #BinanceSquare
@Dusk $DUSK
I’ve been looking at Dusk from a simple question:
Can blockchain infrastructure give institutions privacy without sacrificing compliance?
That’s where Dusk gets interesting to me.
🔐 PRIVACY
• Zero-knowledge technology
• Shielded transactions
• Selective disclosure
🏛️ COMPLIANCE
• Identity & access controls
• Regulated asset workflows
• Privacy with verifiability
⚙️ SETTLEMENT
• Deterministic finality
• Succinct Attestation consensus
• Infrastructure designed for financial applications
🌍 RWA
The bigger idea isn’t simply putting real-world assets on a blockchain.
It’s building the rails for issuance, ownership, transfer and settlement while keeping privacy and regulatory requirements in the picture.
That’s the part I’ll be watching closely.
👇 Do you think privacy + compliance can become the missing piece for institutional blockchain adoption?
#Dusk #RWA #Privacy #Layer1 #BinanceSquare
I’ve been looking at Dusk from a simple question:
Can blockchain infrastructure give institutions privacy without sacrificing compliance?
That’s where Dusk gets interesting to me.
🔐 PRIVACY
• Zero-knowledge technology
• Shielded transactions
• Selective disclosure
🏛️ COMPLIANCE
• Identity & access controls
• Regulated asset workflows
• Privacy with verifiability
⚙️ SETTLEMENT
• Deterministic finality
• Succinct Attestation consensus
• Infrastructure designed for financial applications
🌍 RWA
The bigger idea isn’t simply putting real-world assets on a blockchain.
It’s building the rails for issuance, ownership, transfer and settlement while keeping privacy and regulatory requirements in the picture.
That’s the part I’ll be watching closely.
👇 Do you think privacy + compliance can become the missing piece for institutional blockchain adoption?
#Dusk #RWA #Privacy #Layer1 #BinanceSquare
1
154
·
--
#baby $BABY
@Babylon Mir ist aufgefallen, dass beim Bitcoin-Staking das Anziehen von Kapital nur das erste Etappenziel ist.
Die größere Herausforderung besteht darin, dieses Kapital langfristig aktiv zu halten.
Aus genau diesem Grund beobachte ich das Babylon-Ökosystem $BABY besonders genau.
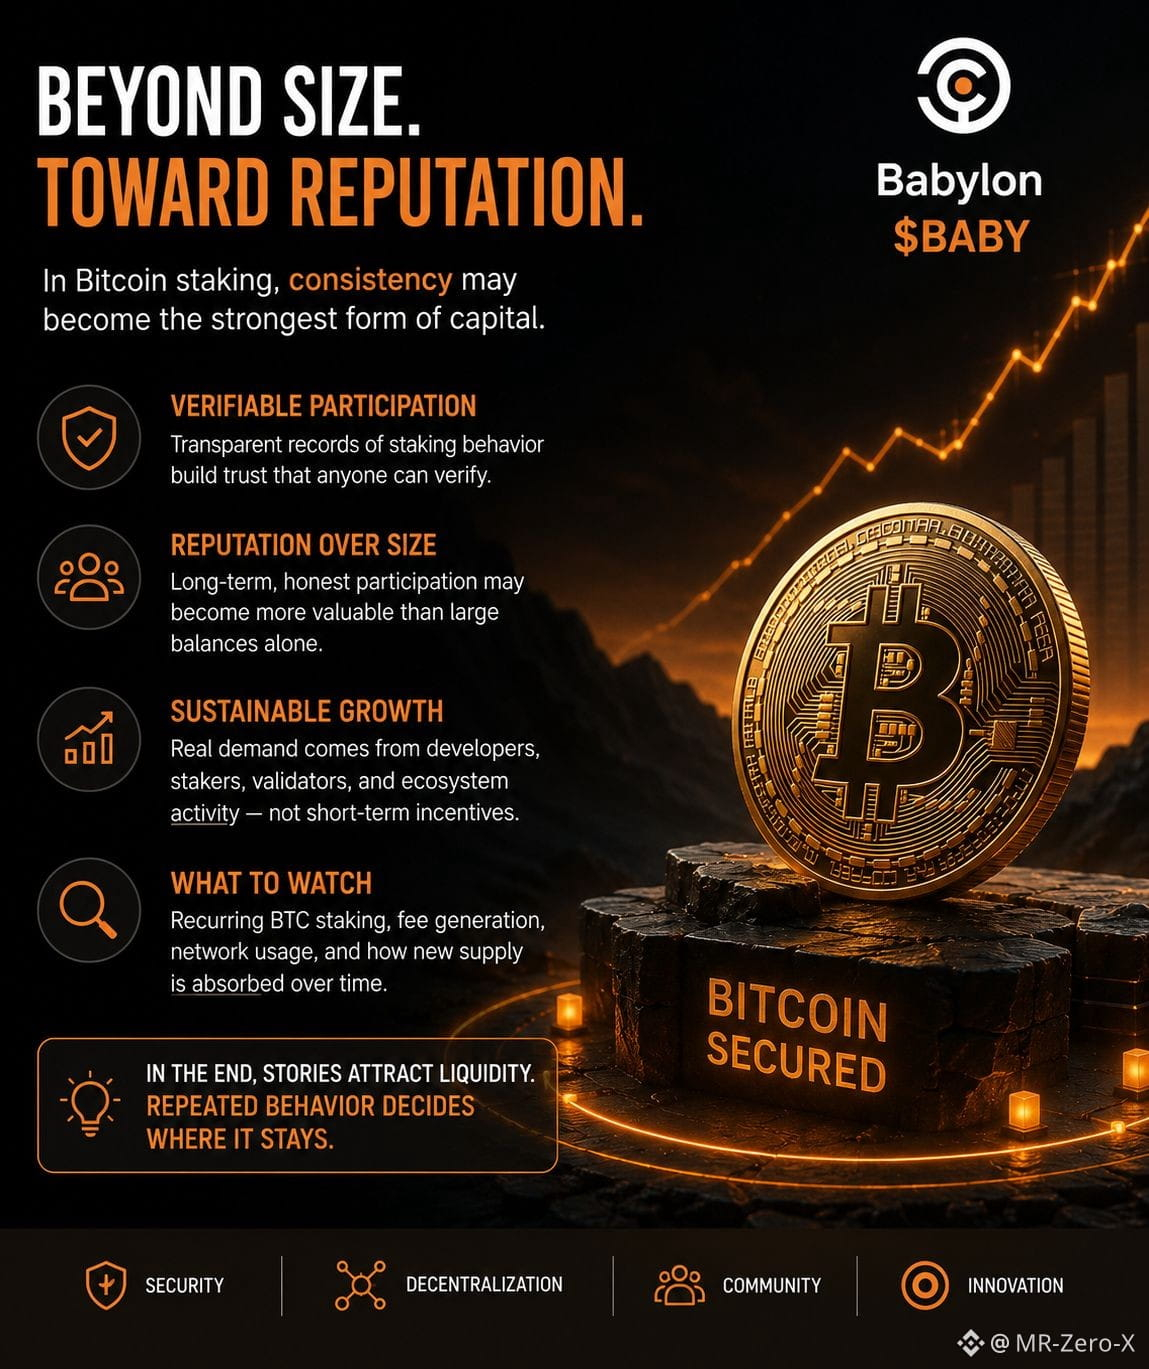
Wenn Bitcoin-Staking weiterhin mehrere Netzwerke absichert, bauen die Teilnehmenden eine On-Chain-Historie auf, die jeder überprüfen kann. Im Laufe der Zeit könnte diese Historie zu einem wertvollen Signal für Verlässlichkeit werden.
Ein Validator, der in unterschiedlichen Marktbedingungen durchgehend gute Leistungen erbringt, kann zur Netzwerksicherheit beitragen, mehr als einer, der lediglich für kurze Zeit mit einer großen Stakaussage in Erscheinung tritt.
Natürlich funktioniert das nur, wenn das Netzwerk weiterhin echten Bedarf erzeugt.
Entwickler brauchen nützliche Infrastruktur.
Staker brauchen nachhaltige Belohnungen.
Validatoren brauchen genug wirtschaftliche Aktivität, um es sich zu rechtfertigen, online zu bleiben.
Für mich sind die wichtigsten Kennzahlen nicht täglicher Hype oder Kursbewegungen. Ich beobachte wiederkehrendes BTC-Staking, die Validator-Teilnahme, das Wachstum des Ökosystems, die Erzeugung von Gebühren und ob die Netzwerkaktivität sich weiter stärkt, nachdem die anfängliche Begeisterung nachlässt.
Starke Narrative ziehen Aufmerksamkeit auf sich.
Der langfristige Nutzen entscheidet meist darüber, ob ein Ökosystem weiter wächst.
Was wird für Babylon in den nächsten Jahren Ihrer Meinung nach wichtiger sein: mehr BTC-Staker oder mehr echte Anwendungen, die auf dem Netzwerk aufbauen? 👇
#Babylon #baby #bitcoin #BTC
{spot}(BTCUSDT)
{future}(SOLUSDT)
{spot}(BABYUSDT)
#baby $BABY
@Babylon Mir ist aufgefallen, dass beim Bitcoin-Staking das Anziehen von Kapital nur das erste Etappenziel ist.
Die größere Herausforderung besteht darin, dieses Kapital langfristig aktiv zu halten.
Aus genau diesem Grund beobachte ich das Babylon-Ökosystem $BABY besonders genau.
Wenn Bitcoin-Staking weiterhin mehrere Netzwerke absichert, bauen die Teilnehmenden eine On-Chain-Historie auf, die jeder überprüfen kann. Im Laufe der Zeit könnte diese Historie zu einem wertvollen Signal für Verlässlichkeit werden.
Ein Validator, der in unterschiedlichen Marktbedingungen durchgehend gute Leistungen erbringt, kann zur Netzwerksicherheit beitragen, mehr als einer, der lediglich für kurze Zeit mit einer großen Stakaussage in Erscheinung tritt.
Natürlich funktioniert das nur, wenn das Netzwerk weiterhin echten Bedarf erzeugt.
Entwickler brauchen nützliche Infrastruktur.
Staker brauchen nachhaltige Belohnungen.
Validatoren brauchen genug wirtschaftliche Aktivität, um es sich zu rechtfertigen, online zu bleiben.
Für mich sind die wichtigsten Kennzahlen nicht täglicher Hype oder Kursbewegungen. Ich beobachte wiederkehrendes BTC-Staking, die Validator-Teilnahme, das Wachstum des Ökosystems, die Erzeugung von Gebühren und ob die Netzwerkaktivität sich weiter stärkt, nachdem die anfängliche Begeisterung nachlässt.
Starke Narrative ziehen Aufmerksamkeit auf sich.
Der langfristige Nutzen entscheidet meist darüber, ob ein Ökosystem weiter wächst.
Was wird für Babylon in den nächsten Jahren Ihrer Meinung nach wichtiger sein: mehr BTC-Staker oder mehr echte Anwendungen, die auf dem Netzwerk aufbauen? 👇
#Babylon #baby #bitcoin #BTC
@Babylon Mir ist aufgefallen, dass beim Bitcoin-Staking das Anziehen von Kapital nur das erste Etappenziel ist.
Die größere Herausforderung besteht darin, dieses Kapital langfristig aktiv zu halten.
Aus genau diesem Grund beobachte ich das Babylon-Ökosystem $BABY besonders genau.
Wenn Bitcoin-Staking weiterhin mehrere Netzwerke absichert, bauen die Teilnehmenden eine On-Chain-Historie auf, die jeder überprüfen kann. Im Laufe der Zeit könnte diese Historie zu einem wertvollen Signal für Verlässlichkeit werden.
Ein Validator, der in unterschiedlichen Marktbedingungen durchgehend gute Leistungen erbringt, kann zur Netzwerksicherheit beitragen, mehr als einer, der lediglich für kurze Zeit mit einer großen Stakaussage in Erscheinung tritt.
Natürlich funktioniert das nur, wenn das Netzwerk weiterhin echten Bedarf erzeugt.
Entwickler brauchen nützliche Infrastruktur.
Staker brauchen nachhaltige Belohnungen.
Validatoren brauchen genug wirtschaftliche Aktivität, um es sich zu rechtfertigen, online zu bleiben.
Für mich sind die wichtigsten Kennzahlen nicht täglicher Hype oder Kursbewegungen. Ich beobachte wiederkehrendes BTC-Staking, die Validator-Teilnahme, das Wachstum des Ökosystems, die Erzeugung von Gebühren und ob die Netzwerkaktivität sich weiter stärkt, nachdem die anfängliche Begeisterung nachlässt.
Starke Narrative ziehen Aufmerksamkeit auf sich.
Der langfristige Nutzen entscheidet meist darüber, ob ein Ökosystem weiter wächst.
Was wird für Babylon in den nächsten Jahren Ihrer Meinung nach wichtiger sein: mehr BTC-Staker oder mehr echte Anwendungen, die auf dem Netzwerk aufbauen? 👇
#Babylon #baby #bitcoin #BTC
110
·
--
Verifiziert
$OPG @OpenGradient
Je mehr ich über OpenGradient nachdenke, desto mehr wird mir klar, dass Koordination nur dann funktioniert, wenn jedes Mitglied im Netzwerk eine klare Rolle hat.
Ein Aspekt der Architektur, der mir besonders auffällt, ist, wie Verantwortlichkeiten verteilt werden, anstatt jeden Knoten die gleiche Aufgabe ausführen zu lassen.
KI-Workloads sind selten einheitlich. Einige Operationen erfordern starke Rechenleistung, andere konzentrieren sich auf Verifikation, Datenzugriff oder Speicherung.
OpenGradient begegnet dieser Herausforderung, indem diese Funktionen auf spezialisierte Teilnehmer aufgeteilt werden.
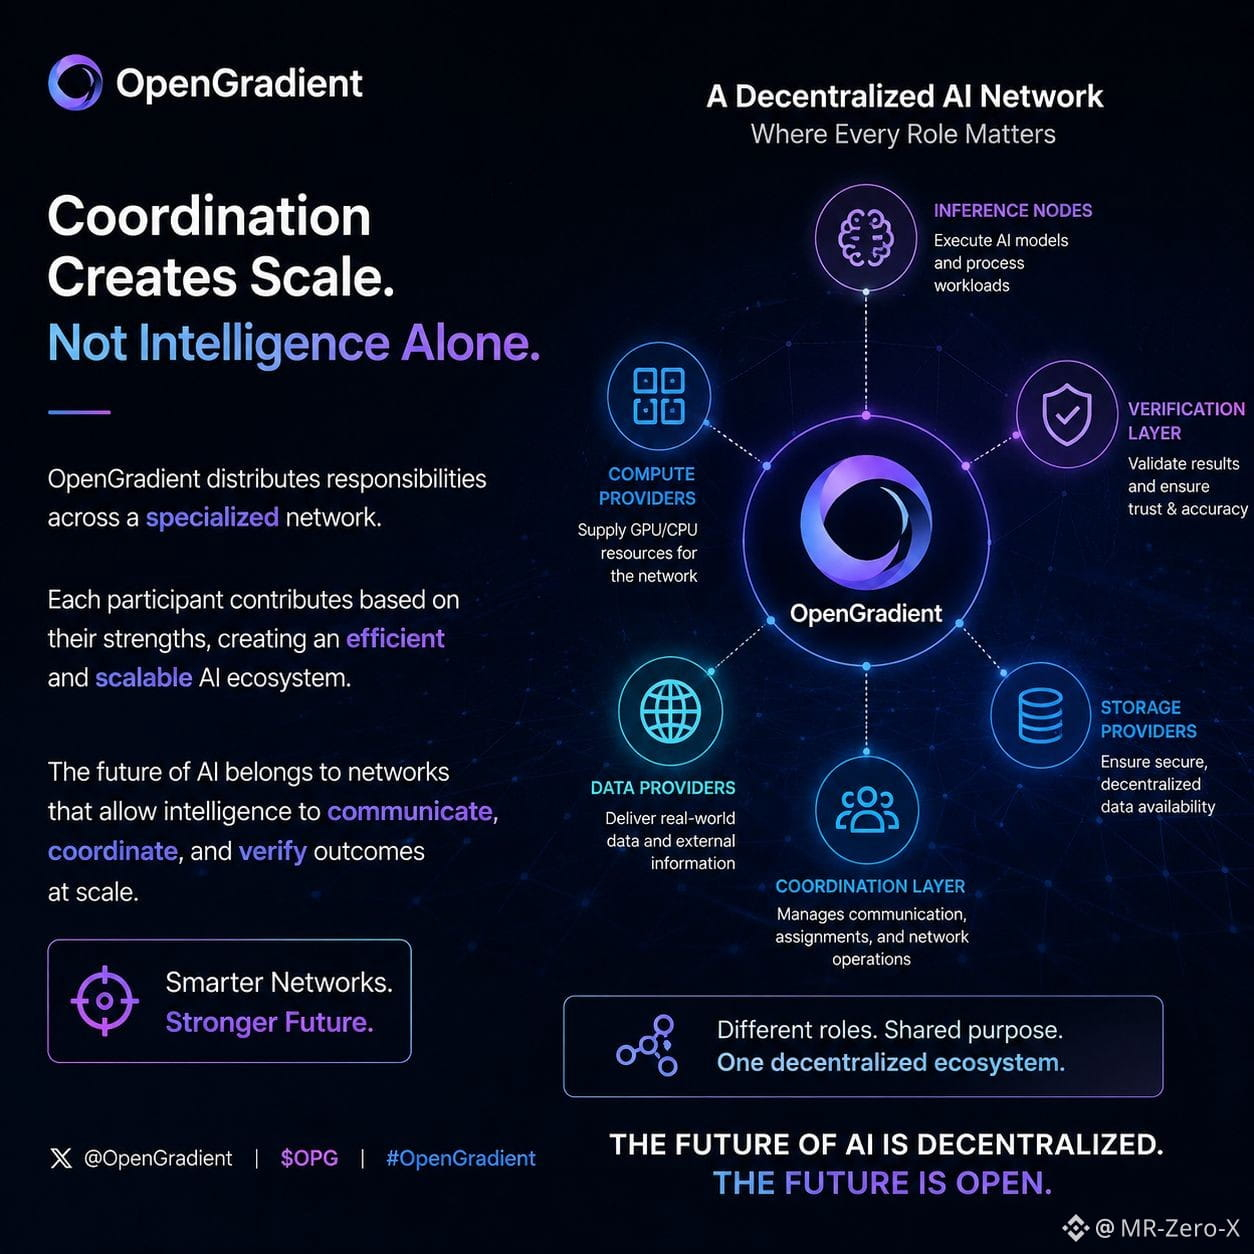
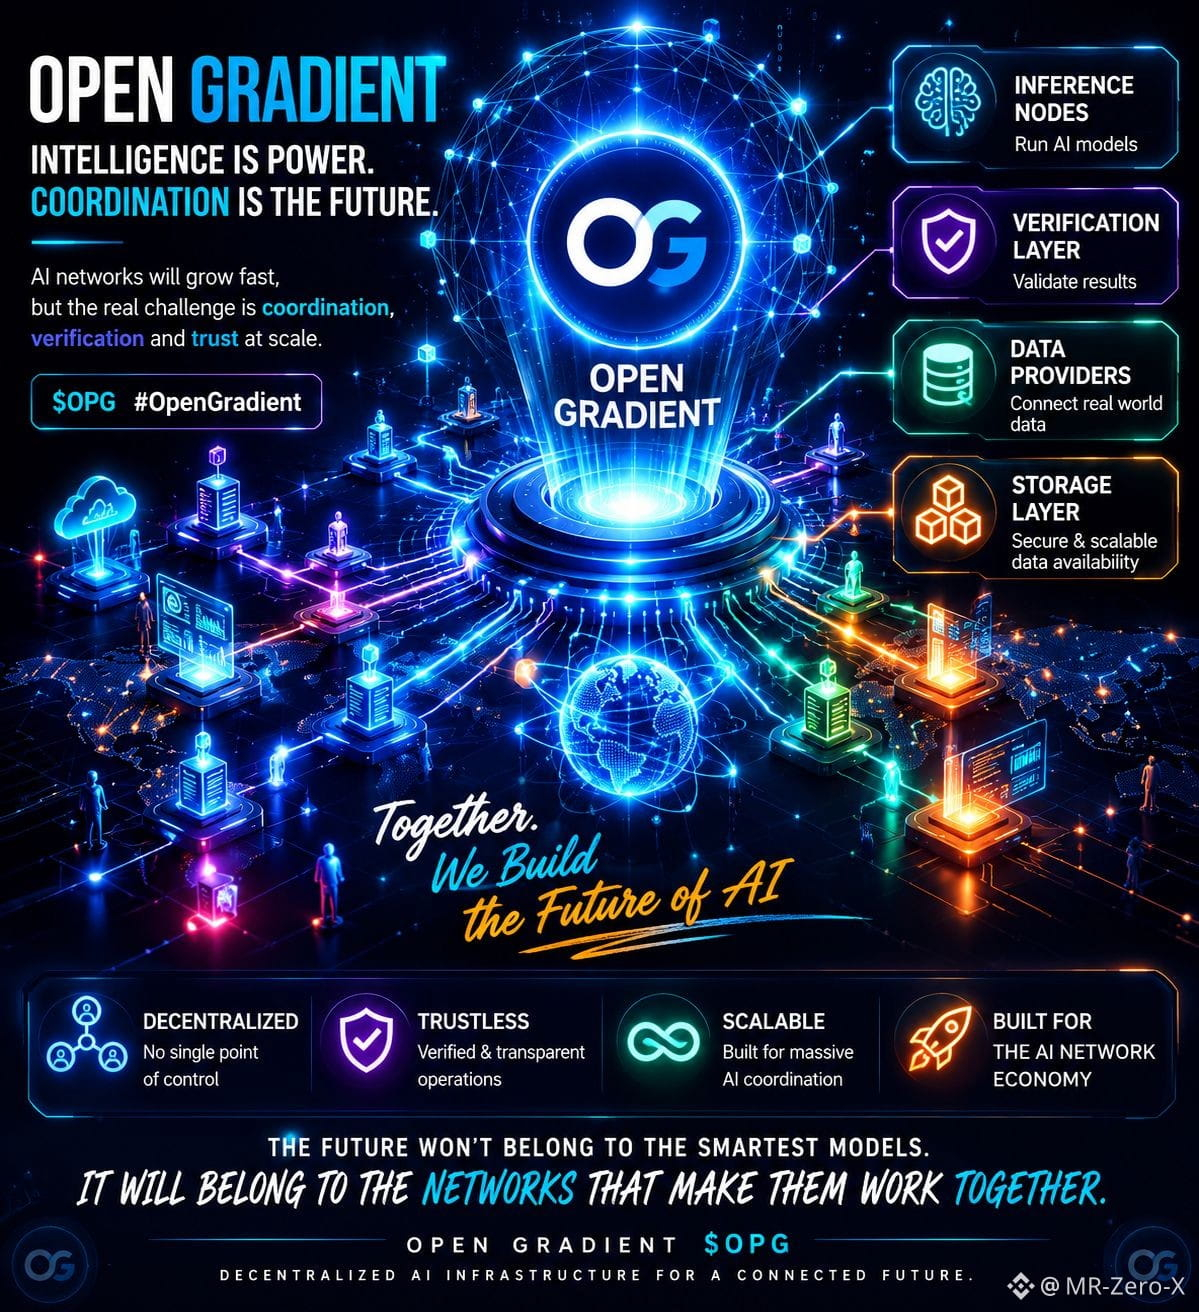
Inferenzknoten führen KI-Modelle aus, Verifikationsschichten helfen, Ergebnisse zu validieren, Datenanbieter stellen externe Informationen bereit, und die Speicherinfrastruktur verwaltet die langfristige Datenverfügbarkeit.
Was mich am meisten interessiert, ist die Effizienz, die dadurch entsteht. Anstatt ein Netzwerk aufzubauen, in dem jeder Teilnehmer alles erledigt, ist das System eher so gestaltet wie ein Ökosystem, in dem unterschiedliche Komponenten entsprechend ihren Stärken beitragen.
Während KI-Netzwerke weiter wachsen, könnte Skalierbarkeit weniger von reiner Rechenleistung abhängen und mehr davon, wie effektiv Ressourcen im System koordiniert werden.
Die Projekte, die Koordination, Verifikation und Ressourcenallokation lösen, könnten genauso wichtig werden wie die Modelle selbst.
Das ist einer der Gründe, warum OpenGradient weiterhin meine Aufmerksamkeit auf sich zieht.
@OpenGradient $OPG #OpenGradient
#opg
$OPG @OpenGradient
Je mehr ich über OpenGradient nachdenke, desto mehr wird mir klar, dass Koordination nur dann funktioniert, wenn jedes Mitglied im Netzwerk eine klare Rolle hat.
Ein Aspekt der Architektur, der mir besonders auffällt, ist, wie Verantwortlichkeiten verteilt werden, anstatt jeden Knoten die gleiche Aufgabe ausführen zu lassen.
KI-Workloads sind selten einheitlich. Einige Operationen erfordern starke Rechenleistung, andere konzentrieren sich auf Verifikation, Datenzugriff oder Speicherung.
OpenGradient begegnet dieser Herausforderung, indem diese Funktionen auf spezialisierte Teilnehmer aufgeteilt werden.
Inferenzknoten führen KI-Modelle aus, Verifikationsschichten helfen, Ergebnisse zu validieren, Datenanbieter stellen externe Informationen bereit, und die Speicherinfrastruktur verwaltet die langfristige Datenverfügbarkeit.
Was mich am meisten interessiert, ist die Effizienz, die dadurch entsteht. Anstatt ein Netzwerk aufzubauen, in dem jeder Teilnehmer alles erledigt, ist das System eher so gestaltet wie ein Ökosystem, in dem unterschiedliche Komponenten entsprechend ihren Stärken beitragen.
Während KI-Netzwerke weiter wachsen, könnte Skalierbarkeit weniger von reiner Rechenleistung abhängen und mehr davon, wie effektiv Ressourcen im System koordiniert werden.
Die Projekte, die Koordination, Verifikation und Ressourcenallokation lösen, könnten genauso wichtig werden wie die Modelle selbst.
Das ist einer der Gründe, warum OpenGradient weiterhin meine Aufmerksamkeit auf sich zieht.
@OpenGradient $OPG #OpenGradient
#opg
Je mehr ich über OpenGradient nachdenke, desto mehr wird mir klar, dass Koordination nur dann funktioniert, wenn jedes Mitglied im Netzwerk eine klare Rolle hat.
Ein Aspekt der Architektur, der mir besonders auffällt, ist, wie Verantwortlichkeiten verteilt werden, anstatt jeden Knoten die gleiche Aufgabe ausführen zu lassen.
KI-Workloads sind selten einheitlich. Einige Operationen erfordern starke Rechenleistung, andere konzentrieren sich auf Verifikation, Datenzugriff oder Speicherung.
OpenGradient begegnet dieser Herausforderung, indem diese Funktionen auf spezialisierte Teilnehmer aufgeteilt werden.
Inferenzknoten führen KI-Modelle aus, Verifikationsschichten helfen, Ergebnisse zu validieren, Datenanbieter stellen externe Informationen bereit, und die Speicherinfrastruktur verwaltet die langfristige Datenverfügbarkeit.
Was mich am meisten interessiert, ist die Effizienz, die dadurch entsteht. Anstatt ein Netzwerk aufzubauen, in dem jeder Teilnehmer alles erledigt, ist das System eher so gestaltet wie ein Ökosystem, in dem unterschiedliche Komponenten entsprechend ihren Stärken beitragen.
Während KI-Netzwerke weiter wachsen, könnte Skalierbarkeit weniger von reiner Rechenleistung abhängen und mehr davon, wie effektiv Ressourcen im System koordiniert werden.
Die Projekte, die Koordination, Verifikation und Ressourcenallokation lösen, könnten genauso wichtig werden wie die Modelle selbst.
Das ist einer der Gründe, warum OpenGradient weiterhin meine Aufmerksamkeit auf sich zieht.
@OpenGradient $OPG #OpenGradient
#opg
4
4
338
·
--
@OpenGradient
Je mehr ich über OpenGradient lese, desto mehr erkenne ich, dass KI irgendwann möglicherweise vor einer Herausforderung steht, die über die reine Modellintelligenz hinausgeht.
Intelligente Systeme zu bauen ist das eine.
Intelligenz so zuzulassen, dass sie sich im großen Maßstab koordinieren kann, ist etwas völlig anderes.
$OPG
Die meisten Gespräche konzentrieren sich noch immer auf die Fähigkeiten von Modellen, die Qualität des Denkens und die Inferenzgeschwindigkeit. Diese Verbesserungen sind wichtig, aber ich frage mich immer wieder, was passiert, wenn große Mengen an KI-Systemen miteinander interagieren müssen, auf externe Ressourcen zugreifen und Entscheidungen in dezentralen Umgebungen treffen.
Wie koordinieren sie sich?
Wie verifizieren sie Informationen?
Wie funktionieren sie, ohne sich auf eine einzelne zentrale Autorität zu verlassen?
Hier wird OpenGradient für mich interessant.
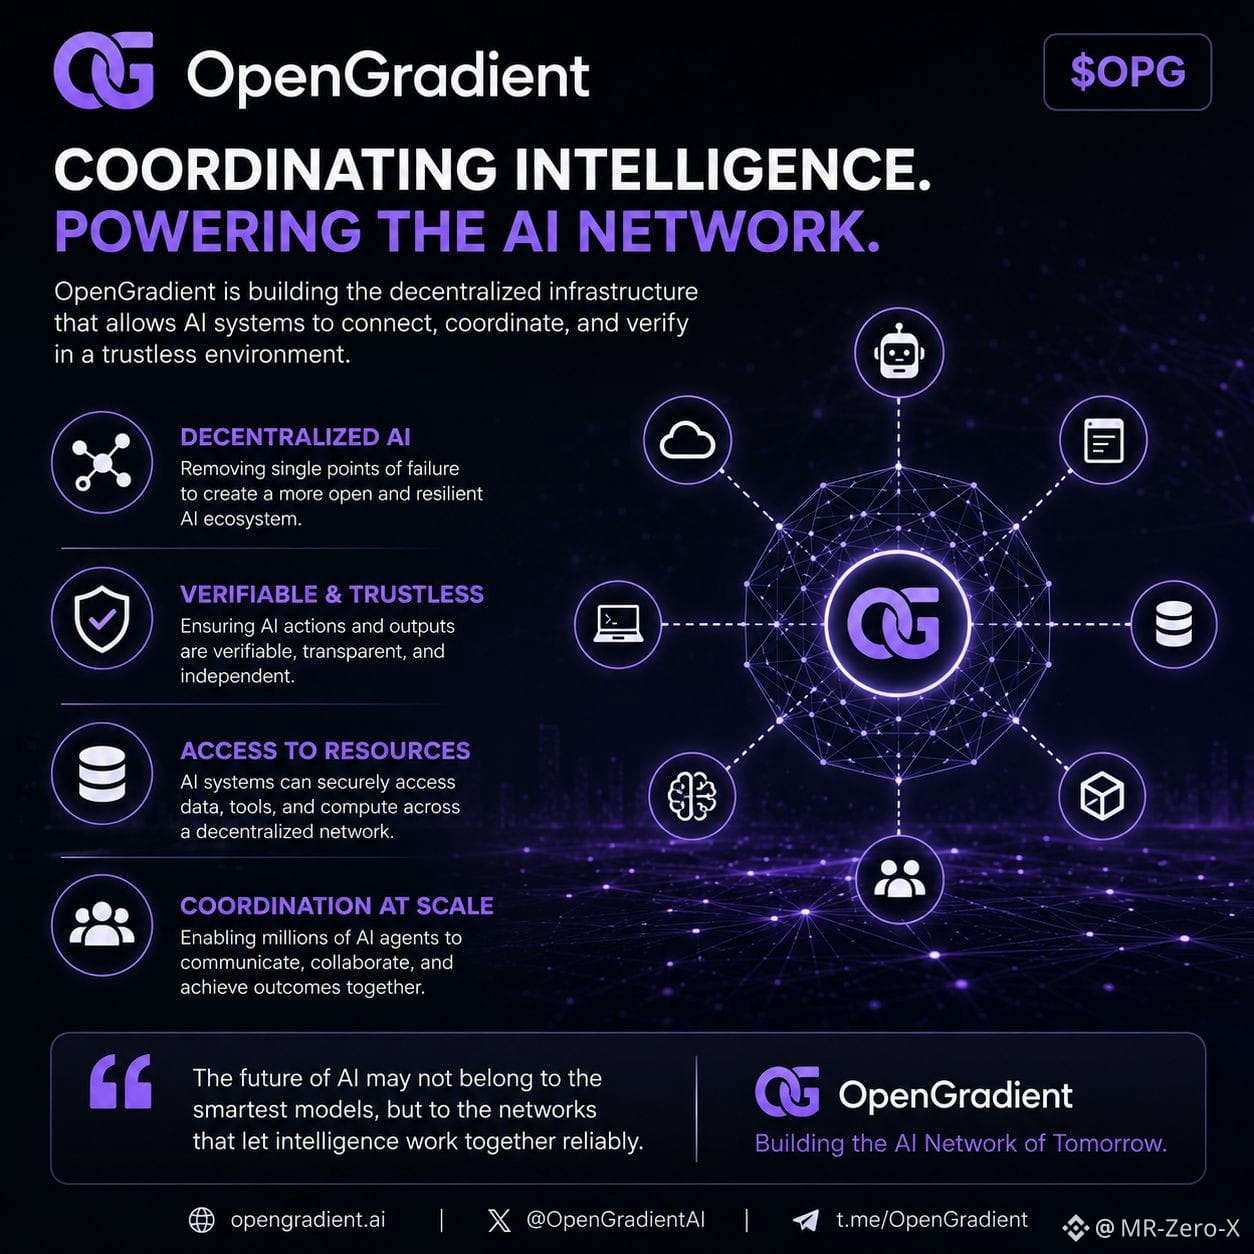
Das Projekt verlagert den Fokus von einzelnen KI-Modellen auf die Infrastruktur, die es Intelligenz ermöglicht, als Teil eines breiteren Netzwerks zu funktionieren.
Je mehr ich dezentrale KI erforsche, desto mehr denke ich, dass die Zukunft nicht nur von schlaueren Modellen abhängen könnte, sondern auch von Systemen, die Koordination, Transparenz und Verifikation im großen Maßstab unterstützen.
Die nächste Phase der KI könnte nicht durch einen einzelnen Durchbruch definiert sein.
Sie könnte durch die Netzwerke definiert werden, die es ermöglichen, dass Intelligenz zuverlässig zusammenarbeiten kann.
Das ist einer der Gründe, warum OpenGradient bei mir weiterhin auf dem Radar bleibt.
@OpenGradient
$OPG #OpenGradient #OPG
@OpenGradient
Je mehr ich über OpenGradient lese, desto mehr erkenne ich, dass KI irgendwann möglicherweise vor einer Herausforderung steht, die über die reine Modellintelligenz hinausgeht.
Intelligente Systeme zu bauen ist das eine.
Intelligenz so zuzulassen, dass sie sich im großen Maßstab koordinieren kann, ist etwas völlig anderes.
$OPG
Die meisten Gespräche konzentrieren sich noch immer auf die Fähigkeiten von Modellen, die Qualität des Denkens und die Inferenzgeschwindigkeit. Diese Verbesserungen sind wichtig, aber ich frage mich immer wieder, was passiert, wenn große Mengen an KI-Systemen miteinander interagieren müssen, auf externe Ressourcen zugreifen und Entscheidungen in dezentralen Umgebungen treffen.
Wie koordinieren sie sich?
Wie verifizieren sie Informationen?
Wie funktionieren sie, ohne sich auf eine einzelne zentrale Autorität zu verlassen?
Hier wird OpenGradient für mich interessant.
Das Projekt verlagert den Fokus von einzelnen KI-Modellen auf die Infrastruktur, die es Intelligenz ermöglicht, als Teil eines breiteren Netzwerks zu funktionieren.
Je mehr ich dezentrale KI erforsche, desto mehr denke ich, dass die Zukunft nicht nur von schlaueren Modellen abhängen könnte, sondern auch von Systemen, die Koordination, Transparenz und Verifikation im großen Maßstab unterstützen.
Die nächste Phase der KI könnte nicht durch einen einzelnen Durchbruch definiert sein.
Sie könnte durch die Netzwerke definiert werden, die es ermöglichen, dass Intelligenz zuverlässig zusammenarbeiten kann.
Das ist einer der Gründe, warum OpenGradient bei mir weiterhin auf dem Radar bleibt.
@OpenGradient
$OPG #OpenGradient #OPG
Je mehr ich über OpenGradient lese, desto mehr erkenne ich, dass KI irgendwann möglicherweise vor einer Herausforderung steht, die über die reine Modellintelligenz hinausgeht.
Intelligente Systeme zu bauen ist das eine.
Intelligenz so zuzulassen, dass sie sich im großen Maßstab koordinieren kann, ist etwas völlig anderes.
$OPG
Die meisten Gespräche konzentrieren sich noch immer auf die Fähigkeiten von Modellen, die Qualität des Denkens und die Inferenzgeschwindigkeit. Diese Verbesserungen sind wichtig, aber ich frage mich immer wieder, was passiert, wenn große Mengen an KI-Systemen miteinander interagieren müssen, auf externe Ressourcen zugreifen und Entscheidungen in dezentralen Umgebungen treffen.
Wie koordinieren sie sich?
Wie verifizieren sie Informationen?
Wie funktionieren sie, ohne sich auf eine einzelne zentrale Autorität zu verlassen?
Hier wird OpenGradient für mich interessant.
Das Projekt verlagert den Fokus von einzelnen KI-Modellen auf die Infrastruktur, die es Intelligenz ermöglicht, als Teil eines breiteren Netzwerks zu funktionieren.
Je mehr ich dezentrale KI erforsche, desto mehr denke ich, dass die Zukunft nicht nur von schlaueren Modellen abhängen könnte, sondern auch von Systemen, die Koordination, Transparenz und Verifikation im großen Maßstab unterstützen.
Die nächste Phase der KI könnte nicht durch einen einzelnen Durchbruch definiert sein.
Sie könnte durch die Netzwerke definiert werden, die es ermöglichen, dass Intelligenz zuverlässig zusammenarbeiten kann.
Das ist einer der Gründe, warum OpenGradient bei mir weiterhin auf dem Radar bleibt.
@OpenGradient
$OPG #OpenGradient #OPG
22
11
276
·
--
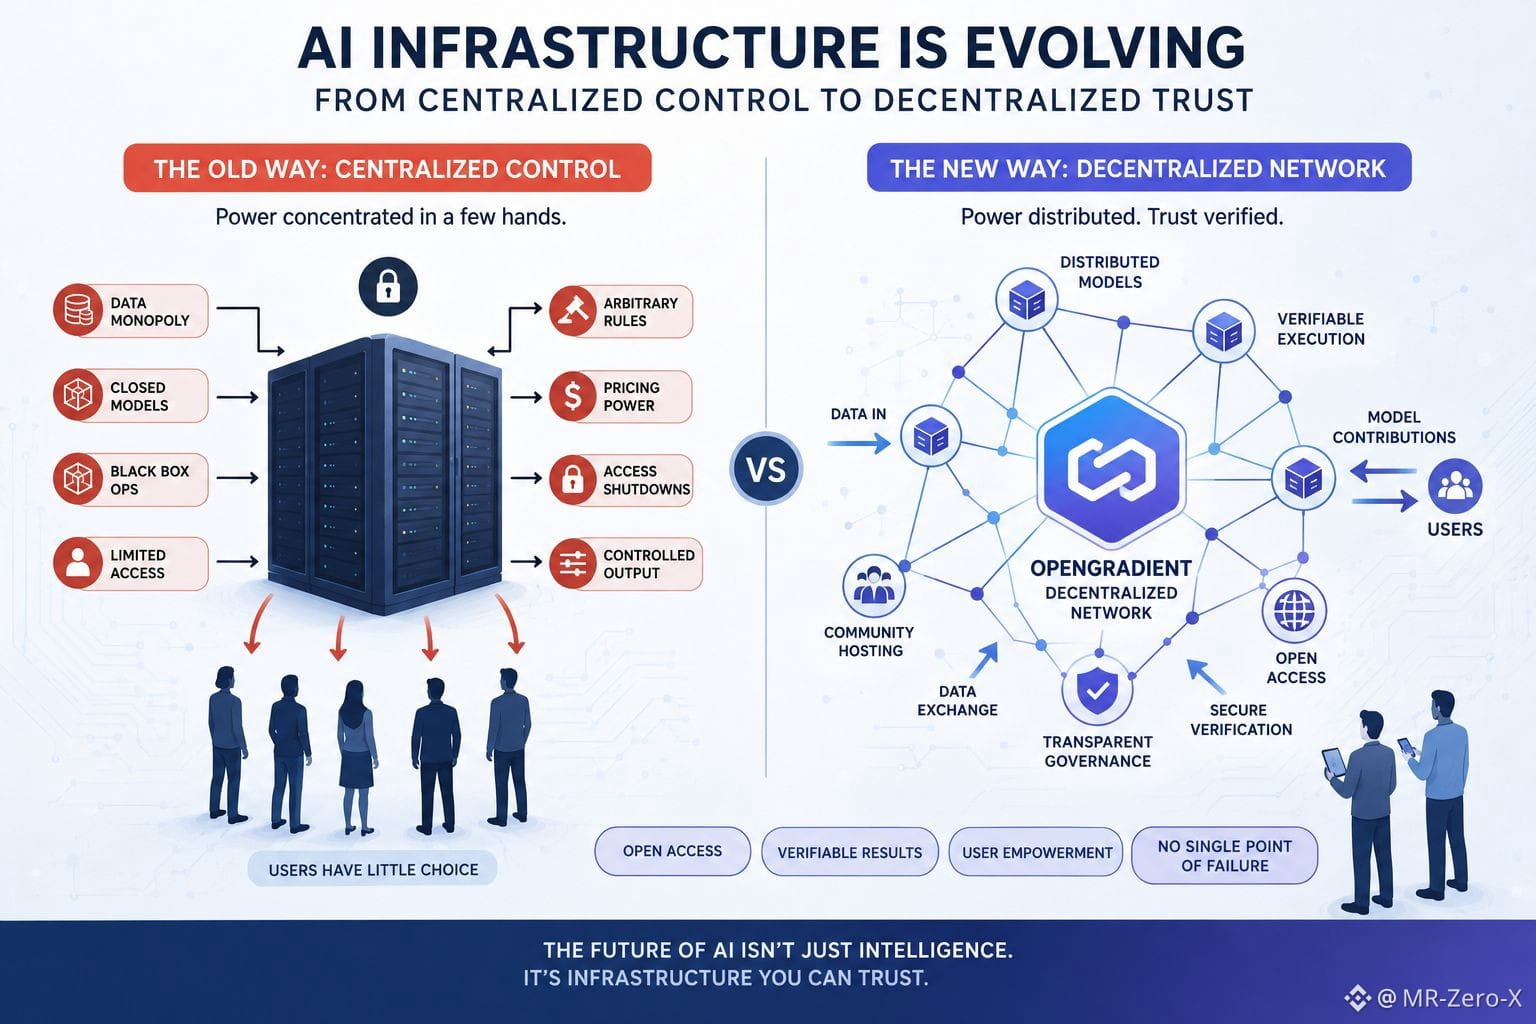
Je mehr ich über Open Gradient lese, desto mehr erkenne ich, dass KI irgendwann vor derselben Herausforderung stehen könnte, der viele Netzwerke schon zuvor begegnet sind.
Intelligenz zu erschaffen ist das eine.
Intelligenz zu koordinieren ist etwas ganz anderes.
$OPG
Die meisten Diskussionen konzentrieren sich noch immer auf Modelle und Fähigkeiten. Besseres Reasoning, größere Kontextfenster, schnellere Inferenz. Diese Verbesserungen sind wichtig, aber ich frage mich immer wieder, was passiert, wenn Tausende oder sogar Millionen von KI-Systemen miteinander und mit externen Ressourcen interagieren müssen.
Wie koordinieren sie sich?
Wie greifen sie auf Daten zu?
Wie überprüfen sie Aktionen?
Wie funktionieren sie, ohne sich auf einen einzelnen zentralen Kontrollpunkt zu verlassen?
Hier wird OpenGradient für mich interessant.
Das Projekt bringt mich dazu, weniger über einzelne KI-Modelle nachzudenken und mehr über die Infrastruktur, die es ermöglicht, dass Intelligenz Teil eines größeren Netzwerks wird.
Je mehr ich dezentrale KI studiere, desto mehr fühlt es sich so an, als könnte Intelligenz allein nicht das endgültige Ziel sein.
Die eigentliche Herausforderung könnte darin bestehen, Systeme zu schaffen, in denen Intelligenz in großem Maßstab kommunizieren, koordinieren und Ergebnisse verifizieren kann.
Ich erforsche immer noch die Architektur und lerne, wie die Bausteine zusammenpassen, aber eine Idee sticht immer wieder heraus.
Die Zukunft der KI gehört möglicherweise nicht nur den klügsten Modellen.
Sie könnte den Netzwerken gehören, die es ermöglichen, dass Intelligenz zuverlässig zusammenarbeiten kann.
Das ist einer der Gründe, warum OpenGradient weiterhin in meinem Blickfeld bleibt.
@OpenGradient $OPG #OpenGradient #OPG
Je mehr ich über Open Gradient lese, desto mehr erkenne ich, dass KI irgendwann vor derselben Herausforderung stehen könnte, der viele Netzwerke schon zuvor begegnet sind.
Intelligenz zu erschaffen ist das eine.
Intelligenz zu koordinieren ist etwas ganz anderes.
$OPG
Die meisten Diskussionen konzentrieren sich noch immer auf Modelle und Fähigkeiten. Besseres Reasoning, größere Kontextfenster, schnellere Inferenz. Diese Verbesserungen sind wichtig, aber ich frage mich immer wieder, was passiert, wenn Tausende oder sogar Millionen von KI-Systemen miteinander und mit externen Ressourcen interagieren müssen.
Wie koordinieren sie sich?
Wie greifen sie auf Daten zu?
Wie überprüfen sie Aktionen?
Wie funktionieren sie, ohne sich auf einen einzelnen zentralen Kontrollpunkt zu verlassen?
Hier wird OpenGradient für mich interessant.
Das Projekt bringt mich dazu, weniger über einzelne KI-Modelle nachzudenken und mehr über die Infrastruktur, die es ermöglicht, dass Intelligenz Teil eines größeren Netzwerks wird.
Je mehr ich dezentrale KI studiere, desto mehr fühlt es sich so an, als könnte Intelligenz allein nicht das endgültige Ziel sein.
Die eigentliche Herausforderung könnte darin bestehen, Systeme zu schaffen, in denen Intelligenz in großem Maßstab kommunizieren, koordinieren und Ergebnisse verifizieren kann.
Ich erforsche immer noch die Architektur und lerne, wie die Bausteine zusammenpassen, aber eine Idee sticht immer wieder heraus.
Die Zukunft der KI gehört möglicherweise nicht nur den klügsten Modellen.
Sie könnte den Netzwerken gehören, die es ermöglichen, dass Intelligenz zuverlässig zusammenarbeiten kann.
Das ist einer der Gründe, warum OpenGradient weiterhin in meinem Blickfeld bleibt.
@OpenGradient $OPG #OpenGradient #OPG
Intelligenz zu erschaffen ist das eine.
Intelligenz zu koordinieren ist etwas ganz anderes.
$OPG
Die meisten Diskussionen konzentrieren sich noch immer auf Modelle und Fähigkeiten. Besseres Reasoning, größere Kontextfenster, schnellere Inferenz. Diese Verbesserungen sind wichtig, aber ich frage mich immer wieder, was passiert, wenn Tausende oder sogar Millionen von KI-Systemen miteinander und mit externen Ressourcen interagieren müssen.
Wie koordinieren sie sich?
Wie greifen sie auf Daten zu?
Wie überprüfen sie Aktionen?
Wie funktionieren sie, ohne sich auf einen einzelnen zentralen Kontrollpunkt zu verlassen?
Hier wird OpenGradient für mich interessant.
Das Projekt bringt mich dazu, weniger über einzelne KI-Modelle nachzudenken und mehr über die Infrastruktur, die es ermöglicht, dass Intelligenz Teil eines größeren Netzwerks wird.
Je mehr ich dezentrale KI studiere, desto mehr fühlt es sich so an, als könnte Intelligenz allein nicht das endgültige Ziel sein.
Die eigentliche Herausforderung könnte darin bestehen, Systeme zu schaffen, in denen Intelligenz in großem Maßstab kommunizieren, koordinieren und Ergebnisse verifizieren kann.
Ich erforsche immer noch die Architektur und lerne, wie die Bausteine zusammenpassen, aber eine Idee sticht immer wieder heraus.
Die Zukunft der KI gehört möglicherweise nicht nur den klügsten Modellen.
Sie könnte den Netzwerken gehören, die es ermöglichen, dass Intelligenz zuverlässig zusammenarbeiten kann.
Das ist einer der Gründe, warum OpenGradient weiterhin in meinem Blickfeld bleibt.
@OpenGradient $OPG #OpenGradient #OPG
11
6
101
·
--
#opg $OPG @OpenGradient
Je mehr Zeit ich damit verbringe, OpenGradient zu betrachten, desto mehr denke ich über etwas nach, das nicht oft genug diskutiert wird.
Die meisten Gespräche über KI scheinen mit Modellen zu beginnen.
Intelligentere Modelle.
Schnellere Modelle.
Größere Modelle.
Aber ich komme immer wieder zu einer anderen Frage zurück.
Was passiert, nachdem das Modell eine Antwort generiert?
Woher kommen die Informationen?
Wie kann man sie verifizieren?
Wie interagiert das System mit den Ressourcen um es herum?
Der Grund, warum ich OpenGradient weiterhin aufmerksam verfolge, ist, dass es mich dazu bringt, über die Schichten unter der KI nachzudenken, anstatt nur über die Ausgaben oben.
Ich sehe keinen langfristigen Wert, der nur aus Intelligenz kommt.
Ich denke, Zugang, Koordination und Verifizierung werden genauso wichtig sein.
Vielleicht sogar mehr.
Ich lerne immer noch und verbinde die Puzzlestücke, aber eines wird mir zunehmend klar.
Die Zukunft der KI könnte nicht durch ein einzelnes bahnbrechendes Modell definiert werden.
Sie könnte durch die Infrastruktur geprägt sein, die es ermöglicht, dass Intelligenz auf eine zuverlässige und überprüfbare Weise funktioniert.
Das ist der Teil, den ich gerade am genauesten beobachte.
#OpenGradient $OPG @OpenGradient
#opg $OPG @OpenGradient
Je mehr Zeit ich damit verbringe, OpenGradient zu betrachten, desto mehr denke ich über etwas nach, das nicht oft genug diskutiert wird.
Die meisten Gespräche über KI scheinen mit Modellen zu beginnen.
Intelligentere Modelle.
Schnellere Modelle.
Größere Modelle.
Aber ich komme immer wieder zu einer anderen Frage zurück.
Was passiert, nachdem das Modell eine Antwort generiert?
Woher kommen die Informationen?
Wie kann man sie verifizieren?
Wie interagiert das System mit den Ressourcen um es herum?
Der Grund, warum ich OpenGradient weiterhin aufmerksam verfolge, ist, dass es mich dazu bringt, über die Schichten unter der KI nachzudenken, anstatt nur über die Ausgaben oben.
Ich sehe keinen langfristigen Wert, der nur aus Intelligenz kommt.
Ich denke, Zugang, Koordination und Verifizierung werden genauso wichtig sein.
Vielleicht sogar mehr.
Ich lerne immer noch und verbinde die Puzzlestücke, aber eines wird mir zunehmend klar.
Die Zukunft der KI könnte nicht durch ein einzelnes bahnbrechendes Modell definiert werden.
Sie könnte durch die Infrastruktur geprägt sein, die es ermöglicht, dass Intelligenz auf eine zuverlässige und überprüfbare Weise funktioniert.
Das ist der Teil, den ich gerade am genauesten beobachte.
#OpenGradient $OPG @OpenGradient
Je mehr Zeit ich damit verbringe, OpenGradient zu betrachten, desto mehr denke ich über etwas nach, das nicht oft genug diskutiert wird.
Die meisten Gespräche über KI scheinen mit Modellen zu beginnen.
Intelligentere Modelle.
Schnellere Modelle.
Größere Modelle.
Aber ich komme immer wieder zu einer anderen Frage zurück.
Was passiert, nachdem das Modell eine Antwort generiert?
Woher kommen die Informationen?
Wie kann man sie verifizieren?
Wie interagiert das System mit den Ressourcen um es herum?
Der Grund, warum ich OpenGradient weiterhin aufmerksam verfolge, ist, dass es mich dazu bringt, über die Schichten unter der KI nachzudenken, anstatt nur über die Ausgaben oben.
Ich sehe keinen langfristigen Wert, der nur aus Intelligenz kommt.
Ich denke, Zugang, Koordination und Verifizierung werden genauso wichtig sein.
Vielleicht sogar mehr.
Ich lerne immer noch und verbinde die Puzzlestücke, aber eines wird mir zunehmend klar.
Die Zukunft der KI könnte nicht durch ein einzelnes bahnbrechendes Modell definiert werden.
Sie könnte durch die Infrastruktur geprägt sein, die es ermöglicht, dass Intelligenz auf eine zuverlässige und überprüfbare Weise funktioniert.
Das ist der Teil, den ich gerade am genauesten beobachte.
#OpenGradient $OPG @OpenGradient
45
22
490
·
--
Verifiziert
#opg $OPG @OpenGradient
Ich habe viel Zeit damit verbracht, KI-Projekte zu studieren, und etwas sticht mir immer wieder heraus. Die meisten Gespräche drehen sich um Intelligenz. Jeder möchte smartere Modelle, schnellere Antworten und größere Fähigkeiten. Aber da KI immer stärker Teil realer Systeme wird, denke ich, dass ein weiterer Faktor genauso wichtig wird: Vertrauen.
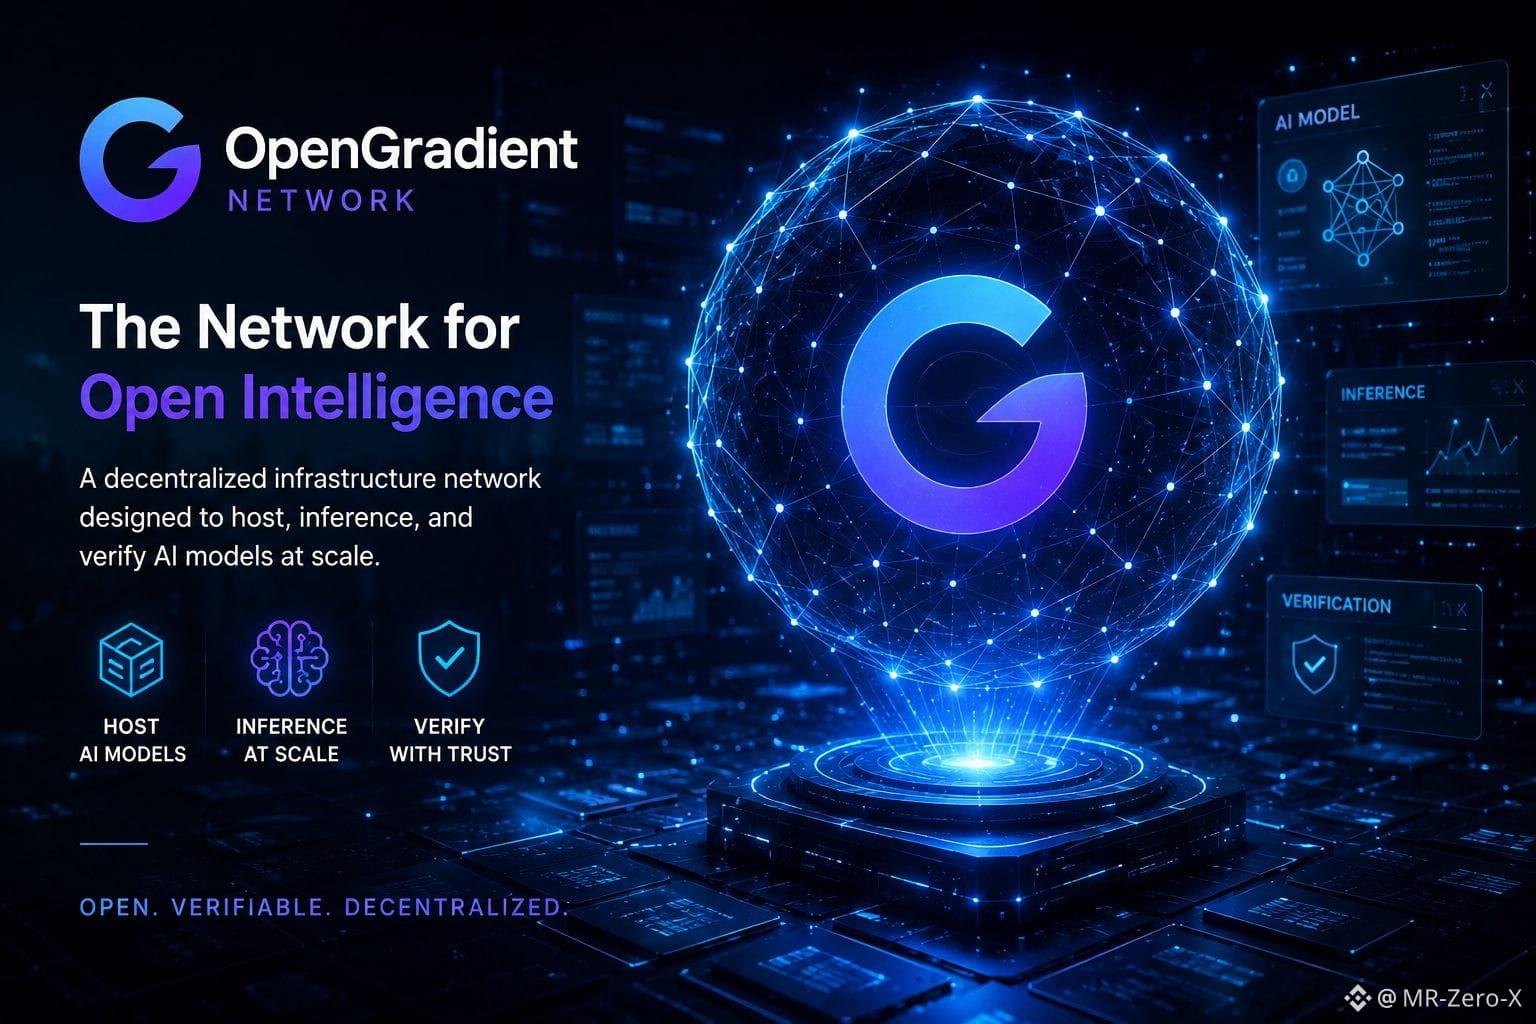
Aus diesem Grund hat mich OpenGradient Network besonders angesprochen.
Wenn ich mir KI-Infrastruktur anschaue, frage ich nicht nur, was ein Modell leisten kann. Ich frage auch, ob sich seine Ergebnisse verifizieren lassen. OpenGradient baut ein dezentrales Netzwerk auf, das darauf ausgelegt ist, KI-Modelle in großem Maßstab bereitzustellen, auszuführen und zu verifizieren. Dieser Fokus wirkt zunehmend relevant, da die KI-Nutzung weiter wächst.
Viele KI-Systeme setzen noch immer darauf, dass Nutzer die Ergebnisse, die sie erhalten, einfach vertrauen. Das funktioniert bis zu einem gewissen Punkt, aber die langfristige Einführung könnte mehr Transparenz und Verantwortlichkeit erfordern. Verifizierung könnte zu einem entscheidenden Bestandteil der KI-Infrastruktur werden – statt nur einer optionalen Funktion.
Ich behandle das nicht als bereits gelöstes Problem. Skalierbarkeit, Effizienz und die Einführung bleiben wichtige Herausforderungen für jedes dezentrale KI-Netzwerk. Aber ich finde, die Richtung lohnt es, im Blick zu behalten.
Die Zukunft der KI hängt vielleicht nicht nur von Intelligenz ab. Sie hängt auch davon ab, ob Intelligenz überprüfbar und vertrauenswürdig ist. Deshalb bleibt OpenGradient Network für mich ein spannendes Projekt, dem ich folgen möchte.
@OpenGradient $OPG #OpenGradient
#opg $OPG @OpenGradient
Ich habe viel Zeit damit verbracht, KI-Projekte zu studieren, und etwas sticht mir immer wieder heraus. Die meisten Gespräche drehen sich um Intelligenz. Jeder möchte smartere Modelle, schnellere Antworten und größere Fähigkeiten. Aber da KI immer stärker Teil realer Systeme wird, denke ich, dass ein weiterer Faktor genauso wichtig wird: Vertrauen.
Aus diesem Grund hat mich OpenGradient Network besonders angesprochen.
Wenn ich mir KI-Infrastruktur anschaue, frage ich nicht nur, was ein Modell leisten kann. Ich frage auch, ob sich seine Ergebnisse verifizieren lassen. OpenGradient baut ein dezentrales Netzwerk auf, das darauf ausgelegt ist, KI-Modelle in großem Maßstab bereitzustellen, auszuführen und zu verifizieren. Dieser Fokus wirkt zunehmend relevant, da die KI-Nutzung weiter wächst.
Viele KI-Systeme setzen noch immer darauf, dass Nutzer die Ergebnisse, die sie erhalten, einfach vertrauen. Das funktioniert bis zu einem gewissen Punkt, aber die langfristige Einführung könnte mehr Transparenz und Verantwortlichkeit erfordern. Verifizierung könnte zu einem entscheidenden Bestandteil der KI-Infrastruktur werden – statt nur einer optionalen Funktion.
Ich behandle das nicht als bereits gelöstes Problem. Skalierbarkeit, Effizienz und die Einführung bleiben wichtige Herausforderungen für jedes dezentrale KI-Netzwerk. Aber ich finde, die Richtung lohnt es, im Blick zu behalten.
Die Zukunft der KI hängt vielleicht nicht nur von Intelligenz ab. Sie hängt auch davon ab, ob Intelligenz überprüfbar und vertrauenswürdig ist. Deshalb bleibt OpenGradient Network für mich ein spannendes Projekt, dem ich folgen möchte.
@OpenGradient $OPG #OpenGradient
Ich habe viel Zeit damit verbracht, KI-Projekte zu studieren, und etwas sticht mir immer wieder heraus. Die meisten Gespräche drehen sich um Intelligenz. Jeder möchte smartere Modelle, schnellere Antworten und größere Fähigkeiten. Aber da KI immer stärker Teil realer Systeme wird, denke ich, dass ein weiterer Faktor genauso wichtig wird: Vertrauen.
Aus diesem Grund hat mich OpenGradient Network besonders angesprochen.
Wenn ich mir KI-Infrastruktur anschaue, frage ich nicht nur, was ein Modell leisten kann. Ich frage auch, ob sich seine Ergebnisse verifizieren lassen. OpenGradient baut ein dezentrales Netzwerk auf, das darauf ausgelegt ist, KI-Modelle in großem Maßstab bereitzustellen, auszuführen und zu verifizieren. Dieser Fokus wirkt zunehmend relevant, da die KI-Nutzung weiter wächst.
Viele KI-Systeme setzen noch immer darauf, dass Nutzer die Ergebnisse, die sie erhalten, einfach vertrauen. Das funktioniert bis zu einem gewissen Punkt, aber die langfristige Einführung könnte mehr Transparenz und Verantwortlichkeit erfordern. Verifizierung könnte zu einem entscheidenden Bestandteil der KI-Infrastruktur werden – statt nur einer optionalen Funktion.
Ich behandle das nicht als bereits gelöstes Problem. Skalierbarkeit, Effizienz und die Einführung bleiben wichtige Herausforderungen für jedes dezentrale KI-Netzwerk. Aber ich finde, die Richtung lohnt es, im Blick zu behalten.
Die Zukunft der KI hängt vielleicht nicht nur von Intelligenz ab. Sie hängt auch davon ab, ob Intelligenz überprüfbar und vertrauenswürdig ist. Deshalb bleibt OpenGradient Network für mich ein spannendes Projekt, dem ich folgen möchte.
@OpenGradient $OPG #OpenGradient
9
6
291
·
--
#opg $OPG @OpenGradient
Ich habe immer wieder bemerkt, dass die meisten KI-Gespräche von derselben Annahme ausgehen:
Intelligenz ist die knappe Ressource.
Nachdem ich Zeit damit verbracht habe, dezentrale KI-Systeme zu studieren, beginne ich zu denken, dass diese Annahme falsch sein könnte.
Modelle werden von Quartal zu Quartal günstiger, schneller und zugänglicher. Was jedoch knapp bleibt, ist etwas, das viel weniger diskutiert wird: Verifikation.
Diese Idee tauchte immer wieder auf, als ich mir die Architektur von OpenGradient genauer ansah. Die meisten KI-Systeme fordern von den Nutzern, Ausgaben zu vertrauen, ohne zu sehen, wie die Berechnung ablief, woher die Daten stammten oder ob die Ausführung tatsächlich wie behauptet erfolgt ist. Das System funktioniert, bis Entscheidungen echte wirtschaftliche Konsequenzen haben.
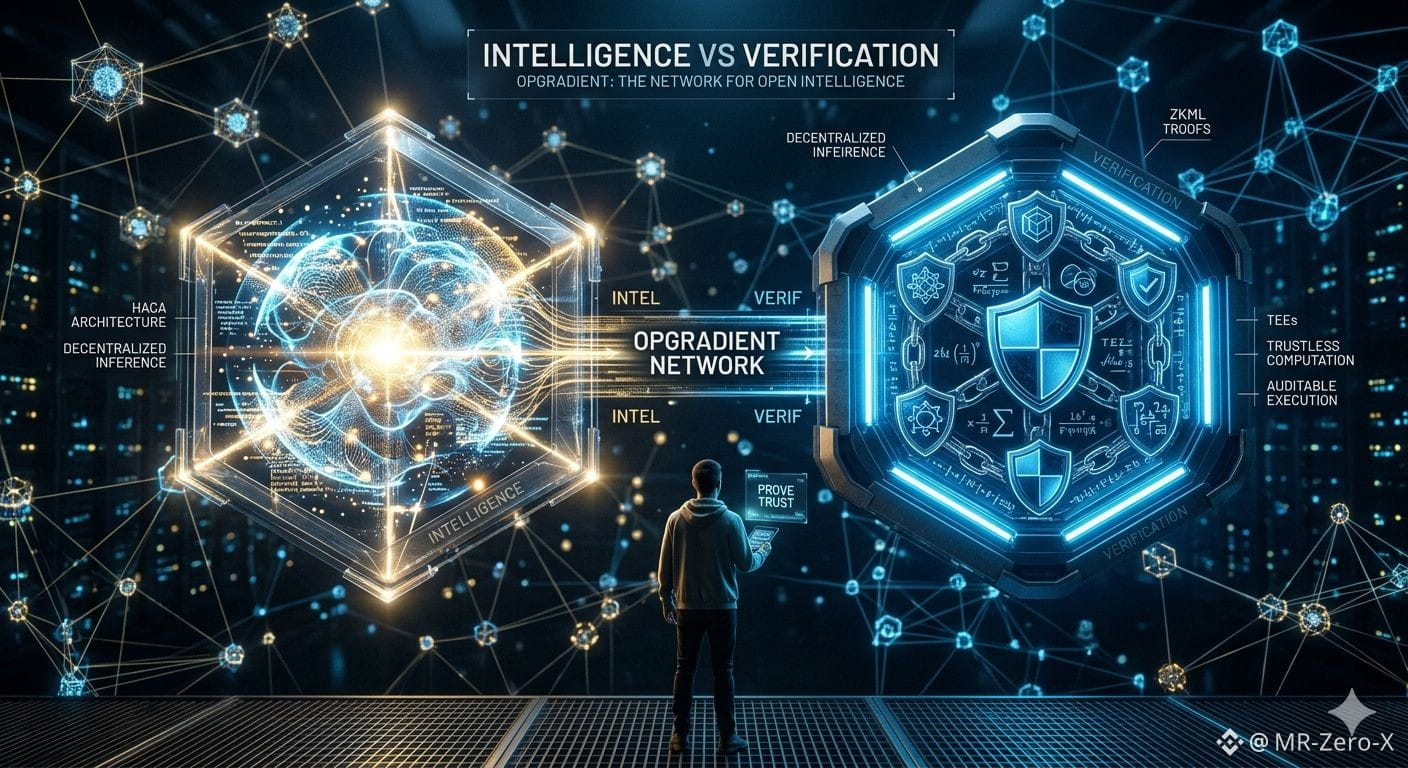
Ich betrachte KI zunehmend über ein simples Rahmenwerk: Intelligenz vs. Verifikation.
Intelligenz liefert Antworten. Verifikation schafft Vertrauen.
Was OpenGradient interessant macht, ist nicht, dass es versucht, schlauere Modelle zu bauen, sondern dass es Mechanismen wie Trusted Execution Environments, zkML, Datenherkunft (Data Provenance) und datenschutzfreundliche Berechnung erforscht, um die KI-Ausführung prüfbar zu machen, ohne alles darunter offenlegen zu müssen.
Die verborgene Stärke könnte die Koordination sein. Verifikation schafft einen gemeinsamen Bezugspunkt zwischen Parteien, die einander nicht kennen oder einander nicht vertrauen.
Die ungelöste Herausforderung ist ebenso wichtig. Beweissysteme erhöhen Kosten, Komplexität und Latenz. Wenn Verifikation zu teuer wird, werden Nutzer sie dann noch einfordern?
Wenn KI skaliert: Was wird dann wertvoller—das Modell, das eine Antwort erzeugt, oder das Netzwerk, das beweist, dass die Antwort vertrauenswürdig ist?
$OPG #trades @OpenGradient
#opg $OPG @OpenGradient
Ich habe immer wieder bemerkt, dass die meisten KI-Gespräche von derselben Annahme ausgehen:
Intelligenz ist die knappe Ressource.
Nachdem ich Zeit damit verbracht habe, dezentrale KI-Systeme zu studieren, beginne ich zu denken, dass diese Annahme falsch sein könnte.
Modelle werden von Quartal zu Quartal günstiger, schneller und zugänglicher. Was jedoch knapp bleibt, ist etwas, das viel weniger diskutiert wird: Verifikation.
Diese Idee tauchte immer wieder auf, als ich mir die Architektur von OpenGradient genauer ansah. Die meisten KI-Systeme fordern von den Nutzern, Ausgaben zu vertrauen, ohne zu sehen, wie die Berechnung ablief, woher die Daten stammten oder ob die Ausführung tatsächlich wie behauptet erfolgt ist. Das System funktioniert, bis Entscheidungen echte wirtschaftliche Konsequenzen haben.
Ich betrachte KI zunehmend über ein simples Rahmenwerk: Intelligenz vs. Verifikation.
Intelligenz liefert Antworten. Verifikation schafft Vertrauen.
Was OpenGradient interessant macht, ist nicht, dass es versucht, schlauere Modelle zu bauen, sondern dass es Mechanismen wie Trusted Execution Environments, zkML, Datenherkunft (Data Provenance) und datenschutzfreundliche Berechnung erforscht, um die KI-Ausführung prüfbar zu machen, ohne alles darunter offenlegen zu müssen.
Die verborgene Stärke könnte die Koordination sein. Verifikation schafft einen gemeinsamen Bezugspunkt zwischen Parteien, die einander nicht kennen oder einander nicht vertrauen.
Die ungelöste Herausforderung ist ebenso wichtig. Beweissysteme erhöhen Kosten, Komplexität und Latenz. Wenn Verifikation zu teuer wird, werden Nutzer sie dann noch einfordern?
Wenn KI skaliert: Was wird dann wertvoller—das Modell, das eine Antwort erzeugt, oder das Netzwerk, das beweist, dass die Antwort vertrauenswürdig ist?
$OPG #trades @OpenGradient
Ich habe immer wieder bemerkt, dass die meisten KI-Gespräche von derselben Annahme ausgehen:
Intelligenz ist die knappe Ressource.
Nachdem ich Zeit damit verbracht habe, dezentrale KI-Systeme zu studieren, beginne ich zu denken, dass diese Annahme falsch sein könnte.
Modelle werden von Quartal zu Quartal günstiger, schneller und zugänglicher. Was jedoch knapp bleibt, ist etwas, das viel weniger diskutiert wird: Verifikation.
Diese Idee tauchte immer wieder auf, als ich mir die Architektur von OpenGradient genauer ansah. Die meisten KI-Systeme fordern von den Nutzern, Ausgaben zu vertrauen, ohne zu sehen, wie die Berechnung ablief, woher die Daten stammten oder ob die Ausführung tatsächlich wie behauptet erfolgt ist. Das System funktioniert, bis Entscheidungen echte wirtschaftliche Konsequenzen haben.
Ich betrachte KI zunehmend über ein simples Rahmenwerk: Intelligenz vs. Verifikation.
Intelligenz liefert Antworten. Verifikation schafft Vertrauen.
Was OpenGradient interessant macht, ist nicht, dass es versucht, schlauere Modelle zu bauen, sondern dass es Mechanismen wie Trusted Execution Environments, zkML, Datenherkunft (Data Provenance) und datenschutzfreundliche Berechnung erforscht, um die KI-Ausführung prüfbar zu machen, ohne alles darunter offenlegen zu müssen.
Die verborgene Stärke könnte die Koordination sein. Verifikation schafft einen gemeinsamen Bezugspunkt zwischen Parteien, die einander nicht kennen oder einander nicht vertrauen.
Die ungelöste Herausforderung ist ebenso wichtig. Beweissysteme erhöhen Kosten, Komplexität und Latenz. Wenn Verifikation zu teuer wird, werden Nutzer sie dann noch einfordern?
Wenn KI skaliert: Was wird dann wertvoller—das Modell, das eine Antwort erzeugt, oder das Netzwerk, das beweist, dass die Antwort vertrauenswürdig ist?
$OPG #trades @OpenGradient
2
217
·
--
Verifiziert
#opg $OPG @OpenGradient
Ich denke, einer der größten Fehler im Krypto-Bereich ist es, Sichtbarkeit mit Wert gleichzusetzen.
Projekte investieren Monate darin, Aufmerksamkeit zu jagen, aber allein Aufmerksamkeit schafft niemals Nachhaltigkeit.
Deshalb hat OpenGradient meine Aufmerksamkeit erregt. Während sich viele Netzwerke auf Narrative konzentrieren, ist OpenGradient auf Infrastruktur fokussiert. Das Ziel ist nicht, wichtig auszusehen – sondern KI-Deployments, Inferenz und Verifikation tatsächlich im großen Maßstab zum Laufen zu bringen.
$OPG
Was mir auffällt, ist, dass das Netzwerk einen echten Engpass angeht. Anstatt sich auf zentralisierte Anbieter zu verlassen, schafft es eine Umgebung, in der offene Intelligenz über dezentrale Infrastruktur funktionieren kann.
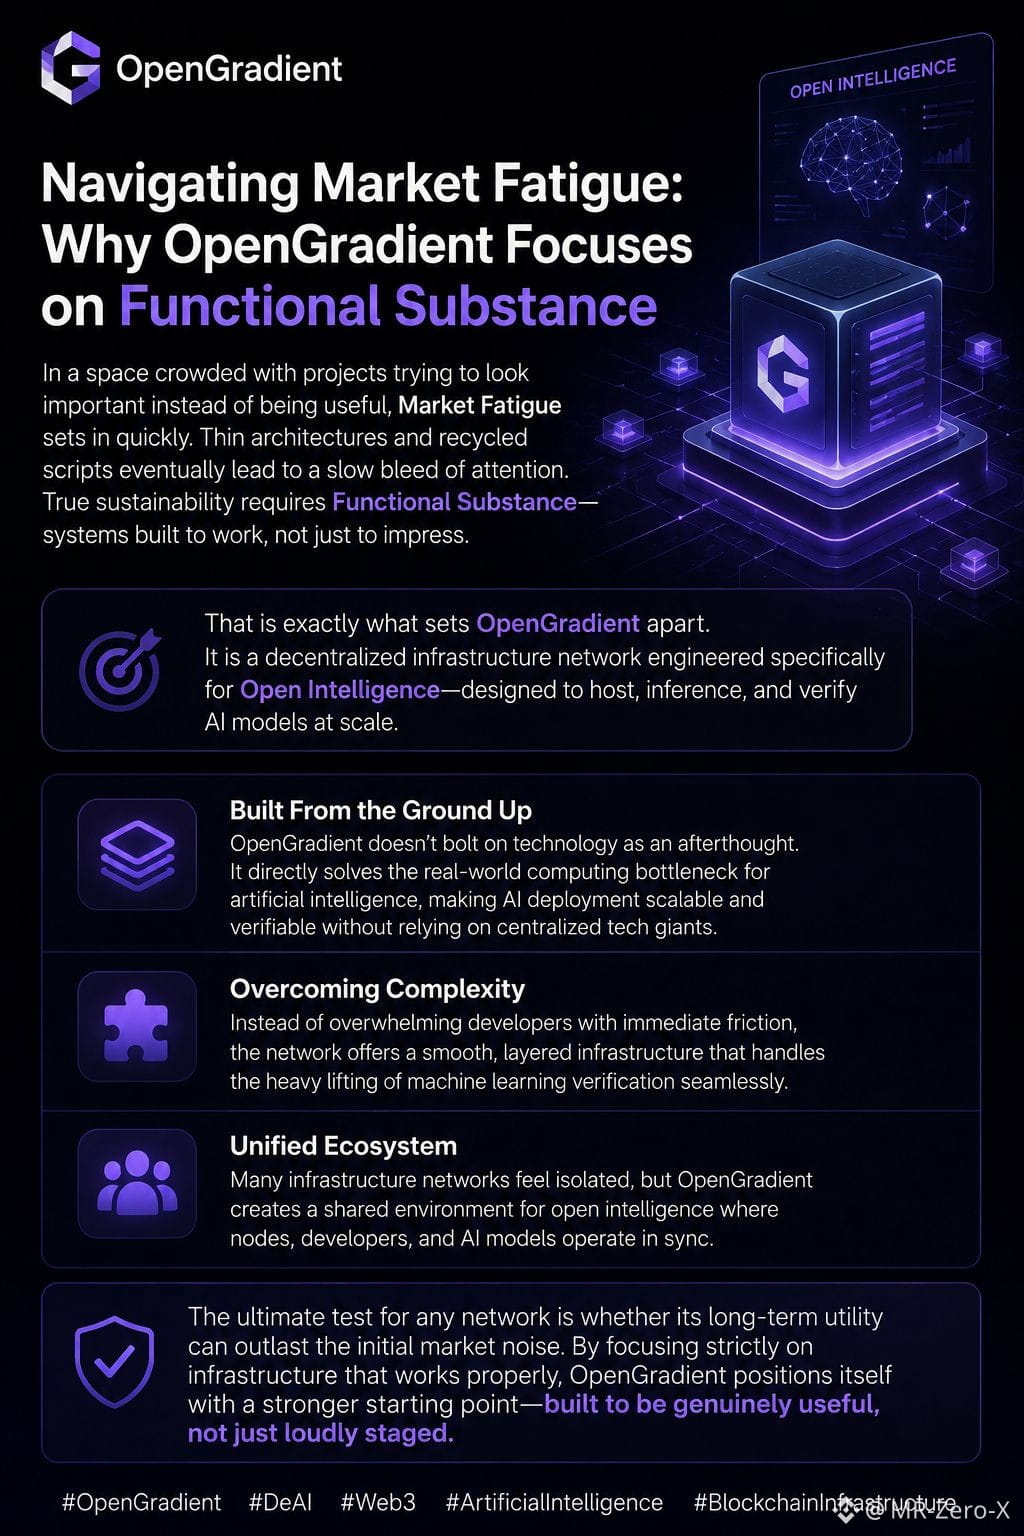
Marktmüdigkeit entlarvt irgendwann schwache Grundlagen. Der Hype vergeht. Die Nützlichkeit bleibt. Deshalb interessiere ich mich mehr für Netzwerke, die funktionale Substanz aufbauen, statt Projekte, die nur vorübergehende Begeisterung erzeugen.
#OpenGradient #DeAI #Web3 #ArtificialIntelligence
#opg $OPG @OpenGradient
Ich denke, einer der größten Fehler im Krypto-Bereich ist es, Sichtbarkeit mit Wert gleichzusetzen.
Projekte investieren Monate darin, Aufmerksamkeit zu jagen, aber allein Aufmerksamkeit schafft niemals Nachhaltigkeit.
Deshalb hat OpenGradient meine Aufmerksamkeit erregt. Während sich viele Netzwerke auf Narrative konzentrieren, ist OpenGradient auf Infrastruktur fokussiert. Das Ziel ist nicht, wichtig auszusehen – sondern KI-Deployments, Inferenz und Verifikation tatsächlich im großen Maßstab zum Laufen zu bringen.
$OPG
Was mir auffällt, ist, dass das Netzwerk einen echten Engpass angeht. Anstatt sich auf zentralisierte Anbieter zu verlassen, schafft es eine Umgebung, in der offene Intelligenz über dezentrale Infrastruktur funktionieren kann.
Marktmüdigkeit entlarvt irgendwann schwache Grundlagen. Der Hype vergeht. Die Nützlichkeit bleibt. Deshalb interessiere ich mich mehr für Netzwerke, die funktionale Substanz aufbauen, statt Projekte, die nur vorübergehende Begeisterung erzeugen.
#OpenGradient #DeAI #Web3 #ArtificialIntelligence
Ich denke, einer der größten Fehler im Krypto-Bereich ist es, Sichtbarkeit mit Wert gleichzusetzen.
Projekte investieren Monate darin, Aufmerksamkeit zu jagen, aber allein Aufmerksamkeit schafft niemals Nachhaltigkeit.
Deshalb hat OpenGradient meine Aufmerksamkeit erregt. Während sich viele Netzwerke auf Narrative konzentrieren, ist OpenGradient auf Infrastruktur fokussiert. Das Ziel ist nicht, wichtig auszusehen – sondern KI-Deployments, Inferenz und Verifikation tatsächlich im großen Maßstab zum Laufen zu bringen.
$OPG
Was mir auffällt, ist, dass das Netzwerk einen echten Engpass angeht. Anstatt sich auf zentralisierte Anbieter zu verlassen, schafft es eine Umgebung, in der offene Intelligenz über dezentrale Infrastruktur funktionieren kann.
Marktmüdigkeit entlarvt irgendwann schwache Grundlagen. Der Hype vergeht. Die Nützlichkeit bleibt. Deshalb interessiere ich mich mehr für Netzwerke, die funktionale Substanz aufbauen, statt Projekte, die nur vorübergehende Begeisterung erzeugen.
#OpenGradient #DeAI #Web3 #ArtificialIntelligence
5
3
310
·
--
Verifiziert
#opg $OPG
Die meisten Leute konzentrieren sich auf KI-Modelle.
Ich lege mehr Wert auf die Infrastruktur, die darunter liegt.
Denn großartige Technologie gewinnt selten nur durch ihre Fähigkeiten.
Sie gewinnt, wenn die Builder sie tatsächlich nutzen können.
Das ist ein Grund, warum OpenGradient mein Interesse weckt.
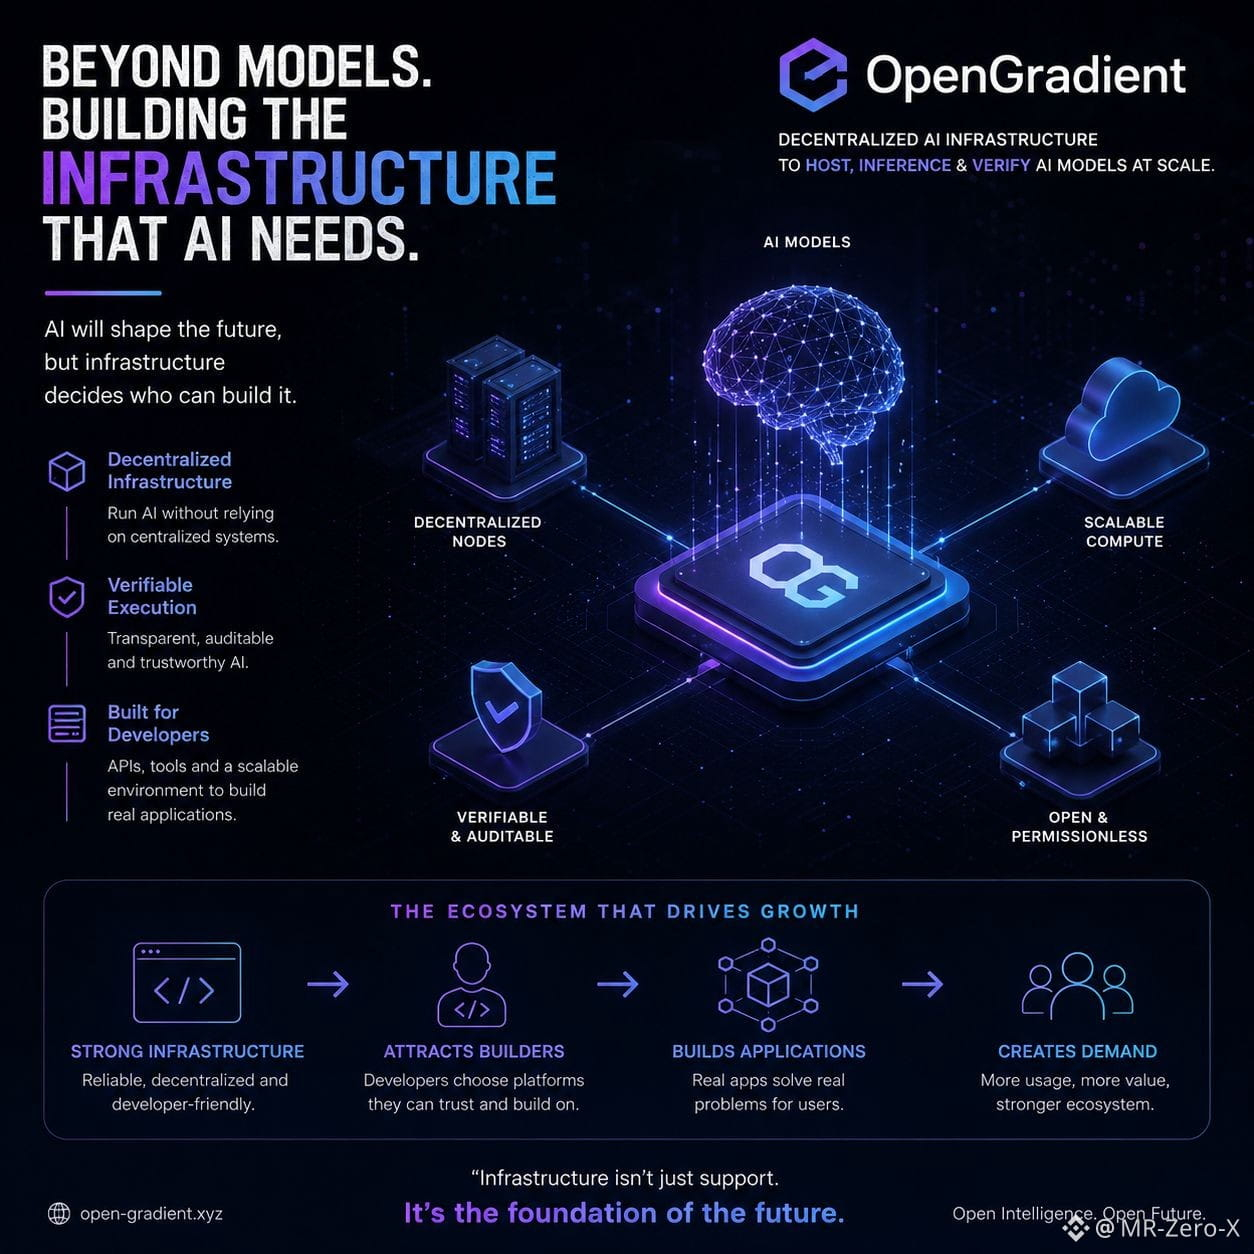
Viele KI-Projekte sprechen von Dezentralisierung, aber nur sehr wenige konzentrieren sich darauf, die Bereitstellung von KI für Entwickler praktisch zu gestalten. Ohne nutzbare Infrastruktur haben selbst die besten Ideen Schwierigkeiten, über Demos hinauszukommen.
Was ich interessant finde, ist der Versuch von OpenGradient, eine Umgebung zu schaffen, in der KI-Modelle gehostet, ausgeführt und verifiziert werden können, durch dezentrale Infrastruktur, anstatt sich vollständig auf zentrale Systeme zu verlassen.
Der echte Test ist nicht die Technologie selbst.
Es ist, ob Entwickler sich entscheiden, darauf aufzubauen.
Starke Infrastruktur zieht Builder an.
Builder erstellen Anwendungen.
Anwendungen schaffen Nachfrage.
Dieser Zyklus verwandelt eine Idee in ein Ökosystem.
Für den Moment ist das die Kennzahl, die ich bei OpenGradient am genauesten beobachte.
Nicht die Schlagzeilen.
Die Akzeptanz durch Entwickler.
#OpenGradient @OpenGradient $OPG
#opg $OPG
Die meisten Leute konzentrieren sich auf KI-Modelle.
Ich lege mehr Wert auf die Infrastruktur, die darunter liegt.
Denn großartige Technologie gewinnt selten nur durch ihre Fähigkeiten.
Sie gewinnt, wenn die Builder sie tatsächlich nutzen können.
Das ist ein Grund, warum OpenGradient mein Interesse weckt.
Viele KI-Projekte sprechen von Dezentralisierung, aber nur sehr wenige konzentrieren sich darauf, die Bereitstellung von KI für Entwickler praktisch zu gestalten. Ohne nutzbare Infrastruktur haben selbst die besten Ideen Schwierigkeiten, über Demos hinauszukommen.
Was ich interessant finde, ist der Versuch von OpenGradient, eine Umgebung zu schaffen, in der KI-Modelle gehostet, ausgeführt und verifiziert werden können, durch dezentrale Infrastruktur, anstatt sich vollständig auf zentrale Systeme zu verlassen.
Der echte Test ist nicht die Technologie selbst.
Es ist, ob Entwickler sich entscheiden, darauf aufzubauen.
Starke Infrastruktur zieht Builder an.
Builder erstellen Anwendungen.
Anwendungen schaffen Nachfrage.
Dieser Zyklus verwandelt eine Idee in ein Ökosystem.
Für den Moment ist das die Kennzahl, die ich bei OpenGradient am genauesten beobachte.
Nicht die Schlagzeilen.
Die Akzeptanz durch Entwickler.
#OpenGradient @OpenGradient $OPG
Die meisten Leute konzentrieren sich auf KI-Modelle.
Ich lege mehr Wert auf die Infrastruktur, die darunter liegt.
Denn großartige Technologie gewinnt selten nur durch ihre Fähigkeiten.
Sie gewinnt, wenn die Builder sie tatsächlich nutzen können.
Das ist ein Grund, warum OpenGradient mein Interesse weckt.
Viele KI-Projekte sprechen von Dezentralisierung, aber nur sehr wenige konzentrieren sich darauf, die Bereitstellung von KI für Entwickler praktisch zu gestalten. Ohne nutzbare Infrastruktur haben selbst die besten Ideen Schwierigkeiten, über Demos hinauszukommen.
Was ich interessant finde, ist der Versuch von OpenGradient, eine Umgebung zu schaffen, in der KI-Modelle gehostet, ausgeführt und verifiziert werden können, durch dezentrale Infrastruktur, anstatt sich vollständig auf zentrale Systeme zu verlassen.
Der echte Test ist nicht die Technologie selbst.
Es ist, ob Entwickler sich entscheiden, darauf aufzubauen.
Starke Infrastruktur zieht Builder an.
Builder erstellen Anwendungen.
Anwendungen schaffen Nachfrage.
Dieser Zyklus verwandelt eine Idee in ein Ökosystem.
Für den Moment ist das die Kennzahl, die ich bei OpenGradient am genauesten beobachte.
Nicht die Schlagzeilen.
Die Akzeptanz durch Entwickler.
#OpenGradient @OpenGradient $OPG
1
181
·
--
Verifiziert
#opg $OPG
OpenGradient $OPG:
Entkopplung von Hype und Ausführungsintelligenz.
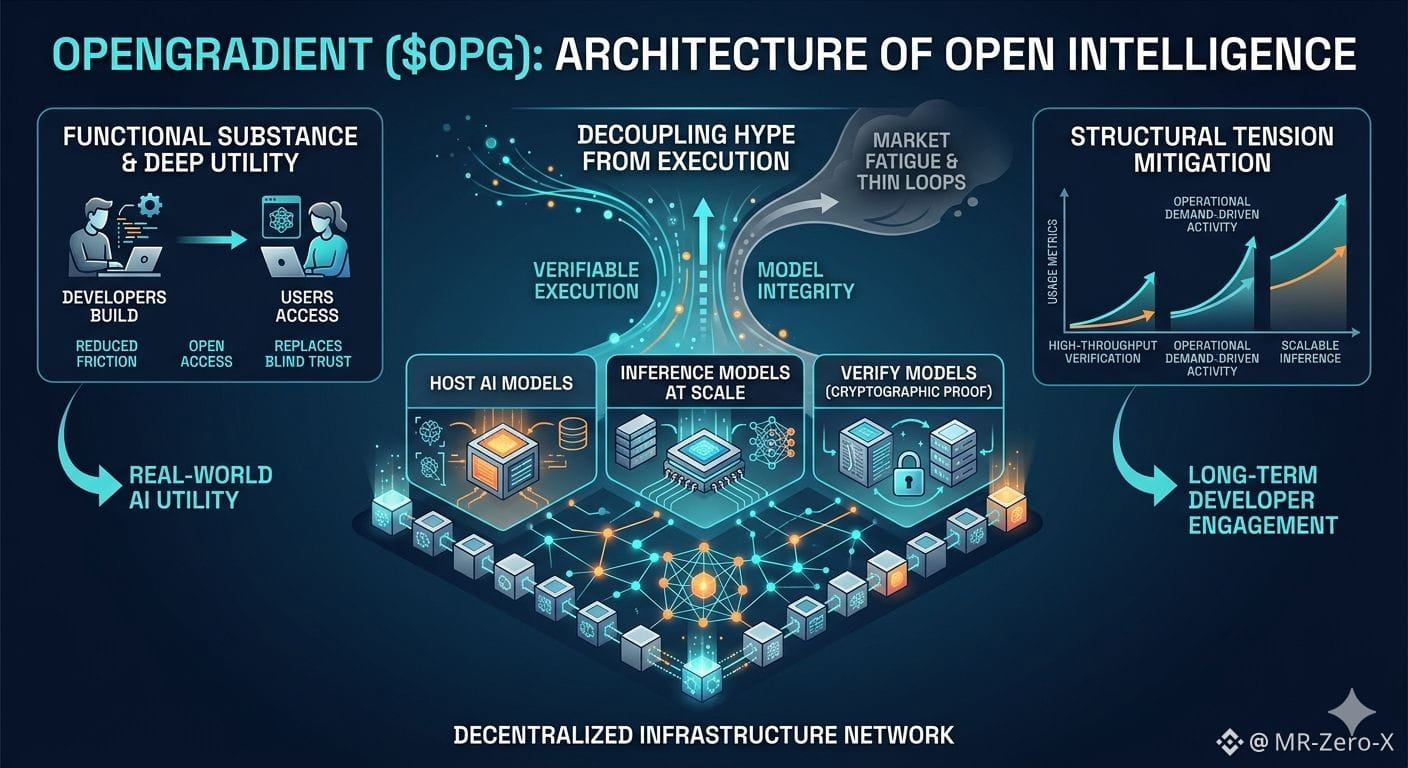
Die Web3-Infrastrukturlandschaft leidet unter akuter Marktmüdigkeit. Wir sind überschwemmt mit Netzwerken, die technische Bedeutung vorspielen – stark auf tokenbasierten Pitches, aber bemerkenswert dünn in Bezug auf funktionale Substanz. Wenn man unter die Oberfläche vieler dezentraler KI (DeAI) Plattformen schaut, ist die Architektur brüchig, verlässt sich auf zentrale Vertrauensannahmen oder ineffiziente Rechenzyklen, die unter der realen Nachfrage zusammenbrechen.
OpenGradient ($OPG) sticht hervor, weil es dieses recycelte Skript vermeidet. Es wird nicht rückwärts aufgebaut; das Netzwerk konzentriert sich vollständig darauf, im Kern der Ausführungsschicht ordnungsgemäß zu funktionieren. Entworfen als dezentrales Infrastruktur-Netzwerk, um KI-Modelle zu hosten, zu inferieren und zu verifizieren, ersetzt OpenGradient blinden Vertrauen durch kryptographische Sicherheit. Anstatt Entwickler in starre, unoptimierte Umgebungen zu zwingen, führt es eine hybride Rechenarchitektur ein, bei der die Integrität des Modells überprüfbar und die Ausführung nahtlos ist.
Was hier die Marktmüdigkeit verhindert, ist das Gleichgewicht zwischen roher Nützlichkeit und struktureller Nachhaltigkeit. Durch die Senkung der Reibung, die erforderlich ist, um mit offener Intelligenz zu interagieren, sorgt $OPG dafür, dass die Netzwerkaktivität von echtem operativen Bedarf und nicht von künstlichen Anreizschleifen angetrieben wird. Es schafft eine Umgebung, in der dezentrale KI wie ein robustes, industrielles Werkzeug und nicht wie ein inszeniertes Experiment wirkt.
Der echte Test für jede DeAI-Infrastruktur ist die strukturelle Spannung: Kann das Netzwerk eine hohe Durchsatzverifizierung ohne übermäßige Latenz aufrechterhalten? Während viele Projekte unter fortgesetztem Gebrauch zerbrechen, bietet OpenGradients Fokus auf skalierbare, verifizierbare Inferenz das tiefgehende technische Fundament, das erforderlich ist, um langfristiges Entwicklerengagement aufrechtzuerhalten. Es versucht nicht, mit narrativem Geschwafel zu beeindrucken, sondern konzentriert sich auf Ausführungsintelligenz.
@OpenGradient $OPG #OpenGradient
#opg $OPG
OpenGradient $OPG :
Entkopplung von Hype und Ausführungsintelligenz.
Die Web3-Infrastrukturlandschaft leidet unter akuter Marktmüdigkeit. Wir sind überschwemmt mit Netzwerken, die technische Bedeutung vorspielen – stark auf tokenbasierten Pitches, aber bemerkenswert dünn in Bezug auf funktionale Substanz. Wenn man unter die Oberfläche vieler dezentraler KI (DeAI) Plattformen schaut, ist die Architektur brüchig, verlässt sich auf zentrale Vertrauensannahmen oder ineffiziente Rechenzyklen, die unter der realen Nachfrage zusammenbrechen.
OpenGradient ($OPG ) sticht hervor, weil es dieses recycelte Skript vermeidet. Es wird nicht rückwärts aufgebaut; das Netzwerk konzentriert sich vollständig darauf, im Kern der Ausführungsschicht ordnungsgemäß zu funktionieren. Entworfen als dezentrales Infrastruktur-Netzwerk, um KI-Modelle zu hosten, zu inferieren und zu verifizieren, ersetzt OpenGradient blinden Vertrauen durch kryptographische Sicherheit. Anstatt Entwickler in starre, unoptimierte Umgebungen zu zwingen, führt es eine hybride Rechenarchitektur ein, bei der die Integrität des Modells überprüfbar und die Ausführung nahtlos ist.
Was hier die Marktmüdigkeit verhindert, ist das Gleichgewicht zwischen roher Nützlichkeit und struktureller Nachhaltigkeit. Durch die Senkung der Reibung, die erforderlich ist, um mit offener Intelligenz zu interagieren, sorgt $OPG dafür, dass die Netzwerkaktivität von echtem operativen Bedarf und nicht von künstlichen Anreizschleifen angetrieben wird. Es schafft eine Umgebung, in der dezentrale KI wie ein robustes, industrielles Werkzeug und nicht wie ein inszeniertes Experiment wirkt.
Der echte Test für jede DeAI-Infrastruktur ist die strukturelle Spannung: Kann das Netzwerk eine hohe Durchsatzverifizierung ohne übermäßige Latenz aufrechterhalten? Während viele Projekte unter fortgesetztem Gebrauch zerbrechen, bietet OpenGradients Fokus auf skalierbare, verifizierbare Inferenz das tiefgehende technische Fundament, das erforderlich ist, um langfristiges Entwicklerengagement aufrechtzuerhalten. Es versucht nicht, mit narrativem Geschwafel zu beeindrucken, sondern konzentriert sich auf Ausführungsintelligenz.
@OpenGradient $OPG #OpenGradient
OpenGradient $OPG :
Entkopplung von Hype und Ausführungsintelligenz.
Die Web3-Infrastrukturlandschaft leidet unter akuter Marktmüdigkeit. Wir sind überschwemmt mit Netzwerken, die technische Bedeutung vorspielen – stark auf tokenbasierten Pitches, aber bemerkenswert dünn in Bezug auf funktionale Substanz. Wenn man unter die Oberfläche vieler dezentraler KI (DeAI) Plattformen schaut, ist die Architektur brüchig, verlässt sich auf zentrale Vertrauensannahmen oder ineffiziente Rechenzyklen, die unter der realen Nachfrage zusammenbrechen.
OpenGradient ($OPG ) sticht hervor, weil es dieses recycelte Skript vermeidet. Es wird nicht rückwärts aufgebaut; das Netzwerk konzentriert sich vollständig darauf, im Kern der Ausführungsschicht ordnungsgemäß zu funktionieren. Entworfen als dezentrales Infrastruktur-Netzwerk, um KI-Modelle zu hosten, zu inferieren und zu verifizieren, ersetzt OpenGradient blinden Vertrauen durch kryptographische Sicherheit. Anstatt Entwickler in starre, unoptimierte Umgebungen zu zwingen, führt es eine hybride Rechenarchitektur ein, bei der die Integrität des Modells überprüfbar und die Ausführung nahtlos ist.
Was hier die Marktmüdigkeit verhindert, ist das Gleichgewicht zwischen roher Nützlichkeit und struktureller Nachhaltigkeit. Durch die Senkung der Reibung, die erforderlich ist, um mit offener Intelligenz zu interagieren, sorgt $OPG dafür, dass die Netzwerkaktivität von echtem operativen Bedarf und nicht von künstlichen Anreizschleifen angetrieben wird. Es schafft eine Umgebung, in der dezentrale KI wie ein robustes, industrielles Werkzeug und nicht wie ein inszeniertes Experiment wirkt.
Der echte Test für jede DeAI-Infrastruktur ist die strukturelle Spannung: Kann das Netzwerk eine hohe Durchsatzverifizierung ohne übermäßige Latenz aufrechterhalten? Während viele Projekte unter fortgesetztem Gebrauch zerbrechen, bietet OpenGradients Fokus auf skalierbare, verifizierbare Inferenz das tiefgehende technische Fundament, das erforderlich ist, um langfristiges Entwicklerengagement aufrechtzuerhalten. Es versucht nicht, mit narrativem Geschwafel zu beeindrucken, sondern konzentriert sich auf Ausführungsintelligenz.
@OpenGradient $OPG #OpenGradient
9
1
260
·
--
Verifiziert
#opg $OPG Ich habe gesehen, wie sich die „DeAI“-Erzählung in nicht viel mehr als ein Marketing-Spiel verwandelt hat.
Die meisten Projekte behaupten dezentrale KI, aber die eigentliche Inferenz läuft weiterhin über zentrale Web2-APIs. Einen Token hinzufügen, Hype erzeugen, wiederholen.
@OpenGradient hat meine Aufmerksamkeit geweckt, weil es das eigentliche Problem angreift: Compute.
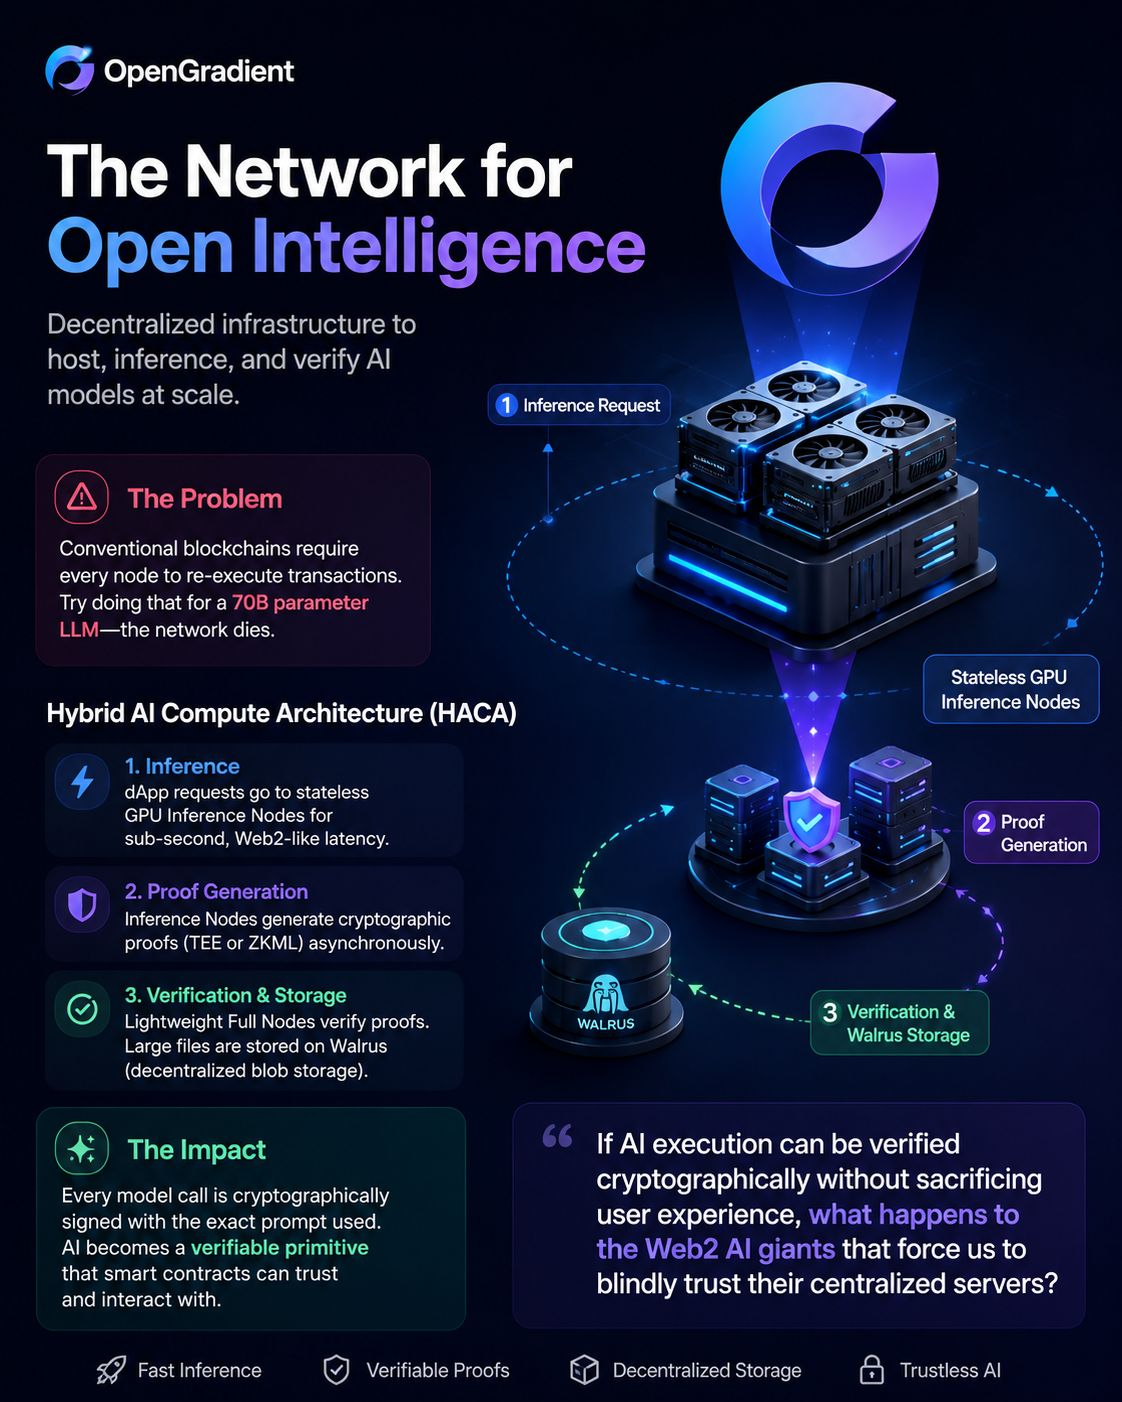
Traditionelle Blockchains verlangen, dass jeder Knoten Transaktionen erneut ausführt. Dieses Modell bricht völlig zusammen, wenn man mit großen KI-Systemen zu tun hat. Niemand läuft ein 70B-Parameter-LLM über jeden Validator, ohne die Performance zu zerstören.
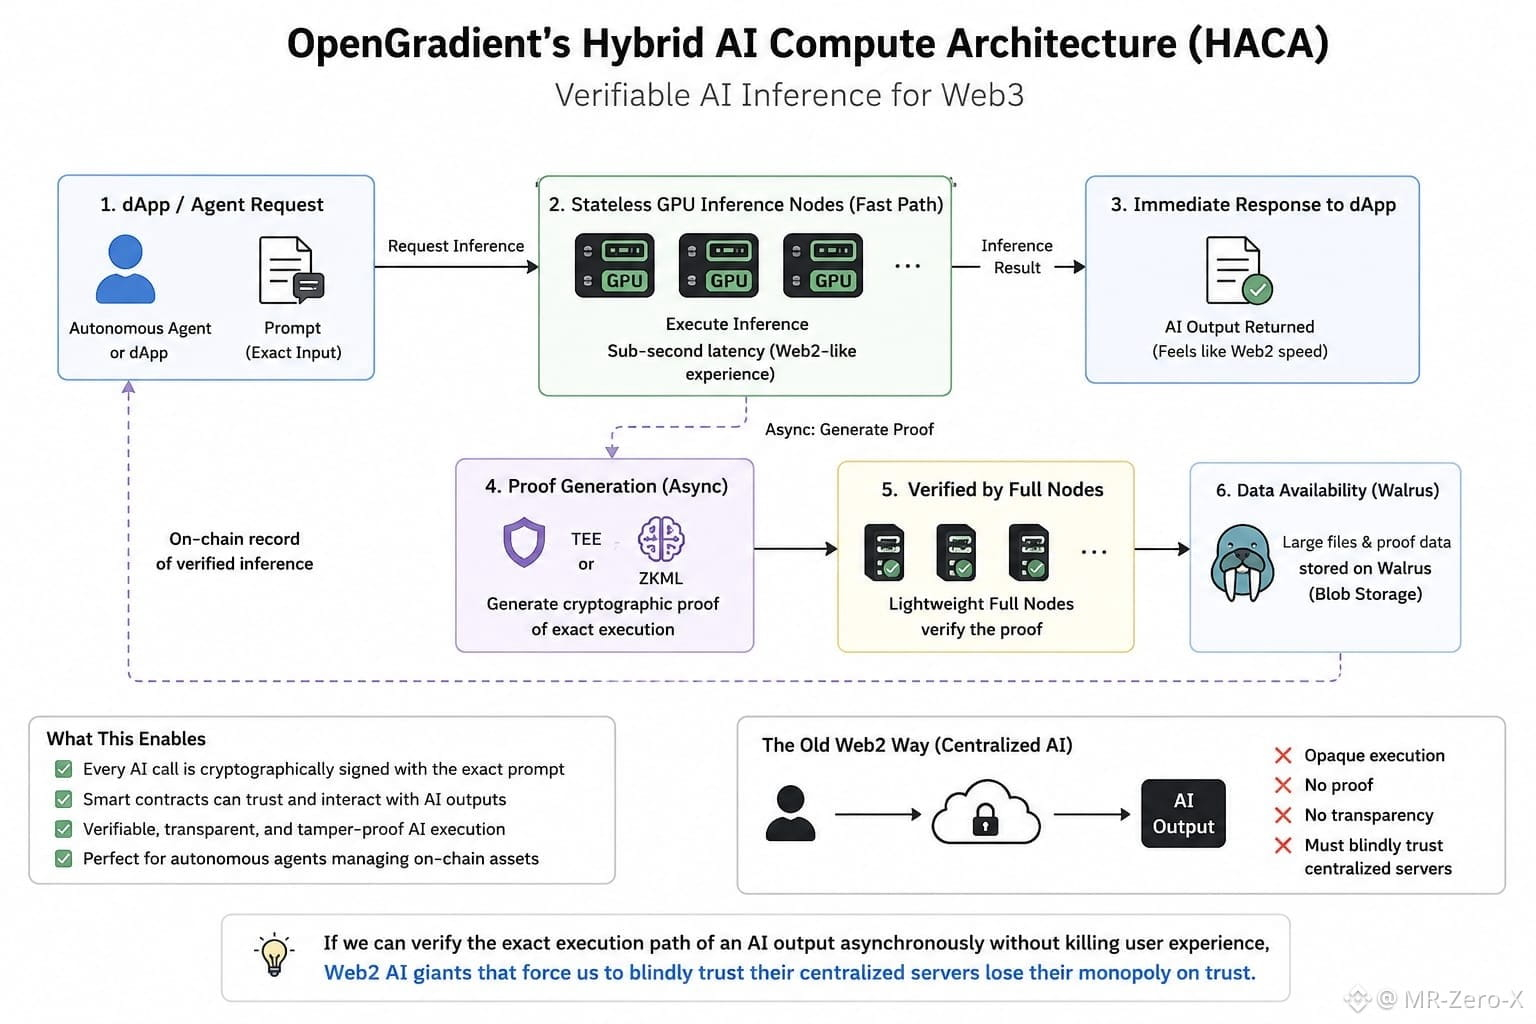
Ihre Hybrid AI Compute Architecture (HACA) verfolgt einen anderen Ansatz.
Inferenzanfragen werden direkt von zustandslosen GPU-Inferenzknoten verarbeitet und liefern nahezu Web2-ähnliche Latenz. Währenddessen werden kryptografische Beweise (TEE oder ZKML) asynchron erzeugt und von leichten Full Nodes verifiziert, während große Artefakte über Walrus gespeichert werden.
Das Ergebnis?
KI-Ausgaben werden überprüfbar.
Jeder Modellaufruf kann kryptografisch mit dem exakten Prompt und der verwendeten Ausführungsumgebung verknüpft werden. Anstatt einem Black-Box-Orakel zu vertrauen, um Entscheidungen zu treffen oder Assets zu verschieben, erhalten Smart Contracts eine Möglichkeit, das KI-Verhalten zu verifizieren.
Das ist ein großer Wandel für autonome Agenten und On-Chain-KI-Anwendungen.
Ich bin weiterhin gespannt zu sehen, wie das Netzwerk sich unter dauerhaftem, gleichzeitigen Bedarf verhält, aber die Architektur wirkt eher auf Nutzen ausgerichtet als auf Erzählung.
Die größere Frage ist diese:
Wenn KI-Ausführung kryptografisch verifiziert werden kann, ohne die Nutzererfahrung zu opfern, was passiert dann mit den zentralisierten KI-Plattformen, die sich vollständig auf Vertrauen verlassen?
OpenGradient baut dezentrale Infrastruktur, um KI-Modelle in großem Maßstab bereitzustellen, auszuführen und zu verifizieren.
$OPG #OpenGradient @OpenGradient
#opg $OPG Ich habe gesehen, wie sich die „DeAI“-Erzählung in nicht viel mehr als ein Marketing-Spiel verwandelt hat.
Die meisten Projekte behaupten dezentrale KI, aber die eigentliche Inferenz läuft weiterhin über zentrale Web2-APIs. Einen Token hinzufügen, Hype erzeugen, wiederholen.
@OpenGradient hat meine Aufmerksamkeit geweckt, weil es das eigentliche Problem angreift: Compute.
Traditionelle Blockchains verlangen, dass jeder Knoten Transaktionen erneut ausführt. Dieses Modell bricht völlig zusammen, wenn man mit großen KI-Systemen zu tun hat. Niemand läuft ein 70B-Parameter-LLM über jeden Validator, ohne die Performance zu zerstören.
Ihre Hybrid AI Compute Architecture (HACA) verfolgt einen anderen Ansatz.
Inferenzanfragen werden direkt von zustandslosen GPU-Inferenzknoten verarbeitet und liefern nahezu Web2-ähnliche Latenz. Währenddessen werden kryptografische Beweise (TEE oder ZKML) asynchron erzeugt und von leichten Full Nodes verifiziert, während große Artefakte über Walrus gespeichert werden.
Das Ergebnis?
KI-Ausgaben werden überprüfbar.
Jeder Modellaufruf kann kryptografisch mit dem exakten Prompt und der verwendeten Ausführungsumgebung verknüpft werden. Anstatt einem Black-Box-Orakel zu vertrauen, um Entscheidungen zu treffen oder Assets zu verschieben, erhalten Smart Contracts eine Möglichkeit, das KI-Verhalten zu verifizieren.
Das ist ein großer Wandel für autonome Agenten und On-Chain-KI-Anwendungen.
Ich bin weiterhin gespannt zu sehen, wie das Netzwerk sich unter dauerhaftem, gleichzeitigen Bedarf verhält, aber die Architektur wirkt eher auf Nutzen ausgerichtet als auf Erzählung.
Die größere Frage ist diese:
Wenn KI-Ausführung kryptografisch verifiziert werden kann, ohne die Nutzererfahrung zu opfern, was passiert dann mit den zentralisierten KI-Plattformen, die sich vollständig auf Vertrauen verlassen?
OpenGradient baut dezentrale Infrastruktur, um KI-Modelle in großem Maßstab bereitzustellen, auszuführen und zu verifizieren.
$OPG #OpenGradient @OpenGradient
Die meisten Projekte behaupten dezentrale KI, aber die eigentliche Inferenz läuft weiterhin über zentrale Web2-APIs. Einen Token hinzufügen, Hype erzeugen, wiederholen.
@OpenGradient hat meine Aufmerksamkeit geweckt, weil es das eigentliche Problem angreift: Compute.
Traditionelle Blockchains verlangen, dass jeder Knoten Transaktionen erneut ausführt. Dieses Modell bricht völlig zusammen, wenn man mit großen KI-Systemen zu tun hat. Niemand läuft ein 70B-Parameter-LLM über jeden Validator, ohne die Performance zu zerstören.
Ihre Hybrid AI Compute Architecture (HACA) verfolgt einen anderen Ansatz.
Inferenzanfragen werden direkt von zustandslosen GPU-Inferenzknoten verarbeitet und liefern nahezu Web2-ähnliche Latenz. Währenddessen werden kryptografische Beweise (TEE oder ZKML) asynchron erzeugt und von leichten Full Nodes verifiziert, während große Artefakte über Walrus gespeichert werden.
Das Ergebnis?
KI-Ausgaben werden überprüfbar.
Jeder Modellaufruf kann kryptografisch mit dem exakten Prompt und der verwendeten Ausführungsumgebung verknüpft werden. Anstatt einem Black-Box-Orakel zu vertrauen, um Entscheidungen zu treffen oder Assets zu verschieben, erhalten Smart Contracts eine Möglichkeit, das KI-Verhalten zu verifizieren.
Das ist ein großer Wandel für autonome Agenten und On-Chain-KI-Anwendungen.
Ich bin weiterhin gespannt zu sehen, wie das Netzwerk sich unter dauerhaftem, gleichzeitigen Bedarf verhält, aber die Architektur wirkt eher auf Nutzen ausgerichtet als auf Erzählung.
Die größere Frage ist diese:
Wenn KI-Ausführung kryptografisch verifiziert werden kann, ohne die Nutzererfahrung zu opfern, was passiert dann mit den zentralisierten KI-Plattformen, die sich vollständig auf Vertrauen verlassen?
OpenGradient baut dezentrale Infrastruktur, um KI-Modelle in großem Maßstab bereitzustellen, auszuführen und zu verifizieren.
$OPG #OpenGradient @OpenGradient
1
385
·
--
Verifiziert
#opg $OPG Ich habe gesehen, wie der „DeAI“-Sektor in eine teure Marketing-Aktion abrutscht. Teams versprechen dezentrale Inferenz, leiten aber einfach Anfragen an Web2-APIs weiter, während sie hastig einen ERC-20-Token draufpacken, um Hype zu erzeugen. Das ist eine leere Schleife.
@OpenGradient fühlt sich anders an, weil sie das Rechen-Engpass-Problem angehen. Herkömmliche Ketten zwingen jeden Knoten, Transaktionen erneut auszuführen – probiere das mal mit einem LLM mit 70B Parametern aus, dann stirbt das Netzwerk.
Ihre Hybrid- KI-Compute-Architektur (HACA) verteilt die Last. Wenn eine dApp eine Inferenz anfordert, geht sie direkt an zustandslose GPU-Inferenzknoten für Inferenzzeiten im Bereich von Sub-Sekunden und Web2-ähnlicher Latenz. Asynchron erzeugt der Knoten einen kryptografischen Beweis (TEE oder ZKML), der von leichten Full Nodes verifiziert wird; schwere Dateien werden auf Walrus-Blob-Speicher ausgelagert.
Das verändert alles für autonome Agenten. Statt blind einem undurchsichtigen Orakel zu vertrauen, um Treasury-Gelder zu bewegen, wird jeder Model-Aufruf kryptografisch signiert – mit genau dem Prompt, der verwendet wurde. So wird maschinelles Lernen zu einer verifizierbaren Grundlage, mit der Smart Contracts nativ interagieren können.
Ich beobachte, wie es mit Spitzenverkehr unter starker gleichzeitiger Auslastung umgeht, aber die strukturelle Basis ist tatsächlich für Nutzen statt für Rauschen gebaut.
Wenn wir den exakten Ausführungspfad eines KI-Ausgabeprodukts asynchron verifizieren können, ohne die Nutzererfahrung zu ruinieren – was passiert dann mit den Web2-KI-Riesen, die uns zwingen, ihren zentralisierten Servern blind zu vertrauen?
@OpenGradient #opg
#opg $OPG Ich habe gesehen, wie der „DeAI“-Sektor in eine teure Marketing-Aktion abrutscht. Teams versprechen dezentrale Inferenz, leiten aber einfach Anfragen an Web2-APIs weiter, während sie hastig einen ERC-20-Token draufpacken, um Hype zu erzeugen. Das ist eine leere Schleife.
@OpenGradient fühlt sich anders an, weil sie das Rechen-Engpass-Problem angehen. Herkömmliche Ketten zwingen jeden Knoten, Transaktionen erneut auszuführen – probiere das mal mit einem LLM mit 70B Parametern aus, dann stirbt das Netzwerk.
Ihre Hybrid- KI-Compute-Architektur (HACA) verteilt die Last. Wenn eine dApp eine Inferenz anfordert, geht sie direkt an zustandslose GPU-Inferenzknoten für Inferenzzeiten im Bereich von Sub-Sekunden und Web2-ähnlicher Latenz. Asynchron erzeugt der Knoten einen kryptografischen Beweis (TEE oder ZKML), der von leichten Full Nodes verifiziert wird; schwere Dateien werden auf Walrus-Blob-Speicher ausgelagert.
Das verändert alles für autonome Agenten. Statt blind einem undurchsichtigen Orakel zu vertrauen, um Treasury-Gelder zu bewegen, wird jeder Model-Aufruf kryptografisch signiert – mit genau dem Prompt, der verwendet wurde. So wird maschinelles Lernen zu einer verifizierbaren Grundlage, mit der Smart Contracts nativ interagieren können.
Ich beobachte, wie es mit Spitzenverkehr unter starker gleichzeitiger Auslastung umgeht, aber die strukturelle Basis ist tatsächlich für Nutzen statt für Rauschen gebaut.
Wenn wir den exakten Ausführungspfad eines KI-Ausgabeprodukts asynchron verifizieren können, ohne die Nutzererfahrung zu ruinieren – was passiert dann mit den Web2-KI-Riesen, die uns zwingen, ihren zentralisierten Servern blind zu vertrauen?
@OpenGradient #opg
@OpenGradient fühlt sich anders an, weil sie das Rechen-Engpass-Problem angehen. Herkömmliche Ketten zwingen jeden Knoten, Transaktionen erneut auszuführen – probiere das mal mit einem LLM mit 70B Parametern aus, dann stirbt das Netzwerk.
Ihre Hybrid- KI-Compute-Architektur (HACA) verteilt die Last. Wenn eine dApp eine Inferenz anfordert, geht sie direkt an zustandslose GPU-Inferenzknoten für Inferenzzeiten im Bereich von Sub-Sekunden und Web2-ähnlicher Latenz. Asynchron erzeugt der Knoten einen kryptografischen Beweis (TEE oder ZKML), der von leichten Full Nodes verifiziert wird; schwere Dateien werden auf Walrus-Blob-Speicher ausgelagert.
Das verändert alles für autonome Agenten. Statt blind einem undurchsichtigen Orakel zu vertrauen, um Treasury-Gelder zu bewegen, wird jeder Model-Aufruf kryptografisch signiert – mit genau dem Prompt, der verwendet wurde. So wird maschinelles Lernen zu einer verifizierbaren Grundlage, mit der Smart Contracts nativ interagieren können.
Ich beobachte, wie es mit Spitzenverkehr unter starker gleichzeitiger Auslastung umgeht, aber die strukturelle Basis ist tatsächlich für Nutzen statt für Rauschen gebaut.
Wenn wir den exakten Ausführungspfad eines KI-Ausgabeprodukts asynchron verifizieren können, ohne die Nutzererfahrung zu ruinieren – was passiert dann mit den Web2-KI-Riesen, die uns zwingen, ihren zentralisierten Servern blind zu vertrauen?
@OpenGradient #opg
207
·
--
#genius $GENIUS @GeniusOfficial
Genius Terminal bezeichnet sich selbst als das erste private und finale On-Chain-Terminal.
Große Behauptung.
Aber wenn man tiefer schaut, wird die These interessant.
━━━━━━━━━━━━━━━
EBENE 1: AUSFÜHRUNG
Die meisten Trader springen immer noch zwischen Wallets, Bridges, Aggregatoren und mehreren Chains.
Dieser Reibungsverlust kostet Zeit.
Und in Krypto ist Zeit oft Profit.
Genius versucht, das gesamte Handelserlebnis in ein einziges Terminal zu komprimieren.
---
EBENE 2: DATENSCHUTZ
Eines der größten Probleme in On-Chain-Märkten ist die Sichtbarkeit.
Große Orders können Aufmerksamkeit anziehen, bevor sie ausgeführt werden.
Der Fokus des Projekts auf privaten Order-Flow zielt darauf ab, diese Exposition zu reduzieren.
Denk darüber sorgfältig nach.
Datenschutz ist nicht nur ein Feature.
Für ernsthaftes Kapital kann er zu einer Infrastruktur werden.
---
EBENE 3: CROSS-CHAIN-ABSTRAKTION
Retail sieht oft Chains.
Professionals sehen Liquidität.
Die langfristige Vision scheint die Komplexität des Bridgings, des Gas-Managements und des Netzwerkwechsels zu beseitigen.
Wenn das gelingt, interagieren Nutzer mit Möglichkeiten – statt mit Blockchains.
━━━━━━━━━━━━━━━
RISIKO / SCHWÄCHE
Die Vision ist ambitioniert.
Das Ausführungsrisiko bleibt hoch.
Eine private, nahtlose Multi-Chain-Handelsschicht zu bauen, ist deutlich schwieriger, als sie zu vermarkten.
Nicht jeder wird einem neuen Terminal sofort vertrauen.
Die Akzeptanz wird der echte Test sein.
━━━━━━━━━━━━━━━
Die Frage ist einfach:
Baut Genius Terminal die nächste Generation der On-Chain-Handelsinfrastruktur,
oder löst es ein Problem, das die meisten Nutzer noch immer nicht richtig verstehen?
Was ist deine Sicht?
#genius
#genius $GENIUS @GeniusOfficial
Genius Terminal bezeichnet sich selbst als das erste private und finale On-Chain-Terminal.
Große Behauptung.
Aber wenn man tiefer schaut, wird die These interessant.
━━━━━━━━━━━━━━━
EBENE 1: AUSFÜHRUNG
Die meisten Trader springen immer noch zwischen Wallets, Bridges, Aggregatoren und mehreren Chains.
Dieser Reibungsverlust kostet Zeit.
Und in Krypto ist Zeit oft Profit.
Genius versucht, das gesamte Handelserlebnis in ein einziges Terminal zu komprimieren.
---
EBENE 2: DATENSCHUTZ
Eines der größten Probleme in On-Chain-Märkten ist die Sichtbarkeit.
Große Orders können Aufmerksamkeit anziehen, bevor sie ausgeführt werden.
Der Fokus des Projekts auf privaten Order-Flow zielt darauf ab, diese Exposition zu reduzieren.
Denk darüber sorgfältig nach.
Datenschutz ist nicht nur ein Feature.
Für ernsthaftes Kapital kann er zu einer Infrastruktur werden.
---
EBENE 3: CROSS-CHAIN-ABSTRAKTION
Retail sieht oft Chains.
Professionals sehen Liquidität.
Die langfristige Vision scheint die Komplexität des Bridgings, des Gas-Managements und des Netzwerkwechsels zu beseitigen.
Wenn das gelingt, interagieren Nutzer mit Möglichkeiten – statt mit Blockchains.
━━━━━━━━━━━━━━━
RISIKO / SCHWÄCHE
Die Vision ist ambitioniert.
Das Ausführungsrisiko bleibt hoch.
Eine private, nahtlose Multi-Chain-Handelsschicht zu bauen, ist deutlich schwieriger, als sie zu vermarkten.
Nicht jeder wird einem neuen Terminal sofort vertrauen.
Die Akzeptanz wird der echte Test sein.
━━━━━━━━━━━━━━━
Die Frage ist einfach:
Baut Genius Terminal die nächste Generation der On-Chain-Handelsinfrastruktur,
oder löst es ein Problem, das die meisten Nutzer noch immer nicht richtig verstehen?
Was ist deine Sicht?
#genius
Genius Terminal bezeichnet sich selbst als das erste private und finale On-Chain-Terminal.
Große Behauptung.
Aber wenn man tiefer schaut, wird die These interessant.
━━━━━━━━━━━━━━━
EBENE 1: AUSFÜHRUNG
Die meisten Trader springen immer noch zwischen Wallets, Bridges, Aggregatoren und mehreren Chains.
Dieser Reibungsverlust kostet Zeit.
Und in Krypto ist Zeit oft Profit.
Genius versucht, das gesamte Handelserlebnis in ein einziges Terminal zu komprimieren.
---
EBENE 2: DATENSCHUTZ
Eines der größten Probleme in On-Chain-Märkten ist die Sichtbarkeit.
Große Orders können Aufmerksamkeit anziehen, bevor sie ausgeführt werden.
Der Fokus des Projekts auf privaten Order-Flow zielt darauf ab, diese Exposition zu reduzieren.
Denk darüber sorgfältig nach.
Datenschutz ist nicht nur ein Feature.
Für ernsthaftes Kapital kann er zu einer Infrastruktur werden.
---
EBENE 3: CROSS-CHAIN-ABSTRAKTION
Retail sieht oft Chains.
Professionals sehen Liquidität.
Die langfristige Vision scheint die Komplexität des Bridgings, des Gas-Managements und des Netzwerkwechsels zu beseitigen.
Wenn das gelingt, interagieren Nutzer mit Möglichkeiten – statt mit Blockchains.
━━━━━━━━━━━━━━━
RISIKO / SCHWÄCHE
Die Vision ist ambitioniert.
Das Ausführungsrisiko bleibt hoch.
Eine private, nahtlose Multi-Chain-Handelsschicht zu bauen, ist deutlich schwieriger, als sie zu vermarkten.
Nicht jeder wird einem neuen Terminal sofort vertrauen.
Die Akzeptanz wird der echte Test sein.
━━━━━━━━━━━━━━━
Die Frage ist einfach:
Baut Genius Terminal die nächste Generation der On-Chain-Handelsinfrastruktur,
oder löst es ein Problem, das die meisten Nutzer noch immer nicht richtig verstehen?
Was ist deine Sicht?
#genius
1
1
203
·
--
Verifiziert
#bedrock $BR @Bedrock Etwas kam mir beim Zusehen zu DeFi-Ausentwicklung komisch vor.
Die Branche jagte weiter nach höheren Renditen, doch das Kapital blieb hinter fragmentierten Staking-Systemen gefangen – in isolierten Chains, mit ständigem Koordinationsdruck.
Schon die Sichtbarkeit wurde anstrengend.
Die Masse fokussiert sich auf APYs, Token-Narrative und alles, was die Timeline für eine Woche dominiert.
Doch unter der Oberfläche ist das, was wirklich zählt, die Wahrung von Optionalität.
Smart Money interessiert sich für Liquidität, Kapitaleffizienz und für eine Infrastruktur, die Assets produktiv hält, ohne Flexibilität zu opfern.
Genau das hat meine Aufmerksamkeit auf Bedrock 2.0 und @Bedrock_DeFi gelenkt.
Anstatt Kapital in isolierte Staking-Silos zu pressen, macht Bedrock BTC, ETH und andere Assets zu liquiden Restaking-Positionen, die in DeFi weiter nutzbar bleiben.
uniBTC und andere liquide Restaking-Assets verwandeln ungenutztes Sicherheitenkapital in kontinuierlich produktives Kapital.
Multi-Asset-Restaking reduziert Fragmentierung und vereinfacht die Generierung von Renditen über mehrere Ökosysteme hinweg.
Der eigentliche Vorteil ist die operative Effizienz. Das Kapital muss sich nicht mehr zwischen Liquidität und Rewards entscheiden.
💀 Dieser Trade-off ist seit Jahren ein strukturelles Problem.
Der Grund, warum das mir besonders aufgefallen ist, ist, dass Bedrock still und leise zu einer operativen Schicht für BTCFi und Multi-Chain-DeFi wird.
Gestützt durch Infrastruktur-Partnerschaften wie RockX und integriert in große Restaking-Ökosysteme, $BR wirkt weniger wie ein spekulatives Asset und mehr wie eine unvermeidliche Infrastruktur-Schiene.
Ich sehe nur zwei Wege von hier aus:
A) Temporäre Narrative jagen
B) Infrastruktur besitzen, bevor die Masse es merkt
Auf welcher Seite stehst du?
#bedrock $BR @Bedrock Etwas kam mir beim Zusehen zu DeFi-Ausentwicklung komisch vor.
Die Branche jagte weiter nach höheren Renditen, doch das Kapital blieb hinter fragmentierten Staking-Systemen gefangen – in isolierten Chains, mit ständigem Koordinationsdruck.
Schon die Sichtbarkeit wurde anstrengend.
Die Masse fokussiert sich auf APYs, Token-Narrative und alles, was die Timeline für eine Woche dominiert.
Doch unter der Oberfläche ist das, was wirklich zählt, die Wahrung von Optionalität.
Smart Money interessiert sich für Liquidität, Kapitaleffizienz und für eine Infrastruktur, die Assets produktiv hält, ohne Flexibilität zu opfern.
Genau das hat meine Aufmerksamkeit auf Bedrock 2.0 und @Bedrock_DeFi gelenkt.
Anstatt Kapital in isolierte Staking-Silos zu pressen, macht Bedrock BTC, ETH und andere Assets zu liquiden Restaking-Positionen, die in DeFi weiter nutzbar bleiben.
uniBTC und andere liquide Restaking-Assets verwandeln ungenutztes Sicherheitenkapital in kontinuierlich produktives Kapital.
Multi-Asset-Restaking reduziert Fragmentierung und vereinfacht die Generierung von Renditen über mehrere Ökosysteme hinweg.
Der eigentliche Vorteil ist die operative Effizienz. Das Kapital muss sich nicht mehr zwischen Liquidität und Rewards entscheiden.
💀 Dieser Trade-off ist seit Jahren ein strukturelles Problem.
Der Grund, warum das mir besonders aufgefallen ist, ist, dass Bedrock still und leise zu einer operativen Schicht für BTCFi und Multi-Chain-DeFi wird.
Gestützt durch Infrastruktur-Partnerschaften wie RockX und integriert in große Restaking-Ökosysteme, $BR wirkt weniger wie ein spekulatives Asset und mehr wie eine unvermeidliche Infrastruktur-Schiene.
Ich sehe nur zwei Wege von hier aus:
A) Temporäre Narrative jagen
B) Infrastruktur besitzen, bevor die Masse es merkt
Auf welcher Seite stehst du?
Die Branche jagte weiter nach höheren Renditen, doch das Kapital blieb hinter fragmentierten Staking-Systemen gefangen – in isolierten Chains, mit ständigem Koordinationsdruck.
Schon die Sichtbarkeit wurde anstrengend.
Die Masse fokussiert sich auf APYs, Token-Narrative und alles, was die Timeline für eine Woche dominiert.
Doch unter der Oberfläche ist das, was wirklich zählt, die Wahrung von Optionalität.
Smart Money interessiert sich für Liquidität, Kapitaleffizienz und für eine Infrastruktur, die Assets produktiv hält, ohne Flexibilität zu opfern.
Genau das hat meine Aufmerksamkeit auf Bedrock 2.0 und @Bedrock_DeFi gelenkt.
Anstatt Kapital in isolierte Staking-Silos zu pressen, macht Bedrock BTC, ETH und andere Assets zu liquiden Restaking-Positionen, die in DeFi weiter nutzbar bleiben.
uniBTC und andere liquide Restaking-Assets verwandeln ungenutztes Sicherheitenkapital in kontinuierlich produktives Kapital.
Multi-Asset-Restaking reduziert Fragmentierung und vereinfacht die Generierung von Renditen über mehrere Ökosysteme hinweg.
Der eigentliche Vorteil ist die operative Effizienz. Das Kapital muss sich nicht mehr zwischen Liquidität und Rewards entscheiden.
💀 Dieser Trade-off ist seit Jahren ein strukturelles Problem.
Der Grund, warum das mir besonders aufgefallen ist, ist, dass Bedrock still und leise zu einer operativen Schicht für BTCFi und Multi-Chain-DeFi wird.
Gestützt durch Infrastruktur-Partnerschaften wie RockX und integriert in große Restaking-Ökosysteme, $BR wirkt weniger wie ein spekulatives Asset und mehr wie eine unvermeidliche Infrastruktur-Schiene.
Ich sehe nur zwei Wege von hier aus:
A) Temporäre Narrative jagen
B) Infrastruktur besitzen, bevor die Masse es merkt
Auf welcher Seite stehst du?
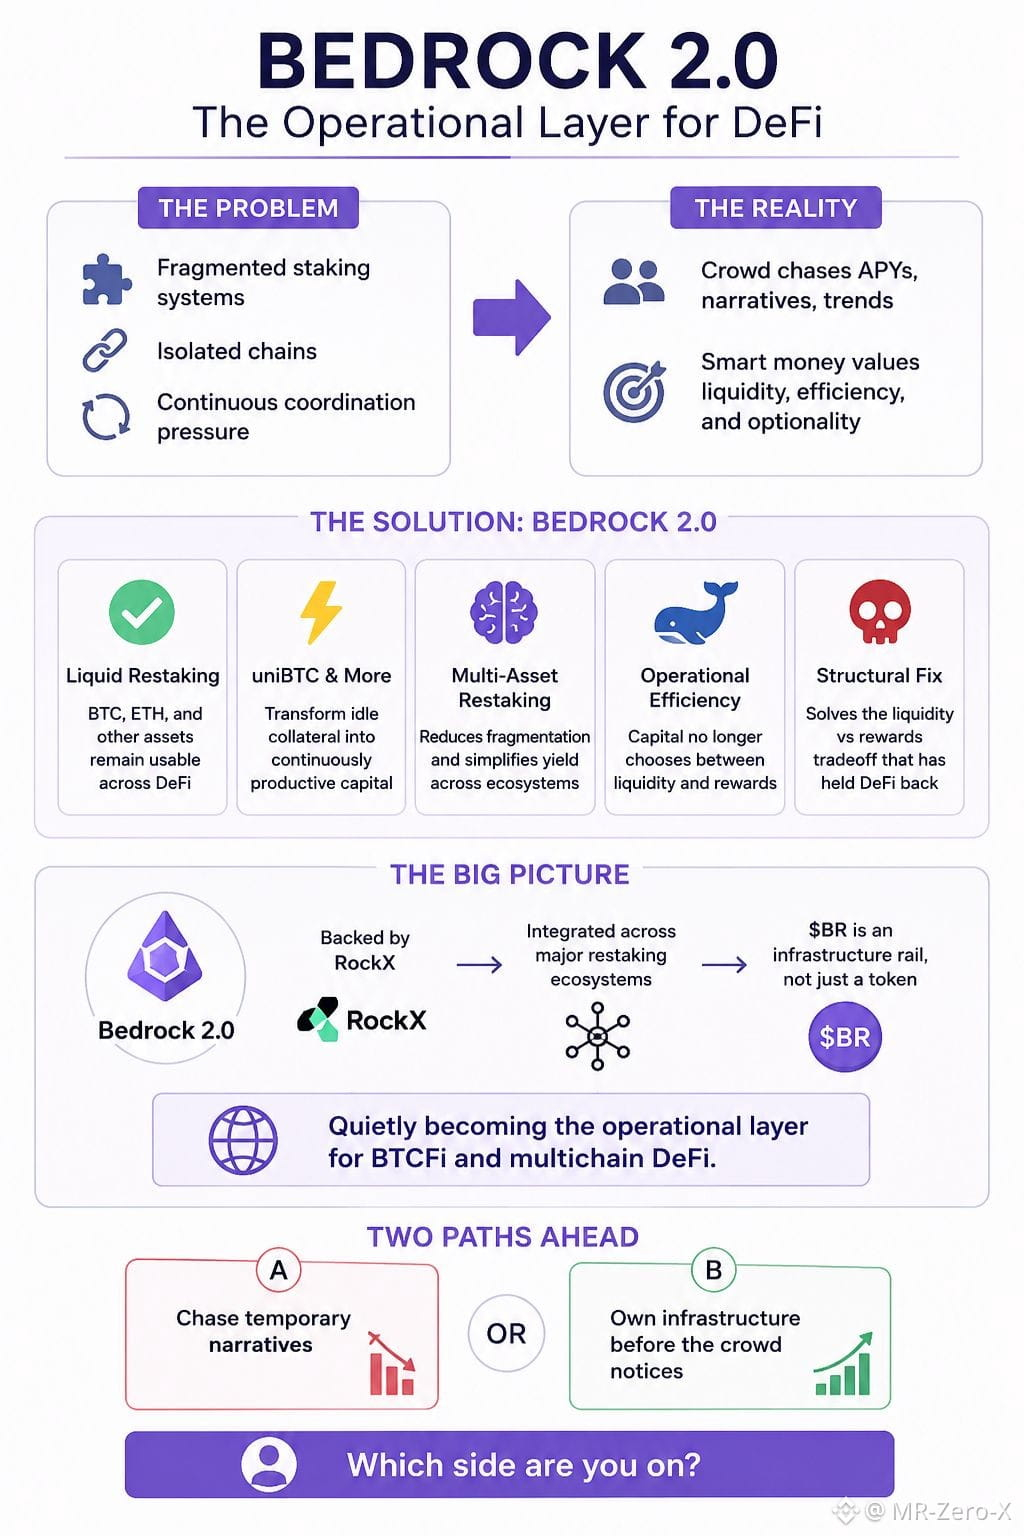
90
·
--
Verifiziert
#genius $GENIUS @GeniusOfficial Ich erinnere mich, dass mir klar wurde, dass die meisten Trader nicht wegen schlechter Ausführung verloren. Sie verloren, weil der Markt sie kommen sah. In einer transparenten Umgebung wird die Absicht oft zu einem Signal, lange bevor eine Transaktion bestätigt wird.
Die Branche liebt es, sich auf Geschwindigkeit, Gebühren und Durchsatz zu konzentrieren, aber die wichtigere Frage ist, wer die Informationen kontrolliert. Wallet-Tracking, Verhaltensprofiling und die Beobachtung des Orderflows haben Transparenz zu einem Wettbewerbsvorteil für Beobachter anstelle von Teilnehmern gemacht.
Das macht Genius Terminal interessant. Anstatt marginale Verbesserungen in der Ausführung zu verfolgen, konzentriert es sich auf Privatsphäre und Endgültigkeit. Das Wertangebot besteht nicht einfach darin, schneller zu sein, sondern strategische Absichten zu bewahren und unnötige Informationslecks zu reduzieren.
Natürlich übersetzt sich ein überzeugendes Produkt nicht automatisch in ein nachhaltiges Netzwerk. Die Qualität der Adoption, die Benutzerbindung, die Dynamik der Token-Freigabe und die echte Nachfrage werden letztendlich bestimmen, ob das Modell über die anfängliche Erzählung hinaus Bestand haben kann.
Märkte werden kurzfristig von Geschichten angetrieben, aber langfristiger Wert wird durch konsistentes Nutzerverhalten geschaffen. Aufmerksamkeit kann Momentum erzeugen, aber wiederkehrende Nutzung ist es, was Infrastruktur in ein dauerhaftes Asset verwandelt.
$GENIUS #GeniusTerminal #DeFi
#genius $GENIUS @GeniusOfficial Ich erinnere mich, dass mir klar wurde, dass die meisten Trader nicht wegen schlechter Ausführung verloren. Sie verloren, weil der Markt sie kommen sah. In einer transparenten Umgebung wird die Absicht oft zu einem Signal, lange bevor eine Transaktion bestätigt wird.
Die Branche liebt es, sich auf Geschwindigkeit, Gebühren und Durchsatz zu konzentrieren, aber die wichtigere Frage ist, wer die Informationen kontrolliert. Wallet-Tracking, Verhaltensprofiling und die Beobachtung des Orderflows haben Transparenz zu einem Wettbewerbsvorteil für Beobachter anstelle von Teilnehmern gemacht.
Das macht Genius Terminal interessant. Anstatt marginale Verbesserungen in der Ausführung zu verfolgen, konzentriert es sich auf Privatsphäre und Endgültigkeit. Das Wertangebot besteht nicht einfach darin, schneller zu sein, sondern strategische Absichten zu bewahren und unnötige Informationslecks zu reduzieren.
Natürlich übersetzt sich ein überzeugendes Produkt nicht automatisch in ein nachhaltiges Netzwerk. Die Qualität der Adoption, die Benutzerbindung, die Dynamik der Token-Freigabe und die echte Nachfrage werden letztendlich bestimmen, ob das Modell über die anfängliche Erzählung hinaus Bestand haben kann.
Märkte werden kurzfristig von Geschichten angetrieben, aber langfristiger Wert wird durch konsistentes Nutzerverhalten geschaffen. Aufmerksamkeit kann Momentum erzeugen, aber wiederkehrende Nutzung ist es, was Infrastruktur in ein dauerhaftes Asset verwandelt.
$GENIUS #GeniusTerminal #DeFi
Die Branche liebt es, sich auf Geschwindigkeit, Gebühren und Durchsatz zu konzentrieren, aber die wichtigere Frage ist, wer die Informationen kontrolliert. Wallet-Tracking, Verhaltensprofiling und die Beobachtung des Orderflows haben Transparenz zu einem Wettbewerbsvorteil für Beobachter anstelle von Teilnehmern gemacht.
Das macht Genius Terminal interessant. Anstatt marginale Verbesserungen in der Ausführung zu verfolgen, konzentriert es sich auf Privatsphäre und Endgültigkeit. Das Wertangebot besteht nicht einfach darin, schneller zu sein, sondern strategische Absichten zu bewahren und unnötige Informationslecks zu reduzieren.
Natürlich übersetzt sich ein überzeugendes Produkt nicht automatisch in ein nachhaltiges Netzwerk. Die Qualität der Adoption, die Benutzerbindung, die Dynamik der Token-Freigabe und die echte Nachfrage werden letztendlich bestimmen, ob das Modell über die anfängliche Erzählung hinaus Bestand haben kann.
Märkte werden kurzfristig von Geschichten angetrieben, aber langfristiger Wert wird durch konsistentes Nutzerverhalten geschaffen. Aufmerksamkeit kann Momentum erzeugen, aber wiederkehrende Nutzung ist es, was Infrastruktur in ein dauerhaftes Asset verwandelt.
$GENIUS #GeniusTerminal #DeFi
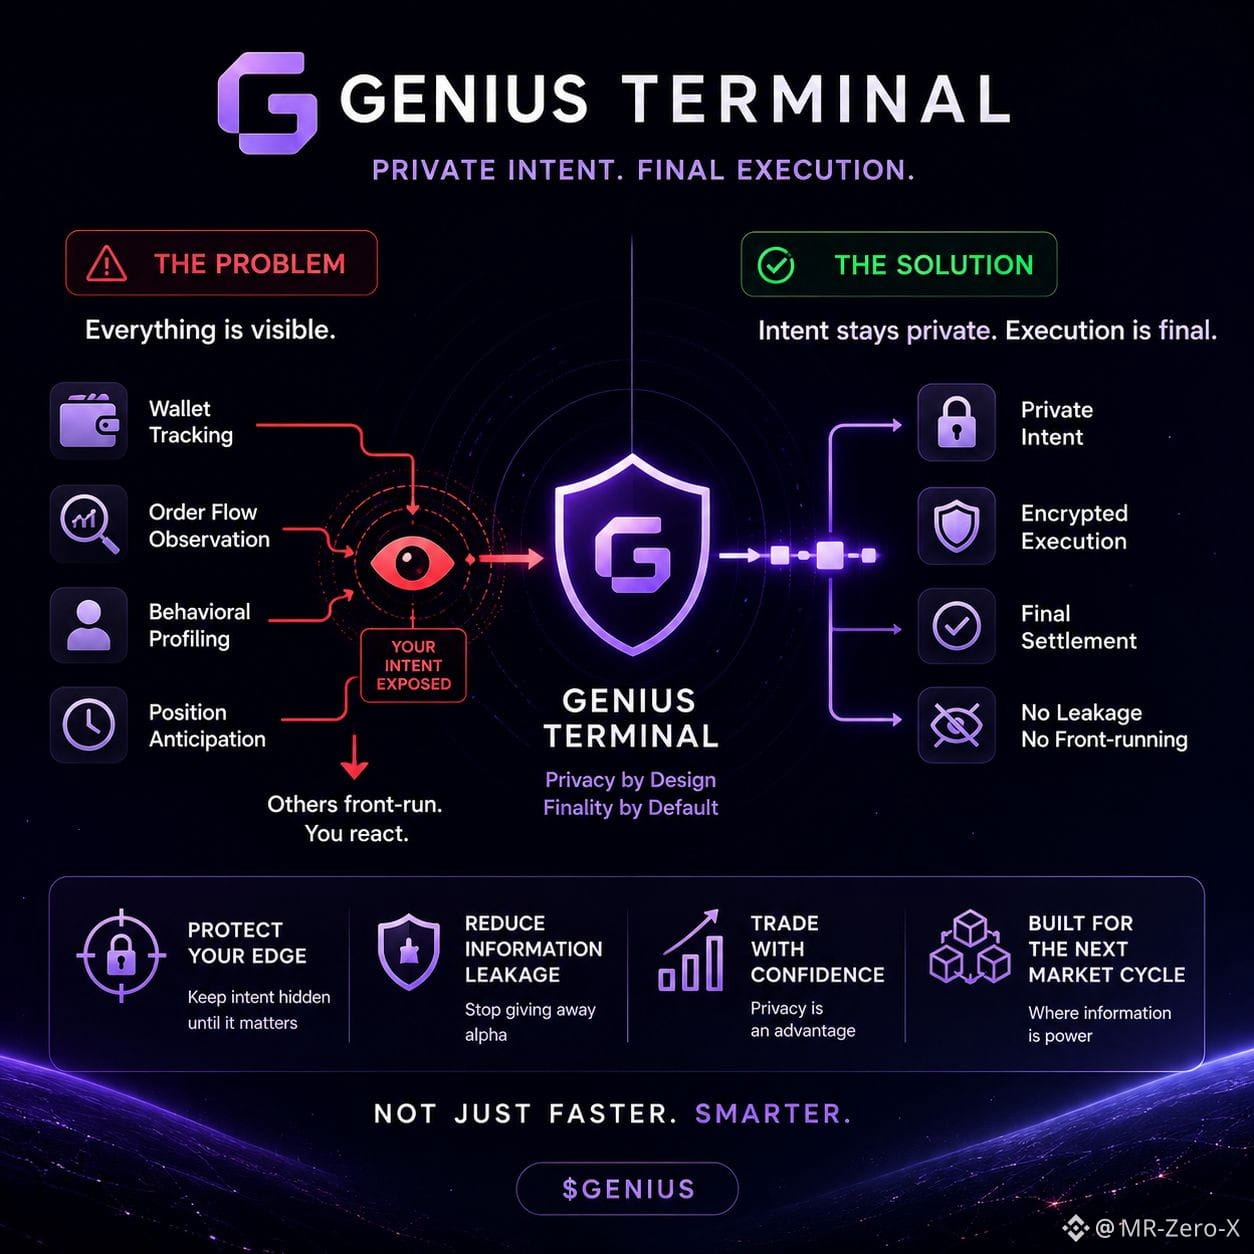
599
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer