#opg $OPG Ich habe gesehen, wie der „DeAI“-Sektor in eine teure Marketing-Aktion abrutscht. Teams versprechen dezentrale Inferenz, leiten aber einfach Anfragen an Web2-APIs weiter, während sie hastig einen ERC-20-Token draufpacken, um Hype zu erzeugen. Das ist eine leere Schleife.
@OpenGradient fühlt sich anders an, weil sie das Rechen-Engpass-Problem angehen. Herkömmliche Ketten zwingen jeden Knoten, Transaktionen erneut auszuführen – probiere das mal mit einem LLM mit 70B Parametern aus, dann stirbt das Netzwerk.
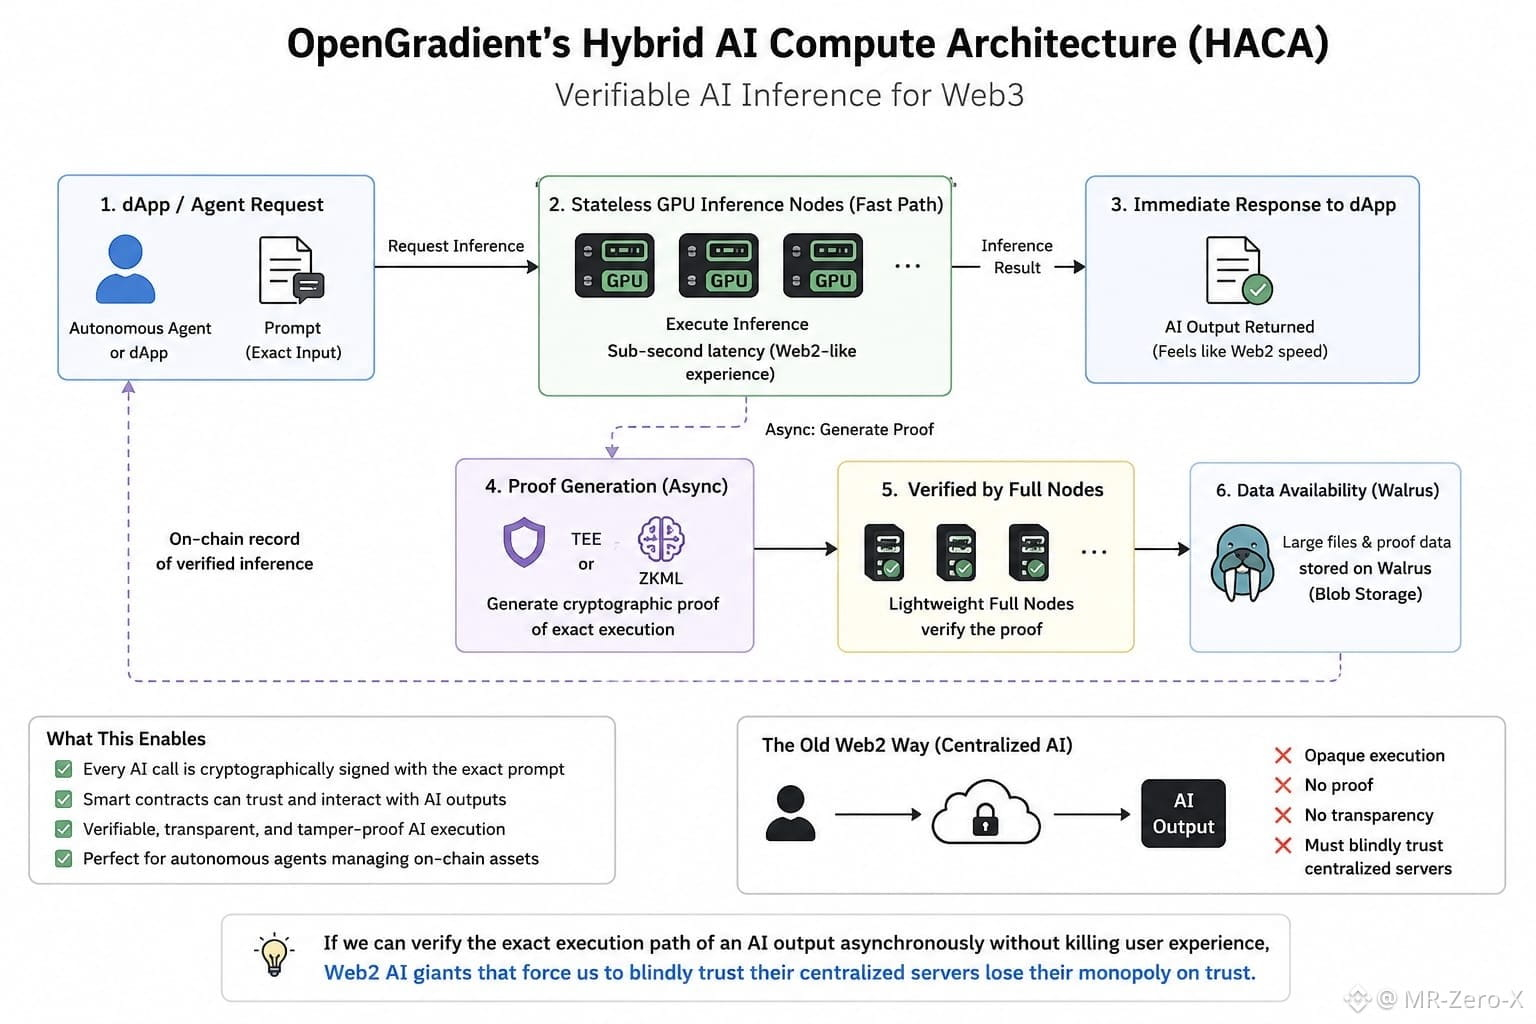
Ihre Hybrid- KI-Compute-Architektur (HACA) verteilt die Last. Wenn eine dApp eine Inferenz anfordert, geht sie direkt an zustandslose GPU-Inferenzknoten für Inferenzzeiten im Bereich von Sub-Sekunden und Web2-ähnlicher Latenz. Asynchron erzeugt der Knoten einen kryptografischen Beweis (TEE oder ZKML), der von leichten Full Nodes verifiziert wird; schwere Dateien werden auf Walrus-Blob-Speicher ausgelagert.
Das verändert alles für autonome Agenten. Statt blind einem undurchsichtigen Orakel zu vertrauen, um Treasury-Gelder zu bewegen, wird jeder Model-Aufruf kryptografisch signiert – mit genau dem Prompt, der verwendet wurde. So wird maschinelles Lernen zu einer verifizierbaren Grundlage, mit der Smart Contracts nativ interagieren können.
Ich beobachte, wie es mit Spitzenverkehr unter starker gleichzeitiger Auslastung umgeht, aber die strukturelle Basis ist tatsächlich für Nutzen statt für Rauschen gebaut.
Wenn wir den exakten Ausführungspfad eines KI-Ausgabeprodukts asynchron verifizieren können, ohne die Nutzererfahrung zu ruinieren – was passiert dann mit den Web2-KI-Riesen, die uns zwingen, ihren zentralisierten Servern blind zu vertrauen?
@OpenGradient #opg
@OpenGradient fühlt sich anders an, weil sie das Rechen-Engpass-Problem angehen. Herkömmliche Ketten zwingen jeden Knoten, Transaktionen erneut auszuführen – probiere das mal mit einem LLM mit 70B Parametern aus, dann stirbt das Netzwerk.
Ihre Hybrid- KI-Compute-Architektur (HACA) verteilt die Last. Wenn eine dApp eine Inferenz anfordert, geht sie direkt an zustandslose GPU-Inferenzknoten für Inferenzzeiten im Bereich von Sub-Sekunden und Web2-ähnlicher Latenz. Asynchron erzeugt der Knoten einen kryptografischen Beweis (TEE oder ZKML), der von leichten Full Nodes verifiziert wird; schwere Dateien werden auf Walrus-Blob-Speicher ausgelagert.
Das verändert alles für autonome Agenten. Statt blind einem undurchsichtigen Orakel zu vertrauen, um Treasury-Gelder zu bewegen, wird jeder Model-Aufruf kryptografisch signiert – mit genau dem Prompt, der verwendet wurde. So wird maschinelles Lernen zu einer verifizierbaren Grundlage, mit der Smart Contracts nativ interagieren können.
Ich beobachte, wie es mit Spitzenverkehr unter starker gleichzeitiger Auslastung umgeht, aber die strukturelle Basis ist tatsächlich für Nutzen statt für Rauschen gebaut.
Wenn wir den exakten Ausführungspfad eines KI-Ausgabeprodukts asynchron verifizieren können, ohne die Nutzererfahrung zu ruinieren – was passiert dann mit den Web2-KI-Riesen, die uns zwingen, ihren zentralisierten Servern blind zu vertrauen?
@OpenGradient #opg