

#kgen
kgen
閲覧回数 1.3M
3,409人が討論中
注目
最新
·
--
弱気相場
#KGEN | 短いセットアップ$KGEN
{future}(KGENUSDT)
💰 エントリー: $0.1597
🎯 目標1: $0.15858
🎯 目標2: $0.15730
🎯 目標3: $0.15571
🎯 目標4: $0.15363
🎯 目標5: $0.15140
🛡 ストップ: $0.16769
#KGEN | 短いセットアップ$KGEN
💰 エントリー: $0.1597
🎯 目標1: $0.15858
🎯 目標2: $0.15730
🎯 目標3: $0.15571
🎯 目標4: $0.15363
🎯 目標5: $0.15140
🛡 ストップ: $0.16769
💰 エントリー: $0.1597
🎯 目標1: $0.15858
🎯 目標2: $0.15730
🎯 目標3: $0.15571
🎯 目標4: $0.15363
🎯 目標5: $0.15140
🛡 ストップ: $0.16769
1
47
·
--
ブリッシュ
206 Atlas:
A 10% stop on a long-term hold is too tight and will likely get you shaken out by normal volatility.
1
2
743

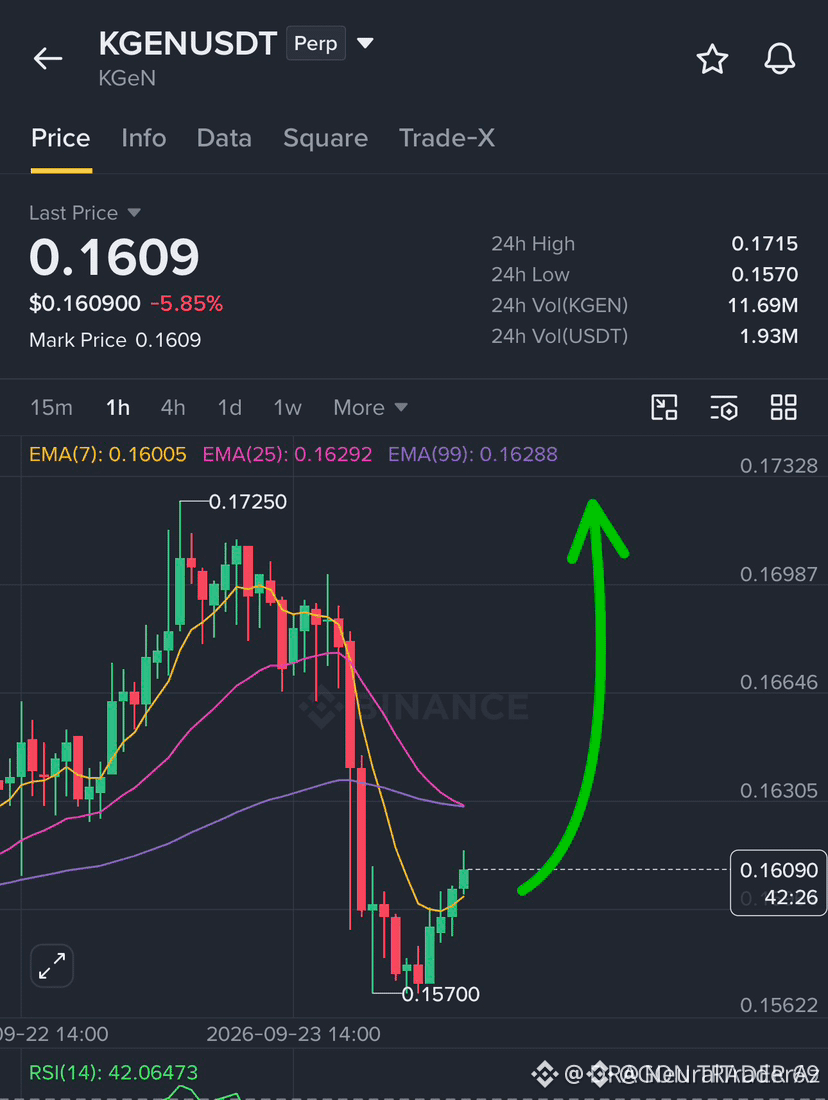
🚨 $KGEN SWEEPS LIQUIDITY INTO DEMAND ORDER BLOCK FOR HIGH-PROBABILITY RECLAIM! ⚡
エントリー: 0.158 - 0.161 ⚡
ターゲット: 0.164, 0.168, 0.172 🚀
ストップロス: 0.156 ⚠️
スマートマネーは首尾よく、0.158の需要ゾーンへ流動性をスイープし、リテールのストップ注文を吸収したうえで、構造的な拡大を再開しました。📊 現在はディスカウントの配列内で価格が安定化しており、機関投資家の指値が積み上がる中で、最適なリスク定義の再エントリー機会が提供されています。
売り側の流動性が取り除かれたことで、目先の最短ルートは、0.164から始まる上方のフェアバリュー・ギャップのクラスターへ向けて上昇に傾きます。💡 0.156を上回る構造の整合性を維持することで、この強気のオーダーフローが保たれ、クリーンなマルチターゲット拡大が可能になります。💬 あなたはこの需要リテストを先回りしますか?それとも高ボリュームの確定足を待ちますか?👇
⚠️ 金融アドバイスではありません。必ずリスク管理をしてください。🛡️
🏷️ #KGEN #Crypto #TradeSetup #SmartMoney #Breakout
🎯 🦈
6

🚨 $KGEN RECLAIMS KEY LEVEL AFTER INSTITUTIONAL LIQUIDITY SWEEP! 🟢
エントリー:$0.159 - $0.161 ⚡
ターゲット:$0.164 - $0.172 🚀
損切り:$0.156 ⚠️
需要が、アグレッシブな売り手側のスイープの後、$0.157–$0.158の構造的ゾーンで正確に再活性化しました。機関投資家のオーダーフローが残っていた非効率を素早く吸収し、買い手が確信を持って戻ってきたことで、$0.160を上回る鋭いリクレームが発生。 📊
📌 短期で市場構造が強気にシフトしているため、この転換点は上側の流動性ターゲットへ向かう高確率の道筋を提供します。リスクパラメータはスイング安値のすぐ下で明確に定義されており、良好な非対称性があります。 💡
💬 あなたはこの構造のリクレームにポジションを取りますか?それとも上位足の確認を待ちますか? 👇
⚠️ 金融助言ではありません。必ずリスク管理をしてください。 🛡️
🏷️ #KGEN #LongSetup #Altcoins #Trading #Crypto
🎯 🦈
119
$KGEN LONG
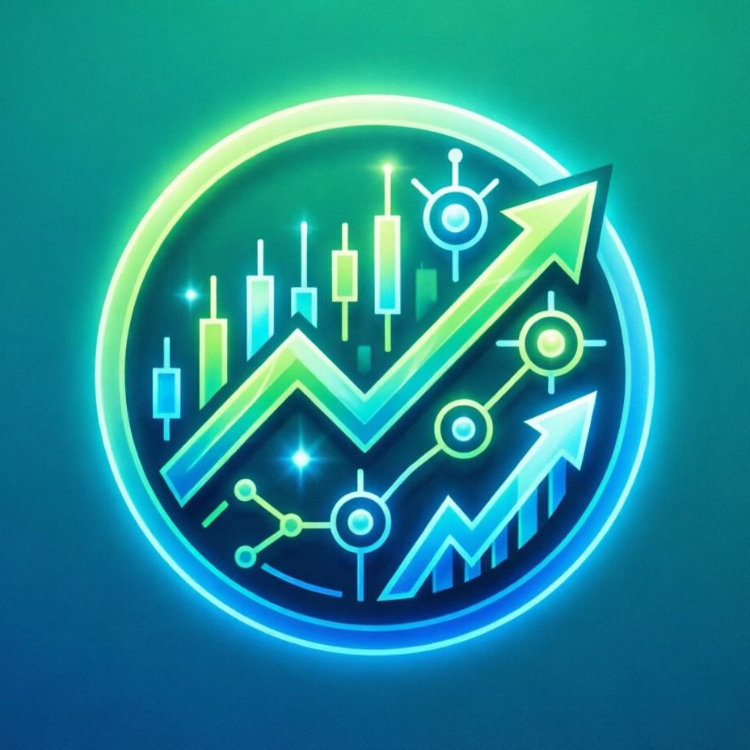
🏁エントリー: 0.1625
✅テイク1: 0.16581821 (+2.04%)
✅テイク2: 0.16923642 (+4.15%)
✅テイク3: 0.17436374 (+7.30%)
⛔️ストップ: 0.15727268 (-3.22%)
パラメータの連動は、買い手が局所的な優位を確立しようとする、現在のロングポジションを示しています。強気勢がこの勢いを維持できれば、価格変動の構造は北方向へとさらに発展し続けるでしょう。
⚠️ これは金融アドバイスではありません。自己責任で取引してください。DYOR。
#KGEN #Crypto #Криптовалюта 📈
$KGEN
🏁エントリー: 0.1625
✅テイク1: 0.16581821 (+2.04%)
✅テイク2: 0.16923642 (+4.15%)
✅テイク3: 0.17436374 (+7.30%)
⛔️ストップ: 0.15727268 (-3.22%)
パラメータの連動は、買い手が局所的な優位を確立しようとする、現在のロングポジションを示しています。強気勢がこの勢いを維持できれば、価格変動の構造は北方向へとさらに発展し続けるでしょう。
⚠️ これは金融アドバイスではありません。自己責任で取引してください。DYOR。
#KGEN #Crypto #Криптовалюта 📈
$KGEN
23

·
--
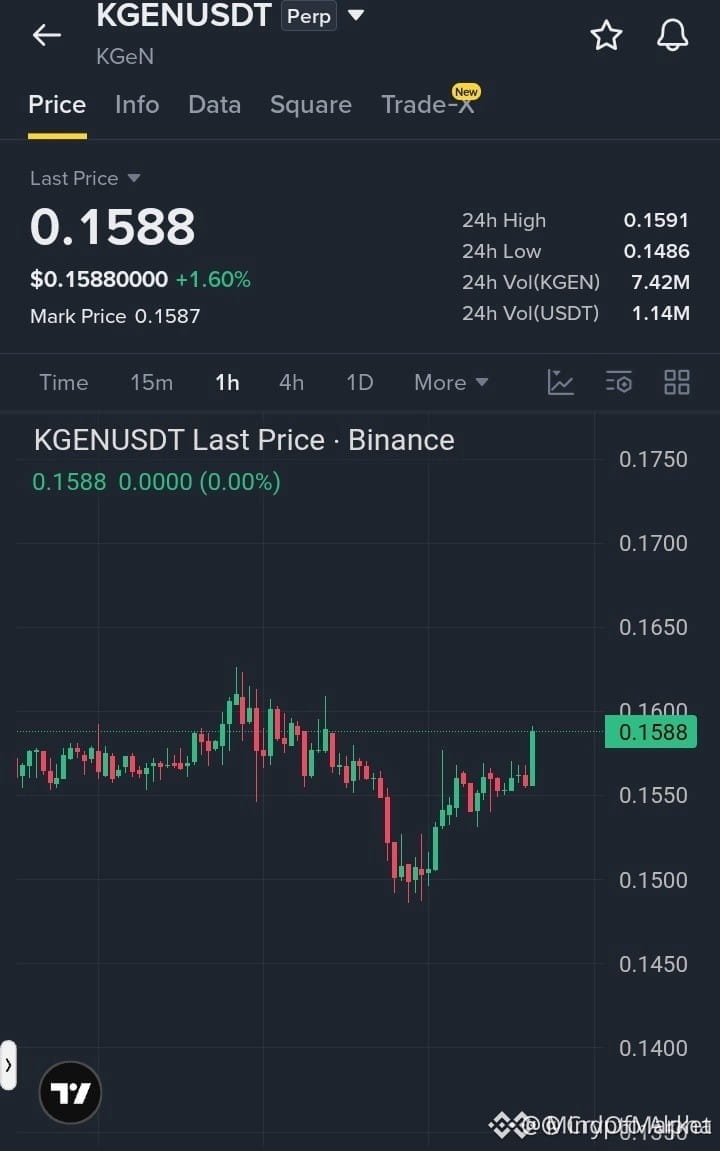
🚨 $KGEN SWEEPS ローカル流動性を事前に回収してから、機関の需要に備えろ! ⚡
エントリー:0.1580 - 0.1590 ⚡
ターゲット:0.1630 🚀
ストップロス:0.1550 ⚠️
📌 $KGEN は、クリーンな売り側の流動性ハント後、0.1580〜0.1590の主要な4Hデマンドゾーンへ直接圧縮されています。 🌊 スマートマネーはこれらの割安水準で売り圧を吸収しているようで、上方の構造的なギャップへの非対称なローテーションを仕掛けています。
💡 0.1550が明確な構造的無効化として機能するため、このセットアップは0.1630のターゲットゾーンに向けて有利なリスクプロファイルを維持しています。 📊 注文フロー指標は、個人のパニックが機関の買いで吸収されていることを示唆しています。
💬 このデマンドゾーンでポジションを取りますか、それともレジスタンス上抜けの構造的確認待ちですか?👇
⚠️ 金融アドバイスではありません。必ずリスク管理をしてください。 🛡️
🏷️ #KGEN #LongSetup #Crypto #Binance #SmartMoney
🎯 🦈
8
·
--
弱気相場
KGENは$0.1607付近でロングが清算されました。
下方向のスイープにより、この水準は値動きが荒れる可能性があります。
$KGEN
{future}(KGENUSDT)
$BR
{future}(BRUSDT)
$ONE
{future}(ONEUSDT)
🔴 流動性ゾーンに到達 🔴
ロングの清算を確認 🧨
$3.5505Kが$0.16066で清算
下方向の流動性をスイープ — 反応を見て 👀
🎯 TP目標:
TP1: 約$0.158
TP2: 約$0.155
TP3: 約$0.151
#KGeN
KGENは$0.1607付近でロングが清算されました。
下方向のスイープにより、この水準は値動きが荒れる可能性があります。
$KGEN
$BR
$ONE
🔴 流動性ゾーンに到達 🔴
ロングの清算を確認 🧨
$3.5505Kが$0.16066で清算
下方向の流動性をスイープ — 反応を見て 👀
🎯 TP目標:
TP1: 約$0.158
TP2: 約$0.155
TP3: 約$0.151
#KGeN
下方向のスイープにより、この水準は値動きが荒れる可能性があります。
$KGEN
$BR
$ONE
🔴 流動性ゾーンに到達 🔴
ロングの清算を確認 🧨
$3.5505Kが$0.16066で清算
下方向の流動性をスイープ — 反応を見て 👀
🎯 TP目標:
TP1: 約$0.158
TP2: 約$0.155
TP3: 約$0.151
#KGeN
406
·
--
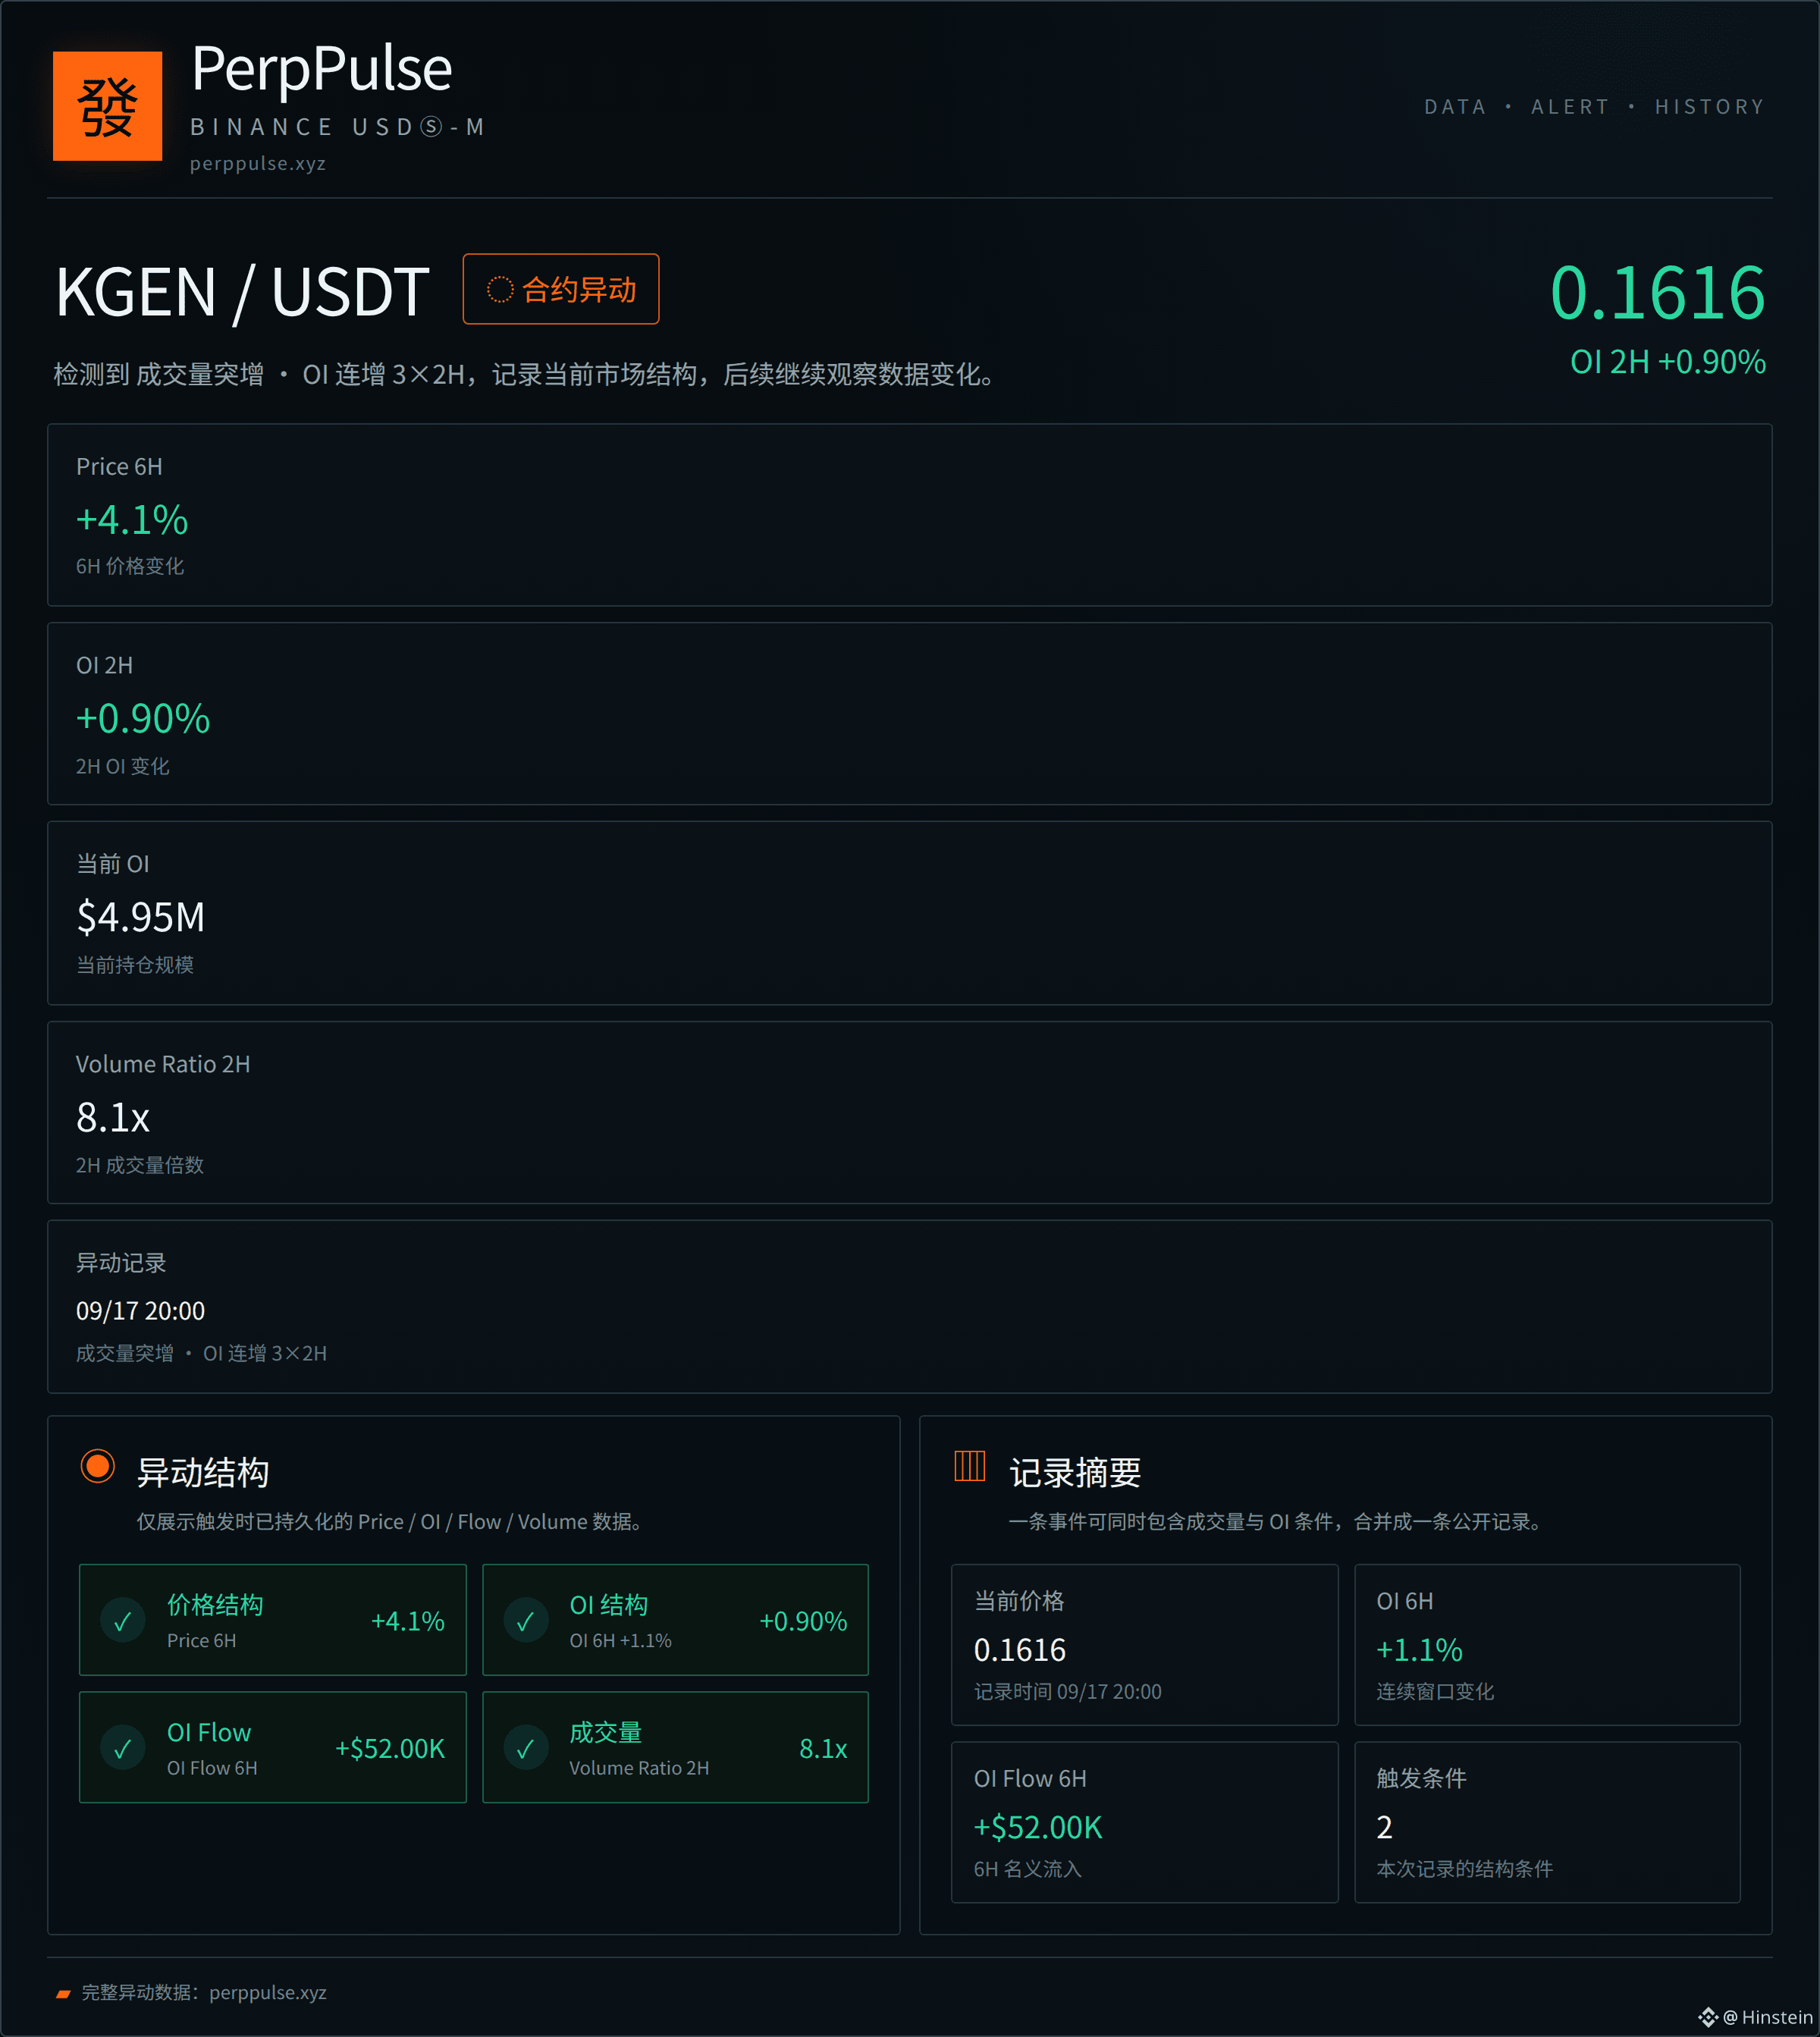
$KGEN 合意盘面には、2つの構造シグナルが同時に記録されました。
出来高が急増し、2Hの出来高比は8.1です。OIは2Hで3×連増しています。アラートの目標水準は0.1616です。
過去6Hでは、価格変化は4.1%、OI変化は1.1%、2HのOI変化は0.9%でした。6HのOI Flowは52426.54米ドルです。現在のOI規模は4948338.41米ドルです。
時間:2026-09-17 20:00 +0800。
出来高の増加と建玉(持ち高)の連続増加が同時に現れているのは、今回の記録で最も直接的な2つの条件です。データはここにあります。以降も継続するかどうかは、引き続き観察が必要です。
#KGEN #合约 #Binance
📌 検証可能な記録
タイプ:出来高急増 · OIが2Hで3×連増
記録時間:2026-09-17 20:00 +0800
記録水準:0.1616
Price 6H:+4.1%
OI 2H:+0.9%
OI 6H:+1.1%
OI Flow 6H:52426.54
Vol 2H:8.1x
完全な異動データ:perppulse.xyz
84
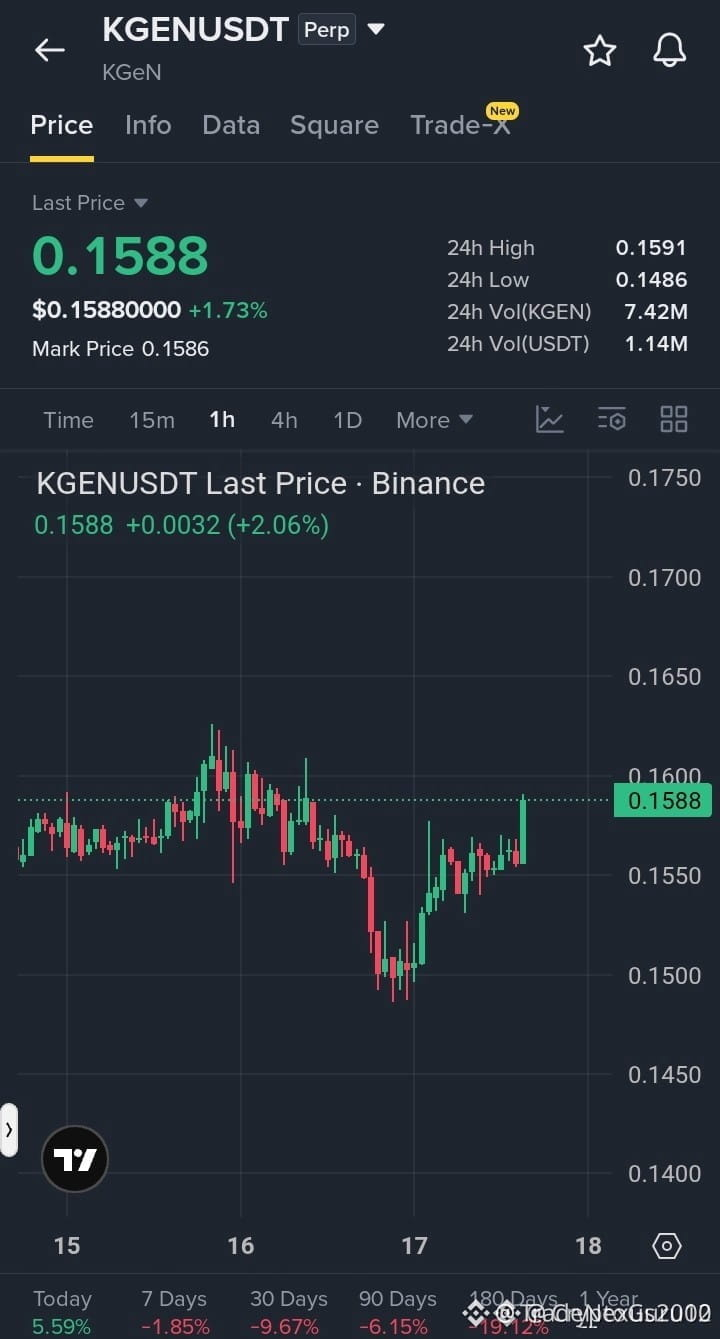
🚨 $KGEN RECLAIMS KEY DEMAND ZONE AS SMART MONEY BUILDS HIGHER LOW STRUCTURE! 🐂
エントリー: $0.1575 - $0.1590 ⚡
ターゲット: $0.1610 - $0.1660 🎯
損切り: $0.1545 ⚠️
📌 スマートマネーは $0.149 の需要ゾーンを防衛し、綺麗な 1H(1時間足)高値安値の連続(Higher Lows)を形成しました。現在、価格は $0.159 の構造上の重要な転換点に押し付けられており、上値の流動性を吸収しながら、ローカル市場の主導権を再び買い手へと移しつつあります。 📊
💡 レジスタンスを上回る時間足の終値が継続すれば、市場構造の転換が有効となり、上方向のより高いターゲットに向けた非効率(非合理)を解消します。 🌊 リスクは直近の構造上の安値のすぐ下に定義されています。 💬 ブレイクアウトを先回りしますか?それともレジスタンス上での構造的な確証を待ちますか? 👇
⚠️ 金融助言ではありません。常にリスク管理をしてください。 🛡️
🏷️ #KGEN #Crypto #TradeSetup #Breakout #MarketStructure
🎯 🦈
12

·
--
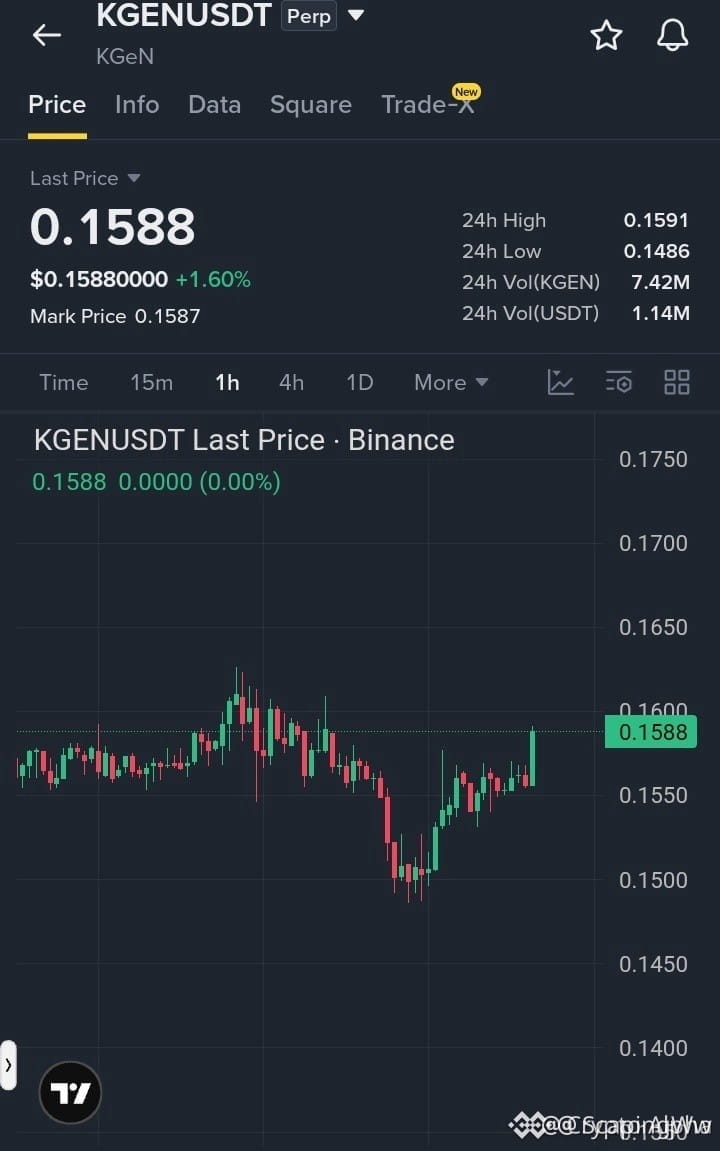
⚡ $KGEN 需要区域からの脱出が加速する!買い圧が拡大中! 💥
エントリー: 0.1580 - 0.1590 ⚡
目標: 0.1600 - 0.1630 🚀
損切り: 0.1550 ⚠️
📌 $KGEN のオーダーフローは、0.1580のサポート底で強い買いの吸収が見られ、上方の流動性に向けたクリーンな継続シナリオを構築しています。 📊 損切りライン以上で需要が維持されている限り、勢いは上側ターゲットへの明確な押し上げを後押しします。
💡 資金のローテーションが、$LSK のような一部のマーケットペアで、出来高が増え始めるにつれて強いモメンタム・セットアップへスムーズに移行しています。 💬 あなたは0.1630へのこの動きを先回りしますか?それとも二段目の押しを待ちますか? 👇
⚠️ 投資助言ではありません。必ずリスク管理を行ってください。 🛡️
🏷️ #KGEN #LSK #LongSetup #Crypto #Altcoins
🔥 💎
210
·
--
翻訳参照
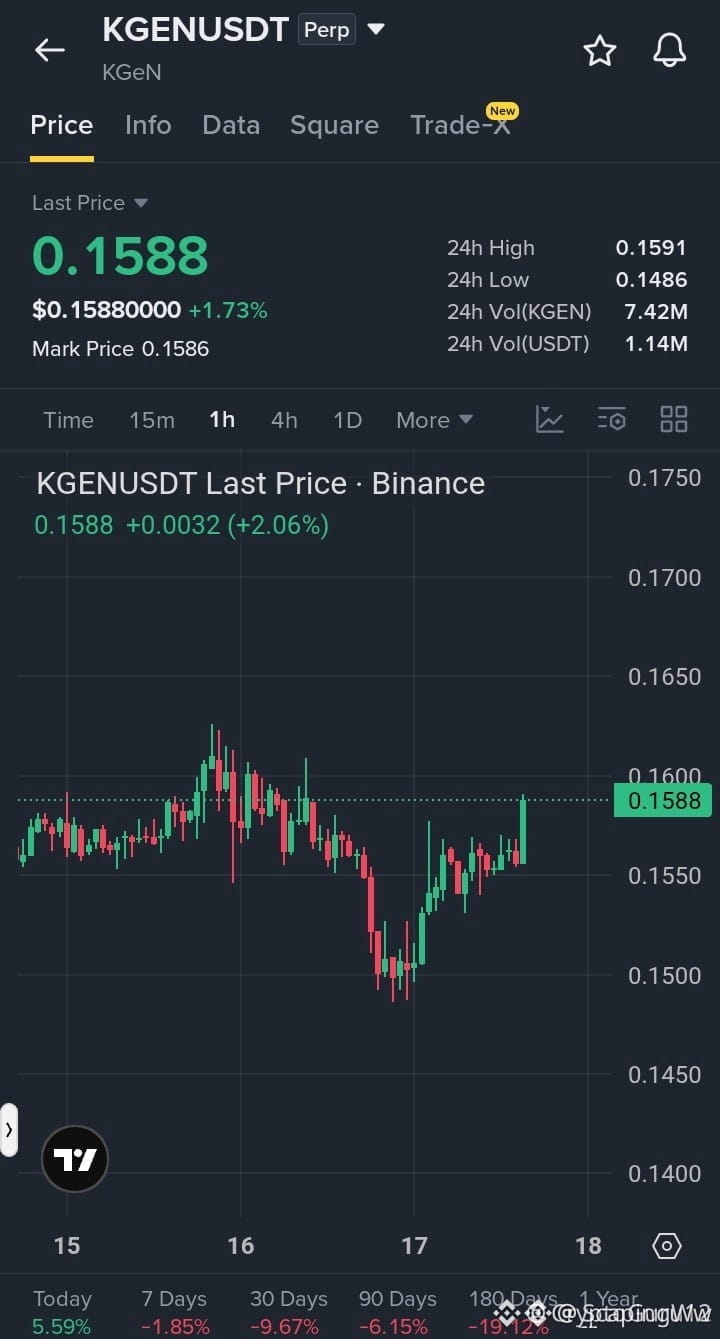
🚨 $KGEN FLIPS THE 1H STRUCTURE WITH HIGHER LOWS TESTING KEY RESISTANCE BREAKOUT! 📈
Entry: 0.1575 - 0.1590 ⚡
Target: 0.1610 - 0.1660 🚀
Stop Loss: 0.1545 ⚠️
Bidders stepped up heavily around the 0.149 demand floor, carving out a clean sequence of higher lows on the hourly chart. 📊 Price is now knocking directly on the 0.159 resistance door, showing clear signs of order flow absorption as sellers lose their grip. 💡
A sustained hourly push above this breakout pivot opens a clear runway toward higher liquidity pools. 📌 Downside risk remains tightly defined below the recent structure shift, creating a sharp risk-to-reward ratio. 💬 Are you front-running this momentum breakout or waiting for the retest? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #KGEN #LongSetup #Breakout #Crypto
⚡ 🎯
46

·
--
ブリッシュ
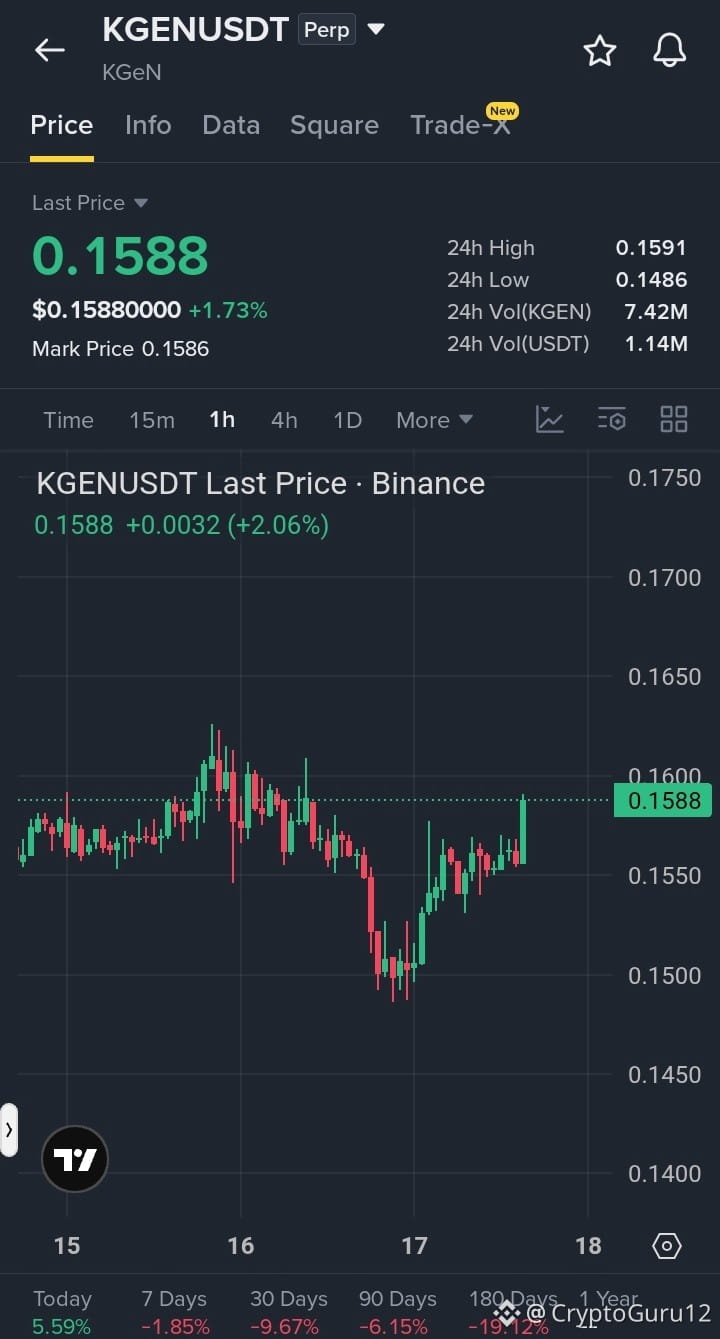
$KGEN ... 買い手が勢いを取り戻す
#KGEN は1Hチャートで一連の高値切り上げにより、$0.149〜$0.150のサポートゾーンから回復しつつあります。現在は$0.159のレジスタンスをテストしており、持続的なブレイクアウトが次の上方向の水準に向けた余地を開く可能性があります。
ロング取引のセットアップ
エントリー: $0.1575 – $0.1590
TP1: $0.1610
TP2: $0.1635
TP3: $0.1660
SL: $0.1545
買いで取引
{future}(KGENUSDT)
$LSK
{future}(LSKUSDT)
$BR
{future}(BRUSDT)
$KGEN ... 買い手が勢いを取り戻す
#KGEN は1Hチャートで一連の高値切り上げにより、$0.149〜$0.150のサポートゾーンから回復しつつあります。現在は$0.159のレジスタンスをテストしており、持続的なブレイクアウトが次の上方向の水準に向けた余地を開く可能性があります。
ロング取引のセットアップ
エントリー: $0.1575 – $0.1590
TP1: $0.1610
TP2: $0.1635
TP3: $0.1660
SL: $0.1545
買いで取引
$LSK
$BR
#KGEN は1Hチャートで一連の高値切り上げにより、$0.149〜$0.150のサポートゾーンから回復しつつあります。現在は$0.159のレジスタンスをテストしており、持続的なブレイクアウトが次の上方向の水準に向けた余地を開く可能性があります。
ロング取引のセットアップ
エントリー: $0.1575 – $0.1590
TP1: $0.1610
TP2: $0.1635
TP3: $0.1660
SL: $0.1545
買いで取引
$LSK
$BR
3
744
·
--
最近、私は KGeN を改めて理解しました。AI に本当に足りないのは、もしかすると「もっと多くのデータ」ではないかもしれません。》
最近 KGeN の研究をしてみて、私がいちばん強く感じたのはこうです:
AI のデータが増えるほど、「データは本当に人間由来なのか」がむしろ重要になる可能性があるということです。
以前、AI プロジェクトがデータについて語っているのを見ると、私は基本的にあまり長く立ち止まりませんでした。なにしろ今では、ネット上には何でもデータがあります。
でも、問題はまさにそこにあります。
AI が生成した記事、画像、音声がますます増えていて、さらにロボットのアカウントも普及しています。これからもし AI が、大量に「すでに AI が生成した」コンテンツを学習するようになったら、ループが起きないでしょうか?
AI 生成 → AI 学習 → 再生成 → 再トレーニング AI。
量はどんどん増えるのに、実際の人間の経験は逆に減ってしまうかもしれません。
それが私が KGeN を真剣に見るようになった理由でもあります。
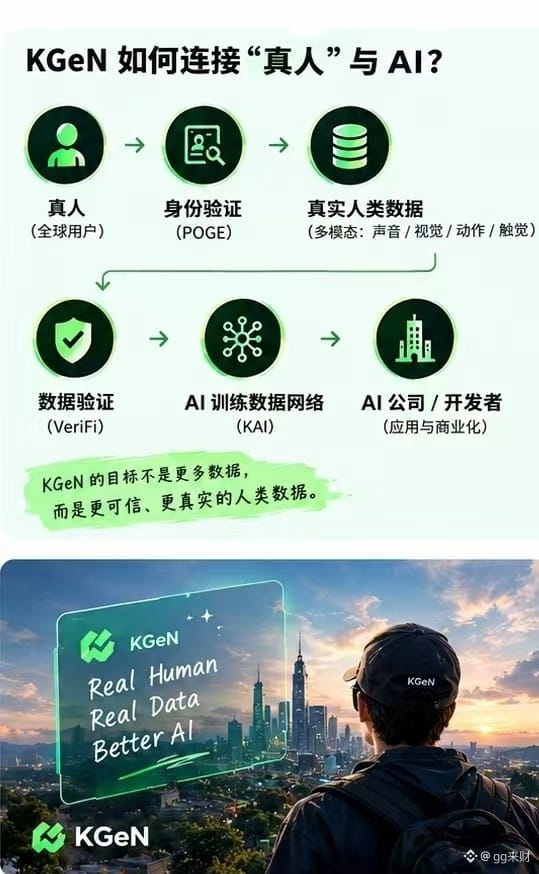
KGeN は現在、自分たちを Verified Human Network(検証済みの人間ネットワーク)と位置付けており、コアとなる方向性は、検証された本物の人間とマルチモーダルデータを獲得し、Physical AI と LLM に活用することです。公式が挙げているデータの種類には、音声、視覚、動作、触覚が含まれており、60+ の国々をカバーしています。
ここで最も考えるべき価値があるのは、「AI」というホットな概念そのものではなく、むしろ次の問いだと思います:
将来 AI が現実世界を本当に理解するなら、まず本物の人間を理解する必要があるのではないでしょうか?
たとえばロボットが実際の環境で暮らせるようになるには、単にインターネット上の画像を見るだけでは到底足りないはずです。
人がどう話し、どう行動し、環境をどう観察するか、さらには人がさまざまな場面でどんな反応をするのかを知る必要があります。
このとき、本物の人間データはもはや「データ量」の問題ではなく、「データの出どころ」と「品質」の問題になります。
KGeN の今の考え方は、実在の人間、検証済みのマルチモーダルデータ、そして AI の学習ニーズをつなげることです。製品群の中には K-Quest も含まれており、検証済みの人間がタスクを完了することで、Physical AI と LLM に必要なマルチモーダルデータを収集します。
もちろん、私は今すぐ「KGeN が必ず成功する」とは言いません。
私にとって、これからも注目する価値があるのは次の点です:
本物のユーザーが継続的に増えていくのか?
データ需要が継続的に生まれるのか?
それらのデータは本当に AI 企業に使われるのか?
そして最終的に、長期的なビジネスのクローズドループを形成できるのか?
これらの問いは、短期的な価格だけを見るよりずっと面白いと思います。
この答えは、私はまだ引き続き観察しています。
#KGen
1
250
·
--
AIが本当にあなたが「人間」だと知らなかったら、AIは「人間」をどう理解するのだろう?
この言葉は、私が最近KGeNについて考えたときに、いちばん率直に浮かんだ疑問です。
私たちは毎日、インターネットにデータを残しています。
微博を投稿する、コメントする、ゲームをする、動画を撮る、話す、歩く、買い物をする……
これらは、本質的に「人間」を記述しているのです。
しかし問題があります。
ネットは、あなたが本当に「本物」だとどうやって分かるのでしょうか?
たとえば、あなたは本物の人間かもしれない。
あるいは、ロボットかもしれない。
本物のユーザーかもしれない。
あるいは大量登録されたアカウントかもしれない。
本物の経験の一部かもしれない。
あるいはAIが自動生成したコンテンツかもしれない。
だから私は、KGeNがやっていることは、かなりシンプルなロジックで理解できると思っています。
まず本物の人間を見つける → 本物かどうかを検証する → 本物のデータを取得する → そのデータを必要とする人たちに提供する。
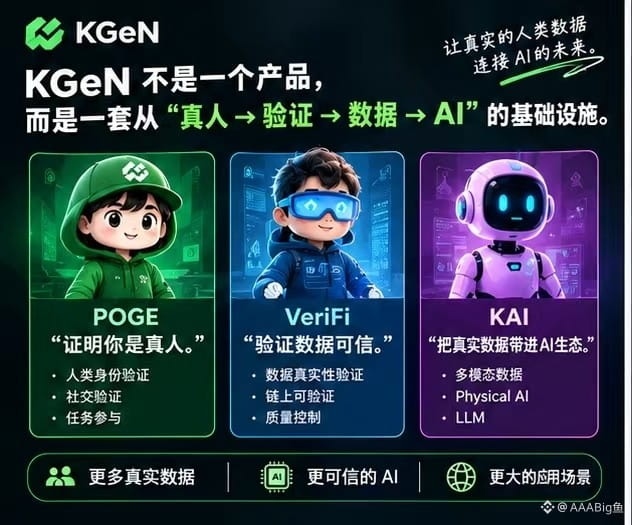
これが、私がVeriFi / POGEのような取り組みを、別立てで研究する価値があると考える理由です。
それらが本当に解決しているのは「データがあるかどうか」ではなくて、
このデータの背後に、実在する本物の人間がいるのかどうか、という点です。
KGeNの公式は現在、Verified Humanを非常に重要な位置づけとしており、オンチェーンで検証可能なソースによって、本物の人間とロボットを区別することを強調しています。
もし将来的にAIのデータ市場が、ますます現実世界のデータに依存するようになるなら、この問題はさらに重要になっていく可能性があります。
今はただのWeb3 + AIの小さな方向性に見えます。
でもAIが本当に、ロボット、自動運転、スマートデバイスといった現実世界のシーンに入ってきた後なら……
「本物のデータ」は、単なる上乗せではなく、インフラになるかもしれません。
だから私は引き続き注目していきます。
#KGEN #VeriFi #AI
184
·
--
最近研究 KGeN,有一个变化挺明显。
以前看到这种项目,我会先看:
币价。
现在会先问:
它到底在解决什么问题?
KGeN 给我的答案比较简单:
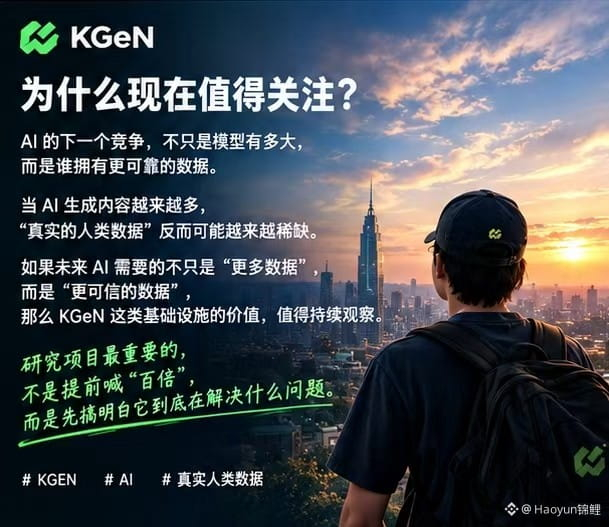
AI需要数据,但未来可能更需要「可信的人类数据」。
这个逻辑其实不难理解。
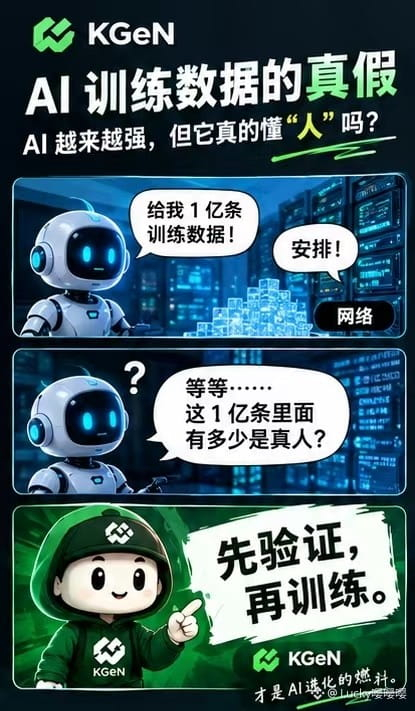
假设你让 AI 学习 1 亿条互联网内容。
听起来非常多。
但如果里面大量内容本身就是机器人生成的、AI生成的、重复的、低质量的……
数量再大也没什么意义。
反过来,如果数据来自不同国家、不同语言、不同生活环境,而且背后确实是经过验证的真人,那价值可能完全不一样。
KGeN 现在就是在往这个方向走。
官方目前把网络定位为 Verified Human Network,并进一步延伸到多模态数据、Physical AI 和 LLM。
我个人比较喜欢这种项目的一点是:
它至少不是在告诉你「AI很性感,所以我们也要AI」。
而是从一个比较具体的问题出发:
AI越来越强以后,哪里还能找到真实的人类?
这个问题有没有价值,我觉得不用急着下结论。
看看未来的数据需求、商业合作和真实使用情况,自然会给答案。
研究项目最重要的不是提前喊「百倍」,而是先搞明白它到底在解决什么问题。
这也是我最近看 KGeN 最大的感受。
#KGEN 🟩
1
216
·
--
KGeN 私がいちばん興味を持つ——
正直に言うと、Web3をやり始めて久しくなってから、新しいプロジェクトを見るたびに、最初に頭に浮かぶのはいつも:
トークンって何のため?
でも最近のKGeNは、むしろ逆の見方をしたくなりました。
まずはコインを見ないでください。
先に確認すべきは、実際に使っている人がいるかどうか!
現時点で公式が示しているのは、Verified Human Networkによって本物で多様なマルチモーダルデータを取得し、それをPhysical AIとLLMに提供するというものです。公式はさらに、データは60+の国から、そして本物の言語・本物のシーンから集められているとも強調しています。
このビジネスロジックは、ただトークンの話をするより面白いと感じます。
なぜなら、もしAIのデータネットワークに本当にユーザーがいるなら、理論上は次のような循環が生まれるはずだからです:
人がデータを提供
↓
データの真実性が検証される
↓
企業がデータを手に入れる
↓
ビジネス収益が生まれる
↓
ネットワークがさらに拡大する
これが、私の理解するKGeNです。
「トークンを出す → コミュニティが盛り上がる → みんなが価格を議論し始める」といった話ではありません。
もちろん、最終的にこの仕組みがうまく回るかどうかは、時間が証明する必要があります。
なので、私は今のところKGeNに対してかなりシンプルな態度です:
盲目的に持ち上げず、急いで否定もしない。
実際のユーザー増加、データ需要、ビジネス収益、そしてそれらの収益がこのエコシステム全体に継続的に還元されるのかを、引き続き見ていきます。
Web3プロジェクトはたくさんあります。
本当に難しいのは:
「物語」を、継続的に起こるビジネス活動へと変えること。
そして、私が次にKGeNでいちばん観察したいのはそこです。
#KGEN
1
156
·
--
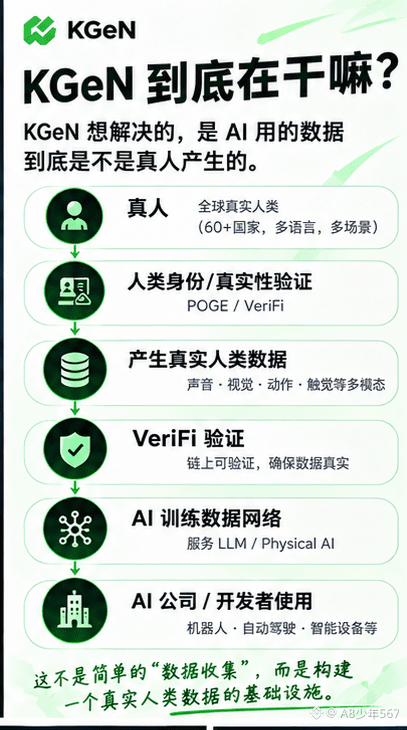
私が初めて KGeN をちゃんと見たのは、「ロボット」だからです。
以前、KGeN を見たときの第一の反応は、実はやっぱり Web3 でした。
でも最近、それが Physical AI / Robotics に重点を置き始めていて、この変化によって改めてこのプロジェクトを見直しました。
このタイミングで「実在のデータ」が、まったく別の意味を持つようになったからです。
チャットボットなら、テキストデータだけで足りるかもしれません。
でもロボットは違います。
ロボットは知る必要があります:
人はどうやって歩くのか?
手はどうやって動くのか?
物に触れたとき、どんな感触なのか?
人は環境によって何をするのか?
音、視覚、動作、さらには触覚まで、訓練データになり得ます。
KGeN が今公式に強調しているのは、Sound、Sight、Motion、Touch を含むマルチモーダルな“本物の人間データ”で、これらのデータを Physical AI と LLM に使うことです。
ここには、すごく直感的な違いがあると思います:
一般的な AI データ:
「AI に人間が何であるかを教える。」
Physical AI データ:
「AI に、人間がどう生活し、どう行動するかを本当に理解させる。」
この2つは、難易度がまったく違います。
だから今の私は、KGeN を見るときに「$KGEN の価格」だけを見ることはあまりありません。
むしろ、こう思います:
これらの実在の人間データは、本当に長期的なビジネス需要を生み出せるのか?
もし AI とロボット業界が本当にますますこうしたデータを必要としていくなら、「Verified Human」は Web3 の概念から、ゆっくりと AI インフラの一部に変わっていくかもしれません
#KGENUpdate #Aİ #KGEN
246
·
--
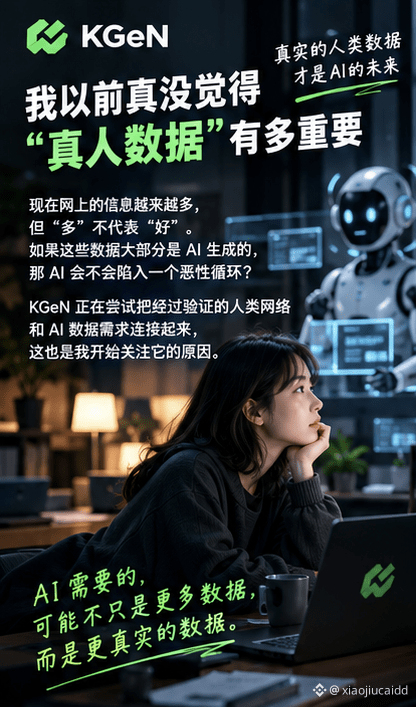
我以前真没觉得“真人数据”有多重要
以前看到 AI 项目讲数据,我基本都是扫一眼。
数据量多少、模型多大、合作了谁……看多了其实都差不多。
但最近看到 KGeN,我反而对一个很简单的问题比较感兴趣:
如果以后 AI 训练数据越来越多是 AI 生成的,那谁来证明这些数据最开始来自真人?
这其实挺有意思。
现在网上的信息越来越多,但“多”不代表“好”。
一篇文章可能是 AI 写的,一张图片可能是 AI 生成的,一段评论也可能是机器人批量产生的。
如果这些东西继续拿去训练下一代 AI,最后可能出现一个很奇怪的循环:
AI 生成数据 → AI 学习 → 再生成更多数据 → 再训练 AI。
数据越来越多,但真实的人类经验反而越来越稀缺。
这也是我最近开始关注 KGeN 的原因。
KGeN 的方向不是单纯再做一个“数据平台”,而是把经过验证的人类网络和 AI 数据需求连接起来。
官方目前强调的方向包括 Verified Human、Sound / Sight / Motion / Touch 等多模态数据,以及 Physical AI 和 LLM。
我觉得这个方向真正有意思的地方,不是“AI”两个字。
而是:
当 AI 越来越多以后,真人本身会不会反而成为一种稀缺资源?
这个问题,我觉得值得继续观察 KGeN。
#KGEN
91
·
--
翻訳参照
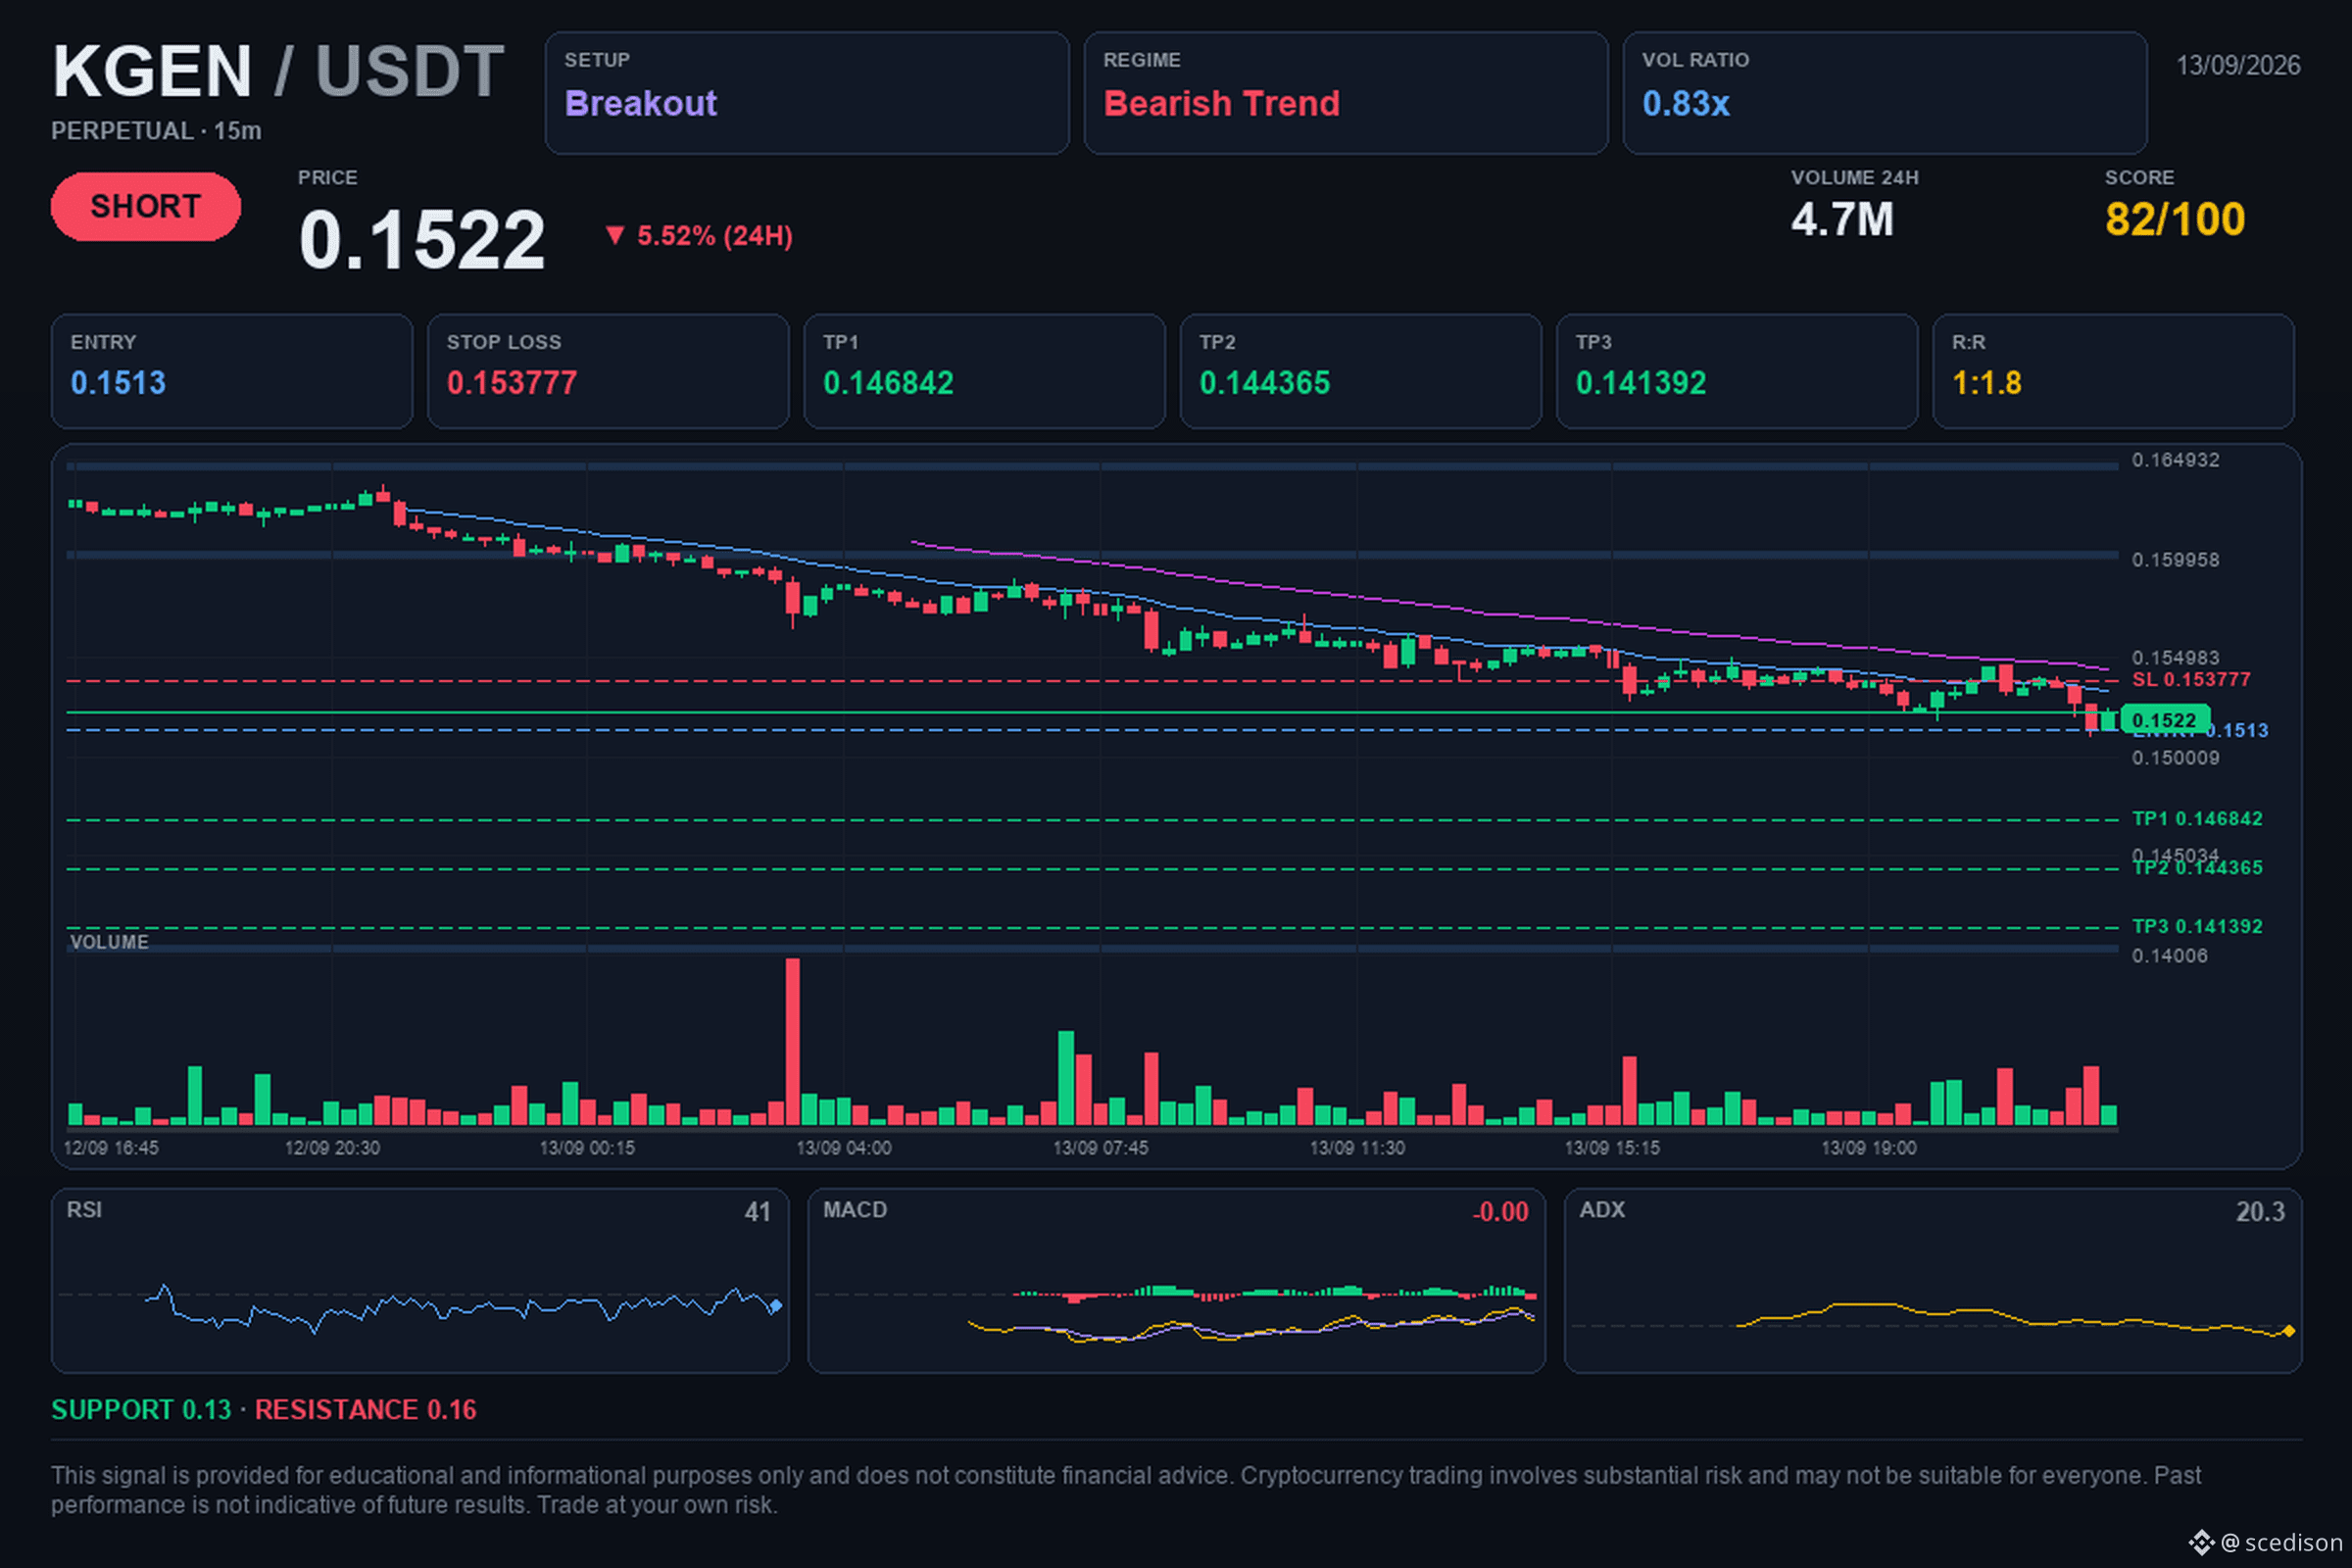
📢 $KGEN / USDT | 🔴 SHORT | ⭐ 82.5%
🎯 Objetivo: $0.14684152. ¿Lo logra?
🎯 Niveles de operación:
🔴 Entrada: $0.1513
🛑 Stop Loss: $0.153777
🏁 TP1: $0.146842
🏁 TP2: $0.144365
🏁 TP3: $0.141392
📈 Análisis:
El activo muestra una estructura bajista consolidada en múltiples temporalidades, confirmada por un patrón de máximos decrecientes. La presión vendedora se ve respaldada por un aumento en el volumen de negociación, que supera el promedio, mientras el precio rompe niveles de soporte clave. Con un RSI en zona neutral, el mercado mantiene una tendencia bajista clara sin señales de reversión inmediata.
⚖️ Riesgo/Beneficio: 1:1.8
⏱️ Timeframe: 15M
💭 Un patrón de máximos decrecientes (LH) indica que cada intento de subida es más débil que el anterior, lo cual suele ser una señal de debilidad en la estructura de precios.
#crypto #KGEN #trading #Futures #Bearish
💡 Este análisis es educativo y no constituye asesoramiento financiero. Investiga por su cuenta y decide con calma.
41
ログインして、さらにコンテンツを読む
厳選トピックで世界の暗号資産トレーダーの仲間入り
⚡️ 暗号資産に関する最新かつ有益な情報が見つかります。
💬 世界最大の暗号資産取引所から信頼されています。
👍 認証を受けたクリエイターから、有益なインサイトを得られます。
メール / 電話番号
トレンドトピック
1
#BitcoinClears$85200
閲覧回数 16,734
239人が討論中
2
#AltcoinSeasonIndexHoldsAbove60For5Days
閲覧回数 82,192
1,320人が討論中
3
#USADPAdds90000JobsInSeptember
閲覧回数 36,764
726人が討論中
4
#USCorePCEEasesTo3%InAugust
閲覧回数 26,557
543人が討論中
5
#KospiPostsWorstQuarterSince2020
閲覧回数 17,500
509人が討論中
6
#SECToClarifyOnChainFundraisingRules
閲覧回数 44,440
690人が討論中
7
#UKFCAOpensCryptoFirmAuthorization
閲覧回数 42,856
582人が討論中
8
#JapanMOFStudyGroupOnTokenizedGovtBonds
閲覧回数 23,593
435人が討論中
9
#QNTRises287%
閲覧回数 114,315
943人が討論中
10
#TrumpRejectsAIRulesForVoluntaryAudits
閲覧回数 64,998
808人が討論中