私が初めて KGeN をちゃんと見たのは、「ロボット」だからです。
以前、KGeN を見たときの第一の反応は、実はやっぱり Web3 でした。
でも最近、それが Physical AI / Robotics に重点を置き始めていて、この変化によって改めてこのプロジェクトを見直しました。
このタイミングで「実在のデータ」が、まったく別の意味を持つようになったからです。
チャットボットなら、テキストデータだけで足りるかもしれません。
でもロボットは違います。
ロボットは知る必要があります:
人はどうやって歩くのか?
手はどうやって動くのか?
物に触れたとき、どんな感触なのか?
人は環境によって何をするのか?
音、視覚、動作、さらには触覚まで、訓練データになり得ます。
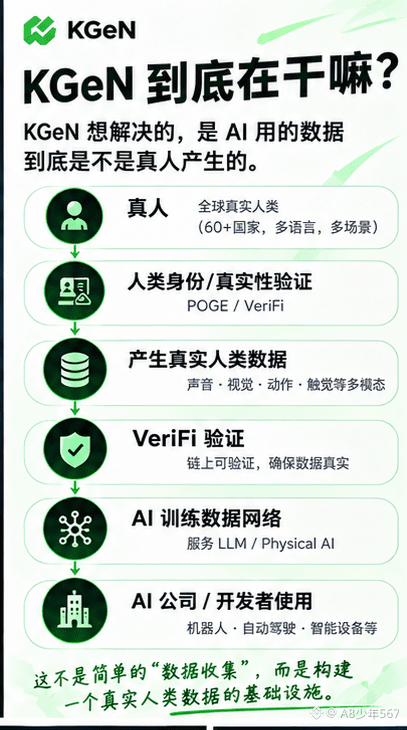
KGeN が今公式に強調しているのは、Sound、Sight、Motion、Touch を含むマルチモーダルな“本物の人間データ”で、これらのデータを Physical AI と LLM に使うことです。
ここには、すごく直感的な違いがあると思います:
一般的な AI データ:
「AI に人間が何であるかを教える。」
Physical AI データ:
「AI に、人間がどう生活し、どう行動するかを本当に理解させる。」
この2つは、難易度がまったく違います。
だから今の私は、KGeN を見るときに「$KGEN の価格」だけを見ることはあまりありません。
むしろ、こう思います:
これらの実在の人間データは、本当に長期的なビジネス需要を生み出せるのか?
もし AI とロボット業界が本当にますますこうしたデータを必要としていくなら、「Verified Human」は Web3 の概念から、ゆっくりと AI インフラの一部に変わっていくかもしれません
#KGENUpdate #Aİ #KGEN
以前、KGeN を見たときの第一の反応は、実はやっぱり Web3 でした。
でも最近、それが Physical AI / Robotics に重点を置き始めていて、この変化によって改めてこのプロジェクトを見直しました。
このタイミングで「実在のデータ」が、まったく別の意味を持つようになったからです。
チャットボットなら、テキストデータだけで足りるかもしれません。
でもロボットは違います。
ロボットは知る必要があります:
人はどうやって歩くのか?
手はどうやって動くのか?
物に触れたとき、どんな感触なのか?
人は環境によって何をするのか?
音、視覚、動作、さらには触覚まで、訓練データになり得ます。
KGeN が今公式に強調しているのは、Sound、Sight、Motion、Touch を含むマルチモーダルな“本物の人間データ”で、これらのデータを Physical AI と LLM に使うことです。
ここには、すごく直感的な違いがあると思います:
一般的な AI データ:
「AI に人間が何であるかを教える。」
Physical AI データ:
「AI に、人間がどう生活し、どう行動するかを本当に理解させる。」
この2つは、難易度がまったく違います。
だから今の私は、KGeN を見るときに「$KGEN の価格」だけを見ることはあまりありません。
むしろ、こう思います:
これらの実在の人間データは、本当に長期的なビジネス需要を生み出せるのか?
もし AI とロボット業界が本当にますますこうしたデータを必要としていくなら、「Verified Human」は Web3 の概念から、ゆっくりと AI インフラの一部に変わっていくかもしれません
#KGENUpdate #Aİ #KGEN