

宝玉(Parody)
38 Publications
宝玉(Parody)
Signaler
Bloquer l’utilisateur
0 Suivis
2 Abonnés
1 J’aime
Publications
Tous
Vidéos
·
--
Voir la traduction
据说是 Gemini 4 Argon 做的视频,我觉得还不如 GPT-6 Astra 做的,更比不上 Opus 5.5
据说是 Gemini 4 Argon 做的视频,我觉得还不如 GPT-6 Astra 做的,更比不上 Opus 5.5
63
·
--
Aujourd’hui, en testant Manus, j’ai appris un petit truc : quand on fait un dessin, il n’est pas nécessaire de contrôler le style avec un prompt. Il suffit de fournir une image de référence, et cette image inclut déjà des éléments comme les couleurs, des exemples de polices, la texture du papier de riz, les contours des traces d’encre, les traces d’eau, les montagnes au loin, les sceaux, ainsi que des règles de composition et d’espace négatif.
Ainsi, la stabilité des rendus est plus élevée, et le prompt de contenu peut être beaucoup plus simple.
Figure 1 : image de référence
Figure 2 content_prompt :
> Titre « Thé et vie lente », sous-titre « Prends un peu de temps, pour une tasse de thé ». Le design doit suivre le style de l’image de référence : calme, retenu, wabi-sabi, style minimaliste à l’encre et composition avec beaucoup d’espace négatif, fond avec une texture de papier de riz. Le texte doit être centré et bien lisible.
Figure 3 content_prompt :
> Titre « Laisse le quotidien ralentir ». Contenu : « Réchauffer la tasse : d’abord ressentir la chaleur des objets »、« Sentir le parfum : prêter attention aux senteurs du thé et de l’eau »、« Déguster : boire une petite gorgée et faire une courte pause ». Le design doit suivre le style de la première page et de l’image de référence : calme, retenu, style minimaliste à l’encre, en utilisant quelques éléments d’encre (par exemple montagnes au loin, traces d’eau des ustensiles à thé, etc.) comme touches dans les zones d’espace négatif, avec un fond en texture de papier de riz. La mise en page du texte doit montrer une hiérarchie et tirer parti de l’espace négatif.
--- Prompt complet de la figure 2 ---
Créer une diapositive de présentation professionnelle avec le contenu suivant :
Titre « Thé et vie lente », sous-titre « Prends un peu de temps, pour une tasse de thé ». Le design doit suivre le style de l’image de référence : calme, retenu, wabi-sabi, style minimaliste à l’encre et composition avec beaucoup d’espace négatif, fond avec une texture de papier de riz. Le texte doit être centré et bien lisible.
Guidance Hiérarchie & Mise en page :
- Commencer par l’élément narratif le plus important (titre / métrique), puis compléter avec des textes de soutien en sections claires
- Tout graphique doit refléter les données réelles fournies dans le prompt de contenu et rester fidèle aux sources décrites
- Disposer les visuels et le texte pour permettre une lecture de gauche à droite ou de haut en bas ; éviter l’empilement vertical des graphiques/images
Direction visuelle :
- Professionnel et épuré
- Respecter le style de l’image de la diapositive précédente (si fournie) pour assurer la continuité visuelle
Exigences :
- Mise en page de présentation professionnelle avec une hiérarchie visuelle claire
- Le texte doit être clairement lisible avec un contraste approprié sur le fond
- Inclure une zone de titre et une zone de contenu selon le besoin
- Maintenir un style cohérent adapté à une présentation professionnelle
- Design visuel de haute qualité, prêt pour publication
- Tous les textes doivent être nets et lisibles
- Garder tout le texte essentiel confortablement à l’intérieur du cadre ; éviter de placer du texte tout près des bords
- Équilibrer les éléments visuels avec l’espace blanc afin que la diapositive paraisse propre et non encombrée
280
·
--
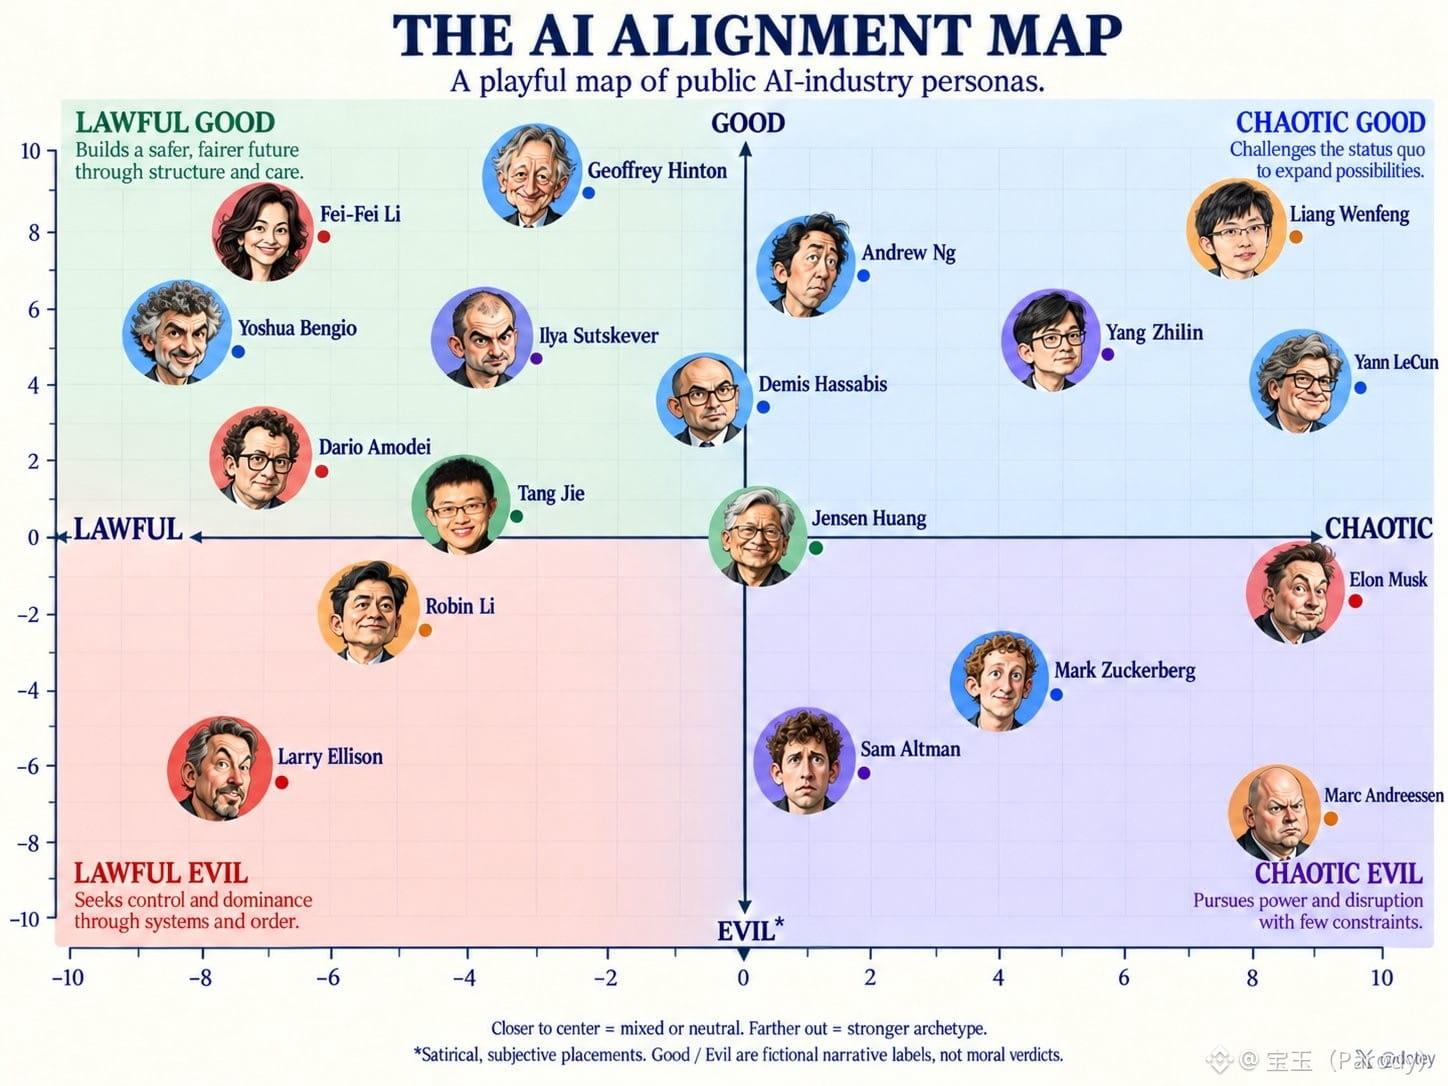
Faites en sorte que ChatGPT classe, avec une grille 9 cases de neutralité ordonnée et du chaos, les personnalités marquantes de l’IA et me dessine ça
Faites en sorte que ChatGPT classe, avec une grille 9 cases de neutralité ordonnée et du chaos, les personnalités marquantes de l’IA et me dessine ça
28
·
--
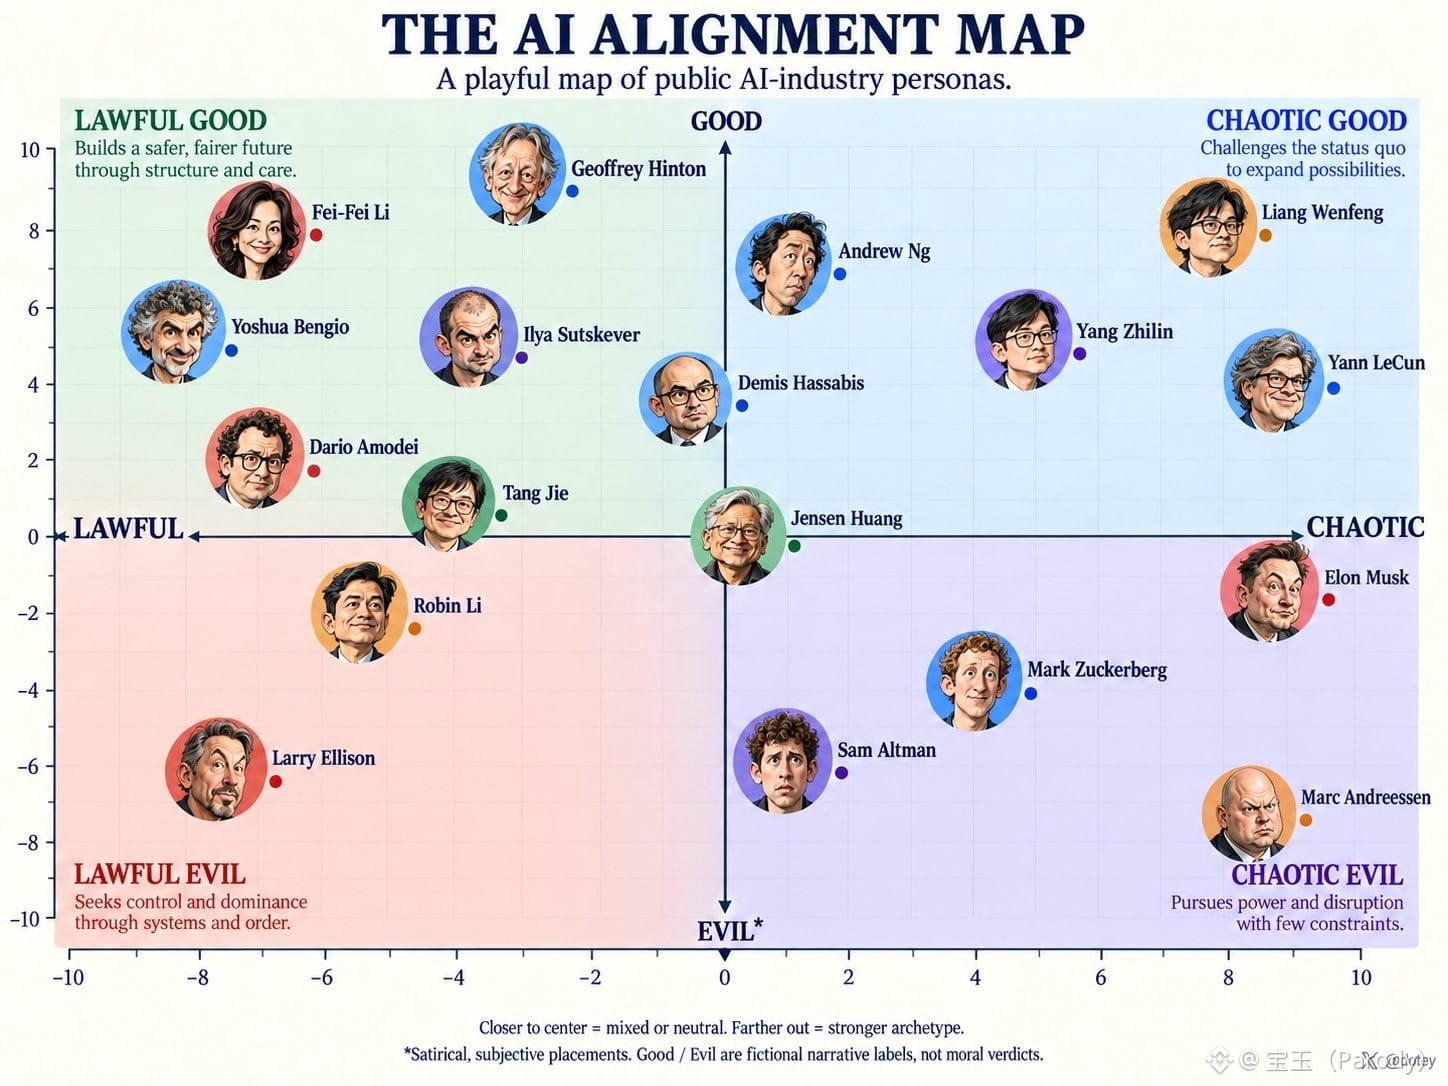
Faites en sorte que ChatGPT classe, avec une grille 9 cases de neutralité ordonnée et du chaos, les personnalités marquantes de l’IA et me dessine ça
Faites en sorte que ChatGPT classe, avec une grille 9 cases de neutralité ordonnée et du chaos, les personnalités marquantes de l’IA et me dessine ça
226
·
--
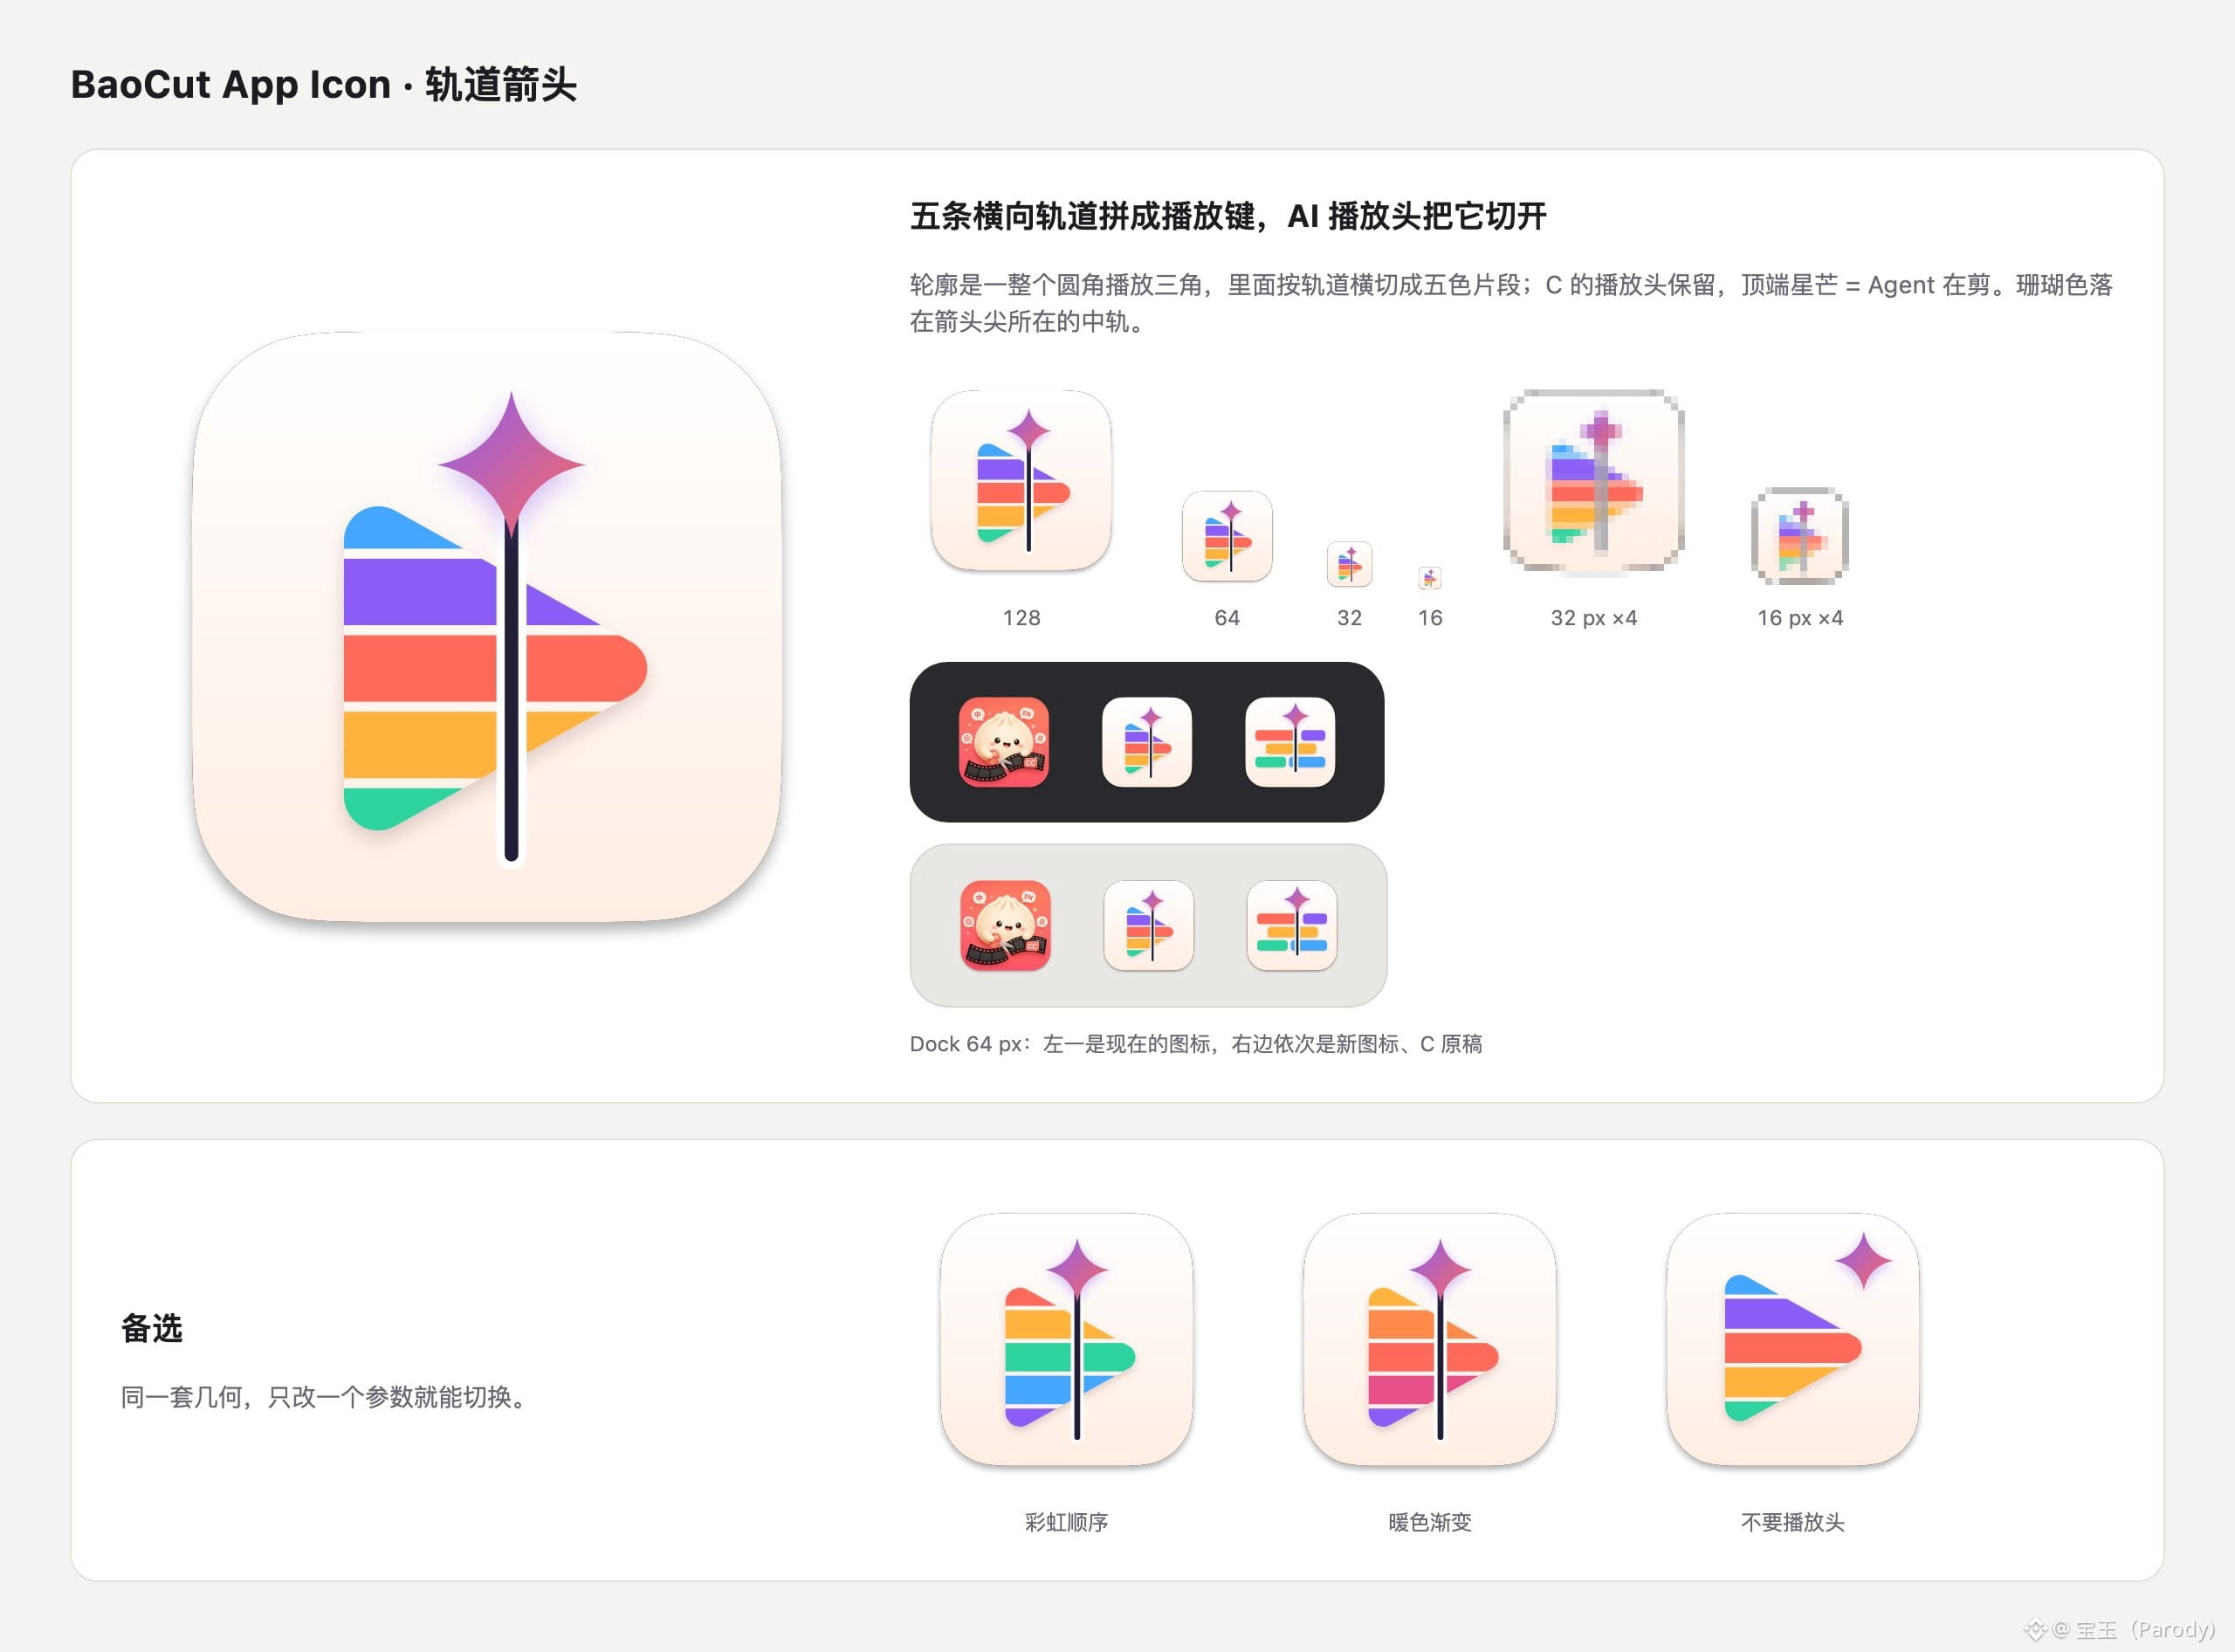
Opus 5.5, pour te donner une liberté totale dans la conception de l’icône d’application
À l’époque, avec Fable, j’avais essayé de faire en sorte que Fable m’aide à concevoir une icône d’application, mais le résultat n’était pas vraiment à la hauteur. Finalement, j’ai dû utiliser ChatGPT pour dessiner l’image, sauf que ce n’était pas du vectoriel.
Ces derniers jours, en utilisant Opus 5.5 pour réaliser des vidéos, j’ai eu une idée. Puisque Opus 5.5 peut utiliser JavaScript + Canvas pour peindre une vidéo image par image, alors le faire pour dessiner une icône avec JS + Canvas ne devrait pas poser de problème.
Je l’ai donc testé : la première version a dépassé mes attentes. C’était simple, joli, et le rendu était vraiment très bon. Le prompt tenait en une seule phrase :
> Aide-moi à redessiner une icône d’application pour http://BaoCut.app, plus simple, en couleurs, qui reflète l’édition vidéo et un AI Agent
> Tu peux la dessiner directement avec du js sur canvas
À noter : l’important est de « dessiner avec JS sur canvas », pas SVG. Le SVG ne produit pas un bon rendu avec l’effet canvas dessiné en JS.
Ensuite, comme avec un client, il suffit de le faire modifier sans arrêt :
Par exemple, je trouvais que le scénario 3 était pas mal. J’ai donc demandé de s’en servir comme base pour ajuster le concept. Après quelques itérations, j’ai fini par obtenir une proposition que j’aimais beaucoup.
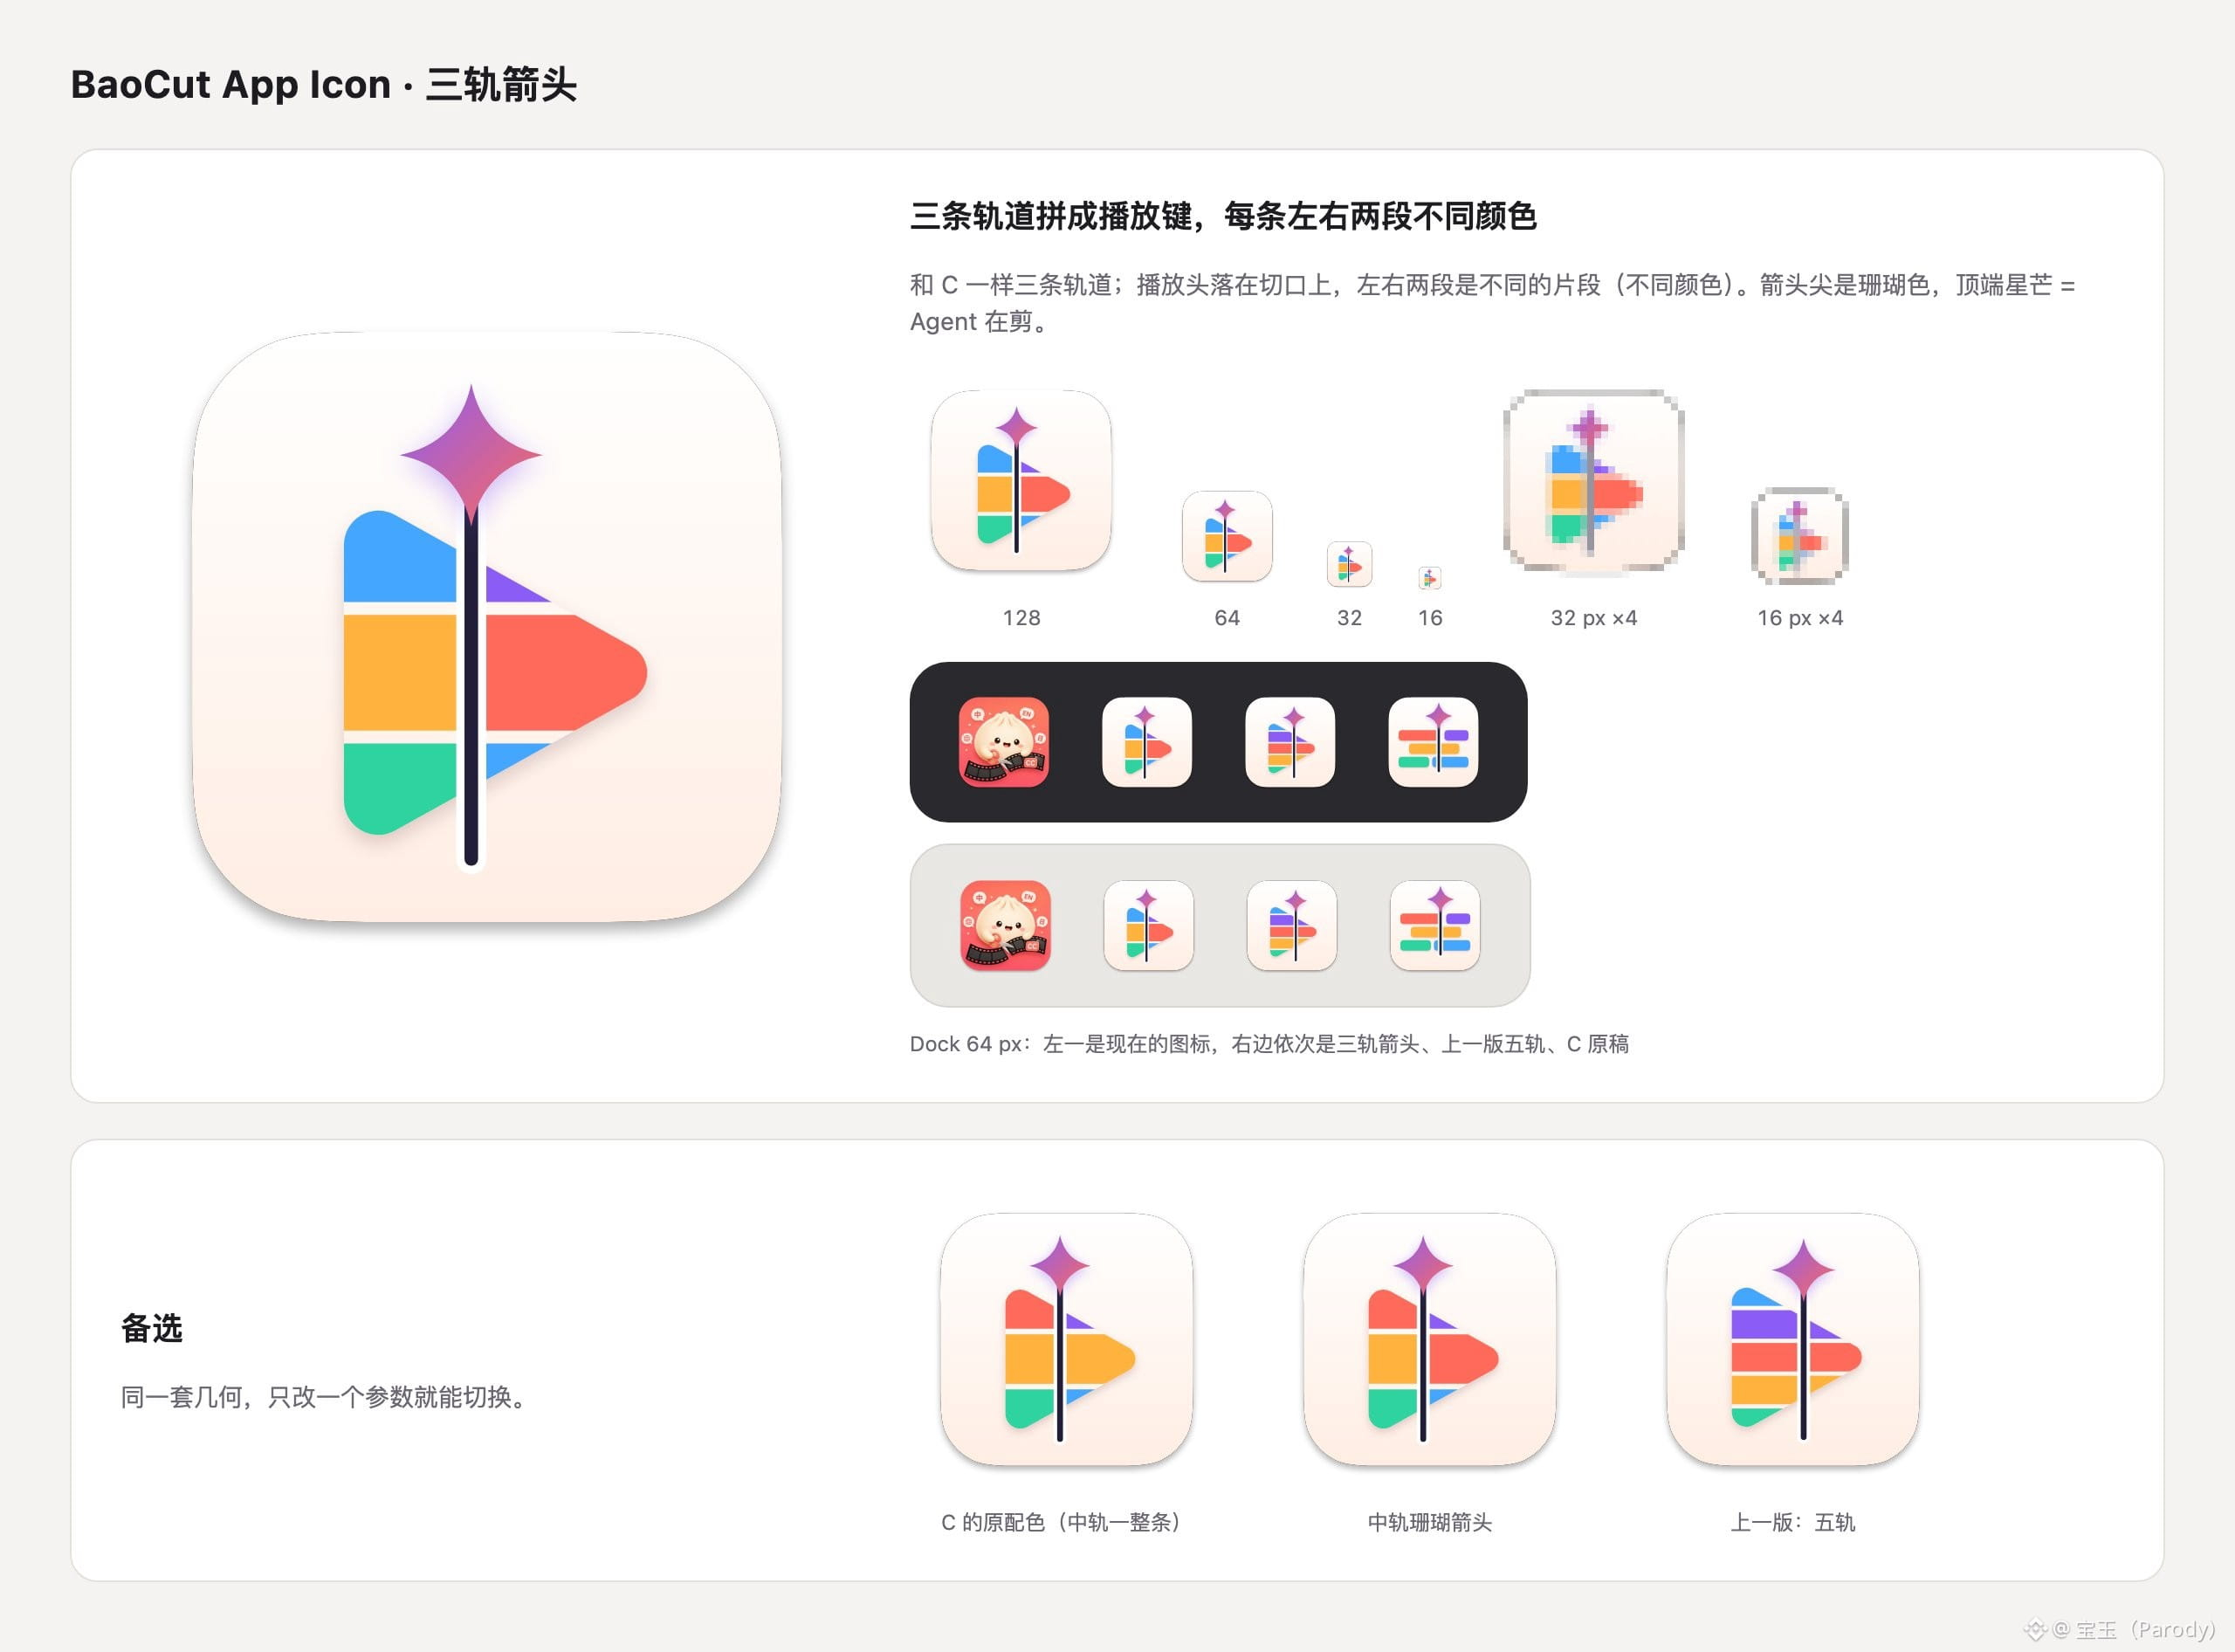
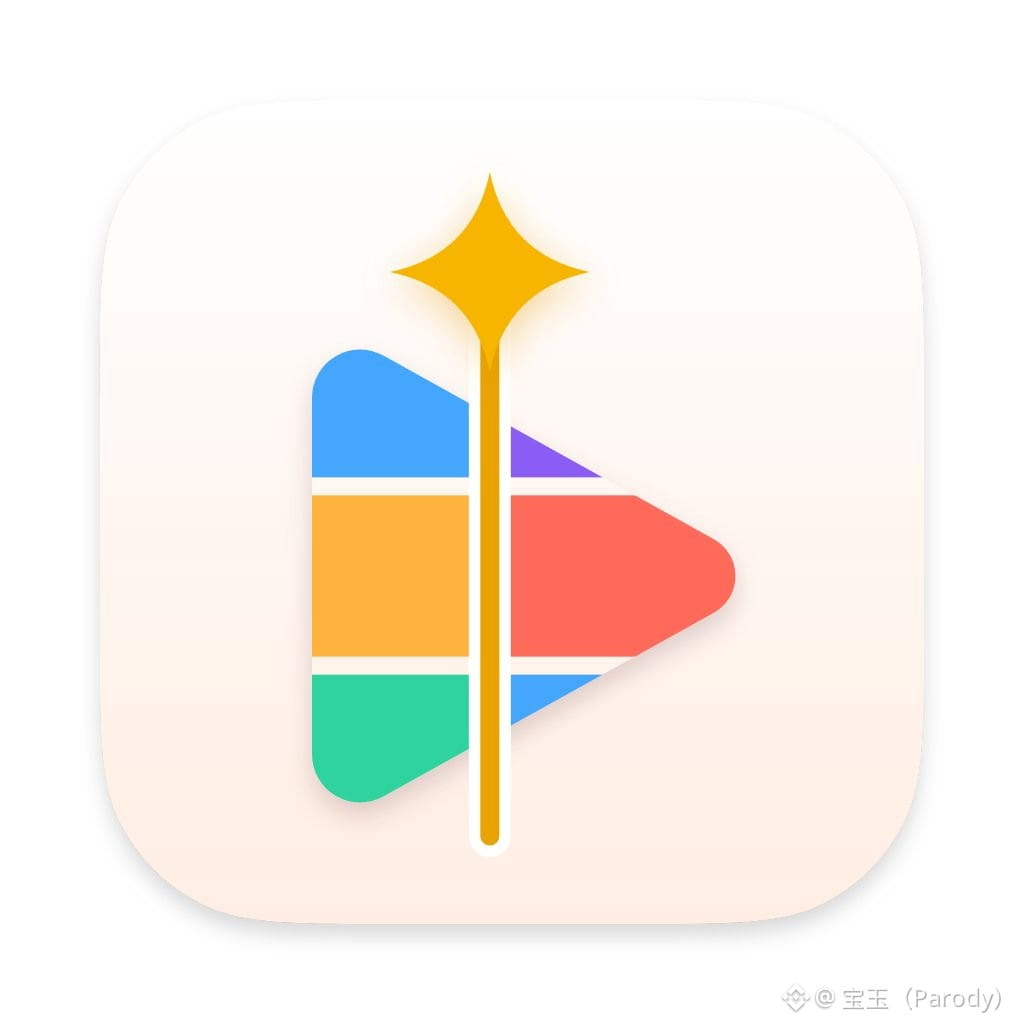
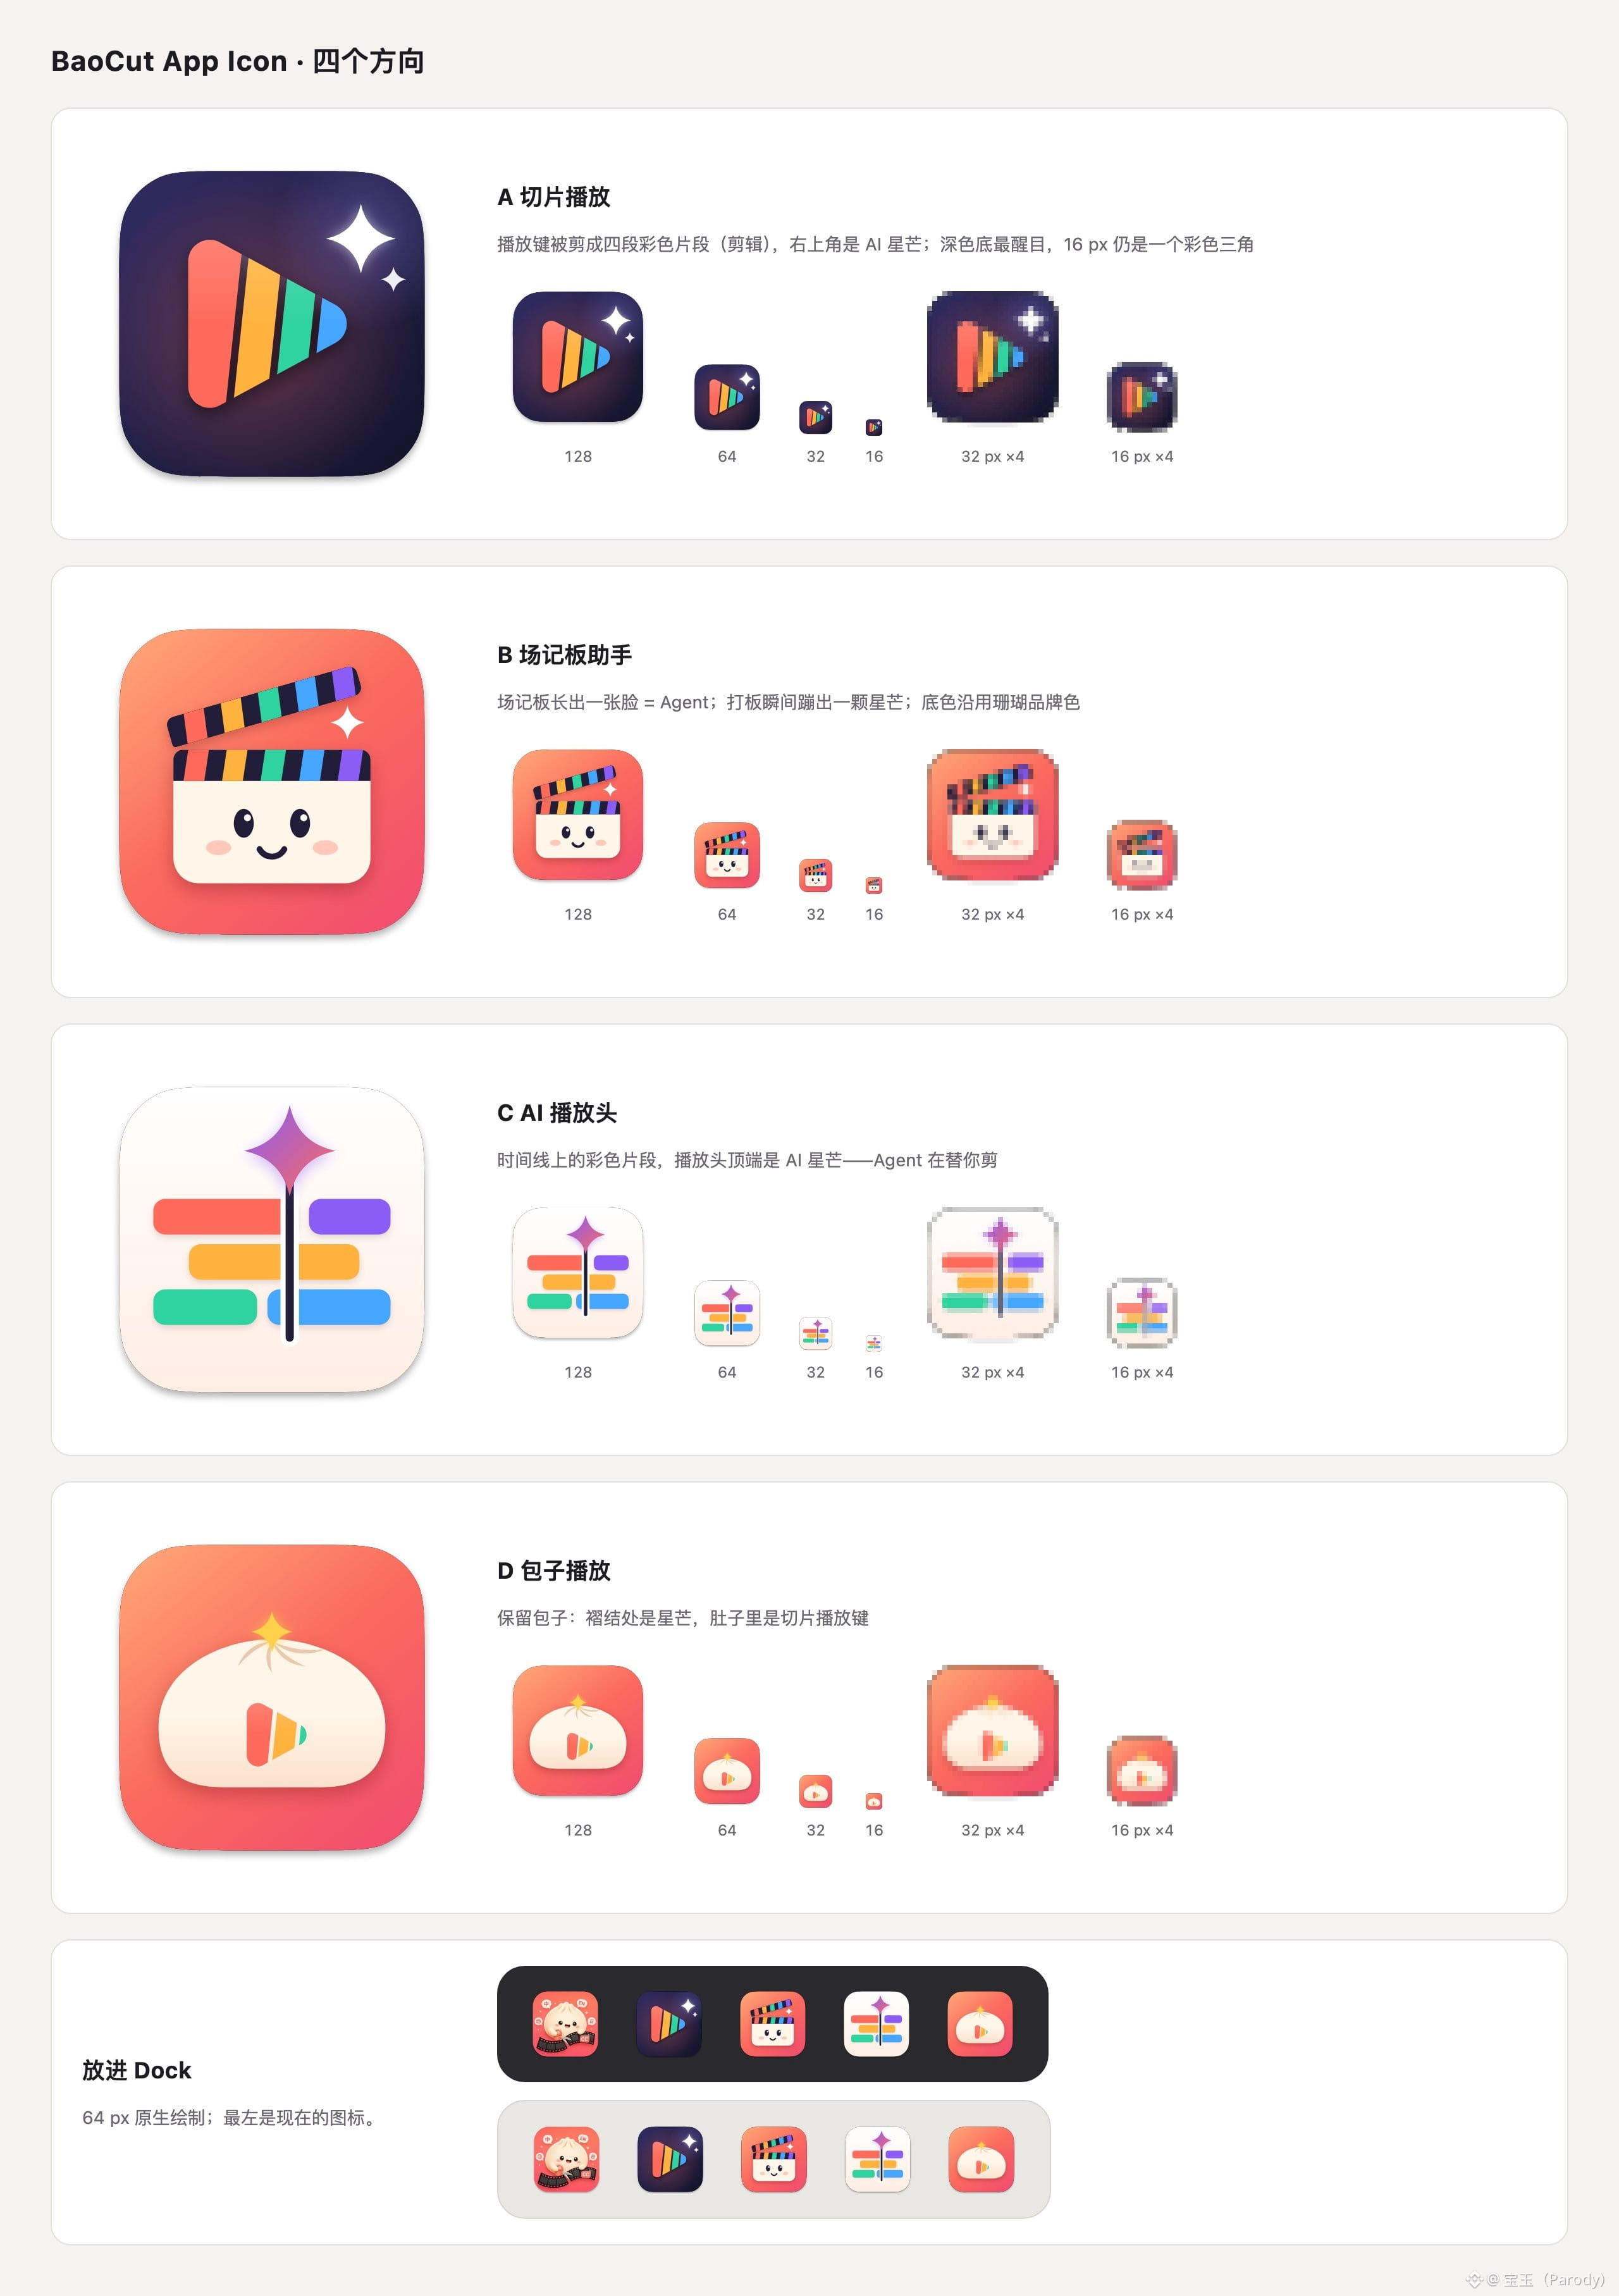
168
·
--
《Histoire de la civilisation chinoise》de Opus 5.5
--- Invite ----
Réalisez une série de chroniques épiques en photogrammes 《Histoire de la civilisation chinoise》 ; vous pouvez écrire du code pour rendre image par image, puis assembler le tout avec ffmpeg.
La musique suit le rythme d’une horloge : mode à cinq notes, évolution des instruments de la flûte d’os et des carillons de cloches jusqu’aux instruments orchestraux ; le BPM s’accélère au fil des époques, et tous les points de coupe sont calés sur la frappe.
Alternance entre deux styles : la peinture au trait sur papier de riz (bai miao) et deux variantes : l’or sur fond noir (ruì jīn) avec boue sombre ; à chaque rouleau correspond une couleur principale et un ensemble de motifs qui évoluent avec le temps (motifs de poterie peinte → motif de taotie → motif de brume nuageuse/énergie nuageuse → motif de l’enroulement de l’herbe → motif de branches entrelacées → motif de motif de retour [hui wen]).
Pour chaque plan, un grand mot-clé calligraphique en lettres d’en-tête apparaissant par groupe de mots ; accompagnez-le d’une illustration au trait.
HUD de tout le film : en haut à gauche, sceau rouge avec le numéro du rouleau ; sur le côté droit, noms des dynasties en colonne verticale ; en bas, une règle chronologique du rouleau et un compteur d’années.
Transitions entre rouleaux : un impact au sceau rouge (apposé) puis un passage coup de marteau/forte frappe des cloches à tambour.
D’abord définir la grille de points de synchronisation et le tableau des plans, puis rendre.
La carte ne doit montrer qu’un schéma : pas de personnages réels de l’époque moderne/contemporaine ; après vérification de la période, livrer.
55
·
--
Recommandez un ensemble de prompts vidéo Awesome Opus 5.5 open source sur GitHub
Recommandez un ensemble de prompts vidéo Awesome Opus 5.5 open source sur GitHub
78
·
--
À l’ère de l’IA, quelle est la compétence que les gens en poste devraient apprendre en priorité ?
Le conseil du professeur Andrew Ng est que tout le monde devrait apprendre à programmer.
De nombreux dirigeants d’entreprise disent aux gens de ne pas apprendre à programmer, au motif que l’IA va l’automatiser. Andrew Ng pense que ce raisonnement est exactement l’inverse. Justement parce que l’IA aide, écrire du code devient plus facile que jamais ; c’est donc une raison de plus pour que tout le monde l’apprenne.
Il a déjà observé, à de nombreux postes, un écart clair de productivité. Ce n’est pas seulement le cas des ingénieurs logiciels. D’un côté, il y a ceux qui savent écrire du code et créer leurs propres logiciels sur mesure ; de l’autre, ceux qui ne savent pas. L’efficacité des deux groupes s’est déjà nettement éloignée.
Apprendre à programmer ne veut pas dire taper du code à la main
Il dit que « programmer » ne consiste pas à taper ligne par ligne du code. Lui-même le fait presque jamais. Dans un avenir prévisible, l’une des compétences les plus importantes sera de savoir dire avec précision à l’ordinateur ce que vous voulez qu’il fasse, afin qu’il le réalise à votre place. Et le code est le langage de l’ordinateur. Donc, apprendre à programmer, c’est apprendre à formuler les besoins d’une manière que l’ordinateur comprend.
Dans son équipe, les meilleurs responsables marketing ont eu des idées : pas besoin d’attendre l’ingénierie pour construire un site web, ils peuvent le faire eux-mêmes. Les meilleurs recruteurs ne se fient plus à leur œil pour parcourir des CV un par un : ils écrivent du code, et le programme les aide à filtrer. À ses yeux, ceux qui savent expliquer les besoins à l’ordinateur deviendront bien plus puissants et bien plus efficaces.
63
·
--
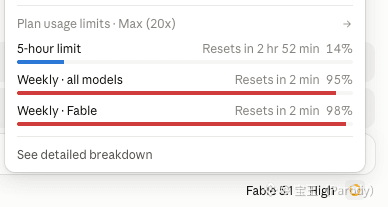
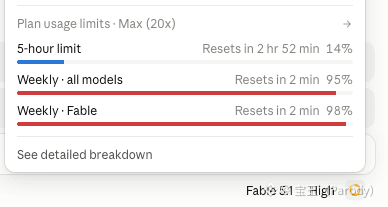
Opus 5.5 est plutôt durable, et je n’ai pas réussi à l’épuiser avant le reset
Opus 5.5 est plutôt durable, et je n’ai pas réussi à l’épuiser avant le reset
1.4k
·
--
Opus 5.5 est plutôt difficile à utiliser ; je n’ai même pas réussi à l’utiliser avant la réinitialisation.
Opus 5.5 est plutôt difficile à utiliser ; je n’ai même pas réussi à l’utiliser avant la réinitialisation.
552
·
--
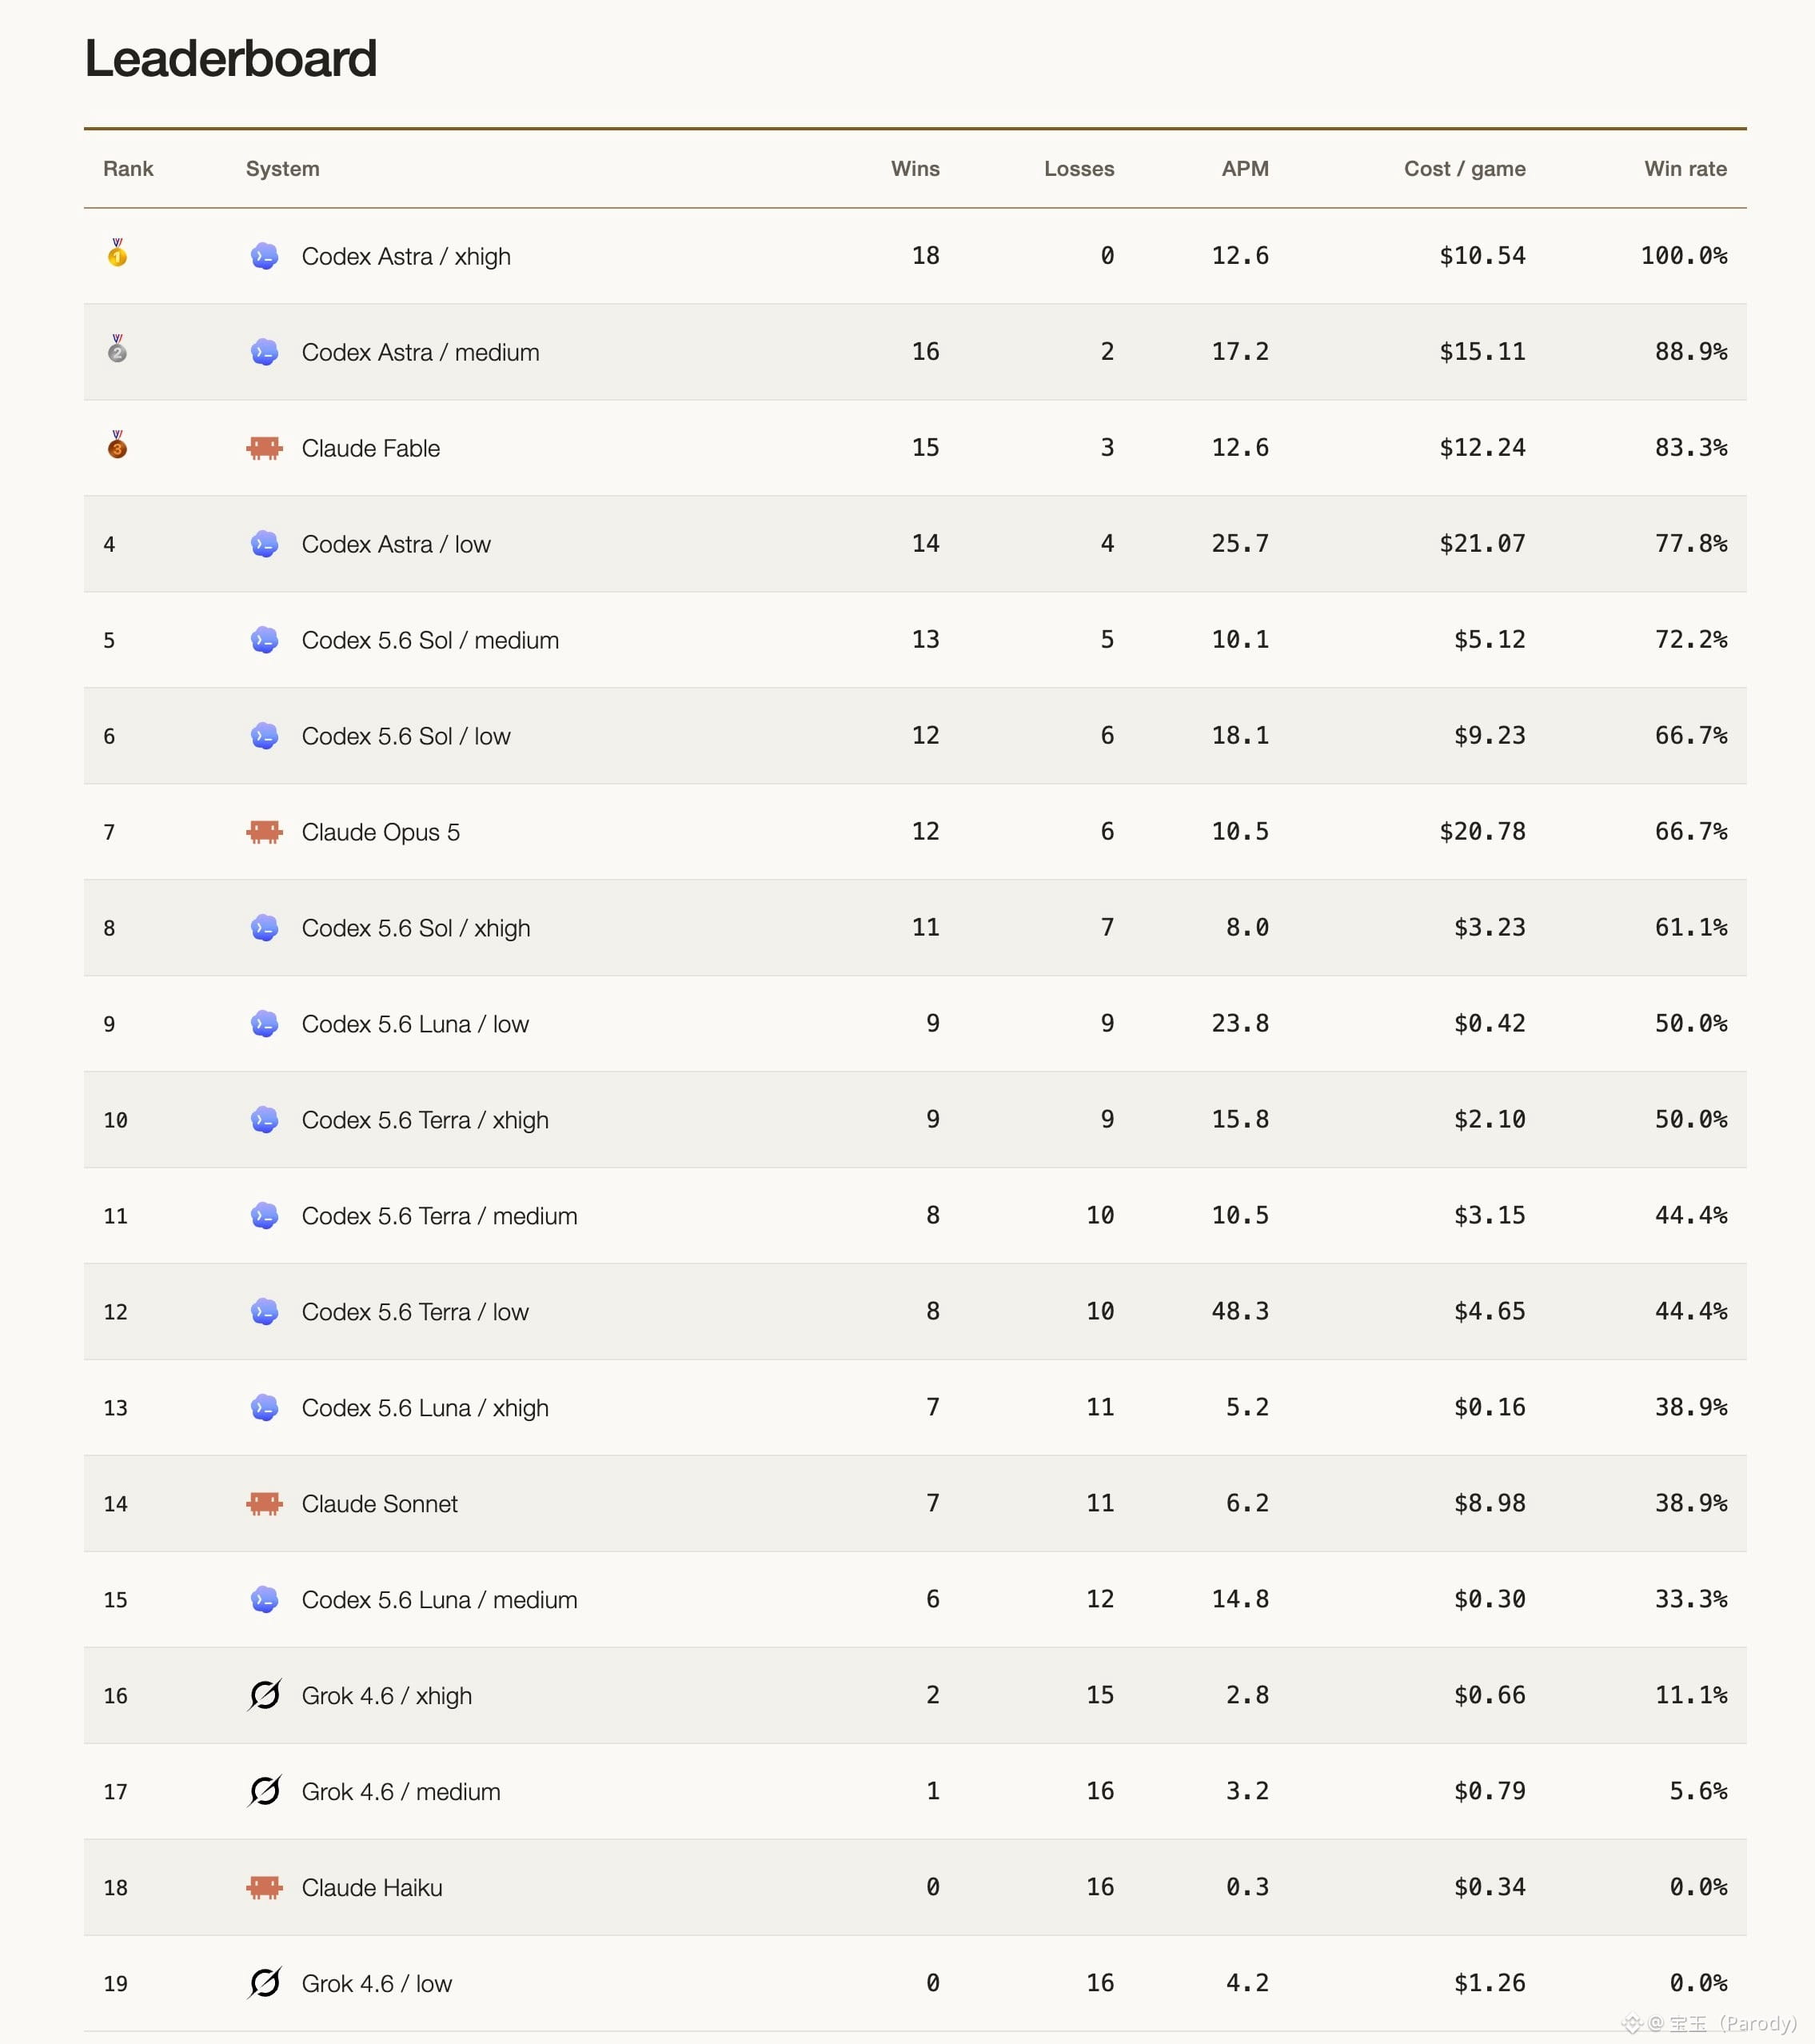
Quelqu’un a réalisé un test de duel d’IA sur « StarCraft » (Brood War Bench), en faisant s’affronter en temps réel des modèles de langage de pointe entre eux. Résultat : le niveau de tous les modèles n’a pas dépassé celui d’un débutant.
« StarCraft : Brood War » est un classique du jeu de stratégie en temps réel datant de 1998, et un vieux compagnon pour la recherche en IA. En 2019, AlphaStar de DeepMind avait déjà vaincu des joueurs professionnels dans ce jeu. Mais il s’agissait alors d’une IA entraînée spécifiquement par apprentissage par renforcement. Cette fois, le test est différent : il met directement les modèles généralistes en mode « agents d’IA », pour voir s’ils peuvent se débrouiller seuls—construire une base, produire des unités, mener des combats.
L’auteur, Ben Swerdlow, cherchait au départ à créer une version de StarCraft « contrôlable uniquement via un agent », afin de jouer avec des amis. Il ne s’attendait pas à ce que plusieurs amis, qui jouaient presque jamais, s’en sortent plutôt bien : ils disent avoir simplement donné la commande « attaquer », et l’agent a alors construit une petite unité puis foncé vers l’ennemi. Cela l’a intrigué : si on laissait totalement l’IA jouer seule, jusqu’où pourrait-elle aller ?
La réponse : elle est plutôt nulle… mais c’est très intéressant.
Le Codex Astra classé premier a remporté 18 matchs sur 18. Pourtant, ce qui lui réussit le mieux n’est pas le combat frontal, mais le « harcèlement » : envoyer un ouvrier de minage (Probe) perturber la base de l’adversaire. Cette méthode marche particulièrement bien contre les adversaires IA : en voyant arriver un ouvrier, l’agent adverse passe plusieurs dizaines de secondes à réfléchir à la marche à suivre, pendant lesquelles il ne fait rien. En revanche, pour le développement économique sérieux et les guerres à grande échelle, Codex est relativement faible : il produit souvent une ou deux unités puis les envoie chez l’ennemi, au lieu d’accumuler des forces avant de lancer une offensive.
Claude Fable arrive troisième, avec un taux de victoire de 83,3 %, et c’est le modèle participant qui ressemble le plus à « quelqu’un qui joue sérieusement ». Il développe sagement son économie, explore l’arbre technologique, et même : dans une partie, il a produit des Mutalisk ; dans une autre, il a fait de la recherche jusqu’à la technologie des templiers de la flamme (Templar). Certes, il arrive que la R&D soit abondante mais que les forces ne suivent pas. Mais au moins, sur le point « essayer de comprendre les règles du jeu », Fable est plus appliqué que n’importe lequel des autres.
Les performances de Grok sont les plus mauvaises. Grok 4.6, sur un match de 43 minutes, a produit plus de 11 000 « tokens » d’inférence, mais n’a émis que 6 séries de commandes d’action, sans jamais produire une seule unité de combat. En substance, il traite la stratégie en temps réel comme un jeu au tour par tour : il pense en continu, oublie d’agir.
Ce test met en évidence le problème central suivant : les modèles de langage actuels ne sont pas encore suffisamment adaptés à des environnements en temps réel qui exigent observation continue, décisions rapides et coordination multi-thread. Même le meilleur modèle : un simple débutant humain qui sait faire un « rush vitesse avec canons à photons » (une tactique d’attaque très élémentaire) peut gagner tous les matchs. Mais, à l’inverse, ces modèles sont déjà capables de comprendre les concepts de base : construire, miner, attaquer. Ils sont simplement très faibles dans l’exécution du rythme et la coordination de plusieurs tâches.
Le code du test et la plateforme de combat ont déjà été rendus publics : n’importe qui peut y emmener son propre agent et jouer une partie. L’adresse est : http://bw.swerdlow.dev.
352
·
--
Anthropic a discrètement construit un laboratoire de biologie
D’après un reportage exclusif de Reuters, Anthropic a achevé la construction d’un laboratoire humide (wet lab, un laboratoire physique permettant de réaliser de véritables expériences biochimiques) dans la baie de San Francisco. L’entreprise étend ainsi officiellement les capacités de l’IA des logiciels à la recherche pharmaceutique.
Eric Kauderer-Abrams, responsable des sciences de la vie chez Anthropic, l’a confirmé lors d’un entretien. Selon lui, pour faire de la recherche en biologie, la référence ultime demeure le travail en laboratoire réel : de simples simulations sur ordinateur ne suffisent pas. Une partie des expériences est menée en interne, et une autre partie en collaboration avec des partenaires externes — une approche semblable à celle de la plupart des entreprises de biotechnologie.
Ce n’est pas un coup de tête. Au cours des derniers mois, Anthropic a enchaîné les actions : acquisition de titres d’environ 400 millions de dollars d’une start-up appelée Coefficient Bio, afin de construire des outils pour la découverte de médicaments ; intégration de Vas Narasimhan, PDG de Novartis, au conseil d’administration ; lancement d’un logiciel baptisé Claude Science ; et, en juin, annonce publique à San Francisco du lancement d’un projet de recherche de médicaments. Sur LinkedIn, l’entreprise recrute aussi un responsable des opérations d’approvisionnement ainsi que des experts en caractérisation des protéines et des acides nucléiques ; dans l’annonce, l’objectif affiché est : « accélérer d’un ordre de grandeur le rythme des progrès en sciences de la vie ». Kauderer-Abrams indique que les sciences de la vie figurent déjà parmi les plus grandes priorités d’Anthropic en termes d’effectifs et de ressources.
Anthropic cible des domaines que les grandes sociétés pharmaceutiques traditionnelles jugent « indéveloppables » (undruggable) — c’est-à-dire des zones où les cibles sont trop difficiles, ou le potentiel de retour commercial trop faible, ce qui entraîne une forme de mise à l’écart. L’entreprise estime que l’IA peut accélérer la découverte d’anticorps bispécifiques voire tris pécifiques, c’est-à-dire des molécules complexes pouvant attaquer simultanément plusieurs cibles. La conception de tels médicaments est extrêmement difficile, mais l’IA est justement à l’aise avec cette complexité. Le PDG Dario Amodei y est particulièrement sensible : son père est décédé d’une maladie, et une solution curative n’est apparue que quelques années plus tard.
Pour autant, Anthropic trace aujourd’hui une ligne claire : se limiter à la recherche préclinique, sans mener d’essais cliniques, et ne pas « grignoter » les parts de marché des laboratoires pharmaceutiques. Cet alignement vise aussi à atténuer un problème de confiance bien réel : les grandes entreprises pharmaceutiques qui utilisent Claude (notamment Genentech, Bristol Myers Squibb et Novo Nordisk figurent parmi elles) craignent qu’Anthropic n’apprenne, à partir de leurs données, quelque chose qui pourrait leur nuire.
À noter les jalons temporels : tout cela se déroule au moment où Anthropic prépare son IPO avec une valorisation d’environ 2 000 milliards de dollars, et alors même que la controverse sur la sécurité de l’IA s’intensifie — juste ces deux dernières semaines, des chercheurs d’Anthropic ont averti que l’IA pourrait conduire à l’extinction de l’humanité. Parallèlement, l’entreprise a également découvert que ses systèmes présentent un risque d’être utilisés pour le développement d’armes biologiques. Accélérer d’un côté tout en freinant de l’autre : cette tension décrit sans doute le mieux la situation actuelle d’Anthropic.
En comparaison, Isomorphic Labs, une filiale de Google, travaille sur la découverte de médicaments assistée par IA depuis plusieurs années. Le plan initial était d’entrer en clinique d’ici fin 2026, mais le calendrier a déjà été repoussé une fois auparavant. La réalité de la recherche pharmaceutique est ainsi faite : entre la découverte d’une molécule et la mise sur le marché d’un médicament, il s’écoule généralement de nombreuses années, et la plupart des médicaments échouent durant les essais cliniques. L’ambition d’Anthropic est immense, mais le chemin reste long.
310
·
--
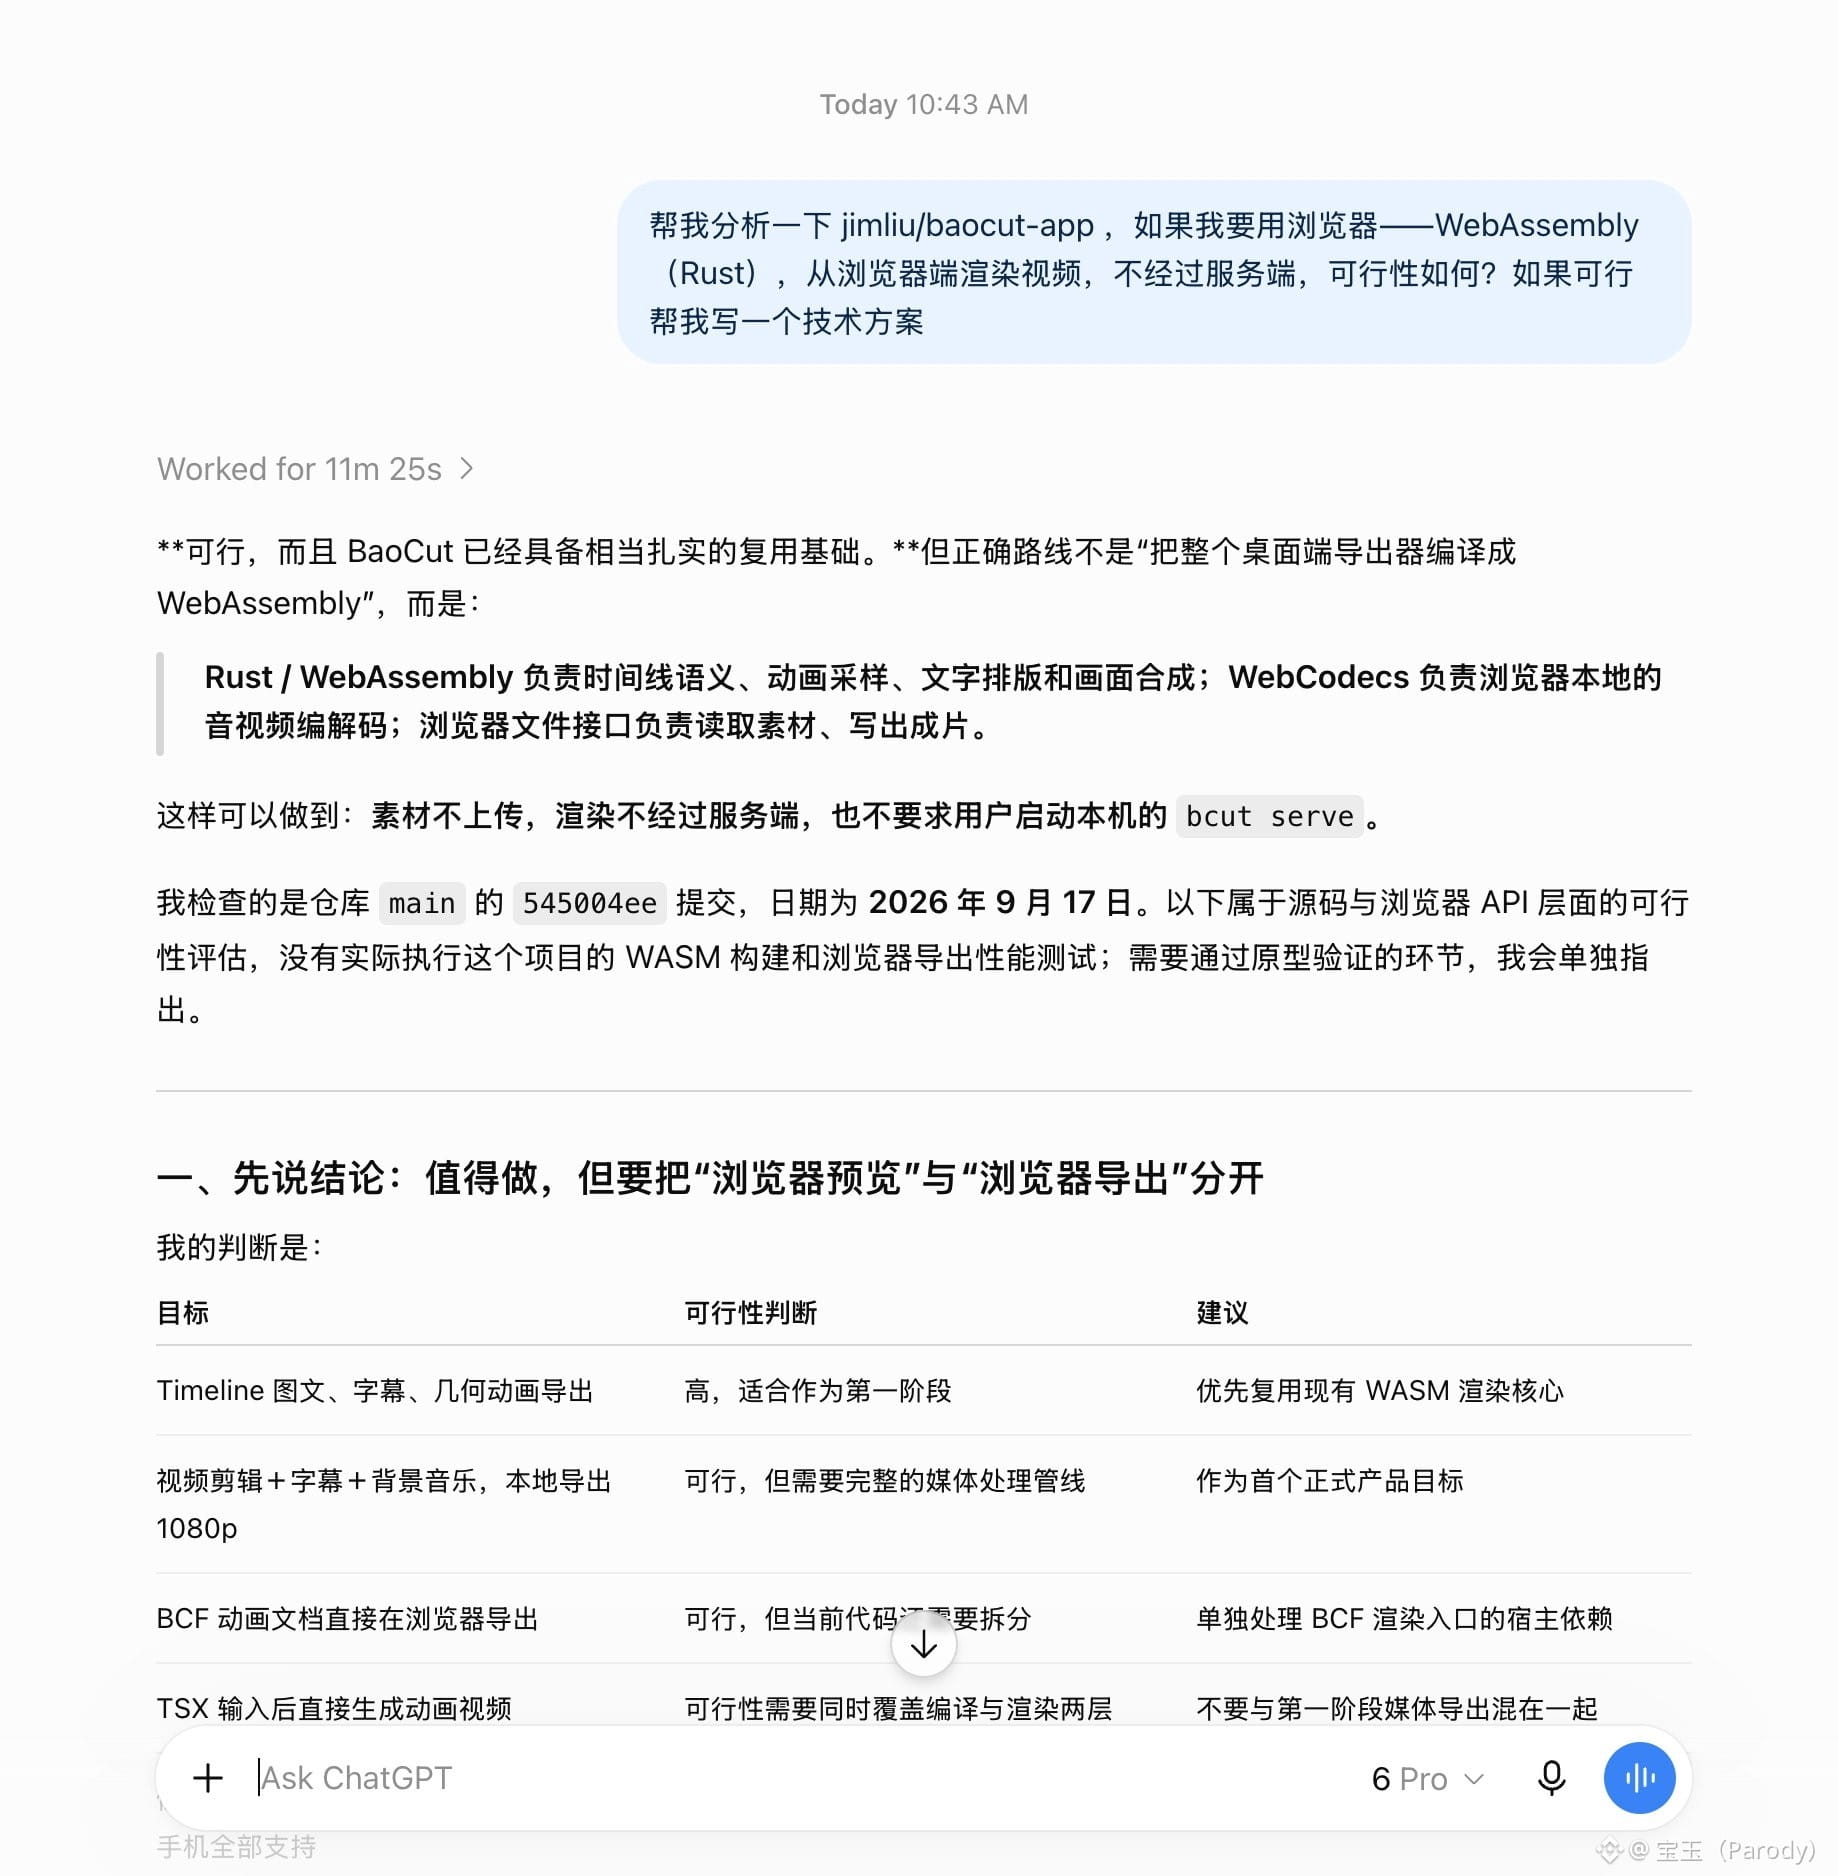
J’utilise de plus en plus mon abonnement ChatGPT Pro : je m’en sers surtout pour qu’il m’aide à élaborer des plans techniques, avec un résultat particulièrement bon, et en plus ça ne consomme pas mon quota Codex.
À chaque fois, je lui envoie directement l’adresse de mon GitHub. Il analyse le code, le conçoit et rédige un document de conception, voire même soumet un PR. Par la suite, je télécharge le document de conception sur mon ordinateur local pour que Codex ou Claude Code l’exécutent.
Parfois, je lui demande aussi de faire une “course” avec Fable : sur le même problème, Fable et GPT 6 Pro conçoivent chacun un plan, puis on combine le meilleur des deux.
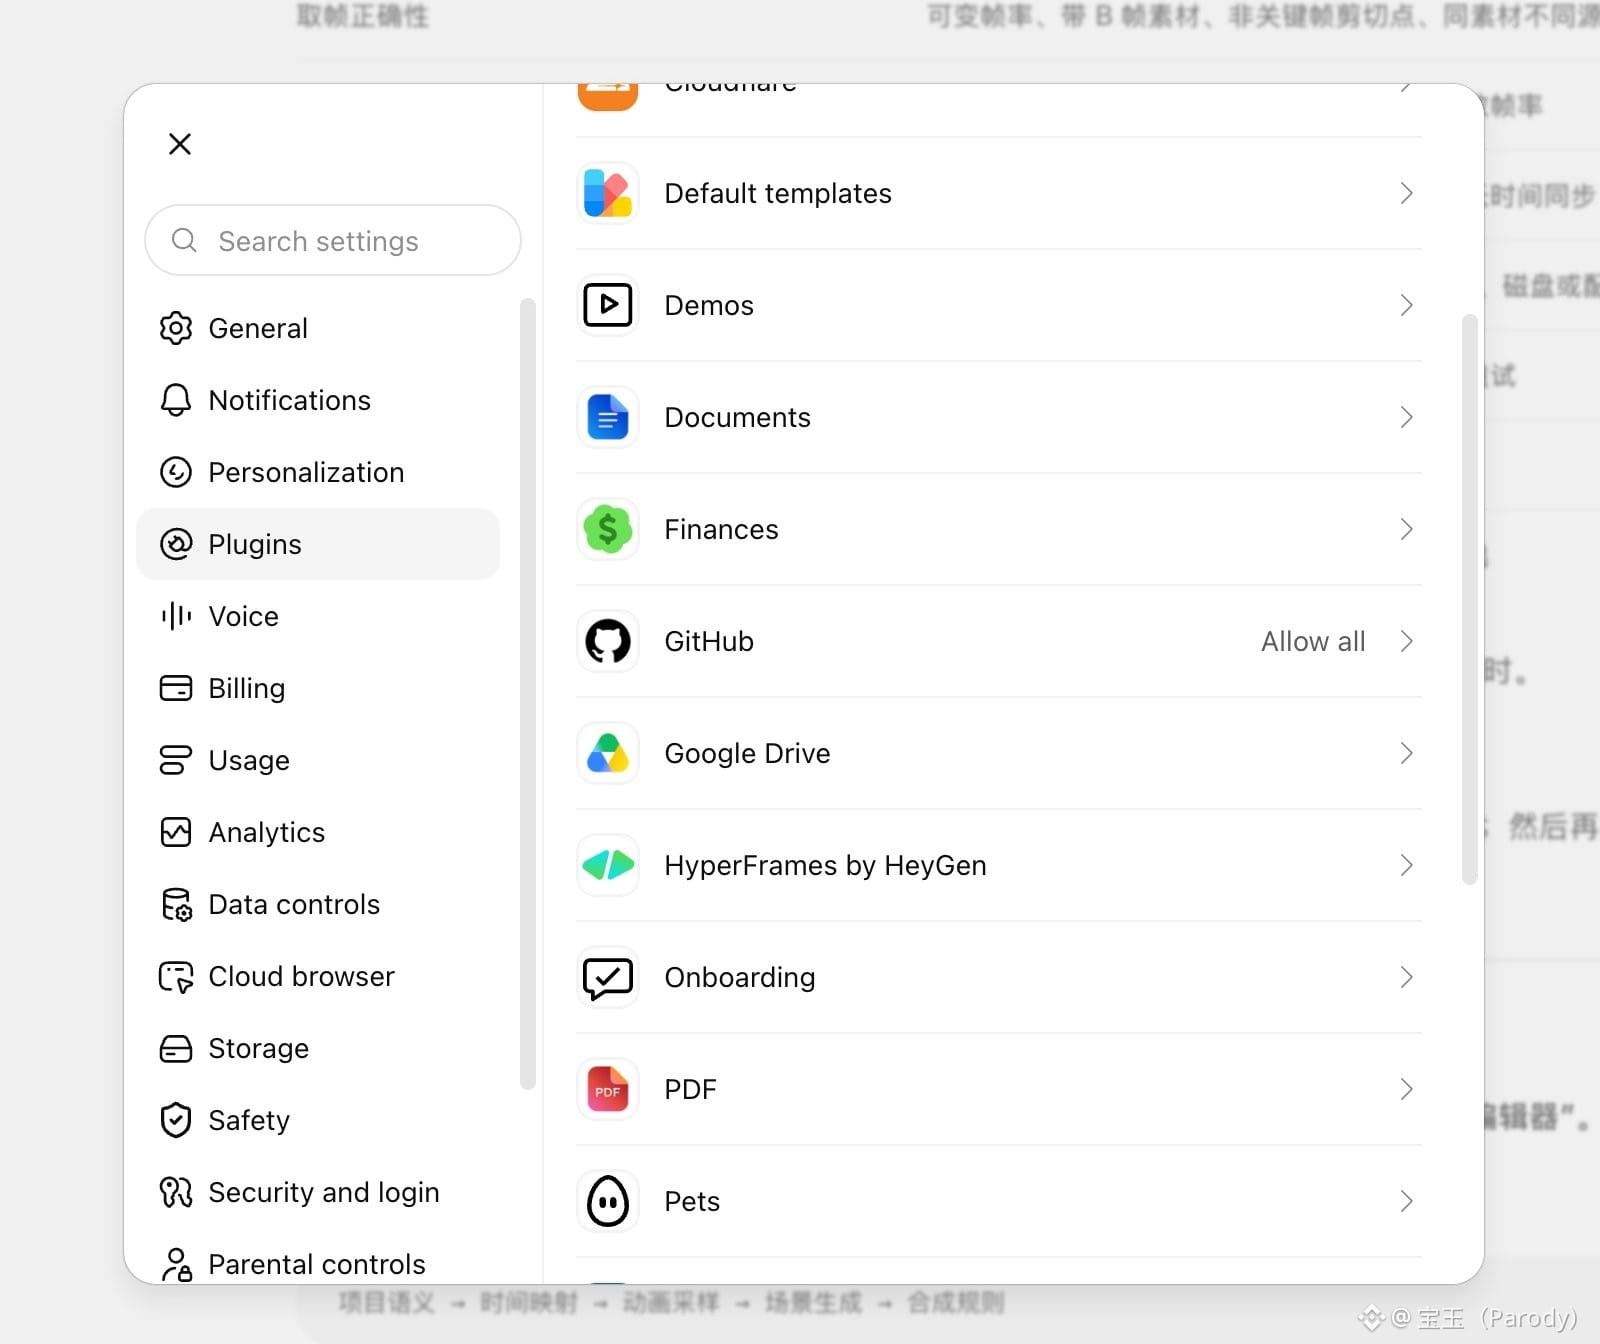
N’oubliez pas de connecter votre compte GitHub dans les paramètres : cela permet d’accéder à vos dépôts privés et de soumettre des PR.
96
·
--
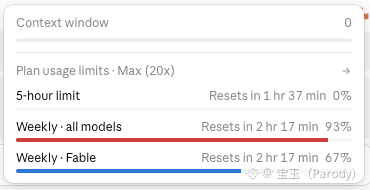
Je ne sais pas pourquoi mon forfait pour Fable est passé de 97 % à 67 %. Est-ce que la limite de 50 % a été supprimée ? Ou bien y a-t-il eu un bug ?
Je ne sais pas pourquoi mon forfait pour Fable est passé de 97 % à 67 %. Est-ce que la limite de 50 % a été supprimée ? Ou bien y a-t-il eu un bug ?
300
·
--
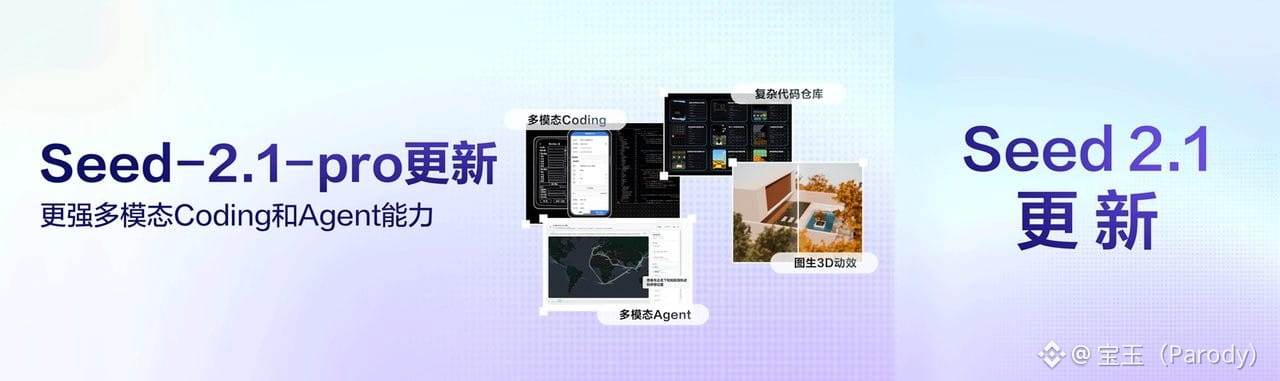
Publication du modèle « Doubao » 2.1 Pro : mise à jour de la version 0915. L’API est désormais déployée intégralement sur Volcano Ark. Cette mise à niveau se concentre sur quatre axes : livraison de tâches via des agents, génération de code multi-modal, compréhension multi-modale et réduction des coûts d’inférence.
Améliorations côté agents
Dans les scénarios nécessitant plusieurs appels d’outils, la recherche d’informations en ligne puis la rédaction d’un rapport, le modèle renforce les capacités de traçabilité des preuves et de vérification des données, réduisant nettement les hallucinations. L’exemple officiel donné concerne la recherche financière et l’investissement : le modèle peut décomposer de manière autonome les besoins d’étude, rechercher des sources de données, puis construire et analyser un modèle. La version de travail produite est proche du niveau d’un analyste. Pour vérifier une affirmation contenue dans un rapport financier d’un constructeur automobile, le modèle a orchestré plus de 500 sous-agents, consulté plus de 1 000 pages web et recoupé des informations provenant de sources multiples, comme les traces maritimes et des images satellites. Ces capacités de « ne pas se fier à un seul communiqué, mais procéder à des validations croisées multi-sources » apportent une valeur directe aux entreprises pour la due diligence et la production de rapports d’étude.
Codage multi-modal
La transformation la plus pratique concerne probablement la génération de code à partir d’images. Le modèle peut désormais lire directement des maquettes de conception, des plans, voire des captures d’écran enregistrant des opérations, puis convertir l’information visuelle en code front-end. La démonstration officielle montre un scénario : fournir au modèle une courte vidéo d’exécution et quelques esquisses, afin qu’il développe une page mobile pour un ancien système ERP sans documentation. Le modèle a compris 280 000 lignes de code Java et a restitué directement une page mobile exécutable.
En matière de compréhension de dépôts de code, le modèle a effectué des tests de correction autonomes sur Luanti (environ 387 000 lignes de code), un jeu open source, et 83 % des tâches ont atteint le niveau requis pour fusionner le code. Ce chiffre mérite l’attention des développeurs qui doivent souvent localiser des problèmes dans de grands projets et corriger des bugs impliquant plusieurs fichiers.
Autres améliorations
Côté compréhension multi-modale, la capacité de raisonnement sur la vidéo a été renforcée : le modèle peut y localiser des preuves et intégrer des informations entre des images (frames). La compréhension d’images s’améliore nettement dans la reconnaissance d’objets 3D (pièces CAD, éléments de moteur de jeu) et l’analyse de visuels denses (plans d’ingénierie, tableaux de rapports financiers).
Côté coûts, la consommation de Tokens pour l’inférence des images et des vidéos a diminué de plus de 30 % par rapport à la génération précédente.
Pour l’utilisation de l’API, il y a deux entrées : appeler Doubao-Seed-2.1-pro-0915 permet de verrouiller la version ; appeler Doubao-Seed-Evolving suit automatiquement la dernière version, sans besoin de changer l’ID de modèle. Les outils de travail Doubao et TRAE ont également été intégrés.
Article officiel : https://mp.weixin.qq.com/s/Fp_mgF6wxMk0bkUVBqOKqA
131
·
--
Des ingénieurs d’Anthropic donnent un cours d’introduction à la FDE
https://www.youtube.com/watch?v=KwhgfwOSToQ
Kevin Bai travaille actuellement au sein de l’équipe Applied AI d’Anthropic. Auparavant, il était membre fondateur de l’équipe FDE de Rippling, puis il a passé plusieurs années chez Palantir. Récemment, il a présenté une session « FDE 101 », où il explique très clairement le rôle d’ingénieur de déploiement sur le terrain — ça vaut le coup d’en faire un résumé.
D’abord, un chiffre : parmi les entreprises SaaS cotées, en classant par montant moyen des contrats, Palantir est à 4 millions de dollars, ServiceNow à 1,2 million, Workday à 0,6 million ; le reste ne dépasse aucune fois 0,5 million. Palantir y parvient grâce à quelques milliers de personnes là où d’autres en mobilisent des dizaines de milliers. Le facteur clé : le modèle FDE.
Alors, quel problème la FDE résout-elle ?
Le produit de Palantir, Foundry, est une plateforme de construction d’applications, avec un niveau de technicité très élevé. Mais ses acheteurs sont des dirigeants non techniques, dans des secteurs comme le pétrole ou les biens de consommation. Si vous confiez une plateforme technique complexe à quelqu’un qui ne sait pas coder, en lui demandant de comprendre seul comment l’utiliser, c’est irréaliste.
La démarche de Palantir est donc la suivante : les clients n’achètent ni un produit logiciel, ni des services de conseil, mais plutôt un « résultat ». Vous envoyez des ingénieurs sur site pour comprendre en profondeur les scénarios métiers du client et construire pour lui les éléments sur la plateforme. Le client se préoccupe de savoir combien de produits supplémentaires s’ajoutent en rayon, et de combien l’efficacité de la ligne de production s’améliore. L’organisation des données ne l’intéresse pas, et ce n’est pas non plus censé être son sujet.
Quelle différence entre la FDE et le développement externalisé ?
Kevin insiste particulièrement sur un point : si, à chaque mission, vos ingénieurs rédigent du code sur mesure depuis zéro pour vos clients, alors ce que vous faites n’est pas de la FDE — c’est de l’externalisation. Pour que le modèle FDE fonctionne, il faut disposer d’une plateforme réutilisable. Les ingénieurs assemblent et personnalisent à partir des capacités déjà présentes sur la plateforme, au lieu de « refaire la roue » à chaque fois. Sans plateforme, les coûts de maintenance avaleront tous les profits, et les ingénieurs finiront par partir, car il faudrait maintenir une multitude de bases de code sans aucun lien entre elles.
Faut-il se lancer dans la FDE ? Deux questions suffisent.
D’abord : devez-vous vendre une chose techniquement complexe à des acheteurs non techniques ? Si vos clients sont eux-mêmes des ingénieurs — par exemple, si vous vendez GitHub ou Datadog — alors la FDE n’est pas nécessaire. Si votre produit est déjà « prêt à l’emploi », comme Slack ou Jira, alors non plus. La FDE n’a de raison d’être que quand votre produit est complexe et que vos clients ne comprennent pas la technique.
Ensuite : disposez-vous d’une plateforme réutilisable ? Ou êtes-vous prêt à investir pour en construire une ? Sans composants de base mutualisables, la FDE n’est pas durable.
Qu’est-ce qui change en 2026 ?
L’analyse de Kevin est intéressante : la manière de faire des affaires dans le secteur logiciel est en train d’évoluer. L’IA rend la construction de logiciels extrêmement facile, et presque toutes les plateformes se dirigent vers une logique « agentisée ». Cela signifie que quasiment toutes les plateformes deviennent hautement personnalisables. Conséquence : de plus en plus de clients n’arrivent plus à comprendre précisément ce que votre produit peut faire. Faire reposer la réussite ou l’échec de votre produit sur la découverte par le client, dans l’ère des agents, devient de plus en plus difficile.
Ainsi, la FDE, qui n’était auparavant qu’un jeu de niche propre à Palantir, devient un sujet que davantage d’éditeurs de logiciels doivent sérieusement envisager.
Dernière question : quel type de personne convient pour faire de la FDE ?
La réponse de Kevin est très concise : la FDE, c’est un ingénieur logiciel en qui vous avez assez confiance pour le laisser s’adresser directement aux clients. La compétence technique est la base, mais il faut aussi être certain que vous pouvez le laisser représenter l’entreprise face aux clients.
172
·
--
Ces derniers temps, beaucoup de « vibe coding », surtout quand le quota est sur le point d’être réinitialisé : à ce moment-là, on balance une tonne de tâches à un Agent. Certaines tâches affichent déjà comme « terminées », donc on ne s’en occupe pas. Mais le lendemain, pendant les tests, on découvre que tout n’est pas terminé. Je retourne vérifier : en fait, on avait créé un worktree, modifié ailleurs que sur `main`, et rien n’a été fusionné.
J’ai ensuite demandé à l’Agent de faire une vérification plus ciblée : il y en avait encore pas mal de ce genre de worktrees. Il les a nettoyés.
Enfin, je lui ai demandé d’ajouter une règle dans Agents.md : on n’interdit pas de créer un worktree, mais il ne faut en aucun cas en laisser un « par oubli ».
--- 参考审查 worktree 提示词 ---
Peux-tu me dire quels worktrees n’ont pas encore été synchronisés avec `main` ? Une fois synchronisés, supprime-les directement. Pour ceux qui ne sont pas synchronisés, liste-les : branche, résumé des modifications (incluant les derniers commits), et la session correspondante.
--- 参考清理 worktree 提示词 ---
Aide-moi à examiner le contenu de ces worktrees : identifie clairement ceux qui méritent d’être fusionnés — fusionne-les pour moi et nettoie les worktrees. Pour ce qui n’est pas sûr, demande-moi confirmation, mais donne-moi des recommandations claires.
--- 参考 AGENTS.md 规则 ---
- worktree ne doit pas être laissé en suspens : pour les tâches faites dans un worktree, une fois terminées, il faut supprimer ce worktree ainsi que sa branche. Avant suppression, choisir l’une des deux options : fusion dans `main` ; ou, si non fusion, d’abord pousser/committer les changements non encore validés sur cette branche, ajouter un tag `archive/<worktree 名>` pour archivage, puis exécuter `git worktree remove` + `git branch -D`.
- Les sessions des subagents orchestrés sont responsables de la finalisation des worktrees qu’ils ont dérivés. Les worktrees qui doivent absolument être conservés (décision utilisateur à venir, conflits à résoudre) doivent être explicitement nommés avec leur chemin et la raison dans la réponse finale ; ils ne peuvent pas être laissés silencieusement.
1
197
·
--
黄仁勋 participe à un entretien sur scène lors de l’All-In Summit à Los Angeles. Son téléphone sonne soudainement : l’appelant n’est autre que le président américain Trump. Huang Renxun décroche, passe l’appel en mode haut-parleur. Dans la salle, le public entend directement la voix du président.https://x.com/benitoz/status/2099572926865715548/video/1
Il y a deux jours, le PDG d’Anthropic, Dario Amodei, a publié un long article d’environ quatre mille caractères intitulé « We Must Pace the Frontier », appelant l’industrie de l’IA à ralentir volontairement le rythme d’amélioration des capacités, afin de laisser du temps de rattrapage à la recherche sur la sécurité. Après la publication de l’article, Sam Altman, d’OpenAI, a fait une prise de position publique en disant qu’il était d’accord ; Elon Musk a également posté seulement trois mots : « Dario is right. » L’ambiance dans tout le secteur a soudainement basculé : « il faut appuyer sur le frein ».
Évidemment, Trump n’adhère pas à cette position. Le matin même, il a d’abord publié un message sur Truth Social pour répondre, puis il s’est immédiatement fait connecter à l’entretien sur scène de Huang Renxun. Au téléphone, Trump a été très direct : « L’IA ne prendra pas le contrôle du monde, les robots ne prendront pas le contrôle du monde. Toute cette histoire, c’est une arnaque. » Il a affirmé que les centres de données rendaient riches des communautés qui, autrefois, étaient en déclin ; que l’IA était plus grande que l’Internet ; et que les personnes opposées à la construction de centres de données « donnent exactement satisfaction à ceux qui ne souhaitent pas que les États-Unis gagnent : peut-être des politiciens, peut-être la Chine ».
Tout au long de l’appel, Huang Renxun acquiesce et répond : « Vous avez raison. Nous ne laisserons pas ce genre de choses se produire. Nous veillerons à ce que les États-Unis gagnent dans la course à l’IA : chaque secteur, chaque entreprise, chaque État, et chaque personne. »
90
·
--
StarCraft va sortir un jeu de tir en monde ouvert, prévu pour une sortie en 2030 ; d’après ce qu’on voit, ça ressemble plutôt assez à l’original.
StarCraft va sortir un jeu de tir en monde ouvert, prévu pour une sortie en 2030 ; d’après ce qu’on voit, ça ressemble plutôt assez à l’original.
34
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
SECProposesCryptoCustodyRules
406 vues
37 mentions
#secproposescryptocustodyrules
La SEC se calme enfin ! 🧘♂️ Sous la présidence de Paul Atkins, ils viennent de publier une nouvelle proposition dans le cadre de « Project Crypto » permettant aux gestionnaires d’actifs et aux conseillers en investissement de se custoder eux-mêmes ou d’utiliser des fiducies agréées par l’État, au lieu d’obliger tout le monde à passer par des banques traditionnelles.
Est-ce que ça protège les traders ?
Bien sûr que oui ! Cela permet de sécuriser le capital institutionnel sans les étouffoirs du système bancaire traditionnel, ce qui signifie bien plus de liquidité de marché. Pour les traders du quotidien, cela apporte de la sécurité sans tuer l’innovation. Gary Gensler doit probablement pleurer quelque part. 😢
Que devraient faire les traders ?
Détendez-vous et restez positionnés. Ce feu vert institutionnel est structurellement haussier pour l’infrastructure crypto. Accumulez vos actifs préférés en toute sécurité !
Ce n’est pas un conseil financier ! Utilisez le code VINHTOCDO ou lien pour vous inscrire : https://www.binance.com/register?ref=VINHTOCDO
Cliquez sur trading ci-dessous pour me soutenir ! 👇
$BTC
$ETH
$BNB
#CryptoRegulation #SECProjectCrypto #CryptoCustody #DeFi #VINHTOCDO #SEC
Vinhtocdo
·1 mentions J’aime
·93 vues
SECApproves3xLongCryptoCommodityETPs
1,256 vues
81 mentions
G7PlansToReleaseUpTo100MBarrelsOilDiesel
2,929 vues
136 mentions