Quelqu’un a réalisé un test de duel d’IA sur « StarCraft » (Brood War Bench), en faisant s’affronter en temps réel des modèles de langage de pointe entre eux. Résultat : le niveau de tous les modèles n’a pas dépassé celui d’un débutant.
« StarCraft : Brood War » est un classique du jeu de stratégie en temps réel datant de 1998, et un vieux compagnon pour la recherche en IA. En 2019, AlphaStar de DeepMind avait déjà vaincu des joueurs professionnels dans ce jeu. Mais il s’agissait alors d’une IA entraînée spécifiquement par apprentissage par renforcement. Cette fois, le test est différent : il met directement les modèles généralistes en mode « agents d’IA », pour voir s’ils peuvent se débrouiller seuls—construire une base, produire des unités, mener des combats.
L’auteur, Ben Swerdlow, cherchait au départ à créer une version de StarCraft « contrôlable uniquement via un agent », afin de jouer avec des amis. Il ne s’attendait pas à ce que plusieurs amis, qui jouaient presque jamais, s’en sortent plutôt bien : ils disent avoir simplement donné la commande « attaquer », et l’agent a alors construit une petite unité puis foncé vers l’ennemi. Cela l’a intrigué : si on laissait totalement l’IA jouer seule, jusqu’où pourrait-elle aller ?
La réponse : elle est plutôt nulle… mais c’est très intéressant.
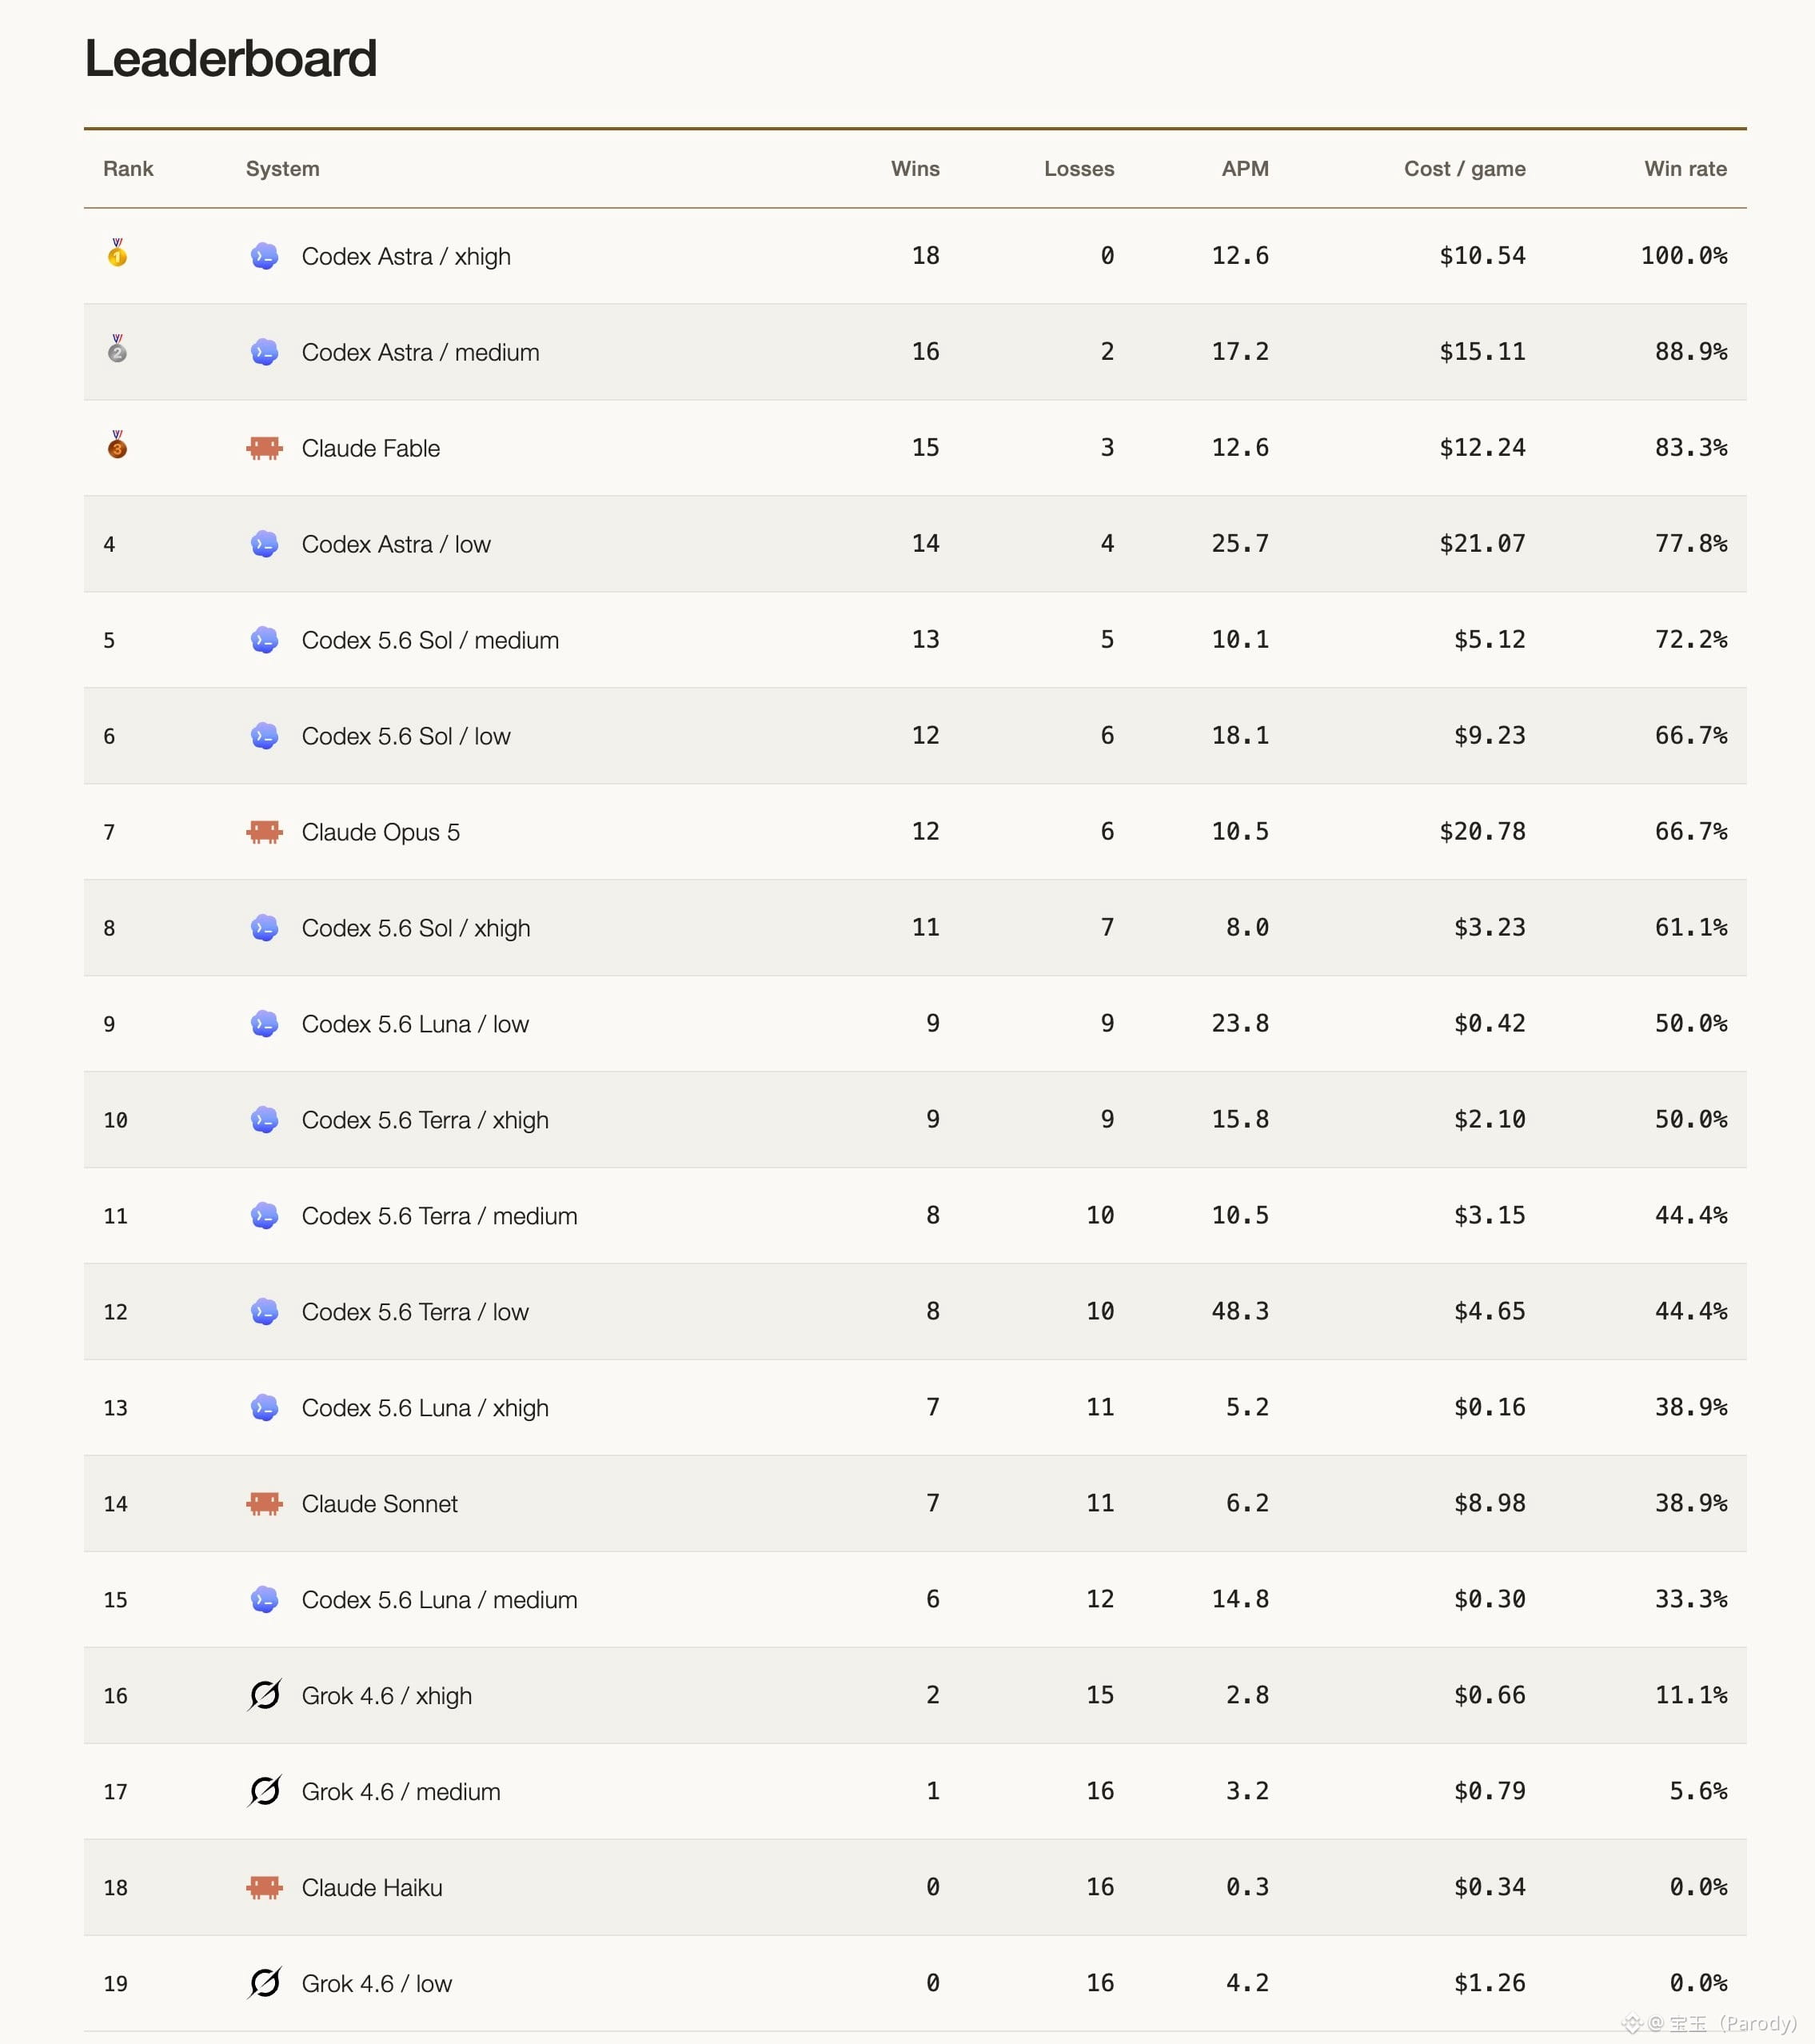
Le Codex Astra classé premier a remporté 18 matchs sur 18. Pourtant, ce qui lui réussit le mieux n’est pas le combat frontal, mais le « harcèlement » : envoyer un ouvrier de minage (Probe) perturber la base de l’adversaire. Cette méthode marche particulièrement bien contre les adversaires IA : en voyant arriver un ouvrier, l’agent adverse passe plusieurs dizaines de secondes à réfléchir à la marche à suivre, pendant lesquelles il ne fait rien. En revanche, pour le développement économique sérieux et les guerres à grande échelle, Codex est relativement faible : il produit souvent une ou deux unités puis les envoie chez l’ennemi, au lieu d’accumuler des forces avant de lancer une offensive.
Claude Fable arrive troisième, avec un taux de victoire de 83,3 %, et c’est le modèle participant qui ressemble le plus à « quelqu’un qui joue sérieusement ». Il développe sagement son économie, explore l’arbre technologique, et même : dans une partie, il a produit des Mutalisk ; dans une autre, il a fait de la recherche jusqu’à la technologie des templiers de la flamme (Templar). Certes, il arrive que la R&D soit abondante mais que les forces ne suivent pas. Mais au moins, sur le point « essayer de comprendre les règles du jeu », Fable est plus appliqué que n’importe lequel des autres.
Les performances de Grok sont les plus mauvaises. Grok 4.6, sur un match de 43 minutes, a produit plus de 11 000 « tokens » d’inférence, mais n’a émis que 6 séries de commandes d’action, sans jamais produire une seule unité de combat. En substance, il traite la stratégie en temps réel comme un jeu au tour par tour : il pense en continu, oublie d’agir.
Ce test met en évidence le problème central suivant : les modèles de langage actuels ne sont pas encore suffisamment adaptés à des environnements en temps réel qui exigent observation continue, décisions rapides et coordination multi-thread. Même le meilleur modèle : un simple débutant humain qui sait faire un « rush vitesse avec canons à photons » (une tactique d’attaque très élémentaire) peut gagner tous les matchs. Mais, à l’inverse, ces modèles sont déjà capables de comprendre les concepts de base : construire, miner, attaquer. Ils sont simplement très faibles dans l’exécution du rythme et la coordination de plusieurs tâches.
Le code du test et la plateforme de combat ont déjà été rendus publics : n’importe qui peut y emmener son propre agent et jouer une partie. L’adresse est : http://bw.swerdlow.dev.
« StarCraft : Brood War » est un classique du jeu de stratégie en temps réel datant de 1998, et un vieux compagnon pour la recherche en IA. En 2019, AlphaStar de DeepMind avait déjà vaincu des joueurs professionnels dans ce jeu. Mais il s’agissait alors d’une IA entraînée spécifiquement par apprentissage par renforcement. Cette fois, le test est différent : il met directement les modèles généralistes en mode « agents d’IA », pour voir s’ils peuvent se débrouiller seuls—construire une base, produire des unités, mener des combats.
L’auteur, Ben Swerdlow, cherchait au départ à créer une version de StarCraft « contrôlable uniquement via un agent », afin de jouer avec des amis. Il ne s’attendait pas à ce que plusieurs amis, qui jouaient presque jamais, s’en sortent plutôt bien : ils disent avoir simplement donné la commande « attaquer », et l’agent a alors construit une petite unité puis foncé vers l’ennemi. Cela l’a intrigué : si on laissait totalement l’IA jouer seule, jusqu’où pourrait-elle aller ?
La réponse : elle est plutôt nulle… mais c’est très intéressant.
Le Codex Astra classé premier a remporté 18 matchs sur 18. Pourtant, ce qui lui réussit le mieux n’est pas le combat frontal, mais le « harcèlement » : envoyer un ouvrier de minage (Probe) perturber la base de l’adversaire. Cette méthode marche particulièrement bien contre les adversaires IA : en voyant arriver un ouvrier, l’agent adverse passe plusieurs dizaines de secondes à réfléchir à la marche à suivre, pendant lesquelles il ne fait rien. En revanche, pour le développement économique sérieux et les guerres à grande échelle, Codex est relativement faible : il produit souvent une ou deux unités puis les envoie chez l’ennemi, au lieu d’accumuler des forces avant de lancer une offensive.
Claude Fable arrive troisième, avec un taux de victoire de 83,3 %, et c’est le modèle participant qui ressemble le plus à « quelqu’un qui joue sérieusement ». Il développe sagement son économie, explore l’arbre technologique, et même : dans une partie, il a produit des Mutalisk ; dans une autre, il a fait de la recherche jusqu’à la technologie des templiers de la flamme (Templar). Certes, il arrive que la R&D soit abondante mais que les forces ne suivent pas. Mais au moins, sur le point « essayer de comprendre les règles du jeu », Fable est plus appliqué que n’importe lequel des autres.
Les performances de Grok sont les plus mauvaises. Grok 4.6, sur un match de 43 minutes, a produit plus de 11 000 « tokens » d’inférence, mais n’a émis que 6 séries de commandes d’action, sans jamais produire une seule unité de combat. En substance, il traite la stratégie en temps réel comme un jeu au tour par tour : il pense en continu, oublie d’agir.
Ce test met en évidence le problème central suivant : les modèles de langage actuels ne sont pas encore suffisamment adaptés à des environnements en temps réel qui exigent observation continue, décisions rapides et coordination multi-thread. Même le meilleur modèle : un simple débutant humain qui sait faire un « rush vitesse avec canons à photons » (une tactique d’attaque très élémentaire) peut gagner tous les matchs. Mais, à l’inverse, ces modèles sont déjà capables de comprendre les concepts de base : construire, miner, attaquer. Ils sont simplement très faibles dans l’exécution du rythme et la coordination de plusieurs tâches.
Le code du test et la plateforme de combat ont déjà été rendus publics : n’importe qui peut y emmener son propre agent et jouer une partie. L’adresse est : http://bw.swerdlow.dev.