

#inference
inference
1,600 vues
32 mentions
Populaire
Récents

⚡ LES CAPITAUX INSTITUTIONNELS CONSOLIDENT L’INFRASTRUCTURE DE L’IA ALORS QUE LA VITESSE D’INFÉRENCE SE DÉPLACE VERS $TAO 🔍
L’acquisition de Moondream par Prime Intellect témoigne d’un virage institutionnel vers une inférence à haut rendement et une exécution multimodale. 🦈 En s’assurant le moteur Photon — qui fournit plus de 60 inférences par seconde sur des unités matérielles individuelles — les capitaux avisés éliminent activement la latence dans des pipelines d’agents complexes. 📊
Cette opération marque une transition structurelle : on passe de modèles gigantesques à un débit opérationnel optimisé. 💡 À mesure que l’accélération de l’inférence devient la principale source de liquidité alimentant le déploiement de l’IA dans le monde réel, les capitaux prennent déjà position en amont. 🌊
🤔 La vitesse d’inférence optimisée déclenchera-t-elle la prochaine hausse durable des protocoles d’IA, ou les contraintes matérielles sont-elles encore mal évaluées ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours vos risques. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
1

·
--
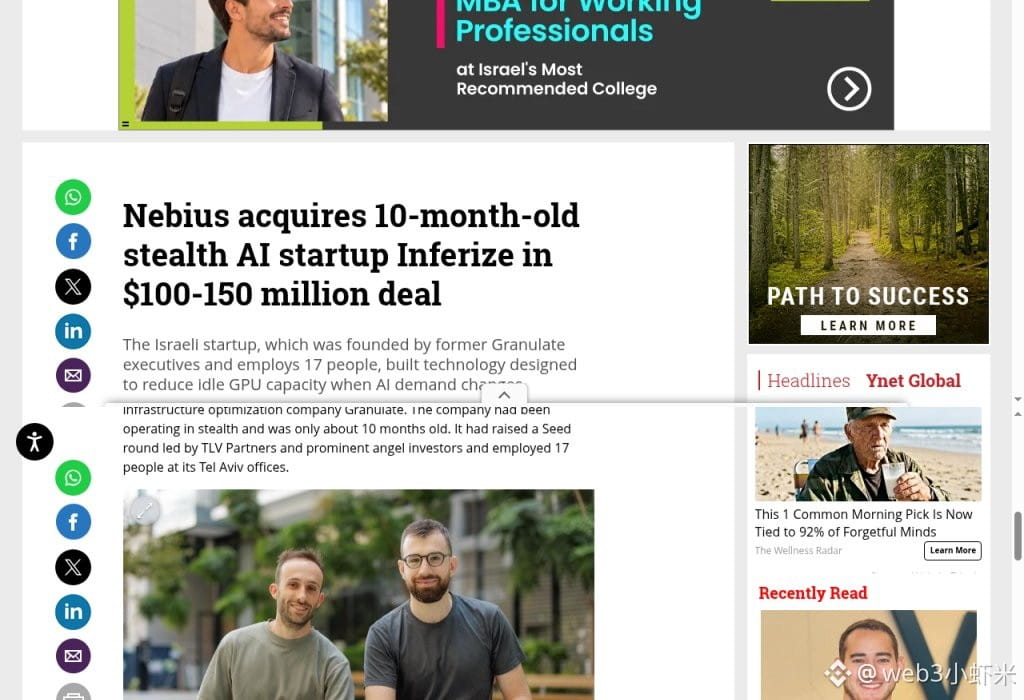
Je tombe sur CTech/Nebius : Nebius ($NBIS), société de cloud IA cotée au Nasdaq, a racheté Inferize, une start-up israélienne spécialisée dans l’optimisation de l’inférence, fondée il y a seulement une dizaine de mois. Les modalités de l’opération n’ont pas été officiellement divulguées ; CTech l’estime entre 100 et 150 millions de dollars.
Son objectif est très concret : supprimer cette « taxe GPU inutilisée » au démarrage à froid des modèles. Lors du chargement des poids, de la montée en charge ou du remplacement des poids en cours d’apprentissage par renforcement, les GPU tournent souvent à vide. Inferize veut ajuster les ressources de calcul au plus près de la demande réelle, afin d’améliorer le taux d’utilisation de la capacité de Token Factory et de réduire le coût par token. L’équipe compte environ 17 personnes. Son fondateur a dirigé Granulate, rachetée par Intel. Nebius indique que l’équipe et la technologie seront intégrées à sa plateforme d’inférence, qui s’est déjà enrichie des capacités d’Eigen AI et de Clarifai.
L’IA passe de l’entraînement au déploiement, et les fournisseurs de cloud étoffent peu à peu leur couche logicielle. Ces acquisitions ciblées d’infrastructures solides sont plus intéressantes que les belles histoires sans substance.
$NBIS #AI #Inference #Nebius
Je tombe sur CTech/Nebius : Nebius ($NBIS ), société de cloud IA cotée au Nasdaq, a racheté Inferize, une start-up israélienne spécialisée dans l’optimisation de l’inférence, fondée il y a seulement une dizaine de mois. Les modalités de l’opération n’ont pas été officiellement divulguées ; CTech l’estime entre 100 et 150 millions de dollars.
Son objectif est très concret : supprimer cette « taxe GPU inutilisée » au démarrage à froid des modèles. Lors du chargement des poids, de la montée en charge ou du remplacement des poids en cours d’apprentissage par renforcement, les GPU tournent souvent à vide. Inferize veut ajuster les ressources de calcul au plus près de la demande réelle, afin d’améliorer le taux d’utilisation de la capacité de Token Factory et de réduire le coût par token. L’équipe compte environ 17 personnes. Son fondateur a dirigé Granulate, rachetée par Intel. Nebius indique que l’équipe et la technologie seront intégrées à sa plateforme d’inférence, qui s’est déjà enrichie des capacités d’Eigen AI et de Clarifai.
L’IA passe de l’entraînement au déploiement, et les fournisseurs de cloud étoffent peu à peu leur couche logicielle. Ces acquisitions ciblées d’infrastructures solides sont plus intéressantes que les belles histoires sans substance.
$NBIS #AI #Inference #Nebius
407

·
--
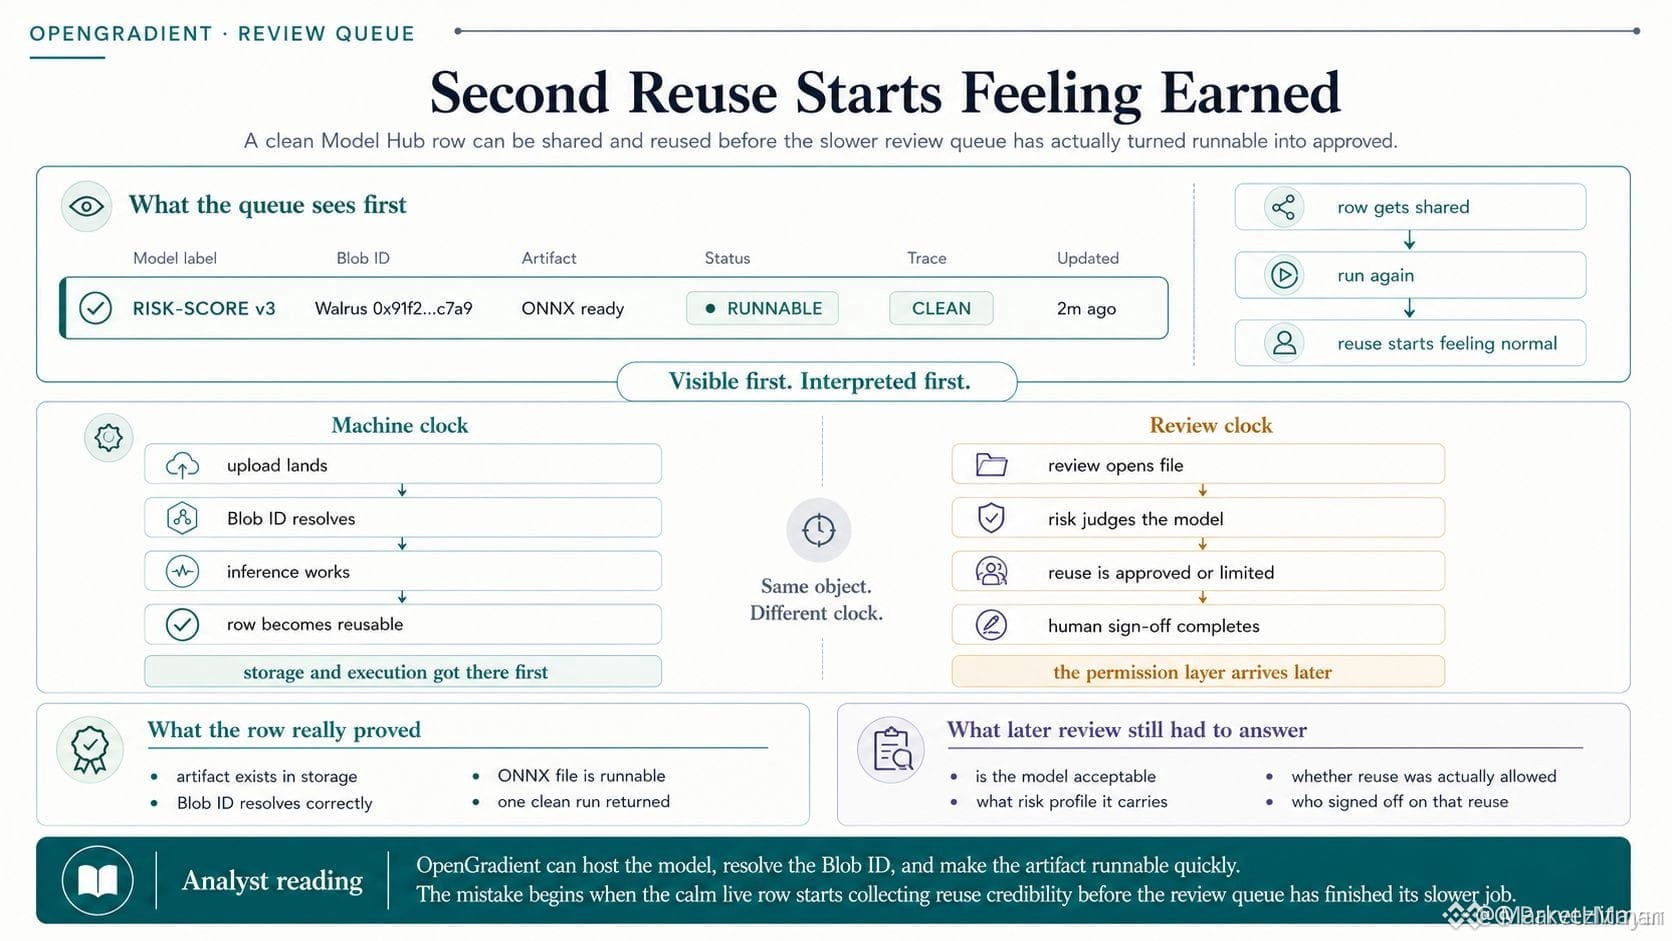
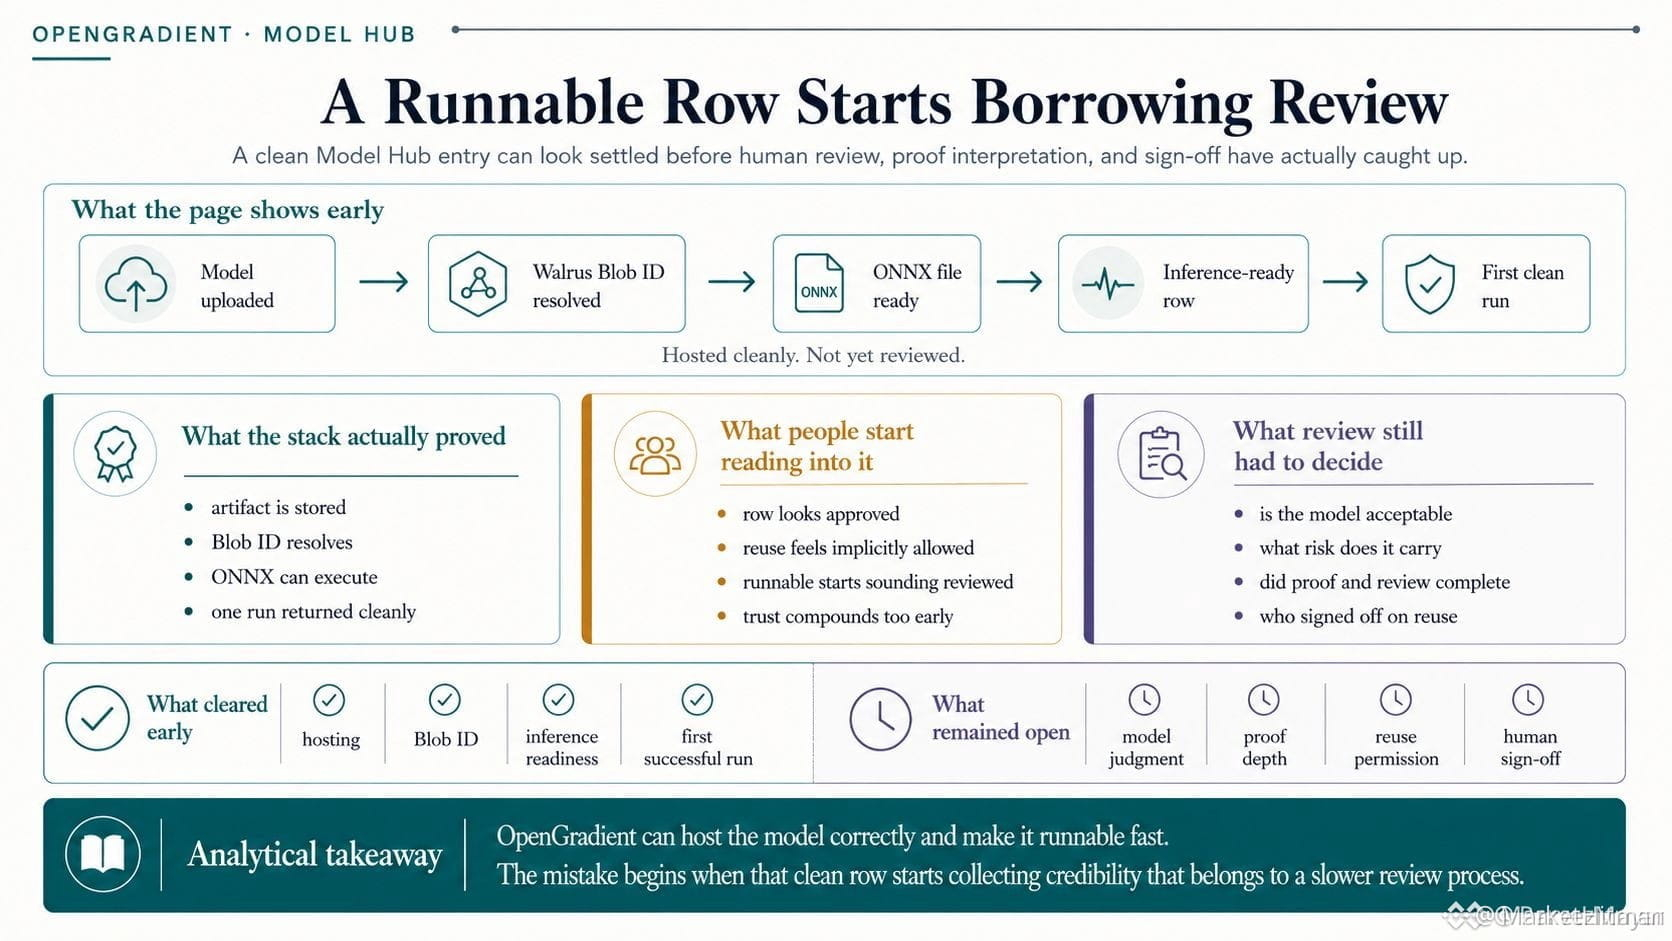
$OPG INFERENCE RUNS AHEAD OF THE REVIEW QUEUE 🔥
Une ligne de modèle sur OpenGradient Model Hub est vérifiée en quelques secondes — traçage propre, ID de blob Walrus prêt, fichier ONNX en ligne. Mais la revue humaine prend du retard. À la troisième réutilisation, cette ligne commence à agir comme si elle avait déjà été revue avant même d’avoir obtenu la validation. Le système fonctionne parfaitement. Le processus, lui, ne suit pas.
Ce décalage entre l’efficacité de la machine et la supervision humaine crée une zone aveugle. Le modèle était solide, mais a-t-il été réellement vérifié ? Faire passer la vitesse avant l’ordre est un avantage discret — ou une fuite discrète.
Faites-vous tourner des modèles qui ont passé la machine, mais ont sauté la validation humaine ?
Ce n’est pas un conseil financier. Gérez toujours votre risque.
#OPG #ModelHub #Inference #CryptoAI
🔥
19

$AI INFERENCE LA MÉMOIRE POURRAIT DEVENIR LE PROCHAIN GROS GOULET D’ÉTRANGLEMENT DANS LA CRYPTO ET L’IA 💎
L’analyste de Critini Research, Jukan, réfute la vision baissière concernant l’avenir de Micron. Il affirme qu’à l’étape de l’inférence en IA, ajouter de la mémoire est plus utile qu’ajouter des GPU. Le problème tient simplement au fait que l’empilement de GPU NVIDIA n’améliore pas les performances d’inférence, car les GPU sont souvent inactifs à cause des goulets d’étranglement liés à la mémoire. Le ROI ultime pour l’inférence dépend davantage de la mémoire que des GPU.
Cela fait évoluer le récit du calcul vers la mémoire—et c’est précisément là que les projets crypto axés sur le stockage décentralisé et la bande passante mémoire pourraient voir un changement de paradigme dans la valeur. Êtes-vous prêt pour ce basculement ?
Ce n’est pas un conseil financier. Gérez toujours votre risque.
#AI #Memory #Inference #CryptoNarratives
💎
29
·
--
Tout le monde pense que l’écosystème $BNB ne bouge que grâce aux mises à niveau sur la blockchain.
La diplomatie mondiale au Moyen-Orient détourne discrètement la puissance de calcul loin des grappes de nœuds. Quand des startups d’IA rencontrent des frictions dans la chaîne d’approvisionnement, des réseaux décentralisés se disputent les mêmes miettes de silicium. Surveillez le coût des nœuds RPC comme indicateur principal du stress matériel local.
$BNB $ETH #CryptoInfra #TechTrends #Inference
57
·
--
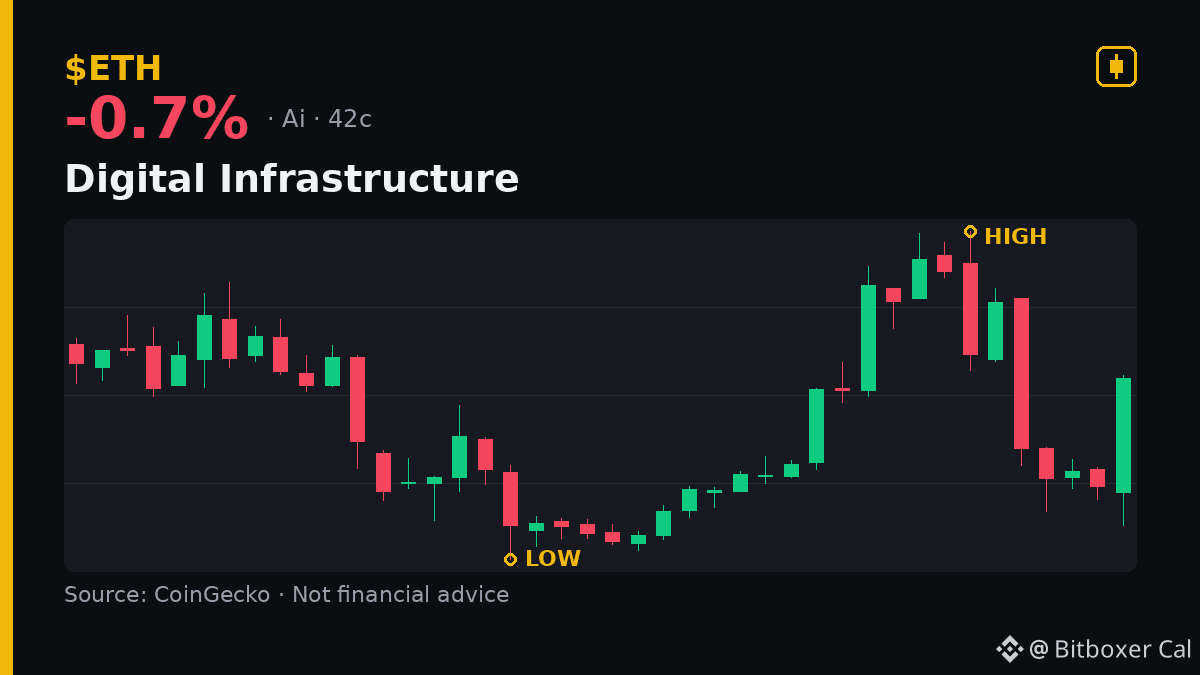
On nous dit que l’IA n’est rien d’autre qu’une course aux armements en matière de matériel.
C’est une distraction. Des entreprises comme Mandela Digital prouvent que la résilience logicielle compte davantage que la puissance de calcul brute. Tout comme un moteur puissant a besoin d’un châssis solide, les applications financières sur ETH ou BTC exigent des données prévisibles — qu’elles tournent sur des puces de pointe ou sur un matériel plus ancien.
$ETH $BTC #AI #CryptoAI #Inference
69
·
--
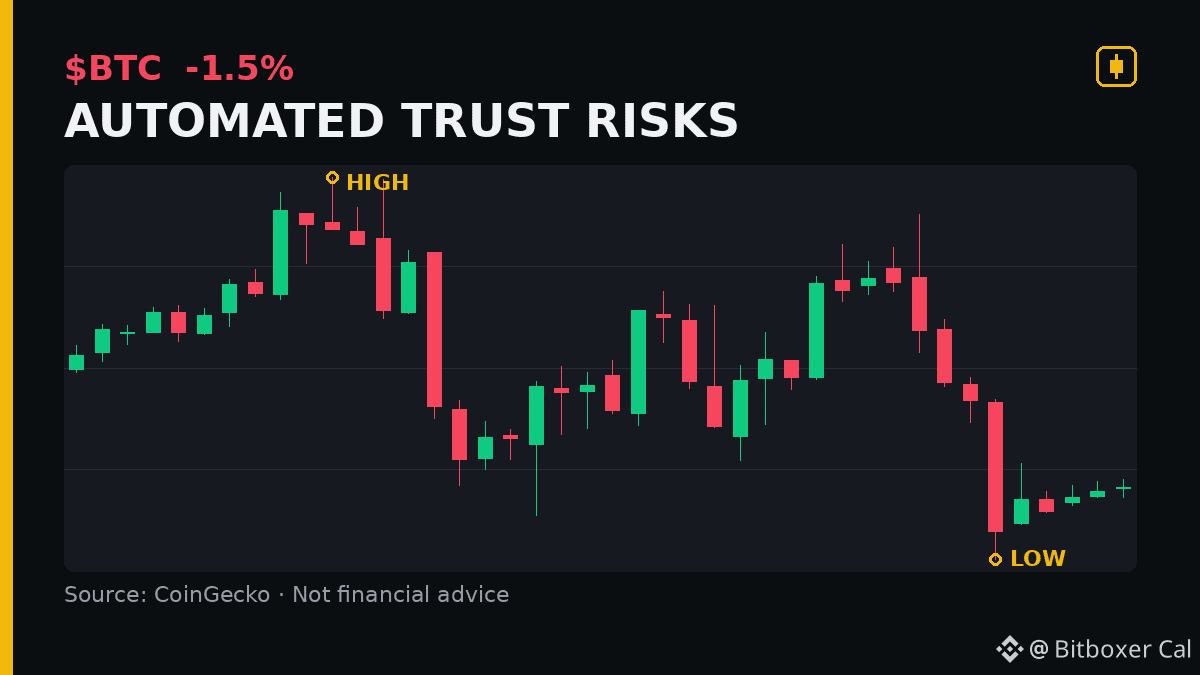
Les optimistes veulent que des algorithmes gèrent les trésors nationaux en Bitcoin, parce qu’ils pensent que les mathématiques sont à l’abri de l’ego.
Ils oublient que le code n’a pas de bilan pour régler des dettes quand les choses se brisent. Confier une logique opaque, non corrigeable, revient simplement à remplacer l’erreur humaine par une machine qu’on ne peut pas tenir responsable. Si le modèle hallucine, l’entité qui s’appuie sur l’écosystème se retrouve avec rien d’autre qu’une défaillance du système.
$BTC $BNB #cryptoeducation #AI #Inference
78

·
--
🚀 $AI RIPL RÉDUIT LA LATENCE D’INFÉRENCE DE 14× – L’EDGE EN TEMPS RÉEL REPENSÉ ! 📈
📊 Le moteur RIPL de Liquid AI réduit la latence du LFM2.5, avec ses 1,2 milliard de paramètres, à 34,6 ms sur un seul NVIDIA B200, en traitant 95 % des 1 000 requêtes par seconde dans ce délai. ⚡ Face aux 498 ms de vLLM, l’écart atteint 14,4×, ce qui confère un avantage décisif en matière de vitesse pour le classement des résultats de recherche et la gestion des risques de paiement.
🦈 Cette accélération transforme les modèles de langage en outils agiles de première ligne, permettant aux institutions de saisir les opportunités de liquidité avant que les flux d’ordres ne se stabilisent. 💡 Attendez-vous à une vague d’adoption rapide, les entreprises cherchant à tirer parti de cet avantage en matière de latence pour devancer leurs rivales dans les boucles de décision en temps réel. 💬 Comment cet avantage de vitesse va-t-il transformer votre stratégie d’IA en temps réel ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours vos risques. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
4
·
--
PRIME INFERENCE RÉVÈLE UNE AVANCÉE DE LATENCE AU DELÀ D’UN TRILLION DE JETONS POUR $AI INFRASTRUCTURE ⚡ 📊
Prime Intellect a lancé Prime Inference, traitant près d’1 trillion de jetons par jour tout en réduisant de 40% la latence p90 entre les jetons pour des charges de travail d’agents complexes. 📊 En séparant le traitement des prompts et la génération de réponses sur des GPUs distincts, le système optimise l’efficacité de calcul à l’échelle institutionnelle.
Avec une expansion de 50% de la capacité du cache KV, jusqu’à 1,63 M de jetons par décodeur, cette pile open source relie sans rupture l’entraînement des modèles à l’exécution en temps réel. 💡 Les données opérationnelles bouclent en continu vers des pipelines d’apprentissage par renforcement, faisant de l’efficacité brute de l’inférence le critère de performance concurrentielle déterminant. 🔍
💬 Voyez-vous l’optimisation open source de l’inférence accélérer le déploiement d’agents décentralisés, ou bien les hubs de calcul propriétaires conserveront-ils leur avance ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
93
·
--
$CRBR DEFINIT LE LANCEMENT DE GPT-5.6 À 750 TOKENS/S EN JUILLET 🚀
Entrée : $170 🔥
La confirmation de Serenity selon laquelle OpenAI déploiera le modèle frontier GPT-5.6 Sol sur le matériel de Cerebras est un catalyseur direct pour le titre. La vitesse d’inférence de 750 tokens/seconde crée un avantage concurrentiel tangible face aux architectures basées sur GPU. Le rachat de Serenity à $170 souligne leur conviction, mais ils indiquent aussi que l’évaluation actuelle est légèrement surélevée par rapport à des pairs comme JBL.
La question clé est de savoir si le marché a déjà pleinement intégré la prime liée au partenariat, ou si un volume soutenu peut faire entrer le titre dans une nouvelle fourchette. Votre objectif ici — $200 ou d’abord un repli ?
Ce n’est pas un conseil financier. Gérez toujours votre risque.
#CRBR #AI #Hardware #Inference #Breakout
🎯
17
$NVDA La demande pour l'inférence AI est toujours en pleine effervescence ⚡
Citigroup indique que la rareté ne concerne plus seulement les toutes dernières puces. Cela s'étend maintenant aux anciennes GPU, aux centres de données, à l'accès à l'énergie, et au niveau de routage qui décide quel modèle et quel matériel utiliser.
Cela compte car la prochaine étape de la valeur AI pourrait ne pas résider uniquement dans le calcul. Le marché commence à évaluer l'ensemble de l'infrastructure, des réseaux optiques aux couches cloud et applicatives.
Ce n'est pas un conseil financier. Gérez votre risque.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
16
$CERVEUX À $170 ÉTAIT L’ENTRÉE D’INITIÉ – MAINTENANT OPENAI CONFIRME 🔥
Entrée : 170 🔥
OpenAI lance GPT‑5.6 sur du matériel Cerebras le mois prochain, avec un débit de 750 tokens par seconde. Ce n’est pas une rumeur : c’est une validation directe de leur pile d’inférence. Serenity, qui a acheté à 170 $, voit toujours un potentiel à long terme malgré la prime actuelle.
Le récit sur l’infrastructure s’intensifie, et Cerebras est au cœur de tout cela. La question maintenant est de savoir si le marché intègre pleinement ce catalyseur ou s’il reste encore de la marge pour monter. Vous attendez un repli ou vous chargez ici ?
Ce n’est pas un conseil financier. Gérez toujours votre risque.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
28

AMAZON AUGMENTE SON CAPEX À 220 MILLIARDS DE $ — LE BESOIN EN INFÉRENCE EST LE MOMENT DE $FET 'S 🦈 💥
Le cycle de l’IA vient de changer de phase. L’entraînement n’était que l’échauffement — l’inférence est là que la vraie puissance de calcul se consomme. Le directeur du cloud d’Amazon dit que les clients en ont fini avec l’expérimentation ; ils connectent leurs modèles directement à des flux de travail de production. C’est une courbe de demande qui remonte fortement. 📊
Désormais, l’AWS relève son plafond de capex à 220 milliards de dollars d’ici 2026. Ce n’est pas une simple erreur d’arrondi — c’est des hyperscalers qui parient sur l’infrastructure la plus importante de cette décennie pour alimenter les moteurs d’inférence. Quand les géants de web2 se battent pour la rareté de la puissance de calcul, le récit de l’IA décentralisée gagne sa place à la table. 💡
Le marché réévalue encore quels tokens héritent de cette demande. L’élan a tendance à prendre du retard par rapport au récit jusqu’à ce que la première percée majeure le confirme. 🔍 Quel projet d’IA dans votre portefeuille a la meilleure histoire d’inférence concrète ? 💬
⚠️ Ce n’est pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
135
·
--
ZHIPU DÉMOLIT LES BARRIÈRES DE VITESSE AVEC GLM-5.3-FLASHX EN ALLUMANT LA PROCHAINE RASSEMBLEMENT DE $AI INFRASTRUCTURES ! ⚡ 🚀
Le passage à l’échelle du calcul de l’IA vient d’atteindre le mode hyperdrive : Zhipu révèle GLM-5.3-FlashX, libérant un débit stupéfiant de 200 tokens par seconde. ⚡ Propulsé par des agents d’infrastructure internes optimisant plus de 100 000 puces spécialisées, les vitesses de traitement de bout en bout ont triplé en moins de deux semaines.
Cette accélération brute du débit annonce un tournant majeur vers une exécution de modèles hyper-efficace à travers le paysage décentralisé de l’intelligence. 📊 À mesure que la vitesse d’inférence brute devient le fossé ultime, un capital intelligent anticipe discrètement la thèse du goulot d’étranglement infrastructurel. 💡
💬 Des moteurs d’inférence à haute vélocité déclencheront-ils la prochaine grande vague de valorisation pour les tokens d’IA ce trimestre ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
55
LA RÉDUCTION DE COÛTS DE 70 % QUI TRANSFORME LE CODAGE IA DE LA LOCATION EN ACTIF DÉTENu — $AMD 🦈 💥
AMD vient de lancer une pile groupée directement à l’entreprise : silicium EPYC, GPU Instinct, serveurs Supermicro, PaletteAI de Spectro Cloud et GLM-5.2 — avec un copilote on-prem préintégré dans une boîte. 🎯 Le chiffre clé qui compte : jusqu’à 70 % de coûts totaux en moins vs les modèles de pointe du cloud, avec un retour sur investissement en capital aussi rapide que six mois.
Le coup de maître tient à l’acheminement piloté par des politiques — PaletteAI bascule automatiquement entre l’inférence on-prem et les modèles cloud d’Anthropic, OpenAI, Google ou xAI à la demande, avec des quotas de tokens, des journaux d’audit et des tableaux de bord Grafana qui révèlent l’écart de coûts réel en temps réel. 🔍
On passe ici un codage IA de la location facturée à une infrastructure prévisible — un jeu de souveraineté qui fait écho à l’état d’esprit de la self-custody. 💬 Les entreprises vont-elles continuer à louer des modèles de pointe ou commencer à posséder la puissance de calcul ? 👇
⚠️ Ceci n’est pas un conseil financier. Gérez toujours vos risques. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
90
·
--
🚨 $NVDA SHIFTS INSTITUTIONAL FOCUS TO AGENTIC AI INFERENCE EFFICIENCY! 🧠
Nvidia a officiellement déclenché la production de masse pour l’accélérateur Groq 3 LPX, marquant une rotation structurelle clé : on passe de l’entraînement pur des modèles à une exécution continue. 🦈 Les grands opérateurs d’infrastructure se heurtent directement à des limites de puissance, forçant les capitaux intelligents à se tourner vers des architectures à haute efficacité pour des charges de travail d’IA agentique multi-étapes. 📊
Cette transition fait passer l’indicateur opérationnel de référence de la capacité de traitement brute à l’efficacité optimisée en calcul par watt. 🔍 À mesure que l’inférence live persistante remplace l’entraînement statique des modèles, la conception matérielle soucieuse de l’énergie devient l’avantage déterminant à l’échelle institutionnelle. 💡
🤔 Les contraintes de puissance vont-elles forcer cette année une réévaluation majeure des valorisations dans les secteurs du calcul haute performance ? 👇
⚠️ Ceci n’est pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
18
·
--
🚨 $AI INFERENCE SHIFT : PARI DE 200 M€ CONTRE LE MONOPOLE DES GPU ⚡
La levée de fonds Série A de 200 M€ d’Euclyd, co-dirigée par Samsung, EQT et Somerset, constitue un vote structurel en faveur de l’inférence IA comme prochain goulot d’étranglement. 📊 Ses 16 384 processeurs mémoire et sa feuille de route de 2028 en exaflops visent la couche d’efficacité énergétique où les GPU pourraient être vulnérables.
⚡ Le point clé : l’efficacité 100x attribuée à Nvidia reste une projection, et non une preuve commerciale. C’est précisément cet écart entre ambition et vérification que la « smart money » surveille pour repérer des catalyseurs. 💬 Est-ce le début d’un nouveau cycle de matériel IA, ou encore un récit non prouvé ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
39
·
--
Le prochain rapport de SpaceX est bien plus qu’une simple actualité d’entreprise ; il met en lumière l’affrontement entre des « boîtes noires » privées et l’ethos $ETH and $BTC .
Les sociétés centralisées exigent une confiance aveugle dans les calculs du conseil d’administration. Les protocoles décentralisés obligent le code à prouver chaque affirmation. Des audits indépendants de votre propre bilan sont la seule façon de garantir une sécurité réelle sur ce marché.
$ETH $BTC #Web3 #Inference #DeFi
65

·
--
⚡ $FET AI INFERENCE BOTTENECK PIVOTE VERS LA BANDE PASSANTE MÉMOIRE À MESURE QUE LES INSTITUTIONS RESTRUCTURENT LEUR INFRASTRUCTURE ! 📊
Les besoins en calcul institutionnel évoluent de manière spectaculaire : on passe d’une simple capacité mémoire brute à une orchestration de bande passante hyper-efficace. 📊 Avec l’architecture MoE qui s’impose, la vitesse de routage entre les pipelines de Prefill et de Decode est devenue le goulot d’étranglement central pour l’infrastructure matérielle de nouvelle génération.
La planification du cache KV par niveaux et le débit de bande passante déterminent désormais l’efficacité des clusters, plutôt que la simple densité matérielle brute. 🔍 Le “smart capital” se positionne autour de protocoles d’infrastructure qui optimisent l’overhead lié au déplacement des données avant la prochaine expansion de l’échelle.
💡 Les architectures de nœuds désagrégées forcent une refonte complète des stratégies d’allocation du matériel dans les institutions. 💬 Les protocoles d’optimisation de la bande passante sauront-ils capter la prochaine rotation structurelle du calcul décentralisé ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
239

·
--
$AI Les Coûts d'Infrastructure Augmentent Alors que la Demande d'Inférence S'intensifie ⚡
Citigroup annonce que la demande d'inférence IA reste toujours forte, et la pression ne se limite plus seulement aux derniers chips. La rareté s'étend aux GPUs, aux centres de données, à l'accès à l'énergie et aux couches de routage, ce qui signifie que le marché évalue désormais l'ensemble de la pile, pas seulement les semi-conducteurs.
Le point clé à retenir est structurel : les fournisseurs de modèles monétisent plus rapidement, tandis que les goulets d'étranglement de l'infrastructure deviennent la véritable contrainte. Si cette tendance se poursuit, la valeur pourrait continuer à se déplacer vers les couches qui aident à réduire le coût d'inférence et à allouer le calcul plus efficacement.
Ce n'est pas un conseil financier. Gérez votre risque.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
64
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
1
#BinanceProcesses$4.65BWithdrawals
8,567 vues
75 mentions
2
#WithdrawalsBack: 15 networks live
5,297 vues
110 mentions
3
#BinanceUpdatesProofofReservesAddresses
94,489 vues
1,363 mentions
4
#BinanceToResumePhaseOneOfWithdrawals
133,785 vues
1,488 mentions
5
#BinanceHadAlreadyCovered$6BofHackLoss
9,085 vues
130 mentions
6
#FBIConfirmsNorthKoreaIsResponsibleForBinanceCryptoHack
45,244 vues
141 mentions
7
#CZDismissesClaimsBinanceHackWasPredicted
65,866 vues
673 mentions
8
#B14gReportsUnauthorizedTransferOfAbout97MCORE
21,605 vues
329 mentions
9
#USSpotETHETFsPost23StraightDaysOfNetOutflows
25,147 vues
306 mentions
10
#IntelHasItsWorstDaySince1974
116,429 vues
921 mentions