
sopleat
658 Beiträge
sopleat
Melden
Nutzer blockieren
一个 05 年 Web3 新人,持续记录自己如何理解项目、产品、用户需求和信息流机会。
Trade eröffnen
Regelmäßiger Trader
1.2 Jahre
79 Following
148 Follower
609 Like gegeben
Beiträge
Portfolio
Alle
Zitierungen
·
--
#dusk $DUSK @Dusk_Foundation Man muss es einmal bestätigen, aber dann dreimal hintereinander den Bestätigen-Button drücken, und außerdem muss man Gas in beiden Netzwerken vorsehen. Die erste Reaktion von normalen Nutzern ist nicht etwa „Cross-Layer-Sicherheit ist wirklich so streng“, sondern eher: „Ist mein Geld feststeckengeblieben?“
Ich habe die aktuelle DuskEVM-Bridging-Anleitung zu @Dusk_Foundation geprüft. Erstmal die wichtigsten Punkte: Die offizielle Seite beschreibt das Testnetz. Testcoins haben keinen realen Wert und dürfen nicht so vorab formuliert werden, als wäre das im Mainnet schon durchgelaufen.
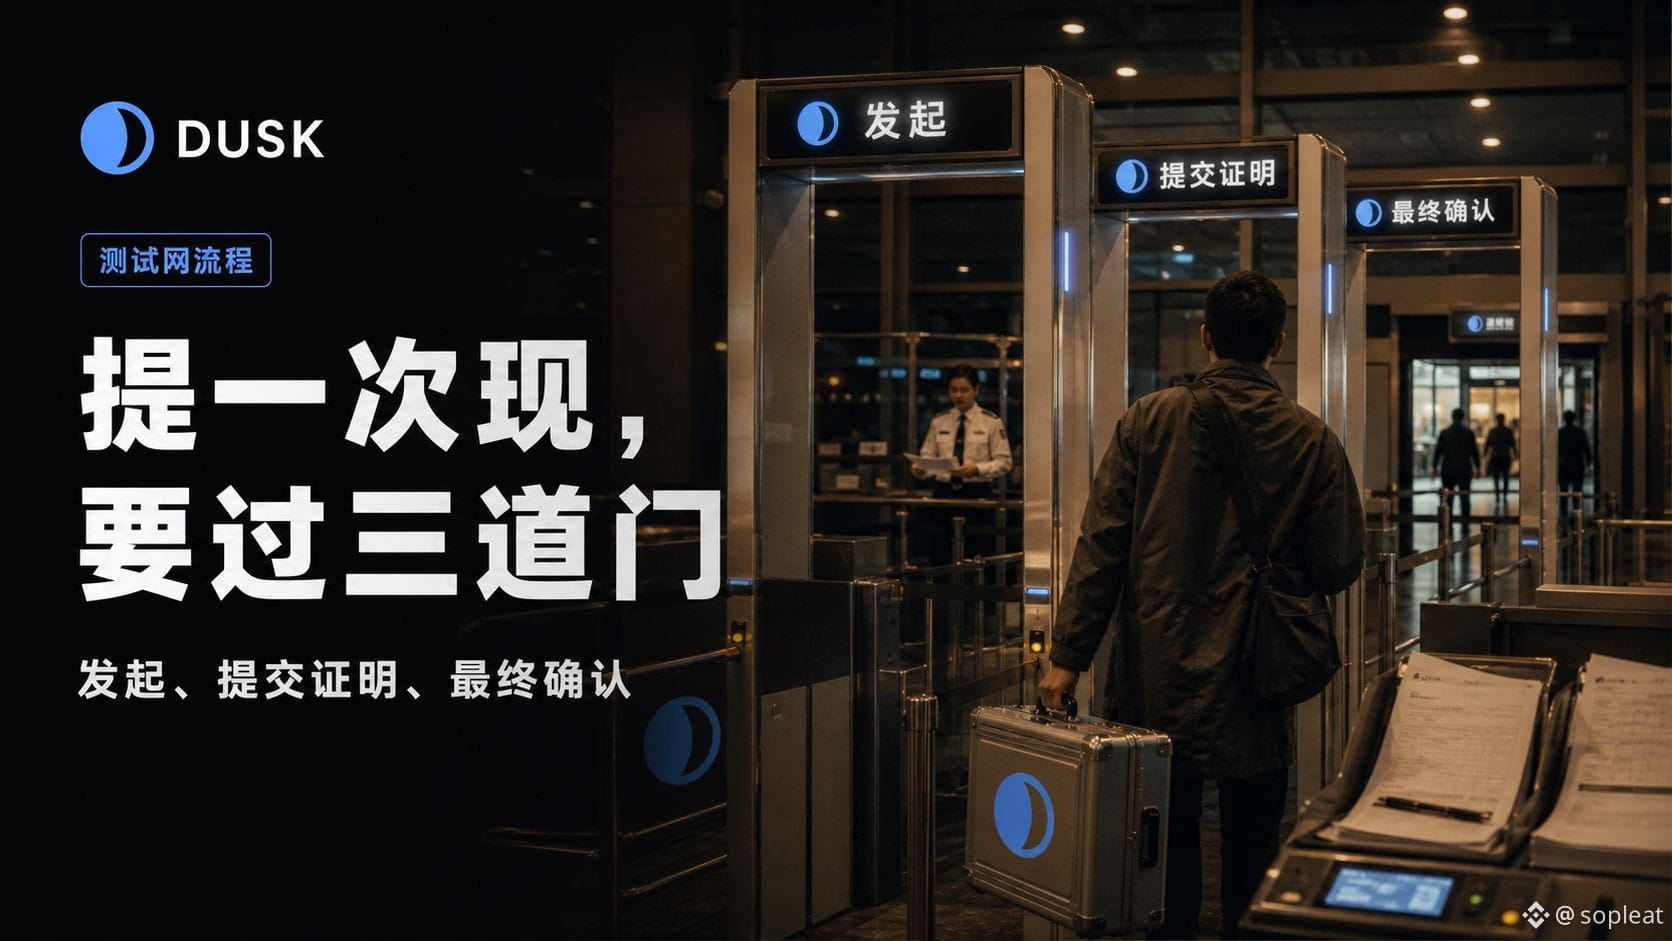
Der Ablauf ist vergleichsweise direkt: Auf Dusk L1 die Transaktion einreichen und dann warten, bis das Guthaben in DuskEVM ankommt; die Zustände beider Ebenen werden nicht gleichzeitig aktualisiert. Beim Ausstieg erst in DuskEVM starten, dann – wenn die Wallet „Nachweis möglich“ anzeigt – auf L1 den Nachweis einreichen; danach erneut warten, bis „Endgültige Bestätigung“ möglich ist, und dann eine L1-Transaktion senden, um DUSK freizugeben.
Ein Ausstieg umfasst drei On-Chain-Aktionen: Initiierung, Nachweis und endgültige Bestätigung. Neben den Quellketten-Gebühren müssen auch zwei L1-Gebühren vorbereitet werden, und man muss nicht privatisiertes DUSK verwenden. Wenn man das gesamte L1-Guthaben in die EVM überträgt, kann das Asset wegen fehlendem Gas auf halbem Weg stecken bleiben.
Warum kann man nicht einfach einmal alles freigeben? DuskEVM führt die Ausführung aus, und Dusk L1 übernimmt den Nachweis sowie die endgültige Freigabe. Das System muss warten, bis Zustände veröffentlicht sind, der Nachweis „reif“ ist und Prüfungen auf Streitfälle abgeschlossen sind, damit das Ausführungsergebnis von der Abrechnungsebene akzeptiert werden kann. Der Preis dafür sind Zeit, Bedienaufwand und die Bindung von Liquidität.
Für Institutionen ist das noch umständlicher. Wenn in der EVM Vermögenswerte abgezogen werden, bedeutet das nicht, dass sie in L1 bereits angekommen sind; das Finanzsystem darf „Initiierung erfolgreich“ nicht als „Auszahlung abgeschlossen“ verbuchen. Es muss Transaktionshash, Nachweisstatus, endgültige Bestätigung und die drei Gebühren genau abgleichen. Sonst entsteht in der Buchhaltung ein Zeitfenster „ausstehend zur Abrechnung“.
Darum verfolge ich vier Punkte: die mittlere Verweilzeit beim Ausstieg, den Anteil der Transaktionen, die in den einzelnen Phasen hängen bleiben, die Gesamtkosten der drei Aktionen und ob man nach einem Scheitern verlustfrei wiederherstellen kann. $DUSK sind native Assets und Gas auf beiden Seiten – aber ob Nutzer einsteigen, hängt davon ab, ob der Ausstieg überhaupt verstanden werden kann und ob sich das auch vollständig in das Buchhaltungsbuch der Institutionen nachprüfen lässt.
#dusk
#dusk $DUSK @Dusk Man muss es einmal bestätigen, aber dann dreimal hintereinander den Bestätigen-Button drücken, und außerdem muss man Gas in beiden Netzwerken vorsehen. Die erste Reaktion von normalen Nutzern ist nicht etwa „Cross-Layer-Sicherheit ist wirklich so streng“, sondern eher: „Ist mein Geld feststeckengeblieben?“
Ich habe die aktuelle DuskEVM-Bridging-Anleitung zu @Dusk geprüft. Erstmal die wichtigsten Punkte: Die offizielle Seite beschreibt das Testnetz. Testcoins haben keinen realen Wert und dürfen nicht so vorab formuliert werden, als wäre das im Mainnet schon durchgelaufen.
Der Ablauf ist vergleichsweise direkt: Auf Dusk L1 die Transaktion einreichen und dann warten, bis das Guthaben in DuskEVM ankommt; die Zustände beider Ebenen werden nicht gleichzeitig aktualisiert. Beim Ausstieg erst in DuskEVM starten, dann – wenn die Wallet „Nachweis möglich“ anzeigt – auf L1 den Nachweis einreichen; danach erneut warten, bis „Endgültige Bestätigung“ möglich ist, und dann eine L1-Transaktion senden, um DUSK freizugeben.
Ein Ausstieg umfasst drei On-Chain-Aktionen: Initiierung, Nachweis und endgültige Bestätigung. Neben den Quellketten-Gebühren müssen auch zwei L1-Gebühren vorbereitet werden, und man muss nicht privatisiertes DUSK verwenden. Wenn man das gesamte L1-Guthaben in die EVM überträgt, kann das Asset wegen fehlendem Gas auf halbem Weg stecken bleiben.
Warum kann man nicht einfach einmal alles freigeben? DuskEVM führt die Ausführung aus, und Dusk L1 übernimmt den Nachweis sowie die endgültige Freigabe. Das System muss warten, bis Zustände veröffentlicht sind, der Nachweis „reif“ ist und Prüfungen auf Streitfälle abgeschlossen sind, damit das Ausführungsergebnis von der Abrechnungsebene akzeptiert werden kann. Der Preis dafür sind Zeit, Bedienaufwand und die Bindung von Liquidität.
Für Institutionen ist das noch umständlicher. Wenn in der EVM Vermögenswerte abgezogen werden, bedeutet das nicht, dass sie in L1 bereits angekommen sind; das Finanzsystem darf „Initiierung erfolgreich“ nicht als „Auszahlung abgeschlossen“ verbuchen. Es muss Transaktionshash, Nachweisstatus, endgültige Bestätigung und die drei Gebühren genau abgleichen. Sonst entsteht in der Buchhaltung ein Zeitfenster „ausstehend zur Abrechnung“.
Darum verfolge ich vier Punkte: die mittlere Verweilzeit beim Ausstieg, den Anteil der Transaktionen, die in den einzelnen Phasen hängen bleiben, die Gesamtkosten der drei Aktionen und ob man nach einem Scheitern verlustfrei wiederherstellen kann. $DUSK sind native Assets und Gas auf beiden Seiten – aber ob Nutzer einsteigen, hängt davon ab, ob der Ausstieg überhaupt verstanden werden kann und ob sich das auch vollständig in das Buchhaltungsbuch der Institutionen nachprüfen lässt.
#dusk
Ich habe die aktuelle DuskEVM-Bridging-Anleitung zu @Dusk geprüft. Erstmal die wichtigsten Punkte: Die offizielle Seite beschreibt das Testnetz. Testcoins haben keinen realen Wert und dürfen nicht so vorab formuliert werden, als wäre das im Mainnet schon durchgelaufen.
Der Ablauf ist vergleichsweise direkt: Auf Dusk L1 die Transaktion einreichen und dann warten, bis das Guthaben in DuskEVM ankommt; die Zustände beider Ebenen werden nicht gleichzeitig aktualisiert. Beim Ausstieg erst in DuskEVM starten, dann – wenn die Wallet „Nachweis möglich“ anzeigt – auf L1 den Nachweis einreichen; danach erneut warten, bis „Endgültige Bestätigung“ möglich ist, und dann eine L1-Transaktion senden, um DUSK freizugeben.
Ein Ausstieg umfasst drei On-Chain-Aktionen: Initiierung, Nachweis und endgültige Bestätigung. Neben den Quellketten-Gebühren müssen auch zwei L1-Gebühren vorbereitet werden, und man muss nicht privatisiertes DUSK verwenden. Wenn man das gesamte L1-Guthaben in die EVM überträgt, kann das Asset wegen fehlendem Gas auf halbem Weg stecken bleiben.
Warum kann man nicht einfach einmal alles freigeben? DuskEVM führt die Ausführung aus, und Dusk L1 übernimmt den Nachweis sowie die endgültige Freigabe. Das System muss warten, bis Zustände veröffentlicht sind, der Nachweis „reif“ ist und Prüfungen auf Streitfälle abgeschlossen sind, damit das Ausführungsergebnis von der Abrechnungsebene akzeptiert werden kann. Der Preis dafür sind Zeit, Bedienaufwand und die Bindung von Liquidität.
Für Institutionen ist das noch umständlicher. Wenn in der EVM Vermögenswerte abgezogen werden, bedeutet das nicht, dass sie in L1 bereits angekommen sind; das Finanzsystem darf „Initiierung erfolgreich“ nicht als „Auszahlung abgeschlossen“ verbuchen. Es muss Transaktionshash, Nachweisstatus, endgültige Bestätigung und die drei Gebühren genau abgleichen. Sonst entsteht in der Buchhaltung ein Zeitfenster „ausstehend zur Abrechnung“.
Darum verfolge ich vier Punkte: die mittlere Verweilzeit beim Ausstieg, den Anteil der Transaktionen, die in den einzelnen Phasen hängen bleiben, die Gesamtkosten der drei Aktionen und ob man nach einem Scheitern verlustfrei wiederherstellen kann. $DUSK sind native Assets und Gas auf beiden Seiten – aber ob Nutzer einsteigen, hängt davon ab, ob der Ausstieg überhaupt verstanden werden kann und ob sich das auch vollständig in das Buchhaltungsbuch der Institutionen nachprüfen lässt.
#dusk
1
2
119
·
--
Das gefährlichste Ergebnis ist nicht unbedingt, dass sich Knoten gegenseitig bekämpfen, sondern dass alle Knoten dieselbe Menge an Verifikationscode aufrufen und dann sauber und ordentlich einen Fehler prüfen.
Ich habe die historischen Whitepaper von @Dusk_Foundation mit der aktuellen Dokumentation abgeglichen. Frühere Unterlagen nennen diese Rust/WASM-Laufzeit Piecrust; die aktuelle Doku verwendet stattdessen DuskVM. Der Name hat sich weiterentwickelt, aber das Kerndesign ist gleich geblieben: Verträge können kryptografische Verifikationen wie PLONK, Groth16, BLS usw. an die öffentliche Einstiegsschicht des Hosts delegieren, statt alles jeweils selbst zu implementieren.
Die Vorteile sind ganz real. Entwickler müssen weniger fehleranfälligen Kryptocode schreiben, und Knoten müssen die grundlegenden Rechenoperationen nicht mehrfach in der WASM-Sandbox wiederholen; das macht Anwendungen leichter und die Verifikationsregeln lassen sich leichter vereinheitlichen.
Die Kosten konzentrieren sich ebenfalls. Wenn ein Anwendungs-Contract falsch geschrieben ist, trifft es zuerst sich selbst; wenn ein gemeinsam genutzter Verifikator bei der Eingabeanalyse, der Versionsauswahl oder bei Randbedingungen einen Fehler macht, können alle von ihm abhängigen Verträge betroffen sein. Im gesamten Netzwerk ist dann alles konsistent – man kann lediglich beweisen, dass alle dieselbe Regel ausgeführt haben.
Dusk hat im Aegis-Upgrade im März 2026 PLONK V3 und ein neues BLS-Verhalten aktiviert, und auch die BLS-Host-Queries, die Verträge nutzen, werden je nach Blockhöhe umgeschaltet. Historische Blöcke rufen den alten Verifikator auf, neue Daten verwenden die neue Version; wenn die Höhe falsch gewählt wird, können Transaktionen unter Umständen zu unterschiedlichen Ergebnissen hinsichtlich ihrer Gültigkeit führen.
Darum werde ich nicht nur die Auditberichte zählen, sondern auch auf die Verifikator-Version, die Upgrade-Höhe, Testvektoren, Cache-Invalidierungen und Rollback-Übungen achten. $DUSK trägt Gas und Konsenssicherheit, aber diese öffentlichen Verifikations-Einstiegspunkte stützen auch die Finanzanwendungen. Geschwindigkeit bestimmt, wie schnell das System laufen kann, und der Verifikator entscheidet, ob es auch Fehler schneller mit ausführt.
#dusk
Das gefährlichste Ergebnis ist nicht unbedingt, dass sich Knoten gegenseitig bekämpfen, sondern dass alle Knoten dieselbe Menge an Verifikationscode aufrufen und dann sauber und ordentlich einen Fehler prüfen.
Ich habe die historischen Whitepaper von @Dusk mit der aktuellen Dokumentation abgeglichen. Frühere Unterlagen nennen diese Rust/WASM-Laufzeit Piecrust; die aktuelle Doku verwendet stattdessen DuskVM. Der Name hat sich weiterentwickelt, aber das Kerndesign ist gleich geblieben: Verträge können kryptografische Verifikationen wie PLONK, Groth16, BLS usw. an die öffentliche Einstiegsschicht des Hosts delegieren, statt alles jeweils selbst zu implementieren.
Die Vorteile sind ganz real. Entwickler müssen weniger fehleranfälligen Kryptocode schreiben, und Knoten müssen die grundlegenden Rechenoperationen nicht mehrfach in der WASM-Sandbox wiederholen; das macht Anwendungen leichter und die Verifikationsregeln lassen sich leichter vereinheitlichen.
Die Kosten konzentrieren sich ebenfalls. Wenn ein Anwendungs-Contract falsch geschrieben ist, trifft es zuerst sich selbst; wenn ein gemeinsam genutzter Verifikator bei der Eingabeanalyse, der Versionsauswahl oder bei Randbedingungen einen Fehler macht, können alle von ihm abhängigen Verträge betroffen sein. Im gesamten Netzwerk ist dann alles konsistent – man kann lediglich beweisen, dass alle dieselbe Regel ausgeführt haben.
Dusk hat im Aegis-Upgrade im März 2026 PLONK V3 und ein neues BLS-Verhalten aktiviert, und auch die BLS-Host-Queries, die Verträge nutzen, werden je nach Blockhöhe umgeschaltet. Historische Blöcke rufen den alten Verifikator auf, neue Daten verwenden die neue Version; wenn die Höhe falsch gewählt wird, können Transaktionen unter Umständen zu unterschiedlichen Ergebnissen hinsichtlich ihrer Gültigkeit führen.
Darum werde ich nicht nur die Auditberichte zählen, sondern auch auf die Verifikator-Version, die Upgrade-Höhe, Testvektoren, Cache-Invalidierungen und Rollback-Übungen achten. $DUSK trägt Gas und Konsenssicherheit, aber diese öffentlichen Verifikations-Einstiegspunkte stützen auch die Finanzanwendungen. Geschwindigkeit bestimmt, wie schnell das System laufen kann, und der Verifikator entscheidet, ob es auch Fehler schneller mit ausführt.
#dusk
Ich habe die historischen Whitepaper von @Dusk mit der aktuellen Dokumentation abgeglichen. Frühere Unterlagen nennen diese Rust/WASM-Laufzeit Piecrust; die aktuelle Doku verwendet stattdessen DuskVM. Der Name hat sich weiterentwickelt, aber das Kerndesign ist gleich geblieben: Verträge können kryptografische Verifikationen wie PLONK, Groth16, BLS usw. an die öffentliche Einstiegsschicht des Hosts delegieren, statt alles jeweils selbst zu implementieren.
Die Vorteile sind ganz real. Entwickler müssen weniger fehleranfälligen Kryptocode schreiben, und Knoten müssen die grundlegenden Rechenoperationen nicht mehrfach in der WASM-Sandbox wiederholen; das macht Anwendungen leichter und die Verifikationsregeln lassen sich leichter vereinheitlichen.
Die Kosten konzentrieren sich ebenfalls. Wenn ein Anwendungs-Contract falsch geschrieben ist, trifft es zuerst sich selbst; wenn ein gemeinsam genutzter Verifikator bei der Eingabeanalyse, der Versionsauswahl oder bei Randbedingungen einen Fehler macht, können alle von ihm abhängigen Verträge betroffen sein. Im gesamten Netzwerk ist dann alles konsistent – man kann lediglich beweisen, dass alle dieselbe Regel ausgeführt haben.
Dusk hat im Aegis-Upgrade im März 2026 PLONK V3 und ein neues BLS-Verhalten aktiviert, und auch die BLS-Host-Queries, die Verträge nutzen, werden je nach Blockhöhe umgeschaltet. Historische Blöcke rufen den alten Verifikator auf, neue Daten verwenden die neue Version; wenn die Höhe falsch gewählt wird, können Transaktionen unter Umständen zu unterschiedlichen Ergebnissen hinsichtlich ihrer Gültigkeit führen.
Darum werde ich nicht nur die Auditberichte zählen, sondern auch auf die Verifikator-Version, die Upgrade-Höhe, Testvektoren, Cache-Invalidierungen und Rollback-Übungen achten. $DUSK trägt Gas und Konsenssicherheit, aber diese öffentlichen Verifikations-Einstiegspunkte stützen auch die Finanzanwendungen. Geschwindigkeit bestimmt, wie schnell das System laufen kann, und der Verifikator entscheidet, ob es auch Fehler schneller mit ausführt.
#dusk
1
98
·
--
Zehn Minuten Offline im Rechenzentrum, und mit demselben Schlüssel zwei widersprüchliche Ergebnisse signiert: Kann man dann gleich hart bestrafen? Wenn die Antwort „beide verbrennen Coins“ ist, traue ich mich eher nicht, Knoten zu betreiben.
Ich habe die aktuellen Pledge-Regeln für @Dusk_Foundation erneut überprüft. Dusk teilt die Consensus-Strafen in soft und hard ein, aber die eigentliche Grenze ist nicht, ob der Node-Owner mit Worten böswillig ist, sondern welche Beweise die On-Chain hinterlässt.
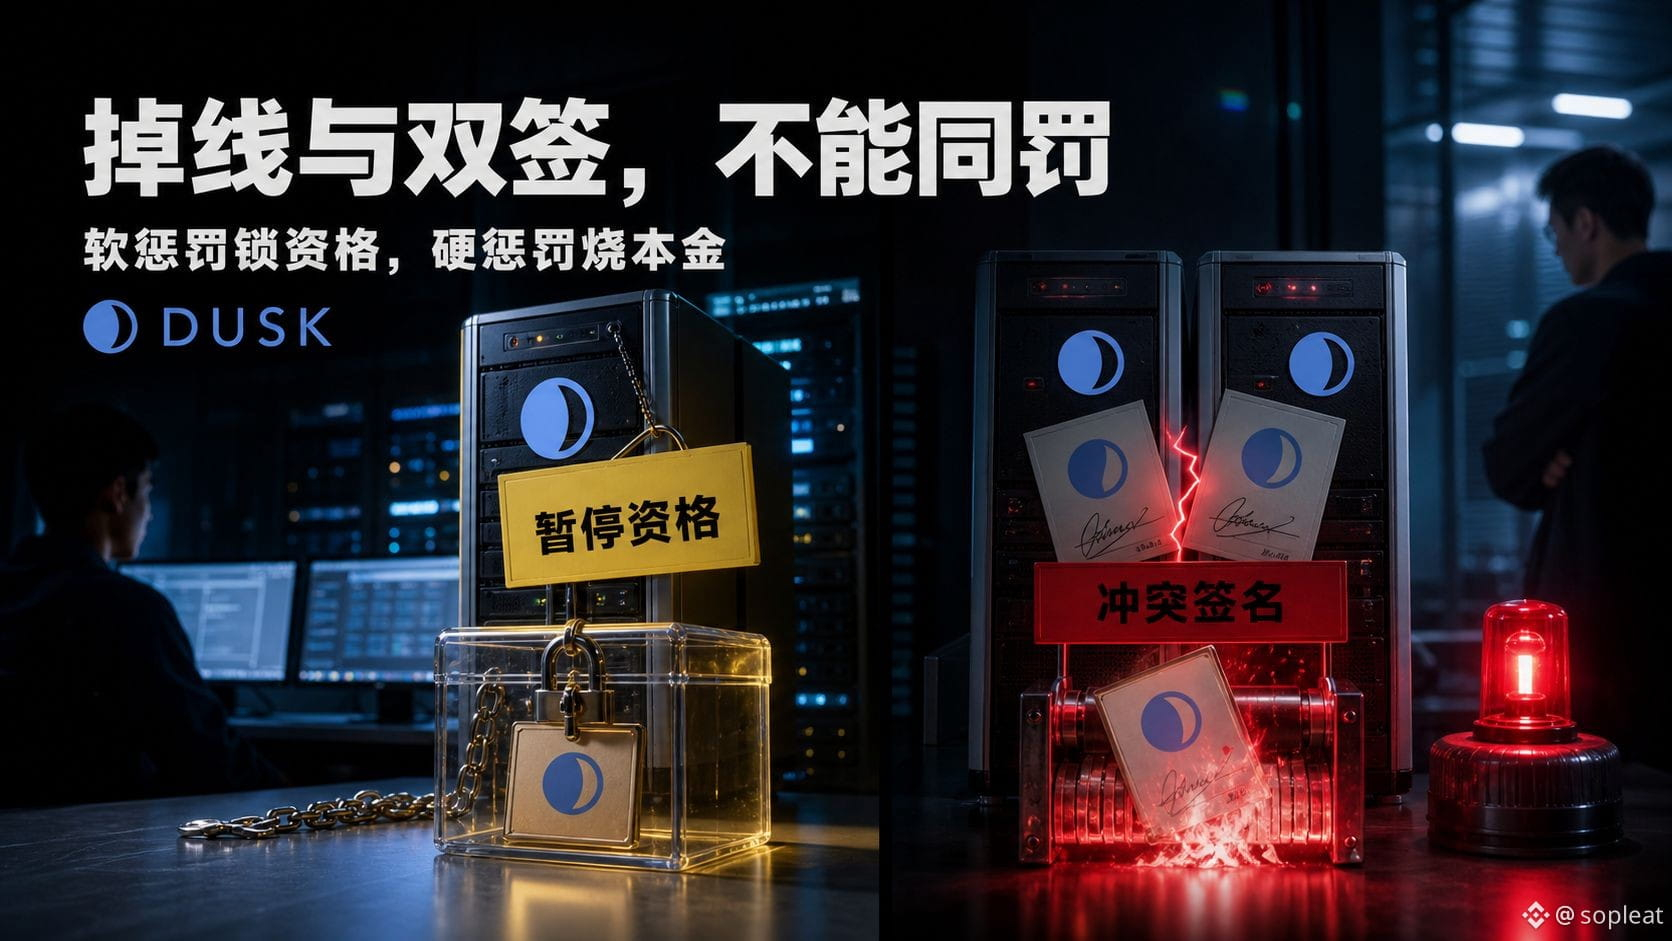
Die Soft-Strafe gilt für gescheitertes Mitwirken, z. B. wenn kein gültiger Kandidatenblock erzeugt werden konnte. Das Protokoll kann die Berechtigung des Knotens aussetzen und einen Teil des aktiven Stakes in einen gesperrten Stake überführen. Die Mittel bleiben Eigentum des Validators, aber sie verlieren vorübergehend die Fähigkeit, am Konsens teilzunehmen und Belohnungen zu verdienen.
Die Hard-Strafe richtet sich gegen nachweislich ungültiges Verhalten, darunter ungültige Votes sowie doppelt signierte Abstimmungs- oder konfliktierende Vorschläge. Zusätzlich zur Aussetzung der Berechtigung kann das Protokoll einen Teil des Stakes direkt vernichten, weil die Signatur bereits ein Beweis für die Zerstörung des Konsenses ist.
Das Protokoll entscheidet nicht für den Knoten, ob es ein Angriff oder ein Bedienfehler war. Die offizielle Stelle weist ausdrücklich darauf hin, dass man denselben <c-1/> consensus key nicht gleichzeitig auf zwei aktiven Knoten laufen lassen darf. Bei der Migration ist der alte Knoten eventuell noch nicht gestoppt, während der neue bereits signiert; Bedienfehler können ebenfalls zu Konfliktmeldungen führen und dann hart bestraft werden.
Daher darf das Pledge-Risiko nicht nur am APY festgemacht werden. Soft-Penalties beeinflussen den effektiven gestakten Betrag und den Ertragsausfall bei Stillstand, Hard-Penalties können das Kapital selbst treffen. Ich werde auf fault count, locked stake, die Aussetzungsdauer und Konflikt-Signaturen achten. $DUSK-Staking ist keine Einzahlung, sondern die Absicherung eines Produktionssystems mit dauerhaftem Online-Betrieb und einem einzigartigen Schlüssel.
#dusk $DUSK
Zehn Minuten Offline im Rechenzentrum, und mit demselben Schlüssel zwei widersprüchliche Ergebnisse signiert: Kann man dann gleich hart bestrafen? Wenn die Antwort „beide verbrennen Coins“ ist, traue ich mich eher nicht, Knoten zu betreiben.
Ich habe die aktuellen Pledge-Regeln für @Dusk erneut überprüft. Dusk teilt die Consensus-Strafen in soft und hard ein, aber die eigentliche Grenze ist nicht, ob der Node-Owner mit Worten böswillig ist, sondern welche Beweise die On-Chain hinterlässt.
Die Soft-Strafe gilt für gescheitertes Mitwirken, z. B. wenn kein gültiger Kandidatenblock erzeugt werden konnte. Das Protokoll kann die Berechtigung des Knotens aussetzen und einen Teil des aktiven Stakes in einen gesperrten Stake überführen. Die Mittel bleiben Eigentum des Validators, aber sie verlieren vorübergehend die Fähigkeit, am Konsens teilzunehmen und Belohnungen zu verdienen.
Die Hard-Strafe richtet sich gegen nachweislich ungültiges Verhalten, darunter ungültige Votes sowie doppelt signierte Abstimmungs- oder konfliktierende Vorschläge. Zusätzlich zur Aussetzung der Berechtigung kann das Protokoll einen Teil des Stakes direkt vernichten, weil die Signatur bereits ein Beweis für die Zerstörung des Konsenses ist.
Das Protokoll entscheidet nicht für den Knoten, ob es ein Angriff oder ein Bedienfehler war. Die offizielle Stelle weist ausdrücklich darauf hin, dass man denselben <c-1/> consensus key nicht gleichzeitig auf zwei aktiven Knoten laufen lassen darf. Bei der Migration ist der alte Knoten eventuell noch nicht gestoppt, während der neue bereits signiert; Bedienfehler können ebenfalls zu Konfliktmeldungen führen und dann hart bestraft werden.
Daher darf das Pledge-Risiko nicht nur am APY festgemacht werden. Soft-Penalties beeinflussen den effektiven gestakten Betrag und den Ertragsausfall bei Stillstand, Hard-Penalties können das Kapital selbst treffen. Ich werde auf fault count, locked stake, die Aussetzungsdauer und Konflikt-Signaturen achten. $DUSK -Staking ist keine Einzahlung, sondern die Absicherung eines Produktionssystems mit dauerhaftem Online-Betrieb und einem einzigartigen Schlüssel.
#dusk $DUSK
Ich habe die aktuellen Pledge-Regeln für @Dusk erneut überprüft. Dusk teilt die Consensus-Strafen in soft und hard ein, aber die eigentliche Grenze ist nicht, ob der Node-Owner mit Worten böswillig ist, sondern welche Beweise die On-Chain hinterlässt.
Die Soft-Strafe gilt für gescheitertes Mitwirken, z. B. wenn kein gültiger Kandidatenblock erzeugt werden konnte. Das Protokoll kann die Berechtigung des Knotens aussetzen und einen Teil des aktiven Stakes in einen gesperrten Stake überführen. Die Mittel bleiben Eigentum des Validators, aber sie verlieren vorübergehend die Fähigkeit, am Konsens teilzunehmen und Belohnungen zu verdienen.
Die Hard-Strafe richtet sich gegen nachweislich ungültiges Verhalten, darunter ungültige Votes sowie doppelt signierte Abstimmungs- oder konfliktierende Vorschläge. Zusätzlich zur Aussetzung der Berechtigung kann das Protokoll einen Teil des Stakes direkt vernichten, weil die Signatur bereits ein Beweis für die Zerstörung des Konsenses ist.
Das Protokoll entscheidet nicht für den Knoten, ob es ein Angriff oder ein Bedienfehler war. Die offizielle Stelle weist ausdrücklich darauf hin, dass man denselben <c-1/> consensus key nicht gleichzeitig auf zwei aktiven Knoten laufen lassen darf. Bei der Migration ist der alte Knoten eventuell noch nicht gestoppt, während der neue bereits signiert; Bedienfehler können ebenfalls zu Konfliktmeldungen führen und dann hart bestraft werden.
Daher darf das Pledge-Risiko nicht nur am APY festgemacht werden. Soft-Penalties beeinflussen den effektiven gestakten Betrag und den Ertragsausfall bei Stillstand, Hard-Penalties können das Kapital selbst treffen. Ich werde auf fault count, locked stake, die Aussetzungsdauer und Konflikt-Signaturen achten. $DUSK -Staking ist keine Einzahlung, sondern die Absicherung eines Produktionssystems mit dauerhaftem Online-Betrieb und einem einzigartigen Schlüssel.
#dusk $DUSK
114
·
--
下午两点质押了1000枚代币,晚上打开面板,奖励还是零。很多人的第一反应是节点坏了,其实更可能是:钱已经进场,节点却还没正式“上岗”。
Ich habe die aktuellen @Dusk_Foundation verifiziert. Die Mindestschwelle für die direkte Teilnahme am Konsens liegt tatsächlich bei 1000 $DUSK, aber neue Stakes erhalten die Berechtigung nicht sofort. Ein Epoch umfasst 2160 Blöcke. Der Stake wird erst am Rand des übernächsten Epoch aktiviert. Üblicherweise dauert das etwa 6 bis 12 Stunden, abhängig davon, wo die Transaktion im aktuellen Epoch platziert wurde.
Daher sollte die „2160-Block-Reifezeit“ nicht einfach so verstanden werden, dass man nur ein Epoch abwartet. Am kürzesten ist sie nahe an einem Epoch, am längsten kann sie sich fast bis zu zwei Epochs erstrecken. Maßgeblich ist nicht die Uhrzeit an der Wand, sondern der von der Wallet zurückgegebene Wert „stake active from block“.
Aus Sicht des Mechanismus führt das dazu, dass sich die Validator-Berechtigungen auf Aktualisierungen an den Epoch-Grenzen konzentrieren und verhindert werden soll, dass sich die Menge der aktiven Stakes mitten in einer Runde des Konsenses ändert. Doch die Kosten trägt ein neues Validator: Das Geld ist bereits eingezahlt, aber die Wartezeit ermöglicht keine Teilnahme am Blockproduzieren und am Voting.
1000 Token sind außerdem nur die Kapital-Schwelle. Direkte Staking erfordert zudem, dass der Provisioner dauerhaft online ist, synchron bleibt und eine korrekte Version ausführt. Die Belohnungen hängen vom Anteil der effektiven Stakes und der tatsächlichen Teilnahme ab – das ist ein probabilistisches Ergebnis, nicht eine feste jährliche Rendite.
Ich beobachte drei Punkte: „active from block“, die Knotensynchronisation und die Teilnahmedaten sowie die Abweichung der tatsächlichen Belohnungen relativ zu den aktiven Stakes. Am leichtesten in die Irre führt gerade der Satz „1000 Token reichen, um teilzunehmen“: Damit kauft man sich Eintrittsberechtigung, nicht einen sofort auszahlenden Sparbrief.
#dusk $DUSK
下午两点质押了1000枚代币,晚上打开面板,奖励还是零。很多人的第一反应是节点坏了,其实更可能是:钱已经进场,节点却还没正式“上岗”。
Ich habe die aktuellen @Dusk verifiziert. Die Mindestschwelle für die direkte Teilnahme am Konsens liegt tatsächlich bei 1000 $DUSK , aber neue Stakes erhalten die Berechtigung nicht sofort. Ein Epoch umfasst 2160 Blöcke. Der Stake wird erst am Rand des übernächsten Epoch aktiviert. Üblicherweise dauert das etwa 6 bis 12 Stunden, abhängig davon, wo die Transaktion im aktuellen Epoch platziert wurde.
Daher sollte die „2160-Block-Reifezeit“ nicht einfach so verstanden werden, dass man nur ein Epoch abwartet. Am kürzesten ist sie nahe an einem Epoch, am längsten kann sie sich fast bis zu zwei Epochs erstrecken. Maßgeblich ist nicht die Uhrzeit an der Wand, sondern der von der Wallet zurückgegebene Wert „stake active from block“.
Aus Sicht des Mechanismus führt das dazu, dass sich die Validator-Berechtigungen auf Aktualisierungen an den Epoch-Grenzen konzentrieren und verhindert werden soll, dass sich die Menge der aktiven Stakes mitten in einer Runde des Konsenses ändert. Doch die Kosten trägt ein neues Validator: Das Geld ist bereits eingezahlt, aber die Wartezeit ermöglicht keine Teilnahme am Blockproduzieren und am Voting.
1000 Token sind außerdem nur die Kapital-Schwelle. Direkte Staking erfordert zudem, dass der Provisioner dauerhaft online ist, synchron bleibt und eine korrekte Version ausführt. Die Belohnungen hängen vom Anteil der effektiven Stakes und der tatsächlichen Teilnahme ab – das ist ein probabilistisches Ergebnis, nicht eine feste jährliche Rendite.
Ich beobachte drei Punkte: „active from block“, die Knotensynchronisation und die Teilnahmedaten sowie die Abweichung der tatsächlichen Belohnungen relativ zu den aktiven Stakes. Am leichtesten in die Irre führt gerade der Satz „1000 Token reichen, um teilzunehmen“: Damit kauft man sich Eintrittsberechtigung, nicht einen sofort auszahlenden Sparbrief.
#dusk $DUSK
Ich habe die aktuellen @Dusk verifiziert. Die Mindestschwelle für die direkte Teilnahme am Konsens liegt tatsächlich bei 1000 $DUSK , aber neue Stakes erhalten die Berechtigung nicht sofort. Ein Epoch umfasst 2160 Blöcke. Der Stake wird erst am Rand des übernächsten Epoch aktiviert. Üblicherweise dauert das etwa 6 bis 12 Stunden, abhängig davon, wo die Transaktion im aktuellen Epoch platziert wurde.
Daher sollte die „2160-Block-Reifezeit“ nicht einfach so verstanden werden, dass man nur ein Epoch abwartet. Am kürzesten ist sie nahe an einem Epoch, am längsten kann sie sich fast bis zu zwei Epochs erstrecken. Maßgeblich ist nicht die Uhrzeit an der Wand, sondern der von der Wallet zurückgegebene Wert „stake active from block“.
Aus Sicht des Mechanismus führt das dazu, dass sich die Validator-Berechtigungen auf Aktualisierungen an den Epoch-Grenzen konzentrieren und verhindert werden soll, dass sich die Menge der aktiven Stakes mitten in einer Runde des Konsenses ändert. Doch die Kosten trägt ein neues Validator: Das Geld ist bereits eingezahlt, aber die Wartezeit ermöglicht keine Teilnahme am Blockproduzieren und am Voting.
1000 Token sind außerdem nur die Kapital-Schwelle. Direkte Staking erfordert zudem, dass der Provisioner dauerhaft online ist, synchron bleibt und eine korrekte Version ausführt. Die Belohnungen hängen vom Anteil der effektiven Stakes und der tatsächlichen Teilnahme ab – das ist ein probabilistisches Ergebnis, nicht eine feste jährliche Rendite.
Ich beobachte drei Punkte: „active from block“, die Knotensynchronisation und die Teilnahmedaten sowie die Abweichung der tatsächlichen Belohnungen relativ zu den aktiven Stakes. Am leichtesten in die Irre führt gerade der Satz „1000 Token reichen, um teilzunehmen“: Damit kauft man sich Eintrittsberechtigung, nicht einen sofort auszahlenden Sparbrief.
#dusk $DUSK
1
127
·
--
Zahlungsseite hängt fünf Sekunden lang, und weil mir kurz die Hand zittert, tippe ich nochmal. Bei normalen Zahlungen kann man noch zwei Buchungen prüfen – aber bei Privatzahlungen werden Betrag und Beteiligte versteckt. Wieso sollte das Netzwerk dann überhaupt wissen, dass du dasselbe Geld nicht zweimal ausgegeben hast?
Ich habe diese Frage erneut aufgegriffen und den Phoenix von @Dusk_Foundation neu zerlegt. Er führt Gelder nicht als öffentliches Guthaben, sondern zerlegt sie in verschlüsselte »notes« und schreibt das »note«-Versprechen in einen Merkle-Baum. Beim Ausgeben sorgt ein Zero-Knowledge-Beweis dafür, dass nachgewiesen wird, dass diese »note« echt existiert, vom Nutzer kontrolliert wird und Eingaben und Ausgaben in der Bilanz übereinstimmen – ohne dabei den konkreten Betrag oder die zugehörigen »notes« offenzulegen.
Wirklich für den Schutz vor »Double-Spending« sorgen die »nullifier«. Man kann sie verstehen als eindeutige Markierungen, die übrig bleiben, sobald eine »note« bereits verwendet wurde. Die Außenwelt kann daraus nicht die ursprüngliche »note« ableiten, aber das Netzwerk kann prüfen, ob diese Markierung schon einmal aufgetaucht ist. Wenn dieselbe »note« für zwei Transaktionen konstruiert wird, kollidieren sie beim gleichen »nullifier« – beide können nicht gleichzeitig gültig sein.
In der aktuellen Dusk-Dokumentation steht außerdem: Wenn Phoenix-Transaktionen im Mempool aufgrund eines »nullifier«-Konflikts kollidieren, kann nur eine neue Transaktion mit streng höherem Gas-Preis die alte ersetzen. Höhere Gebühren erneut senden bedeutet also vermutlich: ersetzen statt eine zusätzliche Zahlung hinzufügen. Sobald aber eine Transaktion in einem bereits akzeptierten Block ausgeführt wurde, werden selbst bei einem Vertragsfehler die betreffenden »notes« und das Gas verbraucht. Erst wenn der Block in den Zustand »finalized« übergeht, gilt es wirklich als endgültiges Ergebnis.
So löst die Kryptografie das Problem, dass Vermögenswerte nicht kopiert werden können – aber die Wallet muss trotzdem erklären, was als »ausstehend«, »ersetzt«, »fehlgeschlagen« und »endgültig bestätigt« gilt. Zeigt sie nur »fehlgeschlagen«, könnte der Nutzer trotzdem immer wieder erneut versuchen.
$DUSK ist Gas und ein gesperrtes Staking-Asset, aber es darf nicht als Qualitätsversprechen für das Produkterlebnis herhalten. Ich möchte vielmehr sehen, ob die Wallet die Ersetzungsbeziehung, den Grund für den »note«-Verbrauch und den endgültigen Status anzeigen kann. Privatsphäre darf Details verbergen, aber nicht, ob eine Transaktion überhaupt stattgefunden hat.
#dusk $DUSK
Zahlungsseite hängt fünf Sekunden lang, und weil mir kurz die Hand zittert, tippe ich nochmal. Bei normalen Zahlungen kann man noch zwei Buchungen prüfen – aber bei Privatzahlungen werden Betrag und Beteiligte versteckt. Wieso sollte das Netzwerk dann überhaupt wissen, dass du dasselbe Geld nicht zweimal ausgegeben hast?
Ich habe diese Frage erneut aufgegriffen und den Phoenix von @Dusk neu zerlegt. Er führt Gelder nicht als öffentliches Guthaben, sondern zerlegt sie in verschlüsselte »notes« und schreibt das »note«-Versprechen in einen Merkle-Baum. Beim Ausgeben sorgt ein Zero-Knowledge-Beweis dafür, dass nachgewiesen wird, dass diese »note« echt existiert, vom Nutzer kontrolliert wird und Eingaben und Ausgaben in der Bilanz übereinstimmen – ohne dabei den konkreten Betrag oder die zugehörigen »notes« offenzulegen.
Wirklich für den Schutz vor »Double-Spending« sorgen die »nullifier«. Man kann sie verstehen als eindeutige Markierungen, die übrig bleiben, sobald eine »note« bereits verwendet wurde. Die Außenwelt kann daraus nicht die ursprüngliche »note« ableiten, aber das Netzwerk kann prüfen, ob diese Markierung schon einmal aufgetaucht ist. Wenn dieselbe »note« für zwei Transaktionen konstruiert wird, kollidieren sie beim gleichen »nullifier« – beide können nicht gleichzeitig gültig sein.
In der aktuellen Dusk-Dokumentation steht außerdem: Wenn Phoenix-Transaktionen im Mempool aufgrund eines »nullifier«-Konflikts kollidieren, kann nur eine neue Transaktion mit streng höherem Gas-Preis die alte ersetzen. Höhere Gebühren erneut senden bedeutet also vermutlich: ersetzen statt eine zusätzliche Zahlung hinzufügen. Sobald aber eine Transaktion in einem bereits akzeptierten Block ausgeführt wurde, werden selbst bei einem Vertragsfehler die betreffenden »notes« und das Gas verbraucht. Erst wenn der Block in den Zustand »finalized« übergeht, gilt es wirklich als endgültiges Ergebnis.
So löst die Kryptografie das Problem, dass Vermögenswerte nicht kopiert werden können – aber die Wallet muss trotzdem erklären, was als »ausstehend«, »ersetzt«, »fehlgeschlagen« und »endgültig bestätigt« gilt. Zeigt sie nur »fehlgeschlagen«, könnte der Nutzer trotzdem immer wieder erneut versuchen.
$DUSK ist Gas und ein gesperrtes Staking-Asset, aber es darf nicht als Qualitätsversprechen für das Produkterlebnis herhalten. Ich möchte vielmehr sehen, ob die Wallet die Ersetzungsbeziehung, den Grund für den »note«-Verbrauch und den endgültigen Status anzeigen kann. Privatsphäre darf Details verbergen, aber nicht, ob eine Transaktion überhaupt stattgefunden hat.
#dusk $DUSK
Ich habe diese Frage erneut aufgegriffen und den Phoenix von @Dusk neu zerlegt. Er führt Gelder nicht als öffentliches Guthaben, sondern zerlegt sie in verschlüsselte »notes« und schreibt das »note«-Versprechen in einen Merkle-Baum. Beim Ausgeben sorgt ein Zero-Knowledge-Beweis dafür, dass nachgewiesen wird, dass diese »note« echt existiert, vom Nutzer kontrolliert wird und Eingaben und Ausgaben in der Bilanz übereinstimmen – ohne dabei den konkreten Betrag oder die zugehörigen »notes« offenzulegen.
Wirklich für den Schutz vor »Double-Spending« sorgen die »nullifier«. Man kann sie verstehen als eindeutige Markierungen, die übrig bleiben, sobald eine »note« bereits verwendet wurde. Die Außenwelt kann daraus nicht die ursprüngliche »note« ableiten, aber das Netzwerk kann prüfen, ob diese Markierung schon einmal aufgetaucht ist. Wenn dieselbe »note« für zwei Transaktionen konstruiert wird, kollidieren sie beim gleichen »nullifier« – beide können nicht gleichzeitig gültig sein.
In der aktuellen Dusk-Dokumentation steht außerdem: Wenn Phoenix-Transaktionen im Mempool aufgrund eines »nullifier«-Konflikts kollidieren, kann nur eine neue Transaktion mit streng höherem Gas-Preis die alte ersetzen. Höhere Gebühren erneut senden bedeutet also vermutlich: ersetzen statt eine zusätzliche Zahlung hinzufügen. Sobald aber eine Transaktion in einem bereits akzeptierten Block ausgeführt wurde, werden selbst bei einem Vertragsfehler die betreffenden »notes« und das Gas verbraucht. Erst wenn der Block in den Zustand »finalized« übergeht, gilt es wirklich als endgültiges Ergebnis.
So löst die Kryptografie das Problem, dass Vermögenswerte nicht kopiert werden können – aber die Wallet muss trotzdem erklären, was als »ausstehend«, »ersetzt«, »fehlgeschlagen« und »endgültig bestätigt« gilt. Zeigt sie nur »fehlgeschlagen«, könnte der Nutzer trotzdem immer wieder erneut versuchen.
$DUSK ist Gas und ein gesperrtes Staking-Asset, aber es darf nicht als Qualitätsversprechen für das Produkterlebnis herhalten. Ich möchte vielmehr sehen, ob die Wallet die Ersetzungsbeziehung, den Grund für den »note«-Verbrauch und den endgültigen Status anzeigen kann. Privatsphäre darf Details verbergen, aber nicht, ob eine Transaktion überhaupt stattgefunden hat.
#dusk $DUSK
1
114
·
--
#dusk $DUSK Das Finanz-Backoffice hat nicht am meisten Angst vor einem fehlgeschlagenen Handel, sondern vor einem Handel, der erfolgreich war – und der „erfolgreich“ ein zweites Mal erfolgreich war. Der Nutzer klickt zweimal; das Netzwerk läuft in einen Timeout und versucht automatisch erneut. Die Mitarbeitenden sehen, dass die Seite nicht reagiert, und senden die Anfrage ein weiteres Mal ab. Wenn derselbe Rücknahme- oder Umbuchungsauftrag zweimal ausgeführt wird, ist der zweite nicht Effizienz, sondern ein Unfall.
Das ist auch der Grund, warum ich beim erneuten Lesen des Whitepapers @Dusk_Foundation das Moonlight-Account-Modell so spannend fand: Das nonce ist es wert, mehr erklärt zu werden als die vier Worte „öffentlicher Account“. Moonlight hält für jeden Public-Key-Account den Kontostand und ein nonce fest, das fortlaufend inkrementiert. Nachdem eine Transaktion ins Netzwerk gelangt, wird neben der Prüfung, ob der Kontostand die Überweisung, Einzahlungen und die maximalen Gas-Kosten abdeckt, auch die Signatur verifiziert. Außerdem muss die mitgelieferte nonce exakt gleich sein dem aktuellen Kontononce plus eins. Nachdem die Transaktion akzeptiert wurde, rückt die nonce des Accounts weiter nach vorne.
Übersetzt in klare Worte: Jede einzelne Anweisung muss eine eindeutige „Warteschlangen-Nummer“ bekommen. Wenn die Nummer bereits verwendet wurde, kann die alte signierte Transaktion – selbst wenn jemand sie erneut im Netzwerk broadcastet – nicht mehr unverändert ausgeführt werden; springt die Nummer, spielt das Netzwerk ebenfalls nicht so, als wäre alles in Ordnung mit der Reihenfolge. Das ist kein Technik-Showcase, sondern das Prinzip „dieselbe Autorisierung kann nicht mehrfach abgebucht werden“ wird in die Transaktionsebene eingraviert.
Das gilt besonders für regulierte Vermögenswerte. Doppelte Banküberweisungen können noch über Stornos/Überziehungen abgewickelt werden. Wenn aber im Wertpapierregister eine Zeile doppelt umbenannt wird, zieht das später Konsequenzen nach sich: für Bestände, Dividenden, Stimmrechte und Rücknahmeberechtigung. Der Fehler ist nicht nur eine einzelne Geldsumme, sondern das Kopieren des gesamten Datensatzes der Rechte.
Aber nonce ist auch kein Allheilmittel gegen Idempotenz-Probleme. Es verhindert zwar das Wiederabspielen einer identischen alten Transaktion, aber es verhindert nicht, dass eine Anwendung mit zwei aufeinanderfolgenden neuen nonces zwei Befehle absendet, die wirtschaftlich dieselbe Bedeutung haben. Zum Beispiel: Wenn das Frontend wirklich zwei gültige Rückgabeanfragen generiert, behandelt die Chain das als zwei unterschiedliche Transaktionen. Auf Business-Ebene muss man weiterhin Order-IDs, Volumen-/Limit-Checks, den Freigabestatus und das Blockieren doppelter Anfragen umsetzen.
Deshalb reicht es für mich nicht zu schauen, ob Dusk bei Finanz-Workflows schnell genug ist. Ich schaue auch, wie Wallets und Anwendungen mit „pending nonce“, fehlgeschlagenen Retries und Bestellnummern über Systemgrenzen hinweg umgehen. Die On-Chain-Reihenfolge ist eine Schutzlinie, die Business-Idempotenz ist die andere. Wenn man beide Schutzlinien in einem einzigen Satz „Replay-Schutz“ vermischt, wird der Unfall früher oder später genau aus der Lücke dazwischen herausbrechen.
Ein wirklich reifes Finanzsystem muss nicht nur sicherstellen, dass die korrekten Transaktionen ausgeführt werden können, sondern auch gewährleisten, dass dieselbe „korrekte“ Sache niemals zweimal ausgeführt wird.
#dusk $DUSK Das Finanz-Backoffice hat nicht am meisten Angst vor einem fehlgeschlagenen Handel, sondern vor einem Handel, der erfolgreich war – und der „erfolgreich“ ein zweites Mal erfolgreich war. Der Nutzer klickt zweimal; das Netzwerk läuft in einen Timeout und versucht automatisch erneut. Die Mitarbeitenden sehen, dass die Seite nicht reagiert, und senden die Anfrage ein weiteres Mal ab. Wenn derselbe Rücknahme- oder Umbuchungsauftrag zweimal ausgeführt wird, ist der zweite nicht Effizienz, sondern ein Unfall.
Das ist auch der Grund, warum ich beim erneuten Lesen des Whitepapers @Dusk das Moonlight-Account-Modell so spannend fand: Das nonce ist es wert, mehr erklärt zu werden als die vier Worte „öffentlicher Account“. Moonlight hält für jeden Public-Key-Account den Kontostand und ein nonce fest, das fortlaufend inkrementiert. Nachdem eine Transaktion ins Netzwerk gelangt, wird neben der Prüfung, ob der Kontostand die Überweisung, Einzahlungen und die maximalen Gas-Kosten abdeckt, auch die Signatur verifiziert. Außerdem muss die mitgelieferte nonce exakt gleich sein dem aktuellen Kontononce plus eins. Nachdem die Transaktion akzeptiert wurde, rückt die nonce des Accounts weiter nach vorne.
Übersetzt in klare Worte: Jede einzelne Anweisung muss eine eindeutige „Warteschlangen-Nummer“ bekommen. Wenn die Nummer bereits verwendet wurde, kann die alte signierte Transaktion – selbst wenn jemand sie erneut im Netzwerk broadcastet – nicht mehr unverändert ausgeführt werden; springt die Nummer, spielt das Netzwerk ebenfalls nicht so, als wäre alles in Ordnung mit der Reihenfolge. Das ist kein Technik-Showcase, sondern das Prinzip „dieselbe Autorisierung kann nicht mehrfach abgebucht werden“ wird in die Transaktionsebene eingraviert.
Das gilt besonders für regulierte Vermögenswerte. Doppelte Banküberweisungen können noch über Stornos/Überziehungen abgewickelt werden. Wenn aber im Wertpapierregister eine Zeile doppelt umbenannt wird, zieht das später Konsequenzen nach sich: für Bestände, Dividenden, Stimmrechte und Rücknahmeberechtigung. Der Fehler ist nicht nur eine einzelne Geldsumme, sondern das Kopieren des gesamten Datensatzes der Rechte.
Aber nonce ist auch kein Allheilmittel gegen Idempotenz-Probleme. Es verhindert zwar das Wiederabspielen einer identischen alten Transaktion, aber es verhindert nicht, dass eine Anwendung mit zwei aufeinanderfolgenden neuen nonces zwei Befehle absendet, die wirtschaftlich dieselbe Bedeutung haben. Zum Beispiel: Wenn das Frontend wirklich zwei gültige Rückgabeanfragen generiert, behandelt die Chain das als zwei unterschiedliche Transaktionen. Auf Business-Ebene muss man weiterhin Order-IDs, Volumen-/Limit-Checks, den Freigabestatus und das Blockieren doppelter Anfragen umsetzen.
Deshalb reicht es für mich nicht zu schauen, ob Dusk bei Finanz-Workflows schnell genug ist. Ich schaue auch, wie Wallets und Anwendungen mit „pending nonce“, fehlgeschlagenen Retries und Bestellnummern über Systemgrenzen hinweg umgehen. Die On-Chain-Reihenfolge ist eine Schutzlinie, die Business-Idempotenz ist die andere. Wenn man beide Schutzlinien in einem einzigen Satz „Replay-Schutz“ vermischt, wird der Unfall früher oder später genau aus der Lücke dazwischen herausbrechen.
Ein wirklich reifes Finanzsystem muss nicht nur sicherstellen, dass die korrekten Transaktionen ausgeführt werden können, sondern auch gewährleisten, dass dieselbe „korrekte“ Sache niemals zweimal ausgeführt wird.
Das ist auch der Grund, warum ich beim erneuten Lesen des Whitepapers @Dusk das Moonlight-Account-Modell so spannend fand: Das nonce ist es wert, mehr erklärt zu werden als die vier Worte „öffentlicher Account“. Moonlight hält für jeden Public-Key-Account den Kontostand und ein nonce fest, das fortlaufend inkrementiert. Nachdem eine Transaktion ins Netzwerk gelangt, wird neben der Prüfung, ob der Kontostand die Überweisung, Einzahlungen und die maximalen Gas-Kosten abdeckt, auch die Signatur verifiziert. Außerdem muss die mitgelieferte nonce exakt gleich sein dem aktuellen Kontononce plus eins. Nachdem die Transaktion akzeptiert wurde, rückt die nonce des Accounts weiter nach vorne.
Übersetzt in klare Worte: Jede einzelne Anweisung muss eine eindeutige „Warteschlangen-Nummer“ bekommen. Wenn die Nummer bereits verwendet wurde, kann die alte signierte Transaktion – selbst wenn jemand sie erneut im Netzwerk broadcastet – nicht mehr unverändert ausgeführt werden; springt die Nummer, spielt das Netzwerk ebenfalls nicht so, als wäre alles in Ordnung mit der Reihenfolge. Das ist kein Technik-Showcase, sondern das Prinzip „dieselbe Autorisierung kann nicht mehrfach abgebucht werden“ wird in die Transaktionsebene eingraviert.
Das gilt besonders für regulierte Vermögenswerte. Doppelte Banküberweisungen können noch über Stornos/Überziehungen abgewickelt werden. Wenn aber im Wertpapierregister eine Zeile doppelt umbenannt wird, zieht das später Konsequenzen nach sich: für Bestände, Dividenden, Stimmrechte und Rücknahmeberechtigung. Der Fehler ist nicht nur eine einzelne Geldsumme, sondern das Kopieren des gesamten Datensatzes der Rechte.
Aber nonce ist auch kein Allheilmittel gegen Idempotenz-Probleme. Es verhindert zwar das Wiederabspielen einer identischen alten Transaktion, aber es verhindert nicht, dass eine Anwendung mit zwei aufeinanderfolgenden neuen nonces zwei Befehle absendet, die wirtschaftlich dieselbe Bedeutung haben. Zum Beispiel: Wenn das Frontend wirklich zwei gültige Rückgabeanfragen generiert, behandelt die Chain das als zwei unterschiedliche Transaktionen. Auf Business-Ebene muss man weiterhin Order-IDs, Volumen-/Limit-Checks, den Freigabestatus und das Blockieren doppelter Anfragen umsetzen.
Deshalb reicht es für mich nicht zu schauen, ob Dusk bei Finanz-Workflows schnell genug ist. Ich schaue auch, wie Wallets und Anwendungen mit „pending nonce“, fehlgeschlagenen Retries und Bestellnummern über Systemgrenzen hinweg umgehen. Die On-Chain-Reihenfolge ist eine Schutzlinie, die Business-Idempotenz ist die andere. Wenn man beide Schutzlinien in einem einzigen Satz „Replay-Schutz“ vermischt, wird der Unfall früher oder später genau aus der Lücke dazwischen herausbrechen.
Ein wirklich reifes Finanzsystem muss nicht nur sicherstellen, dass die korrekten Transaktionen ausgeführt werden können, sondern auch gewährleisten, dass dieselbe „korrekte“ Sache niemals zweimal ausgeführt wird.
1
125
·
--
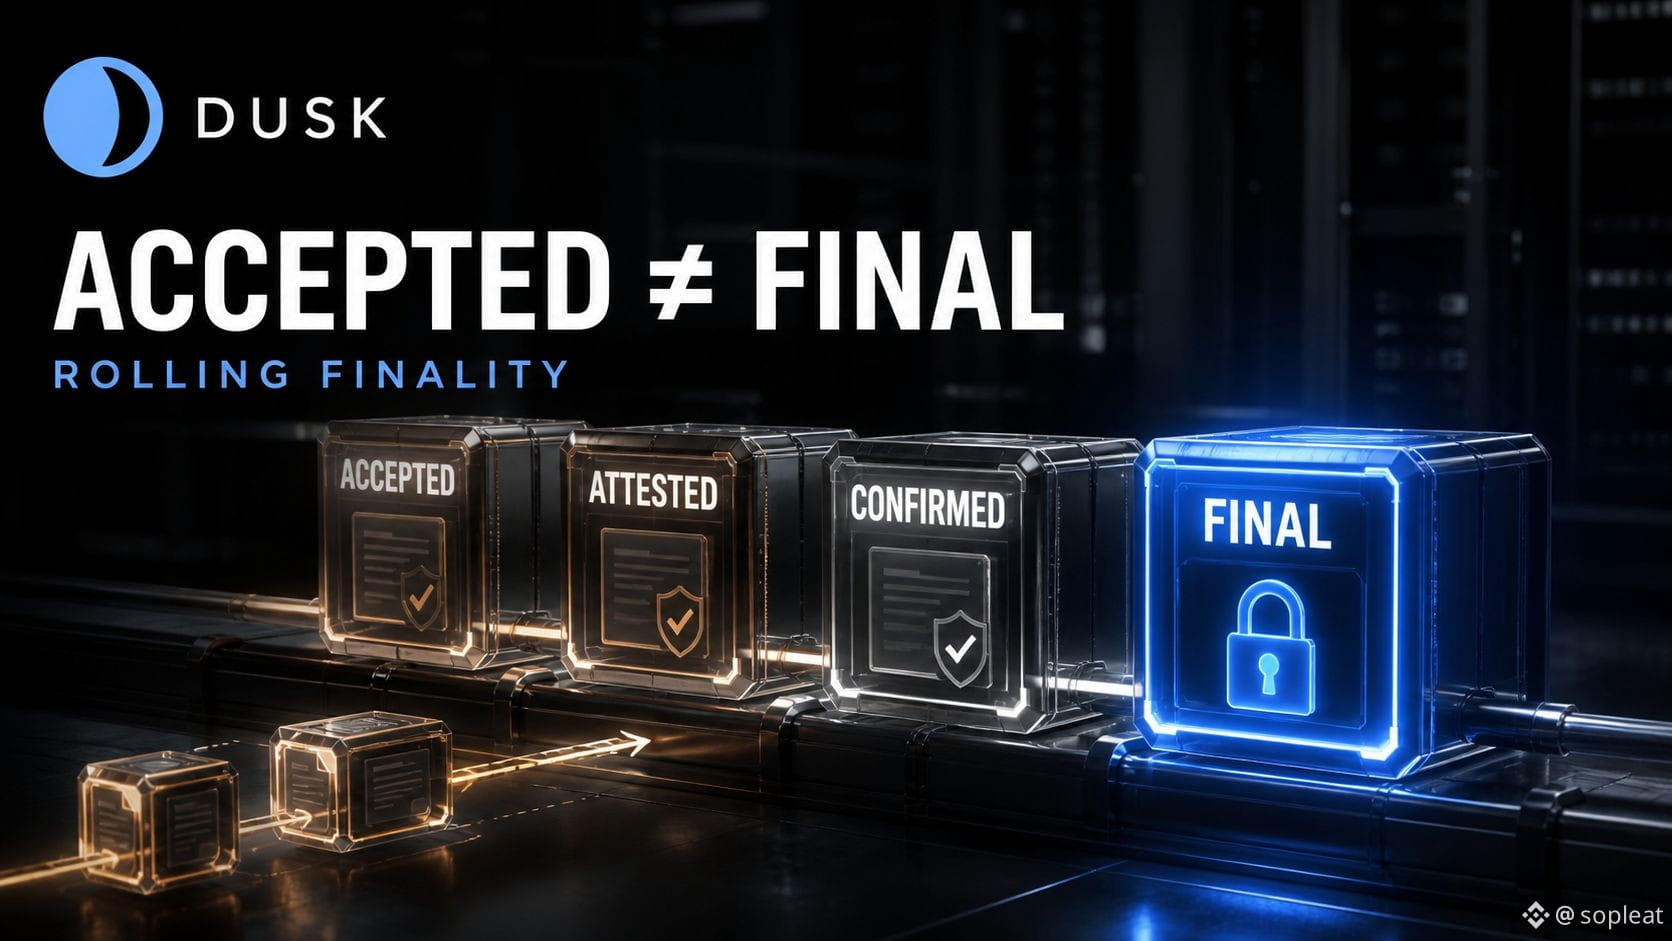
#dusk $DUSK 证券-Backoffice: der gefährlichste Hinweis – nicht unbedingt „fehlgeschlagen“, sondern „bereits bearbeitet“ (accepted). Ein Fehlschlag stoppt die Leute wenigstens. „Bereits bearbeitet“ wird hingegen viel zu leicht als „Geld und Ware sind endgültig ausgetauscht“ verstanden. Auch on-chain gilt dasselbe: Wenn ein Block in das lokale Ledger gelangt, heißt das nicht, dass er bereits den letzten, absolut nicht ersetzbaren Schritt erreicht hat.
Ich habe die Rolling-Finality im Whitepaper von @Dusk_Foundation neu gelesen und erst dabei erkannt: Dusk hat nicht alle „Bestätigungen“ zu einem einzigen Wort vermischt, sondern in vier Zustände aufgeteilt: accepted, attested, confirmed und final. Ein accepted-Block hat zwar einen Erfolgsnachweis erhalten, kann aber dennoch ersetzt werden – etwa wenn er aus einer höheren Iteration stammt und die vorherigen niedrigen Iterationen keine Fehlschlagsnachweise enthalten. Wenn später ein legaler Block aus einer niedrigeren Iteration auftaucht, wird der accepted-Block ersetzt, und die nachfolgenden Blöcke gehen dann ebenfalls mit zurück.
attested ist robuster, weil es entweder aus Iteration 0 stammt oder weil die vorherigen Iterationen bereits Fehlschlagsnachweise hinterlassen haben; confirmed braucht zusätzlich, dass nachfolgende Blöcke weiterhin dazu beitragen, dass die aktuelle Kette glaubwürdig bleibt. Nur final bedeutet: Der Parent-Block ist ebenfalls final; der gesamte Ahnenpfad ist „zugemacht“, nicht mehr ersetzbar.
Das Whitepaper gibt ein konkretes Beispiel: Ein Block entsteht in der 5. Iteration. Davor gab es aber nur zwei Iterationen mit Fehlschlagsnachweisen – deshalb wird er zunächst als accepted markiert. Er muss dann noch 4 aufeinanderfolgende attested- oder confirmed-Blöcke abwarten, bevor er confirmed wird. Das heißt: „Es ist bereits ein Block ausgegeben“ und „man kann die Wertpapierabwicklung als unwiderrufliche Tatsache behandeln“ können tatsächlich ein paar Schritte auseinanderliegen.
Ich finde diese Ehrlichkeit gut. Das Finanzsystem fürchtet am meisten, wenn Wahrscheinlichkeiten in ein grünes Häkchen versteckt werden. Aber es gibt auch Produktteams Hausaufgaben: Welche Status werden in der Wallet, an der Handelsschnittstelle und im Registersystem wirklich angezeigt? Wenn Nutzer sehen, dass es accepted ist – können sie dann weiter übertragen oder einlösen? Wenn das UI überall einfach „Erfolg“ schreibt, wird selbst ein noch so strenger Konsenszustand durch Copywriting geglättet.
Deshalb schaue ich mir Dusk’s Sekundenfinalität nicht nur an, wie viele Sekunden im Durchschnitt benötigt werden, sondern auch daran, wie die Verteilung aussieht, wenn Iterationen „abnormal“ sind – wie sie von accepted zu final kommen – und ob die Anwendung wirklich erst dann „abhakt“, wenn final erreicht ist. Finalität ist keine Marketing-Zahl, sondern eine Disziplin: Man darf „fast fertig“ nicht als „schon fertig“ verkaufen.
#dusk $DUSK 证券-Backoffice: der gefährlichste Hinweis – nicht unbedingt „fehlgeschlagen“, sondern „bereits bearbeitet“ (accepted). Ein Fehlschlag stoppt die Leute wenigstens. „Bereits bearbeitet“ wird hingegen viel zu leicht als „Geld und Ware sind endgültig ausgetauscht“ verstanden. Auch on-chain gilt dasselbe: Wenn ein Block in das lokale Ledger gelangt, heißt das nicht, dass er bereits den letzten, absolut nicht ersetzbaren Schritt erreicht hat.
Ich habe die Rolling-Finality im Whitepaper von @Dusk neu gelesen und erst dabei erkannt: Dusk hat nicht alle „Bestätigungen“ zu einem einzigen Wort vermischt, sondern in vier Zustände aufgeteilt: accepted, attested, confirmed und final. Ein accepted-Block hat zwar einen Erfolgsnachweis erhalten, kann aber dennoch ersetzt werden – etwa wenn er aus einer höheren Iteration stammt und die vorherigen niedrigen Iterationen keine Fehlschlagsnachweise enthalten. Wenn später ein legaler Block aus einer niedrigeren Iteration auftaucht, wird der accepted-Block ersetzt, und die nachfolgenden Blöcke gehen dann ebenfalls mit zurück.
attested ist robuster, weil es entweder aus Iteration 0 stammt oder weil die vorherigen Iterationen bereits Fehlschlagsnachweise hinterlassen haben; confirmed braucht zusätzlich, dass nachfolgende Blöcke weiterhin dazu beitragen, dass die aktuelle Kette glaubwürdig bleibt. Nur final bedeutet: Der Parent-Block ist ebenfalls final; der gesamte Ahnenpfad ist „zugemacht“, nicht mehr ersetzbar.
Das Whitepaper gibt ein konkretes Beispiel: Ein Block entsteht in der 5. Iteration. Davor gab es aber nur zwei Iterationen mit Fehlschlagsnachweisen – deshalb wird er zunächst als accepted markiert. Er muss dann noch 4 aufeinanderfolgende attested- oder confirmed-Blöcke abwarten, bevor er confirmed wird. Das heißt: „Es ist bereits ein Block ausgegeben“ und „man kann die Wertpapierabwicklung als unwiderrufliche Tatsache behandeln“ können tatsächlich ein paar Schritte auseinanderliegen.
Ich finde diese Ehrlichkeit gut. Das Finanzsystem fürchtet am meisten, wenn Wahrscheinlichkeiten in ein grünes Häkchen versteckt werden. Aber es gibt auch Produktteams Hausaufgaben: Welche Status werden in der Wallet, an der Handelsschnittstelle und im Registersystem wirklich angezeigt? Wenn Nutzer sehen, dass es accepted ist – können sie dann weiter übertragen oder einlösen? Wenn das UI überall einfach „Erfolg“ schreibt, wird selbst ein noch so strenger Konsenszustand durch Copywriting geglättet.
Deshalb schaue ich mir Dusk’s Sekundenfinalität nicht nur an, wie viele Sekunden im Durchschnitt benötigt werden, sondern auch daran, wie die Verteilung aussieht, wenn Iterationen „abnormal“ sind – wie sie von accepted zu final kommen – und ob die Anwendung wirklich erst dann „abhakt“, wenn final erreicht ist. Finalität ist keine Marketing-Zahl, sondern eine Disziplin: Man darf „fast fertig“ nicht als „schon fertig“ verkaufen.
Ich habe die Rolling-Finality im Whitepaper von @Dusk neu gelesen und erst dabei erkannt: Dusk hat nicht alle „Bestätigungen“ zu einem einzigen Wort vermischt, sondern in vier Zustände aufgeteilt: accepted, attested, confirmed und final. Ein accepted-Block hat zwar einen Erfolgsnachweis erhalten, kann aber dennoch ersetzt werden – etwa wenn er aus einer höheren Iteration stammt und die vorherigen niedrigen Iterationen keine Fehlschlagsnachweise enthalten. Wenn später ein legaler Block aus einer niedrigeren Iteration auftaucht, wird der accepted-Block ersetzt, und die nachfolgenden Blöcke gehen dann ebenfalls mit zurück.
attested ist robuster, weil es entweder aus Iteration 0 stammt oder weil die vorherigen Iterationen bereits Fehlschlagsnachweise hinterlassen haben; confirmed braucht zusätzlich, dass nachfolgende Blöcke weiterhin dazu beitragen, dass die aktuelle Kette glaubwürdig bleibt. Nur final bedeutet: Der Parent-Block ist ebenfalls final; der gesamte Ahnenpfad ist „zugemacht“, nicht mehr ersetzbar.
Das Whitepaper gibt ein konkretes Beispiel: Ein Block entsteht in der 5. Iteration. Davor gab es aber nur zwei Iterationen mit Fehlschlagsnachweisen – deshalb wird er zunächst als accepted markiert. Er muss dann noch 4 aufeinanderfolgende attested- oder confirmed-Blöcke abwarten, bevor er confirmed wird. Das heißt: „Es ist bereits ein Block ausgegeben“ und „man kann die Wertpapierabwicklung als unwiderrufliche Tatsache behandeln“ können tatsächlich ein paar Schritte auseinanderliegen.
Ich finde diese Ehrlichkeit gut. Das Finanzsystem fürchtet am meisten, wenn Wahrscheinlichkeiten in ein grünes Häkchen versteckt werden. Aber es gibt auch Produktteams Hausaufgaben: Welche Status werden in der Wallet, an der Handelsschnittstelle und im Registersystem wirklich angezeigt? Wenn Nutzer sehen, dass es accepted ist – können sie dann weiter übertragen oder einlösen? Wenn das UI überall einfach „Erfolg“ schreibt, wird selbst ein noch so strenger Konsenszustand durch Copywriting geglättet.
Deshalb schaue ich mir Dusk’s Sekundenfinalität nicht nur an, wie viele Sekunden im Durchschnitt benötigt werden, sondern auch daran, wie die Verteilung aussieht, wenn Iterationen „abnormal“ sind – wie sie von accepted zu final kommen – und ob die Anwendung wirklich erst dann „abhakt“, wenn final erreicht ist. Finalität ist keine Marketing-Zahl, sondern eine Disziplin: Man darf „fast fertig“ nicht als „schon fertig“ verkaufen.
1
111
·
--
Der peinlichste Moment in einer Wertpapier-Abwicklungs-Chain: Es ist nicht unbedingt ein Hackerangriff, sondern eher, dass niemand eindeutig etwas Böses tut – und doch lässt sich das Ledger nicht weiterblättern. Knoten fallen aus, es kommt zu Netzwerkpartitionen, das Komitee schafft nicht die nötige Anzahl Stimmen; das Geld ist nicht weg, aber alle müssen warten. Bei einer öffentlichen Chain heißt das „Stau“, für einen Finanzmarkt kann es sich direkt zu einem Abwicklungsunfall entwickeln.
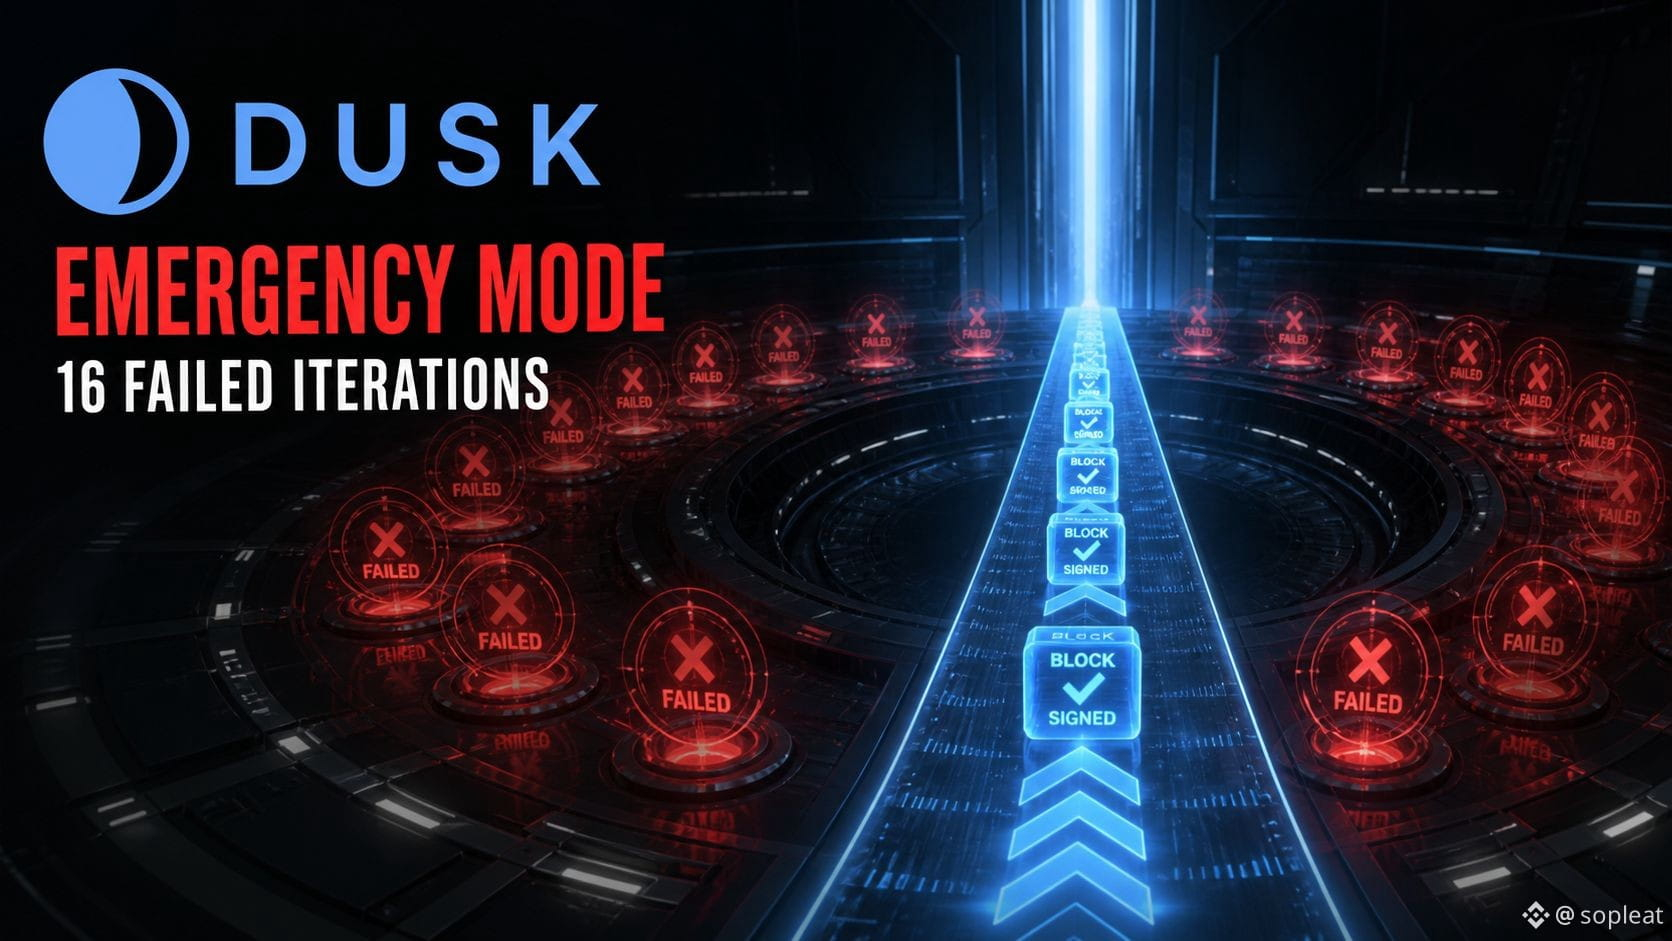
Ich habe das Whitepaper zum „Emergency Mode“ von @Dusk_Foundation erneut gelesen und festgestellt, dass es sich nicht nur so tut, als würde so etwas nicht passieren. Succinct Attestation führt pro Runde höchstens 50 Iterationen aus; wenn 16 Iterationen hintereinander fehlschlagen, geht das Protokoll in den Notfallmodus. Schritt-Schritte, die im normalen Ablauf per Timeout abbrechen, werden deaktiviert. „NoCandidate“ und „NoQuorum“ dienen dann nicht mehr als Ergebnis, das den Fortschritt auslöst. Die bereits gestarteten Iterationen warten stattdessen weiter, bis ein Kandidatenblock im Kandidatenbereich verfügbar ist und in den beiden Phasen Verifikation und Freigabe tatsächlich die gesetzliche Stimmenzahl erreicht ist.
Die Intention dieses Designs ist sehr klar: Im Normalbetrieb kann Konsens wegen Timeouts zur nächsten Runde von Teilnehmenden wechseln; in Extremfällen darf man aber nicht dauerhaft auf „niemand ist da“ hoffen, um das Problem einfach zu überspringen. Das System lässt lieber mehrere offene Iterationen parallel hängen, statt früher oder später aufzugeben – und wartet darauf, dass ein Block gefunden wird, den das Komitee bestätigen kann, um die Wahrscheinlichkeit zu erhöhen, dass das Ledger weiter vorankommt.
Doch die Kosten stehen ebenfalls im Whitepaper. Parallele Iterationen können dazu führen, dass in derselben Runde mehrere Kandidatenblöcke einen Konsens erhalten; das erhöht wiederum das Fork-Risiko. Das Protokoll kann dann nur den Kandidatenblock mit der niedrigsten Iterationsnummer zur Konvergenz bringen. Wenn es am Ende immer noch nicht gelingt, den Betrieb wiederherzustellen, können die meisten Stimmrechtsinhaber gemeinsam eine Notfall-Leerblockanfrage stellen, die keine Transaktionen enthält. Ein Dusk-Knoten erzeugt dann einen neuen Seed, sodass das Netzwerk diese Runde überspringen kann.
Ich werde das nicht als „niemals Abschalten“ verstehen. Es ist eher ein Handbuch für Katastrophenwiederherstellung: Es erkennt an, dass Konsens ins Stocken geraten kann, und legt zugleich fest, wer die Wiederherstellung vorantreiben darf und was dabei geopfert werden kann. Wenn ich mir später die Fähigkeiten zur Finanzabwicklung von $DUSK anschaue, interessiert mich vor allem, wie oft der Notfallmodus tatsächlich ausgelöst wird, wie lange er anhält, wie viele Forks entstehen und wie oft Leerblöcke angefordert werden – nicht nur, wie viele Sekunden im Normalzustand für das Produzieren eines Blocks benötigt werden.
Echte Infrastruktur auf Institutsniveau bedeutet nicht, dass nie Fehler auftreten. Sondern: Wenn Fehler passieren, sind die Regeln für die Behandlung im Voraus festgeschrieben – und die Kosten sind für alle sichtbar.
#dusk
Der peinlichste Moment in einer Wertpapier-Abwicklungs-Chain: Es ist nicht unbedingt ein Hackerangriff, sondern eher, dass niemand eindeutig etwas Böses tut – und doch lässt sich das Ledger nicht weiterblättern. Knoten fallen aus, es kommt zu Netzwerkpartitionen, das Komitee schafft nicht die nötige Anzahl Stimmen; das Geld ist nicht weg, aber alle müssen warten. Bei einer öffentlichen Chain heißt das „Stau“, für einen Finanzmarkt kann es sich direkt zu einem Abwicklungsunfall entwickeln.
Ich habe das Whitepaper zum „Emergency Mode“ von @Dusk erneut gelesen und festgestellt, dass es sich nicht nur so tut, als würde so etwas nicht passieren. Succinct Attestation führt pro Runde höchstens 50 Iterationen aus; wenn 16 Iterationen hintereinander fehlschlagen, geht das Protokoll in den Notfallmodus. Schritt-Schritte, die im normalen Ablauf per Timeout abbrechen, werden deaktiviert. „NoCandidate“ und „NoQuorum“ dienen dann nicht mehr als Ergebnis, das den Fortschritt auslöst. Die bereits gestarteten Iterationen warten stattdessen weiter, bis ein Kandidatenblock im Kandidatenbereich verfügbar ist und in den beiden Phasen Verifikation und Freigabe tatsächlich die gesetzliche Stimmenzahl erreicht ist.
Die Intention dieses Designs ist sehr klar: Im Normalbetrieb kann Konsens wegen Timeouts zur nächsten Runde von Teilnehmenden wechseln; in Extremfällen darf man aber nicht dauerhaft auf „niemand ist da“ hoffen, um das Problem einfach zu überspringen. Das System lässt lieber mehrere offene Iterationen parallel hängen, statt früher oder später aufzugeben – und wartet darauf, dass ein Block gefunden wird, den das Komitee bestätigen kann, um die Wahrscheinlichkeit zu erhöhen, dass das Ledger weiter vorankommt.
Doch die Kosten stehen ebenfalls im Whitepaper. Parallele Iterationen können dazu führen, dass in derselben Runde mehrere Kandidatenblöcke einen Konsens erhalten; das erhöht wiederum das Fork-Risiko. Das Protokoll kann dann nur den Kandidatenblock mit der niedrigsten Iterationsnummer zur Konvergenz bringen. Wenn es am Ende immer noch nicht gelingt, den Betrieb wiederherzustellen, können die meisten Stimmrechtsinhaber gemeinsam eine Notfall-Leerblockanfrage stellen, die keine Transaktionen enthält. Ein Dusk-Knoten erzeugt dann einen neuen Seed, sodass das Netzwerk diese Runde überspringen kann.
Ich werde das nicht als „niemals Abschalten“ verstehen. Es ist eher ein Handbuch für Katastrophenwiederherstellung: Es erkennt an, dass Konsens ins Stocken geraten kann, und legt zugleich fest, wer die Wiederherstellung vorantreiben darf und was dabei geopfert werden kann. Wenn ich mir später die Fähigkeiten zur Finanzabwicklung von $DUSK anschaue, interessiert mich vor allem, wie oft der Notfallmodus tatsächlich ausgelöst wird, wie lange er anhält, wie viele Forks entstehen und wie oft Leerblöcke angefordert werden – nicht nur, wie viele Sekunden im Normalzustand für das Produzieren eines Blocks benötigt werden.
Echte Infrastruktur auf Institutsniveau bedeutet nicht, dass nie Fehler auftreten. Sondern: Wenn Fehler passieren, sind die Regeln für die Behandlung im Voraus festgeschrieben – und die Kosten sind für alle sichtbar.
#dusk
Ich habe das Whitepaper zum „Emergency Mode“ von @Dusk erneut gelesen und festgestellt, dass es sich nicht nur so tut, als würde so etwas nicht passieren. Succinct Attestation führt pro Runde höchstens 50 Iterationen aus; wenn 16 Iterationen hintereinander fehlschlagen, geht das Protokoll in den Notfallmodus. Schritt-Schritte, die im normalen Ablauf per Timeout abbrechen, werden deaktiviert. „NoCandidate“ und „NoQuorum“ dienen dann nicht mehr als Ergebnis, das den Fortschritt auslöst. Die bereits gestarteten Iterationen warten stattdessen weiter, bis ein Kandidatenblock im Kandidatenbereich verfügbar ist und in den beiden Phasen Verifikation und Freigabe tatsächlich die gesetzliche Stimmenzahl erreicht ist.
Die Intention dieses Designs ist sehr klar: Im Normalbetrieb kann Konsens wegen Timeouts zur nächsten Runde von Teilnehmenden wechseln; in Extremfällen darf man aber nicht dauerhaft auf „niemand ist da“ hoffen, um das Problem einfach zu überspringen. Das System lässt lieber mehrere offene Iterationen parallel hängen, statt früher oder später aufzugeben – und wartet darauf, dass ein Block gefunden wird, den das Komitee bestätigen kann, um die Wahrscheinlichkeit zu erhöhen, dass das Ledger weiter vorankommt.
Doch die Kosten stehen ebenfalls im Whitepaper. Parallele Iterationen können dazu führen, dass in derselben Runde mehrere Kandidatenblöcke einen Konsens erhalten; das erhöht wiederum das Fork-Risiko. Das Protokoll kann dann nur den Kandidatenblock mit der niedrigsten Iterationsnummer zur Konvergenz bringen. Wenn es am Ende immer noch nicht gelingt, den Betrieb wiederherzustellen, können die meisten Stimmrechtsinhaber gemeinsam eine Notfall-Leerblockanfrage stellen, die keine Transaktionen enthält. Ein Dusk-Knoten erzeugt dann einen neuen Seed, sodass das Netzwerk diese Runde überspringen kann.
Ich werde das nicht als „niemals Abschalten“ verstehen. Es ist eher ein Handbuch für Katastrophenwiederherstellung: Es erkennt an, dass Konsens ins Stocken geraten kann, und legt zugleich fest, wer die Wiederherstellung vorantreiben darf und was dabei geopfert werden kann. Wenn ich mir später die Fähigkeiten zur Finanzabwicklung von $DUSK anschaue, interessiert mich vor allem, wie oft der Notfallmodus tatsächlich ausgelöst wird, wie lange er anhält, wie viele Forks entstehen und wie oft Leerblöcke angefordert werden – nicht nur, wie viele Sekunden im Normalzustand für das Produzieren eines Blocks benötigt werden.
Echte Infrastruktur auf Institutsniveau bedeutet nicht, dass nie Fehler auftreten. Sondern: Wenn Fehler passieren, sind die Regeln für die Behandlung im Voraus festgeschrieben – und die Kosten sind für alle sichtbar.
#dusk
1
2
94
·
--
Gestern Abend, als ich das „Dusk Whitepaper“ zu „Succinct Attestation“ gelesen habe, kam mir in meinem Kopf plötzlich ein ziemlich plattes Bild: Viele Blockproduzenten in verschiedenen Ketten sind wie eine Gruppe von Leuten, die sich das Mikrofon reißen – wer zuerst dran ist, sagt zuerst. Und @Dusk_Foundation wirkt eher so, als hätte man im Voraus den Moderator, die Prüfer und die Stempelbeamten ausgelost und ließe dann den Ablauf Schritt für Schritt durchlaufen.
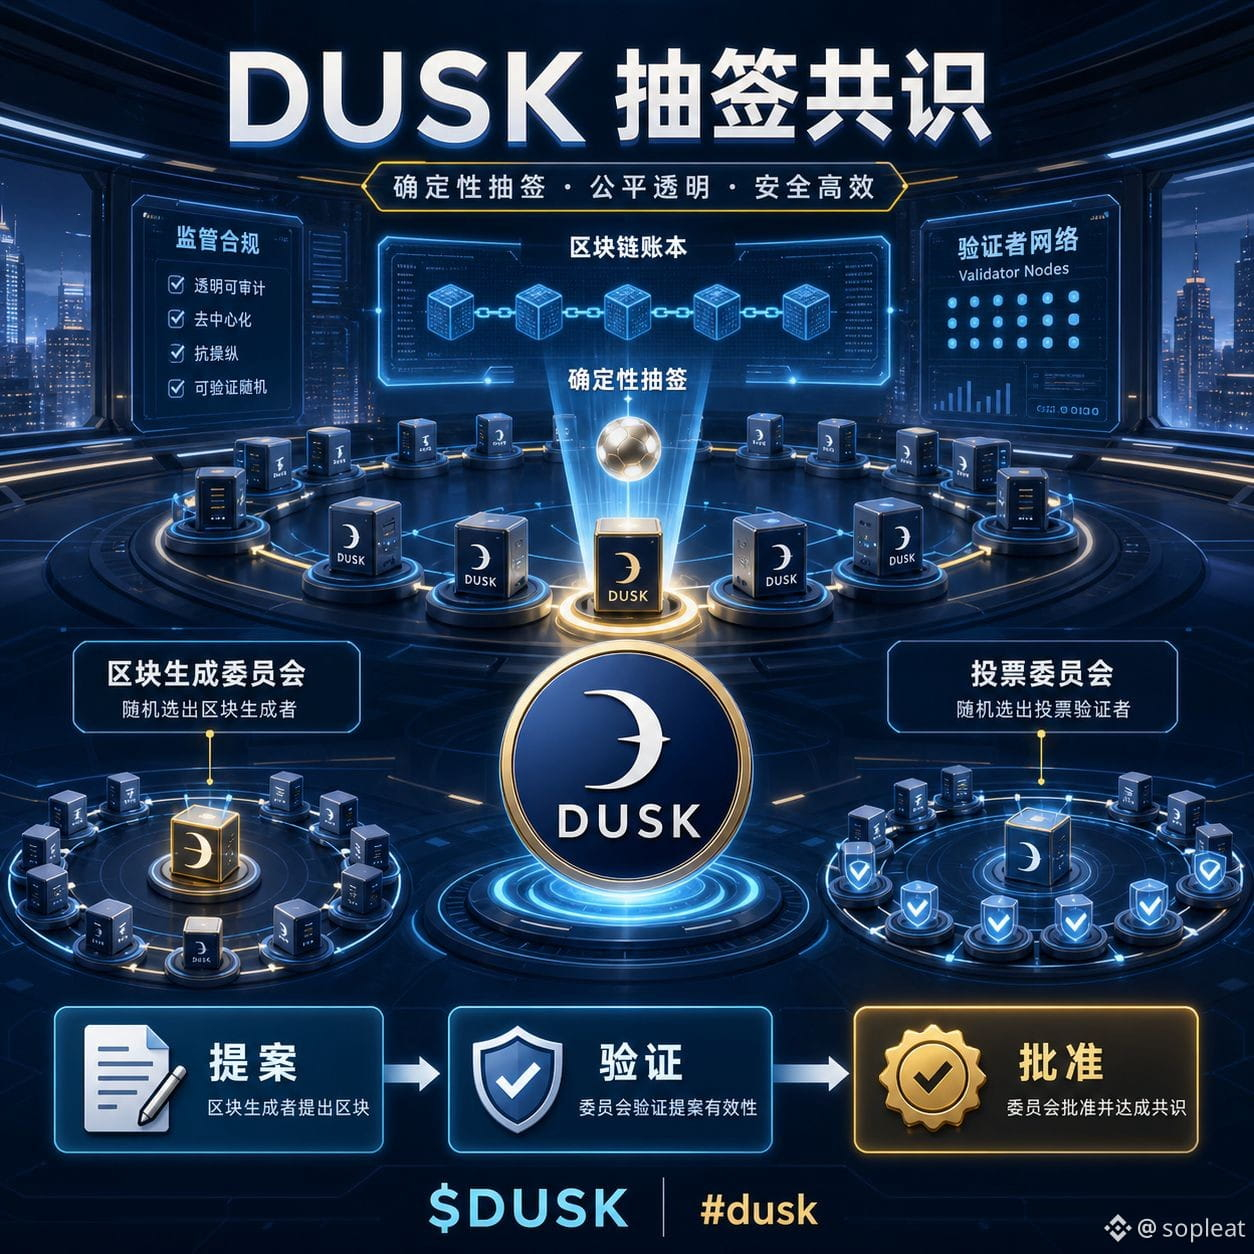
Das Wichtigste hier ist nicht „wer am schnellsten ist“, sondern deterministisches Losziehen. In jeder Runde wählt das System zuerst einen Block-Erzeuger aus, der einen Kandidatenblock vorschlägt; dann wird ein Verifizierungskomitee ausgewählt, das prüft, ob dieser Kandidatenblock gültig ist. Schließlich muss noch ein Approbationskomitee bestätigen. Im Whitepaper wird der Prozess in Proposal, Validation und Ratification aufgeteilt. In der Validierungsphase müssen mehr als zwei Drittel der gültigen Stimmen erreicht werden, und auch in der Approbationsphase muss die Bestätigung weiter erfolgen, damit der Kandidatenblock zum neuen Chain-Head wird.
Interessant finde ich dabei, dass das Design „Zufall“ und „Ordnung“ zusammenbringt. Das Losziehen senkt die Wahrscheinlichkeit, dass einzelne feste Knoten langfristig die Deutungshoheit über den Ton an sich reißen. Der dreistufige Ablauf verhindert außerdem, dass ein einzelner Blockproduzent mit einem Satz darüber entscheidet, ob am Ende alles steht oder fällt. Für Szenarien wie Wertpapierabrechnung ist das wichtiger als nur „TPS zu rufen“. Denn für Finanzmärkte ist nicht die ein paar Sekunden langsame Verarbeitung das Schlimmste, sondern dass Transaktionen so aussehen, als wären sie abgeschlossen – und später doch wieder zurückgedreht werden.
Natürlich ist Konsens durch Losziehen kein Allheilmittel. Dem, was es wirklich zu bestehen gilt, sind Hochlast-Netzwerklatenz, die Online-Quote der Komitees und die Frage, ob Verifizierungsstimmen dauerhaft stabil die Schwelle erreichen können. Wenn diese Daten nicht stabil sind, wird selbst ein noch so schöner Prozess zur Papierordnung.
Deshalb schaue ich mir jetzt $DUSK an, ohne nur auf die drei Worte „Privacy Chain“ zu starren. Ich achte darauf, ob die Konsensschicht langfristig stabil Ledger produziert, die am Ende auch wirklich bestätigt werden können. Beim On-Chain-Finanzgeschäft ist der erste Schritt nicht, Geschichten zu erzählen, sondern dass jede einzelne Buchungszeile von Menschen nach Regeln vorgeschlagen, validiert und schließlich genehmigt wird.
#dusk
Gestern Abend, als ich das „Dusk Whitepaper“ zu „Succinct Attestation“ gelesen habe, kam mir in meinem Kopf plötzlich ein ziemlich plattes Bild: Viele Blockproduzenten in verschiedenen Ketten sind wie eine Gruppe von Leuten, die sich das Mikrofon reißen – wer zuerst dran ist, sagt zuerst. Und @Dusk wirkt eher so, als hätte man im Voraus den Moderator, die Prüfer und die Stempelbeamten ausgelost und ließe dann den Ablauf Schritt für Schritt durchlaufen.
Das Wichtigste hier ist nicht „wer am schnellsten ist“, sondern deterministisches Losziehen. In jeder Runde wählt das System zuerst einen Block-Erzeuger aus, der einen Kandidatenblock vorschlägt; dann wird ein Verifizierungskomitee ausgewählt, das prüft, ob dieser Kandidatenblock gültig ist. Schließlich muss noch ein Approbationskomitee bestätigen. Im Whitepaper wird der Prozess in Proposal, Validation und Ratification aufgeteilt. In der Validierungsphase müssen mehr als zwei Drittel der gültigen Stimmen erreicht werden, und auch in der Approbationsphase muss die Bestätigung weiter erfolgen, damit der Kandidatenblock zum neuen Chain-Head wird.
Interessant finde ich dabei, dass das Design „Zufall“ und „Ordnung“ zusammenbringt. Das Losziehen senkt die Wahrscheinlichkeit, dass einzelne feste Knoten langfristig die Deutungshoheit über den Ton an sich reißen. Der dreistufige Ablauf verhindert außerdem, dass ein einzelner Blockproduzent mit einem Satz darüber entscheidet, ob am Ende alles steht oder fällt. Für Szenarien wie Wertpapierabrechnung ist das wichtiger als nur „TPS zu rufen“. Denn für Finanzmärkte ist nicht die ein paar Sekunden langsame Verarbeitung das Schlimmste, sondern dass Transaktionen so aussehen, als wären sie abgeschlossen – und später doch wieder zurückgedreht werden.
Natürlich ist Konsens durch Losziehen kein Allheilmittel. Dem, was es wirklich zu bestehen gilt, sind Hochlast-Netzwerklatenz, die Online-Quote der Komitees und die Frage, ob Verifizierungsstimmen dauerhaft stabil die Schwelle erreichen können. Wenn diese Daten nicht stabil sind, wird selbst ein noch so schöner Prozess zur Papierordnung.
Deshalb schaue ich mir jetzt $DUSK an, ohne nur auf die drei Worte „Privacy Chain“ zu starren. Ich achte darauf, ob die Konsensschicht langfristig stabil Ledger produziert, die am Ende auch wirklich bestätigt werden können. Beim On-Chain-Finanzgeschäft ist der erste Schritt nicht, Geschichten zu erzählen, sondern dass jede einzelne Buchungszeile von Menschen nach Regeln vorgeschlagen, validiert und schließlich genehmigt wird.
#dusk
Das Wichtigste hier ist nicht „wer am schnellsten ist“, sondern deterministisches Losziehen. In jeder Runde wählt das System zuerst einen Block-Erzeuger aus, der einen Kandidatenblock vorschlägt; dann wird ein Verifizierungskomitee ausgewählt, das prüft, ob dieser Kandidatenblock gültig ist. Schließlich muss noch ein Approbationskomitee bestätigen. Im Whitepaper wird der Prozess in Proposal, Validation und Ratification aufgeteilt. In der Validierungsphase müssen mehr als zwei Drittel der gültigen Stimmen erreicht werden, und auch in der Approbationsphase muss die Bestätigung weiter erfolgen, damit der Kandidatenblock zum neuen Chain-Head wird.
Interessant finde ich dabei, dass das Design „Zufall“ und „Ordnung“ zusammenbringt. Das Losziehen senkt die Wahrscheinlichkeit, dass einzelne feste Knoten langfristig die Deutungshoheit über den Ton an sich reißen. Der dreistufige Ablauf verhindert außerdem, dass ein einzelner Blockproduzent mit einem Satz darüber entscheidet, ob am Ende alles steht oder fällt. Für Szenarien wie Wertpapierabrechnung ist das wichtiger als nur „TPS zu rufen“. Denn für Finanzmärkte ist nicht die ein paar Sekunden langsame Verarbeitung das Schlimmste, sondern dass Transaktionen so aussehen, als wären sie abgeschlossen – und später doch wieder zurückgedreht werden.
Natürlich ist Konsens durch Losziehen kein Allheilmittel. Dem, was es wirklich zu bestehen gilt, sind Hochlast-Netzwerklatenz, die Online-Quote der Komitees und die Frage, ob Verifizierungsstimmen dauerhaft stabil die Schwelle erreichen können. Wenn diese Daten nicht stabil sind, wird selbst ein noch so schöner Prozess zur Papierordnung.
Deshalb schaue ich mir jetzt $DUSK an, ohne nur auf die drei Worte „Privacy Chain“ zu starren. Ich achte darauf, ob die Konsensschicht langfristig stabil Ledger produziert, die am Ende auch wirklich bestätigt werden können. Beim On-Chain-Finanzgeschäft ist der erste Schritt nicht, Geschichten zu erzählen, sondern dass jede einzelne Buchungszeile von Menschen nach Regeln vorgeschlagen, validiert und schließlich genehmigt wird.
#dusk
1
98
·
--
Alle schreien gleichzeitig, aber dadurch wird der Klang nicht unbedingt weiter getragen – im Gegenteil, vielleicht ist der Raum danach zuerst so laut, dass niemand mehr etwas klar hören kann.
Ich ging ursprünglich davon aus, dass die Logik der Blockchain-Übertragung von Transaktionen möglichst simpel sein sollte: Ein Knoten erhält eine Nachricht, leitet sie sofort an alle Knoten in seiner Umgebung weiter, und diese Knoten leiten sie dann weiter. Als ich jedoch im zweiten Kapitel des Whitepapers von 2024 zur @Dusk_Foundation blätterte, merkte ich, dass dieses gängige Gossip-Broadcasting ein sehr reales Problem hat: Dieselbe Transaktion und die Konsensabstimmung werden viele Male wiederholt gesendet. Je mehr Knoten beteiligt sind, desto gravierender werden redundante Nachrichten, der Bandbreitenverbrauch und mögliche Kollisionen.
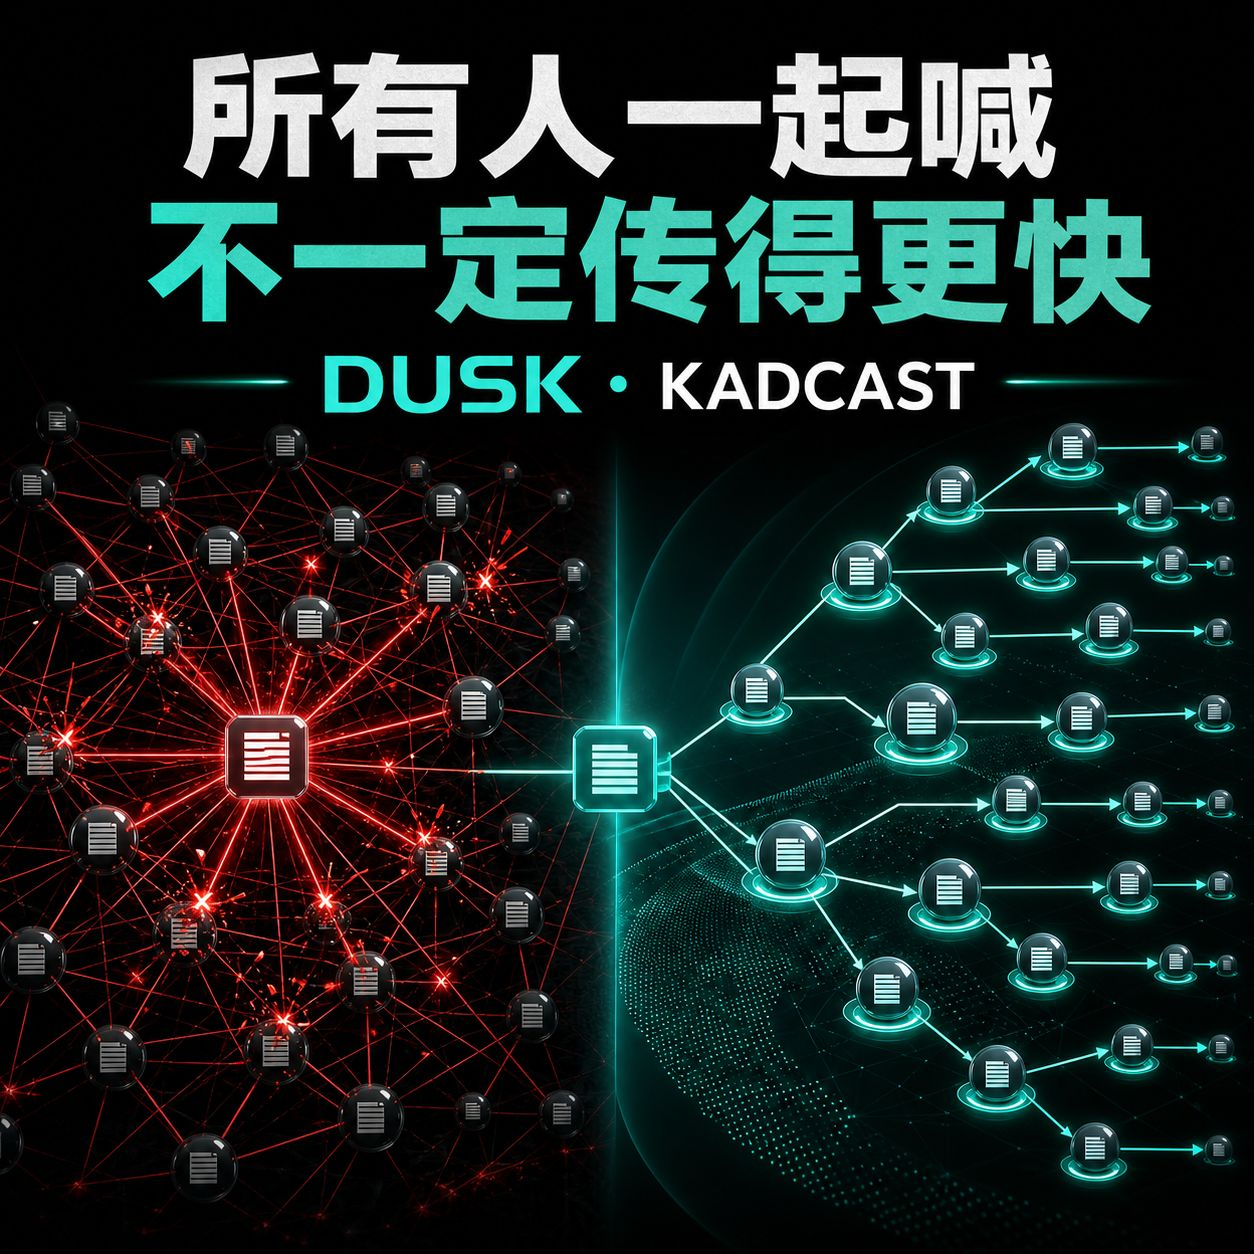
Dusk verwendet Kadcast, ohne dass Knoten unterschiedslos weiterleiten. Stattdessen übernimmt es die Struktur einer Kademlia-Distributed-Hash-Table. Jeder Knoten ordnet eine Routing-Tabelle anhand der XOR-Distanzen zwischen Knoten-IDs: Knoten mit unterschiedlichen Distanzen kommen in verschiedene Buckets. Wenn eine Nachricht eingeht, sendet er sie nicht an alle Nachbarn „im Sinne eines Broadcasts“, sondern wählt Knoten aus, deren Distanz schrittweise größer ist, um die Ausbreitung fortzusetzen – das ergibt eine kaskadierende Pfadstruktur, ähnlich einem Multicast-Baum.
In einfachen Worten: Gossip ist wie, wenn man in einer Gruppe „@alle“ schreibt – Kadcast ist eher wie die Benachrichtigung erst der Verantwortlichen in einzelnen Bereichen, die sie dann entlang der geplanten Routen weiter ausschicken. Nicht das Reduzieren der Abdeckung ist das Ziel, sondern mit weniger doppelten Übertragungen das gesamte Netzwerk zu erreichen.
Diese Struktur hat außerdem zwei Funktionen, die in den Whitepapers ganz explizit beschrieben werden. Erstens: Wenn ein Knoten offline ist, können andere Knoten im selben Bucket eine alternative Route bereitstellen; zweitens: Weil die Nachricht über mehrere zuvor ausgewählte Knoten verbreitet wird, ist es für externe Beobachter schwieriger, den ursprünglichen Absender direkt zurückzurechnen. Kadcast behandelt also nicht nur die Geschwindigkeit, sondern auch Fehlertoleranz bei Netzänderungen und die Privatsphäre der Nachrichtenquelle.
Aber „strukturiert“ bedeutet auch, dass die Routing-Tabelle extrem wichtig ist. Ob Knoten fehlerhafte Verbindungen rechtzeitig entfernen, ob Angreifer Buckets mit Schaddaten „vergiften“ können und ob bei einer plötzlichen Netzpartition genügend alternative Routen vorhanden sind – all das beeinflusst die Ausbreitung. Kadcast prüft die Echtheit der Nachrichten per Signatur, aber Signaturen verhindern Fälschungen – sie bedeuten nicht, dass jede legitime Nachricht garantiert rechtzeitig ankommt
Deshalb sind meine Beobachtungspunkte für $DUSK heute nicht TPS, sondern wie oft eine Nachricht tatsächlich weitergeleitet werden muss, um das Netzwerk abzudecken, und ob sich die Verbreitungs-„Verzögerung“ plötzlich verlängert, wenn Knoten offline gehen. Der Konsens entscheidet, welche Transaktion gültig ist; Kadcast sorgt dafür, dass die an dem Konsens Beteiligten rechtzeitig dieselbe Sache hören. Sobald die Broadcast-Schicht blockiert, kann selbst der schnellste Konsens nur vor Ort auf die Nachricht warten.
#dusk
Alle schreien gleichzeitig, aber dadurch wird der Klang nicht unbedingt weiter getragen – im Gegenteil, vielleicht ist der Raum danach zuerst so laut, dass niemand mehr etwas klar hören kann.
Ich ging ursprünglich davon aus, dass die Logik der Blockchain-Übertragung von Transaktionen möglichst simpel sein sollte: Ein Knoten erhält eine Nachricht, leitet sie sofort an alle Knoten in seiner Umgebung weiter, und diese Knoten leiten sie dann weiter. Als ich jedoch im zweiten Kapitel des Whitepapers von 2024 zur @Dusk blätterte, merkte ich, dass dieses gängige Gossip-Broadcasting ein sehr reales Problem hat: Dieselbe Transaktion und die Konsensabstimmung werden viele Male wiederholt gesendet. Je mehr Knoten beteiligt sind, desto gravierender werden redundante Nachrichten, der Bandbreitenverbrauch und mögliche Kollisionen.
Dusk verwendet Kadcast, ohne dass Knoten unterschiedslos weiterleiten. Stattdessen übernimmt es die Struktur einer Kademlia-Distributed-Hash-Table. Jeder Knoten ordnet eine Routing-Tabelle anhand der XOR-Distanzen zwischen Knoten-IDs: Knoten mit unterschiedlichen Distanzen kommen in verschiedene Buckets. Wenn eine Nachricht eingeht, sendet er sie nicht an alle Nachbarn „im Sinne eines Broadcasts“, sondern wählt Knoten aus, deren Distanz schrittweise größer ist, um die Ausbreitung fortzusetzen – das ergibt eine kaskadierende Pfadstruktur, ähnlich einem Multicast-Baum.
In einfachen Worten: Gossip ist wie, wenn man in einer Gruppe „@alle“ schreibt – Kadcast ist eher wie die Benachrichtigung erst der Verantwortlichen in einzelnen Bereichen, die sie dann entlang der geplanten Routen weiter ausschicken. Nicht das Reduzieren der Abdeckung ist das Ziel, sondern mit weniger doppelten Übertragungen das gesamte Netzwerk zu erreichen.
Diese Struktur hat außerdem zwei Funktionen, die in den Whitepapers ganz explizit beschrieben werden. Erstens: Wenn ein Knoten offline ist, können andere Knoten im selben Bucket eine alternative Route bereitstellen; zweitens: Weil die Nachricht über mehrere zuvor ausgewählte Knoten verbreitet wird, ist es für externe Beobachter schwieriger, den ursprünglichen Absender direkt zurückzurechnen. Kadcast behandelt also nicht nur die Geschwindigkeit, sondern auch Fehlertoleranz bei Netzänderungen und die Privatsphäre der Nachrichtenquelle.
Aber „strukturiert“ bedeutet auch, dass die Routing-Tabelle extrem wichtig ist. Ob Knoten fehlerhafte Verbindungen rechtzeitig entfernen, ob Angreifer Buckets mit Schaddaten „vergiften“ können und ob bei einer plötzlichen Netzpartition genügend alternative Routen vorhanden sind – all das beeinflusst die Ausbreitung. Kadcast prüft die Echtheit der Nachrichten per Signatur, aber Signaturen verhindern Fälschungen – sie bedeuten nicht, dass jede legitime Nachricht garantiert rechtzeitig ankommt
Deshalb sind meine Beobachtungspunkte für $DUSK heute nicht TPS, sondern wie oft eine Nachricht tatsächlich weitergeleitet werden muss, um das Netzwerk abzudecken, und ob sich die Verbreitungs-„Verzögerung“ plötzlich verlängert, wenn Knoten offline gehen. Der Konsens entscheidet, welche Transaktion gültig ist; Kadcast sorgt dafür, dass die an dem Konsens Beteiligten rechtzeitig dieselbe Sache hören. Sobald die Broadcast-Schicht blockiert, kann selbst der schnellste Konsens nur vor Ort auf die Nachricht warten.
#dusk
Ich ging ursprünglich davon aus, dass die Logik der Blockchain-Übertragung von Transaktionen möglichst simpel sein sollte: Ein Knoten erhält eine Nachricht, leitet sie sofort an alle Knoten in seiner Umgebung weiter, und diese Knoten leiten sie dann weiter. Als ich jedoch im zweiten Kapitel des Whitepapers von 2024 zur @Dusk blätterte, merkte ich, dass dieses gängige Gossip-Broadcasting ein sehr reales Problem hat: Dieselbe Transaktion und die Konsensabstimmung werden viele Male wiederholt gesendet. Je mehr Knoten beteiligt sind, desto gravierender werden redundante Nachrichten, der Bandbreitenverbrauch und mögliche Kollisionen.
Dusk verwendet Kadcast, ohne dass Knoten unterschiedslos weiterleiten. Stattdessen übernimmt es die Struktur einer Kademlia-Distributed-Hash-Table. Jeder Knoten ordnet eine Routing-Tabelle anhand der XOR-Distanzen zwischen Knoten-IDs: Knoten mit unterschiedlichen Distanzen kommen in verschiedene Buckets. Wenn eine Nachricht eingeht, sendet er sie nicht an alle Nachbarn „im Sinne eines Broadcasts“, sondern wählt Knoten aus, deren Distanz schrittweise größer ist, um die Ausbreitung fortzusetzen – das ergibt eine kaskadierende Pfadstruktur, ähnlich einem Multicast-Baum.
In einfachen Worten: Gossip ist wie, wenn man in einer Gruppe „@alle“ schreibt – Kadcast ist eher wie die Benachrichtigung erst der Verantwortlichen in einzelnen Bereichen, die sie dann entlang der geplanten Routen weiter ausschicken. Nicht das Reduzieren der Abdeckung ist das Ziel, sondern mit weniger doppelten Übertragungen das gesamte Netzwerk zu erreichen.
Diese Struktur hat außerdem zwei Funktionen, die in den Whitepapers ganz explizit beschrieben werden. Erstens: Wenn ein Knoten offline ist, können andere Knoten im selben Bucket eine alternative Route bereitstellen; zweitens: Weil die Nachricht über mehrere zuvor ausgewählte Knoten verbreitet wird, ist es für externe Beobachter schwieriger, den ursprünglichen Absender direkt zurückzurechnen. Kadcast behandelt also nicht nur die Geschwindigkeit, sondern auch Fehlertoleranz bei Netzänderungen und die Privatsphäre der Nachrichtenquelle.
Aber „strukturiert“ bedeutet auch, dass die Routing-Tabelle extrem wichtig ist. Ob Knoten fehlerhafte Verbindungen rechtzeitig entfernen, ob Angreifer Buckets mit Schaddaten „vergiften“ können und ob bei einer plötzlichen Netzpartition genügend alternative Routen vorhanden sind – all das beeinflusst die Ausbreitung. Kadcast prüft die Echtheit der Nachrichten per Signatur, aber Signaturen verhindern Fälschungen – sie bedeuten nicht, dass jede legitime Nachricht garantiert rechtzeitig ankommt
Deshalb sind meine Beobachtungspunkte für $DUSK heute nicht TPS, sondern wie oft eine Nachricht tatsächlich weitergeleitet werden muss, um das Netzwerk abzudecken, und ob sich die Verbreitungs-„Verzögerung“ plötzlich verlängert, wenn Knoten offline gehen. Der Konsens entscheidet, welche Transaktion gültig ist; Kadcast sorgt dafür, dass die an dem Konsens Beteiligten rechtzeitig dieselbe Sache hören. Sobald die Broadcast-Schicht blockiert, kann selbst der schnellste Konsens nur vor Ort auf die Nachricht warten.
#dusk
1
111
·
--
Wenn sich der Kurs in den frühen Morgenstunden plötzlich stark nach unten bewegt, ist das Gefährlichste nicht, dass ein Trade nur zehn Sekunden zu langsam ausgeführt wird, sondern dass du glaubst, er sei bereits ausgeführt – und das System dir Minuten später sagt: Die betreffende Transaktion gilt nicht.
Das ist auch das zentrale Problem, das mir bei der Fortsetzung des Aufbaus des Konsensmechanismus um @Dusk_Foundation am meisten am Herzen liegt. Viele öffentliche Ketten werben damit, wie viele Transaktionen sie pro Sekunde verarbeiten können, aber in den Finanzmärkten zählt etwas anderes: In dem Moment, in dem auf dem Bildschirm „abgeschlossen“ angezeigt wird – wurde das Eigentum an den Vermögenswerten wirklich vollständig und unwiderruflich festgelegt?
Ducks Succinct Attestation sorgt nicht dafür, dass ein einzelner Knoten zugleich Blöcke erzeugt und sich selbst bestätigt, sondern teilt jede Runde des Konsenses in drei Türen.
Die erste Tür ist der Vorschlag. Das System wählt aus den Stakern den Blockproduzenten aus. Er ordnet die Transaktionen und sendet einen Kandidatenblock aus.
Die zweite Tür ist die Verifikation. Ein zufällig ausgewähltes Komitee prüft, ob der Block gültig ist, und stimmt über das Ergebnis ab. Hier geht es um die Frage: Können diese Transaktionen in das Ledger aufgenommen werden?
Die dritte Tür ist die Genehmigung. Ein weiteres Komitee bestätigt das Verifikationsergebnis erneut. Sobald die erforderliche Stimmenzahl erreicht ist, entsteht ein Beweis und die endgültige Bestätigung ist abgeschlossen. Anders gesagt: Aufgabenstellen für das Aufstellen, das Korrigieren und die finale Unterschrift werden nicht vollständig von derselben Gruppe übernommen.
Früher fragte ich mich, ob ein dreistufiges Design den Prozess nicht zu schwer macht. Später wurde mir klar, dass Dusk darauf setzt, mit kleineren, zufällig ausgewählten Komitees die Kommunikation im gesamten Netzwerk zu reduzieren – und zugleich zwei unabhängige Bewertungen beizubehalten. Die Website nennt derzeit eine finale Endgültigkeit von etwa 10 Sekunden. Sobald ein Block die Genehmigungsphase durchlaufen hat, ist das Ergebnis deterministisch. Unter normalen Umständen müssen Nutzer nicht mehr Dutzende von Bestätigungen mit zählen, und man muss sich auch keine Sorgen machen, dass ein Reorg eine bereits akzeptierte Ausführung wieder „zurückdreht“.
Das ist besonders wichtig für Finanztransaktionen. Nimm an, der „Asset-Leg“ wird bereits als Abwicklung angezeigt, aber der „Payment-Leg“ schlägt wegen eines Reorgs fehl. Dann steht nicht nur eine einzelne fehlgeschlagene Überweisung an – sondern Eigentumsverhältnisse, Buchhaltungsaufzeichnungen und die Verantwortlichkeiten gegenüber dem Gegenparteirisiko geraten gleichzeitig in Konflikt. Was die deterministische Endgültigkeit wirklich reduziert, ist das Risiko-Fenster nach dem Abschluss, in dem man nicht weiß, ob es am Ende „wirklich gilt“.
Aber auch diese drei Türen bedeuten nicht absolute Sicherheit. Ob die Größe des zufällig ausgewählten Komitees ausreicht, ob Knoten konzentriert sind und ob bei Netzwerkstau eine stabile Endgültigkeit beibehalten werden kann, muss durch langfristige Daten verifiziert werden. So schön das Protokolldesign auch ist – es muss auch Knoten-Ausfälle und extreme Verkehrsaufkommen überstehen.
Darum schaue ich bei $DUSK nicht nur auf die beworbene Zahl „10 Sekunden“. Ich möchte vor allem kontinuierliche Endgültigkeit sehen, die Beteiligungsquote der Komitees und den Anteil an anomalien Runden.
#dusk
Wenn sich der Kurs in den frühen Morgenstunden plötzlich stark nach unten bewegt, ist das Gefährlichste nicht, dass ein Trade nur zehn Sekunden zu langsam ausgeführt wird, sondern dass du glaubst, er sei bereits ausgeführt – und das System dir Minuten später sagt: Die betreffende Transaktion gilt nicht.
Das ist auch das zentrale Problem, das mir bei der Fortsetzung des Aufbaus des Konsensmechanismus um @Dusk am meisten am Herzen liegt. Viele öffentliche Ketten werben damit, wie viele Transaktionen sie pro Sekunde verarbeiten können, aber in den Finanzmärkten zählt etwas anderes: In dem Moment, in dem auf dem Bildschirm „abgeschlossen“ angezeigt wird – wurde das Eigentum an den Vermögenswerten wirklich vollständig und unwiderruflich festgelegt?
Ducks Succinct Attestation sorgt nicht dafür, dass ein einzelner Knoten zugleich Blöcke erzeugt und sich selbst bestätigt, sondern teilt jede Runde des Konsenses in drei Türen.
Die erste Tür ist der Vorschlag. Das System wählt aus den Stakern den Blockproduzenten aus. Er ordnet die Transaktionen und sendet einen Kandidatenblock aus.
Die zweite Tür ist die Verifikation. Ein zufällig ausgewähltes Komitee prüft, ob der Block gültig ist, und stimmt über das Ergebnis ab. Hier geht es um die Frage: Können diese Transaktionen in das Ledger aufgenommen werden?
Die dritte Tür ist die Genehmigung. Ein weiteres Komitee bestätigt das Verifikationsergebnis erneut. Sobald die erforderliche Stimmenzahl erreicht ist, entsteht ein Beweis und die endgültige Bestätigung ist abgeschlossen. Anders gesagt: Aufgabenstellen für das Aufstellen, das Korrigieren und die finale Unterschrift werden nicht vollständig von derselben Gruppe übernommen.
Früher fragte ich mich, ob ein dreistufiges Design den Prozess nicht zu schwer macht. Später wurde mir klar, dass Dusk darauf setzt, mit kleineren, zufällig ausgewählten Komitees die Kommunikation im gesamten Netzwerk zu reduzieren – und zugleich zwei unabhängige Bewertungen beizubehalten. Die Website nennt derzeit eine finale Endgültigkeit von etwa 10 Sekunden. Sobald ein Block die Genehmigungsphase durchlaufen hat, ist das Ergebnis deterministisch. Unter normalen Umständen müssen Nutzer nicht mehr Dutzende von Bestätigungen mit zählen, und man muss sich auch keine Sorgen machen, dass ein Reorg eine bereits akzeptierte Ausführung wieder „zurückdreht“.
Das ist besonders wichtig für Finanztransaktionen. Nimm an, der „Asset-Leg“ wird bereits als Abwicklung angezeigt, aber der „Payment-Leg“ schlägt wegen eines Reorgs fehl. Dann steht nicht nur eine einzelne fehlgeschlagene Überweisung an – sondern Eigentumsverhältnisse, Buchhaltungsaufzeichnungen und die Verantwortlichkeiten gegenüber dem Gegenparteirisiko geraten gleichzeitig in Konflikt. Was die deterministische Endgültigkeit wirklich reduziert, ist das Risiko-Fenster nach dem Abschluss, in dem man nicht weiß, ob es am Ende „wirklich gilt“.
Aber auch diese drei Türen bedeuten nicht absolute Sicherheit. Ob die Größe des zufällig ausgewählten Komitees ausreicht, ob Knoten konzentriert sind und ob bei Netzwerkstau eine stabile Endgültigkeit beibehalten werden kann, muss durch langfristige Daten verifiziert werden. So schön das Protokolldesign auch ist – es muss auch Knoten-Ausfälle und extreme Verkehrsaufkommen überstehen.
Darum schaue ich bei $DUSK nicht nur auf die beworbene Zahl „10 Sekunden“. Ich möchte vor allem kontinuierliche Endgültigkeit sehen, die Beteiligungsquote der Komitees und den Anteil an anomalien Runden.
#dusk
Das ist auch das zentrale Problem, das mir bei der Fortsetzung des Aufbaus des Konsensmechanismus um @Dusk am meisten am Herzen liegt. Viele öffentliche Ketten werben damit, wie viele Transaktionen sie pro Sekunde verarbeiten können, aber in den Finanzmärkten zählt etwas anderes: In dem Moment, in dem auf dem Bildschirm „abgeschlossen“ angezeigt wird – wurde das Eigentum an den Vermögenswerten wirklich vollständig und unwiderruflich festgelegt?
Ducks Succinct Attestation sorgt nicht dafür, dass ein einzelner Knoten zugleich Blöcke erzeugt und sich selbst bestätigt, sondern teilt jede Runde des Konsenses in drei Türen.
Die erste Tür ist der Vorschlag. Das System wählt aus den Stakern den Blockproduzenten aus. Er ordnet die Transaktionen und sendet einen Kandidatenblock aus.
Die zweite Tür ist die Verifikation. Ein zufällig ausgewähltes Komitee prüft, ob der Block gültig ist, und stimmt über das Ergebnis ab. Hier geht es um die Frage: Können diese Transaktionen in das Ledger aufgenommen werden?
Die dritte Tür ist die Genehmigung. Ein weiteres Komitee bestätigt das Verifikationsergebnis erneut. Sobald die erforderliche Stimmenzahl erreicht ist, entsteht ein Beweis und die endgültige Bestätigung ist abgeschlossen. Anders gesagt: Aufgabenstellen für das Aufstellen, das Korrigieren und die finale Unterschrift werden nicht vollständig von derselben Gruppe übernommen.
Früher fragte ich mich, ob ein dreistufiges Design den Prozess nicht zu schwer macht. Später wurde mir klar, dass Dusk darauf setzt, mit kleineren, zufällig ausgewählten Komitees die Kommunikation im gesamten Netzwerk zu reduzieren – und zugleich zwei unabhängige Bewertungen beizubehalten. Die Website nennt derzeit eine finale Endgültigkeit von etwa 10 Sekunden. Sobald ein Block die Genehmigungsphase durchlaufen hat, ist das Ergebnis deterministisch. Unter normalen Umständen müssen Nutzer nicht mehr Dutzende von Bestätigungen mit zählen, und man muss sich auch keine Sorgen machen, dass ein Reorg eine bereits akzeptierte Ausführung wieder „zurückdreht“.
Das ist besonders wichtig für Finanztransaktionen. Nimm an, der „Asset-Leg“ wird bereits als Abwicklung angezeigt, aber der „Payment-Leg“ schlägt wegen eines Reorgs fehl. Dann steht nicht nur eine einzelne fehlgeschlagene Überweisung an – sondern Eigentumsverhältnisse, Buchhaltungsaufzeichnungen und die Verantwortlichkeiten gegenüber dem Gegenparteirisiko geraten gleichzeitig in Konflikt. Was die deterministische Endgültigkeit wirklich reduziert, ist das Risiko-Fenster nach dem Abschluss, in dem man nicht weiß, ob es am Ende „wirklich gilt“.
Aber auch diese drei Türen bedeuten nicht absolute Sicherheit. Ob die Größe des zufällig ausgewählten Komitees ausreicht, ob Knoten konzentriert sind und ob bei Netzwerkstau eine stabile Endgültigkeit beibehalten werden kann, muss durch langfristige Daten verifiziert werden. So schön das Protokolldesign auch ist – es muss auch Knoten-Ausfälle und extreme Verkehrsaufkommen überstehen.
Darum schaue ich bei $DUSK nicht nur auf die beworbene Zahl „10 Sekunden“. Ich möchte vor allem kontinuierliche Endgültigkeit sehen, die Beteiligungsquote der Komitees und den Anteil an anomalien Runden.
#dusk
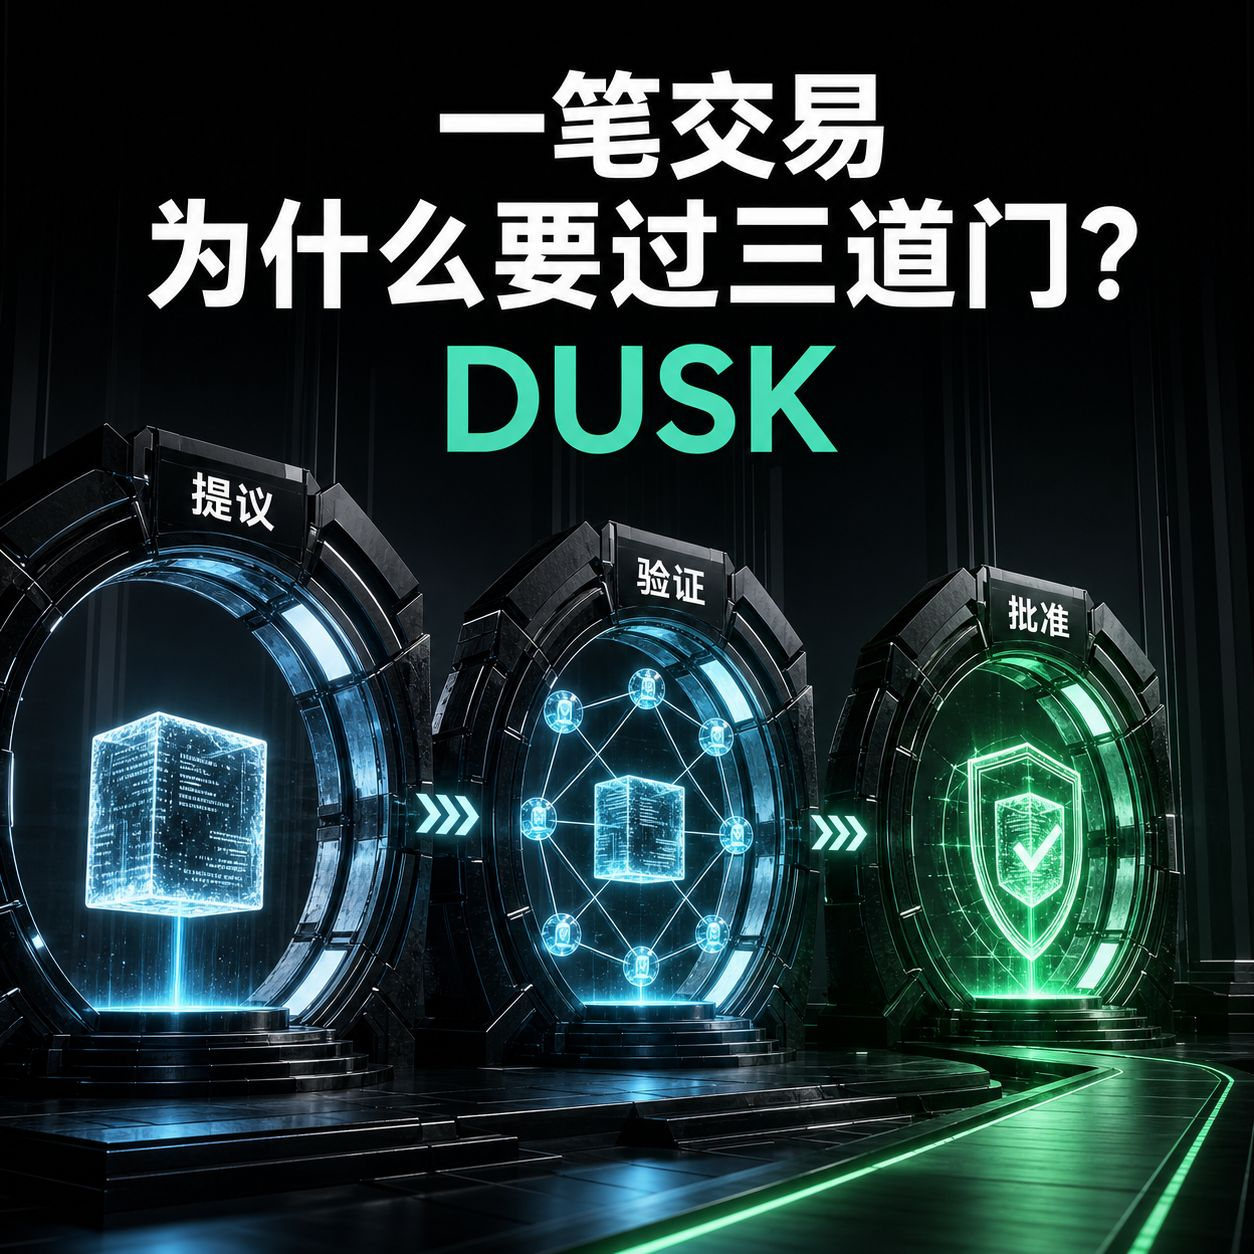
1
125
·
--
Nicht das Verlangen der Plattform, deine Identität zu verifizieren, ist das wirklich Schreckliche – sondern dass du, um zu beweisen, dass du „berechtigt“ bist, gezwungen wirst, deine komplette Lebensakte abzugeben.
Viele Finanzplattformen wollen nur drei Dinge bestätigen: ob du volljährig bist, aus welchem Rechtsgebiet du kommst und ob du ein qualifizierter Anleger bist. In der Realität verlangen KYC-Prozesse jedoch oft, dass Nutzer Ausweis, Adressnachweise, Einkommensnachweise oder sogar vollständige Vermögensnachweise hochladen. Die Plattform braucht am Ende eigentlich nur ein „Ja oder Nein“ – nimmt jedoch stattdessen ein ganzes Set persönlicher Daten mit, das sich langfristig speichern, abgleichen und möglicherweise auch leaken lässt.
Heute habe ich weiter das Citadel-Identitätsprotokoll von @Dusk_Foundation zerlegt und festgestellt, dass es genau diese Art des Datenaustauschs verändern will. Citadel teilt den Ablauf in drei Rollen ein: Nutzer, Qualifikationsanbieter und Diensteanbieter. Der Qualifikationsanbieter prüft zuerst die Originalunterlagen und stellt digitale Nachweise aus. Wenn der Nutzer dann eine Wertpapierplattform aufrufen möchte, nutzt er einen Zero-Knowledge-Beweis, um die von der Plattform gestellten Fragen zu beantworten. Die Plattform kann bestätigen: „Alter erfüllt die Voraussetzung“, „Standort erlaubt die Teilnahme“ oder „entspricht den Anforderungen an Anleger“ – muss aber nicht unbedingt Geburtsdatum, Wohnadresse und konkrete Vermögenszahlen sehen.
Das führt nicht dazu, dass Identität verschwindet, sondern dass aus „Unterlagen einreichen“ „Bedingungen nachweisen“ wird. Dieselbe Qualifikation kann außerdem in unterschiedlichen Diensten verwendet werden; du musst nicht jedes Mal, wenn du die Plattform wechselst, erneut einen Ausweis hochladen. Für Nutzer bedeutet das weniger Offenlegung der Privatsphäre und weniger wiederholtes KYC; für Institutionen bedeutet es weniger Verantwortung, weil über lange Zeit hinweg große Mengen sensibler Daten verwahrt werden müssen.
Allerdings gibt es bei diesem Design ein Problem, das man nicht einfach umgehen kann: Wer stellt dem Qualifikationsanbieter die Lizenz aus? Wenn nur wenige Institutionen die Ausstellung der Nachweise monopolisieren, könnten sie weiterhin zu neuen Einstiegspunkten für Identitäten werden. Wenn Nachweise ablaufen, widerrufen werden oder fälschlicherweise ausgestellt wurden, muss die On-Chain-Anwendung das ebenfalls zeitnah synchronisieren – sonst gilt „Zero-Knowledge-Beweis erfolgreich“ nicht automatisch als „reale Berechtigung ist weiterhin gültig“.
Darum glaube ich, dass Citadel nicht nur beweisen muss, ob die Kryptografie funktioniert, sondern ob mehrere lizensierte Institutionen gemeinsam Nachweise ausstellen können, ob Nutzer Dienste frei wechseln können und ob Widerrufe von Informationen rechtzeitig wirksam werden. Nur wenn sich der Berechtigungsnachweis mitnehmen lässt und die Identitätsdaten nicht überall kopiert werden müssen, ist die Privatsphäre-Identitätsschicht von Dusk mehr als nur eine technische Vorführung – und könnte zu einer grundlegenden Infrastruktur werden, um regulierte Vermögenswerte on-chain zu bringen.
$DUSK #dusk
Nicht das Verlangen der Plattform, deine Identität zu verifizieren, ist das wirklich Schreckliche – sondern dass du, um zu beweisen, dass du „berechtigt“ bist, gezwungen wirst, deine komplette Lebensakte abzugeben.
Viele Finanzplattformen wollen nur drei Dinge bestätigen: ob du volljährig bist, aus welchem Rechtsgebiet du kommst und ob du ein qualifizierter Anleger bist. In der Realität verlangen KYC-Prozesse jedoch oft, dass Nutzer Ausweis, Adressnachweise, Einkommensnachweise oder sogar vollständige Vermögensnachweise hochladen. Die Plattform braucht am Ende eigentlich nur ein „Ja oder Nein“ – nimmt jedoch stattdessen ein ganzes Set persönlicher Daten mit, das sich langfristig speichern, abgleichen und möglicherweise auch leaken lässt.
Heute habe ich weiter das Citadel-Identitätsprotokoll von @Dusk zerlegt und festgestellt, dass es genau diese Art des Datenaustauschs verändern will. Citadel teilt den Ablauf in drei Rollen ein: Nutzer, Qualifikationsanbieter und Diensteanbieter. Der Qualifikationsanbieter prüft zuerst die Originalunterlagen und stellt digitale Nachweise aus. Wenn der Nutzer dann eine Wertpapierplattform aufrufen möchte, nutzt er einen Zero-Knowledge-Beweis, um die von der Plattform gestellten Fragen zu beantworten. Die Plattform kann bestätigen: „Alter erfüllt die Voraussetzung“, „Standort erlaubt die Teilnahme“ oder „entspricht den Anforderungen an Anleger“ – muss aber nicht unbedingt Geburtsdatum, Wohnadresse und konkrete Vermögenszahlen sehen.
Das führt nicht dazu, dass Identität verschwindet, sondern dass aus „Unterlagen einreichen“ „Bedingungen nachweisen“ wird. Dieselbe Qualifikation kann außerdem in unterschiedlichen Diensten verwendet werden; du musst nicht jedes Mal, wenn du die Plattform wechselst, erneut einen Ausweis hochladen. Für Nutzer bedeutet das weniger Offenlegung der Privatsphäre und weniger wiederholtes KYC; für Institutionen bedeutet es weniger Verantwortung, weil über lange Zeit hinweg große Mengen sensibler Daten verwahrt werden müssen.
Allerdings gibt es bei diesem Design ein Problem, das man nicht einfach umgehen kann: Wer stellt dem Qualifikationsanbieter die Lizenz aus? Wenn nur wenige Institutionen die Ausstellung der Nachweise monopolisieren, könnten sie weiterhin zu neuen Einstiegspunkten für Identitäten werden. Wenn Nachweise ablaufen, widerrufen werden oder fälschlicherweise ausgestellt wurden, muss die On-Chain-Anwendung das ebenfalls zeitnah synchronisieren – sonst gilt „Zero-Knowledge-Beweis erfolgreich“ nicht automatisch als „reale Berechtigung ist weiterhin gültig“.
Darum glaube ich, dass Citadel nicht nur beweisen muss, ob die Kryptografie funktioniert, sondern ob mehrere lizensierte Institutionen gemeinsam Nachweise ausstellen können, ob Nutzer Dienste frei wechseln können und ob Widerrufe von Informationen rechtzeitig wirksam werden. Nur wenn sich der Berechtigungsnachweis mitnehmen lässt und die Identitätsdaten nicht überall kopiert werden müssen, ist die Privatsphäre-Identitätsschicht von Dusk mehr als nur eine technische Vorführung – und könnte zu einer grundlegenden Infrastruktur werden, um regulierte Vermögenswerte on-chain zu bringen.
$DUSK #dusk
Viele Finanzplattformen wollen nur drei Dinge bestätigen: ob du volljährig bist, aus welchem Rechtsgebiet du kommst und ob du ein qualifizierter Anleger bist. In der Realität verlangen KYC-Prozesse jedoch oft, dass Nutzer Ausweis, Adressnachweise, Einkommensnachweise oder sogar vollständige Vermögensnachweise hochladen. Die Plattform braucht am Ende eigentlich nur ein „Ja oder Nein“ – nimmt jedoch stattdessen ein ganzes Set persönlicher Daten mit, das sich langfristig speichern, abgleichen und möglicherweise auch leaken lässt.
Heute habe ich weiter das Citadel-Identitätsprotokoll von @Dusk zerlegt und festgestellt, dass es genau diese Art des Datenaustauschs verändern will. Citadel teilt den Ablauf in drei Rollen ein: Nutzer, Qualifikationsanbieter und Diensteanbieter. Der Qualifikationsanbieter prüft zuerst die Originalunterlagen und stellt digitale Nachweise aus. Wenn der Nutzer dann eine Wertpapierplattform aufrufen möchte, nutzt er einen Zero-Knowledge-Beweis, um die von der Plattform gestellten Fragen zu beantworten. Die Plattform kann bestätigen: „Alter erfüllt die Voraussetzung“, „Standort erlaubt die Teilnahme“ oder „entspricht den Anforderungen an Anleger“ – muss aber nicht unbedingt Geburtsdatum, Wohnadresse und konkrete Vermögenszahlen sehen.
Das führt nicht dazu, dass Identität verschwindet, sondern dass aus „Unterlagen einreichen“ „Bedingungen nachweisen“ wird. Dieselbe Qualifikation kann außerdem in unterschiedlichen Diensten verwendet werden; du musst nicht jedes Mal, wenn du die Plattform wechselst, erneut einen Ausweis hochladen. Für Nutzer bedeutet das weniger Offenlegung der Privatsphäre und weniger wiederholtes KYC; für Institutionen bedeutet es weniger Verantwortung, weil über lange Zeit hinweg große Mengen sensibler Daten verwahrt werden müssen.
Allerdings gibt es bei diesem Design ein Problem, das man nicht einfach umgehen kann: Wer stellt dem Qualifikationsanbieter die Lizenz aus? Wenn nur wenige Institutionen die Ausstellung der Nachweise monopolisieren, könnten sie weiterhin zu neuen Einstiegspunkten für Identitäten werden. Wenn Nachweise ablaufen, widerrufen werden oder fälschlicherweise ausgestellt wurden, muss die On-Chain-Anwendung das ebenfalls zeitnah synchronisieren – sonst gilt „Zero-Knowledge-Beweis erfolgreich“ nicht automatisch als „reale Berechtigung ist weiterhin gültig“.
Darum glaube ich, dass Citadel nicht nur beweisen muss, ob die Kryptografie funktioniert, sondern ob mehrere lizensierte Institutionen gemeinsam Nachweise ausstellen können, ob Nutzer Dienste frei wechseln können und ob Widerrufe von Informationen rechtzeitig wirksam werden. Nur wenn sich der Berechtigungsnachweis mitnehmen lässt und die Identitätsdaten nicht überall kopiert werden müssen, ist die Privatsphäre-Identitätsschicht von Dusk mehr als nur eine technische Vorführung – und könnte zu einer grundlegenden Infrastruktur werden, um regulierte Vermögenswerte on-chain zu bringen.
$DUSK #dusk
1
101
·
--
Hängt den Kontoauszug in der Filiale an die Wand—niemand würde das „vertrauenswürdiges Finanzwesen“ nennen. Doch bei einer Public Chain bleiben Guthaben, Überweisungen und Gegenparteien langfristig unverschleiert, werden aber oft als „transparent“ verpackt. Als ich gestern weiter die Dusk-Dokumente zerlegte, stellte ich fest, dass es dabei nicht darum geht, dass alle Informationen verschwinden, sondern darum, „wer welche Informationen sehen darf“ in das Protokoll zu schreiben.
Das Phoenix-Modell mit <b>@Dusk_Foundation </b> macht das Geld zu verschlüsselten Notes: Ein normaler Beobachter kann Überweisungsbeträge, die Sende-Beziehung und die konkreten Notes nicht sehen, aber die Transaktion muss weiterhin mittels Zero-Knowledge beweisen, dass das Guthaben ausreicht und keine Doppelbuchung (Double Spend) vorliegt. Am leichtesten wird das missverstanden, wenn man „selektive Offenlegung“ so versteht, als würde man Aufsehern ein Allzweck-Schlüsselchen einbauen, mit dem man auf das gesamte Kontenbuch im Netz zugreifen kann. In Wahrheit ermöglicht es relevanten Nutzern, durch das Überprüfen von Schlüsseln gezielt einen bestimmten Informationsbereich an ausstellende Stellen, Orte oder Auditoren zu übergeben, die eine Verifikation benötigen. Öffentliche Verifikation sorgt dafür, dass die Regeln nicht gebrochen werden; kontrollierte Offenlegung beantwortet die Frage nach Verantwortung in der realen Welt.
Die Identitätsschicht Citadel von Dusk treibt das Ganze noch einen Schritt weiter. Nutzer müssen nicht bei jeder Einreichung vollständige Ausweisdokumente vorlegen, sondern können nachweisen, dass „der Wohnsitz den Anforderungen entspricht“, „das Alter passt“ oder „es liegt die Qualifikation eines zugelassenen Anlegers vor“—also bestimmte Attribute. Die Service-Seite erhält dann die Antwort auf die Frage, ob Zugang gewährt wird, und muss nicht unbedingt die gesamte Identitätsakte abgreifen. Anders gesagt: Das System versucht, die in klassischem KYC übertriebene Gewohnheit des Sammelns personenbezogener Daten zu verkleinern und auf eine einzige, minimal notwendige Bestätigung zu komprimieren.
Doch selektive Offenlegung ist nicht von Natur aus gleichbedeutend mit Sicherheit. Das eigentliche Problem ist: Wer verwahrt die Schlüssel, wie lange darf man sie einsehen, wie wird mit einer etwaigen Leckage umgegangen, und können unterschiedliche Institutionen nur die Daten erhalten, die in ihren Aufgabenbereich fallen? Wenn eine Anwendung aus Bequemlichkeit die Schlüssel dauerhaft zentral speichert, kann selbst ein noch so hübscher kryptografischer Schutz am Ende erneut ein äußerst wertvolles Daten-Repository entstehen lassen.
Darum ist mein Urteil über Dusk heute konkreter: Seine Schutzmauer ist nicht nur „Verbergen zu können“, sondern sicherzustellen, dass Offenlegungsrechte fein genug, ausreichend auditierbar und zugleich auch noch gut nutzbar ausgestaltet sind. Zukünftig sollte nicht die Anzahl privater Transaktionen an sich im Mittelpunkt stehen, sondern wie viele echte Finanzprozesse sich erfolgreich verifizieren lassen, ohne dass dabei alle Daten offengelegt werden müssen.
<b>$DUSK </b> <b>#dusk </b>
Hängt den Kontoauszug in der Filiale an die Wand—niemand würde das „vertrauenswürdiges Finanzwesen“ nennen. Doch bei einer Public Chain bleiben Guthaben, Überweisungen und Gegenparteien langfristig unverschleiert, werden aber oft als „transparent“ verpackt. Als ich gestern weiter die Dusk-Dokumente zerlegte, stellte ich fest, dass es dabei nicht darum geht, dass alle Informationen verschwinden, sondern darum, „wer welche Informationen sehen darf“ in das Protokoll zu schreiben.
Das Phoenix-Modell mit <b>@Dusk </b> macht das Geld zu verschlüsselten Notes: Ein normaler Beobachter kann Überweisungsbeträge, die Sende-Beziehung und die konkreten Notes nicht sehen, aber die Transaktion muss weiterhin mittels Zero-Knowledge beweisen, dass das Guthaben ausreicht und keine Doppelbuchung (Double Spend) vorliegt. Am leichtesten wird das missverstanden, wenn man „selektive Offenlegung“ so versteht, als würde man Aufsehern ein Allzweck-Schlüsselchen einbauen, mit dem man auf das gesamte Kontenbuch im Netz zugreifen kann. In Wahrheit ermöglicht es relevanten Nutzern, durch das Überprüfen von Schlüsseln gezielt einen bestimmten Informationsbereich an ausstellende Stellen, Orte oder Auditoren zu übergeben, die eine Verifikation benötigen. Öffentliche Verifikation sorgt dafür, dass die Regeln nicht gebrochen werden; kontrollierte Offenlegung beantwortet die Frage nach Verantwortung in der realen Welt.
Die Identitätsschicht Citadel von Dusk treibt das Ganze noch einen Schritt weiter. Nutzer müssen nicht bei jeder Einreichung vollständige Ausweisdokumente vorlegen, sondern können nachweisen, dass „der Wohnsitz den Anforderungen entspricht“, „das Alter passt“ oder „es liegt die Qualifikation eines zugelassenen Anlegers vor“—also bestimmte Attribute. Die Service-Seite erhält dann die Antwort auf die Frage, ob Zugang gewährt wird, und muss nicht unbedingt die gesamte Identitätsakte abgreifen. Anders gesagt: Das System versucht, die in klassischem KYC übertriebene Gewohnheit des Sammelns personenbezogener Daten zu verkleinern und auf eine einzige, minimal notwendige Bestätigung zu komprimieren.
Doch selektive Offenlegung ist nicht von Natur aus gleichbedeutend mit Sicherheit. Das eigentliche Problem ist: Wer verwahrt die Schlüssel, wie lange darf man sie einsehen, wie wird mit einer etwaigen Leckage umgegangen, und können unterschiedliche Institutionen nur die Daten erhalten, die in ihren Aufgabenbereich fallen? Wenn eine Anwendung aus Bequemlichkeit die Schlüssel dauerhaft zentral speichert, kann selbst ein noch so hübscher kryptografischer Schutz am Ende erneut ein äußerst wertvolles Daten-Repository entstehen lassen.
Darum ist mein Urteil über Dusk heute konkreter: Seine Schutzmauer ist nicht nur „Verbergen zu können“, sondern sicherzustellen, dass Offenlegungsrechte fein genug, ausreichend auditierbar und zugleich auch noch gut nutzbar ausgestaltet sind. Zukünftig sollte nicht die Anzahl privater Transaktionen an sich im Mittelpunkt stehen, sondern wie viele echte Finanzprozesse sich erfolgreich verifizieren lassen, ohne dass dabei alle Daten offengelegt werden müssen.
<b>$DUSK </b> <b>#dusk </b>
Das Phoenix-Modell mit <b>@Dusk </b> macht das Geld zu verschlüsselten Notes: Ein normaler Beobachter kann Überweisungsbeträge, die Sende-Beziehung und die konkreten Notes nicht sehen, aber die Transaktion muss weiterhin mittels Zero-Knowledge beweisen, dass das Guthaben ausreicht und keine Doppelbuchung (Double Spend) vorliegt. Am leichtesten wird das missverstanden, wenn man „selektive Offenlegung“ so versteht, als würde man Aufsehern ein Allzweck-Schlüsselchen einbauen, mit dem man auf das gesamte Kontenbuch im Netz zugreifen kann. In Wahrheit ermöglicht es relevanten Nutzern, durch das Überprüfen von Schlüsseln gezielt einen bestimmten Informationsbereich an ausstellende Stellen, Orte oder Auditoren zu übergeben, die eine Verifikation benötigen. Öffentliche Verifikation sorgt dafür, dass die Regeln nicht gebrochen werden; kontrollierte Offenlegung beantwortet die Frage nach Verantwortung in der realen Welt.
Die Identitätsschicht Citadel von Dusk treibt das Ganze noch einen Schritt weiter. Nutzer müssen nicht bei jeder Einreichung vollständige Ausweisdokumente vorlegen, sondern können nachweisen, dass „der Wohnsitz den Anforderungen entspricht“, „das Alter passt“ oder „es liegt die Qualifikation eines zugelassenen Anlegers vor“—also bestimmte Attribute. Die Service-Seite erhält dann die Antwort auf die Frage, ob Zugang gewährt wird, und muss nicht unbedingt die gesamte Identitätsakte abgreifen. Anders gesagt: Das System versucht, die in klassischem KYC übertriebene Gewohnheit des Sammelns personenbezogener Daten zu verkleinern und auf eine einzige, minimal notwendige Bestätigung zu komprimieren.
Doch selektive Offenlegung ist nicht von Natur aus gleichbedeutend mit Sicherheit. Das eigentliche Problem ist: Wer verwahrt die Schlüssel, wie lange darf man sie einsehen, wie wird mit einer etwaigen Leckage umgegangen, und können unterschiedliche Institutionen nur die Daten erhalten, die in ihren Aufgabenbereich fallen? Wenn eine Anwendung aus Bequemlichkeit die Schlüssel dauerhaft zentral speichert, kann selbst ein noch so hübscher kryptografischer Schutz am Ende erneut ein äußerst wertvolles Daten-Repository entstehen lassen.
Darum ist mein Urteil über Dusk heute konkreter: Seine Schutzmauer ist nicht nur „Verbergen zu können“, sondern sicherzustellen, dass Offenlegungsrechte fein genug, ausreichend auditierbar und zugleich auch noch gut nutzbar ausgestaltet sind. Zukünftig sollte nicht die Anzahl privater Transaktionen an sich im Mittelpunkt stehen, sondern wie viele echte Finanzprozesse sich erfolgreich verifizieren lassen, ohne dass dabei alle Daten offengelegt werden müssen.
<b>$DUSK </b> <b>#dusk </b>
1
109
·
--
我以前以为,隐私链最难的是把交易藏起来。翻完Dusk白皮书后才发现,更棘手的问题发生在“藏起来”之后:交易所怎么核对入金,审计方怎么确认资产没有凭空增加,监管者又如何只查看依法需要的信息?完全公开会把余额、仓位和交易关系摊给所有人,完全匿名又很难进入证券与机构市场,两端都不是完整答案。
@Dusk_Foundation 没有逼所有交易挤进同一种账户,而是在同一结算层设置了两条轨道。Moonlight是公开账户模型,余额、发送方、接收方和金额可见,适合交易所充值、机构财库及公开对账;Phoenix则把资金表示成加密note,通过零知识证明确认余额充足、没有双花,却不向普通观察者暴露金额与资金路径。需要核验时,相关方还能使用查看密钥进行有边界的披露。
真正有价值的不是“隐私”两个字,而是可见度可以跟着业务变化。用户能把DUSK从Moonlight公开余额转入Phoenix隐私余额,需要接入交易所时再转回公开侧;两种交易仍由同一套Transfer合约检查状态、手续费与双花。这像一栋银行大楼同时保留公开柜台和私密洽谈室,但总账没有被拆成两套互不相认的系统。
代价也很现实。Phoenix需要生成零知识证明,交易所则被官方建议优先接入Moonlight,因为隐私note需要另一套托管和扫描流程。双轨把选择权交给用户,也把账户转换、查看密钥保管和权限配置的责任交了回来。钱包若把这些步骤做得含糊,隐私就会变成误操作成本。
所以Dusk真正要证明的,不只是能否隐藏转账,而是用户能否看懂自己在哪条轨道、谁拥有查看权限、怎样安全退出。只有当隐私像切换付款方式一样自然,这套设计才可能成为金融基础设施。
$DUSK #dusk
我以前以为,隐私链最难的是把交易藏起来。翻完Dusk白皮书后才发现,更棘手的问题发生在“藏起来”之后:交易所怎么核对入金,审计方怎么确认资产没有凭空增加,监管者又如何只查看依法需要的信息?完全公开会把余额、仓位和交易关系摊给所有人,完全匿名又很难进入证券与机构市场,两端都不是完整答案。
@Dusk 没有逼所有交易挤进同一种账户,而是在同一结算层设置了两条轨道。Moonlight是公开账户模型,余额、发送方、接收方和金额可见,适合交易所充值、机构财库及公开对账;Phoenix则把资金表示成加密note,通过零知识证明确认余额充足、没有双花,却不向普通观察者暴露金额与资金路径。需要核验时,相关方还能使用查看密钥进行有边界的披露。
真正有价值的不是“隐私”两个字,而是可见度可以跟着业务变化。用户能把DUSK从Moonlight公开余额转入Phoenix隐私余额,需要接入交易所时再转回公开侧;两种交易仍由同一套Transfer合约检查状态、手续费与双花。这像一栋银行大楼同时保留公开柜台和私密洽谈室,但总账没有被拆成两套互不相认的系统。
代价也很现实。Phoenix需要生成零知识证明,交易所则被官方建议优先接入Moonlight,因为隐私note需要另一套托管和扫描流程。双轨把选择权交给用户,也把账户转换、查看密钥保管和权限配置的责任交了回来。钱包若把这些步骤做得含糊,隐私就会变成误操作成本。
所以Dusk真正要证明的,不只是能否隐藏转账,而是用户能否看懂自己在哪条轨道、谁拥有查看权限、怎样安全退出。只有当隐私像切换付款方式一样自然,这套设计才可能成为金融基础设施。
$DUSK #dusk
@Dusk 没有逼所有交易挤进同一种账户,而是在同一结算层设置了两条轨道。Moonlight是公开账户模型,余额、发送方、接收方和金额可见,适合交易所充值、机构财库及公开对账;Phoenix则把资金表示成加密note,通过零知识证明确认余额充足、没有双花,却不向普通观察者暴露金额与资金路径。需要核验时,相关方还能使用查看密钥进行有边界的披露。
真正有价值的不是“隐私”两个字,而是可见度可以跟着业务变化。用户能把DUSK从Moonlight公开余额转入Phoenix隐私余额,需要接入交易所时再转回公开侧;两种交易仍由同一套Transfer合约检查状态、手续费与双花。这像一栋银行大楼同时保留公开柜台和私密洽谈室,但总账没有被拆成两套互不相认的系统。
代价也很现实。Phoenix需要生成零知识证明,交易所则被官方建议优先接入Moonlight,因为隐私note需要另一套托管和扫描流程。双轨把选择权交给用户,也把账户转换、查看密钥保管和权限配置的责任交了回来。钱包若把这些步骤做得含糊,隐私就会变成误操作成本。
所以Dusk真正要证明的,不只是能否隐藏转账,而是用户能否看懂自己在哪条轨道、谁拥有查看权限、怎样安全退出。只有当隐私像切换付款方式一样自然,这套设计才可能成为金融基础设施。
$DUSK #dusk
1
2
99
·
--
Man sieht auf Ethereum eine Menge Verträge, was leicht den Eindruck erweckt, dass TBV am Ende doch die Kontrolle über BTC an eine andere Kette überträgt. Wenn man es jedoch wirklich auseinanderbaut, stellt man fest: @babylonlabs_io teilt das System in drei Schichten. Der Zweck ist gerade, zu verhindern, dass irgendeine einzelne Schicht das Ergebnis allein umschreiben kann.
Die erste Schicht liegt in Bitcoin. BTC wird in Taproot-Ausgänge gesperrt; normales Einlösen, einlösungsbasierte Liquidation und dispute-basiertes Response werden bereits beim Erstellen der Bibliothek in die vorbereiteten Transaktionsgrafen geschrieben. Vor der Aktivierung gibt es außerdem ein Pre-PegIn-HTLC; Ethereum hat die Aktivierung nicht abgeschlossen, sodass Nutzer nach Ablauf der Zeitsperre einseitig zurücktreten können. Bitcoin versteht keine Kredite – es ist lediglich dafür zuständig, „welche Transaktionen berechtigt sind, dieses UTXO auszugeben“.
Die zweite Schicht liegt in Ethereum. Kernverträge dokumentieren den Vault-Lebenszyklus, Hashlock- und WOTS-Zusagen, verwalten Zeitsperren, Teilnehmer, Zugangsberechtigung für Anwendungen und Obergrenzen für Expositionen; der Adapter übersetzt außerdem Kreditaufnahme, Rückzahlung und Ausstieg in Protokolloperationen. Derzeit ist im öffentlich registrierten Testnetz nur noch der Aave v4 Adapter registriert.
Die dritte Schicht ist die Offline-Software. Vault Provider koordinieren das Erstellen der Bibliothek und die vorbereiteten Signaturen. Rollen wie Application Vault Keeper, Universal Challenger usw. überwachen beide Ketten, speichern Materialien, erzeugen oder challengen Einlösebeweise und reichen anschließend die nächste Transaktion ein.
Der entscheidende Punkt ist nicht nur „Drei Schichten arbeiten zusammen“, sondern dass die Konsequenzen bei einem Versagen unterschiedlich sind: Ein Fehler im Ethereum-Vertrag wirkt sich auf Buchhaltung und Business aus, Offline-Rollen verzögern den Ausstieg – aber sie können alle keine „aus dem Nichts“ erzeugte Bitcoin-Ausgangstransaktion hervorbringen, die nicht bereits vorbereitet wurde. Umgekehrt kann ein sichererer Bitcoin-Script auch nicht die Aufgaben von Oracles, Anwendungs-Failover/Business-Risiko-Controls und Online-Challengern ersetzen.
TBV zerstört also kein Vertrauen, sondern trennt Asset-Kontrolle, Geschäftsstatus und Ausführbarkeit – sodass ein Fehler in einer einzelnen Schicht nicht direkt zu einem Verlust der BTC-Eigentümerschaft führt. Vor dem Mainnet-Launch werde ich diese drei Schichten jeweils separat prüfen, statt nur auf einen Satz „BTC bleibt auf der ursprünglichen Kette“ zu schauen.
#baby $BABY
Man sieht auf Ethereum eine Menge Verträge, was leicht den Eindruck erweckt, dass TBV am Ende doch die Kontrolle über BTC an eine andere Kette überträgt. Wenn man es jedoch wirklich auseinanderbaut, stellt man fest: @BabylonLabs_io teilt das System in drei Schichten. Der Zweck ist gerade, zu verhindern, dass irgendeine einzelne Schicht das Ergebnis allein umschreiben kann.
Die erste Schicht liegt in Bitcoin. BTC wird in Taproot-Ausgänge gesperrt; normales Einlösen, einlösungsbasierte Liquidation und dispute-basiertes Response werden bereits beim Erstellen der Bibliothek in die vorbereiteten Transaktionsgrafen geschrieben. Vor der Aktivierung gibt es außerdem ein Pre-PegIn-HTLC; Ethereum hat die Aktivierung nicht abgeschlossen, sodass Nutzer nach Ablauf der Zeitsperre einseitig zurücktreten können. Bitcoin versteht keine Kredite – es ist lediglich dafür zuständig, „welche Transaktionen berechtigt sind, dieses UTXO auszugeben“.
Die zweite Schicht liegt in Ethereum. Kernverträge dokumentieren den Vault-Lebenszyklus, Hashlock- und WOTS-Zusagen, verwalten Zeitsperren, Teilnehmer, Zugangsberechtigung für Anwendungen und Obergrenzen für Expositionen; der Adapter übersetzt außerdem Kreditaufnahme, Rückzahlung und Ausstieg in Protokolloperationen. Derzeit ist im öffentlich registrierten Testnetz nur noch der Aave v4 Adapter registriert.
Die dritte Schicht ist die Offline-Software. Vault Provider koordinieren das Erstellen der Bibliothek und die vorbereiteten Signaturen. Rollen wie Application Vault Keeper, Universal Challenger usw. überwachen beide Ketten, speichern Materialien, erzeugen oder challengen Einlösebeweise und reichen anschließend die nächste Transaktion ein.
Der entscheidende Punkt ist nicht nur „Drei Schichten arbeiten zusammen“, sondern dass die Konsequenzen bei einem Versagen unterschiedlich sind: Ein Fehler im Ethereum-Vertrag wirkt sich auf Buchhaltung und Business aus, Offline-Rollen verzögern den Ausstieg – aber sie können alle keine „aus dem Nichts“ erzeugte Bitcoin-Ausgangstransaktion hervorbringen, die nicht bereits vorbereitet wurde. Umgekehrt kann ein sichererer Bitcoin-Script auch nicht die Aufgaben von Oracles, Anwendungs-Failover/Business-Risiko-Controls und Online-Challengern ersetzen.
TBV zerstört also kein Vertrauen, sondern trennt Asset-Kontrolle, Geschäftsstatus und Ausführbarkeit – sodass ein Fehler in einer einzelnen Schicht nicht direkt zu einem Verlust der BTC-Eigentümerschaft führt. Vor dem Mainnet-Launch werde ich diese drei Schichten jeweils separat prüfen, statt nur auf einen Satz „BTC bleibt auf der ursprünglichen Kette“ zu schauen.
#baby $BABY
Die erste Schicht liegt in Bitcoin. BTC wird in Taproot-Ausgänge gesperrt; normales Einlösen, einlösungsbasierte Liquidation und dispute-basiertes Response werden bereits beim Erstellen der Bibliothek in die vorbereiteten Transaktionsgrafen geschrieben. Vor der Aktivierung gibt es außerdem ein Pre-PegIn-HTLC; Ethereum hat die Aktivierung nicht abgeschlossen, sodass Nutzer nach Ablauf der Zeitsperre einseitig zurücktreten können. Bitcoin versteht keine Kredite – es ist lediglich dafür zuständig, „welche Transaktionen berechtigt sind, dieses UTXO auszugeben“.
Die zweite Schicht liegt in Ethereum. Kernverträge dokumentieren den Vault-Lebenszyklus, Hashlock- und WOTS-Zusagen, verwalten Zeitsperren, Teilnehmer, Zugangsberechtigung für Anwendungen und Obergrenzen für Expositionen; der Adapter übersetzt außerdem Kreditaufnahme, Rückzahlung und Ausstieg in Protokolloperationen. Derzeit ist im öffentlich registrierten Testnetz nur noch der Aave v4 Adapter registriert.
Die dritte Schicht ist die Offline-Software. Vault Provider koordinieren das Erstellen der Bibliothek und die vorbereiteten Signaturen. Rollen wie Application Vault Keeper, Universal Challenger usw. überwachen beide Ketten, speichern Materialien, erzeugen oder challengen Einlösebeweise und reichen anschließend die nächste Transaktion ein.
Der entscheidende Punkt ist nicht nur „Drei Schichten arbeiten zusammen“, sondern dass die Konsequenzen bei einem Versagen unterschiedlich sind: Ein Fehler im Ethereum-Vertrag wirkt sich auf Buchhaltung und Business aus, Offline-Rollen verzögern den Ausstieg – aber sie können alle keine „aus dem Nichts“ erzeugte Bitcoin-Ausgangstransaktion hervorbringen, die nicht bereits vorbereitet wurde. Umgekehrt kann ein sichererer Bitcoin-Script auch nicht die Aufgaben von Oracles, Anwendungs-Failover/Business-Risiko-Controls und Online-Challengern ersetzen.
TBV zerstört also kein Vertrauen, sondern trennt Asset-Kontrolle, Geschäftsstatus und Ausführbarkeit – sodass ein Fehler in einer einzelnen Schicht nicht direkt zu einem Verlust der BTC-Eigentümerschaft führt. Vor dem Mainnet-Launch werde ich diese drei Schichten jeweils separat prüfen, statt nur auf einen Satz „BTC bleibt auf der ursprünglichen Kette“ zu schauen.
#baby $BABY
1
243
·
--
Bitcoin kann Ethereum-Belege nicht „lesen“, muss aber entscheiden, wem die in Taproot gesperrten BTC letztlich zurückgegeben werden. Das ist, als würde man einem Türsteher, der nur Siegel akzeptiert, eine Gerichtsentscheidung zur Prüfung geben, die in einer Fremdsprache verfasst ist.
Ich folge dem BABE-Flow für @babylonlabs_io und zerlege ihn Schritt für Schritt. Dabei zeigt sich: Es geht nicht darum, dass Bitcoin einen vollständigen ZK-Verifikator im Script ausführt, sondern darum, die Prüfung von Echtheit in ein vorab arrangiertes Challenge-Spiel zu verwandeln.
Beim Rückkauf bestätigt die Proof-Pipeline zuerst, dass der Ethereum-Beacon-Block endgültig finalisiert ist, verknüpft dann den Ausführungsblock mit dem Rückkaufs-Beleg und lässt schließlich durch SP1 den Beweis erzeugen, der zu Groth16 komprimiert wird. Der Empfänger sendet anschließend „Claim“ und „Assert“; mit WOTS wird das Proof-Versprechen in eine Bitcoin-Transaktion geschrieben. Danach beginnt die öffentliche Testnet-Phase mit etwa 432 BTC-Blöcken und einem rund dreitägigen Challenge-Zeitfenster.
Der entscheidende Punkt ist das Peg-in. Die aktuellen Parameter verlangen, dass pro Empfänger- und Herausforderer-Team 307 Sätze an Kandidaten-Confusion-Schaltungen erzeugt, 301 Sätze öffentlich überprüft werden (um Betrug aufzudecken) und nur 6 zufällig ausgewählte Sätze für die Behandlung künftiger Streitfälle übrig bleiben. Wie wenn man zuerst die allermeisten versiegelten Prüfungsbögen öffnet und prüft und erst den Rest für die eigentliche Prüfung verwendet.
Reicht der Empfänger einen falschen Beweis ein, kann der Herausforderer die Verifikation erneut abspielen und eine „Challenge“ anstoßen. Der falsche Beweis lässt sich nicht auf den korrekten Tag zurückführen; nach etwa 108 Blöcken kann der Herausforderer den No-Payout-Pfad wählen, wodurch die Freigabe der BTC blockiert und die Sicherheitsleistung des Herausforderers verwirkt wird. Wird dagegen ein gültiger Beweis böswillig herausgefordert, kann der Empfänger den korrekten Tag extrahieren, „WronglyChallenged“ ausstrahlen und „Payout“ fortsetzen; der Herausforderer erleidet dann den Verlust seiner Sicherheitsleistung.
Daher geht es bei BABE nicht darum, dass Bitcoin Ethereum direkt versteht, sondern darum, dass Lügner die nächste Stufe nicht erfolgreich abschließen können. Aber Confusion-Schaltungen, die Proof-Pipeline und die Online-Quote der Herausforderer: Wenn irgendwo etwas schiefgeht, wirkt sich das auf den Exit aus. Vor dem Mainnet ist das, was ich am liebsten sehen würde, dass ein echter Streitfall vollständig durchläuft – nicht nur ein „Happy Path“ ohne Challenge.
#baby $BABY
Bitcoin kann Ethereum-Belege nicht „lesen“, muss aber entscheiden, wem die in Taproot gesperrten BTC letztlich zurückgegeben werden. Das ist, als würde man einem Türsteher, der nur Siegel akzeptiert, eine Gerichtsentscheidung zur Prüfung geben, die in einer Fremdsprache verfasst ist.
Ich folge dem BABE-Flow für @BabylonLabs_io und zerlege ihn Schritt für Schritt. Dabei zeigt sich: Es geht nicht darum, dass Bitcoin einen vollständigen ZK-Verifikator im Script ausführt, sondern darum, die Prüfung von Echtheit in ein vorab arrangiertes Challenge-Spiel zu verwandeln.
Beim Rückkauf bestätigt die Proof-Pipeline zuerst, dass der Ethereum-Beacon-Block endgültig finalisiert ist, verknüpft dann den Ausführungsblock mit dem Rückkaufs-Beleg und lässt schließlich durch SP1 den Beweis erzeugen, der zu Groth16 komprimiert wird. Der Empfänger sendet anschließend „Claim“ und „Assert“; mit WOTS wird das Proof-Versprechen in eine Bitcoin-Transaktion geschrieben. Danach beginnt die öffentliche Testnet-Phase mit etwa 432 BTC-Blöcken und einem rund dreitägigen Challenge-Zeitfenster.
Der entscheidende Punkt ist das Peg-in. Die aktuellen Parameter verlangen, dass pro Empfänger- und Herausforderer-Team 307 Sätze an Kandidaten-Confusion-Schaltungen erzeugt, 301 Sätze öffentlich überprüft werden (um Betrug aufzudecken) und nur 6 zufällig ausgewählte Sätze für die Behandlung künftiger Streitfälle übrig bleiben. Wie wenn man zuerst die allermeisten versiegelten Prüfungsbögen öffnet und prüft und erst den Rest für die eigentliche Prüfung verwendet.
Reicht der Empfänger einen falschen Beweis ein, kann der Herausforderer die Verifikation erneut abspielen und eine „Challenge“ anstoßen. Der falsche Beweis lässt sich nicht auf den korrekten Tag zurückführen; nach etwa 108 Blöcken kann der Herausforderer den No-Payout-Pfad wählen, wodurch die Freigabe der BTC blockiert und die Sicherheitsleistung des Herausforderers verwirkt wird. Wird dagegen ein gültiger Beweis böswillig herausgefordert, kann der Empfänger den korrekten Tag extrahieren, „WronglyChallenged“ ausstrahlen und „Payout“ fortsetzen; der Herausforderer erleidet dann den Verlust seiner Sicherheitsleistung.
Daher geht es bei BABE nicht darum, dass Bitcoin Ethereum direkt versteht, sondern darum, dass Lügner die nächste Stufe nicht erfolgreich abschließen können. Aber Confusion-Schaltungen, die Proof-Pipeline und die Online-Quote der Herausforderer: Wenn irgendwo etwas schiefgeht, wirkt sich das auf den Exit aus. Vor dem Mainnet ist das, was ich am liebsten sehen würde, dass ein echter Streitfall vollständig durchläuft – nicht nur ein „Happy Path“ ohne Challenge.
#baby $BABY
Ich folge dem BABE-Flow für @BabylonLabs_io und zerlege ihn Schritt für Schritt. Dabei zeigt sich: Es geht nicht darum, dass Bitcoin einen vollständigen ZK-Verifikator im Script ausführt, sondern darum, die Prüfung von Echtheit in ein vorab arrangiertes Challenge-Spiel zu verwandeln.
Beim Rückkauf bestätigt die Proof-Pipeline zuerst, dass der Ethereum-Beacon-Block endgültig finalisiert ist, verknüpft dann den Ausführungsblock mit dem Rückkaufs-Beleg und lässt schließlich durch SP1 den Beweis erzeugen, der zu Groth16 komprimiert wird. Der Empfänger sendet anschließend „Claim“ und „Assert“; mit WOTS wird das Proof-Versprechen in eine Bitcoin-Transaktion geschrieben. Danach beginnt die öffentliche Testnet-Phase mit etwa 432 BTC-Blöcken und einem rund dreitägigen Challenge-Zeitfenster.
Der entscheidende Punkt ist das Peg-in. Die aktuellen Parameter verlangen, dass pro Empfänger- und Herausforderer-Team 307 Sätze an Kandidaten-Confusion-Schaltungen erzeugt, 301 Sätze öffentlich überprüft werden (um Betrug aufzudecken) und nur 6 zufällig ausgewählte Sätze für die Behandlung künftiger Streitfälle übrig bleiben. Wie wenn man zuerst die allermeisten versiegelten Prüfungsbögen öffnet und prüft und erst den Rest für die eigentliche Prüfung verwendet.
Reicht der Empfänger einen falschen Beweis ein, kann der Herausforderer die Verifikation erneut abspielen und eine „Challenge“ anstoßen. Der falsche Beweis lässt sich nicht auf den korrekten Tag zurückführen; nach etwa 108 Blöcken kann der Herausforderer den No-Payout-Pfad wählen, wodurch die Freigabe der BTC blockiert und die Sicherheitsleistung des Herausforderers verwirkt wird. Wird dagegen ein gültiger Beweis böswillig herausgefordert, kann der Empfänger den korrekten Tag extrahieren, „WronglyChallenged“ ausstrahlen und „Payout“ fortsetzen; der Herausforderer erleidet dann den Verlust seiner Sicherheitsleistung.
Daher geht es bei BABE nicht darum, dass Bitcoin Ethereum direkt versteht, sondern darum, dass Lügner die nächste Stufe nicht erfolgreich abschließen können. Aber Confusion-Schaltungen, die Proof-Pipeline und die Online-Quote der Herausforderer: Wenn irgendwo etwas schiefgeht, wirkt sich das auf den Exit aus. Vor dem Mainnet ist das, was ich am liebsten sehen würde, dass ein echter Streitfall vollständig durchläuft – nicht nur ein „Happy Path“ ohne Challenge.
#baby $BABY
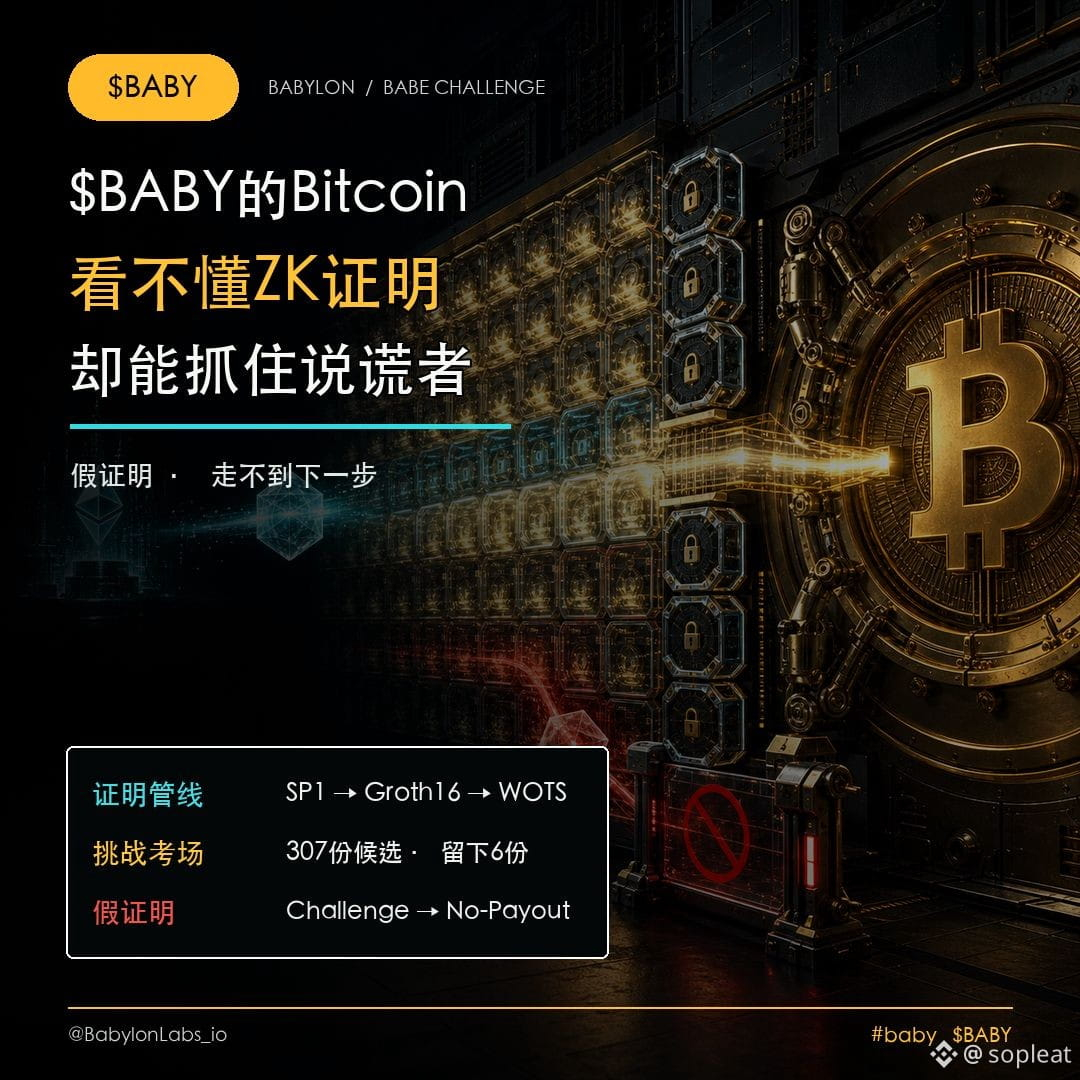
1
108
·
--
Ein einzelner BTC verlässt von Anfang bis Ende nicht Bitcoin — doch Aave kann ihn als Sicherheit behandeln und verleihen. Noch unüblichere gegen den gängigen Konsens ist: In der Mitte gibt es nicht einmal ein handelbares „Shadow BTC“.
Ich habe die Integration von Aave v4 mit der @babylonlabs_io einmal von vorn bis hinten durchgeprüft und festgestellt, dass der Adapter eher wie ein Übersetzer ist, der zwei Sprachen beherrscht. Beim Peg-in gelangt das native BTC in den Taproot Vault auf Bitcoin; nach der Aktivierung stellt der AaveAdapter für den Nutzer ein Position Proxy bereit. Dabei werden interne Sicherheiten im Verhältnis 1:1, präzise bis auf Satoshi, anhand der BTC-Menge erstellt und an den Babylon Core Spoke übergeben.
Diese Aufzeichnung nutzt eine ERC-20-ähnliche Schnittstelle, nur damit Aave den Sicherungswert lesen kann. Sie gelangt nicht in die Wallet des Nutzers, kann nicht an normale Adressen übertragen werden und besitzt keinen Sekundärmarkt. Das echte BTC bleibt weiterhin in den ursprünglichen UTXOs. Auf der Ethereum-Seite wird lediglich erfasst, wie viel Sicherheiten diese Vault für welche Position bereitstellt.
Der Borrow-Befehl geht vom Adapter in das Proxy und den Core Spoke, und holt dann Assets aus dem Aave v4 Hub heraus. Die Rückzahlung läuft in umgekehrter Richtung zurück in den Hub. In dem derzeit öffentlichen Testnetz sind USDC, USDT und WBTC allesamt simulierte Coins ohne echten Wert. Nach dem Erlöschen der Schuld zieht der Nutzer den Vault zurück, die Sicherheiten-Aufzeichnung wird geschlossen, und auf Bitcoin-Seite werden Beweise, Challenges und Payout gestartet.
Das heißt: Es ist nicht so, dass BTC in Aave „hineingebracht“ wird, sondern dass zwei Ledger rund um denselben Sicherungszustand miteinander abgeglichen werden. Aave kann das native BTC nicht anfassen, aber die Kette fügt den Adapter, das Proxy, den Spoke und die Orakel hinzu. Die Kryptografie schützt den BTC-Exit — ob Kreditaufnahme und -vergabe korrekt funktionieren, hängt weiterhin von den App-Verträgen und den Risk-Control-Parametern ab.
Nach dem Go-live im Mainnet sollte man vor allem verifizieren, nicht nur ob Geld ausgeliehen werden kann, sondern ob dieser „Übersetzer“ in hohem Durchsatz und extremen Marktphasen womöglich eine entscheidende Aussage falsch überträgt. #baby $BABY
Ein einzelner BTC verlässt von Anfang bis Ende nicht Bitcoin — doch Aave kann ihn als Sicherheit behandeln und verleihen. Noch unüblichere gegen den gängigen Konsens ist: In der Mitte gibt es nicht einmal ein handelbares „Shadow BTC“.
Ich habe die Integration von Aave v4 mit der @BabylonLabs_io einmal von vorn bis hinten durchgeprüft und festgestellt, dass der Adapter eher wie ein Übersetzer ist, der zwei Sprachen beherrscht. Beim Peg-in gelangt das native BTC in den Taproot Vault auf Bitcoin; nach der Aktivierung stellt der AaveAdapter für den Nutzer ein Position Proxy bereit. Dabei werden interne Sicherheiten im Verhältnis 1:1, präzise bis auf Satoshi, anhand der BTC-Menge erstellt und an den Babylon Core Spoke übergeben.
Diese Aufzeichnung nutzt eine ERC-20-ähnliche Schnittstelle, nur damit Aave den Sicherungswert lesen kann. Sie gelangt nicht in die Wallet des Nutzers, kann nicht an normale Adressen übertragen werden und besitzt keinen Sekundärmarkt. Das echte BTC bleibt weiterhin in den ursprünglichen UTXOs. Auf der Ethereum-Seite wird lediglich erfasst, wie viel Sicherheiten diese Vault für welche Position bereitstellt.
Der Borrow-Befehl geht vom Adapter in das Proxy und den Core Spoke, und holt dann Assets aus dem Aave v4 Hub heraus. Die Rückzahlung läuft in umgekehrter Richtung zurück in den Hub. In dem derzeit öffentlichen Testnetz sind USDC, USDT und WBTC allesamt simulierte Coins ohne echten Wert. Nach dem Erlöschen der Schuld zieht der Nutzer den Vault zurück, die Sicherheiten-Aufzeichnung wird geschlossen, und auf Bitcoin-Seite werden Beweise, Challenges und Payout gestartet.
Das heißt: Es ist nicht so, dass BTC in Aave „hineingebracht“ wird, sondern dass zwei Ledger rund um denselben Sicherungszustand miteinander abgeglichen werden. Aave kann das native BTC nicht anfassen, aber die Kette fügt den Adapter, das Proxy, den Spoke und die Orakel hinzu. Die Kryptografie schützt den BTC-Exit — ob Kreditaufnahme und -vergabe korrekt funktionieren, hängt weiterhin von den App-Verträgen und den Risk-Control-Parametern ab.
Nach dem Go-live im Mainnet sollte man vor allem verifizieren, nicht nur ob Geld ausgeliehen werden kann, sondern ob dieser „Übersetzer“ in hohem Durchsatz und extremen Marktphasen womöglich eine entscheidende Aussage falsch überträgt. #baby $BABY
Ich habe die Integration von Aave v4 mit der @BabylonLabs_io einmal von vorn bis hinten durchgeprüft und festgestellt, dass der Adapter eher wie ein Übersetzer ist, der zwei Sprachen beherrscht. Beim Peg-in gelangt das native BTC in den Taproot Vault auf Bitcoin; nach der Aktivierung stellt der AaveAdapter für den Nutzer ein Position Proxy bereit. Dabei werden interne Sicherheiten im Verhältnis 1:1, präzise bis auf Satoshi, anhand der BTC-Menge erstellt und an den Babylon Core Spoke übergeben.
Diese Aufzeichnung nutzt eine ERC-20-ähnliche Schnittstelle, nur damit Aave den Sicherungswert lesen kann. Sie gelangt nicht in die Wallet des Nutzers, kann nicht an normale Adressen übertragen werden und besitzt keinen Sekundärmarkt. Das echte BTC bleibt weiterhin in den ursprünglichen UTXOs. Auf der Ethereum-Seite wird lediglich erfasst, wie viel Sicherheiten diese Vault für welche Position bereitstellt.
Der Borrow-Befehl geht vom Adapter in das Proxy und den Core Spoke, und holt dann Assets aus dem Aave v4 Hub heraus. Die Rückzahlung läuft in umgekehrter Richtung zurück in den Hub. In dem derzeit öffentlichen Testnetz sind USDC, USDT und WBTC allesamt simulierte Coins ohne echten Wert. Nach dem Erlöschen der Schuld zieht der Nutzer den Vault zurück, die Sicherheiten-Aufzeichnung wird geschlossen, und auf Bitcoin-Seite werden Beweise, Challenges und Payout gestartet.
Das heißt: Es ist nicht so, dass BTC in Aave „hineingebracht“ wird, sondern dass zwei Ledger rund um denselben Sicherungszustand miteinander abgeglichen werden. Aave kann das native BTC nicht anfassen, aber die Kette fügt den Adapter, das Proxy, den Spoke und die Orakel hinzu. Die Kryptografie schützt den BTC-Exit — ob Kreditaufnahme und -vergabe korrekt funktionieren, hängt weiterhin von den App-Verträgen und den Risk-Control-Parametern ab.
Nach dem Go-live im Mainnet sollte man vor allem verifizieren, nicht nur ob Geld ausgeliehen werden kann, sondern ob dieser „Übersetzer“ in hohem Durchsatz und extremen Marktphasen womöglich eine entscheidende Aussage falsch überträgt. #baby $BABY
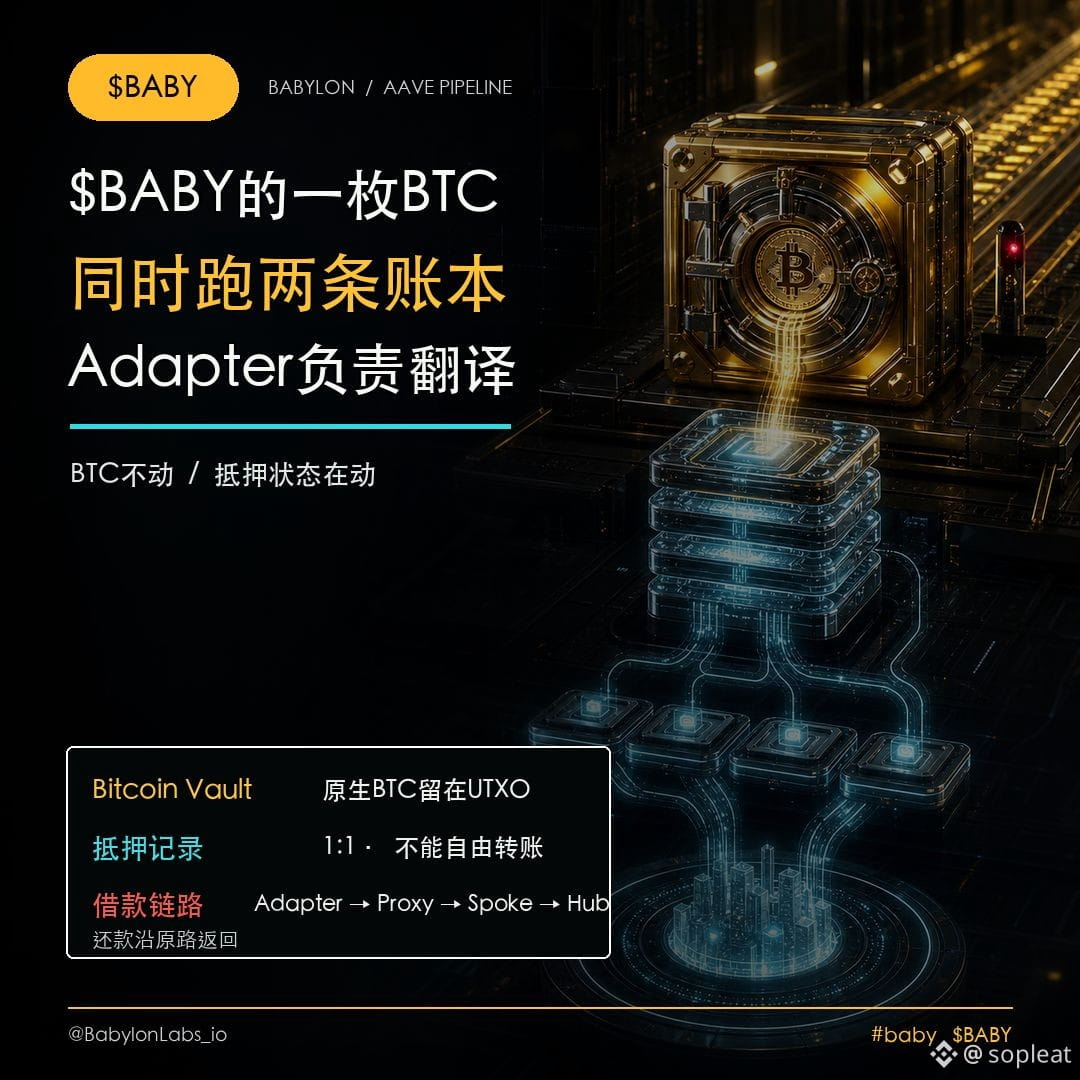
193
·
--
Das Abwicklungs-Robotter hat keine Schere, es räumt einfach ganze Kisten weg. Als ich sah, dass das aktuelle Testnetz @babylonlabs_io jedes Vault als eine eigenständige UTXO entwirft, wurde mir klar: Ein doppeltes Vault ist keine besonders hübsche Einlage-Option, sondern es zielt darauf ab, Verluste der Abwicklung in feinerem Granulat zu zerschneiden.
In normalem DeFi kann man Sicherheiten anteilig abtrennen, aber bei Bitcoin-Transaktionen kann man nur einen Output vollständig ausgeben. Nehmen wir an, eine Position enthält 0,4 BTC; für die Abwicklung muss nur etwa 0,25 BTC davon verarbeitet werden. Wenn jedoch 0,4 BTC komplett in ein einziges Vault gepackt sind, kann das Protokoll keine 0,25 BTC daraus „abschneiden“—es muss das gesamte Vault in die Abwicklung einbeziehen. Der „zu viel“ vorhandene Wert verschwindet dabei nicht einfach: Der faire Mechanismus reduziert zuerst die verbleibende Schuld des Nutzers; falls danach noch ein Rest übrig bleibt, wird dieser mit WBTC zurückerstattet. Aber „einen Gegenwert erhalten“ und „native BTC bleiben weiterhin in deiner eigenen Position“ sind offensichtlich nicht dasselbe.
Genau darin liegt der eigentliche Nutzen von zwei Vaults. Nach den Parametern des aktuellen öffentlich verfügbaren Testnetzes beträgt der Sicherheitenfaktor 78%, der Ziel-Health-Faktor 1,24. Die Dokumentation schätzt: Sobald die Position die Abwicklungsgrenze gerade erreicht, entspricht die Menge, die man als Ziel abgreift, etwa 62% des BTC-Werts. Portal ordnet anhand der aktuellen Parameter das größere Opfer-Vault zuerst ein; der verbleibende BTC-Teil wird in das Schutz-Vault gelegt. Der Abwicklungsprozess prüft die Liste der Reihe nach, Vault für Vault vom Listenanfang aus. Sobald das erste ausreicht, wird gestoppt; das zweite bleibt in der Position.
Daher ist es nicht wirklich ein „Anti-Abwicklungs-Wunderwerkzeug“, sondern eher wie eine Schott-Tür im Frachtraum: Es wird immer noch zu Verlusten kommen, aber man versucht, nicht den ganzen Schiffskörper zu verschlingen. Wenn der Markt zu schnell fällt, die Größe des Opfer-Vaults nicht ausreicht oder die Reihenfolge falsch ist, kann das System dennoch weiter das nächste Vault mitnehmen. Auch 62/38 ist keine dauerhafte Formel—nach Parameteränderungen muss man die Aufteilung, die Portal vorgibt, erneut neu betrachten.
Ich würde diese Gestaltung lieber „Management der Verlust-Granularität“ nennen. Worauf Kreditnehmer wirklich achten müssen, sind neben dem Health-Faktor auch die eigene Vault-Größe und die Anordnung. Würdest du eine komplexere Positionsverwaltung akzeptieren, um das zweite native BTC-Vault zu schützen?
#baby $BABY
Das Abwicklungs-Robotter hat keine Schere, es räumt einfach ganze Kisten weg. Als ich sah, dass das aktuelle Testnetz @BabylonLabs_io jedes Vault als eine eigenständige UTXO entwirft, wurde mir klar: Ein doppeltes Vault ist keine besonders hübsche Einlage-Option, sondern es zielt darauf ab, Verluste der Abwicklung in feinerem Granulat zu zerschneiden.
In normalem DeFi kann man Sicherheiten anteilig abtrennen, aber bei Bitcoin-Transaktionen kann man nur einen Output vollständig ausgeben. Nehmen wir an, eine Position enthält 0,4 BTC; für die Abwicklung muss nur etwa 0,25 BTC davon verarbeitet werden. Wenn jedoch 0,4 BTC komplett in ein einziges Vault gepackt sind, kann das Protokoll keine 0,25 BTC daraus „abschneiden“—es muss das gesamte Vault in die Abwicklung einbeziehen. Der „zu viel“ vorhandene Wert verschwindet dabei nicht einfach: Der faire Mechanismus reduziert zuerst die verbleibende Schuld des Nutzers; falls danach noch ein Rest übrig bleibt, wird dieser mit WBTC zurückerstattet. Aber „einen Gegenwert erhalten“ und „native BTC bleiben weiterhin in deiner eigenen Position“ sind offensichtlich nicht dasselbe.
Genau darin liegt der eigentliche Nutzen von zwei Vaults. Nach den Parametern des aktuellen öffentlich verfügbaren Testnetzes beträgt der Sicherheitenfaktor 78%, der Ziel-Health-Faktor 1,24. Die Dokumentation schätzt: Sobald die Position die Abwicklungsgrenze gerade erreicht, entspricht die Menge, die man als Ziel abgreift, etwa 62% des BTC-Werts. Portal ordnet anhand der aktuellen Parameter das größere Opfer-Vault zuerst ein; der verbleibende BTC-Teil wird in das Schutz-Vault gelegt. Der Abwicklungsprozess prüft die Liste der Reihe nach, Vault für Vault vom Listenanfang aus. Sobald das erste ausreicht, wird gestoppt; das zweite bleibt in der Position.
Daher ist es nicht wirklich ein „Anti-Abwicklungs-Wunderwerkzeug“, sondern eher wie eine Schott-Tür im Frachtraum: Es wird immer noch zu Verlusten kommen, aber man versucht, nicht den ganzen Schiffskörper zu verschlingen. Wenn der Markt zu schnell fällt, die Größe des Opfer-Vaults nicht ausreicht oder die Reihenfolge falsch ist, kann das System dennoch weiter das nächste Vault mitnehmen. Auch 62/38 ist keine dauerhafte Formel—nach Parameteränderungen muss man die Aufteilung, die Portal vorgibt, erneut neu betrachten.
Ich würde diese Gestaltung lieber „Management der Verlust-Granularität“ nennen. Worauf Kreditnehmer wirklich achten müssen, sind neben dem Health-Faktor auch die eigene Vault-Größe und die Anordnung. Würdest du eine komplexere Positionsverwaltung akzeptieren, um das zweite native BTC-Vault zu schützen?
#baby $BABY
In normalem DeFi kann man Sicherheiten anteilig abtrennen, aber bei Bitcoin-Transaktionen kann man nur einen Output vollständig ausgeben. Nehmen wir an, eine Position enthält 0,4 BTC; für die Abwicklung muss nur etwa 0,25 BTC davon verarbeitet werden. Wenn jedoch 0,4 BTC komplett in ein einziges Vault gepackt sind, kann das Protokoll keine 0,25 BTC daraus „abschneiden“—es muss das gesamte Vault in die Abwicklung einbeziehen. Der „zu viel“ vorhandene Wert verschwindet dabei nicht einfach: Der faire Mechanismus reduziert zuerst die verbleibende Schuld des Nutzers; falls danach noch ein Rest übrig bleibt, wird dieser mit WBTC zurückerstattet. Aber „einen Gegenwert erhalten“ und „native BTC bleiben weiterhin in deiner eigenen Position“ sind offensichtlich nicht dasselbe.
Genau darin liegt der eigentliche Nutzen von zwei Vaults. Nach den Parametern des aktuellen öffentlich verfügbaren Testnetzes beträgt der Sicherheitenfaktor 78%, der Ziel-Health-Faktor 1,24. Die Dokumentation schätzt: Sobald die Position die Abwicklungsgrenze gerade erreicht, entspricht die Menge, die man als Ziel abgreift, etwa 62% des BTC-Werts. Portal ordnet anhand der aktuellen Parameter das größere Opfer-Vault zuerst ein; der verbleibende BTC-Teil wird in das Schutz-Vault gelegt. Der Abwicklungsprozess prüft die Liste der Reihe nach, Vault für Vault vom Listenanfang aus. Sobald das erste ausreicht, wird gestoppt; das zweite bleibt in der Position.
Daher ist es nicht wirklich ein „Anti-Abwicklungs-Wunderwerkzeug“, sondern eher wie eine Schott-Tür im Frachtraum: Es wird immer noch zu Verlusten kommen, aber man versucht, nicht den ganzen Schiffskörper zu verschlingen. Wenn der Markt zu schnell fällt, die Größe des Opfer-Vaults nicht ausreicht oder die Reihenfolge falsch ist, kann das System dennoch weiter das nächste Vault mitnehmen. Auch 62/38 ist keine dauerhafte Formel—nach Parameteränderungen muss man die Aufteilung, die Portal vorgibt, erneut neu betrachten.
Ich würde diese Gestaltung lieber „Management der Verlust-Granularität“ nennen. Worauf Kreditnehmer wirklich achten müssen, sind neben dem Health-Faktor auch die eigene Vault-Größe und die Anordnung. Würdest du eine komplexere Positionsverwaltung akzeptieren, um das zweite native BTC-Vault zu schützen?
#baby $BABY
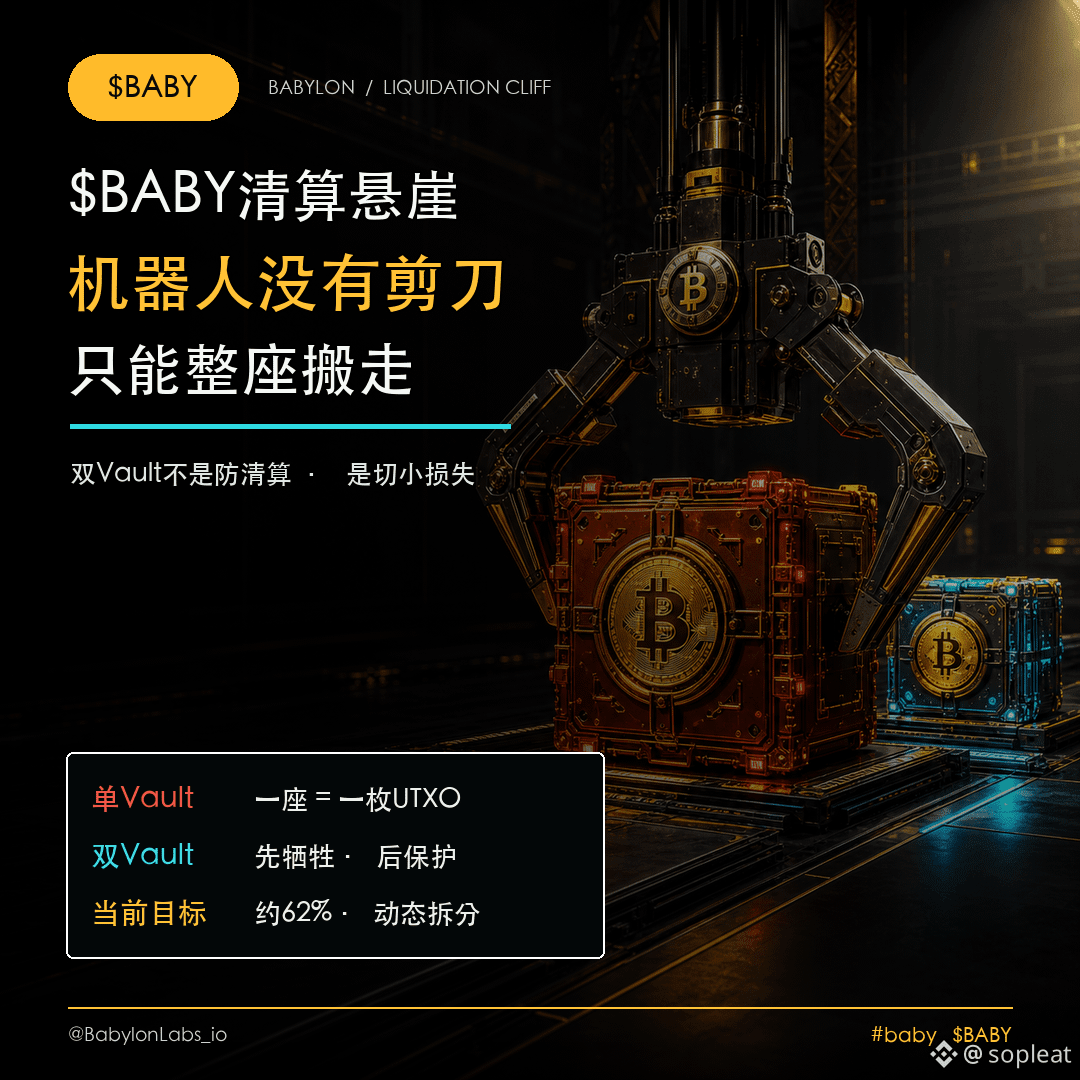
111
·
--
Vier Gruppen wühlen um eine BTC, doch keine von ihnen besitzt die vollständigen Rechte, um sie einfach wegzutragen. Nachdem ich die Rollenzeichnung von @babylonlabs_io neu erstellt habe, stellte ich fest: „Kein Vertrauen nötig“ bedeutet nicht, dass niemand im System dazu in der Lage wäre – sondern dass jede Person nur ein Stück der Fähigkeiten erhält.
VP ist wie ein Projektmanager. Es wird beim Anlegen des Nutzerkontos ausgewählt und kann danach nicht mehr geändert werden; es organisiert vorab die Transaktionsbilder, lädt die PegIn-Signaturen hoch, erzeugt Rückkaufs-/Rückgabe-Nachweise und treibt Claim voran. Es kann jedoch nicht kurzfristig einen neuen Pfad hinzufügen, um BTC wegzutransportieren; wenn es offline geht, kann der Nutzer weiterhin selbst Claim durchführen, gestützt auf WOTS und die „claimer artifacts“.
AVK ist der Liquidationssitz in der Anwendung. Es nimmt an den Cross-Signaturen beim Aufbau teil; bei Aave-Liquidationen können nur die AVKs, die zuvor in das Transaktionsbild eingetragen wurden, das verwaltete Vault kaufen und die BTC einlösen. Es kann den festgelegten Liquidationspfad beschreiten, aber nicht die normale Auszahlungsadresse ändern.
Universal Challenger ist für das „Aufpassen auf Fehler“ zuständig: Es überwacht Claims über Anwendungen hinweg; wenn ein Nachweis nicht zum Ethereum-Zustand passt, wird herausgefordert. Diese Gruppe ist derzeit geschlossen und versioniert; nicht jeder kann beitreten. Doch auch die Nutzer behalten einen Herausforderungsweg – die Sicherheit ruht nicht darauf, dass ein einzelner Monitoring-Operator online ist.
Security Council ist die rote Notbremse. Im aktuellen Testnetz erfordert es 3/5-Signaturen; es kann Payout verhindern, wenn das Nachweissystem katastrophal ausfällt, aber es kann keine neue Empfangsadresse festlegen: Es kann das Geld nur vorerst blockieren, nicht aber das Geld wegtransportieren.
Ich glaube, das wirklich Klügste daran ist, „Böses Tun“ in Handlungen zu zerlegen, die niemand alleine vollständig ausführen kann. Aber es ist dennoch nicht völlig ohne Berechtigungen: AVK, Challenger und das Komitee haben alle Eintrittshürden. Nach dem Mainnet-Start wird wichtiger als die Anzahl sein, ob Rollen aus unterschiedlichen Organisationen stammen und ob Ersatzpfade im Fehlerfall wirklich durchlaufen.
Machst du dir mehr Sorgen, dass eine bestimmte Rolle Böses tut, oder dass alle Rollen im entscheidenden Moment gemeinsam ausfallen?
#baby $BABY
Vier Gruppen wühlen um eine BTC, doch keine von ihnen besitzt die vollständigen Rechte, um sie einfach wegzutragen. Nachdem ich die Rollenzeichnung von @BabylonLabs_io neu erstellt habe, stellte ich fest: „Kein Vertrauen nötig“ bedeutet nicht, dass niemand im System dazu in der Lage wäre – sondern dass jede Person nur ein Stück der Fähigkeiten erhält.
VP ist wie ein Projektmanager. Es wird beim Anlegen des Nutzerkontos ausgewählt und kann danach nicht mehr geändert werden; es organisiert vorab die Transaktionsbilder, lädt die PegIn-Signaturen hoch, erzeugt Rückkaufs-/Rückgabe-Nachweise und treibt Claim voran. Es kann jedoch nicht kurzfristig einen neuen Pfad hinzufügen, um BTC wegzutransportieren; wenn es offline geht, kann der Nutzer weiterhin selbst Claim durchführen, gestützt auf WOTS und die „claimer artifacts“.
AVK ist der Liquidationssitz in der Anwendung. Es nimmt an den Cross-Signaturen beim Aufbau teil; bei Aave-Liquidationen können nur die AVKs, die zuvor in das Transaktionsbild eingetragen wurden, das verwaltete Vault kaufen und die BTC einlösen. Es kann den festgelegten Liquidationspfad beschreiten, aber nicht die normale Auszahlungsadresse ändern.
Universal Challenger ist für das „Aufpassen auf Fehler“ zuständig: Es überwacht Claims über Anwendungen hinweg; wenn ein Nachweis nicht zum Ethereum-Zustand passt, wird herausgefordert. Diese Gruppe ist derzeit geschlossen und versioniert; nicht jeder kann beitreten. Doch auch die Nutzer behalten einen Herausforderungsweg – die Sicherheit ruht nicht darauf, dass ein einzelner Monitoring-Operator online ist.
Security Council ist die rote Notbremse. Im aktuellen Testnetz erfordert es 3/5-Signaturen; es kann Payout verhindern, wenn das Nachweissystem katastrophal ausfällt, aber es kann keine neue Empfangsadresse festlegen: Es kann das Geld nur vorerst blockieren, nicht aber das Geld wegtransportieren.
Ich glaube, das wirklich Klügste daran ist, „Böses Tun“ in Handlungen zu zerlegen, die niemand alleine vollständig ausführen kann. Aber es ist dennoch nicht völlig ohne Berechtigungen: AVK, Challenger und das Komitee haben alle Eintrittshürden. Nach dem Mainnet-Start wird wichtiger als die Anzahl sein, ob Rollen aus unterschiedlichen Organisationen stammen und ob Ersatzpfade im Fehlerfall wirklich durchlaufen.
Machst du dir mehr Sorgen, dass eine bestimmte Rolle Böses tut, oder dass alle Rollen im entscheidenden Moment gemeinsam ausfallen?
#baby $BABY
VP ist wie ein Projektmanager. Es wird beim Anlegen des Nutzerkontos ausgewählt und kann danach nicht mehr geändert werden; es organisiert vorab die Transaktionsbilder, lädt die PegIn-Signaturen hoch, erzeugt Rückkaufs-/Rückgabe-Nachweise und treibt Claim voran. Es kann jedoch nicht kurzfristig einen neuen Pfad hinzufügen, um BTC wegzutransportieren; wenn es offline geht, kann der Nutzer weiterhin selbst Claim durchführen, gestützt auf WOTS und die „claimer artifacts“.
AVK ist der Liquidationssitz in der Anwendung. Es nimmt an den Cross-Signaturen beim Aufbau teil; bei Aave-Liquidationen können nur die AVKs, die zuvor in das Transaktionsbild eingetragen wurden, das verwaltete Vault kaufen und die BTC einlösen. Es kann den festgelegten Liquidationspfad beschreiten, aber nicht die normale Auszahlungsadresse ändern.
Universal Challenger ist für das „Aufpassen auf Fehler“ zuständig: Es überwacht Claims über Anwendungen hinweg; wenn ein Nachweis nicht zum Ethereum-Zustand passt, wird herausgefordert. Diese Gruppe ist derzeit geschlossen und versioniert; nicht jeder kann beitreten. Doch auch die Nutzer behalten einen Herausforderungsweg – die Sicherheit ruht nicht darauf, dass ein einzelner Monitoring-Operator online ist.
Security Council ist die rote Notbremse. Im aktuellen Testnetz erfordert es 3/5-Signaturen; es kann Payout verhindern, wenn das Nachweissystem katastrophal ausfällt, aber es kann keine neue Empfangsadresse festlegen: Es kann das Geld nur vorerst blockieren, nicht aber das Geld wegtransportieren.
Ich glaube, das wirklich Klügste daran ist, „Böses Tun“ in Handlungen zu zerlegen, die niemand alleine vollständig ausführen kann. Aber es ist dennoch nicht völlig ohne Berechtigungen: AVK, Challenger und das Komitee haben alle Eintrittshürden. Nach dem Mainnet-Start wird wichtiger als die Anzahl sein, ob Rollen aus unterschiedlichen Organisationen stammen und ob Ersatzpfade im Fehlerfall wirklich durchlaufen.
Machst du dir mehr Sorgen, dass eine bestimmte Rolle Böses tut, oder dass alle Rollen im entscheidenden Moment gemeinsam ausfallen?
#baby $BABY
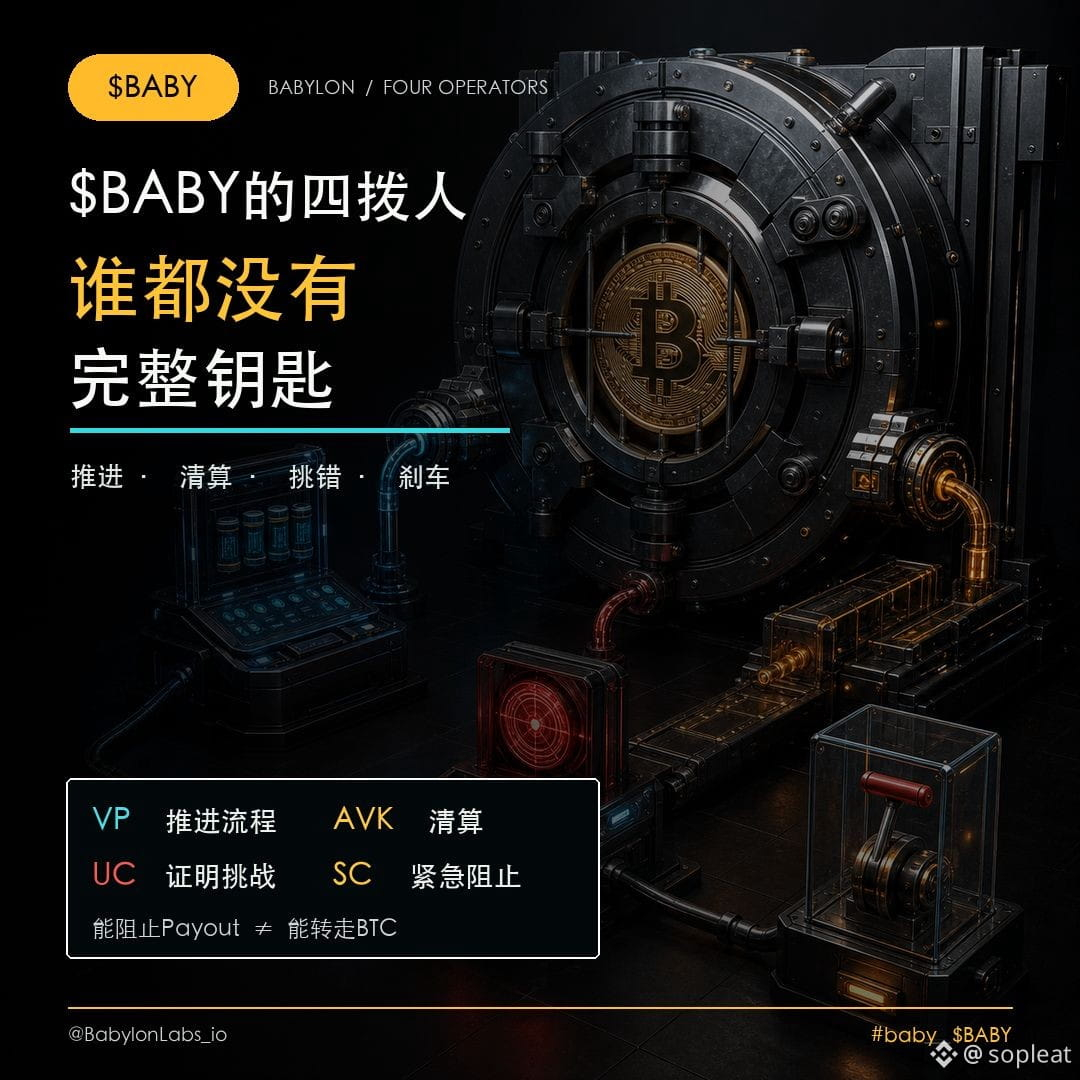
1
112
·
--
Zehn Tresore in einer einzigen Bitcoin-Transaktion unterzubringen, wirkt so, als würde man die Gebühr direkt auf ein Zehntel herunterkürzen. Beim Zerlegen habe ich jedoch festgestellt: Die @babylonlabs_io eingesparten Kosten sind nur ein gemeinsames Außengehäuse, keine neunfachen Sicherheitsprozesse.
Das aktuelle TBV-Testnetz erlaubt, dass eine Batch-Pre-PegIn-Transaktion bis zu 10 HTLC-Outputs enthält. Nehmen wir zwei Tresore als Beispiel: Die beiden Outputs teilen sich eine einzige Bitcoin-Transaktion und denselben Abschnitt der Bestätigungshistorie. Dadurch müssen die Parent-Transaktionen nicht separat ausgestrahlt werden. Aber jeder Output entspricht weiterhin einem unabhängigen Vault. Jeder Vault hat seinen eigenen UTXO, eine eigene Pre-Sign-Transaktionsgrafik und einen eigenen Exit-Pfad. Aus gemeinschaftlichen Geldern wird dadurch kein gemeinsamer Pool.
Was mich jedoch am meisten beschäftigt, ist, wo die Signaturen landen. Während der Erstellung sammelt VP die Signaturen der Teilnehmer für den PegIn-Input und übermittelt sie gebündelt an Ethereum. Sobald der Benutzer das aktivierte secret offenbart, können auch wenn VP plötzlich offline geht, die anderen die Signaturen on-chain abrufen, den finalen Witness zusammenbauen und den PegIn ausstrahlen. Hier geht es nicht darum, dass der Diebstahl eines privaten Schlüssels verhindert wird, sondern darum, dass VP die Signaturen auf einem Server „parkt“, sodass BTC unterwegs feststeckt.
Diese Schicht der Verfügbarkeit hat jedoch klare Grenzen. Die auf der Kette gespeicherten PegIn-Signaturen lösen das Problem „Kann der Einbuchungsprozess abgeschlossen werden?“ Wenn VP später die Rücknahme verweigert, müssen die Nutzer sich weiterhin auf die von ihnen selbst gespeicherten WOTS-Schlüssel und die zu jedem Vault gehörenden clai mer artifacts verlassen, um per Self-Claim zu beanspruchen. Eine Batch-Transaktion bedeutet außerdem: Mehrere Outputs teilen sich den Bestätigungsfortschritt der Parent-Transaktion. Das spart Gebühren, beseitigt aber nicht die Last für Off-Chain-Koordination und Backups.
Darum werde ich Batch-Peg-in nicht so verstehen, als würden „zehn Tresore nur mit einer einzigen Sicherheitsarbeit“ laufen. Es ist eher so, als würde man zehn unabhängige Policen in eine Versandtasche packen: Die Versandkosten sind geringer, aber jede Police muss weiterhin separat korrekt signiert werden. Nach dem Go-Live im Mainnet werde ich mir den durchschnittlichen Batch-Umfang, die Signatur-Completion-Rate und die Übernahmegeschwindigkeit ansehen, wenn VP offline ist, um zu beurteilen, ob die Gebühren durch operativen Reibungsverlust wieder aufgefressen werden.
Was ist dir wichtiger: wie viel Gebühren du durch Batch sparst, oder das Risiko, dass mehrere Vaults gleichzeitig auf die Bestätigung warten?
#baby $BABY
Zehn Tresore in einer einzigen Bitcoin-Transaktion unterzubringen, wirkt so, als würde man die Gebühr direkt auf ein Zehntel herunterkürzen. Beim Zerlegen habe ich jedoch festgestellt: Die @BabylonLabs_io eingesparten Kosten sind nur ein gemeinsames Außengehäuse, keine neunfachen Sicherheitsprozesse.
Das aktuelle TBV-Testnetz erlaubt, dass eine Batch-Pre-PegIn-Transaktion bis zu 10 HTLC-Outputs enthält. Nehmen wir zwei Tresore als Beispiel: Die beiden Outputs teilen sich eine einzige Bitcoin-Transaktion und denselben Abschnitt der Bestätigungshistorie. Dadurch müssen die Parent-Transaktionen nicht separat ausgestrahlt werden. Aber jeder Output entspricht weiterhin einem unabhängigen Vault. Jeder Vault hat seinen eigenen UTXO, eine eigene Pre-Sign-Transaktionsgrafik und einen eigenen Exit-Pfad. Aus gemeinschaftlichen Geldern wird dadurch kein gemeinsamer Pool.
Was mich jedoch am meisten beschäftigt, ist, wo die Signaturen landen. Während der Erstellung sammelt VP die Signaturen der Teilnehmer für den PegIn-Input und übermittelt sie gebündelt an Ethereum. Sobald der Benutzer das aktivierte secret offenbart, können auch wenn VP plötzlich offline geht, die anderen die Signaturen on-chain abrufen, den finalen Witness zusammenbauen und den PegIn ausstrahlen. Hier geht es nicht darum, dass der Diebstahl eines privaten Schlüssels verhindert wird, sondern darum, dass VP die Signaturen auf einem Server „parkt“, sodass BTC unterwegs feststeckt.
Diese Schicht der Verfügbarkeit hat jedoch klare Grenzen. Die auf der Kette gespeicherten PegIn-Signaturen lösen das Problem „Kann der Einbuchungsprozess abgeschlossen werden?“ Wenn VP später die Rücknahme verweigert, müssen die Nutzer sich weiterhin auf die von ihnen selbst gespeicherten WOTS-Schlüssel und die zu jedem Vault gehörenden clai mer artifacts verlassen, um per Self-Claim zu beanspruchen. Eine Batch-Transaktion bedeutet außerdem: Mehrere Outputs teilen sich den Bestätigungsfortschritt der Parent-Transaktion. Das spart Gebühren, beseitigt aber nicht die Last für Off-Chain-Koordination und Backups.
Darum werde ich Batch-Peg-in nicht so verstehen, als würden „zehn Tresore nur mit einer einzigen Sicherheitsarbeit“ laufen. Es ist eher so, als würde man zehn unabhängige Policen in eine Versandtasche packen: Die Versandkosten sind geringer, aber jede Police muss weiterhin separat korrekt signiert werden. Nach dem Go-Live im Mainnet werde ich mir den durchschnittlichen Batch-Umfang, die Signatur-Completion-Rate und die Übernahmegeschwindigkeit ansehen, wenn VP offline ist, um zu beurteilen, ob die Gebühren durch operativen Reibungsverlust wieder aufgefressen werden.
Was ist dir wichtiger: wie viel Gebühren du durch Batch sparst, oder das Risiko, dass mehrere Vaults gleichzeitig auf die Bestätigung warten?
#baby $BABY
Das aktuelle TBV-Testnetz erlaubt, dass eine Batch-Pre-PegIn-Transaktion bis zu 10 HTLC-Outputs enthält. Nehmen wir zwei Tresore als Beispiel: Die beiden Outputs teilen sich eine einzige Bitcoin-Transaktion und denselben Abschnitt der Bestätigungshistorie. Dadurch müssen die Parent-Transaktionen nicht separat ausgestrahlt werden. Aber jeder Output entspricht weiterhin einem unabhängigen Vault. Jeder Vault hat seinen eigenen UTXO, eine eigene Pre-Sign-Transaktionsgrafik und einen eigenen Exit-Pfad. Aus gemeinschaftlichen Geldern wird dadurch kein gemeinsamer Pool.
Was mich jedoch am meisten beschäftigt, ist, wo die Signaturen landen. Während der Erstellung sammelt VP die Signaturen der Teilnehmer für den PegIn-Input und übermittelt sie gebündelt an Ethereum. Sobald der Benutzer das aktivierte secret offenbart, können auch wenn VP plötzlich offline geht, die anderen die Signaturen on-chain abrufen, den finalen Witness zusammenbauen und den PegIn ausstrahlen. Hier geht es nicht darum, dass der Diebstahl eines privaten Schlüssels verhindert wird, sondern darum, dass VP die Signaturen auf einem Server „parkt“, sodass BTC unterwegs feststeckt.
Diese Schicht der Verfügbarkeit hat jedoch klare Grenzen. Die auf der Kette gespeicherten PegIn-Signaturen lösen das Problem „Kann der Einbuchungsprozess abgeschlossen werden?“ Wenn VP später die Rücknahme verweigert, müssen die Nutzer sich weiterhin auf die von ihnen selbst gespeicherten WOTS-Schlüssel und die zu jedem Vault gehörenden clai mer artifacts verlassen, um per Self-Claim zu beanspruchen. Eine Batch-Transaktion bedeutet außerdem: Mehrere Outputs teilen sich den Bestätigungsfortschritt der Parent-Transaktion. Das spart Gebühren, beseitigt aber nicht die Last für Off-Chain-Koordination und Backups.
Darum werde ich Batch-Peg-in nicht so verstehen, als würden „zehn Tresore nur mit einer einzigen Sicherheitsarbeit“ laufen. Es ist eher so, als würde man zehn unabhängige Policen in eine Versandtasche packen: Die Versandkosten sind geringer, aber jede Police muss weiterhin separat korrekt signiert werden. Nach dem Go-Live im Mainnet werde ich mir den durchschnittlichen Batch-Umfang, die Signatur-Completion-Rate und die Übernahmegeschwindigkeit ansehen, wenn VP offline ist, um zu beurteilen, ob die Gebühren durch operativen Reibungsverlust wieder aufgefressen werden.
Was ist dir wichtiger: wie viel Gebühren du durch Batch sparst, oder das Risiko, dass mehrere Vaults gleichzeitig auf die Bestätigung warten?
#baby $BABY
1
108
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
WhoWillSucceedJensenHuangatNvidia?
186,414 Aufrufe
1,733 Kommentare
Nvidia: Keine Gespräche über CEO-Nachfolge – Petition „Stand With Jensen“ erreicht mehr als 77.900 Unterschriften
Binance News
·33 Likes
·65.8k Aufrufe
WhatWillDriveCryptoandStocks’NextRebound?
602,439 Aufrufe
3,570 Kommentare
TradFiForBeginners
743,043 Aufrufe
4,538 Kommentare