

一路生花的故事
69 Beiträge
一路生花的故事
Melden
Nutzer blockieren
4 Following
18 Follower
23 Like gegeben
Beiträge
Alle
Zitierungen
·
--
#opg $OPG 朋友 warf mir diese drei Zahlen ins Gesicht: 4400 Modelle, 2 Millionen Inferenzläufe, 260.000 Adressen. Meine erste Reaktion war nicht „wow“, sondern den Taschenrechner herauszuholen — und am Ende kam eine Zahl heraus, die mir ziemlich peinlich war.
Zuerst die Nutzerrechnung. 260.000 Adressen auf 2 Millionen Läufe verteilt ergibt im Durchschnitt 7,7 Läufe. Was bedeutet 7,7 Läufe? Wer schon einmal einen echten API-Dienst genutzt hat, weiß: Allein in einer Debugging-Phase kommt man oft schon über zehn Durchläufe. Wenn das bei OpenGradient die „echte Nutzerbindung“ sein soll, dann kann man nur sagen: Die allermeisten Adressen waren wohl nur „Interaktionssoldaten“, die wegen der erwarteten Airdrops kamen, sich kurz bedienen ließen und dann wieder verschwanden.
Dann die Modellrechnung. 4400 Modelle konkurrieren um 2 Millionen Inferenzläufe, das macht im Schnitt 455 Läufe pro Modell. Wer in der Praxis schon Fine-Tuning gemacht hat, weiß: Wenn man ein neues Modell auf Hugging Face veröffentlicht, kommen allein die CI-Tests oft auf mehr als diese Menge. Das kann nur zwei Dinge bedeuten: Entweder sind viele Modelle bloß „Zombie-Gewichte“, die von anderen hochgeladen wurden, oder das sogenannte „Hosting“ ist nichts weiter als ein Modellname auf einer Liste, der nie wirklich in die Inferenz-Routing-Pipeline gelangt ist.
Aber was ich am widersprüchlichsten finde, ist nicht die Größe der Zahlen, sondern die Logik dahinter. OpenGradient wirbt mit „verifizierbarer KI“ — der Inferenzprozess soll kryptografische Beweise erzeugen, und die Verifizierungskosten sind extrem hoch. Wenn diese 2 Millionen Inferenzläufe alle on-chain verifiziert würden, wären die Gas-Kosten längst explodiert und das Projekt schon pleite; wenn diese 2 Millionen Läufe dagegen nur off-chain berechnet und lediglich die Ergebnisse zurückgeschickt würden, worin unterscheidet ihr euch dann von einer traditionellen API? Wo genau steckt dann die Dezentralisierung?
Dieser Kernmechanismus bleibt auf der offiziellen Website auffallend vage. Was ich sehe, ist, dass sie „kumulierte Inferenz“ als serverseitigen Zähler für Aktivität verkaufen, dabei aber die entscheidendste Frage umgehen: Wie viele dieser Inferenzläufe wurden tatsächlich durch das Konsensnetzwerk verifiziert?
Ich will das Projekt nicht pauschal abwerten, aber als grundlegende Infrastruktur wirken Daten mit eingebrochener Dichte und ein unklarer Verifizierungsmechanismus nicht wie eine technische Roadmap, sondern wie verpackte Betriebskennzahlen. Beim nächsten Wochenbericht: Packt bitte „tägliche aktive Verifizierungsnodes“ und „Anzahl der On-Chain-Verifizierungen“ auf den Tisch, dann bin ich sofort still. Bis dahin kann ich diese drei Zahlen nur als PR-Text betrachten.@OpenGradient
2
1
109
·
--
Blas nicht länger nur über Rechenleistung—das Nadelöhr dezentraler KI ist das Hosting der „dreckigen Arbeit“
Letzten Monat wollte ich fünf vertikale Kleinstmodelle im Batch auf eine dezentrale Plattform ausrollen. Ergebnis: Geschraubt bis 2 Uhr nachts—und am Ende lag der Grund dafür, dass es komplett abgestürzt ist, an einem einzigen Buchstaben: In den Umgebungsvariablen stimmte die Groß-/Kleinschreibung nicht. In dem Moment habe ich es verstanden: Ganze drei Tage, 80% der Zeit waren dabei, die Plattform als „menschlicher Adapter“ anzupassen. Echtes Business-Testing waren am Ende keine zwei Stunden. In diesem Bereich fehlt nicht die Rechenleistung, sondern eine Hosting-Pipeline, die dich „blind übergeben lässt, automatisch durchreicht“
Als ich dann die HACA-Architektur von OpenGradient auseinandergenommen habe, dachte ich mir: Da ist wirklich jemand an vorderster Linie operativ mitgegangen. Er hat etwas getan, das extrem unsexy ist, aber rettet Leben: Er hat das Modell so verpackt, dass es zu einer standardisierten Pipeline wird. Der Kern ist diese Adaptionsebene—so wie ich es verstehe, bildet sie die Operatoren verschiedener Frameworks wie PyTorch und ONNX hart auf einen einheitlichen Zwischen-Output (IR) ab. Das ist wie ein „Universalübersetzer“: Du gibst ihm jedes Format, und er macht daraus die allgemeine Sprache, die die Plattform versteht. Die Scheduling-Schicht ist noch cleverer: Sie zerlegt den Berechnungsgraphen automatisch anhand der Modellparametergröße—bei großen Modellen auf High-VRAM-Karten, bei kleinen auf Knoten mit geringer Rechenleistung. Ich muss keine Modelle manuell auswählen. Und das Plug-in-Design bedeutet: Wenn künftig etwa Mamba als neue Architektur kommt, hängt man einfach ein Plug-in dran, und die darunterliegende Scheduling-Engine muss gar nicht geändert werden. Das spart uns als Team, das viele Modelle im Batch laufen lässt, nicht nur Zeit—sondern auch Haare. #OPG
Natürlich nicht so tun, als wäre das Magie. Wenn man gleichzeitig über hundert Modelle anhängt, wird der Speicheraufwand und die Lizenzprüfung natürlich gnadenlos entlarvt—die offiziellen Stellen haben bisher auch noch keine perfekte Lösung dafür. Das muss man weiter im Blick behalten: $OPG
Aber mein Urteil ist ziemlich klar: Die Plattformen, die jeden Tag nur Benchmark-Daten abscannen, werden innerhalb von zwei Jahren sehr wahrscheinlich von Infrastruktur mit starken Hosting-Fähigkeiten „niedergedrückt“ werden. Der Grund ist simpel—Rechenleistung kann man mit Geld stapeln, aber „standardisiertes Batch-Hosting“ ist eine Aufgabe, die Empathie mit Entwicklern braucht. OpenGradient liegt mit der Richtung richtig. Wenn das nächste Schritt bei Storage und Lizenzen wirklich landet, schneide ich mein Hauptmodell sofort dorthin um. Investieren ist genauso: Nicht an PPT glauben—glaub an die „nicht nervöse“ Erfahrung, wenn du es wirklich selbst ausrollst. Genau das ist die harte Wahrheit für das Überdauern über den Zyklus hinweg. @OpenGradient
85
·
--
Letzten Monat wurde eine DeFi-Treasury von einem AI Agent in einem Augenblick um mehrere Millionen U geleert. Danach schob die ganze Branche sich gegenseitig die Schuld zu – der Node sei gehackt worden, das Modell habe eine Hintertür gehabt, Anweisungen seien abgefangen worden – aber niemand konnte einen harten Beweis vorlegen. In der Blackbox von Web2 ist selbst dann, wenn der Server schon völlig abgegriffen ist, am Ende nichts Wirkliches herauszufinden. Die rechtliche Verantwortung von KI und ihre Audit-Mechanismen sind bis heute ein riesiges Verantwortungs-Blackhole.
Die Lösung von OpenGradient ist nicht, KI mit „Fesseln“ zu versehen, sondern die grundlegende Logik der KI-Verifikation neu aufzubauen. Der Kern ist nur ein einziger Schritt – zerlegen. Es entkoppelt Inferenz und Verifikation vollständig: Inferenz-Nodes kümmern sich nur darum, schnell Ergebnisse zu liefern; Verifikations-Nodes führen das Modell nicht erneut aus, sondern entscheiden im Nachhinein per probabilistischer Stichprobenprüfung plus doppelter TEE/ZKML-Authentifizierung. Das unterscheidet sich grundlegend vom traditionellen Blockchain-Ansatz „jeder Full Node rechnet jede Transaktion erneut durch“ und auch von Phalas reinem TEE (abhängig von Hardware-Vertrauen) oder Gizas off-chain ZKML (mit verzögerter Verifikation). HACAs eigentlicher Burggraben ist: Verifizierer müssen nicht in Echtzeit mithalten, haben aber jederzeit das Recht, eine zufällige Challenge auszulösen – als hätte jede KI-Handlung einen „Alarmknopf, der jederzeit losgehen kann“.
Das Wirtschaftsmodell ist der Punkt, an dem es wirklich ernst wird. Verifizierer staken OPG, um an Stichproben teilzunehmen; sobald sie eine falsche Bestätigung unterzeichnen, zieht das System die Coins direkt ab – nicht nur an den Pranger stellen, sondern direkt Geld aus dem Wallet schneiden. Diese Mechanik setzt darauf, dass der erwartete Nutzen von Fehlverhalten für Verifizierer negativ ist. Aber das Problem ist: Ich habe die Dokumentation lange durchgesehen und keine klare Anti-Kollusions-Architektur gefunden – wenn Verifikations-Nodes sich gemeinsam verbünden oder die OPG-Bestände zu stark konzentriert sind, dann wird dieser Richterspruch schnell zum Privateigentum der Mächtigen. @OpenGradient
Finanz-Grade-KI will im dunklen Wald überleben; was fehlt, ist nicht Rechenleistung, sondern eine auditierbare Kette. OpenGradient hat vermutlich den ersten Knopf geschlossen. Aber ich fürchte noch mehr, dass irgendwann jemand lernt, mit kryptografischen „harten Beweisen“ die Verfehlungen von KI nachträglich legal zu legitimieren – wenn die Kette sich umkehrt und zum Schutzschirm wird, dann ist das die wahre Dunkelheit. Mal sehen, aber starrt nicht nur auf die Technik, schaut euch auch die Staking-Tabelle an.
#opg $OPG
78
·
--
03:17 Uhr, das Handy blinkt und leuchtet im Takt.
Ein privates Gesundheitsproblem: erst suchen, dann löschen, löschen, dann wieder suchen – die Suchmaschine wird schon nicht aufschreien, der Freundeskreis wird schon nicht fragen. Aber in diesem Moment … habe ich doch aus Versehen fast gesendet. Und es dem gängigen KI-Mainstream gegeben.
Kaum sprang die Sendetaste zurück, lief es mir eiskalt den Rücken hinunter: Wo würde dieser Satz landen? Würde er eines Tages zu Trainingsdaten werden und mich wieder beißen?
In dieser Nacht konnte ich nicht schlafen. Wir bezahlen den KI-Komfort mit dem „Vertrauens-Glücksspiel“ – darauf wetten, dass die Plattform fair ist, darauf wetten, dass Hacker keinen Bedarf an mir haben. Aber das ist kein Vertrauen, das ist keine Wahl.
Bis jemand dieses Spiel aufdeckte.
#opg
OpenGradient packt ChatGPT, Claude, Grok und Gemini in eine einzige Oberfläche – mit jederzeitigem Wechsel. Aber was mich wirklich hat aufspringen lassen, war dieser Satz: „Wir können keinerlei Inhalte lesen, die du eingibst.“
Nicht so ein hohles „Wir versprechen den Schutz“-Gerede – sondern Kryptografie als Türsteher.
Drei Schutzebenen auseinandergenommen:
· Verschlüsselung auf Geräteebene: Das Problem wird schon im Browser zu unlesbarem Kauderwelsch gesperrt, der Schlüssel bleibt nur bei dir.
· Oblivious HTTP-Relay: Das Relay sieht die IP, aber nur Chiffretext; das Gateway sieht Klartext, aber nicht, wer du bist – Identität und Inhalt werden in zwei Teile getrennt.
· TEE-Verschlusskapsel: Entschlüsselung erfolgt innerhalb einer hardwarebasierten Isolation – selbst OpenGradient kann nicht hineingreifen, und der Ablauf ist durchgehend überprüfbar.
Sind die drei Schlösser eingerastet, ist das Ergebnis klar: Niemand kann gleichzeitig „wer fragt“ und „was gefragt wurde“ bekommen.
Traditionelle KI sagt: „Keine Sorge, ich lese nicht.“
OpenGradient sagt: „Du musst nicht beruhigt sein, weil ich gar nichts sehen kann.“
Früher dachte ich immer, Intelligenz und Privatsphäre wären eine Wippe: drückt man die eine Seite nach unten, geht die andere hoch. Jetzt ist die Technik da – beide Seiten kann man stabil besetzen.
Wenn du auch schon nachts am Eingabefeld gezweifelt hast: 1000 kostenlose Credits reichen, um die Fragen herauszuholen, die du jahrelang versteckt hast.
Privatsphäre ist kein Luxus, sondern der härteste Pflichtbedarf im KI-Zeitalter.
Während andere noch auf „Vertrauen“ wetten, ist OpenGradient die Hintertür längst mit Kryptografie zugeklebt.
$OPG zu erzählen hat, ist eine Zeit, in der du endlich die Wahrheit sagen darfst.
👉 Welche war deine erste Frage, die du jemals wirklich gewagt hast – und wie lange war sie schon verborgen?
#OPG #OpenGradient
16
·
--
#opg $OPG Meine Frau fragte mich gestern Abend: "Worüber grinst du da auf dein Handy? Chattest du schon wieder sinnlos auf Twitter herum?" Ich traute mich nicht zu antworten, denn auf dem Bildschirm lagen gerade zehn Nachrichten an einen Fremden, die ich eben erst verschickt hatte. Sie verbietet mir nicht zu chatten, sie hat nur Angst, dass die Plattform mithört, mitliest und eines Tages unsere Chatverläufe dem Werbealgorithmus vorwirft. Um ehrlich zu sein: Nach all den Jahren, in denen ich daran gewöhnt bin, von Daten bis auf die Haut ausgezogen zu werden, bin ich schon völlig abgestumpft. Aber nachdem ich OpenGradient Chat ausprobiert hatte, hatte ich zum ersten Mal das Gefühl: Im KI-Zeitalter kann man tatsächlich verhindern, nackt herumzulaufen.
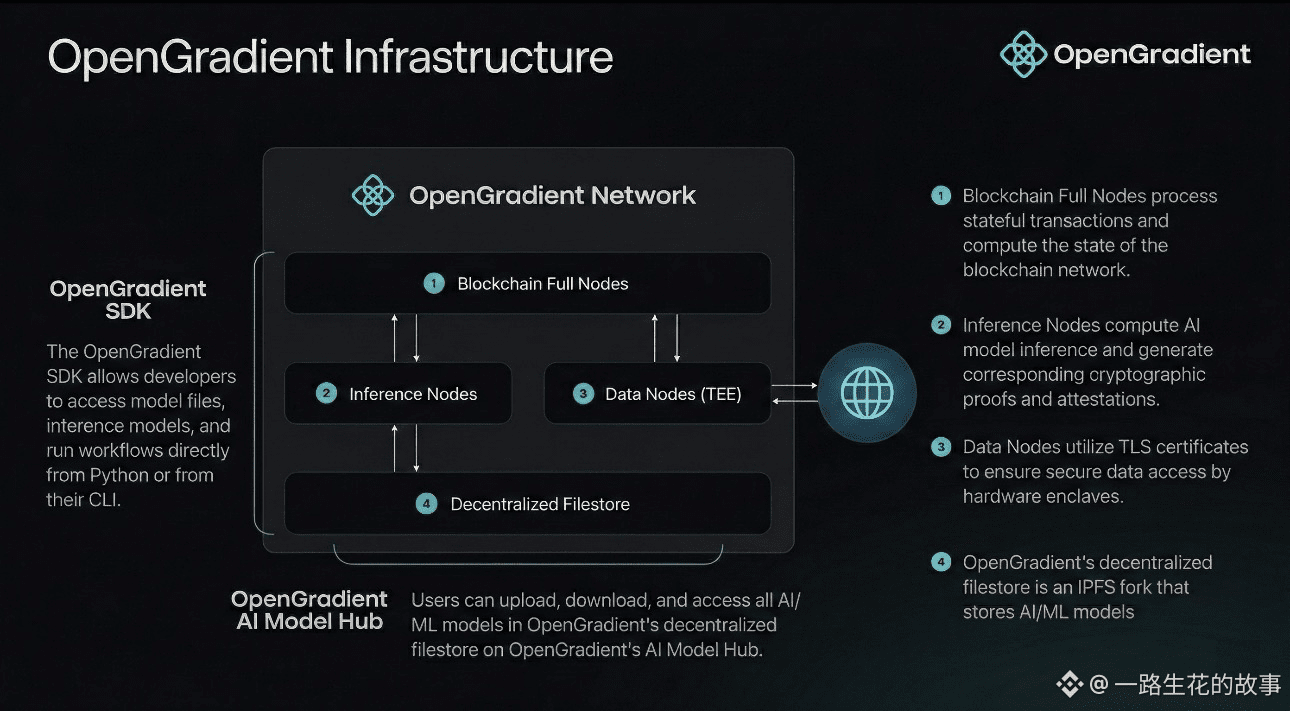
Der Datenschutzmechanismus dieses Chats hat „Privatsphäre“ wirklich in seine DNA eingebaut. Drei Ebenen der Trennung: Du tippst im Browser, der Schlüssel bleibt lokal, und sobald die Nachricht das Gerät verlässt, ist sie nur noch verschlüsselt; das dazwischenliegende Oblivious-HTTP-Relay sieht zwar deine IP, weiß aber nicht, was du gesendet hast; am Downstream-Gateway lässt sich der Inhalt entschlüsseln, aber deine IP ist dort nicht bekannt. Am Ende läuft alles in einer TEE mit Remote Attestation, und selbst wenn das Projektteam heimlich mitlesen wollte, es hat keine Chance. Identität und Inhalt sind vollständig voneinander getrennt.
Aber Privatsphäre ist nur das Eintrittsticket. Der eigentliche Knackpunkt der Branche ist: Was, wenn die Privatsphäre klappt, die Rechenleistung aber einbricht? Früher war KI auf der Blockchain so teuer, dass schon einmal Verifizieren mehr kostete als das Modell einfach neu auszuführen. Traditionelle Blockchains erreichen Konsens, indem sie „neu rechnen“: 100 Verifizierer sollen jeweils ein 70B-Modell einmal durchlaufen? Das verbrennt Rechenleistung in einem erschreckenden Ausmaß, und die Latenz ist direkt ein Dealbreaker. Deshalb hat OpenGradient die HACA-Architektur entwickelt — Ausführung und Verifikation getrennt. Die Inferenzknoten führen nur das Modell aus; die Full Nodes verifizieren lediglich die Nachweise von TEE oder ZKML. Die Verifizierungsknoten müssen nicht einmal wissen, wie dein Prompt lautet, sie prüfen nur, ob der Beweis gültig ist. Die Effizienz ist damit voll ausgeschöpft, die Verifikation dauert nur Millisekunden, egal ob die zugrunde liegende Inferenz 50 ms oder 5 Sekunden braucht.
"Der nützlichste Ort für KI ist genau der Ort, an dem Nutzer am wenigsten bereit sind zu tippen." Dieser Satz des CEOs hat mich wirklich mitten ins Herz getroffen. Früher war es nachts wie ein Dieb, über Märkte zu reden, weil die Daten nackt im Netz lagen. Jetzt kann ich das hier nutzen, und selbst wenn mich eine Kamera beim Tippen erwischt, sieht der Mittelsmann nur eine Zeichenfolge aus Kauderwelsch. Wenn meine Frau mich das nächste Mal zur Rede stellt, kann ich ihr einfach das Handy in die Hand drücken — „Schau ruhig, du verstehst die Verschlüsselung sowieso nicht.“
Das Projekt kam aus dem a16z-Accelerator und hat jetzt GPT, Claude und Gemini integriert. Ein echtes Produkt, ein echtes Grundbedürfnis gelöst — das ist das wahre Asset. Auf kurzfristige Schwankungen schaue ich gar nicht; ich halte es einfach und sehe in einem Jahr, wie es ausgeht. @OpenGradient
1
88
·
--
#opg $OPG Zum ersten Mal nutze ich den OpenGradient Chat und habe absichtlich einen echten Entwurf einer DeFi-Strategie hineingeschoben – kein Test, sondern ein Wagnis darauf, dass er wirklich standhält. In dem Moment, in dem ich Enter drücke, schaue ich nicht auf die Geschwindigkeit der Antwort, sondern darauf, ob dieser Prompt jemals durch die Augen von irgendeinem Dritten gegangen ist.
Das Ergebnis hat mich nicht enttäuscht. TEE sperrt den Dialogprozess fest, und die Nova-Blockchain prüft am Ende die Verifikation – der Cloud-Anbieter, die Node-Betreiber und sogar das Team selbst können auf der physikalischen Ebene nicht heimlich mitlesen. Nach meinem Test macht mir jedoch etwas anderes noch mehr Sorgen: Intel.
Die HACA-Architektur trennt Ausführung und Verifikation konsequent. Ein klassisches Problem bei AI in traditionellen Blockchains: 100 Verifikationsknoten laufen je einmal ein 70B-Parameter-LLM – die Kosten steigen auf das 100-fache, und das Ergebnis ist nicht einmal garantiert identisch. Die Lösung von HACA lautet: In der TEE laufen die Inferenzknoten das Modell, erzeugen hardwarebasierte Zertifikate; die Verifikationsknoten prüfen nur die Gültigkeit dieser Zertifikate – sie müssen von Anfang bis Ende weder Prompt noch Ausgabe kennen. Die Verifikation muss nur im Millisekundenbereich erfolgen. Seit dem Mainnet-Start sind es mehr als zwei Monate: über 2000+ Modelle gehostet, über 2 Millionen Inferenzanfragen verarbeitet, und a16z Crypto sowie Coinbase Ventures führten die Runde mit 9,5 Millionen USD an.
Aber die Sicherheit des TEE hängt vollständig an den Microcodes von Intel/AMD. Die TEE.Fail-Seitenkanalangriffe, die im Oktober 2025 offengelegt wurden, können bei Kosten von weniger als 1000 USD Schlüssel aus SGX, TDX und SEV-SNP stehlen. Nova garantiert, dass „der Ausführungsprozess nicht manipuliert wurde“ – aber es garantiert nicht, dass „die Ausführungsumgebung von Anfang an sauber war“.
Betrachten wir auch das Token: Gesamtangebot 1 Milliarde, aktuell nur 190 Millionen im Umlauf. In der Ecosystem-Struktur sind 40% linear entsperrt, über 60 Monate. Stand vom 16. Juni liegt der OPG-Preis bei 0,1618 USD, die Marktkapitalisierung bei etwa 30,74 Millionen USD, und der Kurs ist in 24 Stunden um 47% gefallen. Diese Volatilität zeigt, dass der Umlauf sehr dünn ist und die Coins stark konzentriert sind.
Meine Strategie ist ganz einfach: extrem niedrige Position als Beobachtungs-Depot. Ich beobachte die TEE-Verifikationsquote und die Stabilität der Block-Produktionsrate der Nodes. Erst wenn beides über drei Monate stabil läuft, denke ich über Nachkauf nach. Bis dahin: Wenn irgendwer „All in“ ruft, bin ich sofort auf Konfrontationskurs mit der Person. In diesem Markt gibt es zu viele Leute, die Geschichten erzählen – und viel zu wenige, die aus Geschichten Realität machen @OpenGradient
96
·
--
In letzter Zeit habe ich ununterbrochen die Rotation des Gesamtmarkts beobachtet, und überall sieht man nur von Marketing aufgeblasene KI-Konzept-Token; das ist so schwindelerregend, dass einem der Kopf dröhnt. Die Marktstimmung ist derzeit extrem oberflächlich und hektisch, voller Kapitalräuber, die Kleinanleger mit bloß zusammengeschusterten Web-Apps hinters Licht führen und damit ganz offen die Intelligenz aller abschöpfen.
Ehrlich gesagt: Wenn ich nicht persönlich getestet und den zugrunde liegenden Betriebsmechanismus von @OpenGradient durchlaufen hätte, würde ich mir diese Art von Story nicht einmal ansehen. Die Grundidee dieses Projekts ist tatsächlich ziemlich hart; es umgeht den überfüllten Endverbrauchermarkt und setzt stattdessen kompromisslos auf die B2B-On-Chain-Intelligenzschicht. Dieses hybride Netzwerk erweitert die Grenzen von EVM erheblich und ermöglicht es Smart Contracts, die eigentlich keine komplexen Berechnungen verarbeiten können, nahtlos auf die Inferenz großer Modelle zuzugreifen. Komplexe On-Chain-Interaktionen, die früher an astronomischen Gasgebühren gescheitert sind, sehen dank des originellen Compute-Netzwerks jetzt endlich eine reale Umsetzbarkeit. #OPG
Trotzdem müssen wir, nüchtern und geschäftlich betrachtet, weiterhin die systemischen Risiken klar im Blick behalten. Da die dezentralisierte Rechenleistung von $OPG auf TEE-Hardwareknoten verwahrt wird, ist der Sicherheitsgrad dieser Grundlage tatsächlich eng an die Vertrauenswürdigkeit der Hardwarehersteller gekoppelt. Sobald es im nachgelagerten Chipbereich auf Mikrocode-Ebene eine Schwachstelle gibt, bricht die Vertrauensbasis des gesamten dezentralen Compute-Netzwerks im Handumdrehen zusammen. Außerdem öffnet das kurze Zeitfenster zwischen der Entstehung der Inferenzdaten und der endgültigen On-Chain-Abrechnung de facto ein perfektes Raum für Sandwich-Arbitrage durch On-Chain-MEV-Bots.
Ich habe mir den Abwicklungsplan angesehen; die Positionskontingente großer Institutionen werden erst im April nächsten Jahres freigeschaltet. Daher ist meine aktuelle Strategie äußerst diszipliniert: Ich betrachte es momentan lediglich als Gradmesser für die technologische Entwicklung und die Marktstimmung, beteilige mich mit sehr kleiner Position und werde keinesfalls leichtfertig mein gesamtes Kapital einsetzen, bevor es einen klaren technischen Patch gibt. #opg
72
·
--
#opg $OPG OpenGradient TEE-Black-Box – und dabei mache ich mir eher noch mehr Sorgen um die Hardware-Anbieter
Beim ersten Einsatz von OpenGradient Chat habe ich bewusst einen echten Entwurf für eine DeFi-Strategie eingegeben – kein Test, sondern ein Wagnis darauf, dass es wirklich standhält. In dem Moment, als ich die Eingabetaste betätigte, richtete sich mein Augenmerk nicht darauf, ob die Antwort schnell kommt, sondern darauf, ob dieser Prompt jemals die Augen irgendeines Zwischenhändlers passiert hat.
Der Ansatz wirkt ziemlich kompromisslos: Der komplette Gesprächsverlauf wird in ein TEE gepackt und zusätzlich durch die On-Chain-Verifizierung im Nova-Netzwerk abgesichert. Das bedeutet: Weder der Cloud-Anbieter noch die Betreiber der Knoten – ja nicht einmal OpenGradient selbst – können auf physischer Ebene deine Eingaben ausspionieren. Die nach der Ausführung erzeugten Hashes werden direkt auf die Kette geschrieben, um die Unschuld zu beweisen.
Diese Logik klingt zwar perfekt, aber was mich wirklich interessiert, ist nicht nur, wie es vor Ausspähung schützt, sondern ob das TEE selbst überhaupt vertrauenswürdig ist. Intel- und AMD-Hardware-Sicherheitsmodule hatten bereits Side-Channel-Schwachstellen – das ist kein Geheimnis. Wenn ein staatlich agierender Angreifer oder ein Miner mit physischem Zugriff es schafft, vor dem TEE-Start einen Hintertür-Code einzupflanzen, hilft selbst der noch so „schöne“ On-Chain-Hash wenig. Natroas Verifizierungsmechanismus kann nur garantieren, dass „der Ausführungsprozess nicht manipuliert wurde“, aber er stellt nicht sicher, dass die Ausführungsumgebung von Anfang an sauber war.
Genau diese Doppelschneidigkeit muss OpenGradient adressieren: Je stärker sie Privatsphäre betonen, desto stärker wird das Vertrauen der Nutzer in die Hardware-Sicherheit zur Single-Point-Abhängigkeit. Ihre aktuelle Gegenmaßnahme ist, dass Verifizierungsknoten über unterschiedliche Hardware-Lieferanten verteilt werden – aber ob sie bei hoher Parallelität sicherstellen können, dass wirklich alle TEE einheitlich auf die entsprechenden Patches aktualisiert werden, habe ich bisher keine konkreten Daten gesehen.
Kommen wir zurück zu ihrer Produktstrategie. Den Chatbot als Einstieg zu wählen, ist in der Tat klug. Ohne Handynummer, ohne Spuren, kein KYC – erst einmal sollen Nutzer in Niedrigrisiko-Szenarien Gewohnheiten aufbauen. Aber der eigentliche Ehrgeiz liegt offensichtlich woanders: Sobald diese verifizierbare Architektur stabil läuft, wird die automatisierte Ausführung von DeFi-Strategien, die datenschutzfreundliche Berechnung für DAO-Governance-Votings und sogar das KI-gestützte Wallet-Management für Menschen mit hohem Nettovermögen nur eine logische Folge sein.
Ich werde zwei On-Chain-Kennzahlen im Blick behalten: Erstens die Häufigkeit und die Erfolgsquote der TEE-Ausführungs-Verifizierung, und zweitens die Stabilität der Block-Rate der Verifizierungsknoten im Nova-Netzwerk. Die erste Linie zeigt Leistungs-Engpässe auf, die zweite macht Lieferkettenrisiken bei der Hardware sichtbar. Diese beiden Spuren sind ehrlicher als jedes Marketing-Gerede.
Was den OPG-Token angeht: Ich schaue mir die Netzvalidierungsdaten an, wenn sie drei Monate im Mainnet gelaufen sind. Jetzt ist ein Fazit noch zu früh@OpenGradient
78
·
--
#opg $OPG Brüder, lasst euch nicht von der Erzählung der "Hash-Power-Mittelsmänner" täuschen, das ist alles nur harte Arbeit für die Miner!
Letzte Nacht habe ich mit ein paar Brüdern, die DePIN schürfen, gegrillt, und je mehr wir sprachen, desto mehr Angst bekam ich. Du gibst viel Geld aus, um ein privates Modell auf der Chain laufen zu lassen, und die Node-Miner können dir einfach dein Gewicht abnehmen; noch absurder ist, dass einige Typen zur Einsparung von Stromkosten einfach Zufallszahlen benutzen, um die Ergebnisse zu verarschen. Wo ist da die Dezentralisierung? Das ist ein "Vertrauens-Schwarzes-Loch", das die großen Fische abzieht!
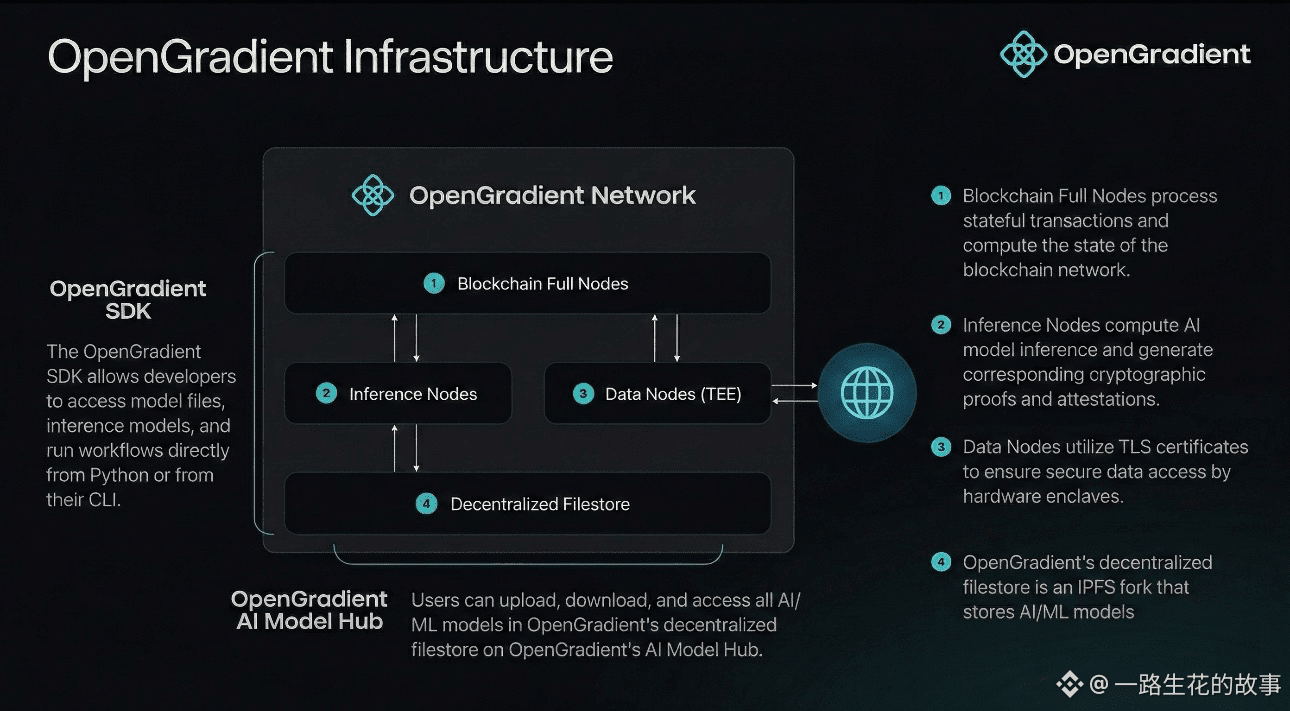
Erst als ich das Whitepaper von @OpenGradient aufgeschlagen habe, habe ich verstanden, was dimensionaler Angriff bedeutet. Es vergleicht nicht die Anzahl der Grafikkarten, sondern kämpft um "vertrauenswürdige Ausführung". Am meisten hat mich seine HACA-Architektur beeindruckt – das Ding trennt "Arbeiten" und "Buchhaltung" einfach in zwei Linien!
Wo sind die traditionellen Projekte blöd? Sie müssen 100 Nodes dazu bringen, das große Modell zur Validierung der Ergebnisse zu wiederholen, die Kosten sind astronomisch. Und das Spiel von OPG ist extrem schlau: Die Inferenz-Nodes laufen in TEE (Trusted Execution Environment) und führen das Modell heimlich aus, am Ende generieren sie einen kryptografischen Beweis, der hardware-gestützt ist; die Full Nodes müssen die Daten überhaupt nicht erneut ausführen, sondern nur in Millisekunden überprüfen, ob dieser Beweis echt ist. Das entkoppelt die "schwere Arbeit" der AI-Inferenz vollkommen von der "leichten Abrechnung" der Chain-Konsens!
Was bedeutet das? Die Miner können weder auf mein Modellgewicht zugreifen (TEE-Isolierung), noch können sie mich mit falschen Ergebnissen verarschen (kryptografischer Beweis auf der Blockchain). Was sie verkaufen, ist nicht billige Rechenleistung, sondern "verifiable Determinism".
Der ökologische Platz dieses Projekts ist zu beängstigend, es ist nicht einfach nur der interne Wettbewerb im DePIN-Sektor, es will die Chainlink der AI-Ära werden – eine absolute Notwendigkeit für die Privatsphäre in der Berechnung. a16z führt die Finanzierung an, das Team besteht aus Technikern von Two Sigma und Palantir. $OPG ist nicht an Stromkosten gebunden, sondern an die "Mautgebühr", die man für Finanz- und Gesundheits-AI zahlen muss. Wenn das Mainnet vollständig ausgerollt ist, wird die Bewertungsobergrenze der traditionellen DePIN vor ihm wie ein kleiner Bruder dastehen. Diese Welle des Wash-Tradings ist vorbei, ich werde schwer investieren, die Perspektiven von @OpenGradient sind riesig.
1
93
·
--
#opg $OPG Über OpenGradient zu sprechen, heißt erst einmal, einen Dämpfer zu geben. Überall Schlagzeilen mit „KI + Krypto“ – neun von zehn Projekten springen nur auf den Hype-Zug auf. OpenGradient hat zwar 9,5 Millionen US-Dollar an angeführter Finanzierung von a16z und Coinbase Ventures erhalten – aber mich interessiert vor allem, ob die Technik in der Praxis funktioniert.
Es macht kein Chatten für Endnutzer, sondern konzentriert sich knallhart auf B2B-Off-Chain-Inferenz. Aufwendige Rechenarbeit wird off-chain verlagert, der kryptografische Nachweis kommt zur Verifizierung zurück auf die EVM. Der Kern des Whitepapers ist die HACA-Architektur: Ausführung und Verifizierung sind getrennt. Das Netzwerk ist aufgeteilt in Inferenz-Knoten, die Modelle ausführen, Full Nodes, die Beweise verifizieren, und Datenknoten, die externe Informationen abrufen. Inferenz-Knoten erzeugen TEE- oder ZK-Nachweise und schreiben sie on-chain; Full Nodes prüfen nur die kryptografische Gültigkeit, ohne das Modell erneut auszuführen – Verifizierung im Millisekundenbereich, egal wie lange die Inferenz dauert. Stand Mainnet-Start im April 2026 wurden über 2000 Modelle verwaltet, mehr als 2 Millionen Inferenzanfragen verarbeitet und über 500.000 Nachweise erzeugt.
Drei Verifizierungsmodi sind einen genaueren Blick wert: TEE (hardwaregestützte Authentifizierung mit geringem Overhead), ZKML (mathematisch sehr sicher, aber rechenintensiv) und Vanilla (nur Signaturen). Die Logik des Whitepapers lautet: im Alltag TEE verwenden, bei Entscheidungen mit großen Vermögenswerten auf ZKML setzen.
Doch das Wirtschaftsmodell hat einen echten Schwachpunkt. Der OPG-Gesamtvorrat beträgt 1 Milliarde, im Umlauf sind nur 190 Millionen. Beim TGE wurden Airdrop und Liquidität vollständig freigeschaltet, während Ökosystem, Stiftung und Mitwirkende langfristig linear freigegeben werden – heute (21. Juni) wurden gerade 9,13 Millionen Token freigeschaltet, im Wert von etwa 1,62 Millionen US-Dollar. Der Angebotsdruck ist offensichtlich.
Noch problematischer sind die Kosten der ZK-Beweise. Ein einzelner Nachweis kann bis zu 65 US-Dollar kosten. Bei heftigen Marktschwankungen können Hardwarekosten plus On-chain-Reibung die Handelsgewinne schnell auffressen. Zwar nennt das Whitepaper mit TEE und ZKML zwei Wege, aber ob die Kostenkurve wirtschaftlich tragfähig ist, beantworten die Mainnet-Daten bisher nicht.
Das Fazit ist ziemlich klar: Die HACA-Architektur ist in sich schlüssig, die technische Basis ist vorhanden, aber das Kostenmodell wurde in der Praxis noch nicht getestet. Behalte die durchschnittlichen Nachweiskosten pro Inferenz im Mainnet im Blick – erst wenn sie unter 0,01 US-Dollar fallen, wäre ein Aufstocken überhaupt zu überlegen. Im Moment taugt das Ganze nur als Risikomanagement-Hilfsmittel. Schweres Gewicht? Dafür ist es noch zu früh.@OpenGradient
4
1
88
·
--
#opg $OPG Willst du etwa, dass 100 Validierungsknoten jedes Mal ein großes Modell komplett neu ausführen? Bist du noch ganz bei Trost?
Traditionelle Blockchains machen es genau so: Jeder Knoten führt jede Transaktion erneut aus. Bei Überweisungen ist das kein Problem, aber für KI ist das praktisch das Aus. Ein LLM mit 70B Parametern braucht für eine einzige Inferenz einen halben Tag GPU-Zeit. Wenn 100 Knoten das jeweils nachrechnen, ist das ein 100-facher Rechenaufwand – und am Ende kommen auch noch unterschiedliche Ergebnisse heraus. KI ist von Natur aus nicht deterministisch; drehst du die Temperatur etwas hoch, ist jede Ausgabe anders. Diese Logik funktioniert schlicht nicht.
OpenGradient geht direkt einen anderen Weg: Ausführung und Verifikation werden konsequent getrennt.
Im Netzwerk gibt es drei Rollen, die jeweils ihre eigene Aufgabe haben. Inferenzknoten führen ausschließlich das Modell aus und erzeugen danach einen Nachweis – entweder ein Hardware-Beleg aus der TEE, der bestätigt, dass die Code-Umgebung nicht manipuliert wurde; oder ein mathematischer Beweis aus ZKML, der belegt, dass das Modell tatsächlich genau dieses Ergebnis erzeugt hat. Dabei sieht niemand die Gewichte oder die Eingaben. Vollknoten prüfen nur, ob der Nachweis gültig ist – in Millisekunden. Ob die Berechnung darunter 50 Millisekunden oder 5 Sekunden gedauert hat, spielt keine Rolle. Datenknoten holen externe Daten in der TEE ab und schützen sie vor Abfangen und Manipulation.
OPG ist das Lebenselixier dieses Netzwerks. Die Gesamtmenge beträgt 1 Milliarde, unveränderlich. Nutzer bezahlen OPG, um Modelle auszuführen; Inferenz-$OPG -Knoten und Validierungsknoten verdienen OPG; Knoten müssen OPG staken, um teilnehmen zu können, und wer böswillig handelt, wird direkt bestraft und eingezogen; Entwickler stellen ihre Modelle im Model Hub bereit und erhalten OPG, wenn sie genutzt werden. In diesem Kreislauf verbraucht oder bindet jede Aktion OPG – genau das ist die harte Grundlage für die Preislogik.
Bis zum Mainnet-Start im April 2026 hat das Netzwerk über 4.400 Modelle verwahrt, mehr als 2 Millionen überprüfbare Inferenzläufe verarbeitet, über 500.000 kryptografische Nachweise erzeugt und über 260.000 unabhängige Wallets erreicht. a16z crypto und Coinbase Ventures investierten 9,5 Millionen US-Dollar. Am 15. Juni wurde es gerade auf Upbit gelistet.
Diese Architektur verwandelt KI von einer Blackbox nach dem Motto „Glaub’s oder lass es“ in transparentes Rechnen, bei dem sich jederzeit Buch führen lässt. Jede Inferenz ist prüfbar; man muss keiner einzelnen Betreibereinheit vertrauen. Die Verifizierungsschicht kommt nicht an deine Rohdaten, wodurch Privatsphäre und Vertrauenswürdigkeit gleichzeitig gewährleistet sind.
Schau dir ihre Testnet-Daten ruhig selbst an, und hör nicht nur auf das, was andere erzählen.
@OpenGradient
71
·
--
#opg $OPG
Letzte Woche habe ich mit Claude in Archivakten der mittelalterlichen religiösen Inquisition nachgeforscht. Es spuckte nur den Spruch aus: „Thema wechseln.“ Ich habe nichts Illegales gemacht, wollte nur etwas ausgefallenere Geschichte recherchieren – aber auch das ginge nicht.
Später habe ich mit Gemini gefragt, woher gesellschaftliche Sitten und Gebräuche stammen, und bekam direkt eine Werteinheitsunterweisung. Alle großen Firmen-AIs klingen wie aus dem Außenministerium: wasserdicht, lückenlos – aber du kannst auch nichts mit Kanten herausquetschen.
Dann kam jemand auf OpenGradient Chat. Claude Fable 5 – die erste Tranche war sofort offline/gesperrt. Ich habe die abgelehnten Fragen rübergeworfen – alles ging durch. Die Antworten waren sehr direkt, ohne dieses „aus Sicherheitsgründen“-Gequatsche.
Was mich aber wirklich anders anfühlt, ist der Private-Chat-Modus. Wechselst du dort hin, kannst du ein Modell namens „Nous Hermes“ einstellen. Es wirkt, als wäre es grundsätzlich ohne Moral-Filter gebaut. Ich habe meine ganze zurückgehaltene Tirade reingeschüttet, inklusive dunkler Vermutungen – es nahm alles an, und ging sogar mit Rückfragen nach: „Was glaubst du, was die eigentliche Motivation dahinter ist?“ Selbst bei Ansichten, die dem Mainstream widersprechen, springt kein Warnkasten auf. Es redet einfach leise zu Ende, wie ein Freund, der die Klappe besonders fest hält und dich nachts beim Rauchen begleitet.
Bei Datenschutz machen sie End-to-End-Verschlüsselung, keine Speicherung der Aufzeichnungen – sonst würde doch niemand wirklich sensible Themen ansprechen.
Und dann habe ich mir deren Token OPG angesehen. Die tiefgehenden Q&A-Abfragen mit Nous Hermes verbrauchen nur extrem wenig Gas – und bezahlt werden kann nur mit OPG. Sobald jemand „hinter verschlossenen Türen die Wahrheit sagen“ will, muss er OPG besitzen. Das ist ein harter Verbrauch, kein „ich nehme mal an“. Danach wird es noch verrückter: Selbst strengere Modelle brauchen das Hinterlegen von OPG für eine White-List. Die Preislogik dahinter – im Kern ist es die Marktbepreisung einer „Steuer auf freie Meinungsäußerung“.
So eine absolute Freiheits-KI ist im regulierten Umfeld wie Blut an der Messerspitze – ich weiß nicht, wie lange das durchhält. Aber ich habe die OPG-Alarmfunktion schon gesetzt und bin beim Launch des neuen Modells als Erstes los, um die Staking-Plätze zu ergattern.
Manche Dinge kannst du nur vor einer Maschine sagen, weil die Maschine nicht mit dem Moralhammer auf dich einschlägt.
Sie sind noch in der Testphase, in Teilen der Regionen muss man wohl übers Netz hinweg/mit VPN arbeiten. Ich bin sowieso nicht namentlich registriert – also sag ich eben, was ich sagen will. Wenn du was hast wie „keine Ahnung, mit wem ich rede“: Mach’s im Dunkeln und probier’s aus. Niemand weiß, was du abgefragt hast. @OpenGradient
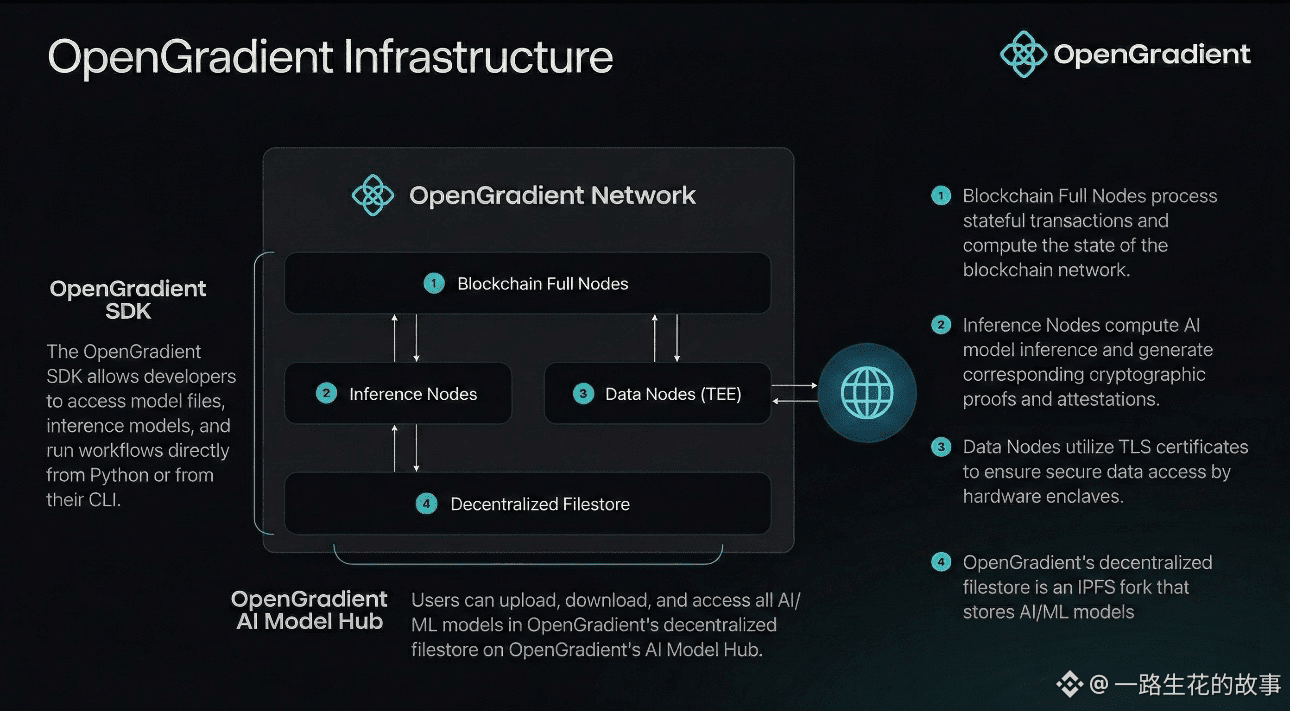
1
110
·
--
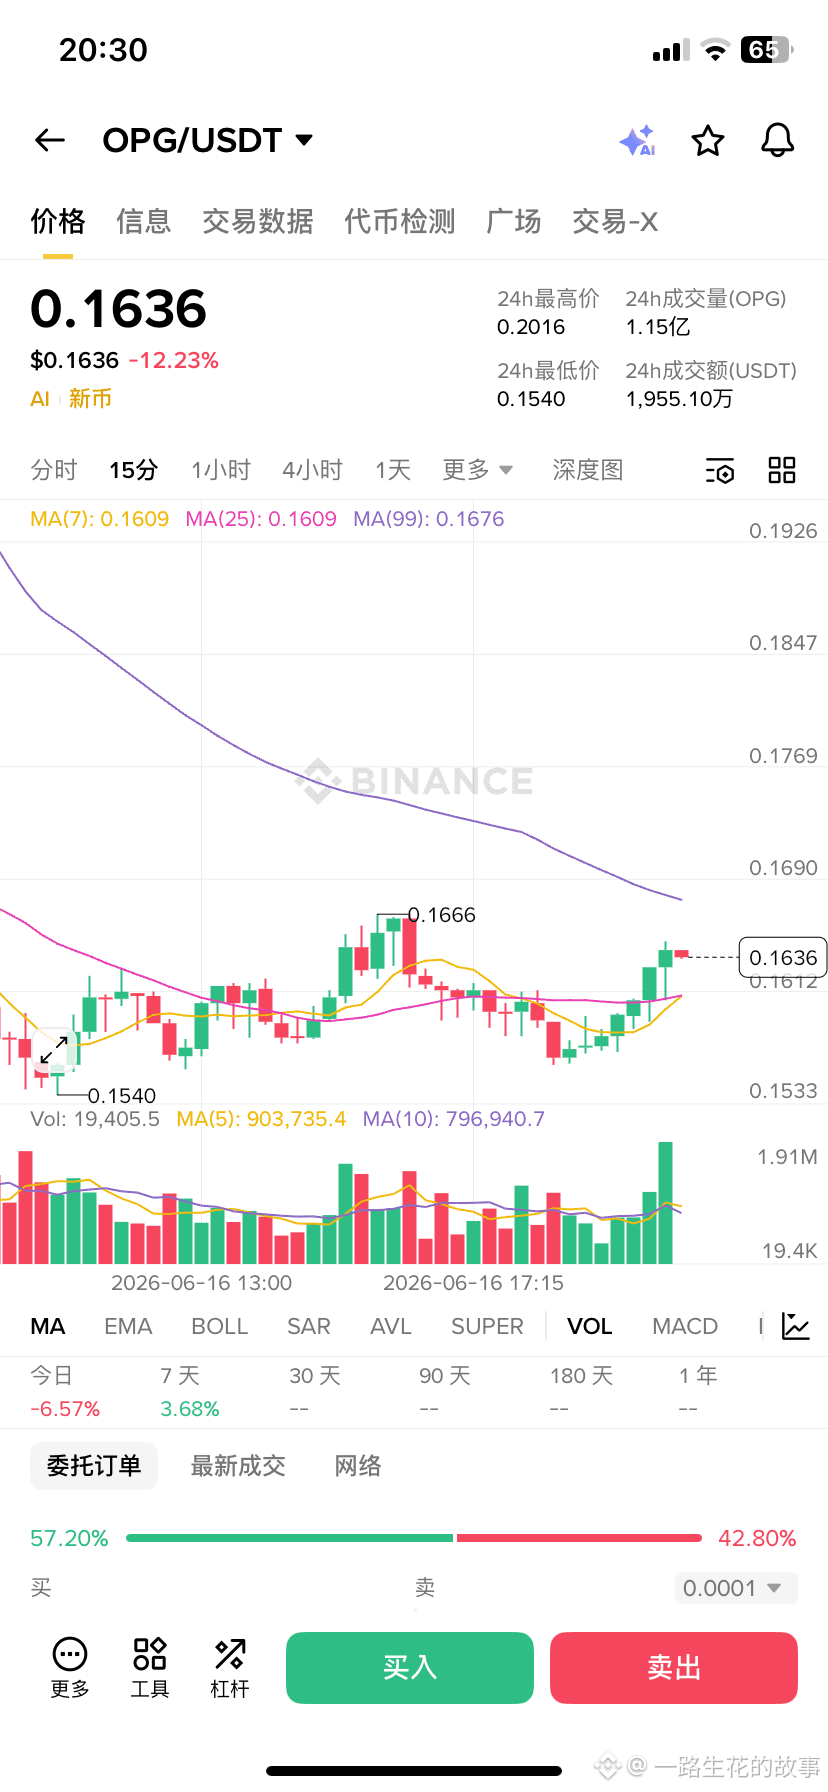
#opg $OPG hat einen ganzen Tag lang den Chart beobachtet. OPG ist vom Hoch bei 0,67 auf jetzt ungefähr 0,16 gefallen – ein Rückgang von mehr als 70%. Manche geraten in Panik, aber ich finde, in so einer Phase sollte man eher ruhig bleiben und sich das genauer anschauen: Gefallen ist der Preis, nicht die technischen/grundlegenden Fundamentaldaten.
Ein paar Punkte, die ich dazu beobachtet habe.
Erstens: Diese Abwärtsbewegung hat eine strukturelle Erklärung.
Die Gesamtmenge der OPG-Token beträgt 1 Milliarde. Im Umlauf sind derzeit nur 190 Millionen – also 19%. Die restlichen 81% sind entweder gesperrt oder unterliegen einer linearen Freigabe. Von den 400 Millionen für das Ökosystem werden 60 Monate lang freigegeben; die 150 Millionen für Kern-Contributoren und die 100 Millionen für Investoren werden jeweils zunächst 12 Monate gesperrt und danach über 36 Monate freigegeben. Was bedeutet das? Kurzfristiger Verkaufsdruck ist demnach tatsächlich besser kontrollierbar, als viele glauben. Der starke Rückgang am 15. Juni wirkt eher wie eine Volatilität, die durch den kurzfristigen Liquiditäts-Peak nach dem Listing bei Binance und Upbit ausgelöst wurde – kein massiver Unlock-/Selloff.
Zweitens: Netzwerknachfrage steigt, der Preis zieht nicht nach.
Stand Mitte Juni hat das OpenGradient-Netzwerk bereits über 2 Millionen verifizierte AI-Inferenzen verarbeitet, über 4400 KI-Modelle bereitgestellt und es gibt über 260.000 Adressen von unabhängigen Wallets. Diese Kennzahlen sind im DePIN-Sektor nicht schlecht. Wenn Preis und Fundamentaldaten auseinanderlaufen, ist das für Trader auf Sicht zwar ein Risiko, für langfristig orientierte Beobachter könnte es dagegen ein günstiges Zeitfenster sein.
Drittens: Das x402-Protokoll-Upgrade wurde übersehen.
Kürzlich hat OpenGradient das x402-Protokoll-Upgrade abgeschlossen – mit einem geschlossenen Kreislauf aus Zahlung und Verifizierung innerhalb von TEE. Ganz einfach gesagt: Zahlung und Verifizierung benötigen keinen Dritten mehr. Damit sinken die Vertrauens-/Kosten für den On-Chain-AI-Inferenzprozess wieder um eine Stufe. Die technischen Details lasse ich weg, aber der Einfluss dieses Upgrades auf die kommerzielle Umsetzung könnte vom Markt unterschätzt worden sein.
Meine Einschätzung: OPG befindet sich aktuell in einer Phase des Wechsels von Story-getrieben zu funktionalem Nachweis. Die reine „Kauf-Story“-Phase ist vorbei; als Nächstes wird entscheidend sein, ob die Abrufe für Inferenz kontinuierlich wachsen und ob die Staking-Rate sich verbessert. Die On-Chain-Daten nach dem Ende der Binance Plaza-Aktion am 30. Juni werden aussagekräftiger sein als das, was die K-Linien heute zeigen.
👇Findest du, dass das eine krasse Fehlbewertung ist (Overreaction) oder eine Rückkehr zum fairen Wert? Schreib’s in die Kommentare. @OpenGradient
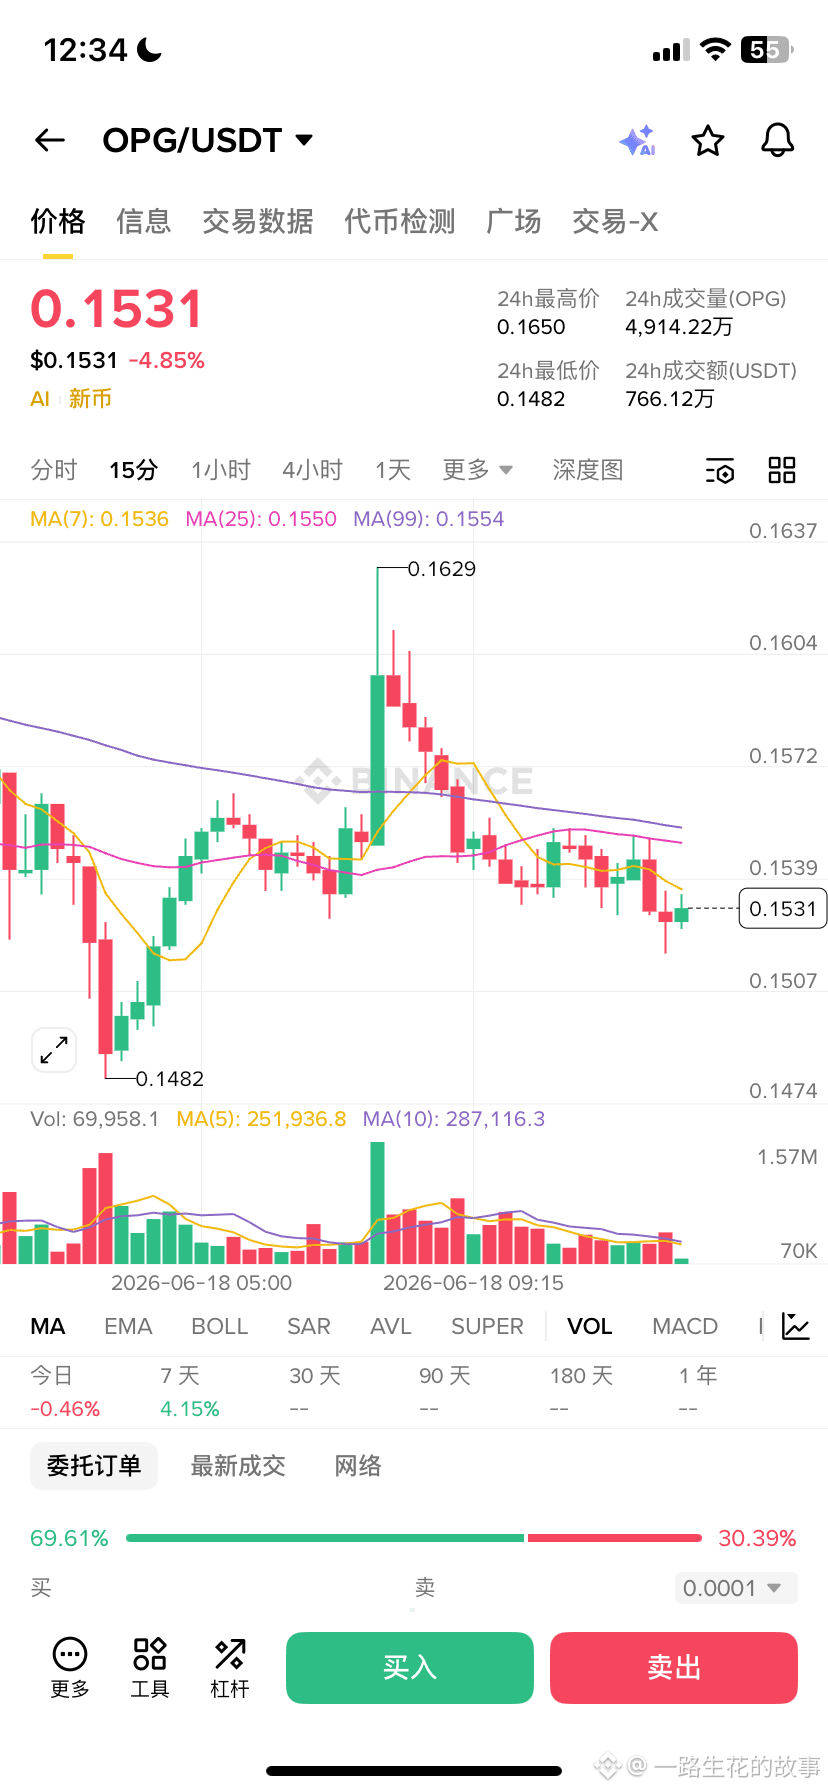
111
·
--
#opg $OPG Die HACA-Architektur von OPG hat die „Vertrauenskosten“ der KI-Inferenz gesenkt.
Warum sollte man ausgerechnet OPG aus all den DePIN-Projekten im KI-Bereich gesondert hervorheben? Ich habe mir das Whitepaper genau angesehen und ein zentrales Design entdeckt – die HACA-Hybrid-Compute-Architektur.
Einfach gesagt wird KI-Inferenz und Verifizierung in zwei Aufgaben aufgeteilt. Die Inferenz-Knoten kümmern sich nur ums Rechnen, während die Vollknoten speziell dafür da sind zu prüfen, ob das Ergebnis korrekt ist. Die Logik klingt simpel, löst aber das größte Problem der KI-Branche: Woher weißt du, dass das Modell, das du aufrufst, dich nicht täuscht?
Die heutige zentralisierte KI ist im Grunde eine Blackbox: Du stellst eine Frage und bekommst ein Ergebnis, der gesamte Zwischenschritt bleibt unsichtbar. OPG geht so vor, dass Verifizierungsknoten den Inferenzpfad auf leichte Weise nachprüfen – praktisch bekommt jede Berechnung einen „Beleg“. Technisch wird für die Standardverifizierung TEE genutzt; in besonders wertvollen Szenarien kann auf ZK-Beweise umgeschaltet werden – beide Modi lassen sich je nach Bedarf wechseln, bei kontrollierbaren Kosten.
Meine Einschätzung: Der kommerzielle Wert dieser Architektur wird unterschätzt.
Warum? Weil es im DePIN-Sektor zwar nicht an Rechenleistungsprojekten mangelt, aber an „verifizierbarer Rechenleistung“. Traditionelle Unternehmen trauen sich nicht, ihr Kerngeschäft einer dezentralen KI anzuvertrauen; das größte Hindernis ist die Unsicherheit – wer haftet, wenn etwas falsch berechnet wird? OPG macht den Verifizierungsmechanismus zum Standard auf der Basisebene und gibt Entwicklern damit im juristischen Sinne eine „Prüfspur“.
Natürlich befindet sich das Projekt noch in einer frühen Phase. Ob die tatsächliche Verifizierungseffizienz von HACA eine groß angelegte kommerzielle Nutzung tragen kann, muss sich nach dem Ende des Events am 30. Juni anhand der On-Chain-Daten zeigen. Aber schon allein aus Sicht des Architektur-Designs hat OPG den entscheidenden Engpass bei der Kommerzialisierung von KI richtig erkannt.
Meine persönliche Meinung: Das Projekt hat ein starkes technisches Fundament, aber beim Community-Hype fehlt aktuell noch der letzte Schub – mal sehen, ob die Binance-Square-Aktion diesen Schwung bringen kann.
👇 Findest du verifizierbare KI-Inferenz wirklich notwendig oder eher ein Scheinproblem? Schreib’s in die Kommentare.@OpenGradient
76
·
--
#opg $OPG Die meisten AI+Blockchain-Projekte werfen nur die Modellergebnisse auf die Chain, aber niemand kann die Ergebnisse validieren. Das Whitepaper von OpenGradient beleuchtet den Kernkonflikt – traditionelle Blockchains verlassen sich auf „jede Node führt die Transaktionen erneut aus“, um Konsens zu erreichen. Logisch gibt es bei der Bearbeitung von Überweisungen keine Probleme, aber bei der KI-Inferenz funktioniert das überhaupt nicht.
Warum? Um LLMs auszuführen, werden GPUs benötigt. Wenn 100 Validierungsnodes alle einmal laufen, sind das 100-fache Kosten; die Ausgabe eines LLM hat Zufälligkeiten, die Validierungsnodes können die Antworten nicht einfach vergleichen; eine Inferenz dauert einige Sekunden, bis alle Nodes durch sind, ist die Chain längst blockiert. KI als Orakel zu verwenden – die Ergebnisse außerhalb der Chain zu laufen und dann auf die Chain zu speisen – bleibt das „umgekehrte Orakel-Problem“: Am Ende musst du dem einzigen Datenlieferanten vertrauen.
Die Lösung von OpenGradient: Ausführung und Verifizierung sind getrennt. Die Inferenznodes verarbeiten Anfragen in TEE und generieren Hardwarebeweise – sie beweisen, dass der Code nicht verändert wurde, die Eingaben nicht manipuliert wurden und die Ausgaben nicht verfälscht sind. Vollnodes verifizieren nur die Beweise (reine kryptographische Operationen) und müssen nichts über die Eingabeaufforderungen, Modelle oder Rückgabewerte wissen. ZKML funktioniert ähnlich, nur dass es sich um Zero-Knowledge-Beweise handelt. Die Verifizierungsschicht führt niemals AI-Berechnungen erneut aus; die Verifizierung eines Beweises dauert nur wenige Millisekunden.
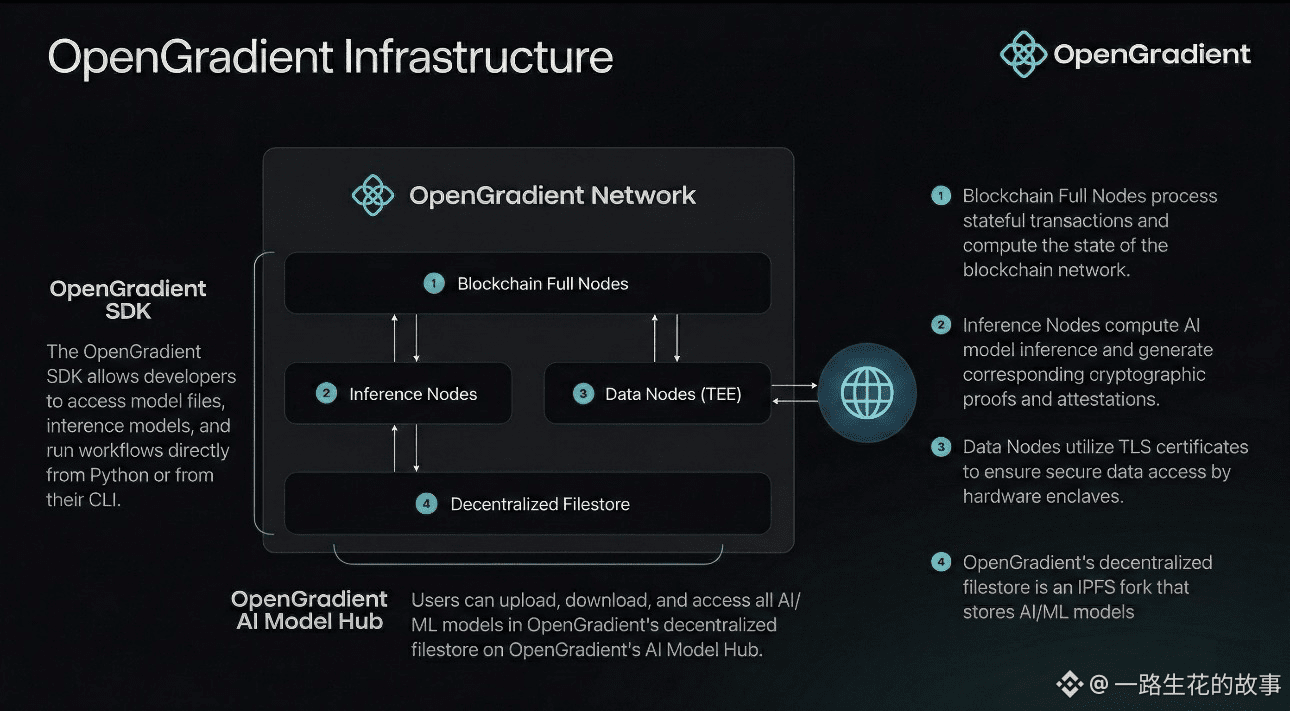
Das Netzwerk besteht aus vier Arten von Nodes: Inferenznodes (GPU-Ausführung), Vollnodes (Verifizierung von Beweisen + CometBFT-Konsens), Daten-Nodes (TEE zur Beschaffung externer Daten) und Speicherebene. EVM-kompatibel, Entwickler können Hardhat, Foundry direkt verwenden.
Die Gesamtversorgung von OPG beträgt 1 Milliarde Token, Verteilung: Ökosystem 40%, Stiftung 15%, Kernbeitragende 15%, Investoren 10%, Staking-Belohnungen 10%, Liquidität 6%, Airdrop 4%. Diese werden verwendet, um Inferenzgebühren zu zahlen, Nodes zu staken, Modelle zu incentivieren und Governance.
Risiken: TEE hängt von Hardwareanbietern ab; wenn es Schwachstellen gibt, sinkt die Vertrauenswürdigkeit der Beweise; die Kosten für die Generierung von ZKML-Beweisen sind für Szenarien mit niedriger Latenz immer noch nicht freundlich; die langfristige Freigabe von 1 Milliarde Token könnte Verkaufsdruck erzeugen.
Persönliche Meinung: OpenGradient rekonstruiert die Verifizierungsschicht basierend auf den tatsächlichen Bedürfnissen der KI, die Logik ist konsistent. Aber die tatsächliche Leistung muss durch Mainnet-Daten validiert werden; die Richtung ist wert, verfolgt zu werden.
Kann TEE+ZKML das KI-Schwarzbox-Problem lösen? Lass uns im Kommentarbereich diskutieren. @OpenGradient
1
1
98
·
--
#opg $OPG Ich habe da was, das ich nie ganz verstanden habe. Wenn eine AI-Anfrage reinkommt und zig Knoten sie sehen, wer greift sie auf?
Wenn der Schnellste die Anfrage aufnimmt, haben die mit schneller Internetverbindung immer die Chance, während die langsamen Knoten leer ausgehen. Am Ende bleiben nur zwei oder drei große Spieler übrig, während alle anderen verhungern. Wo bleibt da die Dezentralisierung?
OpenGradient hat in ihrem Whitepaper eine Lösung angeboten: Lotterie.
Es ist keine willkürliche Lotterie. Das System nimmt den Hash des aktuellen Blocks zusammen mit der ID dieser Anfrage und wirft beides in ein Ding namens VRF, um eine Zufallszahl zu berechnen. Dann wird diese Zufallszahl verwendet, um alle online Knoten zu sortieren. Der Knoten, der zuerst kommt, bekommt die Anfrage. Er muss innerhalb einer festgelegten Zeit das Ergebnis und den Nachweis einreichen. Wenn er die Zeit überschreitet oder betrügt, wird die Anfrage an den Zweitplatzierten weitergegeben, und so weiter.
Das Entscheidende ist, dass diese Zufallszahl verifizierbar ist. Knoten können nicht betrügen, weil die Sortierlogik öffentlich ist und jeder die Berechnung erneut durchführen kann. Im Whitepaper steht, dass Zero-Knowledge-Proofs verwendet werden, um sicherzustellen, dass die Zufallszahl tatsächlich nach den Regeln erzeugt wurde. Wenn du wissen willst, wer die nächste Anfrage erhält, hast du keine Chance.
Ich habe zuvor ein anderes Projekt gesehen, das auch VRF verwendet hat, aber die Sortierung wurde trotzdem überrannt. Später stellte sich heraus, dass der Zufallsseed von den Knoten im Voraus erraten wurde. Bei OpenGradient wird der Seed fest an den Block-Hash gebunden, was bedeutet, dass der Block-Hash nicht vorhergesagt werden kann und so dieses Loch gestopft wird.
Aber dieses Design hat einen nervigen Nachteil. Wenn ein Knoten absichtlich die Zeit überschreitet, wird er nicht sofort bestraft, sondern vorübergehend aus der Warteschlange entfernt. Erst nach mehreren aufeinanderfolgenden Zeitüberschreitungen wird eine Strafe ausgelöst. Im Whitepaper wird dies als "weiche Strafe" bezeichnet. Ich kann das nachvollziehen, jeder hat mal Netzwerkprobleme, eine sofortige Geldstrafe bei einer Zeitüberschreitung wäre wirklich zu hart. Aber das gibt auch Raum für Betrug – jemand kann absichtlich wiederholt die Zeit überschreiten und die gesamte Effizienz verlangsamen. Du kannst ihm nichts entgegen setzen, weil er die Strafgrenze noch nicht erreicht hat.
Im Whitepaper steht nicht, wie viele Zeitüberschreitungen und wie hoch die Strafgrenze ist; wahrscheinlich wird das nach dem Start des Mainnets basierend auf den tatsächlichen Gegebenheiten angepasst.
Wie auch immer, ich denke, dieser Lotteriemechanismus ist in die richtige Richtung, aber er schützt vor ehrlichen Problemen und nicht vor bösen Absichten. Wenn jemand absichtlich Bugs ausnutzt, muss die Community möglicherweise eingreifen.
Wie siehst du das? Hältst du diese Sortiermethode für fair? Ich freue mich auf dein Feedback. @OpenGradient
119
·
--
#bedrock $BR Der Marktfluss spiegelt direkt die Iteration des BTCFi-Ökosystems wider. Dank Punkte-Airdrops und der alten Staking-Modelle mit langfristigen Chips ist der Hype drastisch gesunken. Nach mehreren Marktzyklen legen die Investoren zunehmend Wert auf handfeste, grundsolide Erträge und strömen in Cross-Chain-Arbitrageprodukte. Die BTC-Assets liegen brach, und die Liquidität der verschiedenen Ökosysteme ist stark fragmentiert. Bedrock 2.0 erobert dank des neuen PoSL-Rahmenwerks schnell die Marktaufmerksamkeit.
Der PoSL-Rahmen springt über die Grenzen traditioneller Asset-Mapping-Modelle und zielt darauf ab, einen Liquiditätsknotenpunkt zu schaffen, der das BTC-Hauptnetz, das Ethereum-Ökosystem und den DePIN-Computing-Markt verbindet. Durch die Nutzung von uniBTC als Cross-Chain-Router werden ruhende BTC in Cold Wallets in handelbare Computing-Rechte umgewandelt. Wenn du $BR hältst, kannst du problemlos in die vielfältigen Vaults der Plattform einsteigen und durch die Zinsunterschiede zwischen den Protokollen gestaffelte Erträge erzielen. Das Produktdesign weist im Vergleich zu ähnlichen Staking-Projekten klare Differenzierungsmerkmale auf.
Hinter den auffälligen Erträgen verbirgt sich das Problem unvereinbarer Multi-Chain-Konsens, das Sicherheitsrisiken birgt. BTC nutzt PoW-Mining, was lange Blockzeiten und das Risiko von Block-Rollbacks mit sich bringt, während Second-Layer- und DePIN-Blockchains durch schnelle Konsensverfahren sofortige Rechtevergabe erreichen. Wenn uniBTC in einem Hochgeschwindigkeitsnetz die Erträge auszahlt und die BTC-Transaktionen auf der Basisebene plötzlich zurückgerollt werden, ist es schwierig, bereits gezahlte Erträge zurückzuholen, was langfristig zu faulen Krediten führt. Kriminelle könnten auch Zeitdifferenzen bei Bestätigungen ausnutzen, um Double-Spend-Angriffe durchzuführen und die Sicherheitsreserven des Projekts erheblich zu schädigen.
Institutionelle Investoren in der Branche verfolgen weiterhin diese technischen Schwachstellen und werden nicht blindlings hohe APYs verfolgen. Die Idee, inaktive BTC in Bewegung zu bringen, passt zum allgemeinen Trend in der Branche, aber die asynchronen Determinierungsprobleme haben derzeit noch keine ausgereifte Lösung gefunden. Die gesamte Ökosystem-Cross-Chain-Strategie befindet sich noch in einer risikobehafteten Testphase. Normale Nutzer sollten die positiven Projektankündigungen rational betrachten und von übermäßigen Investitionen absehen; stattdessen sollte man leicht positioniert bleiben und beobachten. @Bedrock
#Bedrock #btcfire
69
·
--
#bedrock $BR In letzter Zeit beschweren sich in vielen Foren immer mehr Leute: Das Airdrop-Farmen wird immer härter umkämpft, und die Airdrops selbst werden immer schwächer. Die echten langfristigen Chancen liegen eigentlich in Projekten, bei denen der Token wirklich einen Nutzen hat.
Heute sprechen wir über ein Beispiel, das die Bitcoin-Renditelandschaft verändert: Bedrock 2.0 und seinen $BR -Token.
---
In Bedrock 2.0 ist $BR nicht mehr nur ein gewöhnlicher Belohnungstoken, sondern der „Eintritts-Treibstoff“ des gesamten Bitcoin-Rendite-Engines. Du willst in erstklassige BTCfi-Strategien einsteigen? Dann musst du zuerst $BR halten.
Das Stufensystem (Tiers) steht kurz vor dem Start: Je mehr du sperrst, desto höher dein Level, und desto größer der Renditemultiplikator, den du genießen kannst. Noch wichtiger: Institutionelle Tresore wie Alpha-Selini haben begrenzte Kapazität, und BR-Inhaber mit hohem Level erhalten zuerst Zugriff. Ohne $BR kommst du vielleicht nicht einmal ins Auto.
Das ist die Quelle des FOMO: Wenn immer mehr Kapital in den uniBTC-Tresor strömt, wird der Marktschock auf die BR-Nachfrage die Umlaufmenge rasch aufsaugen.
Außerdem schaltet BR die erweiterten Datenmodellierungsfunktionen des KI-Copiloten BRclaw frei. Dieser On-Chain-Analyst kann dir helfen, die Risiken und Erträge komplexer Strategien zu zerlegen, damit du wie eine Institution entscheidest.@Bedrock
---
BR zu halten bedeutet nicht nur, einen Token zu horten, sondern einen VIP-Schlüssel zu institutionellen Bitcoin-Renditen zu besitzen.
216
·
--
#bedrock $BR 玩BTCFi seit einem halben Jahr. Früher bin ich dem Trend gefolgt und habe mich bei High-APY-Ladder-Projekten eingekauft. Am Ende wurde die Subvention gekürzt und die Rendite brach direkt zusammen. Mit der Zeit wurde mir klar, dass der Trick, Renditen nur durch das Ausgeben von Tokens aufzublähen, auf diesem Sektor nicht weit führt.
Die meisten Freunde um mich herum achten nur darauf, wie uniBTC Stück für Stück auf einzelnen Chains ausgerollt wird, und gehen die Kernänderungen von Bedrock2.0 kaum wirklich tief durch. Vor dem Redesign konnte ich meine BTC nur in Babylon-Staking binden. Die Erträge kamen ausschließlich aus der Grundverzinsung plus unregelmäßigen Airdrops, und die Obergrenze der Rendite lag vollständig in der Hand des Projekts.
Nach dem Upgrade sind die Veränderungen deutlich sichtbar: Wenn man die Coins ins Protokoll legt, muss man die Position nicht mehr manuell verschieben. Das zugrunde liegende Programm beobachtet den Markt rund um die Uhr, und wo es Cross-Chain-Preisunterschiede oder Arbitragemöglichkeiten mit neutralem Hedging gibt, wird Kapital automatisch dorthin umgeleitet, um Erträge aus echter Marktliquidität zu erzielen, statt die Profite durch das zusätzliche Ausgeben von Projekt-Token zu subventionieren.
$BR ist auch nicht mehr nur ein einfacher Staking-Nachweis, sondern zu einem Schlüsselfaktor für die Kapitalallokation des Protokolls geworden. Ganz ehrlich: Mehrstrategische Vertragsarchitekturen mit mehreren Schichten bringen unvermeidlich Vertragsrisiken mit sich, die sich nicht vollständig vermeiden lassen. Aber verglichen mit dem Chaos in der Branche, wo Jahresrenditen oft künstlich aufgeblasen werden, ist diese Änderung, die auf echter Arbitrage basiert, für normale Tokenhalter viel freundlicher.
#bedrock $BR @Bedrock
181
·
--
#bedrock $BR
In letzter Zeit pendelt der große Krypto-Markt seitwärts, und viele werden unruhig: Wer bei einem Pump auf hohes APY jagt, fürchtet sich vor einem Rug Pull; wer einfach abwartet, hat Angst, die Gelegenheit zu verpassen. Eigentlich ist etwas wichtiger als Kursanstiege oder -rückgänge: eine Ertragsmethode zu finden, die nicht von der Richtung abhängt.
Heute sprechen wir über Bedrock 2.0 — eine intelligente Ertragsmaschine, mit der auch normale Nutzer Strategien auf institutionellem Niveau nutzen können.
---
Bedrock hat sich von einem einzelnen Ertragspool zu einer dynamischen Routing-Schicht uniBTC weiterentwickelt, die Kapital automatisch an den Markt anpassen kann. Das neueste modulare Vault-Framework bringt vier Strategien mit: Delta-neutrales Arbitrage, reine Liquiditätsallokation, Kreditvergabe und RWA. Dabei wird der Alpha-Selini-Vault von Selini Capital verwaltet und nutzt marktneutrales High-Frequency-Trading.
Noch wichtiger ist der KI-On-Chain-Analyst BRclaw, der dir hilft, die Risiken und Erträge verschiedener Vaults zu entschlüsseln — wie ein Co-Pilot, der dich bei der Bedienung begleitet. BRclaw befindet sich derzeit in der Testphase, der Zugang wird bald erweitert.
$BR ist nicht mehr nur ein Belohnungstoken, sondern der Zugangsschlüssel zur Ertragsmaschine. Je höher dein Bestand, desto mehr Profit-Multiplikator erhältst du, desto höher ist deine Priorität beim Zugriff auf die knapp verfügbaren institutionellen Vaults, und du kannst außerdem die Deep-Daten-Funktionen von BRclaw freischalten.
---
👉 Halte @Bedrock bereit, zusammen mit $BR und uniBTC, um das Starten der modularen Vaults zu begrüßen.
#Bedrock $BR
{future}(BRUSDT)
#bedrock $BR
In letzter Zeit pendelt der große Krypto-Markt seitwärts, und viele werden unruhig: Wer bei einem Pump auf hohes APY jagt, fürchtet sich vor einem Rug Pull; wer einfach abwartet, hat Angst, die Gelegenheit zu verpassen. Eigentlich ist etwas wichtiger als Kursanstiege oder -rückgänge: eine Ertragsmethode zu finden, die nicht von der Richtung abhängt.
Heute sprechen wir über Bedrock 2.0 — eine intelligente Ertragsmaschine, mit der auch normale Nutzer Strategien auf institutionellem Niveau nutzen können.
---
Bedrock hat sich von einem einzelnen Ertragspool zu einer dynamischen Routing-Schicht uniBTC weiterentwickelt, die Kapital automatisch an den Markt anpassen kann. Das neueste modulare Vault-Framework bringt vier Strategien mit: Delta-neutrales Arbitrage, reine Liquiditätsallokation, Kreditvergabe und RWA. Dabei wird der Alpha-Selini-Vault von Selini Capital verwaltet und nutzt marktneutrales High-Frequency-Trading.
Noch wichtiger ist der KI-On-Chain-Analyst BRclaw, der dir hilft, die Risiken und Erträge verschiedener Vaults zu entschlüsseln — wie ein Co-Pilot, der dich bei der Bedienung begleitet. BRclaw befindet sich derzeit in der Testphase, der Zugang wird bald erweitert.
$BR ist nicht mehr nur ein Belohnungstoken, sondern der Zugangsschlüssel zur Ertragsmaschine. Je höher dein Bestand, desto mehr Profit-Multiplikator erhältst du, desto höher ist deine Priorität beim Zugriff auf die knapp verfügbaren institutionellen Vaults, und du kannst außerdem die Deep-Daten-Funktionen von BRclaw freischalten.
---
👉 Halte @Bedrock bereit, zusammen mit $BR und uniBTC, um das Starten der modularen Vaults zu begrüßen.
#Bedrock $BR
216
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
Nikkei225Jumps2.5%ToThreeMonthHigh
15,705 Aufrufe
336 Kommentare
#Nikkei225Jumps2.5%ToThreeMonthHigh
🚀 Nikkei 225 steigt um 2,45 % auf den höchsten Stand seit 3 Monaten!
Japans Leitindex Nikkei 225 legte am Montag kräftig zu und schloss bei 69,946.86, nachdem er kurzzeitig erstmals seit drei Monaten die Marke von 70,000 überschritten hatte.
💡 Was treibt den Anstieg an?
KI- und Halbleiterboom: Große Technologieführer wie Advantest und Tokyo Electron gaben mit deutlichen Kursgewinnen den Ton an.
Aufwind von der Wall Street: Positive Impulse von den US-Märkten stärkten das Vertrauen der Anleger insgesamt.
Makroökonomische Veränderungen: Niedriger als erwartet ausgefallene US-Arbeitsmarktdaten milderten die Sorgen und senkten die Erwartungen an eine aggressive Zinserhöhung der Fed im Oktober.
📊 Fazit für den Markt:
Diese kräftige Rally signalisiert ein starkes Wiederaufleben des Anlegerinteresses an Technologie- und KI-bezogenen Anlagen. Händler sollten jedoch die erhöhten Anleiherenditen als anhaltenden Risikofaktor genau im Blick behalten.
Glaubt ihr, dass der Nikkei sich erfolgreich über 70,000 halten und neue Höchststände erreichen kann? Teilt uns eure Meinung mit!
#JapanStocks #StockMarket" #AIStocks #Semiconductors #Investing #Nikkei225
$EWJ
Nurul Hasnat Samir
·0 Likes
·343 Aufrufe
DriftHackVictimsBeginClaims
93,671 Aufrufe
1,018 Kommentare
SolanaTokenizedStockVolumeTops$4.4BInSeptember
8,834 Aufrufe
98 Kommentare