#opg $OPG Meine Frau fragte mich gestern Abend: "Worüber grinst du da auf dein Handy? Chattest du schon wieder sinnlos auf Twitter herum?" Ich traute mich nicht zu antworten, denn auf dem Bildschirm lagen gerade zehn Nachrichten an einen Fremden, die ich eben erst verschickt hatte. Sie verbietet mir nicht zu chatten, sie hat nur Angst, dass die Plattform mithört, mitliest und eines Tages unsere Chatverläufe dem Werbealgorithmus vorwirft. Um ehrlich zu sein: Nach all den Jahren, in denen ich daran gewöhnt bin, von Daten bis auf die Haut ausgezogen zu werden, bin ich schon völlig abgestumpft. Aber nachdem ich OpenGradient Chat ausprobiert hatte, hatte ich zum ersten Mal das Gefühl: Im KI-Zeitalter kann man tatsächlich verhindern, nackt herumzulaufen.
Der Datenschutzmechanismus dieses Chats hat „Privatsphäre“ wirklich in seine DNA eingebaut. Drei Ebenen der Trennung: Du tippst im Browser, der Schlüssel bleibt lokal, und sobald die Nachricht das Gerät verlässt, ist sie nur noch verschlüsselt; das dazwischenliegende Oblivious-HTTP-Relay sieht zwar deine IP, weiß aber nicht, was du gesendet hast; am Downstream-Gateway lässt sich der Inhalt entschlüsseln, aber deine IP ist dort nicht bekannt. Am Ende läuft alles in einer TEE mit Remote Attestation, und selbst wenn das Projektteam heimlich mitlesen wollte, es hat keine Chance. Identität und Inhalt sind vollständig voneinander getrennt.
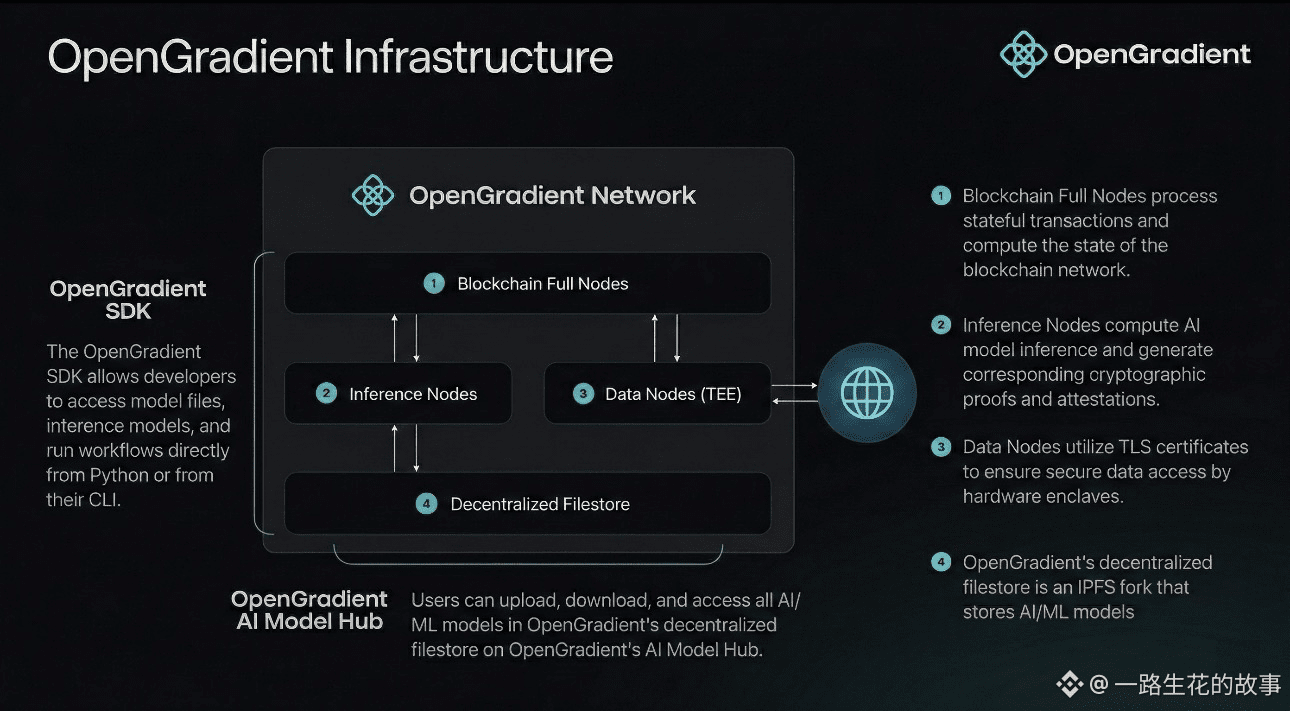
Aber Privatsphäre ist nur das Eintrittsticket. Der eigentliche Knackpunkt der Branche ist: Was, wenn die Privatsphäre klappt, die Rechenleistung aber einbricht? Früher war KI auf der Blockchain so teuer, dass schon einmal Verifizieren mehr kostete als das Modell einfach neu auszuführen. Traditionelle Blockchains erreichen Konsens, indem sie „neu rechnen“: 100 Verifizierer sollen jeweils ein 70B-Modell einmal durchlaufen? Das verbrennt Rechenleistung in einem erschreckenden Ausmaß, und die Latenz ist direkt ein Dealbreaker. Deshalb hat OpenGradient die HACA-Architektur entwickelt — Ausführung und Verifikation getrennt. Die Inferenzknoten führen nur das Modell aus; die Full Nodes verifizieren lediglich die Nachweise von TEE oder ZKML. Die Verifizierungsknoten müssen nicht einmal wissen, wie dein Prompt lautet, sie prüfen nur, ob der Beweis gültig ist. Die Effizienz ist damit voll ausgeschöpft, die Verifikation dauert nur Millisekunden, egal ob die zugrunde liegende Inferenz 50 ms oder 5 Sekunden braucht.
"Der nützlichste Ort für KI ist genau der Ort, an dem Nutzer am wenigsten bereit sind zu tippen." Dieser Satz des CEOs hat mich wirklich mitten ins Herz getroffen. Früher war es nachts wie ein Dieb, über Märkte zu reden, weil die Daten nackt im Netz lagen. Jetzt kann ich das hier nutzen, und selbst wenn mich eine Kamera beim Tippen erwischt, sieht der Mittelsmann nur eine Zeichenfolge aus Kauderwelsch. Wenn meine Frau mich das nächste Mal zur Rede stellt, kann ich ihr einfach das Handy in die Hand drücken — „Schau ruhig, du verstehst die Verschlüsselung sowieso nicht.“
Das Projekt kam aus dem a16z-Accelerator und hat jetzt GPT, Claude und Gemini integriert. Ein echtes Produkt, ein echtes Grundbedürfnis gelöst — das ist das wahre Asset. Auf kurzfristige Schwankungen schaue ich gar nicht; ich halte es einfach und sehe in einem Jahr, wie es ausgeht. @OpenGradient