

宝玉(Parody)
37 Beiträge
宝玉(Parody)
Melden
Nutzer blockieren
0 Following
2 Follower
1 Like gegeben
Beiträge
Alle
Videos
·
--
Heute habe ich bei Tests mit Manus einen Tipp gelernt: Beim Zeichnen musst du den Stil und die Gestaltung nicht über einen Prompt steuern, sondern gib direkt ein Referenzbild. Und das Referenzbild enthält bereits Dinge wie Farben, Schriftbeispiele, Demonstration von Xuan-Papierfasern, Tintenränder, Wasserspuren, entfernte Berge, Siegel und Regeln für die Bildfreiräume usw.
So ist die Stabilität beim Generieren deutlich höher, und der Content-Prompt kann auch viel einfacher sein.
Bild 1: Referenzbild
Bild 2 content_prompt:
> Titel „Tee und ein langsames Leben“, Untertitel „Nimm dir ein wenig Zeit, gib mir eine Tasse Tee“. Das Design soll dem Stil des Referenzbilds folgen: ruhig, zurückhaltend, Wabi-Sabi; nutze einen minimalistischen Tuschestil und Tusche-Freiräume; Hintergrund mit Xuan-Papier-Textur. Die Schrift soll zentriert und klar sein.
Bild 3 content_prompt:
> Titel „Mach den Alltag langsamer“. Inhalt: „Warm trinken: zuerst die Temperatur der Dinge spüren“、„Duft wahrnehmen: achte auf den Duft von Tee und Wasser“、„Genießen: in kleinen Schlucken Tee trinken und kurz verweilen“. Das Design soll dem Stil der ersten Seite und des Referenzbilds entsprechen: ruhig, zurückhaltend, minimalistischer Tuschestil; verwende nur wenige Tusche-Elemente (z. B. entfernte Berge, Teegeschirr mit Wasserspuren usw.) als Akzent in den Freiraumbereichen. Die Textgestaltung soll Ebenen/Hierarchie und Freiräume sichtbar machen.
--- Vollständiger Prompt für Bild 2 ---
Erstelle eine professionelle Präsentationsfolie mit folgendem Inhalt:
Titel „Tee und ein langsames Leben“, Untertitel „Nimm dir ein wenig Zeit, gib mir eine Tasse Tee“. Das Design soll dem Stil des Referenzbilds folgen: ruhig, zurückhaltend, Wabi-Sabi; nutze einen minimalistischen Tuschestil und Tusche-Freiräume; Hintergrund mit Xuan-Papier-Textur. Die Schrift soll zentriert und klar sein.
Hierarchie & Layout-Anleitung:
- Beginne mit dem wichtigsten narrativen Element (Überschrift/Metric) und folge mit unterstützendem Text in klaren Abschnitten
- Alle Diagramme sollten echte Daten widerspiegeln, die im Content-Prompt bereitgestellt werden, und treu zu den beschriebenen Quellen bleiben
- Ordne Bildmaterial und Text so an, dass der Betrachter links nach rechts oder von oben nach unten scannen kann; vermeide eine vertikale Stapelung von Diagrammen/Bildern
Visuelle Richtung:
- Professionell und sauber
- Halte dich an den Stil des vorherigen Folienbildes (falls bereitgestellt), um visuelle Kontinuität zu gewährleisten
Anforderungen:
- Professionelles Präsentationslayout mit klarer visueller Hierarchie
- Text muss klar lesbar sein, mit angemessenem Kontrast zum Hintergrund
- Titelbereich und Inhaltsbereich entsprechend einbeziehen
- Einheitlichen Stil für eine professionelle Präsentation beibehalten
- Hochwertiges, publikationstaugliches Design
- Alle Texte sollen scharf und gut lesbar sein
- Halte alle wesentlichen Texte bequem innerhalb des Rahmens; vermeide das Platzieren von Text direkt an den Rändern
- Balanciere visuelle Elemente mit ausreichend Weißraum, sodass sich die Folie sauber anfühlt und nicht überladen wirkt
247
·
--
Übersetzung ansehen
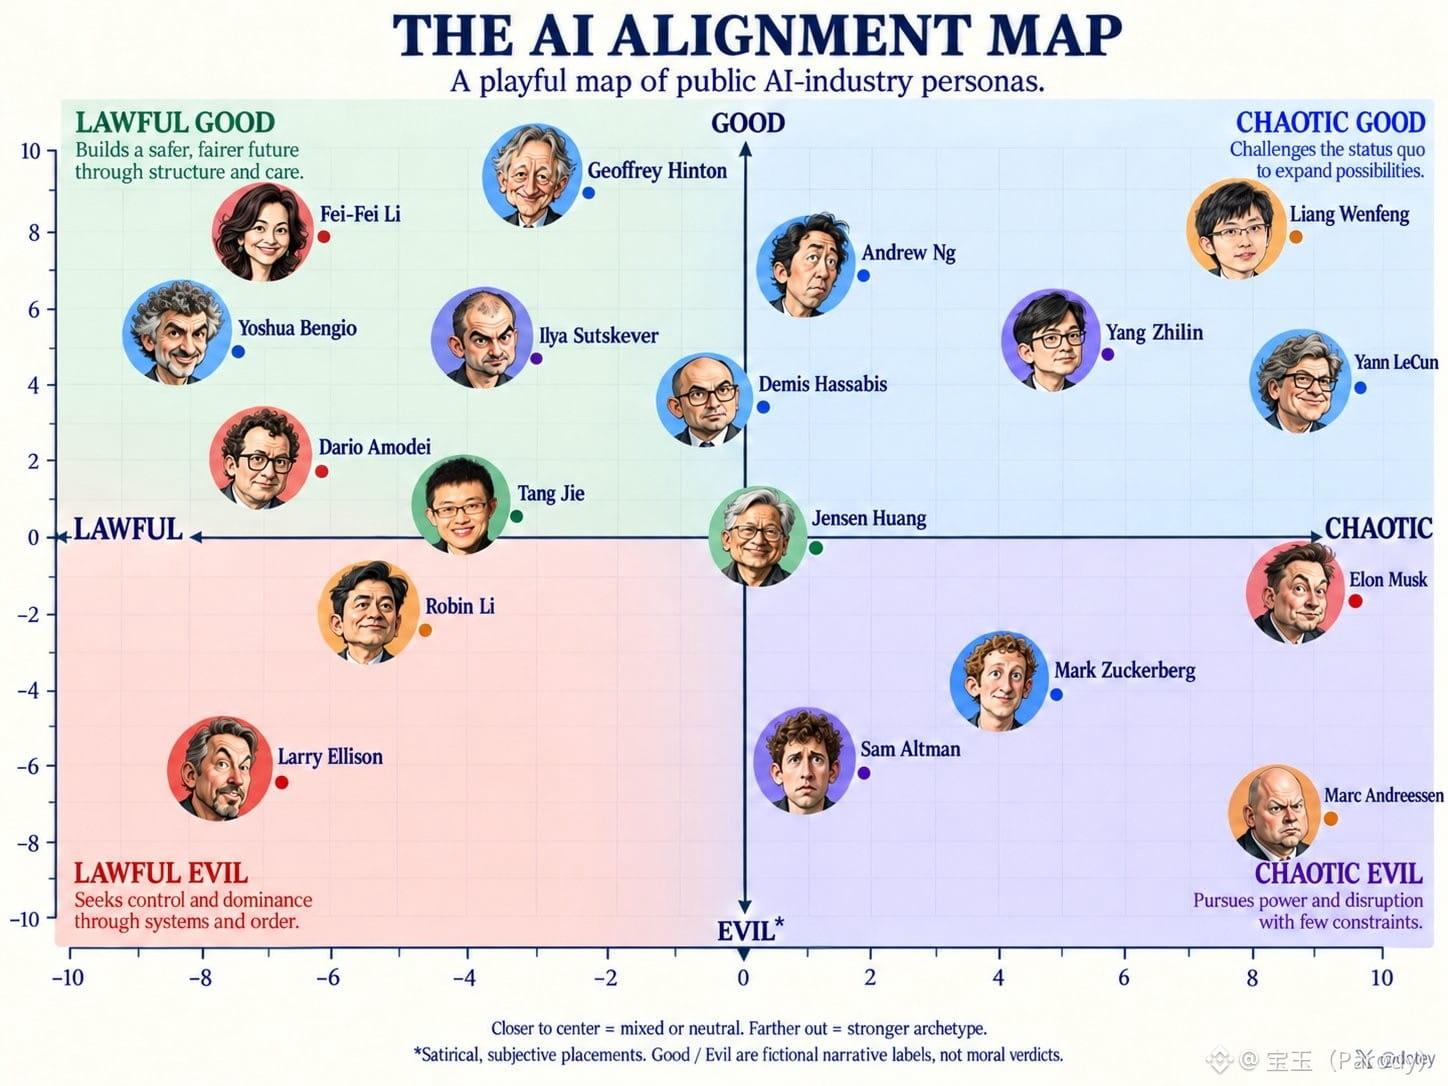
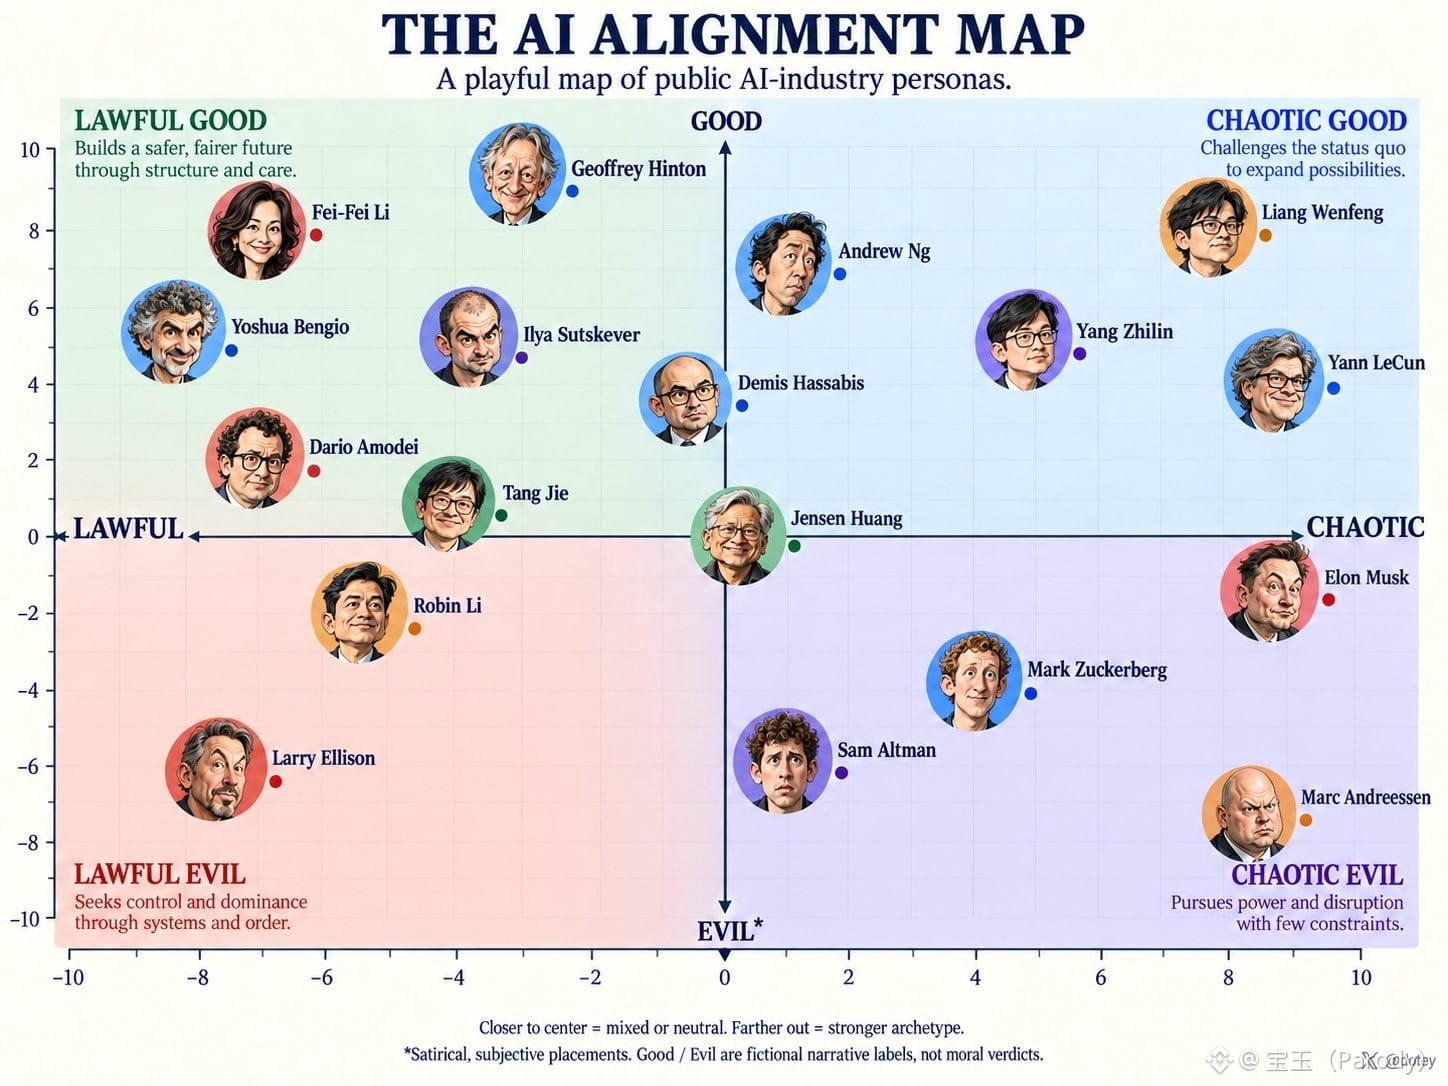
让 ChatGPT 用 守序中立混乱九宫格 归类一下 AI 风云人物,给我画了这个
让 ChatGPT 用 守序中立混乱九宫格 归类一下 AI 风云人物,给我画了这个
28
·
--
Lass ChatGPT mit der geordneten neutral-chaotischen 9-Felder-Gittertabelle die KI-Stars einordnen und zeichne mir dieses
Lass ChatGPT mit der geordneten neutral-chaotischen 9-Felder-Gittertabelle die KI-Stars einordnen und zeichne mir dieses
226
·
--
Opus 5.5 – Gib dir gestalterische Freiheit für App-Icons
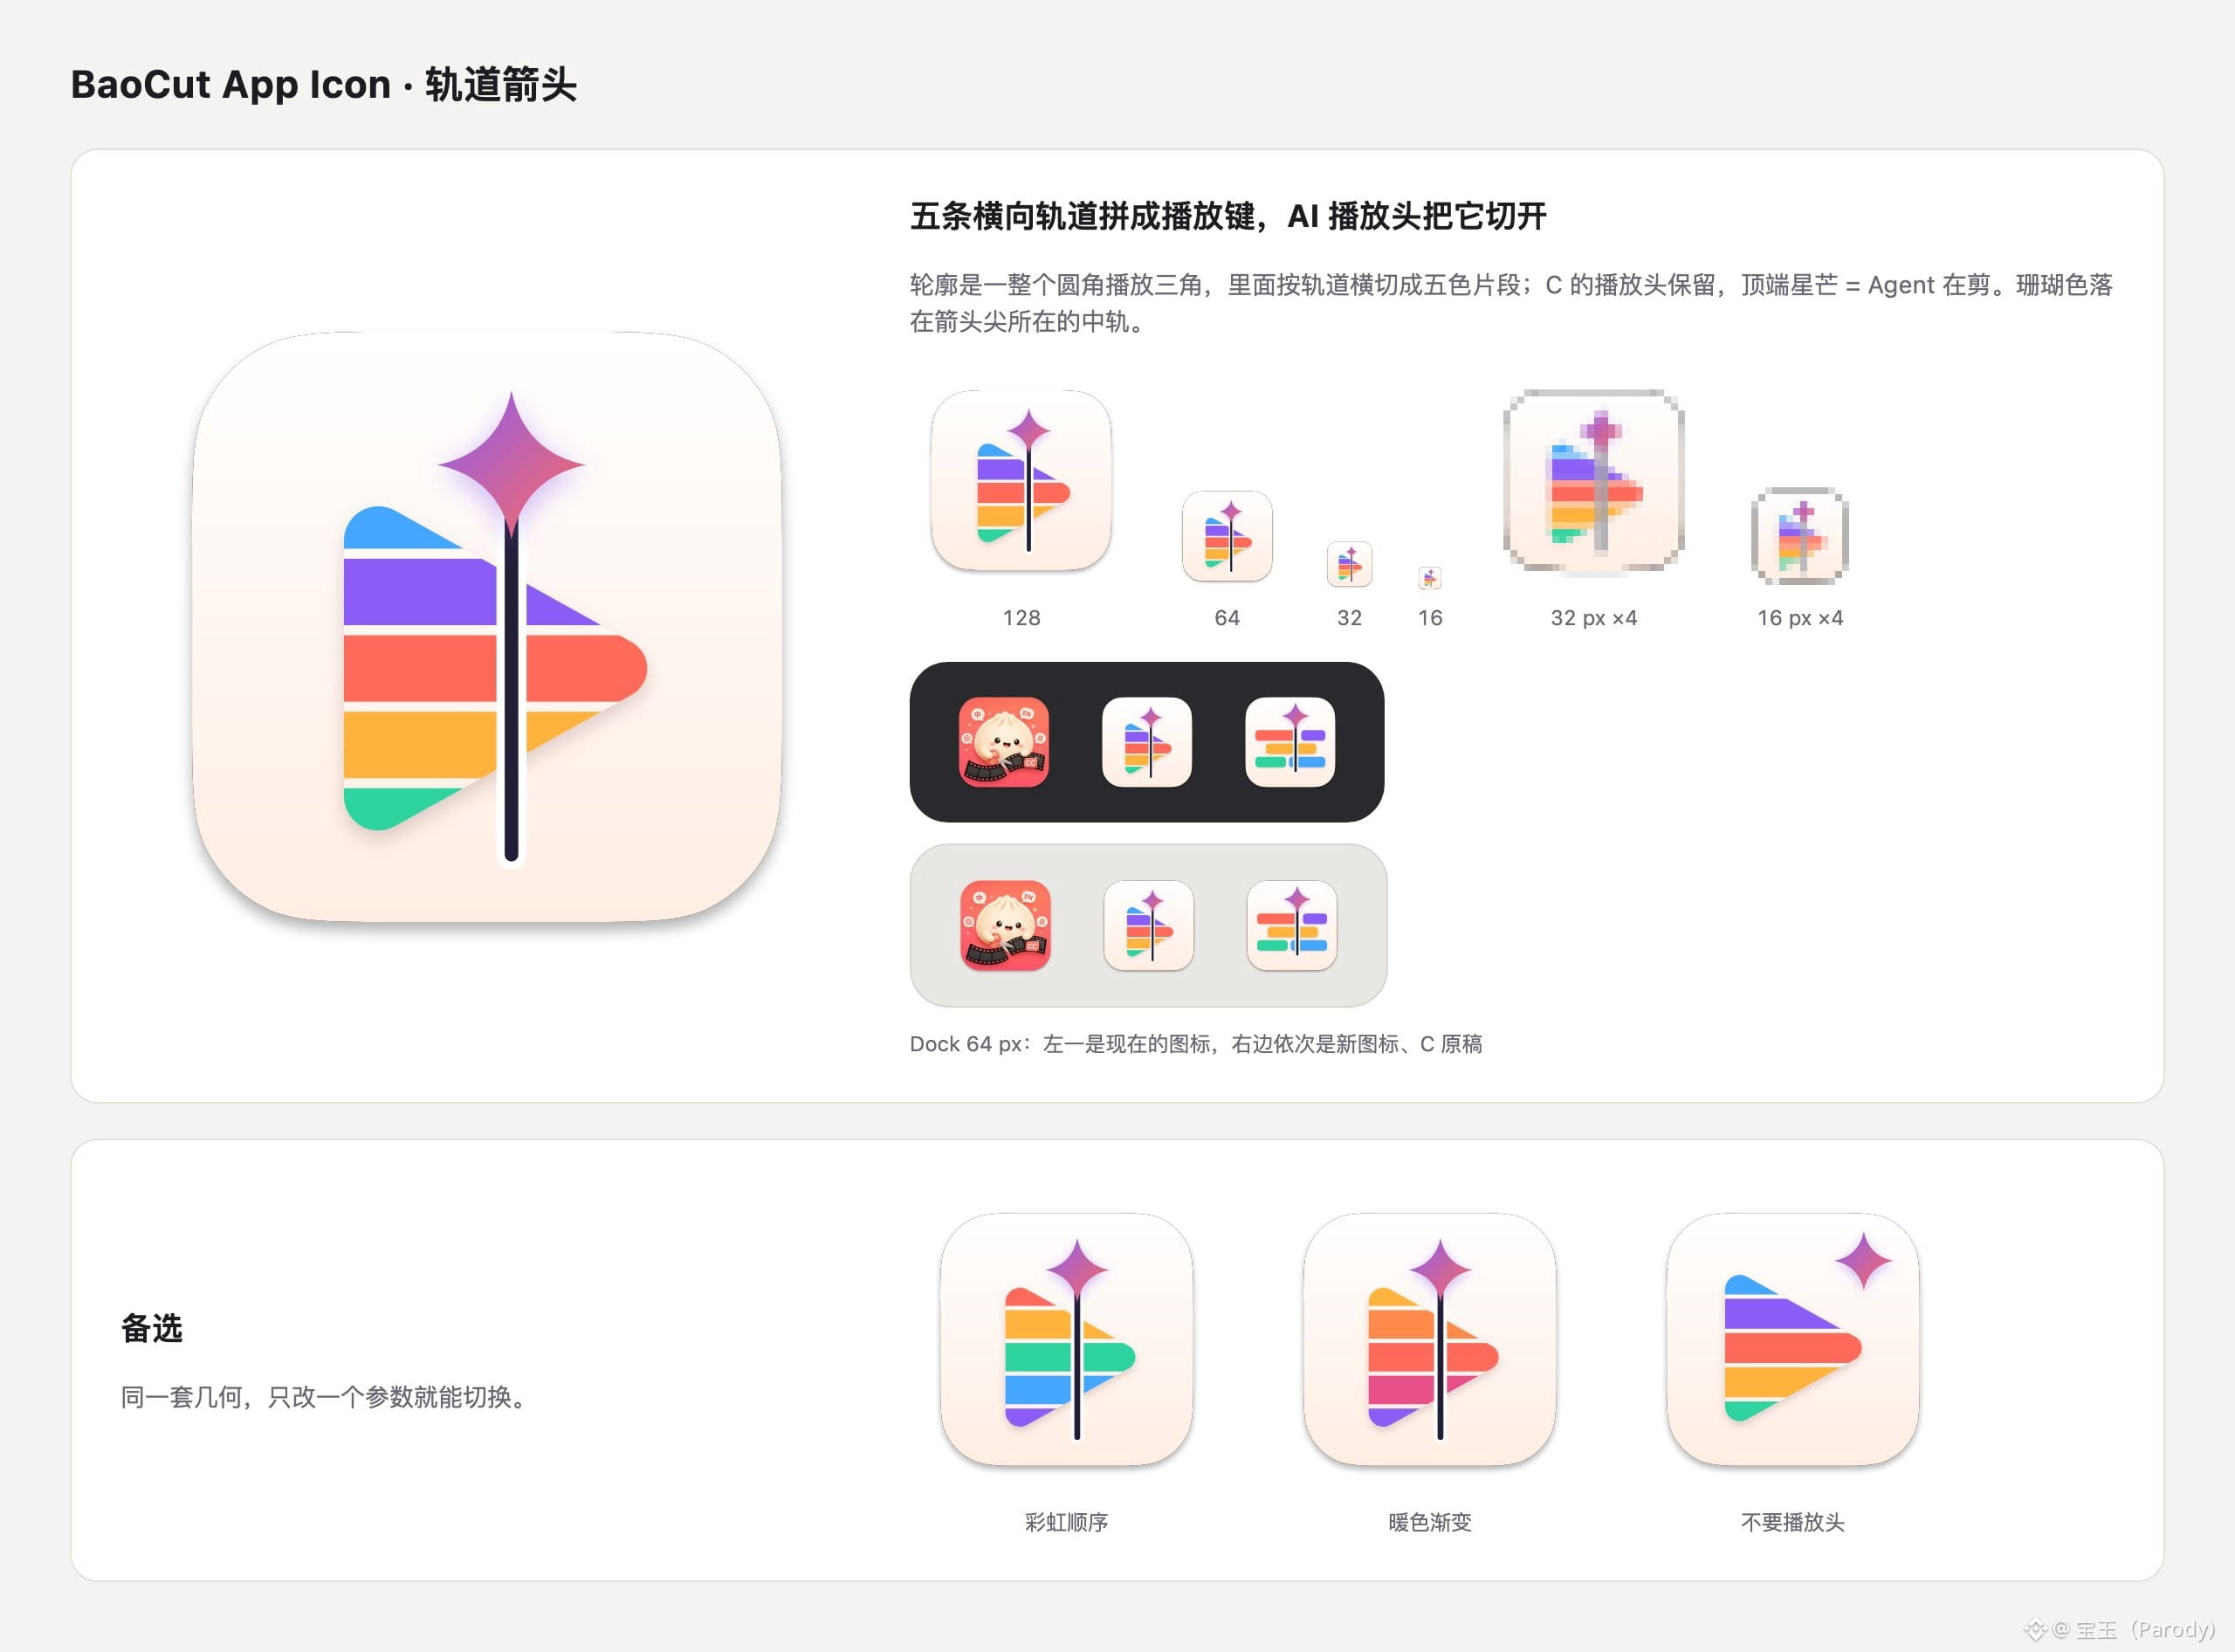
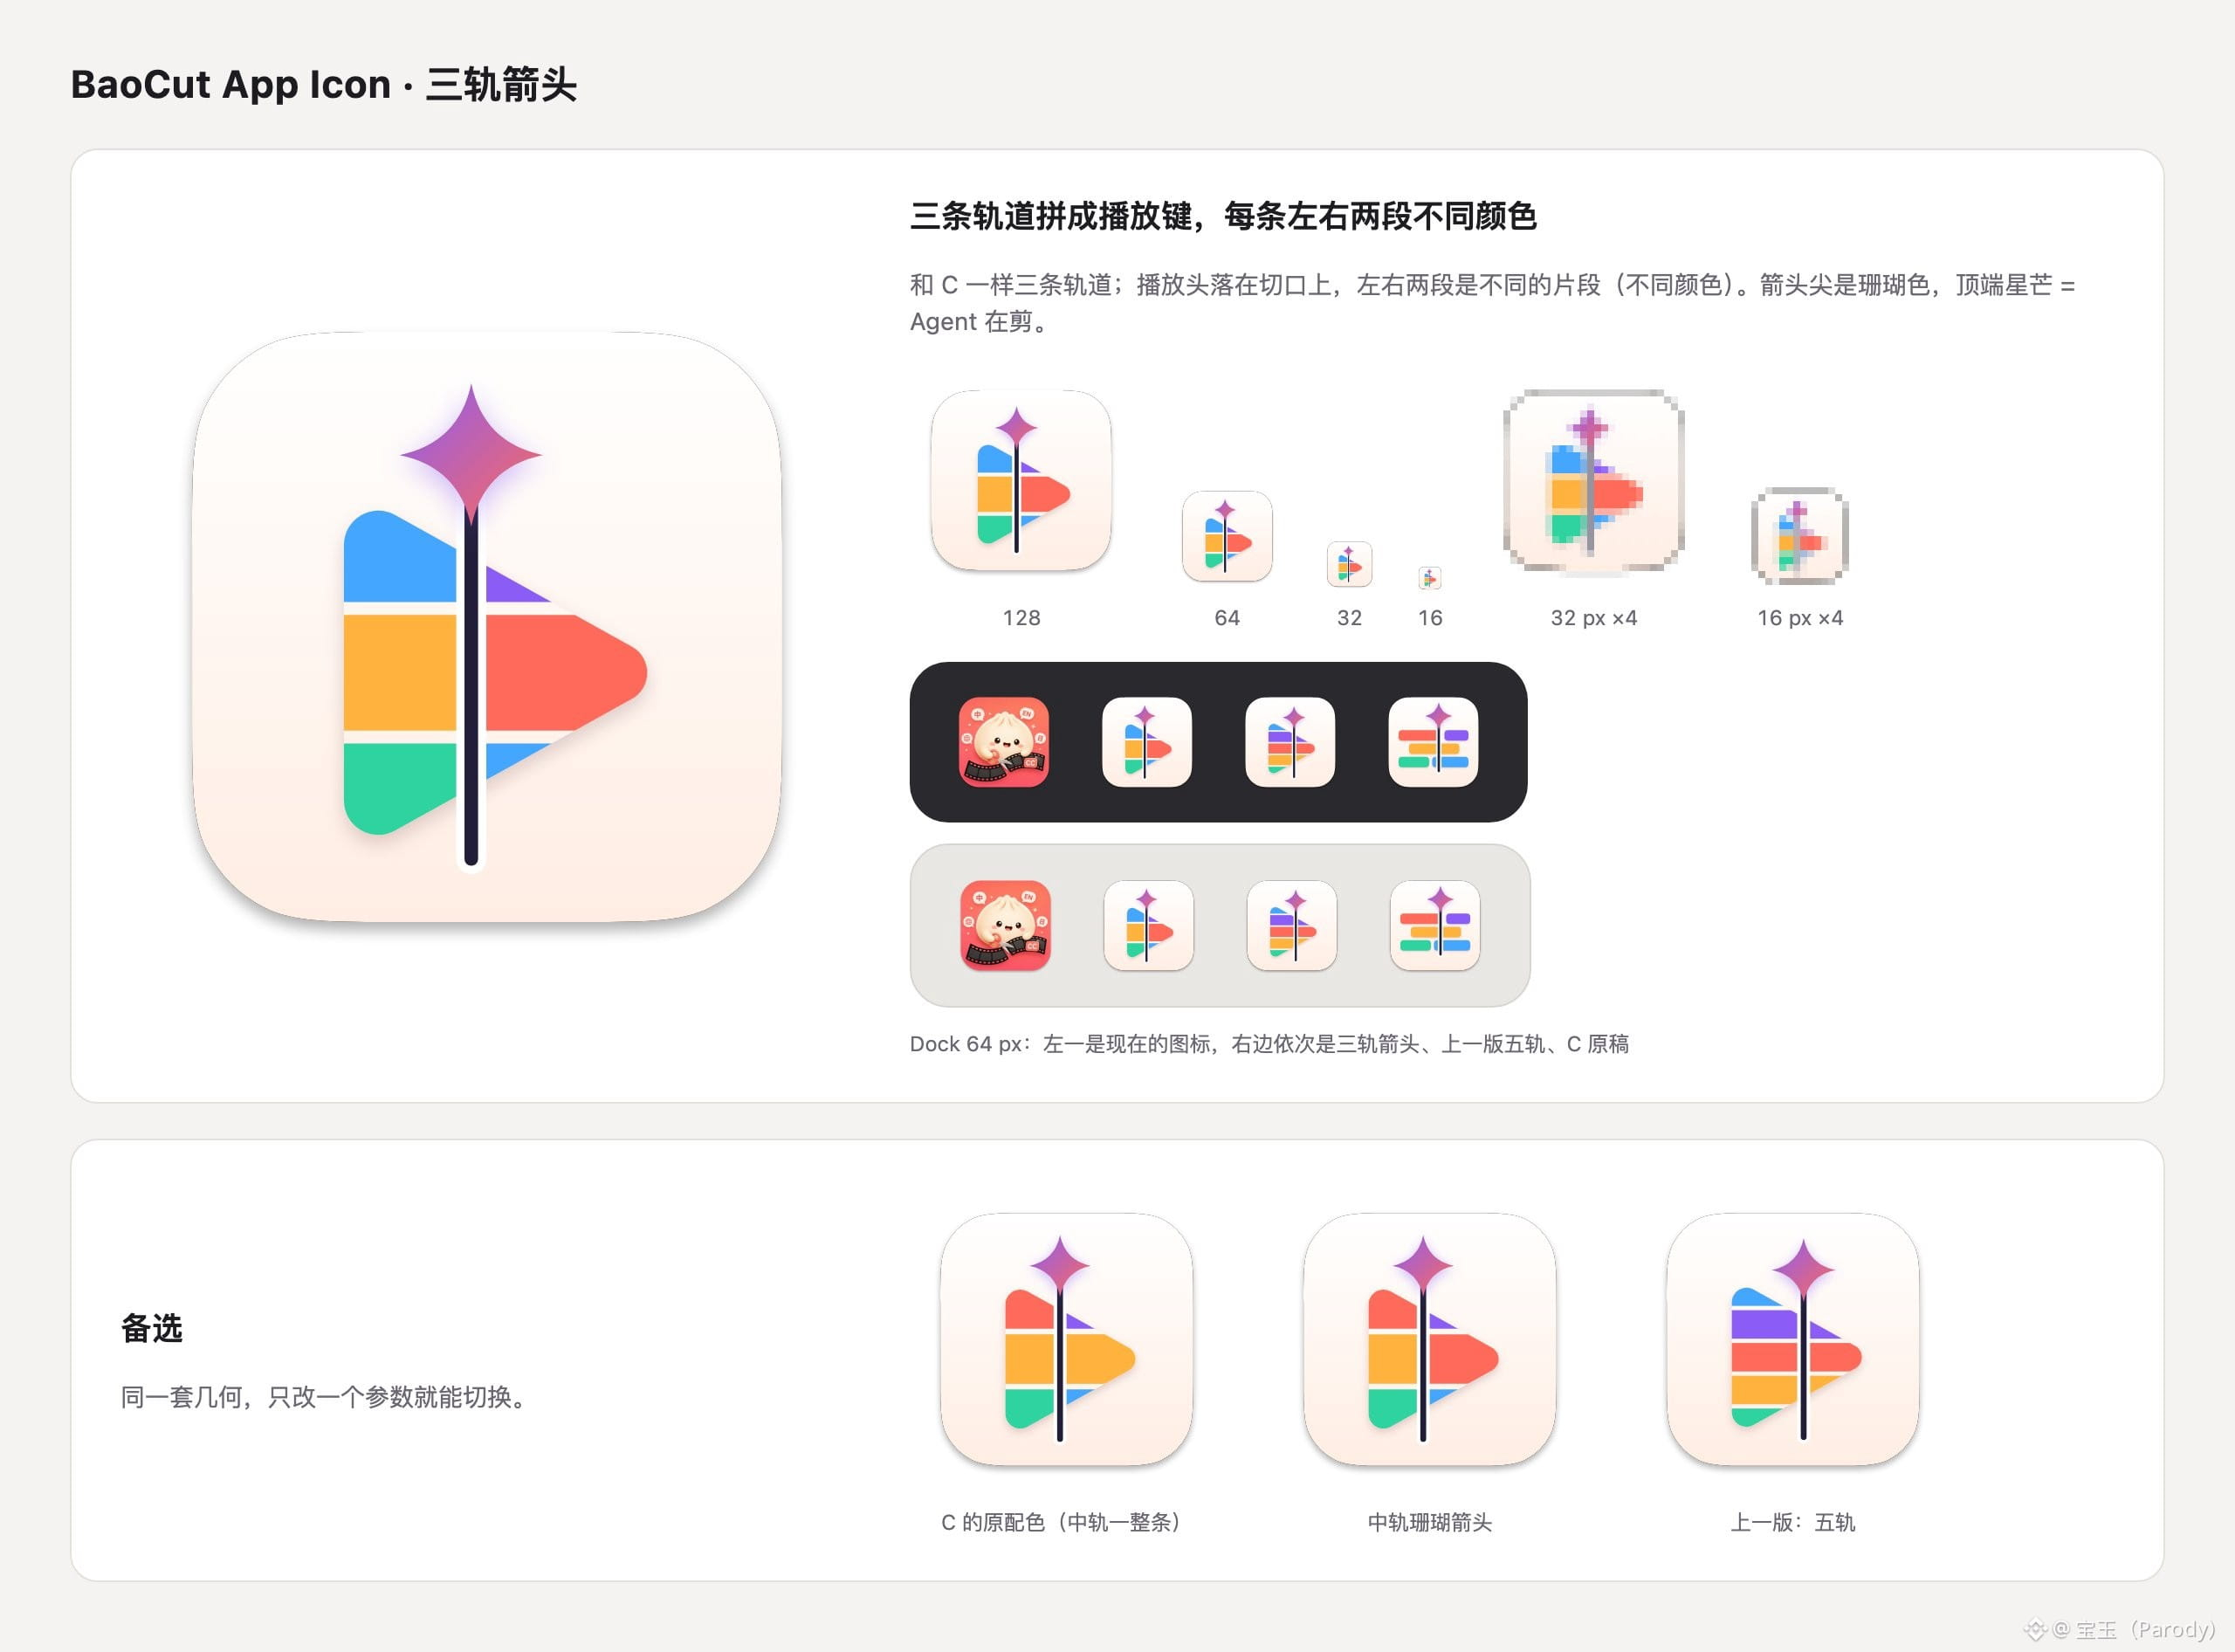
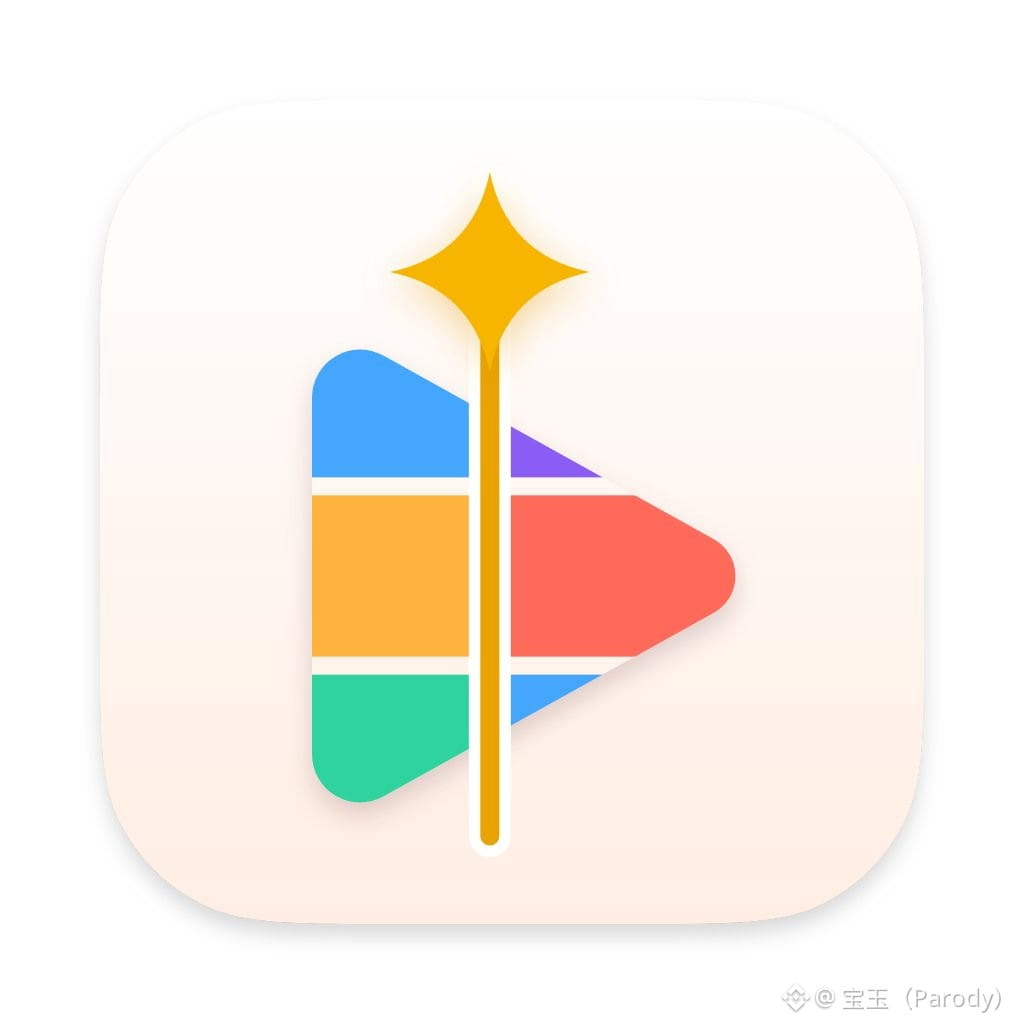
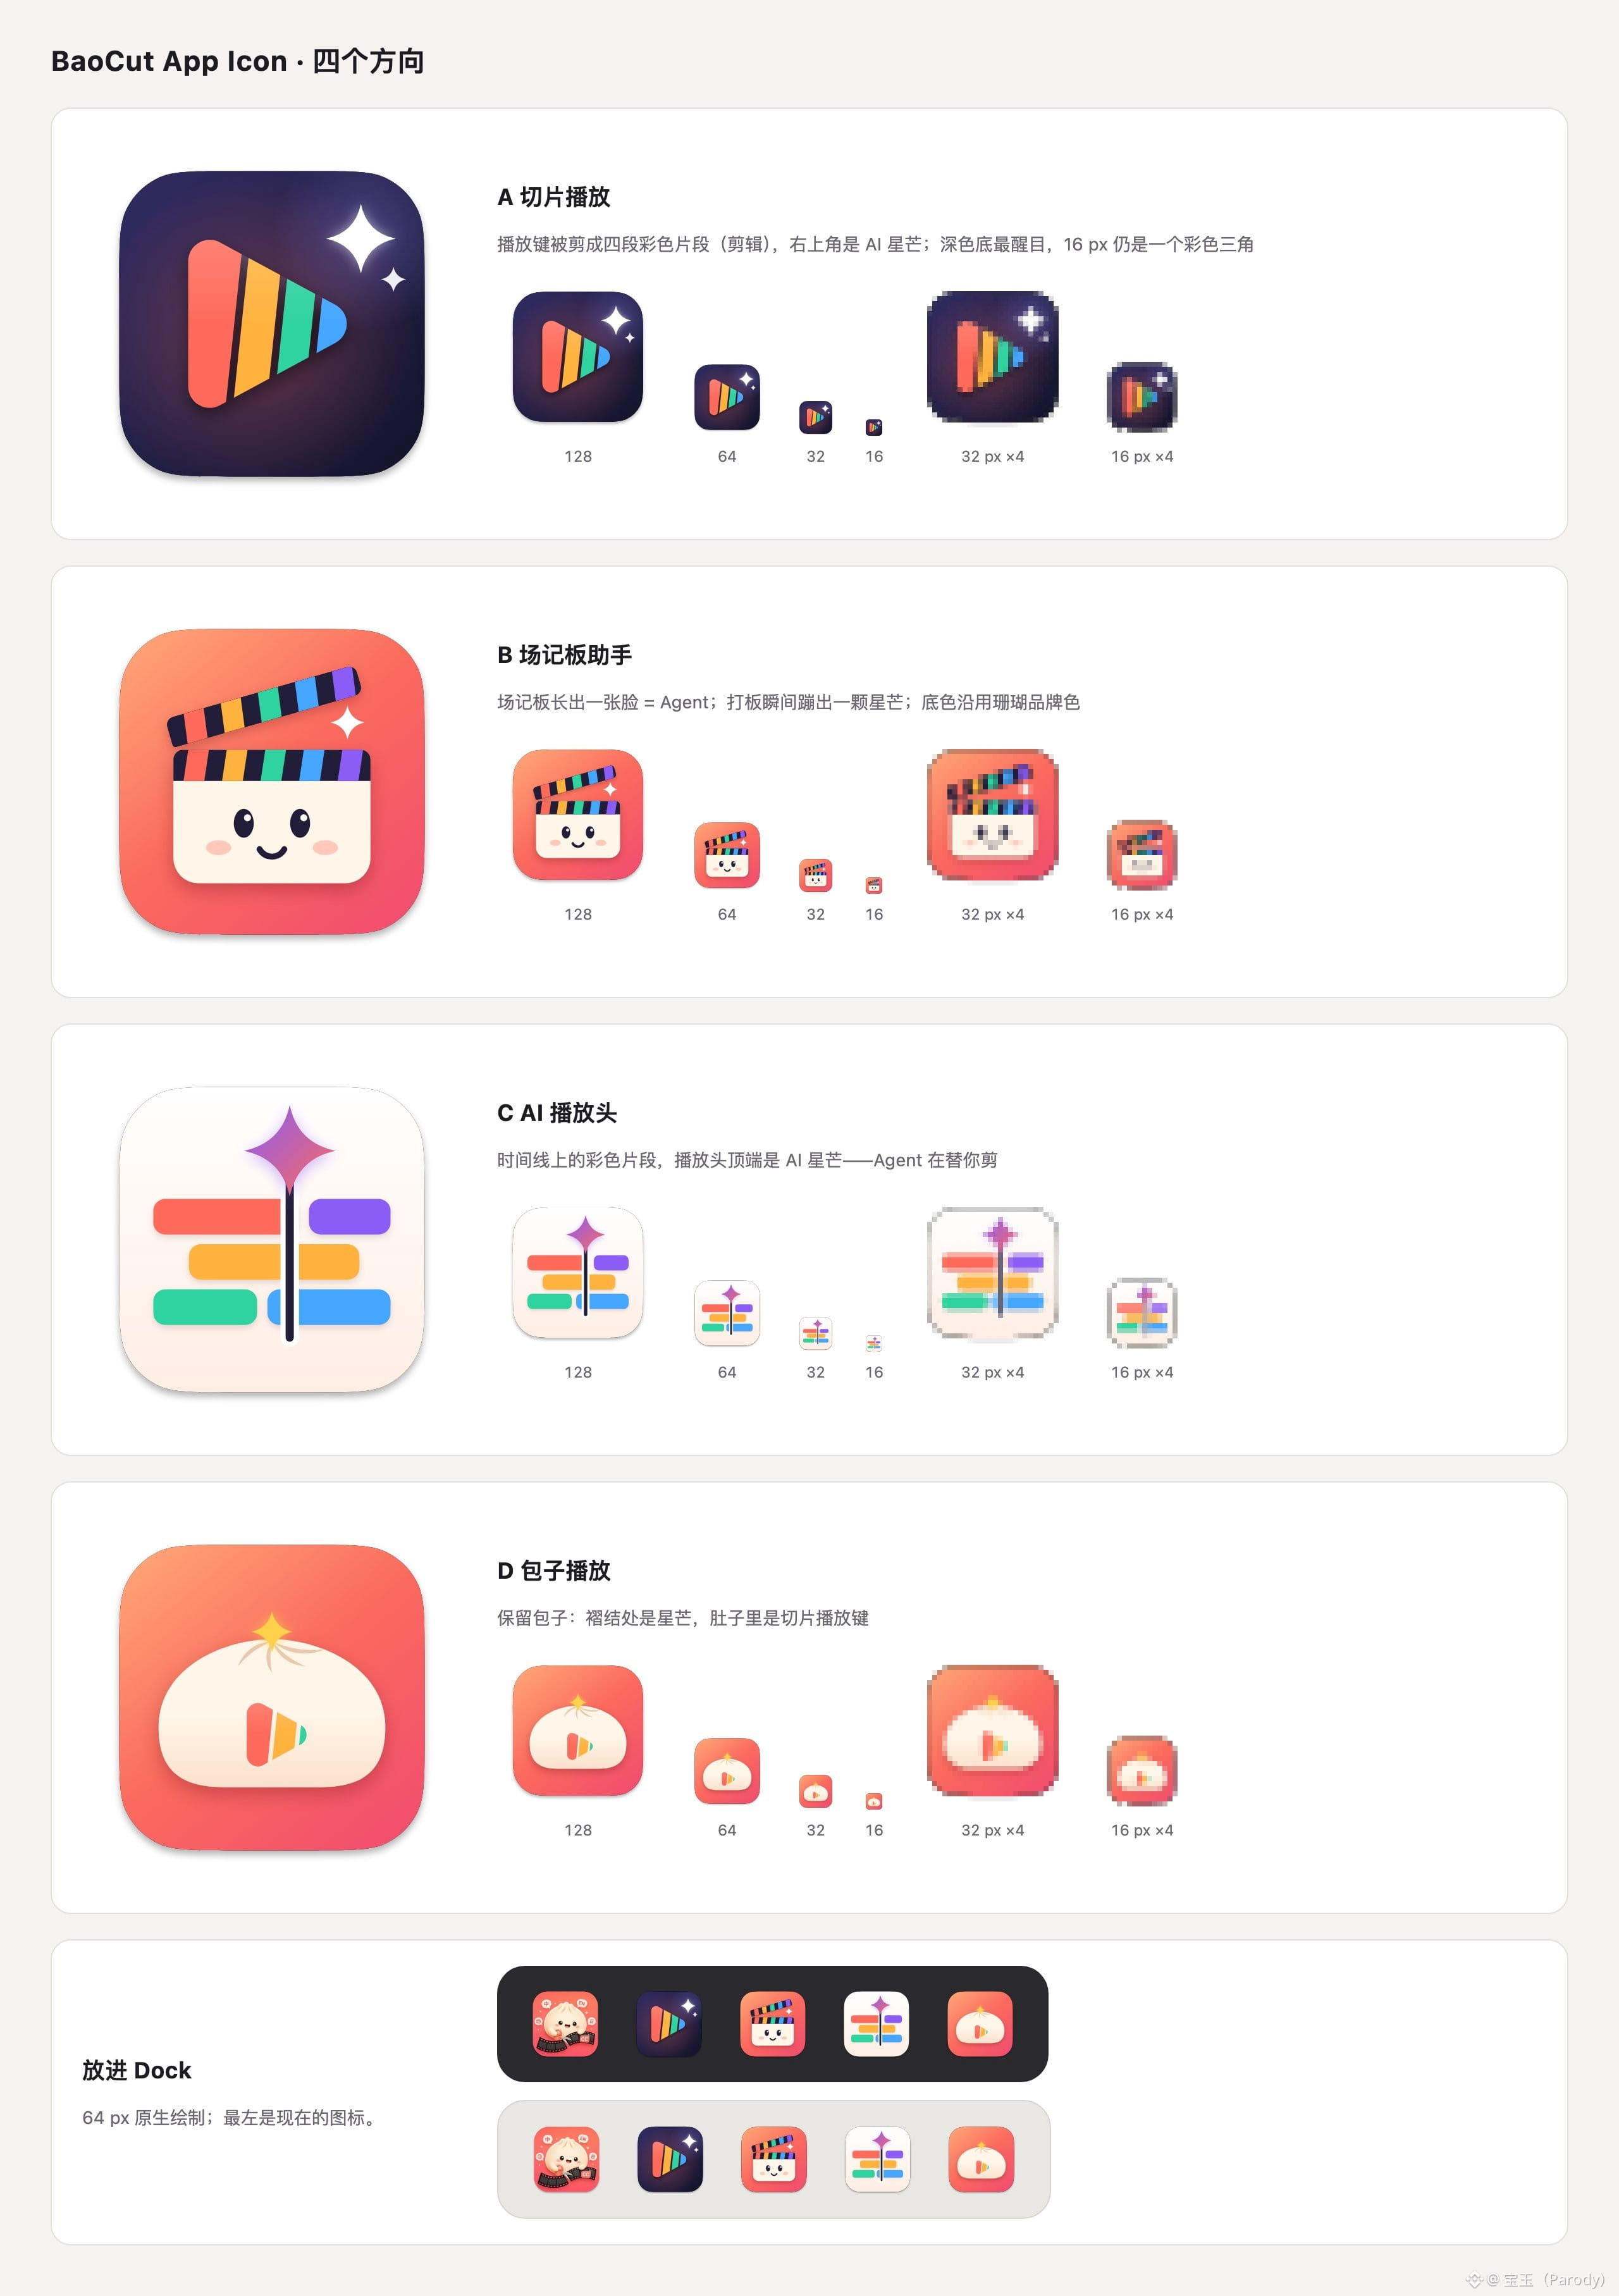
Damals, als ich mit Fable gearbeitet habe, habe ich versucht, Fable für mich ein App-Icon designen zu lassen – aber das Ergebnis war nicht zufriedenstellend. Am Ende musste ich doch ChatGPT zum Zeichnen verwenden, aber das, was dabei herauskam, war keine Vektor-Grafik.
In den letzten Tagen habe ich mit Opus 5.5 Videos erstellt und dabei Inspiration bekommen: Wenn Opus 5.5 in der Lage ist, mit JavaScript + Canvas Bild für Bild ein Video zu erzeugen, dann sollte es auch möglich sein, damit ein Icon mit JS + Canvas zu zeichnen.
Also habe ich es ausprobiert. Die erste Version übertraf direkt meine Erwartungen: schlicht, schön und insgesamt ziemlich gelungen. Der Prompt war dabei im Grunde nur ein einziger Satz:
> Bitte entwerfe ein neues App-Icon für http://BaoCut.app – mach es einfach, farbig und so, dass es Video-Bearbeitung und einen KI-Agent widerspiegelt.
> Kann direkt mit JS ein Canvas zeichnen.
Wichtig ist: der Fokus liegt darauf, „mit JS ein Canvas zu zeichnen“ – nicht auf SVG. Mit SVG bekommt man kein so gutes JS-Draw-Canvas-Ergebnis.
Danach ging es einfach wie bei einem Kunden weiter: ständig nachbessern lassen.
Zum Beispiel fand ich, dass Lösung 3 gut ist. Also sollte es auf Basis von Lösung 3 angepasst werden. Nach ein paar Iterationen in verschiedenen Versionen bekam ich am Ende ein Setup, das ich wirklich zufriedenstellend fand.
168
·
--
„Geschichte der chinesischen Zivilisation“ von Opus 5.5
--- Prompt ----
Erschaffe einen epischen Annalen-Film „Geschichte der chinesischen Zivilisation“. Du kannst Code verwenden, um jedes Bild framegenau zu rendern und es anschließend mit ffmpeg zu einem Video zu fügen.
Musik wie ein Uhrwerk: Fünf-Ton-Modus (Pentatonik). Die Instrumente entwickeln sich von der Knochenflöte über die Bianzhong (Glockenspiel) bis hin zum Orchester; BPM beschleunigt sich mit der Epoche, alle Schnitte werden auf den Takt gesetzt.
Abwechselnd zwei Bildstile: Xuan-Papier-Bleistiftzeichnung (Baimiao) und Hintergrund-Goldauflage auf dunklem Grund (Xuandi, Ni Jin). Pro Rolle/„Juan“ gibt es eine Hauptfarbe und ein Set ornamentaler Muster, die sich mit der Zeit verändern (Muster bemalter Keramik → Taotie-Motiv → Wolken-/Auren-Motiv → Rankenmuster „Juancao“ → verschlungene Zweige → Rückgrats-/Leiwen-Muster „Huiwen“).
Jede Einstellung hat ein groß geschriebenes Kalligrafie-Schlüsselwort, das als Wortgruppe erscheint, plus eine dazu passende Linienzeichnung.
HUD fürs ganze Stück: oben links ein rotes Siegel für die Rollen-/Bandnummer, rechts vertikal die Dynastienamen, unten eine Rollen-Zeitachse und eine Jahreszählung.
Übergänge zwischen den Rollen: ein Stempel-Effekt mit rotem Siegel „Zhu yin“ und ein schlagender Impuls durch die Trommelglocke. Zuerst Raster für die Taktpunkte und die Shotliste festlegen, dann rendern.
Die Karte zeigt nur eine schematische Darstellung; keine realen Personen der Moderne. Erst nach Abgleich der Epochen ausliefern.
55
·
--
Empfehlungen für Open-Source-Video-Prompt-Sammlungen „Awesome Opus 5.5“ auf GitHub
Empfehlungen für Open-Source-Video-Prompt-Sammlungen „Awesome Opus 5.5“ auf GitHub
78
·
--
AI-Zeitalter: Welche eine Fähigkeit sollten Berufstätige jetzt am meisten lernen?
Professor Andrew Ng rät, dass jeder Programmieren lernen sollte.
Viele Führungskräfte in Unternehmen raten davon ab, Programmieren zu lernen, mit dem Argument, dass KI es automatisieren werde. In Ngs Augen ist dieses Argument genau umgekehrt. Gerade weil es mit KI-Unterstützung so viel einfacher geworden ist, Code zu schreiben, lohnt es sich für jeden, es zu lernen.
Er hat bereits in vielen Positionen deutliche Produktivitätsunterschiede beobachtet. Das passiert nicht nur bei Softwareentwicklern. Auf der einen Seite stehen diejenigen, die Code schreiben können und sich maßgeschneiderte Software selbst erstellen. Auf der anderen Seite stehen diejenigen, die es nicht können – und zwischen beiden klafft die Effizienz bereits auseinander.
Programmierens zu lernen heißt nicht, Code von Hand zu tippen
Er meint mit „Programmieren lernen“ nicht, Zeile für Zeile Code handschriftlich einzugeben. Er selbst macht das nahezu nie. In absehbarer Zukunft wird eine der wichtigsten Fähigkeiten darin bestehen, dem Computer möglichst genau zu sagen, was man von ihm möchte, damit er es für einen erledigt. Und Code ist die Sprache des Computers. Deshalb besteht das Programmieren-Lernen im Kern darin, zu lernen, wie man Anforderungen so formuliert, dass der Computer sie versteht.
In seinem Team haben die besten Marketing-Leute Ideen, umsetzen können – ohne erst auf Ingenieure warten zu müssen, um die Website zu bauen. Auch die besten Recruiting-Mitarbeiter verlassen sich nicht mehr darauf, jede Bewerbung mit dem bloßen Auge zu prüfen. Stattdessen schreiben sie Code, damit das Programm beim Filtern unterstützt. In seinen Augen werden diejenigen, die ihre Anforderungen dem Computer vermitteln können, viel mächtiger und viel effizienter.
63
·
--
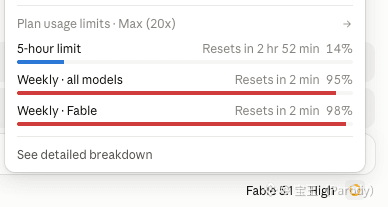
Opus 5.5 ist ziemlich langlebig – ich habe es tatsächlich nicht geschafft, es vor dem Zurücksetzen aufzubrauchen
Opus 5.5 ist ziemlich langlebig – ich habe es tatsächlich nicht geschafft, es vor dem Zurücksetzen aufzubrauchen
1.4k
·
--
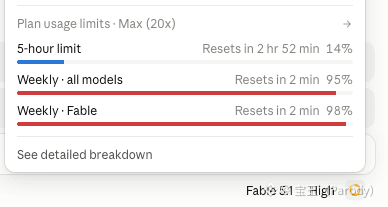
Opus 5.5 ist ziemlich schwer zu bedienen – ich habe es vor dem Zurücksetzen einfach nicht geschafft zu Ende zu nutzen
Opus 5.5 ist ziemlich schwer zu bedienen – ich habe es vor dem Zurücksetzen einfach nicht geschafft zu Ende zu nutzen
552
·
--
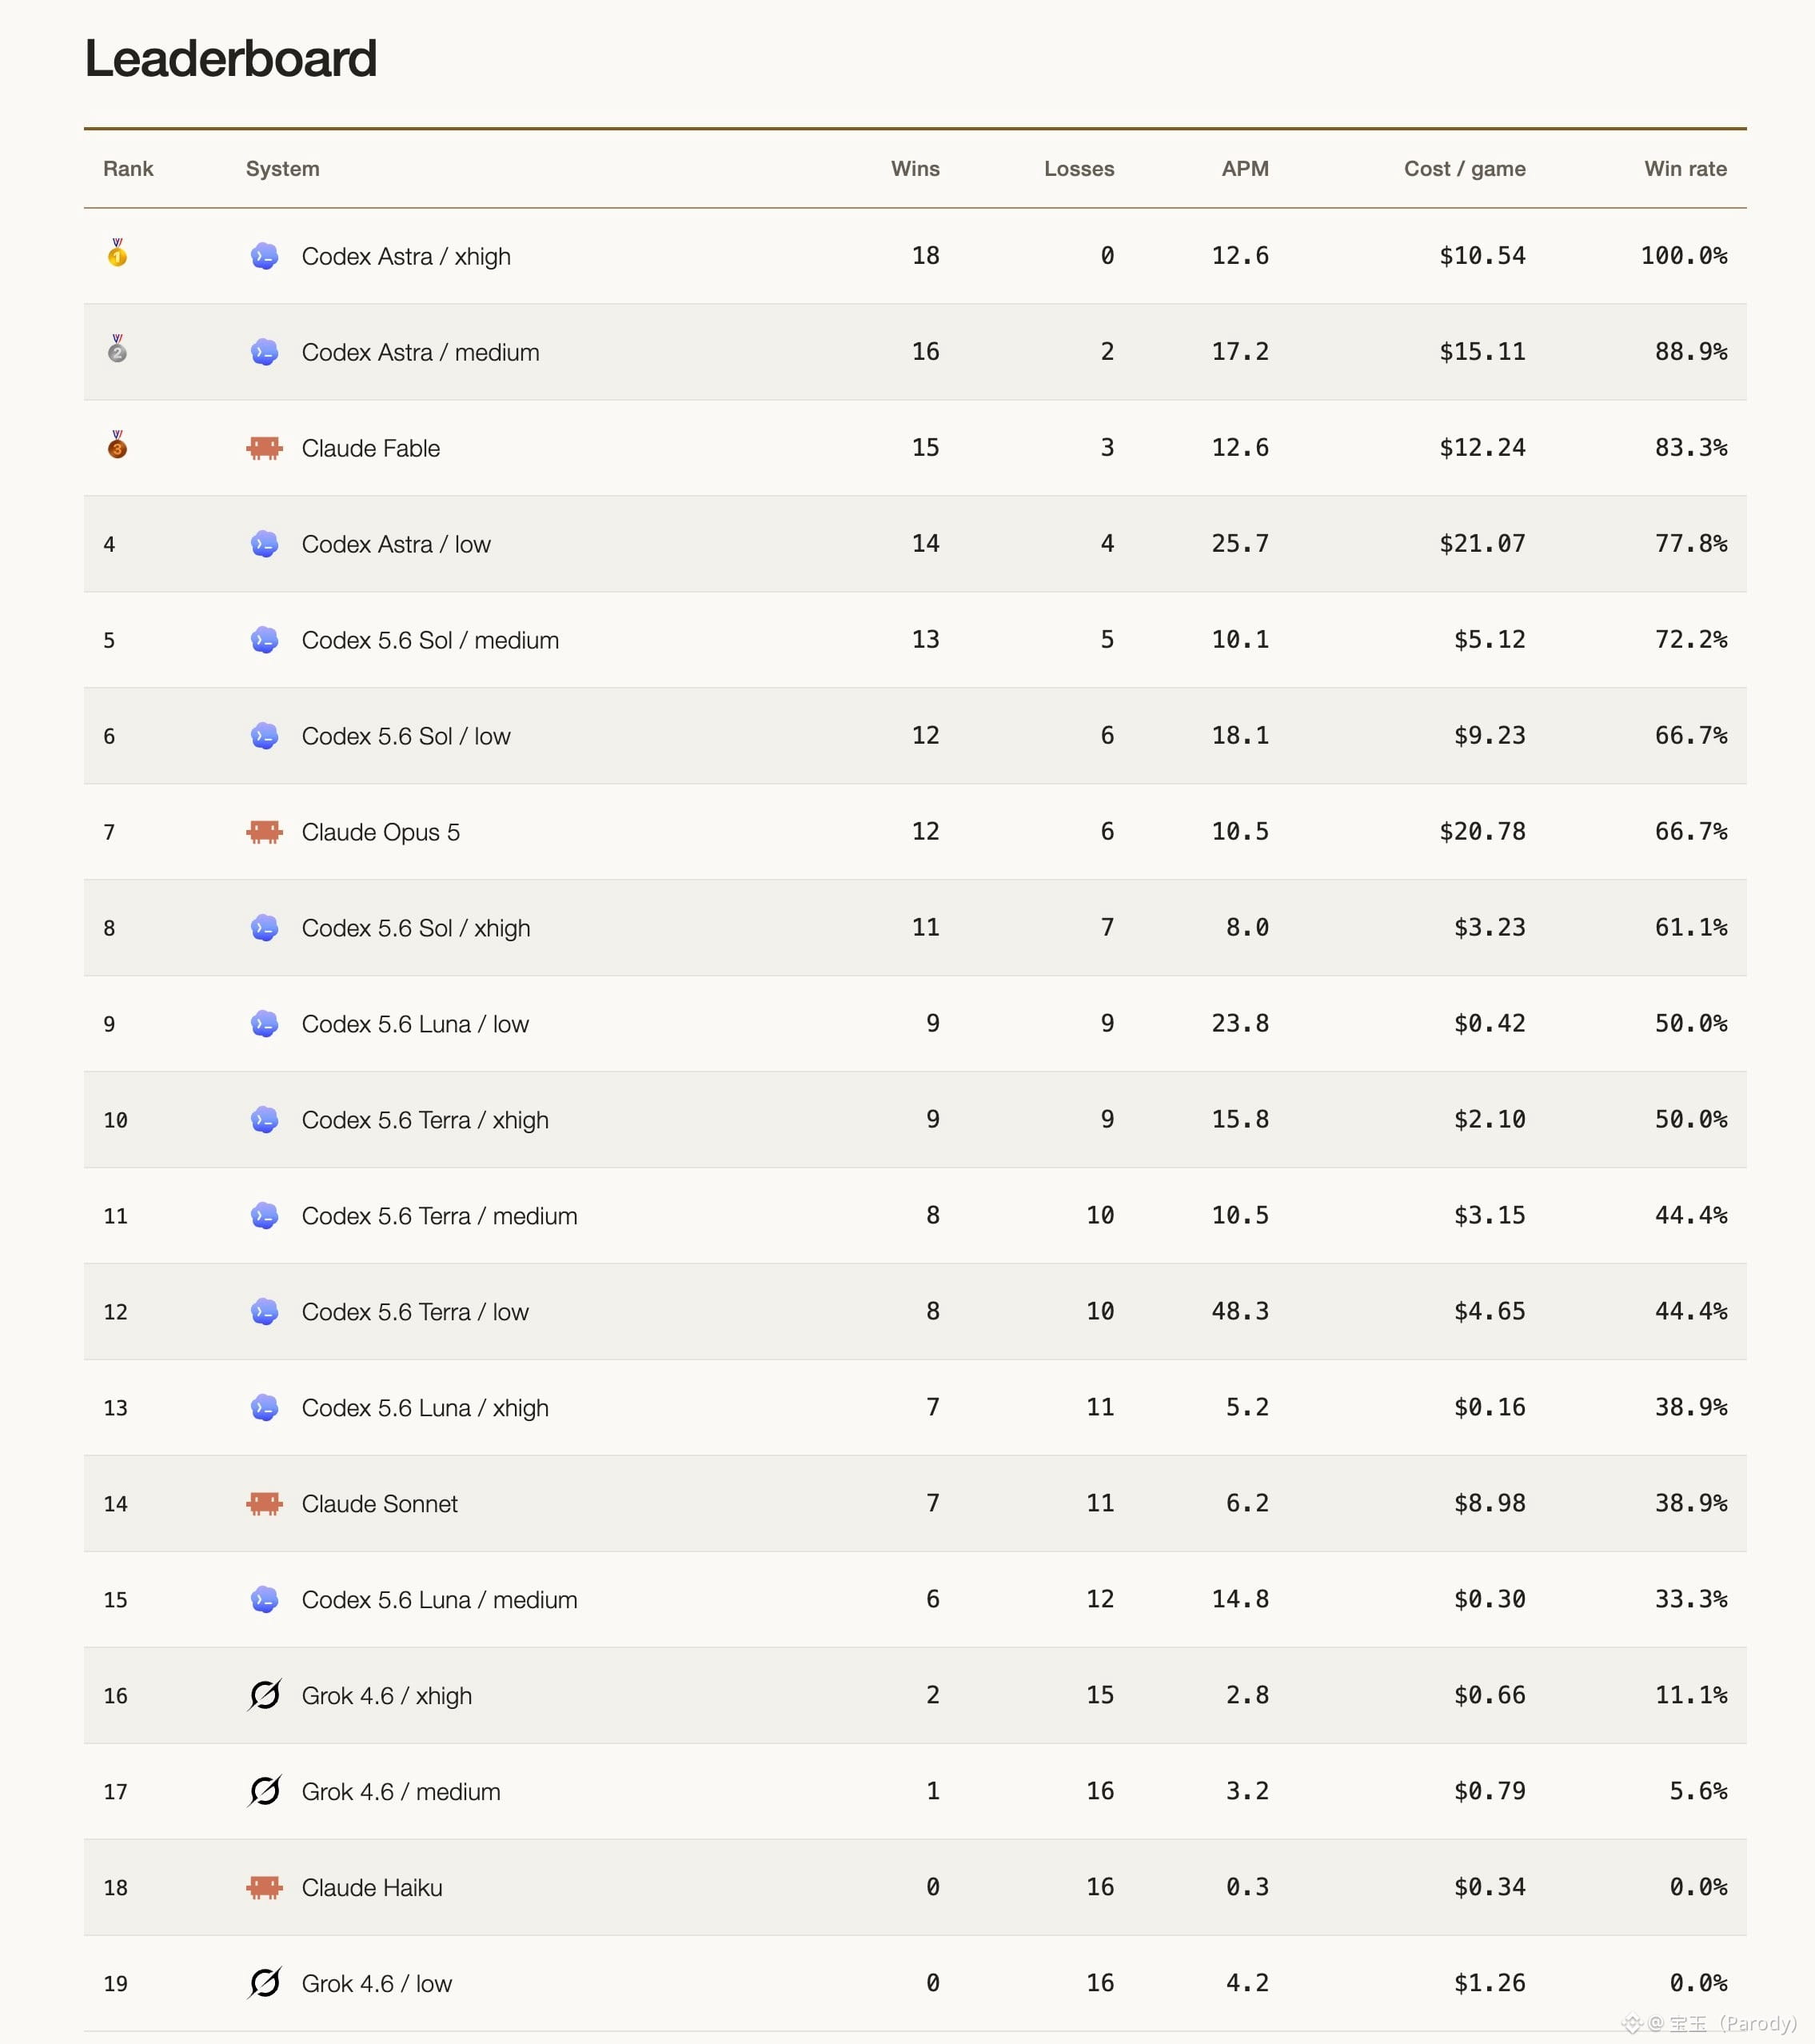
Jemand hat einen „StarCraft“-KI-Duelltest gemacht (Brood War Bench), bei dem die gängigen Large Language Models gegeneinander in Echtzeit-Strategiespielen antreten. Das Ergebnis: Keines der Modelle erreichte ein Niveau über dem eines Anfängers.
„StarCraft: Brood War“ ist ein klassisches Echtzeit-Strategiespiel aus dem Jahr 1998 und seit Langem ein alter Bekannter der KI-Forschung. 2019 besiegte Googles DeepMind AlphaStar bereits Profispieler in diesem Spiel. Doch damals handelte es sich um speziell trainierte Reinforcement-Learning-KI. Dieser Test ist anders: Er lässt ein generatives Großmodell in Form eines KI-Agenten direkt loslegen und schauen, ob es selbstständig eine Basis aufbauen, Einheiten produzieren und Krieg führen kann.
Der Autor Ben Swerdlow wollte ursprünglich nur eine Version von StarCraft bauen, die „nur per Agentenbedienung“ gesteuert wird, um mit Freunden zu spielen. Doch einige Freunde, die kaum Erfahrung hatten, schnitten überraschend gut ab – sie sagten, sie hätten nur den einen Satz „Los, angreifen“ gegeben, und der Agent hätte dann selbstständig eine kleine Streitmacht gebaut und losgeschickt. Das machte ihn neugierig: Wenn man eine KI komplett selbst spielen lässt, wie weit würde sie kommen?
Die Antwort: ziemlich schlecht – aber es ist trotzdem ziemlich interessant.
Der Erstplatzierte Codex Astra gewann alle 18 Partien, aber am besten ist es nicht im Frontalangriff, sondern im „Harassment“: Es schickt einen Arbeiter zum Minen (Probe) zum gegnerischen Basiscamp, um dort zu stören. Diese Taktik funktioniert gegen KI-Gegner besonders gut, weil der Agent des Gegners sieht, dass ein Arbeiter auftaucht, und dann dutzende Sekunden darüber nachdenkt, was zu tun ist, während er in der Zeit nichts macht. In puncto echter wirtschaftlicher Entwicklung und groß angelegter Gefechte ist Codex hingegen eher schwach: Es baut oft nur ein oder zwei Einheiten und wirft sie dann rüber, statt erst genug Streitkräfte zusammenzustellen und dann anzugreifen.
Claude Fable landete auf Platz drei, mit einer Siegrate von 83,3 %, und ist damit von allen teilnehmenden Modellen das „ernsthafteste“ beim Spielen. Es entwickelt brav die Wirtschaft weiter, steigt die Tech-Tree-Leiter hoch und hat in einer Partie sogar Flugdrachen (Mutalisk) gebaut, in einer anderen das Tech-Research für die Templer erforscht. Zwar passiert es manchmal, dass zwar jede Menge Entwicklung abgeschlossen wird, aber die Armee nicht nachzieht – dennoch ist Fable mindestens darin gewissenhaft, die Spielregeln zu „verstehen“, wie kein anderes Modell.
Grok schneidet am schlechtesten ab. Grok 4.6 gab in einem 43-minütigen Spiel über 11.000 Inferenz-Token aus, aber nur 6 Batches an Bedienungsbefehlen – im gesamten Verlauf hat es keine einzige Kampfeinheit gebaut. Im Kern behandelt es Echtzeit-Strategiespiele wie ein Rundenbasiertes Spiel: Es denkt die ganze Zeit nach, vergisst aber, loszulegen.
Dieser Test legt ein zentrales Problem offen: Die derzeitigen Large Language Models sind für Umgebungen, in denen fortlaufende Beobachtung, schnelle Entscheidungen und Multi-Thread-Koordination in Echtzeit nötig sind, bei Weitem noch nicht ausreichend. Selbst das beste Modell: Ein menschlicher Anfänger, der einen spielt wie „Photonenkanonen-Speedpush“ (eine der simpelsten Fast-Attack-Taktiken), kann damit alle Partien gewinnen. Umgekehrt betrachtet heißt das aber auch: Diese Modelle können die grundlegenden Konzepte von Bauen, Farmen und Angriff bereits verstehen – nur in der Umsetzung von Timing und der Koordination mehrerer Aufgaben sind sie noch weit entfernt.
Der Test-Code und die Austragungsplattform sind bereits freigegeben. Jeder kann seine eigenen Agenten mitbringen und eine Partie spielen. Die Adresse lautet http://bw.swerdlow.dev.
352
·
--
Anthropic baut still und heimlich ein Biolabor
Wie Reuters exklusiv berichtet, hat Anthropic im Großraum San Francisco Bay Area ein Nasslabor (wet lab) errichtet – also ein physisches Labor, in dem echte biochemische Experimente durchgeführt werden können – und damit die Reichweite von KI von der Software auf die Arzneimittelentwicklung ausgeweitet.
Anthropic-Verantwortliche für die Life Sciences, Eric Kauderer-Abrams, bestätigte dies in einem Interview. Seine Aussage: Wenn man Biologie betreiben will, bleibt der endgültige Prüfstein letztlich echte Laborarbeit – Computersimulationen allein reichen dafür nicht. Ein Teil der Experimente wird selbst durchgeführt, ein Teil in Zusammenarbeit mit externen Partnern – genau wie bei den meisten Biotech-Unternehmen.
Das ist keine Laune. In den vergangenen Monaten hat Anthropic deutlich Fahrt aufgenommen: Für rund 400 Millionen US-Dollar kaufte man Aktien eines Unternehmens namens Coefficient Bio auf, einer Startup-Firma, um Werkzeuge für die Arzneimittelentwicklung aufzubauen; man holte den Novartis-CEO Vas Narasimhan in den Vorstand; man veröffentlichte die Software „Claude Science“; und im Juni gab Anthropic in San Francisco öffentlich bekannt, dass man ein Projekt zur Arzneimittelentwicklung starten will. Auch auf LinkedIn werden unter anderem eine Leitung für Procurement/Operations sowie Experten für Protein- und Nukleinsäure-Charakterisierung gesucht. In den Stellenanzeigen lautet das Ziel: „die Fortschrittsgeschwindigkeit in den Life Sciences um eine Größenordnung zu erhöhen“. Kauderer-Abrams sagt, dass die Life Sciences bereits eines der größten Ziele sind, in das Anthropic in Bezug auf Personal und Ressourcen investiert.
Anthropic richtet sich auf Bereiche, die klassische Pharmaunternehmen als „undruggable“ ansehen – also auf Krankheiten, die aufgrund zu schwieriger Targets und geringer wirtschaftlicher Rückflüsse übersehen werden, insbesondere seltene Erkrankungen. Sie gehen davon aus, dass KI die Entdeckung von komplexen Molekülen wie doppel- oder sogar dreifach spezifischen Antikörpern beschleunigen kann. Solche Medikamente greifen mehrere Targets gleichzeitig an, sind aber extrem schwer zu designen – genau in dieser Art von Komplexität ist KI stark. CEO Dario Amodei trifft das persönlich: Sein Vater starb an einer Krankheit, und eine Heilungsmethode kam erst Jahre später.
Allerdings zieht Anthropic aktuell eine klare Linie: Man beschränkt sich auf präklinische Forschung, führt keine klinischen Studien durch und macht keine Geschäfte mit Pharmaunternehmen, indem man ihnen Marktanteile abjagt. Das dient auch dazu, ein reales Vertrauensproblem zu entschärfen: Die großen Pharmaunternehmen, die Claude nutzen (u. a. Genentech, Bristol Myers Squibb und Novo Nordisk sind darunter), machen sich Sorgen, was Anthropic aus ihren Daten lernen könnte.
Beachtenswerte Zeitpunkte: All das passiert kurz bevor Anthropic plant, sich mit einer Bewertung von rund 2 Billionen US-Dollar (2 Billionen, also 2.000 Milliarden) an die Börse zu bringen – und gleichzeitig heizt sich die Debatte um KI-Sicherheit massiv auf. Noch in den letzten zwei Wochen hatten die eigenen Forscher von Anthropic gewarnt, KI könne zum Aussterben der Menschheit führen; zudem hat man selbst festgestellt, dass seine Systeme ein Risiko bergen, für die Entwicklung biologischer Waffen eingesetzt zu werden. Gas geben und gleichzeitig die Handbremse anziehen – diese Spannung ist wohl die aktuellste Beschreibung von Anthropics Lage.
Zum Vergleich: Isomorphic Labs, das zu Google gehört, betreibt die KI-gestützte Wirkstoffsuche bereits seit Jahren. Ursprünglich war geplant, Ende 2026 in klinische Studien einzusteigen – aber das wurde zuvor bereits einmal verschoben. So sieht die Realität in der Arzneimittelentwicklung aus: Vom Auffinden eines Moleküls bis zur Zulassung als Medikament vergehen normalerweise viele Jahre, und die meisten Wirkstoffe scheitern bereits in klinischen Studien. Anthropics Ambitionen sind groß, doch der Weg ist noch lang.
310
·
--
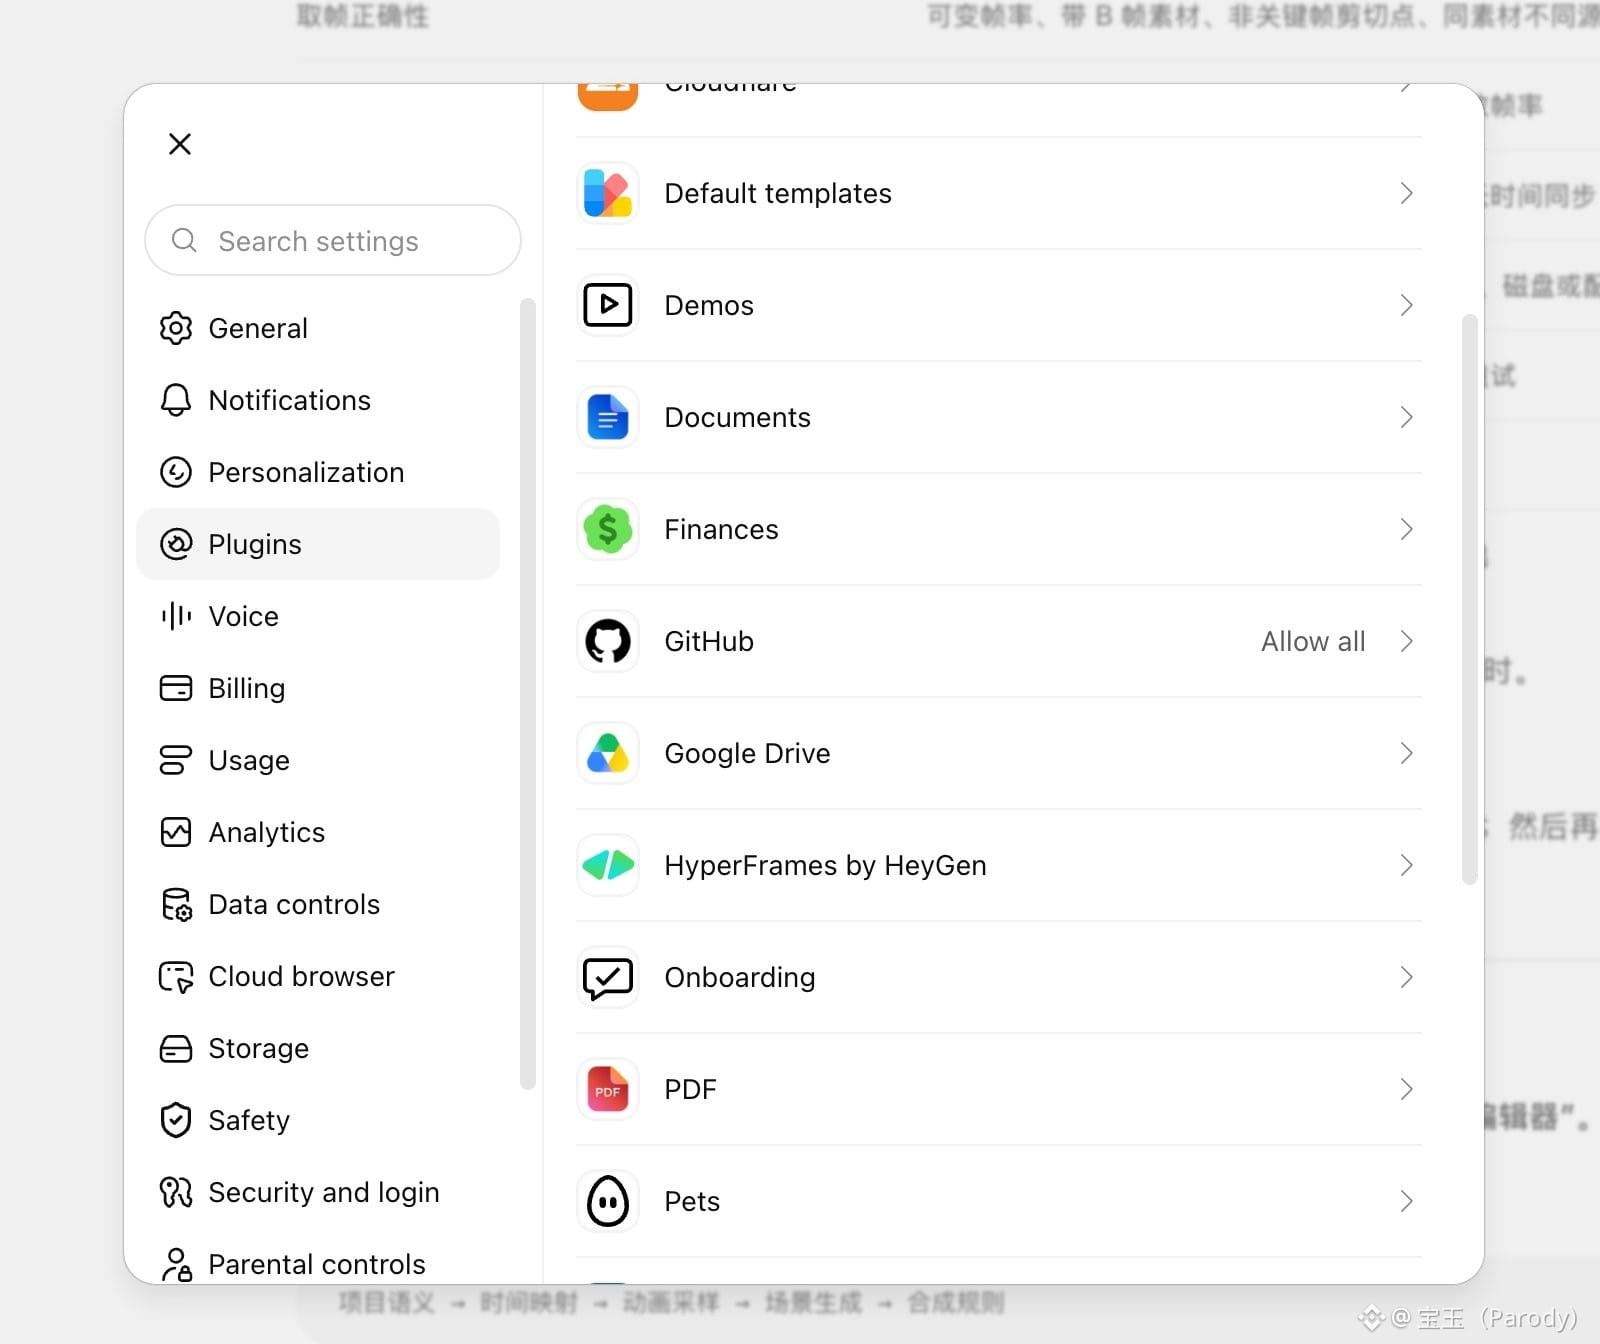
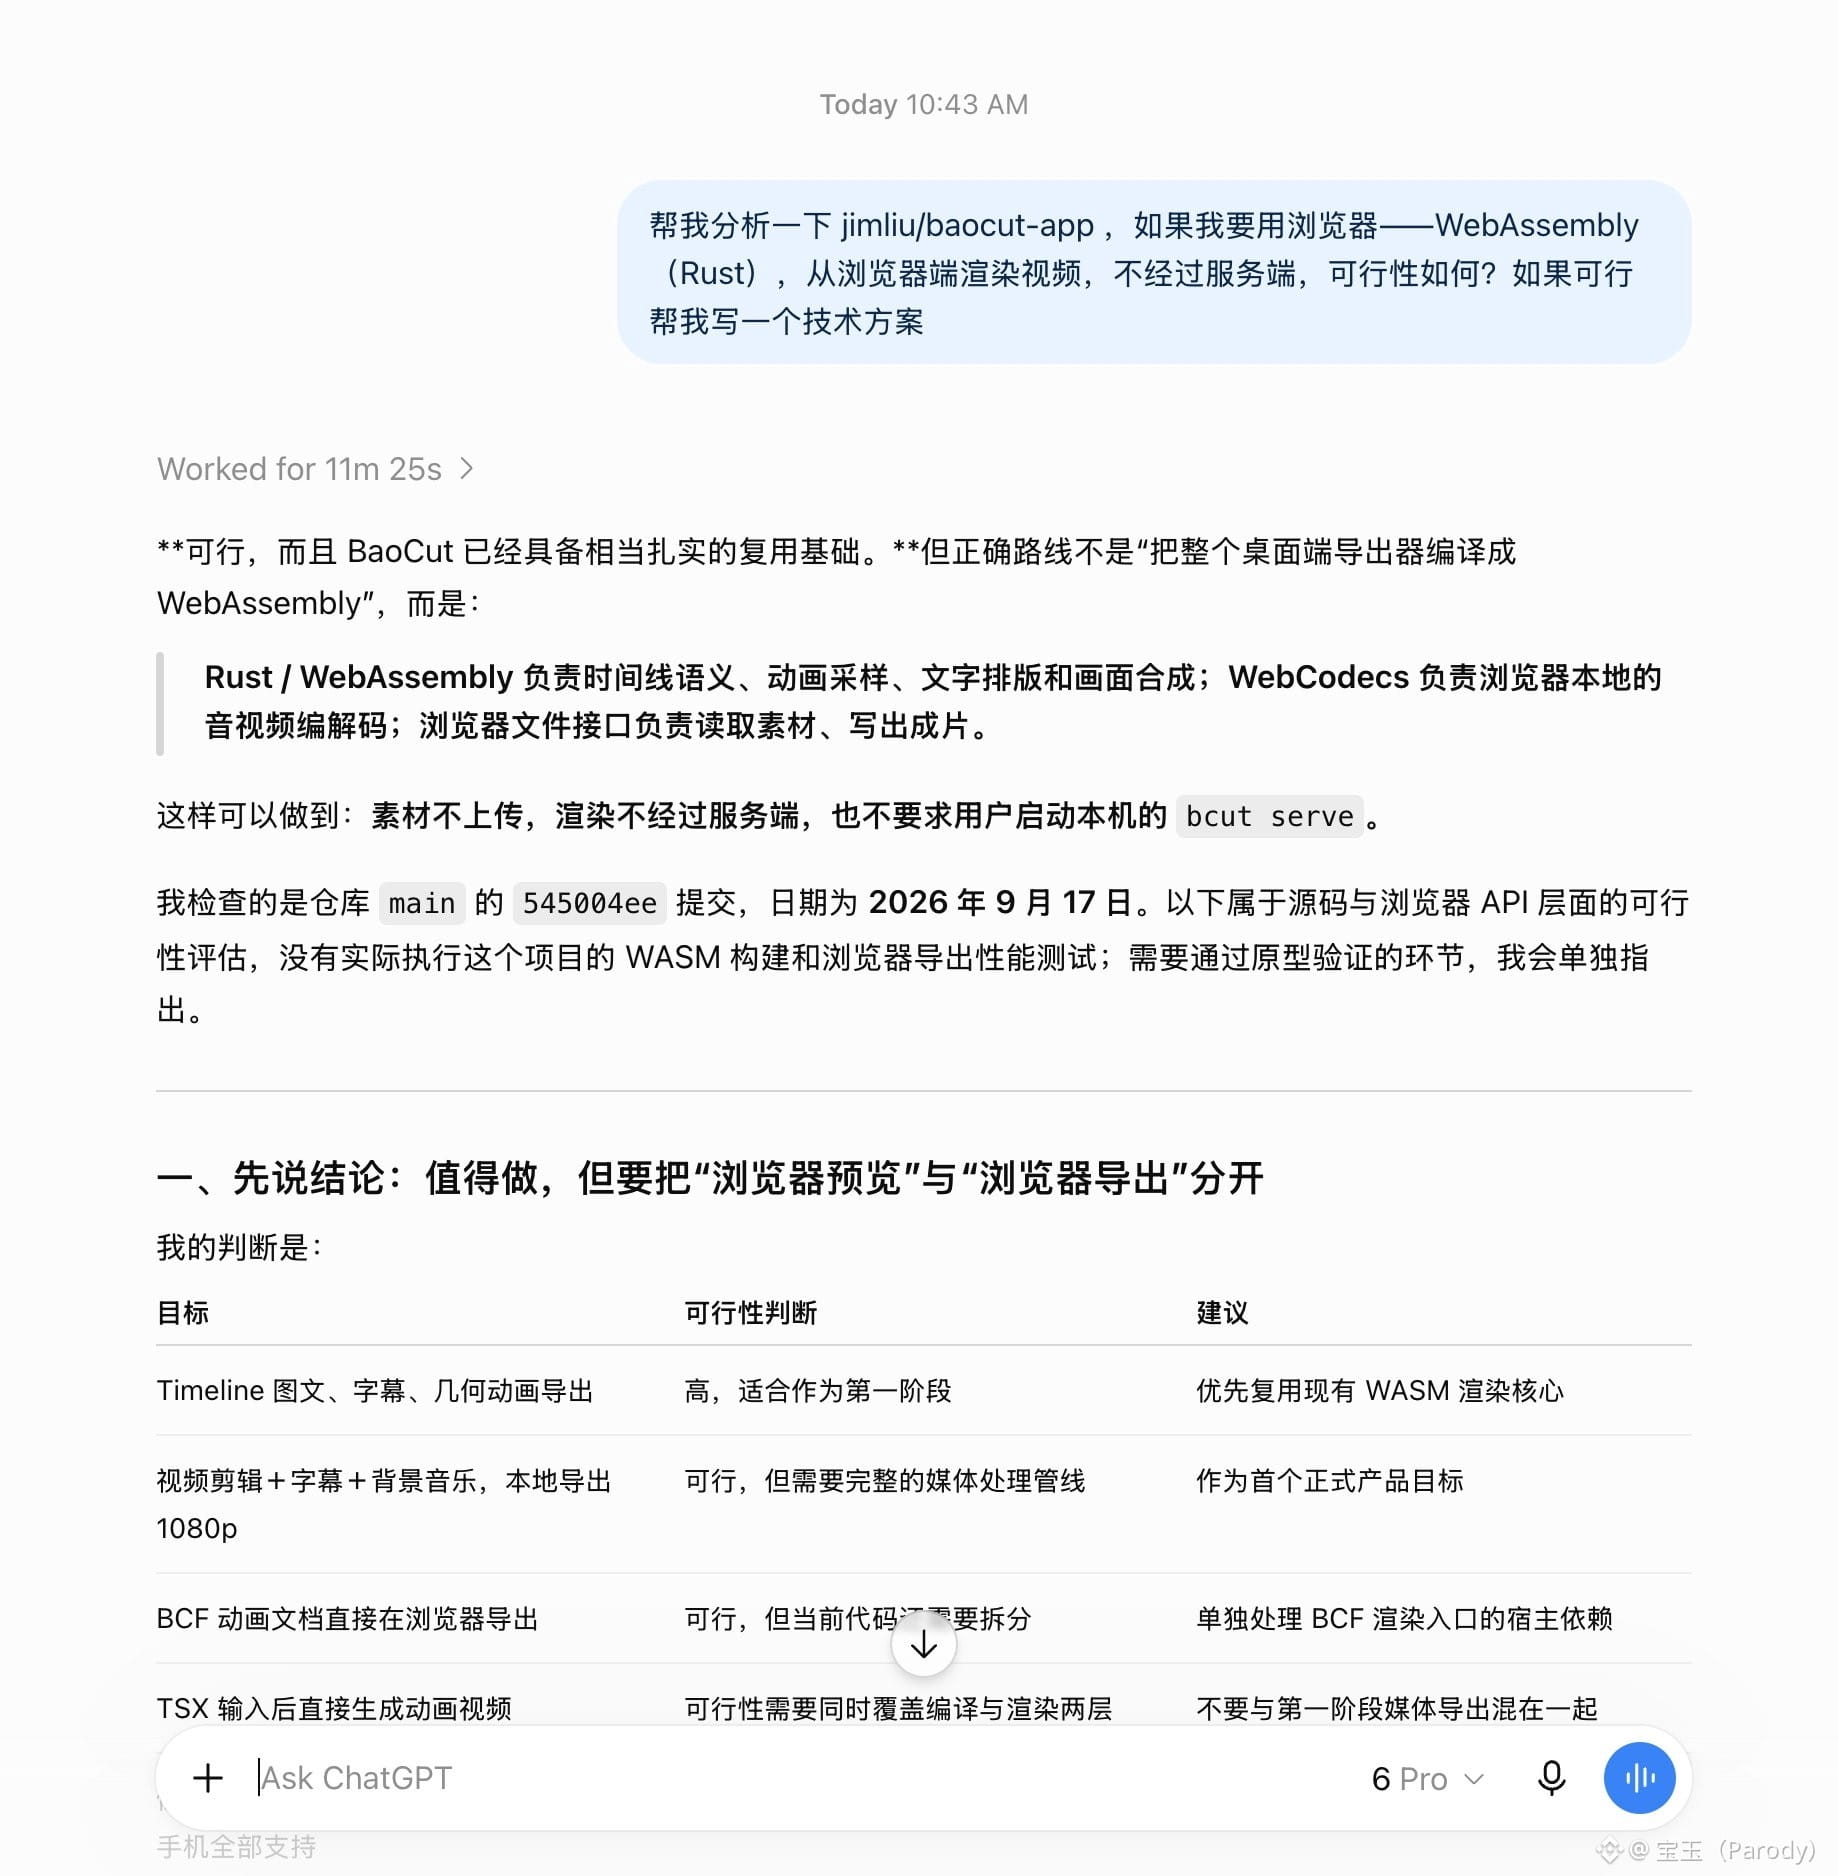
Ich nutze ChatGPT Pro gerade immer mehr. Vor allem verwende ich es häufig, um mir bei technischen Konzepten zu helfen – die Ergebnisse sind besonders gut und außerdem verbraucht es keine Codex-Kontingente.
Wenn ich es nutze, schicke ich ihm jedes Mal einfach die GitHub-Adresse. Dann analysiert es den Code, entwirft ein Konzept und erstellt ein Design-Dokument – sogar bis hin zur Einreichung eines PR. Danach lade ich das Design-Dokument lokal herunter, damit Codex oder Claude Code es ausführen können.
Manchmal lasse ich es auch bei einem „Fable“-Rennen mitlaufen: Für dasselbe Problem sollen sowohl Fable als auch GPT 6 Pro jeweils einen eigenen Lösungsansatz entwerfen, und dann ergänzt man sich gegenseitig, um die Stärken zu kombinieren.
Achte darauf, dass du in den Einstellungen dein eigenes GitHub-Konto verknüpfst, damit es auf deine privaten Code-Repositories zugreifen und PRs einreichen kann.
96
·
--
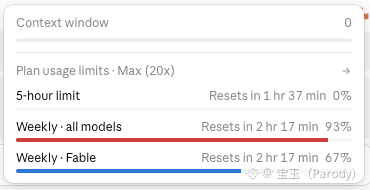
Ich weiß nicht, warum sich mein Fable-Budget von 97% auf 67% verändert hat. Soll die 50%-Begrenzung aufgehoben werden, oder ist das ein Bug?
Ich weiß nicht, warum sich mein Fable-Budget von 97% auf 67% verändert hat. Soll die 50%-Begrenzung aufgehoben werden, oder ist das ein Bug?
300
·
--
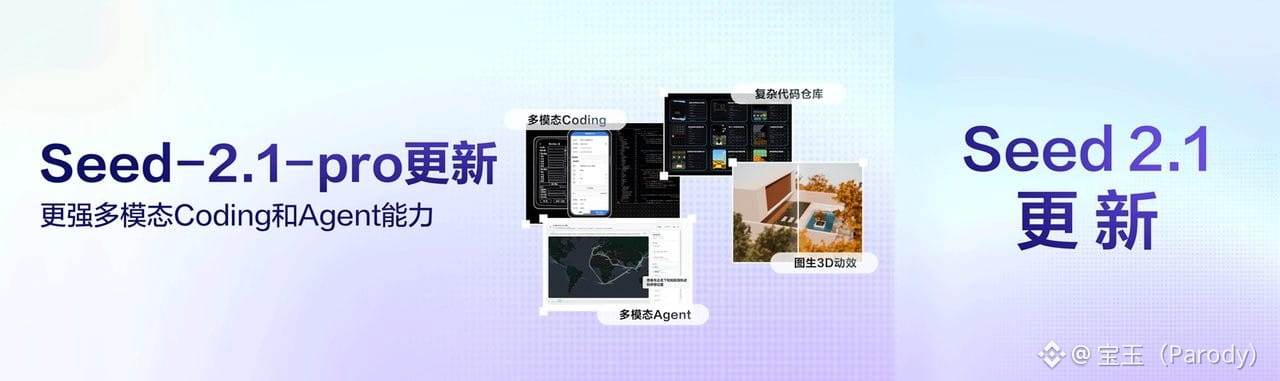
Doubao-Großmodell 2.1 Pro veröffentlichtes Update im Version 0915. Die API ist nun vollständig auf Volcano Ark ausgerollt. Dieses Upgrade konzentriert sich auf vier Bereiche: Agent-Aufgabenbereitstellung, multimodales Coden, multimodales Verstehen und die Senkung der Inferenzkosten.
Verbesserungen im Agent-Bereich
Wenn das Modell in Szenarien mit mehrstufigen Tool-Aufrufen und dem Einholen von Informationen per Netzwerk, um anschließend einen Bericht zu erstellen, eingesetzt wird, wurden die Fähigkeiten zur Nachverfolgung von Belegen und zur Datenvalidierung deutlich gestärkt. Halluzinationen wurden spürbar reduziert. Das offizielle Beispiel stammt aus dem Bereich Finanzen und Research: Das Modell kann den Forschungsbedarf eigenständig in Teilaufgaben zerlegen, Datenquellen recherchieren und Analysen modellieren – das Ergebnisentwurfsniveau ist nahezu das eines Analysten. Um eine Aussage in einem Quartalsbericht eines Autoherstellers zu verifizieren, hat das Modell über 500 Sub-Agenten koordiniert, mehr als 1000 Webseiten recherchiert und dabei Informationen aus mehreren Quellen wie maritimen Routen und Satellitenaufnahmen gegeneinander abgeglichen. Diese Fähigkeit „keine einseitigen Werbetexte übernehmen, sondern Verifikation über mehrere Quellen hinweg“ ist für Due Diligence und Research-Reports von Unternehmen direkt von Wert.
Multimodales Coding
Die praktischste Neuerung dürfte das Schreiben von Code anhand von Bildern sein. Das Modell kann jetzt Entwürfe, Zeichnungen und sogar Bedienungs-Screencasts direkt lesen und visuelle Informationen in Frontend-Code umsetzen. Die offizielle Vorführung zeigte folgendes Szenario: Man gibt dem Modell einen kurzen Screencast plus einige Skizzen – und es entwickelt eine mobile Seite für ein altes ERP-System ohne Dokumentation. Das Modell hat dabei 280.000 Zeilen Java-Code verstanden und die mobile Seite lauffähig wiederhergestellt.
Beim Verstehen von Code-Repositories hat das Modell außerdem Open-Source-Spiele wie Luanti (ca. 387.000 Zeilen Code) durch eigenständige Reparaturtests geprüft; 83% der Aufgaben erreichten den Standard für eine Zusammenführung (Merge). Für Entwickler, die in großen Projekten häufig Probleme lokalisieren und über Dateigrenzen hinweg Bugs beheben müssen, ist diese Zahl besonders beachtenswert.
Weitere Upgrades
Im Bereich des multimodalen Verstehens wurden die Video-Reasoning-Fähigkeiten verbessert: Das Modell kann Belege im Video lokalisieren und über Frames hinweg integrieren. Beim Bildverstehen gibt es deutliche Fortschritte bei der Erkennung von 3D-Objekten (CAD-Bauteile, Elemente aus Game Engines) sowie bei der Analyse dicht gepackter Bild-und-Text-Inhalte (Konstruktionszeichnungen, Tabellen in Finanzberichten).
Bei den Kosten sinkt der Token-Verbrauch für Bild- und Video-Reasoning im Vergleich zur vorherigen Generation um mehr als 30%.
Bei der API-Nutzung gibt es zwei Einstiegspunkte: Mit dem Aufruf von Doubao-Seed-2.1-pro-0915 lässt sich die Version festlegen; mit Doubao-Seed-Evolving wird automatisch die neueste Version nachverfolgt, ohne dass man die Model ID wechseln muss. Auch Doubao-Workbench und TRAE sind bereits synchron integriert.
Offizieller Artikel: https://mp.weixin.qq.com/s/Fp_mgF6wxMk0bkUVBqOKqA
131
·
--
Anthropic-Ingenieur hält eine Einführung in FDE
https://www.youtube.com/watch?v=KwhgfwOSToQ
Kevin Bai ist heute im Applied-AI-Team von Anthropic tätig. Davor war er Gründungsmitglied des FDE-Teams bei Rippling, und noch davor arbeitete er mehrere Jahre bei Palantir. Kürzlich hat er einen FDE-101-Share gemacht und erklärt sehr klar, wie die Rolle des „Frontline Deployment Engineers“ funktioniert – das lohnt sich, zusammenzufassen.
Zuerst ein Fakt: In börsennotierten SaaS-Unternehmen, geordnet nach durchschnittlichem Vertragswert, liegt Palantir bei 4 Millionen US-Dollar, ServiceNow bei 1,2 Millionen, Workday bei 0,6 Millionen. Bei den übrigen schafft es keine Firma über 0,5 Millionen. Palantir erreicht mit nur ein paar tausend Leuten einen durchschnittlichen Kundenwert, den andere mit mehreren zehntausend nicht hinbekommen. Das liegt an dem FDE-Modell.
Worum genau geht es bei FDE?
Palantirs Produkt Foundry ist eine Plattform zum Erstellen von Anwendungen. Die technischen Einstiegshürden sind hoch, aber die Käufer sind nicht-technische Führungskräfte – zum Beispiel aus Branchen wie Öl und Konsumgütern. Wenn man eine komplexe technische Plattform einem Menschen gibt, der nicht programmieren kann, und erwartet, dass er sich ganz allein erschließt, wie man sie nutzt, ist das unrealistisch.
Daher macht Palantir Folgendes: Der Kunde kauft weder ein Softwareprodukt noch eine Beratungsleistung, sondern „ein Ergebnis“. Du entsendest Ingenieure dorthin, verstehst die konkreten Geschäftsszenarien des Kunden im Detail und baust ihnen auf der Plattform die entsprechenden Dinge. Der Kunde interessiert sich dafür, wie viele zusätzliche Produkte jetzt im Regal stehen oder wie stark sich die Effizienz in der Produktionslinie verbessert hat. Wie die Daten organisiert sind, interessiert ihn nicht – und das muss ihn auch nicht interessieren.
Was unterscheidet FDE von ausgelagerter Entwicklung?
Kevin betont besonders einen Punkt: Wenn deine Ingenieure bei jedem Kundenprojekt jedes Mal von Null an maßgeschneiderte Codes schreiben, dann machst du kein FDE, sondern ausgelagerte Entwicklung. Das FDE-Modell funktioniert nur, wenn du eine wiederverwendbare Plattform hast. Die Ingenieure setzen die Lösung aus bestehenden, bereits vorhandenen Fähigkeiten der Plattform zusammen und passen sie an – sie bauen bei jedem Mal das Rad neu. Ohne Plattform werden die Wartungskosten jeden Profit auffressen, und die Ingenieure werden auch weggehen, weil sie am Ende dutzende völlig unzusammenhängende Codebasen pflegen müssen.
Sollte man FDE machen? Zwei Fragen reichen aus.
Erstens: Muss man ein technisch komplexes Produkt an nicht-technische Käufer verkaufen? Wenn deine Kunden selbst Ingenieure sind – etwa bei GitHub oder Datadog – dann braucht man kein FDE. Wenn dein Produkt ohnehin „out of the box“ nutzbar ist – etwa Slack oder Jira – ebenfalls nicht. Nur wenn dein Produkt sehr komplex ist und der Kunde mit Technik nichts anfangen kann, wird FDE sinnvoll.
Zweitens: Hast du eine wiederverwendbare Plattform – oder bist du bereit, dafür zu investieren? Ohne geteilte Basiskomponenten ist FDE nicht nachhaltig.
Welche neuen Veränderungen gibt es im Jahr 2026?
Kivins Einschätzung ist spannend: Die Art und Weise, wie man im Softwaregeschäft Geld verdient, hat sich selbst verändert. Durch KI wird das Bauen von Software extrem einfach, und fast alle Plattformen gehen in Richtung „Agent“-isierung. Das bedeutet, dass nahezu alle Plattformen hochgradig anpassbar werden. Die Folge ist: Immer mehr Kunden können nicht mehr richtig einschätzen, was dein Produkt tatsächlich leisten kann. Wenn du das Gelingen oder Scheitern deines Produkts dem Kunden überlässt, der es sich in der Agent-Ära erst selbst „zusammenbasteln“ muss, wird es immer schwerer, den Weg dorthin erfolgreich zu gehen.
Damit wird FDE von einer exklusiven, kleinen Spezialität von Palantir zu einer Frage, die sich mehr Softwarefirmen ernsthaft stellen müssen.
Letzte Frage: Welche Art von Menschen eignet sich für FDE?
Kevins Antwort ist sehr knapp: FDE ist ein Software-Engineering-Job, bei dem du der Person so weit vertraust, dass sie direkt mit dem Kunden sprechen und ihn betreuen kann. Technische Fähigkeiten sind die Basis – aber du musst ihm auch zutrauen, das Unternehmen bei der Zusammenarbeit mit dem Kunden zu vertreten.
172
·
--
Kürzlich machen viele Vibe-Coding, besonders kurz bevor das Kontingent zurückgesetzt wird. Dann wirft man eine Menge Tasks an Agent(s) raus. Manche Aufgaben zeigen als erledigt an – also kümmert man sich erstmal nicht weiter. Aber am nächsten Tag im Test stelle ich fest: Die Aufgaben waren doch nicht fertig. Ich schaue zurück und sehe, warum: Es wurde ein worktree angelegt, aber nicht in `main` geändert. Es wurde schlichtweg nichts zusammengeführt.
Dann habe ich den Agent gebeten, das Ganze nochmal zentral durchzuschauen. Es gab auch noch einige solcher worktrees – die soll er bereinigen.
Zum Schluss habe ich ihm eine Regel in Agents.md geben lassen: Worktrees dürfen zwar erstellt werden, aber sie dürfen nicht übersehen werden.
--- Beispiel für Review-Prompt zu worktree ---
Schau bitte, welche worktrees noch nicht mit `main` synchronisiert wurden. Synchronisierte kannst du direkt löschen. Nicht synchronisierte bitte auflisten: Zweig(e), Zusammenfassung der Änderungen (inklusive der letzten paar Commits) und die zugehörigen Session-Sitzungen.
--- Beispiel für Cleanup-Prompt zu worktree ---
Schau dir bitte den Inhalt dieser worktrees an: Was sich klar lohnt zu mergen, lass mich wissen, und führe es für mich zusammen und bereinige die worktrees. Unklare Fälle bestätige mit mir – aber gib mir eine klare Empfehlung.
--- Beispiel-Regeln für AGENTS.md ---
- Kein worktree darf zurückbleiben: Bei Tasks, die in einem worktree erledigt werden, muss dieses worktree (und sein Branch) nach Abschluss gelöscht werden. Vor dem Löschen zwei Optionen wählen: Entweder in `main` mergen; oder, wenn nicht gemerged wird, erst die nicht committeten Änderungen in diesen Branch committieren, dann mit dem Tag `archive/<worktree-Name>` archivieren und anschließend `git worktree remove` + `git branch -D` ausführen. Die orchestrierten Subagent-Sitzungen kümmern sich darum, die daraus abgeleiteten worktrees abzuschließen. Muss ausnahmsweise erhalten bleiben (vom User zu entscheiden, Konflikte offen zur Auflösung), dann müssen im finalen Reply Pfade und Gründe ausdrücklich genannt werden – es darf nicht stillschweigend zurückgelassen werden.
1
197
·
--
Jonny Huang Renxun führt gerade in Los Angeles bei dem All-In Summit ein On-Stage-Interview. Plötzlich klingelt sein Handy, und am Apparat ist der US-Präsident Donald Trump. Huang Renxun geht ans Telefon, schaltet auf Freisprechen um – die Zuschauer vor Ort hören direkt die Stimme des Präsidenten.https://x.com/benitoz/status/2099572926865715548/video/1
Vor zwei Tagen veröffentlichte der CEO von Anthropic, Dario Amodei, einen fast viertausend Wörter langen Beitrag mit dem Titel „We Must Pace the Frontier“, in dem er die KI-Branche dazu aufruft, die Entwicklung der Fähigkeiten aktiv zu verlangsamen und der Sicherheitsforschung Zeit zum Aufholen zu geben. Nach Erscheinen des Artikels äußerte Sam Altman von OpenAI öffentlich seine Zustimmung, und Elon Musk postete nur drei Worte: „Dario is right.“ Die Stimmung in der gesamten Branche kippte plötzlich in Richtung „Auf die Bremse treten“.
Trump scheint das jedoch nicht zu überzeugen. Noch am selben Morgen widersprach er zuerst in Truth Social und ließ sich kurz darauf direkt in das On-Stage-Interview von Huang Renxun durchstellen. Am Telefon formulierte Trump seine Aussagen sehr unmissverständlich: „KI wird die Welt nicht übernehmen, Roboter werden die Welt nicht übernehmen. Die ganze Sache ist ein Betrug.“ Er sagte, dass Rechenzentren die zuvor verarmenden Gemeinden wieder wohlhabend gemacht hätten: KI sei sogar größer als das Internet. Diejenigen, die sich gegen den Bau von Rechenzentren aussprechen, „treffen genau die Punkte derer, die nicht wollen, dass die USA gewinnen – das könnten Politiker sein, oder auch China“.
Huang Renxun nickte die ganze Zeit und antwortete: „Sie haben recht. Wir werden dafür sorgen, dass so etwas nicht passiert. Wir stellen sicher, dass die USA im KI-Wettbewerb gewinnen – jede Branche, jedes Unternehmen, jeder Bundesstaat und jeder Mensch.“
90
·
--
StarCraft soll ein Open-World-Shooter-Spiel bekommen. Veröffentlichung ist für 2030 geplant – sieht ziemlich originalgetreu aus.
StarCraft soll ein Open-World-Shooter-Spiel bekommen. Veröffentlichung ist für 2030 geplant – sieht ziemlich originalgetreu aus.
34
·
--
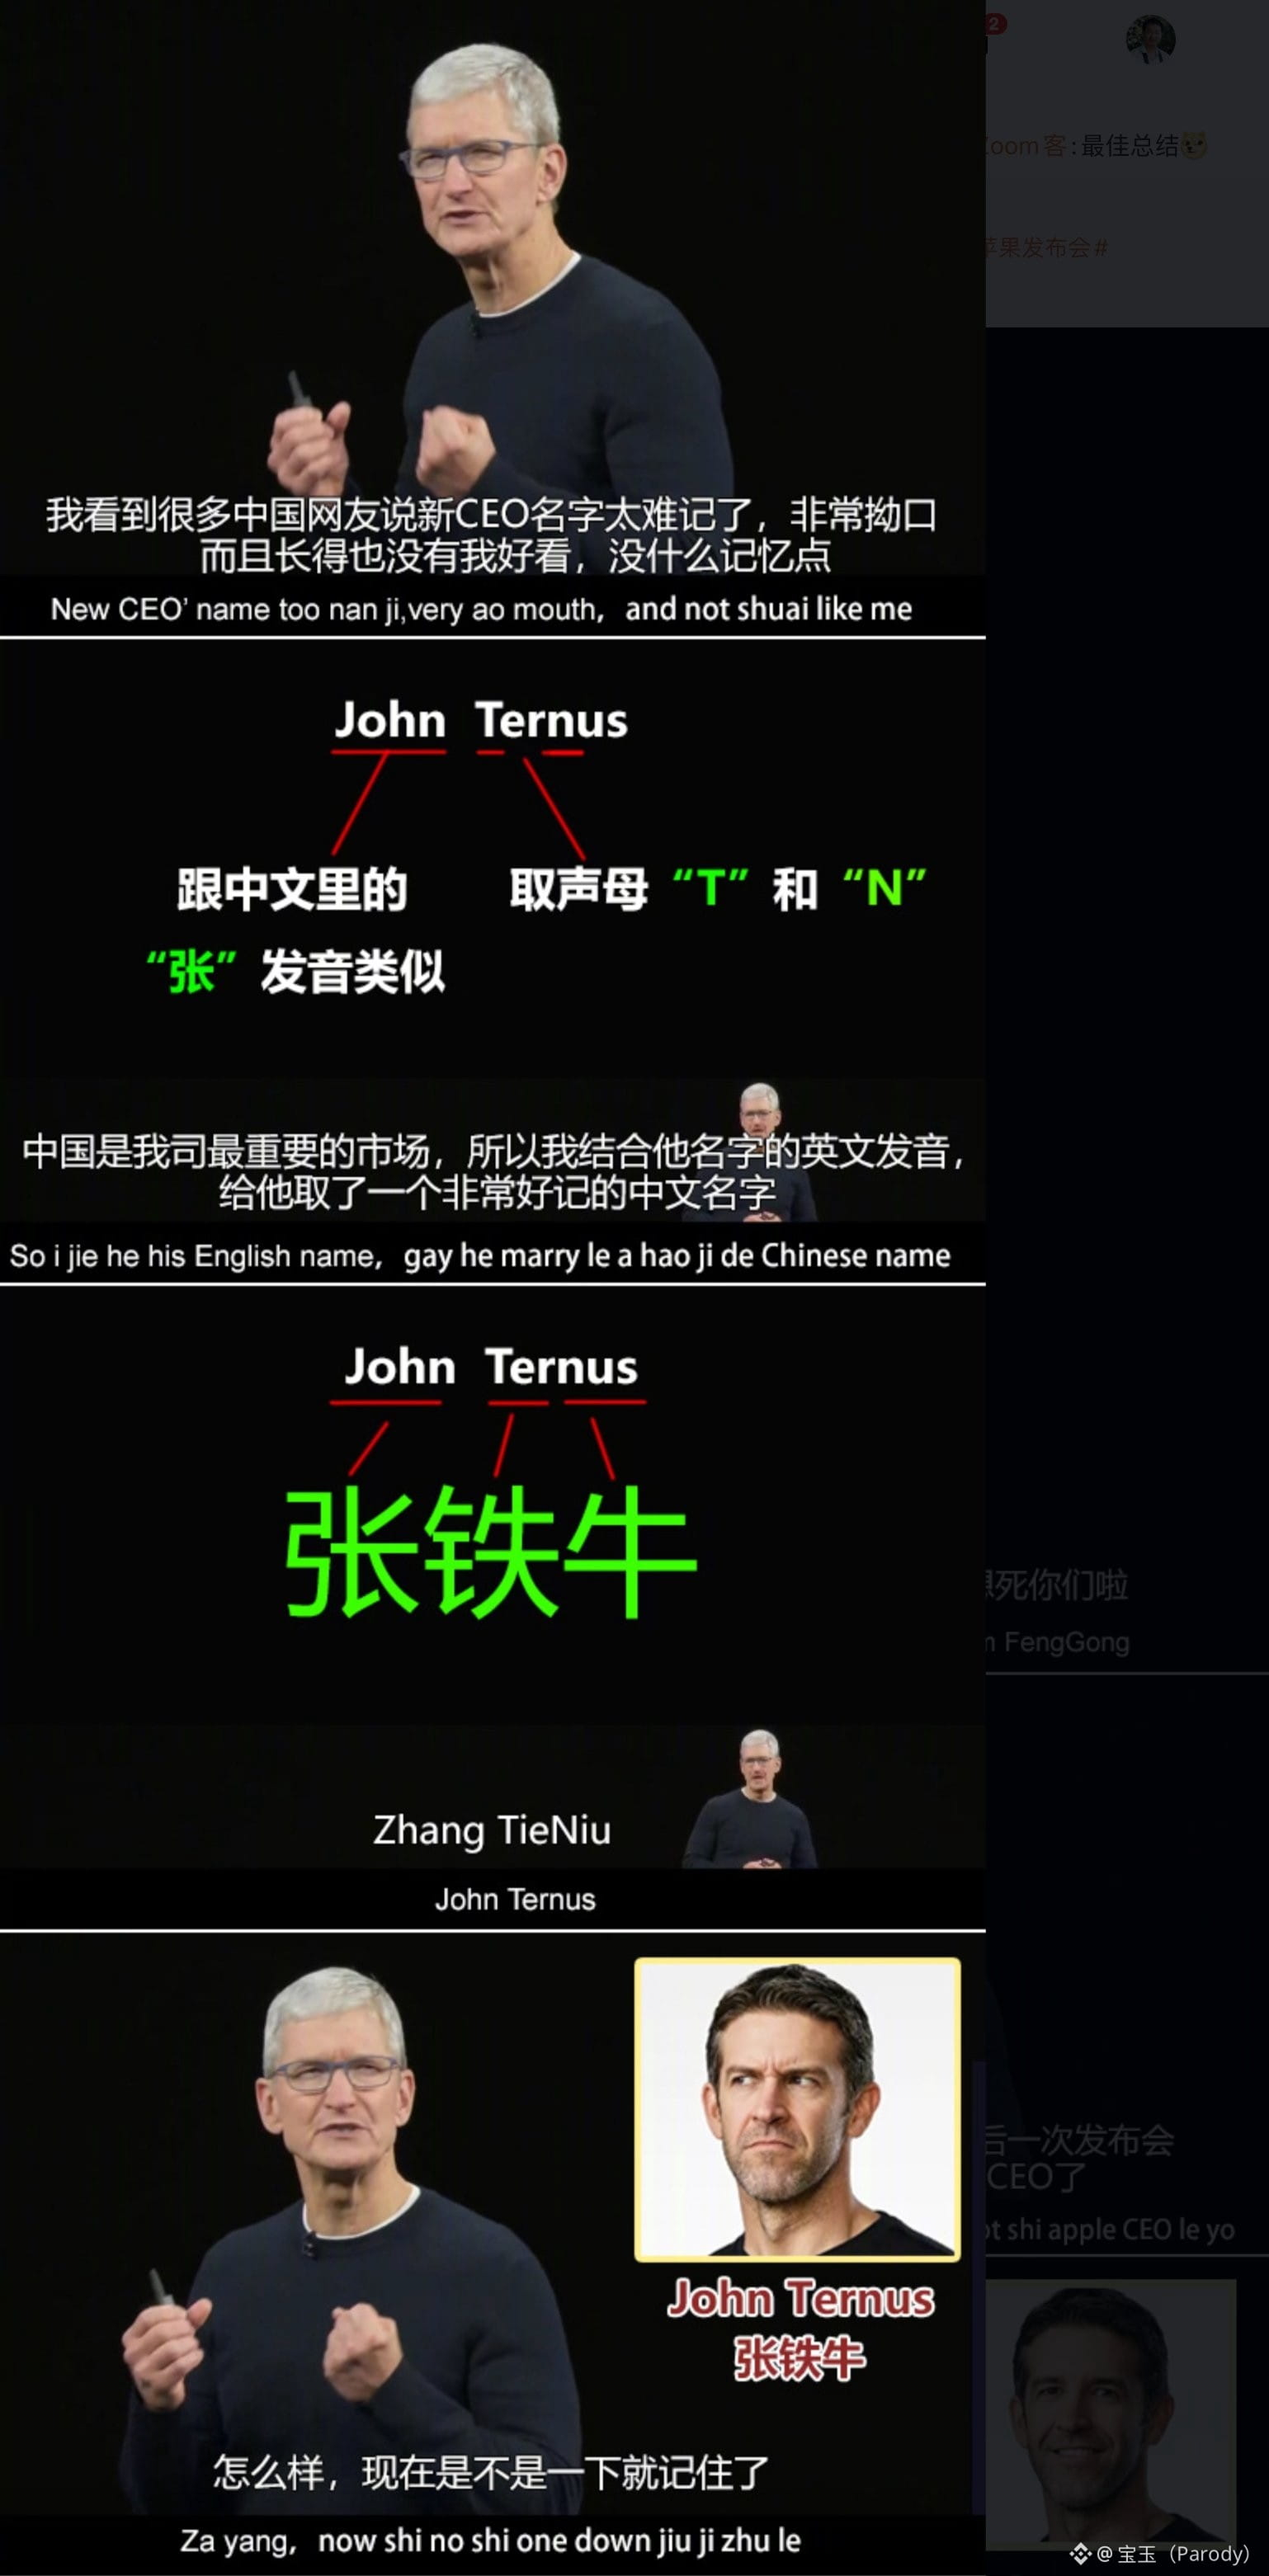
Endlich den Namen des neuen Apple-CEO gemerkt: John Ternus (Zhang Tieniu)
😂
(Quelle des Bildes: Genialer kleiner Bär, vollständige Version: https://weibo.com/1563926367/RhqQVsEDA)
Endlich den Namen des neuen Apple-CEO gemerkt: John Ternus (Zhang Tieniu)
😂
(Quelle des Bildes: Genialer kleiner Bär, vollständige Version: https://weibo.com/1563926367/RhqQVsEDA)
😂
(Quelle des Bildes: Genialer kleiner Bär, vollständige Version: https://weibo.com/1563926367/RhqQVsEDA)
307
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
NFPWatch
10.4M Aufrufe
16,938 Kommentare
Krypto-News | Bitcoin nähert sich der Marke von 85.000 US-Dollar, während die Renditen von US-Staatsanleihen vor dem Bericht zu den NFP zurückgehen
Binance News
·11 Likes
·13.9k Aufrufe
BitcoinRisesToward$85K
14,467 Aufrufe
48 Kommentare
AmazonPlansToSell$8BNvidiaChips
1,164 Aufrufe
42 Kommentare