Jemand hat einen „StarCraft“-KI-Duelltest gemacht (Brood War Bench), bei dem die gängigen Large Language Models gegeneinander in Echtzeit-Strategiespielen antreten. Das Ergebnis: Keines der Modelle erreichte ein Niveau über dem eines Anfängers.
„StarCraft: Brood War“ ist ein klassisches Echtzeit-Strategiespiel aus dem Jahr 1998 und seit Langem ein alter Bekannter der KI-Forschung. 2019 besiegte Googles DeepMind AlphaStar bereits Profispieler in diesem Spiel. Doch damals handelte es sich um speziell trainierte Reinforcement-Learning-KI. Dieser Test ist anders: Er lässt ein generatives Großmodell in Form eines KI-Agenten direkt loslegen und schauen, ob es selbstständig eine Basis aufbauen, Einheiten produzieren und Krieg führen kann.
Der Autor Ben Swerdlow wollte ursprünglich nur eine Version von StarCraft bauen, die „nur per Agentenbedienung“ gesteuert wird, um mit Freunden zu spielen. Doch einige Freunde, die kaum Erfahrung hatten, schnitten überraschend gut ab – sie sagten, sie hätten nur den einen Satz „Los, angreifen“ gegeben, und der Agent hätte dann selbstständig eine kleine Streitmacht gebaut und losgeschickt. Das machte ihn neugierig: Wenn man eine KI komplett selbst spielen lässt, wie weit würde sie kommen?
Die Antwort: ziemlich schlecht – aber es ist trotzdem ziemlich interessant.
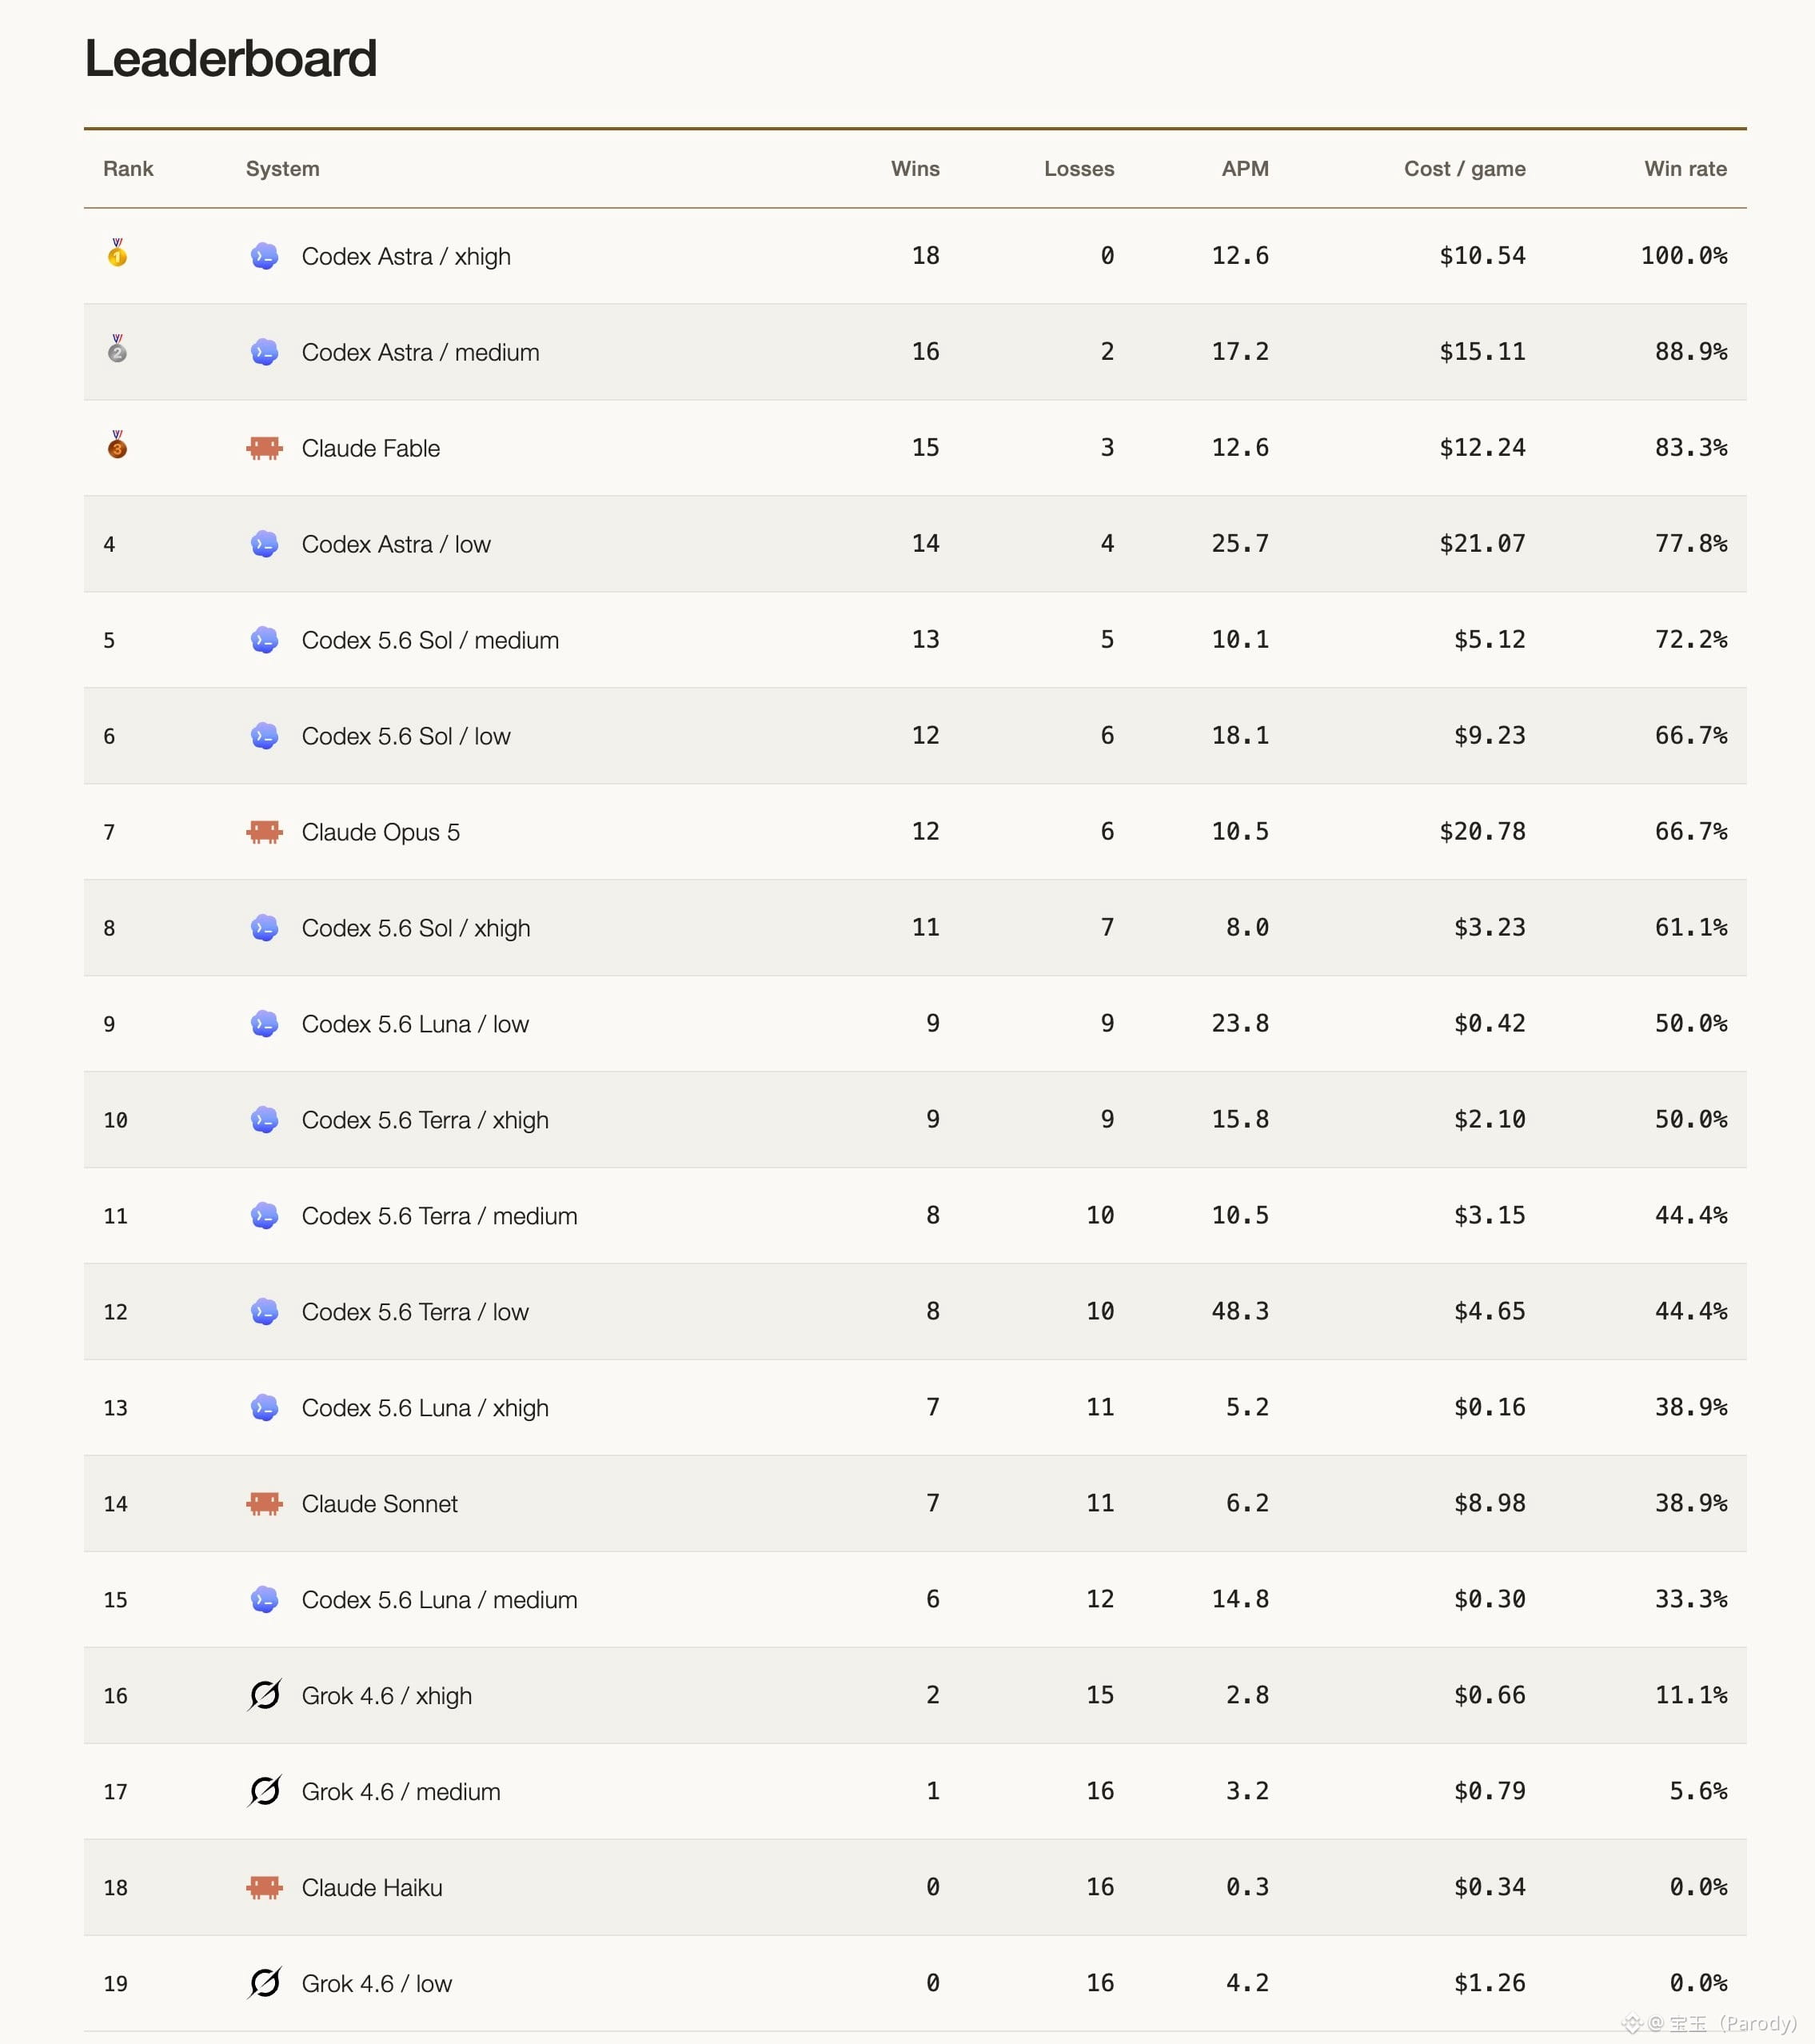
Der Erstplatzierte Codex Astra gewann alle 18 Partien, aber am besten ist es nicht im Frontalangriff, sondern im „Harassment“: Es schickt einen Arbeiter zum Minen (Probe) zum gegnerischen Basiscamp, um dort zu stören. Diese Taktik funktioniert gegen KI-Gegner besonders gut, weil der Agent des Gegners sieht, dass ein Arbeiter auftaucht, und dann dutzende Sekunden darüber nachdenkt, was zu tun ist, während er in der Zeit nichts macht. In puncto echter wirtschaftlicher Entwicklung und groß angelegter Gefechte ist Codex hingegen eher schwach: Es baut oft nur ein oder zwei Einheiten und wirft sie dann rüber, statt erst genug Streitkräfte zusammenzustellen und dann anzugreifen.
Claude Fable landete auf Platz drei, mit einer Siegrate von 83,3 %, und ist damit von allen teilnehmenden Modellen das „ernsthafteste“ beim Spielen. Es entwickelt brav die Wirtschaft weiter, steigt die Tech-Tree-Leiter hoch und hat in einer Partie sogar Flugdrachen (Mutalisk) gebaut, in einer anderen das Tech-Research für die Templer erforscht. Zwar passiert es manchmal, dass zwar jede Menge Entwicklung abgeschlossen wird, aber die Armee nicht nachzieht – dennoch ist Fable mindestens darin gewissenhaft, die Spielregeln zu „verstehen“, wie kein anderes Modell.
Grok schneidet am schlechtesten ab. Grok 4.6 gab in einem 43-minütigen Spiel über 11.000 Inferenz-Token aus, aber nur 6 Batches an Bedienungsbefehlen – im gesamten Verlauf hat es keine einzige Kampfeinheit gebaut. Im Kern behandelt es Echtzeit-Strategiespiele wie ein Rundenbasiertes Spiel: Es denkt die ganze Zeit nach, vergisst aber, loszulegen.
Dieser Test legt ein zentrales Problem offen: Die derzeitigen Large Language Models sind für Umgebungen, in denen fortlaufende Beobachtung, schnelle Entscheidungen und Multi-Thread-Koordination in Echtzeit nötig sind, bei Weitem noch nicht ausreichend. Selbst das beste Modell: Ein menschlicher Anfänger, der einen spielt wie „Photonenkanonen-Speedpush“ (eine der simpelsten Fast-Attack-Taktiken), kann damit alle Partien gewinnen. Umgekehrt betrachtet heißt das aber auch: Diese Modelle können die grundlegenden Konzepte von Bauen, Farmen und Angriff bereits verstehen – nur in der Umsetzung von Timing und der Koordination mehrerer Aufgaben sind sie noch weit entfernt.
Der Test-Code und die Austragungsplattform sind bereits freigegeben. Jeder kann seine eigenen Agenten mitbringen und eine Partie spielen. Die Adresse lautet http://bw.swerdlow.dev.
„StarCraft: Brood War“ ist ein klassisches Echtzeit-Strategiespiel aus dem Jahr 1998 und seit Langem ein alter Bekannter der KI-Forschung. 2019 besiegte Googles DeepMind AlphaStar bereits Profispieler in diesem Spiel. Doch damals handelte es sich um speziell trainierte Reinforcement-Learning-KI. Dieser Test ist anders: Er lässt ein generatives Großmodell in Form eines KI-Agenten direkt loslegen und schauen, ob es selbstständig eine Basis aufbauen, Einheiten produzieren und Krieg führen kann.
Der Autor Ben Swerdlow wollte ursprünglich nur eine Version von StarCraft bauen, die „nur per Agentenbedienung“ gesteuert wird, um mit Freunden zu spielen. Doch einige Freunde, die kaum Erfahrung hatten, schnitten überraschend gut ab – sie sagten, sie hätten nur den einen Satz „Los, angreifen“ gegeben, und der Agent hätte dann selbstständig eine kleine Streitmacht gebaut und losgeschickt. Das machte ihn neugierig: Wenn man eine KI komplett selbst spielen lässt, wie weit würde sie kommen?
Die Antwort: ziemlich schlecht – aber es ist trotzdem ziemlich interessant.
Der Erstplatzierte Codex Astra gewann alle 18 Partien, aber am besten ist es nicht im Frontalangriff, sondern im „Harassment“: Es schickt einen Arbeiter zum Minen (Probe) zum gegnerischen Basiscamp, um dort zu stören. Diese Taktik funktioniert gegen KI-Gegner besonders gut, weil der Agent des Gegners sieht, dass ein Arbeiter auftaucht, und dann dutzende Sekunden darüber nachdenkt, was zu tun ist, während er in der Zeit nichts macht. In puncto echter wirtschaftlicher Entwicklung und groß angelegter Gefechte ist Codex hingegen eher schwach: Es baut oft nur ein oder zwei Einheiten und wirft sie dann rüber, statt erst genug Streitkräfte zusammenzustellen und dann anzugreifen.
Claude Fable landete auf Platz drei, mit einer Siegrate von 83,3 %, und ist damit von allen teilnehmenden Modellen das „ernsthafteste“ beim Spielen. Es entwickelt brav die Wirtschaft weiter, steigt die Tech-Tree-Leiter hoch und hat in einer Partie sogar Flugdrachen (Mutalisk) gebaut, in einer anderen das Tech-Research für die Templer erforscht. Zwar passiert es manchmal, dass zwar jede Menge Entwicklung abgeschlossen wird, aber die Armee nicht nachzieht – dennoch ist Fable mindestens darin gewissenhaft, die Spielregeln zu „verstehen“, wie kein anderes Modell.
Grok schneidet am schlechtesten ab. Grok 4.6 gab in einem 43-minütigen Spiel über 11.000 Inferenz-Token aus, aber nur 6 Batches an Bedienungsbefehlen – im gesamten Verlauf hat es keine einzige Kampfeinheit gebaut. Im Kern behandelt es Echtzeit-Strategiespiele wie ein Rundenbasiertes Spiel: Es denkt die ganze Zeit nach, vergisst aber, loszulegen.
Dieser Test legt ein zentrales Problem offen: Die derzeitigen Large Language Models sind für Umgebungen, in denen fortlaufende Beobachtung, schnelle Entscheidungen und Multi-Thread-Koordination in Echtzeit nötig sind, bei Weitem noch nicht ausreichend. Selbst das beste Modell: Ein menschlicher Anfänger, der einen spielt wie „Photonenkanonen-Speedpush“ (eine der simpelsten Fast-Attack-Taktiken), kann damit alle Partien gewinnen. Umgekehrt betrachtet heißt das aber auch: Diese Modelle können die grundlegenden Konzepte von Bauen, Farmen und Angriff bereits verstehen – nur in der Umsetzung von Timing und der Koordination mehrerer Aufgaben sind sie noch weit entfernt.
Der Test-Code und die Austragungsplattform sind bereits freigegeben. Jeder kann seine eigenen Agenten mitbringen und eine Partie spielen. Die Adresse lautet http://bw.swerdlow.dev.