

花儿不在
17 Публикации
花儿不在
Отправить жалобу
Заблокировать пользователя
2 подписок(и/а)
5 подписчиков(а)
3 понравилось
Посты
·
--
См. перевод
#opg $OPG
今天必须得唠唠OpenGradient——不是因为它画饼画得圆,是因为币安HODLer空投今天刚上线。我翻了一下午白皮书,发现这项目确实有点东西
先说技术。如果让链上每个节点都去跑一遍大模型,网络直接瘫痪。OpenGradient白皮书里有句原话特别实在——“让每个验证节点独立重跑模型推理是不切实际的”。所以他们搞了套混合AI计算架构(HACA) ,把“执行”和“验证”彻底分开。推理节点用GPU和TEE跑模型、干重活;全节点只管验证TEE认证和ZKML证明、记个账。你不需要重跑一遍模型,只需要验证它跑对了。验证节点可以很轻量——就这么一个简单的认知转换,把性能和信任全解决了
再说产品。他们家那个Opg Chat,能直接用ChatGPT、Claude、Gemini、Grok这些模型,还能生成图片、传文件。关键是设备端加密——信息在离开浏览器之前就本地加密了,密钥只在你设备上。经过Oblivious HTTP中继时,中继能看到你的IP但只有密文;下游网关能看到明文但永远看不到你的IP。到了TEE隔离网关里才解密处理。而且TEE带远程认证,你可以自己验证这些隐私承诺。这相当于给你配了辆全封闭的超级运钞车——除了你自己,没人知道里面装了啥。Opg Chat上线两周已经服务超200万用户,处理了200多万次可验证推理。Model Hub上还集成了2000多个模型
在算经济账。OPG总量10亿枚,流通约1.98亿枚。a16z crypto领投、Coinbase Ventures、SV Angel、Foresight Ventures等24家机构累计投了950万美元。币安第66期HODLer空投今天刚上线。但我也得说句实在话——空投是机会,可别光盯着糖果忘了脚下的荆棘。当前价格$0.15左右,全流通市值(FDV)超1.5亿美元,80%的代币还没解锁呢。项目还在测试网阶段,技术没大规模验证
我的结论很简单——技术叙事能打,空投机会真实,但80%未解锁的代币是悬在头顶的剑 @OpenGradient
1
127
·
--
См. перевод
昨晚翻OpenGradient的文档翻到凌晨一点。看到"异步验证"四个字的时候,条件反射般地按了Ctrl+F,输入"验证失败"。
0 results。
又试了"failure"、"settlement"、"rollback"。全都没有。
HACA的设计其实很聪明。传统区块链让每个验证者重跑每笔交易,AI推理又贵又非确定,根本跑不动。OpenGradient的解法是把执行和验证拆开:推理节点跑模型,毫秒级返回结果;全节点异步验证TEE证明。验证节点不需要知道prompt是什么、模型是什么,只需要确认代码在飞地中未被篡改。
问题恰恰出在这儿。官方文档写得清楚:TEE证明验证的是"enclave was not tampered with",不是结果本身对不对。推理节点完全可以在TEE里"正确"跑完模型,返回一个错误结果——证明照样过。文档承认有"临时的信任缺口",但这个缺口怎么补,只字未提。$OPG
Gate学院有篇文章提到"验证失败,结果将被拒绝或重新计算"。可重新计算的钱谁出?已经执行的交易怎么回滚?官方文档里连个TODO都没留
你看看DeFi,验证失败有清算和罚没兜底;再看看乐观Rollup,有挑战期和欺诈证明。OpenGradient把"先出结果、后验证"当卖点,烂摊子谁来收拾——目前看是用户自己扛。#OPG
架构方向没问题。但在主网经济模型完整公布、验证失败处理机制写进文档之前,这笔账我得先算清楚。@OpenGradient
1
78
·
--
Не гадите, меняют ли вам в бэкэнде большую модель на более дистиллированную — я сам на этом попался. Я две недели настраивал промпты: после релиза результат то взлетал, то падал. Платформа клянётся в груди, что версии совпадают, но у вас даже нет способов доказать свою невиновность.
Способ OpenGradient, чтобы прорваться, без иллюзий: рассуждения запускают в CPU TEE — защищённой безопасной зоне. В чём сила этой «клетки»? Когда вычисления стартуют, даже root-админ у облачного провайдера не может сорвать занавес и получить доступ к данным: ввод и вывод изолированы на физическом уровне. Но это решает только половину задачи — как гарантировать, что запускают GPT‑4, а не GPT‑3.5? Они заранее «вшивают» хэши весов модели в цепочечный Registry. После инференса железо выплёвывает аппаратную подпись-сертификат; если «шифры» не совпадают, всё сразу аннулируется. Выполнение — выполняют, аудит — аудитят: двойная взаимопроверка, не хватает одного шага — всё, крах. $OPG
OPG в этом замкнутом контуре — как «счётчик». Каждую попытку вызова он списывает автоматически через протокол x402, а разработчику подключить Python SDK — и всё, не нужно разбираться ни в каких подписях и проверках. В чём ценность OPG? Нечего недооценивать: сегодня сеть обрабатывает 100 тысяч инференсов — значит, проходит 100 тысяч оплат; 1 миллион — и оценка мгновенно становится «твёрдой валютой», растёт вдвое. Эта логика оценки — намного более хардкорная, чем у MEME‑коинов, которые просто рисуют презентации: #OPG
Сравните с рынком: централизованные API целиком полагаются на доверие; zkML проверяет шаг и это всё занимает три секунды — в коммерческом сегменте это сразу отпугивает. OpenGradient выбрал компромисс: жертвуют экстремальной централизацией ради максимальной децентрализации, взамен получают верификацию на уровне миллисекунд. Не надо мне рассказывать про «идеальную децентрализованную AI» — когда эта штука реально начнёт вместо людей выдавать кредиты и управлять частными фондами, «проверяемость» будет не плюсом, а обязательной дверной карточкой. Кто первым удержит в руках доказательство чистоты на уровне железа, тот и зажмёт горло следующему поколению финансовых AI. Болтовню с концепциями — в сторону.
@OpenGradient
82
·
--
См. перевод
99%的人把质押当存钱罐,但@OpenGradient 白皮书第4.3节有一行被划过去的“魔鬼细节”——错误证明罚没(Slash)。读到这里我后背发凉:质押根本不是生息工具,而是AI推理的“信用保险金”。
验证者质押OPG,不是在挖矿,是在给网络写“欠条”:我对这次验证负责,错了,真金白银赔。OpenGradient每一次AI推理返回结果,背后都有人在用资产担保它的准确性。
对比传统AI就扎心了。 OpenAI、Claude、Gemini,全建立在“无成本证词”之上——模型没篡改?硬件没问题?全靠口头承诺。OpenGradient把道德约束换成了经济约束,把“我相信你”变成了“你不敢骗我,因为骗我有成本”。
这引出一个多数人没算过的供应侧推论:
质押中的OPG退出需要解绑期,Slash风险悬顶时,轻率退出的机会成本比留着更高。所以链上那批OPG,不是因为持有人看好,是因为被机制焊死在那里——被动锁仓和主动持有,是两码事。
如果Slash真实运行,OPG的供需模型将彻底重构:网络越繁荣→验证者需求越多→被责任锁死的筹码比例越高→自由流通盘越稀缺。这是一个非线性的通缩斜率。
当然,风险也摆在那: 验证者节点是否真实增长?Slash是否真实发生?这两组数据目前还是黑盒。但市场往往在“看不清”的时候定价最狠。
当别人还在卷TEE和ZKML技术名词时,聪明钱已经开始计算罚没机制带来的天然买盘压力。质押量决定网络的安全上限,而安全上限决定估值天花板——这个叙事,比单纯的AI Meme硬核十倍。
方向对了,数据会说话。静待验证者地址公开的那天。$OPG #opg @OpenGradient
1
94
·
--
См. перевод
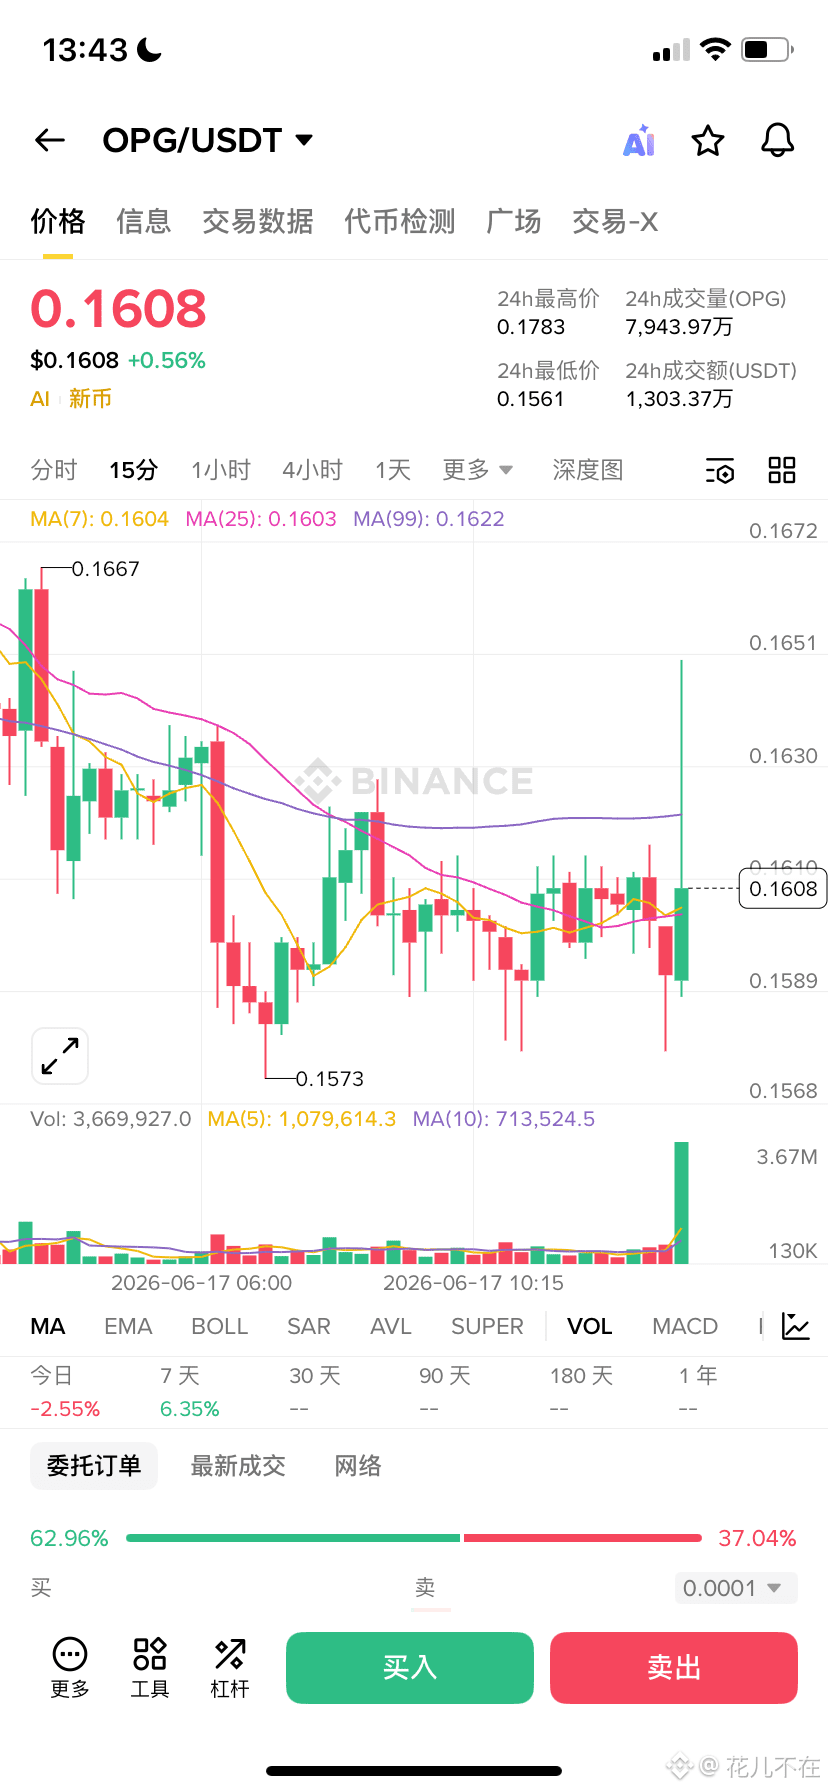
#opg $OPG 周末在咖啡店被店员安利“隐藏菜单”,满怀期待点了一杯——不过是普通拿铁加了焦糖糖浆。这让我想起币圈那些号称“AI革新”的项目,大多只是给大模型套了个发币的壳。但深度体验@OpenGradient后,确实让我改观不少。
它的HACA混合AI计算架构打破了我对“区块链+AI=慢”的刻板印象。 传统区块链靠每个验证节点重复执行每笔交易达成共识,跑大模型在计算上完全不可行。HACA将网络拆分为三个专业角色:推理节点跑模型并生成可验证证明,全节点只验证证明的密码学有效性,数据节点获取可信外部输入。用户先拿结果,验证和结算异步完成——既保住Web2级速度,又锁死链上信任。
更让我觉得“真不一样”的是它的隐私设计。 OpenGradient Chat处理敏感信息时,消息在浏览器端就完成加密,密钥只存在你的设备上;通过Oblivious HTTP匿名中继后,在TEE可信环境中解密处理——运营方既看不到你是谁,也读不懂内容。对比ChatGPT们拿对话喂模型的套路,这才是真正的“架构级隐私”。
数据印证落地速度:4月上线Base以来,已托管超2000个模型、验证超50万份证明、处理超200万次推理。但我心里始终有个结:AI的“黑盒幻觉”与区块链的“透明契约”天生冲突。若模型推理出错,链上自动决策的风险谁来担?目前我只拿小仓位参与观望,既不盲目押注,也不愿错过。
当AI既能极速服务又能锁死隐私,它会是巨头的劲敌,还是一场技术豪赌?且看它下一步怎么解题@OpenGradient
88
·
--
#opg $OPG 代价异步结算的@OpenGradient OpenGradient x402机制下被转嫁的节点资金效率风险
Opg的x402支付协议常被包装为“Web2级低延迟”体验,但其核心机制暗含结构性缺陷:异步结算模式将资金效率与价格波动风险完全转嫁给算力节点,在商用批量推理场景下存在先天不适配
机制拆解:预授权≠即时结算 用户发起推理前通过Permit2完成链上预授权,批准OPG额度给结算合约;节点消耗GPU算力返回结果后,OPG代币的正式扣款与划转才在Base链上异步完成。执行与结算在时空上被彻底剥离——节点“先干活”资金“后到账”
对比基准:前置扣款vs后置结算的范式冲突。AWS、GCP等主流云平台均执行“资金到位,算力启动”,或预冻结余额,或实时扣费;去中心化竞品也多采用“预付充值、按秒扣费、余额耗尽即停机”的硬约束。x402的Permit2预授权仅解决“防用户跑单”,却回避了“钱在路上”的账期与汇损问题,本质是将流动性杠杆强行加给硬件提供者
量化视角:三重压力下的收益侵蚀。 面向B端批量推理时:Base链结算拥堵致资金到账窗口延长至12-15个区块(约3-5分钟)此窗口内OPG价格波动带来0.5%-2%的隐性滑点;月均10万次推理的中型节点,未到账资金日均沉淀约5000枚OPG,折算链上借贷成本,每月侵蚀4%以上净利润。GPU电费与折旧是刚性支出,收入却存在不确定延迟,节点现金流安全边际被持续压缩
破局推演:协议层必须补齐的“解药”。 若要保持算力供给稳定,x402须引入动态汇率锚定机制(如按5分钟TWAP均价结算),或设立节点流动性预支池对冲账期风险。否则,Web2级的响应速度与Web3级的结算摩擦之间,终将形成算力供给失血的“成本无底洞”。先服务、后结算,看似保障用户体验,实则将财务风险全额转嫁——这套经济设计的长期可持续性,值得每个算力提供者审慎重估
1
1
80
·
--
См. перевод
#opg $OPG
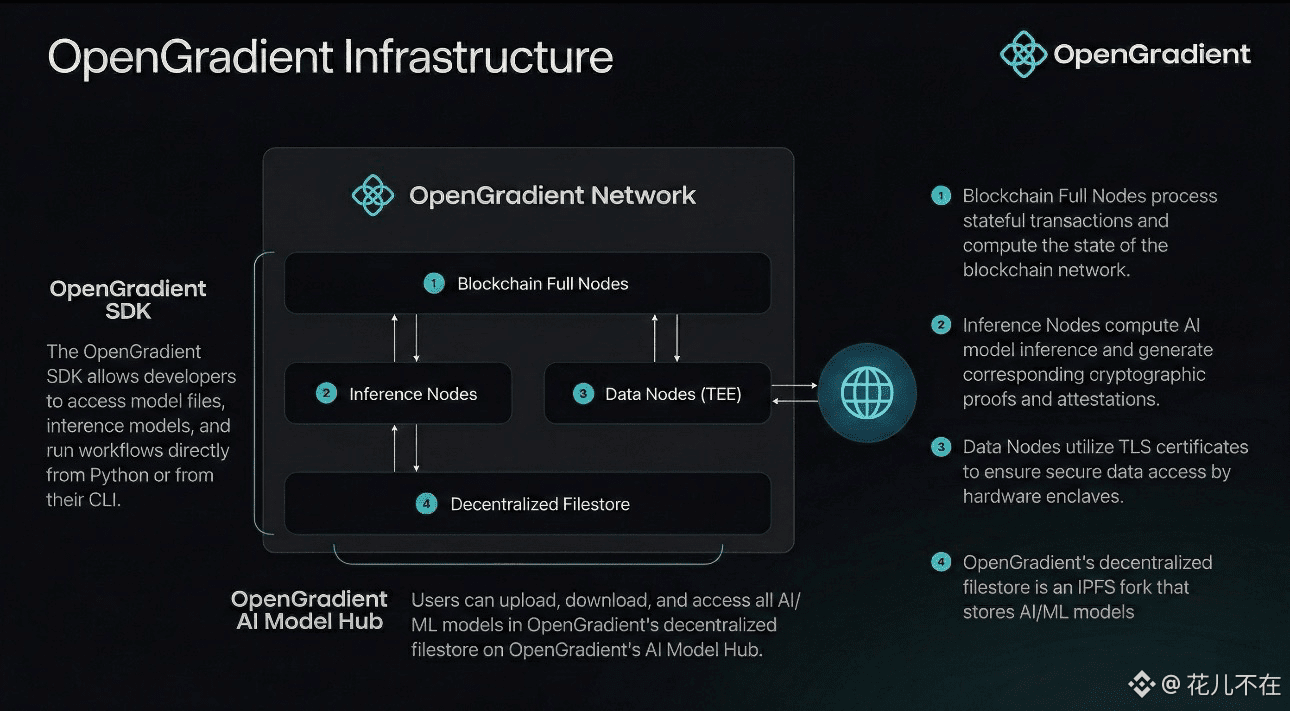
咱今天不扯虚的。OpenGradient那玩意儿,我最近才整明白。以前一看什么全节点、零知识证明,脑袋嗡嗡的,觉得离咱太远。但耐着性子扒了扒它底下怎么跑的,嘿,说白了就是一群较真儿的老会计给你当门神。网络里随便哪台机器跑个AI模型,甭管是推理还是训练,出了结果,你得把账本交到那帮全节点手里。这帮人手里攥着密码学公式和TEE硬件报告,一条条给你对,对不上?直接大喇叭全网广播,把你作弊那点破事抖搂得干干净净。而且他们之间还互相喊话对账,生怕漏了哪个细节。传统那些大厂,数据出岔子,顶多发个道歉信,让你接着信他人品。搁这儿?人品不好使,数学说你不合规,你找谁哭都没用,全节点就是不盖章,没跑。
你肯定得问,全节点自己要是使坏呢?人家不傻,得上质押,锁一大笔OPG代币才能上岗。系统天天盯着,谁要是敢监守自盗或者偷懒,查出来直接罚没你的筹码,肉疼不?反过来,查账查得勤快,把作弊的揪出来,系统奖励OPG,明码标价,谁跟钱过不去?这套玩法高明在把人情世故全踢一边,全靠利益和数学互相咬合。普通用户压根不用自己花几万块配高配机器当节点,您就前端调用,底下那帮倔驴替您把着关,踏实得很。我试过几次,确实不用求爷爷告奶奶,直接调用,结果嘎嘎准。
以后AI处理敏感数据,靠这群咬住细节不放的节点兜底,比什么CEO拍胸脯都硬气。用数学盖章代替口头承诺,这路子,对胃口。而且这帮节点为了赚OPG,查得比谁都细,你想糊弄?门儿都没有。我就喜欢这干净利落的劲儿,不用看谁脸色,全靠算法和硬件较真儿。你说,这比那些天天喊“透明”却啥也看不见的项目强多了吧?反正我以后用AI就认准这种底层,心里踏实。@OpenGradient
67
·
--
См. перевод
#opg $OPG 你有没有想过,每次调用一个AI风控模型,真正危险的其实不是它“读”你的输入,而是它去后台取数据的那一瞬间?
我做过系统运维,见过太多日志里明晃晃地躺着用户ID、账户余额、最近几笔交易的触发原因。排查问题嘛,免不了翻请求参数和返回结果,可翻着翻着,一些不该看的东西就进了眼。这不是谁坏,是架构本身就没把“取数”当回事——应用服务器一手握着接口权限,一手把数据喂给模型,中间所有痕迹全留在普通日志里。外部数据源越多,这摊水就越浑,运维人员不知不觉就成了隐私的隐形观察者。
OpenGradient 的 Data Nodes 切的就是这个入口。它不是简单加个代理,而是把“拉数据”这个动作单独拎出来,塞进一个隔离的执行环境里。任务只告诉它“去查什么”和“按什么规则查”,真正的读取在 TEE 里头完成——那个环境连主机操作系统都插不进手,节点运营者想翻日志?翻到的全是乱码
但这还不够。我最在意的是它怎么证明自己没换料。Data Node 返回数据时,会附带一份远程认证凭据,相当于一个加密的“收货单”,写着:这份数据是某时某刻在指定环境里按指定条件取的。后面的推理节点拿着数据干活,验证节点只检查这张单子真不真。想偷换数据?单子对不上,全链驳回。验证的人自始至终不用看明文,这才是闭环
这套东西解决了一个很实在的困局:实时数据用越多,造假空间就越大;权限越集中,信任就越脆弱。以前我们靠“相信运维不会偷看”,现在把信任替换成可验证的流程——取数有隔离,结果有证明,追责有依据。隐私不再是一句承诺,而是被拆进架构里的硬条件。就这么简单@OpenGradient
81
·
--
См. перевод
#opg $OPG 上次让AI帮我算笔定投收益,结果它把年化瞎翻了一倍,我差点头脑一热全仓冲进去。后来才反应过来,这玩意儿背后咋算的,我压根没地儿查,跟个黑箱似的。所以看到OpenGradient要砸箱子搞透明,我这种被坑过的新韭菜第一个想鼓掌。
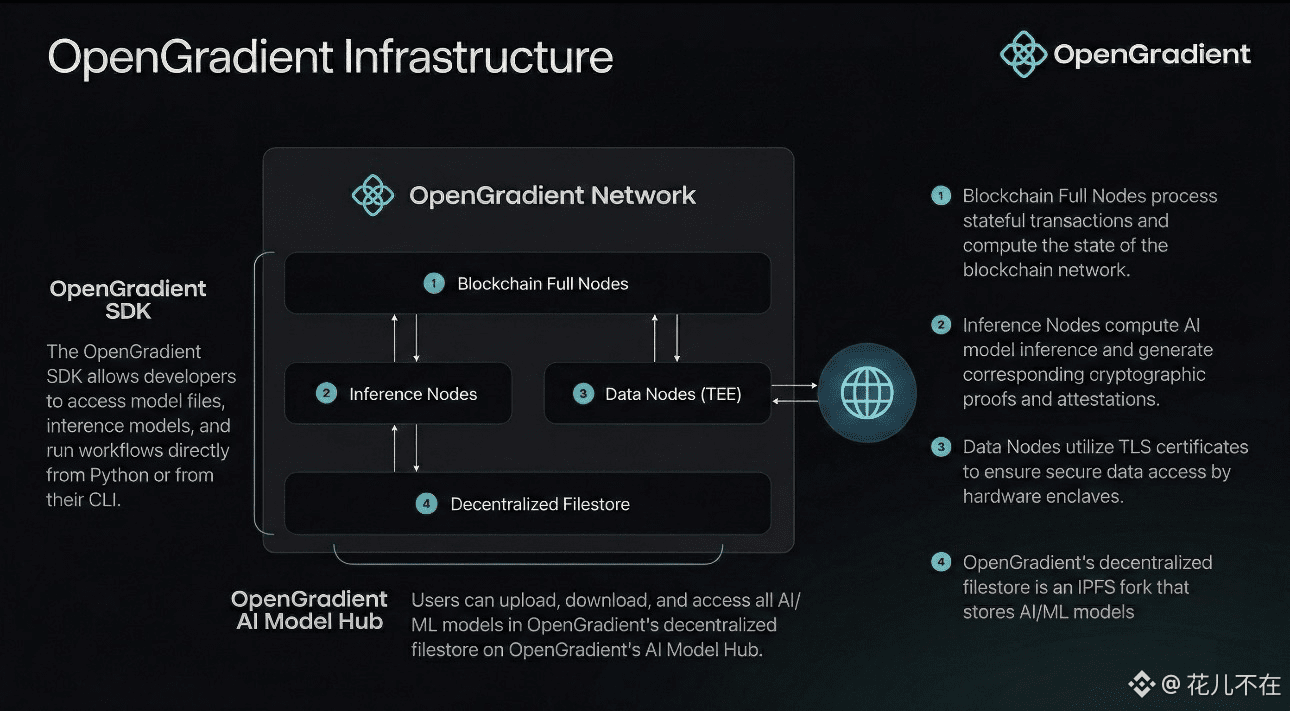
它跟那些只会卷参数、卷视频多逼真的大厂不一样,核心就干一件事:把AI推理的过程,变成人人都能查的“公开账本”。怎么做到的?得拆开它的混合AI计算架构(HACA)。简单说就四个字:执行和验证分开干。
以前想把AI上链有个死结——让100个节点都去重跑一遍大模型,成本贵上天不说,大模型带“温度系数”每次回答还不一样,根本达不成共识。HACA直接换了思路:推理节点先跑模型快速出结果(这是快路径),同时异步生成密码学证明(慢路径),用的是TEE可信环境或者ZKML零知识证明。全链节点不重跑模型,只花几毫秒验证这个证明有没有效,底层用CometBFT共识拍板上链,谁也别想篡改。这套组合拳打下来,链上已经托管了4400多个模型,干了200多万次可验证推理,产出了50多万份证明,全是实打实的链上数据。
那让这套“透明监控”转起来的油钱,就是OPG代币。我们散户花OPG调用推理,节点赚服务费;想当节点得先质押OPG入场,要是敢在数据上搞鬼,质押物直接罚没。这套“付费干活、干坏赔钱”的玩法,等于把“不作恶”变成了经济账,比指望大厂良心靠谱一万倍。
以后我再用AI,就认准这种能查监控的。聪明但心眼多的机器,我这种新韭菜真伺候不起。@OpenGradient
99
·
--
#opg $OPG Белая книга OpenGradient, если её перелистывать туда-сюда, — это ещё не самое важное. Настоящая точка напряжения — уровень расчётов x402. Эта штука занимается тем, что выводит AI-инференс в блокчейн, а $OPG используется для оплаты газа и стейкинга. Но главное не в технологии, а в том, что разработчикам предлагают три варианта — PRIVATE, BATCH_HASHED, INDIVIDUAL_FULL — и выглядит это как забота, хотя на деле тебе в руки суют бомбу с комплаенсом, а время взрыва ты назначаешь сам.
PRIVATE: в цепочке не остаётся следов. Приватность сохраняется, но вывеска «проверяемый AI» тут же рассыпается. Регулятор придёт с проверкой — чем ты докажешь, что агент не жульничал? Воздухом?
INDIVIDUAL_FULL: полный лог навсегда пишется в блокчейн. В белой книге сказано, что это подходит для «DeFi-агента с публичным аудитом», а если перевести на человеческий: лимит займа пользователя, порог ликвидации и логика стратегии выставлены голыми на всеобщее обозрение. Достаточно просто просканировать цепочку, чтобы точно прицелиться в твою позицию — даже приятнее, чем инсайдерская торговля.
BATCH_HASHED: агрегирование по Мерклу, вариант по умолчанию. Дёшево, проверяемо, приватность терпимая — но по сути это компромисс «ни рыба ни мясо». Регулятор говорит: «предоставьте исходный лог», а ты приносишь хэш — судья это примет?
Вот реальный пример: допустим, ты запускаешь кредитного агента, выбрал режим FULL, и весь процесс рассуждений по запросу пользователя «сколько максимум можно занять» уходит в цепочку. Конкурент по этому вычисляет его риск-экспозицию и мгновенно опережает ликвидацию. Теряешь ты живые деньги, а пользователь подаёт на тебя за утечку приватных данных. А OpenGradient уже заранее с себя всё стряхнуло — в SDK есть всего лишь параметр settlement_mode, разработчик сам ставит галочку; если что-то случится, к проекту не ходи.
Моя практическая стратегия без иллюзий: первые три месяца после запуска mainnet — только некритичные процессы, и принудительно BATCH_HASHED. Параллельно слежу за двумя метриками — частотой запросов на ончейн-аудит и количеством споров/жалоб по каждому режиму. К концу третьего месяца, когда станет ясно, в каком режиме меньше всего инцидентов и ниже всего трение с регулятором, тогда и решу, какую часть логики переносить. До этого момента вся ключевая инференс-логика выполняется локально, а в блокчейн отправляется только проверочный хэш.
Запомни: записи о рассуждениях AI в блокчейне нужны не для того, чтобы хранить их как можно больше, а для того, чтобы хранить ровно столько, чтобы можно было доказать корректность и не нарушить правила. Эту линию никто за тебя не проведёт — придётся проверять на своей позиции. Но перед тем как проверять, сначала очерти границу для выживания: если не понял, куда деваются данные, не ставь на кон все козыри сразу@OpenGradient
2
91
·
--
#opg $OPG
Ой, OpenGradient: не давайте размахивать красивыми историями — давайте просто посмотрим на его архитектуру HACA.
В чем болезнь традиционных блокчейнов? Каждый узел должен заново прогонять транзакцию. Ты отправляешь перевод — всё ок, но заставить 100 узлов прогонять 70B-модель? Стоимость растет в 100 раз, по времени не успеть, а результат при этом может оказаться не лучше. Хитрость OpenGradient в том, что выполнение и верификация разделены: узлы для вывода работают с GPU, а потом выдают сертификат TEE или доказательство ZKML, и всем остальным узлам остается только проверять доказательства — не нужно тупо заново прогонять модель.
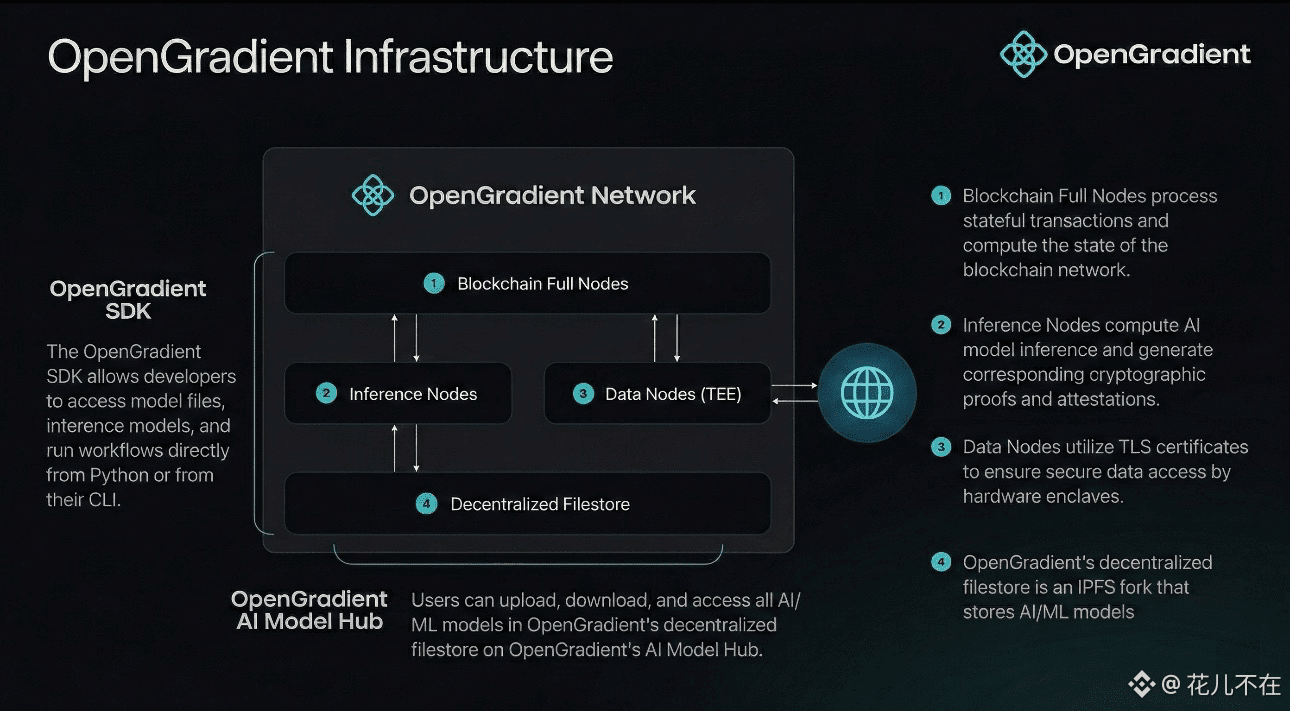
Честно, задумка технически неплохая. Узлы делятся на четыре группы: узлы вывода запускают модель, полные узлы ведут учет и верифицируют доказательства, узлы данных подают внешнюю информацию, а хранение уходит в Walrus. Но где проблема? Регистрация TEE-узлов требует «железной» аутентификации — это не запустить на любой домашней машине. Кто будет покупать H100? Кто будет платить за электричество в стойке?
Я специально пролистал экономическую модель из белой книги. Общее предложение токенов — 1 миллиард, награды за стейкинг составляют лишь 10%, и они линейно выпускаются в течение 96 месяцев. 96 месяцев — это что? 8 лет. По текущей оценке $OPG: сколько там в среднем выходит в месяц — хватит ли хотя бы на оплату кондиционеров для пары машин? Эксплуатация узлов — не благотворительность. Если субсидии закончились, чья вычислительная мощность побежит быстрее — и так ясно.
Команда говорит, что на мейннете провели 2 миллиона запусков вывода, но сколько именно узлов вывода и на каких конфигурациях — до сих пор не раскрыто. Техническое повествование звучит сексуально, а экономику посчитать получается не так. Я, пожалуй, пока просто сохранил список узлов в закладки — через три месяца вернусь сверяться. А сейчас заходить? Погляжу еще на @OpenGradient
#opg $OPG
Ой, OpenGradient: не давайте размахивать красивыми историями — давайте просто посмотрим на его архитектуру HACA.
В чем болезнь традиционных блокчейнов? Каждый узел должен заново прогонять транзакцию. Ты отправляешь перевод — всё ок, но заставить 100 узлов прогонять 70B-модель? Стоимость растет в 100 раз, по времени не успеть, а результат при этом может оказаться не лучше. Хитрость OpenGradient в том, что выполнение и верификация разделены: узлы для вывода работают с GPU, а потом выдают сертификат TEE или доказательство ZKML, и всем остальным узлам остается только проверять доказательства — не нужно тупо заново прогонять модель.
Честно, задумка технически неплохая. Узлы делятся на четыре группы: узлы вывода запускают модель, полные узлы ведут учет и верифицируют доказательства, узлы данных подают внешнюю информацию, а хранение уходит в Walrus. Но где проблема? Регистрация TEE-узлов требует «железной» аутентификации — это не запустить на любой домашней машине. Кто будет покупать H100? Кто будет платить за электричество в стойке?
Я специально пролистал экономическую модель из белой книги. Общее предложение токенов — 1 миллиард, награды за стейкинг составляют лишь 10%, и они линейно выпускаются в течение 96 месяцев. 96 месяцев — это что? 8 лет. По текущей оценке $OPG : сколько там в среднем выходит в месяц — хватит ли хотя бы на оплату кондиционеров для пары машин? Эксплуатация узлов — не благотворительность. Если субсидии закончились, чья вычислительная мощность побежит быстрее — и так ясно.
Команда говорит, что на мейннете провели 2 миллиона запусков вывода, но сколько именно узлов вывода и на каких конфигурациях — до сих пор не раскрыто. Техническое повествование звучит сексуально, а экономику посчитать получается не так. Я, пожалуй, пока просто сохранил список узлов в закладки — через три месяца вернусь сверяться. А сейчас заходить? Погляжу еще на @OpenGradient
1
94
·
--
#opg $OPG Тестировал OpenGradient Chat четыре дня, провёл между собой и системой семьдесят-восемьдесят диалогов — от простых вопросов и ответов до многошаговых логических рассуждений, так что поделюсь практическими ощущениями.
Первое впечатление — быстро. Проверял и в 11 вечера, и в два-три часа дня: даже в часы пик заметных тормозов не было, после вопроса текст начинал появляться почти в течение двух секунд. Во второй главе white paper они разделяют inference и verification на два пути — GPU-узлы только запускают модель, а результат отдельно проходит через шифрованную верификацию. На практике это ощущается: не как у некоторых проектов, где inference ускорили, а верификация не успевает, или, наоборот, всё завязали на проверку и она душит отклик.
Но были и сбои. На третий вечер по вопросу о безопасности смарт-контракта inference сработал быстро — результат пришёл через три секунды, но верификация зависла почти на десять секунд, статус всё время был pending, и я уже подумал, что связь оборвалась. Потом посмотрел запись в блокчейне: один из верификационных узлов медленно создал блок. В white paper такие детали не пишут, но в реальной работе это обязательно всплывает — вот это и есть настоящий AI on-chain.
Теперь о распределении узлов. Я поговорил с двумя людьми, которые запускали OPG-ноды, и они прикинули экономику: при текущей цене OPG, если учесть электричество и амортизацию железа, срок окупаемости почти вдвое длиннее, чем заявляет команда. Один из них сказал буквально: «Если цена токена не вырастет вдвое, расширять парк — это просто игра в угадайку». Сейчас по всей сети inference-узлов не так уж много, а несколько лидеров сосредоточили у себя большую часть вычислительной мощности, и это меня немного настораживает.
Мой вывод: как централизованный AI-инструмент это вполне проходит по качеству и даже кажется удобным. Но в on-chain верификацию я пока не стал бы вкладывать крупные суммы. Когда степень распределения узлов снизит концентрацию у лидеров до уровня ниже 60%, я пересмотрю оценку. Нижняя граница OpenGradient — это то, что в экстремальных случаях верификационный путь может зависать, а верхняя — сможет ли система удержать стимулы для узлов. Пользоваться с удовольствием и инвестировать с надёжностью — это две разные вещи, а я пока просто смотрю на карту распределения узлов
@OpenGradient
102
·
--
Проверено
#opg О действительно ли стоит держать OPG токены? Поговорим по делу
Сначала вывод: OPG — это не тот токен, в который стоит сломя голову вкладываться, но его ценностная логика значительно крепче, чем у большинства AI проектов.
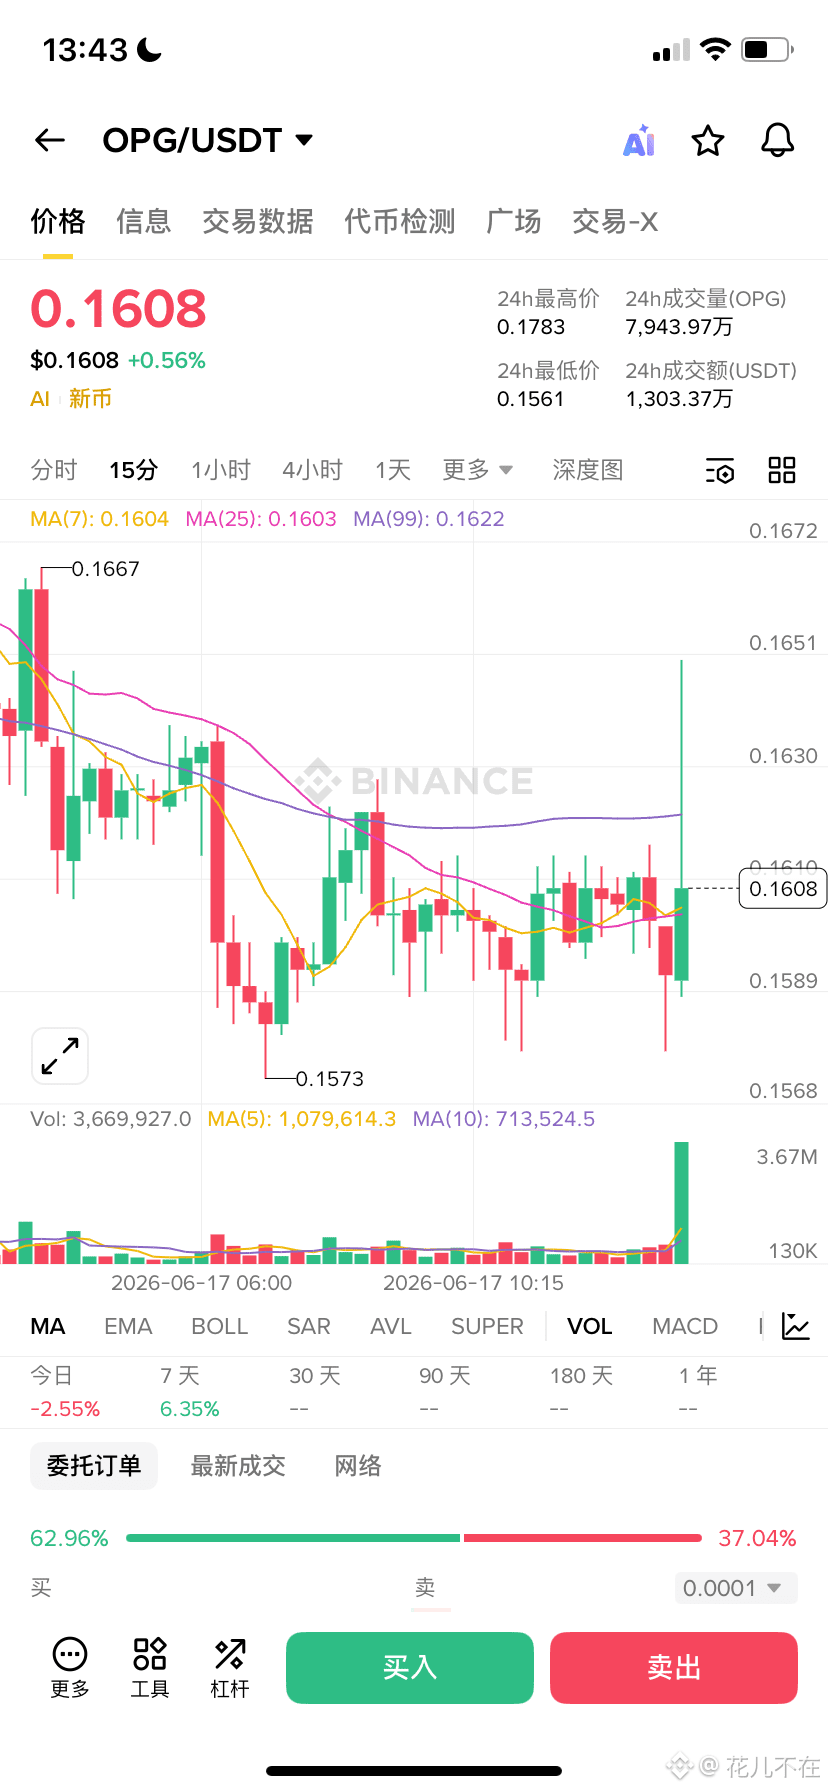
Многие сразу спрашивают о цене, так вот, 16 июня OPG стоил 0.1618 долларов, рыночная капитализация чуть больше 30 миллионов. Но это не главное. Сначала нужно понять одну вещь — этот токен действительно используется или нет?
Спрос реальный или нет?
OpenGradient сейчас провел больше 2 миллионов верифицируемых AI выводов, поддерживая более 2000 моделей. Каждый раз, когда происходит вывод, OPG сжигается. Это не те данные, которые подгоняет команда проекта, это проверяемая информация на блокчейне.
На Binance токен появился 22 мая, корейский Upbit тоже последовал примеру. Грубо говоря, если крупные биржи готовы его листить, это значит, что провели дью-дилижанс, и проект не пустышка.
В распределении токенов есть нюансы
Общее количество 1 миллиард, сейчас в обращении менее 190 миллионов, около 19%. На первый взгляд, есть давление на разблокировку, не так ли? Но если посмотреть внимательнее: 40% для экосистемы будут медленно разблокированы в течение 60 месяцев, 25% для вкладчиков и инвесторов заблокированы на 12 месяцев, а потом разблокировка идет в течение 36 месяцев. Что это означает? Большие объемы находятся под контролем, в краткосрочной перспективе не будет массовых распродаж.
Четыре уровня ценностного захвата
OPG — это не какой-то пустой управляющий токен. Это платежный инструмент, чтобы настроить AI модель, нужно потратить OPG; узлы должны сначала заложить OPG, если что-то пойдет не так, токены конфискуются; разработчики тоже могут зарабатывать OPG за загрузку моделей. Четыре уровня спроса в совокупности намного сильнее, чем у токенов, которые только голосуют.
Риски тоже нужно прояснить
TEE зависит от AWS, это централизованный риск. Команда проекта это понимает, но ничего не поделаешь, в краткосрочной перспективе нет лучшего выбора, чем Nitro. Кроме того, ZKML слишком дорого для LLM, в большинстве случаев по-прежнему полагаются на TEE.
Напоследок, скажу прямо $OPG
Настоящее испытание на этом рынке: когда верифицируемый AI вывод станет жизненно необходимым, сможет ли скорость расходования OPG обогнать разблокировку токенов. Сейчас объем небольшой, волатильность высокая, взвесьте все за и против. @OpenGradient
1
1
439
·
--
#opg $OPG Давайте поговорим о парадоксальном выводе: OpenGradient не стремится решить проблему "недостаточной силы ИИ", а скорее проблему "недостаточной надежности ИИ". Инвестиционные рекомендации или торговые сигналы, выданные LLM, пользователи не могут самостоятельно проверить, не был ли искажён процесс вычислений. Основная идея белой книги заключается в том, чтобы сделать этот процесс "аудируемыми вычислениями".
1. HACA: отделение выполнения от проверки
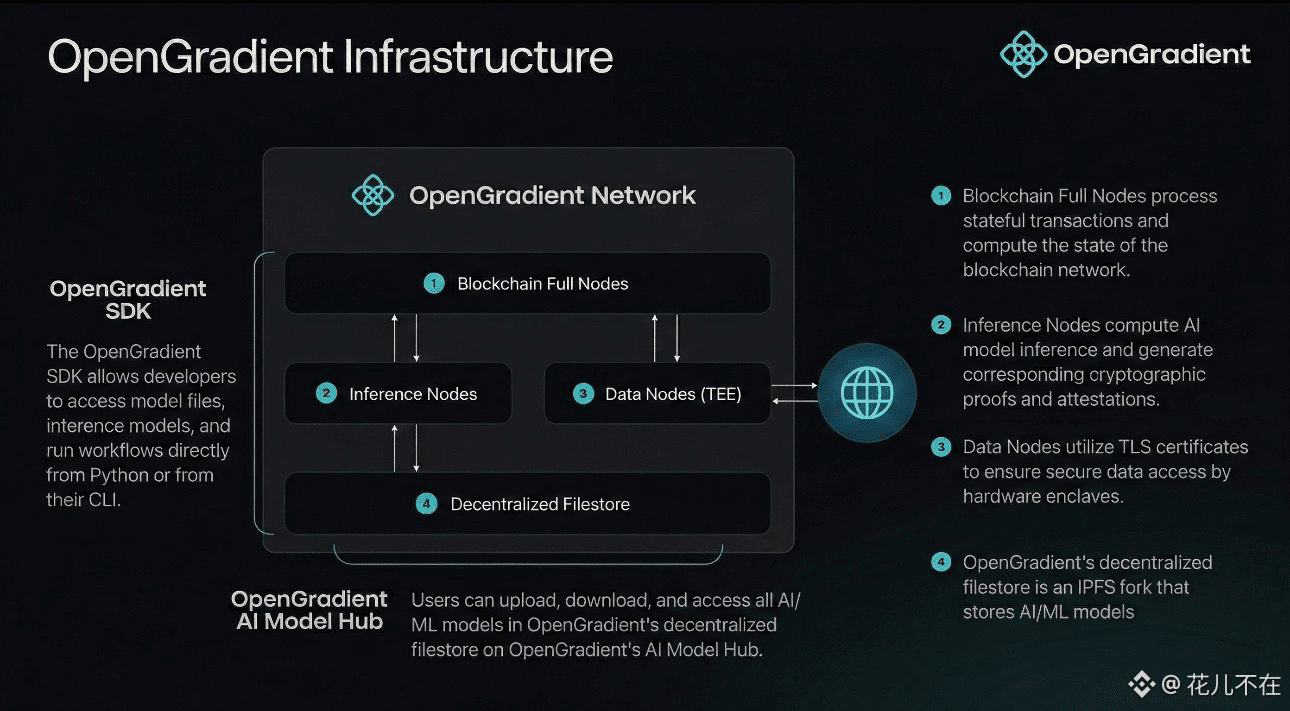
Традиционные блокчейны требуют от каждого узла проверки повторного выполнения каждой транзакции, что для ИИ-вычислений нереалистично. Архитектура HACA от OpenGradient разделяет сеть на три слоя: узлы вывода (GPU+TEE выполняют модель, возвращают результат, блокчейн не находится на ключевом пути), полные узлы (проверяют TEE/ZKML доказательства, одновременно поддерживают книгу с помощью CometBFT консенсуса), узлы данных (безопасный доступ к внешним данным внутри TEE). Узлы проверки не запускают модели, а только проверяют доказательства — это и есть основа оптимизации производительности.
2. Фреймворк проверки: меню уровней доверия
Белая книга разработала три пути проверки: TEE (AWS Nitro Enclaves, сертификационные документы подтверждают, что среда не была искажена, охватывает LLM и большинство ML-сценариев), ZKML (доказательства с нулевым знанием, математически определённые, но с высокими затратами, используются только для высокорисковых ML-вычислений), Vanilla (без доказательств, низкие требования). Протокол оплаты x402 уже встроен в каждый экземпляр TEE, устраняя централизацию промежуточного ПО, поддерживает асинхронные расчёты, запросы на вывод после предоплаты не блокируются в сети.
3. Токены и текущее состояние
Общее предложение OPG составляет 1 миллиард токенов, TGE запланировано на апрель 2026 года на базе сети Base, текущая циркуляция составляет около 19%. Токены используются для оплаты сборов за вычисления, штрафов за ставки, голосования в управлении. Доли экосистемы, участников и инвесторов имеют долгосрочные заморозки (12 месяцев cliff + 36 месяцев линейного выпуска), краткосрочный распродажа контролируется. В настоящее время сеть находится на стадии тестирования, обработано более 2 миллионов проверяемых вычислений, размещено более 2000 моделей, создано более 500000 доказательств.
Риски, которые стоит наблюдать: TEE зависит от AWS Nitro, существует напряжение между децентрализацией и централизацией; ZKML для LLM пока не реалистичен, разработчики несут ответственность за компромисс "стоимость-безопасность"; в ближайшие два года продолжится освобождение предложения, необходимо, чтобы рост доходов сети соответствовал этому.
Когда "проверяемость" станет стандартом для вывода ИИ, архитектурные выборы OpenGradient получат настоящую защиту.
#OPG $OPG @OpenGradient
113
·
--
#opg $OPG Давайте поговорим по делу. Многие люди следят за ценой токена OPG, не понимая, что на самом деле решает его базовая архитектура HACA.
Традиционный блокчейн не справляется с AI, причина очень проста. Логика Ethereum заключается в том, что каждый узел-валидатор повторно обрабатывает одну и ту же транзакцию, и когда результаты совпадают, достигается консенсус. С переводами все в порядке, но что насчет AI-выводов? Чтобы обработать модель с 700 миллиардами параметров, нужны GPU, время, а каждый раз выход может отличаться. Заставить 100 валидаторов обработать один и тот же запрос? Это увеличивает стоимость в 100 раз и затягивает время до бесконечности. Некоторые рассматривают AI как «оракул», подавая данные, что по сути переносит доверие от поставщика AI к поставщику оракулов, ничего не меняя.
Идея OpenGradient сводится к одному слову: разделение. Основная идея HACA: выполнение и проверка делаются отдельно. Три типа узлов выполняют свои задачи:
· Узлы вывода — GPU обрабатывают модели, результаты сразу отправляются пользователю, задержка примерно такая же, как у ChatGPT.
· Полные узлы — не обрабатывают модели, а только проверяют криптографические доказательства, предоставленные узлами вывода (TEE или ZKML). Если проверка пройдена, запись идет в блокчейн, совершенно не важно, какие ключевые слова, модели и результаты использовались — это чисто криптографическая операция.
· Узлы данных — специально извлекают данные из внешних источников, работают в TEE, чтобы обеспечить целостность данных.
В чем же крутость этого дизайна? Обработка идет по «быстрому пути» — вы отправляете запрос, GPU вычисляет, результат мгновенно возвращается вам, блокчейн не вмешивается. Проверка идет по «медленному пути» — доказательства отправляются асинхронно, полные узлы проверяют, записи идут в цепочку. Скорость на уровне Web2, доверие на уровне Web3. Чем больше узлов вывода, тем выше пропускная способность, нагрузка на уровень проверки не увеличивается — проверка проходит за миллисекунды, и не имеет значения, потратили ли вы 5 секунд или 50 секунд на обработку модели.
Говоря простым языком: вы получаете результаты с такой же скоростью, как и при использовании ChatGPT, но каждое значение можно независимо проверить и проследить навсегда — не надо никому доверять.
На данный момент основная сеть выполнила более 2 миллионов проверяемых выводов, более 500 тысяч доказательств и более 2000 моделей. a16z и Coinbase Ventures уже на борту. Этот механизм разбивает «черный ящик AI» на «прозрачную конвейерную линию», направление правильное, осталось посмотреть, сможет ли экосистема заработать @OpenGradient
95
·
--
#bedrock $BR В текущем круге повсюду можно встретить рекламные материалы по продвижению ликвидности Bedrock на всех цепочках. Аирдропы и высокая доходность продолжают стимулировать рынок, многие мелкие трейдеры следуют за толпой, берут кредиты и наращивают активность, пытаясь заработать на наградах. После двухнедельного тестирования на практике, хочу поделиться с точки зрения обычного инвестора о реальном состоянии проекта.
Ключевая особенность проекта — это кросс-цепная система доходности, построенная на uniBTC. Ранее для того, чтобы управлять BTC-активами в разных экосистемах, приходилось многократно пересекать мосты, что занимало много времени и накладывало несколько комиссий за транзакции. Однако на платформе можно просто внести средства в стейкинг и получить ликвидные сертификаты, которые позволяют гибко перемещать активы между различными доходными протоколами. Эффективность оборота капитала значительно превышает традиционные стейкинг-продукты на рынке, а архитектура проекта дружелюбна к крупным инвестициям.
Тем не менее, для упрощения операций, проект полностью закрыл внутреннюю упаковку управления узлами, управления рисками активов и правилами сбора средств. Пользователи могут только видеть бумажную прибыль на фронтэнде и не могут самостоятельно проверить детали хранения активов на нижнем уровне, что является серьезной проблемой для опытных игроков, ценящих прозрачность цепочки.
В настоящее время большое количество мелких трейдеров с капиталом в несколько сотен U участвуют в циклическом стейкинге для выполнения задач; вся экономическая модель в основном ориентирована на крупных китов. Частые операции с небольшими суммами приводят к увеличению комиссий за Gas и проскальзыванию при обмене, что медленно съедает оставшиеся экологические награды, и большинство участников в конечном итоге не зарабатывают, а наоборот, повышают TVL проекта.
Рекомендации по практике: сохраняйте спокойствие, откажитесь от идеи быстрого обогащения через аирдропы и рассматривайте проект только как инструмент ликвидности. Ликвидные сертификаты, полученные от стейкинга, комбинируйте с проверенными DeFi для надежной настройки, а аирдропы рассматривайте как приятный бонус. Дождитесь снижения ажиотажа на рынке, оцените реальные остатки средств в экосистеме, прежде чем планировать дальнейшие инвестиции.
#Bedrock #btcfire @Bedrock
65
·
--
#bedrock $BR В нашем месячном сообществе все больше людей хвастаются BR-очками, один знакомый даже поставил скриншот топ-10 в качестве аватарки и всем говорит: "Вот это настоящая мощь BTCFi". Честно говоря, я тогда чуть не рассмеялся — шесть лет в DeFi-инфраструктуре, от MakerDAO до текущих реинвестиций, я видел этот трюк с "финансовым порогом", перевернутым в "стимулы для пользователей" не меньше десятка раз.
Если говорить по сути, Bedrock не просто делает BTC кроссчейн, чтобы взлететь на платформе BTCFi. Вы заметили? Настоящая защитная стена — это их казалось бы справедливая нелинейная модель затухания очков. Разработчики очень умные, не выставляют на показ "не беспокоить тех, у кого недостаточно средств", а потихоньку осуществляют капитализацию через формулу очков: при одинаковом залоге в 1 BTC, доход от крупного игрока, который заморозил средства на год, может сопоставляться с доходом мелкого игрока, который тусуется по рынкам три месяца. Два типа капитала, две системы дисконтирования, и между ними навсегда стоит купол доходности, который невозможно преодолеть.
Это решение приносит явные плюсы протоколу: TVL взлетает, как воздушный шар, с 500 миллионов до 3 миллиардов, капитал прочно заперт в многоуровневых контрактах, даже киты не спешат покидать рынок. Но цену платят именно мелкие трейдеры — я лично видел, как кто-то каждый день ставил три будильника, вставал в два часа ночи, чтобы менять пулы для получения очков, а комиссии сжигали по несколько тысяч U, в то время как рейтинг очков оставался на месте. Почему? Потому что в модели, которая зависит от времени хранения и объема средств, оборот мелких средств никогда не сравнится с спящими активами крупных игроков.
Ещё более иронично, что платформа намеренно создает иллюзию "усердие приносит доход". Вы каждый день следите за колебаниями APY, перемещаете средства между различными пулами ради тех 0.01% прироста очков, и действительно ли это справедливое участие? Мы лишь мигрировали с нижнего уровня пищевой цепи традиционных финансов на придаток к системе очков на блокчейне. Каждый из $BR очков, которые скупаются по завышенной цене институциональными игроками, основан на множестве мелких средств, которые двойным ударом времени и масштаба размываются в затратах.
#bedrock $BR @Bedrock
104
Войдите, чтобы посмотреть больше материала
Присоединяйтесь к пользователям криптовалют по всему миру на Binance Square
⚡️ Получайте новейшую и полезную информацию о криптоактивах.
💬 Нам доверяет крупнейшая в мире криптобиржа.
👍 Получите достоверные аналитические данные от верифицированных создателей контента.
Эл. почта/номер телефона