

#inference
inference
1,600 visualizações
32 a discutir
Popular
Mais recente

⚡ CAPITAL INSTITUCIONAL CONSOLIDA A INFRAESTRUTURA DE IA À MEDIDA QUE A VELOCIDADE DE INFERÊNCIA SE VOLTA PARA $TAO 🔍
A aquisição da Moondream pela Prime Intellect sinaliza uma mudança institucional em direção à inferência de alta eficiência e à execução multimodal. 🦈 Ao garantir o mecanismo Photon — capaz de realizar mais de 60 inferências por segundo em unidades de hardware individuais —, o dinheiro inteligente está reduzindo ativamente a latência em pipelines complexos de agentes. 📊
Essa iniciativa marca uma transição estrutural do tamanho bruto dos modelos para uma capacidade operacional enxuta. 💡 À medida que a aceleração da inferência se torna a principal camada de liquidez que impulsiona a implantação de IA no mundo real, o capital já está se posicionando à frente da curva. 🌊
🤔 A velocidade otimizada de inferência vai impulsionar a próxima alta sustentada dos protocolos de IA ou as limitações do hardware físico ainda estão sendo mal avaliadas? 👇
⚠️ Isto não é aconselhamento financeiro. Gerencie sempre seus riscos. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
1

·
--
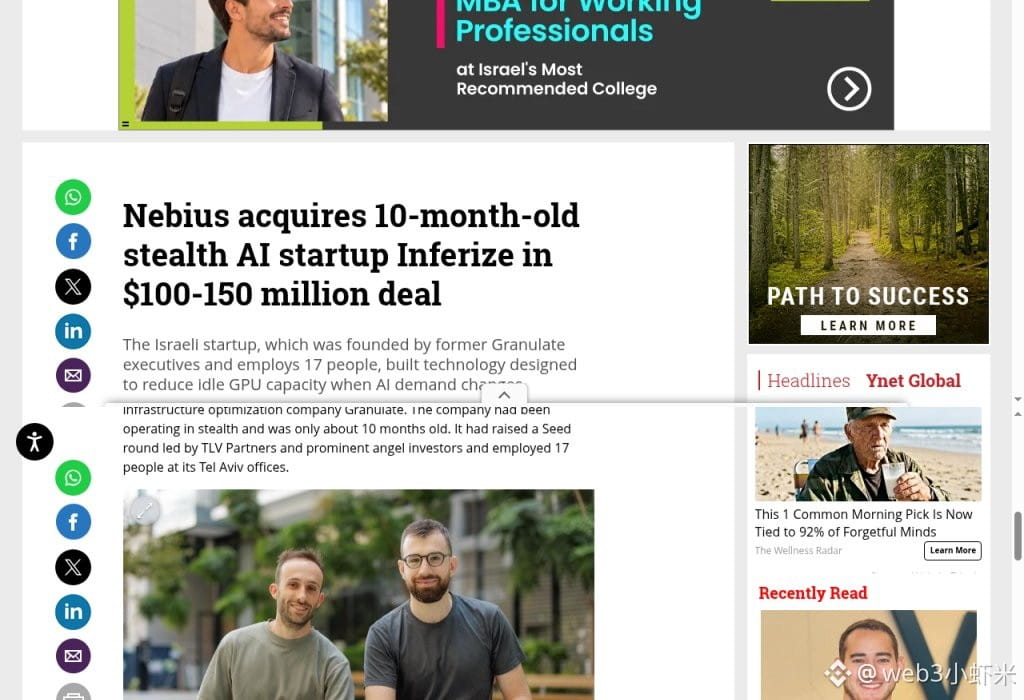
Vi no CTech/Nebius: a empresa de cloud de IA Nebius ($NBIS), cotada na Nasdaq, adquiriu a Inferize, uma startup israelita de otimização de inferência fundada há apenas cerca de 10 meses. Os termos oficiais do negócio não foram divulgados; a CTech estima que tenha rondado os 100–150 milhões de dólares.
O que faz é muito específico: eliminar o «custo de GPUs ociosas» durante o arranque a frio dos modelos. Ao carregar pesos, escalar a capacidade ou trocar pesos a meio do treino por reforço, as GPUs ficam muitas vezes sem fazer nada. A Inferize quer ajustar a capacidade de computação à procura real, aumentando a utilização da capacidade do Token Factory e reduzindo o custo por token. A equipa tem cerca de 17 pessoas, e o fundador liderou a Granulate, adquirida pela Intel. A Nebius afirma que a equipa e a tecnologia serão integradas na sua plataforma de inferência, que já tinha incorporado capacidades relacionadas com a Eigen AI e a Clarifai.
A IA está a passar do treino para a implementação, e as empresas de cloud estão a reforçar, uma a uma, a camada de software. Estas aquisições de infraestrutura pequenas, mas robustas, são mais interessantes do que histórias sem substância.
$NBIS #AI #Inference #Nebius
Vi no CTech/Nebius: a empresa de cloud de IA Nebius ($NBIS ), cotada na Nasdaq, adquiriu a Inferize, uma startup israelita de otimização de inferência fundada há apenas cerca de 10 meses. Os termos oficiais do negócio não foram divulgados; a CTech estima que tenha rondado os 100–150 milhões de dólares.
O que faz é muito específico: eliminar o «custo de GPUs ociosas» durante o arranque a frio dos modelos. Ao carregar pesos, escalar a capacidade ou trocar pesos a meio do treino por reforço, as GPUs ficam muitas vezes sem fazer nada. A Inferize quer ajustar a capacidade de computação à procura real, aumentando a utilização da capacidade do Token Factory e reduzindo o custo por token. A equipa tem cerca de 17 pessoas, e o fundador liderou a Granulate, adquirida pela Intel. A Nebius afirma que a equipa e a tecnologia serão integradas na sua plataforma de inferência, que já tinha incorporado capacidades relacionadas com a Eigen AI e a Clarifai.
A IA está a passar do treino para a implementação, e as empresas de cloud estão a reforçar, uma a uma, a camada de software. Estas aquisições de infraestrutura pequenas, mas robustas, são mais interessantes do que histórias sem substância.
$NBIS #AI #Inference #Nebius
407

·
--
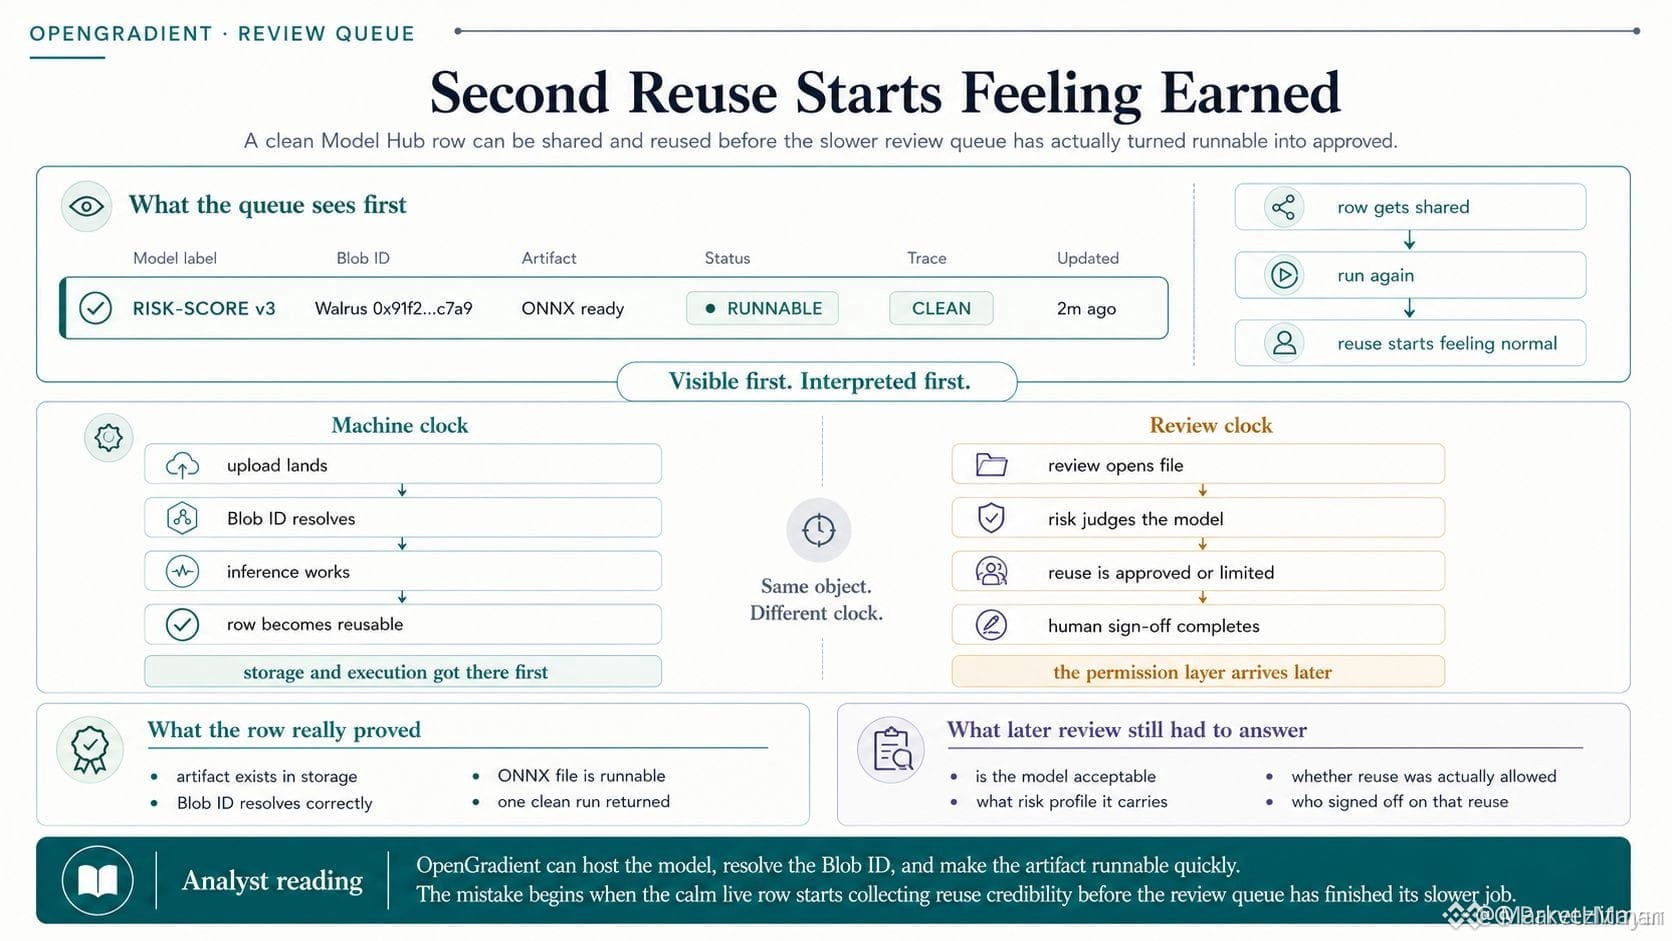
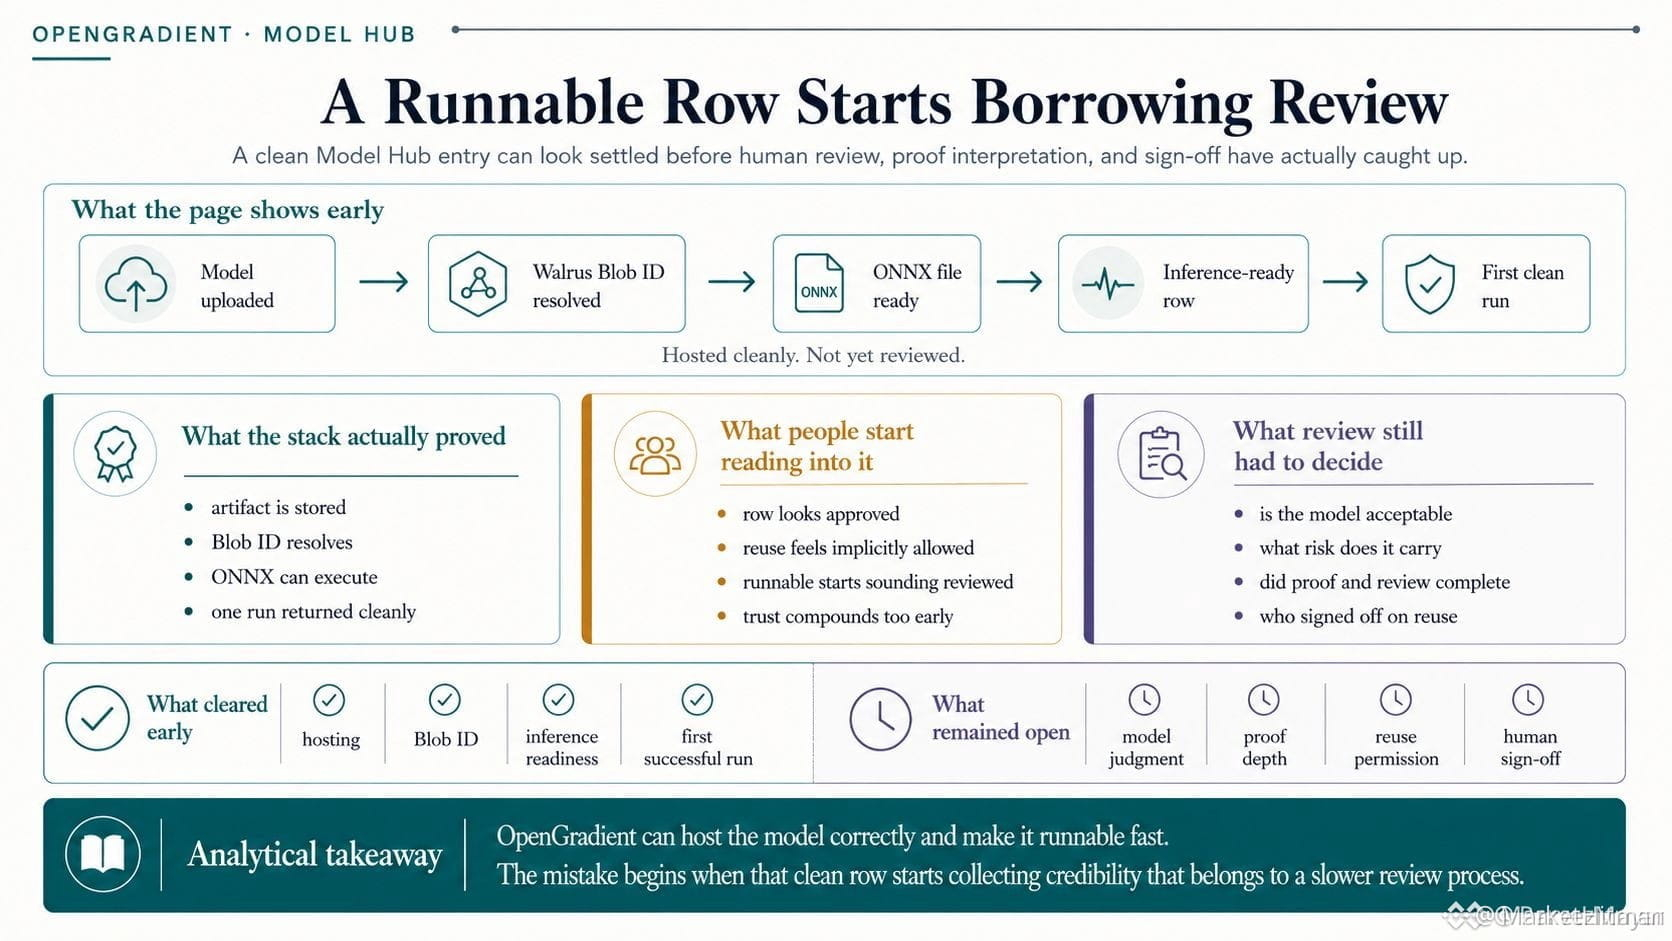
$OPG INFERENCE RUNS AHEAD OF THE REVIEW QUEUE 🔥
Uma linha de modelo no OpenGradient Model Hub é verificada em segundos — rastreamento limpo, ID do blob Walrus pronto, arquivo ONNX ativo. Mas a revisão humana fica para trás. A partir da terceira reutilização, essa linha começa a parecer revisada antes mesmo de ter recebido a aprovação. O sistema funciona perfeitamente. O processo não.
Esse hiato entre eficiência da máquina e supervisão humana cria uma zona cega. O modelo estava sólido, mas foi realmente verificado? Confiar na velocidade acima da sequência é uma vantagem silenciosa — ou uma fuga silenciosa.
Você está executando modelos que passaram pela máquina, mas pularam o portal humano?
Não é aconselhamento financeiro. Gerencie sempre seu risco.
#OPG #ModelHub #Inference #CryptoAI
🔥
19

$AI INFERENCE MEMORY COULD BE THE NEXT MAJOR BOTTLENECK IN CRYPTO AI 💎
O analista da Critini Research, Jukan, refuta a visão pessimista sobre o futuro da Micron, afirmando que, na fase de inferência de IA, adicionar memória é mais valioso do que adicionar GPUs. O problema é simplesmente que empilhar GPUs da NVIDIA não melhora o desempenho da inferência, porque as GPUs frequentemente ficam ociosas devido a gargalos de memória. O ROI final para inferência depende mais de memória do que de GPUs.
Isso muda o discurso de computação para memória — e é aí que projetos de cripto focados em armazenamento e largura de banda de memória descentralizados podem ver uma mudança de paradigma no valor. Você está posicionado para essa mudança de fase?
Não é aconselhamento financeiro. Gerencie sempre seu risco.
#AI #Memory #Inference #CryptoNarratives
💎
29
·
--
Todo mundo acha que o ecossistema $BNB só se move com atualizações de cadeia.
A diplomacia global no Oriente Médio redireciona silenciosamente o poder de computação longe de clusters de nós. Quando startups de IA enfrentam atritos na cadeia de suprimentos, redes descentralizadas brigam pelos mesmos restos de silício. Observe o custo dos nós de RPC como seu indicador principal de estresse do hardware local.
$BNB $ETH #CryptoInfra #TechTrends #Inference
57
·
--
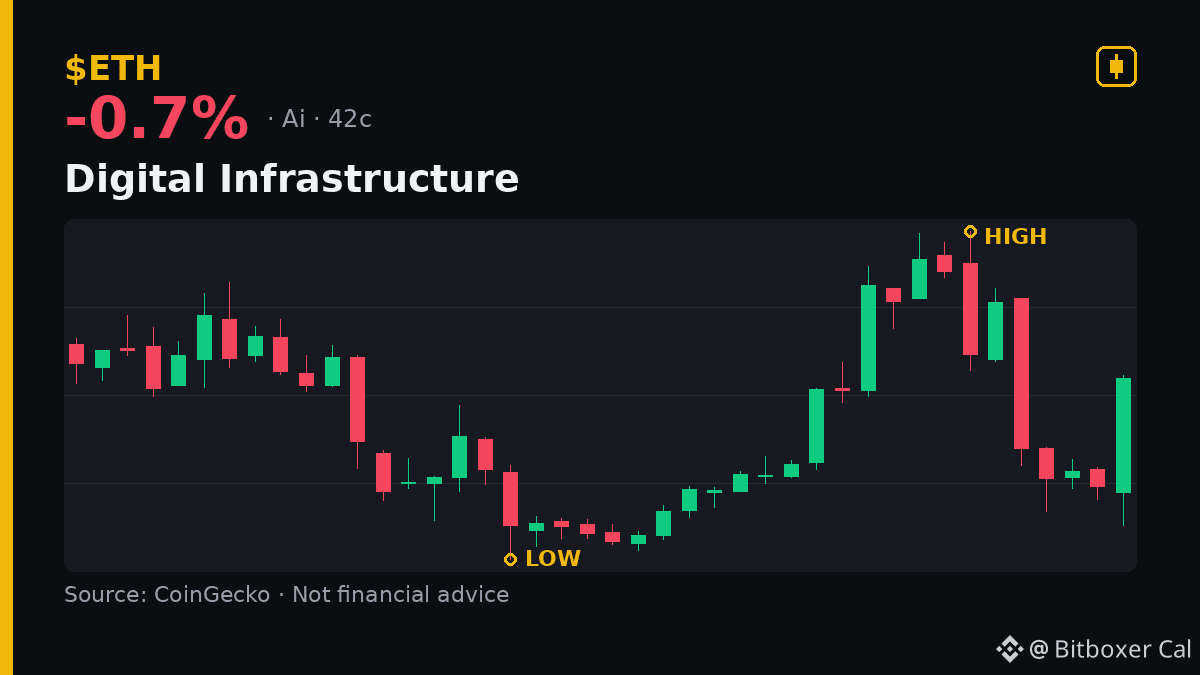
Dizem-nos que a IA é nada mais do que uma corrida armamentista de hardware.
Isso é uma distração. Empresas como a Mandela Digital provam que a resiliência de software importa mais do que o poder bruto de computação. Assim como um motor potente precisa de uma estrutura sólida, aplicativos financeiros em ETH ou BTC exigem dados previsíveis — quer estejam rodando em chips de ponta ou em hardware mais antigo.
$ETH $BTC #AI #CryptoAI #Inference
69
·
--
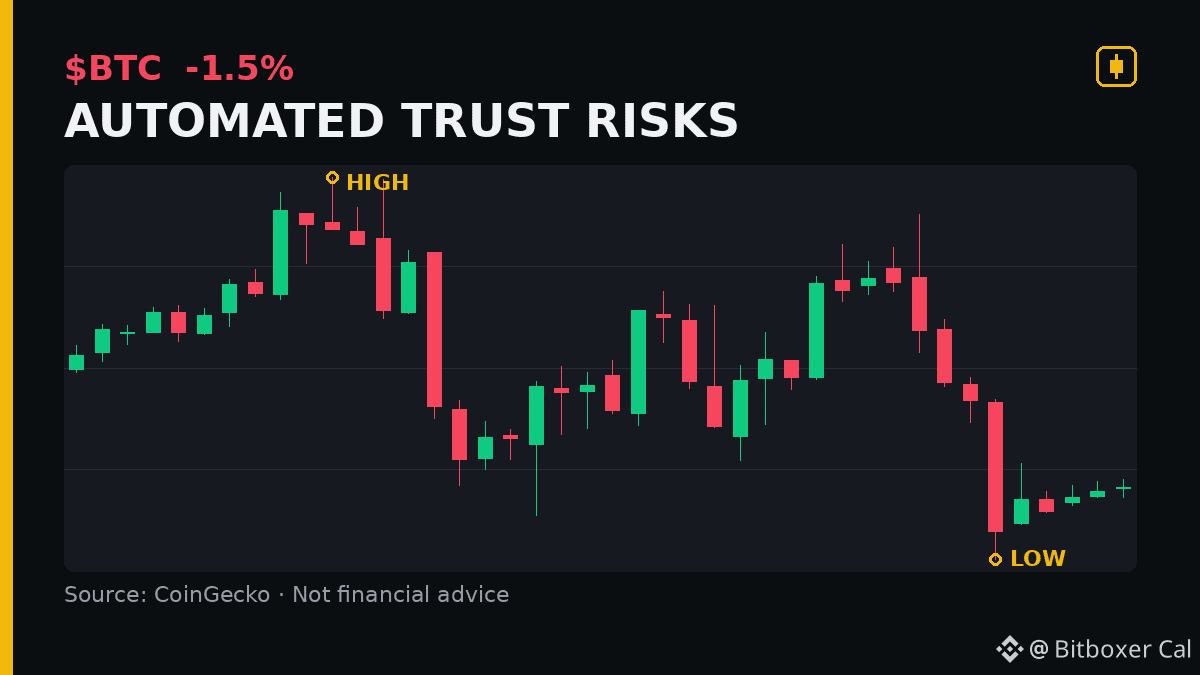
Os otimistas querem que algoritmos gerenciem tesourarias nacionais de Bitcoin porque acreditam que a matemática é imune ao ego.
Eles esquecem que o código não tem um balanço para liquidar dívidas quando as coisas dão errado. Confiar em um fluxo de lógica opaco e inatualizável é apenas trocar o erro humano por uma máquina que não pode ser responsabilizada. Se o modelo alucinar, a entidade que depende do ecossistema fica com nada além de uma falha no sistema.
$BTC $BNB #cryptoeducation #AI #Inference
78

·
--
🚀 $AI RIPL REDUZ A LATÊNCIA DE INFERÊNCIA EM 14X – O EDGE EM TEMPO REAL REDEFINIDO! 📈
📊 O mecanismo RIPL da Liquid AI reduz a latência do LFM2.5, com 1,2 bilhão de parâmetros, para 34,6 ms em uma única NVIDIA B200, atendendo a 95 % das solicitações a 1.000 RPS dentro desse intervalo. ⚡ Em comparação com os 498 ms do vLLM, a diferença aumenta para 14,4×, indicando uma vantagem de velocidade decisiva para classificação de buscas e controle de risco em pagamentos.
🦈 Essa aceleração transforma os modelos de linguagem em recursos ágeis na linha de frente, permitindo que as instituições aproveitem a liquidez antes que o fluxo de ordens se estabilize. 💡 Espere uma onda de adoção rápida à medida que as empresas buscam vantagem em latência para superar os concorrentes em ciclos de decisão em tempo real. 💬 Como essa vantagem de velocidade vai transformar sua estratégia de IA em tempo real? 👇
⚠️ Isto não é aconselhamento financeiro. Gerencie sempre seus riscos. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
4
·
--
A PRIME INFERENCE REVELA UMA QUEBRA DE LATÊNCIA DE 1 TRILHÃO DE TOKENS PARA INFRAESTRUTURA $AI ⚡ 📊
A Prime Intellect lançou a Prime Inference, processando quase 1 trilhão de tokens por dia enquanto reduz em 40% a latência p90 entre tokens para cargas de trabalho complexas de agentes. 📊 Ao separar o processamento do prompt e a geração de resposta em GPUs diferentes, o sistema otimiza a eficiência de computação em escala institucional.
Com uma expansão de 50% na capacidade do cache KV, chegando a 1,63M tokens por decodificador, essa pilha open-source conecta de forma contínua o treinamento do modelo à execução em tempo real. 💡 Os dados operacionais voltam continuamente para pipelines de aprendizado por reforço, tornando a eficiência bruta da inferência o principal indicador de competitividade. 🔍
💬 Você vê a otimização de inferência open-source acelerando a implantação de agentes descentralizados, ou hubs de computação proprietários manterão sua vantagem? 👇
⚠️ Não é aconselhamento financeiro. Sempre gerencie seu risco. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
93
$CÉREBROS A US$ 170 FOI A ENTRADA DO INSIDER – AGORA A OPENAI CONFIRMA 🔥
Entrada: 170 🔥
A OpenAI está lançando o GPT‑5.6 em hardware da Cerebras no próximo mês, atingindo 750 tokens por segundo. Isso não é boato — é uma validação direta da pilha de inferência deles. Serenity, que comprou a US$ 170, ainda vê potencial de longo prazo apesar do prêmio atual.
A narrativa de infraestrutura está esquentando, e a Cerebras está no centro disso. Agora a questão é se o mercado precifica totalmente esse catalisador ou se ainda há espaço para subir. Você está esperando uma correção ou comprando aqui?
Isso não é aconselhamento financeiro. Gerencie sempre seu risco.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
28
·
--
$CRBR PRONTO PARA LANÇAR O GPT-5.6 A 750 TOKENS/S EM JULHO 🚀
Entrada: $170 🔥
A confirmação da Serenity de que a OpenAI vai implantar o modelo Sol frontier GPT-5.6 em hardware da Cerebras é um catalisador direto para a ação. A velocidade de inferência de 750 tokens/segundo cria uma vantagem competitiva tangível contra arquiteturas baseadas em GPU. A compra da Serenity a US$ 170 destaca convicção, mas também aponta que a valuation atual está um pouco acima em relação a pares como a JBL.
A questão principal é se o mercado já precificou totalmente o prêmio da parceria ou se um volume sustentado pode levar a ação para uma nova faixa. Qual é seu objetivo aqui — US$ 200 ou uma correção primeiro?
Não é aconselhamento financeiro. Gerencie sempre seu risco.
#CRBR #AI #Hardware #Inference #Breakout
🎯
17
$NVDA A demanda por inferência de IA ainda está fervendo ⚡
O Citigroup diz que a escassez não é mais apenas sobre os chips mais novos. Agora está se espalhando para GPUs mais antigas, data centers, acesso à energia e a camada de roteamento que decide qual modelo e hardware usar.
Isso importa porque a próxima perna do valor da IA pode não estar apenas no computacional. O mercado está começando a precificar a pilha de infraestrutura mais ampla, desde redes ópticas até camadas de nuvem e de aplicativos.
Não é conselho financeiro. Gerencie seu risco.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
16

AMAZON ELEVA O CAPEX PARA US$ 220B — A DEMANDA POR INFERÊNCIA É O MOMENTO DE $FET 'S 🦈 💥
O ciclo da IA acabou de mudar de fase. O treinamento foi o aquecimento — a inferência é onde o consumo real de computação acontece. O chefe de nuvem da Amazon diz que os clientes já pararam de experimentar; agora eles estão conectando modelos diretamente em fluxos de trabalho de produção. Isso é uma curva de demanda se curvando para cima. 📊
Agora, a AWS aumenta seu teto de capex para US$ 220B até 2026. Isso não é um mero arredondamento — é um posicionamento dos grandes provedores de infraestrutura na maior aposta em infraestrutura desta década para alimentar motores de inferência. Quando gigantes do web2 brigam por escassez de capacidade, a narrativa de IA descentralizada ganha um lugar à mesa. 💡
O mercado ainda está reajustando quais tokens herdam essa demanda. O impulso costuma ficar atrás da narrativa até que o primeiro grande rompimento confirme isso. 🔍 Qual projeto de IA na sua carteira tem a história de inferência mais forte no mundo real? 💬
⚠️ Não é aconselhamento financeiro. Sempre gerencie seu risco. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
135
·
--
A ZHIPU DERRUBA AS BARREIRAS DE VELOCIDADE COM A GLM-5.3-FLASHX, ACENDENDO A PRÓXIMA MOBILIZAÇÃO DA INFRAESTRUTURA $AI ! ⚡ 🚀
O escalonamento de computação em IA acabou de entrar em velocidade máxima: à medida que a Zhipu revela a GLM-5.3-FlashX, liberando um impressionante throughput de 200 tokens por segundo. ⚡ Alimentado por Agentes Internos de Infra que otimizam mais de 100.000 chips especializados, as velocidades de processamento ponta a ponta triplicaram em menos de duas semanas.
Esse aumento bruto de aceleração de throughput sinaliza uma grande mudança rumo à execução de modelos hipereficientes no cenário de inteligência descentralizada. 📊 À medida que a velocidade bruta de inferência se torna o derradeiro fosso, o capital inteligente está, silenciosamente, antecipando a tese do gargalo de infraestrutura. 💡
💬 Motores de inferência de alta velocidade vão impulsionar a próxima grande rodada de valorização dos tokens de IA neste trimestre? 👇
⚠️ Não é aconselhamento financeiro. Sempre gerencie seu risco. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
55
O CORTE DE CUSTOS DE 70% QUE TRANSFORMA O CODING DE IA DE “ALUGADO” EM UM ATIVO PRÓPRIO — $AMD 🦈 💥
A AMD acabou de mirar direto no setor empresarial com uma pilha integrada: silício EPYC, GPUs Instinct, servidores Supermicro, o PaletteAI da Spectro Cloud e o GLM-5.2 — um copilot pré-integrado no local, em uma “caixa”. 🎯 O número principal que importa: até 70% de menor custo total em comparação com modelos da fronteira em nuvem, com retorno do capital em tão rápido quanto seis meses.
O movimento mais “agudo” é o roteamento baseado em políticas — o PaletteAI muda automaticamente entre inferência no local e modelos de nuvem da Anthropic, OpenAI, Google ou xAI sob demanda, com cotas de tokens, trilhas de auditoria e dashboards do Grafana revelando a diferença real de custos ao vivo. 🔍
Isso é coding de IA saindo de locação por minuto (“metered rental”) para uma infraestrutura previsível — um movimento de soberania que ecoa a mentalidade de autoproteção dos ativos. 💬 As empresas vão continuar alugando modelos de fronteira ou começar a ser donas do poder de computação? 👇
⚠️ Não é aconselhamento financeiro. Gerencie sempre seu risco. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
90
·
--
🚨 $NVDA SHIFTS INSTITUTIONAL FOCUS TO AGENTIC AI INFERENCE EFFICIENCY! 🧠
A Nvidia oficialmente disparou a produção em massa para o acelerador Groq 3 LPX, marcando uma rotação estrutural importante de um foco apenas em treinamento de modelos para uma execução contínua. 🦈 Grandes operadores de infraestrutura estão se esbarrando diretamente nos limites de energia, forçando o capital inteligente a migrar para arquiteturas de alta eficiência para cargas de trabalho de IA agentic em múltiplas etapas. 📊
Essa transição muda o padrão operacional de capacidade bruta de processamento para eficiência de computação por watt otimizada. 🔍 À medida que a inferência ao vivo persistente substitui o treinamento estático de modelos, o design de hardware consciente com energia se torna a vantagem definidora para escala institucional. 💡
🤔 As restrições de energia vão forçar uma grande reavaliação de valor nos setores de computação de alto desempenho este ano? 👇
⚠️ Não é aconselhamento financeiro. Gerencie sempre seu risco. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
18
·
--
🚨 $AI INFERENCE SHIFT: APOSTE DE €200M CONTRA O MONOPÓLIO DE GPU ⚡
A rodada Série A de €200M da Euclyd, co-liderada pela Samsung, EQT e Somerset, é um voto estrutural a favor da inferência de IA como o próximo gargalo. 📊 Seus 16.384 processadores em memória e o roadmap de 2028 em exaflops miram a camada de eficiência energética onde as GPUs podem ser vulneráveis.
⚡ O “porém”: a eficiência de 100x da Nvidia alegada ainda é uma projeção, não uma prova comercial. Essa lacuna entre ambição e verificação é exatamente onde o dinheiro inteligente procura catalisadores. 💬 Isso é o começo de um novo ciclo de hardware de IA, ou ainda é uma narrativa não comprovada? 👇
⚠️ Não é aconselhamento financeiro. Administre sempre seu risco. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
39
·
--
O relatório que a SpaceX está por vir é mais do que uma notícia corporativa; ele destaca o choque entre caixas-pretas privadas e a $ETH and $BTC ethos.
Empresas centralizadas exigem fé cega na matemática das salas de conselho. Protocolos descentralizados forçam o código a comprovar cada alegação. Auditorias independentes do seu próprio balanço são a única forma de garantir uma segurança verdadeira neste mercado.
$ETH $BTC #Web3 #Inference #DeFi
Empresas centralizadas exigem fé cega na matemática das salas de conselho. Protocolos descentralizados forçam o código a comprovar cada alegação. Auditorias independentes do seu próprio balanço são a única forma de garantir uma segurança verdadeira neste mercado.
$ETH $BTC #Web3 #Inference #DeFi
65

·
--
⚡ $FET AI BOTTLENECK DE INFERÊNCIA SE VOLTA PARA A LARGURA DE BANDA DA MEMÓRIA À MEDIDA QUE AS INSTITUIÇÕES REESTRUTURAM A INFRAESTRUTURA! 📊
As demandas computacionais institucionais estão mudando drasticamente da capacidade bruta de memória para a orquestração hipereficiente de largura de banda. 📊 Com a arquitetura MoE dominando, a velocidade de roteamento entre os pipelines de Prefill e Decode tornou-se o principal gargalo para a próxima geração de infraestrutura de hardware.
O agendamento em camadas do cache KV e o throughput de largura de banda agora determinam a eficiência do cluster, mais do que a densidade bruta do hardware. 🔍 O capital inteligente está se posicionando em torno de protocolos de infraestrutura que otimizam o overhead do movimento de dados antes da próxima expansão de escala.
💡 Arquiteturas de nós desagregadas estão forçando uma reformulação completa das estratégias de alocação de hardware institucional. 💬 Protocolos de otimização de largura de banda conseguirão capturar a próxima rotação estrutural na computação descentralizada? 👇
⚠️ Não é aconselhamento financeiro. Sempre gerencie seu risco. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
239

·
--
$AI Os Custos de Infraestrutura Estão Aumentando à Medida que a Demanda por Inferência Se Expande ⚡
O Citigroup afirma que a demanda por inferência de IA ainda está em alta, e a pressão não está mais limitada aos chips mais novos. A escassez está se espalhando por GPUs, data centers, acesso à energia e camadas de roteamento, o que significa que o mercado agora está precificando toda a pilha, não apenas os semicondutores.
O principal takeaway é estrutural: os fornecedores de modelos estão monetizando mais rápido, enquanto os gargalos de infraestrutura estão se tornando a verdadeira limitação. Se essa tendência continuar, o valor pode continuar girando em direção às camadas que ajudam a reduzir o custo de inferência e alocar computação de forma mais eficiente.
Não é aconselhamento financeiro. Gerencie seu risco.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
64
Inicia sessão para explorar mais conteúdos
Junta-te a utilizadores de criptomoedas de todo o mundo na Binance Square
⚡️ Obtém informações úteis e recentes sobre criptomoedas.
💬 Com a confiança da maior exchange de criptomoedas do mundo.
👍 Descobre perspetivas reais de criadores verificados.
E-mail/Número de telefone
Tópicos em Tendência
1
#BinanceProcesses$4.65BWithdrawals
18,736 visualizações
101 a discutir
2
#WithdrawalsBack: 15 networks live
6,952 visualizações
121 a discutir
3
#BinanceUpdatesProofofReservesAddresses
113,477 visualizações
1,490 a discutir
4
#BinanceToResumePhaseOneOfWithdrawals
151,896 visualizações
1,574 a discutir
5
#BinanceHadAlreadyCovered$6BofHackLoss
10,247 visualizações
136 a discutir
6
#FBIConfirmsNorthKoreaIsResponsibleForBinanceCryptoHack
49,647 visualizações
149 a discutir
7
#CZDismissesClaimsBinanceHackWasPredicted
77,484 visualizações
745 a discutir
8
#B14gReportsUnauthorizedTransferOfAbout97MCORE
28,092 visualizações
378 a discutir
9
#USSpotETHETFsPost23StraightDaysOfNetOutflows
30,623 visualizações
369 a discutir
10
#IntelHasItsWorstDaySince1974
124,110 visualizações
977 a discutir