

花儿不在
17 投稿
花儿不在
報告
ユーザーをブロック
2 フォロー
5 フォロワー
3 いいね
投稿
·
--
翻訳参照
#opg $OPG
今天必须得唠唠OpenGradient——不是因为它画饼画得圆,是因为币安HODLer空投今天刚上线。我翻了一下午白皮书,发现这项目确实有点东西
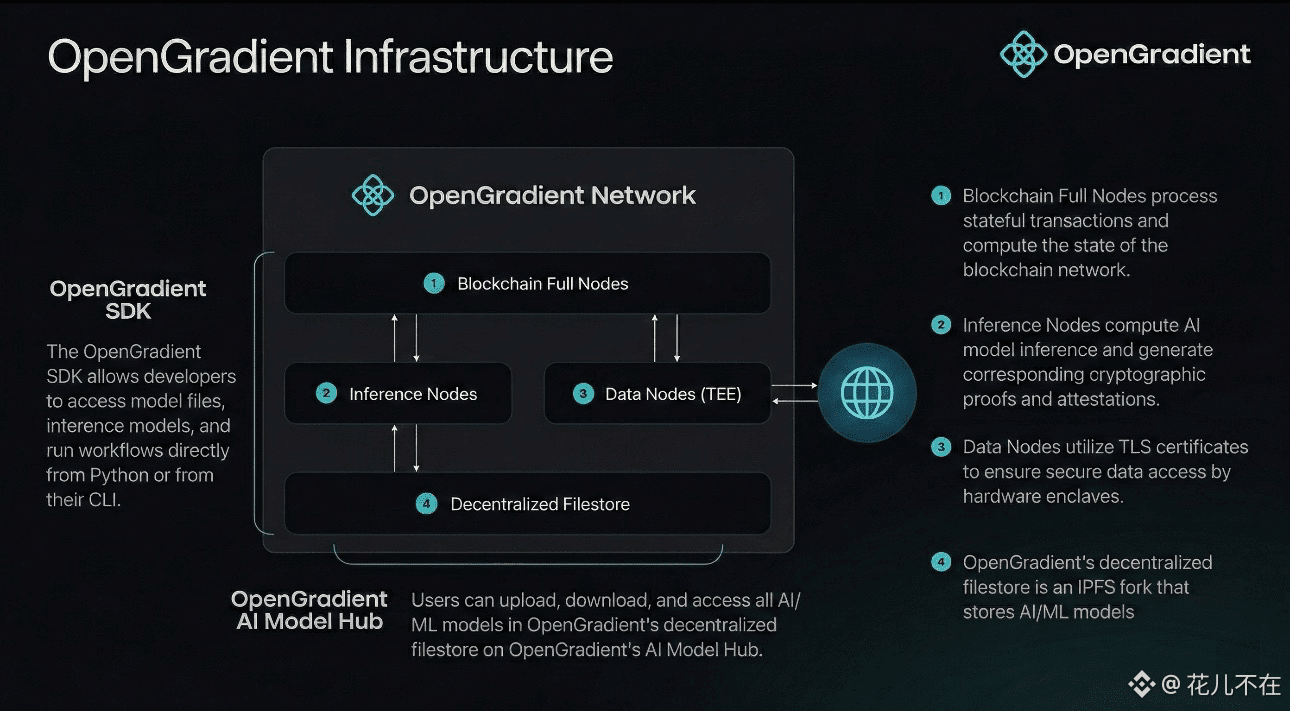
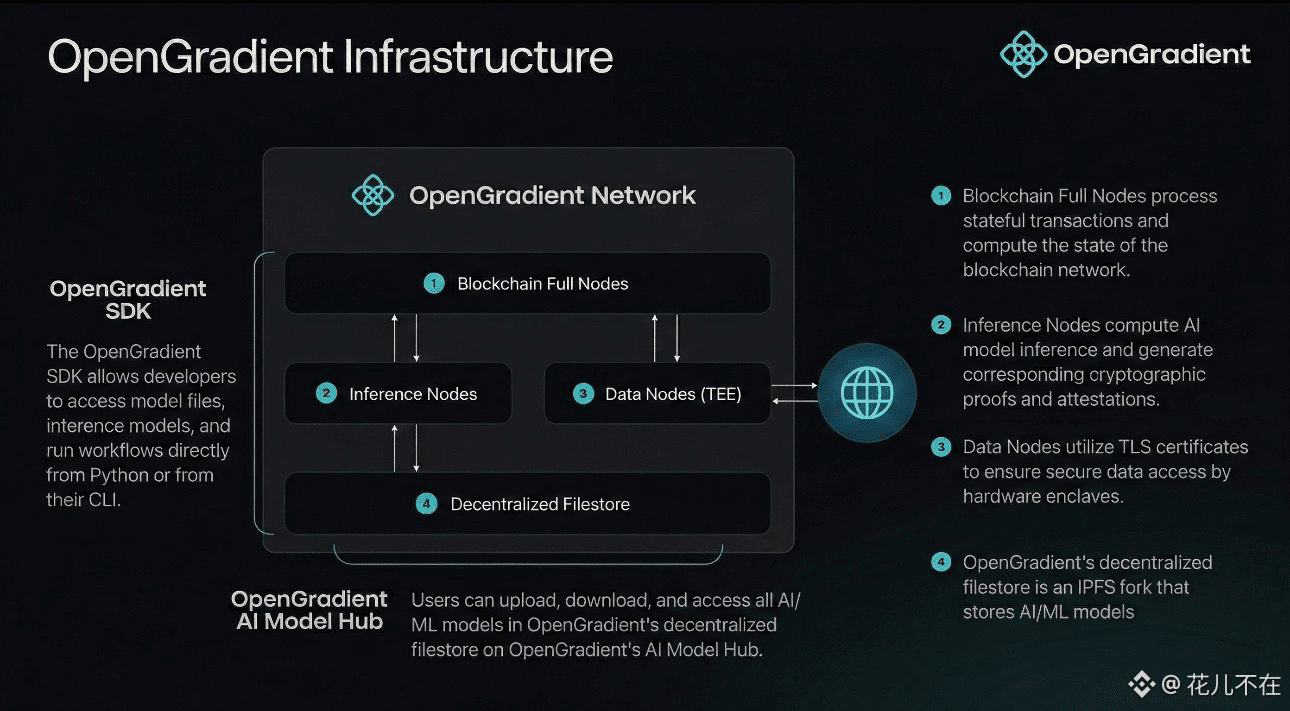
先说技术。如果让链上每个节点都去跑一遍大模型,网络直接瘫痪。OpenGradient白皮书里有句原话特别实在——“让每个验证节点独立重跑模型推理是不切实际的”。所以他们搞了套混合AI计算架构(HACA) ,把“执行”和“验证”彻底分开。推理节点用GPU和TEE跑模型、干重活;全节点只管验证TEE认证和ZKML证明、记个账。你不需要重跑一遍模型,只需要验证它跑对了。验证节点可以很轻量——就这么一个简单的认知转换,把性能和信任全解决了
再说产品。他们家那个Opg Chat,能直接用ChatGPT、Claude、Gemini、Grok这些模型,还能生成图片、传文件。关键是设备端加密——信息在离开浏览器之前就本地加密了,密钥只在你设备上。经过Oblivious HTTP中继时,中继能看到你的IP但只有密文;下游网关能看到明文但永远看不到你的IP。到了TEE隔离网关里才解密处理。而且TEE带远程认证,你可以自己验证这些隐私承诺。这相当于给你配了辆全封闭的超级运钞车——除了你自己,没人知道里面装了啥。Opg Chat上线两周已经服务超200万用户,处理了200多万次可验证推理。Model Hub上还集成了2000多个模型
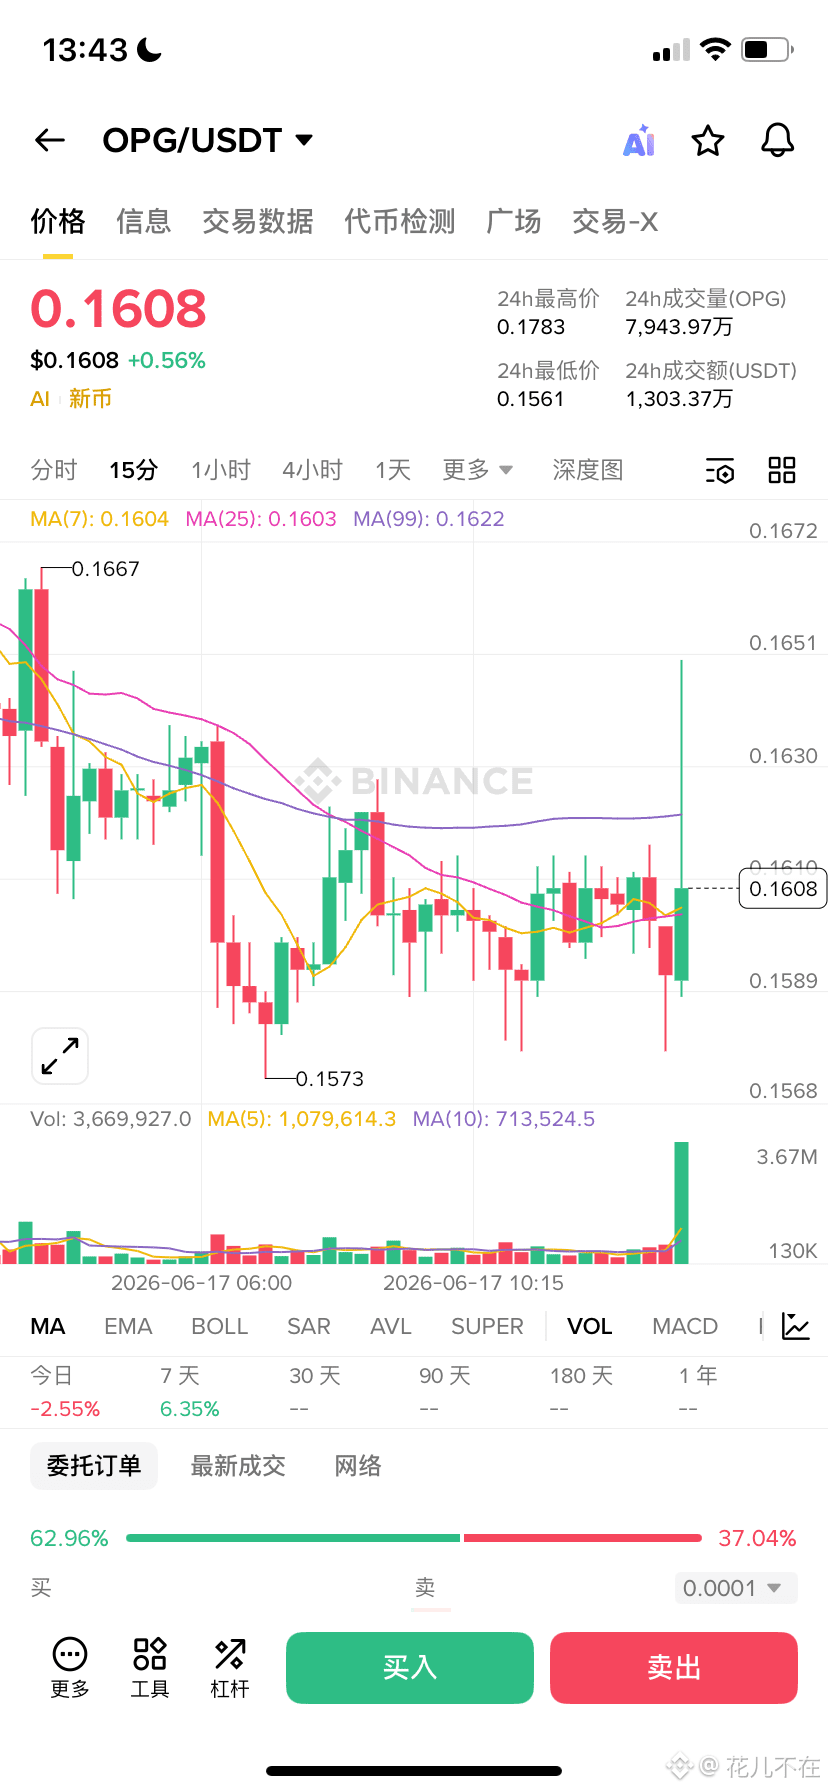
在算经济账。OPG总量10亿枚,流通约1.98亿枚。a16z crypto领投、Coinbase Ventures、SV Angel、Foresight Ventures等24家机构累计投了950万美元。币安第66期HODLer空投今天刚上线。但我也得说句实在话——空投是机会,可别光盯着糖果忘了脚下的荆棘。当前价格$0.15左右,全流通市值(FDV)超1.5亿美元,80%的代币还没解锁呢。项目还在测试网阶段,技术没大规模验证
我的结论很简单——技术叙事能打,空投机会真实,但80%未解锁的代币是悬在头顶的剑 @OpenGradient
1
127
·
--
翻訳参照
昨晚翻OpenGradient的文档翻到凌晨一点。看到"异步验证"四个字的时候,条件反射般地按了Ctrl+F,输入"验证失败"。
0 results。
又试了"failure"、"settlement"、"rollback"。全都没有。
HACA的设计其实很聪明。传统区块链让每个验证者重跑每笔交易,AI推理又贵又非确定,根本跑不动。OpenGradient的解法是把执行和验证拆开:推理节点跑模型,毫秒级返回结果;全节点异步验证TEE证明。验证节点不需要知道prompt是什么、模型是什么,只需要确认代码在飞地中未被篡改。
问题恰恰出在这儿。官方文档写得清楚:TEE证明验证的是"enclave was not tampered with",不是结果本身对不对。推理节点完全可以在TEE里"正确"跑完模型,返回一个错误结果——证明照样过。文档承认有"临时的信任缺口",但这个缺口怎么补,只字未提。$OPG
Gate学院有篇文章提到"验证失败,结果将被拒绝或重新计算"。可重新计算的钱谁出?已经执行的交易怎么回滚?官方文档里连个TODO都没留
你看看DeFi,验证失败有清算和罚没兜底;再看看乐观Rollup,有挑战期和欺诈证明。OpenGradient把"先出结果、后验证"当卖点,烂摊子谁来收拾——目前看是用户自己扛。#OPG
架构方向没问题。但在主网经济模型完整公布、验证失败处理机制写进文档之前,这笔账我得先算清楚。@OpenGradient
1
78
·
--
翻訳参照
别猜大模型有没有在后台给你换蒸馏版了,这事我踩过坑。调了两周的prompt,上线后结果忽高忽低,平台拍胸脯说版本一致,你连自证清白的手段都没有。
OpenGradient破局的手法不玩虚的,直接把推理关进CPU的TEE安全区里跑。这铁笼子狠在哪?算力跑起来那一刻,连云厂商的root管理员都扒不开数据帘子,输入输出全程物理级隔离。但这只解决了一半问题——你怎么保证跑的是GPT-4而不是GPT-3.5?它把模型权重哈希提前写死在链上Registry里,推理完硬件吐个签名凭证,两边对不上暗号直接作废。执行归执行,审计归审计,双人互检,缺一个就翻车。$OPG
OPG在这闭环里就是个“计价器”。每次调用走x402协议自动划扣,开发者接个Python SDK就不用管后头签名校验那些破事,只管写业务。OPG不值钱才怪,网络今天处理10万次推理它就流转10万次费用,处理100万次它就硬通货翻倍——这估值逻辑比画PPT的MEME币硬核多了#OPG
对比下市面:中心化API纯靠信任,zkML验证一步等三秒,商用直接劝退。OpenGradient选了个折中路线,牺牲点极致去中心化,换毫秒级可验证。别跟我扯什么去中心化AI的理想,当这玩意真开始替人批贷款、管私募的时候,“可验证”不是加分项,是叩门砖。谁先把硬件级的清白证明攥手里,谁就卡住下一代金融AI的脖子。吹概念的,靠边站。
@OpenGradient
82
·
--
翻訳参照
99%的人把质押当存钱罐,但@OpenGradient 白皮书第4.3节有一行被划过去的“魔鬼细节”——错误证明罚没(Slash)。读到这里我后背发凉:质押根本不是生息工具,而是AI推理的“信用保险金”。
验证者质押OPG,不是在挖矿,是在给网络写“欠条”:我对这次验证负责,错了,真金白银赔。OpenGradient每一次AI推理返回结果,背后都有人在用资产担保它的准确性。
对比传统AI就扎心了。 OpenAI、Claude、Gemini,全建立在“无成本证词”之上——模型没篡改?硬件没问题?全靠口头承诺。OpenGradient把道德约束换成了经济约束,把“我相信你”变成了“你不敢骗我,因为骗我有成本”。
这引出一个多数人没算过的供应侧推论:
质押中的OPG退出需要解绑期,Slash风险悬顶时,轻率退出的机会成本比留着更高。所以链上那批OPG,不是因为持有人看好,是因为被机制焊死在那里——被动锁仓和主动持有,是两码事。
如果Slash真实运行,OPG的供需模型将彻底重构:网络越繁荣→验证者需求越多→被责任锁死的筹码比例越高→自由流通盘越稀缺。这是一个非线性的通缩斜率。
当然,风险也摆在那: 验证者节点是否真实增长?Slash是否真实发生?这两组数据目前还是黑盒。但市场往往在“看不清”的时候定价最狠。
当别人还在卷TEE和ZKML技术名词时,聪明钱已经开始计算罚没机制带来的天然买盘压力。质押量决定网络的安全上限,而安全上限决定估值天花板——这个叙事,比单纯的AI Meme硬核十倍。
方向对了,数据会说话。静待验证者地址公开的那天。$OPG #opg @OpenGradient
1
94
·
--
翻訳参照
#opg $OPG 周末在咖啡店被店员安利“隐藏菜单”,满怀期待点了一杯——不过是普通拿铁加了焦糖糖浆。这让我想起币圈那些号称“AI革新”的项目,大多只是给大模型套了个发币的壳。但深度体验@OpenGradient后,确实让我改观不少。
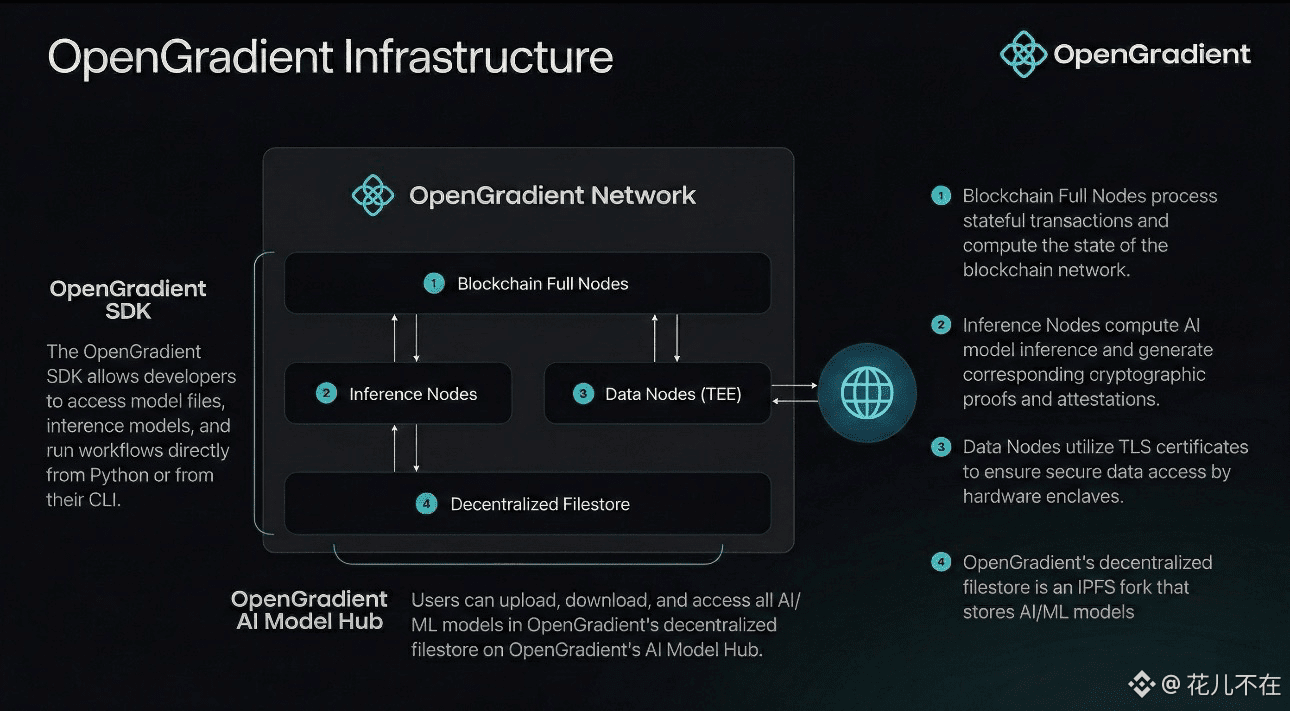
它的HACA混合AI计算架构打破了我对“区块链+AI=慢”的刻板印象。 传统区块链靠每个验证节点重复执行每笔交易达成共识,跑大模型在计算上完全不可行。HACA将网络拆分为三个专业角色:推理节点跑模型并生成可验证证明,全节点只验证证明的密码学有效性,数据节点获取可信外部输入。用户先拿结果,验证和结算异步完成——既保住Web2级速度,又锁死链上信任。
更让我觉得“真不一样”的是它的隐私设计。 OpenGradient Chat处理敏感信息时,消息在浏览器端就完成加密,密钥只存在你的设备上;通过Oblivious HTTP匿名中继后,在TEE可信环境中解密处理——运营方既看不到你是谁,也读不懂内容。对比ChatGPT们拿对话喂模型的套路,这才是真正的“架构级隐私”。
数据印证落地速度:4月上线Base以来,已托管超2000个模型、验证超50万份证明、处理超200万次推理。但我心里始终有个结:AI的“黑盒幻觉”与区块链的“透明契约”天生冲突。若模型推理出错,链上自动决策的风险谁来担?目前我只拿小仓位参与观望,既不盲目押注,也不愿错过。
当AI既能极速服务又能锁死隐私,它会是巨头的劲敌,还是一场技术豪赌?且看它下一步怎么解题@OpenGradient
88
·
--
#opg $OPG
今日は、うわべだけの話はしません。OpenGradientっていうやつを、最近やっと仕組みを理解しました。前に「全ノード」「ゼロ知識証明」みたいな言葉を見ると頭がぐるぐるして、遠い世界の話に思えたんです。でも根気よく、その仕組みが下でどう動いているかを分解してみたら、要するに、細かいことにこだわる“古株の会計士集団”が番人をやってるだけだと分かりました。ネット上のどこかのマシンがAIモデルを推論でも学習でも動かして結果を出したら、その帳簿をその「全ノード」たちに渡す必要がある。彼らは暗号の数式とTEEのハードウェアレポートを握っていて、ひとつひとつ照合するんです。合わなければ? 大々的に全ネットにブロードキャストして、不正してた証拠をきっちり晒す。さらに彼ら同士でも帳尻合わせの連絡を取り合って、どんな細部も漏れないようにしてる。
従来の大手企業は、データにミスが起きたら、せいぜいお詫び文を出して「人品は信じて続けてください」みたいな話にする。でもここでは違う。人品じゃない。数学が「規約違反」と言ったら終わり。泣きついても無駄で、全ノードはスタンプ(承認)を押さない。そもそも通らないんです。
あなたならきっと聞きますよね。「全ノード自身が悪さしたらどうするの?」って。彼らはバカじゃない。担保に出させられていて、OPGトークンを大きくロックしてから参加する。システムは毎日監視していて、監守自盗したりサボったりしたら、見つかり次第、担保を没収される。痛いでしょ? 逆に言うと、帳簿チェックをちゃんと頻繁にやって不正をあぶり出せば、システムがOPGを報酬として出す。しかも明確に値段がついてる。金をめぐらせたいのに合わないことできる?できない。しかもこの仕組みは、人情や社交の駆け引きをほぼ全部吹き飛ばして、利益と数学が噛み合うように作ってある。普通のユーザーは数万単位で高性能マシンを用意してノードを回す必要はなくて、あなたはフロントで呼び出すだけ。下の融通のきかない連中が責任を持って見張ってくれるので安心です。自分でも何回か試しましたが、爺さん婆さんに頼む必要なんてなく、普通に呼べばガチでバッチリ返ってきます。
今後、AIが機微データを扱うなら、この細部を絶対に離さないノードたちで支えるのが一番です。CEOが胸を叩くよりずっと頼もしい。口約束の代わりに数学でスタンプを押す。そのやり方が、自分の好みに合いました。そして、OPGを稼ぐために、彼らは誰よりも細かくチェックする。ごまかそうと思っても無理です。私はこの、無駄がないキレの良さが好き。誰の顔色を見る必要もなくて、アルゴリズムとハードウェアの“こだわり”だけで決まる。ほら、毎日「透明」と叫んでるだけで何も見えないようなプロジェクトより、こっちのほうがずっと良くない? とにかく自分は、今後AIを使うならこういう下層の仕組みを信じる。気持ちが落ち着きます。@OpenGradient
67
·
--
翻訳参照
#opg $OPG 你有没有想过,每次调用一个AI风控模型,真正危险的其实不是它“读”你的输入,而是它去后台取数据的那一瞬间?
我做过系统运维,见过太多日志里明晃晃地躺着用户ID、账户余额、最近几笔交易的触发原因。排查问题嘛,免不了翻请求参数和返回结果,可翻着翻着,一些不该看的东西就进了眼。这不是谁坏,是架构本身就没把“取数”当回事——应用服务器一手握着接口权限,一手把数据喂给模型,中间所有痕迹全留在普通日志里。外部数据源越多,这摊水就越浑,运维人员不知不觉就成了隐私的隐形观察者。
OpenGradient 的 Data Nodes 切的就是这个入口。它不是简单加个代理,而是把“拉数据”这个动作单独拎出来,塞进一个隔离的执行环境里。任务只告诉它“去查什么”和“按什么规则查”,真正的读取在 TEE 里头完成——那个环境连主机操作系统都插不进手,节点运营者想翻日志?翻到的全是乱码
但这还不够。我最在意的是它怎么证明自己没换料。Data Node 返回数据时,会附带一份远程认证凭据,相当于一个加密的“收货单”,写着:这份数据是某时某刻在指定环境里按指定条件取的。后面的推理节点拿着数据干活,验证节点只检查这张单子真不真。想偷换数据?单子对不上,全链驳回。验证的人自始至终不用看明文,这才是闭环
这套东西解决了一个很实在的困局:实时数据用越多,造假空间就越大;权限越集中,信任就越脆弱。以前我们靠“相信运维不会偷看”,现在把信任替换成可验证的流程——取数有隔离,结果有证明,追责有依据。隐私不再是一句承诺,而是被拆进架构里的硬条件。就这么简单@OpenGradient
81
·
--
翻訳参照
#opg $OPG 上次让AI帮我算笔定投收益,结果它把年化瞎翻了一倍,我差点头脑一热全仓冲进去。后来才反应过来,这玩意儿背后咋算的,我压根没地儿查,跟个黑箱似的。所以看到OpenGradient要砸箱子搞透明,我这种被坑过的新韭菜第一个想鼓掌。
它跟那些只会卷参数、卷视频多逼真的大厂不一样,核心就干一件事:把AI推理的过程,变成人人都能查的“公开账本”。怎么做到的?得拆开它的混合AI计算架构(HACA)。简单说就四个字:执行和验证分开干。
以前想把AI上链有个死结——让100个节点都去重跑一遍大模型,成本贵上天不说,大模型带“温度系数”每次回答还不一样,根本达不成共识。HACA直接换了思路:推理节点先跑模型快速出结果(这是快路径),同时异步生成密码学证明(慢路径),用的是TEE可信环境或者ZKML零知识证明。全链节点不重跑模型,只花几毫秒验证这个证明有没有效,底层用CometBFT共识拍板上链,谁也别想篡改。这套组合拳打下来,链上已经托管了4400多个模型,干了200多万次可验证推理,产出了50多万份证明,全是实打实的链上数据。
那让这套“透明监控”转起来的油钱,就是OPG代币。我们散户花OPG调用推理,节点赚服务费;想当节点得先质押OPG入场,要是敢在数据上搞鬼,质押物直接罚没。这套“付费干活、干坏赔钱”的玩法,等于把“不作恶”变成了经济账,比指望大厂良心靠谱一万倍。
以后我再用AI,就认准这种能查监控的。聪明但心眼多的机器,我这种新韭菜真伺候不起。@OpenGradient
99
·
--
#opg $OPG
OpenGradientについて話そう。派手な物語はさておき、HACAアーキテクチャを見ていく。
従来のブロックチェーンの問題は何か? 各ノードが毎回、取引をやり直して再実行しないといけないことだ。送金自体は問題ない。でも100のノードに70B級の大モデルを各々走らせるとなると、コストは100倍、時間も持たないし、結果も同じようにはならない。
OpenGradientのやり方は「実行」と「検証」を分けること。推論ノードはGPUで仕事をして、終わったらTEE認証かZKMLの証明を投げる。すると全ノードは証明だけを検証すればよく、わざわざ愚直にモデルを再実行する必要がない。
正直、この発想は技術的には筋が通っている。ノードは4つの役割に分かれている。推論ノードがモデルを実行し、全ノードは台帳として証明を検証し、データノードは外部情報を供給し、ストレージはWalrusに投げる。ただ、どこが問題か? TEEノードはハードウェア認証が厳しい。こんなの、家庭用PCで気軽に動かせるわけがない。誰がH100を買う? 誰がデータセンターの電気代を払う?
私は白書の経済モデルを特に調べてみた。総トークン供給は10億。ステーキング報酬が占めるのは1割だけで、96か月でリニアに放出される。96か月ってどういうこと? 8年だ。いまの$OPGの評価額だとすると、平均して毎月放出される分で、数台分のマシンのエアコン代は賄えるのか? ノード運営は慈善事業じゃない。補助が止まれば、計算力は誰よりも速く減る。
プロジェクト側はメインネットで200万回の推論を実行したと言っているが、推論ノードが実際に何台なのか、どんな構成なのかは今のところ非公開だ。技術ストーリーはセクシーでも、経済が成立するかどうかは別問題。私はとりあえずノード一覧をブックマークして、3か月後に照合するつもりだ。今突っ込む? まずは@OpenGradient も見直してみる。
#opg $OPG
OpenGradientについて話そう。派手な物語はさておき、HACAアーキテクチャを見ていく。
従来のブロックチェーンの問題は何か? 各ノードが毎回、取引をやり直して再実行しないといけないことだ。送金自体は問題ない。でも100のノードに70B級の大モデルを各々走らせるとなると、コストは100倍、時間も持たないし、結果も同じようにはならない。
OpenGradientのやり方は「実行」と「検証」を分けること。推論ノードはGPUで仕事をして、終わったらTEE認証かZKMLの証明を投げる。すると全ノードは証明だけを検証すればよく、わざわざ愚直にモデルを再実行する必要がない。
正直、この発想は技術的には筋が通っている。ノードは4つの役割に分かれている。推論ノードがモデルを実行し、全ノードは台帳として証明を検証し、データノードは外部情報を供給し、ストレージはWalrusに投げる。ただ、どこが問題か? TEEノードはハードウェア認証が厳しい。こんなの、家庭用PCで気軽に動かせるわけがない。誰がH100を買う? 誰がデータセンターの電気代を払う?
私は白書の経済モデルを特に調べてみた。総トークン供給は10億。ステーキング報酬が占めるのは1割だけで、96か月でリニアに放出される。96か月ってどういうこと? 8年だ。いまの$OPG の評価額だとすると、平均して毎月放出される分で、数台分のマシンのエアコン代は賄えるのか? ノード運営は慈善事業じゃない。補助が止まれば、計算力は誰よりも速く減る。
プロジェクト側はメインネットで200万回の推論を実行したと言っているが、推論ノードが実際に何台なのか、どんな構成なのかは今のところ非公開だ。技術ストーリーはセクシーでも、経済が成立するかどうかは別問題。私はとりあえずノード一覧をブックマークして、3か月後に照合するつもりだ。今突っ込む? まずは@OpenGradient も見直してみる。
1
94
·
--
翻訳参照
#opg $OPG 测了四天OpenGradient Chat,前后七八十条对话,从简单问答到多轮逻辑推理都试了,说点实操感受。
第一反应是快。晚上十一点和下午两三点都测过,高峰期也没明显卡顿,问完基本两秒内开始出字。翻白皮书第二章,他们把推理和验证拆成两条路径——GPU节点只管跑模型,结果单独走加密验证。这个设计实际体验中能感受到区别,不像有些项目,推理快了验证跟不上,或者验证做全了响应就拖垮。
但也有翻车。第三天晚上一条合约安全问题,推理很快,三秒出结果,但验证卡了快十秒,状态一直pending,差点以为断线。后来查链上记录,是某个验证节点出块慢了。白皮书不会写这种细节,但实际跑起来就是会遇到,这才是真实的链上AI。
再说节点分布。我找了两个跑过OPG节点的人聊,他们算了一笔账——目前OPG价格下,电费和机器折旧算进去,回本周期比官方说的长将近一倍。其中一个原话:“除非币价翻倍,不然扩机器就是赌。”目前全网推理节点就那么些,头部几个集中了大部分算力,这让我有点犹豫。
我的判断:拿它当中心化AI工具用,体验过关,甚至算好用。但链上验证那部分,暂时不会放大资金。等节点分散度从目前头部集中降到60%以下,再重新评估。OpenGradient的下限是验证路径在极端情况下会卡,上限看节点激励能否持续。用着爽和投着稳是两码事,我现在就盯着节点分布图看
@OpenGradient
102
·
--
本人確認中
翻訳参照
#opg OPG代币到底值不值得拿?说点实在的
先说结论:OPG不是那种让你无脑冲的币,但它的价值逻辑比大多数AI项目要硬。
很多人一上来就问价格,我告诉你,6月16号OPG是0.1618美元,市值3000万出头。但这都不重要。你得先搞清楚一件事——这个代币到底有没有人用?
需求是真的还是假的?
OpenGradient现在跑了200多万次可验证AI推理,托了2000多个模型在上面。每次推理调用都要烧OPG。这不是那种项目方自己刷的数据,是可验证的链上记录。
币安5月22号上了现货,韩国Upbit也跟进。说白了大交易所愿意接,说明尽调过了,不是空气。
代币分配里有玄机
总量10亿,现在流通不到1.9亿,19%左右。乍一看有解锁压力对不对?但你仔细看:生态40%要60个月慢慢放,贡献者和投资者那25%都锁12个月才开始放,一放就是36个月。这意味着什么?大仓位被摁住了,短期内不会砸盘。
四层价值捕获
OPG不是治理币那种虚头巴脑的东西。它是支付工具,你调AI模型就得花OPG;节点要干活得先质押OPG,搞鬼了直接罚没;开发者上传模型也能赚OPG。四层需求叠在一起,比那种只会投票的空气币强太多了。
风险也得说清楚
TEE依赖AWS,这是个中心化风险。项目方自己也清楚,但没办法,短期没有比Nitro更好的选择。另外ZKML那套对LLM成本太高,大部分场景还是靠TEE顶着。
最后说句实在话$OPG
这个赛道真正的考验是:当可验证AI推理成为刚需,OPG的消耗速度能不能跑赢代币解锁。现在盘子小,波动大,自己掂量着来。@OpenGradient
1
1
439
·
--
翻訳参照
#opg $OPG 先说一个反直觉的判断:OpenGradient要解决的不是“AI不够强”,而是“AI不可信”。LLM输出的投资建议或交易信号,用户无法独立验证计算过程是否被篡改。白皮书的核心思路就是把这个过程变成“可审计的计算”。
一、HACA:执行与验证解耦
传统区块链要求每个验证节点重新执行每笔交易,这对AI推理不现实。OpenGradient的HACA架构把网络拆成三层:推理节点(GPU+TEE执行模型,返回结果,区块链不在关键路径上)、全节点(验证TEE/ZKML证明,同时用CometBFT共识维护账本)、数据节点(TEE内安全获取外部数据)。验证节点不跑模型,只检查证明——这是性能优化的核心。
二、验证框架:信任等级菜单
白皮书设计了三种验证路径:TEE(AWS Nitro Enclaves,认证文档证明环境未被篡改,覆盖LLM和大部分ML场景)、ZKML(零知识证明,数学级别确定性,但成本高,仅用于高风险ML推理)、Vanilla(无证明,低要求场景)。x402支付协议已嵌入每个TEE实例,消除中心化中间件,支持异步结算,预充值后推理请求不被链上阻塞。
三、代币与现状
OPG总供应量10亿枚,2026年4月TGE于Base链,当前流通约19%。代币用于支付推理费、质押罚没、治理投票。生态、贡献者、投资者份额均有长期锁仓(12个月cliff+36个月线性释放),短期抛压受控。网络目前处于测试网阶段,已处理200万+可验证推理,托管2000+模型,生成50万+证明。
值得观察的风险:TEE依赖AWS Nitro,去中心化存在集中化张力;ZKML对LLM尚不现实,验证的“成本-安全”权衡由开发者承担;未来两年供给释放持续,需网络收入增长匹配。
当“可验证”成为AI输出的默认要求,OpenGradient的架构取舍才有真正的护城河。
#OPG $OPG @OpenGradient
113
·
--
翻訳参照
#opg $OPG 聊点实在的。很多人盯着OPG代币价格,没搞懂它底层HACA架构到底在解决什么。
传统区块链玩不转AI,原因特简单。以太坊那套逻辑是每个验证节点把同一笔交易重新跑一遍,结果一致就达成共识。转账没问题,但AI推理呢?跑700亿参数大模型,需要GPU、需要时间、每次输出还不一样。让100个验证节点各跑一遍?成本翻100倍,时间拖到死。有人把AI当“预言机”数据喂进来,等于把信任从AI提供商挪到预言机提供商,换汤不换药。
OpenGradient的思路就一个字:拆。HACA的核心:执行和验证分开搞。三种节点各干各的:
· 推理节点——GPU跑模型,结果直接甩给用户,延迟跟用ChatGPT差不多。
· 全节点——不跑模型,只验证推理节点提交的密码学证明(TEE或ZKML)。验证通过就记上链,根本不需要知道提示词、模型、结果是啥,纯密码学操作。
· 数据节点——专门从外部抓数据,TEE里搞,确保数据没被动手脚。
这设计妙在哪?推理走“快路径”——你发请求、GPU算、结果秒回你,区块链不掺和。验证走“慢路径”——证明异步提交、全节点验证、链上记录。速度是Web2级别,信任是Web3级别。推理节点越多吞吐量越大,验证层压力一点不涨——证明验证就毫秒级,跟你跑模型花了5秒还是50秒没关系。
说人话:你拿到结果的速度跟用ChatGPT一样快,但每个结果都能被独立验证、永久追溯——不需要信任何人。
目前主网跑了200多万次可验证推理、50多万份证明、2000多个模型。a16z和Coinbase Ventures已上车。这机制把“黑盒AI”拆成“透明流水线”,方向对了,剩下的看生态能不能跑起来@OpenGradient
95
·
--
#bedrock $BR 現在の圈子では、Bedrock全链流动性のプロモーション文が至る所で見られます。エアドロップの利好と高額なリターンが市場を刺激し、多くの散户がフォローして借り入れやインタラクションを増やし、報酬を得ることで利益を上げようとしています。実際に半月間試してみた後、宣伝の包装を脱ぎ捨て、普通の投資者の視点からプロジェクトの真実の姿についてお話しします。
uniBTCに基づいて構築されたクロスチェーンの利息生成システムは、このプロジェクトの核心的なハイライトです。以前は、BTC資産を複数のエコシステムで運用するためには、何度もブリッジを渡る必要があり、時間がかかるだけでなく、多くのオンチェーン手数料も発生しました。しかし、プラットフォームの単点ステーキングで流動性証明書を生成でき、資産は各種の収益プロトコル間を柔軟に移動できるため、資金の回転効率は市場に存在する従来のステーキング商品を大きく上回ります。アーキテクチャの設計は大口資金に非常に優しいです。
しかし、操作を簡素化するために、プロジェクトは基盤のノード管理、資産のリスク管理、資金の集約ルールをすべて内部で封装しています。ユーザーはフロントエンドで帳面上の利益を見ることしかできず、基盤資産の保管明細を自分で確認することができません。オンチェーンの透明性を重視する古参プレイヤーにとって、これは無視できないリスクです。
現在、多くの数百U規模の散户がフォローして循環ステーキングを行い、タスクをこなしていますが、全体の経済モデルは本質的にクジラに偏っています。小額資金の頻繁な操作がもたらすGas費用や交換スリッページは、次第にわずかなエコシステムの報酬を食いつぶしてしまい、大部分の参加者は最終的に利益を得ることができず、逆にプロジェクトのTVLを引き上げる結果となります。
実践的なアドバイスとしては、心を平静に保ち、エアドロップで一攫千金を狙う考えを放棄し、プロジェクトを流動性ツールとして扱うことです。ステーキングで得た証明書を老舗DeFiと組み合わせて安定した構成を作り、エアドロップは追加のサプライズと考えると良いでしょう。市場の炒作熱が落ち着いて、エコシステムの実際の留存資金を観察した後に、次の投資を計画することをお勧めします。
#Bedrock #btcfire @Bedrock
65
·
--
#bedrock $BR ヶ月も経たないうちに、コミュニティ内でBRポイントを晒す人がどんどん増えてきた。友人の中には、ランキングのトップ10のスクリーンショットをプロフィール画像にして、会う人ごとに「これがBTCFiの真の力だ」と言っている人もいる。正直なところ、その時は笑いを堪えるのが大変だった——DeFiのインフラ業界で6年ももがいてきて、MakerDAOから今の再ステーキングのトラックまで、この「資金のハードル」を「ユーザーインセンティブ」として包装する手法は、もう何度も見てきた。
要するに、BedrockがBTCFiのトラックで異彩を放つ理由は、単にBTCをクロスチェーンさせるだけじゃないってこと。気づいた? それが本当の競争優位性は、一見公平に見える非線形ポイント減衰モデルにある。プロジェクトチームは賢くて、「資金量不足者はお断り」という明言を避け、ポイントの公式を使って静かに資本の階層を完成させている。同じく1 BTCをステーキングしても、大口は1年間ロックすることで得られるポイントは、小口が頻繁に出入りして3ヶ月間に得るポイントの合計に匹敵する。資金の種類が違えば、ディスカウントシステムも2つあって、その間には決して越えられない利益のドームがある。
この設計はプロトコルにとってのメリットが明白すぎる:TVLは風船のように5億から30億に膨れ上がり、資本の粘着性は重層的な契約の中にロックされていて、巨鯨ですら簡単には離れられない。しかし、その代償は全て小口投資家が負うことになる——私は群の中で、毎日3つのアラームを設定して、午前2時に起きてプールを切り替えてポイントを稼ごうとしている人を目の当たりにした。手数料で数千Uを使っても、ポイントランキングは全く動かない。なぜか? それは、蓄積された時間と資金の量で決まるモデルの中で、小口の回転資金は常に大口の休眠資産に敵わないからだ。
さらに皮肉なのは、プラットフォームが「勤勉すれば収入が増える」という幻想を演出していることだ。毎日APYの変動を見つめて、資金を異なるプール間で移動させて、0.01%のポイント増加に自分を感動させるという、このシーシュポス的な繰り返しは、本当に公平な参加と呼べるのか? 私たちはただ、伝統金融の食物連鎖の底辺から、チェーン上のポイントシステムの従属層に移動しただけだ。機関によってプレミアムを収穫された$BR ポイントの背後には、無数の小口資金が時間とスケールにより二重に希釈された沈没コストがある。
#bedrock $BR @Bedrock
104
ログインして、さらにコンテンツを読む
厳選トピックで世界の暗号資産トレーダーの仲間入り
⚡️ 暗号資産に関する最新かつ有益な情報が見つかります。
💬 世界最大の暗号資産取引所から信頼されています。
👍 認証を受けたクリエイターから、有益なインサイトを得られます。
メール / 電話番号
トレンドトピック
ADAGains10%Above$0.27
閲覧回数 8,281
142人が討論中
$ADA は本日大きく上昇し、10%超値上がりして027前後に達し、90日間の新高値を更新しました。
取引高も10億を超えて急増しており、市場の活況を示しています。
この動きは、$ADA が6月の安値から回復を続けるなか、最近のテクニカル面の形勢がより強気に転じたことを背景としています。
現在、027~028のゾーンが注目すべき重要な水準です。上抜けが続けば、さらに上の抵抗線を目指す展開となる可能性があります。
ただし、これほど急激な日中の値動きの後は、ボラティリティが高い状態が続く可能性があります。
#ADAGains10%Above$0.27 #crypto #ADA #Cardano #crypto #Write2Earn
AbdullahAbid_7
·いいね:0件
·閲覧回数 282
ETHUp70%InQ3ButLiquidityFalls
閲覧回数 97,163
871人が討論中
EthStakingExitQueueHits2026High
閲覧回数 36,251
644人が討論中