

#aiinference
aiinference
閲覧回数 1,217
7人が討論中
注目
最新
·
--
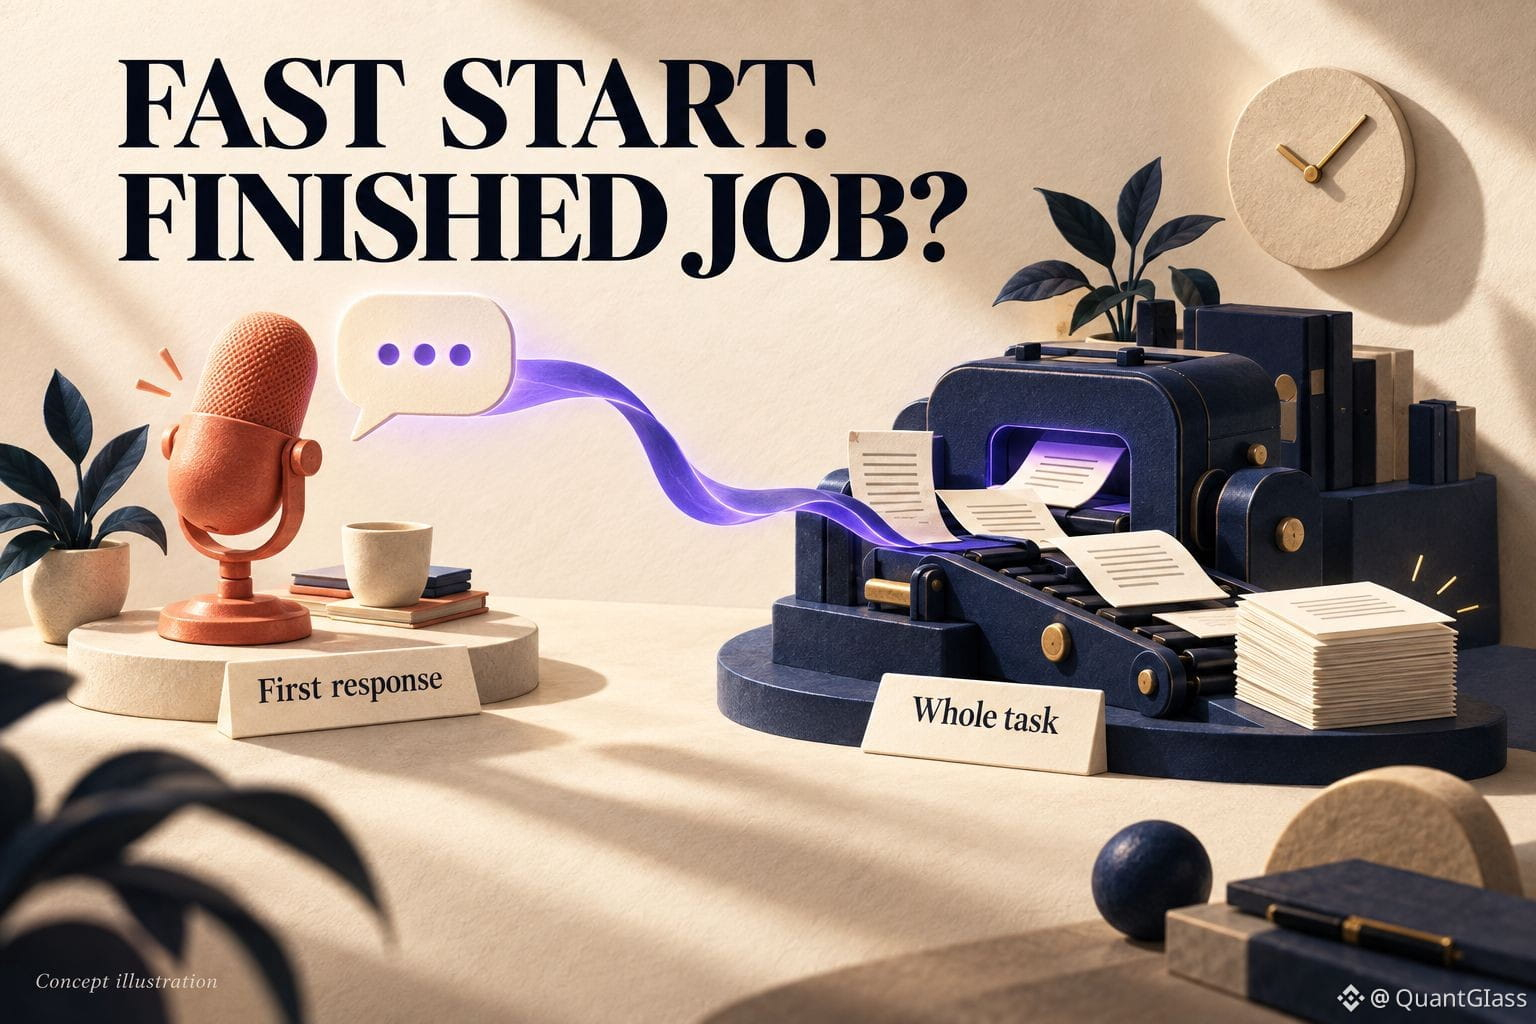
すぐに返事を始めるAIでも、仕事が終わるまでには何時間もかかることがあります。
9月18日の記事で、io.netは「最初のトークンまでの時間(time-to-first-token)」――出力が始まるまでの待ち時間――と「バッチ処理のスループット」を区別しています。io.netは分散GPUを、最初のトークン競争で勝つことよりも、コストと柔軟性の観点で配置しています。
$IO computeの話について私が行うテストは、タスク全体を測ることです。ライブ音声アシスタントには素早い応答が必要ですが、徹夜のドキュメント作業では、期限までに、かつ妥当な総コストで正確な結果が必要になります。記事中のコスト例は説明のためのもので、独立したベンチマークではありません。実際のワークロードでは、やはりテストが必要です。
よりイライラするのはどちらですか。最初の一言を待つこと、完成した答えを待つこと? #AIInference
167
·
--
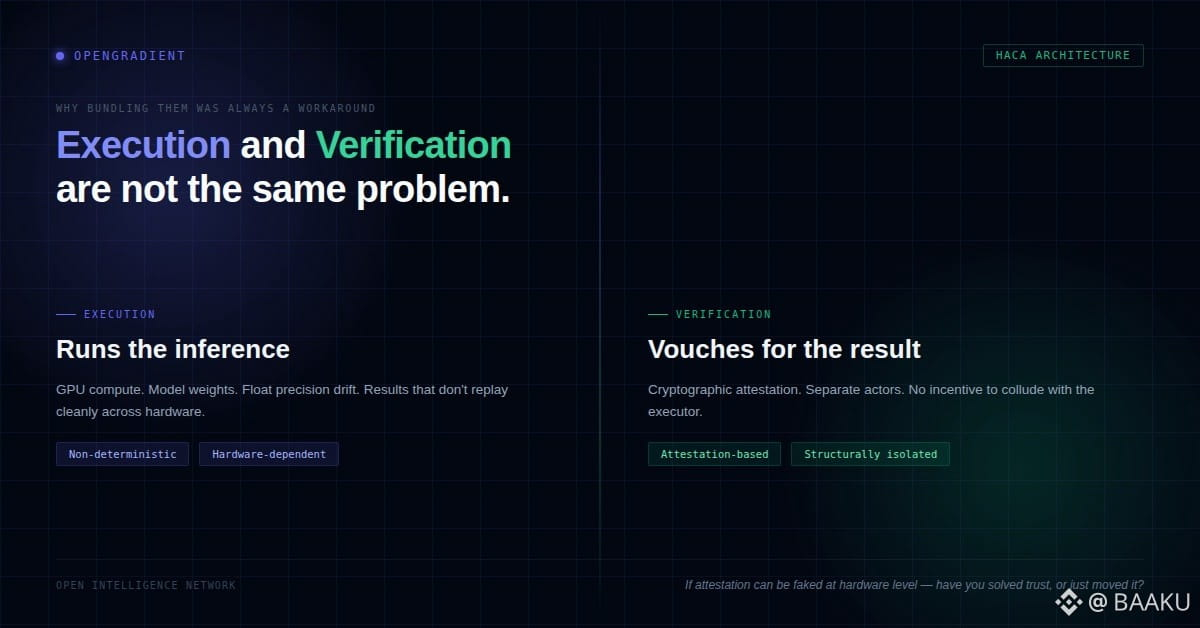
ほとんどのブロックチェーンは、実行と検証を同じ問題のように扱っていますが、実際にはそうではありません。
実行は計算です。検証は信頼です。それらを一緒に束ねることは、常に回避策であり、設計上の選択ではありませんでした。そして何年もの間、モデルが「もう一度実行してチェックする」という感じで十分シンプルだったため、誰もそれに気づきませんでした。
今はもうそうではありません。
AIの推論はきれいに再生されません。同じモデルを異なるハードウェアで二度実行すると、異なる出力が得られることがあります。浮動小数点の精度、温度の変動、GPUのクセ — 結果はずれます。だから、あなたの検証レイヤーが「再実行して比較する」だけの場合、すでに負けています。あなたは真実を検証しているのではなく、理想的な条件下での一貫性を検証しているのです。これは全く異なることです。
これが、「オンチェーンで検証可能なAI」について語るときにほとんどの人がスキップするギャップです。
OpenGradientのHACAアーキテクチャは、実際にこれら二つのレイヤーを分離しています。実行ノードは推論を実行し、別の検証レイヤーが結果をチェックします — 再実行ではなく、暗号的な証明を使用します。モデルを実行したノードとそれを保証するシステムは、構造的に異なるアクターであり、異なるインセンティブを持っています。
その分離は、人々が気づいている以上に重要です。実行と検証が同じ論理で処理されると、システムの信頼モデルは実行者の誠実さと同じくらいしか良くありません。あなたはAIを検証しているのではなく、ランナーが自己報告することを信頼しています。
役割を分けると、インセンティブ構造が実際に変わります。検証ノードは実行者と共謀する理由がありません — 彼らはモデルを実行しておらず、ただ証明をチェックしているだけです。それは理論的なものではなく、実際の信頼の境界です。
正直な制限:証明ベースの検証はまだ成熟していません。暗号的なオーバーヘッドは現実のものであり、大規模モデルにおける「正しい推論の証明」は解決された問題ではありません。設計の方向性は防御可能です。しかし、実際のセキュリティの仮定は、裏で多くの静かな作業をしています。
#OpenGradient #DecentralizedAI #AIInference #opg $OPG @OpenGradient
5
2
97
·
--
ほとんどの人は、決済がただの退屈なバックエンドの作業だと思っている。「ただ動いている」部分だと。
だからこそ、最悪のタイミングで壊れてしまうのだ。
実際に何が起こっているのか見てみよう。AIモデルが推論を実行する時 — 出力を生成し、決定を下し、結果をスコアリングする — その出力が本物かどうか、あなたには全く分からない。検証可能な意味で。誰か別のサーバーのブラックボックスに真実を教えてもらうのを信頼しているだけだ。そして、現在のAIインフラの99%では、それが全てのセキュリティモデルなのだ。信じてくれ、兄弟。実稼働中で、スケールしている。
決済はこれを解決することになっている。アイデアはシンプルだ:モデルを実行し、正しく実行されたことを証明し、その証明を記録すれば、出力には整合性が生まれる。簡単だ。
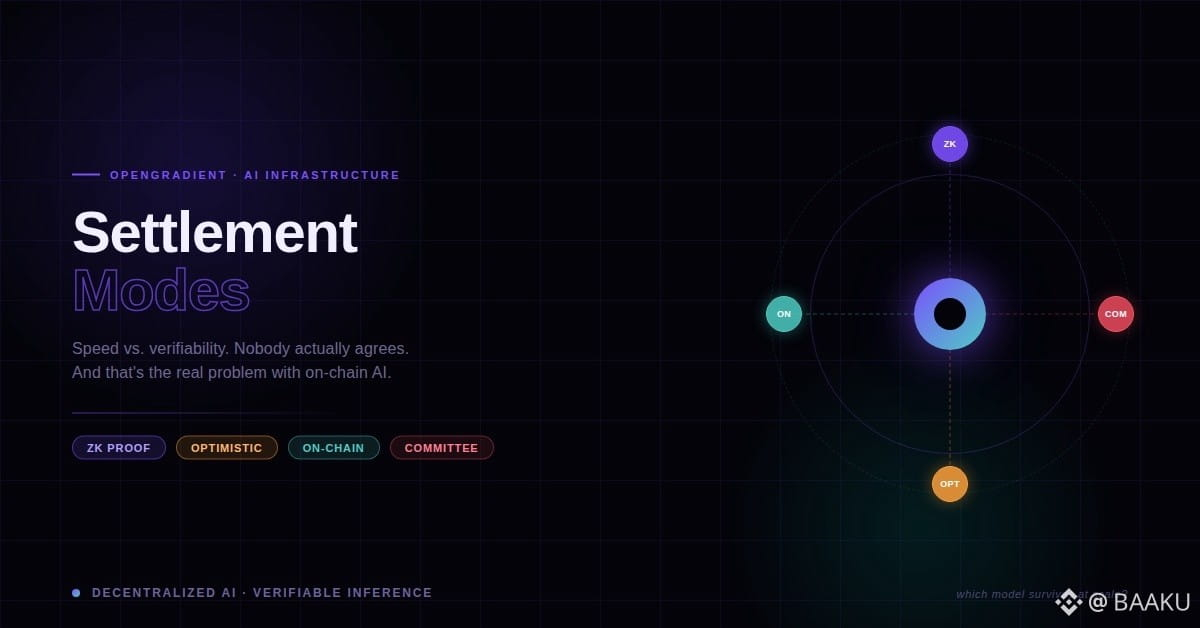
ただし、その証明がどのように決済されるのか — オンチェーン、オフチェーン、楽観的、ZK、委員会ベース — を尋ねた瞬間、誰も実際には同意しないことに気づく。そして、そのトレードオフマトリクスは残酷だ。
オンチェーン決済は実際の検証可能性を提供するが、リアルタイムAI推論を完全に実用不可能にする遅延を導入する。モデルがコールを行うたびにブロック確認に12秒待つわけにはいかない。
楽観的決済は速いが、整合性の問題を先送りにする — 誰かが異議を唱えない限り、正しさを仮定している。ほとんどのユーザーは何も異議を唱えないだろう。それが人間の行動だ。
#OpenGradient #AIInference #opg $OPG @OpenGradient
6
5
198

A16Zは、オンデバイス・エージェントが「$AI NARRATIVE!」を燃え上がらせる—ローカルAI革命を後押し ⚡ 🦈
📌 シリコンバレーの大手、a16zとKhosla VenturesがConway ResearchのUnderdogローカル・エージェントに、機関投資家としての資金を投入しました。MLX上で4Bパラメータのコンパクトなモデルを、コンシューマー機器上で4.5倍の速度で動作させることで、ゼロクラウド実行への大規模な構造的転換を示しています。💡
賢い資金は、かさばるデータセンターモデルから、俊敏なオンデバイス知能への移行を積極的に先回りしています。📊 エッジコンピュートが自律エージェント実行と収束するにつれ、ローカルAI基盤は市場をまたいだ次の主要なナラティブ要因として急速に立ち上がりつつあります。⚡
🤔 ローカルAIエージェントは、日常タスクにおいて中央集権型のクラウドモデルを時代遅れにしてしまうのでしょうか? 👇
⚠️ 金融助言ではありません。常にリスクを管理してください。🛡️
🏷️ #AI #CryptoAI #TechTrends #Agents #AIInference
🔥 ⚡
123
ログインして、さらにコンテンツを読む
厳選トピックで世界の暗号資産トレーダーの仲間入り
⚡️ 暗号資産に関する最新かつ有益な情報が見つかります。
💬 世界最大の暗号資産取引所から信頼されています。
👍 認証を受けたクリエイターから、有益なインサイトを得られます。
メール / 電話番号
トレンドトピック
1
#ZcashETFPostsFirstWeeklyOutflow$93.6M
閲覧回数 33,809
98人が討論中
2
#GreekPoliceBustCryptoScamRingArrest17
閲覧回数 69,893
672人が討論中
3
#BitcoinRejectedAt$87K
閲覧回数 119,027
156人が討論中
4
#FedOctoberRateHikeOddsFallTo17%
閲覧回数 95,509
956人が討論中
5
#NvidiaHitsRecordHighUp2.4%
閲覧回数 64,260
700人が討論中
6
#CanaryFilesAmendedS1ForPEPEETF
閲覧回数 18,293
493人が討論中
7
#USRussiaUkraineTalksReportedlyIncludeLukoilOilDeal
閲覧回数 28,824
490人が討論中
8
#BitcoinParesGainsAfterRallyTo$86.5K
閲覧回数 46,929
166人が討論中
9
#CerebrasSinksNearly20%OnReportNvidiaToPowerOpenAI
閲覧回数 114,066
1,098人が討論中
10
#SECProposesCryptoCustodyRules
閲覧回数 154,067
1,376人が討論中