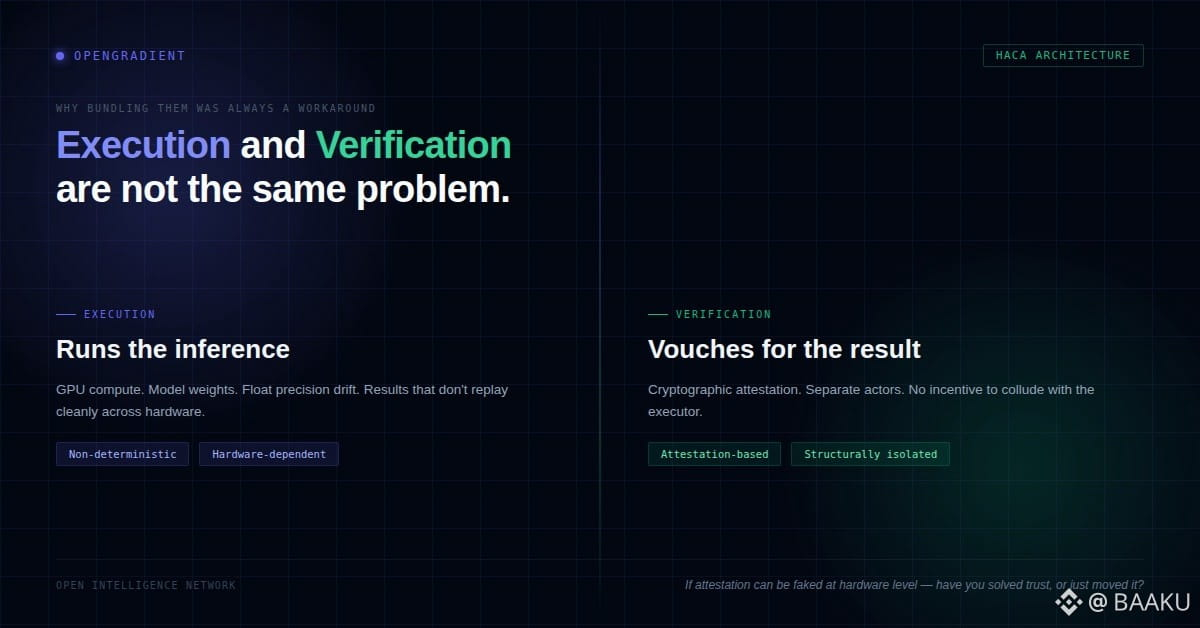
ほとんどのブロックチェーンは、実行と検証を同じ問題のように扱っていますが、実際にはそうではありません。
実行は計算です。検証は信頼です。それらを一緒に束ねることは、常に回避策であり、設計上の選択ではありませんでした。そして何年もの間、モデルが「もう一度実行してチェックする」という感じで十分シンプルだったため、誰もそれに気づきませんでした。
今はもうそうではありません。
AIの推論はきれいに再生されません。同じモデルを異なるハードウェアで二度実行すると、異なる出力が得られることがあります。浮動小数点の精度、温度の変動、GPUのクセ — 結果はずれます。だから、あなたの検証レイヤーが「再実行して比較する」だけの場合、すでに負けています。あなたは真実を検証しているのではなく、理想的な条件下での一貫性を検証しているのです。これは全く異なることです。
これが、「オンチェーンで検証可能なAI」について語るときにほとんどの人がスキップするギャップです。
OpenGradientのHACAアーキテクチャは、実際にこれら二つのレイヤーを分離しています。実行ノードは推論を実行し、別の検証レイヤーが結果をチェックします — 再実行ではなく、暗号的な証明を使用します。モデルを実行したノードとそれを保証するシステムは、構造的に異なるアクターであり、異なるインセンティブを持っています。
その分離は、人々が気づいている以上に重要です。実行と検証が同じ論理で処理されると、システムの信頼モデルは実行者の誠実さと同じくらいしか良くありません。あなたはAIを検証しているのではなく、ランナーが自己報告することを信頼しています。
役割を分けると、インセンティブ構造が実際に変わります。検証ノードは実行者と共謀する理由がありません — 彼らはモデルを実行しておらず、ただ証明をチェックしているだけです。それは理論的なものではなく、実際の信頼の境界です。
正直な制限:証明ベースの検証はまだ成熟していません。暗号的なオーバーヘッドは現実のものであり、大規模モデルにおける「正しい推論の証明」は解決された問題ではありません。設計の方向性は防御可能です。しかし、実際のセキュリティの仮定は、裏で多くの静かな作業をしています。
#OpenGradient #DecentralizedAI #AIInference #opg $OPG @OpenGradient