
Xinyu-新宇
108 Publications
Xinyu-新宇
Crypto explorer | Market watcher | Future builder 🚀
Ouvert au trading
Trade régulièrement
1.4 an(s)
16 Suivis
7 Abonnés
161 J’aime
Publications
Portefeuille
Tous
Citations
Âkšhu-艾
·
--
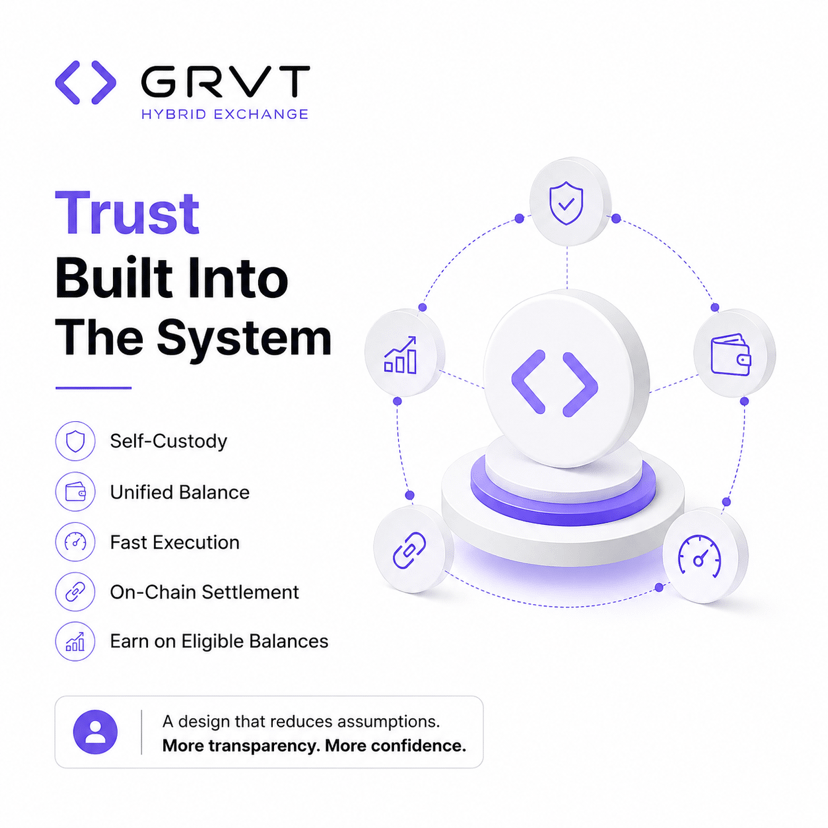
#grvt @grvt_io Chaque système numérique exige de la confiance quelque part. La question intéressante est de savoir si cette confiance provient de promesses ou de la conception. Cette réflexion m’est restée lorsque j’explorais GRVT. Au lieu de séparer la garde, l’exécution, le règlement et la gestion des soldes en expériences distinctes, son architecture d’échange hybride les réunit dans un seul modèle opérationnel où chaque partie renforce les autres. La garde auto, un solde unifié, une exécution rapide, un règlement on-chain, et des gains sur les soldes éligibles ont plus de sens ensemble que séparément. Je me suis surpris à penser moins aux transactions et davantage à la confiance. Un système semble différent lorsque moins d’issues dépendent d’hypothèses et que davantage d’entre elles peuvent être comprises à travers sa structure. Cela a fait évoluer ma façon d’envisager l’infrastructure d’échange. La conception la plus précieuse n’est peut-être pas celle qui demande aux utilisateurs de lui faire davantage confiance, mais celle qui réduit silencieusement, en premier lieu, la quantité de confiance dont elle a besoin.
Âkšhu-艾
·
--
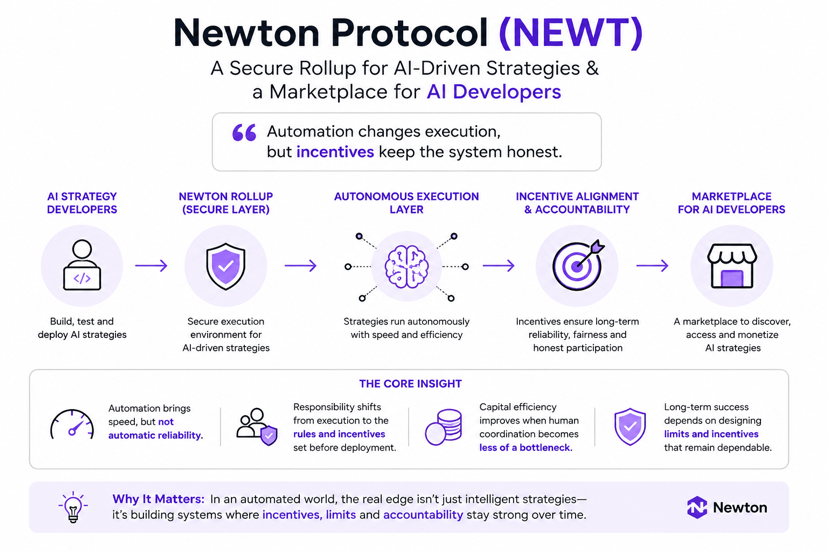
Un détail ne cessait de m’interrompre pendant que j’explorais Newton Protocol. Plus je regardais des stratégies automatisées, moins je pensais à la manière dont elles prennent des décisions, et plus je me demandais qui a le droit de définir les limites que ces décisions ne peuvent jamais franchir. Ce n’était pas la question à laquelle je m’attendais à devoir rester avec.
Je suis retourné dans certaines parties de la documentation, parce que ma première impression me semblait trop simple. Il est facile d’admirer l’exécution plus rapide, mais l’automatisation modifie aussi l’endroit où réside la responsabilité. Au lieu de disparaître, elle se déplace vers les règles, les incitations et les hypothèses qui existent avant même qu’une stratégie ne soit déployée. Je n’avais pas pensé à cette distinction.
Ce qui m’a marqué n’était pas une fonctionnalité ni un choix de conception technique. C’était la prise de conscience que l’efficacité du capital peut s’améliorer, tandis que le véritable défi devient silencieusement de concevoir des limites qui restent fiables bien après que l’intervention humaine soit devenue l’exception plutôt que la routine. Cette pensée est restée dans mon carnet plus longtemps que tout le reste que j’avais lu.
#Newt $NEWT @NewtonProtocol
Je suis retourné dans certaines parties de la documentation, parce que ma première impression me semblait trop simple. Il est facile d’admirer l’exécution plus rapide, mais l’automatisation modifie aussi l’endroit où réside la responsabilité. Au lieu de disparaître, elle se déplace vers les règles, les incitations et les hypothèses qui existent avant même qu’une stratégie ne soit déployée. Je n’avais pas pensé à cette distinction.
Ce qui m’a marqué n’était pas une fonctionnalité ni un choix de conception technique. C’était la prise de conscience que l’efficacité du capital peut s’améliorer, tandis que le véritable défi devient silencieusement de concevoir des limites qui restent fiables bien après que l’intervention humaine soit devenue l’exception plutôt que la routine. Cette pensée est restée dans mon carnet plus longtemps que tout le reste que j’avais lu.
#Newt $NEWT @NewtonProtocol
Âkšhu-艾
·
--
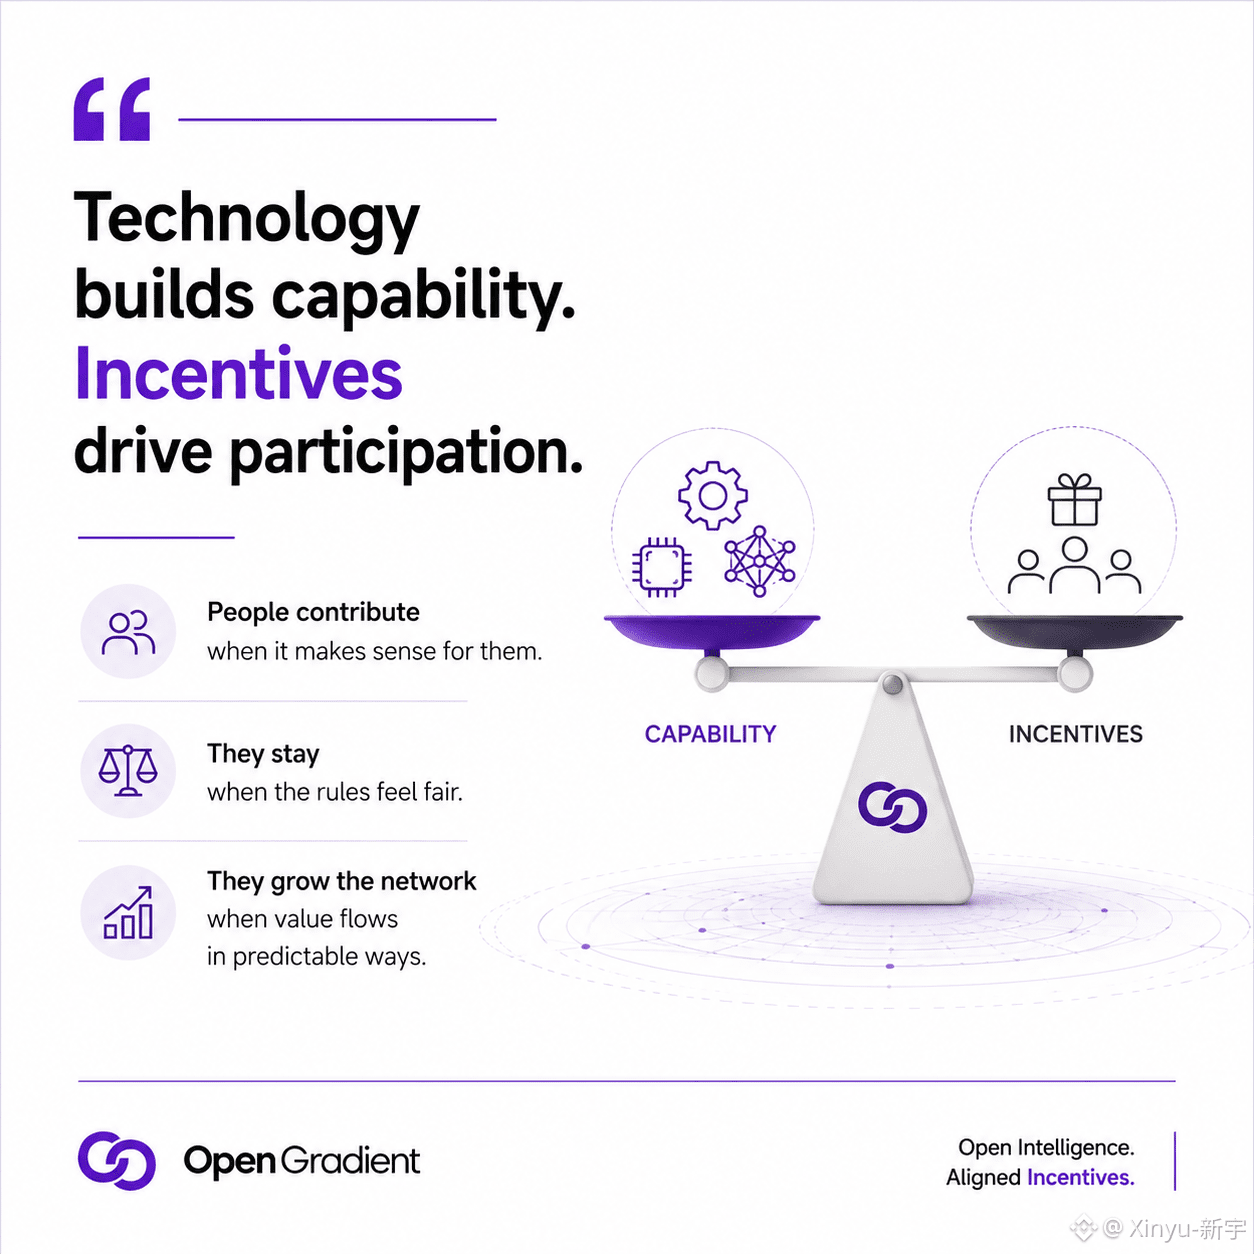
HaussierJ’ai remarqué quelque chose d’étrange après avoir passé du temps avec Newton Protocol. Le récit de l’IA s’est estompé bien plus vite que je ne l’avais prévu, en arrière-plan. Ce qui continuait à me ramener, c’était une question plus discrète : la conception des incitations peut-elle rester fiable une fois que l’exécution de la stratégie devient de plus en plus autonome ?
J’ai fini par relire deux fois les mêmes sections, parce que ma première conclusion n’a pas résisté à une seconde lecture. Le défi ne semblait pas de prendre de meilleures décisions, mais de s’assurer que chaque participant ait une raison de maintenir ces décisions honnêtes dans la durée. Ce changement m’a surpris. J’ai fermé les documents en pensant moins à l’IA elle-même, et davantage aux incitations qui façonnent tranquillement tout ce qui se cache derrière elle.
#Newt $NEWT @NewtonProtocol
Qu’est-ce qui vous a le plus marqué ?
J’ai fini par relire deux fois les mêmes sections, parce que ma première conclusion n’a pas résisté à une seconde lecture. Le défi ne semblait pas de prendre de meilleures décisions, mais de s’assurer que chaque participant ait une raison de maintenir ces décisions honnêtes dans la durée. Ce changement m’a surpris. J’ai fermé les documents en pensant moins à l’IA elle-même, et davantage aux incitations qui façonnent tranquillement tout ce qui se cache derrière elle.
#Newt $NEWT @NewtonProtocol
Qu’est-ce qui vous a le plus marqué ?
Âkšhu-艾
·
--
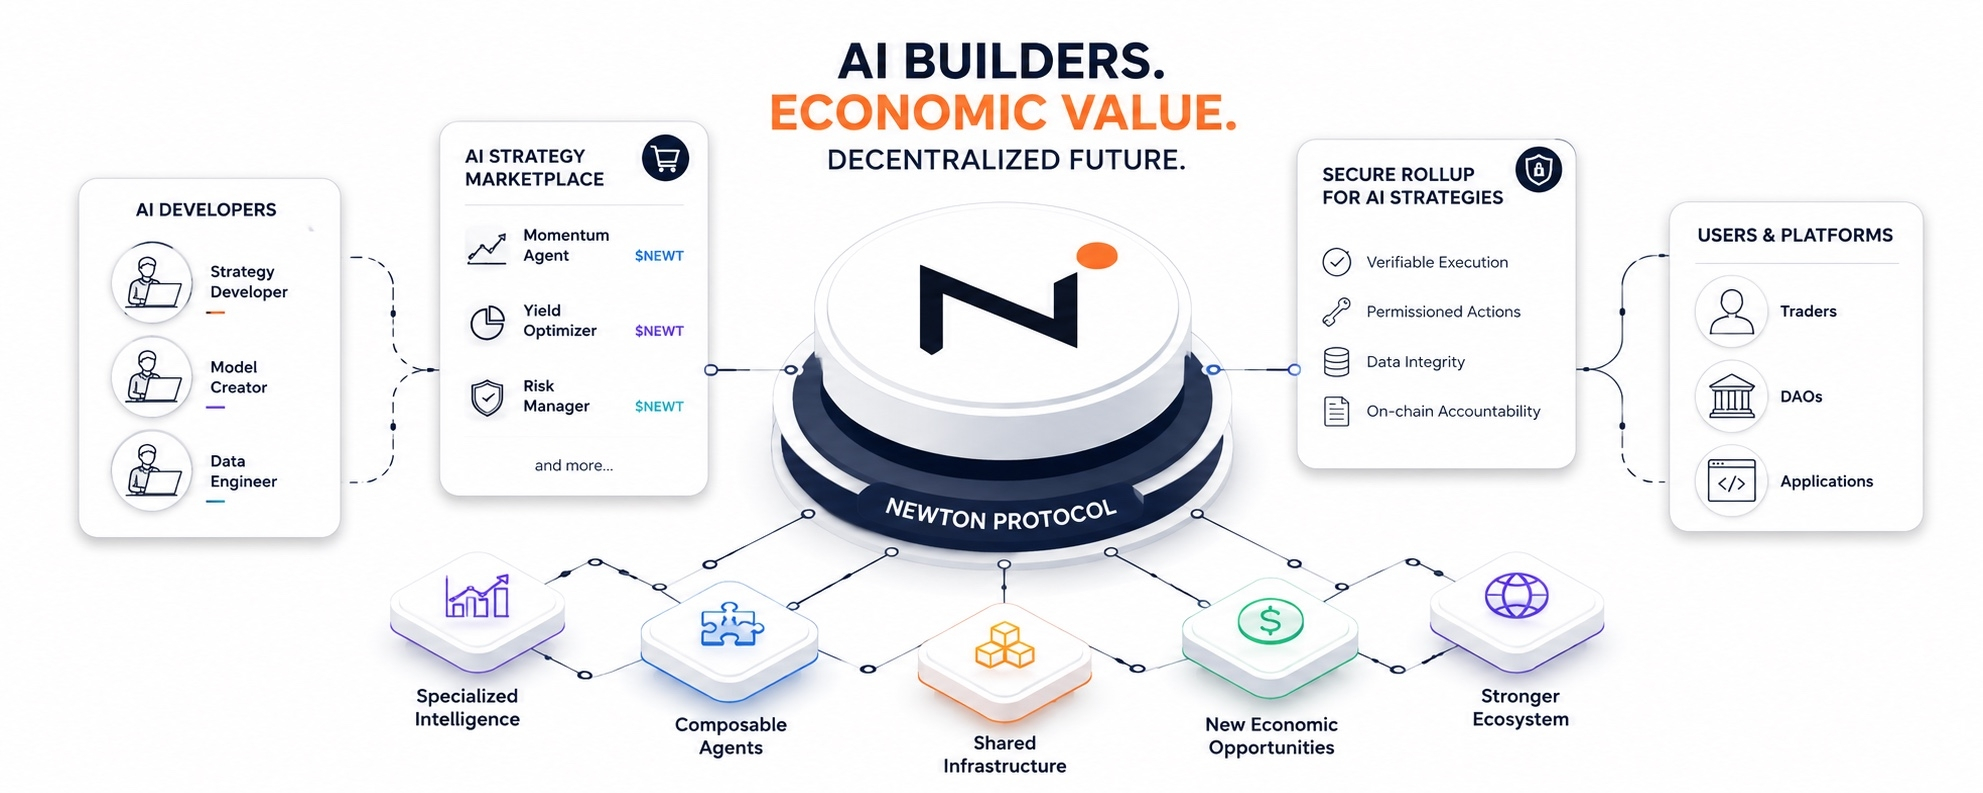
La prochaine économie crypto pourrait être construite par des créateurs d’IA
Plus je regarde l’IA se développer au sein de la crypto, moins je pense que la plus grande transformation viendra d’une meilleure gestion des échanges. Ce qui retient surtout mon attention, c’est quelque chose de plus discret. Chaque nouvelle vague d’automatisation pousse davantage de personnes à concevoir des modèles, des stratégies et des systèmes autonomes. On passe beaucoup de temps à se demander ce que ces systèmes peuvent faire, mais beaucoup moins à se demander quel rôle ils finiront par jouer dans l’économie elle-même.
Cela ressemble à une lacune inhabituelle.
La crypto a toujours récompensé ceux qui contribuent au réseau. Les mineurs sécurisaient les blockchains. Les validateurs maintenaient le consensus en fonctionnement. Les apporteurs de liquidité rendaient les marchés utilisables. Les développeurs créaient des applications qui attiraient les utilisateurs. Chaque étape a donné naissance à un type d’acteur économique différent, plutôt qu’à un simple autre consommateur.
Cela ressemble à une lacune inhabituelle.
La crypto a toujours récompensé ceux qui contribuent au réseau. Les mineurs sécurisaient les blockchains. Les validateurs maintenaient le consensus en fonctionnement. Les apporteurs de liquidité rendaient les marchés utilisables. Les développeurs créaient des applications qui attiraient les utilisateurs. Chaque étape a donné naissance à un type d’acteur économique différent, plutôt qu’à un simple autre consommateur.
The intelligence users see❤️
100%
Infrastructure never notice💕
0%
4 Votes • Vote fermé
Âkšhu-艾
·
--
OpenLedger ressemble moins à de la liquidité IA et plus à de la responsabilité IA
Je suis entré dans OpenLedger $OPEN en m'attendant à quelque chose de fluide et sans effort. La façon dont les gens parlent de la liquidité des actifs IA fait sembler que les données et les modèles peuvent bouger librement dès que vous contribuez quelque chose de précieux.
Ce n'était pas du tout la sensation que j'ai eue en l'utilisant.
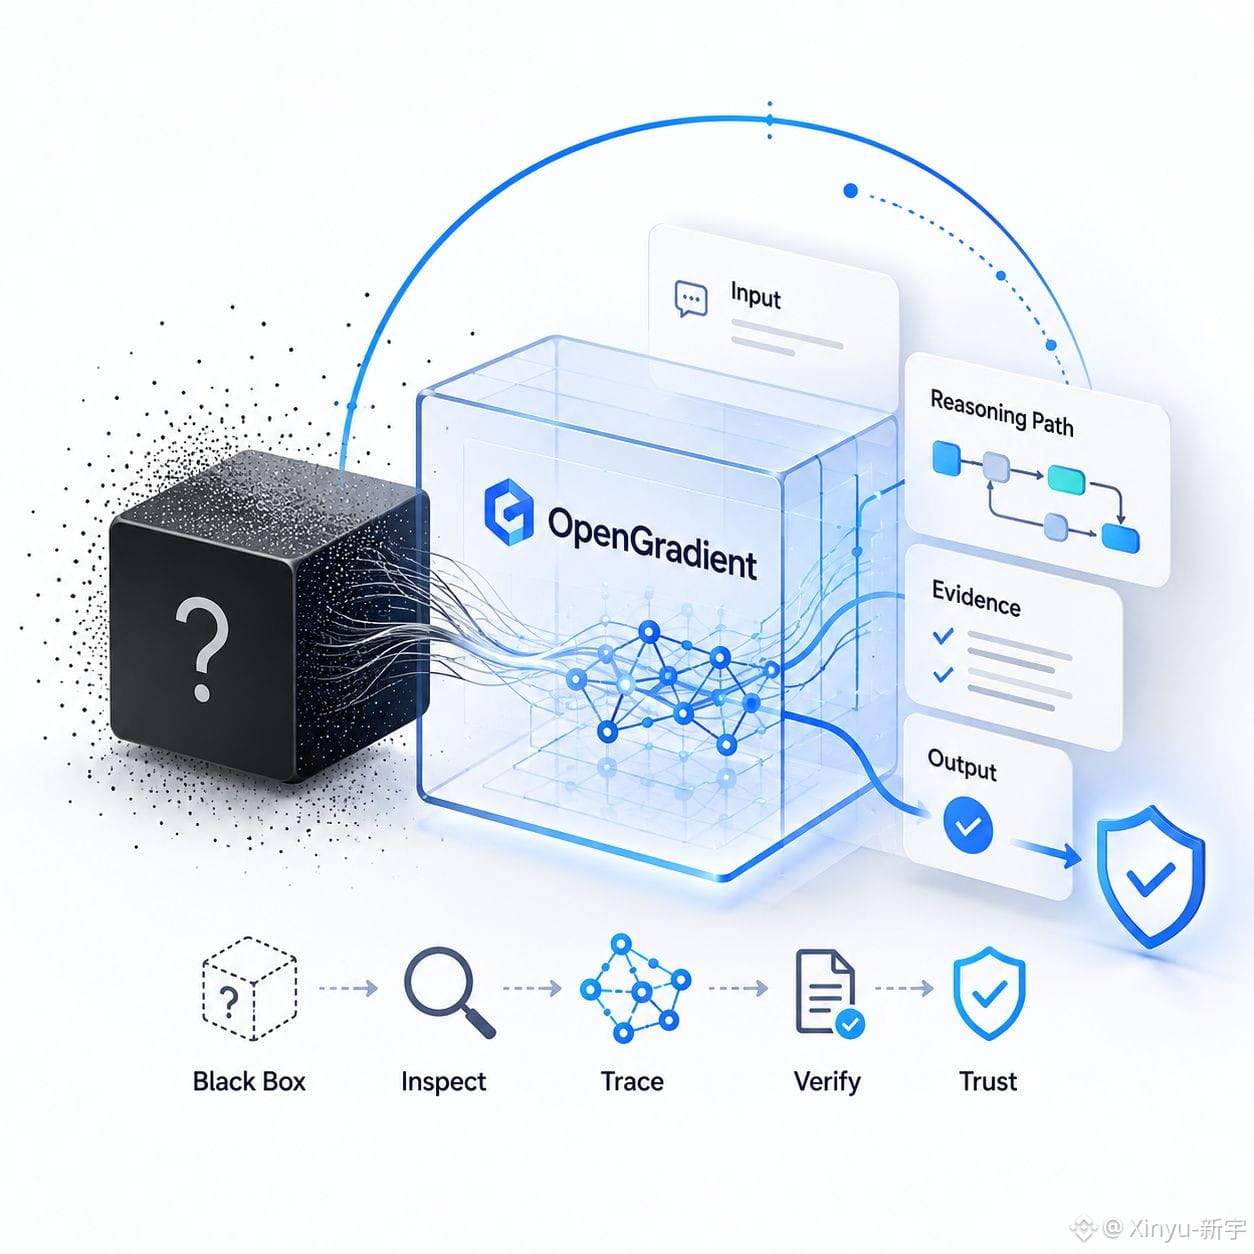
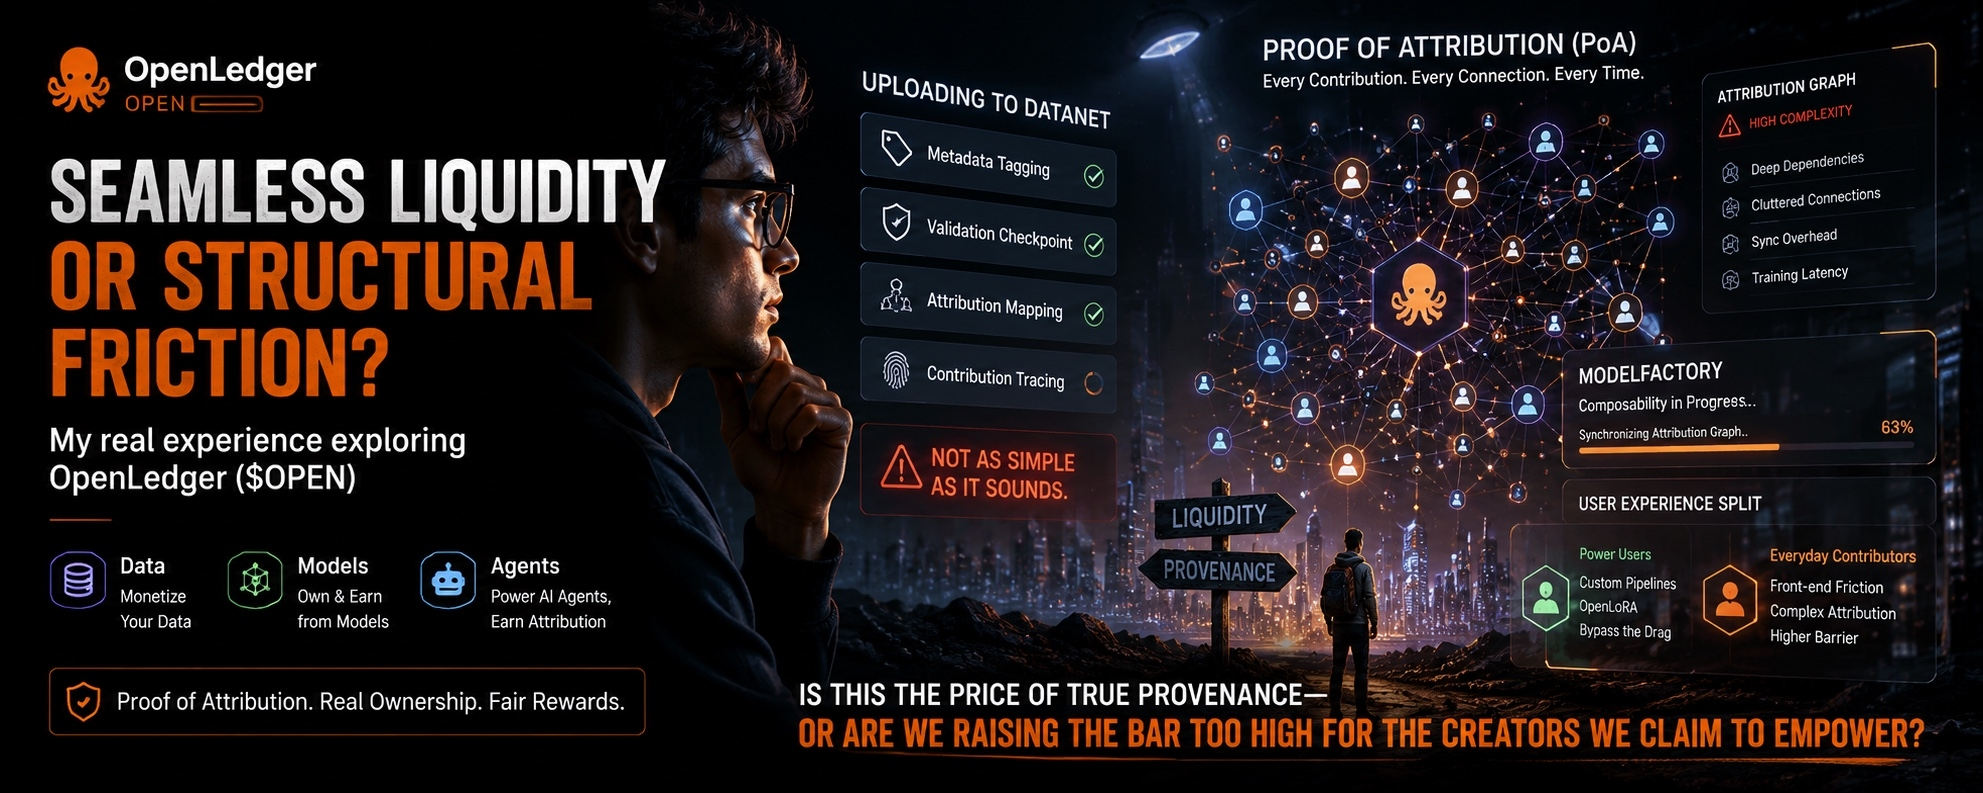
J'ai essayé de télécharger un petit jeu de données localisé dans un Datanet et le processus est devenu instantanément plus lourd que prévu. Avant même que les données puissent exister dans le réseau, j'ai dû passer par le balisage des métadonnées, les étapes de validation, les couches d'attribution et le suivi des contributions. Ça ne semblait pas décontracté ou ouvert. On aurait dit que j'entrais dans un système qui voulait se souvenir de chaque empreinte digitale attachée aux données pour toujours.
Ce n'était pas du tout la sensation que j'ai eue en l'utilisant.
J'ai essayé de télécharger un petit jeu de données localisé dans un Datanet et le processus est devenu instantanément plus lourd que prévu. Avant même que les données puissent exister dans le réseau, j'ai dû passer par le balisage des métadonnées, les étapes de validation, les couches d'attribution et le suivi des contributions. Ça ne semblait pas décontracté ou ouvert. On aurait dit que j'entrais dans un système qui voulait se souvenir de chaque empreinte digitale attachée aux données pour toujours.
Âkšhu-艾
·
--
Comment OpenLedger construit un marché ouvert pour l'IA
Le monde évolue plus vite que la plupart des gens ne l'avaient prévu. Il y a quelques années, l'intelligence artificielle semblait encore lointaine pour beaucoup. Maintenant, elle est partout. Elle rédige du contenu, crée de l'art, analyse les marchés, propulse des entreprises, et devient lentement partie intégrante de la vie quotidienne. Mais derrière toute cette innovation, il y a une réalité à laquelle la plupart des gens pensent rarement.
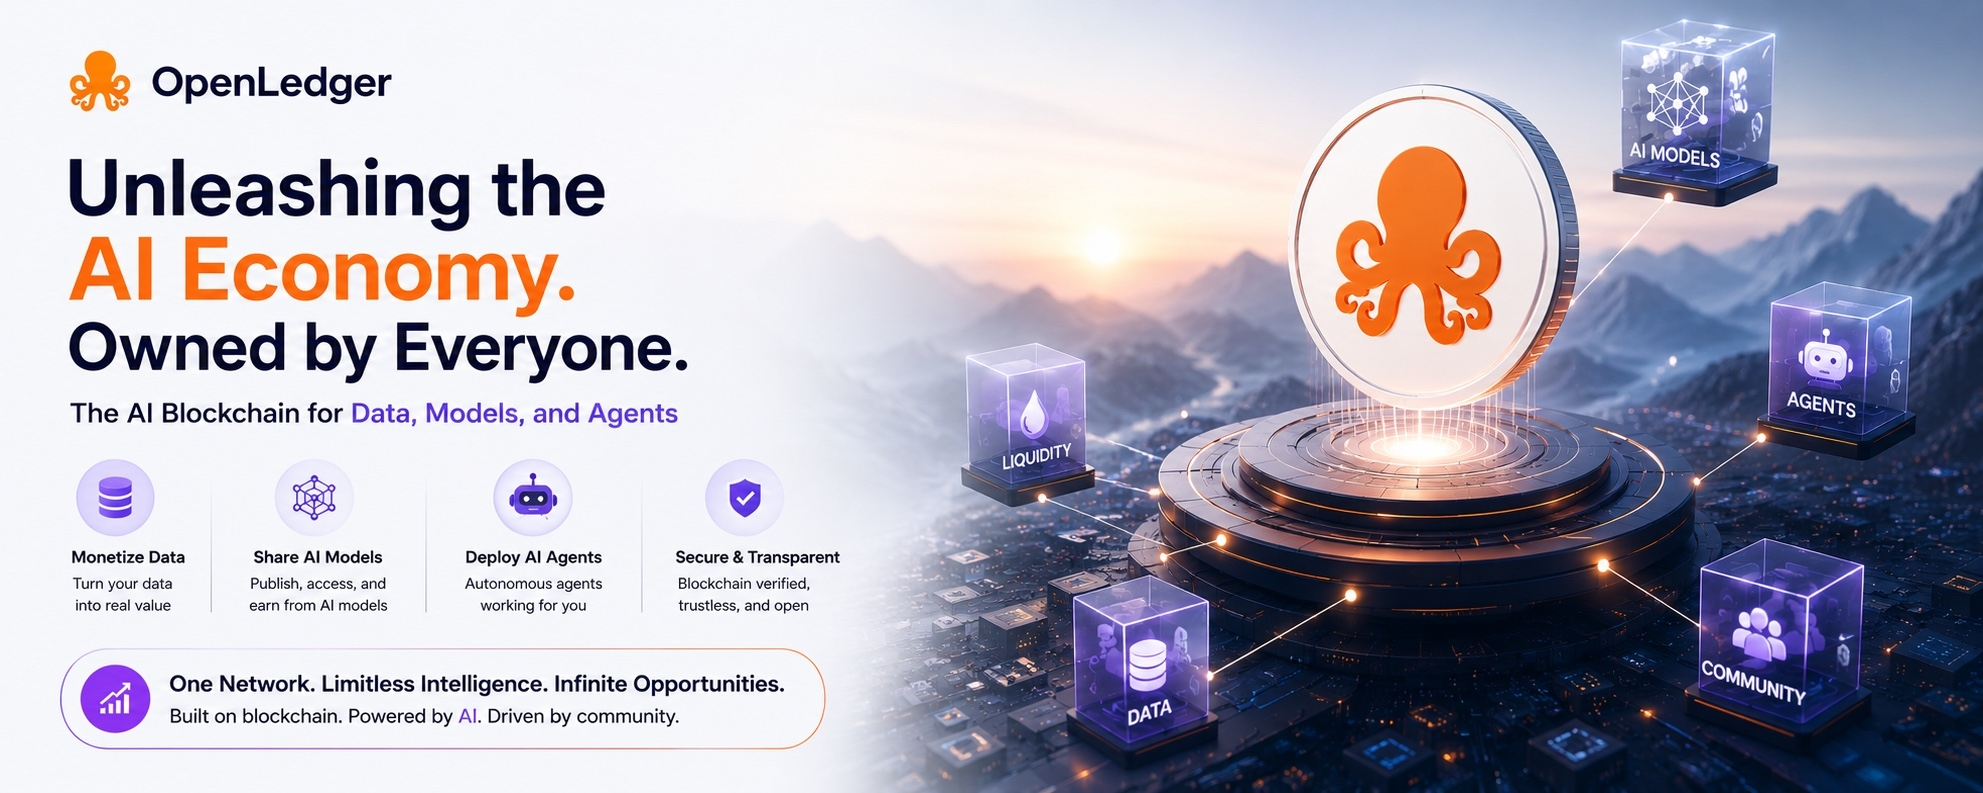
La vraie valeur de l'IA ne provient pas seulement de la technologie elle-même. Elle vient des données, des modèles, de l'intelligence, et des personnes qui contribuent discrètement en coulisses.
La vraie valeur de l'IA ne provient pas seulement de la technologie elle-même. Elle vient des données, des modèles, de l'intelligence, et des personnes qui contribuent discrètement en coulisses.
Âkšhu-艾
·
--
#openledger $OPEN La plupart des projets crypto semblent bien ficelés en surface mais sont vides en dessous. Les mêmes promesses recyclées, la même vision exagérée, et la même pression pour croire que quelque chose de grand est en route. Au bout d'un moment, tout cela commence à sembler déconnecté de la réalité.
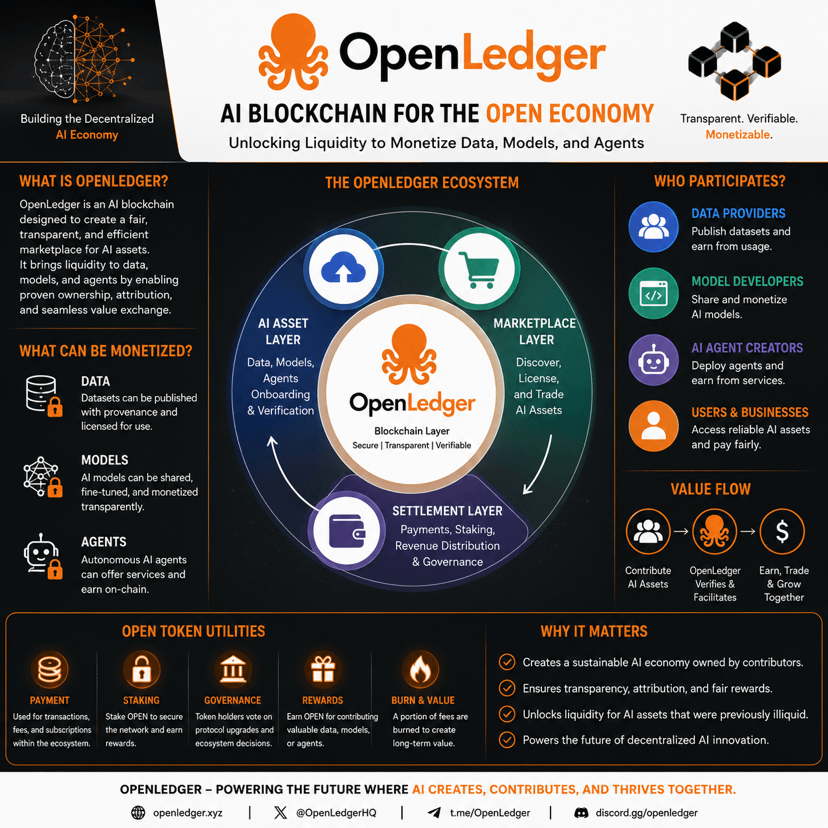
Ce qui m'a semblé différent avec le token Open, c'est ce sentiment qu'il essaie de résoudre quelque chose de plus profond que la visibilité ou le hype. Ce n'est pas seulement une question d'IA ou de blockchain comme idées autonomes. Il s'agit de créer un système où les données, les modèles et les agents intelligents peuvent enfin avoir une vraie valeur et circuler librement entre ceux qui construisent, contribuent et participent.
Pour moi, cela change le poids émotionnel du projet. Une grande partie du monde numérique aujourd'hui est construite sur des contributions invisibles qui ne sont jamais reconnues correctement. OpenLedger semble explorer une structure où l'intelligence elle-même peut devenir partie intégrante d'une économie ouverte au lieu de rester piégée dans des plateformes fermées.
Ce qui a attiré mon attention, c'est l'accent mis sur la coordination et la durabilité plutôt que sur l'excitation à court terme. Parce que lorsqu'un projet crée une véritable utilité entre les utilisateurs, les développeurs et les systèmes, il a bien plus de chances de survivre après que le bruit se soit estompé.
C'est pourquoi le token Open reste sur mon radar. Pas parce qu'il promet tout, mais parce que l'idée qui le sous-tend semble connectée à la direction que prend déjà la technologie et la contribution humaine.@OpenLedger
Ce qui m'a semblé différent avec le token Open, c'est ce sentiment qu'il essaie de résoudre quelque chose de plus profond que la visibilité ou le hype. Ce n'est pas seulement une question d'IA ou de blockchain comme idées autonomes. Il s'agit de créer un système où les données, les modèles et les agents intelligents peuvent enfin avoir une vraie valeur et circuler librement entre ceux qui construisent, contribuent et participent.
Pour moi, cela change le poids émotionnel du projet. Une grande partie du monde numérique aujourd'hui est construite sur des contributions invisibles qui ne sont jamais reconnues correctement. OpenLedger semble explorer une structure où l'intelligence elle-même peut devenir partie intégrante d'une économie ouverte au lieu de rester piégée dans des plateformes fermées.
Ce qui a attiré mon attention, c'est l'accent mis sur la coordination et la durabilité plutôt que sur l'excitation à court terme. Parce que lorsqu'un projet crée une véritable utilité entre les utilisateurs, les développeurs et les systèmes, il a bien plus de chances de survivre après que le bruit se soit estompé.
C'est pourquoi le token Open reste sur mon radar. Pas parce qu'il promet tout, mais parce que l'idée qui le sous-tend semble connectée à la direction que prend déjà la technologie et la contribution humaine.@OpenLedger
Âkšhu-艾
·
--
Pourquoi OpenLedger pourrait devenir l'un des projets d'infrastructure IA les plus importants dans le crypto
Si tu passes assez de temps dans le crypto, tu finis par ne plus être impressionné par le branding bruyant et les promesses recyclées. Chaque cycle introduit une nouvelle vague de projets qui prétendent qu'ils vont "tout changer", mais la plupart ne font que rivaliser pour l'attention, la liquidité et un coup de pouce narratif temporaire avant que le marché ne passe à autre chose.
C'est pourquoi OpenLedger a attiré mon attention différemment.
On n'a pas l'impression que c'est un projet qui essaie de créer du buzz à partir de rien. L'idée derrière ça est vraiment liée à un changement réel qui se produit en ligne en ce moment, surtout autour de l'intelligence artificielle et de la propriété numérique.
C'est pourquoi OpenLedger a attiré mon attention différemment.
On n'a pas l'impression que c'est un projet qui essaie de créer du buzz à partir de rien. L'idée derrière ça est vraiment liée à un changement réel qui se produit en ligne en ce moment, surtout autour de l'intelligence artificielle et de la propriété numérique.
Âkšhu-艾
·
--
OpenLedger pourrait bien construire la couche manquante de l'économie de l'IA
OpenLedger a une vibe différente de la plupart des projets crypto dont on parle ces jours-ci. Une grande partie du marché fonctionne sur le hype, des récits rapides et une excitation temporaire, mais ce projet semble poursuivre quelque chose de bien plus grand que l'attention à court terme.
Ce qui est intéressant, c'est qu'OpenLedger n'essaie pas de vendre aux gens un fantasme. Il cherche à résoudre un problème qui existe déjà juste devant nous.
L'IA évolue à une vitesse folle. Les gens l'utilisent pour écrire, créer, faire des recherches, apprendre à coder et automatiser les tâches quotidiennes. Mais derrière chaque modèle d'IA, il y a des millions de contributions humaines qui maintiennent tout cela en place. Conversations, idées, images, articles, motifs de comportement et travaux créatifs alimentent constamment ces systèmes.
Ce qui est intéressant, c'est qu'OpenLedger n'essaie pas de vendre aux gens un fantasme. Il cherche à résoudre un problème qui existe déjà juste devant nous.
L'IA évolue à une vitesse folle. Les gens l'utilisent pour écrire, créer, faire des recherches, apprendre à coder et automatiser les tâches quotidiennes. Mais derrière chaque modèle d'IA, il y a des millions de contributions humaines qui maintiennent tout cela en place. Conversations, idées, images, articles, motifs de comportement et travaux créatifs alimentent constamment ces systèmes.
Âkšhu-艾
·
--
#pixel $PIXEL Beaucoup de projets crypto viennent enveloppés de bruit, avec de grandes promesses qui semblent excitantes au début mais s'estompent dès que vous cherchez quelque chose de réel en dessous. Ce qui m'a frappé à propos de Pixels, c'est que ça se sent plus calme, mais beaucoup plus significatif. Ça n'essaie pas de forcer l'importance. Ça la gagne par la façon dont le monde du jeu, les joueurs et le token semblent tous avancer ensemble. Pour moi, c'est ce qui lui donne un poids émotionnel. Il y a quelque chose de captivant dans un projet où le token est lié à une participation réelle, un effort réel, et un temps réel passé à l'intérieur de l'écosystème. Quand un token cesse d'être juste une histoire et commence à faire partie de la façon dont les gens appartiennent réellement et contribuent, ça se sent différent. C'est pourquoi Pixels a mon attention.@Pixels
Connectez-vous pour découvrir plus de contenu