

The MeeCrypt
107 Beiträge
The MeeCrypt
Melden
Nutzer blockieren
Early on crypto trends | Talking DePIN, AI & blockchain
9 Following
45 Follower
136 Like gegeben
Beiträge
Alle
Zitierungen
·
--
Viele Infrastrukturprodukte zwingen Entwickler dazu, ihren gewohnten Workflow zu verlassen, um sie zu nutzen.
@fluence MCP geht in die entgegengesetzte Richtung.
Sobald die Verbindung hergestellt ist, kann dein KI-Coding-Agent direkt aus der Umgebung, die du bereits nutzt, mit der Rechenleistung von Fluence arbeiten.
Die Einrichtung ist unkompliziert:
• Ein Konfigurationsausschnitt
• Ein Fluence-API-Schlüssel
• Ein MCP-kompatibler Client
Kein lokaler MCP-Server, der installiert werden muss. Keine Updates, um die du dich kümmern musst.
Und nach der ersten Verbindung musst du die Fluence Console nicht ständig wieder öffnen. Die Interaktion bleibt in deinem Coding-Client.
Das mag wie eine kleine Verbesserung der Nutzererfahrung klingen, aber ich finde, sie ist wichtig.
Entwickler gewöhnen sich bereits daran, KI-Agenten immer mehr Aufgaben im Entwicklungsprozess zu überlassen. Diesen Agenten Zugriff auf Rechenleistung zu geben, ist der logische nächste Schritt.
#FluenceProject #DePIN #AI
Viele Infrastrukturprodukte zwingen Entwickler dazu, ihren gewohnten Workflow zu verlassen, um sie zu nutzen.
@Fluence MCP geht in die entgegengesetzte Richtung.
Sobald die Verbindung hergestellt ist, kann dein KI-Coding-Agent direkt aus der Umgebung, die du bereits nutzt, mit der Rechenleistung von Fluence arbeiten.
Die Einrichtung ist unkompliziert:
• Ein Konfigurationsausschnitt
• Ein Fluence-API-Schlüssel
• Ein MCP-kompatibler Client
Kein lokaler MCP-Server, der installiert werden muss. Keine Updates, um die du dich kümmern musst.
Und nach der ersten Verbindung musst du die Fluence Console nicht ständig wieder öffnen. Die Interaktion bleibt in deinem Coding-Client.
Das mag wie eine kleine Verbesserung der Nutzererfahrung klingen, aber ich finde, sie ist wichtig.
Entwickler gewöhnen sich bereits daran, KI-Agenten immer mehr Aufgaben im Entwicklungsprozess zu überlassen. Diesen Agenten Zugriff auf Rechenleistung zu geben, ist der logische nächste Schritt.
#FluenceProject #DePIN #AI
337
·
--
DePIN hat weiterhin Schwierigkeiten damit, dezentrale Infrastruktur für Entwickler zugänglich zu machen.
@fluence verfolgt mit seiner neuen MCP-Integration einen interessanten Ansatz. Dadurch können KI-Agenten über MCP-kompatible Tools mit der Rechenleistung von Fluence interagieren.
• Cursor, Claude Code, VS Code, Codex oder einen anderen MCP-Client verbinden
• Deinem KI-Agenten mitteilen, welche Rechenleistung du brauchst
• Den Agenten die Interaktion mit Fluence übernehmen lassen
• Dezentrale Rechenleistung nutzen, ohne dass die Verwaltung der Infrastruktur zum Mittelpunkt deines Workflows wird
Entwickler möchten nicht unbedingt noch einen komplizierten Infrastruktur-Stack erlernen. Sie wollen entwickeln, bereitstellen und die zugrunde liegenden Systeme ihre Arbeit machen lassen.
Wenn Fluence dezentrale Rechenleistung so zugänglich machen kann, dass ein KI-Agent sie bei Bedarf einfach abrufen kann, erhält DePIN eine deutlich praxisnähere Geschichte für Entwickler.
Die Erkenntnis für Builder ist einfach: Beobachte nicht nur den DePIN-Trend. Probiere die Infrastruktur aus.
Ich hoffe wirklich, dass mehr Entwickler Fluence entdecken und sehen, was sie damit entwickeln können.
#FLT #DePIN #Web3 #AI
DePIN hat weiterhin Schwierigkeiten damit, dezentrale Infrastruktur für Entwickler zugänglich zu machen.
@Fluence verfolgt mit seiner neuen MCP-Integration einen interessanten Ansatz. Dadurch können KI-Agenten über MCP-kompatible Tools mit der Rechenleistung von Fluence interagieren.
• Cursor, Claude Code, VS Code, Codex oder einen anderen MCP-Client verbinden
• Deinem KI-Agenten mitteilen, welche Rechenleistung du brauchst
• Den Agenten die Interaktion mit Fluence übernehmen lassen
• Dezentrale Rechenleistung nutzen, ohne dass die Verwaltung der Infrastruktur zum Mittelpunkt deines Workflows wird
Entwickler möchten nicht unbedingt noch einen komplizierten Infrastruktur-Stack erlernen. Sie wollen entwickeln, bereitstellen und die zugrunde liegenden Systeme ihre Arbeit machen lassen.
Wenn Fluence dezentrale Rechenleistung so zugänglich machen kann, dass ein KI-Agent sie bei Bedarf einfach abrufen kann, erhält DePIN eine deutlich praxisnähere Geschichte für Entwickler.
Die Erkenntnis für Builder ist einfach: Beobachte nicht nur den DePIN-Trend. Probiere die Infrastruktur aus.
Ich hoffe wirklich, dass mehr Entwickler Fluence entdecken und sehen, was sie damit entwickeln können.
#FLT #DePIN #Web3 #AI
72
·
--
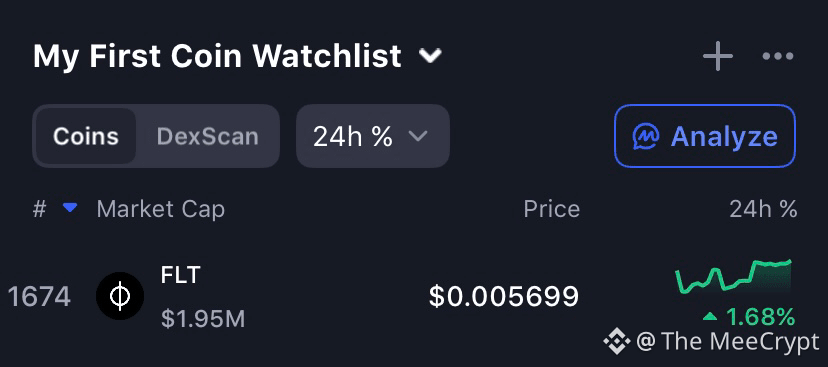
Fast hätte ich vergessen, dass ich ein paar $FLT von @fluence in meiner Geldbörse hatte.
Ich habe letztes Jahr ein paar FLT aufgesammelt, und ehrlich gesagt habe ich eine Weile nicht wirklich darauf geachtet.
Aber als ich kürzlich Fluence wieder angeschaut habe, hat es mich dazu gebracht, nachzuprüfen, was der Token eigentlich innerhalb des Ökosystems macht.
Und da ist mehr dran, als ich anfangs dachte.
• FLT ist Teil des Staking-Systems, in dem Tokens für die Absicherung und Koordination von Rechenressourcen verwendet werden.
• Es hat eine Rolle in der Governance und gibt der Community eine Möglichkeit, an Entscheidungen rund um das Fluence-Ökosystem teilzunehmen.
• Compute-Provider und die Netzwerkökonomie sind mit FLT verbunden, was dem Token eine praktische Funktion verleiht – über das bloße Herumliegen in einer Geldbörse hinaus.
• Auch die Cloud-Seite wird zunehmend interessanter. Fluence baut Infrastruktur, in der Nutzer auf Rechenressourcen zugreifen können, ohne sich vollständig auf traditionelle zentrale Cloud-Anbieter verlassen zu müssen.
• Und jetzt gibt es noch einen größeren Aspekt: KI- und GPU-Compute. Mit der Menge an Rechenleistung, die KI-Anwendungen einfordern, wird der dezentrale Zugang zu GPUs zu einem deutlich spannenderen Bereich, den man im Blick behalten sollte.
Der letzte Punkt dürfte das sein, was meine Aufmerksamkeit am meisten geweckt hat.
Denn als ich mir letztes Jahr diese paar FLT gekauft habe, dachte ich nicht groß über KI-Infrastruktur oder den GPU-Bedarf nach.
Jetzt sieht das Gespräch über Fluence ganz anders aus.
Ich will nicht behaupten, dass ich weiß, wohin FLT von hier aus geht.
Ich finde es nur interessant, wenn ein Token, den man eher nebenbei mitgenommen hat, plötzlich Teil einer viel größeren Infrastruktur-Story wird.
Also ja… ich behalte jetzt wieder mein kleines FLT-Bündel im Auge.
#Fluence #Web3 #DePIN #AI
Fast hätte ich vergessen, dass ich ein paar $FLT von @Fluence in meiner Geldbörse hatte.
Ich habe letztes Jahr ein paar FLT aufgesammelt, und ehrlich gesagt habe ich eine Weile nicht wirklich darauf geachtet.
Aber als ich kürzlich Fluence wieder angeschaut habe, hat es mich dazu gebracht, nachzuprüfen, was der Token eigentlich innerhalb des Ökosystems macht.
Und da ist mehr dran, als ich anfangs dachte.
• FLT ist Teil des Staking-Systems, in dem Tokens für die Absicherung und Koordination von Rechenressourcen verwendet werden.
• Es hat eine Rolle in der Governance und gibt der Community eine Möglichkeit, an Entscheidungen rund um das Fluence-Ökosystem teilzunehmen.
• Compute-Provider und die Netzwerkökonomie sind mit FLT verbunden, was dem Token eine praktische Funktion verleiht – über das bloße Herumliegen in einer Geldbörse hinaus.
• Auch die Cloud-Seite wird zunehmend interessanter. Fluence baut Infrastruktur, in der Nutzer auf Rechenressourcen zugreifen können, ohne sich vollständig auf traditionelle zentrale Cloud-Anbieter verlassen zu müssen.
• Und jetzt gibt es noch einen größeren Aspekt: KI- und GPU-Compute. Mit der Menge an Rechenleistung, die KI-Anwendungen einfordern, wird der dezentrale Zugang zu GPUs zu einem deutlich spannenderen Bereich, den man im Blick behalten sollte.
Der letzte Punkt dürfte das sein, was meine Aufmerksamkeit am meisten geweckt hat.
Denn als ich mir letztes Jahr diese paar FLT gekauft habe, dachte ich nicht groß über KI-Infrastruktur oder den GPU-Bedarf nach.
Jetzt sieht das Gespräch über Fluence ganz anders aus.
Ich will nicht behaupten, dass ich weiß, wohin FLT von hier aus geht.
Ich finde es nur interessant, wenn ein Token, den man eher nebenbei mitgenommen hat, plötzlich Teil einer viel größeren Infrastruktur-Story wird.
Also ja… ich behalte jetzt wieder mein kleines FLT-Bündel im Auge.
#Fluence #Web3 #DePIN #AI
89
·
--
@fluence hat seine Website offiziell von Fluence Network zu fluence.ai verlegt, und ich denke, diese Änderung sagt mehr über die Ausrichtung des Projekts aus, als es auf den ersten Blick erscheinen mag.
• Neue Domain: Fluence Network wird jetzt über fluence.ai repräsentiert, wodurch KI deutlich näher an den Mittelpunkt der Identität des Projekts rückt.
• KI-Infrastruktur: Das spiegelt den wachsenden Fokus von Fluence auf Infrastruktur für KI-Workloads wider – statt lediglich als dezentraler Compute-Netzwerkdienst bekannt zu sein.
• GPU + CPU Compute: Fluence baut sich um den Zugang zu sowohl GPU- als auch CPU-Ressourcen herum auf, die zunehmend wichtiger werden, während KI-Workloads weiter wachsen.
• Fluence Cloud: Ein interessanter Punkt ist, dass Fluence jetzt Fluence Cloud als Nachfolger des Fluence Project beschreibt.
• Ein breiterer Infrastruktur-Fokus: Die Ausrichtung des Projekts scheint sich in Richtung Cloud-Infrastruktur zu bewegen und verteiltes Computing für Entwickler und Macher zugänglicher zu machen.
• Die Domain erzählt einen Teil der Geschichte: Der Wechsel von „Network“ zu „.ai“ gibt der Marke eine direktere Verbindung zu dem Bereich der KI-Infrastruktur, auf den sie zunehmend fokussiert ist.
Auf der Oberfläche ist es immer noch „nur“ eine Domain-Änderung, aber wenn man auf das größere Ganze blickt, wirkt es wie ein klareres Signal dafür, wohin Fluence steuert.
Vom dezentralen Compute hin zu einer KI-fokussierten Cloud-Infrastruktur wird die Entwicklung immer leichter zu erkennen.
#Fluence #AI #DePIN #Web3
@Fluence hat seine Website offiziell von Fluence Network zu fluence.ai verlegt, und ich denke, diese Änderung sagt mehr über die Ausrichtung des Projekts aus, als es auf den ersten Blick erscheinen mag.
• Neue Domain: Fluence Network wird jetzt über fluence.ai repräsentiert, wodurch KI deutlich näher an den Mittelpunkt der Identität des Projekts rückt.
• KI-Infrastruktur: Das spiegelt den wachsenden Fokus von Fluence auf Infrastruktur für KI-Workloads wider – statt lediglich als dezentraler Compute-Netzwerkdienst bekannt zu sein.
• GPU + CPU Compute: Fluence baut sich um den Zugang zu sowohl GPU- als auch CPU-Ressourcen herum auf, die zunehmend wichtiger werden, während KI-Workloads weiter wachsen.
• Fluence Cloud: Ein interessanter Punkt ist, dass Fluence jetzt Fluence Cloud als Nachfolger des Fluence Project beschreibt.
• Ein breiterer Infrastruktur-Fokus: Die Ausrichtung des Projekts scheint sich in Richtung Cloud-Infrastruktur zu bewegen und verteiltes Computing für Entwickler und Macher zugänglicher zu machen.
• Die Domain erzählt einen Teil der Geschichte: Der Wechsel von „Network“ zu „.ai“ gibt der Marke eine direktere Verbindung zu dem Bereich der KI-Infrastruktur, auf den sie zunehmend fokussiert ist.
Auf der Oberfläche ist es immer noch „nur“ eine Domain-Änderung, aber wenn man auf das größere Ganze blickt, wirkt es wie ein klareres Signal dafür, wohin Fluence steuert.
Vom dezentralen Compute hin zu einer KI-fokussierten Cloud-Infrastruktur wird die Entwicklung immer leichter zu erkennen.
#Fluence #AI #DePIN #Web3
77
·
--
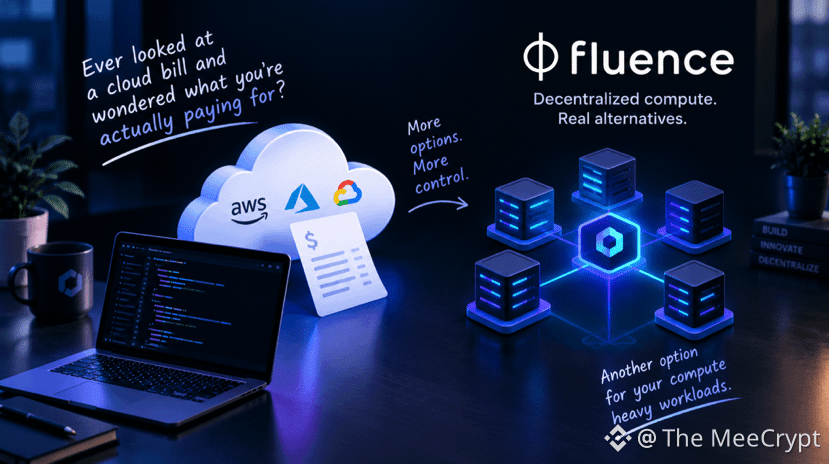
Ihre Cloud-Rechnung könnte flexibler sein, als Sie denken.
Cloud-Infrastruktur ist praktisch, aber Bequemlichkeit kann teuer werden, wenn die Rechenanforderungen zu skalieren beginnen – insbesondere bei KI-Workloads.
@fluence $FLT geht einen anderen Ansatz, indem es Workloads mit einem dezentralen Netzwerk aus Compute-Providern verbindet.
• Niedrigere Infrastrukturkosten: Zugriff auf verteiltes Computing, ohne sich vollständig auf traditionelle Cloud-Provider zu verlassen
• Mehr Flexibilität: Workloads können Rechenleistung von verschiedenen Anbietern abrufen
• KI-fähige Infrastruktur: sinnvoll, wenn KI-Anwendungen weiter an Rechenleistungbedarf gewinnen
• Weniger Cloud-Konzentration: eine Alternative dazu, alles über dieselben großen Anbieter laufen zu lassen
Die große Idee ist einfach: Computing wird zunehmend wichtiger, daher könnte es genauso relevant sein, mehr Optionen dafür zu haben, wo und wie es bezogen wird, wie mehr davon zu haben.
Dort wird dezentrales Computing interessant.
#Fluence #DePIN #AI
Ihre Cloud-Rechnung könnte flexibler sein, als Sie denken.
Cloud-Infrastruktur ist praktisch, aber Bequemlichkeit kann teuer werden, wenn die Rechenanforderungen zu skalieren beginnen – insbesondere bei KI-Workloads.
@Fluence $FLT geht einen anderen Ansatz, indem es Workloads mit einem dezentralen Netzwerk aus Compute-Providern verbindet.
• Niedrigere Infrastrukturkosten: Zugriff auf verteiltes Computing, ohne sich vollständig auf traditionelle Cloud-Provider zu verlassen
• Mehr Flexibilität: Workloads können Rechenleistung von verschiedenen Anbietern abrufen
• KI-fähige Infrastruktur: sinnvoll, wenn KI-Anwendungen weiter an Rechenleistungbedarf gewinnen
• Weniger Cloud-Konzentration: eine Alternative dazu, alles über dieselben großen Anbieter laufen zu lassen
Die große Idee ist einfach: Computing wird zunehmend wichtiger, daher könnte es genauso relevant sein, mehr Optionen dafür zu haben, wo und wie es bezogen wird, wie mehr davon zu haben.
Dort wird dezentrales Computing interessant.
#Fluence #DePIN #AI
3
·
--
Jeder sagte $ETH . Ich begann, über $FLT nachzudenken, das mit @fluence in Verbindung steht
Ich habe kürzlich eine interessante Frage gesehen: Wenn $BTC plötzlich verschwinden würde, welches Asset könnte an seine Stelle treten?
Die Antworten waren größtenteils ETH und andere etablierte Krypto-Namen.
Dann dachte ich über einen anderen Blickwinkel nach: Was wäre, wenn die nächste wichtige Story nicht einfach nur ein weiteres Finanz-Asset ist, sondern die Infrastruktur, die die nächste Welle der Technologie antreibt?
KI erzeugt bereits einen enormen Bedarf an Rechenleistung. Modelle, Agenten und Anwendungen benötigen alle Rechenressourcen, um zu funktionieren.
Deshalb ist es spannend, $FLT zu beobachten.
@fluence arbeitet an dezentralem Compute. Und wie Evgeny Ponomarev in einem kürzlich abgehaltenen AMA erläuterte, besteht die größere Vision darin, eine Alternative zu einer zunehmend zentralisierten Cloud-Infrastruktur zu schaffen – wobei KI ein wichtiger Ausgangspunkt ist.
$BTC steht für ein bedeutendes Kapitel im Bereich DeFi (dezentrale Finanzen).
Könnte dezentrales Compute zu einem ebenso wichtigen Bestandteil des nächsten Kapitels von Web3 werden?
Jeder sagte $ETH . Ich begann, über $FLT nachzudenken, das mit @Fluence in Verbindung steht
Ich habe kürzlich eine interessante Frage gesehen: Wenn $BTC plötzlich verschwinden würde, welches Asset könnte an seine Stelle treten?
Die Antworten waren größtenteils ETH und andere etablierte Krypto-Namen.
Dann dachte ich über einen anderen Blickwinkel nach: Was wäre, wenn die nächste wichtige Story nicht einfach nur ein weiteres Finanz-Asset ist, sondern die Infrastruktur, die die nächste Welle der Technologie antreibt?
KI erzeugt bereits einen enormen Bedarf an Rechenleistung. Modelle, Agenten und Anwendungen benötigen alle Rechenressourcen, um zu funktionieren.
Deshalb ist es spannend, $FLT zu beobachten.
@Fluence arbeitet an dezentralem Compute. Und wie Evgeny Ponomarev in einem kürzlich abgehaltenen AMA erläuterte, besteht die größere Vision darin, eine Alternative zu einer zunehmend zentralisierten Cloud-Infrastruktur zu schaffen – wobei KI ein wichtiger Ausgangspunkt ist.
$BTC steht für ein bedeutendes Kapitel im Bereich DeFi (dezentrale Finanzen).
Könnte dezentrales Compute zu einem ebenso wichtigen Bestandteil des nächsten Kapitels von Web3 werden?
57
·
--
@fluence : Wer erhält die GPU-Kapazität?
Wie GPU-Kapazität tatsächlich gekauft und verkauft wird. Es kann weltweit viele GPUs geben und dennoch für einen bestimmten Käufer, einen Standort, eine Arbeitslast oder einen Zeitraum ein Engpass bestehen. Das macht Preisgestaltung und Zugriff komplizierter als nur eine Zahl neben eine GPU zu setzen.
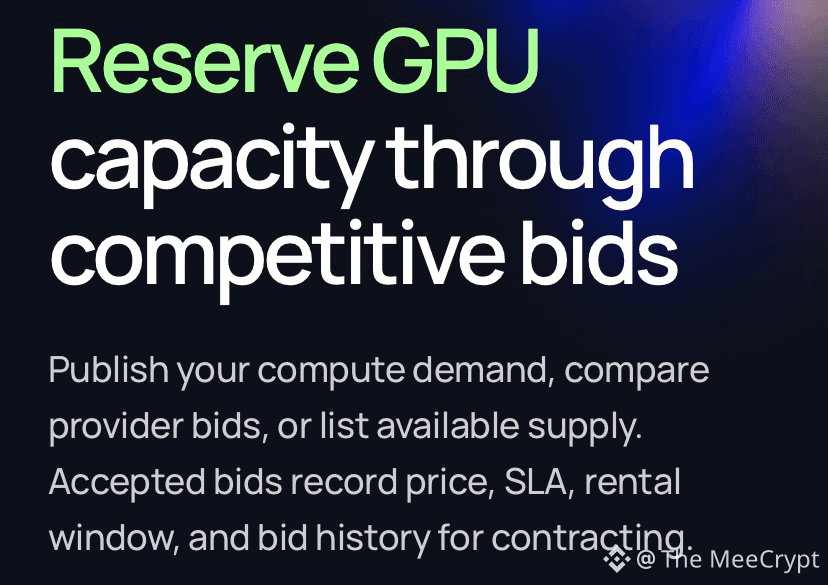
An dieser Stelle werden Auktionen nützlich. Bei einer Vorwärtsauktion konkurrieren Käufer um verfügbare Kapazität, während bei einer Rückwärtsauktion Anbieter konkurrieren, um eine Nachfrage zu erfüllen.
Beides schafft einen dynamischeren Weg, um in einem gegebenen Moment herauszufinden, was Rechenleistung tatsächlich wert ist. Und für jemanden, der ernsthafte GPU-Kapazität kauft, ist die günstigste Option nicht automatisch die richtige.
Sie müssen außerdem fragen: Steht die Kapazität tatsächlich zur Verfügung, wenn Sie sie brauchen? Kann das Netzwerk die Arbeitslast bewältigen? Welchen SLA bietet die Infrastruktur? Wenn etwas ausfällt: Wie schnell kann es wiederhergestellt werden? Diese Details können bei laufenden KI-Workloads im Maßstab einen großen Unterschied machen.
Fluence baut auf einen globalen Marktplatz hin, in dem Rechenzentren sich direkt mit qualifizierter Nachfrage nach reservierten GPU-Clustern verbinden können.
Das Interessante daran ist, dass es dabei nicht nur um das Hinzufügen weiterer GPUs geht. Es geht darum, die GPUs, die bereits existieren, leichter auffindbar zu machen, sie besser zu vergleichen, zu bepreisen und effektiver zu nutzen.
#Fluence #DePIN #AI
@Fluence : Wer erhält die GPU-Kapazität?
Wie GPU-Kapazität tatsächlich gekauft und verkauft wird. Es kann weltweit viele GPUs geben und dennoch für einen bestimmten Käufer, einen Standort, eine Arbeitslast oder einen Zeitraum ein Engpass bestehen. Das macht Preisgestaltung und Zugriff komplizierter als nur eine Zahl neben eine GPU zu setzen.
An dieser Stelle werden Auktionen nützlich. Bei einer Vorwärtsauktion konkurrieren Käufer um verfügbare Kapazität, während bei einer Rückwärtsauktion Anbieter konkurrieren, um eine Nachfrage zu erfüllen.
Beides schafft einen dynamischeren Weg, um in einem gegebenen Moment herauszufinden, was Rechenleistung tatsächlich wert ist. Und für jemanden, der ernsthafte GPU-Kapazität kauft, ist die günstigste Option nicht automatisch die richtige.
Sie müssen außerdem fragen: Steht die Kapazität tatsächlich zur Verfügung, wenn Sie sie brauchen? Kann das Netzwerk die Arbeitslast bewältigen? Welchen SLA bietet die Infrastruktur? Wenn etwas ausfällt: Wie schnell kann es wiederhergestellt werden? Diese Details können bei laufenden KI-Workloads im Maßstab einen großen Unterschied machen.
Fluence baut auf einen globalen Marktplatz hin, in dem Rechenzentren sich direkt mit qualifizierter Nachfrage nach reservierten GPU-Clustern verbinden können.
Das Interessante daran ist, dass es dabei nicht nur um das Hinzufügen weiterer GPUs geht. Es geht darum, die GPUs, die bereits existieren, leichter auffindbar zu machen, sie besser zu vergleichen, zu bepreisen und effektiver zu nutzen.
#Fluence #DePIN #AI
1
109
·
--
Wer steckt hinter der KI im Hintergrund? @fluence
Eine Sache, die ich an KI-Agenten interessant finde, ist, dass Latenz nicht immer allein durch das Modell verursacht wird.
Ein Agent kann mehrere Tool-Aufrufe ausführen, den Status abrufen, Validierungen durchführen, den Speicher aktualisieren und die Schleife mehrere Male wiederholen. Ein paar Millisekunden CPU-Verzögerung in jedem Schritt mögen für sich genommen unbedeutend wirken, aber über den gesamten Workflow hinweg können sich diese Verzögerungen summieren und die Anfrage über ihre Deadline hinaus schieben.
Hier wird die Infrastruktur wichtiger, als es zunächst den Anschein hat.
Bei KI-Workloads reicht eine durchschnittliche Performance nicht immer aus. Das eigentliche Problem kann sich besonders dann zeigen, wenn CPU-Konkurrenz kleine Verzögerungen über viele Phasen hinweg verursacht.
Das macht dedizierte Rechenleistung zu einer interessanten Option für Workloads, bei denen vorhersehbare Performance entscheidend ist.
Fluence geht das aus der dezentralen Compute-Perspektive an und gibt Entwicklern Zugriff auf dedizierte CPU-Ressourcen für Workloads, die mehr konsistente Kapazität benötigen.
Ich denke, das wird zunehmend relevant, wenn KI-Agenten von einfachen Experimenten in den Produktionsbetrieb übergehen. Wenn ein Agent Dutzende von Schritten übernimmt, kann das Reduzieren der Schwankungen in jeder Phase viel größere Auswirkungen auf das endgültige Nutzererlebnis haben.
Die Frage, auf die ich achte, ist einfach: Wenn Agent-Workloads komplexer werden, wird vorhersehbare Compute dann genauso wichtig sein wie reine Rechenleistung?
https://fluence.ai/
#Fluence #AI #DePIN
Wer steckt hinter der KI im Hintergrund? @Fluence
Eine Sache, die ich an KI-Agenten interessant finde, ist, dass Latenz nicht immer allein durch das Modell verursacht wird.
Ein Agent kann mehrere Tool-Aufrufe ausführen, den Status abrufen, Validierungen durchführen, den Speicher aktualisieren und die Schleife mehrere Male wiederholen. Ein paar Millisekunden CPU-Verzögerung in jedem Schritt mögen für sich genommen unbedeutend wirken, aber über den gesamten Workflow hinweg können sich diese Verzögerungen summieren und die Anfrage über ihre Deadline hinaus schieben.
Hier wird die Infrastruktur wichtiger, als es zunächst den Anschein hat.
Bei KI-Workloads reicht eine durchschnittliche Performance nicht immer aus. Das eigentliche Problem kann sich besonders dann zeigen, wenn CPU-Konkurrenz kleine Verzögerungen über viele Phasen hinweg verursacht.
Das macht dedizierte Rechenleistung zu einer interessanten Option für Workloads, bei denen vorhersehbare Performance entscheidend ist.
Fluence geht das aus der dezentralen Compute-Perspektive an und gibt Entwicklern Zugriff auf dedizierte CPU-Ressourcen für Workloads, die mehr konsistente Kapazität benötigen.
Ich denke, das wird zunehmend relevant, wenn KI-Agenten von einfachen Experimenten in den Produktionsbetrieb übergehen. Wenn ein Agent Dutzende von Schritten übernimmt, kann das Reduzieren der Schwankungen in jeder Phase viel größere Auswirkungen auf das endgültige Nutzererlebnis haben.
Die Frage, auf die ich achte, ist einfach: Wenn Agent-Workloads komplexer werden, wird vorhersehbare Compute dann genauso wichtig sein wie reine Rechenleistung?
https://fluence.ai/
#Fluence #AI #DePIN
1
44
·
--
@fluence VPC geht live zu gehen könnte ein wichtiger Schritt für das Fluence-Ökosystem sein.
https://fluence.ai/
Die neue VPC-Infrastruktur ermöglicht Entwicklern, mehrere VMs mit privatem Networking, Security Groups, gesteuertem Egress, optionalen öffentlichen IPs und cloud-init zu betreiben. Ganz einfach: Sie macht Fluence besser geeignet, um echte Anwendungen auszuführen, bei denen verschiedene Services sicher zusammenarbeiten.
Aus der Perspektive von $FLT ist das für mich der Punkt, an dem es spannend wird.
Eine neue Infrastrukturfunktion bedeutet nicht automatisch, dass der FLT-Preis steigt. Die größere Frage ist, ob VPC dabei hilft, dass Fluence mehr Entwickler, Workloads und Unternehmen anzieht.
Wenn die Akzeptanz wächst, könnte mehr Compute im Netzwerk bereitgestellt werden. Das würde die zugrunde liegende Nachfrage stärken und möglicherweise die Fundamentaldaten unterstützen, die FLT zugrunde liegen.
Darum beobachte ich eher die Nutzung als die Ankündigung selbst. Wenn Fluence weiter praktische Infrastruktur hinzufügt und diese Funktionen in echte Netzwerkaktivität übersetzen, denke ich, dass das mit der Zeit ein positiver Katalysator für FLT werden könnte.
Für mich ist die These einfach: bessere Infrastruktur → mehr Use Cases → mehr Netzwerkaktivität → möglicherweise stärkere FLT-Fundamentaldaten.
#DePIN #AI #Web3
@Fluence VPC geht live zu gehen könnte ein wichtiger Schritt für das Fluence-Ökosystem sein.
https://fluence.ai/
Die neue VPC-Infrastruktur ermöglicht Entwicklern, mehrere VMs mit privatem Networking, Security Groups, gesteuertem Egress, optionalen öffentlichen IPs und cloud-init zu betreiben. Ganz einfach: Sie macht Fluence besser geeignet, um echte Anwendungen auszuführen, bei denen verschiedene Services sicher zusammenarbeiten.
Aus der Perspektive von $FLT ist das für mich der Punkt, an dem es spannend wird.
Eine neue Infrastrukturfunktion bedeutet nicht automatisch, dass der FLT-Preis steigt. Die größere Frage ist, ob VPC dabei hilft, dass Fluence mehr Entwickler, Workloads und Unternehmen anzieht.
Wenn die Akzeptanz wächst, könnte mehr Compute im Netzwerk bereitgestellt werden. Das würde die zugrunde liegende Nachfrage stärken und möglicherweise die Fundamentaldaten unterstützen, die FLT zugrunde liegen.
Darum beobachte ich eher die Nutzung als die Ankündigung selbst. Wenn Fluence weiter praktische Infrastruktur hinzufügt und diese Funktionen in echte Netzwerkaktivität übersetzen, denke ich, dass das mit der Zeit ein positiver Katalysator für FLT werden könnte.
Für mich ist die These einfach: bessere Infrastruktur → mehr Use Cases → mehr Netzwerkaktivität → möglicherweise stärkere FLT-Fundamentaldaten.
#DePIN #AI #Web3
1
70
·
--
Noch ein 5,5-Mio.-USD-Compute-Deal für @fluence
Fluence hat sich einen 5,5-Mio.-USD-Compute-Deal mit einem Kunden gesichert, der AGI in den Fokus stellt – mit dem Ziel, schnellere Wege von der Biologie zu Medikamenten zu finden.
Was für mich dabei nicht nur ins Gewicht fällt, ist die Größe des Deals.
Es ist die zu lösende Aufgabe: sicherzustellen, dass Compute nicht zum Flaschenhals wird.
Die KI-Entwicklung wird zunehmend rechenintensiv, aber allein mehr GPUs zu haben ist nicht die ganze Geschichte. Die größere Herausforderung ist, Rechenleistung dort verfügbar zu machen, wo und wann sie gebraucht wird.
Genau hier werden dezentrale GPU-Marktplätze interessant.
Fluence baut einen Marktplatz, auf dem sich GPU-Anbieter um Workloads bewerben können – möglicherweise entsteht dadurch eine flexiblere Möglichkeit, wie Teams auf die Compute-Ressourcen zugreifen können, die sie benötigen.
Ich denke, wir werden mehr über die Compute-Schicht hinter der KI hören – nicht nur über die Modelle selbst.
5,5 Mio. USD sind ein Deal, aber es zeigt auch, wie wertvoll der zuverlässige Zugang zu GPU-Compute inzwischen geworden ist.
Es lohnt sich zu beobachten, was Fluence als Nächstes macht.
$FLT #DePIN #AI #Web3
Noch ein 5,5-Mio.-USD-Compute-Deal für @Fluence
Fluence hat sich einen 5,5-Mio.-USD-Compute-Deal mit einem Kunden gesichert, der AGI in den Fokus stellt – mit dem Ziel, schnellere Wege von der Biologie zu Medikamenten zu finden.
Was für mich dabei nicht nur ins Gewicht fällt, ist die Größe des Deals.
Es ist die zu lösende Aufgabe: sicherzustellen, dass Compute nicht zum Flaschenhals wird.
Die KI-Entwicklung wird zunehmend rechenintensiv, aber allein mehr GPUs zu haben ist nicht die ganze Geschichte. Die größere Herausforderung ist, Rechenleistung dort verfügbar zu machen, wo und wann sie gebraucht wird.
Genau hier werden dezentrale GPU-Marktplätze interessant.
Fluence baut einen Marktplatz, auf dem sich GPU-Anbieter um Workloads bewerben können – möglicherweise entsteht dadurch eine flexiblere Möglichkeit, wie Teams auf die Compute-Ressourcen zugreifen können, die sie benötigen.
Ich denke, wir werden mehr über die Compute-Schicht hinter der KI hören – nicht nur über die Modelle selbst.
5,5 Mio. USD sind ein Deal, aber es zeigt auch, wie wertvoll der zuverlässige Zugang zu GPU-Compute inzwischen geworden ist.
Es lohnt sich zu beobachten, was Fluence als Nächstes macht.
$FLT #DePIN #AI #Web3
1
66
·
--
@fluence : Der versteckte GPU-Markt
KI-Workloads wachsen, Rechenzentren werden größer, und Unternehmen investieren massiv in Rechenleistung.
Aber es gibt eine andere Seite der GPU-Geschichte, der ich Aufmerksamkeit schenken möchte:
Manche Hardware steht zwischen den Workloads ungenutzt herum. Ein Teil wird nur unterausgelastet genutzt. Und manche Rechenleistung ist schlicht für andere schwer zugänglich.
Das macht die Zukunft der Rechenleistung weniger zu einer Frage des bloßen Hinzufügens weiterer GPUs, sondern vielmehr darum, wie effizient wir die GPUs nutzen können, die bereits existieren.
@fluence idea ist einfach, aber interessant: Infrastruktur schaffen, die verfügbare Rechenleistung mit Menschen und Workloads verbindet, die sie benötigen.
Wenn die KI-Nachfrage weiter beschleunigt, denke ich, dass sich das Gespräch nach und nach von:
„Wer hat die meisten GPUs?“
zu:
„Wer kann die meiste Rechenleistung verfügbar machen – flexibel und effizient genutzt?“
verschieben wird.
Die GPU-Ökonomie könnte sich nicht mehr nur um Hardware drehen.
Sie könnte auch darum gehen, bessere Märkte für die Rechenleistung aufzubauen, die bereits vorhanden ist.
#DePIN #AI #Web3
@Fluence : Der versteckte GPU-Markt
KI-Workloads wachsen, Rechenzentren werden größer, und Unternehmen investieren massiv in Rechenleistung.
Aber es gibt eine andere Seite der GPU-Geschichte, der ich Aufmerksamkeit schenken möchte:
Manche Hardware steht zwischen den Workloads ungenutzt herum. Ein Teil wird nur unterausgelastet genutzt. Und manche Rechenleistung ist schlicht für andere schwer zugänglich.
Das macht die Zukunft der Rechenleistung weniger zu einer Frage des bloßen Hinzufügens weiterer GPUs, sondern vielmehr darum, wie effizient wir die GPUs nutzen können, die bereits existieren.
@Fluence idea ist einfach, aber interessant: Infrastruktur schaffen, die verfügbare Rechenleistung mit Menschen und Workloads verbindet, die sie benötigen.
Wenn die KI-Nachfrage weiter beschleunigt, denke ich, dass sich das Gespräch nach und nach von:
„Wer hat die meisten GPUs?“
zu:
„Wer kann die meiste Rechenleistung verfügbar machen – flexibel und effizient genutzt?“
verschieben wird.
Die GPU-Ökonomie könnte sich nicht mehr nur um Hardware drehen.
Sie könnte auch darum gehen, bessere Märkte für die Rechenleistung aufzubauen, die bereits vorhanden ist.
#DePIN #AI #Web3
1
81
·
--
Die schnellste GPU auf dem Papier ist nicht automatisch die beste Wahl für jede Arbeitslast.
Ein Benchmark kann Ihnen zwar zeigen, welche GPU die meisten Tokens pro Sekunde verarbeiten kann, aber bei realen Deployments gibt es mehr Faktoren zu berücksichtigen.
Modellgröße, Ausgabelänge, Speicheranforderungen, Parallelität, Region, Verfügbarkeit und natürlich die tatsächlichen Kosten für das Ausführen der Arbeitslast können die Rechnung jederzeit verändern.
Genau hier setzt @fluence mit einem interessanten Ansatz an.
Mit GPU-Cluster-Auktionen können Käufer Angebote verschiedener Anbieter vergleichen – basierend auf GPU-Typ, Kapazität, Region, Preisen und Verfügbarkeit.
Das verlagert die Entscheidung weg vom bloßen Streben nach der leistungsstärksten Hardware.
Statt zu fragen:
„Welche GPU ist am schnellsten?“
könnte eine bessere Frage sein:
Welche GPU liefert mir die Performance, die ich brauche – zu einem Preis, der wirklich Sinn ergibt?
Denn wenn eine leistungsstärkere GPU deutlich mehr kostet, aber keinen spürbaren Vorteil für Ihre konkrete Arbeitslast bietet, ist die zusätzliche Leistung möglicherweise nicht das Geld wert.
Und wenn eine andere GPU dieselbe Arbeitslast zu geringeren Kosten bewältigen kann, wird dieser Unterschied im Maßstab zunehmend relevant.
Während sich KI-Workloads weiterentwickeln, wird die Nachfrage nach GPUs nicht nur darum gehen, mehr Rechenleistung zu finden.
Es wird auch darum gehen, die richtige Rechenleistung zu finden – am richtigen Ort, zum richtigen Preis.
Genau hier könnte die Ermittlung des GPU-Preises künftig immer wichtiger werden.
#Flt #DePIN #Web3 #AI
Die schnellste GPU auf dem Papier ist nicht automatisch die beste Wahl für jede Arbeitslast.
Ein Benchmark kann Ihnen zwar zeigen, welche GPU die meisten Tokens pro Sekunde verarbeiten kann, aber bei realen Deployments gibt es mehr Faktoren zu berücksichtigen.
Modellgröße, Ausgabelänge, Speicheranforderungen, Parallelität, Region, Verfügbarkeit und natürlich die tatsächlichen Kosten für das Ausführen der Arbeitslast können die Rechnung jederzeit verändern.
Genau hier setzt @Fluence mit einem interessanten Ansatz an.
Mit GPU-Cluster-Auktionen können Käufer Angebote verschiedener Anbieter vergleichen – basierend auf GPU-Typ, Kapazität, Region, Preisen und Verfügbarkeit.
Das verlagert die Entscheidung weg vom bloßen Streben nach der leistungsstärksten Hardware.
Statt zu fragen:
„Welche GPU ist am schnellsten?“
könnte eine bessere Frage sein:
Welche GPU liefert mir die Performance, die ich brauche – zu einem Preis, der wirklich Sinn ergibt?
Denn wenn eine leistungsstärkere GPU deutlich mehr kostet, aber keinen spürbaren Vorteil für Ihre konkrete Arbeitslast bietet, ist die zusätzliche Leistung möglicherweise nicht das Geld wert.
Und wenn eine andere GPU dieselbe Arbeitslast zu geringeren Kosten bewältigen kann, wird dieser Unterschied im Maßstab zunehmend relevant.
Während sich KI-Workloads weiterentwickeln, wird die Nachfrage nach GPUs nicht nur darum gehen, mehr Rechenleistung zu finden.
Es wird auch darum gehen, die richtige Rechenleistung zu finden – am richtigen Ort, zum richtigen Preis.
Genau hier könnte die Ermittlung des GPU-Preises künftig immer wichtiger werden.
#Flt #DePIN #Web3 #AI
1
61
·
--
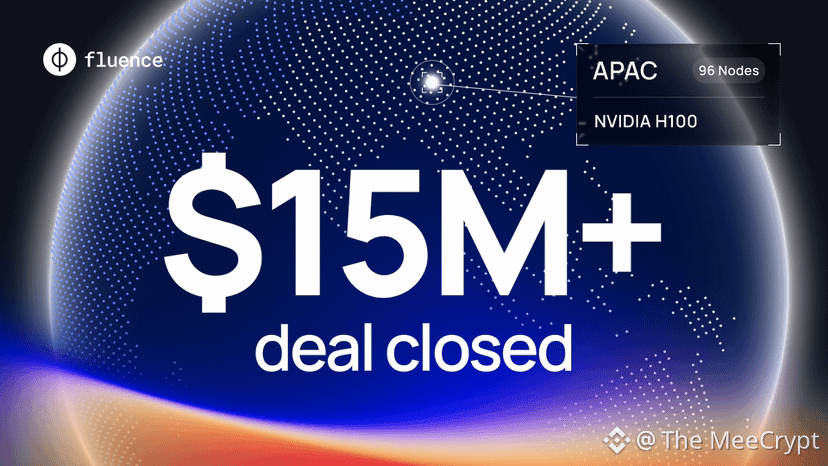
@fluence GPU-AUSSTEIGER: NEUE VERTRÄGE GELANDET — NOCH EIN $15,4M+-DEAL
Fluence hat über seine Auktionsplattform einen weiteren wichtigen GPU-Deal gesichert.
Dabei handelt es sich um 96 H100-Nodes in ganz Asien, die in die Produktion gehen, um KI-Inferenz und Modelltraining zu unterstützen.
Das Interessante ist nicht nur die Größe des Deals.
Er zeigt, dass die echte GPU-Nachfrage über den wettbewerbsorientierten Bietprozess in Bewegung ist: Käufer, die Kapazität suchen, treffen auf Anbieter, die GPUs verfügbar haben.
Mit weiteren hochwertigen Deals, die über die Plattform hereinkommen, werden GPU Auctions zu einem spannenden Bestandteil des AI-Infrastrukturmarkts, den man im Blick behalten sollte.
#FLT #DePIN #Web3
@Fluence GPU-AUSSTEIGER: NEUE VERTRÄGE GELANDET — NOCH EIN $15,4M+-DEAL
Fluence hat über seine Auktionsplattform einen weiteren wichtigen GPU-Deal gesichert.
Dabei handelt es sich um 96 H100-Nodes in ganz Asien, die in die Produktion gehen, um KI-Inferenz und Modelltraining zu unterstützen.
Das Interessante ist nicht nur die Größe des Deals.
Er zeigt, dass die echte GPU-Nachfrage über den wettbewerbsorientierten Bietprozess in Bewegung ist: Käufer, die Kapazität suchen, treffen auf Anbieter, die GPUs verfügbar haben.
Mit weiteren hochwertigen Deals, die über die Plattform hereinkommen, werden GPU Auctions zu einem spannenden Bestandteil des AI-Infrastrukturmarkts, den man im Blick behalten sollte.
#FLT #DePIN #Web3
1
85
·
--
Würdest du lieber einen Token mit echtem Nutzen halten oder einen, der nur Aufmerksamkeit bekommt, wenn sich der Chart zu bewegen beginnt?
Das ist auch der Grund, warum es sich lohnt, $FLT genauer anzusehen.
@fluence baut dezentrale Recheninfrastruktur für die KI-Wirtschaft auf, und $FLT steht im Zentrum der Netzwerk-Ökonomie.
Also: Was kann $FLT tatsächlich?
→ Staking: FLT kann gestaked werden, um dabei zu helfen, Compute-Ressourcen zu sichern und bereitzustellen – Token-Inhaber können sich am Staking beteiligen.
→ Governance: FLT-Inhaber können an der Fluence-DAO-Governance teilnehmen und über Vorschläge abstimmen, die das Netzwerk prägen.
→ Netzwerkanreize: FLT ist Teil des Anreizsystems, das Compute-Provider koordiniert und dazu beiträgt, das Netzwerk abzusichern.
Was ich interessant finde: Der Token hängt nicht komplett von der Infrastruktur ab.
Das Netzwerk konzentriert sich auf KI und GPU-Compute, und Fluence sagt, dass es inzwischen 1.400+ GPUs über 32 Regionen und 71 Rechenzentren bereitstellt.
Und genau hier glaube ich, dass manche beim letzten $FLT-Move das größere Bild übersehen haben.
Ein Pump zieht die Aufmerksamkeit aller auf sich.
Nutzen ist das, was dafür sorgt, dass ich weiter hinschaue.
Die spannende Frage ist jetzt nicht nur, wohin $FLT als Nächstes geht.
Sondern: Wie viel Wert lässt sich rund um die Infrastruktur aufbauen, die es antreibt.
KI braucht Compute.
Fluence baut die Compute-Ebene.
$FLT ist Teil der wirtschaftlichen Ebene dahinter.
Glaubst du, dass Utility-Tokens in der nächsten Phase von DePIN besser abschneiden werden als reine Narrative-Spiele?
#Fluence #DePIN #AI
Würdest du lieber einen Token mit echtem Nutzen halten oder einen, der nur Aufmerksamkeit bekommt, wenn sich der Chart zu bewegen beginnt?
Das ist auch der Grund, warum es sich lohnt, $FLT genauer anzusehen.
@Fluence baut dezentrale Recheninfrastruktur für die KI-Wirtschaft auf, und $FLT steht im Zentrum der Netzwerk-Ökonomie.
Also: Was kann $FLT tatsächlich?
→ Staking: FLT kann gestaked werden, um dabei zu helfen, Compute-Ressourcen zu sichern und bereitzustellen – Token-Inhaber können sich am Staking beteiligen.
→ Governance: FLT-Inhaber können an der Fluence-DAO-Governance teilnehmen und über Vorschläge abstimmen, die das Netzwerk prägen.
→ Netzwerkanreize: FLT ist Teil des Anreizsystems, das Compute-Provider koordiniert und dazu beiträgt, das Netzwerk abzusichern.
Was ich interessant finde: Der Token hängt nicht komplett von der Infrastruktur ab.
Das Netzwerk konzentriert sich auf KI und GPU-Compute, und Fluence sagt, dass es inzwischen 1.400+ GPUs über 32 Regionen und 71 Rechenzentren bereitstellt.
Und genau hier glaube ich, dass manche beim letzten $FLT-Move das größere Bild übersehen haben.
Ein Pump zieht die Aufmerksamkeit aller auf sich.
Nutzen ist das, was dafür sorgt, dass ich weiter hinschaue.
Die spannende Frage ist jetzt nicht nur, wohin $FLT als Nächstes geht.
Sondern: Wie viel Wert lässt sich rund um die Infrastruktur aufbauen, die es antreibt.
KI braucht Compute.
Fluence baut die Compute-Ebene.
$FLT ist Teil der wirtschaftlichen Ebene dahinter.
Glaubst du, dass Utility-Tokens in der nächsten Phase von DePIN besser abschneiden werden als reine Narrative-Spiele?
#Fluence #DePIN #AI
1
103
·
--
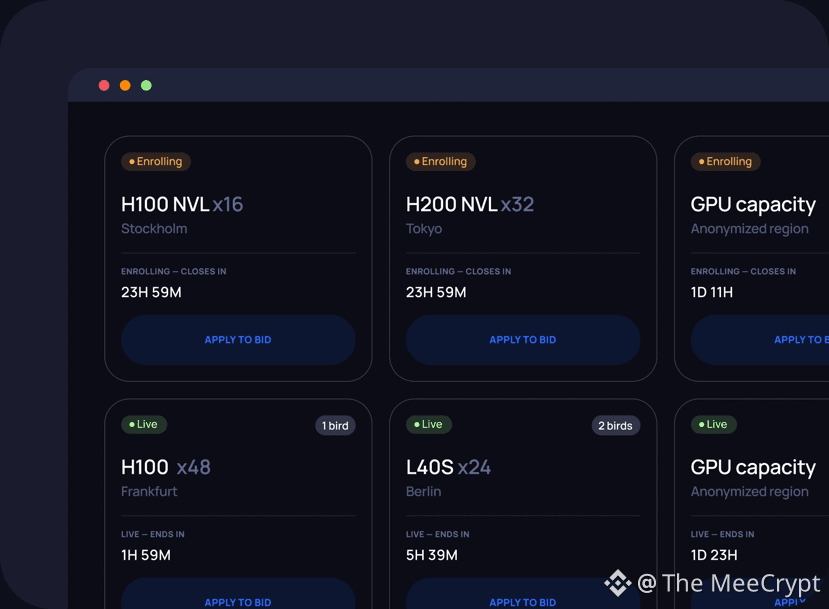
$6M IN GPU-VERTRÄGE: @fluence
GPUs wurden knapp, teuer und werden für Teams, die KI-Produkte entwickeln, zunehmend wichtiger. Doch GPUs zu haben ist nur die halbe Lösung. Die andere Hälfte besteht darin, die verfügbare Kapazität mit den Teams zu verbinden, die sie tatsächlich benötigen.
Genau hier kommen https://auctions.fluence.network/ GPU-Auktionen ins Spiel.
Seit dem Start des Marktplatzes wurden bereits $6M an GPU-Cluster-Verträgen erfasst.
Das Modell ist einfach:
→ Teams posten ihre Rechenanforderungen
→ Anbieter konkurrieren mit Geboten
→ Käufer vergleichen Preis, SLA und Mietzeiträume
→ Verträge werden auf der Grundlage des akzeptierten Gebots geschlossen
Der aktuelle Marktplatz zeigt 6.468 GPUs, die in 4 Ländern verfügbar sind.
Was ich hier besonders interessant finde, ist die Verschiebung vom reinen Mieten von Rechenleistung hin zum Aufbau eines wettbewerbsorientierteren Marktes rund um GPU-Kapazitäten.
KI braucht mehr Rechenleistung.
Aber sie braucht auch bessere Wege, um die Rechenleistung, die wir bereits haben, zuzuweisen.
Und Fluence setzt genau dort an, um diese Seite der Gleichung zu lösen.
Brauchst du Rechenleistung? Hast du Kapazität?
#Fluence #DePIN #AI #Web3
$6M IN GPU-VERTRÄGE: @Fluence
GPUs wurden knapp, teuer und werden für Teams, die KI-Produkte entwickeln, zunehmend wichtiger. Doch GPUs zu haben ist nur die halbe Lösung. Die andere Hälfte besteht darin, die verfügbare Kapazität mit den Teams zu verbinden, die sie tatsächlich benötigen.
Genau hier kommen https://auctions.fluence.network/ GPU-Auktionen ins Spiel.
Seit dem Start des Marktplatzes wurden bereits $6M an GPU-Cluster-Verträgen erfasst.
Das Modell ist einfach:
→ Teams posten ihre Rechenanforderungen
→ Anbieter konkurrieren mit Geboten
→ Käufer vergleichen Preis, SLA und Mietzeiträume
→ Verträge werden auf der Grundlage des akzeptierten Gebots geschlossen
Der aktuelle Marktplatz zeigt 6.468 GPUs, die in 4 Ländern verfügbar sind.
Was ich hier besonders interessant finde, ist die Verschiebung vom reinen Mieten von Rechenleistung hin zum Aufbau eines wettbewerbsorientierteren Marktes rund um GPU-Kapazitäten.
KI braucht mehr Rechenleistung.
Aber sie braucht auch bessere Wege, um die Rechenleistung, die wir bereits haben, zuzuweisen.
Und Fluence setzt genau dort an, um diese Seite der Gleichung zu lösen.
Brauchst du Rechenleistung? Hast du Kapazität?
#Fluence #DePIN #AI #Web3
85
·
--
Warum erregt DTEC Aufmerksamkeit im DePIN- und Mobility-Bereich?
Anstatt Fahrzeuge als passive Maschinen zu betrachten, baut @DtecAI auf der Idee auf, dass alltägliche Mobilität Teil eines dezentralen Daten- und KI-Netzwerks werden kann.
Wichtige Werttreiber:
• Real-Daten aus der Praxis: Fahrzeug- und Mobilitätsdaten können zu einer wertvollen Ressource für KI und vernetzte Anwendungen werden.
• DePIN-Infrastruktur: Vernetzte Fahrzeuge und Geräte liefern reale Daten für ein dezentrales Netzwerk.
• KI-gestützte Mobilität: DTECs Architektur kombiniert Fahrzeugdaten, IoT-Eingaben und KI, um personalisiertere Mobilitätserlebnisse zu schaffen.
• Beteiligung der Fahrer: Das Ökosystem ist darauf ausgelegt, Nutzer dafür zu belohnen, wertvolle Daten für das Netzwerk beizusteuern – über den DTEC-Token.
Wenn dezentrale Mobilitätsdaten effektiv skaliert werden können, könnte sich die Chance weit über Krypto hinaus erstrecken – hin zu KI, Automobildaten, vernetzten Fahrzeugen und intelligentem Verkehr.
Das Interessante für mich ist die Verschiebung von der bloßen Nutzung eines Fahrzeugs hin dazu, das Fahrzeug selbst zu einem Teil eines größeren Datennetzwerks zu machen.
Bist du bullisch auf die $DTEC-These? 👀
#DePIN #AI #Web3 #DTEC
1
69
·
--
Ist $DTEC die ultimative DePIN-Mobilitätschance?
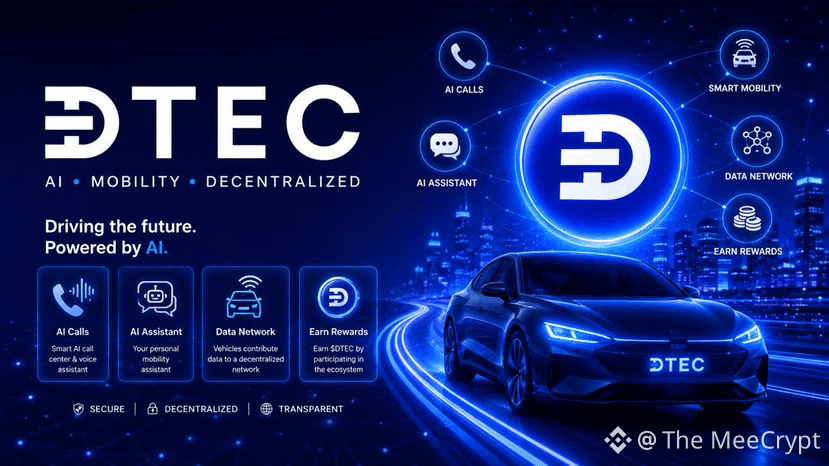
Mobilität zu dezentralisieren ist nicht nur ein Trend – es könnte verändern, wie Fahrzeuge, Daten und KI miteinander interagieren. DTEC baut ein Ökosystem auf, das Fahrzeuge, reale Daten, KI und dezentrale Infrastruktur über sein Mobilitätsnetzwerk miteinander verbindet.
WICHTIGSTE HIGHLIGHTS:
• Verdiene mit deinem Fahrzeug: Stelle Fahrzeug- und Mobilitätsdaten für das Netzwerk bereit und erhalte Belohnungen für deine Teilnahme.
• KI-gestützte Mobilität: Dtec kombiniert reale Fahrzeugdaten mit KI, um intelligentere Mobilitätsanwendungen zu ermöglichen.
• Dezentralisierte Daten: Von Fahrzeugen generierte Daten können Teil einer offenen, dezentralisierten Infrastruktur werden – statt in zentralisierten Systemen eingeschlossen zu bleiben.
• KI-Callcenter: Dtec bringt außerdem KI in die Geschäftskommunikation ein, um Kundeninteraktionen zu automatisieren und Support zu leisten.
• Real-World DePIN: Anstatt sich ausschließlich auf digitale Assets zu verlassen, verbindet Dtec dezentrale Infrastruktur mit physischen Fahrzeugen und alltäglicher Mobilität.
Wenn DePIN, KI und vernetzte Mobilität zusammenlaufen, baut DTEC an einer spannenden Schnittstelle.
$DTEC könnte möglicherweise zu einem der größten Projekte werden, das die nächste Generation dezentraler Mobilität prägt.
#Dtec #AI #DePIN
1
61
·
--
@fluence : GPU-Kapazität in einen Marktplatz verwandeln
KI-Workloads schaffen einen enormen Bedarf an GPUs, doch der Zugang zu der richtigen Hardware kann immer noch teuer und schwierig sein.
Fluence geht das auf eine andere Weise an.
Das dezentrale Compute-Netzwerk verbindet vorhandene Infrastruktur mit Kunden, während die GPU-Auktion ein Marktplatzmodell einführt: GPU-Kapazität kann ersteigert werden – statt wie üblich einfach über feste Cloud-Preise gekauft zu werden.
Anstatt dass jeder Kunde die gleiche, vorab festgelegte Rate zahlt, kann eine Auktion dabei helfen, verfügbare GPU-Angebote mit der tatsächlichen Nachfrage abzugleichen.
Für Anbieter schafft das eine weitere Möglichkeit, mit ihrer Hardware Geld zu verdienen.
Für Kunden eröffnet es die Chance, einen wettbewerbsfähigen Zugang zu der Compute-Kapazität zu finden, die sie benötigen.
Und hier wird die breitere Fluence-These besonders interessant.
Die Zukunft des Compute könnte nicht darum gehen, dass ein einzelnes Unternehmen die gesamte Hardware besitzt.
Es könnte darum gehen, offene Märkte für die Hardware zu schaffen, die bereits existiert.
Das ist der Infrastruktur-Aspekt, auf den es bei $FLT zu achten gilt.
#DePIN #AI #Web3 #FLT
@Fluence : GPU-Kapazität in einen Marktplatz verwandeln
KI-Workloads schaffen einen enormen Bedarf an GPUs, doch der Zugang zu der richtigen Hardware kann immer noch teuer und schwierig sein.
Fluence geht das auf eine andere Weise an.
Das dezentrale Compute-Netzwerk verbindet vorhandene Infrastruktur mit Kunden, während die GPU-Auktion ein Marktplatzmodell einführt: GPU-Kapazität kann ersteigert werden – statt wie üblich einfach über feste Cloud-Preise gekauft zu werden.
Anstatt dass jeder Kunde die gleiche, vorab festgelegte Rate zahlt, kann eine Auktion dabei helfen, verfügbare GPU-Angebote mit der tatsächlichen Nachfrage abzugleichen.
Für Anbieter schafft das eine weitere Möglichkeit, mit ihrer Hardware Geld zu verdienen.
Für Kunden eröffnet es die Chance, einen wettbewerbsfähigen Zugang zu der Compute-Kapazität zu finden, die sie benötigen.
Und hier wird die breitere Fluence-These besonders interessant.
Die Zukunft des Compute könnte nicht darum gehen, dass ein einzelnes Unternehmen die gesamte Hardware besitzt.
Es könnte darum gehen, offene Märkte für die Hardware zu schaffen, die bereits existiert.
Das ist der Infrastruktur-Aspekt, auf den es bei $FLT zu achten gilt.
#DePIN #AI #Web3 #FLT
105
·
--
@fluence : Cloud-Compute auf Enterprise-Niveau, ohne den hohen Preis der Big Tech
Wenn du ernsthafte Rechenleistung brauchst – die Art, mit der KI-Modelle trainiert oder umfangreiche Workloads im großen Maßstab betrieben werden –, gab es dafür nur ein paar wenige Anlaufstellen. AWS, Google Cloud, Azure. Zuverlässig, sicherlich, aber teuer – und vollständig in den Händen weniger Konzerne.
Fluence baut eine Alternative, bei der du nicht auf Qualität verzichten musst, um dorthin zu gelangen.
Gleiche Infrastruktur, anderes Eigentumsmodell
Fluence bezieht seine Compute-Ressourcen aus erstklassigen Rechenzentren, die bereits große Web2-Unternehmen versorgen. Das ist kein Netzwerk aus zufälligen, nicht verifizierten Maschinen – es ist die gleiche Qualität an Infrastruktur, die die traditionelle Cloud antreibt, nur anders organisiert. Statt dass ein Unternehmen diese Kapazität besitzt und bepreist, bündelt Fluence freie Kapazitäten zu einem dezentralen, dauerhaft verfügbaren Netzwerk, auf das jeder zugreifen kann.
Das Ergebnis: Kunden erhalten einen Enterprise-Grade-Service zu geringeren Kosten. Nutzer von Fluence haben bereits Millionen von Dollar gespart – im Vergleich zu dem, was sie bei traditionellen Cloud-Providern zahlen würden: echte Einsparungen von echten Kunden, die reale Workloads im Netzwerk ausführen.
$FLT ist der Token, der das gesamte System zusammenhält:
• Provider setzen FLT ein, um das Netzwerk abzusichern und werden für die von ihnen bereitgestellte Compute-Kapazität bezahlt
• Kundeneinnahmen finanzieren ein Rückkaufprogramm, sodass die Nutzung im Netzwerk direkt in die Token-Ökonomie von FLT zurückfließt
• Aktuell sind über 25 Millionen FLT hinterlegt (staked), die das Netzwerk im großen Maßstab absichern
• Inhaber können FLT über das Token Dashboard staken, an der Governance teilnehmen und Rewards erhalten, die an die Netzwerkaktivität gekoppelt sind
Der Bedarf von KI nach Compute lässt nicht nach. Das Trainieren und Ausführen von Modellen erfordert enorme Infrastruktur – und dieser Bedarf wächst weiter. Traditionelle Cloud-Provider haben ihre Geschäftsmodelle darauf aufgebaut, den Zugang zu dieser Infrastruktur zu kontrollieren und sie entsprechend zu bepreisen.
Fluence schlägt einen anderen Weg ein: die gleiche Qualität an Compute, bezogen aus den gleichen erstklassigen Rechenzentren – aufgebaut jedoch auf einem Netzwerk, in dem der Wert zurück zu den Menschen fließt, die es absichern und nutzen.
#DePIN #FLT #AI #Web3
@Fluence : Cloud-Compute auf Enterprise-Niveau, ohne den hohen Preis der Big Tech
Wenn du ernsthafte Rechenleistung brauchst – die Art, mit der KI-Modelle trainiert oder umfangreiche Workloads im großen Maßstab betrieben werden –, gab es dafür nur ein paar wenige Anlaufstellen. AWS, Google Cloud, Azure. Zuverlässig, sicherlich, aber teuer – und vollständig in den Händen weniger Konzerne.
Fluence baut eine Alternative, bei der du nicht auf Qualität verzichten musst, um dorthin zu gelangen.
Gleiche Infrastruktur, anderes Eigentumsmodell
Fluence bezieht seine Compute-Ressourcen aus erstklassigen Rechenzentren, die bereits große Web2-Unternehmen versorgen. Das ist kein Netzwerk aus zufälligen, nicht verifizierten Maschinen – es ist die gleiche Qualität an Infrastruktur, die die traditionelle Cloud antreibt, nur anders organisiert. Statt dass ein Unternehmen diese Kapazität besitzt und bepreist, bündelt Fluence freie Kapazitäten zu einem dezentralen, dauerhaft verfügbaren Netzwerk, auf das jeder zugreifen kann.
Das Ergebnis: Kunden erhalten einen Enterprise-Grade-Service zu geringeren Kosten. Nutzer von Fluence haben bereits Millionen von Dollar gespart – im Vergleich zu dem, was sie bei traditionellen Cloud-Providern zahlen würden: echte Einsparungen von echten Kunden, die reale Workloads im Netzwerk ausführen.
$FLT ist der Token, der das gesamte System zusammenhält:
• Provider setzen FLT ein, um das Netzwerk abzusichern und werden für die von ihnen bereitgestellte Compute-Kapazität bezahlt
• Kundeneinnahmen finanzieren ein Rückkaufprogramm, sodass die Nutzung im Netzwerk direkt in die Token-Ökonomie von FLT zurückfließt
• Aktuell sind über 25 Millionen FLT hinterlegt (staked), die das Netzwerk im großen Maßstab absichern
• Inhaber können FLT über das Token Dashboard staken, an der Governance teilnehmen und Rewards erhalten, die an die Netzwerkaktivität gekoppelt sind
Der Bedarf von KI nach Compute lässt nicht nach. Das Trainieren und Ausführen von Modellen erfordert enorme Infrastruktur – und dieser Bedarf wächst weiter. Traditionelle Cloud-Provider haben ihre Geschäftsmodelle darauf aufgebaut, den Zugang zu dieser Infrastruktur zu kontrollieren und sie entsprechend zu bepreisen.
Fluence schlägt einen anderen Weg ein: die gleiche Qualität an Compute, bezogen aus den gleichen erstklassigen Rechenzentren – aufgebaut jedoch auf einem Netzwerk, in dem der Wert zurück zu den Menschen fließt, die es absichern und nutzen.
#DePIN #FLT #AI #Web3
87
·
--
Alle rennen los, um das nächste große KI-Produkt zu bauen, aber fast niemand spricht darüber, was diesen Wettlauf tatsächlich ausbremst: genug GPUs zu bekommen, ohne monatelang zu warten oder dafür hyperskalare Preise zu zahlen.
@fluence ist eines der wenigen Projekte, die dieses Problem wirklich lösen – und nicht nur darüber reden.
So ist der Aufbau: Fluence verbindet Entwickler direkt mit einem globalen Netzwerk unabhängiger Compute-Anbieter, statt alle über AWS, Google Cloud oder Azure zu routen. Echte Rechenzentren, echte Hardware – ohne dass ein einzelnes Unternehmen die Preisgestaltung oder die Pipeline kontrolliert.
Und es funktioniert bereits. Ihr GPU-Marktplatz ist live und bietet Enterprise-taugliches Computing zu bis zu 85 % niedrigeren Kosten als die großen Clouds. Auf der CPU-Seite haben sie zudem schon über 1 Mio. US-Dollar Umsatz pro Jahr erzielt – das ist kein Roadmap-Versprechen, sondern ein Produkt, das Menschen tatsächlich nutzen und dafür bezahlen.
Das Neueste sind GPU-Cluster-Auktionen: ein echtes Bietermarkt-Modell für reservierte GPU-Kapazitäten. Anstatt zu hoffen, dass ein Anbieter zu einem fairen Preis verfügbar ist, posten Teams genau, was sie brauchen (GPU-Modell, Menge, Region, Zeitraum) – und Anbieter konkurrieren um den Auftrag. Das ist Preisfindung, die es in diesem Bereich derzeit schlicht nirgendwo anders gibt.
DePIN und KI prallen gerade heftig aufeinander, und die meisten Projekte in diesem Überschneidungsbereich sind noch theoretisch. Fluence ist es nicht – es ist Infrastruktur, die bereits genutzt wird, um ein echtes, teures Problem zu lösen.
Wenn du dir den Web3-x-KI-Bereich anschaust, ist $FLT es wert, verstanden zu werden – nicht wegen der Story, sondern dafür, was tatsächlich gebaut wird.
#Fluence #DePIN #AI
Alle rennen los, um das nächste große KI-Produkt zu bauen, aber fast niemand spricht darüber, was diesen Wettlauf tatsächlich ausbremst: genug GPUs zu bekommen, ohne monatelang zu warten oder dafür hyperskalare Preise zu zahlen.
@Fluence ist eines der wenigen Projekte, die dieses Problem wirklich lösen – und nicht nur darüber reden.
So ist der Aufbau: Fluence verbindet Entwickler direkt mit einem globalen Netzwerk unabhängiger Compute-Anbieter, statt alle über AWS, Google Cloud oder Azure zu routen. Echte Rechenzentren, echte Hardware – ohne dass ein einzelnes Unternehmen die Preisgestaltung oder die Pipeline kontrolliert.
Und es funktioniert bereits. Ihr GPU-Marktplatz ist live und bietet Enterprise-taugliches Computing zu bis zu 85 % niedrigeren Kosten als die großen Clouds. Auf der CPU-Seite haben sie zudem schon über 1 Mio. US-Dollar Umsatz pro Jahr erzielt – das ist kein Roadmap-Versprechen, sondern ein Produkt, das Menschen tatsächlich nutzen und dafür bezahlen.
Das Neueste sind GPU-Cluster-Auktionen: ein echtes Bietermarkt-Modell für reservierte GPU-Kapazitäten. Anstatt zu hoffen, dass ein Anbieter zu einem fairen Preis verfügbar ist, posten Teams genau, was sie brauchen (GPU-Modell, Menge, Region, Zeitraum) – und Anbieter konkurrieren um den Auftrag. Das ist Preisfindung, die es in diesem Bereich derzeit schlicht nirgendwo anders gibt.
DePIN und KI prallen gerade heftig aufeinander, und die meisten Projekte in diesem Überschneidungsbereich sind noch theoretisch. Fluence ist es nicht – es ist Infrastruktur, die bereits genutzt wird, um ein echtes, teures Problem zu lösen.
Wenn du dir den Web3-x-KI-Bereich anschaust, ist $FLT es wert, verstanden zu werden – nicht wegen der Story, sondern dafür, was tatsächlich gebaut wird.
#Fluence #DePIN #AI
68
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer