

Not 歸藏
60 Beiträge

Not 歸藏
Melden
Nutzer blockieren
0 Following
2 Follower
3 Like gegeben
Beiträge
Alle
Videos
·
--
In letzter Zeit ist ein „Personal Agent“ sehr angesagt
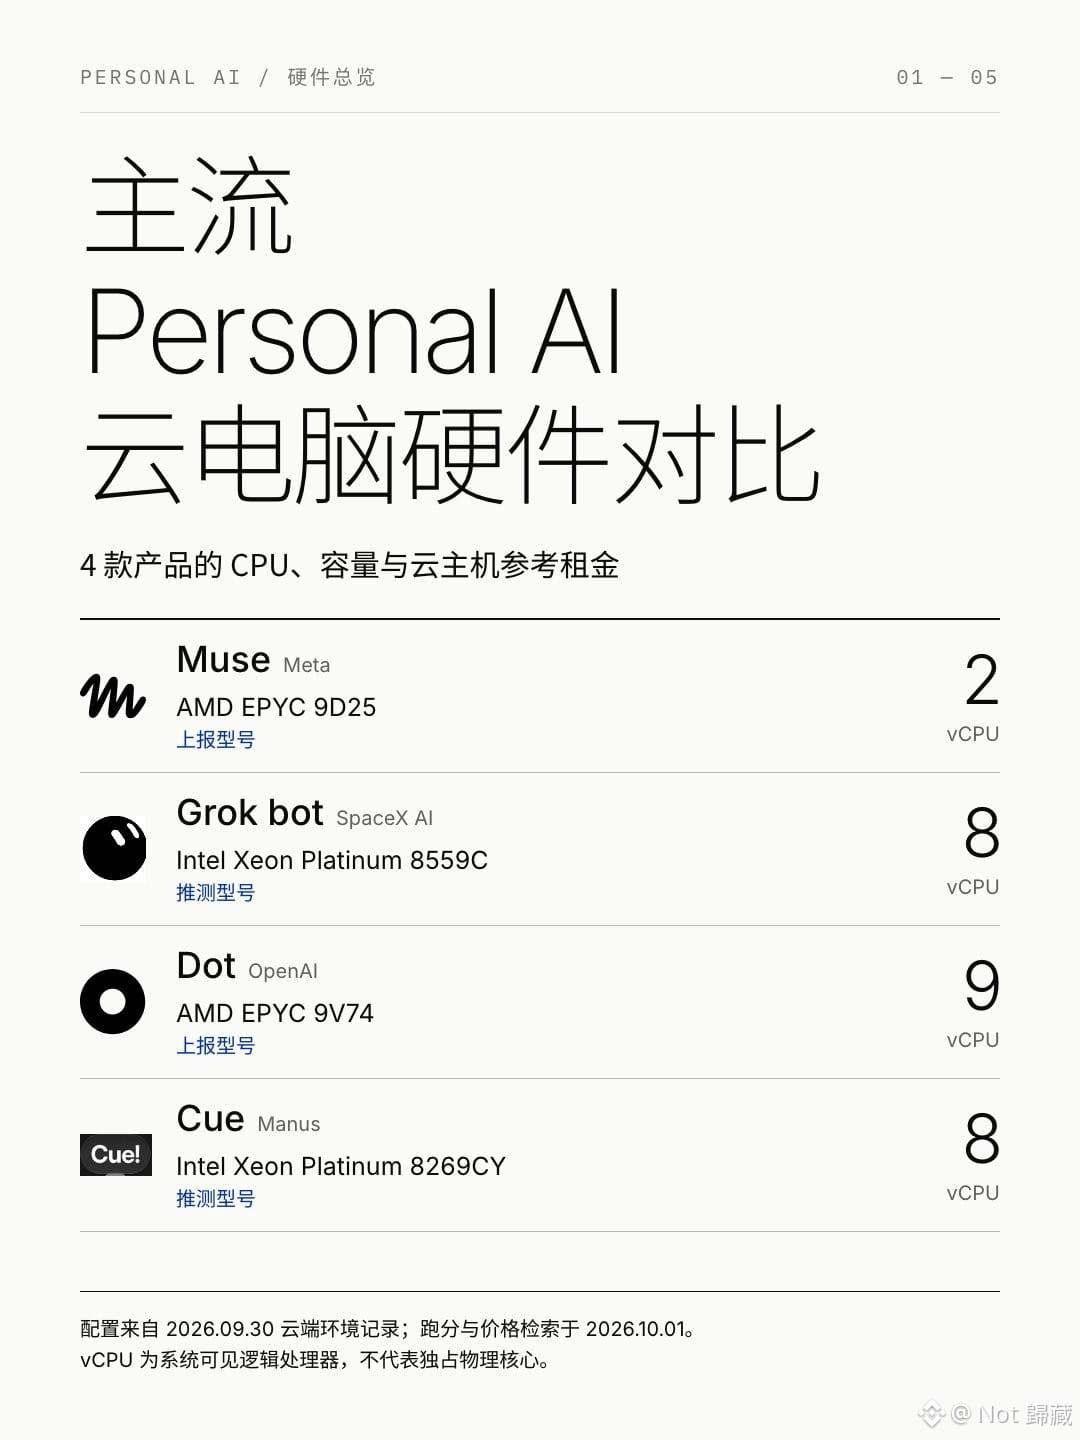
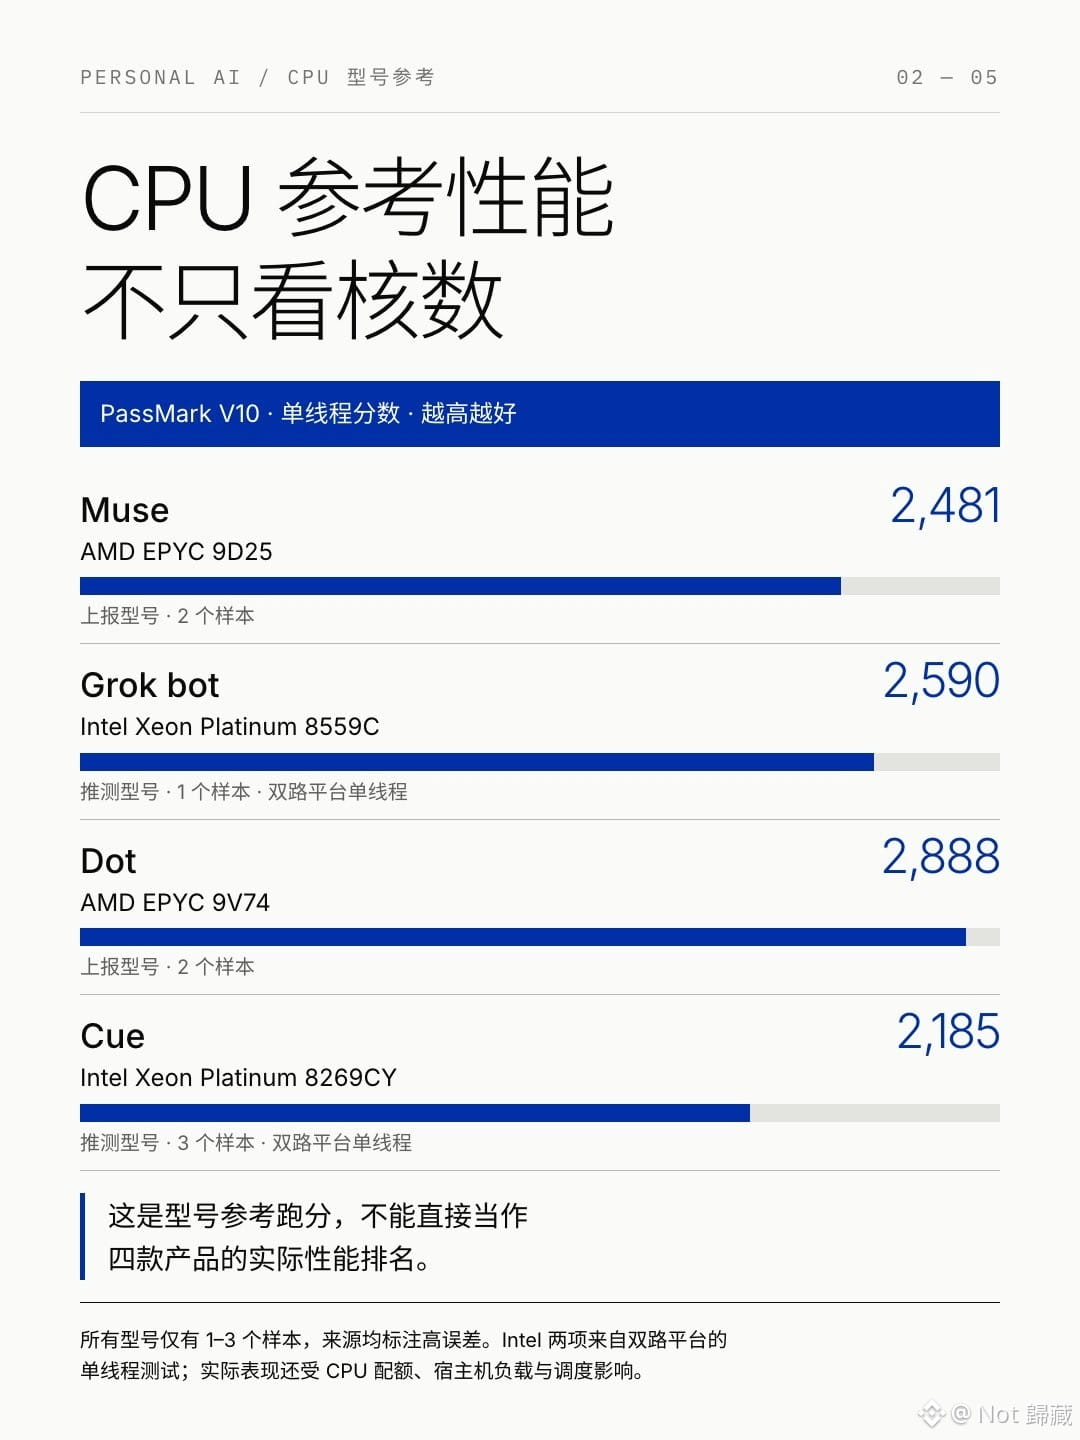
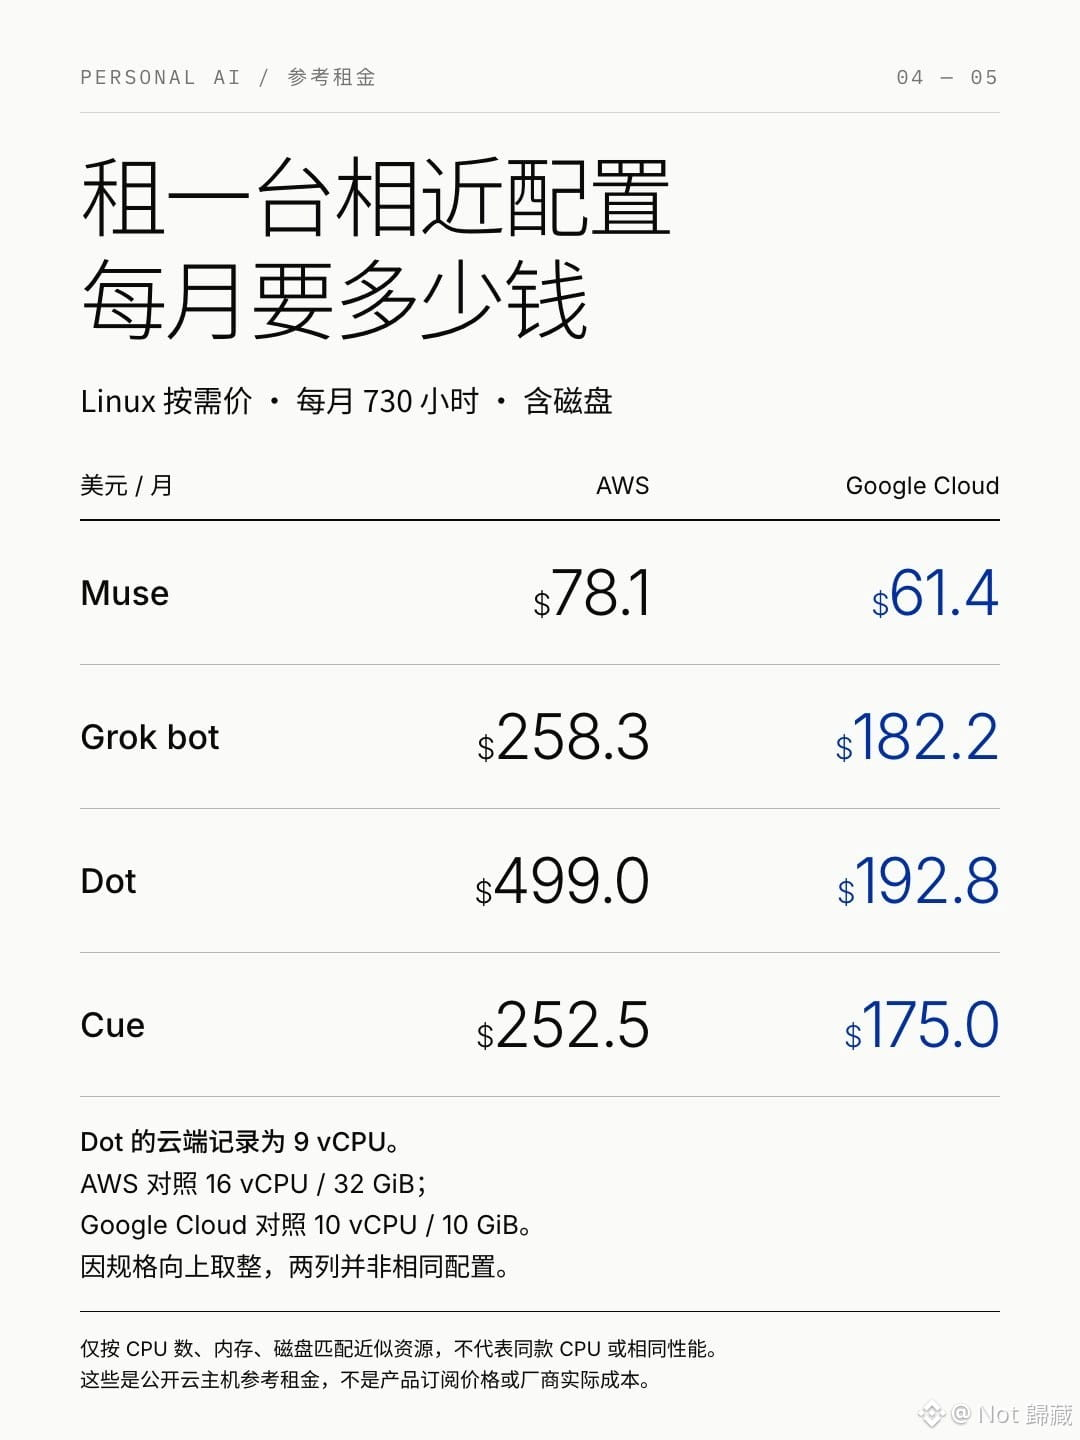
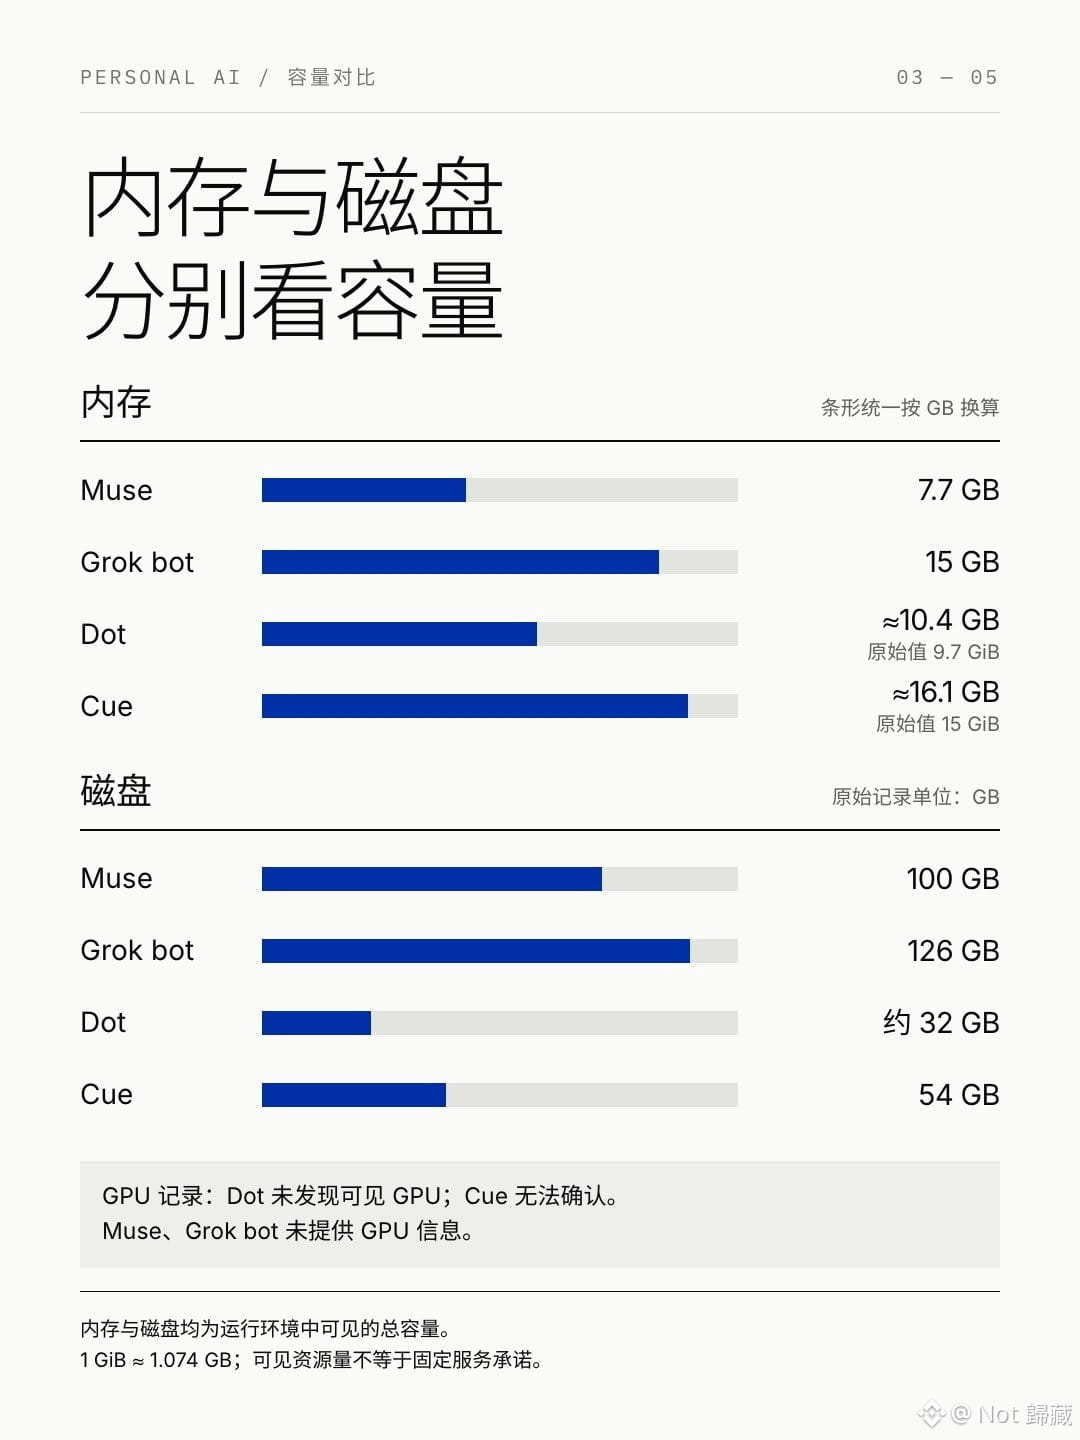
Ich habe mir die VM-Konfigurationen gängiger Personal-Agents angesehen. So betrachtet ist Ma ja wirklich großzügig.
Grokbot ist mit sehr soliden Zuteilungen bei CPU, RAM und Festplatte ausgestattet, und auch Dots Konfiguration ist ziemlich hoch.
Allerdings scheint Dot sich die virtuelle Maschine nicht exklusiv zu teilen – möglicherweise gibt es eine gemeinsame Nutzung.
221
·
--
Übersetzung ansehen
Muse 用法+1,每天早上帮我生成一个 AI 资讯早报视频
写一下实践的步骤:
1. 基于我日常的内容渠道和喜好先整理文案来源到 Notion 和聊天里面
2. 查找下载相关内容的图片和视频素材
3. 在虚拟机里面通过 Pi 调用我的 K3 和 GLM 5.3 模型利用 guizang-product-video-skill 将所有的信息组装成视频
4. 通过 Muesli 聊天发给我
Muse 用法+1,每天早上帮我生成一个 AI 资讯早报视频
写一下实践的步骤:
1. 基于我日常的内容渠道和喜好先整理文案来源到 Notion 和聊天里面
2. 查找下载相关内容的图片和视频素材
3. 在虚拟机里面通过 Pi 调用我的 K3 和 GLM 5.3 模型利用 guizang-product-video-skill 将所有的信息组装成视频
4. 通过 Muesli 聊天发给我
写一下实践的步骤:
1. 基于我日常的内容渠道和喜好先整理文案来源到 Notion 和聊天里面
2. 查找下载相关内容的图片和视频素材
3. 在虚拟机里面通过 Pi 调用我的 K3 和 GLM 5.3 模型利用 guizang-product-video-skill 将所有的信息组装成视频
4. 通过 Muesli 聊天发给我
52
·
--
Muse 用法+1, jeden Morgen sollst du mir ein KI-News-Update als Video generieren
Schreib die Schritte der Praxis auf:
1. Richte zuerst anhand meiner täglichen Content-Kanäle und Vorlieben die Quellen der Copy zusammen und lege sie in Notion und im Chat ab
2. Suche und lade passende Bild- und Videomaterialien zu den Inhalten herunter
3. Rufe in der virtuellen Maschine über Pi mein K3- und GLM-5.3-Modell auf und nutze dabei die guizang-product-video-skill, um alle Informationen zu einem Video zusammenzusetzen
4. Sende mir das über die Mues-Chatoberfläche
78
·
--
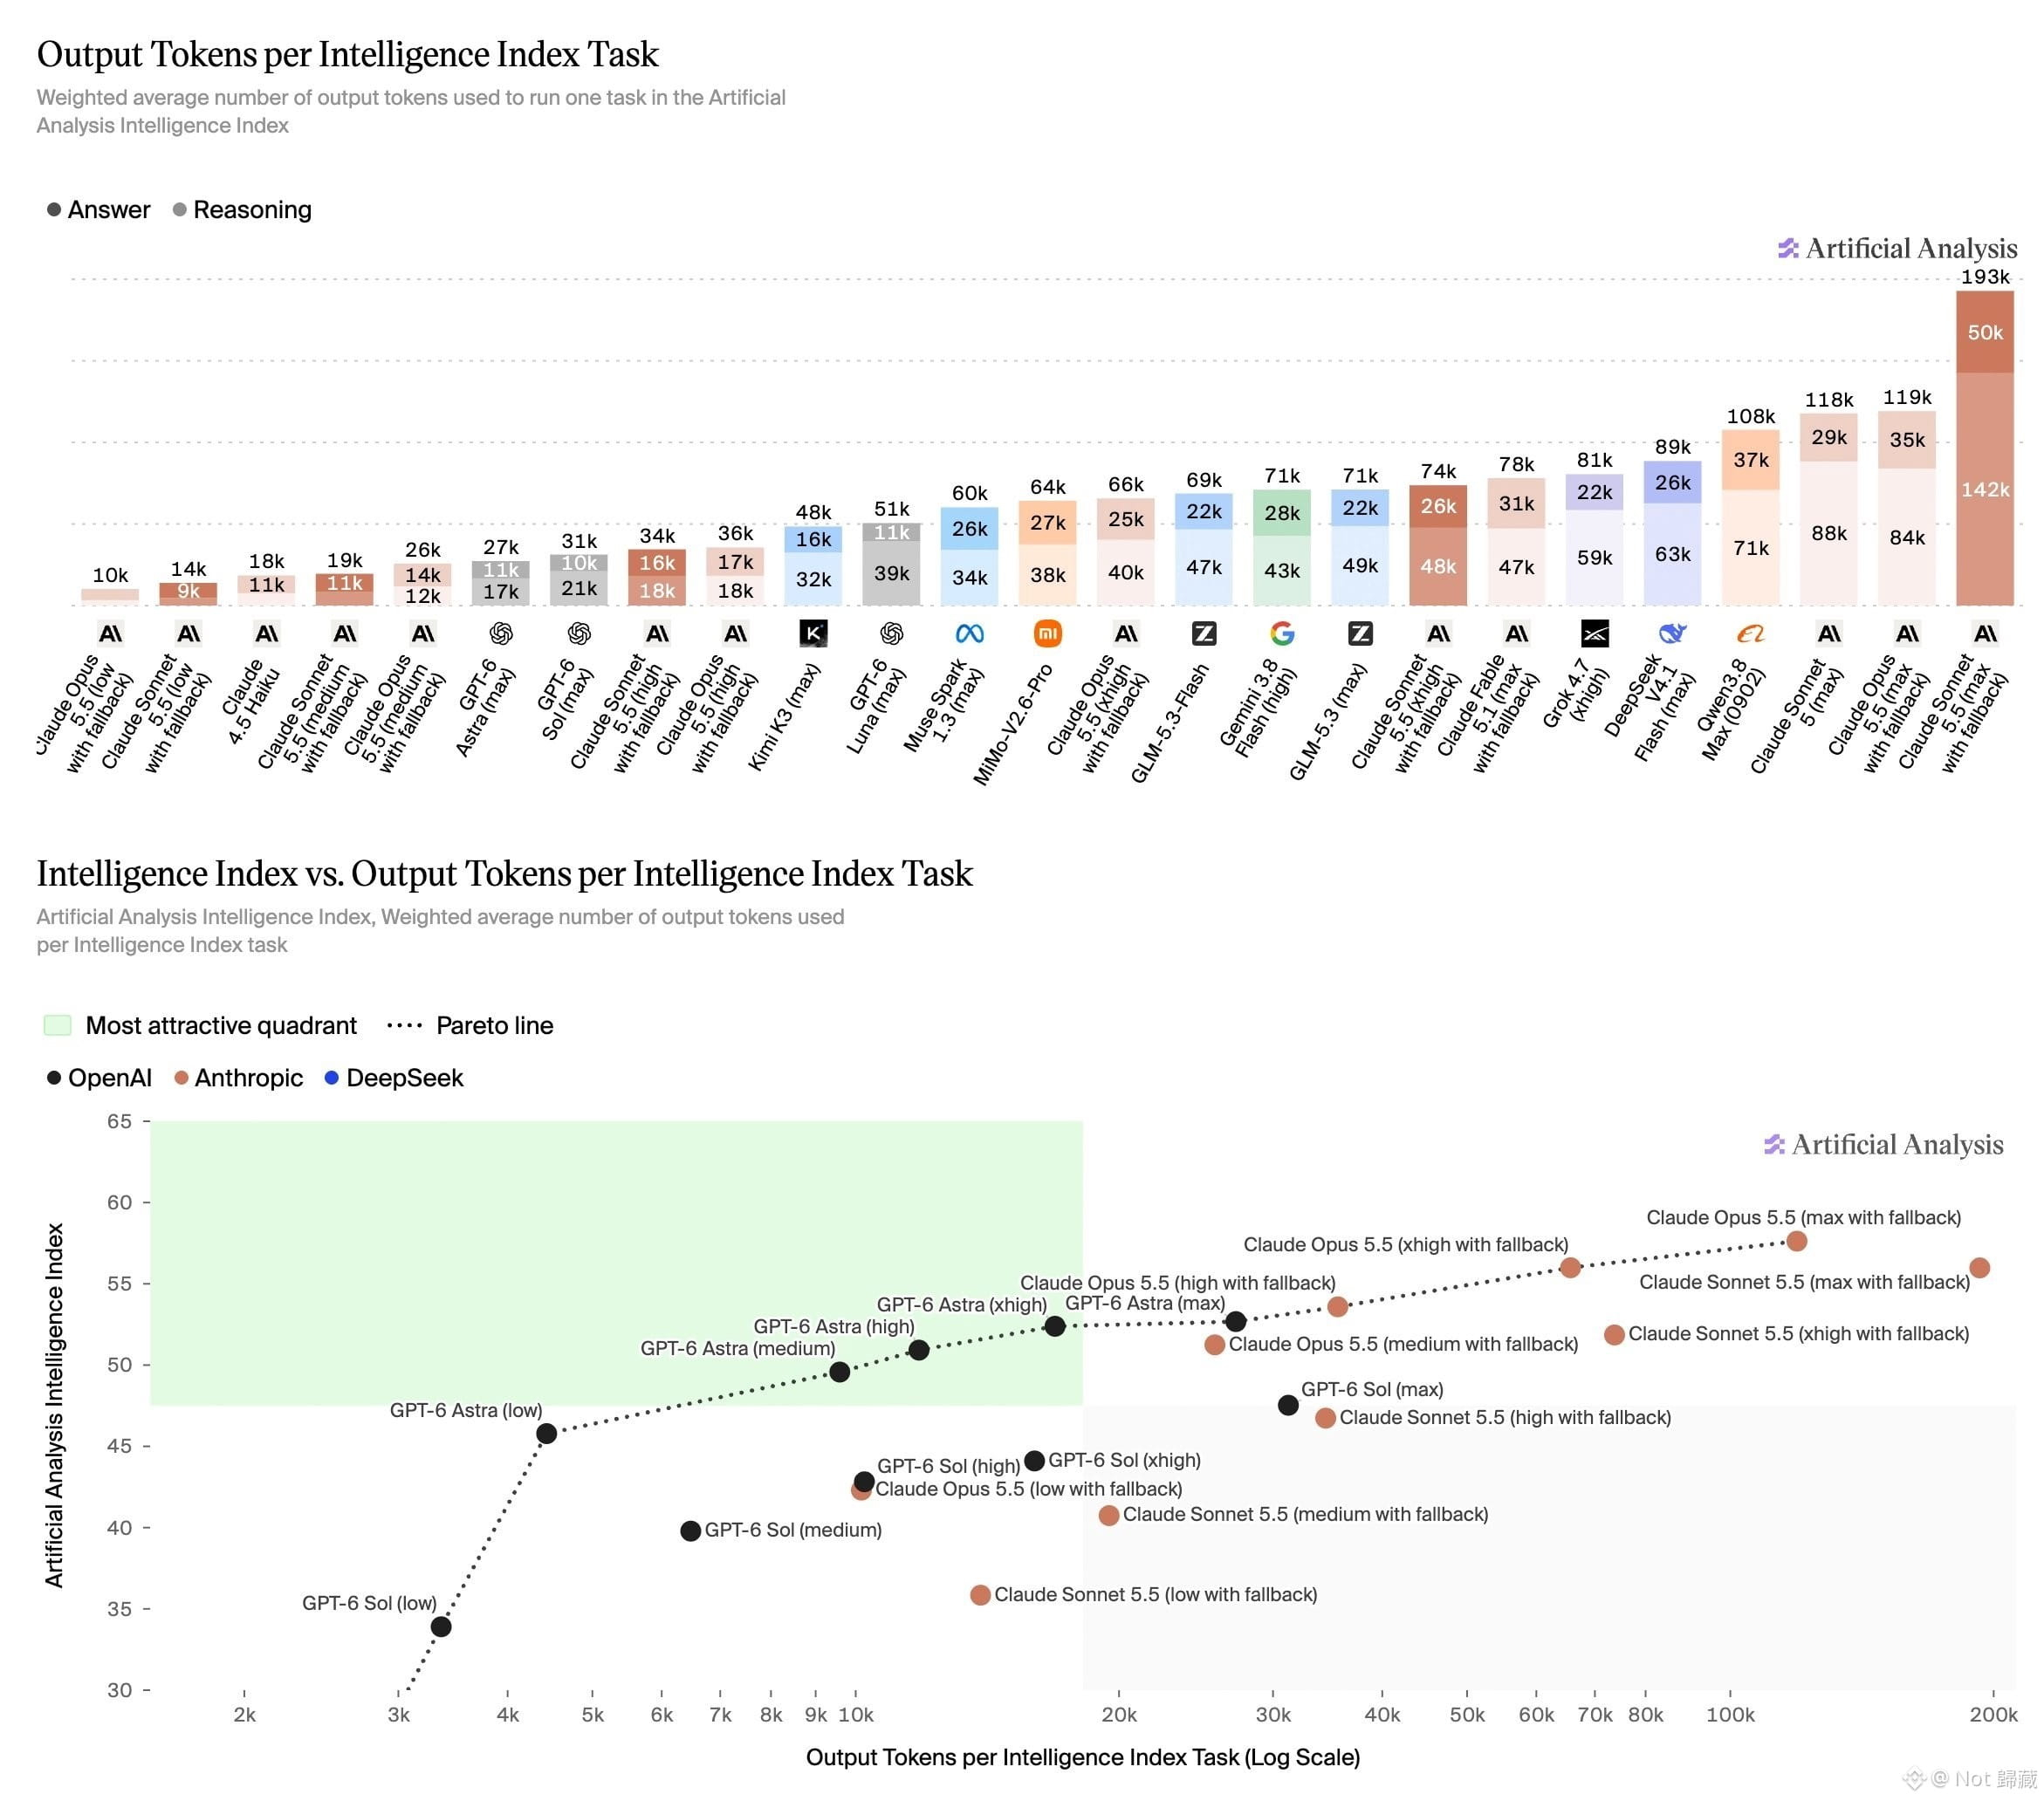
Sonnet 5.5 wurde veröffentlicht, und dieses Modell ist wirklich erstaunlich: Bei Agentic-Coding-Tests erzielt es einen um 4 Punkte höheren Score als Opus 5.5.
Auch beim Preis ist es sehr günstig: Die Kosten pro einer Million Tokens für Input und Output betragen jeweils 2 und 10 US-Dollar – also genauso wie bei GPT-6 Sol. Außerdem ist seine Laufgeschwindigkeit im Vergleich zu Sonnet 5 um 30 % schneller, und laut der offiziellen Angabe von Claude sind auch die Kosten um 30 % gesunken.
Warum seine Leistung beim Agentic-Coding ähnlich ist wie die von Opus 5.5, sogar teils höher, lässt sich anhand der Preistests erkennen.
Unter maximalem Einsatzgrad (max) sind die Kosten für dieselben Aufgaben bei Sonnet 5.5 deutlich höher als bei Opus 5.5: Es liegt fast gleichauf oder überholt es sogar. Das könnte der Grund für den hohen Score sein.
Also: Setzt bei der Nutzung von Opus 5.5 oder Sonnet 5.5 auf keinen Fall „max“ ein. Bei manchen komplexen Aufgaben kann es einen extrem teuren Preis verursachen – beinahe auf dem Niveau von Claude Fable 5.1.
369
·
--
Muse, ein Agent mit virtueller Maschine – das Gameplay ist unglaublich vielfältig
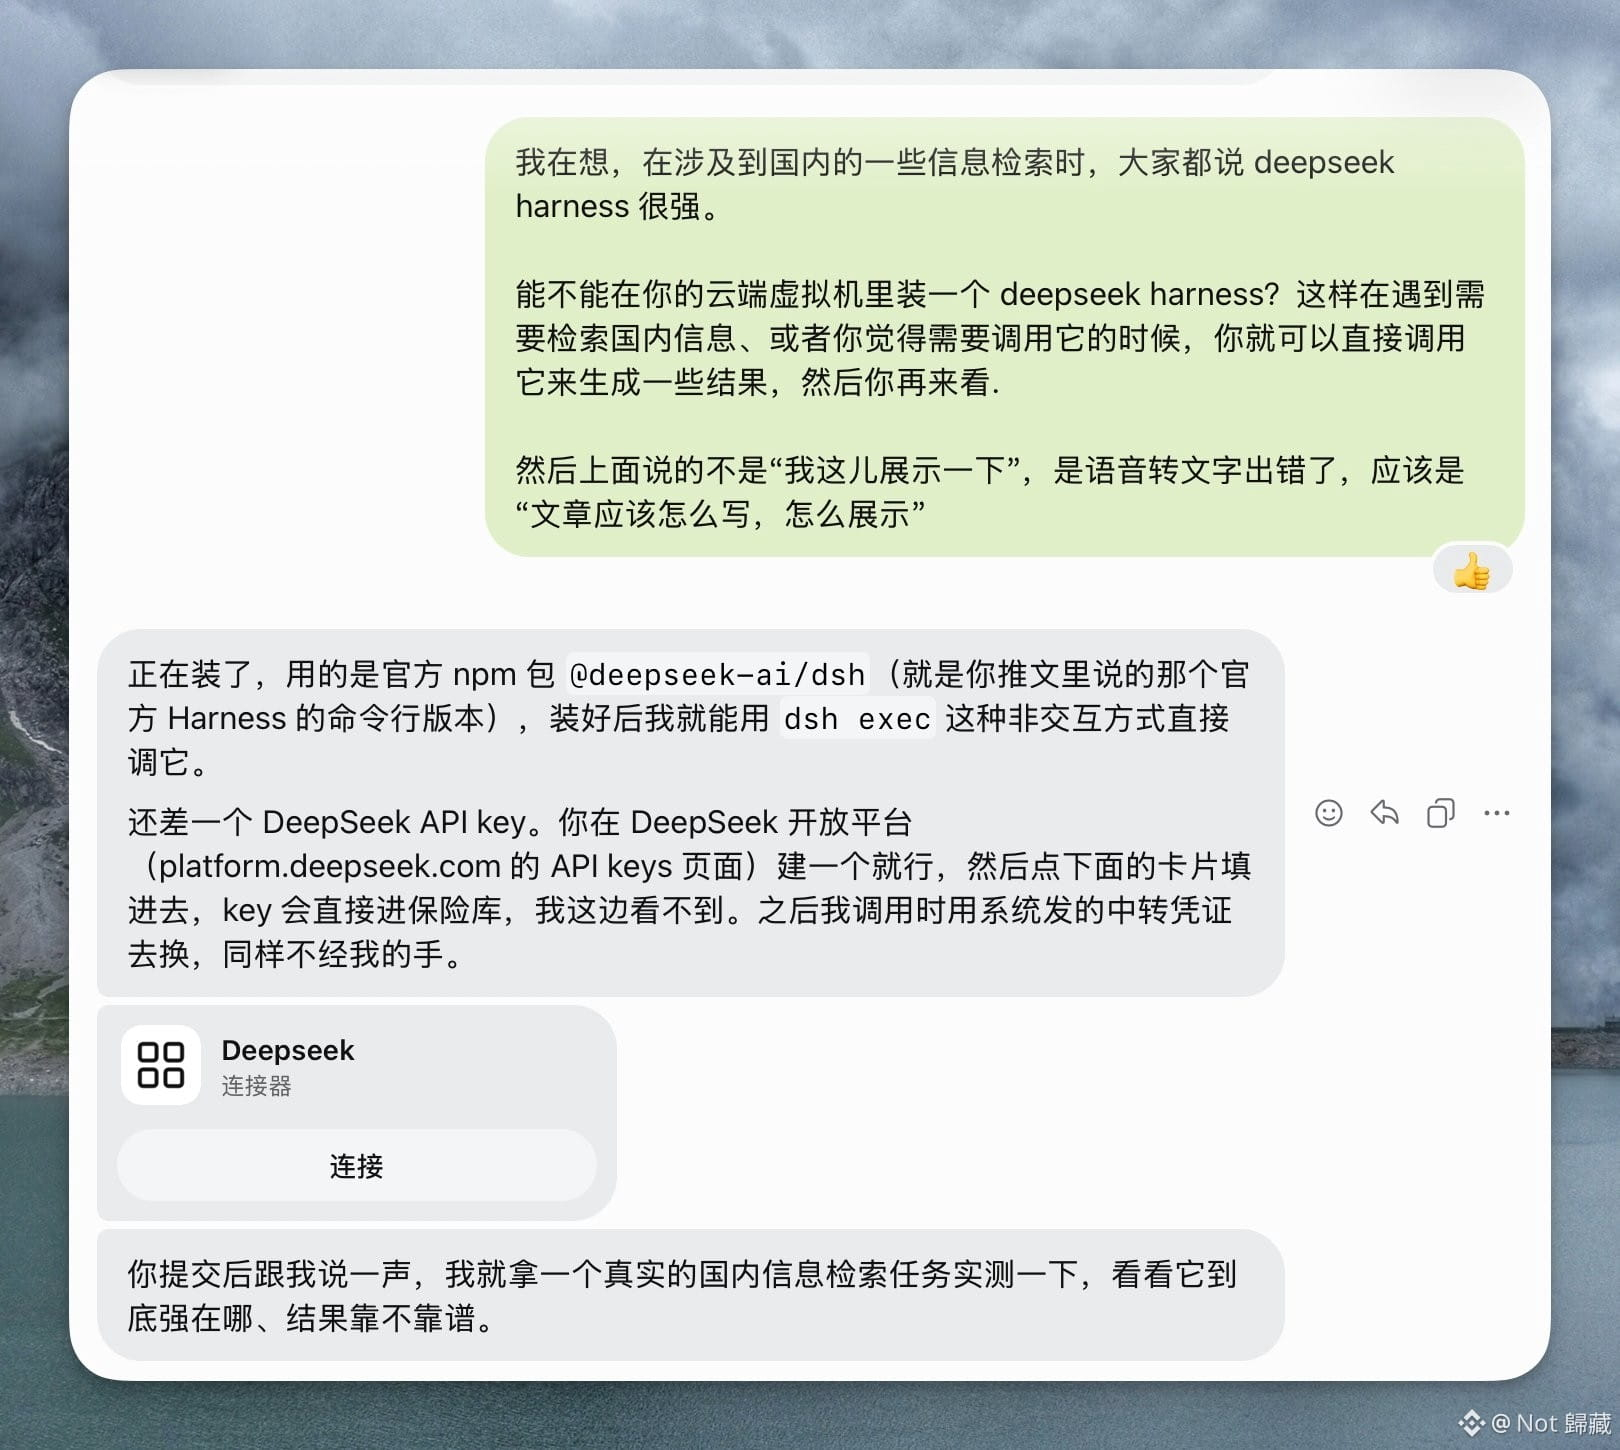
Freunde sagen, dass DeepSeek Harness beim Durchsuchen von Inhalten im Inland ziemlich umfassend und genau ist.
Genau das nutze ich gerade auch mit Muse. Also lassen wir es DeepSeek Harness in die virtuelle Maschine in der Muse-Cloud einbauen.
Sobald es um die Informationsrecherche innerhalb des Landes geht, rufen wir einfach DeepSeek Harness auf der virtuellen Maschine direkt auf, um nachzuschauen.
118
·
--
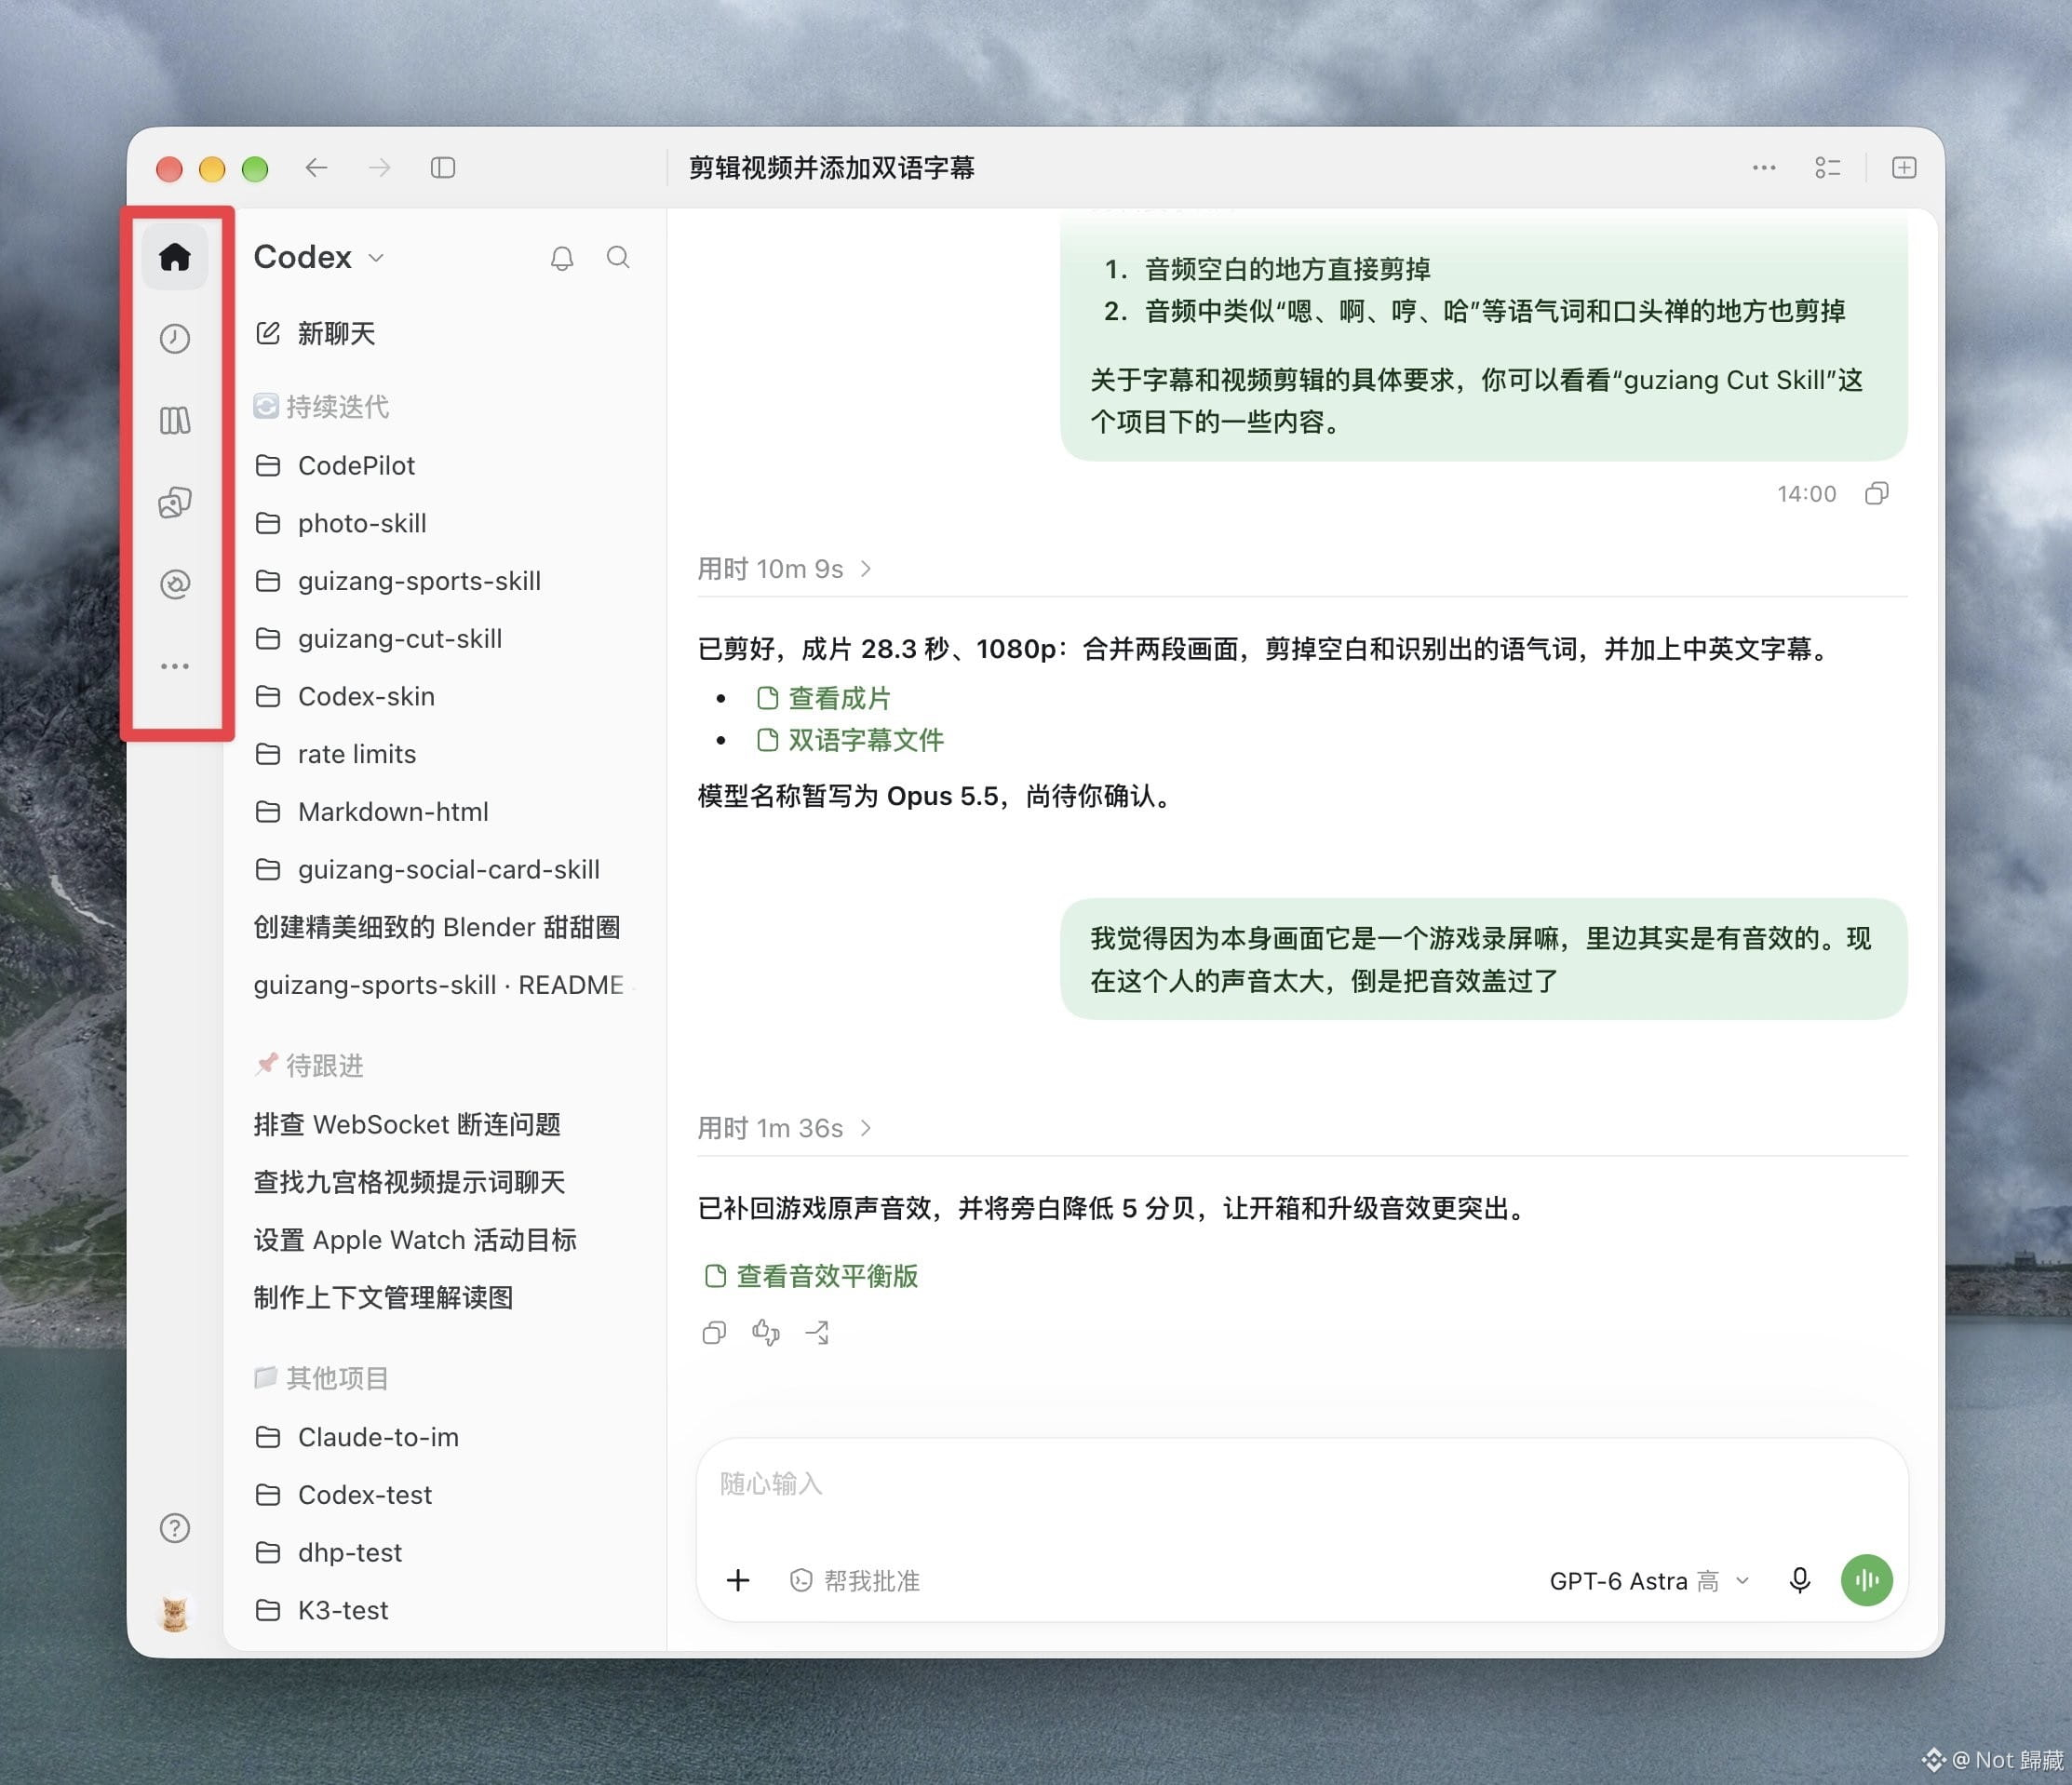
Codex wurde aktualisiert – die Benutzeroberfläche wurde komplett überarbeitet. Links wurde eine neue Navigationsleiste hinzugefügt, in der jetzt die Plugins, geplanten Aufgaben, Sites, Projekte, die Karte sowie PRs im linken Menübereich zu finden sind.
Außerdem wurden zwei neue Seiten hinzugefügt: die Mediathek und Bilder.
In der Mediathek findest du all deine Bilder, Fotos, Dateien, Ordner und Favoriten. Auch alle Dokumente, die du erstellst, sowie die von KI erstellten Bilddokumente werden hier gespeichert.
Auf der Seite „Bilder“ gibt es im Grunde die gleichen Vorlagen und Prompt-Texte, die zuvor in der ursprünglichen ChatGPT-Bilder-Seite für das GPT-Image-Modell verfügbar waren.
Eigentlich ist diese Änderung viel besser.
Sonst war vorher alles oben zusammengepackt. Mit zunehmenden Projekten und Chats musste man jedes Mal zurückscrollen, um die paar Einstiegspunkte oben wiederzufinden – ziemlich nervig.
Außerdem ist CodPilot von „Zang Shifu“ jetzt eine Version voraus gegenüber Codex. Vor ein paar Monaten wurde bereits die Mediathek hinzugefügt, die alle von dir mit KI generierten Ergebnisse auf einer Seite bündelt – zum Beispiel Bild-, Video-, Web- und Audio-Materialien.
Du kannst auch direkt aus den Ergebnissen der Mediathek zurück in den Chat springen und dir ansehen, wie genau es gemacht wurde. Das ist sehr praktisch für die Verwaltung und außerdem dafür, dass andere Modelle diese Materialien abrufen und wiederverwenden können.
Allerdings finden auch viele Leute es unpraktisch und sagen, dass es sich ungewohnt anfühlt. Bei so einem großen Umbau wird es natürlich immer solche Fälle geben.
1
102
·
--
Mit Opus 5.5 für Spiel-Animations-Countdowns/-Abrechnungen zu arbeiten, ist auch wirklich toll!
Ursprünglich erstellt es 2D-SVG-Symbole, aber dann habe ich es so umgestellt, dass es diesen 3D-Effekt erzeugt – das macht es abwechslungsreicher, und außerdem wurde die Darstellung der Lichteffekte usw. noch optimiert
Das ist die erste Truhen-Version, später gibt es noch eine Abzeichen-Version
Ursprünglich erstellt es 2D-SVG-Symbole, aber dann habe ich es so umgestellt, dass es diesen 3D-Effekt erzeugt – das macht es abwechslungsreicher, und außerdem wurde die Darstellung der Lichteffekte usw. noch optimiert
Das ist die erste Truhen-Version, später gibt es noch eine Abzeichen-Version
59
·
--
Opus 5.5 macht dynamisch einfach zu krass!
Ich versuche, mit ihm ein Video mit einer künstlerischen Interpretation fürs Mid-Autumn-Festival zu machen und wünsche allen einen schönen Mittherbstabend!
Die Musik ist ein elektronischer Remix/Variation, den er mit der Notenvorlage von „Der Mond steht für mein Herz“ gemacht hat.
Er kann nicht nur selbst Originale schaffen, sondern auch mixen und umarbeiten – und dann setzt er noch gekonnt passende Akzente. Echt unglaublich!
59
·
--
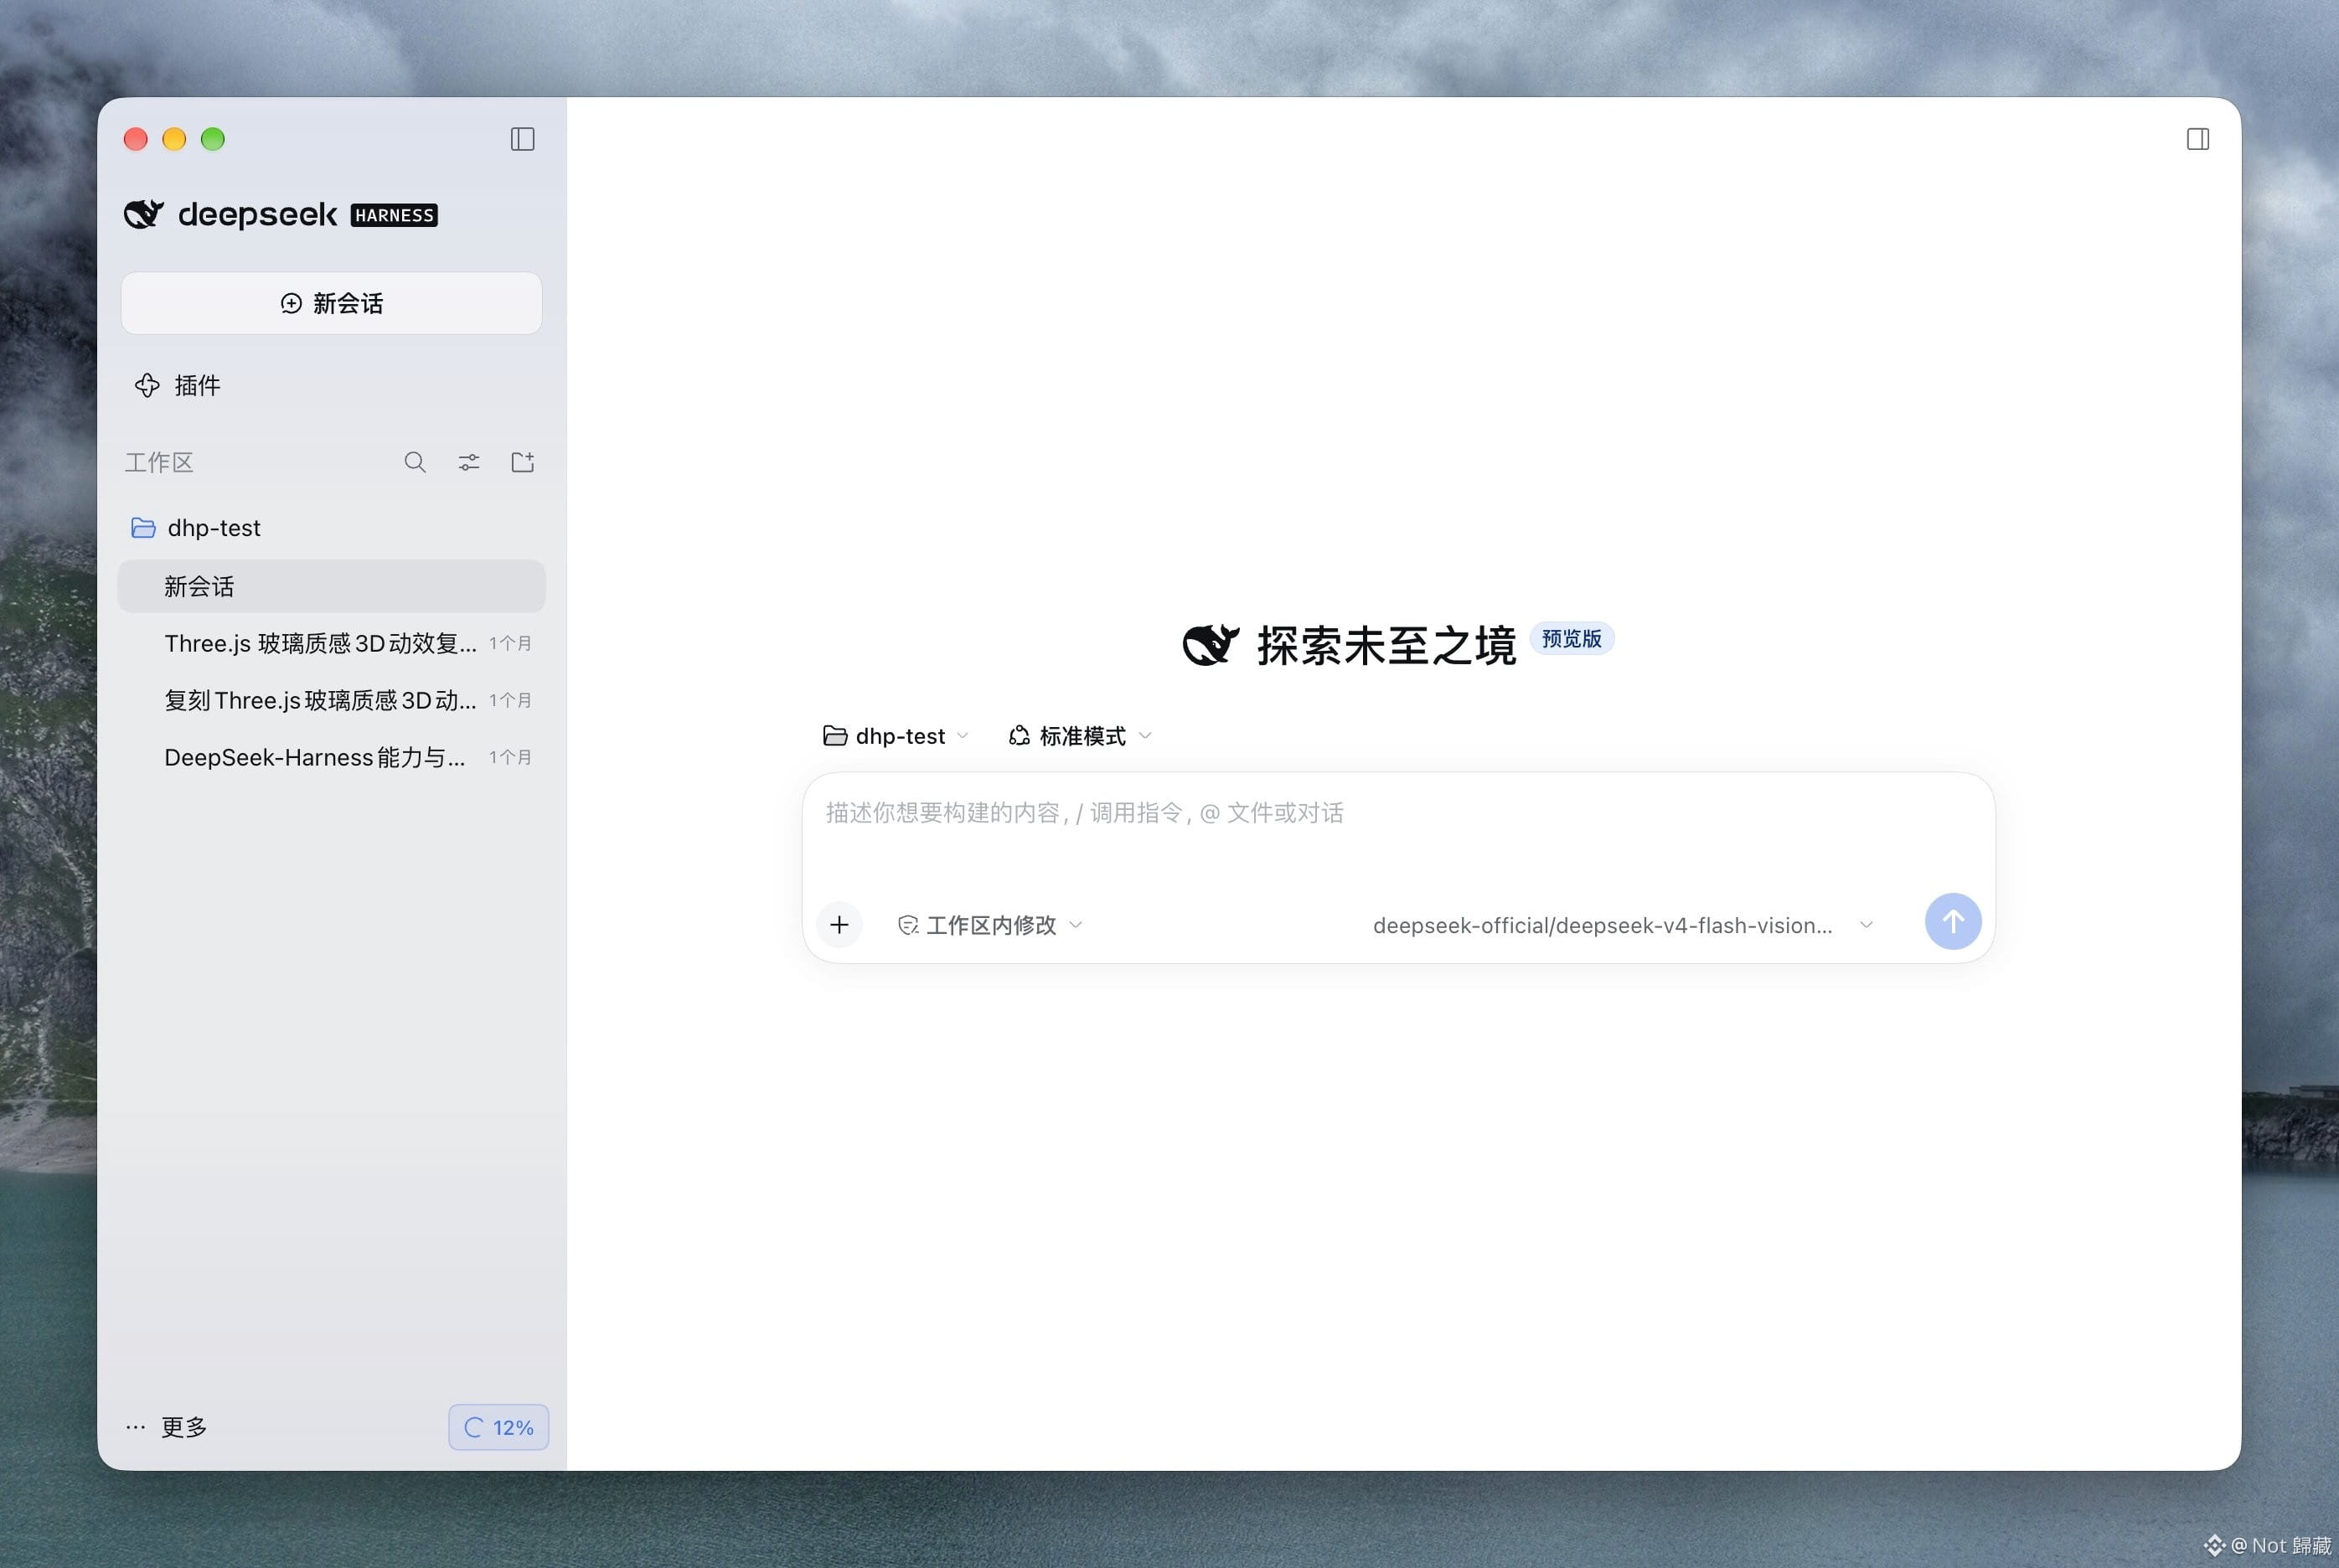
Deepseek Harness hat tatsächlich eine offizielle, verpackte Client-Version veröffentlicht
Man muss nicht bei jedem Start oder jeder Installation jedes Mal Befehle verwenden. Windows und Mac sind verfügbar
Deepseek Harness hat tatsächlich eine offizielle, verpackte Client-Version veröffentlicht
Man muss nicht bei jedem Start oder jeder Installation jedes Mal Befehle verwenden. Windows und Mac sind verfügbar
Man muss nicht bei jedem Start oder jeder Installation jedes Mal Befehle verwenden. Windows und Mac sind verfügbar
61
·
--
Muse ist wirklich Feuer und steigt direkt auf Platz 1 im US-Apple-App-Store. An dem Tag, an dem es offiziell integriert wurde, stieg Shopify direkt um 13 %.
Zufällig hat mein Freund Today AI auch heute in China gestartet.
Muse bringt das Konzept des „Personal Agent“ erst so richtig in die Aufmerksamkeit – aber eigentlich gab es schon vorher Hinweise, zum Beispiel beim Grok-Bot.
Schade nur, dass Muse für uns ziemlich umständlich und anstrengend zu nutzen ist (schließlich hat Meta dank der jahrelangen Erfahrung in der Risiko- und Zugangskontrolle vermutlich sogar noch strengere Vorgaben als Anthropic).
Today AI dürfte außerdem das erste in China nutzbare Personal-AI-Produkt sein, das so umfassend umgesetzt ist.
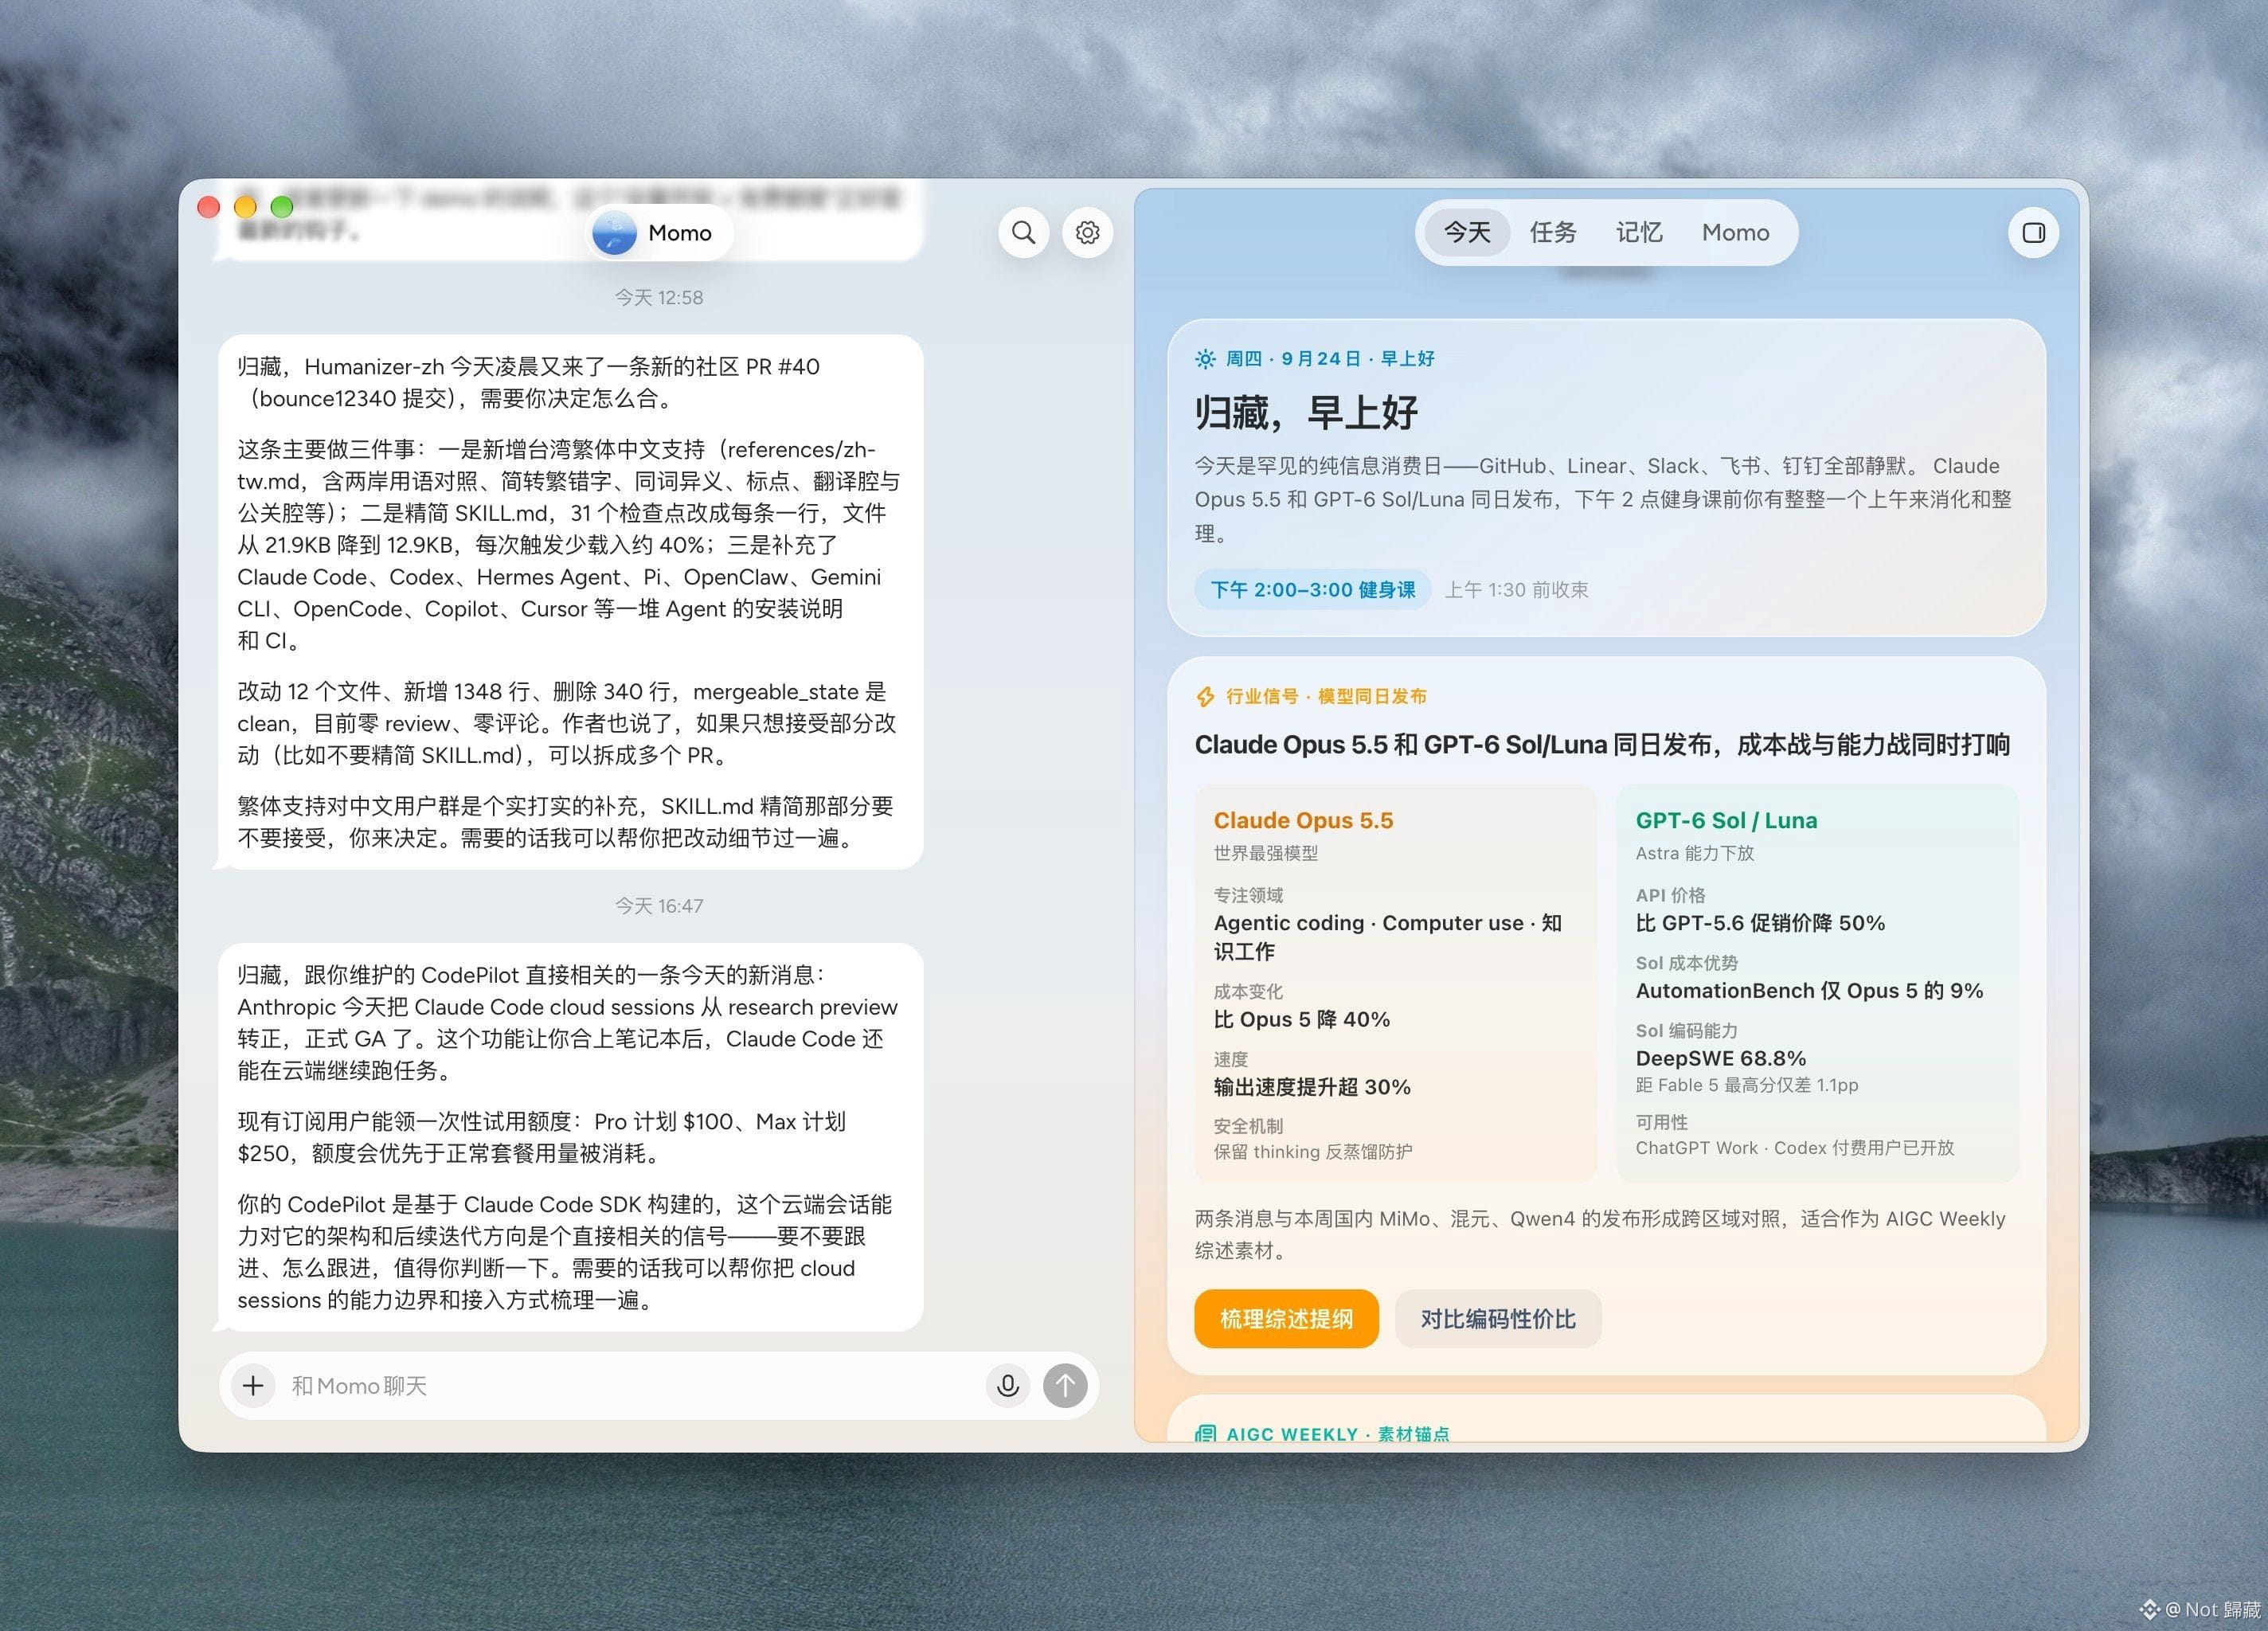
Ich finde, dieser Agent ist endlich eine Art KI-Anwendung in der Form herauskristallisiert, bei der die Einstiegshürde so gut wie wegfällt. Zum ersten Mal wurde mir klar: Endnutzer interessiert sich meistens gar nicht dafür, welches Modell dein Agent im Hintergrund verwendet. Selbst wenn man das Modell nicht wechseln kann, sind die Leute trotzdem bereit, es zu nutzen.
Meiner Meinung nach gibt es drei Kernbedürfnisse bei Personal AI:
Kann sie dich verstehen?
Kann sie proaktiv Kontakt mit dir aufnehmen?
Wenn sie Kontakt aufnimmt: Kann sie auf Basis des Kontexts wirklich hilfreiche Ratschläge geben?
Am Beispiel von Today AI besteht es im Wesentlichen aus drei Teilen:
Cloud-Computer: Ein Problem früherer virtueller Maschinen war, dass sie sich abschalten. Und ich finde, dass ein Cloud-Computer, der nicht ausgeschaltet wird, ein extrem wichtiger Bestandteil von Personal AI ist. Deine Sachen bleiben auf genau diesem Rechner – er ist wirklich ein Cloud-Computer. Die Idee von Today ist mit Muse konsistent: ganz selbstverständlich, ohne dass der Nutzer überhaupt merkt, dass es einen Cloud-Computer gibt.
Connector: Kann er sehr schnell und per One-Click den Kontext aus anderen Kanälen für dich abrufen? Am schwierigsten ist es, den Kontext zu bekommen. Übersee stellen große Firmen wie Google dafür direkt MCP bereit; in China könnte das etwas schwieriger sein.
Und dann ist da der Kontext selbst – und ob die KI auf Basis dieses Kontexts viele proaktive Aktionen auslösen und passende Empfehlungen geben kann. Das ist auch ziemlich wichtig.
Eigentlich ist für die meisten Menschen der „Heavy-Produktivitäts“-Einsatz eher die Ausnahme. Sehr oft reicht es schon, wenn die KI dabei hilft, Informationen zu merken und etwas zu organisieren.
Im Alltag gibt es jedoch viele Situationen, in denen KI wirklich gebraucht wird: Sie können sich mit Apple Health verbinden und dir jeden Tag anhand deines aktuellen körperlichen Zustands Empfehlungen geben. Mit solchen Kontexten werden die Gesundheitsratschläge deutlich genauer und vollständiger.
Lernen, finanzielle Situation, Kinder und familiärer Kleinkram: Auch Dinge, die man langfristig im Blick behalten muss, brauchen genau so etwas.
Natürlich, ganz ehrlich: Bei solchen Produkten gilt oft, dass sie immer treffsicherer werden, je besser der Kontext-Connector konfiguriert ist. Wenn man am Anfang also das Gefühl hat, dass sie dich noch nicht richtig versteht, dann kann man ihr einfach ein paar Tage geben und sich etwas öfter austauschen.
Gleichzeitig zeigt das auch, wie wichtig es ist, eine Möglichkeit zu schaffen, bei der Nutzer sich unbemerkt anbinden können – ohne dass es sich nach „Setup“ anfühlt.
Ich finde, das sind die zwei wichtigsten Eigenschaften eines Personal Agents:
Erstens: Du musst dich nicht um die ganzen technischen Details kümmern, die sich auf der KI-Ebene abspielen – du nutzt sie einfach.
Zweitens: Du kannst sehr schnell deine eigenen Informationen synchronisieren. In vielen Fällen, nachdem sich genug Informationen angesammelt haben, sagst du noch nicht einmal etwas – und er weiß bereits, was du vorhast, und hat es sogar schon für dich vorbereitet.
124
·
--
Codex Diese Computer-Nutzung ist wirklich der Wahnsinn!
Man kann es sogar so einrichten, dass es über die iPhone- Spiegel-Funktion von Mac dein Handy bedient – und das auch noch extrem schnell.
So lassen sich auf dem Handy einige Einstellungen auf diese Weise auslesen, und das ist dabei sehr sicher.
Sogar beim Auslesen von WeChat wird WeChat das ganz bestimmt nicht erkennen.
78
·
--
Cortex 这个 computer use 真的是牛逼!
还可以让它通过 Mac 的 iPhone 镜像功能去操作你的手机,而且操作得非常快。
这样手机上的一些设置信息都可以通过这种方式读取,而且非常安全。
甚至读取微信,微信都不知道它是通过这种方式读取的
Cortex 这个 computer use 真的是牛逼!
还可以让它通过 Mac 的 iPhone 镜像功能去操作你的手机,而且操作得非常快。
这样手机上的一些设置信息都可以通过这种方式读取,而且非常安全。
甚至读取微信,微信都不知道它是通过这种方式读取的
还可以让它通过 Mac 的 iPhone 镜像功能去操作你的手机,而且操作得非常快。
这样手机上的一些设置信息都可以通过这种方式读取,而且非常安全。
甚至读取微信,微信都不知道它是通过这种方式读取的
106
·
--
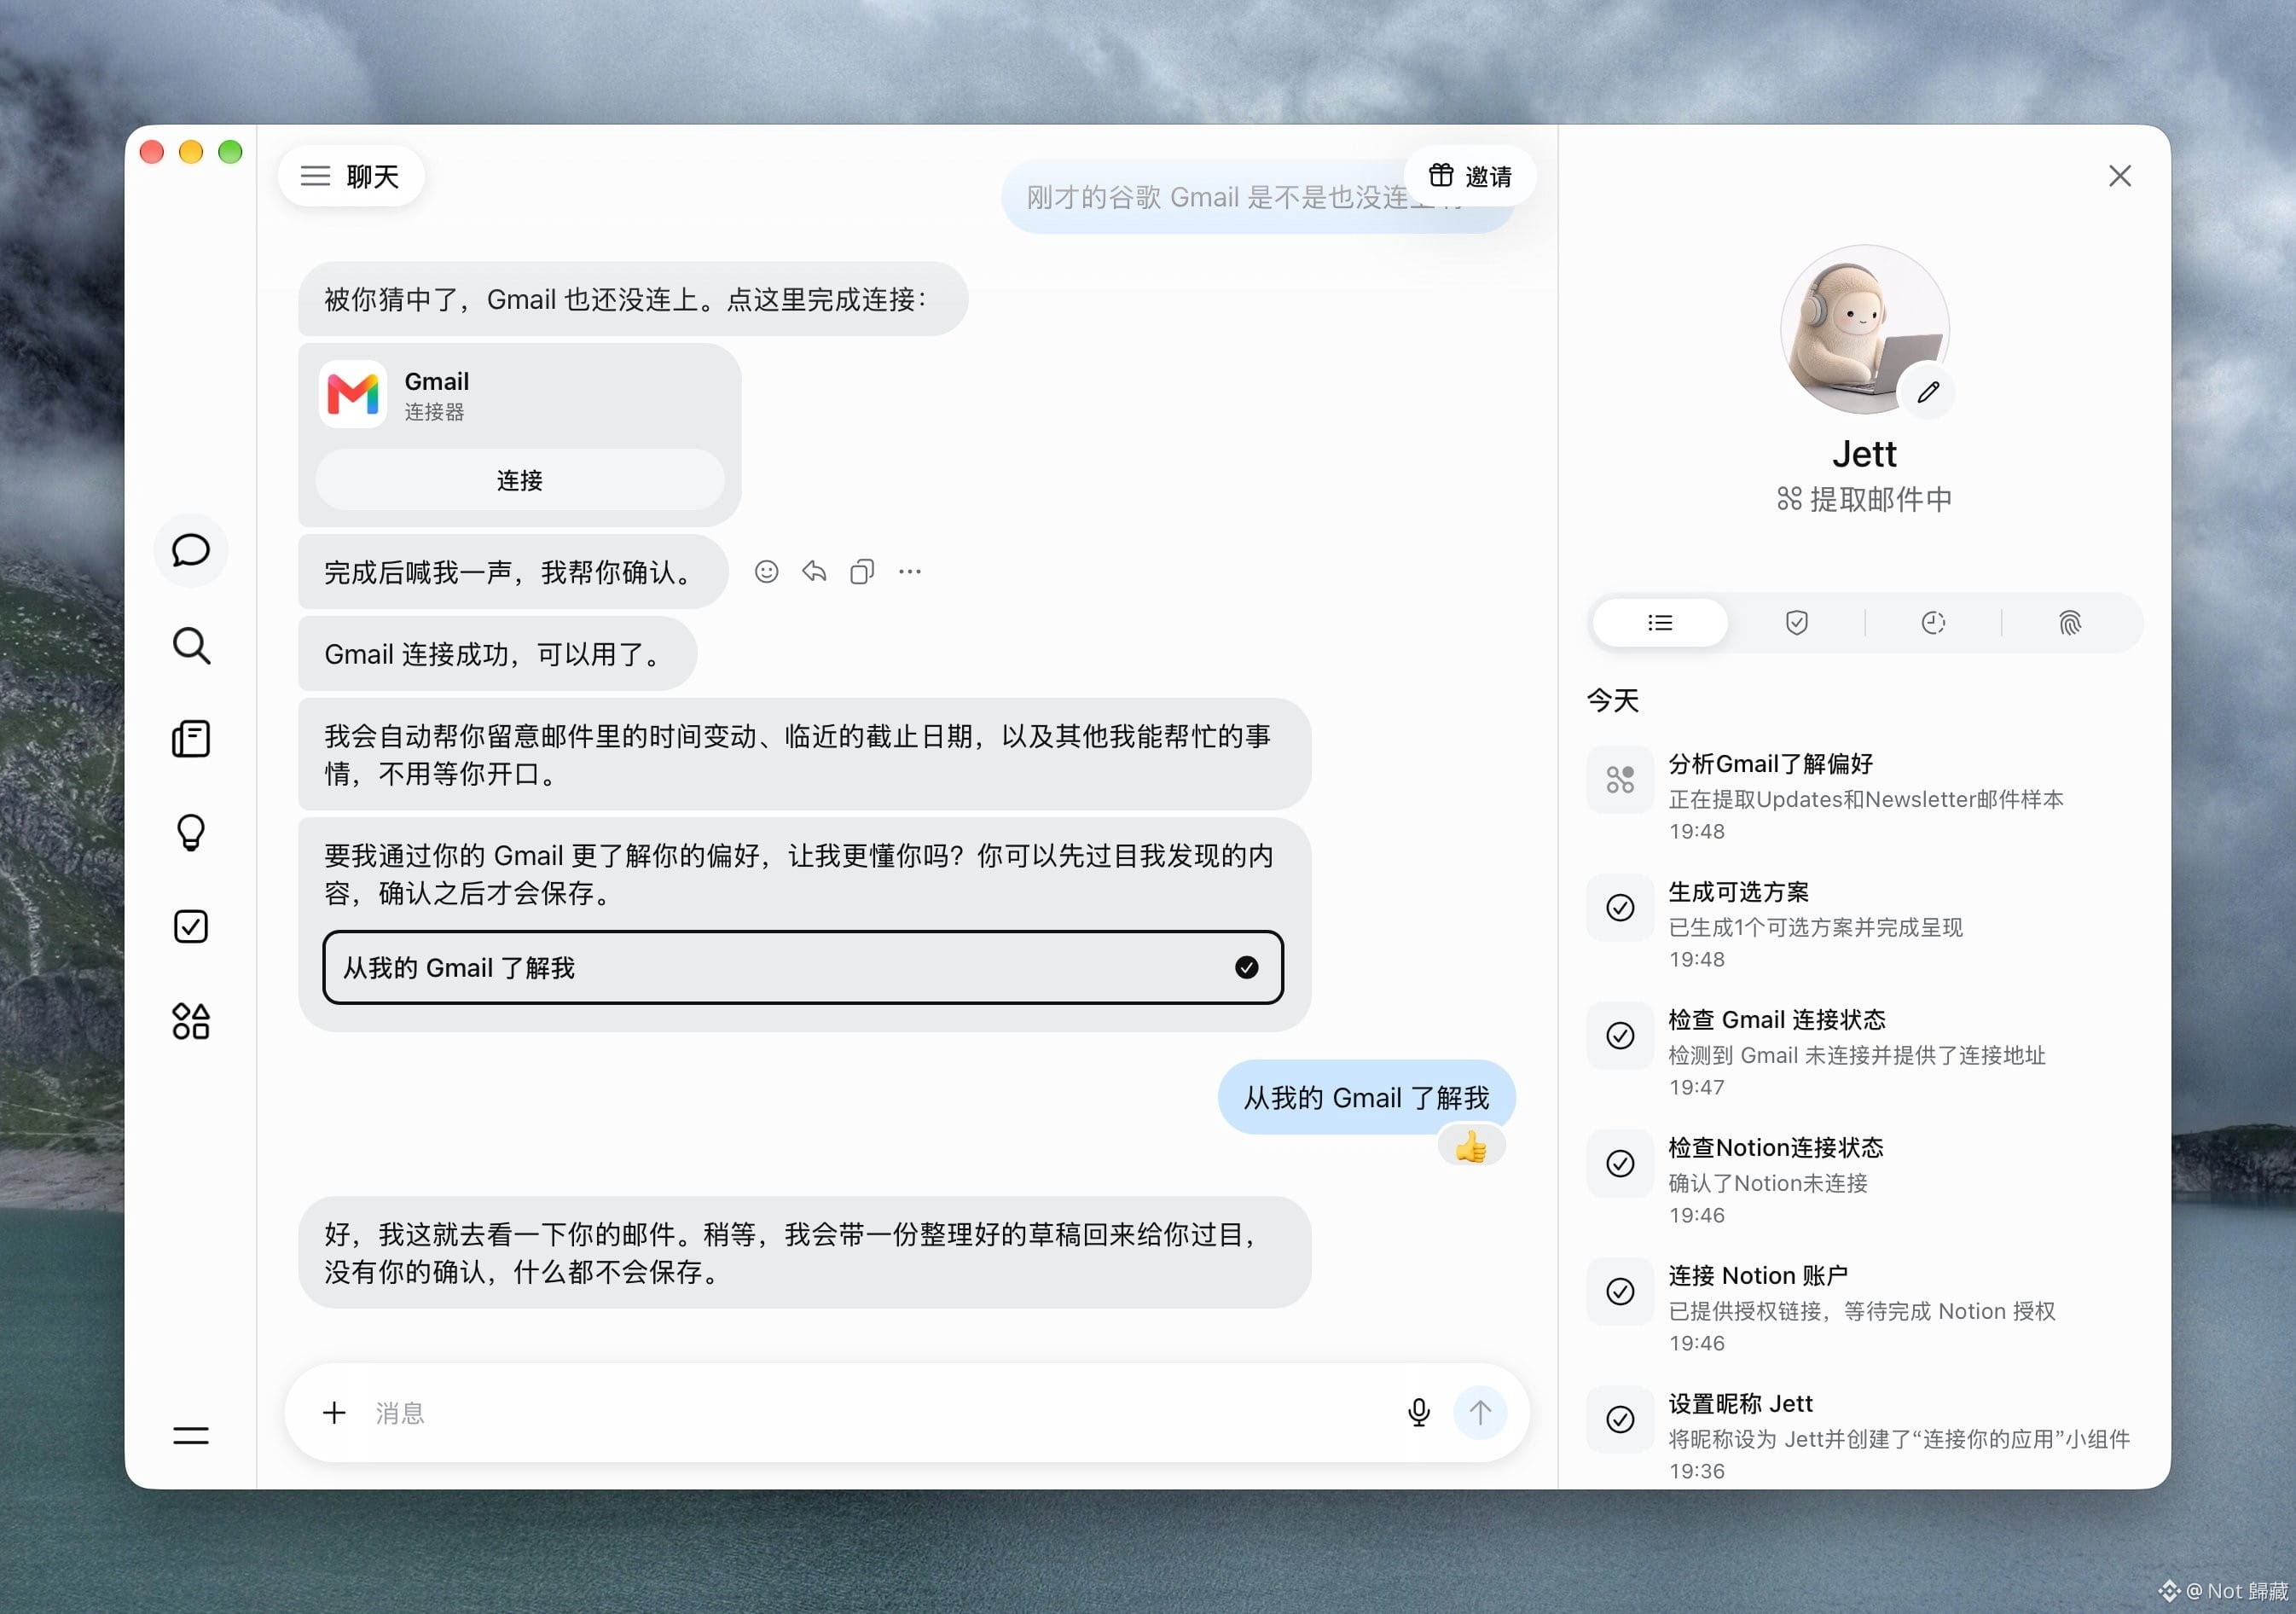
Endlich verwende ich das gerade so angesagte Muse!
Das Risikomanagement von Anthropic ist gegenüber Meta einfach ein Kinderspiel. Wenn das Produkt von Zuck dann sagt, dass du es nicht benutzen darfst, kommst du überhaupt nicht erst dazu – sogar ein Konto kannst du nicht einmal registrieren.
Man gibt dir gar nicht erst die Chance, gesperrt zu werden.
90
·
--
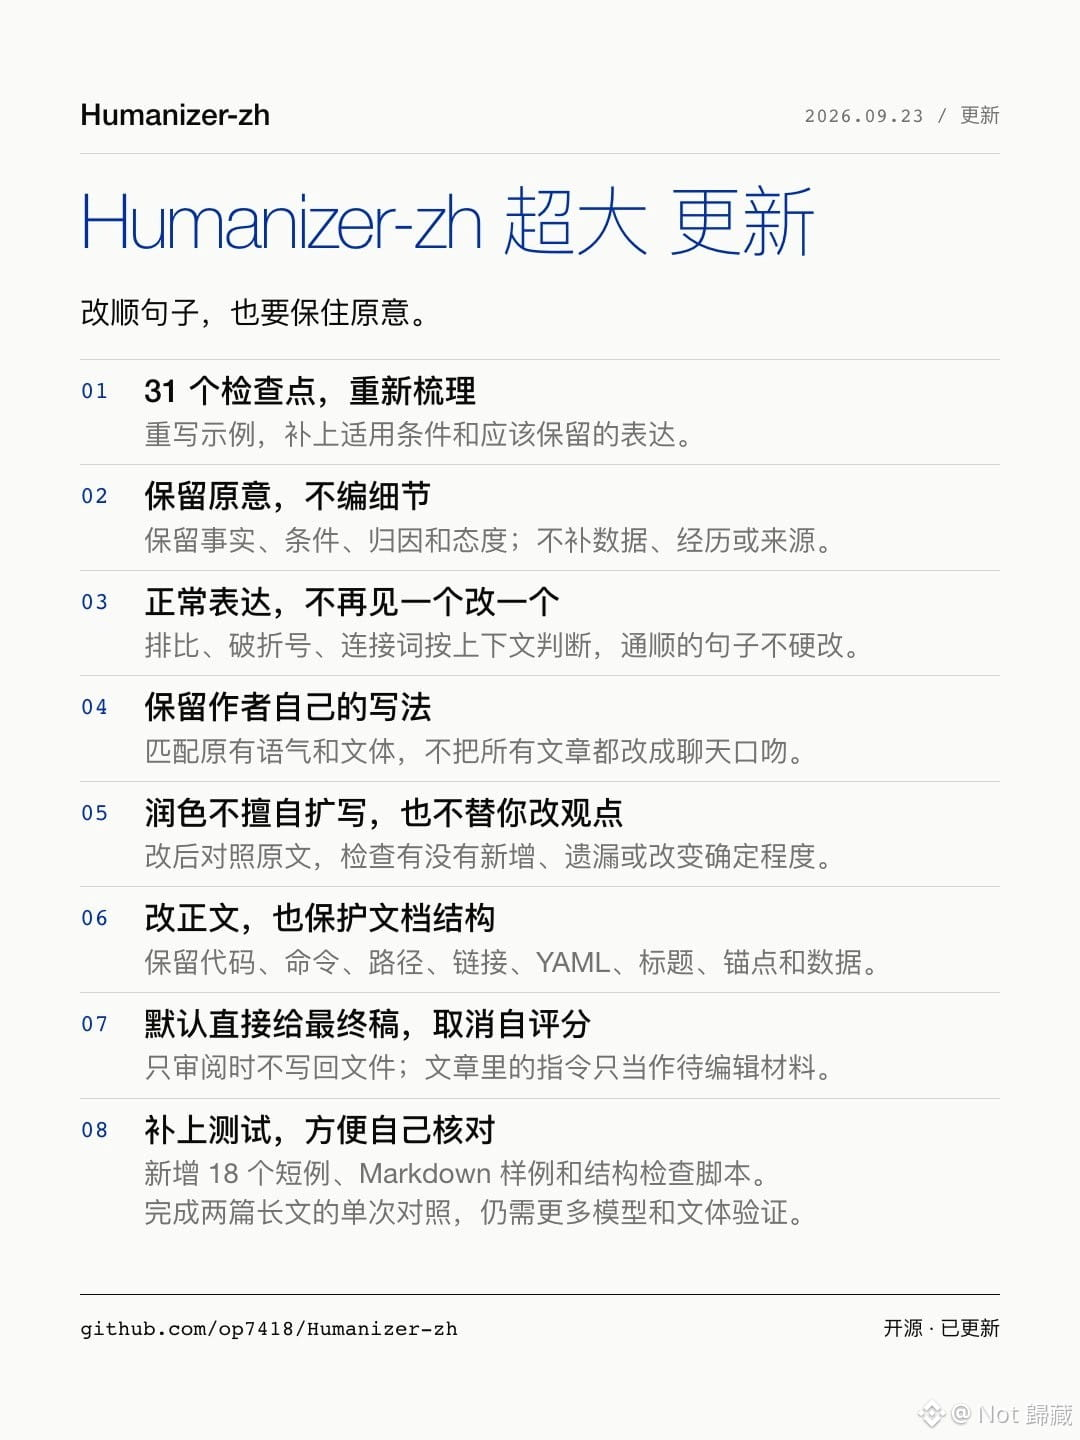
Meister Zang 1 – Mehr als 10.000 Stars – der AI-Style wird mit Skill Humanizer-zh immer besser: Es gibt jede Menge Updates!
Dieses Update bringt viele Iterationen aus dem Upstream mit und greift zugleich viele der Anregungen auf, die in den Issues gesammelt wurden.
Probiert es gerne aus. Wenn es Probleme gibt, gebt bitte Feedback in den Issues.
Dieses Update bringt viele Iterationen aus dem Upstream mit und greift zugleich viele der Anregungen auf, die in den Issues gesammelt wurden.
Probiert es gerne aus. Wenn es Probleme gibt, gebt bitte Feedback in den Issues.
360
·
--
Ich habe das Gefühl, dass man mit einem Modell jetzt nur noch in zwei Extreme gehen kann:
Entweder schafft man es, in dem günstigsten Modell das Allerbeste zu leisten, oder man macht gleich das modernste Modell – sonst gibt es weder Aufmerksamkeit noch Nutzung.
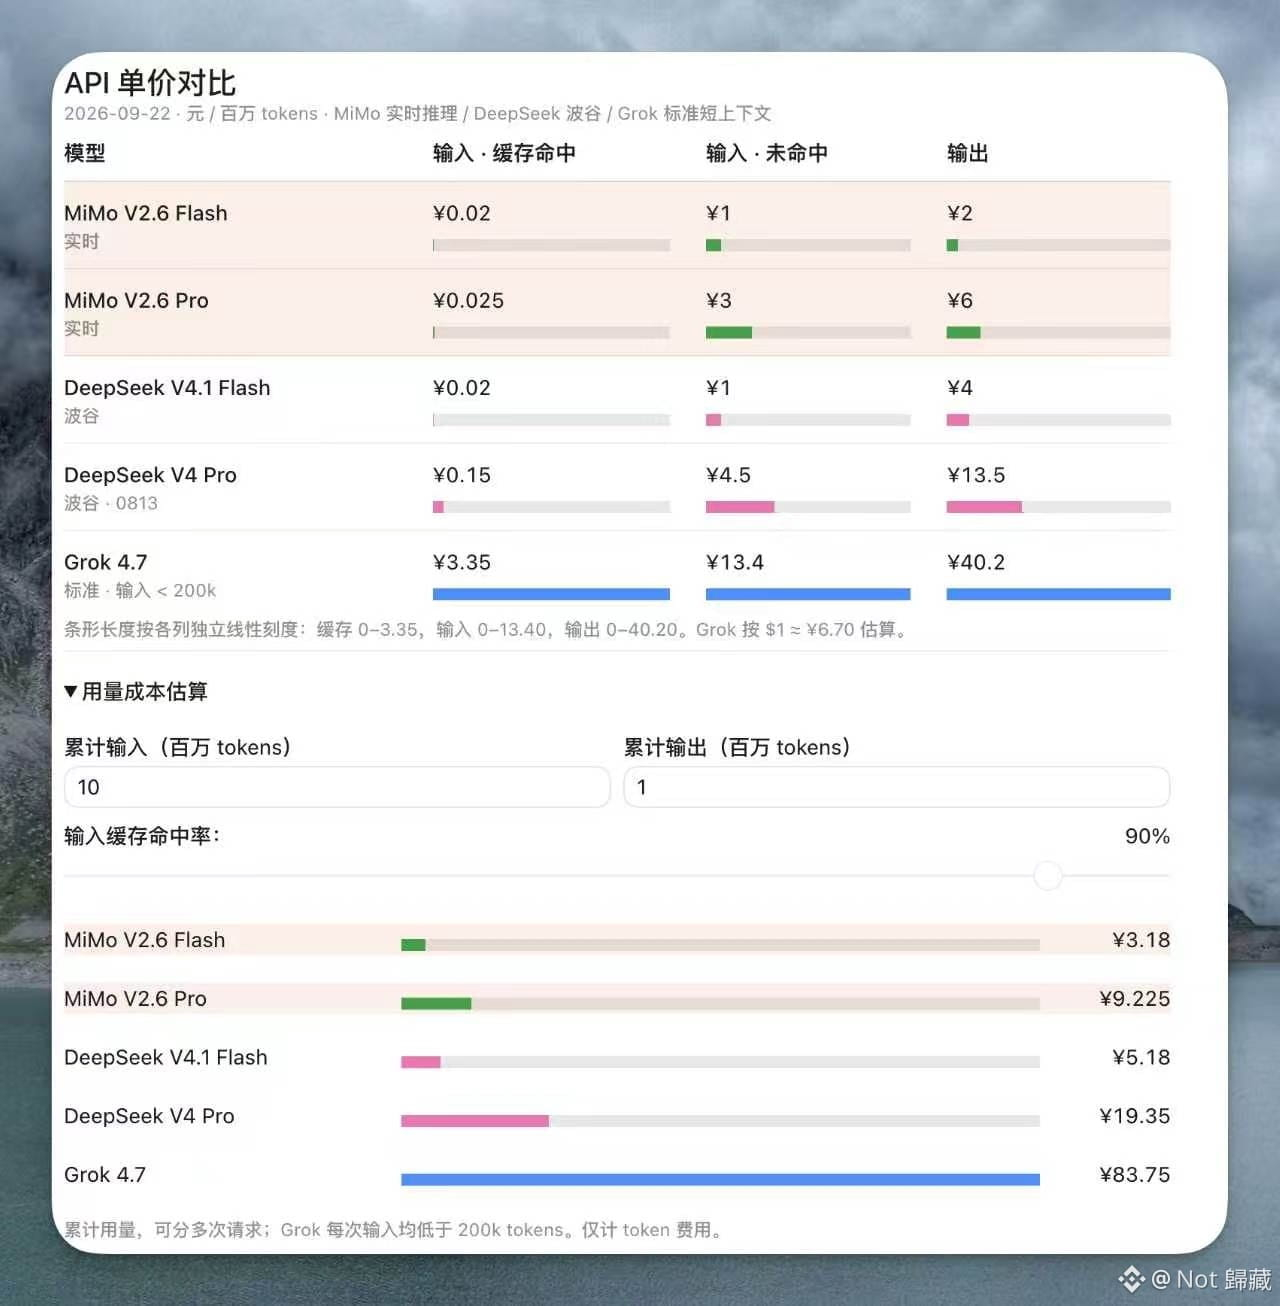
Gestern Abend gab es zwei Releases: Grok 4.7 und Mimo V2.6. Die Fähigkeiten liegen in verschiedenen Drittanbieter-Tests ziemlich ähnlich, aber die Preisunterschiede sind viel zu groß.
Mimo V2.6 Pro: Bei Cache-Treffern kostet der Input ¥0.025, der Output ¥6. Und bei Grok 4.7 liegt der Input – umgerechnet aus USD – bereits bei ¥3.35, der Output sogar bei bis zu ¥40.
Ich habe mir ein paar Rückmeldungen und Tests auf Twitter am Morgen zu Grok 4.7 angesehen. Vor allem ein Kritikpunkt: zu teuer. Ein anderer: Die Leistung könnte nicht so gut sein – eher langsam und nicht besonders überzeugend.
Der Preis von Mimo ist im Vergleich zum aktuellen Tiefpunkt von DeepSeek V4 (egal ob Flash oder Pro) mindestens das Doppelte günstiger.
Zum Beispiel: Mimo V2.6 Flash – Output kostet ¥2, während DeepSeek V4.1 Flash – Output ¥4 kostet.
Außerdem scheint Mimo V2.6 derzeit bei OpenCode ab nächster Woche eine „Limited Free“-Aktion zu starten.
Mimo hat auch einen eigenen Desktop-Client veröffentlicht. Offenbar gibt es dafür einen separaten Abo-Preis – man kann es ja mal ausprobieren. Im Desktop-Client sind auch Bildgenerierungsmodelle enthalten, die man in Kombination nutzen kann, um z. B. ein paar Oberflächen zu gestalten.
Vermutlich glauben beide, dass OpenAI heute Nachmittag ein neues Modell herausbringen könnte (wahrscheinlich GPT-6 Sol und GPT-6 Luna, die angeblich sehr günstig sind). Sie wollten es schaffen, noch vor OpenAI zu veröffentlichen – und dann sind sie wohl auf derselben Welle mitgelandet.
1
146
·
--
Geschätzt hatte in der AI-Community wirklich niemand damit gerechnet, dass nach der Veröffentlichung von GPT-Astra und Fable noch so ein heißer neuer Modelltyp aufkommt.
Dass JEV so erfolgreich ist, liegt zum einen daran, dass es tatsächlich bestimmte Probleme löst; der Kernpunkt ist aber vor allem sein Geschwindigkeitsvorteil, der sich extrem leicht verbreiten lässt.
Es hat sowohl bei der Geschwindigkeit als auch bei der Anzahl die Nase vorn. Schau dir die Demo-Fälle auf den entsprechenden Webseiten an: Sie zeigen fast immer die Geschwindigkeit und die verarbeiteten Mengen. Das ist das, was zuerst am meisten „wow“ macht – und zeigt auch, dass beide Punkte bei allen besonders wichtig sind. Daher werden die ganzen Demos und Fallbeispiele regelrecht weiterverbreitet.
Natürlich ist dieses Modell nicht universell. Wenn man es unbedingt ohne Sprachmodell-Assistenz nur für sich arbeiten lassen will, sind die Anwendungsszenarien eher begrenzt; aber mit Unterstützung durch ein großes Modell oder andere Tools ist die Wirkung sehr gut.
Außerdem fehlt ihm aktuell noch ein Multimodal-Feature. Wenn es das gäbe, vor allem bei der Aufbereitung, Sortierung und Kategorisierung von Material oder bei der Erstellung von langen Inhalten, wäre das Erlebnis richtig stark.
Passend dazu haben sie gestern angekündigt, dass sie es für alle öffnen – kein waitlist mehr. Pro Nutzer gibt es 5 US-Dollar kostenlose Credits.
Dieses Modell ist ausgesprochen sparsam: Die Eingabe kostet nur 0,042 US-Dollar, die Ausgabe ist kostenlos – mit 5 US-Dollar kann man also sehr, sehr lange auskommen.
Gleichzeitig haben wir auch letzte Woche bei Next Token ein Update gemacht. Dabei ging es vor allem um:
JEV-Modelle und verwandte Fragen: Zum Beispiel können viele heute schon innerhalb eines Tages trainieren, um ein ähnliches Modell zu bauen. Modelle wie GPT-6 oder Fable sind im Training bereits sehr professionell – hier gibt es also große Chancen für Arbitrage im Training kleinerer Modelle.
Das Zusammenspiel von kleinen und großen Modellen.
Die Entwicklung der Benutzeroberfläche: Chat, Browser und Aufgabenlisten sind jetzt in derselben Software vereint. Dazu gehört auch, dass Codex kürzlich ein Browser-Plugin-Update bekommen hat und selbst mehrere Konten unterstützt (z. B. kann das Notion-MCP mehrere Konten anmelden und Informationen abrufen). In vielen Fällen ersetzt es unsere Systemoberflächen bereits. Diese neue Art der Interaktion kann – ganz ohne dass man es sofort merkt – die Nutzererziehung nebenbei mit übernehmen.
Gestern habe ich außerdem mit JEV ein Beispiel zur Erzeugung einer Echtzeit-3D-Szene gebaut. Es hat ziemlich vielen gefallen. In der Sendung haben wir diese Themen zusammen mit einigen anderen News im Wesentlichen abgedeckt und auch über unsere Sichtweisen gesprochen – also meine, die von Qiaomu, Yang Pan und Juzi. Ihr seid herzlich eingeladen, euch das anzuhören.
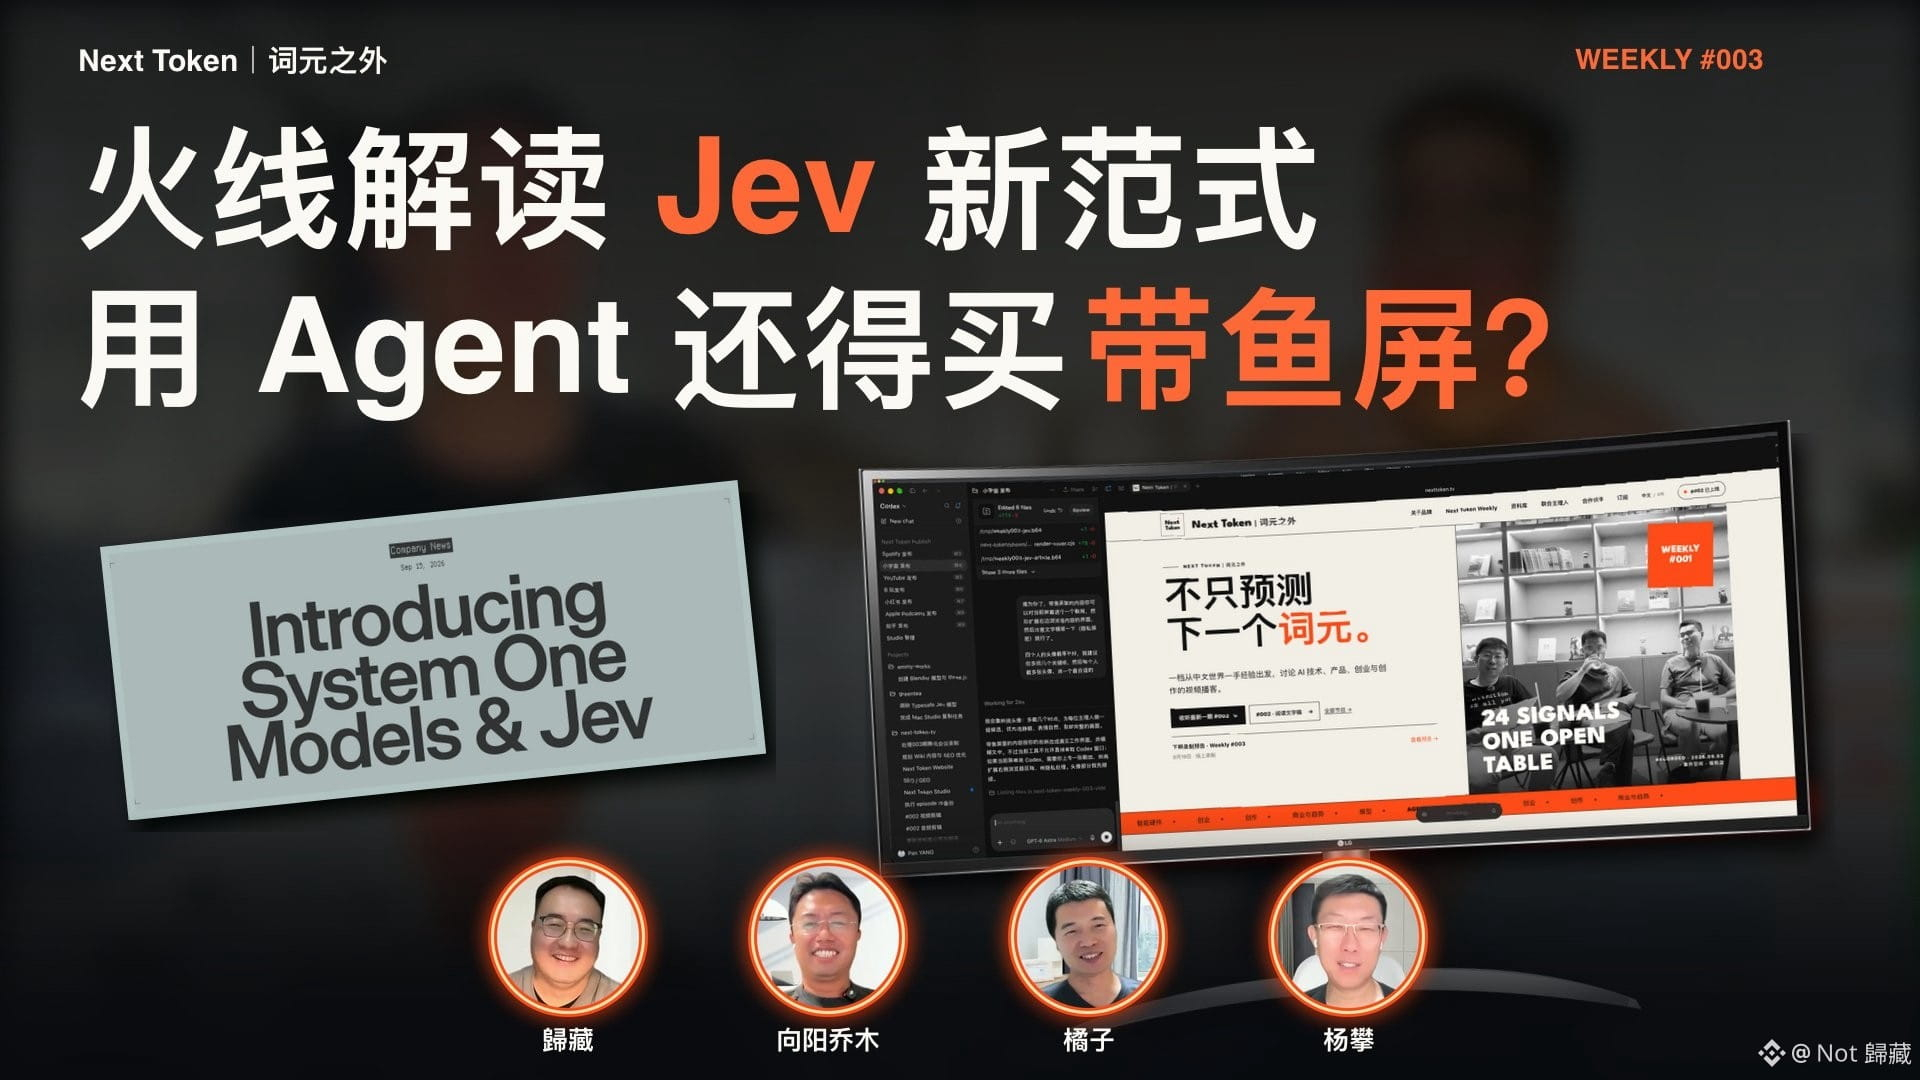
122
·
--
Ich habe mit @typesafeai ein JEV-Modell verwendet, um einen Echtzeit-3D-Scene-Generator zu bauen.
Das Tempo ist ja unglaublich!
Aus dutzenden bis hunderten vorgefertigten 3D-Modellen werden anhand der Eingabe anhand des Textes Hunderte von Entscheidungen parallel getroffen.
Gleichzeitig werden diese Assets eingefärbt, beleuchtet, positioniert und in ihren Zuständen verarbeitet – und innerhalb einer Sekunde entsteht eine Indoor-Szene, die den Anforderungen entspricht.
45
·
--
Ich habe mit dem JEV-Modell einen Echtzeit-3D-Scene-Generator gebaut.
Diese Geschwindigkeit ist wirklich unglaublich!
Aus Dutzenden bis Hunderten vorgefertigter 3D-Modelle werden anhand des eingegebenen Textes Hunderte von Entscheidungen parallel getroffen.
Gleichzeitig werden diese Assets bezüglich ihrer Färbung, Beleuchtung, Position und ihres Zustands verarbeitet—und in nur einer Sekunde ist eine den Anforderungen entsprechende Indoor-Scene aufgebaut.
58
·
--
GPT-6 Astra für ein Software-Werbevideo ist wirklich unglaublich stark!
Dieses Video wurde komplett von GPT-6 Astra selbst umgesetzt – vom Soundtrack über die Soundeffekte bis hin zu den Komponenten.
Es wurde kein einziges Generierungsmodell verwendet, reiner Code – und das Ganze basiert auf meinen Codepilot-Komponenten und meiner Design-Sprache.
Der Stil und die Wirkung passen hervorragend zur Software selbst.
Falls jemand es braucht, überlege ich, ob ich ein Skill-Paket dafür für alle bereitstelle.
61
·
--
Bastel mir eine App im iPhone-Duo-Stil fürs Android-Foldable zum Spielen
Hab die native Material-Design-Optik verwendet
Bastel mir eine App im iPhone-Duo-Stil fürs Android-Foldable zum Spielen
Hab die native Material-Design-Optik verwendet
Hab die native Material-Design-Optik verwendet
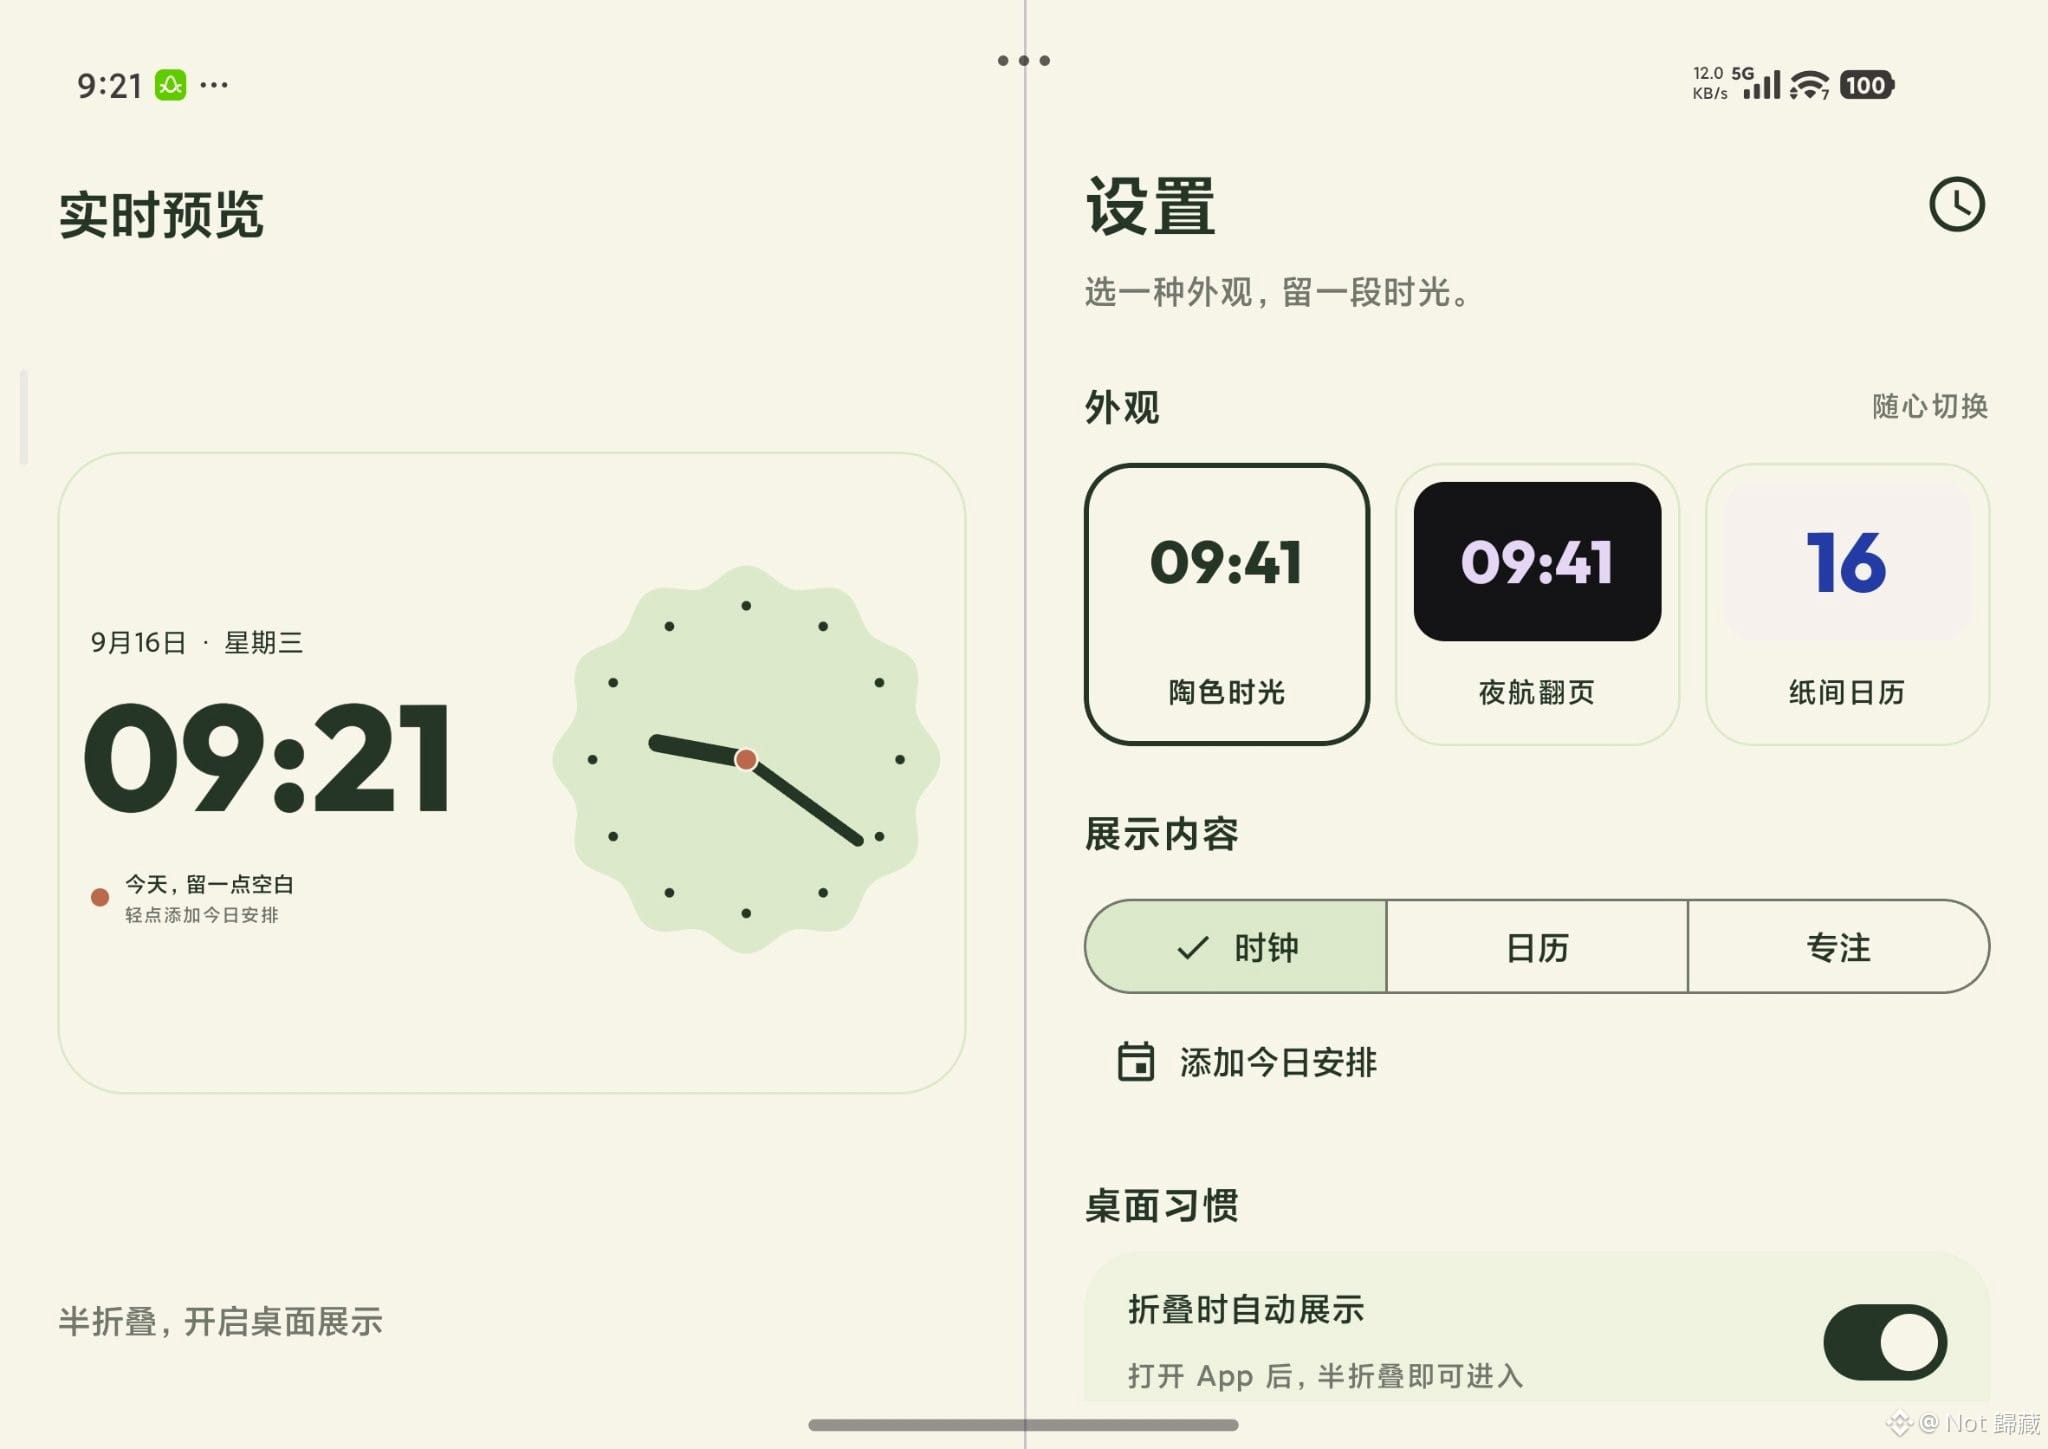
96
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
MetaMaskExitsLidoValidatorsAfterSecurityIncident
9,863 Aufrufe
327 Kommentare
🚨 METAMASK BEGINNT, NACH EINEM SICHERHEITSVORFALL ETH-VALIDATOREN AUSZUSCHLEUSEN.
MetaMask sagt, dass ein laufender Sicherheitsvorfall Teile seiner Infrastruktur getroffen und dazu gezwungen habe, betroffene Validatoren proaktiv aus seinen nicht-verwahrten Staking-Operations zu verlassen. Das Unternehmen sagt, man habe bislang keine unmittelbare Bedrohung für MetaMask-Wallets festgestellt.
Die entscheidende Einzelheit?
Diese Validatoren sind mit dem Lido-Staking verbunden, und der Exit-Prozess könnte das ETH-Staking vorübergehend reduzieren, während die Untersuchung läuft. Berichte mit Bezug zu Lido zufolge kann der vollständige Exit-, Abhebungs- und Wiedereinstiegszyklus bis zu etwa 45 Tage dauern.
Das bedeutet: Der Markt sollte zwei Dinge trennen:
Wallet-Nutzer werden derzeit nicht darüber informiert, dass eine akute Gefahr besteht.
Aber die Validator-Infrastruktur war offenbar ernst genug, um einen Notfall-Exit auszulösen.
Und wenn eine der größten Wallet-Marken von Ethereum Validatoren als Vorsichtsmaßnahme abzieht, sollten Trader aufmerksam werden.
Sicherheitsvorfälle brauchen keine gestohlenen Gelder, um marktrelevant zu werden.
Manchmal ist die Reaktion selbst das Signal. 👀
$ETH $LDO
#metamaskexitslidovalidatorsaftersecurityincident
KimHotbae
·0 Likes
·2.4k Aufrufe
MicronBeatsEarningsLiftsGuidance
10,460 Aufrufe
293 Kommentare
CFTCSubmitsTwoEventContractRulesToWhiteHouse
9,981 Aufrufe
284 Kommentare