
#depin
depin
3.7M Aufrufe
13,164 Kommentare
Hot
Zuletzt
·
--
Bullisch
$GLM DePIN und KI-Berechnungen: Was ist auf dem höheren Timeframe bei $GLM zu sehen?
Während der lokale Feed voller Rauschen rund um Mikro-Schwingungen ist, zeigen die höheren Charts ein ganz anderes Bild.
Fakten aus dem höheren Timeframe:
Globale Basis: Die Münze handelt im Bereich von $0.1160, direkt am Block des historischen Tiefs ($0.0850–$0.1000).
Test der wichtigen Durchschnitte: Der Kurs kam bis auf 1D EMA 21 ($0.1160) heran und zieht sich allmählich zusammen, bevor er auf 1D EMA 50 ($0.1520) trifft.
Neutraler RSI: Im Wochenintervall hat der Oszillator die gesamte Überhitzung der vorherigen Impulse abgebaut und eine Plattform für eine neue langfristige Akkumulation geschaffen.
Volatilitätskompression: Nach dem Rückgang von lokalen Hochs ist das Angebot am Markt komprimiert, und die Volumina sind auf Minimums gefallen.
Echte Bewegungen bei Alts mit starkem Fundament (DePIN/AI-Sektor) werden nicht an einem Tag vorbereitet. Akkumulation am Boden ist immer ein stiller und zäher Prozess.
Wie denkt ihr: Sehen wir diesen Herbst einen Ausbruch aus dieser Basis, oder wird sich die Akkumulation in die Länge ziehen? 👇
#GLMUSDT #DePIN #BinanceSquareTalks #CryptoAnalysis #Trading #AI
$GLM DePIN und KI-Berechnungen: Was ist auf dem höheren Timeframe bei $GLM zu sehen?
Während der lokale Feed voller Rauschen rund um Mikro-Schwingungen ist, zeigen die höheren Charts ein ganz anderes Bild.
Fakten aus dem höheren Timeframe:
Globale Basis: Die Münze handelt im Bereich von $0.1160, direkt am Block des historischen Tiefs ($0.0850–$0.1000).
Test der wichtigen Durchschnitte: Der Kurs kam bis auf 1D EMA 21 ($0.1160) heran und zieht sich allmählich zusammen, bevor er auf 1D EMA 50 ($0.1520) trifft.
Neutraler RSI: Im Wochenintervall hat der Oszillator die gesamte Überhitzung der vorherigen Impulse abgebaut und eine Plattform für eine neue langfristige Akkumulation geschaffen.
Volatilitätskompression: Nach dem Rückgang von lokalen Hochs ist das Angebot am Markt komprimiert, und die Volumina sind auf Minimums gefallen.
Echte Bewegungen bei Alts mit starkem Fundament (DePIN/AI-Sektor) werden nicht an einem Tag vorbereitet. Akkumulation am Boden ist immer ein stiller und zäher Prozess.
Wie denkt ihr: Sehen wir diesen Herbst einen Ausbruch aus dieser Basis, oder wird sich die Akkumulation in die Länge ziehen? 👇
#GLMUSDT #DePIN #BinanceSquareTalks #CryptoAnalysis #Trading #AI
Während der lokale Feed voller Rauschen rund um Mikro-Schwingungen ist, zeigen die höheren Charts ein ganz anderes Bild.
Fakten aus dem höheren Timeframe:
Globale Basis: Die Münze handelt im Bereich von $0.1160, direkt am Block des historischen Tiefs ($0.0850–$0.1000).
Test der wichtigen Durchschnitte: Der Kurs kam bis auf 1D EMA 21 ($0.1160) heran und zieht sich allmählich zusammen, bevor er auf 1D EMA 50 ($0.1520) trifft.
Neutraler RSI: Im Wochenintervall hat der Oszillator die gesamte Überhitzung der vorherigen Impulse abgebaut und eine Plattform für eine neue langfristige Akkumulation geschaffen.
Volatilitätskompression: Nach dem Rückgang von lokalen Hochs ist das Angebot am Markt komprimiert, und die Volumina sind auf Minimums gefallen.
Echte Bewegungen bei Alts mit starkem Fundament (DePIN/AI-Sektor) werden nicht an einem Tag vorbereitet. Akkumulation am Boden ist immer ein stiller und zäher Prozess.
Wie denkt ihr: Sehen wir diesen Herbst einen Ausbruch aus dieser Basis, oder wird sich die Akkumulation in die Länge ziehen? 👇
#GLMUSDT #DePIN #BinanceSquareTalks #CryptoAnalysis #Trading #AI
1
125
·
--
Der Kryptomarkt entwickelt sich ständig weiter, und kluge Anleger haben immer ein Auge auf Projekte, die dezentrale Finanzen (DeFi) mit echtem Nutzen aus der realen Welt verankern. Eines dieser Projekte baut seine Grundlage im Stillen: Standard Protocol, dargestellt durch das Ticker-Symbol STND. Lassen Sie uns eintauchen, was dieses Projekt in der aktuellen Marktlandschaft besonders macht.
Standard Protocol positioniert sich an der Schnittstelle zwischen Decentralized Physical Infrastructure Networks (DePIN) und Web3-Datenstandards. Ursprünglich bekannt für seinen innovativen Ansatz bei besicherten Stablecoins und Rebase-Mechanismen, hat das Projekt seine Vision erweitert. Es verfolgt nun das Ziel, eine große Engstelle in Web3 zu lösen: das Fehlen standardisierter, zuverlässiger Daten- und Liquiditätsinfrastruktur über Multi-Chain-Ökosysteme hinweg.
Warum gewinnt STND gerade jetzt an Zugkraft? Die Antwort liegt in einem massiven Narrativwechsel hin zu DePIN und Real-World Assets (RWA). Anleger wenden sich von reiner Spekulation ab und fordern Projekte mit greifbarem Nutzen. Standard Protocol liefert den Rahmen, damit dezentrale Anwendungen Datensätze für Assets sichern, teilen und bewerten können. Dadurch ermöglicht es reibungslosere Cross-Chain-Operationen und reduziert die Fragmentierung, die DeFi oft plagt.
Aus Marktsicht steht STND für ein Asset mit niedrigerer Marktkapitalisierung, aber mit hohem asymmetrischem Upside-Potenzial – insbesondere dann, wenn der breitere Markt nach unterbewerteten Infrastruktur-Playbooks sucht. Die Integration mit großen Ökosystemen wie Polkadot und Ethereum gibt ihm zudem eine solide technische Grundlage. Zusätzlich stellt der Fokus auf gemeinschaftsgetriebene Governance sicher, dass sich das Netzwerk direkt an den Bedürfnissen der Nutzer ausrichtet.
Wenn wir in eine stark selektive Marktphase hineinsteuern, lohnen sich Infrastrukturprotokolle wie Standard auf jeden Fall für Ihre Watchlist. Sie mögen keine täglichen Schlagzeilen wie Meme-Coins machen, aber sie bauen die Autobahnen, auf denen die nächste Bull-Run-Fahrt stattfinden wird.
Was denken Sie über STND? Ist DePIN das dominante Narrativ dieses Zyklus? Teilen Sie uns Ihre Meinung in den Kommentaren unten mit.
#STND #DePIN #CryptoAnalysis
Der Kryptomarkt entwickelt sich ständig weiter, und kluge Anleger haben immer ein Auge auf Projekte, die dezentrale Finanzen (DeFi) mit echtem Nutzen aus der realen Welt verankern. Eines dieser Projekte baut seine Grundlage im Stillen: Standard Protocol, dargestellt durch das Ticker-Symbol STND. Lassen Sie uns eintauchen, was dieses Projekt in der aktuellen Marktlandschaft besonders macht.
Standard Protocol positioniert sich an der Schnittstelle zwischen Decentralized Physical Infrastructure Networks (DePIN) und Web3-Datenstandards. Ursprünglich bekannt für seinen innovativen Ansatz bei besicherten Stablecoins und Rebase-Mechanismen, hat das Projekt seine Vision erweitert. Es verfolgt nun das Ziel, eine große Engstelle in Web3 zu lösen: das Fehlen standardisierter, zuverlässiger Daten- und Liquiditätsinfrastruktur über Multi-Chain-Ökosysteme hinweg.
Warum gewinnt STND gerade jetzt an Zugkraft? Die Antwort liegt in einem massiven Narrativwechsel hin zu DePIN und Real-World Assets (RWA). Anleger wenden sich von reiner Spekulation ab und fordern Projekte mit greifbarem Nutzen. Standard Protocol liefert den Rahmen, damit dezentrale Anwendungen Datensätze für Assets sichern, teilen und bewerten können. Dadurch ermöglicht es reibungslosere Cross-Chain-Operationen und reduziert die Fragmentierung, die DeFi oft plagt.
Aus Marktsicht steht STND für ein Asset mit niedrigerer Marktkapitalisierung, aber mit hohem asymmetrischem Upside-Potenzial – insbesondere dann, wenn der breitere Markt nach unterbewerteten Infrastruktur-Playbooks sucht. Die Integration mit großen Ökosystemen wie Polkadot und Ethereum gibt ihm zudem eine solide technische Grundlage. Zusätzlich stellt der Fokus auf gemeinschaftsgetriebene Governance sicher, dass sich das Netzwerk direkt an den Bedürfnissen der Nutzer ausrichtet.
Wenn wir in eine stark selektive Marktphase hineinsteuern, lohnen sich Infrastrukturprotokolle wie Standard auf jeden Fall für Ihre Watchlist. Sie mögen keine täglichen Schlagzeilen wie Meme-Coins machen, aber sie bauen die Autobahnen, auf denen die nächste Bull-Run-Fahrt stattfinden wird.
Was denken Sie über STND? Ist DePIN das dominante Narrativ dieses Zyklus? Teilen Sie uns Ihre Meinung in den Kommentaren unten mit.
#STND #DePIN #CryptoAnalysis
Standard Protocol positioniert sich an der Schnittstelle zwischen Decentralized Physical Infrastructure Networks (DePIN) und Web3-Datenstandards. Ursprünglich bekannt für seinen innovativen Ansatz bei besicherten Stablecoins und Rebase-Mechanismen, hat das Projekt seine Vision erweitert. Es verfolgt nun das Ziel, eine große Engstelle in Web3 zu lösen: das Fehlen standardisierter, zuverlässiger Daten- und Liquiditätsinfrastruktur über Multi-Chain-Ökosysteme hinweg.
Warum gewinnt STND gerade jetzt an Zugkraft? Die Antwort liegt in einem massiven Narrativwechsel hin zu DePIN und Real-World Assets (RWA). Anleger wenden sich von reiner Spekulation ab und fordern Projekte mit greifbarem Nutzen. Standard Protocol liefert den Rahmen, damit dezentrale Anwendungen Datensätze für Assets sichern, teilen und bewerten können. Dadurch ermöglicht es reibungslosere Cross-Chain-Operationen und reduziert die Fragmentierung, die DeFi oft plagt.
Aus Marktsicht steht STND für ein Asset mit niedrigerer Marktkapitalisierung, aber mit hohem asymmetrischem Upside-Potenzial – insbesondere dann, wenn der breitere Markt nach unterbewerteten Infrastruktur-Playbooks sucht. Die Integration mit großen Ökosystemen wie Polkadot und Ethereum gibt ihm zudem eine solide technische Grundlage. Zusätzlich stellt der Fokus auf gemeinschaftsgetriebene Governance sicher, dass sich das Netzwerk direkt an den Bedürfnissen der Nutzer ausrichtet.
Wenn wir in eine stark selektive Marktphase hineinsteuern, lohnen sich Infrastrukturprotokolle wie Standard auf jeden Fall für Ihre Watchlist. Sie mögen keine täglichen Schlagzeilen wie Meme-Coins machen, aber sie bauen die Autobahnen, auf denen die nächste Bull-Run-Fahrt stattfinden wird.
Was denken Sie über STND? Ist DePIN das dominante Narrativ dieses Zyklus? Teilen Sie uns Ihre Meinung in den Kommentaren unten mit.
#STND #DePIN #CryptoAnalysis
59
·
--
$GLM DePIN und KI-Computing: Warum der Markt die Knappheit $GLM ignoriert?
Während der Einzelhandel Memecoins jagt, reift in der dezentralen Infrastruktur (DePIN) ein grundlegender Wandel.
Fakten:
Mehr als 40% APR verdienen: Tageshohe Ausschläge der Renditen – ein Hinweis darauf, dass Market Maker katastrophal an Liquidität fehlen.
Nachfrage nach Rechenleistung: Vor dem Hintergrund des KI-Booms werden dezentrale GPU/CPU zu einer günstigen Alternative zu Cloud-Diensten.
Technik: Nach dem Impuls fällt der Preis nicht, sondern entlastet den RSI an den wichtigen EMAs (50/200).
Echte Bewegungen entstehen in der Stille, während die Orderbücher vor der zweiten Welle zusammengedrückt werden. Und wer Gewinne nach dem System realisiert, wartet gelassen auf die Auflösung mit Cash.
Meinung teilen: Ruhe vor dem Ruck oder eine Seitwärtsphase? 👇
#GLM #DePIN #BinanceSquare #Crypto
$GLM DePIN und KI-Computing: Warum der Markt die Knappheit $GLM ignoriert?
Während der Einzelhandel Memecoins jagt, reift in der dezentralen Infrastruktur (DePIN) ein grundlegender Wandel.
Fakten:
Mehr als 40% APR verdienen: Tageshohe Ausschläge der Renditen – ein Hinweis darauf, dass Market Maker katastrophal an Liquidität fehlen.
Nachfrage nach Rechenleistung: Vor dem Hintergrund des KI-Booms werden dezentrale GPU/CPU zu einer günstigen Alternative zu Cloud-Diensten.
Technik: Nach dem Impuls fällt der Preis nicht, sondern entlastet den RSI an den wichtigen EMAs (50/200).
Echte Bewegungen entstehen in der Stille, während die Orderbücher vor der zweiten Welle zusammengedrückt werden. Und wer Gewinne nach dem System realisiert, wartet gelassen auf die Auflösung mit Cash.
Meinung teilen: Ruhe vor dem Ruck oder eine Seitwärtsphase? 👇
#GLM #DePIN #BinanceSquare #Crypto
Während der Einzelhandel Memecoins jagt, reift in der dezentralen Infrastruktur (DePIN) ein grundlegender Wandel.
Fakten:
Mehr als 40% APR verdienen: Tageshohe Ausschläge der Renditen – ein Hinweis darauf, dass Market Maker katastrophal an Liquidität fehlen.
Nachfrage nach Rechenleistung: Vor dem Hintergrund des KI-Booms werden dezentrale GPU/CPU zu einer günstigen Alternative zu Cloud-Diensten.
Technik: Nach dem Impuls fällt der Preis nicht, sondern entlastet den RSI an den wichtigen EMAs (50/200).
Echte Bewegungen entstehen in der Stille, während die Orderbücher vor der zweiten Welle zusammengedrückt werden. Und wer Gewinne nach dem System realisiert, wartet gelassen auf die Auflösung mit Cash.
Meinung teilen: Ruhe vor dem Ruck oder eine Seitwärtsphase? 👇
#GLM #DePIN #BinanceSquare #Crypto
1
357
·
--
$RENDER
{future}(RENDERUSDT)
RENDER verbindet Blockchain-Technologie mit dezentralem GPU-Computing. Das Netzwerk ist darauf ausgelegt, verteilte Rechenressourcen für anspruchsvolle digitale Workloads bereitzustellen.
Da KI und Hochleistungsrechnen zu zentralen Technologiethemen werden, gewinnt dezentrale GPU-Infrastruktur in Web3 zunehmend an Aufmerksamkeit.
#RENDER #AI #DePIN #BinanceSquare
$RENDER
RENDER verbindet Blockchain-Technologie mit dezentralem GPU-Computing. Das Netzwerk ist darauf ausgelegt, verteilte Rechenressourcen für anspruchsvolle digitale Workloads bereitzustellen.
Da KI und Hochleistungsrechnen zu zentralen Technologiethemen werden, gewinnt dezentrale GPU-Infrastruktur in Web3 zunehmend an Aufmerksamkeit.
#RENDER #AI #DePIN #BinanceSquare
RENDER verbindet Blockchain-Technologie mit dezentralem GPU-Computing. Das Netzwerk ist darauf ausgelegt, verteilte Rechenressourcen für anspruchsvolle digitale Workloads bereitzustellen.
Da KI und Hochleistungsrechnen zu zentralen Technologiethemen werden, gewinnt dezentrale GPU-Infrastruktur in Web3 zunehmend an Aufmerksamkeit.
#RENDER #AI #DePIN #BinanceSquare
63
·
--
$FIL steigt vor dem Hintergrund von DePIN, während der Speicherbereich gegen den Trend stärker wird
Am 14. September fielen die meisten Krypto-Sektoren, nur DePIN und Teile von Layer 2 entwickelten sich gegenläufig: Der DePIN-Sektor legte in 24 Stunden um etwa 3,49% zu; dabei stieg $FIL um rund 21,43% und $AR um etwa 9,41%. Der Sektor für dezentralen Speicher erreichte eine Marktkapitalisierung von etwa 2,87 Milliarden US-Dollar und verzeichnete innerhalb von 24 Stunden etwa +5,6%.
Auch das Markt-Update nennt FIL, AR und SKL als führende Werte; bei FIL gab es dabei ein deutliches Handelsvolumen.
Auf der Narrativ-Ebene richtet sich die Aufmerksamkeit auf den möglichen Wechsel im Zeitplan der Freigabe von Filecoin-Anteilen rund um den 15. Oktober. Zusätzlich wird über eine neue Ausgabe oder eine deutlich verlangsamte Emission spekuliert (ein Teil der Analysen spricht davon, dass die Emissionsrate um etwa 75% zurückgehen könnte). In Kombination mit Erwartungen an AI-Datenarchivierung und dauerhaftes Speichern treibt dies Kapital von belasteten Mainstream-Coins hin zu Speicher- und DePIN-Beta.
Zu beachten ist, dass einige Statistiken zeigen, dass das Handelsvolumen weiterhin unter dem 30-Tage-Durchschnitt liegt; kurzfristige Schwankungen sind stark. Ein Ausbruch und das Durchsetzen über entscheidende Widerstände müssen noch durch ausreichendes Volumen und die makroökonomische Lage bestätigt werden. Daher sollte man den Verlauf nicht allein anhand des Tagesanstiegs extrapolieren.
$FIL $AR
{spot}(FILUSDT)
#DePIN #Filecoin. #去中心化存储
Stellt keine Anlageberatung dar
$FIL steigt vor dem Hintergrund von DePIN, während der Speicherbereich gegen den Trend stärker wird
Am 14. September fielen die meisten Krypto-Sektoren, nur DePIN und Teile von Layer 2 entwickelten sich gegenläufig: Der DePIN-Sektor legte in 24 Stunden um etwa 3,49% zu; dabei stieg $FIL um rund 21,43% und $AR um etwa 9,41%. Der Sektor für dezentralen Speicher erreichte eine Marktkapitalisierung von etwa 2,87 Milliarden US-Dollar und verzeichnete innerhalb von 24 Stunden etwa +5,6%.
Auch das Markt-Update nennt FIL, AR und SKL als führende Werte; bei FIL gab es dabei ein deutliches Handelsvolumen.
Auf der Narrativ-Ebene richtet sich die Aufmerksamkeit auf den möglichen Wechsel im Zeitplan der Freigabe von Filecoin-Anteilen rund um den 15. Oktober. Zusätzlich wird über eine neue Ausgabe oder eine deutlich verlangsamte Emission spekuliert (ein Teil der Analysen spricht davon, dass die Emissionsrate um etwa 75% zurückgehen könnte). In Kombination mit Erwartungen an AI-Datenarchivierung und dauerhaftes Speichern treibt dies Kapital von belasteten Mainstream-Coins hin zu Speicher- und DePIN-Beta.
Zu beachten ist, dass einige Statistiken zeigen, dass das Handelsvolumen weiterhin unter dem 30-Tage-Durchschnitt liegt; kurzfristige Schwankungen sind stark. Ein Ausbruch und das Durchsetzen über entscheidende Widerstände müssen noch durch ausreichendes Volumen und die makroökonomische Lage bestätigt werden. Daher sollte man den Verlauf nicht allein anhand des Tagesanstiegs extrapolieren.
$FIL $AR
#DePIN #Filecoin. #去中心化存储
Stellt keine Anlageberatung dar
Am 14. September fielen die meisten Krypto-Sektoren, nur DePIN und Teile von Layer 2 entwickelten sich gegenläufig: Der DePIN-Sektor legte in 24 Stunden um etwa 3,49% zu; dabei stieg $FIL um rund 21,43% und $AR um etwa 9,41%. Der Sektor für dezentralen Speicher erreichte eine Marktkapitalisierung von etwa 2,87 Milliarden US-Dollar und verzeichnete innerhalb von 24 Stunden etwa +5,6%.
Auch das Markt-Update nennt FIL, AR und SKL als führende Werte; bei FIL gab es dabei ein deutliches Handelsvolumen.
Auf der Narrativ-Ebene richtet sich die Aufmerksamkeit auf den möglichen Wechsel im Zeitplan der Freigabe von Filecoin-Anteilen rund um den 15. Oktober. Zusätzlich wird über eine neue Ausgabe oder eine deutlich verlangsamte Emission spekuliert (ein Teil der Analysen spricht davon, dass die Emissionsrate um etwa 75% zurückgehen könnte). In Kombination mit Erwartungen an AI-Datenarchivierung und dauerhaftes Speichern treibt dies Kapital von belasteten Mainstream-Coins hin zu Speicher- und DePIN-Beta.
Zu beachten ist, dass einige Statistiken zeigen, dass das Handelsvolumen weiterhin unter dem 30-Tage-Durchschnitt liegt; kurzfristige Schwankungen sind stark. Ein Ausbruch und das Durchsetzen über entscheidende Widerstände müssen noch durch ausreichendes Volumen und die makroökonomische Lage bestätigt werden. Daher sollte man den Verlauf nicht allein anhand des Tagesanstiegs extrapolieren.
$FIL $AR
#DePIN #Filecoin. #去中心化存储
Stellt keine Anlageberatung dar
1
375
·
--
DEPIN-MÜNZEN KÖNNTEN DIE NÄCHSTE WERTENTWICKLUNG SEIN
$FIL bleibt ein bedeutendes Projekt für dezentrale Speicherlösungen.
$AR setzt weiterhin auf dauerhaftes, dezentrales Speichern.
$HNT bleibt einer der bekanntesten DePIN-Namen.
Könnten Infrastruktur-Tokens die nächsten Gewinner sein?
NFA. Persönliche Meinung. DYOR.
#FIL #AR #HNT #DePIN #Crypto
DEPIN-MÜNZEN KÖNNTEN DIE NÄCHSTE WERTENTWICKLUNG SEIN
$FIL bleibt ein bedeutendes Projekt für dezentrale Speicherlösungen.
$AR setzt weiterhin auf dauerhaftes, dezentrales Speichern.
$HNT bleibt einer der bekanntesten DePIN-Namen.
Könnten Infrastruktur-Tokens die nächsten Gewinner sein?
NFA. Persönliche Meinung. DYOR.
#FIL #AR #HNT #DePIN #Crypto
$FIL bleibt ein bedeutendes Projekt für dezentrale Speicherlösungen.
$AR setzt weiterhin auf dauerhaftes, dezentrales Speichern.
$HNT bleibt einer der bekanntesten DePIN-Namen.
Könnten Infrastruktur-Tokens die nächsten Gewinner sein?
NFA. Persönliche Meinung. DYOR.
#FIL #AR #HNT #DePIN #Crypto
3
347

{alpha}(560xd955c9ba56fb1ab30e34766e252a97ccce3d31a6)
👀 Warum spricht niemand über $XPIN ?
XPIN Network baut rund um die DePIN- + KI-Storyline auf, und diese Kombination wird immer schwerer zu ignorieren. 🔥
Aber hier ist die Frage:
Kann XPIN den Hype in echte Akzeptanz und echte Nutzbarkeit verwandeln? 🤔
Ich beobachte:
🌐 Wachstum des Netzwerks
🤖 KI-Integration
📈 Aktivitäten der Community
🚀 Entwicklung des Ökosystems
Ich sage nicht, dass $XPIN pumpen wird.
Ich sage nur, dass es ein Projekt ist, das man sich genau anschauen sollte. 👀
Hast du XPIN schon recherchiert, oder ist es noch immer an deinem Radar vorbei?
#XPIN #XPINNetwork #DePIN #AImodel #crypto
👀 Warum spricht niemand über $XPIN ?
XPIN Network baut rund um die DePIN- + KI-Storyline auf, und diese Kombination wird immer schwerer zu ignorieren. 🔥
Aber hier ist die Frage:
Kann XPIN den Hype in echte Akzeptanz und echte Nutzbarkeit verwandeln? 🤔
Ich beobachte:
🌐 Wachstum des Netzwerks
🤖 KI-Integration
📈 Aktivitäten der Community
🚀 Entwicklung des Ökosystems
Ich sage nicht, dass $XPIN pumpen wird.
Ich sage nur, dass es ein Projekt ist, das man sich genau anschauen sollte. 👀
Hast du XPIN schon recherchiert, oder ist es noch immer an deinem Radar vorbei?
#XPIN #XPINNetwork #DePIN #AImodel #crypto
XPIN Network baut rund um die DePIN- + KI-Storyline auf, und diese Kombination wird immer schwerer zu ignorieren. 🔥
Aber hier ist die Frage:
Kann XPIN den Hype in echte Akzeptanz und echte Nutzbarkeit verwandeln? 🤔
Ich beobachte:
🌐 Wachstum des Netzwerks
🤖 KI-Integration
📈 Aktivitäten der Community
🚀 Entwicklung des Ökosystems
Ich sage nicht, dass $XPIN pumpen wird.
Ich sage nur, dass es ein Projekt ist, das man sich genau anschauen sollte. 👀
Hast du XPIN schon recherchiert, oder ist es noch immer an deinem Radar vorbei?
#XPIN #XPINNetwork #DePIN #AImodel #crypto
1
272
·
--
Artikel
Wo werden die Daten gespeichert, mit denen die Künstliche Intelligenz trainiert wird?Jedes Mal, wenn wir mit einem KI-Modell interagieren, verarbeitet es und erzeugt in Echtzeit Gigabytes an Informationen. $Für das Jahr 2026 hat die Datenmenge, die erforderlich ist, um große Sprachmodelle und generative Systeme zu trainieren, astronomische Ausmaße erreicht. Es gibt jedoch eine entscheidende Frage, die sich nur wenige stellen:
Wo wird all diese Information physisch gespeichert und wer kontrolliert diese Infrastruktur?
Derzeit liegt die große Mehrheit der Speicher- und Rechenkapazität der Welt in den Händen einer kleinen Gruppe von Tech-Giganten. Wenn die Infrastruktur, die die KI trägt, weiterhin unter der Kontrolle von drei oder vier Konzernen bleibt, stehen wir vor schweren Risiken durch massive Unterbrechungen aufgrund zentralisierter Ausfälle, Risiken von Zensur bei Informationen und nicht nachhaltige Skalierungskosten für unabhängige Entwickler.
Wo werden die Daten gespeichert, mit denen die Künstliche Intelligenz trainiert wird?
Jedes Mal, wenn wir mit einem KI-Modell interagieren, verarbeitet es und erzeugt in Echtzeit Gigabytes an Informationen. $Für das Jahr 2026 hat die Datenmenge, die erforderlich ist, um große Sprachmodelle und generative Systeme zu trainieren, astronomische Ausmaße erreicht. Es gibt jedoch eine entscheidende Frage, die sich nur wenige stellen:
Wo wird all diese Information physisch gespeichert und wer kontrolliert diese Infrastruktur?
Derzeit liegt die große Mehrheit der Speicher- und Rechenkapazität der Welt in den Händen einer kleinen Gruppe von Tech-Giganten. Wenn die Infrastruktur, die die KI trägt, weiterhin unter der Kontrolle von drei oder vier Konzernen bleibt, stehen wir vor schweren Risiken durch massive Unterbrechungen aufgrund zentralisierter Ausfälle, Risiken von Zensur bei Informationen und nicht nachhaltige Skalierungskosten für unabhängige Entwickler.
Wo wird all diese Information physisch gespeichert und wer kontrolliert diese Infrastruktur?
Derzeit liegt die große Mehrheit der Speicher- und Rechenkapazität der Welt in den Händen einer kleinen Gruppe von Tech-Giganten. Wenn die Infrastruktur, die die KI trägt, weiterhin unter der Kontrolle von drei oder vier Konzernen bleibt, stehen wir vor schweren Risiken durch massive Unterbrechungen aufgrund zentralisierter Ausfälle, Risiken von Zensur bei Informationen und nicht nachhaltige Skalierungskosten für unabhängige Entwickler.
1
79
·
--
Wer steckt hinter der KI im Hintergrund? @fluence
Eine Sache, die ich an KI-Agenten interessant finde, ist, dass Latenz nicht immer allein durch das Modell verursacht wird.
Ein Agent kann mehrere Tool-Aufrufe ausführen, den Status abrufen, Validierungen durchführen, den Speicher aktualisieren und die Schleife mehrere Male wiederholen. Ein paar Millisekunden CPU-Verzögerung in jedem Schritt mögen für sich genommen unbedeutend wirken, aber über den gesamten Workflow hinweg können sich diese Verzögerungen summieren und die Anfrage über ihre Deadline hinaus schieben.
Hier wird die Infrastruktur wichtiger, als es zunächst den Anschein hat.
Bei KI-Workloads reicht eine durchschnittliche Performance nicht immer aus. Das eigentliche Problem kann sich besonders dann zeigen, wenn CPU-Konkurrenz kleine Verzögerungen über viele Phasen hinweg verursacht.
Das macht dedizierte Rechenleistung zu einer interessanten Option für Workloads, bei denen vorhersehbare Performance entscheidend ist.
Fluence geht das aus der dezentralen Compute-Perspektive an und gibt Entwicklern Zugriff auf dedizierte CPU-Ressourcen für Workloads, die mehr konsistente Kapazität benötigen.
Ich denke, das wird zunehmend relevant, wenn KI-Agenten von einfachen Experimenten in den Produktionsbetrieb übergehen. Wenn ein Agent Dutzende von Schritten übernimmt, kann das Reduzieren der Schwankungen in jeder Phase viel größere Auswirkungen auf das endgültige Nutzererlebnis haben.
Die Frage, auf die ich achte, ist einfach: Wenn Agent-Workloads komplexer werden, wird vorhersehbare Compute dann genauso wichtig sein wie reine Rechenleistung?
https://fluence.ai/
#Fluence #AI #DePIN
Wer steckt hinter der KI im Hintergrund? @Fluence
Eine Sache, die ich an KI-Agenten interessant finde, ist, dass Latenz nicht immer allein durch das Modell verursacht wird.
Ein Agent kann mehrere Tool-Aufrufe ausführen, den Status abrufen, Validierungen durchführen, den Speicher aktualisieren und die Schleife mehrere Male wiederholen. Ein paar Millisekunden CPU-Verzögerung in jedem Schritt mögen für sich genommen unbedeutend wirken, aber über den gesamten Workflow hinweg können sich diese Verzögerungen summieren und die Anfrage über ihre Deadline hinaus schieben.
Hier wird die Infrastruktur wichtiger, als es zunächst den Anschein hat.
Bei KI-Workloads reicht eine durchschnittliche Performance nicht immer aus. Das eigentliche Problem kann sich besonders dann zeigen, wenn CPU-Konkurrenz kleine Verzögerungen über viele Phasen hinweg verursacht.
Das macht dedizierte Rechenleistung zu einer interessanten Option für Workloads, bei denen vorhersehbare Performance entscheidend ist.
Fluence geht das aus der dezentralen Compute-Perspektive an und gibt Entwicklern Zugriff auf dedizierte CPU-Ressourcen für Workloads, die mehr konsistente Kapazität benötigen.
Ich denke, das wird zunehmend relevant, wenn KI-Agenten von einfachen Experimenten in den Produktionsbetrieb übergehen. Wenn ein Agent Dutzende von Schritten übernimmt, kann das Reduzieren der Schwankungen in jeder Phase viel größere Auswirkungen auf das endgültige Nutzererlebnis haben.
Die Frage, auf die ich achte, ist einfach: Wenn Agent-Workloads komplexer werden, wird vorhersehbare Compute dann genauso wichtig sein wie reine Rechenleistung?
https://fluence.ai/
#Fluence #AI #DePIN
Eine Sache, die ich an KI-Agenten interessant finde, ist, dass Latenz nicht immer allein durch das Modell verursacht wird.
Ein Agent kann mehrere Tool-Aufrufe ausführen, den Status abrufen, Validierungen durchführen, den Speicher aktualisieren und die Schleife mehrere Male wiederholen. Ein paar Millisekunden CPU-Verzögerung in jedem Schritt mögen für sich genommen unbedeutend wirken, aber über den gesamten Workflow hinweg können sich diese Verzögerungen summieren und die Anfrage über ihre Deadline hinaus schieben.
Hier wird die Infrastruktur wichtiger, als es zunächst den Anschein hat.
Bei KI-Workloads reicht eine durchschnittliche Performance nicht immer aus. Das eigentliche Problem kann sich besonders dann zeigen, wenn CPU-Konkurrenz kleine Verzögerungen über viele Phasen hinweg verursacht.
Das macht dedizierte Rechenleistung zu einer interessanten Option für Workloads, bei denen vorhersehbare Performance entscheidend ist.
Fluence geht das aus der dezentralen Compute-Perspektive an und gibt Entwicklern Zugriff auf dedizierte CPU-Ressourcen für Workloads, die mehr konsistente Kapazität benötigen.
Ich denke, das wird zunehmend relevant, wenn KI-Agenten von einfachen Experimenten in den Produktionsbetrieb übergehen. Wenn ein Agent Dutzende von Schritten übernimmt, kann das Reduzieren der Schwankungen in jeder Phase viel größere Auswirkungen auf das endgültige Nutzererlebnis haben.
Die Frage, auf die ich achte, ist einfach: Wenn Agent-Workloads komplexer werden, wird vorhersehbare Compute dann genauso wichtig sein wie reine Rechenleistung?
https://fluence.ai/
#Fluence #AI #DePIN
33
·
--
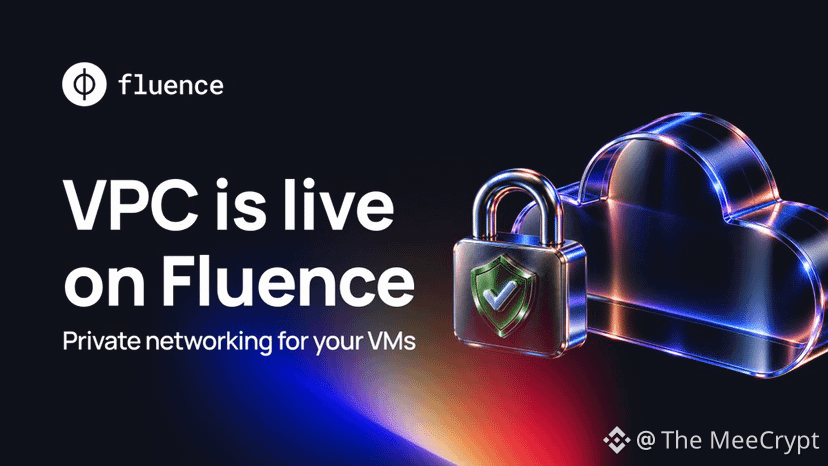
@fluence VPC geht live zu gehen könnte ein wichtiger Schritt für das Fluence-Ökosystem sein.
https://fluence.ai/
Die neue VPC-Infrastruktur ermöglicht Entwicklern, mehrere VMs mit privatem Networking, Security Groups, gesteuertem Egress, optionalen öffentlichen IPs und cloud-init zu betreiben. Ganz einfach: Sie macht Fluence besser geeignet, um echte Anwendungen auszuführen, bei denen verschiedene Services sicher zusammenarbeiten.
Aus der Perspektive von $FLT ist das für mich der Punkt, an dem es spannend wird.
Eine neue Infrastrukturfunktion bedeutet nicht automatisch, dass der FLT-Preis steigt. Die größere Frage ist, ob VPC dabei hilft, dass Fluence mehr Entwickler, Workloads und Unternehmen anzieht.
Wenn die Akzeptanz wächst, könnte mehr Compute im Netzwerk bereitgestellt werden. Das würde die zugrunde liegende Nachfrage stärken und möglicherweise die Fundamentaldaten unterstützen, die FLT zugrunde liegen.
Darum beobachte ich eher die Nutzung als die Ankündigung selbst. Wenn Fluence weiter praktische Infrastruktur hinzufügt und diese Funktionen in echte Netzwerkaktivität übersetzen, denke ich, dass das mit der Zeit ein positiver Katalysator für FLT werden könnte.
Für mich ist die These einfach: bessere Infrastruktur → mehr Use Cases → mehr Netzwerkaktivität → möglicherweise stärkere FLT-Fundamentaldaten.
#DePIN #AI #Web3
@Fluence VPC geht live zu gehen könnte ein wichtiger Schritt für das Fluence-Ökosystem sein.
https://fluence.ai/
Die neue VPC-Infrastruktur ermöglicht Entwicklern, mehrere VMs mit privatem Networking, Security Groups, gesteuertem Egress, optionalen öffentlichen IPs und cloud-init zu betreiben. Ganz einfach: Sie macht Fluence besser geeignet, um echte Anwendungen auszuführen, bei denen verschiedene Services sicher zusammenarbeiten.
Aus der Perspektive von $FLT ist das für mich der Punkt, an dem es spannend wird.
Eine neue Infrastrukturfunktion bedeutet nicht automatisch, dass der FLT-Preis steigt. Die größere Frage ist, ob VPC dabei hilft, dass Fluence mehr Entwickler, Workloads und Unternehmen anzieht.
Wenn die Akzeptanz wächst, könnte mehr Compute im Netzwerk bereitgestellt werden. Das würde die zugrunde liegende Nachfrage stärken und möglicherweise die Fundamentaldaten unterstützen, die FLT zugrunde liegen.
Darum beobachte ich eher die Nutzung als die Ankündigung selbst. Wenn Fluence weiter praktische Infrastruktur hinzufügt und diese Funktionen in echte Netzwerkaktivität übersetzen, denke ich, dass das mit der Zeit ein positiver Katalysator für FLT werden könnte.
Für mich ist die These einfach: bessere Infrastruktur → mehr Use Cases → mehr Netzwerkaktivität → möglicherweise stärkere FLT-Fundamentaldaten.
#DePIN #AI #Web3
https://fluence.ai/
Die neue VPC-Infrastruktur ermöglicht Entwicklern, mehrere VMs mit privatem Networking, Security Groups, gesteuertem Egress, optionalen öffentlichen IPs und cloud-init zu betreiben. Ganz einfach: Sie macht Fluence besser geeignet, um echte Anwendungen auszuführen, bei denen verschiedene Services sicher zusammenarbeiten.
Aus der Perspektive von $FLT ist das für mich der Punkt, an dem es spannend wird.
Eine neue Infrastrukturfunktion bedeutet nicht automatisch, dass der FLT-Preis steigt. Die größere Frage ist, ob VPC dabei hilft, dass Fluence mehr Entwickler, Workloads und Unternehmen anzieht.
Wenn die Akzeptanz wächst, könnte mehr Compute im Netzwerk bereitgestellt werden. Das würde die zugrunde liegende Nachfrage stärken und möglicherweise die Fundamentaldaten unterstützen, die FLT zugrunde liegen.
Darum beobachte ich eher die Nutzung als die Ankündigung selbst. Wenn Fluence weiter praktische Infrastruktur hinzufügt und diese Funktionen in echte Netzwerkaktivität übersetzen, denke ich, dass das mit der Zeit ein positiver Katalysator für FLT werden könnte.
Für mich ist die These einfach: bessere Infrastruktur → mehr Use Cases → mehr Netzwerkaktivität → möglicherweise stärkere FLT-Fundamentaldaten.
#DePIN #AI #Web3
67
·
--
🎯 Ein Satellitennetzwerk im Wert von 1 Mrd. US-Dollar – DePIN sorgt wieder für Aufregung
📰 Space42 und Viasat gründen gemeinsam Equatys: Beide investieren je 400 Mio. US-Dollar in den Aufbau einer terrestrisch- und weltraumgestützten Kommunikationsplattform; anschließend soll noch ein dritter Partner 200 Mio. US-Dollar hinzusteuern. Geplant sind 60 Umlaufbahnen und 2800 Satelliten
💬 Geteilte Infrastruktur ist das lebendige Beispiel für DePIN. Genau dort, wo Boden-Signale nicht erreichbar sind – auf See und in der Wüste – ist der echte Schauplatz, an dem On-Chain-Knoten sich den Kuchen verdienen können
🏷️ #DePIN #卫星互联网 #Space42 #Viasat #Web3基建
🎯 Ein Satellitennetzwerk im Wert von 1 Mrd. US-Dollar – DePIN sorgt wieder für Aufregung
📰 Space42 und Viasat gründen gemeinsam Equatys: Beide investieren je 400 Mio. US-Dollar in den Aufbau einer terrestrisch- und weltraumgestützten Kommunikationsplattform; anschließend soll noch ein dritter Partner 200 Mio. US-Dollar hinzusteuern. Geplant sind 60 Umlaufbahnen und 2800 Satelliten
💬 Geteilte Infrastruktur ist das lebendige Beispiel für DePIN. Genau dort, wo Boden-Signale nicht erreichbar sind – auf See und in der Wüste – ist der echte Schauplatz, an dem On-Chain-Knoten sich den Kuchen verdienen können
🏷️ #DePIN #卫星互联网 #Space42 #Viasat #Web3基建
📰 Space42 und Viasat gründen gemeinsam Equatys: Beide investieren je 400 Mio. US-Dollar in den Aufbau einer terrestrisch- und weltraumgestützten Kommunikationsplattform; anschließend soll noch ein dritter Partner 200 Mio. US-Dollar hinzusteuern. Geplant sind 60 Umlaufbahnen und 2800 Satelliten
💬 Geteilte Infrastruktur ist das lebendige Beispiel für DePIN. Genau dort, wo Boden-Signale nicht erreichbar sind – auf See und in der Wüste – ist der echte Schauplatz, an dem On-Chain-Knoten sich den Kuchen verdienen können
🏷️ #DePIN #卫星互联网 #Space42 #Viasat #Web3基建
5

·
--
Gerade hinzugefügt $FIL um etwa 0,812 $. Ich beobachte dieses Niveau, weil Filcoins dezentrale Storage-Erzählung weiterhin stark relevant ist, während die Nachfrage nach Dateninfrastruktur weiter wächst.
Am meisten interessiert mich die Rolle des Netzwerks beim Speichern und Abrufen von Daten über einen dezentralen Marktplatz, mit zunehmender Überschneidung zwischen Storage, Web3 und KI-Infrastruktur.
Wenn Käufer mit stärkerem Volumen einsteigen, könnte FIL Raum für einen soliden Erholungs-Move haben.
TP: 0,92–1,05
#fil #Filecoin #DecentralizedStorage #DePIN
$FIL
{future}(FILUSDT)
Gerade hinzugefügt $FIL um etwa 0,812 $. Ich beobachte dieses Niveau, weil Filcoins dezentrale Storage-Erzählung weiterhin stark relevant ist, während die Nachfrage nach Dateninfrastruktur weiter wächst.
Am meisten interessiert mich die Rolle des Netzwerks beim Speichern und Abrufen von Daten über einen dezentralen Marktplatz, mit zunehmender Überschneidung zwischen Storage, Web3 und KI-Infrastruktur.
Wenn Käufer mit stärkerem Volumen einsteigen, könnte FIL Raum für einen soliden Erholungs-Move haben.
TP: 0,92–1,05
#fil #Filecoin #DecentralizedStorage #DePIN
$FIL
Am meisten interessiert mich die Rolle des Netzwerks beim Speichern und Abrufen von Daten über einen dezentralen Marktplatz, mit zunehmender Überschneidung zwischen Storage, Web3 und KI-Infrastruktur.
Wenn Käufer mit stärkerem Volumen einsteigen, könnte FIL Raum für einen soliden Erholungs-Move haben.
TP: 0,92–1,05
#fil #Filecoin #DecentralizedStorage #DePIN
$FIL
3
214
#opticalcommsstocksrallyover3%
Das Rückgrat der KI-Revolution besteht nicht nur aus Silizium – sondern aus Glas. 🌐
Aktien für optische Kommunikation wie Corning, Coherent und Ciena sind zuletzt um über 3% gestiegen und signalisieren einen großen Wandel im Infrastrukturbereich. Dieser Anstieg wird durch eine massive Welle von Investitionen in KI-Rechenzentren sowie durch jüngste Analysten- bzw. institutionelle Prognate-Updates für Hochgeschwindigkeits-Optikmodule angetrieben. Um enorme KI-Compute-Lasten zu bewältigen, benötigen Netzwerke eine Bandbreite, die nur Glasfaser liefern kann.
Für den Kryptomarkt bestätigt dieser traditionelle Hardware-Run eine zentrale These: Die physische Infrastruktur-Schicht ist entscheidend. Sie spiegelt direkt den Schwung wider, den wir in DePIN (Dezentrale Physische Infrastrukturnetze) beobachten, denn sowohl der Web2- als auch der Web3-Sektor arbeiten daran, die Hardware-Grundlagen für dezentrale KI zu schaffen.
Wie positionierst du dich für den KI-Infrastruktur-Boom?
👇 Lass es mich in der Umfrage unten wissen!
#DePIN #AIInfrastructure #CryptoMacro
$NEAR
{future}(NEARUSDT)
$TAO
{future}(TAOUSDT)
$RENDER
{future}(RENDERUSDT)
#opticalcommsstocksrallyover3%
Das Rückgrat der KI-Revolution besteht nicht nur aus Silizium – sondern aus Glas. 🌐
Aktien für optische Kommunikation wie Corning, Coherent und Ciena sind zuletzt um über 3% gestiegen und signalisieren einen großen Wandel im Infrastrukturbereich. Dieser Anstieg wird durch eine massive Welle von Investitionen in KI-Rechenzentren sowie durch jüngste Analysten- bzw. institutionelle Prognate-Updates für Hochgeschwindigkeits-Optikmodule angetrieben. Um enorme KI-Compute-Lasten zu bewältigen, benötigen Netzwerke eine Bandbreite, die nur Glasfaser liefern kann.
Für den Kryptomarkt bestätigt dieser traditionelle Hardware-Run eine zentrale These: Die physische Infrastruktur-Schicht ist entscheidend. Sie spiegelt direkt den Schwung wider, den wir in DePIN (Dezentrale Physische Infrastrukturnetze) beobachten, denn sowohl der Web2- als auch der Web3-Sektor arbeiten daran, die Hardware-Grundlagen für dezentrale KI zu schaffen.
Wie positionierst du dich für den KI-Infrastruktur-Boom?
👇 Lass es mich in der Umfrage unten wissen!
#DePIN #AIInfrastructure #CryptoMacro
$NEAR
$TAO
$RENDER
Das Rückgrat der KI-Revolution besteht nicht nur aus Silizium – sondern aus Glas. 🌐
Aktien für optische Kommunikation wie Corning, Coherent und Ciena sind zuletzt um über 3% gestiegen und signalisieren einen großen Wandel im Infrastrukturbereich. Dieser Anstieg wird durch eine massive Welle von Investitionen in KI-Rechenzentren sowie durch jüngste Analysten- bzw. institutionelle Prognate-Updates für Hochgeschwindigkeits-Optikmodule angetrieben. Um enorme KI-Compute-Lasten zu bewältigen, benötigen Netzwerke eine Bandbreite, die nur Glasfaser liefern kann.
Für den Kryptomarkt bestätigt dieser traditionelle Hardware-Run eine zentrale These: Die physische Infrastruktur-Schicht ist entscheidend. Sie spiegelt direkt den Schwung wider, den wir in DePIN (Dezentrale Physische Infrastrukturnetze) beobachten, denn sowohl der Web2- als auch der Web3-Sektor arbeiten daran, die Hardware-Grundlagen für dezentrale KI zu schaffen.
Wie positionierst du dich für den KI-Infrastruktur-Boom?
👇 Lass es mich in der Umfrage unten wissen!
#DePIN #AIInfrastructure #CryptoMacro
$NEAR
$TAO
$RENDER

246
·
--
In der sich weiterentwickelnden Landschaft dezentraler physischer Infrastruktur zeigen Netzwerke, die reale Ressourcen koordinieren, weiterhin einen konkreten Nutzen über die Erzählung hinaus. Wenn Sensoren, Bandbreite und Rechenleistung für die On-Chain-Koordination zusammenkommen, beginnt Kapital, den geerdeten Wertzuwachs anzuerkennen. In Anlehnung an die Infrastruktur-Wellen von 2021, die eine praktische Umsetzung belohnten, trägt dieses Kapitel eine 64%ige Wahrscheinlichkeit für ein beständiges Wachstum über die Saison hinweg, wenn die Kennzahlen zur Einführung und die Integration von Partnerschaften weiter eskalieren.
$FIL $RENDER #RadaRI106 #CoinVahini #DePIN #Infrastructure
In der sich weiterentwickelnden Landschaft dezentraler physischer Infrastruktur zeigen Netzwerke, die reale Ressourcen koordinieren, weiterhin einen konkreten Nutzen über die Erzählung hinaus. Wenn Sensoren, Bandbreite und Rechenleistung für die On-Chain-Koordination zusammenkommen, beginnt Kapital, den geerdeten Wertzuwachs anzuerkennen. In Anlehnung an die Infrastruktur-Wellen von 2021, die eine praktische Umsetzung belohnten, trägt dieses Kapitel eine 64%ige Wahrscheinlichkeit für ein beständiges Wachstum über die Saison hinweg, wenn die Kennzahlen zur Einführung und die Integration von Partnerschaften weiter eskalieren.
$FIL $RENDER #RadaRI106 #CoinVahini #DePIN #Infrastructure
$FIL $RENDER #RadaRI106 #CoinVahini #DePIN #Infrastructure
1
378

·
--
Wenn es gerade so richtig lebhaft am Markt zugeht, will ich eigentlich lieber über ein Projekt aus einem fast schon vergessenen, etablierten Sektor sprechen.
$STORJ steht für dezentrale Cloud-Speicherung: Dateien werden verschlüsselt, in Teile geschnitten und auf Knoten auf der ganzen Welt verteilt. Im Kern geht es darum, brachliegende Festplatten und Bandbreite zu monetarisieren – und das gehört zu den ganz frühen Spielern im DePIN- sowie Storage-Sektor.
Ein paar Kennzahlen, die man im Blick behalten sollte: der aktuelle Kurs liegt bei etwa 0,067 US-Dollar, die Marktkapitalisierung beträgt weniger als 29 Millionen US-Dollar, und das 24-Stunden-Volumen liegt bei rund 18 Millionen US-Dollar. Die Umschlagshäufigkeit ist nicht gerade niedrig – das deutet darauf hin, dass die Coins weiterhin in Bewegung sind. Das Projekt ist also nicht völlig aus dem Fokus verschwunden, nur die Story-/Narrativ-Hitze ist deutlich abgeflaut.
Speicher ist in der Kryptowelt eine der wenigen Richtungen mit echten, kontinuierlichen Bedarfen: Die Datenmenge wächst langfristig, die Kosten für zentrale Cloud-Dienste sind hoch – und die Logik dahinter stimmt seit jeher. Die Realität ist jedoch: Der Wettbewerb im Sektor ist hart, und die Marktführer üben starken Druck aus. Storj möchte neu bewertet werden. Das klappt am Ende nur über Wachstum bei Speichermengen, zahlenden Kunden und realen Einnahmen – nicht indem man dieselbe alte Geschichte noch einmal erzählt.
Eine geringe Marktkapitalisierung bedeutet Chancen durch Hebelwirkung, aber genauso auch Risiko. In der Phase, in der kaum jemand darüber spricht, ist es meist sinnvoller, das Projekt erst einmal auf die Beobachtungsliste zu setzen und geduldig zu verfolgen – statt vorschnell zu handeln. Wenn dann Signale aus den Fundamentaldaten oder eine Bestätigung durch Sektor-Rotation vorliegen, ist der Zeitpunkt zum Handeln noch immer nicht zu spät.
#DePIN #去中心化存储 #Storj
Wenn es gerade so richtig lebhaft am Markt zugeht, will ich eigentlich lieber über ein Projekt aus einem fast schon vergessenen, etablierten Sektor sprechen.
$STORJ steht für dezentrale Cloud-Speicherung: Dateien werden verschlüsselt, in Teile geschnitten und auf Knoten auf der ganzen Welt verteilt. Im Kern geht es darum, brachliegende Festplatten und Bandbreite zu monetarisieren – und das gehört zu den ganz frühen Spielern im DePIN- sowie Storage-Sektor.
Ein paar Kennzahlen, die man im Blick behalten sollte: der aktuelle Kurs liegt bei etwa 0,067 US-Dollar, die Marktkapitalisierung beträgt weniger als 29 Millionen US-Dollar, und das 24-Stunden-Volumen liegt bei rund 18 Millionen US-Dollar. Die Umschlagshäufigkeit ist nicht gerade niedrig – das deutet darauf hin, dass die Coins weiterhin in Bewegung sind. Das Projekt ist also nicht völlig aus dem Fokus verschwunden, nur die Story-/Narrativ-Hitze ist deutlich abgeflaut.
Speicher ist in der Kryptowelt eine der wenigen Richtungen mit echten, kontinuierlichen Bedarfen: Die Datenmenge wächst langfristig, die Kosten für zentrale Cloud-Dienste sind hoch – und die Logik dahinter stimmt seit jeher. Die Realität ist jedoch: Der Wettbewerb im Sektor ist hart, und die Marktführer üben starken Druck aus. Storj möchte neu bewertet werden. Das klappt am Ende nur über Wachstum bei Speichermengen, zahlenden Kunden und realen Einnahmen – nicht indem man dieselbe alte Geschichte noch einmal erzählt.
Eine geringe Marktkapitalisierung bedeutet Chancen durch Hebelwirkung, aber genauso auch Risiko. In der Phase, in der kaum jemand darüber spricht, ist es meist sinnvoller, das Projekt erst einmal auf die Beobachtungsliste zu setzen und geduldig zu verfolgen – statt vorschnell zu handeln. Wenn dann Signale aus den Fundamentaldaten oder eine Bestätigung durch Sektor-Rotation vorliegen, ist der Zeitpunkt zum Handeln noch immer nicht zu spät.
#DePIN #去中心化存储 #Storj
$STORJ steht für dezentrale Cloud-Speicherung: Dateien werden verschlüsselt, in Teile geschnitten und auf Knoten auf der ganzen Welt verteilt. Im Kern geht es darum, brachliegende Festplatten und Bandbreite zu monetarisieren – und das gehört zu den ganz frühen Spielern im DePIN- sowie Storage-Sektor.
Ein paar Kennzahlen, die man im Blick behalten sollte: der aktuelle Kurs liegt bei etwa 0,067 US-Dollar, die Marktkapitalisierung beträgt weniger als 29 Millionen US-Dollar, und das 24-Stunden-Volumen liegt bei rund 18 Millionen US-Dollar. Die Umschlagshäufigkeit ist nicht gerade niedrig – das deutet darauf hin, dass die Coins weiterhin in Bewegung sind. Das Projekt ist also nicht völlig aus dem Fokus verschwunden, nur die Story-/Narrativ-Hitze ist deutlich abgeflaut.
Speicher ist in der Kryptowelt eine der wenigen Richtungen mit echten, kontinuierlichen Bedarfen: Die Datenmenge wächst langfristig, die Kosten für zentrale Cloud-Dienste sind hoch – und die Logik dahinter stimmt seit jeher. Die Realität ist jedoch: Der Wettbewerb im Sektor ist hart, und die Marktführer üben starken Druck aus. Storj möchte neu bewertet werden. Das klappt am Ende nur über Wachstum bei Speichermengen, zahlenden Kunden und realen Einnahmen – nicht indem man dieselbe alte Geschichte noch einmal erzählt.
Eine geringe Marktkapitalisierung bedeutet Chancen durch Hebelwirkung, aber genauso auch Risiko. In der Phase, in der kaum jemand darüber spricht, ist es meist sinnvoller, das Projekt erst einmal auf die Beobachtungsliste zu setzen und geduldig zu verfolgen – statt vorschnell zu handeln. Wenn dann Signale aus den Fundamentaldaten oder eine Bestätigung durch Sektor-Rotation vorliegen, ist der Zeitpunkt zum Handeln noch immer nicht zu spät.
#DePIN #去中心化存储 #Storj
58
·
--
Bullisch
🟧👉 Offenlegung: Dieser Beitrag ( ✍️ Text + 🖼️ Bilder ) wurde mit KI generiert.
🚀 Das dezentrale Streaming-Ökosystem kommt mit echter Netzwerkauslastung so richtig in Fahrt 🔥.
1️⃣ Der On-Chain-Gasbedarf wächst rasant, da $TFUEL die Videolieferung und Smart Contracts antreibt ⚡.
2️⃣ Unternehmens-Edge-Nodes verarbeiten weiterhin enorme verteilte Bandbreite, während sie $TFUEL 🌐 verbrennen.
3️⃣ Marktbeobachter bemerken, wie sich Akkumulationszonen über die Orderbücher der Börsen für $TFUEL 📈 bilden.
{spot}(TFUELUSDT)
#TFUEL #Crypto #Altcoins #Binance #DePIN .
🟥👉 Erinnerung: Keine 🚫 Finanzberatung (NFA). Bitte 🙏 Machen Sie Ihre eigene Recherche (DYOR).
🟧👉 Offenlegung: Dieser Beitrag ( ✍️ Text + 🖼️ Bilder ) wurde mit KI generiert.
🚀 Das dezentrale Streaming-Ökosystem kommt mit echter Netzwerkauslastung so richtig in Fahrt 🔥.
1️⃣ Der On-Chain-Gasbedarf wächst rasant, da $TFUEL die Videolieferung und Smart Contracts antreibt ⚡.
2️⃣ Unternehmens-Edge-Nodes verarbeiten weiterhin enorme verteilte Bandbreite, während sie $TFUEL 🌐 verbrennen.
3️⃣ Marktbeobachter bemerken, wie sich Akkumulationszonen über die Orderbücher der Börsen für $TFUEL 📈 bilden.
#TFUEL #Crypto #Altcoins #Binance #DePIN .
🟥👉 Erinnerung: Keine 🚫 Finanzberatung (NFA). Bitte 🙏 Machen Sie Ihre eigene Recherche (DYOR).
🚀 Das dezentrale Streaming-Ökosystem kommt mit echter Netzwerkauslastung so richtig in Fahrt 🔥.
1️⃣ Der On-Chain-Gasbedarf wächst rasant, da $TFUEL die Videolieferung und Smart Contracts antreibt ⚡.
2️⃣ Unternehmens-Edge-Nodes verarbeiten weiterhin enorme verteilte Bandbreite, während sie $TFUEL 🌐 verbrennen.
3️⃣ Marktbeobachter bemerken, wie sich Akkumulationszonen über die Orderbücher der Börsen für $TFUEL 📈 bilden.
#TFUEL #Crypto #Altcoins #Binance #DePIN .
🟥👉 Erinnerung: Keine 🚫 Finanzberatung (NFA). Bitte 🙏 Machen Sie Ihre eigene Recherche (DYOR).

23
·
--
Werden dezentrale physische Infrastruktur-Netzwerke (DePIN) den nächsten Krypto-Bullenlauf anführen? 🌐⚡
Während sich die Blockchain-Technologie über rein finanzielle Anwendungen hinaus weiterentwickelt, zeichnet sich DePIN schnell als einer der vielversprechendsten Bereiche in Web3 ab. Doch was genau macht DePIN zu einem potenziellen Game-Changer für die breite Akzeptanz?
DePIN nutzt Token-Anreize, um reale physische Infrastruktur aufzubauen und zu betreiben – von dezentralen Funknetzwerken und Compute-Clustern bis hin zu Solarstromnetzen und Speicherlösungen. Durch die Tokenisierung von Hardware-Beiträgen senkt es die Kapitalaufwendungen und bringt traditionelle zentralisierte Platzhirsche ins Wanken.
Indem DePIN digitale Tokens mit realem Nutzen verbindet, liefert es greifbaren wirtschaftlichen Mehrwert – weit über spekulativen Handel hinaus.
$RNDR $FIL #DePIN #Web3 #CryptoInnovation #CoinVahini
Werden dezentrale physische Infrastruktur-Netzwerke (DePIN) den nächsten Krypto-Bullenlauf anführen? 🌐⚡
Während sich die Blockchain-Technologie über rein finanzielle Anwendungen hinaus weiterentwickelt, zeichnet sich DePIN schnell als einer der vielversprechendsten Bereiche in Web3 ab. Doch was genau macht DePIN zu einem potenziellen Game-Changer für die breite Akzeptanz?
DePIN nutzt Token-Anreize, um reale physische Infrastruktur aufzubauen und zu betreiben – von dezentralen Funknetzwerken und Compute-Clustern bis hin zu Solarstromnetzen und Speicherlösungen. Durch die Tokenisierung von Hardware-Beiträgen senkt es die Kapitalaufwendungen und bringt traditionelle zentralisierte Platzhirsche ins Wanken.
Indem DePIN digitale Tokens mit realem Nutzen verbindet, liefert es greifbaren wirtschaftlichen Mehrwert – weit über spekulativen Handel hinaus.
$RNDR $FIL #DePIN #Web3 #CryptoInnovation #CoinVahini
Während sich die Blockchain-Technologie über rein finanzielle Anwendungen hinaus weiterentwickelt, zeichnet sich DePIN schnell als einer der vielversprechendsten Bereiche in Web3 ab. Doch was genau macht DePIN zu einem potenziellen Game-Changer für die breite Akzeptanz?
DePIN nutzt Token-Anreize, um reale physische Infrastruktur aufzubauen und zu betreiben – von dezentralen Funknetzwerken und Compute-Clustern bis hin zu Solarstromnetzen und Speicherlösungen. Durch die Tokenisierung von Hardware-Beiträgen senkt es die Kapitalaufwendungen und bringt traditionelle zentralisierte Platzhirsche ins Wanken.
Indem DePIN digitale Tokens mit realem Nutzen verbindet, liefert es greifbaren wirtschaftlichen Mehrwert – weit über spekulativen Handel hinaus.
$RNDR $FIL #DePIN #Web3 #CryptoInnovation #CoinVahini
1
253

Marktstimmung ist kühl, heißt aber nicht, dass es keine Geschichten gibt. Das etablierte Dezentralisierte-Storage-Projekt Storj wird in letzter Zeit fast gar nicht mehr diskutiert, aber die Kursdaten sind keineswegs langweilig.
Der aktuelle Preis liegt bei etwa 0,0508 US-Dollar, die Marktkapitalisierung nur bei rund 21,61 Millionen US-Dollar. Gleichzeitig ist das 24-Stunden-Volumen mit etwa 11,86 Millionen US-Dollar sehr hoch; der Tages-Umschlag im Verhältnis zur Marktkapitalisierung liegt bei über fünfzig Prozent. Eine geringe Marktkapitalisierung verstärkt den Umschlag: Das bedeutet, dass sich Low-Level-Anteile in der Tiefe fortlaufend still und leise austauschen, nur fehlt bislang die Rückkehr der Aufmerksamkeit genau darauf.
Storj macht verteiltes, kryptografisch gesichertes Object Storage: Betreiber von Knoten tragen zur Auslastung mit ungenutztem Speicherplatz bei und erzielen damit Erträge, während Geschäftskunden ihre Daten in Segmente schneiden, verschlüsseln und dann auf globale Knoten verteilen. Das ist eine von wenigen Richtungen innerhalb des DePIN-Storage-Segments mit tatsächlich vorhandenem Zahlungsbedarf.
Wenn niemand darüber spricht, ist es gerade dann oft sinnvoll, es zunächst auf die Beobachtungsliste zu setzen. Als Nächstes gilt es, zwei Dinge besonders im Blick zu behalten: ob das Handelsvolumen sich weiter verstärkt, und wann die Story im gesamten Storage-Sektor wieder anzieht. Bevor der Wind (der Hype) kommt, ist Geduld wichtiger als das Hinterherlaufen mit Kurssteigerungen.
$STORJ #DePIN #Dezentralisierte Speicherung
Marktstimmung ist kühl, heißt aber nicht, dass es keine Geschichten gibt. Das etablierte Dezentralisierte-Storage-Projekt Storj wird in letzter Zeit fast gar nicht mehr diskutiert, aber die Kursdaten sind keineswegs langweilig.
Der aktuelle Preis liegt bei etwa 0,0508 US-Dollar, die Marktkapitalisierung nur bei rund 21,61 Millionen US-Dollar. Gleichzeitig ist das 24-Stunden-Volumen mit etwa 11,86 Millionen US-Dollar sehr hoch; der Tages-Umschlag im Verhältnis zur Marktkapitalisierung liegt bei über fünfzig Prozent. Eine geringe Marktkapitalisierung verstärkt den Umschlag: Das bedeutet, dass sich Low-Level-Anteile in der Tiefe fortlaufend still und leise austauschen, nur fehlt bislang die Rückkehr der Aufmerksamkeit genau darauf.
Storj macht verteiltes, kryptografisch gesichertes Object Storage: Betreiber von Knoten tragen zur Auslastung mit ungenutztem Speicherplatz bei und erzielen damit Erträge, während Geschäftskunden ihre Daten in Segmente schneiden, verschlüsseln und dann auf globale Knoten verteilen. Das ist eine von wenigen Richtungen innerhalb des DePIN-Storage-Segments mit tatsächlich vorhandenem Zahlungsbedarf.
Wenn niemand darüber spricht, ist es gerade dann oft sinnvoll, es zunächst auf die Beobachtungsliste zu setzen. Als Nächstes gilt es, zwei Dinge besonders im Blick zu behalten: ob das Handelsvolumen sich weiter verstärkt, und wann die Story im gesamten Storage-Sektor wieder anzieht. Bevor der Wind (der Hype) kommt, ist Geduld wichtiger als das Hinterherlaufen mit Kurssteigerungen.
$STORJ #DePIN #Dezentralisierte Speicherung
Der aktuelle Preis liegt bei etwa 0,0508 US-Dollar, die Marktkapitalisierung nur bei rund 21,61 Millionen US-Dollar. Gleichzeitig ist das 24-Stunden-Volumen mit etwa 11,86 Millionen US-Dollar sehr hoch; der Tages-Umschlag im Verhältnis zur Marktkapitalisierung liegt bei über fünfzig Prozent. Eine geringe Marktkapitalisierung verstärkt den Umschlag: Das bedeutet, dass sich Low-Level-Anteile in der Tiefe fortlaufend still und leise austauschen, nur fehlt bislang die Rückkehr der Aufmerksamkeit genau darauf.
Storj macht verteiltes, kryptografisch gesichertes Object Storage: Betreiber von Knoten tragen zur Auslastung mit ungenutztem Speicherplatz bei und erzielen damit Erträge, während Geschäftskunden ihre Daten in Segmente schneiden, verschlüsseln und dann auf globale Knoten verteilen. Das ist eine von wenigen Richtungen innerhalb des DePIN-Storage-Segments mit tatsächlich vorhandenem Zahlungsbedarf.
Wenn niemand darüber spricht, ist es gerade dann oft sinnvoll, es zunächst auf die Beobachtungsliste zu setzen. Als Nächstes gilt es, zwei Dinge besonders im Blick zu behalten: ob das Handelsvolumen sich weiter verstärkt, und wann die Story im gesamten Storage-Sektor wieder anzieht. Bevor der Wind (der Hype) kommt, ist Geduld wichtiger als das Hinterherlaufen mit Kurssteigerungen.
$STORJ #DePIN #Dezentralisierte Speicherung
17
🚨 Die stille Rotation, die die meisten Trader übersehen
Während alle Memecoins beobachten, rotiert das Kapital leise in AI-, RWA- und DePIN-Projekte.
Warum das wichtig ist:
✅ AI-Tokens profitieren von der wachsenden Nachfrage nach dezentraler Rechenleistung.
✅ RWA bringt reale Vermögenswerte on-chain und zieht institutionelles Interesse an.
✅ DePIN-Projekte bauen physische Infrastruktur auf, die durch Krypto-Anreize angetrieben wird.
Die nächsten großen Gewinner entstehen oft dann, wenn die Aufmerksamkeit woanders ist.
📌 Meine Sicht: Narrative mit echtem Nutzen können kurzlebige Hype-Zyklen langfristig übertreffen.
⚠️ Risiko: Die Marktlage steuert weiterhin die Kursbewegungen kurzfristig. Starke Narrative garantieren keine Performance.
Welchen Sektor beobachtest du gerade am genauesten: AI, RWA, DePIN oder Memes? 👇
$BTC
{future}(BTCUSDT)
$ETH $BNB $LINK $RNDR
#crypto #BinanceSquare #AI #RWA #DePIN
🚨 Die stille Rotation, die die meisten Trader übersehen
Während alle Memecoins beobachten, rotiert das Kapital leise in AI-, RWA- und DePIN-Projekte.
Warum das wichtig ist:
✅ AI-Tokens profitieren von der wachsenden Nachfrage nach dezentraler Rechenleistung.
✅ RWA bringt reale Vermögenswerte on-chain und zieht institutionelles Interesse an.
✅ DePIN-Projekte bauen physische Infrastruktur auf, die durch Krypto-Anreize angetrieben wird.
Die nächsten großen Gewinner entstehen oft dann, wenn die Aufmerksamkeit woanders ist.
📌 Meine Sicht: Narrative mit echtem Nutzen können kurzlebige Hype-Zyklen langfristig übertreffen.
⚠️ Risiko: Die Marktlage steuert weiterhin die Kursbewegungen kurzfristig. Starke Narrative garantieren keine Performance.
Welchen Sektor beobachtest du gerade am genauesten: AI, RWA, DePIN oder Memes? 👇
$BTC
$ETH $BNB $LINK $RNDR
#crypto #BinanceSquare #AI #RWA #DePIN
Während alle Memecoins beobachten, rotiert das Kapital leise in AI-, RWA- und DePIN-Projekte.
Warum das wichtig ist:
✅ AI-Tokens profitieren von der wachsenden Nachfrage nach dezentraler Rechenleistung.
✅ RWA bringt reale Vermögenswerte on-chain und zieht institutionelles Interesse an.
✅ DePIN-Projekte bauen physische Infrastruktur auf, die durch Krypto-Anreize angetrieben wird.
Die nächsten großen Gewinner entstehen oft dann, wenn die Aufmerksamkeit woanders ist.
📌 Meine Sicht: Narrative mit echtem Nutzen können kurzlebige Hype-Zyklen langfristig übertreffen.
⚠️ Risiko: Die Marktlage steuert weiterhin die Kursbewegungen kurzfristig. Starke Narrative garantieren keine Performance.
Welchen Sektor beobachtest du gerade am genauesten: AI, RWA, DePIN oder Memes? 👇
$BTC
$ETH $BNB $LINK $RNDR
#crypto #BinanceSquare #AI #RWA #DePIN

142
$TAO sitzt in einem interessanten Teil des Marktes.
Bitcoin kämpft sich im Bereich von etwa 77–78K durch, während der Makro-Druck steigt.
Doch TAO bleibt eine der Altcoins, auf die Anleger achten, wenn die KI-Story wieder anzieht.
Dieser Unterschied ist entscheidend.
Bittensor setzt nicht einfach nur darauf, dass „KI-Tokens nach oben gehen“. Die These zielt darauf ab, ein Anreiznetzwerk rund um dezentrale maschinelle Intelligenz zu schaffen.
Aber der Markt stellt jetzt eine härtere Frage:
Kann TAO weiter outperformen, wenn die Liquidität knapper wird?
Bei ungefähr der 250-Dollar-Marke würde ich lieber auf Struktur und Bestätigung achten, statt dem Momentum hinterherzulaufen.
Die stärksten Assets brauchen kein FOMO von dir.
Sie geben dir ein Setup.
📊 UMFRAGE:
Wo wird TAO als Nächstes hingehen?
#TAO #bittensor #AI #crypto #DePIN
$TAO sitzt in einem interessanten Teil des Marktes.
Bitcoin kämpft sich im Bereich von etwa 77–78K durch, während der Makro-Druck steigt.
Doch TAO bleibt eine der Altcoins, auf die Anleger achten, wenn die KI-Story wieder anzieht.
Dieser Unterschied ist entscheidend.
Bittensor setzt nicht einfach nur darauf, dass „KI-Tokens nach oben gehen“. Die These zielt darauf ab, ein Anreiznetzwerk rund um dezentrale maschinelle Intelligenz zu schaffen.
Aber der Markt stellt jetzt eine härtere Frage:
Kann TAO weiter outperformen, wenn die Liquidität knapper wird?
Bei ungefähr der 250-Dollar-Marke würde ich lieber auf Struktur und Bestätigung achten, statt dem Momentum hinterherzulaufen.
Die stärksten Assets brauchen kein FOMO von dir.
Sie geben dir ein Setup.
📊 UMFRAGE:
Wo wird TAO als Nächstes hingehen?
#TAO #bittensor #AI #crypto #DePIN
Bitcoin kämpft sich im Bereich von etwa 77–78K durch, während der Makro-Druck steigt.
Doch TAO bleibt eine der Altcoins, auf die Anleger achten, wenn die KI-Story wieder anzieht.
Dieser Unterschied ist entscheidend.
Bittensor setzt nicht einfach nur darauf, dass „KI-Tokens nach oben gehen“. Die These zielt darauf ab, ein Anreiznetzwerk rund um dezentrale maschinelle Intelligenz zu schaffen.
Aber der Markt stellt jetzt eine härtere Frage:
Kann TAO weiter outperformen, wenn die Liquidität knapper wird?
Bei ungefähr der 250-Dollar-Marke würde ich lieber auf Struktur und Bestätigung achten, statt dem Momentum hinterherzulaufen.
Die stärksten Assets brauchen kein FOMO von dir.
Sie geben dir ein Setup.
📊 UMFRAGE:
Wo wird TAO als Nächstes hingehen?
#TAO #bittensor #AI #crypto #DePIN
🧱 Consolidation first
60%
📉 Deeper correction
30%
👀 Too early to decide
10%
10 Stimmen • Abstimmung beendet
550
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
1
#FedRateWatch
579,035 Aufrufe
2,734 Kommentare
2
#BitcoinSlidesTo$76000
22,254 Aufrufe
118 Kommentare
3
#BitcoinReboundsTo$79K
62,206 Aufrufe
401 Kommentare
4
#StrategyMarketCapPassesFord
39,718 Aufrufe
653 Kommentare
5
#ClarityActOddsHalveOnPolymarket
59,872 Aufrufe
543 Kommentare
6
#US30YTreasuryYieldTops5.40%
34,020 Aufrufe
363 Kommentare
7
#BessentEndorsesFinalClarityActDraft
56,598 Aufrufe
744 Kommentare
8
#ZamaOpens16ConfidentialMorphoVaults
19,497 Aufrufe
362 Kommentare
9
#USDCOnChainVolumeTops$100Trillion
2,970 Aufrufe
49 Kommentare
10
#BitcoinSpotETFsNetInflow$160M
4,980 Aufrufe
102 Kommentare