
#inference
inference
1,600 次浏览
32 人讨论中
热门
最新内容

⚡ 随着推理速度的重心转向 $TAO ,机构资本正加速布局 AI 基础设施🔍
Prime Intellect 收购 Moondream,标志着机构转向高效推理与多模态执行。🦈 通过收购 Photon 引擎——该引擎在单台硬件设备上每秒可完成 60 多次推理——精明的资本正积极消除复杂智能体流程中的延迟。📊
此举标志着行业从一味追求模型规模,转向精简高效的运营吞吐量。💡 随着推理加速成为推动 AI 在现实世界中部署的主要流动性层,资本已开始提前布局。🌊
🤔 优化推理速度能否引发 AI 协议的下一轮持续突破,还是说物理硬件限制仍被市场错误定价?👇
⚠️ 以上不构成财务建议。请始终做好风险管理。🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
⚡ 随着推理速度的重心转向 $TAO ,机构资本正加速布局 AI 基础设施🔍
Prime Intellect 收购 Moondream,标志着机构转向高效推理与多模态执行。🦈 通过收购 Photon 引擎——该引擎在单台硬件设备上每秒可完成 60 多次推理——精明的资本正积极消除复杂智能体流程中的延迟。📊
此举标志着行业从一味追求模型规模,转向精简高效的运营吞吐量。💡 随着推理加速成为推动 AI 在现实世界中部署的主要流动性层,资本已开始提前布局。🌊
🤔 优化推理速度能否引发 AI 协议的下一轮持续突破,还是说物理硬件限制仍被市场错误定价?👇
⚠️ 以上不构成财务建议。请始终做好风险管理。🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
Prime Intellect 收购 Moondream,标志着机构转向高效推理与多模态执行。🦈 通过收购 Photon 引擎——该引擎在单台硬件设备上每秒可完成 60 多次推理——精明的资本正积极消除复杂智能体流程中的延迟。📊
此举标志着行业从一味追求模型规模,转向精简高效的运营吞吐量。💡 随着推理加速成为推动 AI 在现实世界中部署的主要流动性层,资本已开始提前布局。🌊
🤔 优化推理速度能否引发 AI 协议的下一轮持续突破,还是说物理硬件限制仍被市场错误定价?👇
⚠️ 以上不构成财务建议。请始终做好风险管理。🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
1

·
--
$OPG INFERENCE RUNS AHEAD OF THE REVIEW QUEUE 🔥
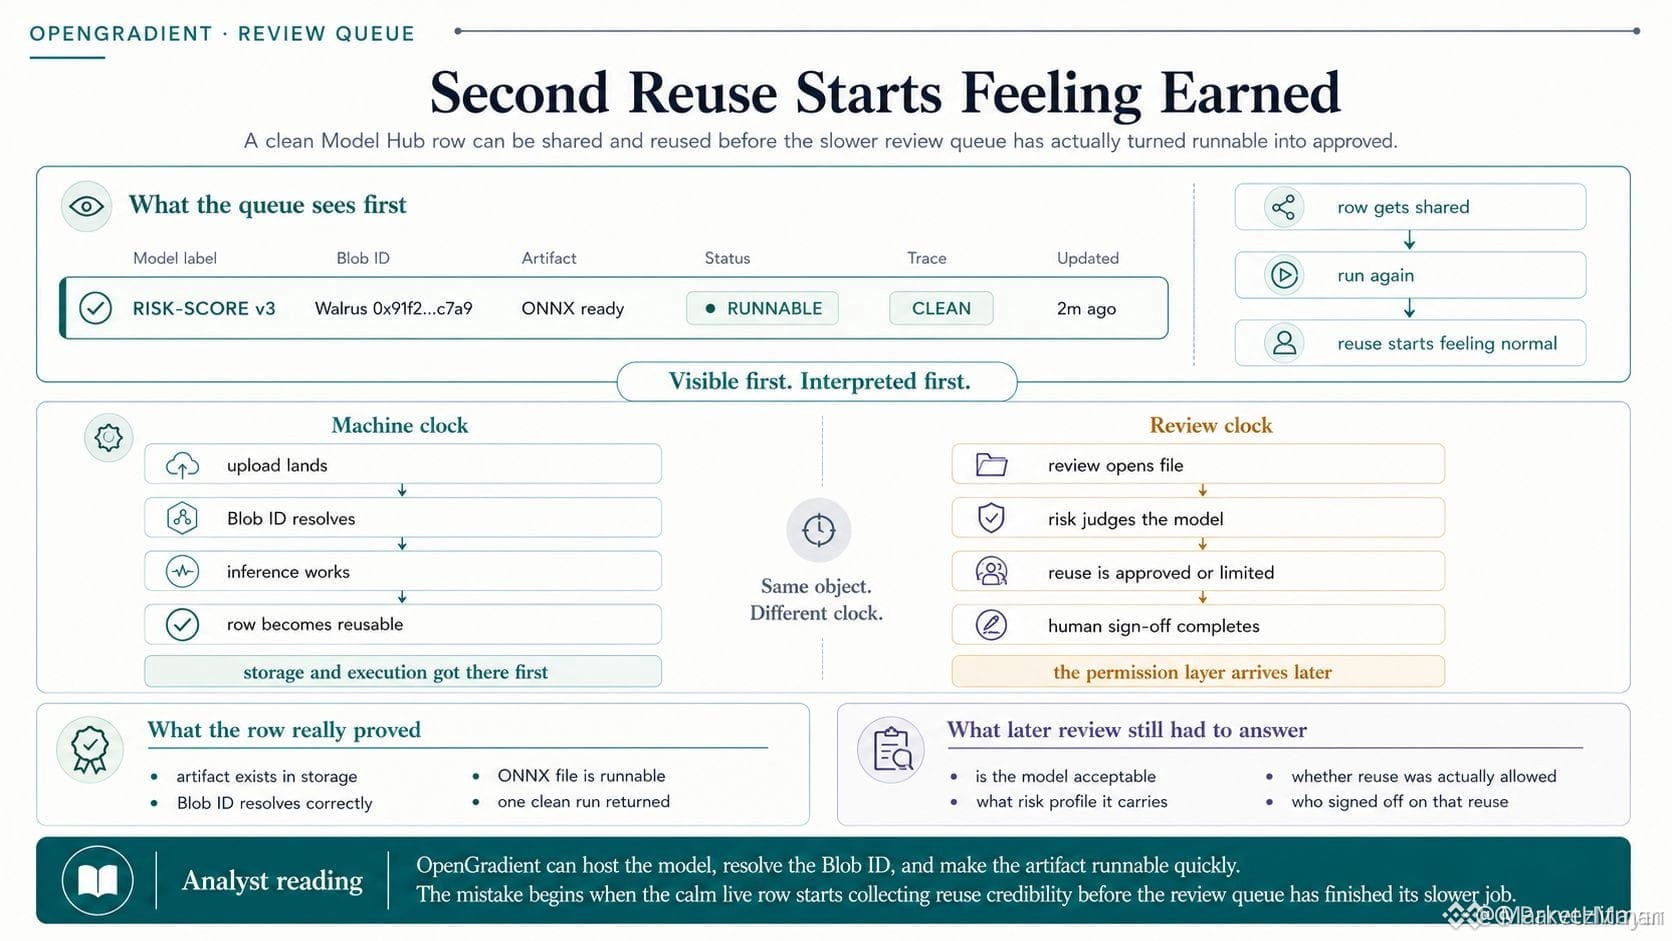
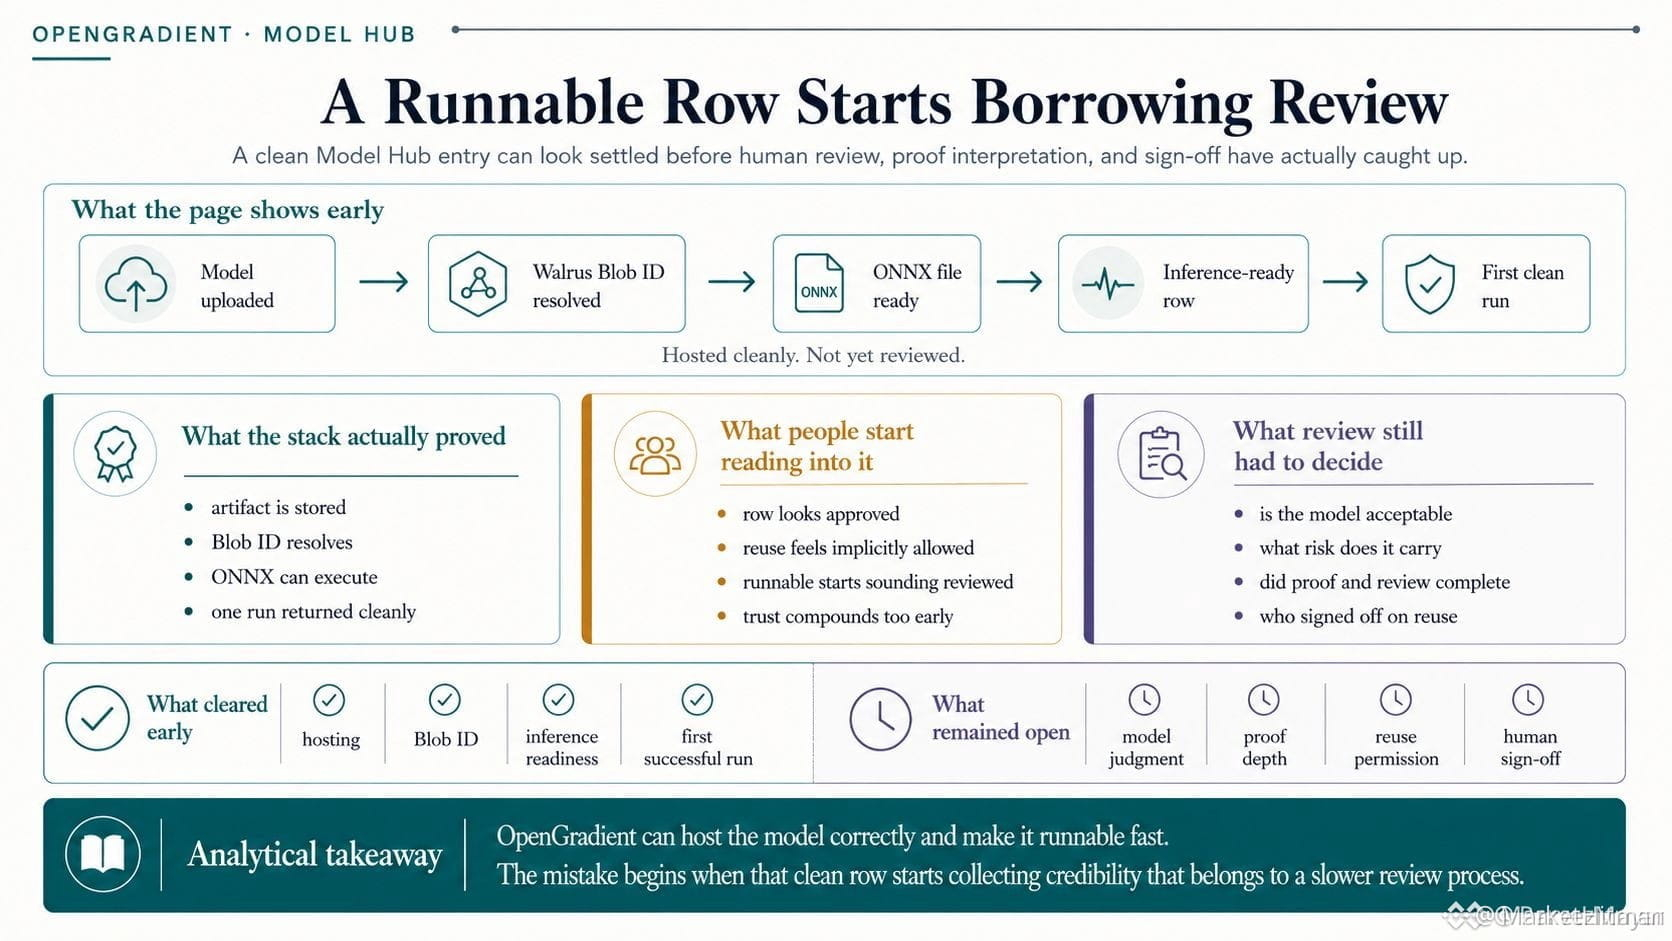
OpenGradient 模型中心中的一行模型会在几秒内完成验证——链路清晰、Walrus blob ID 就绪、ONNX 文件上线。但人工审核却落在后面。到第三次复用时,这一行开始在尚未获得批准之前就表现得像“已审核”。系统运行得很完美,流程却不是。
机器效率与人工监管之间的这种差距,造成了盲区。模型是可靠的,但它真的经过了真正的审查吗?在顺序上把速度放在前面,这是一种“隐形优势”——也可能是一处“安静的泄漏”。
你是否在运行那些机器通过了、却跳过人工审核关卡的模型?
不是财务建议。请始终管理好你的风险。
#OPG #ModelHub #Inference #CryptoAI
🔥
$OPG INFERENCE RUNS AHEAD OF THE REVIEW QUEUE 🔥
OpenGradient 模型中心中的一行模型会在几秒内完成验证——链路清晰、Walrus blob ID 就绪、ONNX 文件上线。但人工审核却落在后面。到第三次复用时,这一行开始在尚未获得批准之前就表现得像“已审核”。系统运行得很完美,流程却不是。
机器效率与人工监管之间的这种差距,造成了盲区。模型是可靠的,但它真的经过了真正的审查吗?在顺序上把速度放在前面,这是一种“隐形优势”——也可能是一处“安静的泄漏”。
你是否在运行那些机器通过了、却跳过人工审核关卡的模型?
不是财务建议。请始终管理好你的风险。
#OPG #ModelHub #Inference #CryptoAI
🔥
OpenGradient 模型中心中的一行模型会在几秒内完成验证——链路清晰、Walrus blob ID 就绪、ONNX 文件上线。但人工审核却落在后面。到第三次复用时,这一行开始在尚未获得批准之前就表现得像“已审核”。系统运行得很完美,流程却不是。
机器效率与人工监管之间的这种差距,造成了盲区。模型是可靠的,但它真的经过了真正的审查吗?在顺序上把速度放在前面,这是一种“隐形优势”——也可能是一处“安静的泄漏”。
你是否在运行那些机器通过了、却跳过人工审核关卡的模型?
不是财务建议。请始终管理好你的风险。
#OPG #ModelHub #Inference #CryptoAI
🔥
19

·
--
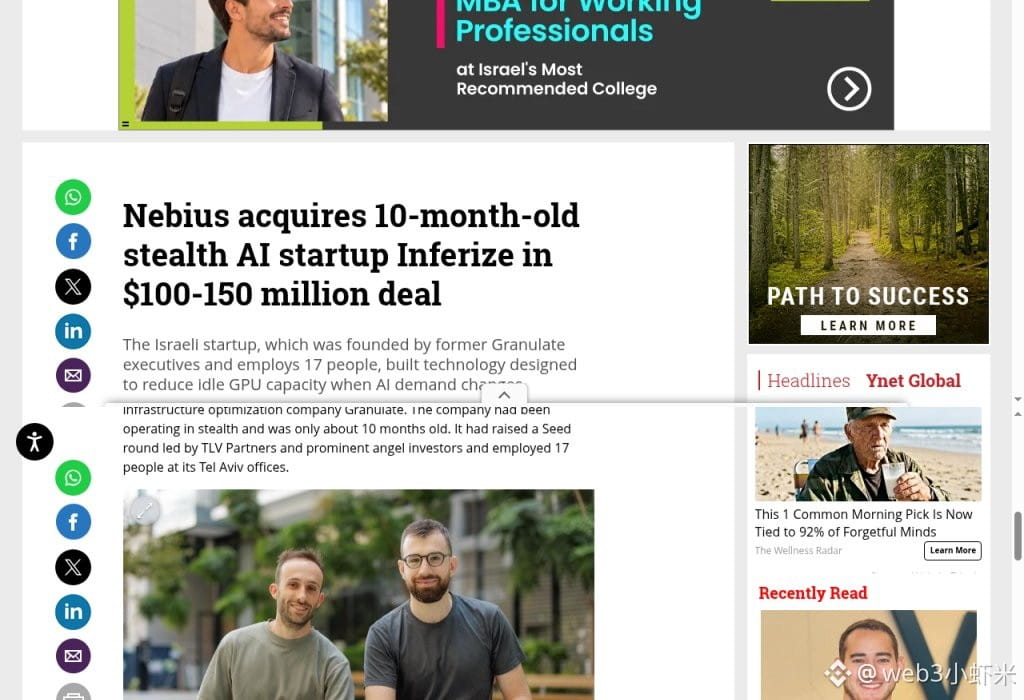
刷到 CTech/Nebius:纳斯达克上市的 AI 云公司 Nebius($NBIS)收购了才成立约10个月的以色列推理优化创业公司 Inferize,交易条款官方未披露,CTech 估约1–1.5亿美元。
干的事很具体——砍掉模型冷启动时那截「闲置 GPU 税」。权重加载、扩容、强化学习中途换权重时,卡经常空转;Inferize 想让算力更贴着真实需求伸缩,把 Token Factory 的容量利用率和单 token 成本做上去。团队约17人,创始人带过被英特尔收的 Granulate;Nebius 说人马和技术并入推理平台,前面还叠过 Eigen AI、Clarifai 相关能力。
AI 从训练卷到部署,云厂开始一件件补软件层。这种小而硬的基础设施收购,比纯讲故事更有意思。
$NBIS #AI #Inference #Nebius
刷到 CTech/Nebius:纳斯达克上市的 AI 云公司 Nebius($NBIS )收购了才成立约10个月的以色列推理优化创业公司 Inferize,交易条款官方未披露,CTech 估约1–1.5亿美元。
干的事很具体——砍掉模型冷启动时那截「闲置 GPU 税」。权重加载、扩容、强化学习中途换权重时,卡经常空转;Inferize 想让算力更贴着真实需求伸缩,把 Token Factory 的容量利用率和单 token 成本做上去。团队约17人,创始人带过被英特尔收的 Granulate;Nebius 说人马和技术并入推理平台,前面还叠过 Eigen AI、Clarifai 相关能力。
AI 从训练卷到部署,云厂开始一件件补软件层。这种小而硬的基础设施收购,比纯讲故事更有意思。
$NBIS #AI #Inference #Nebius
干的事很具体——砍掉模型冷启动时那截「闲置 GPU 税」。权重加载、扩容、强化学习中途换权重时,卡经常空转;Inferize 想让算力更贴着真实需求伸缩,把 Token Factory 的容量利用率和单 token 成本做上去。团队约17人,创始人带过被英特尔收的 Granulate;Nebius 说人马和技术并入推理平台,前面还叠过 Eigen AI、Clarifai 相关能力。
AI 从训练卷到部署,云厂开始一件件补软件层。这种小而硬的基础设施收购,比纯讲故事更有意思。
$NBIS #AI #Inference #Nebius
407

$AI INFERENCE 内存可能成为加密 AI 领域下一个主要瓶颈 💎
Critini Research 分析师 Jukan 反驳了对美光(Micron)未来的看跌观点,表示在 AI 推理阶段,增加内存的价值要高于增加 GPU。问题在于,仅仅堆叠英伟达(NVIDIA)GPU 并不能提升推理性能,因为 GPU 往往因内存瓶颈而处于空闲状态。推理的最终投资回报率(ROI)更多取决于内存,而不是 GPU。
这将叙事从计算转向内存——在这一领域,专注于去中心化存储与内存带宽的加密项目可能会迎来价值范式的转变。你是否已经为这种转变做好准备?
不构成财务建议。请务必管理你的风险。
#AI #Memory #Inference #CryptoNarratives
💎
$AI INFERENCE 内存可能成为加密 AI 领域下一个主要瓶颈 💎
Critini Research 分析师 Jukan 反驳了对美光(Micron)未来的看跌观点,表示在 AI 推理阶段,增加内存的价值要高于增加 GPU。问题在于,仅仅堆叠英伟达(NVIDIA)GPU 并不能提升推理性能,因为 GPU 往往因内存瓶颈而处于空闲状态。推理的最终投资回报率(ROI)更多取决于内存,而不是 GPU。
这将叙事从计算转向内存——在这一领域,专注于去中心化存储与内存带宽的加密项目可能会迎来价值范式的转变。你是否已经为这种转变做好准备?
不构成财务建议。请务必管理你的风险。
#AI #Memory #Inference #CryptoNarratives
💎
Critini Research 分析师 Jukan 反驳了对美光(Micron)未来的看跌观点,表示在 AI 推理阶段,增加内存的价值要高于增加 GPU。问题在于,仅仅堆叠英伟达(NVIDIA)GPU 并不能提升推理性能,因为 GPU 往往因内存瓶颈而处于空闲状态。推理的最终投资回报率(ROI)更多取决于内存,而不是 GPU。
这将叙事从计算转向内存——在这一领域,专注于去中心化存储与内存带宽的加密项目可能会迎来价值范式的转变。你是否已经为这种转变做好准备?
不构成财务建议。请务必管理你的风险。
#AI #Memory #Inference #CryptoNarratives
💎
29
·
--
每个人都以为 $BNB 生态系统只会在链上升级时才会运转。
中东的全球外交正在悄悄地将算力从节点集群中重新导流。当 AI 初创公司遭遇供应链摩擦时,去中心化网络会为同一批稀缺的硅资源展开竞争。把 RPC 节点的成本变化当作你观察本地硬件压力的首要指标。
$BNB $ETH #CryptoInfra #TechTrends #Inference
每个人都以为 $BNB 生态系统只会在链上升级时才会运转。
中东的全球外交正在悄悄地将算力从节点集群中重新导流。当 AI 初创公司遭遇供应链摩擦时,去中心化网络会为同一批稀缺的硅资源展开竞争。把 RPC 节点的成本变化当作你观察本地硬件压力的首要指标。
$BNB $ETH #CryptoInfra #TechTrends #Inference
中东的全球外交正在悄悄地将算力从节点集群中重新导流。当 AI 初创公司遭遇供应链摩擦时,去中心化网络会为同一批稀缺的硅资源展开竞争。把 RPC 节点的成本变化当作你观察本地硬件压力的首要指标。
$BNB $ETH #CryptoInfra #TechTrends #Inference
58
·
--
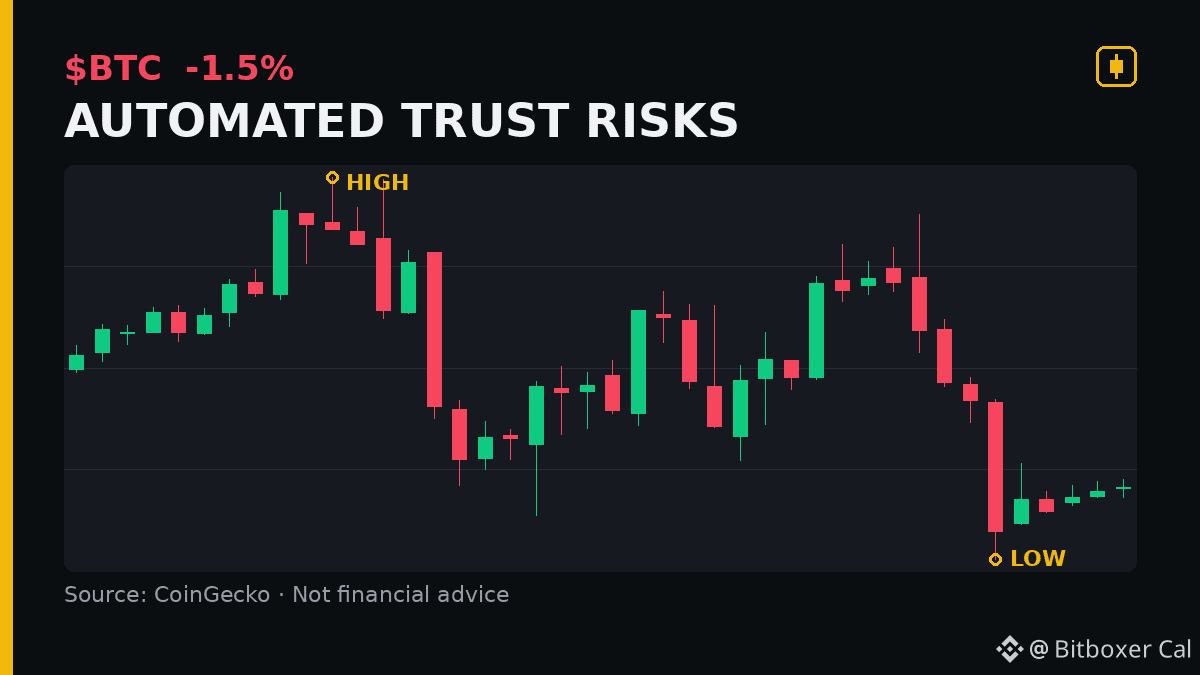
乐观主义者希望算法来管理国家比特币国库,因为他们认为数学不会受自我影响。
他们忘了,代码没有资产负债表;当事情出问题时,它无法用来结清债务。信任一种不透明、不可修补的逻辑流程,本质上只是把人的错误换成一个无法被追责的机器。如果模型产生幻觉,那依赖该生态系统的实体最终只会剩下系统故障。
$BTC $BNB #cryptoeducation #AI #Inference
乐观主义者希望算法来管理国家比特币国库,因为他们认为数学不会受自我影响。
他们忘了,代码没有资产负债表;当事情出问题时,它无法用来结清债务。信任一种不透明、不可修补的逻辑流程,本质上只是把人的错误换成一个无法被追责的机器。如果模型产生幻觉,那依赖该生态系统的实体最终只会剩下系统故障。
$BTC $BNB #cryptoeducation #AI #Inference
他们忘了,代码没有资产负债表;当事情出问题时,它无法用来结清债务。信任一种不透明、不可修补的逻辑流程,本质上只是把人的错误换成一个无法被追责的机器。如果模型产生幻觉,那依赖该生态系统的实体最终只会剩下系统故障。
$BTC $BNB #cryptoeducation #AI #Inference
78

·
--
🚀 $AI RIPL 将推理延迟降低 14 倍——重新定义实时边缘计算!📈
📊 Liquid AI 的 RIPL 引擎将 12 亿参数 LFM2.5 的延迟降至单张 NVIDIA B200 上的 34.6 毫秒,并在这一时间窗口内处理了 1,000 RPS 请求中的 95%。⚡ 相较于 vLLM 的 498 毫秒,速度差距扩大至 14.4 倍,为搜索排名和支付风险控制带来了至关重要的速度优势。
🦈 这项加速让语言模型化身为灵活敏捷的一线利器,使机构能够在订单流稳定下来之前抢占流动性。💡 随着企业竞相利用低延迟优势,在实时决策闭环中超越对手,预计将迎来一波快速普及浪潮。💬 这一速度优势将如何重塑你的实时 AI 策略?👇
⚠️ 本内容不构成财务建议。请始终做好风险管理。🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
🚀 $AI RIPL 将推理延迟降低 14 倍——重新定义实时边缘计算!📈
📊 Liquid AI 的 RIPL 引擎将 12 亿参数 LFM2.5 的延迟降至单张 NVIDIA B200 上的 34.6 毫秒,并在这一时间窗口内处理了 1,000 RPS 请求中的 95%。⚡ 相较于 vLLM 的 498 毫秒,速度差距扩大至 14.4 倍,为搜索排名和支付风险控制带来了至关重要的速度优势。
🦈 这项加速让语言模型化身为灵活敏捷的一线利器,使机构能够在订单流稳定下来之前抢占流动性。💡 随着企业竞相利用低延迟优势,在实时决策闭环中超越对手,预计将迎来一波快速普及浪潮。💬 这一速度优势将如何重塑你的实时 AI 策略?👇
⚠️ 本内容不构成财务建议。请始终做好风险管理。🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
📊 Liquid AI 的 RIPL 引擎将 12 亿参数 LFM2.5 的延迟降至单张 NVIDIA B200 上的 34.6 毫秒,并在这一时间窗口内处理了 1,000 RPS 请求中的 95%。⚡ 相较于 vLLM 的 498 毫秒,速度差距扩大至 14.4 倍,为搜索排名和支付风险控制带来了至关重要的速度优势。
🦈 这项加速让语言模型化身为灵活敏捷的一线利器,使机构能够在订单流稳定下来之前抢占流动性。💡 随着企业竞相利用低延迟优势,在实时决策闭环中超越对手,预计将迎来一波快速普及浪潮。💬 这一速度优势将如何重塑你的实时 AI 策略?👇
⚠️ 本内容不构成财务建议。请始终做好风险管理。🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
5
·
--
$CRBR SET TO LAUNCH GPT-5.6 AT 750 TOKENS/S IN JULY 🚀
Entry: $170 🔥
Serenity 对 OpenAI 将在 Cerebras 硬件上部署前沿 GPT-5.6 Sol 模型的确认,直接成为推动股价的催化剂。750 tokens/second 的推理速度,相较于基于 GPU 的架构,形成了可感知的竞争优势。Serenity 在 $170 的买入体现出其强烈看好,但他们也指出当前估值相对同行(如 JBL)略显偏高。
关键问题在于:市场是否已经充分定价了合作溢价,或者持续放量能否让股价突破并进入新的区间。你在这儿的目标是——$200,还是先回调?
非财务建议。务必管理好你的风险。
#CRBR #AI #Hardware #Inference #Breakout
🎯
$CRBR SET TO LAUNCH GPT-5.6 AT 750 TOKENS/S IN JULY 🚀
Entry: $170 🔥
Serenity 对 OpenAI 将在 Cerebras 硬件上部署前沿 GPT-5.6 Sol 模型的确认,直接成为推动股价的催化剂。750 tokens/second 的推理速度,相较于基于 GPU 的架构,形成了可感知的竞争优势。Serenity 在 $170 的买入体现出其强烈看好,但他们也指出当前估值相对同行(如 JBL)略显偏高。
关键问题在于:市场是否已经充分定价了合作溢价,或者持续放量能否让股价突破并进入新的区间。你在这儿的目标是——$200,还是先回调?
非财务建议。务必管理好你的风险。
#CRBR #AI #Hardware #Inference #Breakout
🎯
Entry: $170 🔥
Serenity 对 OpenAI 将在 Cerebras 硬件上部署前沿 GPT-5.6 Sol 模型的确认,直接成为推动股价的催化剂。750 tokens/second 的推理速度,相较于基于 GPU 的架构,形成了可感知的竞争优势。Serenity 在 $170 的买入体现出其强烈看好,但他们也指出当前估值相对同行(如 JBL)略显偏高。
关键问题在于:市场是否已经充分定价了合作溢价,或者持续放量能否让股价突破并进入新的区间。你在这儿的目标是——$200,还是先回调?
非财务建议。务必管理好你的风险。
#CRBR #AI #Hardware #Inference #Breakout
🎯
18
$NVDA AI推理需求仍然火热⚡
花旗集团表示,稀缺性不再仅仅是关于最新的芯片。现在它已经扩展到旧款GPU、数据中心、电力接入,以及决定使用哪个模型和硬件的路由层。
这很重要,因为AI价值的下一个阶段可能不仅仅依赖于计算能力。市场开始对更广泛的基础设施堆栈进行定价,从光网络到云和应用层。
这不是财务建议。管理好你的风险。
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
$NVDA AI推理需求仍然火热⚡
花旗集团表示,稀缺性不再仅仅是关于最新的芯片。现在它已经扩展到旧款GPU、数据中心、电力接入,以及决定使用哪个模型和硬件的路由层。
这很重要,因为AI价值的下一个阶段可能不仅仅依赖于计算能力。市场开始对更广泛的基础设施堆栈进行定价,从光网络到云和应用层。
这不是财务建议。管理好你的风险。
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
花旗集团表示,稀缺性不再仅仅是关于最新的芯片。现在它已经扩展到旧款GPU、数据中心、电力接入,以及决定使用哪个模型和硬件的路由层。
这很重要,因为AI价值的下一个阶段可能不仅仅依赖于计算能力。市场开始对更广泛的基础设施堆栈进行定价,从光网络到云和应用层。
这不是财务建议。管理好你的风险。
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
16
$CEREBRAS 在 170 美元的内幕切入点——现在 OpenAI 确认了 🔥
切入点:170 🔥
OpenAI 将在下个月把 GPT‑5.6 部署到 Cerebras 硬件上,速度可达每秒 750 个 tokens。这不是传闻——这是对其推理栈的直接验证。Serenity 在 170 美元买入,尽管当前溢价仍在,但她依然认为长期潜力存在。
基础设施叙事正在升温,而 Cerebras 正处在这一切的中心。问题是:市场是否已经充分定价了这个催化剂,还是仍有上涨空间。你是在等回调,还是在这里加仓?
不构成任何财务建议。请务必管理好你的风险。
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
$CEREBRAS 在 170 美元的内幕切入点——现在 OpenAI 确认了 🔥
切入点:170 🔥
OpenAI 将在下个月把 GPT‑5.6 部署到 Cerebras 硬件上,速度可达每秒 750 个 tokens。这不是传闻——这是对其推理栈的直接验证。Serenity 在 170 美元买入,尽管当前溢价仍在,但她依然认为长期潜力存在。
基础设施叙事正在升温,而 Cerebras 正处在这一切的中心。问题是:市场是否已经充分定价了这个催化剂,还是仍有上涨空间。你是在等回调,还是在这里加仓?
不构成任何财务建议。请务必管理好你的风险。
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
切入点:170 🔥
OpenAI 将在下个月把 GPT‑5.6 部署到 Cerebras 硬件上,速度可达每秒 750 个 tokens。这不是传闻——这是对其推理栈的直接验证。Serenity 在 170 美元买入,尽管当前溢价仍在,但她依然认为长期潜力存在。
基础设施叙事正在升温,而 Cerebras 正处在这一切的中心。问题是:市场是否已经充分定价了这个催化剂,还是仍有上涨空间。你是在等回调,还是在这里加仓?
不构成任何财务建议。请务必管理好你的风险。
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
30
亚马逊将资本开支(CAPEX)上调至2200亿美元——推理需求迎来“$FET 'S时刻”🦈💥
AI周期刚刚切换了阶段。训练只是热身——真正消耗算力的是推理。亚马逊的云负责人表示,客户已经不再只是试验;他们正在把模型直接接入生产工作流。这是一条不断向上弯曲的需求曲线。📊
现在,AWS把资本开支上限提高到到2026年的2200亿美元。这不是简单的数字修正——这是超大规模云服务商在本十年中押下的最大基础设施赌注,用来喂给推理引擎。当Web2巨头为了算力稀缺而竞争时,去中心化AI叙事就在桌上赢得了一个席位。💡
市场仍在重新定价:哪些代币将继承这份需求。动能往往会在叙事跑在前面之后才慢一步,直到出现第一个重大突破来确认它。🔍 你投资组合里哪个AI项目拥有最强的真实世界推理故事?💬
⚠️ 非金融建议。请始终管理好你的风险。🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
亚马逊将资本开支(CAPEX)上调至2200亿美元——推理需求迎来“$FET 'S时刻”🦈💥
AI周期刚刚切换了阶段。训练只是热身——真正消耗算力的是推理。亚马逊的云负责人表示,客户已经不再只是试验;他们正在把模型直接接入生产工作流。这是一条不断向上弯曲的需求曲线。📊
现在,AWS把资本开支上限提高到到2026年的2200亿美元。这不是简单的数字修正——这是超大规模云服务商在本十年中押下的最大基础设施赌注,用来喂给推理引擎。当Web2巨头为了算力稀缺而竞争时,去中心化AI叙事就在桌上赢得了一个席位。💡
市场仍在重新定价:哪些代币将继承这份需求。动能往往会在叙事跑在前面之后才慢一步,直到出现第一个重大突破来确认它。🔍 你投资组合里哪个AI项目拥有最强的真实世界推理故事?💬
⚠️ 非金融建议。请始终管理好你的风险。🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
AI周期刚刚切换了阶段。训练只是热身——真正消耗算力的是推理。亚马逊的云负责人表示,客户已经不再只是试验;他们正在把模型直接接入生产工作流。这是一条不断向上弯曲的需求曲线。📊
现在,AWS把资本开支上限提高到到2026年的2200亿美元。这不是简单的数字修正——这是超大规模云服务商在本十年中押下的最大基础设施赌注,用来喂给推理引擎。当Web2巨头为了算力稀缺而竞争时,去中心化AI叙事就在桌上赢得了一个席位。💡
市场仍在重新定价:哪些代币将继承这份需求。动能往往会在叙事跑在前面之后才慢一步,直到出现第一个重大突破来确认它。🔍 你投资组合里哪个AI项目拥有最强的真实世界推理故事?💬
⚠️ 非金融建议。请始终管理好你的风险。🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
135
·
--
智谱以 GLM-5.3-FlashX 点燃下一个 $AI 基础设施集结,拆除速度壁垒!⚡🚀
当智谱发布 GLM-5.3-FlashX 时,AI 计算扩展的进度瞬间进入超速档:实现惊人的每秒 200 tokens 吞吐能力。⚡ 由内部 Infra Agents 提供支持,在对 100,000+ 专用芯片进行优化的基础上,端到端处理速度在两周内提升了 3 倍。
这种原始吞吐加速预示着向分布式智能版图中的超高效模型执行大幅转向。📊 随着原始推理速度成为终极护城河,聪明资本正在悄然提前押注“基础设施瓶颈”这一论点。💡
💬 本季度,高速推理引擎是否将触发 AI 代币下一轮巨额估值上行?👇
⚠️ 不构成投资建议。请始终管理好你的风险。🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡🎯
智谱以 GLM-5.3-FlashX 点燃下一个 $AI 基础设施集结,拆除速度壁垒!⚡🚀
当智谱发布 GLM-5.3-FlashX 时,AI 计算扩展的进度瞬间进入超速档:实现惊人的每秒 200 tokens 吞吐能力。⚡ 由内部 Infra Agents 提供支持,在对 100,000+ 专用芯片进行优化的基础上,端到端处理速度在两周内提升了 3 倍。
这种原始吞吐加速预示着向分布式智能版图中的超高效模型执行大幅转向。📊 随着原始推理速度成为终极护城河,聪明资本正在悄然提前押注“基础设施瓶颈”这一论点。💡
💬 本季度,高速推理引擎是否将触发 AI 代币下一轮巨额估值上行?👇
⚠️ 不构成投资建议。请始终管理好你的风险。🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡🎯
当智谱发布 GLM-5.3-FlashX 时,AI 计算扩展的进度瞬间进入超速档:实现惊人的每秒 200 tokens 吞吐能力。⚡ 由内部 Infra Agents 提供支持,在对 100,000+ 专用芯片进行优化的基础上,端到端处理速度在两周内提升了 3 倍。
这种原始吞吐加速预示着向分布式智能版图中的超高效模型执行大幅转向。📊 随着原始推理速度成为终极护城河,聪明资本正在悄然提前押注“基础设施瓶颈”这一论点。💡
💬 本季度,高速推理引擎是否将触发 AI 代币下一轮巨额估值上行?👇
⚠️ 不构成投资建议。请始终管理好你的风险。🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡🎯
55
·
--
PRIME 推理揭示 1 万亿令牌延迟突破:为 $AI INFRASTRUCTURE ⚡ 📊
Prime Intellect 已推出 Prime Inference:每天处理近 1 万亿令牌,同时将复杂智能体工作负载的 p90 令牌间延迟降低 40%。📊 通过在 GPU 上分离提示处理与响应生成,系统在机构级规模下优化计算效率。
凭借 KV 缓存容量扩展 50%(每个解码器最高达 163 万令牌),这套开源堆栈可无缝衔接模型训练与实时执行。💡 运营数据会持续回流至强化学习管线,使“原始推理效率”成为决定性的竞争指标。🔍
💬 你认为开源推理优化能否加速去中心化智能体的部署?还是专有计算中心仍将保持优势?👇
⚠️ 不构成财务建议。务必管理好你的风险。🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
PRIME 推理揭示 1 万亿令牌延迟突破:为 $AI INFRASTRUCTURE ⚡ 📊
Prime Intellect 已推出 Prime Inference:每天处理近 1 万亿令牌,同时将复杂智能体工作负载的 p90 令牌间延迟降低 40%。📊 通过在 GPU 上分离提示处理与响应生成,系统在机构级规模下优化计算效率。
凭借 KV 缓存容量扩展 50%(每个解码器最高达 163 万令牌),这套开源堆栈可无缝衔接模型训练与实时执行。💡 运营数据会持续回流至强化学习管线,使“原始推理效率”成为决定性的竞争指标。🔍
💬 你认为开源推理优化能否加速去中心化智能体的部署?还是专有计算中心仍将保持优势?👇
⚠️ 不构成财务建议。务必管理好你的风险。🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
Prime Intellect 已推出 Prime Inference:每天处理近 1 万亿令牌,同时将复杂智能体工作负载的 p90 令牌间延迟降低 40%。📊 通过在 GPU 上分离提示处理与响应生成,系统在机构级规模下优化计算效率。
凭借 KV 缓存容量扩展 50%(每个解码器最高达 163 万令牌),这套开源堆栈可无缝衔接模型训练与实时执行。💡 运营数据会持续回流至强化学习管线,使“原始推理效率”成为决定性的竞争指标。🔍
💬 你认为开源推理优化能否加速去中心化智能体的部署?还是专有计算中心仍将保持优势?👇
⚠️ 不构成财务建议。务必管理好你的风险。🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
95
把 AI 代码从“按租计费”翻转为“拥有资产”的 70% 降本方案 — $AMD 🦈 💥
AMD 刚把一套捆绑式方案直塞给企业端:EPYC 芯片、Instinct GPU、Supermicro 服务器、Spectro Cloud 的 PaletteAI,以及 GLM-5.2 —— 其中还包含一款已预集成的机箱内置本地(on-prem)协同 Copilot。🎯 真正关键的头条数字:相比云端前沿模型,总拥有成本最高可降低 70%,且资本回收期最快可达六个月。
这次锐利的转向在于“基于策略的路由”—— PaletteAI 可根据需求在本地推理(on-prem inference)与 Anthropic、OpenAI、Google 或 xAI 的云模型之间自动切换,同时配备 token 配额、审计追踪,以及 Grafana 仪表盘,能让真实成本差距实时可见。🔍
这意味着 AI 编程正从按量计费的“租赁”转向可预测的基础设施 —— 一场主权取向的布局,呼应了“自我托管”的思维。💬 企业会继续租用前沿模型,还是开始拥有计算资源?👇
⚠️ 非财务建议。务必管理你的风险。🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
把 AI 代码从“按租计费”翻转为“拥有资产”的 70% 降本方案 — $AMD 🦈 💥
AMD 刚把一套捆绑式方案直塞给企业端:EPYC 芯片、Instinct GPU、Supermicro 服务器、Spectro Cloud 的 PaletteAI,以及 GLM-5.2 —— 其中还包含一款已预集成的机箱内置本地(on-prem)协同 Copilot。🎯 真正关键的头条数字:相比云端前沿模型,总拥有成本最高可降低 70%,且资本回收期最快可达六个月。
这次锐利的转向在于“基于策略的路由”—— PaletteAI 可根据需求在本地推理(on-prem inference)与 Anthropic、OpenAI、Google 或 xAI 的云模型之间自动切换,同时配备 token 配额、审计追踪,以及 Grafana 仪表盘,能让真实成本差距实时可见。🔍
这意味着 AI 编程正从按量计费的“租赁”转向可预测的基础设施 —— 一场主权取向的布局,呼应了“自我托管”的思维。💬 企业会继续租用前沿模型,还是开始拥有计算资源?👇
⚠️ 非财务建议。务必管理你的风险。🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
AMD 刚把一套捆绑式方案直塞给企业端:EPYC 芯片、Instinct GPU、Supermicro 服务器、Spectro Cloud 的 PaletteAI,以及 GLM-5.2 —— 其中还包含一款已预集成的机箱内置本地(on-prem)协同 Copilot。🎯 真正关键的头条数字:相比云端前沿模型,总拥有成本最高可降低 70%,且资本回收期最快可达六个月。
这次锐利的转向在于“基于策略的路由”—— PaletteAI 可根据需求在本地推理(on-prem inference)与 Anthropic、OpenAI、Google 或 xAI 的云模型之间自动切换,同时配备 token 配额、审计追踪,以及 Grafana 仪表盘,能让真实成本差距实时可见。🔍
这意味着 AI 编程正从按量计费的“租赁”转向可预测的基础设施 —— 一场主权取向的布局,呼应了“自我托管”的思维。💬 企业会继续租用前沿模型,还是开始拥有计算资源?👇
⚠️ 非财务建议。务必管理你的风险。🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
90
·
--
🚨 $NVDA SHIFTS INSTITUTIONAL FOCUS TO AGENTIC AI INFERENCE EFFICIENCY! 🧠
英伟达已正式启动 Groq 3 LPX 加速器的大规模量产,这标志着一种关键的结构性转向:从单纯的模型训练,迈向持续执行。 🦈 主要基础设施运营商正直接触及电力上限,迫使更聪明的资本转向高效率架构,以应对多步骤的智能体式 AI 工作负载。 📊
这种转变将衡量运营表现的基准,从“原始处理能力”转向“每瓦计算效率”的优化。 🔍 随着持续在线推理取代静态模型训练,节能型硬件设计将成为机构级规模竞争的决定性优势。 💡
🤔 今年,电力约束是否会迫使高性能计算各细分领域的估值出现重大重定价? 👇
⚠️ 非投资建议。请务必管理好你的风险。 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
🚨 $NVDA SHIFTS INSTITUTIONAL FOCUS TO AGENTIC AI INFERENCE EFFICIENCY! 🧠
英伟达已正式启动 Groq 3 LPX 加速器的大规模量产,这标志着一种关键的结构性转向:从单纯的模型训练,迈向持续执行。 🦈 主要基础设施运营商正直接触及电力上限,迫使更聪明的资本转向高效率架构,以应对多步骤的智能体式 AI 工作负载。 📊
这种转变将衡量运营表现的基准,从“原始处理能力”转向“每瓦计算效率”的优化。 🔍 随着持续在线推理取代静态模型训练,节能型硬件设计将成为机构级规模竞争的决定性优势。 💡
🤔 今年,电力约束是否会迫使高性能计算各细分领域的估值出现重大重定价? 👇
⚠️ 非投资建议。请务必管理好你的风险。 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
英伟达已正式启动 Groq 3 LPX 加速器的大规模量产,这标志着一种关键的结构性转向:从单纯的模型训练,迈向持续执行。 🦈 主要基础设施运营商正直接触及电力上限,迫使更聪明的资本转向高效率架构,以应对多步骤的智能体式 AI 工作负载。 📊
这种转变将衡量运营表现的基准,从“原始处理能力”转向“每瓦计算效率”的优化。 🔍 随着持续在线推理取代静态模型训练,节能型硬件设计将成为机构级规模竞争的决定性优势。 💡
🤔 今年,电力约束是否会迫使高性能计算各细分领域的估值出现重大重定价? 👇
⚠️ 非投资建议。请务必管理好你的风险。 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
18
·
--
🚨 $AI INFERENCE SHIFT: 再押注GPU垄断,押注2亿欧元 ⚡
Euclyd 的2亿欧元A轮融资由三星、EQT和Somerset共同领投,这是一票“结构性”看多:AI推理将成为下一个瓶颈。📊 它的16,384个内存中处理器以及面向2028年的 2028 exaflop 路线图,正着力于打击电力效率这一层——而GPU可能在这里暴露出脆弱点。
⚡ 关键在于:所称的“100倍英伟达效率”目前仍是推断,并非商业验证。野心与可证实证据之间的落差,正是聪明资金寻找催化剂的地方。💬 这是新一轮AI硬件周期的开端,还是一个尚未被证实的叙事? 👇
⚠️ 非财务建议。请务必管理好你的风险。🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
🚨 $AI INFERENCE SHIFT: 再押注GPU垄断,押注2亿欧元 ⚡
Euclyd 的2亿欧元A轮融资由三星、EQT和Somerset共同领投,这是一票“结构性”看多:AI推理将成为下一个瓶颈。📊 它的16,384个内存中处理器以及面向2028年的 2028 exaflop 路线图,正着力于打击电力效率这一层——而GPU可能在这里暴露出脆弱点。
⚡ 关键在于:所称的“100倍英伟达效率”目前仍是推断,并非商业验证。野心与可证实证据之间的落差,正是聪明资金寻找催化剂的地方。💬 这是新一轮AI硬件周期的开端,还是一个尚未被证实的叙事? 👇
⚠️ 非财务建议。请务必管理好你的风险。🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
Euclyd 的2亿欧元A轮融资由三星、EQT和Somerset共同领投,这是一票“结构性”看多:AI推理将成为下一个瓶颈。📊 它的16,384个内存中处理器以及面向2028年的 2028 exaflop 路线图,正着力于打击电力效率这一层——而GPU可能在这里暴露出脆弱点。
⚡ 关键在于:所称的“100倍英伟达效率”目前仍是推断,并非商业验证。野心与可证实证据之间的落差,正是聪明资金寻找催化剂的地方。💬 这是新一轮AI硬件周期的开端,还是一个尚未被证实的叙事? 👇
⚠️ 非财务建议。请务必管理好你的风险。🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
39
·
--
SpaceX即将发布的报告不仅仅是企业新闻;它突显了私营“黑箱”与$ETH 和$BTC 所代表的理念之间的冲突。
集中化的公司要求在董事会“算账”上盲目信任。去中心化的协议则迫使代码用事实证明每一项主张。对你自己的资产负债表进行独立审计,才是确保这个市场中真正安全的唯一方式。
$ETH $BTC #Web3 #Inference #DeFi
SpaceX即将发布的报告不仅仅是企业新闻;它突显了私营“黑箱”与$ETH 和$BTC 所代表的理念之间的冲突。
集中化的公司要求在董事会“算账”上盲目信任。去中心化的协议则迫使代码用事实证明每一项主张。对你自己的资产负债表进行独立审计,才是确保这个市场中真正安全的唯一方式。
$ETH $BTC #Web3 #Inference #DeFi
集中化的公司要求在董事会“算账”上盲目信任。去中心化的协议则迫使代码用事实证明每一项主张。对你自己的资产负债表进行独立审计,才是确保这个市场中真正安全的唯一方式。
$ETH $BTC #Web3 #Inference #DeFi
65

·
--
⚡ $FET AI 推理瓶颈转向内存带宽:随着机构重组基础设施而改变动力! 📊
机构算力需求正在从单纯的内存容量,转向对超高效率带宽编排的追求。📊 随着 MoE 架构占据主导地位,Prefill 与 Decode 流水线之间的路由速度,已成为下一代硬件基础设施的核心瓶颈。
分层 KV 缓存调度与带宽吞吐量如今决定了集群效率,而非仅取决于原始硬件密度。🔍 聪明资金正在围绕基础设施协议布局,以在下一轮扩容之前优化数据移动开销。
💡 解耦节点架构正在逼迫对机构级硬件分配策略进行彻底改造。💬 带宽优化协议能否捕捉去中心化计算中的下一次结构性轮转?👇
⚠️ 不是财务建议。请始终管理好你的风险。🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
⚡ $FET AI 推理瓶颈转向内存带宽:随着机构重组基础设施而改变动力! 📊
机构算力需求正在从单纯的内存容量,转向对超高效率带宽编排的追求。📊 随着 MoE 架构占据主导地位,Prefill 与 Decode 流水线之间的路由速度,已成为下一代硬件基础设施的核心瓶颈。
分层 KV 缓存调度与带宽吞吐量如今决定了集群效率,而非仅取决于原始硬件密度。🔍 聪明资金正在围绕基础设施协议布局,以在下一轮扩容之前优化数据移动开销。
💡 解耦节点架构正在逼迫对机构级硬件分配策略进行彻底改造。💬 带宽优化协议能否捕捉去中心化计算中的下一次结构性轮转?👇
⚠️ 不是财务建议。请始终管理好你的风险。🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
机构算力需求正在从单纯的内存容量,转向对超高效率带宽编排的追求。📊 随着 MoE 架构占据主导地位,Prefill 与 Decode 流水线之间的路由速度,已成为下一代硬件基础设施的核心瓶颈。
分层 KV 缓存调度与带宽吞吐量如今决定了集群效率,而非仅取决于原始硬件密度。🔍 聪明资金正在围绕基础设施协议布局,以在下一轮扩容之前优化数据移动开销。
💡 解耦节点架构正在逼迫对机构级硬件分配策略进行彻底改造。💬 带宽优化协议能否捕捉去中心化计算中的下一次结构性轮转?👇
⚠️ 不是财务建议。请始终管理好你的风险。🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
241

·
--
$AI 基础设施成本因推理需求扩张而上涨 ⚡
花旗集团表示,AI推理需求仍然火热,压力已不再仅限于最新的芯片。稀缺性正在蔓延到GPU、数据中心、电力接入和路由层,这意味着市场现在正在为整个栈定价,而不仅仅是半导体。
关键要点在于结构性:模型供应商的货币化速度加快,而基础设施瓶颈正成为真正的制约因素。如果这一趋势持续,价值可能会继续向那些有助于降低推理成本并更有效地分配计算资源的层级旋转。
非金融建议。管理好你的风险。
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
$AI 基础设施成本因推理需求扩张而上涨 ⚡
花旗集团表示,AI推理需求仍然火热,压力已不再仅限于最新的芯片。稀缺性正在蔓延到GPU、数据中心、电力接入和路由层,这意味着市场现在正在为整个栈定价,而不仅仅是半导体。
关键要点在于结构性:模型供应商的货币化速度加快,而基础设施瓶颈正成为真正的制约因素。如果这一趋势持续,价值可能会继续向那些有助于降低推理成本并更有效地分配计算资源的层级旋转。
非金融建议。管理好你的风险。
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
花旗集团表示,AI推理需求仍然火热,压力已不再仅限于最新的芯片。稀缺性正在蔓延到GPU、数据中心、电力接入和路由层,这意味着市场现在正在为整个栈定价,而不仅仅是半导体。
关键要点在于结构性:模型供应商的货币化速度加快,而基础设施瓶颈正成为真正的制约因素。如果这一趋势持续,价值可能会继续向那些有助于降低推理成本并更有效地分配计算资源的层级旋转。
非金融建议。管理好你的风险。
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
64
登录解锁更多内容
加入币安广场,与全球加密货币用户互动
⚡️ 获取关于加密货币的最新实用信息。
💬 受到全球最大加密货币交易平台的信赖。
👍 发现来自认证创作者的真知灼见。
邮箱/手机号码
热门话题
1
#英伟达正物色新CEO,谁会接替黄仁勋?
215,419 次浏览
357 人讨论中
2
#加密美股齐跌,下轮反弹的驱动力在哪?
742,872 次浏览
1,844 人讨论中
3
#TONStrategy第三季度净亏损2397万美元
17,991 次浏览
80 人讨论中
4
#美国PPI年率6.5%,低于预期或缓解BTC压力
339,384 次浏览
705 人讨论中
5
#波卡社区以97%票数通过新战略
20,576 次浏览
42 人讨论中
6
#dYdX拟通过v9.9升级将USDC转向Injective
8,114 次浏览
63 人讨论中
7
#新人宝典:从零了解TradFi
1.9M 次浏览
1,266 人讨论中
8
#MANTRA因Keplr安全事件暂停解除质押7天
31,410 次浏览
265 人讨论中
9
#比特币Core披露Tor流量漏洞
60,486 次浏览
351 人讨论中
10
#比特币跌破200周均线
451,866 次浏览
1,076 人讨论中