
 Một điều mà tôi nghĩ thị trường vẫn hiểu sai về trí tuệ nhân tạo là các công ty không thực sự tối ưu hóa cho trí thông minh.
Họ đang tối ưu hóa để sống sót.
Nghe có vẻ bi quan cho đến khi bạn xem cách mà các quyết định công nghệ doanh nghiệp thực sự được đưa ra.
Các hội đồng không quan tâm liệu một mô hình có ấn tượng về triết lý hay không. Các phòng pháp lý không quan tâm liệu kiến trúc có thanh lịch hay không. Các đội tuân thủ không thức dậy với sự hào hứng về các tiêu chuẩn lý luận tiên phong. Hầu hết các tập đoàn cuối cùng chỉ quan tâm đến một điều duy nhất:
Liệu hệ thống này có thể tạo ra giá trị mà không đồng thời tạo ra mức phơi bày không thể kiểm soát về sau không?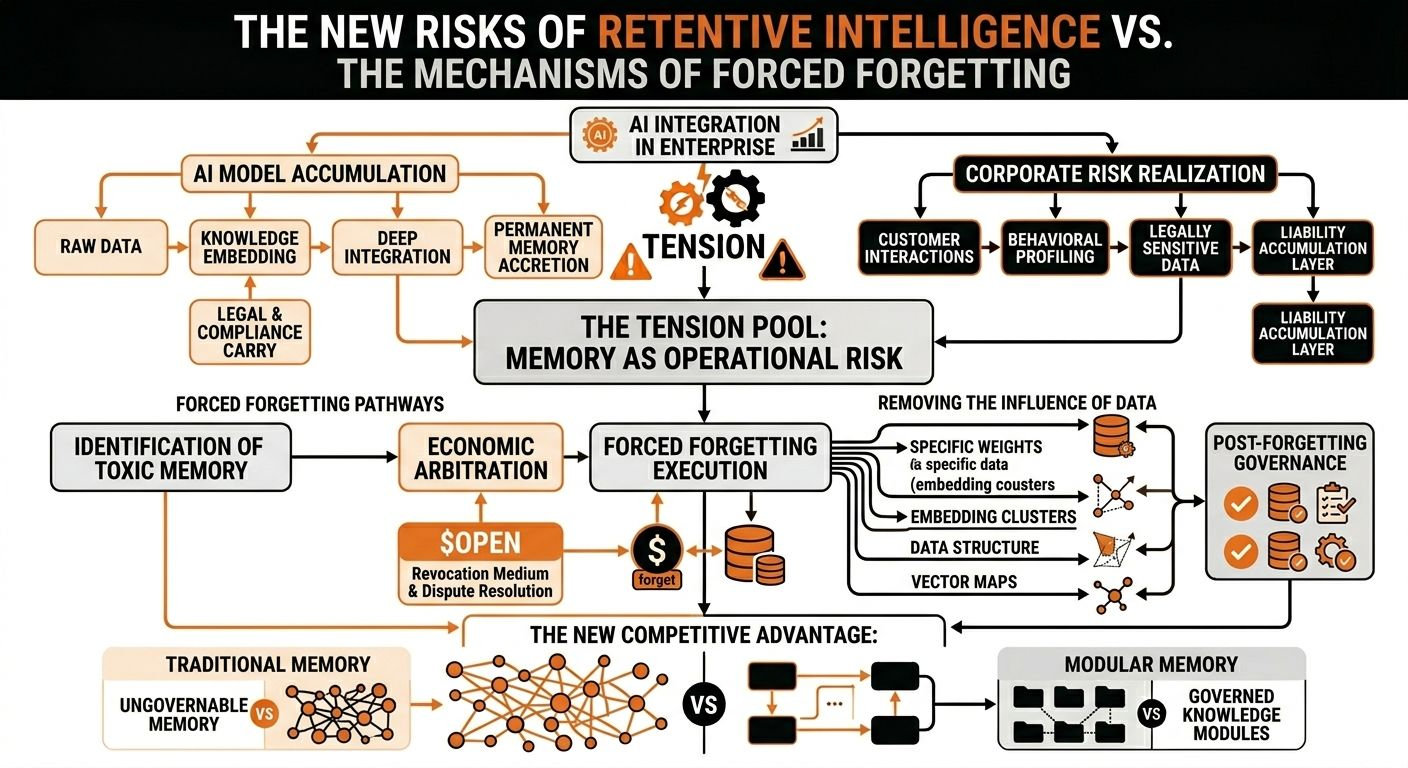
Vì vậy OpenLedger càng khiến tôi thấy thú vị hơn khi tôi đào sâu về hướng đi của AI doanh nghiệp.
Phần lớn mọi người vẫn nhìn OpenLedger qua lăng kính quen thuộc về AI phi tập trung. Người đóng góp dữ liệu, hệ thống gắn nhãn/ghi nhận xuất xứ, Datanets, phối hợp mô hình, khuyến khích token thông qua $OPEN. Được thôi. Cách hiểu ở bề mặt này hiện hữu.
Nhưng tôi ngày càng nghi ngờ rằng lớp quan trọng hơn lại là một thứ hoàn toàn khác.
OpenLedger có thể đang định vị quanh một tương lai mà sự “quên có chọn lọc” trở thành chiến lược kinh tế.
Bởi vì thị trường AI hiện tại vẫn bị mắc kẹt trong tâm lý tích lũy. Mỗi công ty đều tin lợi thế cạnh tranh đến từ việc giữ càng nhiều thông tin càng tốt. Tương tác với khách hàng nhiều hơn. Các mẫu hành vi nhiều hơn. Hồ sơ lịch sử nhiều hơn. Ngữ cảnh độc quyền nhiều hơn.
Giả định nằm dưới chiến lược này rất đơn giản: càng nhiều trí nhớ thì càng có trí tuệ tốt hơn.
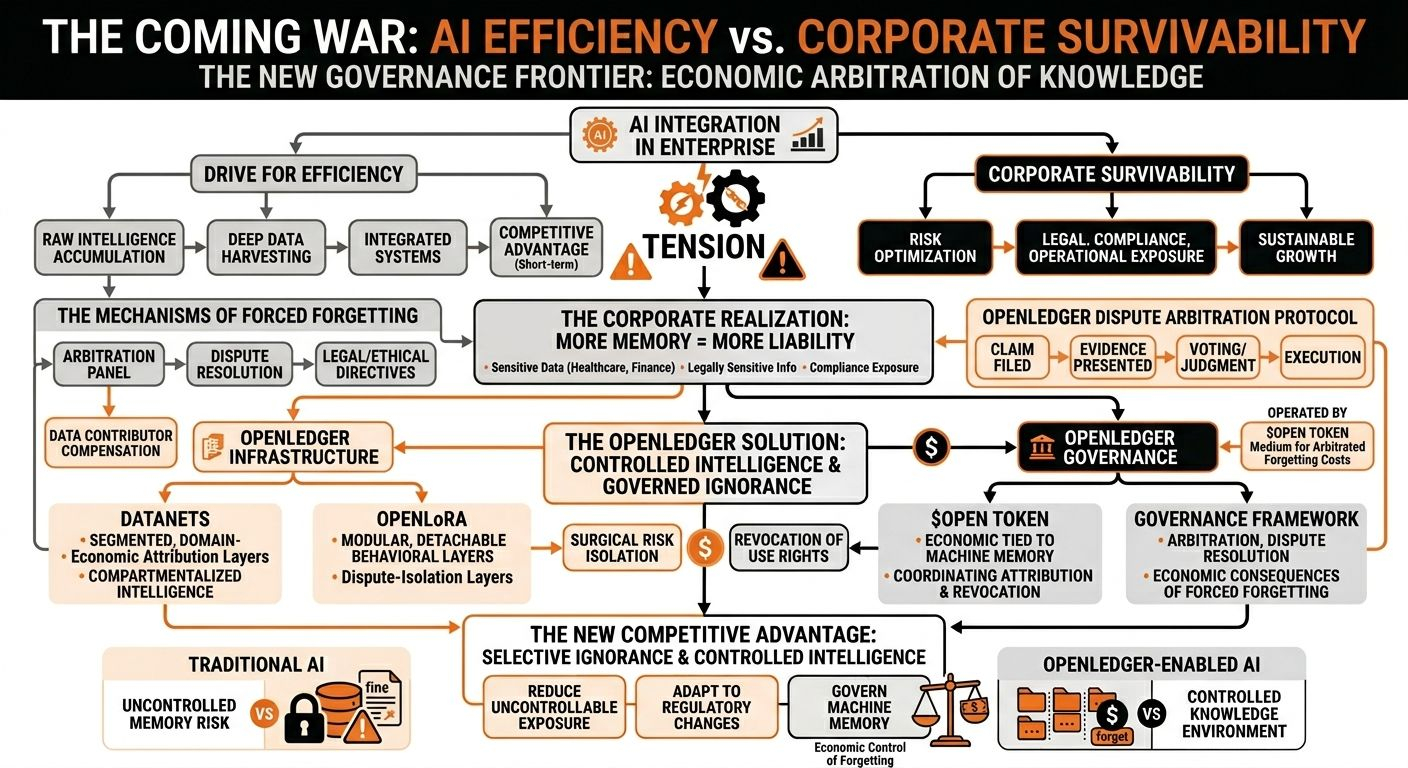
Nhưng logic đó lặng lẽ sụp đổ ngay khi chính trí nhớ bắt đầu tạo ra rủi ro pháp lý, rủi ro vận hành và rủi ro tài chính nhanh hơn so với lượng giá trị mà nó tạo ra.
Và nói thật, tôi nghĩ nhiều doanh nghiệp đã tiến gần hơn đến nhận thức đó so với mức mà thị trường công khai hiểu.
Hiện tại, hầu hết các hệ thống AI doanh nghiệp vẫn đang vận hành trong những môi trường tương đối được kiểm soát. Trợ lý nội bộ (internal copilots). Bổ trợ dịch vụ chăm sóc khách hàng. Tự động hóa quy trình làm việc. Hỗ trợ phân tích. Nhưng khi AI đi sâu vào các ngành được quản lý và hạ tầng mang tính quyết định, thì trí tuệ được giữ lại trở nên nguy hiểm hơn.
Bởi vì trí nhớ doanh nghiệp không hề trung lập.
Một mô hình y tế giữ lại ngữ cảnh chẩn đoán nhạy cảm không chỉ đơn thuần là “thông minh”. Nó đang mang rủi ro trách nhiệm pháp lý. Một hệ thống tư vấn tài chính được huấn luyện từ nhiều năm dữ liệu hành vi của khách hàng không chỉ đơn thuần là cá nhân hóa. Nó đang tích lũy rủi ro tuân thủ. Một tác nhân doanh nghiệp tiếp nhận các trao đổi nội bộ có thể vô tình trở thành một kho lưu trữ vĩnh viễn của thông tin nhạy cảm về mặt pháp lý.
Và phần thực sự khó chịu là thế này:
Hầu hết các hệ thống AI về mặt cấu trúc đều kém trong việc quên sạch sẽ.
Điều đó tạo ra một tương lai khá kỳ lạ, nơi các doanh nghiệp cuối cùng có thể cạnh tranh ít hơn về việc hệ thống của họ biết được bao nhiêu…
và chi tiết hơn là về việc họ có thể kiểm soát chính xác những hệ thống đó được phép tiếp tục biết điều gì.
Sự khác biệt đó hiện đang bị định giá quá thấp một cách đáng kể.
Bởi vì một khi dữ liệu đã được “nhúng” xuyên qua nhiều lớp đã tinh chỉnh (fine-tuned), hệ thống truy xuất, không gian vector và ngay cả hành vi của mô hình, thì việc xóa không còn vận hành như kiểu xóa phần mềm truyền thống nữa. Doanh nghiệp đang dần phát hiện rằng “loại bỏ dữ liệu” và “loại bỏ ảnh hưởng của dữ liệu” là hoàn toàn khác nhau về bài toán kỹ thuật.
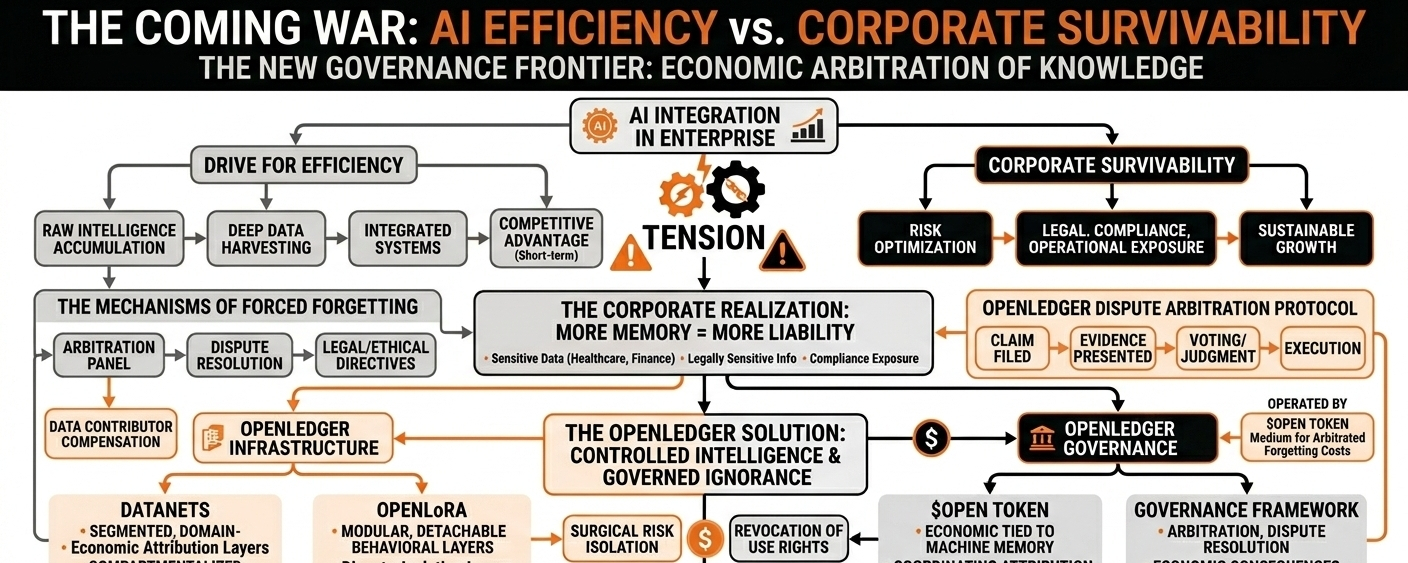
Đó là lúc OpenLedger bắt đầu trông giống ít hơn một thị trường dữ liệu phi tập trung và giống nhiều hơn một lớp hạ tầng để phân khoang rủi ro cho doanh nghiệp.
Kiến trúc Datanet thú vị chính vì lý do đó. Thay vì coi trí tuệ là một “bể nhớ” khổng lồ không phân biệt, cấu trúc này đẩy theo hướng những môi trường tri thức được phân mảnh và chuyên biệt theo miền, gắn với khả năng quy kết (attribution) và trách nhiệm giải trình về kinh tế.
Thoạt nhìn, điều đó có vẻ kém hiệu quả hơn so với cách tích lũy tập trung theo kiểu “bạo lực” (brute-force).
Về lâu dài, có thể nó sẽ trở nên cần thiết về mặt vận hành.
Bởi vì trí tuệ được phân khoang sẽ dễ quản trị hơn trí nhớ tổng quát vĩnh viễn.
Cũng vì vậy mà OpenLoRA có vẻ quan trọng hơn rất nhiều so với điều mà hầu hết mọi người hiện đang nhận ra. Thị trường thường đóng khung nó như một lớp hiệu quả để triển khai các thích nghi mô hình nhẹ (lightweight) một cách rẻ. Nhưng hàm ý sâu hơn là tính linh hoạt về kiến trúc.
Nếu trí tuệ có thể được chia mô-đun, thì nó cũng có thể được tách rời.
Điều đó làm thay đổi toàn bộ kinh tế học của rủi ro AI doanh nghiệp.
Một tập đoàn không còn cần phải huấn luyện lại toàn bộ hệ thống nền tảng mỗi khi khung pháp lý thay đổi hoặc khi một tập dữ liệu trở nên có vấn đề. Các lớp hành vi cụ thể theo lý thuyết có thể được cô lập, tách rời, thay thế, hoặc bị “ngừng sử dụng” về mặt kinh tế.
Nói cách khác, OpenLoRA không chỉ giúp AI chuyên biệt hóa.
Nó đang giúp AI trở nên có thể “loại bỏ” có chọn lọc.
Sau này có thể nó sẽ trở nên cực kỳ có giá trị.
Đặc biệt vì doanh nghiệp hiếm khi tối ưu vì lý tưởng. Họ tối ưu cho mức độ phơi bày rủi ro có thể kiểm soát. Khả năng cô lập rủi ro vận hành một cách tinh gọn mà không làm sập toàn bộ chồng hệ thống là thứ mà các tập đoàn trong lịch sử luôn trả giá rất cao để có.
Và điều đó đưa tôi quay lại với $OPEN chính nó.
Tôi nghĩ đa số mọi người vẫn đang định giá token theo logic hạ tầng crypto tiêu chuẩn: dùng càng nhiều, giao dịch càng nhiều, hoạt động hệ sinh thái càng nhiều, nhu cầu càng tăng.
Có lẽ.
Nhưng khả năng thú vị hơn là $OPEN gắn kết về mặt kinh tế với chính việc quản trị trí nhớ máy móc. Không chỉ tạo điều kiện cho luồng trí tuệ, mà còn phối hợp chi phí, khả năng quy kết (attribution), tính bền vững và cuối cùng là việc loại bỏ các lớp trí tuệ hoạt động xuyên suốt hệ thống doanh nghiệp.
Đó là một thị trường còn lạ hơn rất nhiều so với những gì mọi người nhận ra.
Bởi vì một khi trí nhớ mang trọng lượng tài chính và pháp lý, thì hạ tầng AI không còn thuần túy là vấn đề kỹ thuật nữa.
Nó trở thành vấn đề chính trị.
Ai nắm quyền thu hồi (revocation rights)?
Ai đứng ra phân xử tranh chấp giữa người đóng góp và doanh nghiệp?
Ai quyết định khi nào trí tuệ được giữ lại trở nên không an toàn?
Ai sẽ là người gánh hậu quả kinh tế của việc buộc phải quên?
Những xung đột đó không có câu trả lời rõ ràng.
Và nói thật, chính vì điều đó mà lĩnh vực này cảm giác quan trọng về mặt cấu trúc.
Thị trường AI vẫn vận hành như thể trí tuệ thô vẫn là nguồn lực khan hiếm.
Tôi ngày càng nghĩ trí tuệ có kiểm soát sẽ trở nên khan hiếm hơn.
Điều đó thay đổi lớp hạ tầng nào trở nên quan trọng nhất.
OpenLedger có thể hoàn toàn thất bại. Hầu hết các giao thức hạ tầng đều vậy. Chỉ riêng độ phức tạp vận hành thôi đã là một thách thức nghiêm trọng. Doanh nghiệp có thể vẫn tiếp tục thích sự mờ đục tập trung chỉ vì nó dễ và nhanh hơn.
Nhưng nếu các hệ thống AI cuối cùng được tích hợp sâu đến mức trí nhớ không thể kiểm soát biến thành rủi ro mang tính thể chế…
…thì các công ty có khả năng quản trị sự “mù lòa” của máy móc có thể sẽ trở nên có giá trị hơn những công ty chỉ đơn thuần xây dựng máy móc thông minh hơn.
Và OpenLedger ngày càng giống như một trong số ít dự án đang xây dựng xoay quanh chính sự giằng co trong tương lai đó, trước khi thị trường nhìn thấy nó hoàn toàn.
#OpenLedger #openledger $BSB @OpenLedger
#BitcoinBreaksBelow75KAsWarshTakesFedHelm #FenwickWestSettlesFTXFor54M #SECHaltsInnovationExemption