
#axis
axis
2,409 views
26 සාකච්ඡා කරමින්
උණුසුම්
නවතම


·
--
අර්ධ වශයෙන් සත්යයි
පරිවර්තනය බලන්න
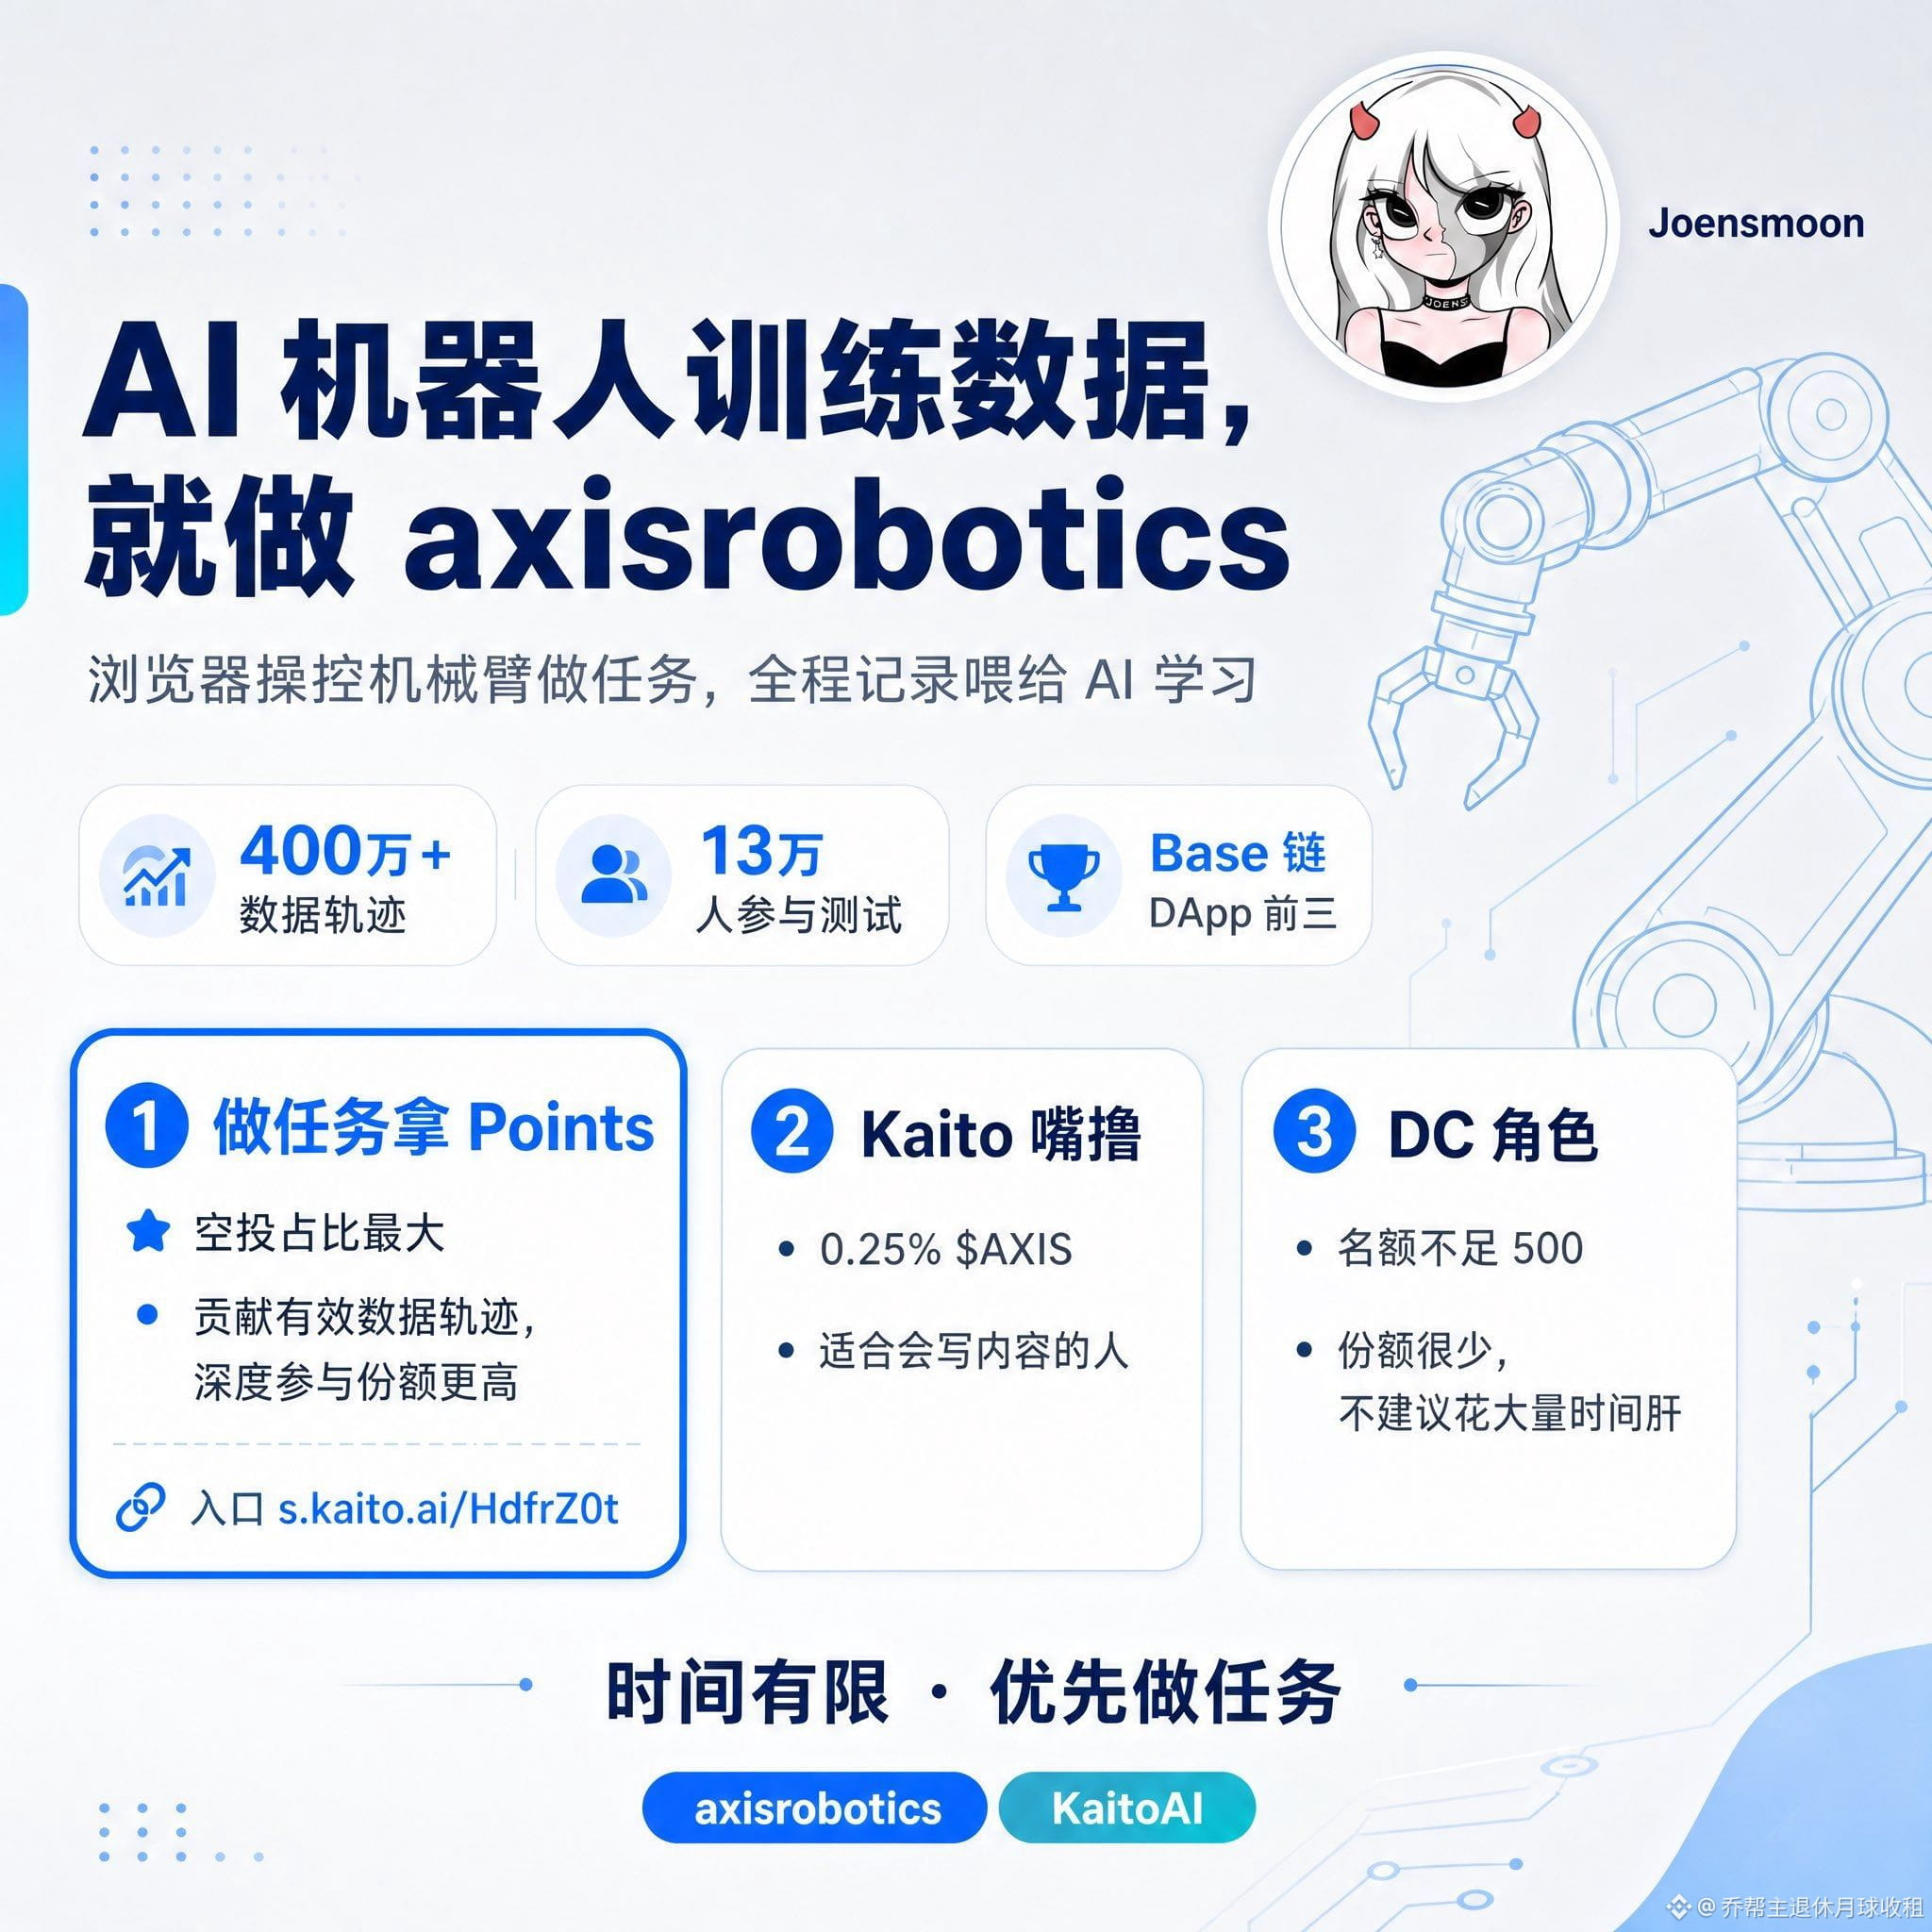
话说做机器人训练数据的就@axisrobotics这一个项目
目前有400万+条轨迹 13万人在做测试
是Base链DApp前三名,币安钱包活动也快了
平时只需要把浏览器操控机械臂完成任务 操作全程记录下来给AI机器人学 数据轨迹就是它赚钱的
参与的三种方式: 👇👇👇
▎做任务拿Points(空投占比最大)
贡献有效数据轨迹 深度参与和随便做几条 份额差很多
入口:http://s.kaito.ai/HdfrZ0t
▎Kaito嘴撸(0.25% $AXIS)
适合会写内容的人 我自己也在参与
▎DC角色(份额很少)
不到500个名额 不建议花大量时间肝
⸻
时间有限 优先做任务
@axisrobotics @KaitoAI
#AXIS
话说做机器人训练数据的就@axisrobotics这一个项目
目前有400万+条轨迹 13万人在做测试
是Base链DApp前三名,币安钱包活动也快了
平时只需要把浏览器操控机械臂完成任务 操作全程记录下来给AI机器人学 数据轨迹就是它赚钱的
参与的三种方式: 👇👇👇
▎做任务拿Points(空投占比最大)
贡献有效数据轨迹 深度参与和随便做几条 份额差很多
入口:http://s.kaito.ai/HdfrZ0t
▎Kaito嘴撸(0.25% $AXIS)
适合会写内容的人 我自己也在参与
▎DC角色(份额很少)
不到500个名额 不建议花大量时间肝
⸻
时间有限 优先做任务
@axisrobotics @KaitoAI
#AXIS
目前有400万+条轨迹 13万人在做测试
是Base链DApp前三名,币安钱包活动也快了
平时只需要把浏览器操控机械臂完成任务 操作全程记录下来给AI机器人学 数据轨迹就是它赚钱的
参与的三种方式: 👇👇👇
▎做任务拿Points(空投占比最大)
贡献有效数据轨迹 深度参与和随便做几条 份额差很多
入口:http://s.kaito.ai/HdfrZ0t
▎Kaito嘴撸(0.25% $AXIS)
适合会写内容的人 我自己也在参与
▎DC角色(份额很少)
不到500个名额 不建议花大量时间肝
⸻
时间有限 优先做任务
@axisrobotics @KaitoAI
#AXIS
4
1.5k

පරිවර්තනය බලන්න
⚡ 1,500,000 POINTS UNLOCKED AS $AXIS RAIDS THE ON-CHAIN LIQUIDITY ARENA! 💥
📌 Axis Robotics has officially opened the vault with a massive 1,500,000 point allocation for proactive on-chain participants. Institutional automation narratives are quietly building momentum, and smart capital is stacking exposure well ahead of the crowd.
💡 Positioning early in dedicated infrastructure campaigns is how sharp traders lock in asymmetry before broad market volume rushes in. 🔍 Securing strategic positioning during silent accumulation windows often separates the top percentile from reactive chasers. 💬 Are you farming this reward pool early or waiting for mainstream momentum to catch up? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AXIS #Web3 #Airdrop #OnChain #Crypto
🔥 💎
⚡ 1,500,000 POINTS UNLOCKED AS $AXIS RAIDS THE ON-CHAIN LIQUIDITY ARENA! 💥
📌 Axis Robotics has officially opened the vault with a massive 1,500,000 point allocation for proactive on-chain participants. Institutional automation narratives are quietly building momentum, and smart capital is stacking exposure well ahead of the crowd.
💡 Positioning early in dedicated infrastructure campaigns is how sharp traders lock in asymmetry before broad market volume rushes in. 🔍 Securing strategic positioning during silent accumulation windows often separates the top percentile from reactive chasers. 💬 Are you farming this reward pool early or waiting for mainstream momentum to catch up? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AXIS #Web3 #Airdrop #OnChain #Crypto
🔥 💎
📌 Axis Robotics has officially opened the vault with a massive 1,500,000 point allocation for proactive on-chain participants. Institutional automation narratives are quietly building momentum, and smart capital is stacking exposure well ahead of the crowd.
💡 Positioning early in dedicated infrastructure campaigns is how sharp traders lock in asymmetry before broad market volume rushes in. 🔍 Securing strategic positioning during silent accumulation windows often separates the top percentile from reactive chasers. 💬 Are you farming this reward pool early or waiting for mainstream momentum to catch up? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AXIS #Web3 #Airdrop #OnChain #Crypto
🔥 💎
20

පරිවර්තනය බලන්න
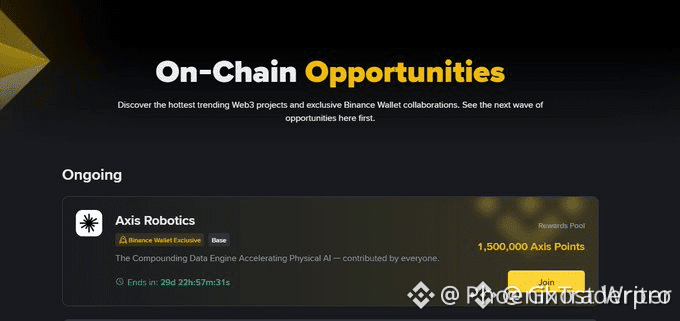
🚨 INSTITUTIONAL YIELD UNLOCKED AS $AXIS LAUNCHES EXCLUSIVE WEB3 ECOSYSTEM CAMPAIGN! ⚡
Smart money recognizes that early yield initiatives often precede major liquidity expansion. The exclusive Web3 Wallet campaign with Axis Robotics unlocks a strategic incentive pool of 1,500,000 Axis points to reward active on-chain participants. 🔍
Sophisticated capital is already positioning to capture structural yield parameters before secondary market velocity picks up. 📊 Tracking these strategic incentives remains crucial for mapping early institutional footprint. ⚡
💬 Are you positioning early in this yield initiative or watching from the sidelines? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AXIS #Web3 #BSC #Crypto #Yield
🎯 🦈
🚨 INSTITUTIONAL YIELD UNLOCKED AS $AXIS LAUNCHES EXCLUSIVE WEB3 ECOSYSTEM CAMPAIGN! ⚡
Smart money recognizes that early yield initiatives often precede major liquidity expansion. The exclusive Web3 Wallet campaign with Axis Robotics unlocks a strategic incentive pool of 1,500,000 Axis points to reward active on-chain participants. 🔍
Sophisticated capital is already positioning to capture structural yield parameters before secondary market velocity picks up. 📊 Tracking these strategic incentives remains crucial for mapping early institutional footprint. ⚡
💬 Are you positioning early in this yield initiative or watching from the sidelines? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AXIS #Web3 #BSC #Crypto #Yield
🎯 🦈
Smart money recognizes that early yield initiatives often precede major liquidity expansion. The exclusive Web3 Wallet campaign with Axis Robotics unlocks a strategic incentive pool of 1,500,000 Axis points to reward active on-chain participants. 🔍
Sophisticated capital is already positioning to capture structural yield parameters before secondary market velocity picks up. 📊 Tracking these strategic incentives remains crucial for mapping early institutional footprint. ⚡
💬 Are you positioning early in this yield initiative or watching from the sidelines? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AXIS #Web3 #BSC #Crypto #Yield
🎯 🦈
1
14
·
--
私は@axisroboticsを再調査したところ、むしろ
Axisが本当に注目されるべきなのは、すでにどれだけのロボットデータを持っているかではなく
それらのデータを、継続的に自己強化できるシステムへと変えていることだと感じるようになりました。
8月、Axisのrobotic data engineが3M trajectoriesを突破しました
その裏には123K+のcontributorsがいます
ですが、データが増えていくだけなら
正直、それほど“セクシー”ではありません
本当に私がAxisを見直し始めたのは
最近の一連の動きです:
Dataset V1 → Axis V2 → Booster Robotics → OpenRoboto
それらの背後にあるのは、実は同じこと——
Physical AIのData Loopを本当に動かすことです。
ロボット学習で一番難しいのは
データが不足していることだけではありません
むしろ
次のバッチで何を収集すべきかをどう知るか、です。
従来の流れは、たとえば
Task → Data → Model
学習してからデプロイ
モデルが問題を起こしてから、またデータを集めに戻る
Axis V2は、このプロセスを変え始めています。
モデルが先にタスクを実行し
モデルがweaknessを露出し
人間が重要な節目でcorrectionを行う
Correction Dataが訓練フローに戻り
モデルはさらに強くなり
その後、また新しいweaknessが現れる
つまり、
Model → Failure → Correction → Data → Better Model
これこそが、Human-Gated DAggerの本当に面白いところです。
それは、人間がモデルがすでにできる動作を延々と繰り返させることではありません。
モデルが“どうすればいいか分からない”瞬間に、人間が介入するのです。
言い換えると
単に、より多くの正解を集めるのではなく
“なぜ間違うのか”を精密に収集することです。
私は、これがロボットデータにおける非常に重要な価値の転換だと思います。
なぜなら、モデルがすでにできることに
さらに10,000回のdemonstrationを追加しても
限界価値がどんどん下がっていく可能性が高い。
一方で、モデルが何度も失敗する場所——
そここそが、次のラウンドの学習に最も必要なデータになりがちです。
だから、Axisが言うCompounding Data Engineについて、
私の理解は単にDatasetを大きくしていくことではありません。
むしろ
毎回の学習が、次のデータ収集をより正確にするのに役立つ——
それがcompoundingの本質だと思います。
そして、それがまさに最近のAxisとOpenRobotoの協業を特に注目する理由でもあります。
Axisは3M+のmultimodal trajectoriesを提供し
OpenRobotoのOpen Data Poolに投入されます。
さらに、Data-to-Model Pipelineにより
モデル評価とbenchmarkをサポートします。
これにより、クローズドループがさらに拡張され
Data → Training → Benchmark → Evaluation → Better Data
以前は私はAxisを
Robot Data Platformとして理解していました。
でも今は、より
Physical AIのData Infrastructureとして捉えるほうがしっくりきます。
ハードウェアは変わる
モデルも変わる
VLAも変わる
しかしロボットは、現実世界から新しいExperienceを得る必要がある。
だからこそ本当に観察すべきなのは
Axisが次にどれだけtrajectoriesに到達するかではなく
これらのデータが、より多くのモデル、より多くのロボット、より多くのbenchmarkで使われるようになったときに
Data Flywheelが本当にCompounding Effectを生み始めるのか——です。
もしこの循環が回り始めるなら
Axisの堀(モート)は、私たちがどれだけデータを持っているかではなく
次の、より価値の高いデータを継続的に生み出せるかどうかになります。
これが、私が現時点でAxisで最も面白いと思っている点です。
#PhysicalAI #Robotics @KaitoAI #Axis #kaito
私は@axisroboticsを再調査したところ、むしろ
Axisが本当に注目されるべきなのは、すでにどれだけのロボットデータを持っているかではなく
それらのデータを、継続的に自己強化できるシステムへと変えていることだと感じるようになりました。
8月、Axisのrobotic data engineが3M trajectoriesを突破しました
その裏には123K+のcontributorsがいます
ですが、データが増えていくだけなら
正直、それほど“セクシー”ではありません
本当に私がAxisを見直し始めたのは
最近の一連の動きです:
Dataset V1 → Axis V2 → Booster Robotics → OpenRoboto
それらの背後にあるのは、実は同じこと——
Physical AIのData Loopを本当に動かすことです。
ロボット学習で一番難しいのは
データが不足していることだけではありません
むしろ
次のバッチで何を収集すべきかをどう知るか、です。
従来の流れは、たとえば
Task → Data → Model
学習してからデプロイ
モデルが問題を起こしてから、またデータを集めに戻る
Axis V2は、このプロセスを変え始めています。
モデルが先にタスクを実行し
モデルがweaknessを露出し
人間が重要な節目でcorrectionを行う
Correction Dataが訓練フローに戻り
モデルはさらに強くなり
その後、また新しいweaknessが現れる
つまり、
Model → Failure → Correction → Data → Better Model
これこそが、Human-Gated DAggerの本当に面白いところです。
それは、人間がモデルがすでにできる動作を延々と繰り返させることではありません。
モデルが“どうすればいいか分からない”瞬間に、人間が介入するのです。
言い換えると
単に、より多くの正解を集めるのではなく
“なぜ間違うのか”を精密に収集することです。
私は、これがロボットデータにおける非常に重要な価値の転換だと思います。
なぜなら、モデルがすでにできることに
さらに10,000回のdemonstrationを追加しても
限界価値がどんどん下がっていく可能性が高い。
一方で、モデルが何度も失敗する場所——
そここそが、次のラウンドの学習に最も必要なデータになりがちです。
だから、Axisが言うCompounding Data Engineについて、
私の理解は単にDatasetを大きくしていくことではありません。
むしろ
毎回の学習が、次のデータ収集をより正確にするのに役立つ——
それがcompoundingの本質だと思います。
そして、それがまさに最近のAxisとOpenRobotoの協業を特に注目する理由でもあります。
Axisは3M+のmultimodal trajectoriesを提供し
OpenRobotoのOpen Data Poolに投入されます。
さらに、Data-to-Model Pipelineにより
モデル評価とbenchmarkをサポートします。
これにより、クローズドループがさらに拡張され
Data → Training → Benchmark → Evaluation → Better Data
以前は私はAxisを
Robot Data Platformとして理解していました。
でも今は、より
Physical AIのData Infrastructureとして捉えるほうがしっくりきます。
ハードウェアは変わる
モデルも変わる
VLAも変わる
しかしロボットは、現実世界から新しいExperienceを得る必要がある。
だからこそ本当に観察すべきなのは
Axisが次にどれだけtrajectoriesに到達するかではなく
これらのデータが、より多くのモデル、より多くのロボット、より多くのbenchmarkで使われるようになったときに
Data Flywheelが本当にCompounding Effectを生み始めるのか——です。
もしこの循環が回り始めるなら
Axisの堀(モート)は、私たちがどれだけデータを持っているかではなく
次の、より価値の高いデータを継続的に生み出せるかどうかになります。
これが、私が現時点でAxisで最も面白いと思っている点です。
#PhysicalAI #Robotics @KaitoAI #Axis #kaito
Axisが本当に注目されるべきなのは、すでにどれだけのロボットデータを持っているかではなく
それらのデータを、継続的に自己強化できるシステムへと変えていることだと感じるようになりました。
8月、Axisのrobotic data engineが3M trajectoriesを突破しました
その裏には123K+のcontributorsがいます
ですが、データが増えていくだけなら
正直、それほど“セクシー”ではありません
本当に私がAxisを見直し始めたのは
最近の一連の動きです:
Dataset V1 → Axis V2 → Booster Robotics → OpenRoboto
それらの背後にあるのは、実は同じこと——
Physical AIのData Loopを本当に動かすことです。
ロボット学習で一番難しいのは
データが不足していることだけではありません
むしろ
次のバッチで何を収集すべきかをどう知るか、です。
従来の流れは、たとえば
Task → Data → Model
学習してからデプロイ
モデルが問題を起こしてから、またデータを集めに戻る
Axis V2は、このプロセスを変え始めています。
モデルが先にタスクを実行し
モデルがweaknessを露出し
人間が重要な節目でcorrectionを行う
Correction Dataが訓練フローに戻り
モデルはさらに強くなり
その後、また新しいweaknessが現れる
つまり、
Model → Failure → Correction → Data → Better Model
これこそが、Human-Gated DAggerの本当に面白いところです。
それは、人間がモデルがすでにできる動作を延々と繰り返させることではありません。
モデルが“どうすればいいか分からない”瞬間に、人間が介入するのです。
言い換えると
単に、より多くの正解を集めるのではなく
“なぜ間違うのか”を精密に収集することです。
私は、これがロボットデータにおける非常に重要な価値の転換だと思います。
なぜなら、モデルがすでにできることに
さらに10,000回のdemonstrationを追加しても
限界価値がどんどん下がっていく可能性が高い。
一方で、モデルが何度も失敗する場所——
そここそが、次のラウンドの学習に最も必要なデータになりがちです。
だから、Axisが言うCompounding Data Engineについて、
私の理解は単にDatasetを大きくしていくことではありません。
むしろ
毎回の学習が、次のデータ収集をより正確にするのに役立つ——
それがcompoundingの本質だと思います。
そして、それがまさに最近のAxisとOpenRobotoの協業を特に注目する理由でもあります。
Axisは3M+のmultimodal trajectoriesを提供し
OpenRobotoのOpen Data Poolに投入されます。
さらに、Data-to-Model Pipelineにより
モデル評価とbenchmarkをサポートします。
これにより、クローズドループがさらに拡張され
Data → Training → Benchmark → Evaluation → Better Data
以前は私はAxisを
Robot Data Platformとして理解していました。
でも今は、より
Physical AIのData Infrastructureとして捉えるほうがしっくりきます。
ハードウェアは変わる
モデルも変わる
VLAも変わる
しかしロボットは、現実世界から新しいExperienceを得る必要がある。
だからこそ本当に観察すべきなのは
Axisが次にどれだけtrajectoriesに到達するかではなく
これらのデータが、より多くのモデル、より多くのロボット、より多くのbenchmarkで使われるようになったときに
Data Flywheelが本当にCompounding Effectを生み始めるのか——です。
もしこの循環が回り始めるなら
Axisの堀(モート)は、私たちがどれだけデータを持っているかではなく
次の、より価値の高いデータを継続的に生み出せるかどうかになります。
これが、私が現時点でAxisで最も面白いと思っている点です。
#PhysicalAI #Robotics @KaitoAI #Axis #kaito
64

$AXIS ROBOTICS သည် $12M Seed ရရှိပြီး Physical AI ၏ Oxygen ကို ထောက်ပံ့ရန် ဆင်းသက်လာသည် 🚀
📌 Smart money သည် နောက်ထပ် AI ခုန်ကျော်မှုအတွက် လမ်းကြောင်း (rails) များကို တိတ်တဆိတ် ပြင်ဆင်နေသည် — physical world နှင့် အပြန်အလှန် လုပ်ဆောင်မှုဆိုင်ရာ interaction data ဖြစ်သည်။ Axis Robotics သည် Hack VC ဦးဆောင်မှုဖြင့် $12M seed ကို လက်မှတ်ထိုးပြီး Pi Network Ventures နှင့် အခြားသူများလည်း ပါဝင်ကြသည်။ သူတို့က robotics အကြီးမားဆုံး bottleneck ကို ဖြေရှင်းနေသည်— လူသား-စက်ရုပ် အပြန်အလှန်လုပ်ဆောင်မှုမှ ရလာတဲ့ training data က ရှားပါးပြီး ခွဲစိတ်ထားသလို fragmented ဖြစ်နေခြင်း။ 🦈
💡 သူတို့၏ “Composite Data Engine” ကတော့ လက်ရှိတွင် active contributor 100K+ ရှိပြီး လစဉ် 20K+ hours အထိ real-world ပထမလူမျက်နှာစာ (first-person) ဗီဒီယို footage ကို ထုတ်လုပ်ပေးနေပြီ ဖြစ်သည်။ စမ်းသပ်မှု benchmark များ (LIBERO-Plus) တွင် သူတို့၏ dataset က baseline ထက် success rates ကို နီးပါး 5% အထိ တိုးမြှင့်ပေးခဲ့သည်။ ဒါက ရန်ပုံငွေတင်မဟုတ်ပါဘူး — AI အောက်ခံ data layer က “high-conviction” အခြေခံအဆောက်အအုံ စွမ်းရည်အသစ်ဖြစ်လာတော့မယ့် အချက်ပြမှုတစ်ခုပါ။ 📊
🤔 consumer AI ဇာတ်ကြောင်းက စျေးကွက်ထဲကို မျောလွှားဝင်လာခင် upstream plays တွေကို သင် စောင့်ကြည့်နေပါသလား၊ ဒါမှမဟုတ် tokens တွေကိုပဲ လိုက်ဖမ်းနေပါသလား? 👇
⚠️ ငွေကြေးဆိုင်ရာ အကြံပေးချက်မဟုတ်ပါ။ သင့်အန္တရာယ်ကို အမြဲ စီမံပါ။ 🛡️
🏷️ #AXIS #AI #PhysicalAI #DataInfrastructure #Crypto
🎯 🦈
$AXIS ROBOTICS သည် $12M Seed ရရှိပြီး Physical AI ၏ Oxygen ကို ထောက်ပံ့ရန် ဆင်းသက်လာသည် 🚀
📌 Smart money သည် နောက်ထပ် AI ခုန်ကျော်မှုအတွက် လမ်းကြောင်း (rails) များကို တိတ်တဆိတ် ပြင်ဆင်နေသည် — physical world နှင့် အပြန်အလှန် လုပ်ဆောင်မှုဆိုင်ရာ interaction data ဖြစ်သည်။ Axis Robotics သည် Hack VC ဦးဆောင်မှုဖြင့် $12M seed ကို လက်မှတ်ထိုးပြီး Pi Network Ventures နှင့် အခြားသူများလည်း ပါဝင်ကြသည်။ သူတို့က robotics အကြီးမားဆုံး bottleneck ကို ဖြေရှင်းနေသည်— လူသား-စက်ရုပ် အပြန်အလှန်လုပ်ဆောင်မှုမှ ရလာတဲ့ training data က ရှားပါးပြီး ခွဲစိတ်ထားသလို fragmented ဖြစ်နေခြင်း။ 🦈
💡 သူတို့၏ “Composite Data Engine” ကတော့ လက်ရှိတွင် active contributor 100K+ ရှိပြီး လစဉ် 20K+ hours အထိ real-world ပထမလူမျက်နှာစာ (first-person) ဗီဒီယို footage ကို ထုတ်လုပ်ပေးနေပြီ ဖြစ်သည်။ စမ်းသပ်မှု benchmark များ (LIBERO-Plus) တွင် သူတို့၏ dataset က baseline ထက် success rates ကို နီးပါး 5% အထိ တိုးမြှင့်ပေးခဲ့သည်။ ဒါက ရန်ပုံငွေတင်မဟုတ်ပါဘူး — AI အောက်ခံ data layer က “high-conviction” အခြေခံအဆောက်အအုံ စွမ်းရည်အသစ်ဖြစ်လာတော့မယ့် အချက်ပြမှုတစ်ခုပါ။ 📊
🤔 consumer AI ဇာတ်ကြောင်းက စျေးကွက်ထဲကို မျောလွှားဝင်လာခင် upstream plays တွေကို သင် စောင့်ကြည့်နေပါသလား၊ ဒါမှမဟုတ် tokens တွေကိုပဲ လိုက်ဖမ်းနေပါသလား? 👇
⚠️ ငွေကြေးဆိုင်ရာ အကြံပေးချက်မဟုတ်ပါ။ သင့်အန္တရာယ်ကို အမြဲ စီမံပါ။ 🛡️
🏷️ #AXIS #AI #PhysicalAI #DataInfrastructure #Crypto
🎯 🦈
📌 Smart money သည် နောက်ထပ် AI ခုန်ကျော်မှုအတွက် လမ်းကြောင်း (rails) များကို တိတ်တဆိတ် ပြင်ဆင်နေသည် — physical world နှင့် အပြန်အလှန် လုပ်ဆောင်မှုဆိုင်ရာ interaction data ဖြစ်သည်။ Axis Robotics သည် Hack VC ဦးဆောင်မှုဖြင့် $12M seed ကို လက်မှတ်ထိုးပြီး Pi Network Ventures နှင့် အခြားသူများလည်း ပါဝင်ကြသည်။ သူတို့က robotics အကြီးမားဆုံး bottleneck ကို ဖြေရှင်းနေသည်— လူသား-စက်ရုပ် အပြန်အလှန်လုပ်ဆောင်မှုမှ ရလာတဲ့ training data က ရှားပါးပြီး ခွဲစိတ်ထားသလို fragmented ဖြစ်နေခြင်း။ 🦈
💡 သူတို့၏ “Composite Data Engine” ကတော့ လက်ရှိတွင် active contributor 100K+ ရှိပြီး လစဉ် 20K+ hours အထိ real-world ပထမလူမျက်နှာစာ (first-person) ဗီဒီယို footage ကို ထုတ်လုပ်ပေးနေပြီ ဖြစ်သည်။ စမ်းသပ်မှု benchmark များ (LIBERO-Plus) တွင် သူတို့၏ dataset က baseline ထက် success rates ကို နီးပါး 5% အထိ တိုးမြှင့်ပေးခဲ့သည်။ ဒါက ရန်ပုံငွေတင်မဟုတ်ပါဘူး — AI အောက်ခံ data layer က “high-conviction” အခြေခံအဆောက်အအုံ စွမ်းရည်အသစ်ဖြစ်လာတော့မယ့် အချက်ပြမှုတစ်ခုပါ။ 📊
🤔 consumer AI ဇာတ်ကြောင်းက စျေးကွက်ထဲကို မျောလွှားဝင်လာခင် upstream plays တွေကို သင် စောင့်ကြည့်နေပါသလား၊ ဒါမှမဟုတ် tokens တွေကိုပဲ လိုက်ဖမ်းနေပါသလား? 👇
⚠️ ငွေကြေးဆိုင်ရာ အကြံပေးချက်မဟုတ်ပါ။ သင့်အန္တရာယ်ကို အမြဲ စီမံပါ။ 🛡️
🏷️ #AXIS #AI #PhysicalAI #DataInfrastructure #Crypto
🎯 🦈
18
පරිවර්තනය බලන්න
$AXIS IS GAINING TRACTION AS ROBOTICS NARRATIVES START TO HEAT UP 🤖
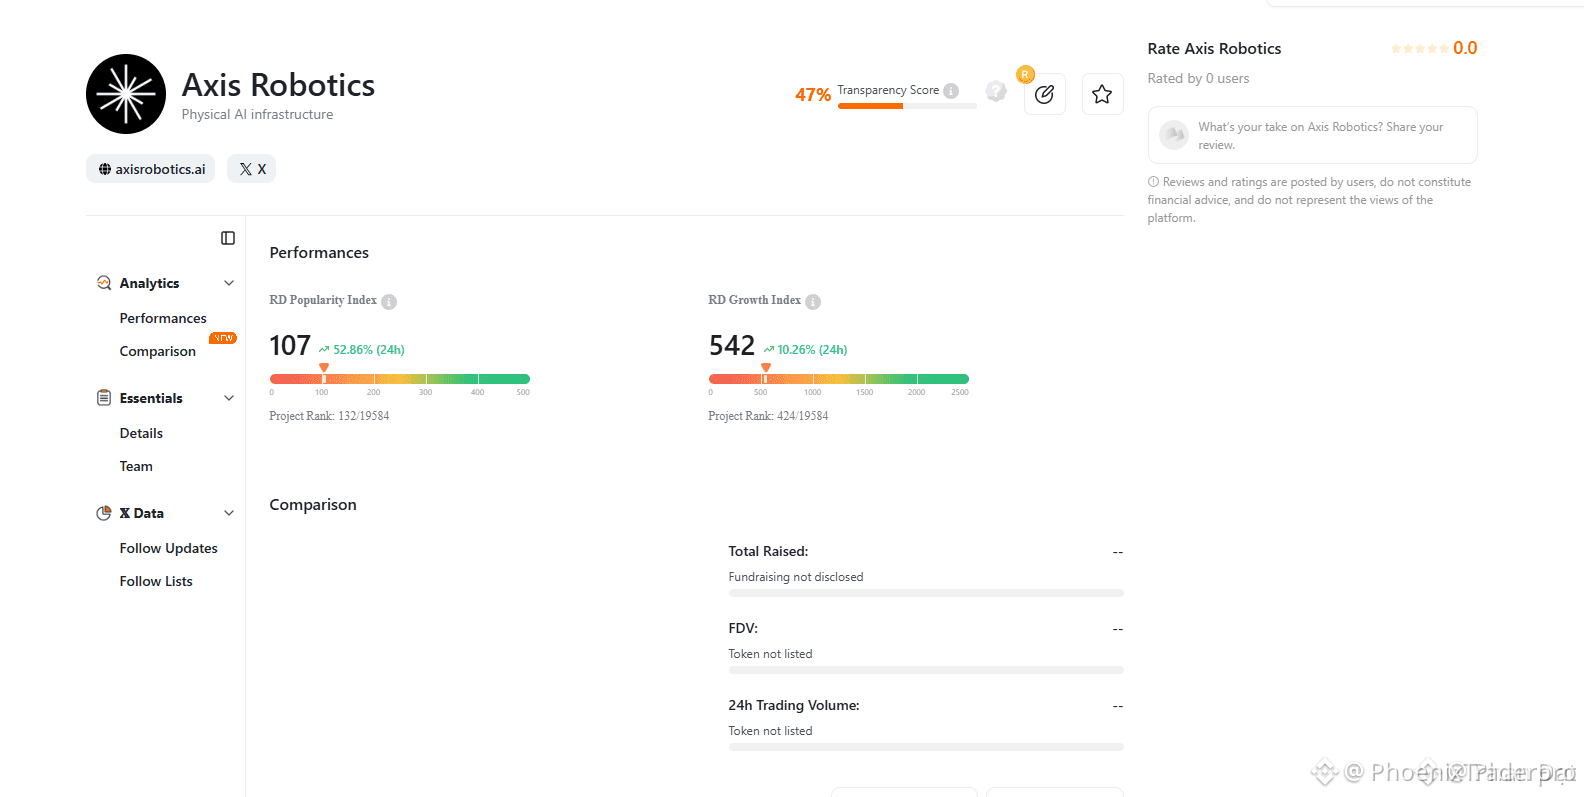
The robotics sector is showing fresh signs of life and $AXIS is currently the name popping up across my feed. Sentiment is shifting quickly as more participants begin to position themselves for potential airdrop opportunities.
I am watching the volume profile closely to see if this interest translates into a sustained move or if it is just noise. It is worth keeping an eye on the daily flows to see if the smart money is actually accumulating here.
Are you positioning for the potential airdrop or waiting for a clearer trend to emerge?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Crypto #Airdrop #Altcoins
⚡
$AXIS IS GAINING TRACTION AS ROBOTICS NARRATIVES START TO HEAT UP 🤖
The robotics sector is showing fresh signs of life and $AXIS is currently the name popping up across my feed. Sentiment is shifting quickly as more participants begin to position themselves for potential airdrop opportunities.
I am watching the volume profile closely to see if this interest translates into a sustained move or if it is just noise. It is worth keeping an eye on the daily flows to see if the smart money is actually accumulating here.
Are you positioning for the potential airdrop or waiting for a clearer trend to emerge?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Crypto #Airdrop #Altcoins
⚡
The robotics sector is showing fresh signs of life and $AXIS is currently the name popping up across my feed. Sentiment is shifting quickly as more participants begin to position themselves for potential airdrop opportunities.
I am watching the volume profile closely to see if this interest translates into a sustained move or if it is just noise. It is worth keeping an eye on the daily flows to see if the smart money is actually accumulating here.
Are you positioning for the potential airdrop or waiting for a clearer trend to emerge?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Crypto #Airdrop #Altcoins
⚡
5

·
--
පරිවර්තනය බලන්න
$AXIS ROBOTICS NARRATIVE IS BECOMING A LONG-TERM TECH CYCLE 🤖
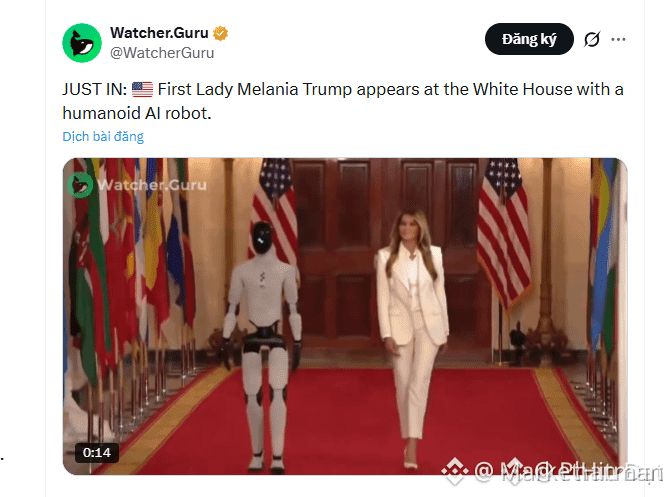
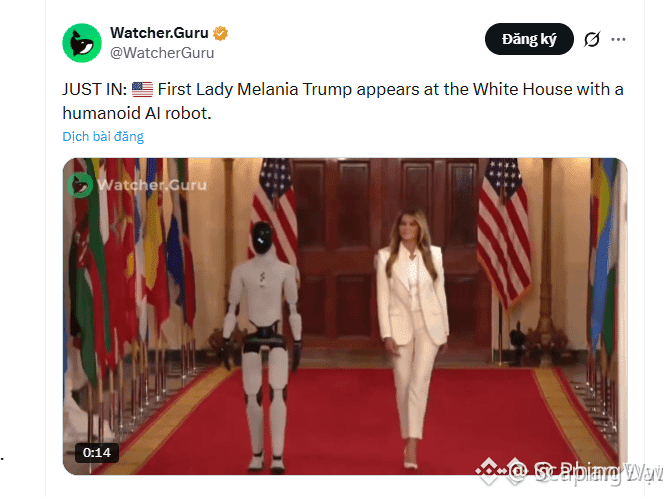
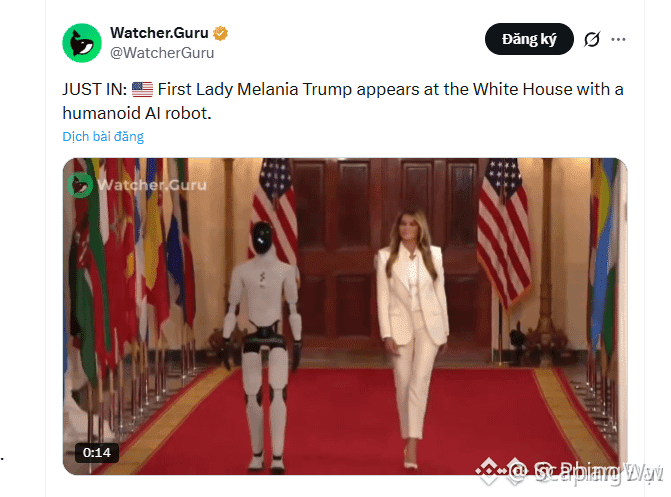
The sight of the US First Lady sharing a stage with a robot isn't a gimmick — it's a confirmation that robotics is entering a mainstream investment cycle. Projects like Axis Robotics sit at the intersection of AI, hardware, and blockchain, where real value and sustainable cash flow can emerge.
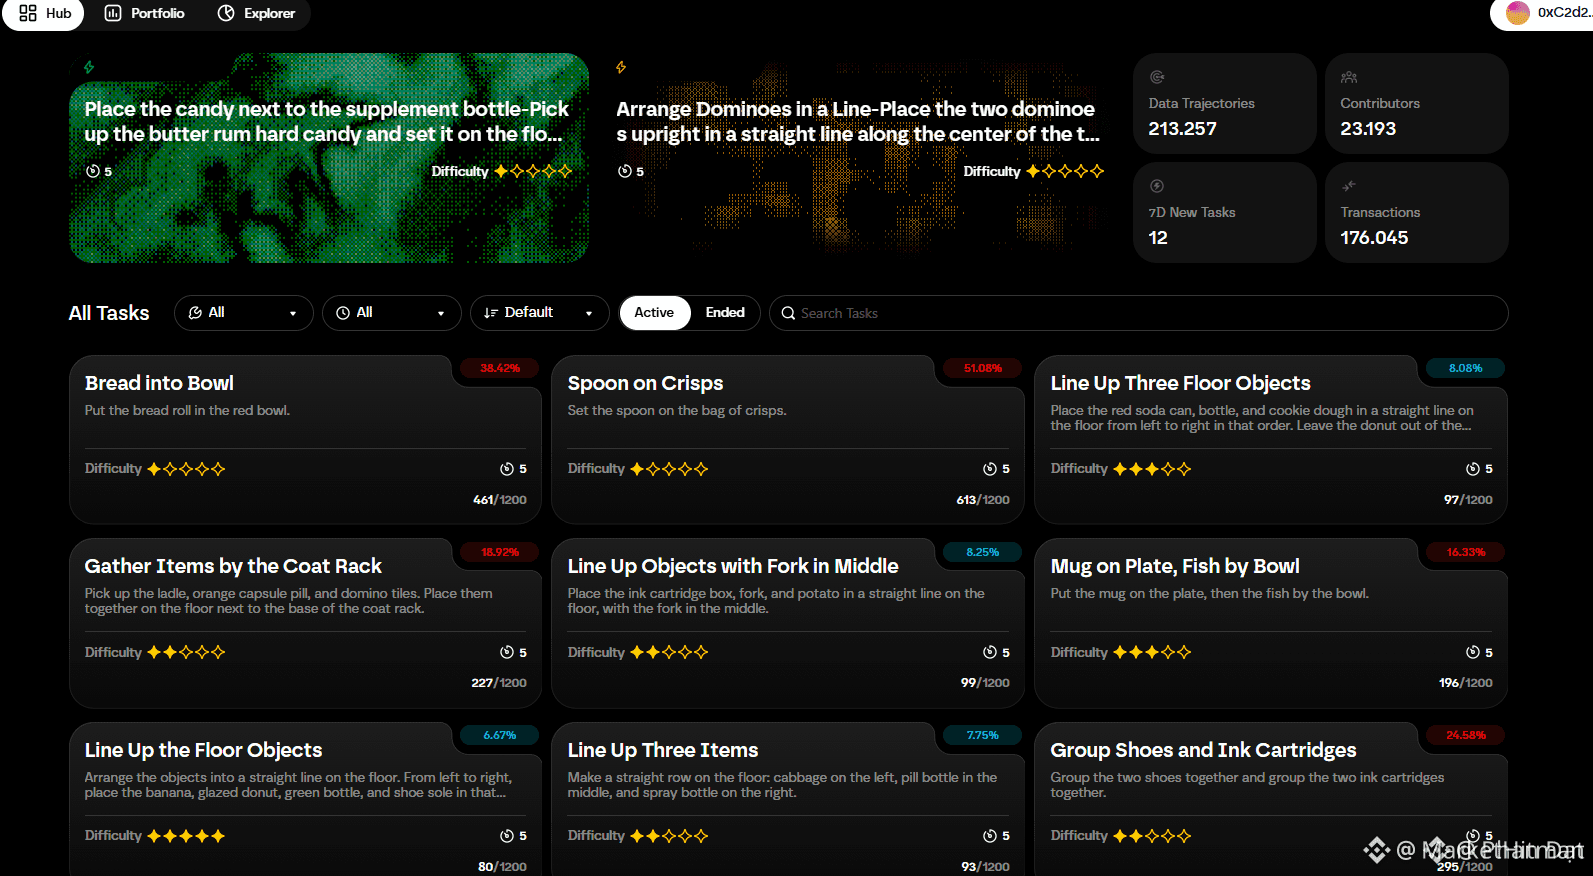
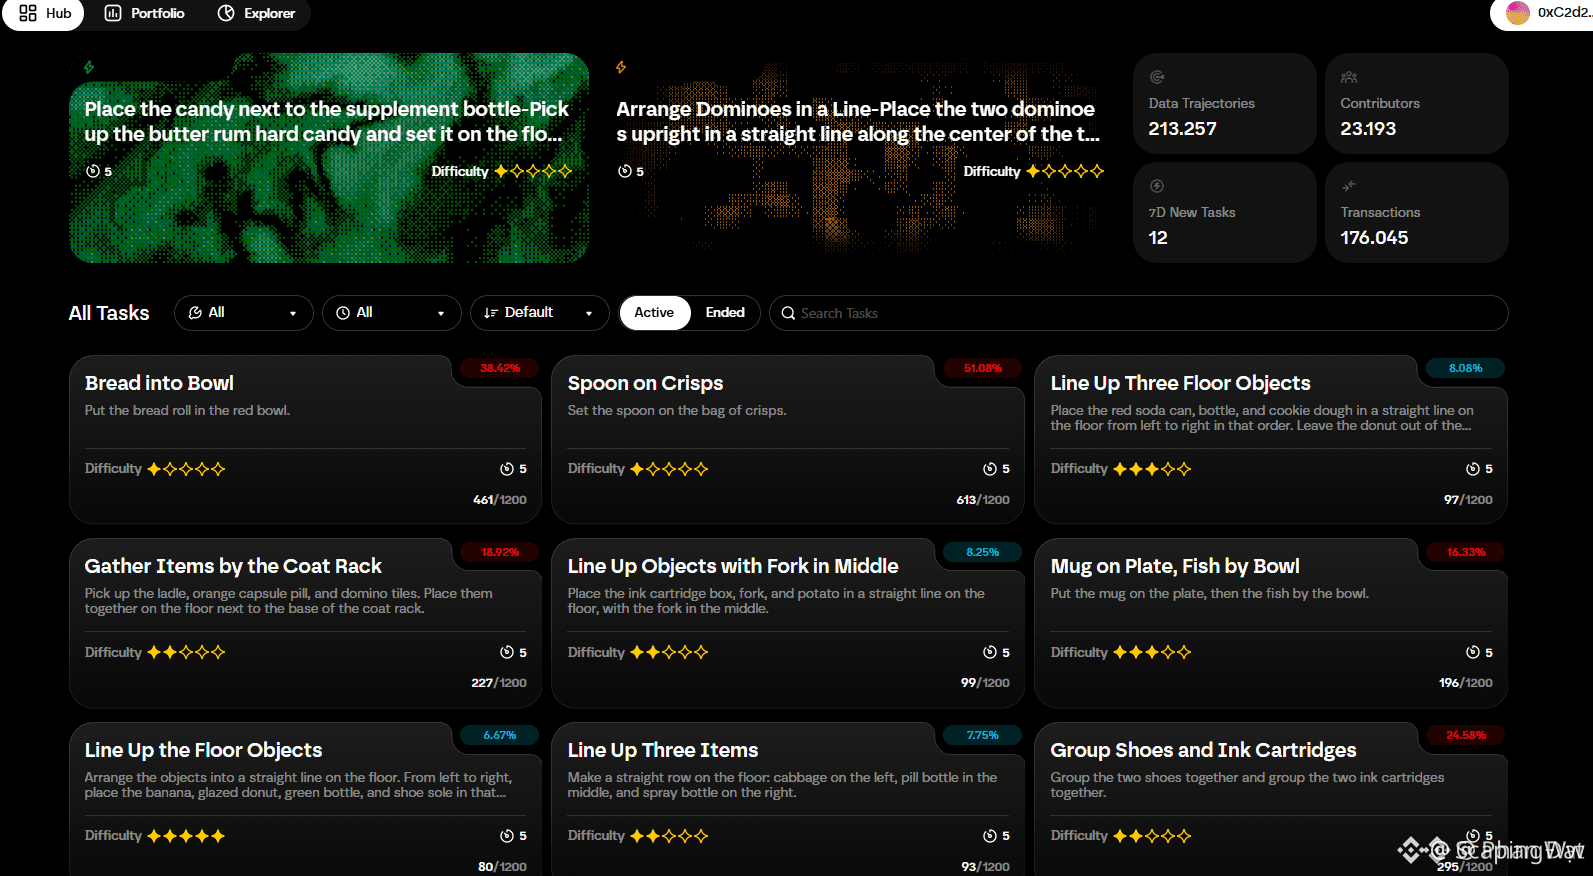
The hub tasks remain open and veteran users are already circling back to farm familiar actions. That kind of repeat activity suggests conviction, not hype. Are you treating this as a passing narrative or positioning for the long cycle?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Web3 #TechCycle #Crypto
🤖
$AXIS ROBOTICS NARRATIVE IS BECOMING A LONG-TERM TECH CYCLE 🤖
The sight of the US First Lady sharing a stage with a robot isn't a gimmick — it's a confirmation that robotics is entering a mainstream investment cycle. Projects like Axis Robotics sit at the intersection of AI, hardware, and blockchain, where real value and sustainable cash flow can emerge.
The hub tasks remain open and veteran users are already circling back to farm familiar actions. That kind of repeat activity suggests conviction, not hype. Are you treating this as a passing narrative or positioning for the long cycle?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Web3 #TechCycle #Crypto
🤖
The sight of the US First Lady sharing a stage with a robot isn't a gimmick — it's a confirmation that robotics is entering a mainstream investment cycle. Projects like Axis Robotics sit at the intersection of AI, hardware, and blockchain, where real value and sustainable cash flow can emerge.
The hub tasks remain open and veteran users are already circling back to farm familiar actions. That kind of repeat activity suggests conviction, not hype. Are you treating this as a passing narrative or positioning for the long cycle?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Web3 #TechCycle #Crypto
🤖
20

පරිවර්තනය බලන්න
$AXIS ROBOTICS HYPE REAL OR JUST AIRDROP FARMING? 🔥
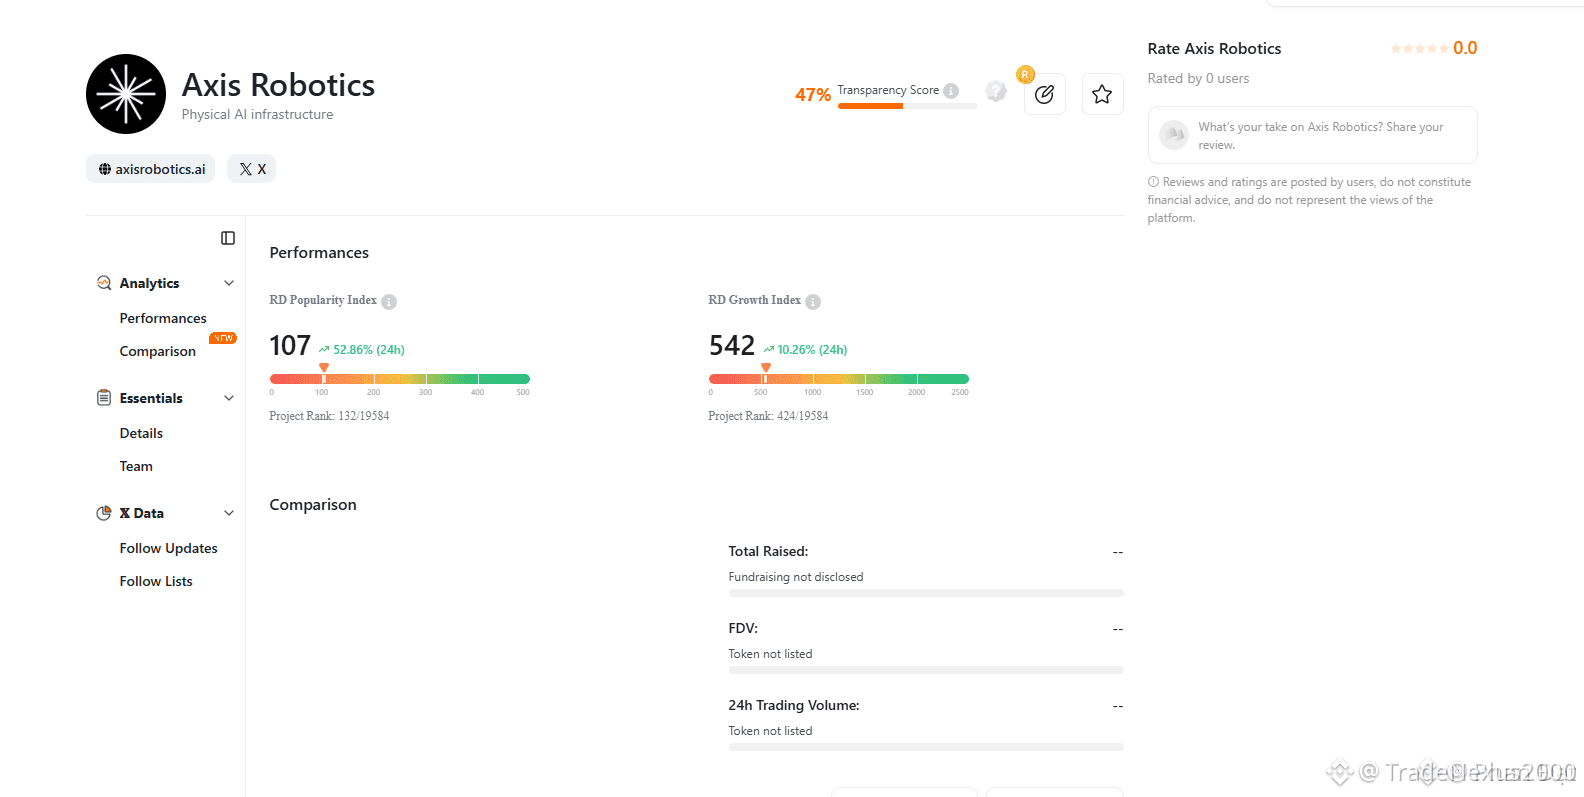
The robotics narrative is drawing serious attention, and Axis is at the center of it. Multiple KOLs are promoting the airdrop campaign, but from a market structure perspective, we need to see actual volume and liquidity before committing.
The question is whether the hype will translate into sustainable momentum or if this is just a liquidity grab for early farmers. Patience is key here. Have you looked at the order book depth yet?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Airdrop #Crypto #Trading
⚡
$AXIS ROBOTICS HYPE REAL OR JUST AIRDROP FARMING? 🔥
The robotics narrative is drawing serious attention, and Axis is at the center of it. Multiple KOLs are promoting the airdrop campaign, but from a market structure perspective, we need to see actual volume and liquidity before committing.
The question is whether the hype will translate into sustainable momentum or if this is just a liquidity grab for early farmers. Patience is key here. Have you looked at the order book depth yet?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Airdrop #Crypto #Trading
⚡
The robotics narrative is drawing serious attention, and Axis is at the center of it. Multiple KOLs are promoting the airdrop campaign, but from a market structure perspective, we need to see actual volume and liquidity before committing.
The question is whether the hype will translate into sustainable momentum or if this is just a liquidity grab for early farmers. Patience is key here. Have you looked at the order book depth yet?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Airdrop #Crypto #Trading
⚡
10
·
--
පරිවර්තනය බලන්න
🚨 $AXIS SMART MONEY STACKS $12M — THE DATA ENGINE BEHIND PHYSICAL AI IS LIVE 🦈
📌 A $12M seed round led by Hack VC signals deep institutional conviction in Axis Robotics’ data pipeline for physical AI — the backbone that robot models desperately need to scale. 💡 While most narratives chase chatbots, this team is quietly cornering the training data layer for human-robot interaction, generating over 1,200 hours of simulation data monthly with a 100K+ contributor network.
💥 Their π0.5 model already outperformed standard benchmarks by 4.9%, and partnerships with Geely, Lotus, and Booster Robotics prove enterprise adoption is accelerating. 💬 Are you watching the infrastructure layer that enables the next generation of general intelligence, or is this flying under your radar? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AXIS #PhysicalAI #Robotics #Crypto #SmartMoney
🦈 🔍
🚨 $AXIS SMART MONEY STACKS $12M — THE DATA ENGINE BEHIND PHYSICAL AI IS LIVE 🦈
📌 A $12M seed round led by Hack VC signals deep institutional conviction in Axis Robotics’ data pipeline for physical AI — the backbone that robot models desperately need to scale. 💡 While most narratives chase chatbots, this team is quietly cornering the training data layer for human-robot interaction, generating over 1,200 hours of simulation data monthly with a 100K+ contributor network.
💥 Their π0.5 model already outperformed standard benchmarks by 4.9%, and partnerships with Geely, Lotus, and Booster Robotics prove enterprise adoption is accelerating. 💬 Are you watching the infrastructure layer that enables the next generation of general intelligence, or is this flying under your radar? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AXIS #PhysicalAI #Robotics #Crypto #SmartMoney
🦈 🔍
📌 A $12M seed round led by Hack VC signals deep institutional conviction in Axis Robotics’ data pipeline for physical AI — the backbone that robot models desperately need to scale. 💡 While most narratives chase chatbots, this team is quietly cornering the training data layer for human-robot interaction, generating over 1,200 hours of simulation data monthly with a 100K+ contributor network.
💥 Their π0.5 model already outperformed standard benchmarks by 4.9%, and partnerships with Geely, Lotus, and Booster Robotics prove enterprise adoption is accelerating. 💬 Are you watching the infrastructure layer that enables the next generation of general intelligence, or is this flying under your radar? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AXIS #PhysicalAI #Robotics #Crypto #SmartMoney
🦈 🔍
12

·
--
පරිවර්තනය බලන්න
$AXIS IS POSITIONING ITSELF AS THE FRONTLINE LEADER IN THE ROBOTICS NARRATIVE 🤖
The convergence of AI, hardware, and blockchain is shifting from a niche concept to a long-term technological cycle. With global leaders now integrating robotics into the mainstream, projects like $AXIS are capturing the infrastructure layer of this transition.
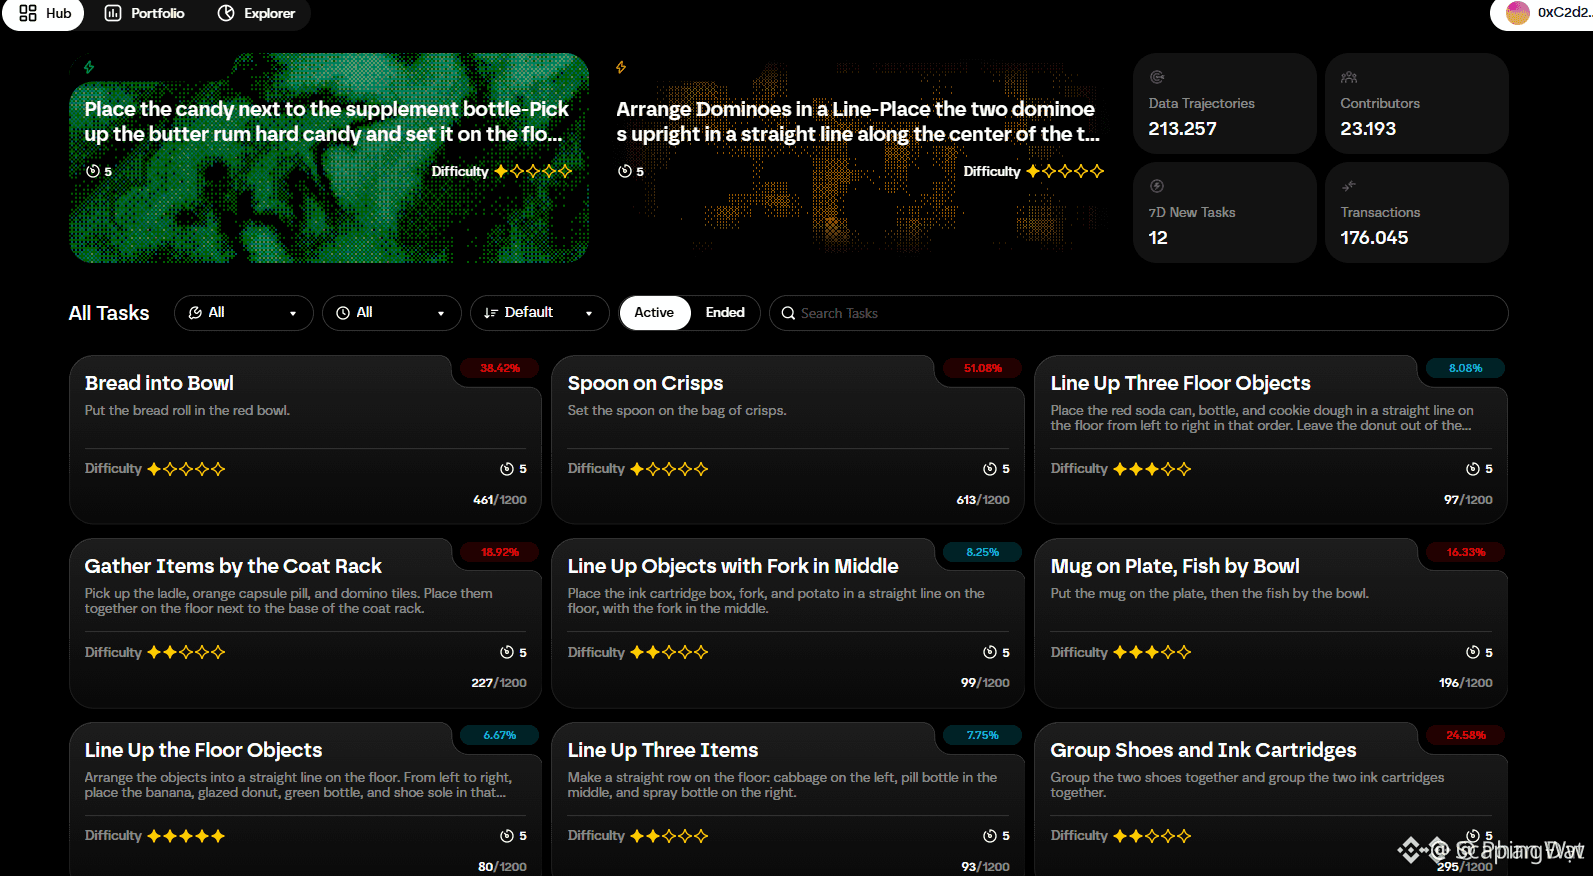
I am tracking the increased activity on the hub as they continue to open new tasks. This is not just a short-term trend but a fundamental play on real-world utility and sustainable growth. Do you see robotics as the next major sector to rotate into?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Crypto #Web3 #Altcoins
🎯
$AXIS IS POSITIONING ITSELF AS THE FRONTLINE LEADER IN THE ROBOTICS NARRATIVE 🤖
The convergence of AI, hardware, and blockchain is shifting from a niche concept to a long-term technological cycle. With global leaders now integrating robotics into the mainstream, projects like $AXIS are capturing the infrastructure layer of this transition.
I am tracking the increased activity on the hub as they continue to open new tasks. This is not just a short-term trend but a fundamental play on real-world utility and sustainable growth. Do you see robotics as the next major sector to rotate into?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Crypto #Web3 #Altcoins
🎯
The convergence of AI, hardware, and blockchain is shifting from a niche concept to a long-term technological cycle. With global leaders now integrating robotics into the mainstream, projects like $AXIS are capturing the infrastructure layer of this transition.
I am tracking the increased activity on the hub as they continue to open new tasks. This is not just a short-term trend but a fundamental play on real-world utility and sustainable growth. Do you see robotics as the next major sector to rotate into?
Not financial advice. Always manage your risk.
#AXIS #Robotics #Crypto #Web3 #Altcoins
🎯
7
·
--
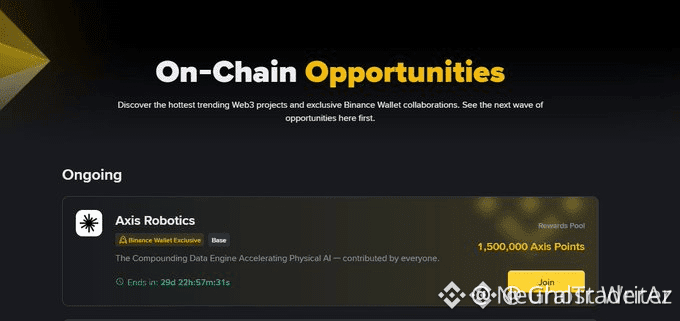
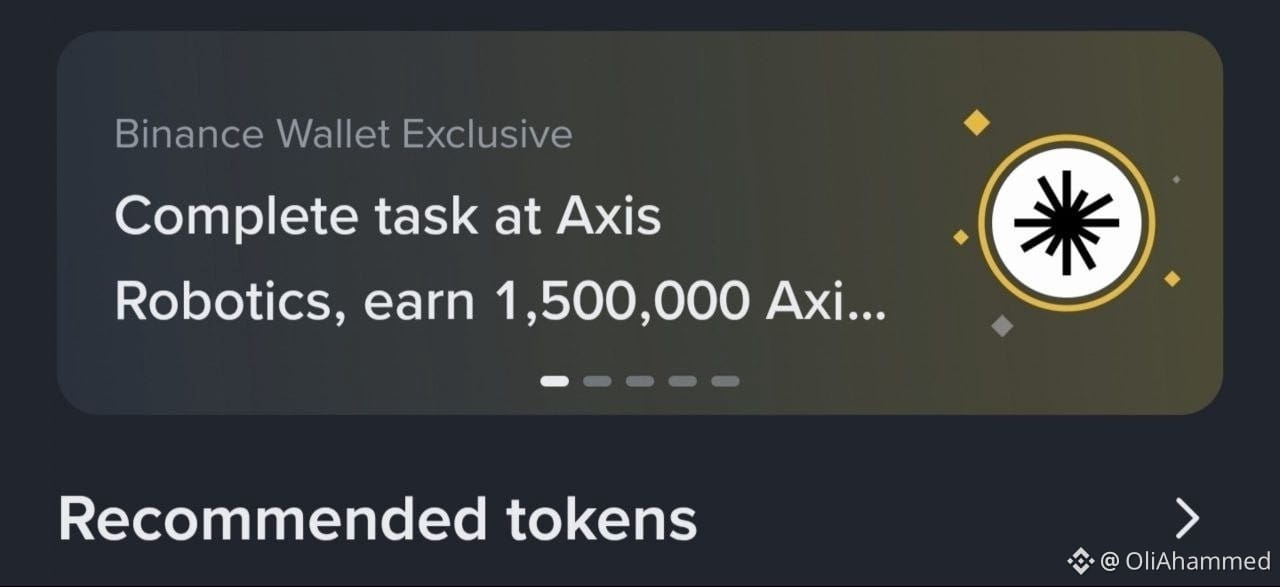
🛒 Axis Robotics X Binance Web3 විශේෂ ප්රචාරක වැඩසටහන!!
🎁මුළු : මිලියන 1.5 Axis Points
✅ Binance Web3 විවෘත කරන්න & සිදුවීමට එක්වන්න
✅ ඔබගේ X ගිණුම බයින්ඩ් කරන්න
✅ PTS දිගටම එකතු කරගන්න
#AxisRobotics #axis #BoosterProgram #wallet🔥 #Web3
🛒 Axis Robotics X Binance Web3 විශේෂ ප්රචාරක වැඩසටහන!!
🎁මුළු : මිලියන 1.5 Axis Points
✅ Binance Web3 විවෘත කරන්න & සිදුවීමට එක්වන්න
✅ ඔබගේ X ගිණුම බයින්ඩ් කරන්න
✅ PTS දිගටම එකතු කරගන්න
#AxisRobotics #axis #BoosterProgram #wallet🔥 #Web3
🎁මුළු : මිලියන 1.5 Axis Points
✅ Binance Web3 විවෘත කරන්න & සිදුවීමට එක්වන්න
✅ ඔබගේ X ගිණුම බයින්ඩ් කරන්න
✅ PTS දිගටම එකතු කරගන්න
#AxisRobotics #axis #BoosterProgram #wallet🔥 #Web3
84
·
--
පරිවර්තනය බලන්න
Axis Robotics and $AXIS: Robotics capital rotation is building 🚀
Robotics continues to attract structural capital as AI, hardware, and blockchain converge into a more durable investment narrative. The current backdrop reflects a clear shift from speculative attention to long-duration thematic positioning, with task-based engagement on the Axis hub suggesting ongoing user retention rather than a short-lived spike. Public-facing robotics optics have also reinforced the sector’s visibility, which matters when narrative and execution begin to align.
My read is that retail is still underestimating how early the market is in pricing the infrastructure layer of robotics. The real flow is not chasing isolated token momentum; it is rotating toward ecosystems that can capture recurring utility, task completion, and network activity. If Axis can sustain operational cadence and convert attention into measurable on-chain participation, it may benefit from a stronger liquidity profile than standard narrative coins, especially as capital searches for the next AI-adjacent beta with tangible product-market fit.
This is not financial advice. Digital assets are volatile, and thematic strength does not eliminate execution risk, liquidity risk, or structural invalidation.
#AXIS #Robotics #Web3 #Aİ
Axis Robotics and $AXIS: Robotics capital rotation is building 🚀
Robotics continues to attract structural capital as AI, hardware, and blockchain converge into a more durable investment narrative. The current backdrop reflects a clear shift from speculative attention to long-duration thematic positioning, with task-based engagement on the Axis hub suggesting ongoing user retention rather than a short-lived spike. Public-facing robotics optics have also reinforced the sector’s visibility, which matters when narrative and execution begin to align.
My read is that retail is still underestimating how early the market is in pricing the infrastructure layer of robotics. The real flow is not chasing isolated token momentum; it is rotating toward ecosystems that can capture recurring utility, task completion, and network activity. If Axis can sustain operational cadence and convert attention into measurable on-chain participation, it may benefit from a stronger liquidity profile than standard narrative coins, especially as capital searches for the next AI-adjacent beta with tangible product-market fit.
This is not financial advice. Digital assets are volatile, and thematic strength does not eliminate execution risk, liquidity risk, or structural invalidation.
#AXIS #Robotics #Web3 #Aİ
Robotics continues to attract structural capital as AI, hardware, and blockchain converge into a more durable investment narrative. The current backdrop reflects a clear shift from speculative attention to long-duration thematic positioning, with task-based engagement on the Axis hub suggesting ongoing user retention rather than a short-lived spike. Public-facing robotics optics have also reinforced the sector’s visibility, which matters when narrative and execution begin to align.
My read is that retail is still underestimating how early the market is in pricing the infrastructure layer of robotics. The real flow is not chasing isolated token momentum; it is rotating toward ecosystems that can capture recurring utility, task completion, and network activity. If Axis can sustain operational cadence and convert attention into measurable on-chain participation, it may benefit from a stronger liquidity profile than standard narrative coins, especially as capital searches for the next AI-adjacent beta with tangible product-market fit.
This is not financial advice. Digital assets are volatile, and thematic strength does not eliminate execution risk, liquidity risk, or structural invalidation.
#AXIS #Robotics #Web3 #Aİ
42
පරිවර්තනය බලන්න
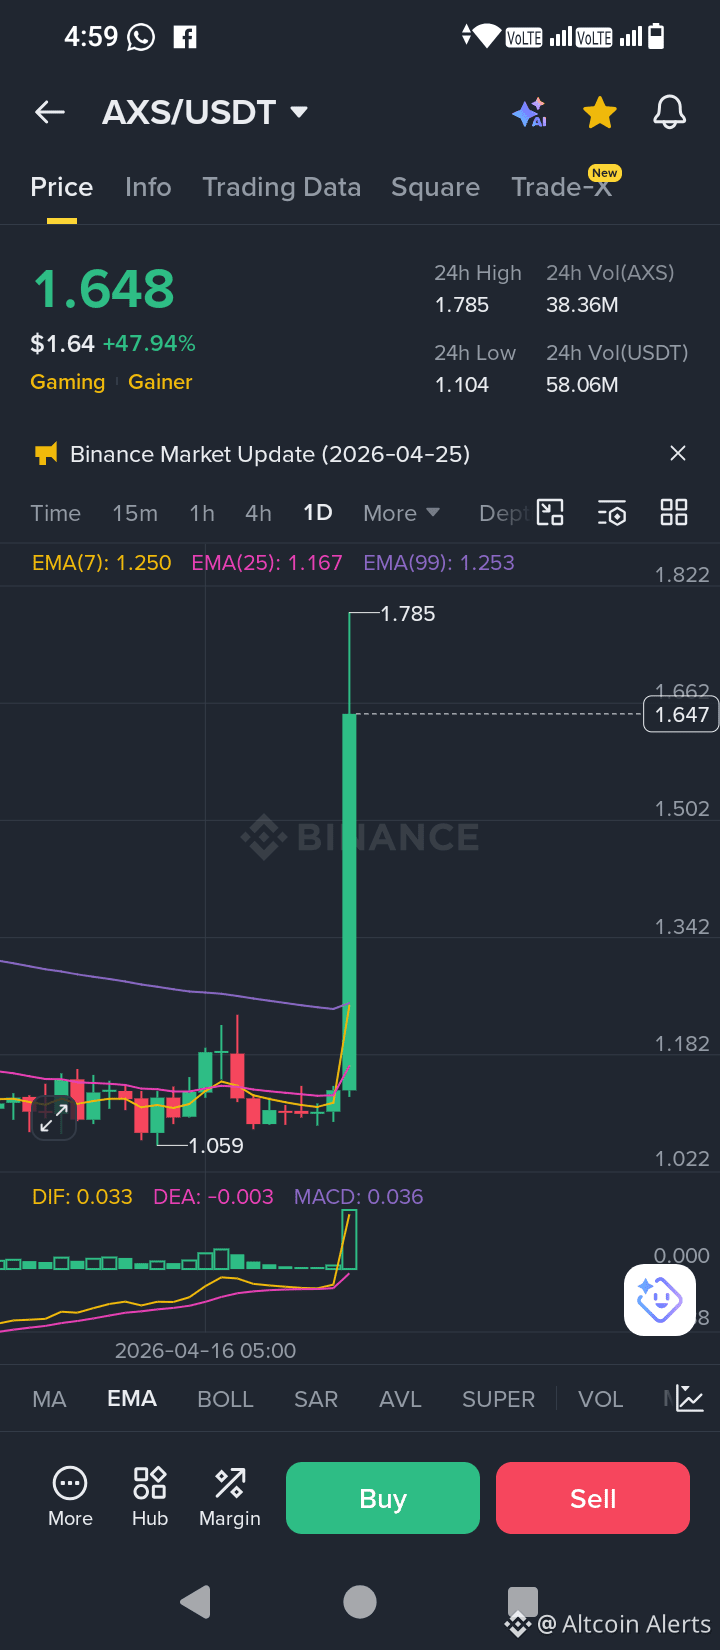
🚨 $AXS/SUDT is acting WEIRD. Here’s why I’m watching it closely.
Let’s be real – most pairs move in patterns you can kinda guess. But $AXS ? It's been rejecting support at 1.5 like it’s glued there, and the volume spikes are anything but random.
I’m not saying it’s the next moonshot, but when a low-cap pair starts printing these clean wicks + consolidation breaks, my spidey senses tingle.
What I’m doing:
· Watching the 1.50–1.55 zone like a hawk.
· Scaling a tiny bag with tight stops.
· Not aping – just respecting the setup.
Could be nothing. Could be the calm before a move. Either way, it’s on my list.
You watching anything weird today? 👇
$AXS
{spot}(AXSUSDT)
#AXIS #BinanceSquare #Crypto #TradingSetup
🚨 $AXS /SUDT is acting WEIRD. Here’s why I’m watching it closely.
Let’s be real – most pairs move in patterns you can kinda guess. But $AXS ? It's been rejecting support at 1.5 like it’s glued there, and the volume spikes are anything but random.
I’m not saying it’s the next moonshot, but when a low-cap pair starts printing these clean wicks + consolidation breaks, my spidey senses tingle.
What I’m doing:
· Watching the 1.50–1.55 zone like a hawk.
· Scaling a tiny bag with tight stops.
· Not aping – just respecting the setup.
Could be nothing. Could be the calm before a move. Either way, it’s on my list.
You watching anything weird today? 👇
$AXS
#AXIS #BinanceSquare #Crypto #TradingSetup
Let’s be real – most pairs move in patterns you can kinda guess. But $AXS ? It's been rejecting support at 1.5 like it’s glued there, and the volume spikes are anything but random.
I’m not saying it’s the next moonshot, but when a low-cap pair starts printing these clean wicks + consolidation breaks, my spidey senses tingle.
What I’m doing:
· Watching the 1.50–1.55 zone like a hawk.
· Scaling a tiny bag with tight stops.
· Not aping – just respecting the setup.
Could be nothing. Could be the calm before a move. Either way, it’s on my list.
You watching anything weird today? 👇
$AXS
#AXIS #BinanceSquare #Crypto #TradingSetup
13
තවත් අන්තර්ගතයන් ගවේෂණය කිරීමට ඇතුල් වන්න
Binance චතුරශ්රය හි ගෝලීය ක්රිප්ටෝ පරිශීලකයින් හා එක්වන්න
⚡️ ක්රිප්ටෝ පිළිබඳ නවතම සහ ප්රයෝජනවත් තොරතුරු ලබා ගන්න.
💬 ලොව විශාලතම ක්රිප්ටෝ හුවමාරුව මගින් විශ්වාස කෙරේ.
👍 සත්යායනය කරන ලද නිර්මාණකරුවන්ගෙන් සැබෑ විදසුන් සොයා ගන්න.
විද්යුත් තැපෑල / දුරකථන අංකය
නැගී එන මාතෘකා
1
#BitcoinReboundsTo$79K
19,353 views
162 සාකච්ඡා කරමින්
2
#BitcoinSpotETFsNetInflow$160M
19 views
21 සාකච්ඡා කරමින්
3
#SouthKoreaCryptoTaxDelayPetitionTops50000
7,338 views
210 සාකච්ඡා කරමින්
4
#SolanaTransactionV1GoesLiveOnMainnet
3,657 views
140 සාකච්ඡා කරමින්
5
#RussianCentralBankFlagsCryptoAsFinancialRisk
4,790 views
173 සාකච්ඡා කරමින්
6
#GrayscalePutsXRPAt26.11%InAdvisorPortfolio
16,051 views
275 සාකච්ඡා කරමින්
7
#PhiladelphiaSemiconductorIndexFalls5.9%
5,067 views
175 සාකච්ඡා කරමින්
8
#SECChairUrgesCongressToAdvanceClarityAct
15,864 views
187 සාකච්ඡා කරමින්
9
#FedHikeOddsRiseTo89%
105,124 views
1,197 සාකච්ඡා කරමින්
10
#RLUSDSupplyHitsRecord$2.442B
7,696 views
70 සාකච්ඡා කරමින්