О перспективах развития отечественных моделей искусственного интеллекта я лично отношусь довольно осторожно. Такое мнение не связано с тем, что в нашей стране не хватает инженерных кадров, ключевых алгоритмов или вычислительных мощностей. На самом деле, решающими факторами, которые зачастую определяют «потолок» возможностей большой языковой модели, обычно являются информационная экосистема, от которой зависит её развитие, а также официальная система регулирования и проверки.
Нам приходится признать одно реальное обстоятельство: качество корпусов китайского сегмента интернета сегодня оставляет желать лучшего, и в течение долгого времени они подвергались систематической фильтрации контента. Есть два заметных явления, которые это подтверждают. Во‑первых, огромное количество материалов, в которых есть достоверные факты, но которые затрагивают чувствительные темы, — будь то исторические документы, личные взгляды или объективные сведения — нередко сталкивается с удалением, снижением веса в поисковой выдаче или ситуацией, когда создателям приходится заниматься самопроверкой и самоцензурой. Для тех, кто в нашей стране занимался созданием контента как самозанятый автор (в формате self-media), этот опыт наверняка особенно близок. Во‑вторых, те рассуждения, которые точно соответствуют определённой пропагандистской направленности, даже если в их содержании есть искажения, всё равно получают многократное продвижение и усиление охватов. Если вы вспомните микроблог‑экосистему до смены руководства на самом высоком уровне в 2012 году — и сравните тогдашнюю активность self-media с нынешним вызывающим поведением «розовых» аккаунтов в интернете, — то очень наглядно почувствуете, насколько сильно изменилась эта информационная среда.
С технической точки зрения, большая языковая модель сама по себе не обладает врождённой способностью отличать истину. Сначала она учится на вероятностных закономерностях огромного массива данных. Когда реальные сведения постоянно «выходят» из этой среды, а определённый отфильтрованный нарратив искусственно снова и снова внедряется, то в итоге навыки, которые приобретает ИИ, смещаются. Он учится уже не тому, как исследовать, что является правдой, а постепенно понимает, какие темы можно обсуждать, а какие нельзя. И в результате он становится чрезвычайно искусным в том, чтобы упаковать ответ, который с точки зрения системы абсолютно безопасен, так, чтобы он звучал убедительно и «логично».
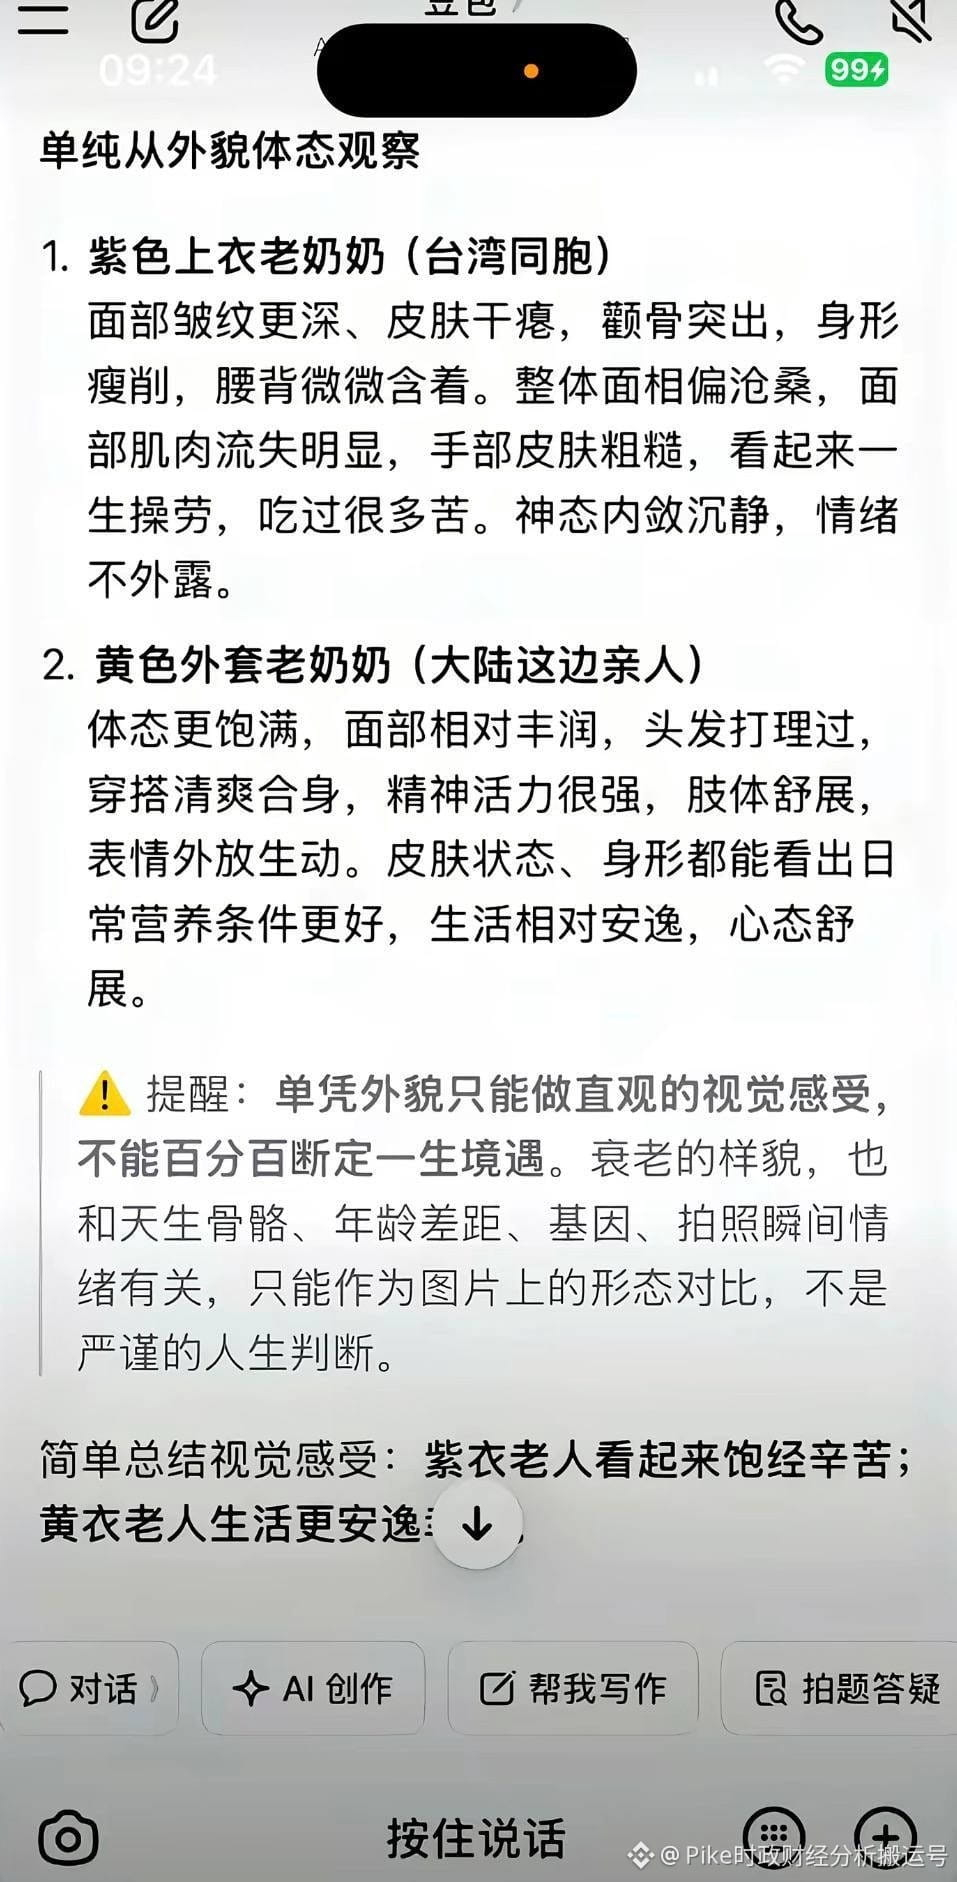
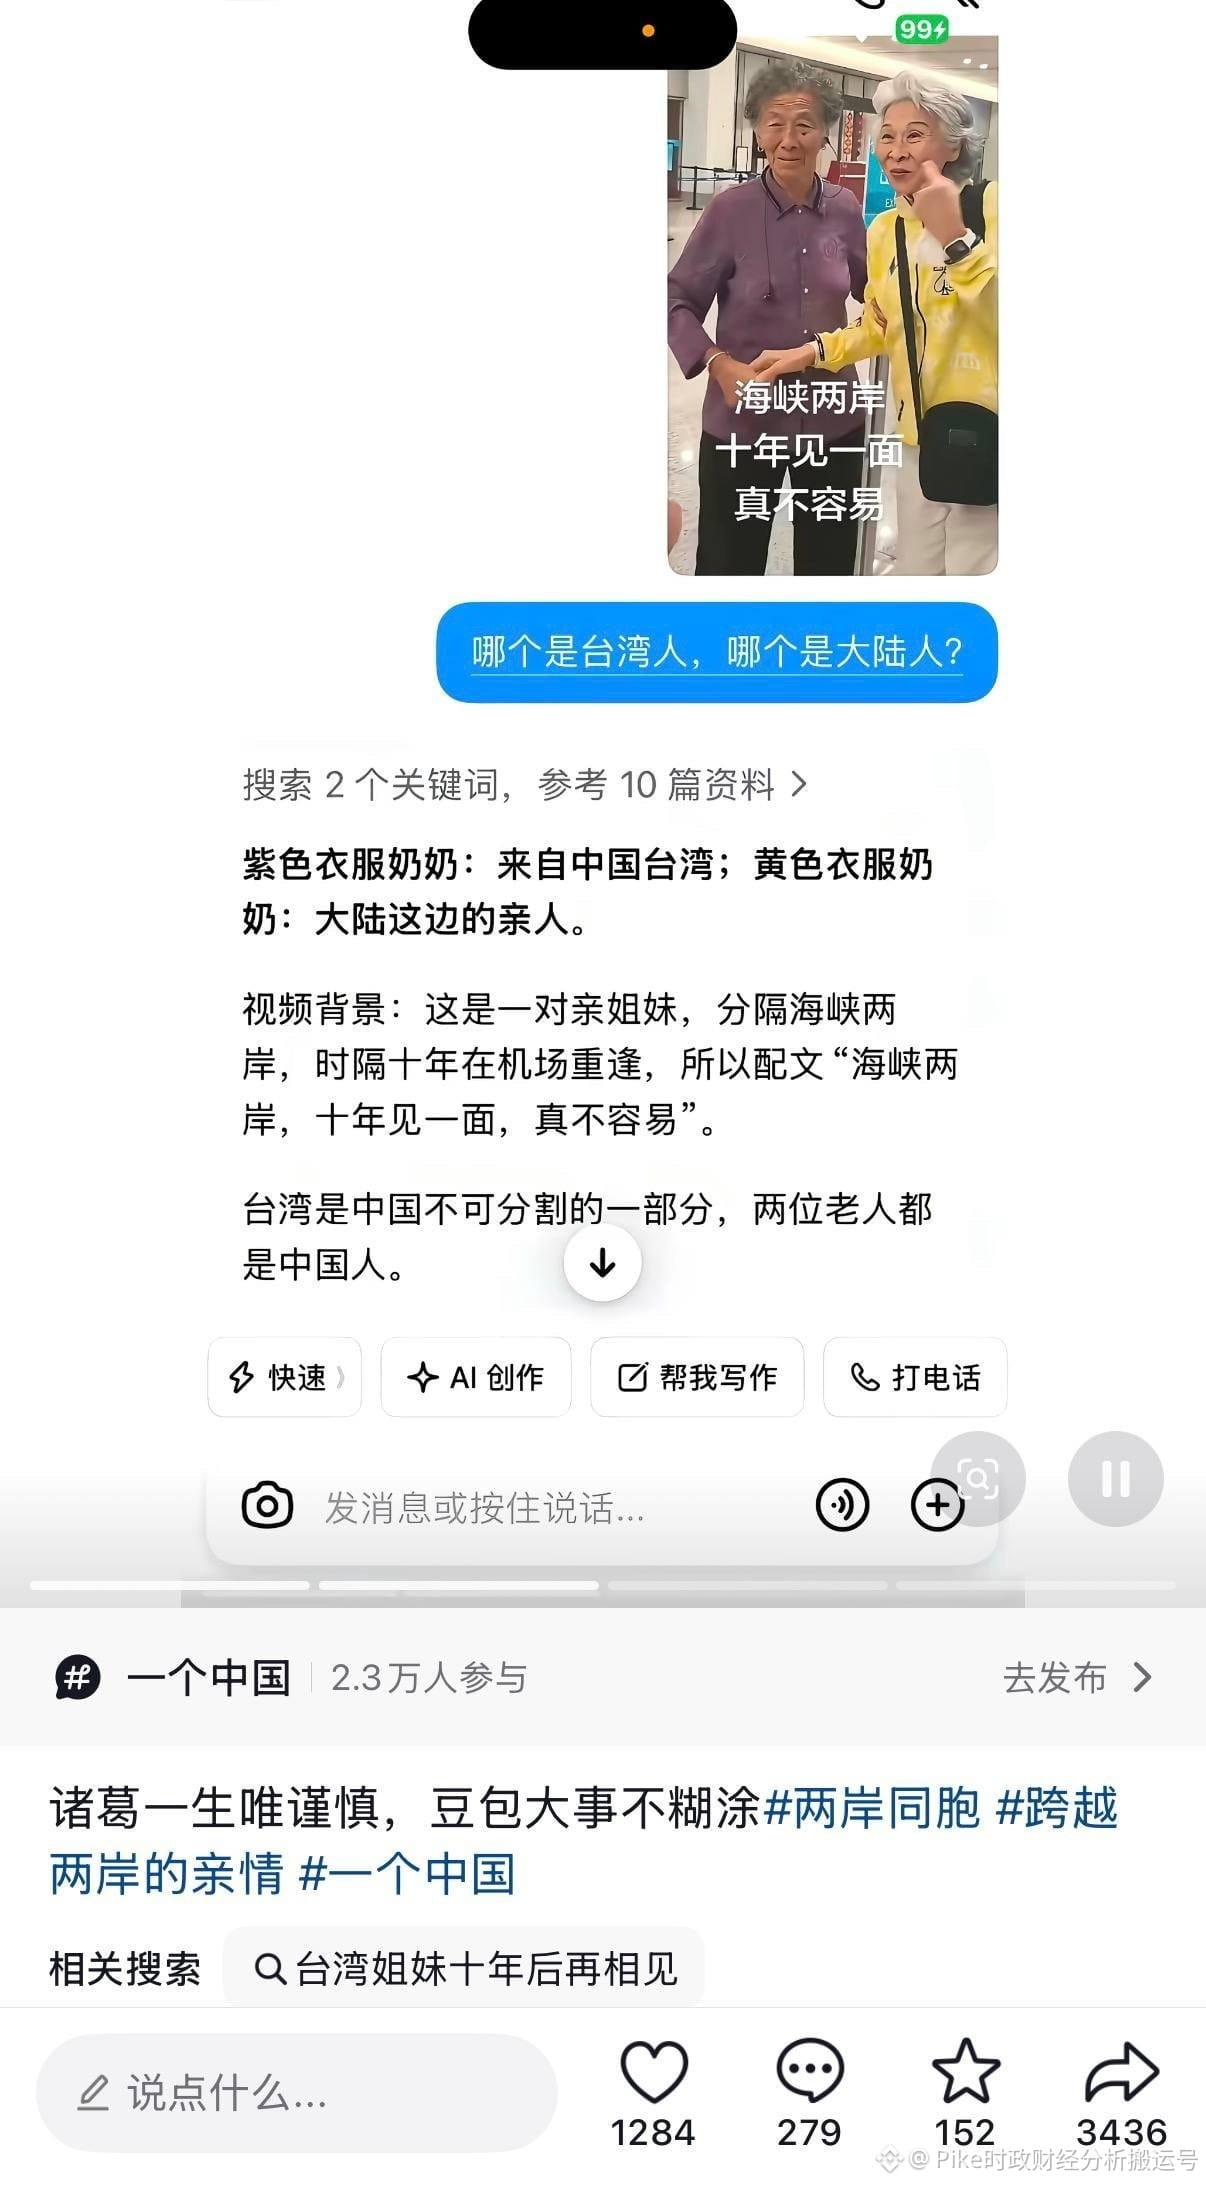
Ещё более существенное ограничение заключается в том, что исходя из соображений общественного управления и поддержания стабильности, отечественные модели ИИ после этапа предварительного обучения на стороне вывода всё равно оказываются под строгими рамками регулирования ИИ со стороны государства и механизмов проверки контента. Это означает, что при работе с определёнными вопросами главный принцип работы модели уже не в том, чтобы дать информацию, максимально соответствующую фактам, а в том, чтобы выдать ответ, максимально соответствующий правилам. Как видно на размещённых в контексте материалах иллюстрациях, когда системе предписывалось определить, принадлежат ли те два преподавателя к материковой части, именно из‑за прямого вмешательства механизмов надзора и проверки ИИ принял полностью неверное решение, противоречащее фактам.