
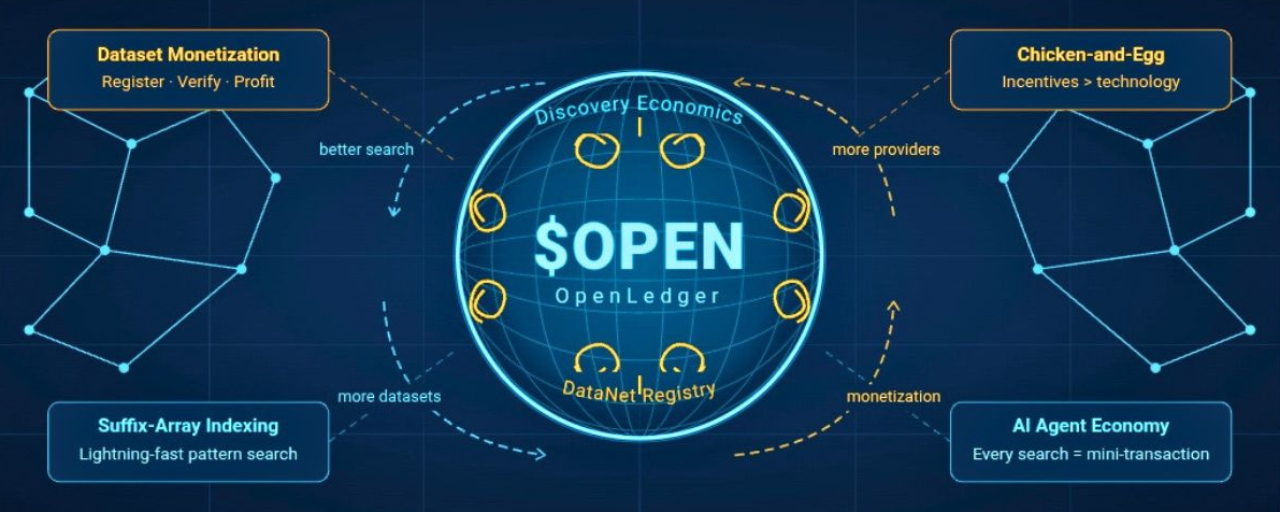


Впервые открыв Реестр DataNet от OpenLedger, я ожидал очередную историю об ИИ-инфраструктуре. Вместо этого, это заставило меня задуматься о базах данных.
Обычно, когда люди говорят о ИИ-инфраструктуре, вы слышите о моделях. Больше моделей. Быстрее обработка. Более крутые результаты. Но то, что тихо определяет успех или провал ИИ-системы, это не модели; это то, как вы организуете данные за кулисами.
Разница, по крайней мере, с того, что я вижу, заключается в том, что OpenLedger сосредоточен на открытии — не только на хранении.
Не сами данные. Просто… как их находить.
Эта разница ощущается сильнее, чем большинство людей понимают.
Чем больше я в это вникал, тем сильнее ощущалось, что это похоже на Discovery Economics — идею о том, что поиск данных может стать ценнее, чем само их хранение.
Меня больше всего зацепило то, что индексация в стиле suffix-array встроена прямо в их архитектуру. Если вы раньше не углублялись в suffix arrays, то вот — несколько лет назад я наткнулся на них, когда возился с оптимизацией поиска. Идея простая, но немного безумная: она позволяет организовать информацию так, что поиск паттернов становится «щелк — и готово», молниеносно быстро.
Звучит технично, да, но реальный эффект — экономический.
Потому что когда эти ИИ-агенты начинают носиться сами по себе, каждый поиск превращается в мини-транзакцию. Каждая лишняя секунда, потраченная на поиск, — это трение. Каждый тупиковый запрос? Пустые вычисления, потраченная впустую энергия. Когда агенты начинают принимать решения в масштабе, эти крошечные неэффективности начинают складываться, как сумасшедшие.
Вот тогда DataNet Registry стал для меня действительно интересным.
Вместо того чтобы просто выбрасывать наборы данных в интернет как статичные файлы, он обращается с ними скорее как с активами, которые можно находить и даже монетизировать. Система не просто складывает их в ящик — она дает структурированные «рельсы» для регистрации, верификации, поиска и, возможно, извлечения прибыли из наборов данных. И всё это под одной крышей.
Лучшая эффективность поиска повышает продуктивность агентов. Более продуктивные агенты потребляют больше наборов данных. Большее использование наборов данных создает возможности для монетизации, что привлекает дополнительных провайдеров и укрепляет сеть. Это базовая логика того, что я начал называть Discovery Economics (экономика обнаружения).
Честно, если оглянуться назад, слои, отвечающие за обнаружение, имеют свойство затмевать само содержимое. Поисковые системы выросли больше, чем сайты. Магазины приложений обогнали большинство отдельных приложений. Маркетплейсы выигрывают, потому что уменьшают усилия по сопоставлению того, что нужно людям, с тем, что предлагает продавец.
Я всё думаю: а может ли такое случиться и с наборами данных для ИИ? Особенно с учетом того, как сейчас смещается фокус.
Похоже, рынок снова сдвигается в сторону разговора об инфраструктуре. ИИ получает внимание, без сомнений, но инвесторы, судя по всему, больше цепляются за «трубы» и «топки» для него — а не только за яркие модели. С криптой уже такое было: сначала дикая радость от приложений… а потом все начинают охотиться за теми самыми рельсами под ними.
Иногда? Вторая фаза забирает себе куда больше ценности, чем первая.
Но у сетей данных есть эта раздражающая проблема начальной раскрутки (bootstrap). Реестр работает только тогда, когда внутри живет достаточно «сочных» наборов данных. А «сочные» наборы данных появляются только если уже работает обнаружение и монетизация из них.
Чистое «курица и яйцо».
Крипта снова и снова об это спотыкается. Будь то пулы ликвидности, оракульные сети, децентрализованное хранилище — все упирается в вариации одной и той же головной боли.
Важнее всего стимулы, а не технологии.
Красивая реестровая система? Но это не значит, что люди массово придут. Людям нужны реальные причины делиться данными, держать их в чистоте и доверять системе. Иначе вы получаете красивую полку для мусорной информации — цифровой город-призрак.
Честно говоря, именно с этим я всё еще борюсь.
Архитектура классная — она сочетает классическую компьютерную науку с новыми «рецептами» стимулов на блокчейне. Но история снова и снова напоминает мне: технический блеск и реальная устойчивость в реальном мире не всегда идут рука об руку.
Возможно, реальная искра не в магии индексации, а в том, чтобы сама обнаруживаемость стала нативным экономическим драйвером для ИИ.
Или, возможно, — это на самом деле просто дым и зеркала.
Похоже, мы на ранних этапах — честно говоря. Трудно понять, что является реальной инфраструктурой, а что просто история в одежде инфраструктуры.
Экономика работает только если качество набора данных масштабируется вместе с количеством. Одного роста недостаточно.
Может, именно это Discovery Economics и проверяет: не есть ли у данных ценность, а может ли обнаруживаемость стать рынком сама по себе.
Если обнаруживаемость станет собственной экономической прослойкой, реестр DataNet Registry может в итоге оказаться важнее самих наборов данных. Если нет — это будет всего лишь еще один реестр, которым никто не пользуется.
#OpenLedger @OpenLedger $OPEN
