
#depin
depin
Просмотров: 3.7M
13,164 обсуждают
Популярные
Новые
·
--
Рост
$GLM DePIN и AI-вычисления: что видно на старшем таймфрейме $GLM?
Пока локальная лента забита шумом вокруг микро-колебаний, старшие графики показывают совсем другую картину.
Факты со старшего таймфрейма:
Глобальная база: Монета торгуется в районе $0.1160, находясь прямо у блока исторического дна ($0.0850–$0.1000).
Тест ключевых средних: Цена подошла вплотную к 1D EMA 21 ($0.1160), постепенно сжимаясь перед 1D EMA 50 ($0.1520).
Нейтральный RSI: На недельном интервале осциллятор сбросил всю перегретость предыдущих импульсов, сформировав площадку для нового долгосрочного накопления.
Сжатие волатильности: После падения с локальных пиков предложение на рынке сжато, а объемы упали до минимумов.
Настоящие движения на альтах с сильным фундаменталом (сектор DePIN/AI) готовятся не за один день. Накопление на дне — это всегда процесс тихий и вязкий.
Как считаете: увидим выход из этой базы этой осенью или накопление затянется? 👇
#GLMUSDT #DePIN #BinanceSquareTalks #CryptoAnalysis #Trading #AI
$GLM DePIN и AI-вычисления: что видно на старшем таймфрейме $GLM ?
Пока локальная лента забита шумом вокруг микро-колебаний, старшие графики показывают совсем другую картину.
Факты со старшего таймфрейма:
Глобальная база: Монета торгуется в районе $0.1160, находясь прямо у блока исторического дна ($0.0850–$0.1000).
Тест ключевых средних: Цена подошла вплотную к 1D EMA 21 ($0.1160), постепенно сжимаясь перед 1D EMA 50 ($0.1520).
Нейтральный RSI: На недельном интервале осциллятор сбросил всю перегретость предыдущих импульсов, сформировав площадку для нового долгосрочного накопления.
Сжатие волатильности: После падения с локальных пиков предложение на рынке сжато, а объемы упали до минимумов.
Настоящие движения на альтах с сильным фундаменталом (сектор DePIN/AI) готовятся не за один день. Накопление на дне — это всегда процесс тихий и вязкий.
Как считаете: увидим выход из этой базы этой осенью или накопление затянется? 👇
#GLMUSDT #DePIN #BinanceSquareTalks #CryptoAnalysis #Trading #AI
Пока локальная лента забита шумом вокруг микро-колебаний, старшие графики показывают совсем другую картину.
Факты со старшего таймфрейма:
Глобальная база: Монета торгуется в районе $0.1160, находясь прямо у блока исторического дна ($0.0850–$0.1000).
Тест ключевых средних: Цена подошла вплотную к 1D EMA 21 ($0.1160), постепенно сжимаясь перед 1D EMA 50 ($0.1520).
Нейтральный RSI: На недельном интервале осциллятор сбросил всю перегретость предыдущих импульсов, сформировав площадку для нового долгосрочного накопления.
Сжатие волатильности: После падения с локальных пиков предложение на рынке сжато, а объемы упали до минимумов.
Настоящие движения на альтах с сильным фундаменталом (сектор DePIN/AI) готовятся не за один день. Накопление на дне — это всегда процесс тихий и вязкий.
Как считаете: увидим выход из этой базы этой осенью или накопление затянется? 👇
#GLMUSDT #DePIN #BinanceSquareTalks #CryptoAnalysis #Trading #AI
1
125
·
--
$GLM DePIN и AI-вычисления: почему рынок игнорирует дефицит $GLM ?
Пока розница бегает за мемкоинами, в децентрализованной инфраструктуре (DePIN) спеет фундаментальный сдвиг.
Факты:
Earn выше 40% APR: Суточные всплески доходностей — маркер того, что маркетмейкерам катастрофически не хватает ликвидности.
Спрос на мощности: На фоне бума ИИ децентрализованные GPU/CPU становятся дешёвой альтернативой облакам.
Техника: После импульса цена не падаёт, а разгружает RSI у ключевых EMA (50/200).
Настоящие движения формируются в тишине, пока стаканы зажимаются перед второй волной. А те, кто фиксирует профит по системе, спокойно ждут развязки с кэшем.
Делитесь мнением: затишье перед рывком или боковик? 👇
#GLM #DePIN #BinanceSquare #Crypto
$GLM DePIN и AI-вычисления: почему рынок игнорирует дефицит $GLM ?
Пока розница бегает за мемкоинами, в децентрализованной инфраструктуре (DePIN) спеет фундаментальный сдвиг.
Факты:
Earn выше 40% APR: Суточные всплески доходностей — маркер того, что маркетмейкерам катастрофически не хватает ликвидности.
Спрос на мощности: На фоне бума ИИ децентрализованные GPU/CPU становятся дешёвой альтернативой облакам.
Техника: После импульса цена не падаёт, а разгружает RSI у ключевых EMA (50/200).
Настоящие движения формируются в тишине, пока стаканы зажимаются перед второй волной. А те, кто фиксирует профит по системе, спокойно ждут развязки с кэшем.
Делитесь мнением: затишье перед рывком или боковик? 👇
#GLM #DePIN #BinanceSquare #Crypto
Пока розница бегает за мемкоинами, в децентрализованной инфраструктуре (DePIN) спеет фундаментальный сдвиг.
Факты:
Earn выше 40% APR: Суточные всплески доходностей — маркер того, что маркетмейкерам катастрофически не хватает ликвидности.
Спрос на мощности: На фоне бума ИИ децентрализованные GPU/CPU становятся дешёвой альтернативой облакам.
Техника: После импульса цена не падаёт, а разгружает RSI у ключевых EMA (50/200).
Настоящие движения формируются в тишине, пока стаканы зажимаются перед второй волной. А те, кто фиксирует профит по системе, спокойно ждут развязки с кэшем.
Делитесь мнением: затишье перед рывком или боковик? 👇
#GLM #DePIN #BinanceSquare #Crypto
1
357
·
--
Криптовалютный рынок постоянно развивается, и умные инвесторы всегда ищут проекты, которые подкрепляют децентрализованные финансы реальным практическим применением. Одним из таких проектов, который спокойно закладывает фундамент, является Standard Protocol, представленный тикером STND. Давайте разберёмся, что делает этот проект заметным на текущем рынке.
Standard Protocol находится на стыке сетей децентрализованной физической инфраструктуры (DePIN) и стандартов данных Web3. Изначально проект был известен инновационным подходом к обеспеченным стейблкоинам и механизмам ребейсинга, однако со временем его видение расширилось. Теперь он нацелен на решение крупного узкого места в Web3: отсутствия стандартизированной, надёжной инфраструктуры данных и ликвидности в мультицепочечных экосистемах.
Почему STND набирает популярность именно сейчас? Ответ кроется в масштабном сдвиге нарратива в сторону DePIN и Real-World Assets (RWA). Инвесторы уходят от чистых спекуляций и требуют проекты с понятной, осязаемой пользой. Standard Protocol предоставляет основу, чтобы децентрализованные приложения могли безопасно хранить, обмениваться и оценивать активы данных. Тем самым он помогает более плавно выстраивать кроссчейн-операции и снижает фрагментацию, которая часто мешает DeFi.
С точки зрения рынка, STND — это актив с меньшей капитализацией и потенциально высокой асимметричной доходностью, особенно на фоне того, что более широкий рынок ищет недооценённые инфраструктурные идеи. Его интеграция с крупными экосистемами вроде Polkadot и Ethereum даёт понятный технический задел. Кроме того, фокус на управлении, основанном на сообществе, гарантирует, что сеть будет напрямую адаптироваться под потребности пользователей.
Переходя в фазу строго селективного рынка, инфраструктурные протоколы вроде Standard стоит держать в своём списке наблюдения. Возможно, они не будут ежедневно попадать в заголовки, как мемкоины, но именно они строят автострады, по которым проедет следующий бычий рынок.
Что вы думаете о STND? DePIN — доминирующий нарратив этого цикла? Напишите в комментариях ниже.
#STND #DePIN #CryptoAnalysis
Криптовалютный рынок постоянно развивается, и умные инвесторы всегда ищут проекты, которые подкрепляют децентрализованные финансы реальным практическим применением. Одним из таких проектов, который спокойно закладывает фундамент, является Standard Protocol, представленный тикером STND. Давайте разберёмся, что делает этот проект заметным на текущем рынке.
Standard Protocol находится на стыке сетей децентрализованной физической инфраструктуры (DePIN) и стандартов данных Web3. Изначально проект был известен инновационным подходом к обеспеченным стейблкоинам и механизмам ребейсинга, однако со временем его видение расширилось. Теперь он нацелен на решение крупного узкого места в Web3: отсутствия стандартизированной, надёжной инфраструктуры данных и ликвидности в мультицепочечных экосистемах.
Почему STND набирает популярность именно сейчас? Ответ кроется в масштабном сдвиге нарратива в сторону DePIN и Real-World Assets (RWA). Инвесторы уходят от чистых спекуляций и требуют проекты с понятной, осязаемой пользой. Standard Protocol предоставляет основу, чтобы децентрализованные приложения могли безопасно хранить, обмениваться и оценивать активы данных. Тем самым он помогает более плавно выстраивать кроссчейн-операции и снижает фрагментацию, которая часто мешает DeFi.
С точки зрения рынка, STND — это актив с меньшей капитализацией и потенциально высокой асимметричной доходностью, особенно на фоне того, что более широкий рынок ищет недооценённые инфраструктурные идеи. Его интеграция с крупными экосистемами вроде Polkadot и Ethereum даёт понятный технический задел. Кроме того, фокус на управлении, основанном на сообществе, гарантирует, что сеть будет напрямую адаптироваться под потребности пользователей.
Переходя в фазу строго селективного рынка, инфраструктурные протоколы вроде Standard стоит держать в своём списке наблюдения. Возможно, они не будут ежедневно попадать в заголовки, как мемкоины, но именно они строят автострады, по которым проедет следующий бычий рынок.
Что вы думаете о STND? DePIN — доминирующий нарратив этого цикла? Напишите в комментариях ниже.
#STND #DePIN #CryptoAnalysis
Standard Protocol находится на стыке сетей децентрализованной физической инфраструктуры (DePIN) и стандартов данных Web3. Изначально проект был известен инновационным подходом к обеспеченным стейблкоинам и механизмам ребейсинга, однако со временем его видение расширилось. Теперь он нацелен на решение крупного узкого места в Web3: отсутствия стандартизированной, надёжной инфраструктуры данных и ликвидности в мультицепочечных экосистемах.
Почему STND набирает популярность именно сейчас? Ответ кроется в масштабном сдвиге нарратива в сторону DePIN и Real-World Assets (RWA). Инвесторы уходят от чистых спекуляций и требуют проекты с понятной, осязаемой пользой. Standard Protocol предоставляет основу, чтобы децентрализованные приложения могли безопасно хранить, обмениваться и оценивать активы данных. Тем самым он помогает более плавно выстраивать кроссчейн-операции и снижает фрагментацию, которая часто мешает DeFi.
С точки зрения рынка, STND — это актив с меньшей капитализацией и потенциально высокой асимметричной доходностью, особенно на фоне того, что более широкий рынок ищет недооценённые инфраструктурные идеи. Его интеграция с крупными экосистемами вроде Polkadot и Ethereum даёт понятный технический задел. Кроме того, фокус на управлении, основанном на сообществе, гарантирует, что сеть будет напрямую адаптироваться под потребности пользователей.
Переходя в фазу строго селективного рынка, инфраструктурные протоколы вроде Standard стоит держать в своём списке наблюдения. Возможно, они не будут ежедневно попадать в заголовки, как мемкоины, но именно они строят автострады, по которым проедет следующий бычий рынок.
Что вы думаете о STND? DePIN — доминирующий нарратив этого цикла? Напишите в комментариях ниже.
#STND #DePIN #CryptoAnalysis
59
·
--
$RENDER
{future}(RENDERUSDT)
RENDER связывает блокчейн-технологии с децентрализованными вычислениями на GPU. Сеть предназначена для предоставления распределенных вычислительных ресурсов для требовательных цифровых задач.
Поскольку ИИ и высокопроизводительные вычисления становятся ключевыми технологическими темами, децентрализованная GPU-инфраструктура привлекает все больше внимания в Web3.
#RENDER #AI #DePIN #BinanceSquare
$RENDER
RENDER связывает блокчейн-технологии с децентрализованными вычислениями на GPU. Сеть предназначена для предоставления распределенных вычислительных ресурсов для требовательных цифровых задач.
Поскольку ИИ и высокопроизводительные вычисления становятся ключевыми технологическими темами, децентрализованная GPU-инфраструктура привлекает все больше внимания в Web3.
#RENDER #AI #DePIN #BinanceSquare
RENDER связывает блокчейн-технологии с децентрализованными вычислениями на GPU. Сеть предназначена для предоставления распределенных вычислительных ресурсов для требовательных цифровых задач.
Поскольку ИИ и высокопроизводительные вычисления становятся ключевыми технологическими темами, децентрализованная GPU-инфраструктура привлекает все больше внимания в Web3.
#RENDER #AI #DePIN #BinanceSquare
65
·
--
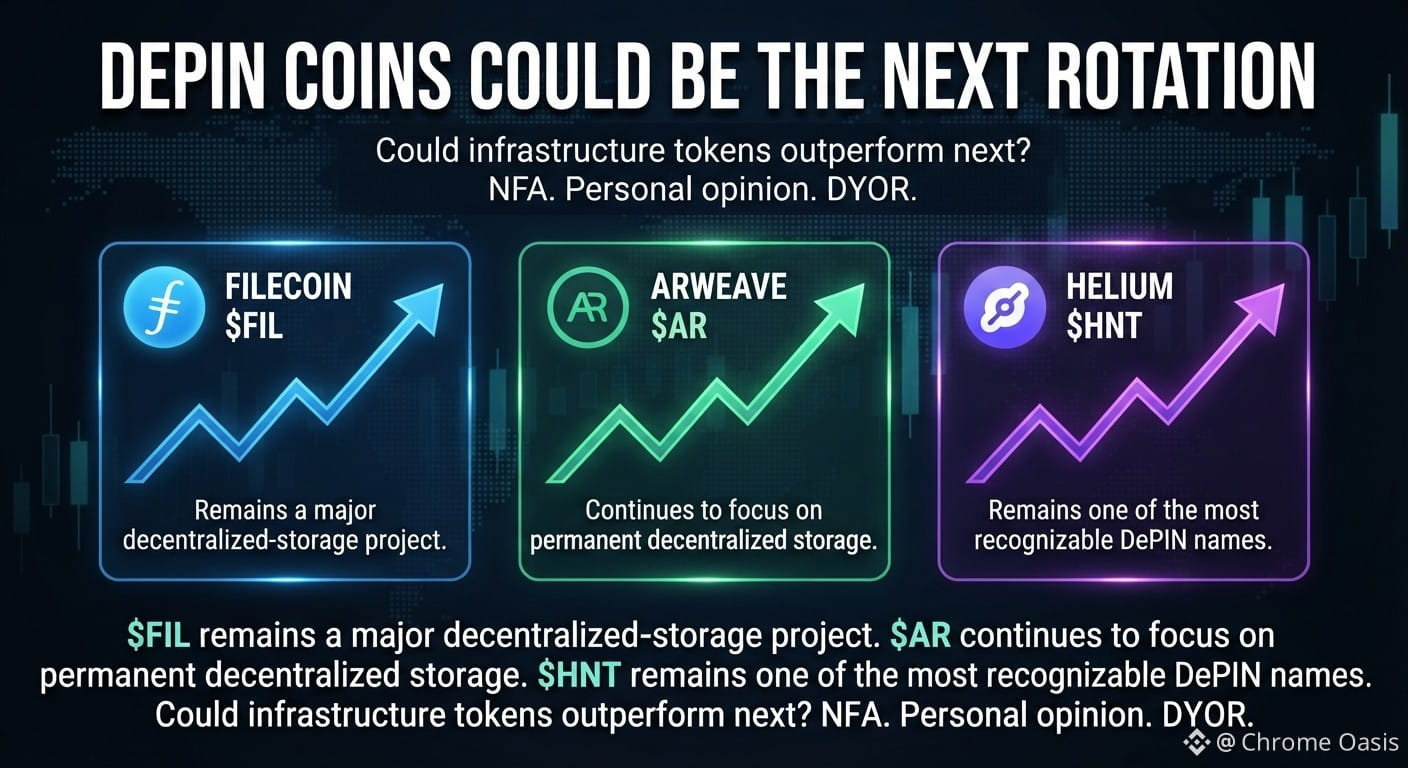
КОИНЫ DEPIN МОГУТ СТАТЬ СЛЕДУЮЩЕЙ РОТАЦИЕЙ
$FIL остается одним из ключевых проектов децентрализованного хранения.
$AR продолжает фокусироваться на постоянном децентрализованном хранении.
$HNT остается одним из самых узнаваемых имен в DePIN.
Могут ли инфраструктурные токены превзойти следующее?
NFA. Личное мнение. DYOR.
#FIL #AR #HNT #DePIN #Crypto
КОИНЫ DEPIN МОГУТ СТАТЬ СЛЕДУЮЩЕЙ РОТАЦИЕЙ
$FIL остается одним из ключевых проектов децентрализованного хранения.
$AR продолжает фокусироваться на постоянном децентрализованном хранении.
$HNT остается одним из самых узнаваемых имен в DePIN.
Могут ли инфраструктурные токены превзойти следующее?
NFA. Личное мнение. DYOR.
#FIL #AR #HNT #DePIN #Crypto
$FIL остается одним из ключевых проектов децентрализованного хранения.
$AR продолжает фокусироваться на постоянном децентрализованном хранении.
$HNT остается одним из самых узнаваемых имен в DePIN.
Могут ли инфраструктурные токены превзойти следующее?
NFA. Личное мнение. DYOR.
#FIL #AR #HNT #DePIN #Crypto
3
349
·
--
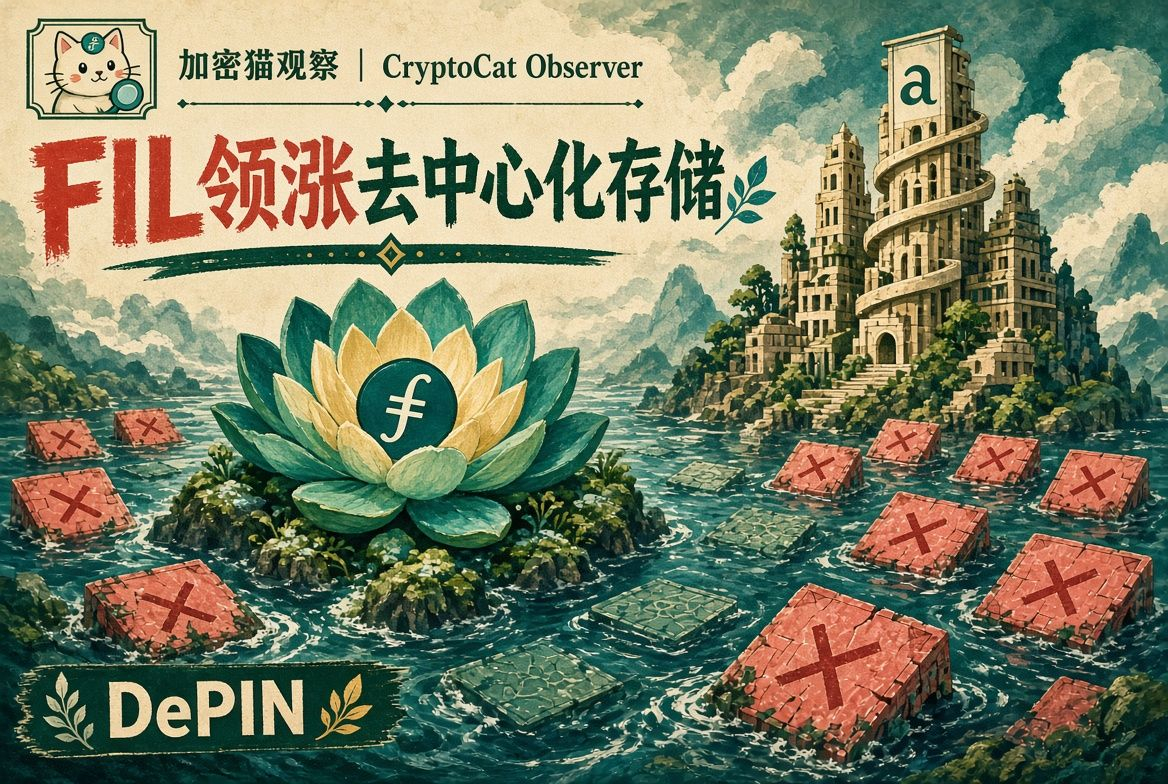
$FIL领涨DePIN,存储板块逆势走强
14 сентября большинство крипто-секторов откатилось, за исключением DePIN и части Layer2, которые действовали вопреки рынку: сектор DePIN за 24 часа прибавил около 3,49%. При этом $FIL вырос примерно на 21,43%, а $AR — примерно на 9,41%; децентрализованный сегмент хранения данных: капитализация около 2,87 млрд долларов, за 24 часа — около +5,6%. В рыночном обзоре также отмечается, что в лидерах были FIL, AR и SKL, при этом по $FIL наблюдался рост объёма торгов.
Со стороны нарратива внимание рынка сосредоточено на возможном изменении темпов выпуска, связанных с тем, что около 15 октября разлоки (получение прав) Filecoin могут привести к появлению дополнительной эмиссии или к заметному замедлению (некоторые аналитики оценивают снижение темпов выпуска примерно на 75%). На этом фоне, вместе с ожиданиями архивирования данных ИИ и долгосрочного/перманентного хранения, капитал смещается из испытывающих давление «основных» монет в сторону беты хранения и DePIN.
Следует учитывать: часть статистики показывает, что объём торгов по-прежнему ниже среднего за 30 дней; в краткосрочной перспективе волатильность высокая. Пробой и закрепление выше ключевых сопротивлений всё ещё требуют подтверждения объемом и макроэкономическим фоном; не стоит делать выводы, опираясь только на однодневный рост.
$FIL $AR
{spot}(FILUSDT)
#DePIN #Filecoin. #去中心化存储
не является инвестиционной рекомендацией
$FIL 领涨DePIN,存储板块逆势走强
14 сентября большинство крипто-секторов откатилось, за исключением DePIN и части Layer2, которые действовали вопреки рынку: сектор DePIN за 24 часа прибавил около 3,49%. При этом $FIL вырос примерно на 21,43%, а $AR — примерно на 9,41%; децентрализованный сегмент хранения данных: капитализация около 2,87 млрд долларов, за 24 часа — около +5,6%. В рыночном обзоре также отмечается, что в лидерах были FIL, AR и SKL, при этом по $FIL наблюдался рост объёма торгов.
Со стороны нарратива внимание рынка сосредоточено на возможном изменении темпов выпуска, связанных с тем, что около 15 октября разлоки (получение прав) Filecoin могут привести к появлению дополнительной эмиссии или к заметному замедлению (некоторые аналитики оценивают снижение темпов выпуска примерно на 75%). На этом фоне, вместе с ожиданиями архивирования данных ИИ и долгосрочного/перманентного хранения, капитал смещается из испытывающих давление «основных» монет в сторону беты хранения и DePIN.
Следует учитывать: часть статистики показывает, что объём торгов по-прежнему ниже среднего за 30 дней; в краткосрочной перспективе волатильность высокая. Пробой и закрепление выше ключевых сопротивлений всё ещё требуют подтверждения объемом и макроэкономическим фоном; не стоит делать выводы, опираясь только на однодневный рост.
$FIL $AR
#DePIN #Filecoin. #去中心化存储
не является инвестиционной рекомендацией
14 сентября большинство крипто-секторов откатилось, за исключением DePIN и части Layer2, которые действовали вопреки рынку: сектор DePIN за 24 часа прибавил около 3,49%. При этом $FIL вырос примерно на 21,43%, а $AR — примерно на 9,41%; децентрализованный сегмент хранения данных: капитализация около 2,87 млрд долларов, за 24 часа — около +5,6%. В рыночном обзоре также отмечается, что в лидерах были FIL, AR и SKL, при этом по $FIL наблюдался рост объёма торгов.
Со стороны нарратива внимание рынка сосредоточено на возможном изменении темпов выпуска, связанных с тем, что около 15 октября разлоки (получение прав) Filecoin могут привести к появлению дополнительной эмиссии или к заметному замедлению (некоторые аналитики оценивают снижение темпов выпуска примерно на 75%). На этом фоне, вместе с ожиданиями архивирования данных ИИ и долгосрочного/перманентного хранения, капитал смещается из испытывающих давление «основных» монет в сторону беты хранения и DePIN.
Следует учитывать: часть статистики показывает, что объём торгов по-прежнему ниже среднего за 30 дней; в краткосрочной перспективе волатильность высокая. Пробой и закрепление выше ключевых сопротивлений всё ещё требуют подтверждения объемом и макроэкономическим фоном; не стоит делать выводы, опираясь только на однодневный рост.
$FIL $AR
#DePIN #Filecoin. #去中心化存储
не является инвестиционной рекомендацией
1
375

{alpha}(560xd955c9ba56fb1ab30e34766e252a97ccce3d31a6)
👀 Почему никто не говорит о $XPIN ?
XPIN Network строит вокруг нарратива DePIN + AI, и это сочетание становится всё сложнее игнорировать. 🔥
Но вот вопрос:
Сможет ли XPIN превратить хайп в реальное внедрение и реальную полезность? 🤔
Я наблюдаю за:
🌐 Ростом сети
🤖 Интеграцией ИИ
📈 Активностью сообщества
🚀 Развитием экосистемы
Я не утверждаю, что $XPIN будет пампиться.
Я говорю, что это проект, за которым стоит внимательно следить. 👀
Ты уже исследовал XPIN, или он всё ещё вне твоего радара?
#XPIN #XPINNetwork #DePIN #AImodel #crypto
👀 Почему никто не говорит о $XPIN ?
XPIN Network строит вокруг нарратива DePIN + AI, и это сочетание становится всё сложнее игнорировать. 🔥
Но вот вопрос:
Сможет ли XPIN превратить хайп в реальное внедрение и реальную полезность? 🤔
Я наблюдаю за:
🌐 Ростом сети
🤖 Интеграцией ИИ
📈 Активностью сообщества
🚀 Развитием экосистемы
Я не утверждаю, что $XPIN будет пампиться.
Я говорю, что это проект, за которым стоит внимательно следить. 👀
Ты уже исследовал XPIN, или он всё ещё вне твоего радара?
#XPIN #XPINNetwork #DePIN #AImodel #crypto
XPIN Network строит вокруг нарратива DePIN + AI, и это сочетание становится всё сложнее игнорировать. 🔥
Но вот вопрос:
Сможет ли XPIN превратить хайп в реальное внедрение и реальную полезность? 🤔
Я наблюдаю за:
🌐 Ростом сети
🤖 Интеграцией ИИ
📈 Активностью сообщества
🚀 Развитием экосистемы
Я не утверждаю, что $XPIN будет пампиться.
Я говорю, что это проект, за которым стоит внимательно следить. 👀
Ты уже исследовал XPIN, или он всё ещё вне твоего радара?
#XPIN #XPINNetwork #DePIN #AImodel #crypto
1
272
·
--
Статья
Где хранятся данные, на которых обучают Искусственный интеллект?Каждый раз, когда мы взаимодействуем с моделью ИИ, она обрабатывает и генерирует гигабайты информации в реальном времени. $К 2026 году объем данных, необходимый для обучения больших языковых моделей и генеративных систем, достиг астрономических масштабов. Однако есть один важный вопрос, который задают себе немногие:
Где физически хранится вся эта информация и кто контролирует эту инфраструктуру?
В настоящее время подавляющее большинство мощностей для хранения данных и вычислений в мире сосредоточено у горстки крупных технологических гигантов. Если инфраструктура, поддерживающая ИИ, остается под контролем трех-четырех корпораций, мы сталкиваемся с серьезными рисками массовых сбоев из-за централизованных отказов, с рисками цензуры информации и с недостижимыми по масштабам затратами для независимых разработчиков.
Где хранятся данные, на которых обучают Искусственный интеллект?
Каждый раз, когда мы взаимодействуем с моделью ИИ, она обрабатывает и генерирует гигабайты информации в реальном времени. $К 2026 году объем данных, необходимый для обучения больших языковых моделей и генеративных систем, достиг астрономических масштабов. Однако есть один важный вопрос, который задают себе немногие:
Где физически хранится вся эта информация и кто контролирует эту инфраструктуру?
В настоящее время подавляющее большинство мощностей для хранения данных и вычислений в мире сосредоточено у горстки крупных технологических гигантов. Если инфраструктура, поддерживающая ИИ, остается под контролем трех-четырех корпораций, мы сталкиваемся с серьезными рисками массовых сбоев из-за централизованных отказов, с рисками цензуры информации и с недостижимыми по масштабам затратами для независимых разработчиков.
Где физически хранится вся эта информация и кто контролирует эту инфраструктуру?
В настоящее время подавляющее большинство мощностей для хранения данных и вычислений в мире сосредоточено у горстки крупных технологических гигантов. Если инфраструктура, поддерживающая ИИ, остается под контролем трех-четырех корпораций, мы сталкиваемся с серьезными рисками массовых сбоев из-за централизованных отказов, с рисками цензуры информации и с недостижимыми по масштабам затратами для независимых разработчиков.
1
79
·
--
Кто обеспечивает работу ИИ за кулисами? @fluence
Одна вещь, которая мне интересна в ИИ-агентах, заключается в том, что задержки не всегда вызваны самим моделью.
Агент может делать несколько вызовов инструментов, получать состояние, выполнять проверки, обновлять память и повторять цикл несколько раз. Пара миллисекунд задержки ЦП на каждом шаге может казаться незначительной сама по себе, но в рамках всего рабочего процесса эти задержки могут накапливаться и подтолкнуть запрос к истечению дедлайна.
Именно здесь инфраструктура становится важнее, чем может показаться на первый взгляд.
Для ИИ-нагрузок средней производительности не всегда достаточно. Реальная проблема может проявиться
особенно тогда, когда из-за конкуренции за ресурсы ЦП возникают небольшие задержки на многих этапах.
Поэтому выделенные вычисления — интересный вариант для нагрузок, где важна предсказуемая производительность.
Fluence подходит к этому с децентрализованной стороны вычислений, предоставляя разработчикам доступ к выделенным ресурсам ЦП для нагрузок, которым требуется более стабильная пропускная способность.
Я думаю, это становится всё более актуальным по мере того, как ИИ-агенты переходят от простых экспериментов к production-эксплуатации. Когда агент обрабатывает десятки шагов, снижение вариативности на каждом этапе может оказать гораздо большее влияние на конечное пользовательское впечатление.
Вопрос, за которым я слежу, прост: по мере того как агентные нагрузки становятся более сложными, станут ли предсказуемые вычисления столь же важными, как и «сырые» вычислительные мощности?
https://fluence.ai/
#Fluence #AI #DePIN
Кто обеспечивает работу ИИ за кулисами? @Fluence
Одна вещь, которая мне интересна в ИИ-агентах, заключается в том, что задержки не всегда вызваны самим моделью.
Агент может делать несколько вызовов инструментов, получать состояние, выполнять проверки, обновлять память и повторять цикл несколько раз. Пара миллисекунд задержки ЦП на каждом шаге может казаться незначительной сама по себе, но в рамках всего рабочего процесса эти задержки могут накапливаться и подтолкнуть запрос к истечению дедлайна.
Именно здесь инфраструктура становится важнее, чем может показаться на первый взгляд.
Для ИИ-нагрузок средней производительности не всегда достаточно. Реальная проблема может проявиться
особенно тогда, когда из-за конкуренции за ресурсы ЦП возникают небольшие задержки на многих этапах.
Поэтому выделенные вычисления — интересный вариант для нагрузок, где важна предсказуемая производительность.
Fluence подходит к этому с децентрализованной стороны вычислений, предоставляя разработчикам доступ к выделенным ресурсам ЦП для нагрузок, которым требуется более стабильная пропускная способность.
Я думаю, это становится всё более актуальным по мере того, как ИИ-агенты переходят от простых экспериментов к production-эксплуатации. Когда агент обрабатывает десятки шагов, снижение вариативности на каждом этапе может оказать гораздо большее влияние на конечное пользовательское впечатление.
Вопрос, за которым я слежу, прост: по мере того как агентные нагрузки становятся более сложными, станут ли предсказуемые вычисления столь же важными, как и «сырые» вычислительные мощности?
https://fluence.ai/
#Fluence #AI #DePIN
Одна вещь, которая мне интересна в ИИ-агентах, заключается в том, что задержки не всегда вызваны самим моделью.
Агент может делать несколько вызовов инструментов, получать состояние, выполнять проверки, обновлять память и повторять цикл несколько раз. Пара миллисекунд задержки ЦП на каждом шаге может казаться незначительной сама по себе, но в рамках всего рабочего процесса эти задержки могут накапливаться и подтолкнуть запрос к истечению дедлайна.
Именно здесь инфраструктура становится важнее, чем может показаться на первый взгляд.
Для ИИ-нагрузок средней производительности не всегда достаточно. Реальная проблема может проявиться
особенно тогда, когда из-за конкуренции за ресурсы ЦП возникают небольшие задержки на многих этапах.
Поэтому выделенные вычисления — интересный вариант для нагрузок, где важна предсказуемая производительность.
Fluence подходит к этому с децентрализованной стороны вычислений, предоставляя разработчикам доступ к выделенным ресурсам ЦП для нагрузок, которым требуется более стабильная пропускная способность.
Я думаю, это становится всё более актуальным по мере того, как ИИ-агенты переходят от простых экспериментов к production-эксплуатации. Когда агент обрабатывает десятки шагов, снижение вариативности на каждом этапе может оказать гораздо большее влияние на конечное пользовательское впечатление.
Вопрос, за которым я слежу, прост: по мере того как агентные нагрузки становятся более сложными, станут ли предсказуемые вычисления столь же важными, как и «сырые» вычислительные мощности?
https://fluence.ai/
#Fluence #AI #DePIN
33
·
--
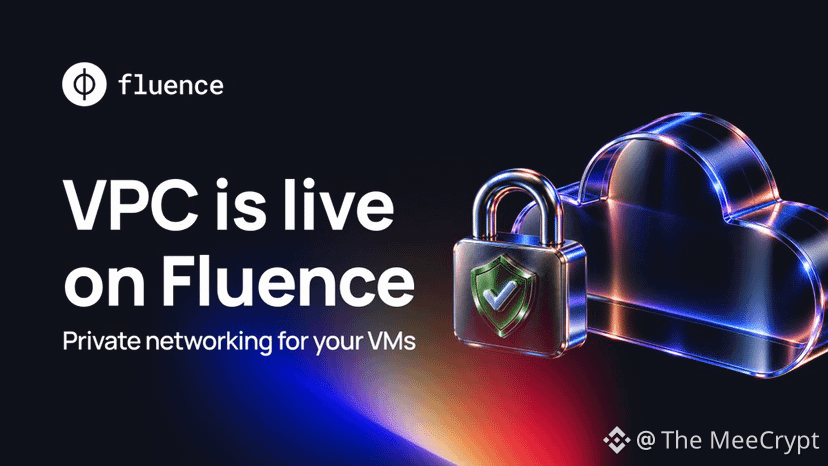
@fluence VPC запуски в продакшн могут стать важным шагом для экосистемы Fluence.
https://fluence.ai/
Новая инфраструктура VPC позволяет разработчикам запускать несколько виртуальных машин с приватным сетевым взаимодействием, группами безопасности, контролируемым исходящим трафиком (egress), опциональными публичными IP-адресами и cloud-init. Проще говоря, это делает Fluence более подходящей для запуска реальных приложений, где разные сервисы работают вместе безопасно.
С точки зрения $FLT, думаю, именно здесь становится интересно.
Новая инфраструктурная функция не означает автоматически, что цена FLT вырастет. Главный вопрос в том, поможет ли VPC Fluence привлечь больше разработчиков, рабочих нагрузок и бизнеса.
Если внедрение будет расти, больше вычислений можно будет развернуть по сети, что создаст более сильный базовый спрос и потенциально улучшит фундаментальные факторы, поддерживающие FLT.
Поэтому я слежу за использованием больше, чем за самим анонсом. Если Fluence продолжит добавлять практическую инфраструктуру и эти функции будут превращаться в реальную сетевую активность, я думаю, это со временем может стать позитивным катализатором для FLT.
Для меня тезис простой: лучше инфраструктура → больше сценариев использования → больше сетевой активности → потенциально более сильные фундаментальные показатели FLT.
#DePIN #AI #Web3
@Fluence VPC запуски в продакшн могут стать важным шагом для экосистемы Fluence.
https://fluence.ai/
Новая инфраструктура VPC позволяет разработчикам запускать несколько виртуальных машин с приватным сетевым взаимодействием, группами безопасности, контролируемым исходящим трафиком (egress), опциональными публичными IP-адресами и cloud-init. Проще говоря, это делает Fluence более подходящей для запуска реальных приложений, где разные сервисы работают вместе безопасно.
С точки зрения $FLT, думаю, именно здесь становится интересно.
Новая инфраструктурная функция не означает автоматически, что цена FLT вырастет. Главный вопрос в том, поможет ли VPC Fluence привлечь больше разработчиков, рабочих нагрузок и бизнеса.
Если внедрение будет расти, больше вычислений можно будет развернуть по сети, что создаст более сильный базовый спрос и потенциально улучшит фундаментальные факторы, поддерживающие FLT.
Поэтому я слежу за использованием больше, чем за самим анонсом. Если Fluence продолжит добавлять практическую инфраструктуру и эти функции будут превращаться в реальную сетевую активность, я думаю, это со временем может стать позитивным катализатором для FLT.
Для меня тезис простой: лучше инфраструктура → больше сценариев использования → больше сетевой активности → потенциально более сильные фундаментальные показатели FLT.
#DePIN #AI #Web3
https://fluence.ai/
Новая инфраструктура VPC позволяет разработчикам запускать несколько виртуальных машин с приватным сетевым взаимодействием, группами безопасности, контролируемым исходящим трафиком (egress), опциональными публичными IP-адресами и cloud-init. Проще говоря, это делает Fluence более подходящей для запуска реальных приложений, где разные сервисы работают вместе безопасно.
С точки зрения $FLT, думаю, именно здесь становится интересно.
Новая инфраструктурная функция не означает автоматически, что цена FLT вырастет. Главный вопрос в том, поможет ли VPC Fluence привлечь больше разработчиков, рабочих нагрузок и бизнеса.
Если внедрение будет расти, больше вычислений можно будет развернуть по сети, что создаст более сильный базовый спрос и потенциально улучшит фундаментальные факторы, поддерживающие FLT.
Поэтому я слежу за использованием больше, чем за самим анонсом. Если Fluence продолжит добавлять практическую инфраструктуру и эти функции будут превращаться в реальную сетевую активность, я думаю, это со временем может стать позитивным катализатором для FLT.
Для меня тезис простой: лучше инфраструктура → больше сценариев использования → больше сетевой активности → потенциально более сильные фундаментальные показатели FLT.
#DePIN #AI #Web3
67
·
--
🎯 Спутниковая сеть на 1 миллиард долларов — DePIN снова собирается вскипеть
📰 Space42 и Viasat объединились для создания Equatys: каждая сторона вложит по 400 млн долларов в строительство платформы связи «космос-земля», а затем планируется привлечь третью сторону еще на 200 млн долларов. Запланировано 60 орбит и 2800 спутников
💬 Совместная инфраструктура — это живой пример DePIN. Дернуть наземный сигнал не получается ни в море, ни в пустыне — именно там, на поле, узлы в цепочке могут делить «пирог»
🏷️ #DePIN #卫星互联网 #Space42 #Viasat #Web3基建
🎯 Спутниковая сеть на 1 миллиард долларов — DePIN снова собирается вскипеть
📰 Space42 и Viasat объединились для создания Equatys: каждая сторона вложит по 400 млн долларов в строительство платформы связи «космос-земля», а затем планируется привлечь третью сторону еще на 200 млн долларов. Запланировано 60 орбит и 2800 спутников
💬 Совместная инфраструктура — это живой пример DePIN. Дернуть наземный сигнал не получается ни в море, ни в пустыне — именно там, на поле, узлы в цепочке могут делить «пирог»
🏷️ #DePIN #卫星互联网 #Space42 #Viasat #Web3基建
📰 Space42 и Viasat объединились для создания Equatys: каждая сторона вложит по 400 млн долларов в строительство платформы связи «космос-земля», а затем планируется привлечь третью сторону еще на 200 млн долларов. Запланировано 60 орбит и 2800 спутников
💬 Совместная инфраструктура — это живой пример DePIN. Дернуть наземный сигнал не получается ни в море, ни в пустыне — именно там, на поле, узлы в цепочке могут делить «пирог»
🏷️ #DePIN #卫星互联网 #Space42 #Viasat #Web3基建
5

·
--
Только что добавлено $FIL примерно за $0.812. Я наблюдаю за этим уровнем, потому что нарратив децентрализованного хранения Filecoin по-прежнему имеет сильную актуальность, поскольку спрос на инфраструктуру данных продолжает расти.
Больше всего меня интересует роль сети в хранении и извлечении данных на децентрализованном рынке, где все больше пересекаются хранение, Web3 и инфраструктура для ИИ.
Если покупатели начнут заходить с более сильными объемами, у FIL может появиться пространство для уверенного восстановительного движения.
TP: $0.92–$1.05
#fil #Filecoin #DecentralizedStorage #DePIN
$FIL
{future}(FILUSDT)
Только что добавлено $FIL примерно за $0.812. Я наблюдаю за этим уровнем, потому что нарратив децентрализованного хранения Filecoin по-прежнему имеет сильную актуальность, поскольку спрос на инфраструктуру данных продолжает расти.
Больше всего меня интересует роль сети в хранении и извлечении данных на децентрализованном рынке, где все больше пересекаются хранение, Web3 и инфраструктура для ИИ.
Если покупатели начнут заходить с более сильными объемами, у FIL может появиться пространство для уверенного восстановительного движения.
TP: $0.92–$1.05
#fil #Filecoin #DecentralizedStorage #DePIN
$FIL
Больше всего меня интересует роль сети в хранении и извлечении данных на децентрализованном рынке, где все больше пересекаются хранение, Web3 и инфраструктура для ИИ.
Если покупатели начнут заходить с более сильными объемами, у FIL может появиться пространство для уверенного восстановительного движения.
TP: $0.92–$1.05
#fil #Filecoin #DecentralizedStorage #DePIN
$FIL
3
214
#opticalcommsstocksrallyover3%
Ось что движет революцией ИИ — это не только кремний, но и стекло. 🌐
Акции оптической связи, такие как Corning, Coherent и Ciena, недавно выросли более чем на 3%, сигнализируя о крупном сдвиге в инфраструктурном секторе. Этот скачок обусловлен масштабной волной инвестиций в дата-центры под ИИ, а также недавними повышениями прогнозов со стороны институциональных участников по высокоскоростным оптическим модулям. Чтобы справляться с огромными нагрузками ИИ-вычислений, сетям требуется пропускная способность, которую может обеспечить только оптоволокно.
Для крипторынка этот ралли по традиционному «железу» подтверждает ключевую теорию: важнейшим фактором является слой физической инфраструктуры. Он напрямую отражает тот импульс, который мы отслеживаем в DePIN (децентрализованных сетях физической инфраструктуры), поскольку и Web2, и Web3-секторы соревнуются в том, чтобы заложить аппаратную основу для децентрализованного ИИ.
Как вы позиционируете себя в преддверии бума инфраструктуры ИИ?
👇 Сообщите в опросе ниже!
#DePIN #AIInfrastructure #CryptoMacro
$NEAR
{future}(NEARUSDT)
$TAO
{future}(TAOUSDT)
$RENDER
{future}(RENDERUSDT)
#opticalcommsstocksrallyover3%
Ось что движет революцией ИИ — это не только кремний, но и стекло. 🌐
Акции оптической связи, такие как Corning, Coherent и Ciena, недавно выросли более чем на 3%, сигнализируя о крупном сдвиге в инфраструктурном секторе. Этот скачок обусловлен масштабной волной инвестиций в дата-центры под ИИ, а также недавними повышениями прогнозов со стороны институциональных участников по высокоскоростным оптическим модулям. Чтобы справляться с огромными нагрузками ИИ-вычислений, сетям требуется пропускная способность, которую может обеспечить только оптоволокно.
Для крипторынка этот ралли по традиционному «железу» подтверждает ключевую теорию: важнейшим фактором является слой физической инфраструктуры. Он напрямую отражает тот импульс, который мы отслеживаем в DePIN (децентрализованных сетях физической инфраструктуры), поскольку и Web2, и Web3-секторы соревнуются в том, чтобы заложить аппаратную основу для децентрализованного ИИ.
Как вы позиционируете себя в преддверии бума инфраструктуры ИИ?
👇 Сообщите в опросе ниже!
#DePIN #AIInfrastructure #CryptoMacro
$NEAR
$TAO
$RENDER
Ось что движет революцией ИИ — это не только кремний, но и стекло. 🌐
Акции оптической связи, такие как Corning, Coherent и Ciena, недавно выросли более чем на 3%, сигнализируя о крупном сдвиге в инфраструктурном секторе. Этот скачок обусловлен масштабной волной инвестиций в дата-центры под ИИ, а также недавними повышениями прогнозов со стороны институциональных участников по высокоскоростным оптическим модулям. Чтобы справляться с огромными нагрузками ИИ-вычислений, сетям требуется пропускная способность, которую может обеспечить только оптоволокно.
Для крипторынка этот ралли по традиционному «железу» подтверждает ключевую теорию: важнейшим фактором является слой физической инфраструктуры. Он напрямую отражает тот импульс, который мы отслеживаем в DePIN (децентрализованных сетях физической инфраструктуры), поскольку и Web2, и Web3-секторы соревнуются в том, чтобы заложить аппаратную основу для децентрализованного ИИ.
Как вы позиционируете себя в преддверии бума инфраструктуры ИИ?
👇 Сообщите в опросе ниже!
#DePIN #AIInfrastructure #CryptoMacro
$NEAR
$TAO
$RENDER

246
·
--
На фоне развивающегося ландшафта децентрализованной физической инфраструктуры сети, координирующие реальные ресурсы, продолжают демонстрировать ощутимую полезность, выходящую за рамки повествования. Когда сенсоры, пропускная способность и вычислительные мощности находят ончейн-координацию, капитал начинает признавать создание ценности, имеющей реальную основу. Отдавая отголоски инфраструктурным волнам 2021 года, которые вознаграждали практическое внедрение, эта глава несет 64% вероятность устойчивого роста в течение сезона, если показатели внедрения и интеграции партнерств продолжают накапливаться.
$FIL $RENDER #RadaRI106 #CoinVahini #DePIN #Infrastructure
На фоне развивающегося ландшафта децентрализованной физической инфраструктуры сети, координирующие реальные ресурсы, продолжают демонстрировать ощутимую полезность, выходящую за рамки повествования. Когда сенсоры, пропускная способность и вычислительные мощности находят ончейн-координацию, капитал начинает признавать создание ценности, имеющей реальную основу. Отдавая отголоски инфраструктурным волнам 2021 года, которые вознаграждали практическое внедрение, эта глава несет 64% вероятность устойчивого роста в течение сезона, если показатели внедрения и интеграции партнерств продолжают накапливаться.
$FIL $RENDER #RadaRI106 #CoinVahini #DePIN #Infrastructure
$FIL $RENDER #RadaRI106 #CoinVahini #DePIN #Infrastructure
1
378

·
--
Когда на рынке ажиотаж, наоборот хочется поговорить о проекте в старой, почти никем не обсуждаемой нише.
$STORJ занимается децентрализованным облачным хранилищем: файлы шифруются, режутся на фрагменты и распределяются по узлам по всему миру. По сути это монетизация простаивающих дисков и пропускной способности — один из самых ранних участников в сегменте DePIN и хранилищ.
Несколько цифр, на которые стоит обратить внимание: текущая цена около 0.067 доллара, капитализация меньше 29 млн долларов, оборот за 24 часа — порядка 18 млн долларов. Оборот (turnover) не выглядит низким, что говорит о том, что «жетоны/активы» все еще активно перемещаются. Проект не полностью забыт, но «жар» нарратива явно пошел на спад.
Хранение данных — один из немногих направлений в криптомире с реально устойчивым спросом: общий объем данных в долгосрочной перспективе растет, а издержки централизованных облачных сервисов остаются высокими — логика работает постоянно. Но реальность такова, что конкуренция в нише жесткая, а позиции лидеров плотно сжимаются. Storj хочет добиться переоценки — в итоге ей придется опираться на рост объема хранения, числа платящих клиентов и реальных доходов, а не просто повторять старую историю.
Небольшая капитализация означает и эластичность, и риск. На этапе, когда проект почти никто не обсуждает, более уместно добавить его в список наблюдения и терпеливо отслеживать, а не спешить с покупкой. Действовать не поздно и после того, как появятся сигналы по фундаментальным показателям или подтвердится ротация по сектору.
#DePIN #去中心化存储 #Storj
Когда на рынке ажиотаж, наоборот хочется поговорить о проекте в старой, почти никем не обсуждаемой нише.
$STORJ занимается децентрализованным облачным хранилищем: файлы шифруются, режутся на фрагменты и распределяются по узлам по всему миру. По сути это монетизация простаивающих дисков и пропускной способности — один из самых ранних участников в сегменте DePIN и хранилищ.
Несколько цифр, на которые стоит обратить внимание: текущая цена около 0.067 доллара, капитализация меньше 29 млн долларов, оборот за 24 часа — порядка 18 млн долларов. Оборот (turnover) не выглядит низким, что говорит о том, что «жетоны/активы» все еще активно перемещаются. Проект не полностью забыт, но «жар» нарратива явно пошел на спад.
Хранение данных — один из немногих направлений в криптомире с реально устойчивым спросом: общий объем данных в долгосрочной перспективе растет, а издержки централизованных облачных сервисов остаются высокими — логика работает постоянно. Но реальность такова, что конкуренция в нише жесткая, а позиции лидеров плотно сжимаются. Storj хочет добиться переоценки — в итоге ей придется опираться на рост объема хранения, числа платящих клиентов и реальных доходов, а не просто повторять старую историю.
Небольшая капитализация означает и эластичность, и риск. На этапе, когда проект почти никто не обсуждает, более уместно добавить его в список наблюдения и терпеливо отслеживать, а не спешить с покупкой. Действовать не поздно и после того, как появятся сигналы по фундаментальным показателям или подтвердится ротация по сектору.
#DePIN #去中心化存储 #Storj
$STORJ занимается децентрализованным облачным хранилищем: файлы шифруются, режутся на фрагменты и распределяются по узлам по всему миру. По сути это монетизация простаивающих дисков и пропускной способности — один из самых ранних участников в сегменте DePIN и хранилищ.
Несколько цифр, на которые стоит обратить внимание: текущая цена около 0.067 доллара, капитализация меньше 29 млн долларов, оборот за 24 часа — порядка 18 млн долларов. Оборот (turnover) не выглядит низким, что говорит о том, что «жетоны/активы» все еще активно перемещаются. Проект не полностью забыт, но «жар» нарратива явно пошел на спад.
Хранение данных — один из немногих направлений в криптомире с реально устойчивым спросом: общий объем данных в долгосрочной перспективе растет, а издержки централизованных облачных сервисов остаются высокими — логика работает постоянно. Но реальность такова, что конкуренция в нише жесткая, а позиции лидеров плотно сжимаются. Storj хочет добиться переоценки — в итоге ей придется опираться на рост объема хранения, числа платящих клиентов и реальных доходов, а не просто повторять старую историю.
Небольшая капитализация означает и эластичность, и риск. На этапе, когда проект почти никто не обсуждает, более уместно добавить его в список наблюдения и терпеливо отслеживать, а не спешить с покупкой. Действовать не поздно и после того, как появятся сигналы по фундаментальным показателям или подтвердится ротация по сектору.
#DePIN #去中心化存储 #Storj
58
·
--
Рост
🟧👉 Раскрытие: этот пост ( ✍️ Текст + 🖼️ изображения ) создан с помощью ИИ.
🚀 Децентрализованная стриминговая экосистема разогревается реальной сетевой активностью 🔥.
1️⃣ Спрос на газ в блокчейне быстро растёт, поскольку $TFUEL powers доставка видео и смарт-контракты ⚡.
2️⃣ Корпоративные edge-узлы продолжают обрабатывать огромные объёмы распределённой пропускной способности, одновременно сжигая $TFUEL 🌐.
3️⃣ Наблюдатели рынка замечают зоны накопления, формирующиеся в стаканах заявок бирж по $TFUEL 📈.
{spot}(TFUELUSDT)
#TFUEL #Crypto #Altcoins #Binance #DePIN .
🟥👉 Напоминание: это не 🚫 Финансовый совет (NFA). Пожалуйста 🙏 Сделайте собственное исследование (DYOR).
🟧👉 Раскрытие: этот пост ( ✍️ Текст + 🖼️ изображения ) создан с помощью ИИ.
🚀 Децентрализованная стриминговая экосистема разогревается реальной сетевой активностью 🔥.
1️⃣ Спрос на газ в блокчейне быстро растёт, поскольку $TFUEL powers доставка видео и смарт-контракты ⚡.
2️⃣ Корпоративные edge-узлы продолжают обрабатывать огромные объёмы распределённой пропускной способности, одновременно сжигая $TFUEL 🌐.
3️⃣ Наблюдатели рынка замечают зоны накопления, формирующиеся в стаканах заявок бирж по $TFUEL 📈.
#TFUEL #Crypto #Altcoins #Binance #DePIN .
🟥👉 Напоминание: это не 🚫 Финансовый совет (NFA). Пожалуйста 🙏 Сделайте собственное исследование (DYOR).
🚀 Децентрализованная стриминговая экосистема разогревается реальной сетевой активностью 🔥.
1️⃣ Спрос на газ в блокчейне быстро растёт, поскольку $TFUEL powers доставка видео и смарт-контракты ⚡.
2️⃣ Корпоративные edge-узлы продолжают обрабатывать огромные объёмы распределённой пропускной способности, одновременно сжигая $TFUEL 🌐.
3️⃣ Наблюдатели рынка замечают зоны накопления, формирующиеся в стаканах заявок бирж по $TFUEL 📈.
#TFUEL #Crypto #Altcoins #Binance #DePIN .
🟥👉 Напоминание: это не 🚫 Финансовый совет (NFA). Пожалуйста 🙏 Сделайте собственное исследование (DYOR).

23
·
--
Приведут ли децентрализованные сети физической инфраструктуры (DePIN) к следующему бычьему рынку в крипто? 🌐⚡
По мере того как технология блокчейна выходит за рамки исключительно финансовых приложений, DePIN быстро становится одним из самых перспективных секторов в Web3. Но что именно делает DePIN потенциальным катализатором для массового внедрения?
DePIN использует токен-стимулы, чтобы строить и поддерживать реальную физическую инфраструктуру — от децентрализованных беспроводных сетей и вычислительных кластеров до солнечных электросетей и решений для хранения данных. Оцифровывая вклад в оборудование, он снижает капитальные затраты и подрывает традиционных централизованных гигантов.
Соединяя цифровые токены с реальной полезностью, DePIN обеспечивает ощутимую экономическую ценность, которая выходит далеко за пределы спекулятивной торговли.
$RNDR $FIL #DePIN #Web3 #CryptoInnovation #CoinVahini
Приведут ли децентрализованные сети физической инфраструктуры (DePIN) к следующему бычьему рынку в крипто? 🌐⚡
По мере того как технология блокчейна выходит за рамки исключительно финансовых приложений, DePIN быстро становится одним из самых перспективных секторов в Web3. Но что именно делает DePIN потенциальным катализатором для массового внедрения?
DePIN использует токен-стимулы, чтобы строить и поддерживать реальную физическую инфраструктуру — от децентрализованных беспроводных сетей и вычислительных кластеров до солнечных электросетей и решений для хранения данных. Оцифровывая вклад в оборудование, он снижает капитальные затраты и подрывает традиционных централизованных гигантов.
Соединяя цифровые токены с реальной полезностью, DePIN обеспечивает ощутимую экономическую ценность, которая выходит далеко за пределы спекулятивной торговли.
$RNDR $FIL #DePIN #Web3 #CryptoInnovation #CoinVahini
По мере того как технология блокчейна выходит за рамки исключительно финансовых приложений, DePIN быстро становится одним из самых перспективных секторов в Web3. Но что именно делает DePIN потенциальным катализатором для массового внедрения?
DePIN использует токен-стимулы, чтобы строить и поддерживать реальную физическую инфраструктуру — от децентрализованных беспроводных сетей и вычислительных кластеров до солнечных электросетей и решений для хранения данных. Оцифровывая вклад в оборудование, он снижает капитальные затраты и подрывает традиционных централизованных гигантов.
Соединяя цифровые токены с реальной полезностью, DePIN обеспечивает ощутимую экономическую ценность, которая выходит далеко за пределы спекулятивной торговли.
$RNDR $FIL #DePIN #Web3 #CryptoInnovation #CoinVahini
1
253

Рынок затих, но это не значит, что нет истории. Старый проект децентрализованного хранения Storj в последнее время почти никто не обсуждает, однако данные с графика выглядят отнюдь не скучно.
Текущая цена около 0.0508 доллара, капитализация всего примерно 21.61 млн долларов, при этом 24-часовой объём торгов достигает порядка 11.86 млн долларов; дневной оборот от капитализации — более половины. Небольшая капитализация в сочетании с высоким оборотом означает, что на низких уровнях незаметно идёт постоянная смена позиций, просто ажиотаж пока ещё не вернулся к самому активу.
Storj занимается распределённым шифрованным объектным хранилищем: операторы нод предоставляют простаивающее дисковое пространство и зарабатывают на этом, а корпоративные клиенты режут данные на части, шифруют и распределённо хранят по глобальной сети нод. Это один из немногих направлений в DePIN-сегменте хранения, где есть реальный спрос с оплатой.
Когда об этом никто не говорит — как раз время, чтобы сначала добавить его в список наблюдения. Дальше ключевое — следить за двумя вещами: сможет ли объём торгов продолжать расти и когда в целом оживёт нарратив по сектору хранения. Пока «ветер» не пришёл, терпение важнее, чем гнаться за ростом.
$STORJ #DePIN #去中心化存储
Рынок затих, но это не значит, что нет истории. Старый проект децентрализованного хранения Storj в последнее время почти никто не обсуждает, однако данные с графика выглядят отнюдь не скучно.
Текущая цена около 0.0508 доллара, капитализация всего примерно 21.61 млн долларов, при этом 24-часовой объём торгов достигает порядка 11.86 млн долларов; дневной оборот от капитализации — более половины. Небольшая капитализация в сочетании с высоким оборотом означает, что на низких уровнях незаметно идёт постоянная смена позиций, просто ажиотаж пока ещё не вернулся к самому активу.
Storj занимается распределённым шифрованным объектным хранилищем: операторы нод предоставляют простаивающее дисковое пространство и зарабатывают на этом, а корпоративные клиенты режут данные на части, шифруют и распределённо хранят по глобальной сети нод. Это один из немногих направлений в DePIN-сегменте хранения, где есть реальный спрос с оплатой.
Когда об этом никто не говорит — как раз время, чтобы сначала добавить его в список наблюдения. Дальше ключевое — следить за двумя вещами: сможет ли объём торгов продолжать расти и когда в целом оживёт нарратив по сектору хранения. Пока «ветер» не пришёл, терпение важнее, чем гнаться за ростом.
$STORJ #DePIN #去中心化存储
Текущая цена около 0.0508 доллара, капитализация всего примерно 21.61 млн долларов, при этом 24-часовой объём торгов достигает порядка 11.86 млн долларов; дневной оборот от капитализации — более половины. Небольшая капитализация в сочетании с высоким оборотом означает, что на низких уровнях незаметно идёт постоянная смена позиций, просто ажиотаж пока ещё не вернулся к самому активу.
Storj занимается распределённым шифрованным объектным хранилищем: операторы нод предоставляют простаивающее дисковое пространство и зарабатывают на этом, а корпоративные клиенты режут данные на части, шифруют и распределённо хранят по глобальной сети нод. Это один из немногих направлений в DePIN-сегменте хранения, где есть реальный спрос с оплатой.
Когда об этом никто не говорит — как раз время, чтобы сначала добавить его в список наблюдения. Дальше ключевое — следить за двумя вещами: сможет ли объём торгов продолжать расти и когда в целом оживёт нарратив по сектору хранения. Пока «ветер» не пришёл, терпение важнее, чем гнаться за ростом.
$STORJ #DePIN #去中心化存储
17
🚨 Тихая ротация, которую большинство трейдеров упускают
Пока все смотрят на мемкоины, капитал незаметно перетекает в проекты в сфере AI, RWA и DePIN.
Почему это важно:
✅ Токены AI выигрывают от растущего спроса на децентрализованные вычисления.
✅ RWA выводит реальные активы on-chain, привлекая институциональный интерес.
✅ Проекты DePIN строят физическую инфраструктуру, опираясь на криптостимулы.
Следующие крупные победители часто появляются, когда внимание направлено в другую сторону.
📌 Моя позиция: Нарративы с реальной пользой могут обгонять краткосрочные всплески хайпа в долгосрочной перспективе.
⚠️ Риск: Рыночные настроения по-прежнему определяют краткосрочное движение цены. Сильные нарративы не гарантируют результат.
Какой сектор вы сейчас отслеживаете внимательнее всего: AI, RWA, DePIN или Memes? 👇
$BTC
{future}(BTCUSDT)
$ETH $BNB $LINK $RNDR
#crypto #BinanceSquare #AI #RWA #DePIN
🚨 Тихая ротация, которую большинство трейдеров упускают
Пока все смотрят на мемкоины, капитал незаметно перетекает в проекты в сфере AI, RWA и DePIN.
Почему это важно:
✅ Токены AI выигрывают от растущего спроса на децентрализованные вычисления.
✅ RWA выводит реальные активы on-chain, привлекая институциональный интерес.
✅ Проекты DePIN строят физическую инфраструктуру, опираясь на криптостимулы.
Следующие крупные победители часто появляются, когда внимание направлено в другую сторону.
📌 Моя позиция: Нарративы с реальной пользой могут обгонять краткосрочные всплески хайпа в долгосрочной перспективе.
⚠️ Риск: Рыночные настроения по-прежнему определяют краткосрочное движение цены. Сильные нарративы не гарантируют результат.
Какой сектор вы сейчас отслеживаете внимательнее всего: AI, RWA, DePIN или Memes? 👇
$BTC
$ETH $BNB $LINK $RNDR
#crypto #BinanceSquare #AI #RWA #DePIN
Пока все смотрят на мемкоины, капитал незаметно перетекает в проекты в сфере AI, RWA и DePIN.
Почему это важно:
✅ Токены AI выигрывают от растущего спроса на децентрализованные вычисления.
✅ RWA выводит реальные активы on-chain, привлекая институциональный интерес.
✅ Проекты DePIN строят физическую инфраструктуру, опираясь на криптостимулы.
Следующие крупные победители часто появляются, когда внимание направлено в другую сторону.
📌 Моя позиция: Нарративы с реальной пользой могут обгонять краткосрочные всплески хайпа в долгосрочной перспективе.
⚠️ Риск: Рыночные настроения по-прежнему определяют краткосрочное движение цены. Сильные нарративы не гарантируют результат.
Какой сектор вы сейчас отслеживаете внимательнее всего: AI, RWA, DePIN или Memes? 👇
$BTC
$ETH $BNB $LINK $RNDR
#crypto #BinanceSquare #AI #RWA #DePIN

142
$TAO находится в интересной части рынка.
Биткоин борется в районе 77–78 тыс. долларов, в то время как макродавление усиливается.
Но TAO по-прежнему остается одной из тех альткоинов, за которыми следят инвесторы, когда возвращается нарратив про ИИ.
Это различие важно.
Bittensor — это не просто ставка на «рост AI-токенов». Его тезис — о создании сети стимулов вокруг децентрализованного машинного интеллекта.
Но сейчас рынок задает более сложный вопрос:
Сможет ли TAO продолжать опережать, если ликвидность станет более скудной?
Примерно в районе 250 долларов я бы предпочел следить за структурой и подтверждениями, а не гнаться за импульсом.
Самые сильные активы не нуждаются в твоем FOMO.
Они дают тебе сценарий.
📊 ОПРОС:
Куда, по-вашему, пойдет TAO дальше?
#TAO #bittensor #AI #crypto #DePIN
$TAO находится в интересной части рынка.
Биткоин борется в районе 77–78 тыс. долларов, в то время как макродавление усиливается.
Но TAO по-прежнему остается одной из тех альткоинов, за которыми следят инвесторы, когда возвращается нарратив про ИИ.
Это различие важно.
Bittensor — это не просто ставка на «рост AI-токенов». Его тезис — о создании сети стимулов вокруг децентрализованного машинного интеллекта.
Но сейчас рынок задает более сложный вопрос:
Сможет ли TAO продолжать опережать, если ликвидность станет более скудной?
Примерно в районе 250 долларов я бы предпочел следить за структурой и подтверждениями, а не гнаться за импульсом.
Самые сильные активы не нуждаются в твоем FOMO.
Они дают тебе сценарий.
📊 ОПРОС:
Куда, по-вашему, пойдет TAO дальше?
#TAO #bittensor #AI #crypto #DePIN
Биткоин борется в районе 77–78 тыс. долларов, в то время как макродавление усиливается.
Но TAO по-прежнему остается одной из тех альткоинов, за которыми следят инвесторы, когда возвращается нарратив про ИИ.
Это различие важно.
Bittensor — это не просто ставка на «рост AI-токенов». Его тезис — о создании сети стимулов вокруг децентрализованного машинного интеллекта.
Но сейчас рынок задает более сложный вопрос:
Сможет ли TAO продолжать опережать, если ликвидность станет более скудной?
Примерно в районе 250 долларов я бы предпочел следить за структурой и подтверждениями, а не гнаться за импульсом.
Самые сильные активы не нуждаются в твоем FOMO.
Они дают тебе сценарий.
📊 ОПРОС:
Куда, по-вашему, пойдет TAO дальше?
#TAO #bittensor #AI #crypto #DePIN
🧱 Consolidation first
60%
📉 Deeper correction
30%
👀 Too early to decide
10%
10 проголосовали • Голосование закрыто
550
Войдите, чтобы посмотреть больше материала
Присоединяйтесь к пользователям криптовалют по всему миру на Binance Square
⚡️ Получайте новейшую и полезную информацию о криптоактивах.
💬 Нам доверяет крупнейшая в мире криптобиржа.
👍 Получите достоверные аналитические данные от верифицированных создателей контента.
Эл. почта/номер телефона
В тренде
1
#FedRateWatch
Просмотров: 686,918
3,251 обсуждают
2
#fomcотслеживание
Просмотров: 19,040
293 обсуждают
3
#ПротоколFOMC
Просмотров: 13,082
87 обсуждают
4
#EthereumFallsBelow$2400
Просмотров: 976
34 обсуждают
5
#USSenateBlocksClarityAct
Просмотров: 4,563
163 обсуждают
6
#BitcoinSlidesTo$76000
Просмотров: 29,671
140 обсуждают
7
#BitcoinReboundsTo$79K
Просмотров: 64,806
416 обсуждают
8
#StrategyMarketCapPassesFord
Просмотров: 50,356
790 обсуждают
9
#ClarityActOddsHalveOnPolymarket
Просмотров: 83,023
696 обсуждают
10
#US30YTreasuryYieldTops5.40%
Просмотров: 43,183
448 обсуждают