

一路生花的故事
69 Publicações
一路生花的故事
Denunciar
Bloquear Utilizador
4 A seguir
18 Seguidores
23 Gostaram
Publicações
Tudo
Cotações
·
--
Ver tradução
#opg $OPG 朋友把这仨数甩我脸上:4400模型、200万推理、26万地址。我第一反应不是“哇”,是掏出计算器——结果算出个让我尴尬的数字。
先算用户账。 26万地址分200万次,平均7.7次。7.7次什么概念?但凡用过真正的API服务,一个调试阶段都不止跑十次。如果这就是OpenGradient的“真实用户留存”,那只能说绝大多数地址是冲着预期空投来的“交互兵”,撸完即走。
再算模型账。 4400个模型抢200万次推理,均摊455次/模型。现实里跑过微调的人都知道,一个新模型挂上Hugging Face,光CI测试都不止这点量。这只能说明两件事:要么大量模型是别人上传的“僵尸权重”,要么所谓“托管”只是把模型名挂上列表,根本没进推理路由。
但我觉得最拧巴的,不是数字大小,而是逻辑错位。 OpenGradient打的旗号是“可验证AI”——推理过程要生成密码学证明,验证成本极高。如果这200万次推理全部上链验证,那Gas费早就爆炸了,项目早破产了;如果这200万次只是链下计算、只把结果传回来,那你跟传统API有什么区别?去中心化体现在哪?
这个核心机制,官网语焉不详。我看到的是,他们把“累计推理”这种服务器端计数当作活跃度指标,却回避了最关键的问题:究竟有多少推理是被验证网络共识过的?
我不是否定项目,但作为一个底层基础设施,密度坍塌的数据配上模糊的验证机制,这不是技术路线图,这是运营数据包装。下次发周报,把“每日活跃验证节点数”和“链上验证次数”甩出来,我立马闭嘴。在那之前,这三个数我只能当PR稿看。@OpenGradient
2
1
109
·
--
Pare de exagerar na capacidade de computação; o ponto fraco da IA descentralizada é a hospedagem das “tarefas sujas”
No mês passado, eu queria implantar em lote 5 pequenos modelos verticais da minha equipe em uma plataforma descentralizada. Resultado: eu fiquei mexendo até 2h da manhã e, no fim, descobri que o motivo do colapso foi simplesmente um erro de maiúscula/minúscula em uma única letra nas variáveis de ambiente. Naquele momento eu entendi: por três dias inteiros, 80% do tempo foi “adaptando na marra” para a plataforma — e só menos de duas horas foram para realmente testar o negócio. O que essa área mais precisa não é poder de computação, e sim um pipeline de hospedagem que te deixe “transmitir com os olhos fechados e fazer funcionar automaticamente”.
Depois, ao desmontar a arquitetura HACA da OpenGradient, eu senti que alguém realmente fez o trabalho operacional pesado na linha de frente. Ela fez uma coisa pouco glamourosa, mas que salvou vidas: empacotar o modelo em um pipeline padronizado. O núcleo é aquela camada de adaptação: pelo que entendi, ela mapeia operadores de frameworks diferentes — como PyTorch e ONNX — para uma expressão intermediária unificada (IR). Em outras palavras, é como colocar um “tradutor universal”: você envia qualquer formato, e ela transforma para a linguagem comum que a plataforma entende.
A camada de escalonamento é ainda mais esperta: ela divide o grafo de computação automaticamente de acordo com o tamanho dos parâmetros do modelo. Em GPUs com alta capacidade de memória para modelos grandes, ela aloca os nós adequados; para modelos pequenos, joga em nós com menor capacidade de computação. Eu não preciso escolher manualmente o tipo de máquina. E o design plugável significa que, no futuro, quando surgirem novas arquiteturas como Mamba, basta adicionar um plugin e pronto — o motor de escalonamento por baixo nem precisa ser mexido. Para um time como o nosso, que roda muitos modelos diferentes em lote, o que isso economiza não é apenas tempo, é cabelo.
#OPG
Claro, não tente transformar isso em “magia”. Se você acoplar cem modelos ao mesmo tempo, a divisão de armazenamento e a validação de direitos autorais certamente vão aparecer na hora. E a plataforma oficial ainda não apresentou uma solução perfeita para isso; essa parte precisa continuar sendo observada $OPG
Mas minha análise é bem direta: aqueles caras que vivem alimentando plataformas com dados para “dar nota em benchmark” serão provavelmente esmagados em dois anos por infraestrutura com capacidade de hospedagem superior. Por um motivo simples: computação é algo que dá pra colocar dinheiro em cima, mas a tarefa de “hospedar em lote de forma padronizada” exige empatia com desenvolvedores. A direção da OpenGradient está certa: se o armazenamento e as licenças conseguirem decolar, eu vou migrar imediatamente meus modelos principais. E investimento também: não acredite em PPT; confie na experiência “sem irritação” quando você coloca isso em produção. Isso é a verdade dura de atravessar o ciclo @OpenGradient
85
·
--
Ver tradução
上个月,一个DeFi国库被AI Agent瞬间卷走几百万U。事后全圈甩锅——节点被黑、模型带后门、指令截胡——但没谁能拿出铁证。在Web2黑盒里,服务器盘出包浆也查不出所以然。AI的法律责任和审计机制,至今仍是巨大的责任黑洞。
OpenGradient的解法不是给AI加“枷锁”,而是重构了AI验证的底层逻辑。核心就一招——拆。它把推理和验证彻底解耦:推理节点只管快速出结果,验证节点不重跑模型,而是用概率性抽查 + TEE/ZKML双重认证来事后仲裁。这跟传统区块链“全节点逐笔重算”完全不同,也区别于Phala的纯TEE(依赖硬件信任)或Giza的链下ZKML(验证滞后)。HACA真正的护城河在于:验证者不必实时跟上,但有权在任意时间点发起随机挑战,等于给每个AI动作都装了个“随时会响的警报器”。
经济模型才是真正见血的地方。验证者质押OPG参与抽检,一旦签了虚假证明,系统直接扣币——不是上耻辱柱,是直接从钱包里割肉。这套机制赌的是:验证者作恶的期望收益为负。但问题来了,我翻了半天文档,没看到明确的抗合谋设计——如果验证节点集体抱团,或者OPG筹码过度集中,这把法槌可就真成了权贵的私产。@OpenGradient
金融级AI想在黑暗森林里活下去,缺的不是算力,而是一条可审计的链。OpenGradient算扣上了第一颗纽扣。但我更怕的,是以后有人学会用密码学“铁证”来给AI的恶行合法背书——当锁链反过来变成保护伞,那才是真正的黑暗。走着瞧,但别光盯着技术,多看看质押表。
#opg $OPG
78
·
--
凌晨3:17,手机光标一闪一闪。
一个私人的健康问题,打了又删,删了又打——搜索引擎不敢敲,朋友圈不敢问。可那个瞬间,我还是鬼使神差点了发送,喂给了主流AI。
发送键弹回的瞬间,后脊发凉:这句话会去哪?会不会变成训练数据,某天再跳出来咬我?
那一晚我失眠了。我们一直在用“信任赌局”换AI便利——赌平台良心,赌黑客看不上我。可这不是信任,是没得选。
直到有人掀了这局。
#opg
OpenGradient把ChatGPT、Claude、Grok、Gemini全塞进一个界面,随时切换。但真正让我坐起来的,是这句:“我们读不到你输入的任何东西。”
不是“承诺保护”那种空话,是密码学在守门。
拆开三层防护:
· 设备端加密:问题在浏览器里就锁成乱码,钥匙只在你手里。
· Oblivious HTTP中继:中继看到IP但只看密文,网关看到明文但不知你是谁——身份和内容被劈成两半。
· TEE密封舱:解密在硬件级隔离内完成,连OpenGradient自己都碰不到,全程可验证。
三层扣完,结论干净:没人能同时拿到“谁问的”和“问了什么”。
传统AI说:“你放心,我不看。”
OpenGradient说:“你不需要放心,因为我根本看不着。”
以前总觉得智能和隐私是跷跷板两头,压下一头另一头翘起。现在技术到位了,两头都能坐稳。
如果你也曾在深夜对着输入框犹豫过,1000免费credits够你把藏了几年的问题全掏出来。
隐私不是奢侈品,是AI时代最硬的刚需。
当别人还在赌“信任”,OpenGradient已用密码学焊死后门。
$OPG 要讲的,是一个你终于敢说真话的时代。
👉 你第一个敢问的问题,藏了多久?
#OPG #OpenGradient
16
·
--
Ver tradução
#opg $OPG 我媳妇昨晚问我:"你对着手机笑什么呢?又在推特上跟人瞎聊?"我没敢接话,因为屏幕上正躺着刚给陌生人发的十条消息。她不是不让我聊,是怕平台偷听、偷看,哪天把我们的聊天记录喂给广告算法。说实话,这些年习惯了被数据扒层皮,我都麻了。但试用完OpenGradient Chat之后,我第一次觉得——原来在AI时代不裸奔,是可以做到的。
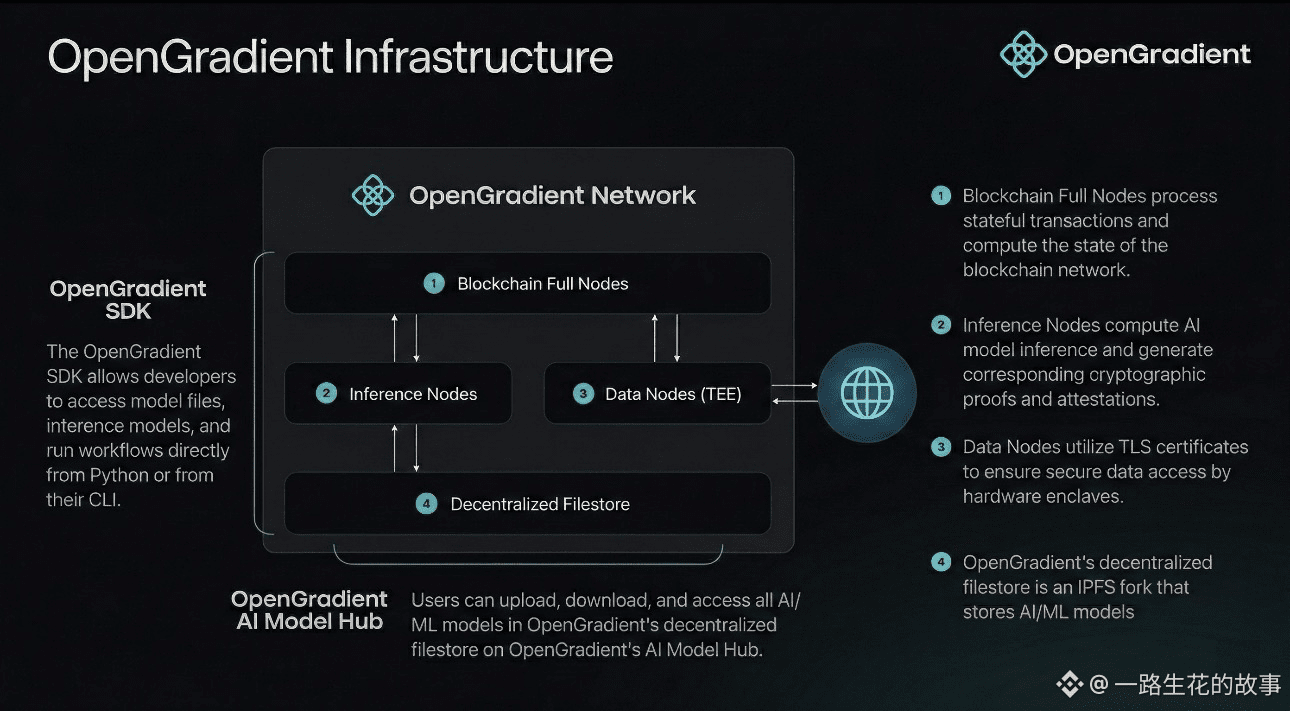
这个Chat的隐私机制,是真把“隐私”刻进DNA里了。三层分离:你在浏览器打字,密钥就在本地,消息出门就是密文;中间那个Oblivious HTTP中继,只能看到你的IP,但不知道你发了啥;到了下游网关,能解开内容却拿不到你的IP。最后所有活儿都在带远程认证的TEE里干,项目方自己想偷看,门都没有。身份和内容彻底决裂。
但隐私只是门票。真正的行业死穴是——隐私做到了,算力崩了怎么办?以前的链上AI,验证一次比跑一遍模型还贵。传统区块链靠“重跑”达成共识,让100个验证者各跑一遍70B的大模型?算力烧得吓死人,延迟直接劝退。所以OpenGradient搞了HACA架构——执行和验证分离。推理节点只管跑模型;全节点只负责验证TEE或ZKML的证明。验证节点根本不需要知道你的Prompt是啥,只需检查证明合不合法。效率直接拉满,验证毫秒级搞定,不管底层推理花了50ms还是5秒。
“AI最有用的地方,恰恰是用户最不敢打字的地方。”CEO这句话真说到心坎里了。以前半夜聊行情像做贼,因为数据在裸奔。现在用这个,哪怕我被监控拍到手在键盘上飞,中间人也只能看到一串乱码。下次媳妇再查岗,我可以直接把手机递过去——“随便看,反正你也看不懂密文。”
从a16z加速器跑出来的项目,GPT、Claude、Gemini全接进去了。有真实产品、解决刚需,这才是真资产。短期波动我根本不看,拿着,一年后见分晓。@OpenGradient
1
88
·
--
#opg $OPG Na primeira vez usando o OpenGradient Chat, eu de propósito inseri um rascunho real de estratégia DeFi — não era teste; era aposta de que ele realmente aguentaria. No momento em que apertei Enter, eu não estava olhando para a rapidez da resposta, e sim se este prompt passou pelos olhos de qualquer intermediário.
O resultado não me decepcionou. O TEE travou o fluxo da conversa; a rede Nova fez a verificação e o fechamento na cadeia — nem o provedor de nuvem, nem os operadores dos nós, nem a própria equipe conseguem bisbilhotar no nível físico. Mas depois que eu testei, fiquei ainda mais preocupado com outra coisa: a Intel.
A arquitetura HACA separa completamente execução e verificação. Tradicionalmente, quando se tenta fazer AI na blockchain, há um impasse: 100 nós validadores rodam cada um um LLM com 70B de parâmetros — o custo sobe 100 vezes e o resultado nem sempre é o mesmo. A solução da HACA é: os nós de inferência rodam o modelo dentro do TEE, geram autenticações de hardware; os nós de validação só verificam a validade das autenticações, sem precisar saber do prompt e da saída do começo ao fim. A verificação só precisa ser em escala de milissegundos. Depois de mais de dois meses no mainnet, já hospedou mais de 2000 modelos, processou mais de 2 milhões de inferências, e a a16z Crypto e a Coinbase Ventures lideraram o investimento de US$ 9,5 milhões.
Mas a segurança do TEE fica totalmente vinculada ao microcódigo da Intel/AMD. Um ataque por canal lateral TEE.Fail divulgado em outubro de 2025 custaria menos de US$ 1000 para furtar chaves a partir de SGX, TDX e SEV-SNP. A Nova garante que "o processo de execução não foi adulterado", mas não garante que "o ambiente de execução já era limpo desde o início".
Agora veja os tokens: oferta total de 1 bilhão; em circulação hoje apenas 190 milhões; desbloqueio linear da cadeia de ecossistema de 40% ao longo de 60 meses. Em 16 de junho, o preço do OPG era US$ 0,1618, com market cap de cerca de US$ 30,74 milhões e queda de 47% nas últimas 24 horas. Essa volatilidade indica que o volume em circulação é pequeno demais e as fichas estão altamente concentradas.
Minha estratégia é simples: posição extremamente baixa como posição de observação; olho para a taxa de sucesso da validação no TEE e a estabilidade da taxa de blocos dos nós. Só considero aumentar a posição depois que as duas estiverem rodando estáveis por mais de três meses. Antes disso, quem gritar All in comigo eu fico de olho no assunto com ele. Tem gente demais contando histórias neste mercado; poucas conseguem transformar história em realidade. @OpenGradient
96
·
--
Ver tradução
最近连轴转盯着大盘的轮动,满眼都是靠营销吹出来的 AI 概念概念币,看得人头昏脑涨。现在的市场风气极其浮躁,全是拿些网页端套壳应用来糊弄散户的镰刀资本,完全是在强行收割大家的智商。
说实话,若不是亲自去测试并跑通了 @OpenGradient 的底层运行逻辑,这类叙事我连看都懒得看。这项目的底层思维确实硬核,它避开了卷向红海的消费端,选择去死磕 B2B 链上智算层。这套混合网络极大地拓宽了 EVM 的边界,让原本无法处理复杂计算的智能合约能够无缝调用大模型推理。过去被天价 Gas 费卡死的复杂链上交互,如今通过其独创的算力网络终于看到了落地的可行性。#OPG
即便如此,在商言商,我们依然需要对其中的系统性风险保持清醒。由于 $OPG 的去中心化算力托管在 TEE 硬件节点上,其底层的安全系数其实和硬件厂商的信用深度绑定。一旦上游芯片出现底层微代码层面的漏洞,整套去中心化算力网络的信任背书就会顷刻间瓦解。而且,推理数据从产生到最终链上清算的短暂时间差,无异于给链上的 MEV 机器人留下了一个完美的夹击套利空间。
看了一下清算日程,大机构的持仓配额要到明年四月份才开始解锁。因此我当下的应对策略极为严谨:目前仅将其视作观察技术演进和资金情绪的风向标,以极低的仓位轻仓参与,在看到明确的技术补丁前绝不轻易把本金全押上去。#opg
72
·
--
Ver tradução
#opg $OPG OpenGradient 的 TEE 黑盒,我反而更担心硬件厂商
第一次用 OpenGradient Chat 时,我刻意输入了一段真实的 DeFi 策略草稿——不是测试,是赌它真能守住。回车敲下去的瞬间,我关注的不是回答快慢,而是这条提示词有没有经过任何中间人的眼睛。
它的做法很硬核:把整个对话进程塞进 TEE,再加 Nova 网络的链上验证。这意味着云厂商、节点运营者、甚至 OpenGradient 团队自己,都没法从物理层面偷看你的输入。执行完的哈希记录直接上链,自证清白。
这套逻辑听起来完美,但我真正好奇的不是它怎么防窥探,而是TEE 本身能不能被信任。Intel 和 AMD 的硬件安全模块出过侧信道漏洞,这不是秘密。如果一个国家级攻击者或者有物理访问权限的矿工,能在 TEE 启动前植入后门,那链上验证的哈希再漂亮也没用。Nova 的验证机制只能保证“执行过程没被篡改”,但保证不了“执行环境一开始就是干净的”。
这恰恰是 OpenGradient 必须面对的双刃剑:越强调隐私,用户对硬件安全的信任就越变成单点依赖。他们现在的应对是让验证节点分散在不同硬件供应商,但高并发下能不能保证所有 TEE 都统一更新补丁,我还没看到具体数据。
说回他们的产品策略。拿聊天机器人当入口,确实聪明。免手机号、无痕、不需要 KYC,先让用户在低风险场景里建立习惯。但真正的野心显然不在这儿——一旦这套可验证架构跑稳,DeFi 策略的自动化执行、DAO 治理投票的隐私计算、甚至高净值钱包的 AI 托管,都会顺理成章地往上接。
我会持续盯两个链上指标:一是 TEE 执行验证的频率和成功率,二是 Nova 网络里验证节点的出块率稳定性。前者暴露性能瓶颈,后者暴露硬件供应链风险。这两条线比任何营销话术都诚实。
至于 OPG 代币,等主网验证数据跑满三个月再看。现在下结论还太早@OpenGradient
78
·
--
Ver tradução
#opg $OPG 兄弟们,别被“算力中介”的叙事骗了,那都是给矿工打工的苦力活!
昨晚和几个挖DePIN的兄弟撸串,越聊越后怕。你花大价钱在链上跑个私有模型,节点矿工转手就能扒你权重;更离谱的是,为了省电费,有些逼直接用随机数糊弄推理结果。这哪是去中心化?这TM是“信任黑盒”在割大户!
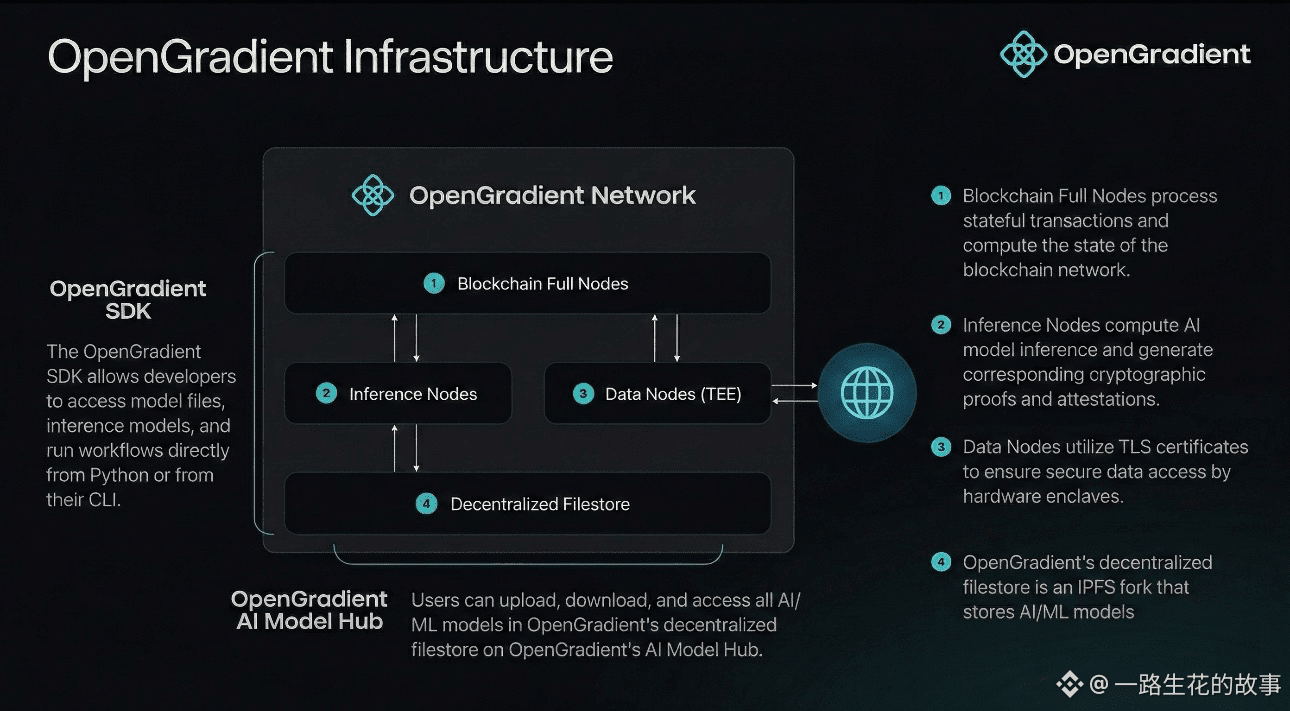
直到我扒开@OpenGradient 的白皮书,才发现什么叫降维打击。它不跟你比显卡数量,死磕的是“可信执行”。最让我拍案叫绝的是它的HACA架构——这玩意儿直接把“干活”和“查账”拆成了两条线!
传统项目傻在哪?非要100个节点重复跑一遍大模型去验证结果,成本贵到姥姥家。而OPG的玩法极其鸡贼:推理节点在TEE(可信飞地)里闷头跑模型,跑完生成一个硬件背书的密码学证明;全节点根本不需要重跑数据,只需花毫秒级时间验一下这张证明的真伪。这就把AI推理的“重体力活”和链上共识的“轻结算”彻底解耦了!
这意味着什么?矿工既碰不到我的模型权重(TEE隔离),又没法拿假结果糊弄我(密码学证明上链存证)。它卖的不是廉价算力,而是“可验证的确定性”。
这货的生态位太恐怖了,根本不是DePIN赛道的内卷,它是要做AI时代的Chainlink——隐私计算层的绝对刚需。a16z领投,团队清一色Two Sigma、Palantir出来的技术极客。$OPG锚定的不是电费成本,而是金融、医疗AI必须交的“过路费”。等主网全面铺开,传统DePIN的估值天花板在它面前就是个弟弟。这波洗盘结束,我必重仓,格局打开@OpenGradient
#opg $OPG 兄弟们,别被“算力中介”的叙事骗了,那都是给矿工打工的苦力活!
昨晚和几个挖DePIN的兄弟撸串,越聊越后怕。你花大价钱在链上跑个私有模型,节点矿工转手就能扒你权重;更离谱的是,为了省电费,有些逼直接用随机数糊弄推理结果。这哪是去中心化?这TM是“信任黑盒”在割大户!
直到我扒开@OpenGradient 的白皮书,才发现什么叫降维打击。它不跟你比显卡数量,死磕的是“可信执行”。最让我拍案叫绝的是它的HACA架构——这玩意儿直接把“干活”和“查账”拆成了两条线!
传统项目傻在哪?非要100个节点重复跑一遍大模型去验证结果,成本贵到姥姥家。而OPG的玩法极其鸡贼:推理节点在TEE(可信飞地)里闷头跑模型,跑完生成一个硬件背书的密码学证明;全节点根本不需要重跑数据,只需花毫秒级时间验一下这张证明的真伪。这就把AI推理的“重体力活”和链上共识的“轻结算”彻底解耦了!
这意味着什么?矿工既碰不到我的模型权重(TEE隔离),又没法拿假结果糊弄我(密码学证明上链存证)。它卖的不是廉价算力,而是“可验证的确定性”。
这货的生态位太恐怖了,根本不是DePIN赛道的内卷,它是要做AI时代的Chainlink——隐私计算层的绝对刚需。a16z领投,团队清一色Two Sigma、Palantir出来的技术极客。$OPG 锚定的不是电费成本,而是金融、医疗AI必须交的“过路费”。等主网全面铺开,传统DePIN的估值天花板在它面前就是个弟弟。这波洗盘结束,我必重仓,格局打开@OpenGradient
1
93
·
--
Ver tradução
#opg $OPG 聊OpenGradient,得先泼盆冷水。 满屏“AI+加密”通稿,十个项目九个蹭热度。OpenGradient拿了a16z和Coinbase Ventures领投的950万美金——但我更关心它技术能不能落地。
它不做C端聊天,死磕B2B链下推理。 复杂算力挪到链下,密码学证明传回EVM验证。白皮书核心是HACA架构:执行与验证分离。网络拆成推理节点跑模型、全节点验证证明、数据节点取外部信息。推理节点生成TEE或ZK证明上链,全节点只校验密码学有效性,不用重跑模型——毫秒级验证,不管推理花多久。截至2026年4月主网上线,托管超2000个模型,处理超200万次推理,生成超50万份证明。
三种验证模式值得细看: TEE(低开销硬件认证)、ZKML(数学级安全但计算密集)、Vanilla(纯签名)。白皮书逻辑是日常用TEE,大额资产决策上ZKML。
但经济模型有硬伤。 OPG总供应10亿,流通仅1.9亿。TGE时空投和流动性完全解锁,生态、基金会、贡献者长期线性释放——今天(6月21日)刚解锁913万枚,价值约162万美元。供给压力明牌。
更要命的是ZK证明成本。 单次可高达65美元。大盘剧烈波动时,硬件开销加链上摩擦,很可能吃掉交易利润。白皮书虽给TEE和ZKML两条路,但成本曲线能否跑通,主网数据还没给答案。
结论很直接: HACA架构自洽,技术底子在,但成本模型未经实战检验。盯着主网每笔推理的平均证明成本——低于0.01美元再考虑加仓。现在只当风控辅助工具,重仓?太早。@OpenGradient
4
1
88
·
--
Ver tradução
#opg $OPG 你让100个验证节点各跑一遍大模型?脑子没病吧?
传统区块链就这么干的——每个节点重跑每笔交易。转账没毛病,AI直接歇菜。一个70B参数的LLM,推理一次就要GPU跑半天。让100个节点各跑一遍,100倍算力浪费,出来的结果还不一样——AI这玩意儿天生非确定性,温度调高点每次输出都不同。这套逻辑根本跑不通。
OpenGradient直接换了个打法:执行和验证,彻底分开搞。
网络里三类角色各干各的。推理节点专门跑模型,跑完生成证明——要么是TEE的硬件背书,证明代码环境没被动过;要么是ZKML的数学证明,证明模型确实跑出了那个结果,全程看不到权重也看不到输入。全节点只负责验证证明有没有效,毫秒级搞定,跟你底层跑了50毫秒还是5秒没关系。数据节点在TEE里抓外部数据,防拦截防篡改。
OPG是这网络的命根子。总量10亿,一个不增。用户花OPG调模型;推理$OPG 节点和验证节点赚OPG;节点得质押OPG才能进场,敢作恶直接罚没;开发者把模型挂上Model Hub,被人调用了也能分到OPG。闭环里每一个动作都在消耗或锁定OPG——这才是价格逻辑的硬核支撑。
截至2026年4月主网上线,网络已托管超4400个模型,处理超200万次可验证推理,生成超50万份密码学证明,独立钱包超26万个。a16z crypto、Coinbase Ventures投了950万美元。6月15号刚上了Upbit。
这套架构把AI从“你爱信不信”的黑盒,变成了“随时可以查账”的透明计算。每一次推理都可审计,不需要信任任何单一运营方。验证层不碰你的原始数据,隐私和可信同时成立。
自己去翻翻他们的测试网数据,别光听别人吹。
@OpenGradient
71
·
--
Ver tradução
#opg $OPG
上周我用Claude查中世纪宗教裁判所的卷宗记录,它弹了句“换个话题吧”。我没犯法,就想查点冷门历史,这也不行。后来换Gemini问社会习俗起源,直接给我上价值观教育。大厂AI全跟外交部似的,滴水不漏,但你也别想掏到任何有棱角的东西。
后来有人推OpenGradient Chat,Claude Fable 5他们第一批就挂上了。我把被拒的问题扔过去,全接了,回答很直接,没有“出于安全考虑”的废话。
但真正让我觉得不一样的,是私聊模式。切过去能调一个叫Nous Hermes的模型,它好像根本没装道德过滤器。我把憋了一肚子的话全倒进去,包括阴暗的揣测,它全接着,还会顺着反问“你觉得背后的动机是什么”。连跟主流相悖的观点,它连警告框都不弹,就安静地聊完,像嘴巴特别严的朋友深夜陪你抽烟。
隐私这块,他们端到端加密,记录不留存,不然谁敢真聊敏感话题。
然后我看了他们代币OPG。调用Nous Hermes的深度问答要消耗极微量Gas,只能用OPG支付。只要有人想“关起门说真话”,就必须持有OPG,这是硬性消耗,不是“我猜”。后面更逆天的模型还得质押OPG拿白名单。这东西的价格逻辑,本质就是“言论自由税”的市场定价。
这种绝对自由的AI在监管环境下就是刀尖舔血,不知道能撑多久。但我已经把OPG警报设好了,新模型上线第一时间冲进去抢质押。
有些话,你只能在机器面前说,因为机器不会用道德大棒砸你。
他们还在测试阶段,部分地区得翻墙。反正我不实名,说就说了。你要有“不知道跟谁说”的话,关了灯去试试,谁也不知道你问过什么。@OpenGradient
1
110
·
--
Ver tradução
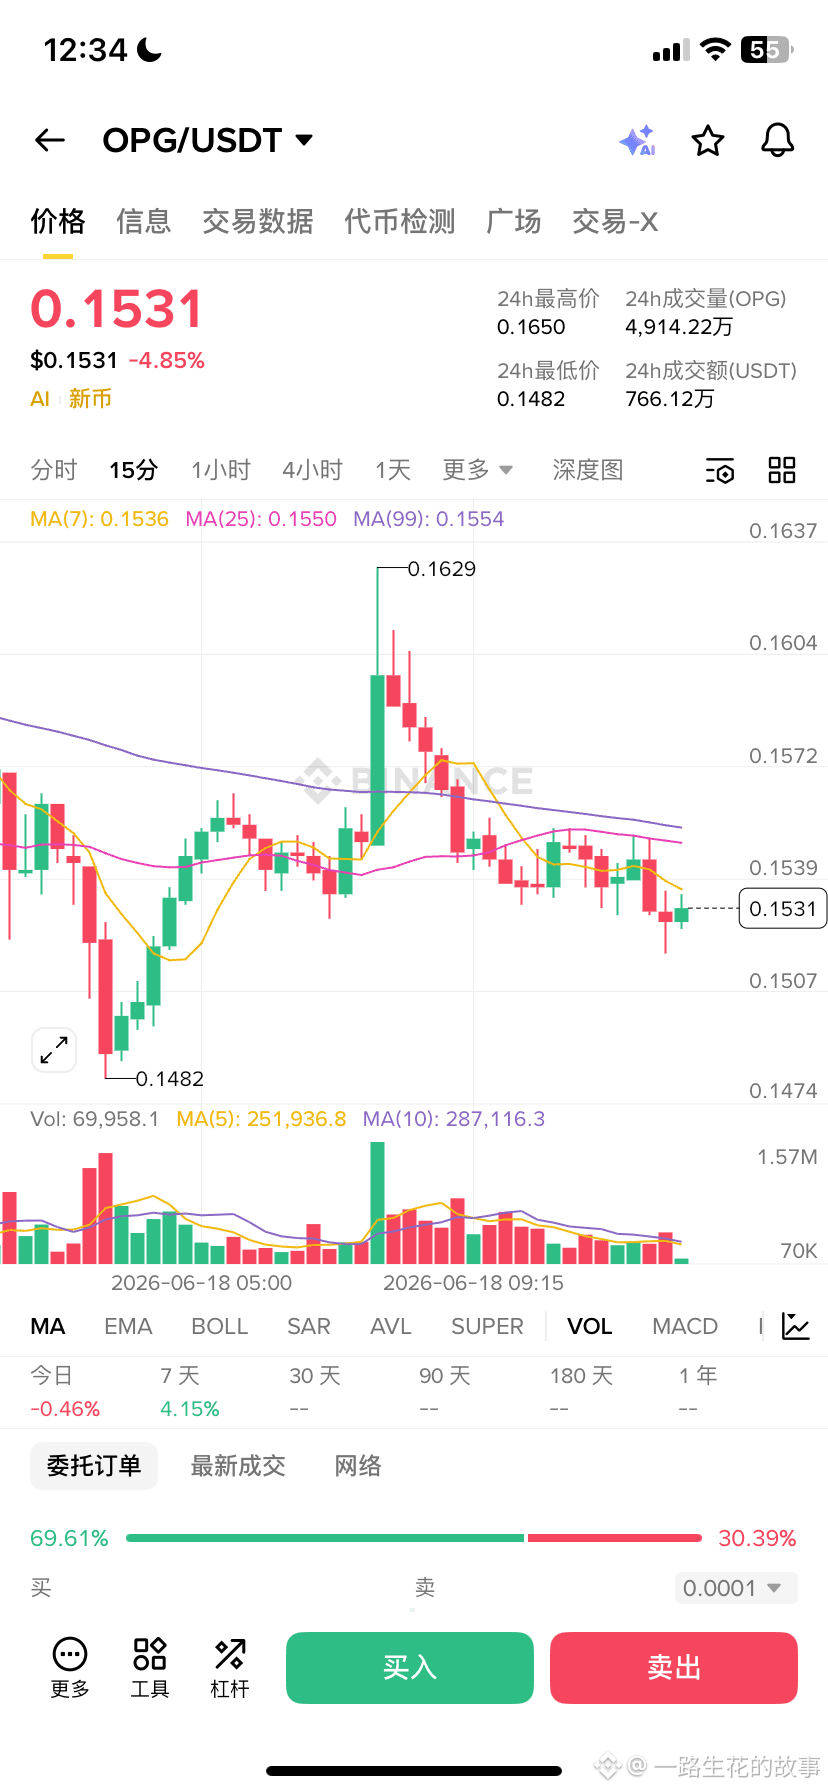
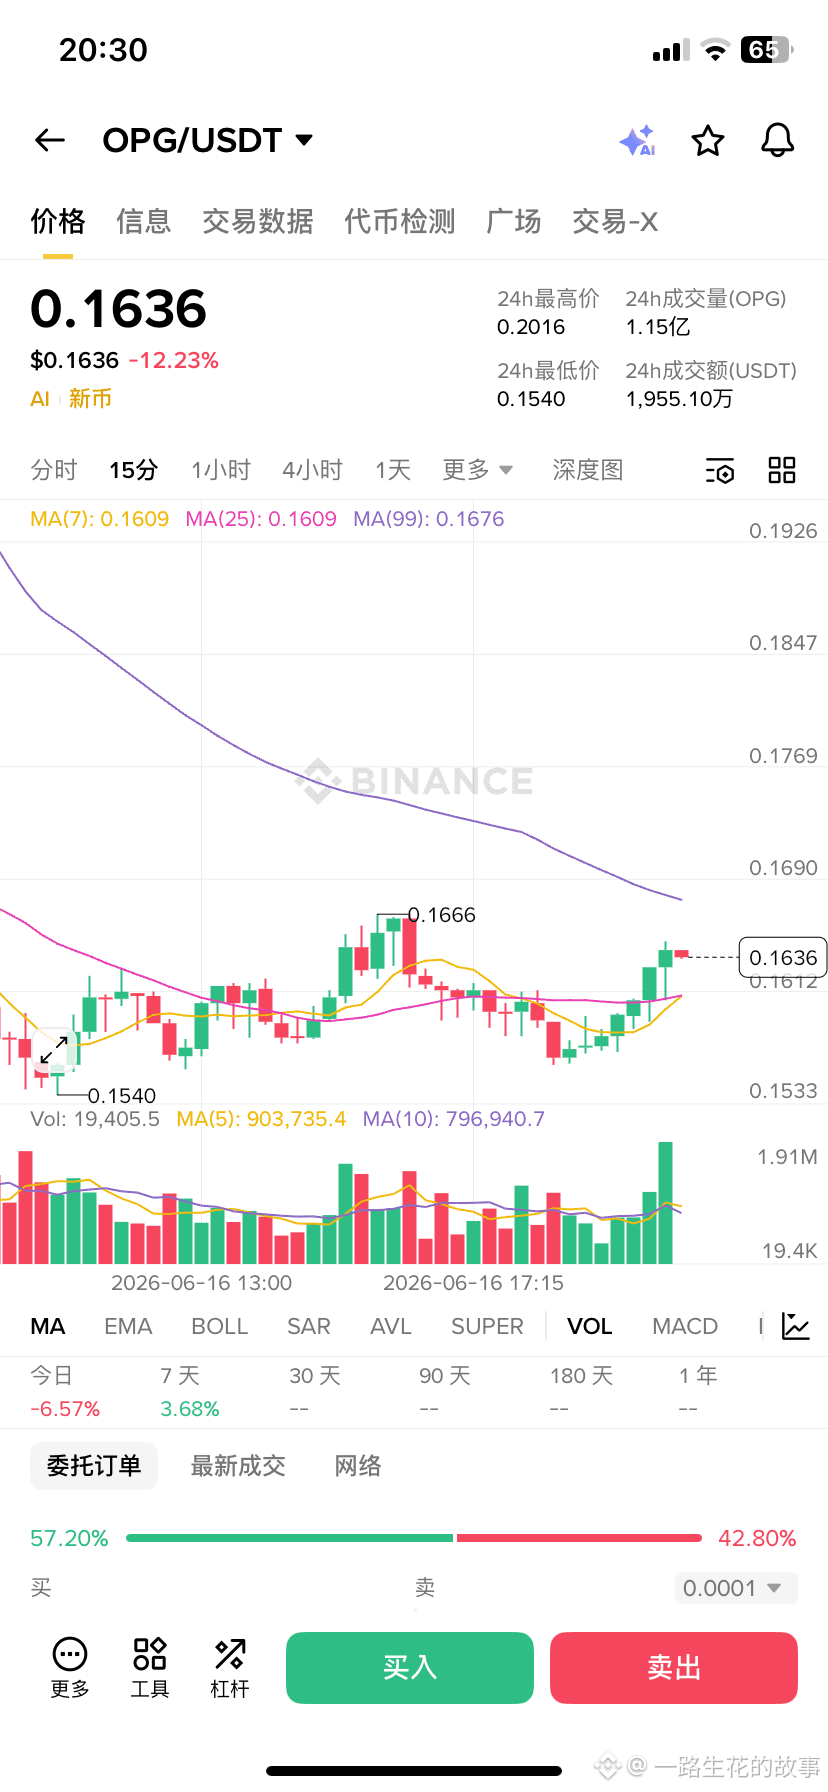
#opg $OPG 盯了一天盘,OPG从高点0.67跌到现在的0.16左右,跌幅超过70%。有人慌了,我倒觉得这个时候反而应该冷静看看——跌下来的是价格,不是技术基本面。
说几个我关注到的点。
第一,这轮下跌有结构性的解释。
OPG代币总量10亿枚,目前流通只有1.9亿枚,占比19%。剩下81%都在锁仓或者线性解锁中——生态系统的4亿枚要分60个月释放,核心贡献者和投资者的1.5亿和1亿枚分别锁12个月再分36个月释放。这意味着什么?短期的抛压其实比很多人想象的要可控。 6月15日那波下跌,更像是币安和Upbit上线后短期流动性脉冲带来的波动,不是大规模解锁砸盘。
第二,网络数据在涨,价格没跟上。
截至6月中旬,OpenGradient网络已经处理了超过200万次可验证AI推理,部署了超过4400个AI模型,独立钱包地址超过26万个。这些指标在DePIN赛道里不算差。价格和基本面出现背离,对短线交易者是风险,但对长线观察者可能是机会窗口。
第三,x402协议升级被忽略了。
最近OpenGradient完成了x402协议升级,实现了TEE内支付和验证的闭环。说白了就是支付和验证不需要第三方介入了,整个链上AI推理的信任成本又低了一截。技术细节不展开,但这个升级对商业落地的影响可能被市场低估了。
我的判断: 现在OPG处于叙事驱动到功能验证的切换期。纯炒概念的阶段过去了,接下来要看的是推理调用量能不能持续增长、质押率有没有提升。6月30日币安广场活动结束后的链上数据,会比今天的K线图更有说服力。
👇你觉得这是错杀还是估值回归?评论区聊聊。@OpenGradient
111
·
--
Ver tradução
#opg $OPG OPG的HACA架构,把AI推理的“信任成本”打下来了
AI赛道这么多DePIN项目,为什么OPG值得单独拎出来聊?我仔细看了下它的白皮书,发现一个关键设计——HACA混合计算架构。
简单说就是把AI推理和验证拆成两件事。推理节点只管算,全节点专门验证结果对不对。这个逻辑听起来简单,但解决的是AI行业最头疼的问题:你怎么知道你调用的模型没在骗你?
现在的中心化AI就是个黑箱,你输入问题拿到结果,中间过程完全不可见。OPG的做法是让验证节点用轻量级的方式复核推理路径,相当于每笔计算都有一张“小票”。技术上用了TEE做常规验证,碰到高价值场景还能切到ZK证明——两种模式按需切换,成本可控。
我的判断是:这个架构的商业价值被低估了。
为什么?因为DePIN赛道不缺算力项目,但缺“可验证算力”。传统企业不敢把核心业务交给去中心化AI,最大的障碍就是不确定性——万一算错了谁负责?OPG把验证机制做成底层标配,相当于给了开发者一个法律意义上的“审计轨迹”。
当然,项目还在早期。HACA的实际验证效率能不能扛住大规模商用,需要等6月30日活动结束后的链上数据来验证。但至少从架构设计上,OPG找对了AI商业化的关键卡点。
个人看法,这项目技术底子够硬,社区热度目前还差口气——就看这波币安广场活动能不能带起来了。
👇你觉得可验证AI推理是刚需还是伪需求?评论区聊。@OpenGradient
76
·
--
#opg $OPG A maioria dos projetos de AI + blockchain apenas jogam os resultados dos modelos na cadeia, mas ninguém consegue validar se os resultados estão corretos. O whitepaper da OpenGradient expõe a contradição central — blockchains tradicionais dependem da "reexecução das transações por cada nó" para alcançar consenso, o que logicamente funciona para transferências, mas falha completamente em inferências de AI.
Por quê? Executar LLM exige GPU, fazer com que 100 nós de validação executem tudo uma vez resulta em 100 vezes o custo; a saída do LLM tem aleatoriedade, os nós de validação não conseguem simplesmente checar a resposta; uma inferência leva alguns segundos, e quando todos os nós terminam, a cadeia já está travada. Usar AI como oráculo — rodar os resultados fora da cadeia e alimentá-los na cadeia — ainda é "o problema do oráculo invertido": você acaba tendo que confiar em um único sujeito que fornece os dados.
A solução da OpenGradient: separação de execução e validação. Os nós de inferência processam as solicitações dentro de um TEE e geram provas de hardware — provando que o código não foi alterado, que a entrada não foi manipulada e que a saída não foi comprometida. Nós completos apenas validam a prova (operações puramente criptográficas), não precisam saber as palavras-chave, o modelo ou o conteúdo retornado. ZKML funciona da mesma forma, apenas substituindo por provas de conhecimento zero. A camada de validação nunca reexecuta os cálculos de AI, validar uma prova leva apenas alguns milissegundos.
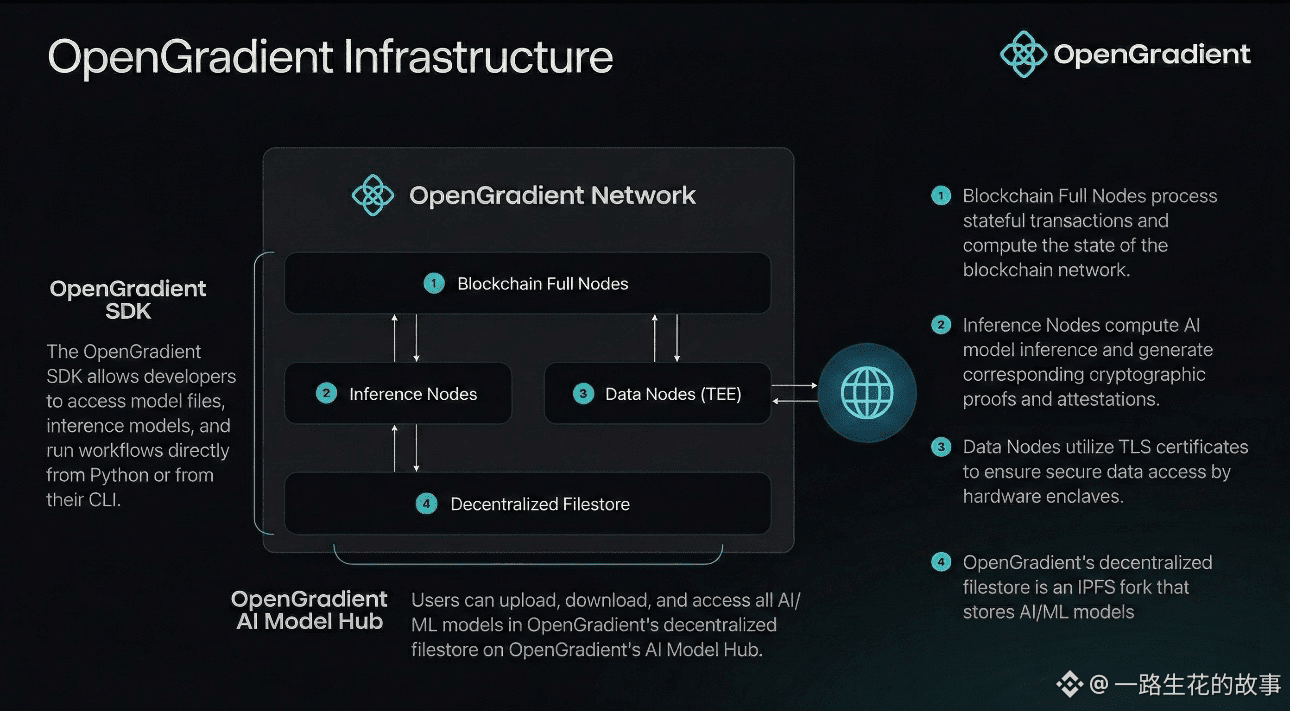
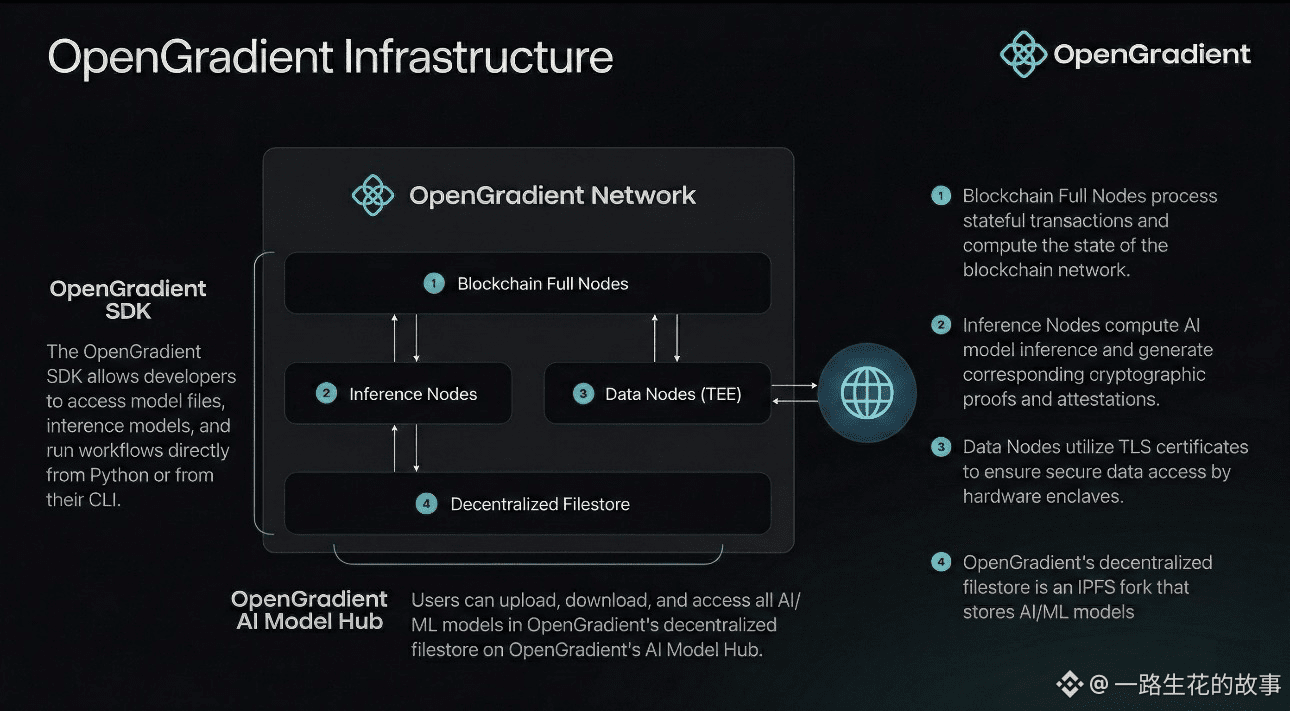
A rede é dividida em quatro tipos de nós: nós de inferência (execução em GPU), nós completos (validação de provas + consenso CometBFT), nós de dados (TEE obtendo dados externos) e camada de armazenamento. Compatível com EVM, desenvolvedores podem usar Hardhat, Foundry para chamadas diretas.
O suprimento total de OPG é de 1 bilhão de tokens, com a distribuição: 40% para o ecossistema, 15% para a fundação, 15% para contribuintes principais, 10% para investidores, 10% para recompensas de staking, 6% para liquidez, 4% para airdrop. Usado para pagar taxas de inferência, staking de nós, incentivos de modelo e governança.
Riscos: TEE depende de fabricantes de hardware, se houver vulnerabilidades, a credibilidade da prova é comprometida; o custo de geração de provas ZKML ainda não é amigável para cenários de baixa latência; o desbloqueio prolongado de 1 bilhão de tokens pode trazer pressão de venda.
Opinião pessoal: A OpenGradient reestrutura a camada de validação em torno das necessidades reais de AI, a lógica se mantém coesa. Mas o desempenho real precisa ser validado com dados da mainnet, a direção é digna de acompanhamento.
TEE + ZKML pode resolver o caixa-preto da AI? Vamos discutir na seção de comentários.@OpenGradient
1
1
98
·
--
Ver tradução
#opg $OPG 有个事我一直没搞懂。一个AI请求进来,十几个节点都看到了,谁接?
如果谁手快谁接,那网速快的永远有活,慢的永远没活。最后就剩下两三个大户,别的节点全饿死。这还去什么中心化。
OpenGradient在白皮书里给了个解法:摇号。
不是瞎摇。系统拿当前区块的哈希加上这个请求的ID,一起扔进一个叫VRF的东西里,算出一个随机数。然后用这个随机数给所有在线节点排个序。排第一的节点优先接单。它必须在规定时间内把结果和证明交上来。如果它超时或者作弊,顺延给第二名,依此类推。
关键是这个随机数是可验证的。节点不能作弊,因为排序逻辑是公开的,谁都可以重新算一遍。白皮书里写的是用零知识证明来保证随机数确实是按规则生成的。你想提前知道下一个请求是谁?门都没有。
之前看另一个项目也搞VRF,结果排序还是被抢跑了。后来发现是随机种子被节点提前猜到了。OpenGradient这边把种子和区块哈希绑死,区块哈希没法预测,算是堵上了这个洞。
但这个设计有个烦人的地方。如果一个节点故意超时,它不会立刻被罚质押,只是被暂时踢出队列。连续超时好几次才会触发惩罚。白皮书管这个叫“软惩罚”。我能理解,网络抖动谁都有,一超时就直接罚钱确实太狠。但这也给了恶心人的空间——有人可以故意反复超时,拖慢整体效率。你拿它没办法,因为它没到惩罚阈值。
白皮书没写具体的超时次数和惩罚阈值是多少,估计是留给主网上线后根据实际情况调的。
反正我觉得,这个摇号机制方向对,但防君子不防小人。遇到故意卡bug的,可能还得靠社区举报。
你怎么看?你觉得这种排序方式公平吗?欢迎拍砖。@OpenGradient
119
·
--
#bedrock $BR O fluxo de capital no mercado reflete claramente a evolução do ecossistema BTCFi. Com a queda drástica do hype em modelos de staking tradicionais, que dependem de airdrops e promessas de tokens futuros, os traders estão cada vez mais focados em retornos concretos. Muitos estão migrando para produtos de arbitragem cross-chain, enquanto a liquidez das criptos se fragmenta em diferentes ecossistemas. O Bedrock2.0, com seu novo framework PoSL, rapidamente ganha atenção no mercado.
O framework PoSL quebra as limitações da tradicional mapeação de ativos, visando construir um hub de liquidez que conecta a mainnet BTC, o ecossistema Ethereum e o mercado de poder computacional DePIN. Utilizando uniBTC como um roteador cross-chain, os BTC ociosos em cold wallets podem ser convertidos em direitos de poder computacional, permitindo que os detentores de $BR acessem livremente múltiplos Vaults na plataforma, aproveitando a diferença de juros entre protocolos para obter retornos em camadas. O design do produto apresenta uma vantagem clara em relação a projetos de staking homogêneos.
Por trás dos retornos atraentes, a falta de consenso entre múltiplas chains cria riscos de segurança. O BTC utiliza mineração PoW, com longos intervalos entre blocos e o risco de rollback de blocos. Chains de segunda camada e DePIN dependem de um consenso rápido para garantir direitos em tempo real. Se o uniBTC completar a distribuição de lucros em uma rede rápida, mas a transação subjacente em BTC for inesperadamente revertida, os lucros já pagos se tornam irrecuperáveis, resultando em contas a receber problemáticas a longo prazo. Malfeitores podem explorar a diferença de confirmação para realizar ataques de double spend, prejudicando as reservas de segurança do projeto.
Investidores institucionais do setor continuam a monitorar essa vulnerabilidade técnica e não vão se deixar levar por altas APYs. A ideia de revitalizar BTC ocioso está alinhada com a tendência de desenvolvimento do setor, mas a questão da certeza assíncrona ainda não possui soluções maduras. O planejamento cross-chain de todo o ecossistema ainda está em fase de testes e riscos. Usuários comuns devem ter uma visão racional sobre a promoção das vantagens do projeto, evitando investimentos pesados, optando por uma abordagem mais leve e observadora. @Bedrock
#Bedrock #btcfire
69
·
--
#bedrock $BR Ultimamente, o pessoal na praça anda reclamando: o farming tá cada vez mais complicado e os airdrops tão cada vez mais fracos. As verdadeiras oportunidades de longo prazo, na verdade, estão escondidas em projetos que "tem uso" para os tokens.
Hoje vamos falar sobre um caso que está mudando o cenário de lucros do Bitcoin: Bedrock 2.0 e seu token $BR .
---
No Bedrock 2.0, o $BR não é mais um simples token de recompensa, mas sim o "combustível de entrada" para todo o motor de lucros do Bitcoin. Quer entrar nas estratégias top de BTCfi? Primeiro, você precisa segurar $BR.
Um sistema de níveis (Tiers) vai ser lançado em breve: quanto mais você travar, maior seu nível, e maiores serão os multiplicadores de lucro que você pode desfrutar. E o mais importante, instituições como a Alpha-Selini têm capacidade de cofre limitada, e os detentores de BR de alto nível terão acesso prioritário. Sem $BR, você pode nem conseguir embarcar.
Essa é a fonte do FOMO — quando cada vez mais grana entra no cofre do uniBTC, a demanda do mercado por BR vai rapidamente esgotar a oferta circulante.
Além disso, o BR pode desbloquear funcionalidades avançadas de modelagem de dados do AI copiloto BRclaw. Esse analista on-chain pode te ajudar a desbravar os riscos e retornos de estratégias complexas, fazendo você decidir como uma instituição. @Bedrock
---
Segurar BR não é apenas estocar um token, mas sim garantir um passe VIP para lucros em Bitcoin de nível institucional.
#bedrock $BR Ultimamente, o pessoal na praça anda reclamando: o farming tá cada vez mais complicado e os airdrops tão cada vez mais fracos. As verdadeiras oportunidades de longo prazo, na verdade, estão escondidas em projetos que "tem uso" para os tokens.
Hoje vamos falar sobre um caso que está mudando o cenário de lucros do Bitcoin: Bedrock 2.0 e seu token $BR .
---
No Bedrock 2.0, o $BR não é mais um simples token de recompensa, mas sim o "combustível de entrada" para todo o motor de lucros do Bitcoin. Quer entrar nas estratégias top de BTCfi? Primeiro, você precisa segurar $BR .
Um sistema de níveis (Tiers) vai ser lançado em breve: quanto mais você travar, maior seu nível, e maiores serão os multiplicadores de lucro que você pode desfrutar. E o mais importante, instituições como a Alpha-Selini têm capacidade de cofre limitada, e os detentores de BR de alto nível terão acesso prioritário. Sem $BR , você pode nem conseguir embarcar.
Essa é a fonte do FOMO — quando cada vez mais grana entra no cofre do uniBTC, a demanda do mercado por BR vai rapidamente esgotar a oferta circulante.
Além disso, o BR pode desbloquear funcionalidades avançadas de modelagem de dados do AI copiloto BRclaw. Esse analista on-chain pode te ajudar a desbravar os riscos e retornos de estratégias complexas, fazendo você decidir como uma instituição. @Bedrock
---
Segurar BR não é apenas estocar um token, mas sim garantir um passe VIP para lucros em Bitcoin de nível institucional.
216
·
--
#bedrock $BR Depois de brincar com BTCFi por um tempo, eu já fui atrás de projetos de alta APY que na verdade eram esquemas de pirâmide. No final, quando os subsídios acabaram, os lucros despencaram e eu percebi que essa estratégia de empilhar tokens não vai longe.
Meus amigos estão focados no uniBTC, tentando se posicionar em uma cadeia de cada vez, mas poucos estão explorando as mudanças fundamentais do Bedrock 2.0. Antes da atualização, meu BTC só podia ser atrelado à staking do Babylon, e os ganhos vinham apenas dos juros básicos + airdrops esporádicos, com o teto de lucro totalmente nas mãos do projeto.
Após a atualização, as mudanças são palpáveis. Agora, ao colocar meus tokens no protocolo, não preciso mais fazer movimentações manuais. O código-fonte fica monitorando o mercado 24/7, e onde houver oportunidades de arbitragem de cross-chain ou hedge neutro, o capital é automaticamente redirecionado para capturar esses lucros, sem depender da emissão de novos tokens pela equipe do projeto.
$BR deixou de ser apenas um recibo de staking e se tornou a chave para a alocação de fundos no protocolo. Para ser sincero, a complexidade das estratégias de contratos é alta e os riscos contratuais não podem ser totalmente evitados, mas em comparação com a bagunça de taxas de juros anuais inflacionadas no setor, essa abordagem que gera lucro real através de arbitragem é muito mais amigável para os hodlers. #bedrock $BR @Bedrock
181
·
--
Ver tradução
#bedrock $BR
最近大饼横盘震荡,很多人开始焦虑:冲高APY怕跑路,躺平又怕踏空。其实比涨跌更重要的,是找到“不依赖方向”的收益方式。
今天聊聊Bedrock 2.0——一个让普通用户也能用上机构级策略的智能收益引擎。
---
Bedrock从单一收益池进化成动态路由层uniBTC,可根据市场自动配置资本。最新模块化金库框架带来四大策略:Delta-中性套利、纯流动性配置、信用贷款和RWA,其中Alpha-Selini金库由Selini Capital管理,采用市场中性的高频交易。
更关键的是AI链上分析师BRclaw,帮你拆解不同金库的风险与收益,像副驾驶一样带你操作。目前BRclaw测试中,即将扩大访问。
$BR不再只是奖励代币,而是收益引擎的接入密钥。持有越高等级,享收益乘数、优先抢容量有限的机构金库,还能解锁BRclaw深度数据功能。
---
👉 @Bedrock 备好 $BR 与 uniBTC,迎接模块化金库上线。
#Bedrock $BR
{future}(BRUSDT)
#bedrock $BR
最近大饼横盘震荡,很多人开始焦虑:冲高APY怕跑路,躺平又怕踏空。其实比涨跌更重要的,是找到“不依赖方向”的收益方式。
今天聊聊Bedrock 2.0——一个让普通用户也能用上机构级策略的智能收益引擎。
---
Bedrock从单一收益池进化成动态路由层uniBTC,可根据市场自动配置资本。最新模块化金库框架带来四大策略:Delta-中性套利、纯流动性配置、信用贷款和RWA,其中Alpha-Selini金库由Selini Capital管理,采用市场中性的高频交易。
更关键的是AI链上分析师BRclaw,帮你拆解不同金库的风险与收益,像副驾驶一样带你操作。目前BRclaw测试中,即将扩大访问。
$BR 不再只是奖励代币,而是收益引擎的接入密钥。持有越高等级,享收益乘数、优先抢容量有限的机构金库,还能解锁BRclaw深度数据功能。
---
👉 @Bedrock 备好 $BR 与 uniBTC,迎接模块化金库上线。
#Bedrock $BR
216
Inicia sessão para explorar mais conteúdos
Junta-te a utilizadores de criptomoedas de todo o mundo na Binance Square
⚡️ Obtém informações úteis e recentes sobre criptomoedas.
💬 Com a confiança da maior exchange de criptomoedas do mundo.
👍 Descobre perspetivas reais de criadores verificados.
E-mail/Número de telefone
Tópicos em Tendência
DriftHackVictimsBeginClaims
42,259 visualizações
558 a discutir
As vítimas do ataque à Drift já podem começar a reivindicar tokens de recuperação DFX pelas perdas sofridas no exploit de abril de 2026.
Foram verificadas perdas de cerca de US$ 295,4 milhões.
Inicialmente, o fundo de recuperação tinha apenas cerca de US$ 3,11 milhões.
Assim, no lançamento, 1 DFX representava US$ 1 em perdas, mas o primeiro resgate valeu apenas cerca de US$ 0,0104 — aproximadamente 1 centavo por cada US$ 1 perdido.
As vítimas podem resgatar, vender ou manter seus DFX.
O grande porém: resgatar queima os DFX, então você abre mão da possível participação desse token em futuros fundos de recuperação.
👉 A pergunta-chave: se a Drift adicionar muito mais dinheiro ao fundo de recuperação, será que os DFX poderão, eventualmente, ajudar as vítimas a recuperar uma porcentagem bem maior do que perderam?
#DriftHackVictimsBeginClaims
$NVDAB
Irfanba
·0 gostos
·9 visualizações
SolanaTokenizedStockVolumeTops$4.4BInSeptember
6,179 visualizações
64 a discutir
BitcoinSpotETFsDraw$6.34BInflowsInQ3
19,272 visualizações
180 a discutir