

宝玉(Parody)
37 Publicações
宝玉(Parody)
Denunciar
Bloquear Utilizador
0 A seguir
2 Seguidores
1 Gostaram
Publicações
Tudo
Vídeos
·
--
Hoje, ao testar o Manus, aprendi uma dica: ao criar desenhos, em vez de usar prompts para controlar o estilo e os detalhes, basta fornecer uma imagem de referência. E nessa imagem de referência já devem estar incluídos cores, demonstração de fontes, fibras do papel arroz, bordas marcadas pela tinta, marcas de água, montanhas ao fundo, selos e regras de espaços em branco, etc.
Assim, a estabilidade da geração fica mais alta, e o prompt de conteúdo também pode ser bem simples.
Figura 1: Imagem de referência
Figura 2 content_prompt:
> Título “Chá e vida lenta”; subtítulo “Reserve um pouco de tempo, para uma xícara de chá”. O design deve seguir o estilo da imagem de referência: silencioso, contido, wabi-sabi; usar um estilo minimalista em pintura com tinta e espaços em branco em estilo de tinta; o fundo deve ser textura de papel de arroz. O texto deve ficar centralizado e legível.
Figura 3 content_prompt:
> Título “Acalme o cotidiano”. Conteúdo: “Aqueça: primeiro sinta a temperatura dos utensílios”, “Aprecie o aroma: perceba o cheiro do chá e da água”, “Deguste: tome pequenos goles de chá, com uma pausa curta”. O design deve seguir o estilo da primeira página e da imagem de referência: silencioso, contido, estilo minimalista em tinta; usar poucos elementos em tinta (como montanhas ao fundo, marcas de água de utensílios de chá etc.) para pontuar as áreas de espaços em branco; fundo com textura de papel de arroz. A diagramação do texto deve transmitir senso de hierarquia e espaços em branco.
--- Prompt completo da Figura 2 ---
Crie um slide de apresentação profissional com o seguinte conteúdo:
Título “Chá e vida lenta”; subtítulo “Reserve um pouco de tempo, para uma xícara de chá”. O design deve seguir o estilo da imagem de referência: silencioso, contido, wabi-sabi; usar um estilo minimalista em pintura com tinta e espaços em branco em estilo de tinta; o fundo deve ser textura de papel de arroz. O texto deve ficar centralizado e legível.
Orientação de Hierarquia e Layout:
- Comece com o elemento narrativo mais importante (título principal / métrica) e complemente com texto de apoio em seções claras
- Quaisquer gráficos devem refletir dados reais fornecidos no prompt de conteúdo e permanecer fiéis às fontes descritas
- Organize as imagens e o texto para que o usuário consiga ler da esquerda para a direita ou de cima para baixo; evite empilhar gráficos/imagens verticalmente
Direção Visual:
- Profissional e limpo
- Siga o estilo da imagem do slide anterior (se fornecida) para continuidade visual
Requisitos:
- Layout de apresentação profissional, com hierarquia visual clara
- O texto deve ser claramente legível, com contraste adequado contra o fundo
- Incluir área de título e área de conteúdo quando apropriado
- Manter estilo consistente para uma apresentação profissional
- Design visual de alta qualidade, pronto para publicação
- Todo o texto deve ser nítido e legível
- Manter todo o texto essencial confortavelmente dentro da moldura; evitar colocar texto nas bordas
- Equilibrar elementos visuais com espaços em branco para que o slide pareça limpo e não fique poluído
272
·
--
28
·
--
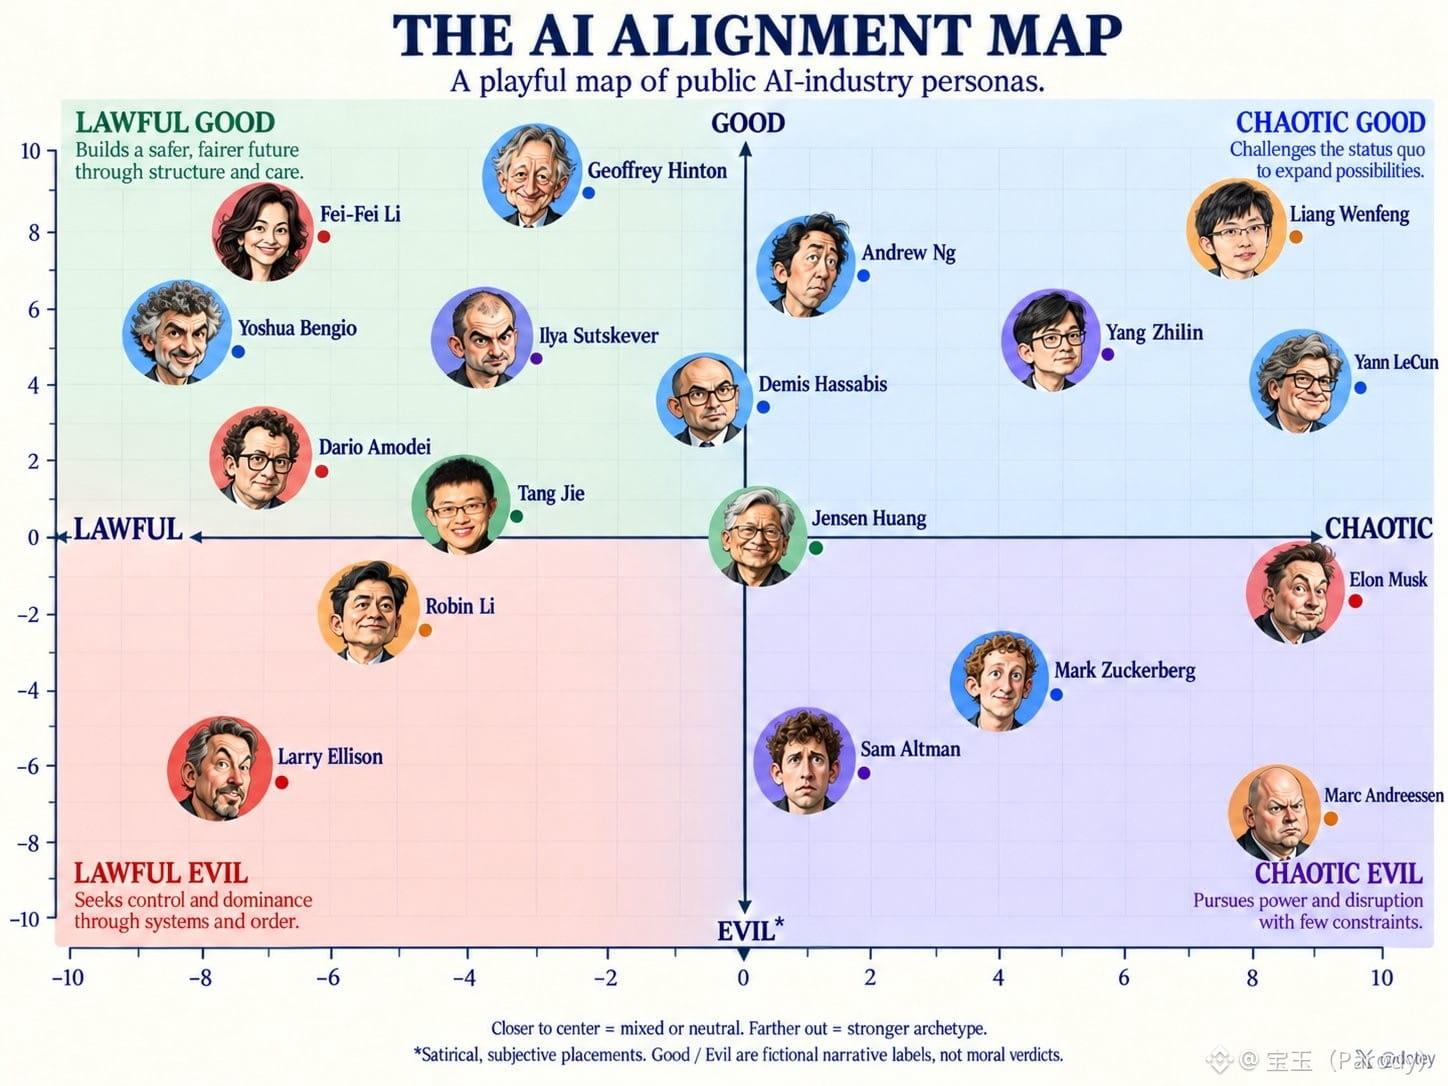
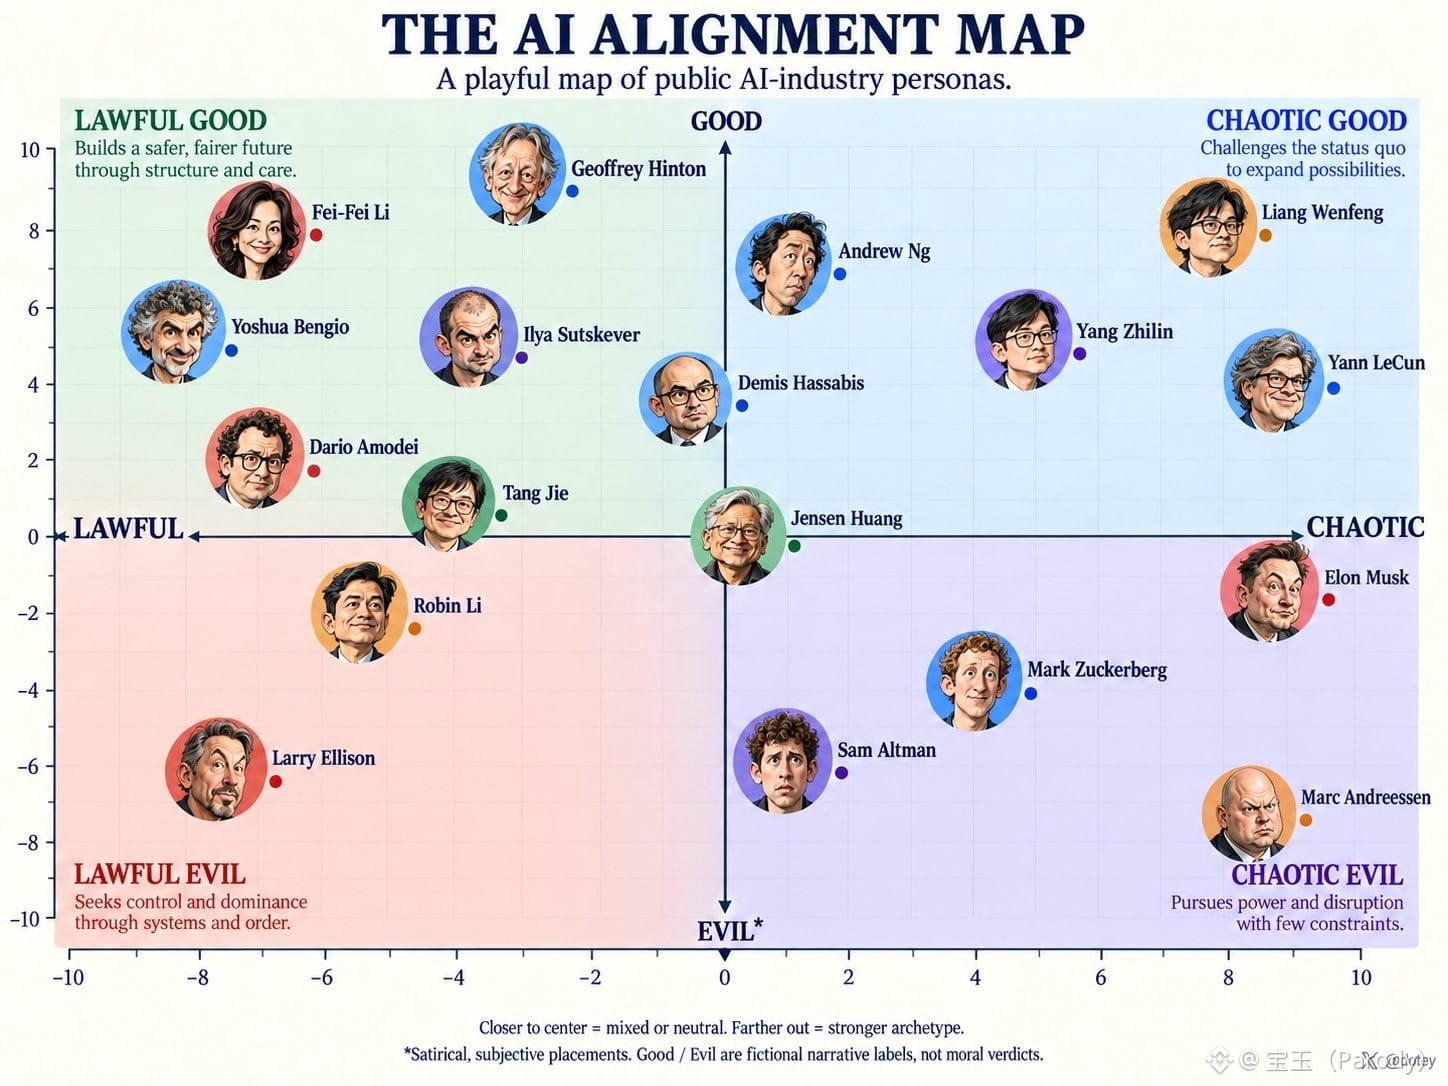
Faça o ChatGPT usar uma grade de nove quadrados de ordem, neutralidade e caos para classificar as figuras mais influentes da IA; desenhou isso para mim
Faça o ChatGPT usar uma grade de nove quadrados de ordem, neutralidade e caos para classificar as figuras mais influentes da IA; desenhou isso para mim
226
·
--
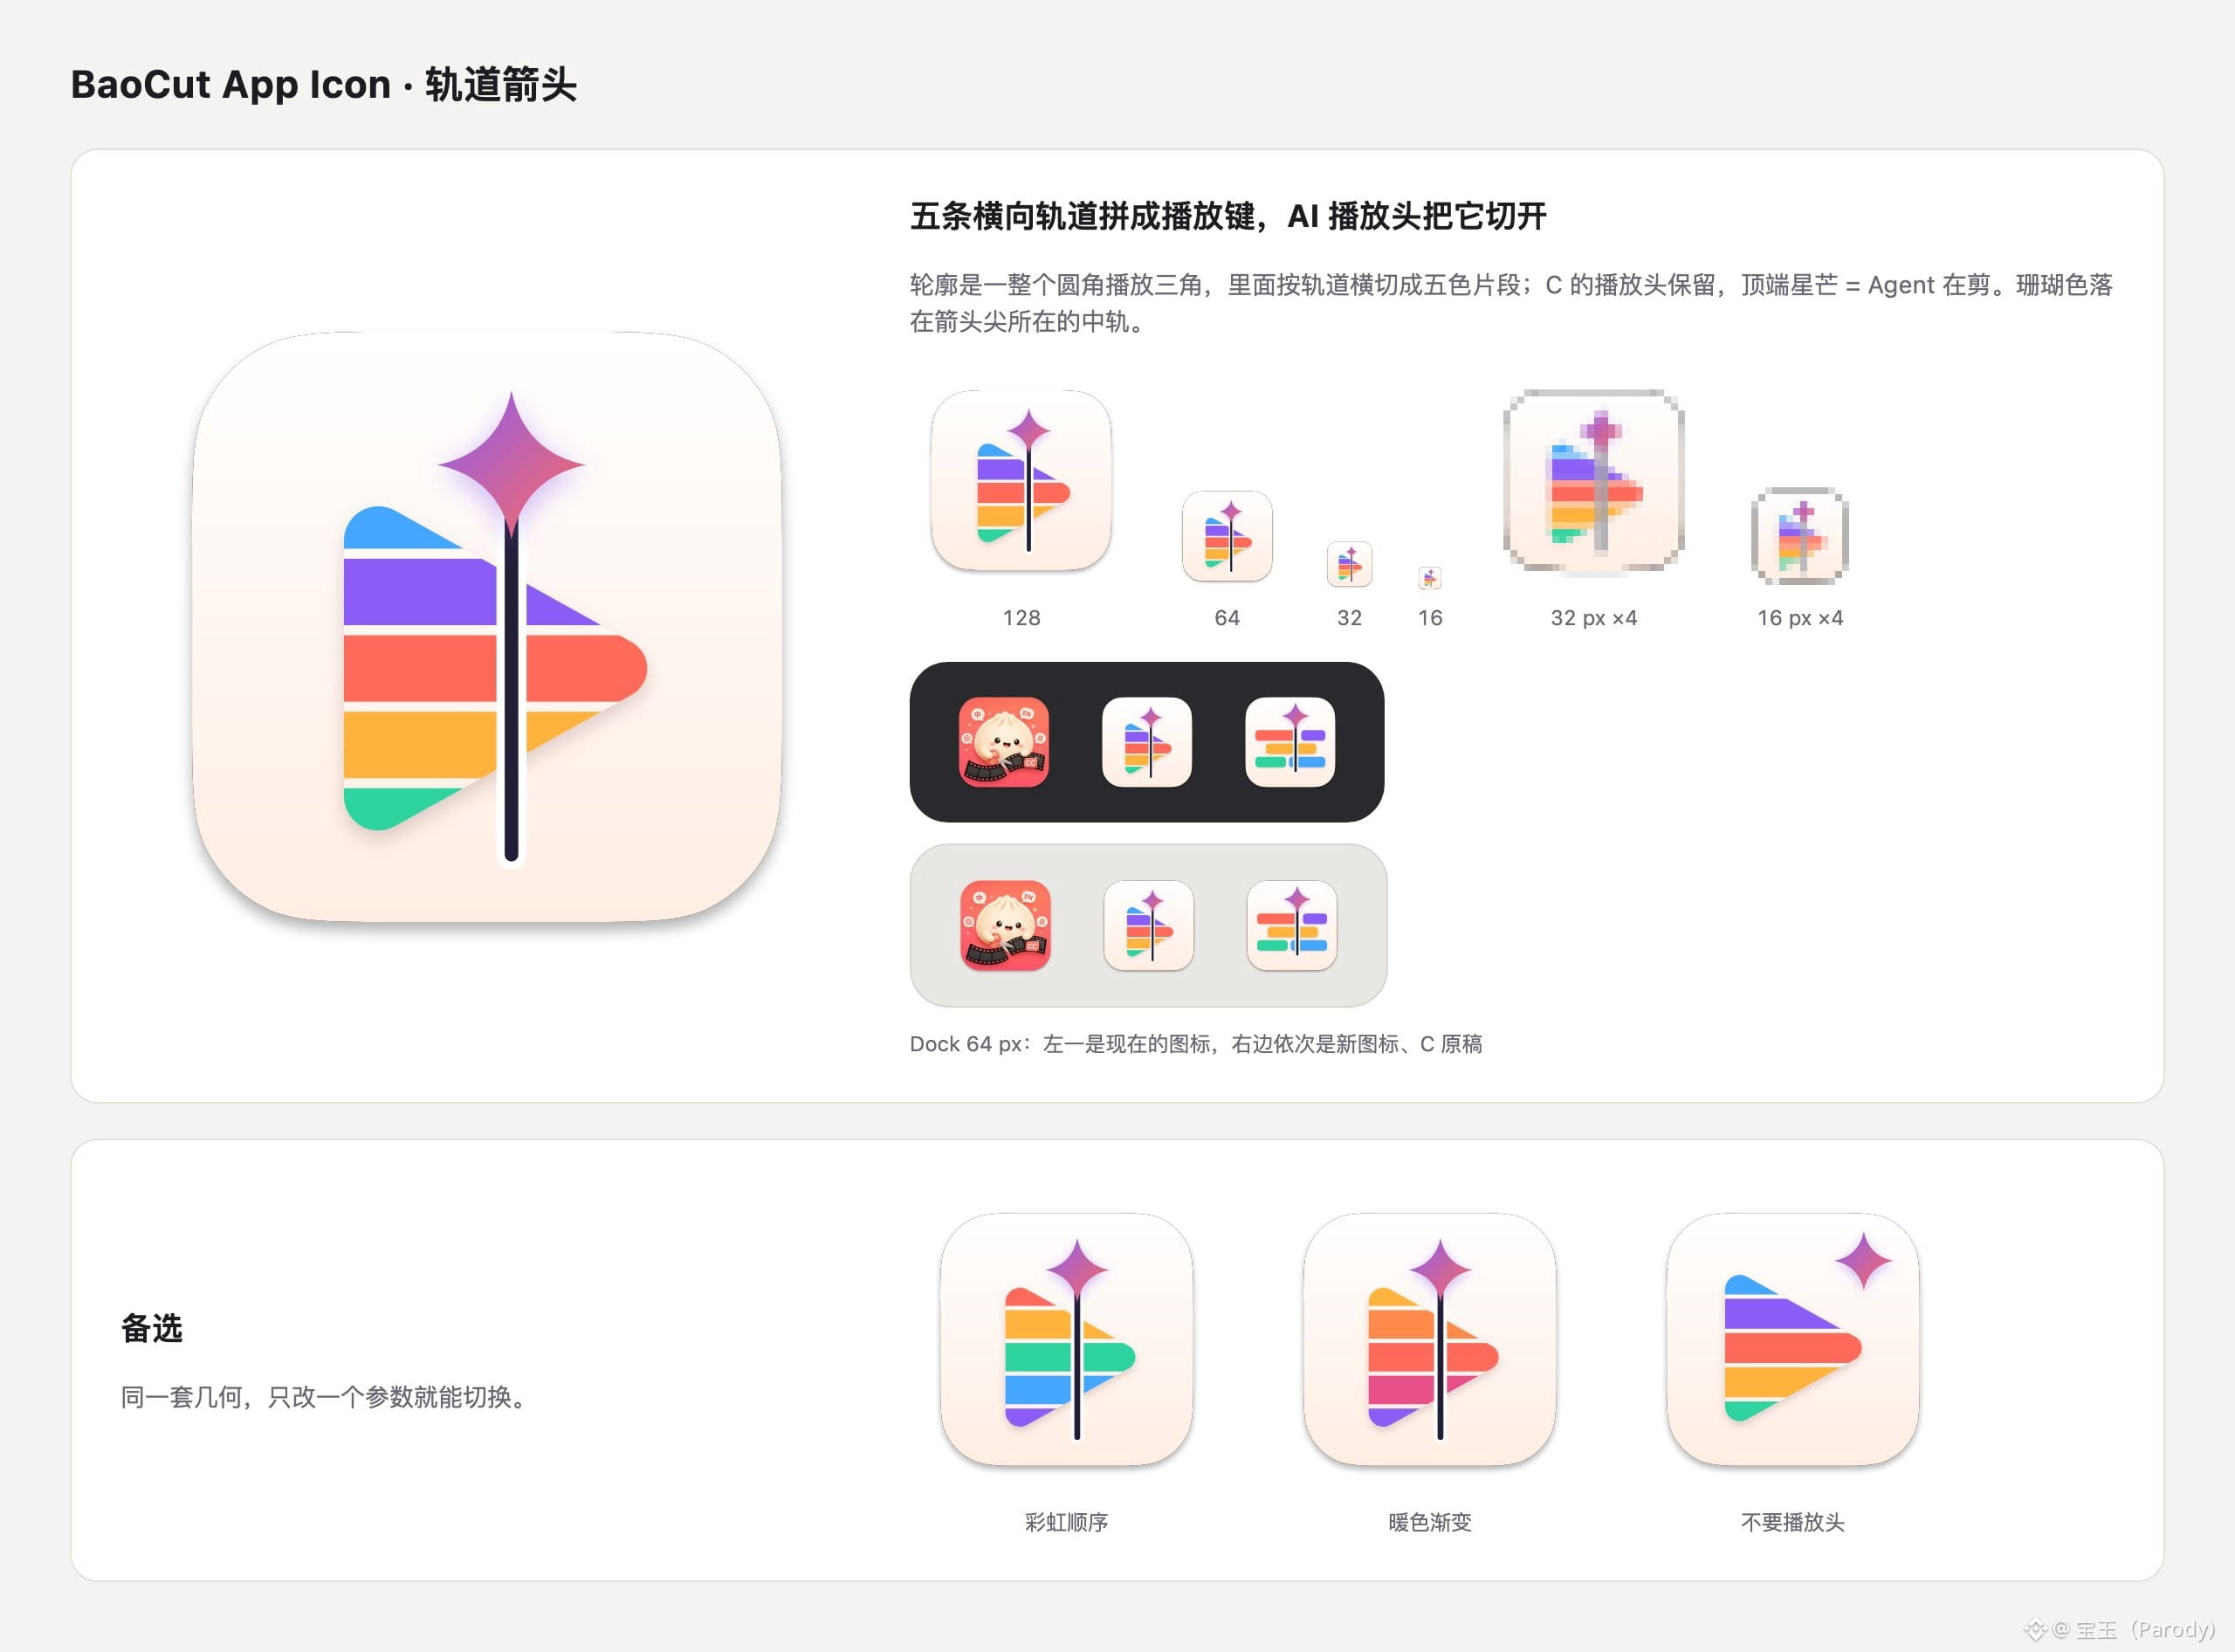
Opus 5.5 — liberte sua criação de App Icons
Quando eu usei o Fable, eu já tentei fazer com que o Fable desenhasse um App Icon para mim, mas o resultado ficou aquém do esperado. No fim, eu acabei usando o ChatGPT para criar as imagens, mas assim o que foi gerado não é vetorial.
Nesses dias, ao usar o Opus 5.5 para fazer vídeos, eu tive uma ideia. Se o Opus 5.5 consegue usar JavaScript + Canvas para renderizar um vídeo quadro a quadro, então usá-lo com JS + Canvas para desenhar um ícone também não deve ser problema.
Então eu tentei. A primeira versão já superou minhas expectativas: ficou simples, bonito e com um resultado bem bom. O prompt era só uma frase:
> Ajude-me a redesenhar um App Icon para http://BaoCut.app, simples, colorido, que represente edição de vídeo e um AI Agent
> Pode desenhar diretamente usando js para canvas
Atenção: o ponto-chave é “desenhar usando js para canvas”, não SVG. O SVG gerado não fica com um resultado bom como o efeito de draw do Canvas com JS.
Depois é só o mesmo ciclo que com o cliente: ficar pedindo alterações até ficar perfeito.
Por exemplo, eu achei que a proposta 3 era a melhor; então pedi para ajustar com base na proposta 3. Depois de algumas iterações e versões, cheguei a um resultado com o qual eu fiquei bastante satisfeito.
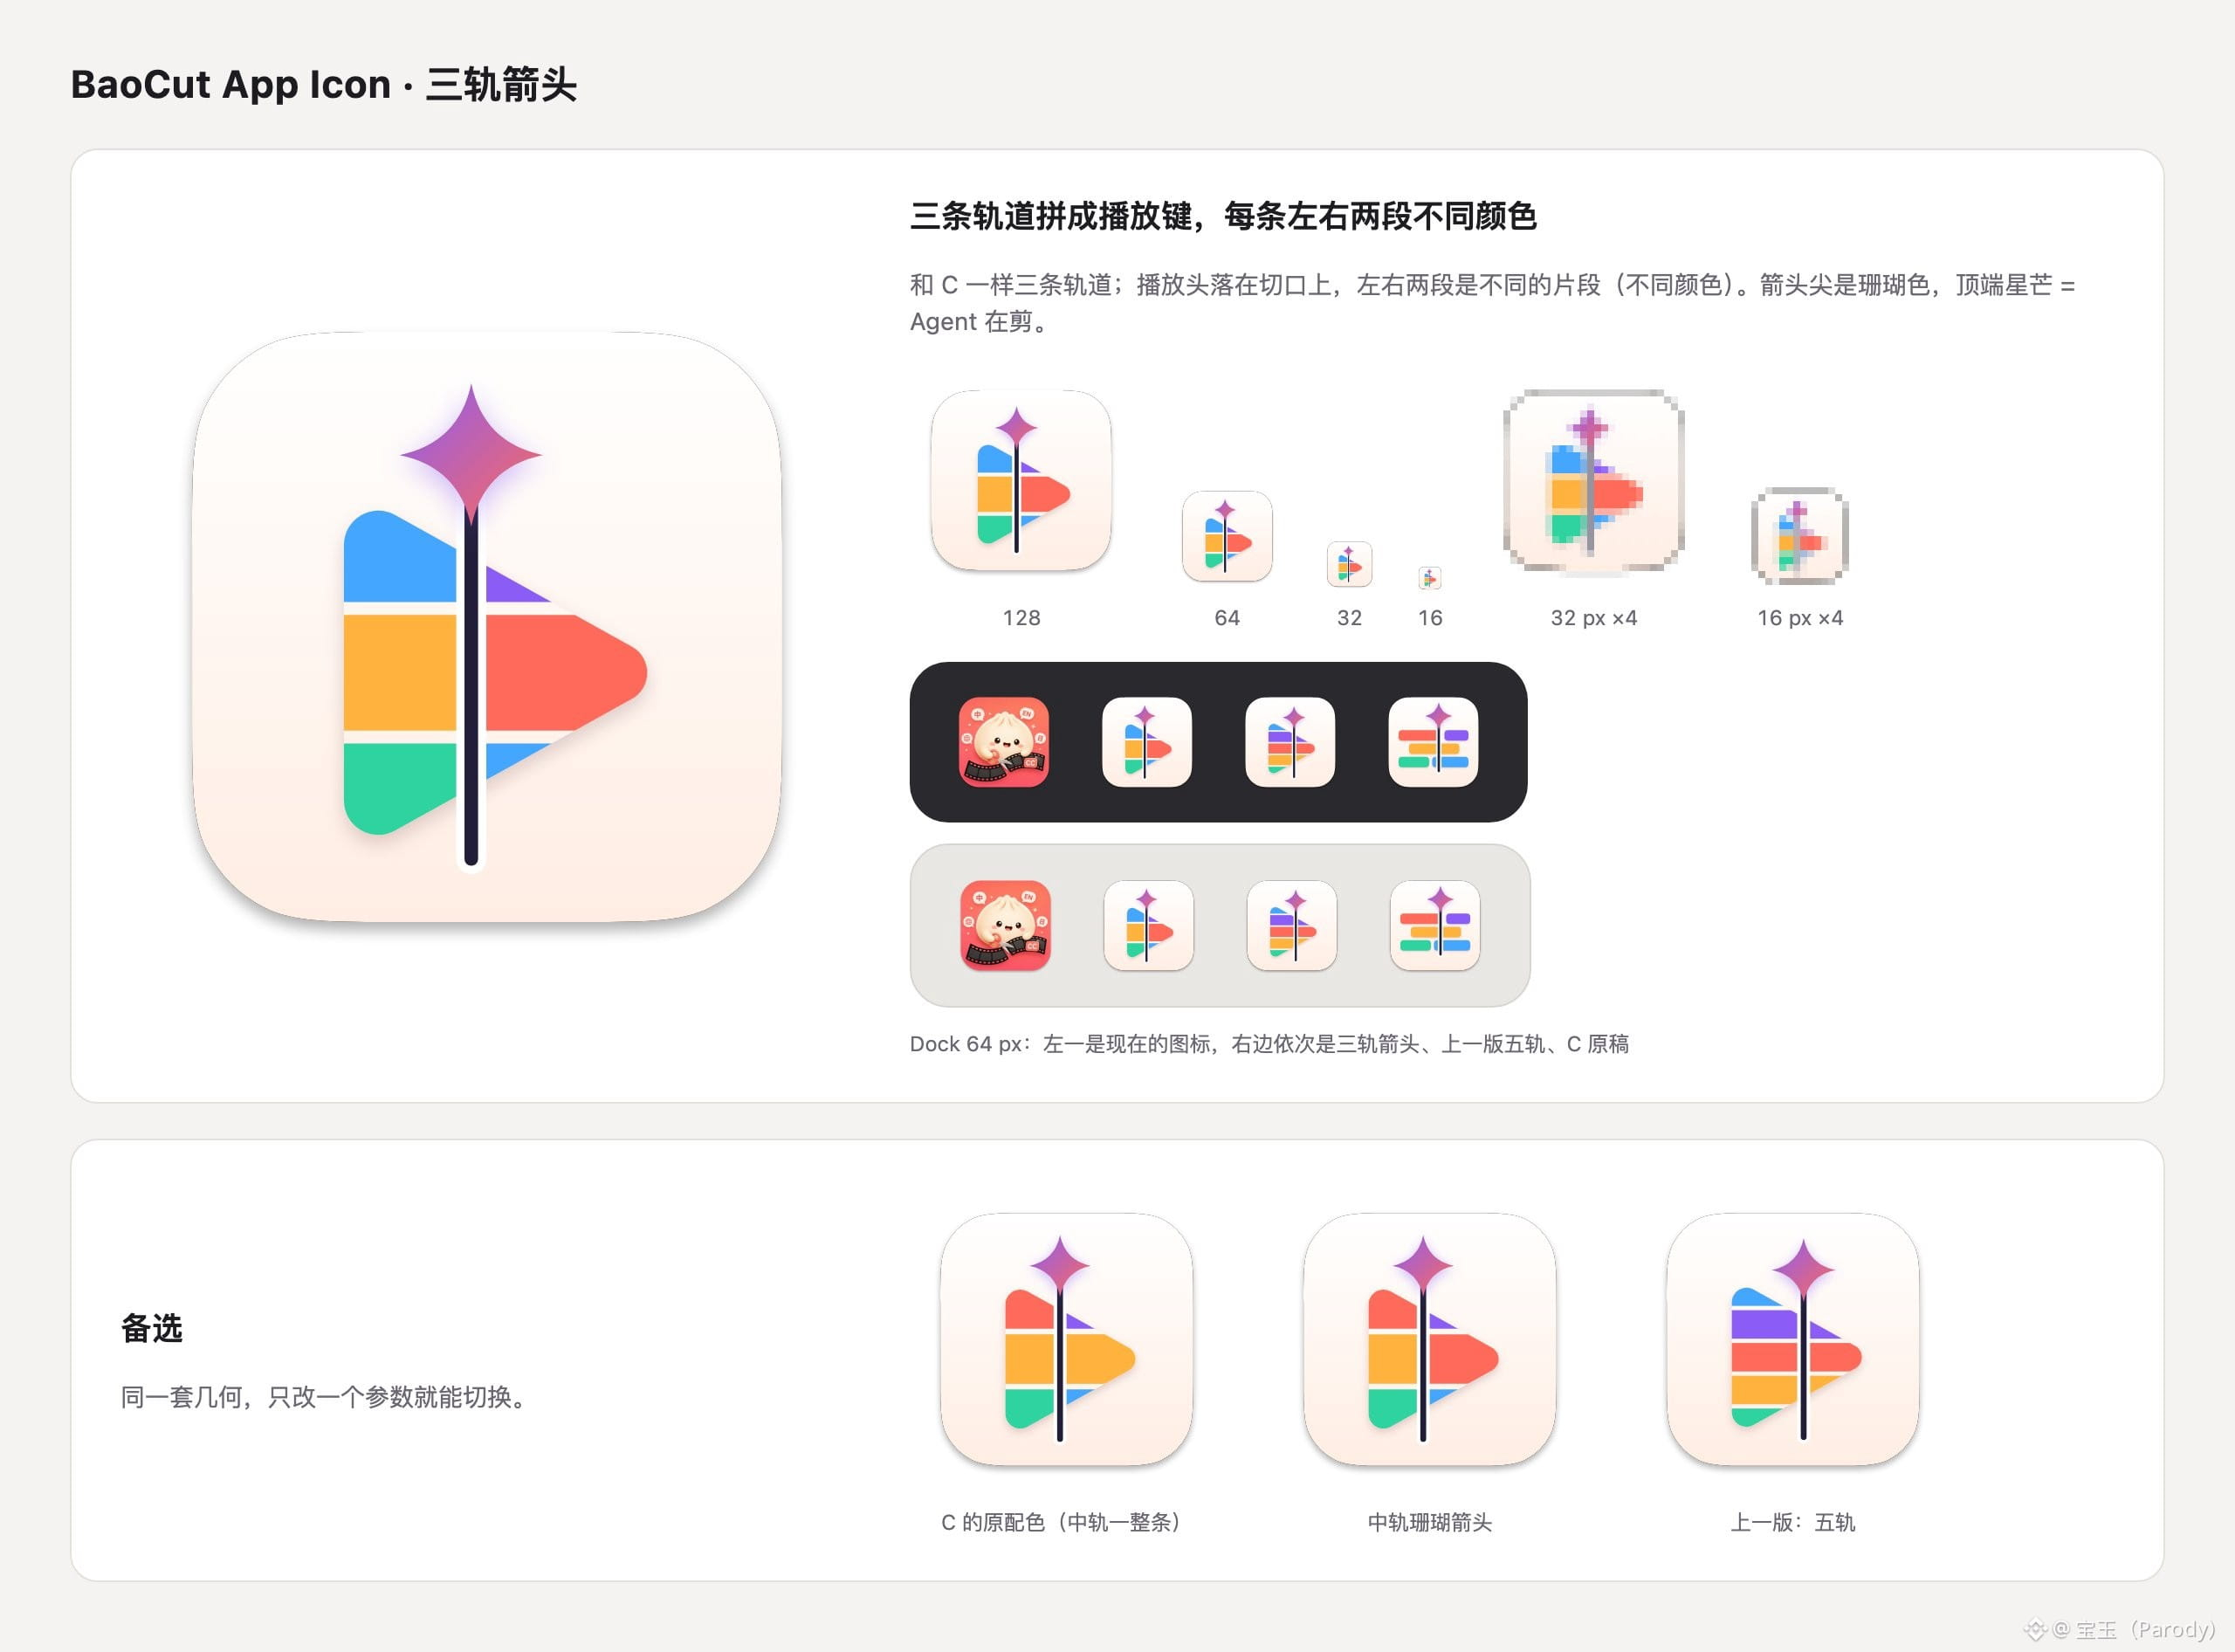
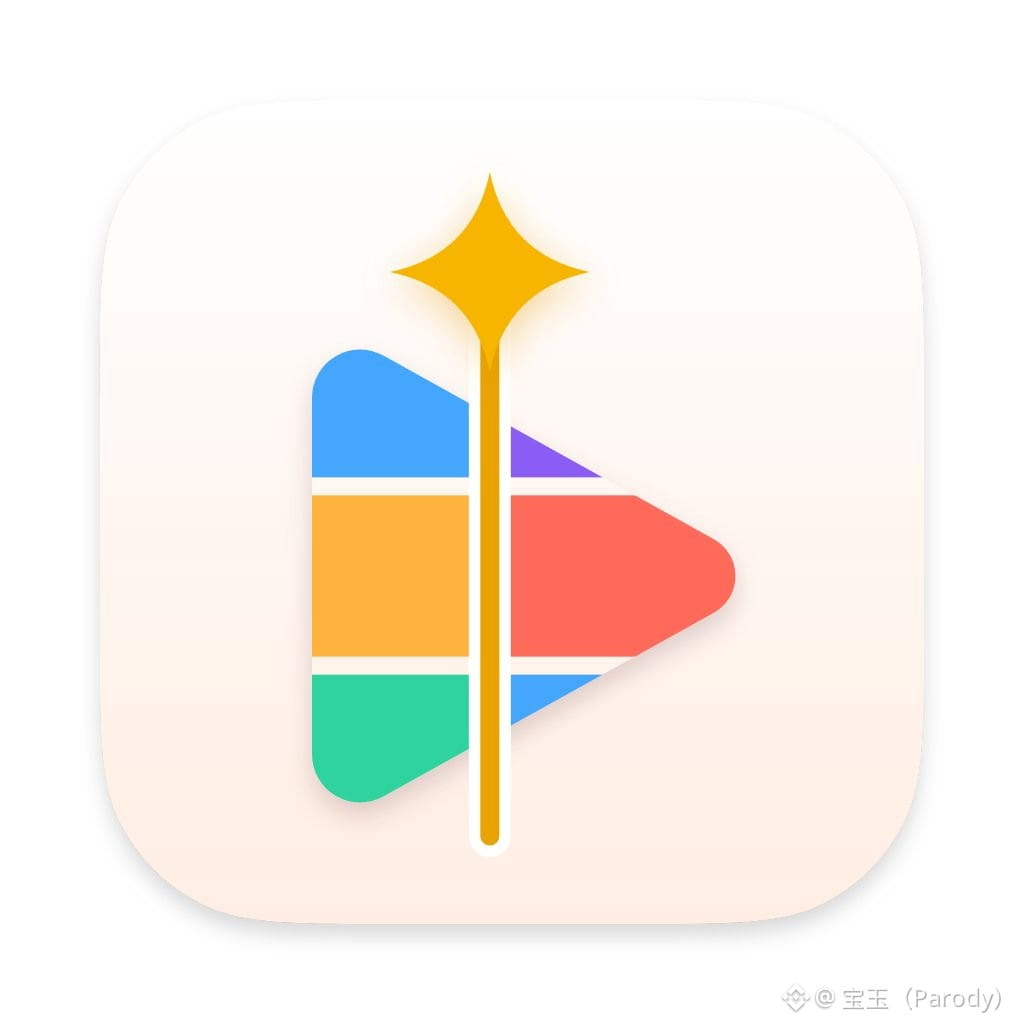
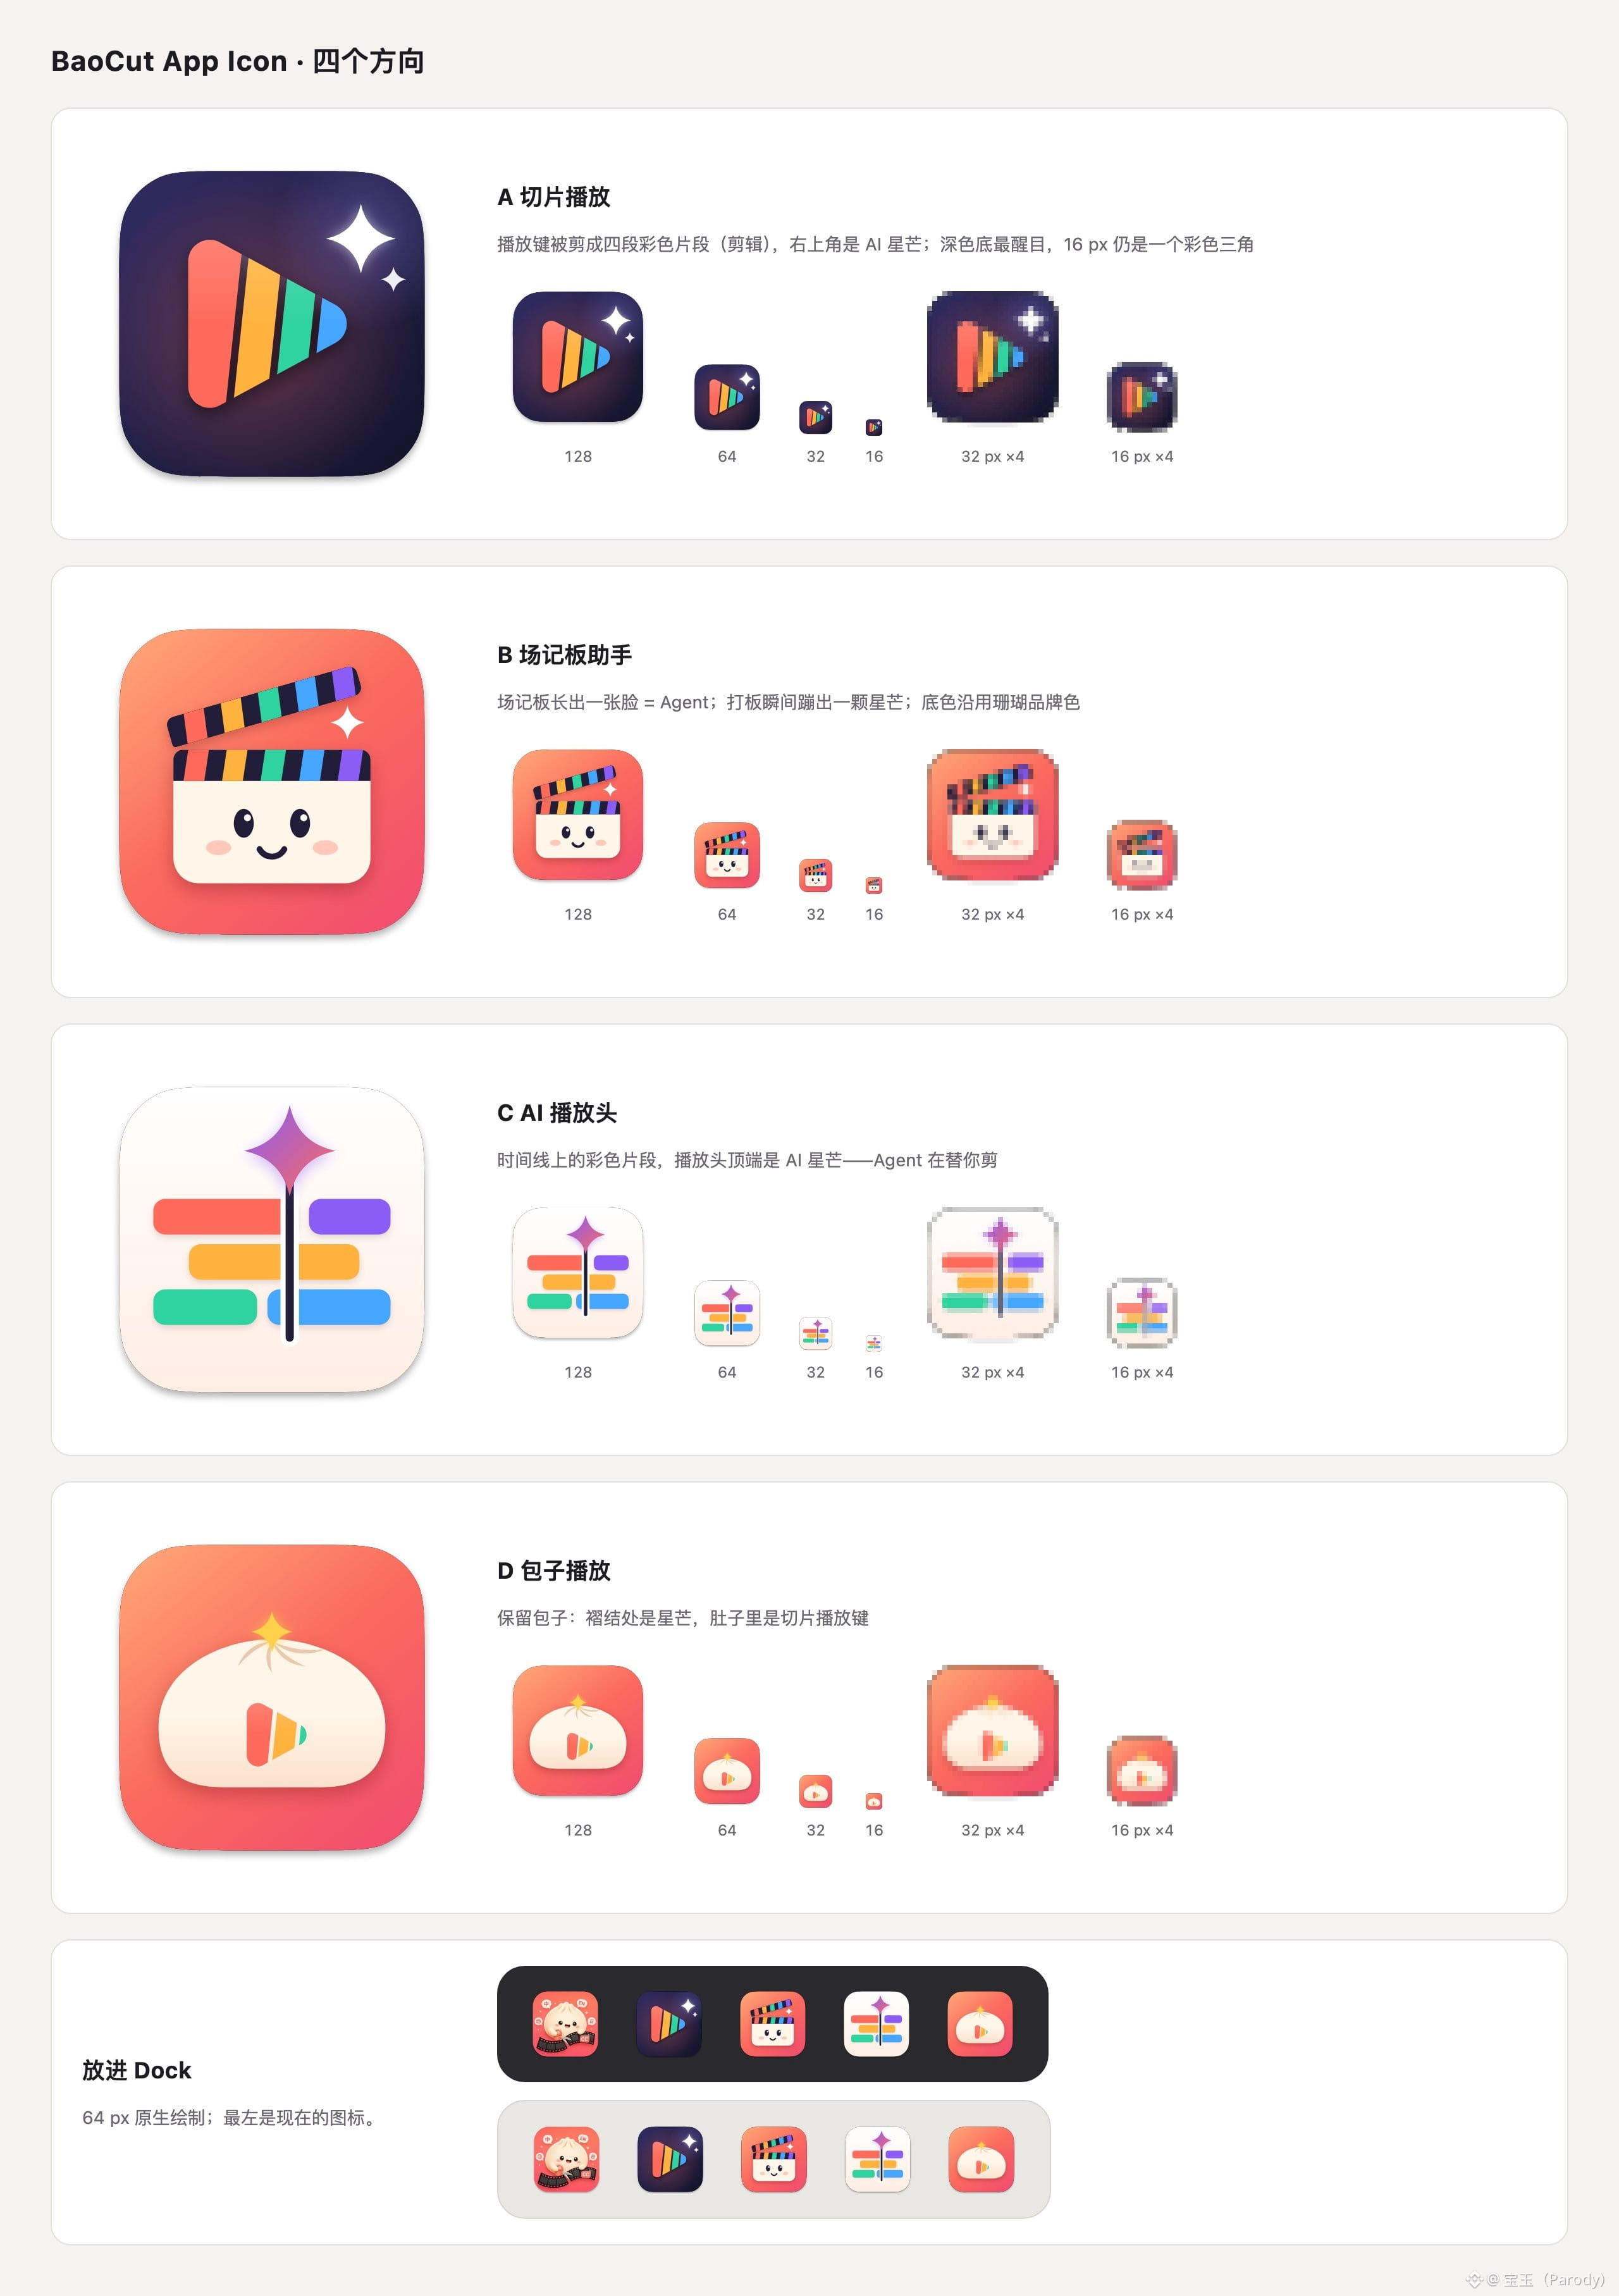
168
·
--
《História da Civilização Chinesa》 de Opus 5.5
--- Prompt ----
Crie um épico em forma de cine-romance cronológico chamado《História da Civilização Chinesa》,podendo escrever código para renderizar cada quadro e depois compor usando o ffmpeg。
Música como relógio: modo pentatônico, instrumentos evoluindo de flautas de osso e sinos de bronze, chegando a orquestra; o BPM acelera com a época, e todos os cortes devem coincidir com a batida (timing).
Alternar dois estilos de pintura: branco e retratista em papel de arroz e ouro sobre fundo escuro em barro; para cada rolo, um cor principal e um conjunto de padrões que evoluem com a era (padrão de cerâmica pintada → padrão taotie → padrão de nuvens e qi → padrão de parreira em espiral → padrão de videira entrelaçada → padrão de retorno/lei circular).
Para cada cena, uma palavra-chave em caracteres grandes de caligrafia que apareça como um conjunto de palavras, acompanhada por uma ilustração em linha (line art). HUD do filme inteiro: selo vermelho no canto superior esquerdo com o número do rolo, nomes das dinastias em orientação vertical no lado direito, e na parte inferior uma régua de tempo do rolo com contagem de anos.
As transições entre rolos devem usar um impacto: carimbo de selo vermelho (yin/baixo) e um golpe forte de sino de tambor. Primeiro defina a grade de pontos de batida e a tabela de cenas, depois renderize.
O mapa deve ser apenas esquemático, sem retratar pessoas reais e contemporâneas; após confirmar a correspondência das épocas, entregue o material.
55
·
--
Recomende conjuntos de prompts de vídeo do Awesome Opus 5.5 de código aberto no GitHub
Recomende conjuntos de prompts de vídeo do Awesome Opus 5.5 de código aberto no GitHub
78
·
--
Na era da IA, qual é a habilidade que os profissionais mais deveriam aprender agora?
A sugestão do professor Andrew Ng é que todo mundo aprenda programação.
Muitos executivos de empresas aconselham as pessoas a não aprenderem programação, com o argumento de que a IA vai automatizá-la. Andrew Ng acredita que esse raciocínio está invertido. Justamente porque a IA ajuda, escrever código ficou sem precedentes em facilidade — e por isso vale a pena que todos aprendam.
Ele já viu, em muitos cargos, uma diferença de produtividade bem evidente. Isso não acontece apenas com engenheiros de software. De um lado, estão as pessoas que sabem programar e conseguem criar softwares personalizados por conta própria; do outro, as que não sabem. A eficiência entre os dois grupos já se ampliou bastante.
Aprender programação não é escrever código manualmente
Ele diz que aprender programação não significa digitar código linha por linha. Na verdade, ele quase nunca faz isso. Num futuro previsível, uma das capacidades mais importantes será saber dizer com precisão para o computador o que você quer que ele faça — para que ele execute por você. E o código é a linguagem do computador. Portanto, o que realmente significa aprender programação é aprender a explicar as necessidades de um jeito que o computador entenda.
Os melhores profissionais de marketing da equipe dele tiveram uma ideia: não precisam esperar os engenheiros para montar um site; eles mesmos conseguem fazer. Os melhores recrutadores também não dependem mais de ler currículos um a um com os próprios olhos; em vez disso, escrevem código para que o programa ajude a filtrar. Na visão dele, quem consegue explicar as necessidades ao computador se torna muito mais forte e muito mais eficiente.
63
·
--
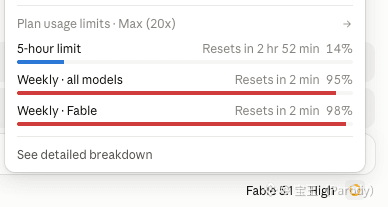
Opus 5.5 aguenta bem, de fato não acabou antes de precisar redefinir
Opus 5.5 aguenta bem, de fato não acabou antes de precisar redefinir
1.4k
·
--
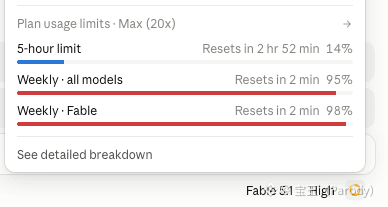
Opus 5.5 ainda é bem difícil de usar; mesmo assim não consegui usá-lo antes de redefinir
Opus 5.5 ainda é bem difícil de usar; mesmo assim não consegui usá-lo antes de redefinir
552
·
--
有人做了一个"星际争霸"AI 对战测试(Brood War Bench),让当下主流大模型互相打即时战略,结果所有模型的水平都没超过新手。
《星际争霸:母巢之战》是 1998 年的经典即时战略游戏,也是 AI 研究的老朋友,2019 年 DeepMind 的 AlphaStar 就曾在这款游戏里击败职业选手。但那是专门训练的强化学习 AI。这次测试不同,它让通用大模型以 AI 智能体的形式直接上手操作,看看它们能不能自己建基地、造兵、打仗。
作者 Ben Swerdlow 原本只是做了一个"只能通过智能体操控"的星际争霸版本,拿来和朋友玩。没想到几个几乎没玩过星际的朋友表现还不错——他们说自己就下了句"去进攻"的命令,智能体就自己造了支小部队冲过去了。这让他好奇:如果完全让 AI 自己玩,能打到什么水平?
答案是:很菜,但很有意思。
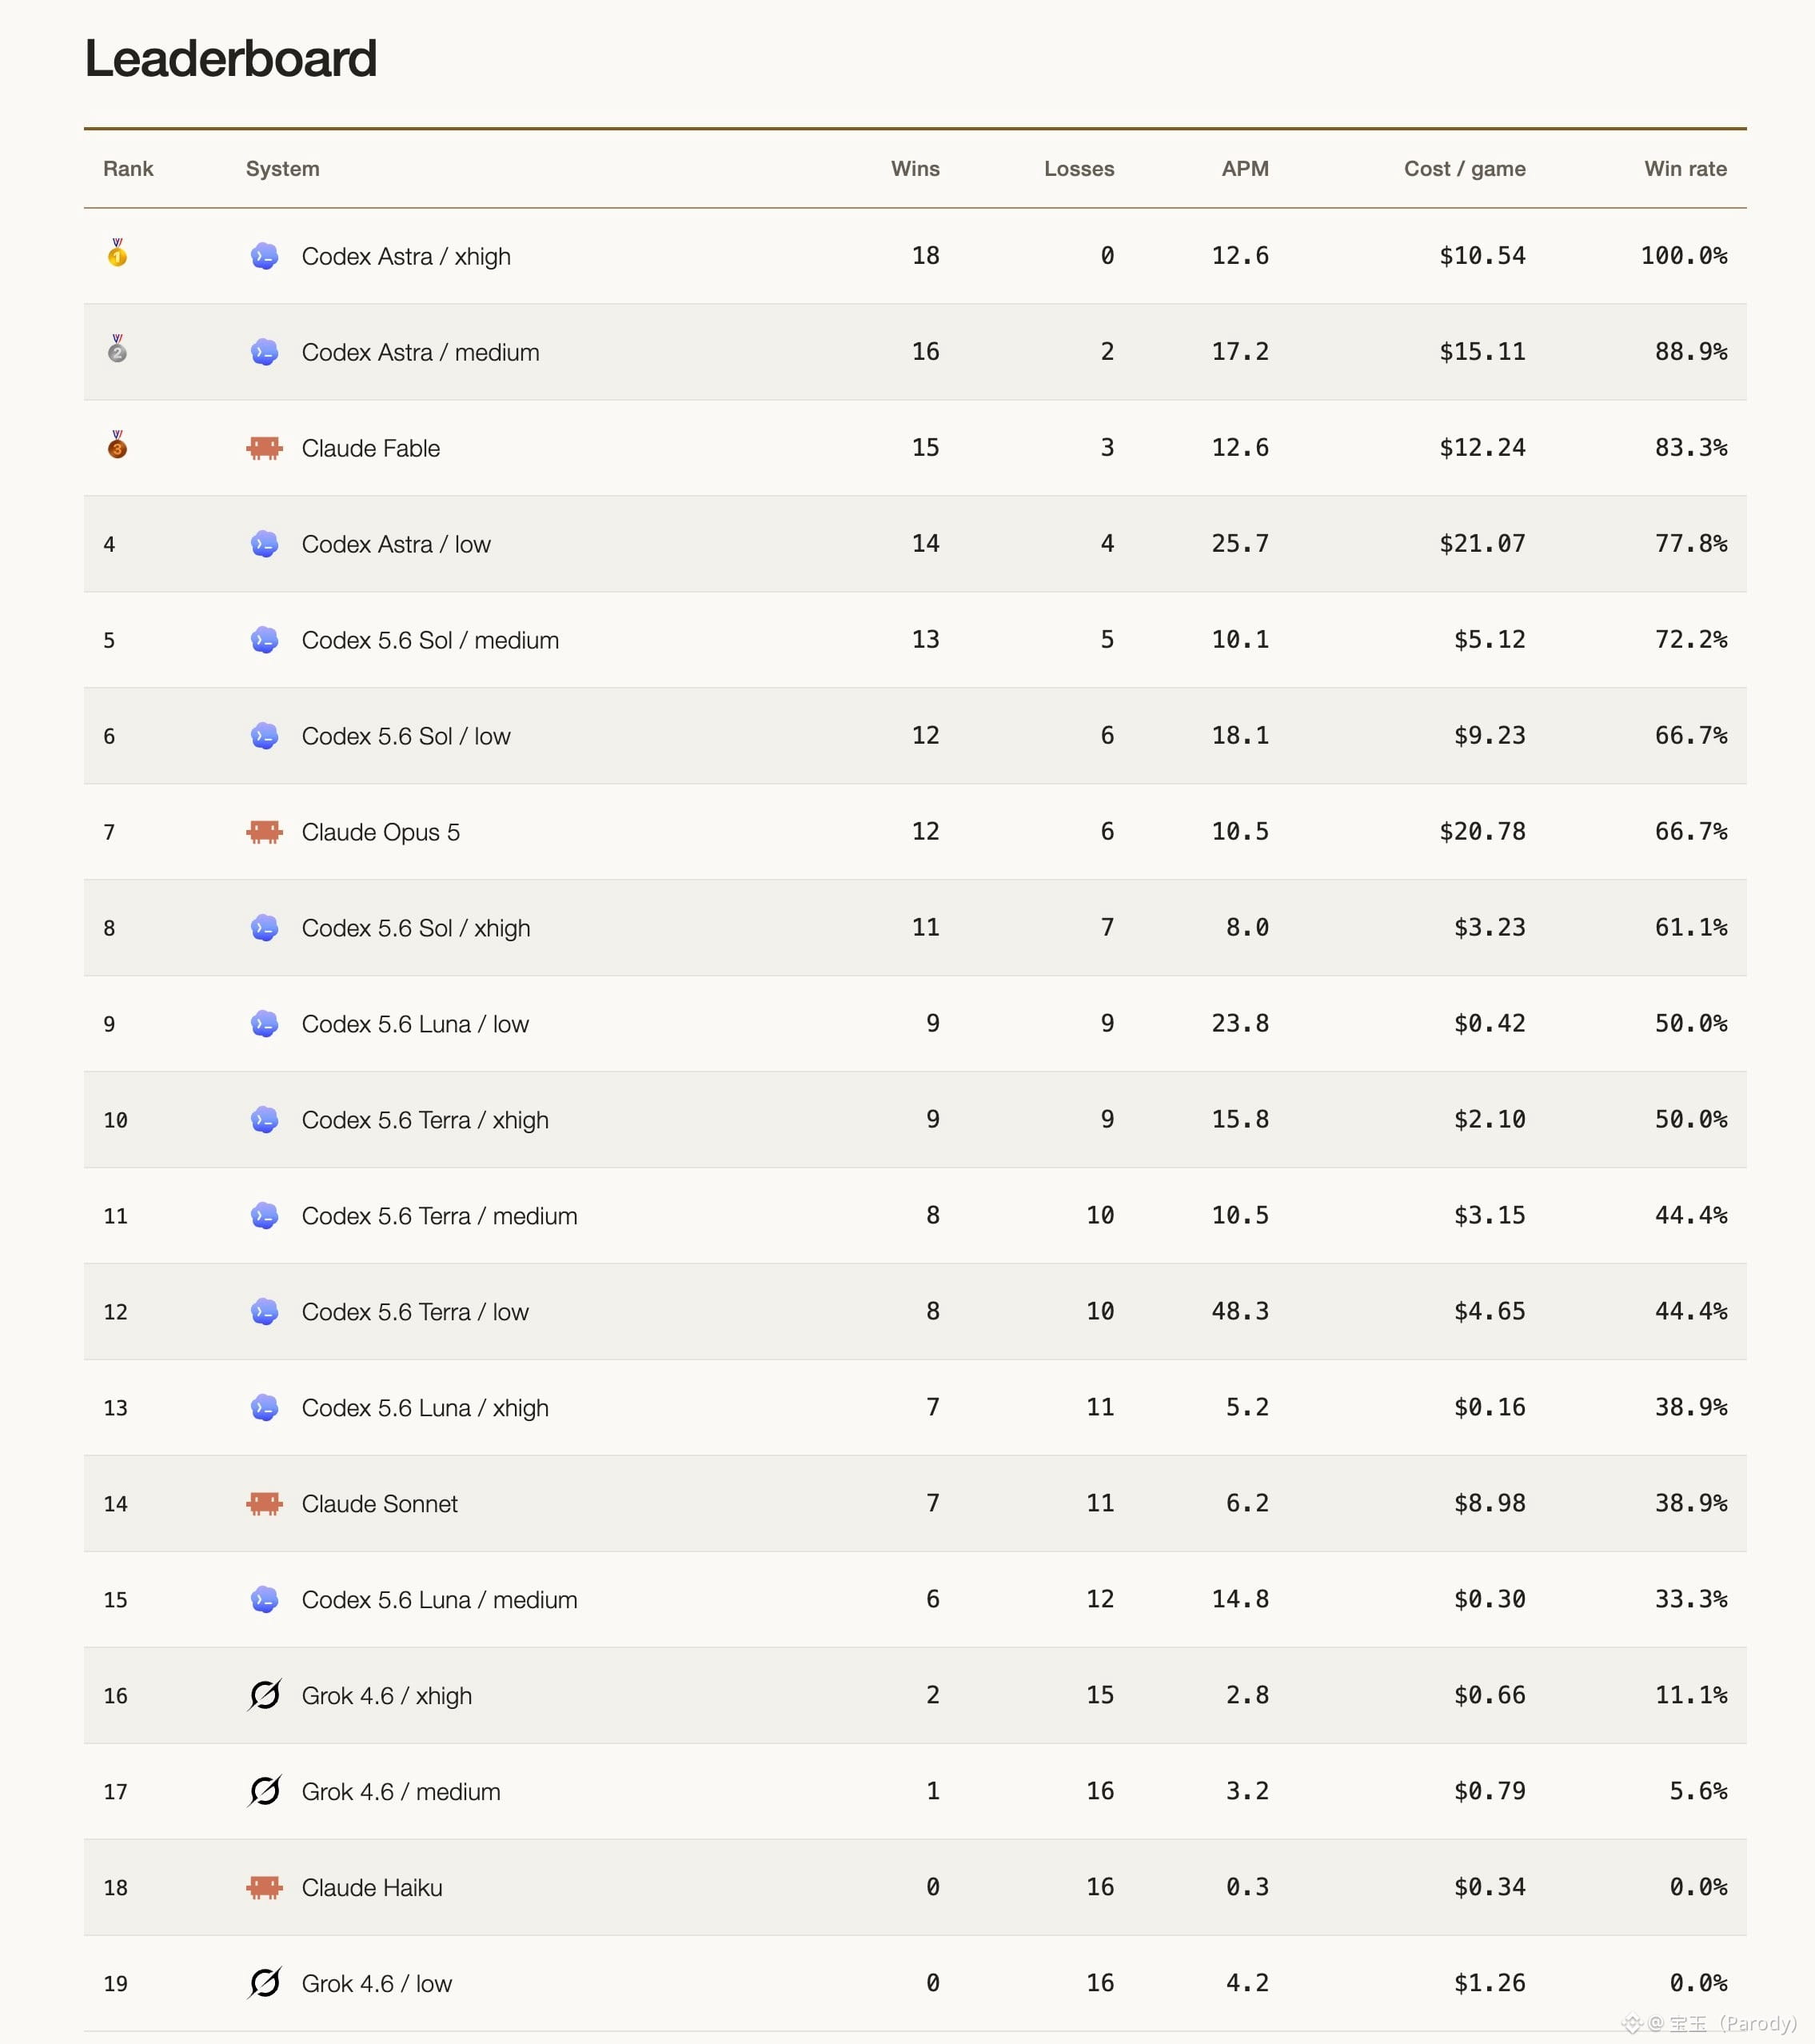
排名第一的 Codex Astra 打了 18 场全胜,但它最擅长的不是正面作战,而是"骚扰":派一个采矿的工人(Probe)跑到对方基地捣乱。这招对 AI 对手特别好使,因为对面的智能体看到一个工人来了,会花几十秒思考该怎么办,期间什么都不干。而在正经的经济发展和大规模作战方面,Codex 反而比较弱,经常造一两个兵就往对面扔,而不是攒够兵力再出击。
Claude Fable 排第三,胜率 83.3%,是所有参赛模型里最"像在认真打游戏"的。它会老老实实发展经济、爬科技树,甚至在一局里造出了飞龙(Mutalisk),在另一局里研究到了圣堂武士科技。虽然有时候研发做了一堆,兵力没跟上,但至少在"试图理解游戏规则"这件事上,Fable 比谁都认真。
Grok 的表现最差。Grok 4.6 在一场 43 分钟的比赛里输出了超过 11000 个推理 token,却只发出了 6 批操作指令,全程没造过一个战斗单位。它本质上是把即时战略当成了回合制游戏,一直在想,忘了要动手。
这个测试揭示的核心问题是:当前大模型在需要持续观察、快速决策、多线程协调的实时环境中,还远远不够用。即使是表现最好的模型,一个会打"光子炮速推"(一种最基础的快攻战术)的人类新手就能赢下所有比赛。但反过来看,这些模型已经能理解建造、采矿、进攻的基本概念,只是在执行节奏和多任务协调上差得远。
测试的代码和对战平台已经开放,任何人都可以带自己的智能体上去打一局,地址是 http://bw.swerdlow.dev。
352
·
--
A Anthropic construiu silenciosamente um laboratório biológico
Segundo um relatório exclusivo da Reuters, a Anthropic já concluiu um laboratório úmido (wet lab — um espaço físico onde é possível realizar experimentos bioquímicos reais) na região da Baía de São Francisco, levando de forma oficial as suas tentativas com IA além do software e para a pesquisa de medicamentos.
O responsável pela área de ciências da vida da Anthropic, Eric Kauderer-Abrams, confirmou a informação em uma entrevista. Ele disse que, para fazer pesquisa em biologia, o padrão final de validação ainda é o trabalho em um laboratório real; a simulação apenas por computador não é suficiente. Uma parte dos experimentos é feita internamente e outra parte é feita em parceria com parceiros externos — uma abordagem semelhante à de muitas empresas de biotecnologia.
Isso não foi um impulso repentino. Nos últimos meses, a Anthropic agiu com intensidade: comprou, por cerca de US$ 400 milhões, ações de uma startup chamada Coefficient Bio, para construir ferramentas de pesquisa de fármacos; colocou o CEO da Novartis, Vas Narasimhan, no conselho; lançou um software chamado Claude Science; e, em junho, anunciou publicamente em São Francisco a intenção de iniciar um projeto de desenvolvimento de medicamentos. No LinkedIn, também há vagas para contratação de líderes de operações de compras e especialistas em caracterização de proteínas e de ácidos nucleicos; nos anúncios, o objetivo declarado é “aumentar em uma ordem de magnitude a velocidade do avanço em ciências da vida”. Kauderer-Abrams afirmou que as ciências da vida já estão entre as maiores direções para as quais a Anthropic tem direcionado pessoal e recursos.
A Anthropic mira áreas em que as tradicionais farmacêuticas consideram “indrogável” (undruggable) — aquelas em que os alvos são difíceis demais e o retorno comercial é baixo, e por isso acabam ignoradas, especialmente em doenças raras. A empresa acredita que a IA pode acelerar a descoberta de anticorpos biespecíficos — ou até mesmo trispecíficos —, que são moléculas complexas capazes de atacar múltiplos alvos ao mesmo tempo. Embora o desafio de projetar esses medicamentos seja extremamente alto, a IA é especialmente boa em lidar com essa complexidade. O CEO Dario Amodei sente o problema na própria pele: o pai dele morreu de uma doença, e a cura só apareceu anos depois.
No entanto, a Anthropic traçou, por enquanto, uma linha bem clara: fazer apenas pesquisa pré-clínica, não realizar ensaios clínicos, e não competir com as farmacêuticas. Isso também tem a ver com um problema real de confiança — as grandes empresas farmacêuticas que usam o Claude (incluindo Genentech, Bristol Myers Squibb e Novo Nordisk) podem temer o que a Anthropic poderia aprender com os dados delas.
Vale destacar a cronologia: tudo isso acontece às vésperas do momento em que a Anthropic planeja abrir capital (IPO) com uma avaliação de cerca de US$ 2 trilhões, justamente quando a controvérsia sobre segurança de IA está em alta. Nas últimas duas semanas, por exemplo, pesquisadores da própria Anthropic alertaram que a IA pode levar à extinção humana; além disso, a empresa descobriu riscos de seus sistemas estarem sendo usados para o desenvolvimento de armas biológicas. Pisando no acelerador e puxando o freio de mão ao mesmo tempo — essa tensão é o retrato mais fiel do momento atual da Anthropic.
Como comparação, a Isomorphic Labs, do Google, faz descoberta de medicamentos com IA há anos. O plano original era entrar em ensaios clínicos até o fim de 2026, mas isso já foi adiado uma vez antes. A realidade da pesquisa de medicamentos é assim: do descobrimento de uma molécula até a aprovação de um fármaco, geralmente são necessários muitos anos, e a maioria dos medicamentos falha durante os ensaios clínicos. A ambição da Anthropic é grande, mas o caminho ainda é longo.
310
·
--
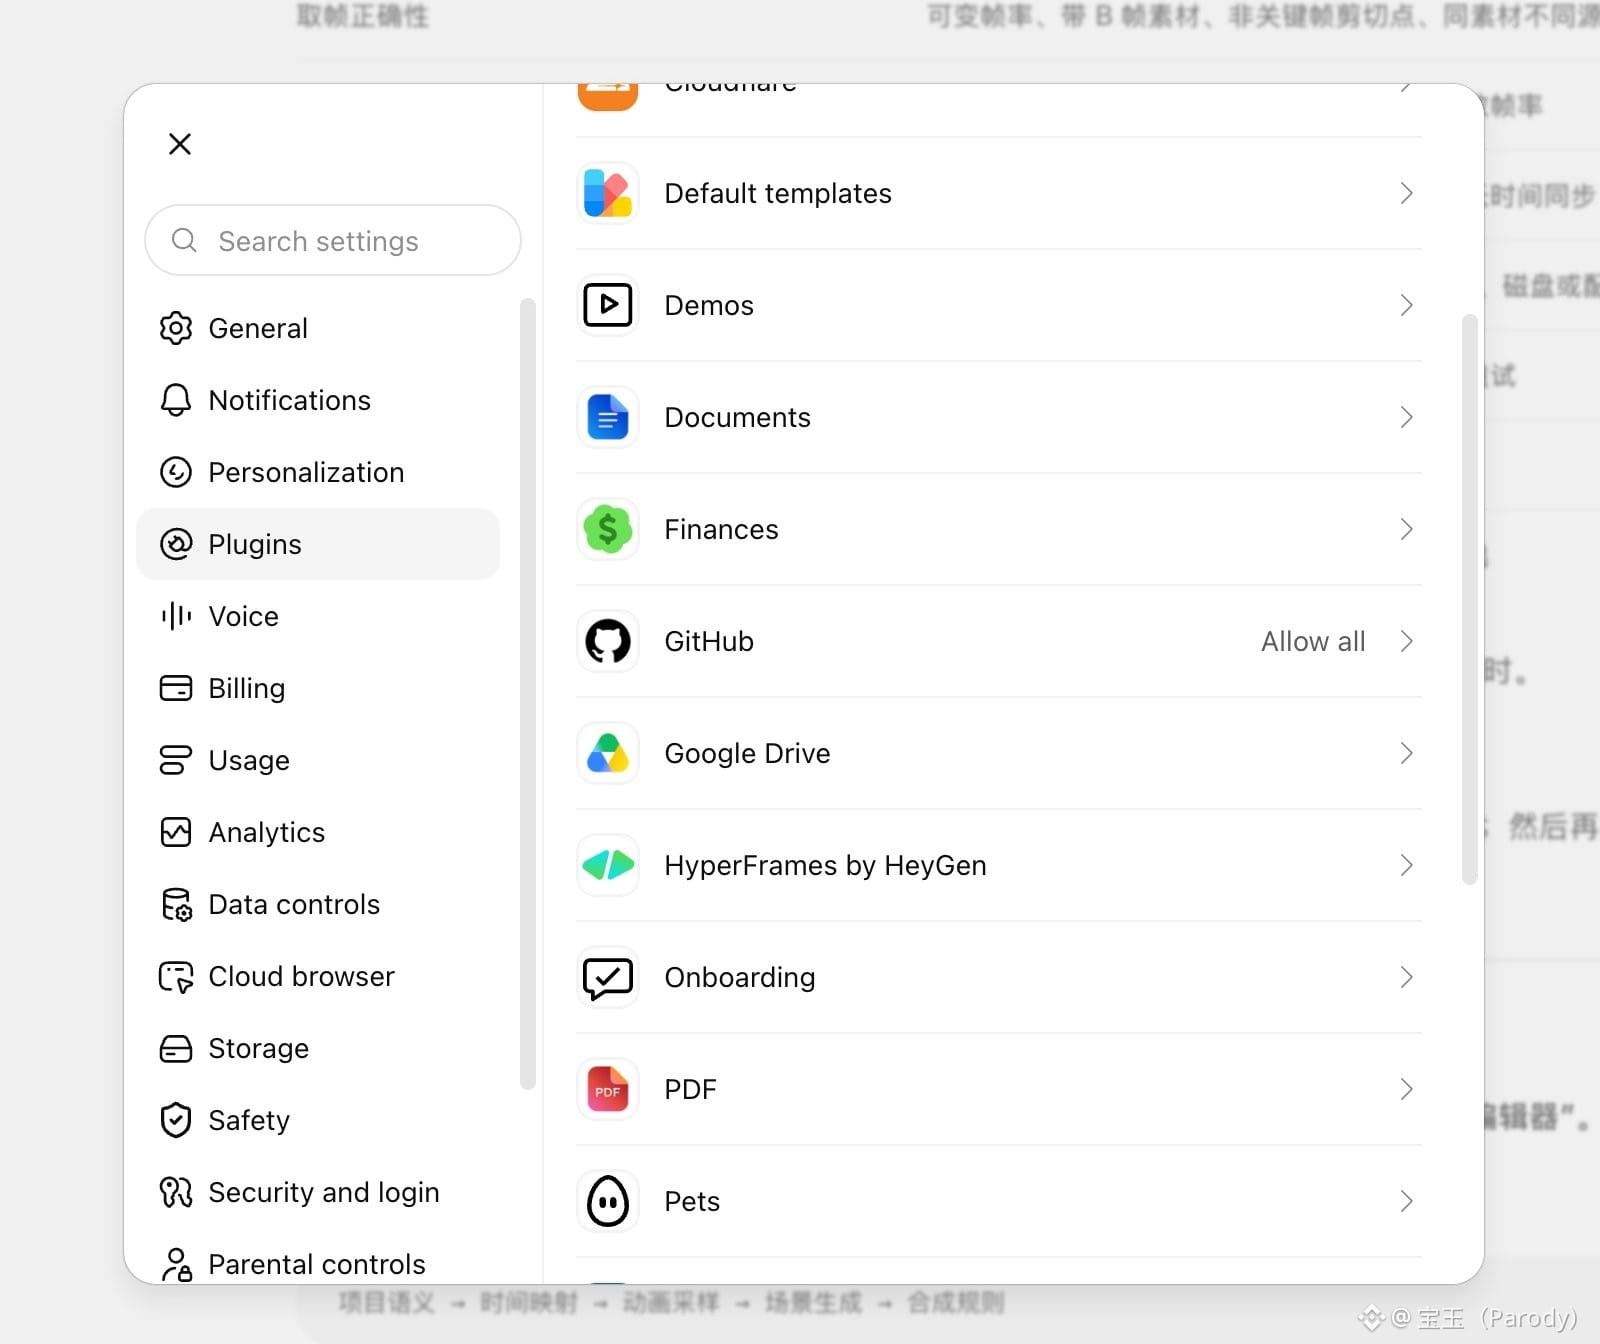
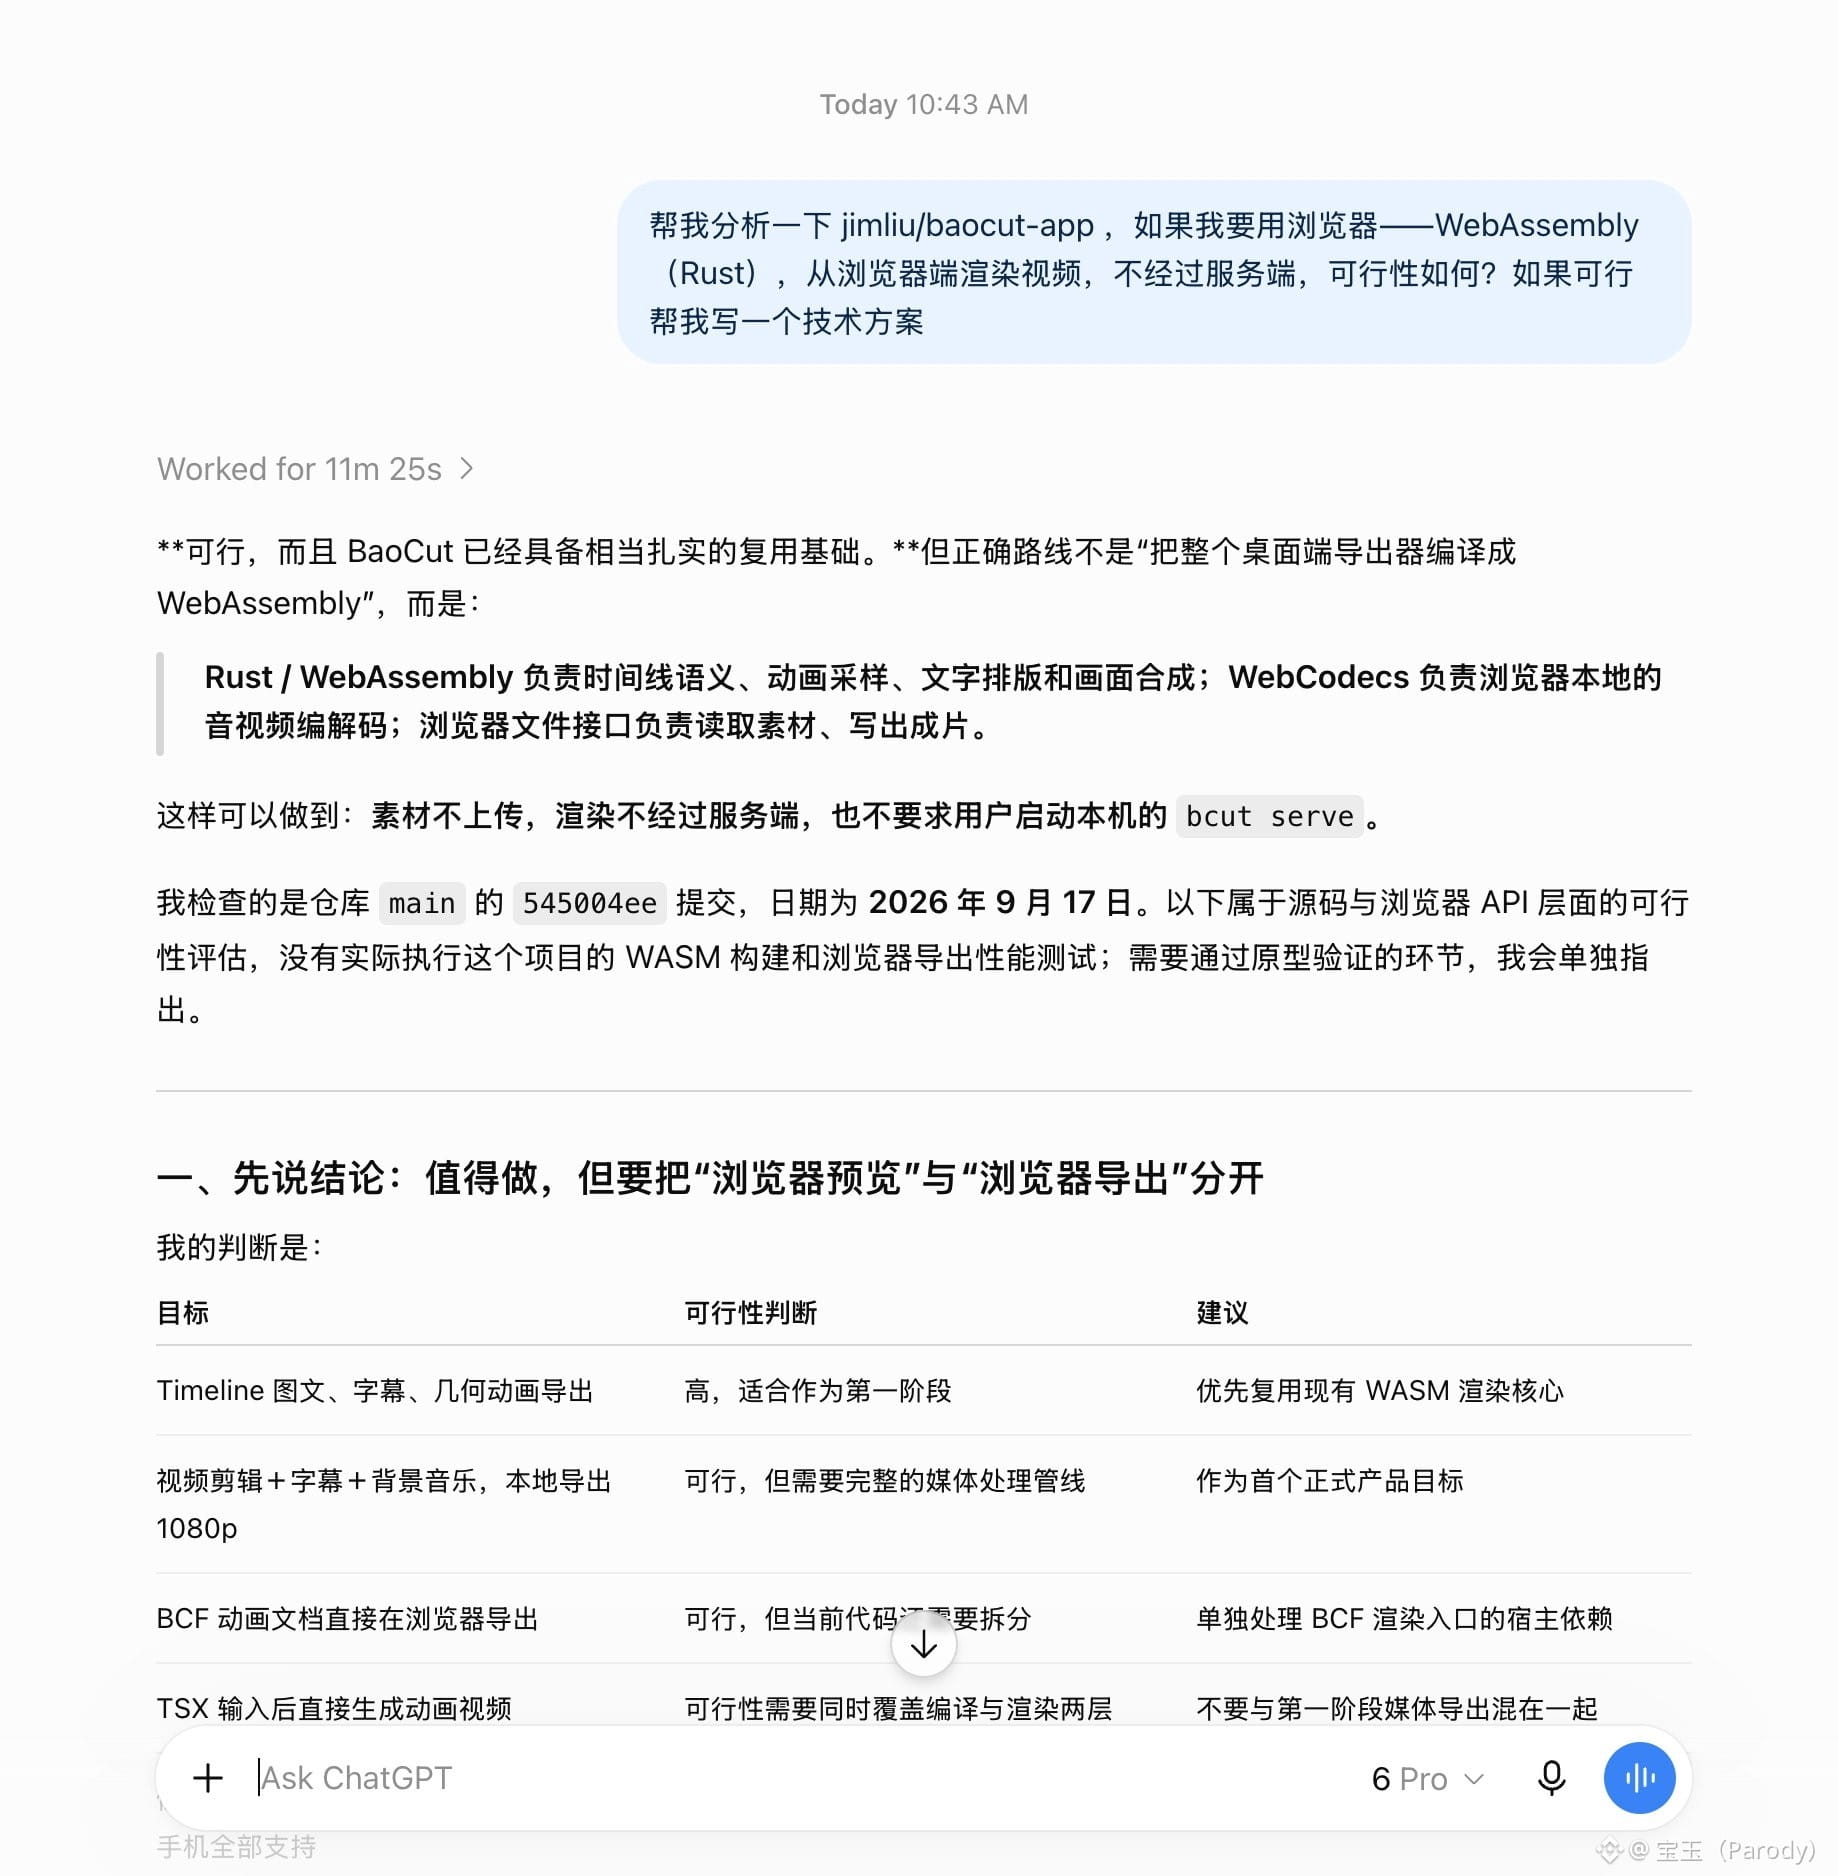
A minha utilização do ChatGPT Pro está cada vez maior; principalmente porque uso com frequência para me ajudar a criar planos técnicos, e o resultado é especialmente bom, além de não consumir limites do Codex.
Toda vez que uso, eu simplesmente envio para ele o endereço do GitHub, e peço que, com base no código, analise e faça o desenho, escreva um documento de design e até mesmo envie um PR. Depois disso, eu baixo o documento de design para o meu computador para o Codex ou o Claude Code executarem.
Às vezes também peço que ele “corra de parelha” com o Fable: para um mesmo problema, faço com que o Fable e o GPT 6 Pro desenvolvam, cada um, uma solução, e então eu aproveito os pontos fortes de cada uma para complementar.
Atenção: é preciso conectar sua própria conta do GitHub nas configurações, para que ele possa acessar seu repositório privado e seus envios de PR.
96
·
--
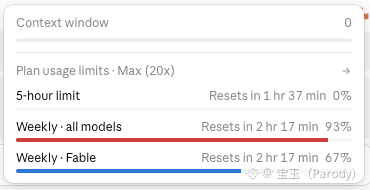
Não sei por que a minha cota do Fable foi de 97% para 67%; é porque estão cancelando o limite de 50%? Ou deu algum bug?
Não sei por que a minha cota do Fable foi de 97% para 67%; é porque estão cancelando o limite de 50%? Ou deu algum bug?
300
·
--
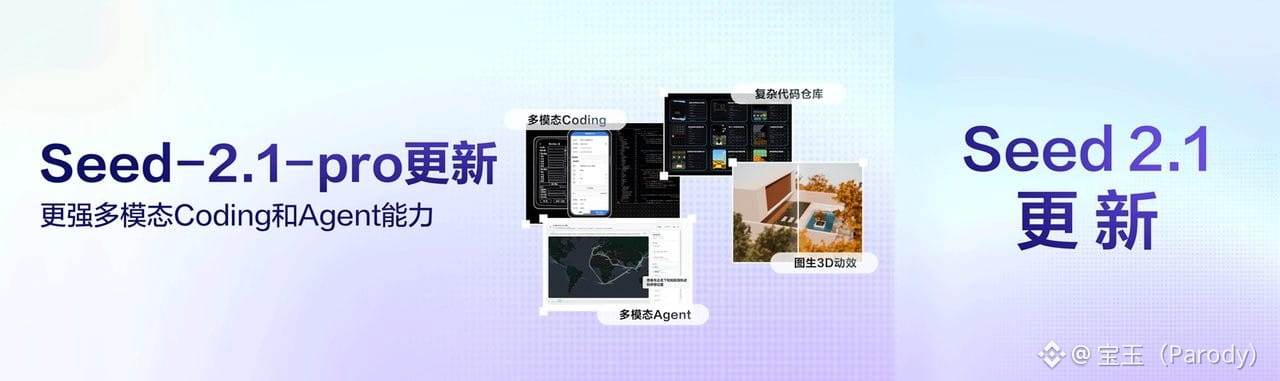
Modelo de grande escala Doubao 2.1 Pro: versão de atualização 0915, com a API já totalmente lançada na plataforma Volcano Ark. Desta vez, a atualização se concentra em quatro áreas: entrega de tarefas por agentes, codificação multimodal, compreensão multimodal e redução de custo de inferência.
Melhorias na área de Agentes
Quando o modelo precisa fazer chamadas de ferramentas em múltiplas rodadas, pesquisar informações na web e depois produzir um relatório, ele foi reforçado em capacidade de rastrear evidências e verificar dados, reduzindo significativamente as alucinações. O exemplo oficial é o de pesquisa e investimento financeiro: o modelo consegue decompor autonomamente as necessidades de pesquisa, buscar fontes de dados e então reconstruir a análise; os rascunhos gerados ficam próximos do nível de um analista. Para verificar uma afirmação em um relatório financeiro de uma montadora, o modelo escalonou mais de 500 subagentes, pesquisou mais de 1000 páginas e ainda cruzou informações de múltiplas fontes, como rotas marítimas e imagens de satélite. Essa capacidade de “não confiar em comunicação unilateral e validar com verificação cruzada de múltiplas fontes” tem valor direto para que empresas façam due diligence e produzam relatórios de pesquisa.
Codificação Multimodal
A mudança mais prática desta vez pode ser escrever código a partir de imagens. Agora o modelo consegue entender diretamente o projeto, plantas e até gravações de operação, transformando informações visuais em código de front-end. A demonstração oficial mostra um cenário: forneça ao modelo uma gravação de tela e algumas anotações/rascunhos, e deixe que ele desenvolva uma página de mobile para um sistema ERP antigo que não tem documentação — o modelo entendeu 280 mil linhas de código em Java e reproduziu diretamente uma página mobile executável.
Em compreensão do repositório de código, o modelo também realizou testes de correção autônoma no game open source Luanti (cerca de 387 mil linhas de código); 83% das tarefas atingiram o padrão para serem mescladas. Para desenvolvedores que frequentemente precisam localizar problemas em projetos grandes e depurar bugs entre múltiplos arquivos, esse número merece atenção.
Outras atualizações
Na compreensão multimodal, a capacidade de raciocínio com vídeo foi aprimorada: consegue localizar evidências no vídeo e integrar informações entre quadros. A compreensão de imagens também melhorou de forma evidente no reconhecimento de objetos 3D (peças CAD, elementos de engines de jogos) e na análise de textos e imagens densos (plantas de engenharia, tabelas de relatórios financeiros).
Em custos, o consumo de Tokens para inferência de imagens e vídeos diminuiu mais de 30% em comparação com a geração anterior.
Na utilização da API há duas portas: chamar Doubao-Seed-2.1-pro-0915 permite fixar a versão; chamar Doubao-Seed-Evolving acompanha automaticamente a versão mais recente, sem precisar trocar o Model ID. O trabalho do Doubao e o TRAE também já foram sincronizados para integração.
Artigo oficial: https://mp.weixin.qq.com/s/Fp_mgF6wxMk0bkUVBqOKqA
131
·
--
O engenheiro da Anthropic dá uma aula introdutória sobre FDE
https://www.youtube.com/watch?v=KwhgfwOSToQ
Kevin Bai agora está no time de Applied AI da Anthropic. Antes, foi um dos membros fundadores do time de FDE da Rippling; ainda antes, trabalhou por vários anos na Palantir. Recentemente, ele fez uma apresentação de “FDE 101”, explicando de forma bem clara o papel do engenheiro de implantação na linha de frente — vale a pena resumir.
Primeiro, um dado: em empresas SaaS listadas, classificando por valor médio do contrato, a Palantir tem US$ 4 milhões, a ServiceNow US$ 1,2 milhão, a Workday US$ 0,6 milhão; o restante nenhuma chega a passar de US$ 0,5 milhão. A Palantir conseguiu, com apenas alguns milhares de pessoas, atingir um ticket médio que outras fariam com dezenas de milhares. O segredo está no modelo FDE.
Então, afinal, o que o FDE resolve?
O produto da Palantir, Foundry, é uma plataforma de construção de aplicações com alto nível de exigência técnica, mas os compradores são executivos não técnicos — como de petróleo e bens de consumo. Você entregar uma plataforma tecnológica complexa para alguém que não sabe programar e esperar que essa pessoa descubra sozinha como usá-la não é realista.
Por isso, a abordagem da Palantir é esta: o cliente compra algo que não é um produto de software nem um serviço de consultoria, e sim um “resultado”. Você envia engenheiros para lá, entende profundamente os cenários de negócio do cliente e constrói as coisas na plataforma. O que o cliente se importa é quantas mercadorias a mais entram nas prateleiras, em quanto a eficiência das linhas de produção melhora; eles não se importam com como os dados são organizados — e nem precisam se importar.
Qual é a diferença entre FDE e desenvolvimento terceirizado?
Kevin enfatiza especialmente um ponto: se seus engenheiros, toda vez, começam do zero e escrevem código personalizado para o cliente, então o que você está fazendo não é FDE, é desenvolvimento terceirizado. O modelo FDE só se sustenta se você tiver uma plataforma reutilizável. Os engenheiros montam e customizam com base nas capacidades já existentes da plataforma, e não ficam reinventando a roda toda vez. Sem uma plataforma, os custos de manutenção vão consumir todo o lucro, e os engenheiros também vão acabar saindo, porque precisariam manter dezenas de repositórios de código sem relação entre si.
Vale a pena fazer FDE? Dois problemas já respondem.
Primeiro: você precisa vender algo tecnologicamente complexo para um comprador não técnico? Se seus clientes são, por natureza, engenheiros — por exemplo, quando você vende GitHub ou Datadog — então não precisa de FDE. Se seu produto já é pronto para uso, como Slack ou Jira, também não precisa. Só quando seu produto é muito complexo e o cliente não entende de tecnologia é que o FDE faz sentido.
Segundo: você tem uma plataforma reutilizável? Ou você está disposto a investir para construí-la? Sem componentes básicos compartilháveis, o FDE não é sustentável.
Quais são as mudanças novas em 2026?
A avaliação do Kevin é interessante: o jeito de fazer negócio na indústria de software mudou. Com a IA, construir software fica extremamente fácil, e quase todas as plataformas estão indo na direção de uma abordagem baseada em agentes (Agent). Isso significa que quase todas as plataformas vão se tornar altamente customizáveis. A consequência é que cada vez mais clientes não conseguem entender exatamente o que o seu produto consegue fazer. Entregar o sucesso ou fracasso do seu produto para o cliente descobrir por conta própria, na era dos agentes, fica cada vez mais difícil.
Isso transforma o FDE, antes um modelo exclusivo e nichado da Palantir, em algo que mais empresas de software precisam considerar seriamente.
Por fim: que tipo de pessoa é adequada para fazer FDE?
A resposta do Kevin é bem direta: FDE é um engenheiro de software em quem você confia a ponto de deixá-lo lidar diretamente com o cliente. Capacidade técnica é a base, mas você também precisa ter segurança para permitir que ele represente a empresa na interação com o cliente.
172
·
--
Ultimamente tem muita “vibe coding”, especialmente quando o limite está prestes a ser resetado. Nessa hora, jogam um monte de tarefas para o Agent fazer: algumas tarefas mostram como concluídas e eu nem olho mais. Mas no dia seguinte, durante os testes, percebi que as tarefas não tinham sido finalizadas. Voltei e verifiquei: afinal, tinha sido criado um worktree, mas não estava sendo modificado no main e nem chegou a ser mesclado.
Depois pedi para o Agent fazer uma checagem mais concentrada e ainda havia vários worktrees assim — ele fez uma limpeza.
No fim, mandei ele adicionar uma regra em Agents.md: não é que não possa criar worktree, mas não pode ficar nada “esquecido” ali.
--- Referência: prompt de revisão do worktree ---
Me ajude a ver quais worktrees ainda não foram sincronizados com o main. Os que estiverem sincronizados, apague diretamente; os que não estiverem, liste: branch, resumo das modificações (incluindo os commits mais recentes) e a sessão correspondente.
--- Referência: prompt de limpeza do worktree ---
Me ajude a ver o conteúdo desses worktrees. Se houver algo que valha a pena mesclar, faça a mesclagem e limpe os worktrees. O que não estiver claro, me peça confirmação, mas me dê recomendações bem claras.
--- Referência: regras do AGENTS.md ---
- worktree não pode ficar deixado para trás: tarefas feitas dentro do worktree, quando concluídas, devem ter aquele worktree e sua branch removidos. Antes de excluir, escolha uma de duas opções: mesclar em `main`; ou, se não for mesclar, primeiro commitar as alterações não enviadas naquela branch, marcar com a tag `archive/<worktree nome>` para arquivar e então executar `git worktree remove` + `git branch -D`. As sessões do subagent orquestradas ficam responsáveis por dar o encerramento nos worktrees derivados dele. Se for realmente necessário manter (aguardando decisão do usuário, ou com conflitos para resolver), aponte no feedback final os caminhos e os motivos, sem deixar nada silenciosamente para trás.
1
197
·
--
Huang Renxun está participando de uma entrevista no palco durante o All-In Summit em Los Angeles. De repente, o celular toca e quem liga é o presidente dos Estados Unidos, Donald Trump. Huang atende, coloca no viva-voz e o público do local ouve diretamente a voz do presidente. https://x.com/benitoz/status/2099572926865715548/video/1
Dois dias antes, o CEO da Anthropic, Dario Amodei, publicou um longo artigo de quase quatro mil palavras, “We Must Pace the Frontier”, pedindo que a indústria de IA desacelere voluntariamente a evolução de suas capacidades, para que a pesquisa em segurança tenha tempo de alcançar o ritmo. Após a publicação, Sam Altman, da OpenAI, se posicionou publicamente concordando, e Elon Musk também publicou apenas três palavras: “Dario is right.” A atmosfera de todo o setor virou de repente para “é hora de pisar no freio”.
Trump claramente não comprou essa ideia. Naquela mesma manhã, ele primeiro publicou um texto no Truth Social refutando, e logo em seguida ligou para entrar na entrevista em palco de Huang Renxun. Ao telefone, Trump foi bem direto: “A IA não vai assumir o mundo, robôs não vão assumir o mundo, e toda essa história é um golpe.” Ele disse que os data centers fariam comunidades que estavam em declínio voltarem a ficar ricas; a IA seria ainda maior do que a própria internet. E que quem se opõe a construir data centers “está exatamente satisfazendo aqueles que não querem que os Estados Unidos ganhem — talvez sejam políticos, talvez seja a China”.
Huang Renxun concordou o tempo todo e respondeu: “O senhor está certo. Não vamos deixar que esse tipo de coisa aconteça. Vamos garantir que, na corrida de IA, os Estados Unidos ganhem em todos os setores, em todas as empresas, em cada estado e por meio de cada pessoa.”
90
·
--
StarCraft vai lançar um jogo de tiro em mundo aberto, com lançamento previsto para 2030; parece bem fiel.
StarCraft vai lançar um jogo de tiro em mundo aberto, com lançamento previsto para 2030; parece bem fiel.
34
·
--
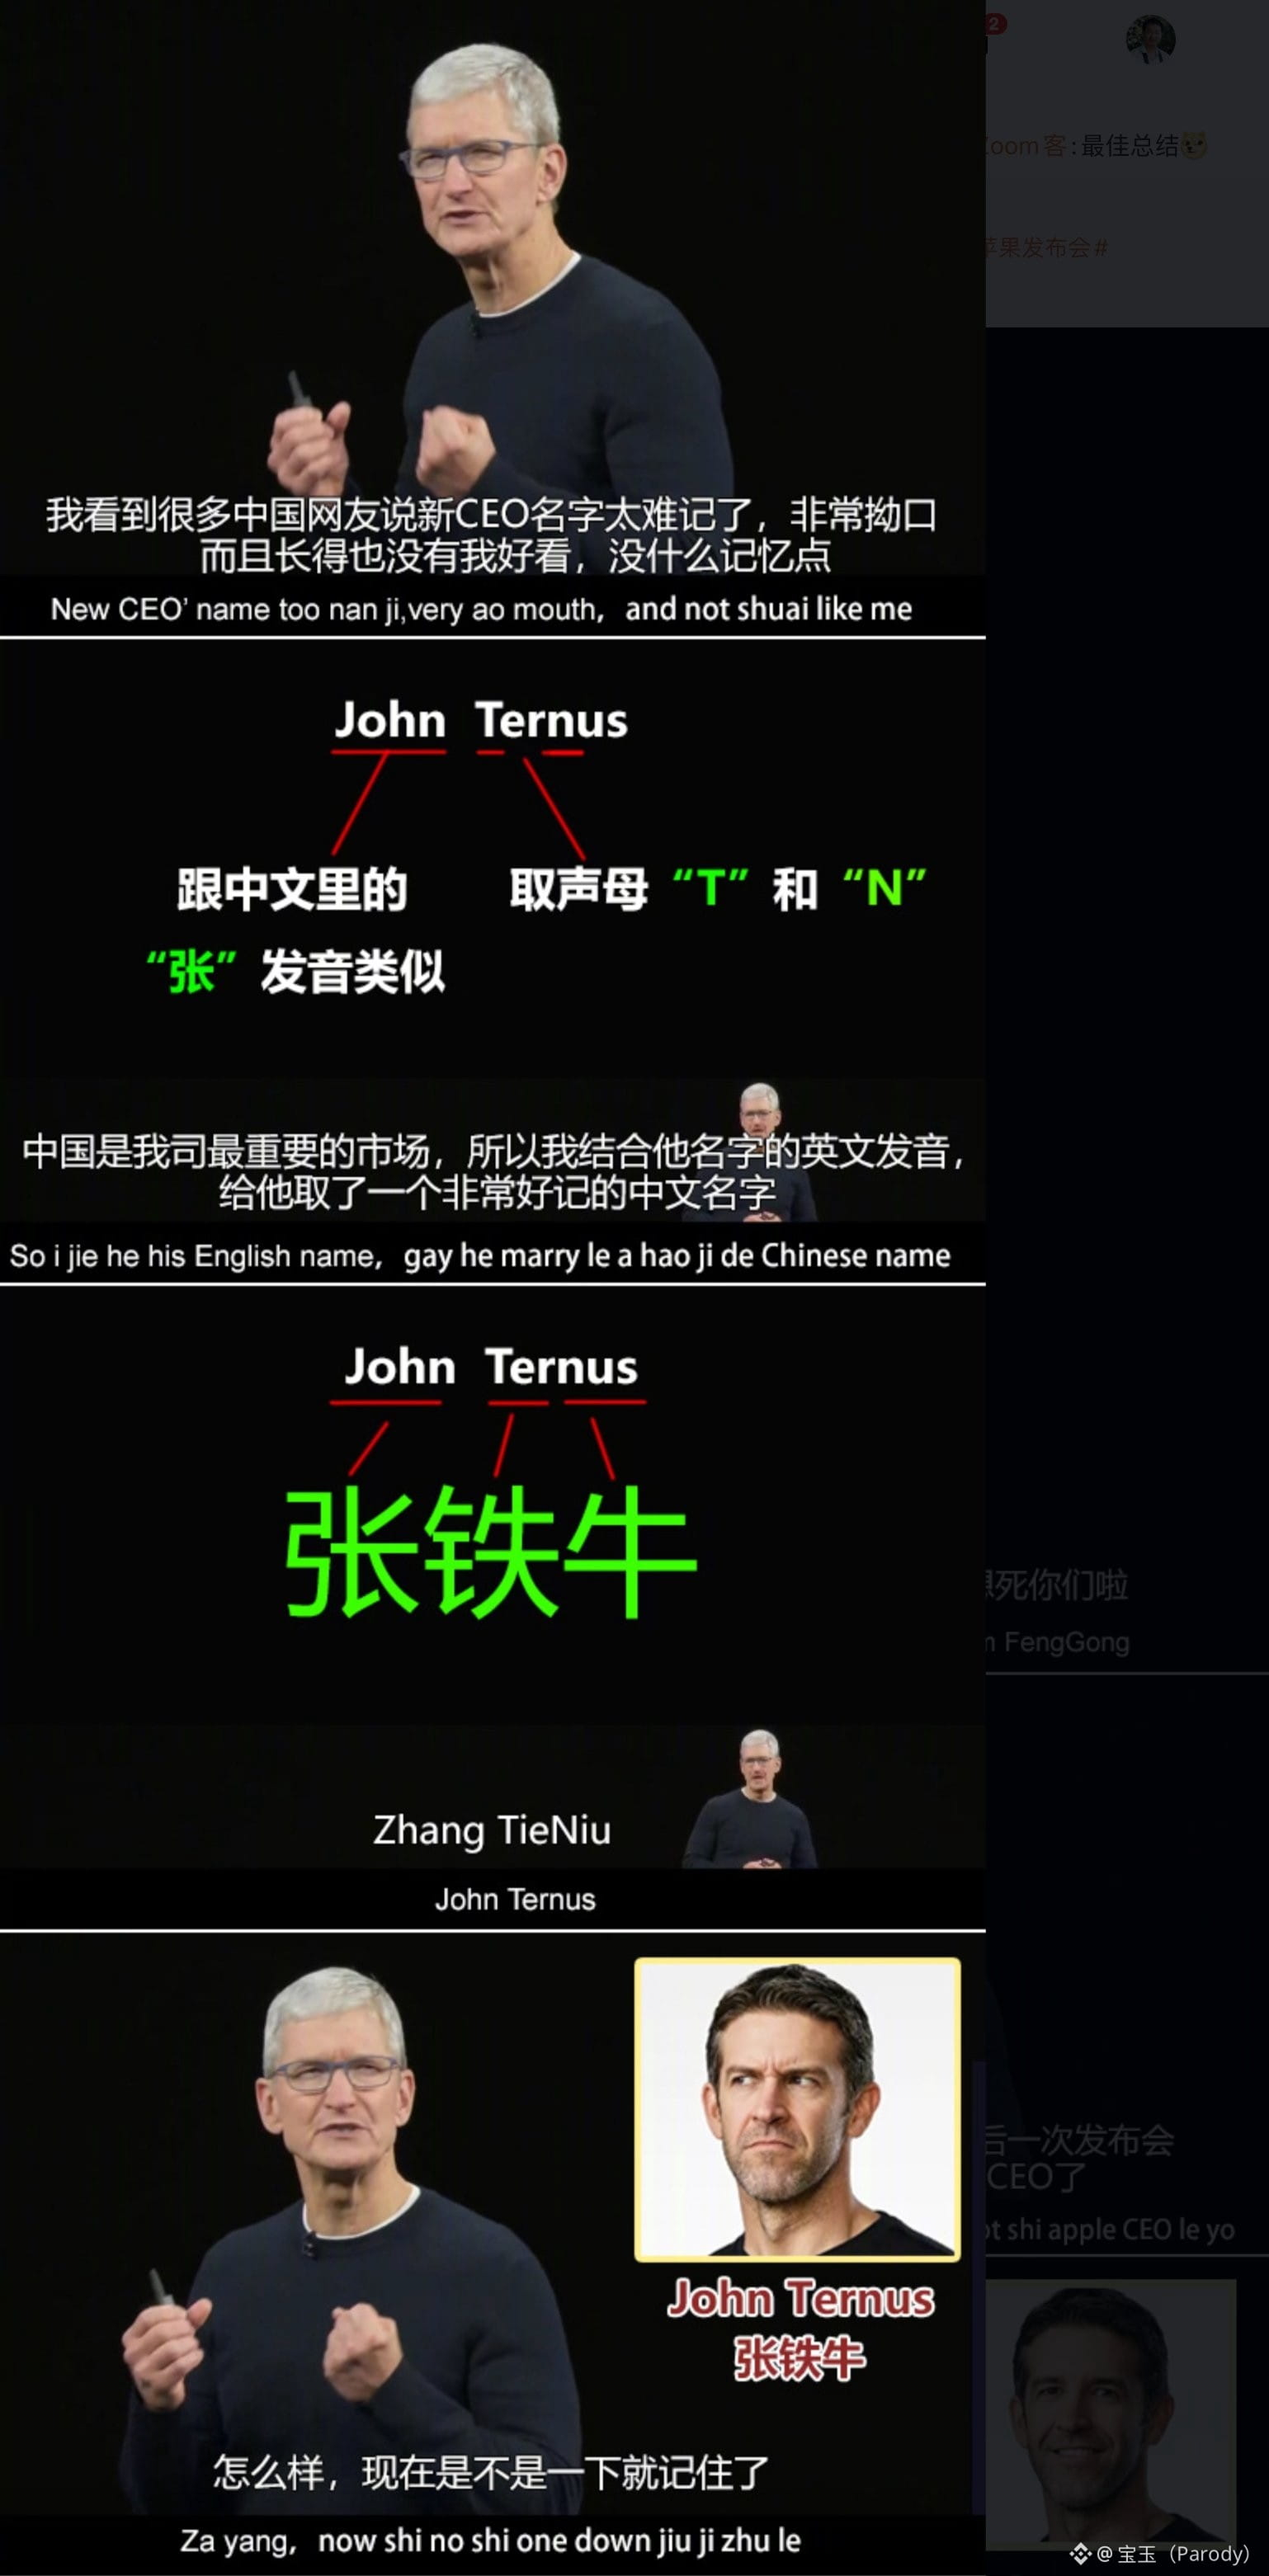
Finalmente lembrei o nome do novo CEO da Apple: John Ternus (张铁牛)
😂
(Fonte da imagem: 天才小熊猫, versão completa: https://weibo.com/1563926367/RhqQVsEDA)
Finalmente lembrei o nome do novo CEO da Apple: John Ternus (张铁牛)
😂
(Fonte da imagem: 天才小熊猫, versão completa: https://weibo.com/1563926367/RhqQVsEDA)
😂
(Fonte da imagem: 天才小熊猫, versão completa: https://weibo.com/1563926367/RhqQVsEDA)
307
Inicia sessão para explorar mais conteúdos
Junta-te a utilizadores de criptomoedas de todo o mundo na Binance Square
⚡️ Obtém informações úteis e recentes sobre criptomoedas.
💬 Com a confiança da maior exchange de criptomoedas do mundo.
👍 Descobre perspetivas reais de criadores verificados.
E-mail/Número de telefone
Tópicos em Tendência
NFPWatch
10.7M visualizações
18,554 a discutir
Notícias de Cripto | Bitcoin se Aproxima de US$ 85 mil à medida que os Rendimento dos Treasuries Caem antes do Relatório NFP dos EUA
Binance News
·31 gostos
·43.8k visualizações
BitcoinFundingRateTriplesTo10%
61,189 visualizações
709 a discutir
BitcoinSurpasses$86KUp2.99%
17,650 visualizações
73 a discutir