

#aiinference
aiinference
1,217 visualizações
7 a discutir
Popular
Mais recente
·
--
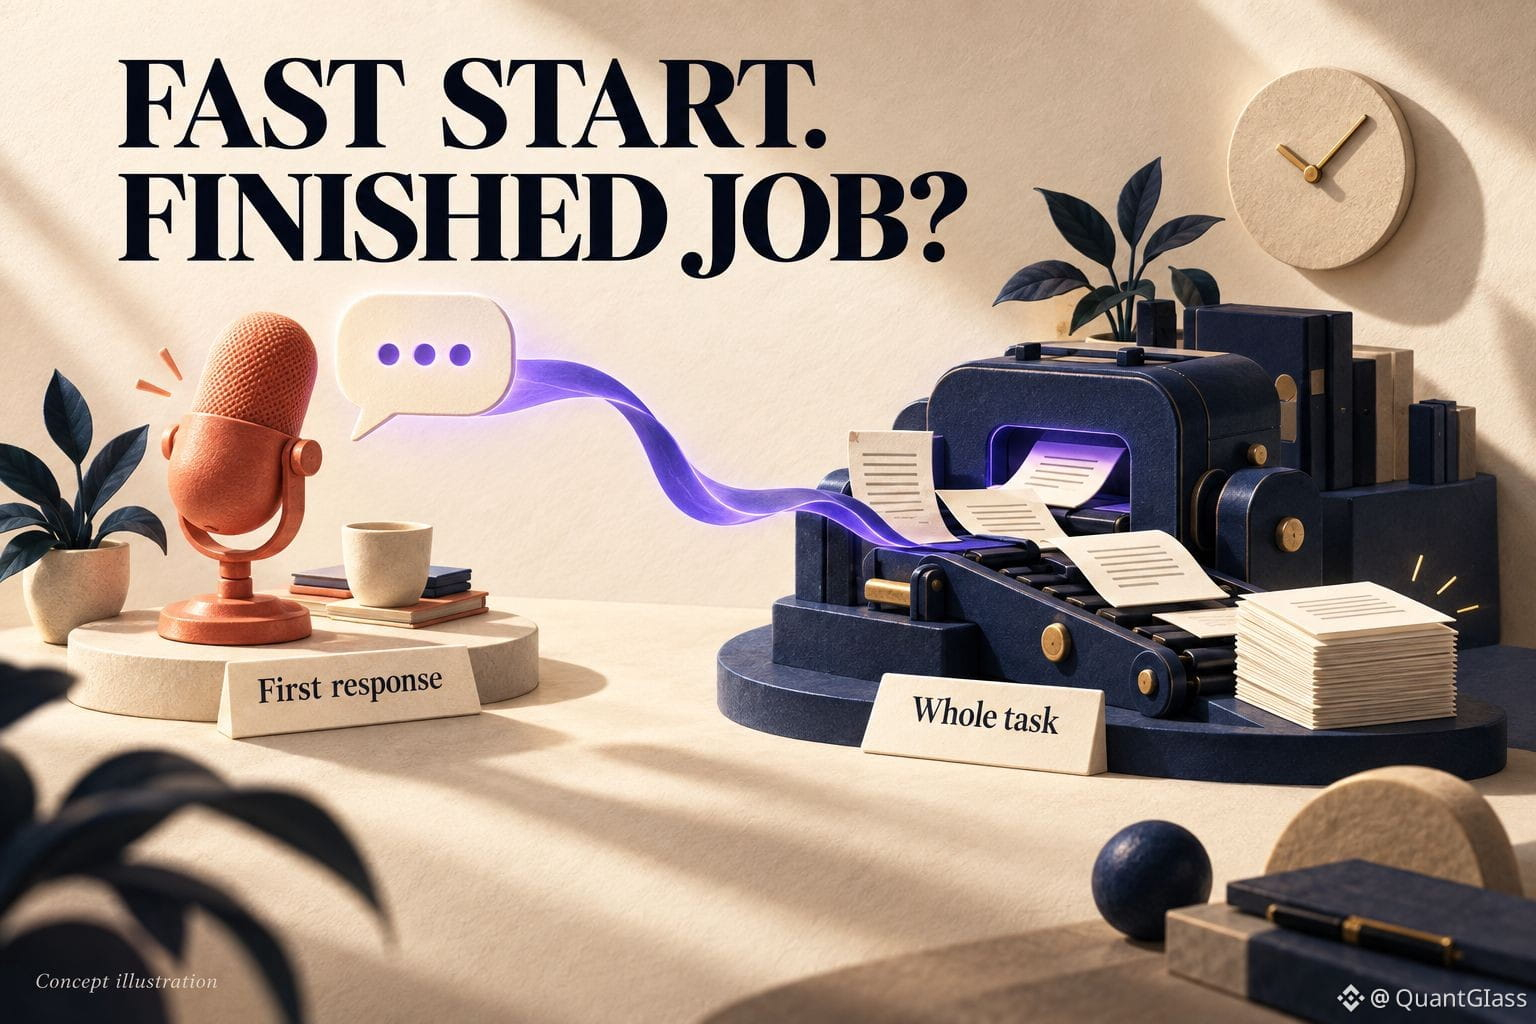
Um IA que começa a responder rapidamente ainda pode levar idades para concluir o trabalho.
No artigo de 18 de setembro, a io.net diferencia tempo até o primeiro token — a espera antes de a saída começar — de throughput em lote. Ela posiciona seus GPUs distribuídos em torno de custo e flexibilidade, e não em vencer a corrida do primeiro token.
Meu teste para a história de $IO compute: medir a tarefa inteira. Um assistente de voz ao vivo precisa de uma resposta rápida; um job de documentos durante a noite precisa de resultados precisos até o prazo, com um custo total razoável. Os exemplos de custo do artigo são apenas ilustrativos, não são benchmarks independentes. As cargas de trabalho reais ainda precisam ser testadas.
O que te frustra mais: esperar pela primeira palavra ou esperar pela resposta final? #AIInference
167
·
--
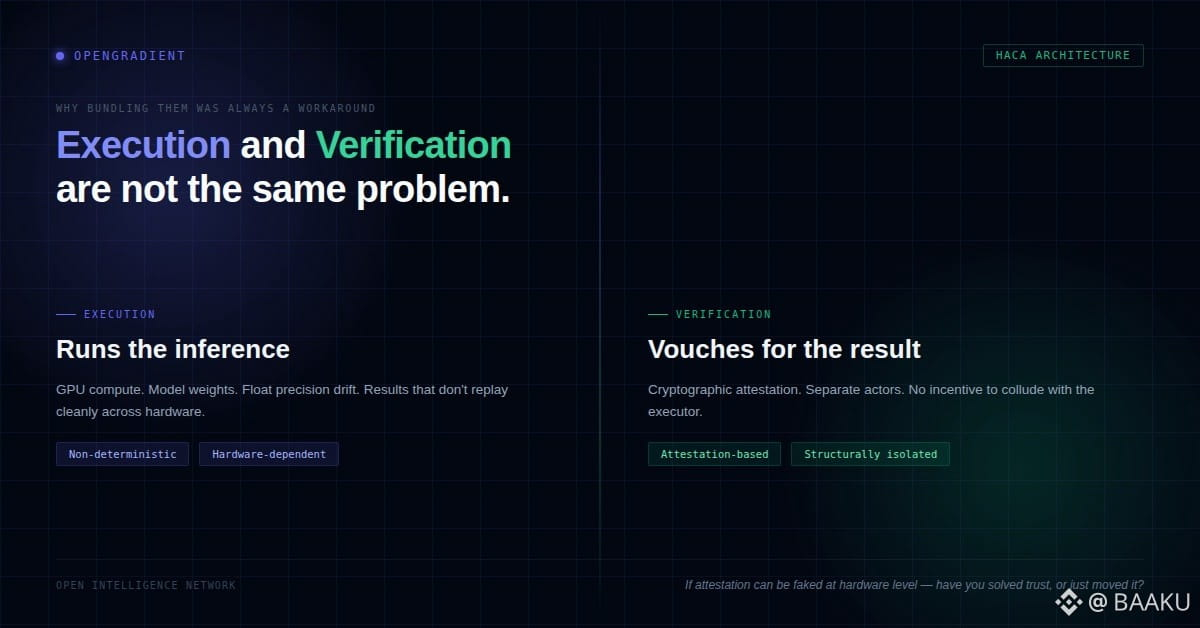
A maioria das blockchains trata a execução e a verificação como se fossem o mesmo problema. Não são.
Execução é computação. Verificação é confiança. Agrupar os dois sempre foi uma solução improvisada — não uma escolha de design. E por anos, ninguém percebeu porque os modelos eram simples o suficiente para que "execute novamente e verifique" parecesse uma solução real.
Não é mais assim.
A inferência de IA não é reproduzida de forma limpa. Execute o mesmo modelo duas vezes em hardware diferente, você pode obter saídas diferentes. Precisão de ponto flutuante, variação de temperatura, peculiaridades de GPU — os resultados se desviam. Então, se sua camada de verificação é apenas "execute novamente e compare", você já perdeu. Você não está verificando a verdade. Você está verificando a consistência sob condições ideais, que é uma coisa completamente diferente.
Essa é a lacuna que a maioria das pessoas ignora quando fala sobre "IA verificável em cadeia."
A arquitetura HACA da OpenGradient realmente separa essas duas camadas. Os nós de execução realizam a inferência. Uma camada de verificação separada checa o resultado — usando atestação criptográfica, não re-execução redundante. O nó que executou o modelo e o sistema que atesta por ele são atores estruturalmente diferentes com incentivos distintos.
Essa separação importa mais do que as pessoas percebem. Quando a execução e a verificação são tratadas pela mesma lógica, o modelo de confiança do sistema é tão bom quanto a honestidade do executor. Você não está verificando a IA. Você está confiando no executor para se auto-relatar.
Separe os papéis, e a estrutura de incentivos realmente muda. Os nós de verificação não têm razão para coludir com os executores — eles não rodaram o modelo, estão apenas checando a prova. Essa é uma verdadeira fronteira de confiança, não uma teórica.
A limitação honesta: a verificação baseada em atestação ainda está amadurecendo. A sobrecarga criptográfica é real, e "prova de inferência correta" em grandes modelos não é um problema resolvido. A direção do design é defensável. Mas as suposições de segurança reais estão fazendo muito trabalho silencioso nos bastidores.
#OpenGradient #DecentralizedAI #AIInference #opg $OPG @OpenGradient
5
2
97
·
--
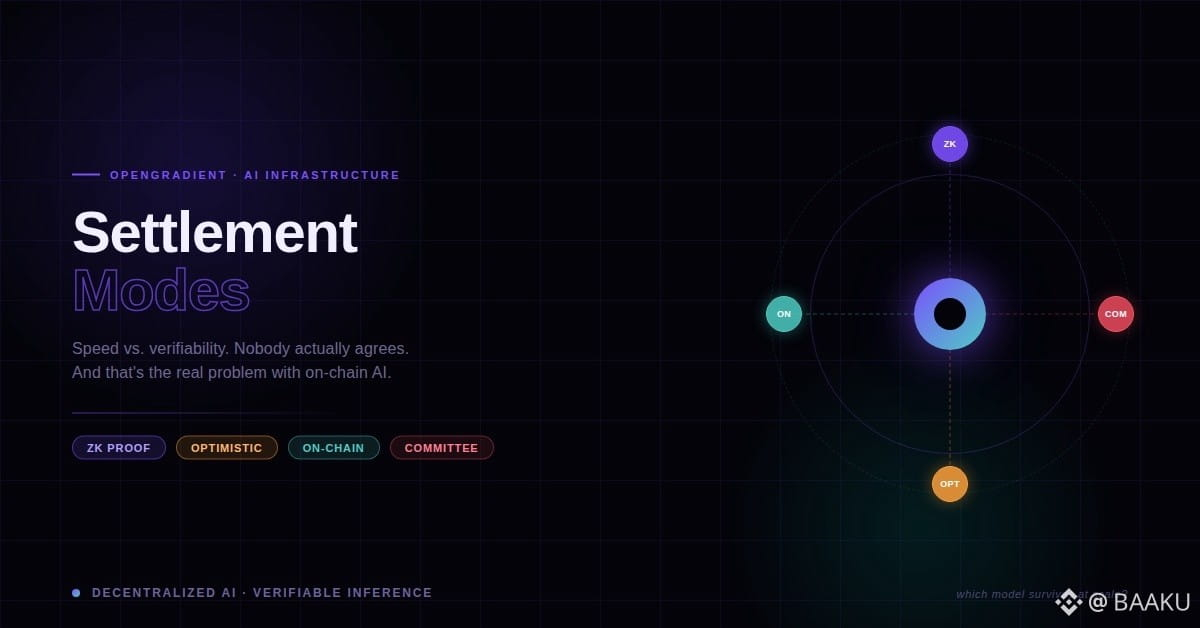
A maioria das pessoas acha que a liquidação é apenas aquela parte chata do backend. A parte que "simplesmente funciona."
É exatamente por isso que ela continua quebrando nos piores momentos possíveis.
Aqui está o que realmente está acontecendo. Quando um modelo de IA executa uma inferência — gera uma saída, toma uma decisão, pontua um resultado — você não tem ideia se essa saída é real. Não de uma forma verificável. Você está confiando em uma caixa-preta no servidor de outra pessoa para te dizer a verdade. E em 99% da infraestrutura atual de IA, esse é o modelo de segurança inteiro. Confia em mim, cara. Em produção. Em escala.
A liquidação deveria consertar isso. A ideia é limpa: você roda o modelo, prova que ele rodou corretamente, registra essa prova e agora a saída tem integridade. Simples.
Exceto que no momento em que você pergunta como essa prova é liquidada — on-chain, off-chain, otimista, ZK, baseada em comitê — você percebe que ninguém realmente concorda. E a matriz de trade-offs é brutal.
A liquidação on-chain te dá uma verificabilidade real, mas introduz latência que torna a inferência de IA em tempo real completamente impraticável. Você não pode esperar 12 segundos para uma confirmação de bloco toda vez que um modelo faz uma chamada.
A liquidação otimista é rápida, mas empurra o problema de integridade para frente — você assume a correção a menos que alguém a desafie. A maioria dos usuários nunca irá desafiar nada. Isso é apenas comportamento humano.
#OpenGradient #AIInference #opg $OPG @OpenGradient
6
5
198

A16Z INVESTE NA REVOLUÇÃO LOCAL DE IA COMO AGENTES NO DISPOSITIVO IGNITEM A NARRATIVA $AI ! ⚡ 🦈
📌 Pesos-pesados de Silicon Valley, a16z e Khosla Ventures, acabaram de colocar capital institucional por trás do agente local Underdog da Conway Research. Executando um modelo compacto de 4B parâmetros diretamente em hardware do consumidor em 4,5x de velocidade sobre MLX, isso sinaliza uma grande virada estrutural rumo à execução sem nuvem. 💡
O dinheiro inteligente está, de forma agressiva, se antecipando à mudança de modelos inchados de data centers para uma inteligência ágil no dispositivo. 📊 À medida que a computação de borda converge com a execução de agentes autônomos, a infraestrutura local de IA está rapidamente se tornando o próximo grande motor narrativo entre os mercados. ⚡
🤔 Agentes locais de IA vão tornar modelos centralizados em nuvem obsoletos para tarefas diárias? 👇
⚠️ Não é aconselhamento financeiro. Gerencie sempre seu risco. 🛡️
🏷️ #AI #CryptoAI #TechTrends #Agents #AIInference
🔥 ⚡
123
Inicia sessão para explorar mais conteúdos
Junta-te a utilizadores de criptomoedas de todo o mundo na Binance Square
⚡️ Obtém informações úteis e recentes sobre criptomoedas.
💬 Com a confiança da maior exchange de criptomoedas do mundo.
👍 Descobre perspetivas reais de criadores verificados.
E-mail/Número de telefone
Tópicos em Tendência
1
#ZcashETFPostsFirstWeeklyOutflow$93.6M
33,809 visualizações
98 a discutir
2
#GreekPoliceBustCryptoScamRingArrest17
69,893 visualizações
672 a discutir
3
#BitcoinRejectedAt$87K
119,027 visualizações
156 a discutir
4
#FedOctoberRateHikeOddsFallTo17%
95,509 visualizações
956 a discutir
5
#NvidiaHitsRecordHighUp2.4%
64,260 visualizações
700 a discutir
6
#CanaryFilesAmendedS1ForPEPEETF
18,293 visualizações
493 a discutir
7
#USRussiaUkraineTalksReportedlyIncludeLukoilOilDeal
28,824 visualizações
490 a discutir
8
#BitcoinParesGainsAfterRallyTo$86.5K
46,929 visualizações
166 a discutir
9
#CerebrasSinksNearly20%OnReportNvidiaToPowerOpenAI
114,066 visualizações
1,098 a discutir
10
#SECProposesCryptoCustodyRules
154,067 visualizações
1,376 a discutir