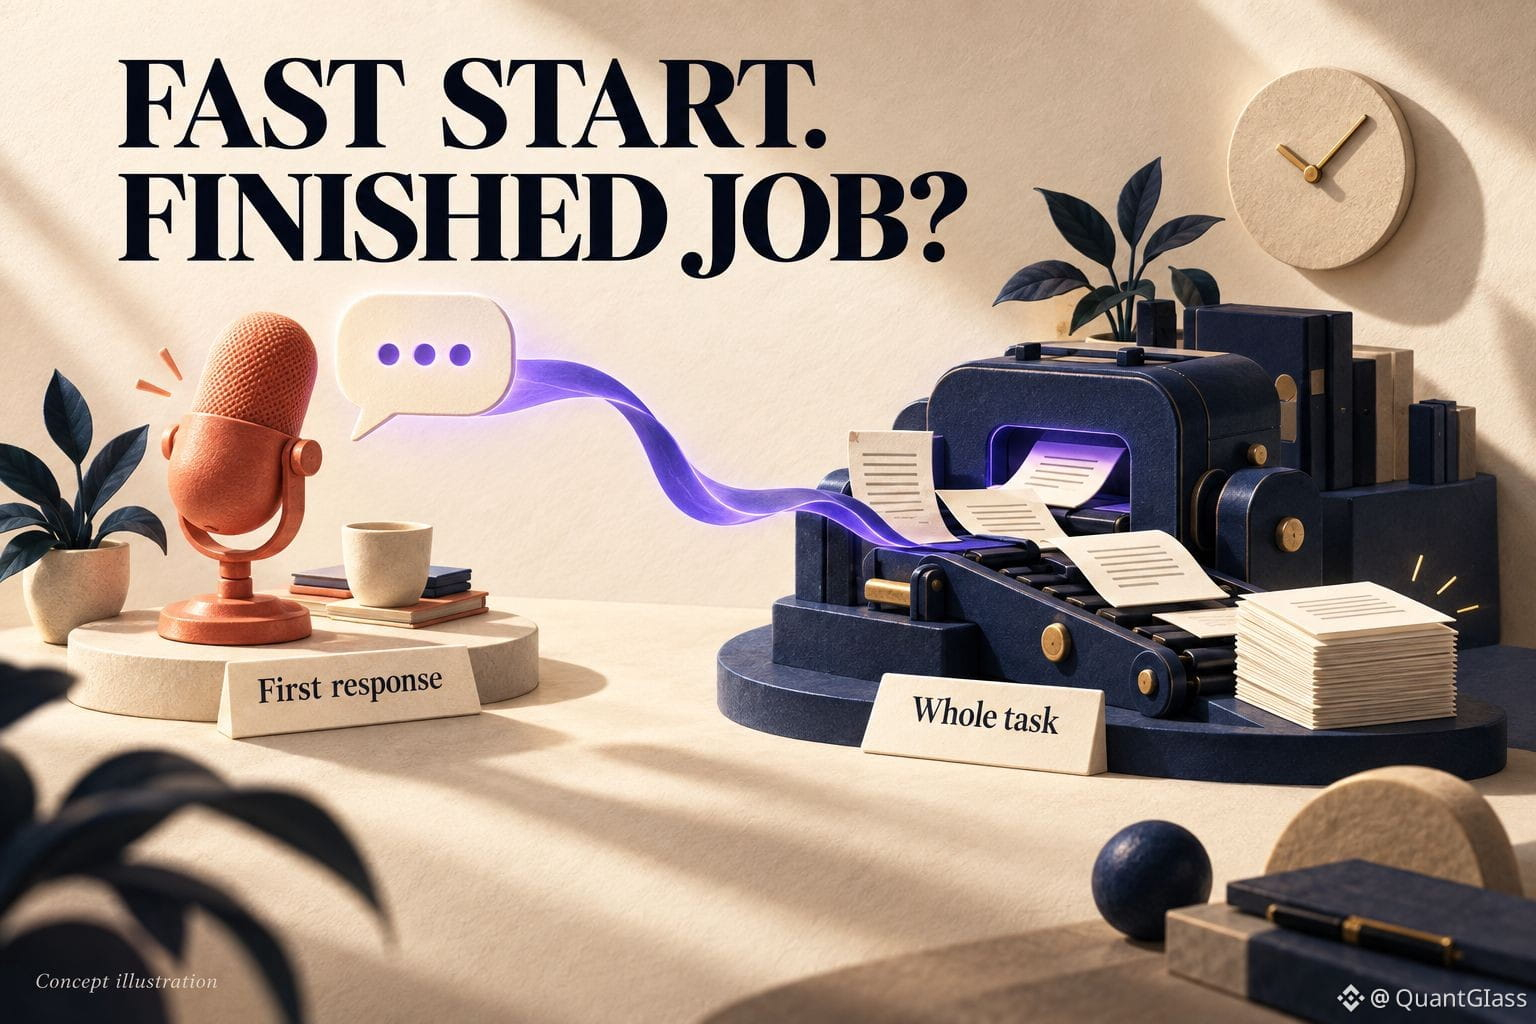
Um IA que começa a responder rapidamente ainda pode levar idades para concluir o trabalho.
No artigo de 18 de setembro, a io.net diferencia tempo até o primeiro token — a espera antes de a saída começar — de throughput em lote. Ela posiciona seus GPUs distribuídos em torno de custo e flexibilidade, e não em vencer a corrida do primeiro token.
Meu teste para a história de $IO compute: medir a tarefa inteira. Um assistente de voz ao vivo precisa de uma resposta rápida; um job de documentos durante a noite precisa de resultados precisos até o prazo, com um custo total razoável. Os exemplos de custo do artigo são apenas ilustrativos, não são benchmarks independentes. As cargas de trabalho reais ainda precisam ser testadas.
O que te frustra mais: esperar pela primeira palavra ou esperar pela resposta final? #AIInference
No artigo de 18 de setembro, a io.net diferencia tempo até o primeiro token — a espera antes de a saída começar — de throughput em lote. Ela posiciona seus GPUs distribuídos em torno de custo e flexibilidade, e não em vencer a corrida do primeiro token.
Meu teste para a história de $IO compute: medir a tarefa inteira. Um assistente de voz ao vivo precisa de uma resposta rápida; um job de documentos durante a noite precisa de resultados precisos até o prazo, com um custo total razoável. Os exemplos de custo do artigo são apenas ilustrativos, não são benchmarks independentes. As cargas de trabalho reais ainda precisam ser testadas.
O que te frustra mais: esperar pela primeira palavra ou esperar pela resposta final? #AIInference