
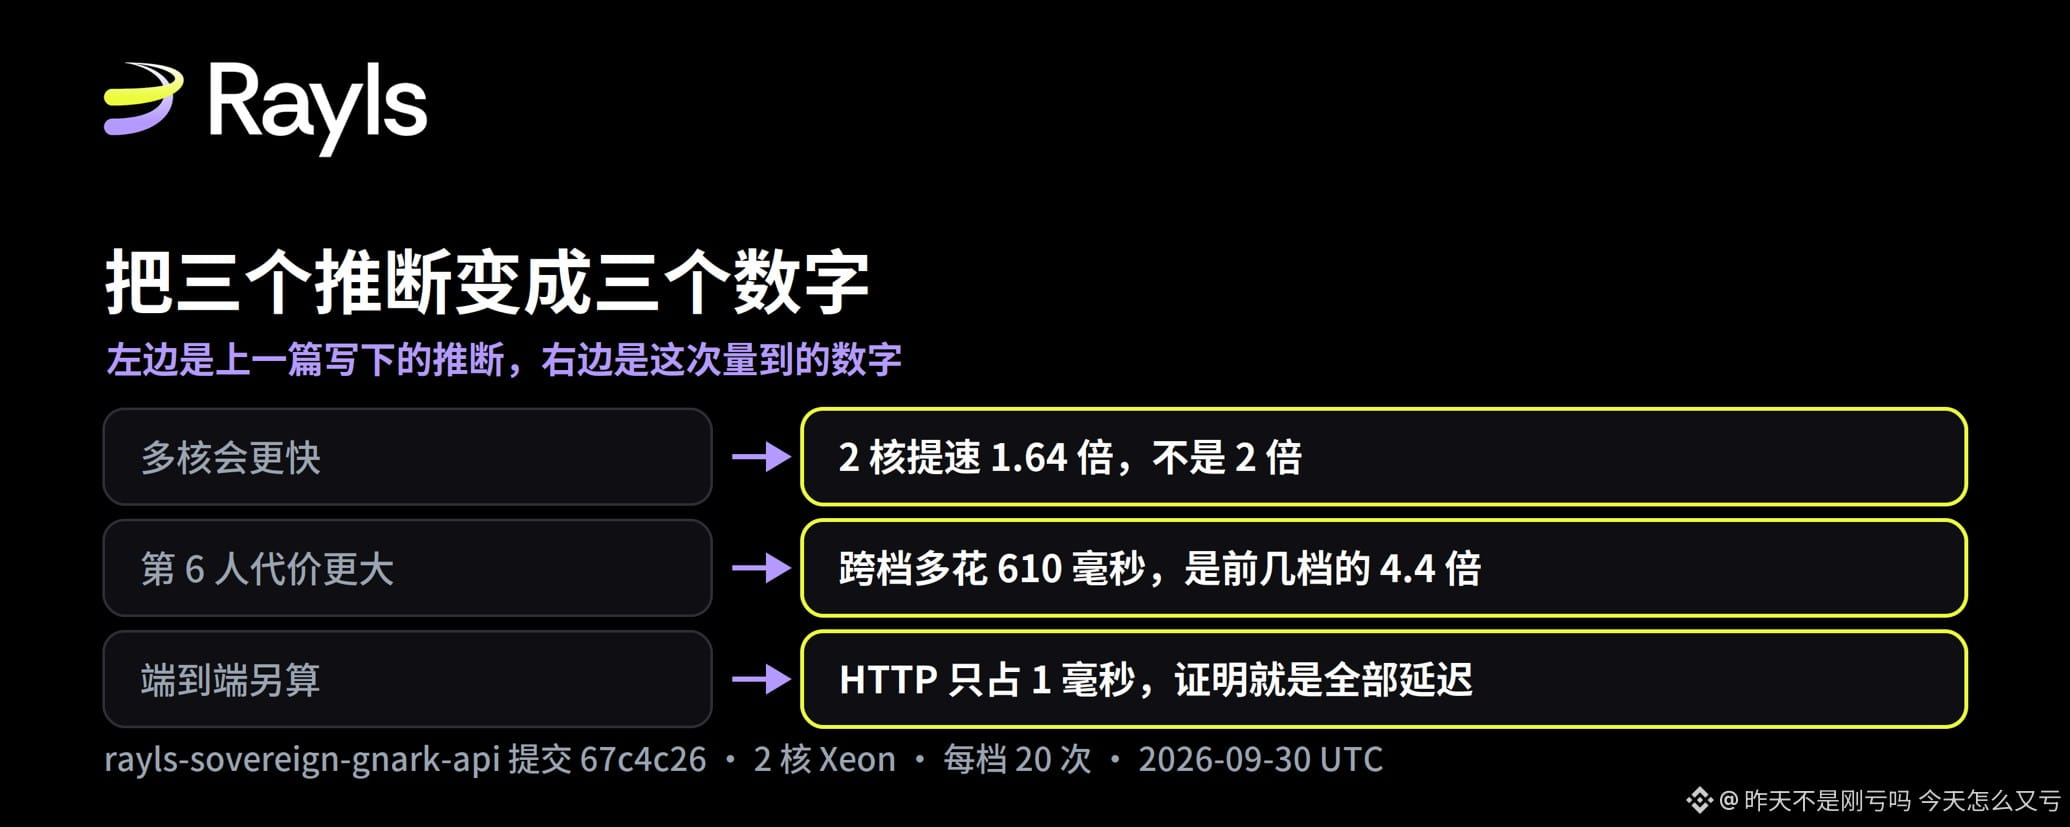
前回、Raylsが公開している証明コードを走らせて、6人匿名集合の1件あたり1.96秒を測りました。ただし、その記事には3つの文が推測であり測定ではないことを、私は自分の中で把握していました。今週はマシンを2核に替えて、さらにいくつかのデータを追加したので、前回の記事のその3つの推測を埋めに戻りました。
まず、この投稿が前回とどんな関係かを明確にします。同じ記事の焼き直しだと思われないように。前回は単一核環境での2人段と6人段の証明にかかる時間を測定しました。今回、その2つの数字を再測定しましたが、ほぼ変わりません。この記事での新しい内容は、前回測れず、推測せざるを得なかった3点です。
3つの論点はそれぞれ:マルチコアは本当に速くなるのか、第6の参加者が特に高い理由、エンドツーエンド遅延のうち証明が占める割合。以下、「前回の推断」と書いてある部分は当時の私の言い方であり、「今回測れた」と書いてある部分は今回の結果です。
まず、テストデータの出どころを説明します
Raylsの証明サービスリポジトリにはテストデータが付いていますが、2人段と6人段の2組しかありません。中間の3・4・5段はなく、前回の記事で中間値を測れなかったのはまさにこのためです。適当に1組作っても無理です。回路がその場で拒否しますし、仮に通る形が作れたとしても、読者に信じる理由がありません。
そこで私はジェネレータを書きました。回路の制約条件はリポジトリのcommon-checks.goに記載されていて、各項目を逆算して確認できます。送信者の共有鍵は前ラウンドの乱数と私鍵のPoseidonハッシュで、BabyJubJub部分群の位数に対してmodを取ったもの。公開鍵は私鍵の自己ハッシュをmodしたもの。ランダム因子では、受信者ごとに各ハッシュの負値を取り、送信者側は受信者側の和を取ります。取引コミットメントは金額とランダム因子のPedersenコミットメントです。ジェネレータは、これらのルールをリポジトリ自身のネイティブ関数でそのまま実装したものです。
重要なのは、このジェネレータが間違いなく正しい回路を書いているかどうかです。私のやり方は次の通りです。まず、それを使って公式の2組のデータを再現します。公式データのうち、制約付きのフィールドをすべて空にし、種と他の参加者の公開入力だけを残します。そしてジェネレータに再計算させ、フィールドごとに突き合わせます。その結果、6人段と2人段の全フィールドが完全に一致しました。
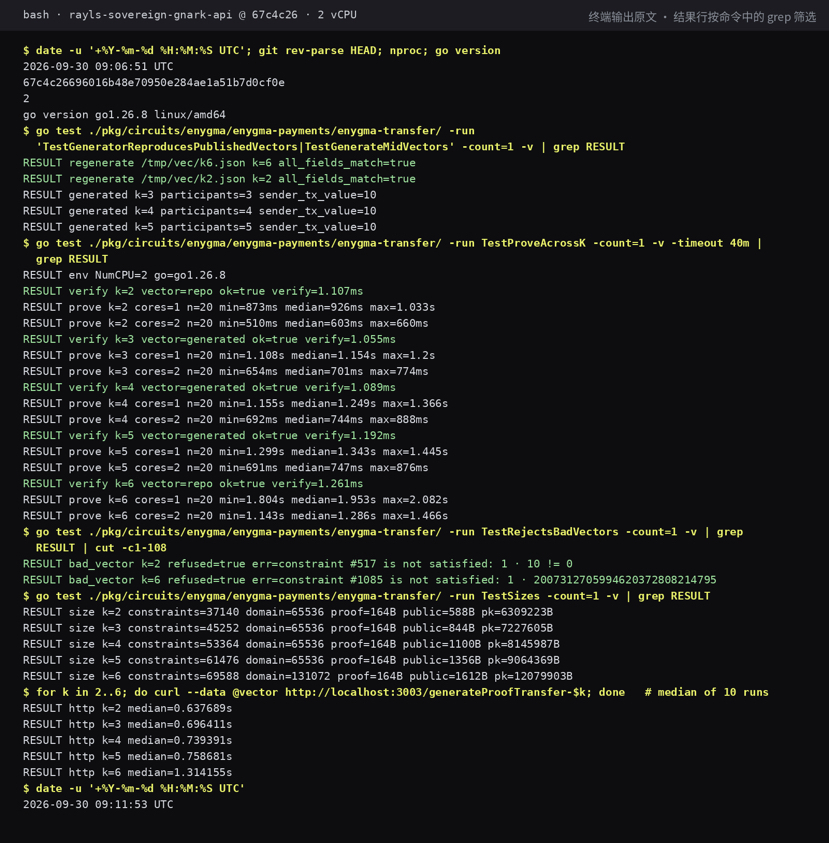
この2組のデータは、Raylsがそれぞれ独立に公開したもので、秘密鍵、ブロック番号、残高、送金額はいずれも異なりますが、同時に再現できます。これは、ジェネレータ実装が回路が要求する一連のルールそのものになっていることを示しています。その後、私は同じロジックを使って、6人段のシードから3・4・5段を生成し、各段についてまず証明を作り、その後対応する検証鍵で検証し、すべて合格したことを確認しました。
補足しておきたいことがあります。これら3つの段は、6人段の送金額と参加者を引き継いでいます。つまり、それらが測っているのは、異なる匿名集合サイズにおける同一取引のコストであって、3つの別々の業務ではありません。
第6人はなぜ高いのか
前回、6人段の計算規模が131,072であるのを見て、2〜5段はすべて65,536だったので、5段から6段へ切り替えるコストは、前の数段の間よりも大きいはずだと推測しました。当時は中間段のデータがなく、推測で止まっていました。
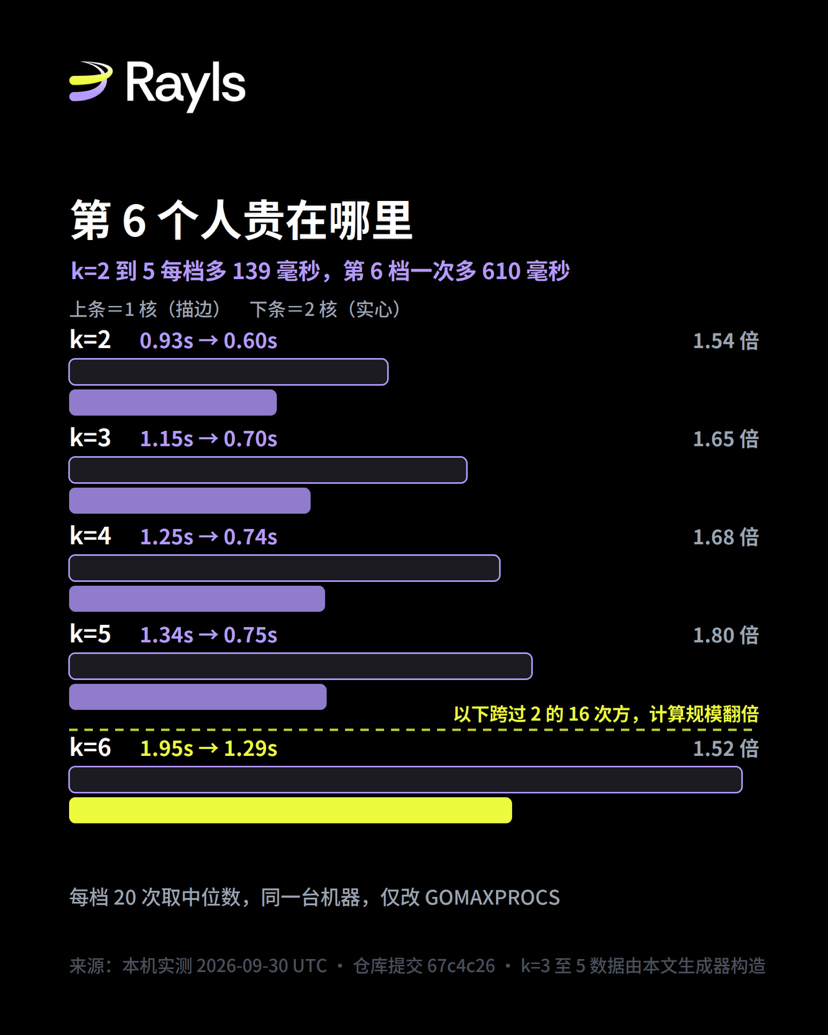
今回の単一核での中央値は:2人段0.93秒、3人段1.15秒、4人段1.25秒、5人段1.34秒、6人段1.95秒です。最初の4段の間では、各段あたり平均で139ミリ秒ずつ増えます。一方、5段から6段にかけては1回につき610ミリ秒増え、それは前半4つの4.4倍です。
証明鍵のサイズは同じ段差になります。2〜5段では各段ごとに安定して約918KBずつ増え、6段では1回で約3.0MB増えます。制約数自体は完全に均一で、参加者が1人増えるごとに固定で8,112本ずつ増え、37,140本から69,588本になります。このラインでは段差は見えません。
なので、段差は制約数ではなく、証明システムが回路に割り当てる計算スペースのほうにあります。これは2の冪で切り上げられ、6人段がちょうど65,536を超えるからです。所要時間と鍵サイズが同じ位置で跳ねるのは、この説明と一致しています。私はこれを「証明」ではなく「この説明と一致する」と書きました。今回測ったのは所要時間と体積だけで、証明プロセス内部の各段階のオーバーヘッドを個別に分解して計測したわけではありません。
ユーザにとっての意味はかなり直接的です。匿名集合サイズが設定可能なら、5と6の間は一様に小さな一歩ではありません。5で止めるか、1回きりの跳躍(ジャンプ)を受け入れるしかなく、中間の妥協点はありません。
マルチコアは1.64倍しか速くならない
前回私は1文書きました。機関のサーバは通常マルチコアなので、遅延はシングル核の結果より小さくなる、という内容です。根拠は、gnarkの証明コードがCPUの核数に応じて最も重い多倍長スカラー乗算を分割することです。この方向性は正しいのですが、当時そのマシンは1核しかなく、倍率がいくつになるかは言えませんでした。
今回のマシンは2つの核です。同じマシン上でGOMAXPROCSだけを変更し、それ以外はすべて同じにしました。5段の加速倍率はそれぞれ1.54、1.65、1.68、1.80、1.52倍で、平均は1.64倍、2倍には届きません。
なぜ2倍に届かないのか。コードから一部の理由が見えます:多倍長スカラー乗算自体は核数に応じてタスク分割されますが、証明プロセスには目撃(witness)解決や、いくつかの逐次手順があり、それらは核数を増やしても短縮されません。私は観測した結果がこれと整合していることまでは言えますが、段階ごとに分解して検証まではしていません。
この倍率はデプロイ選定に影響しますし、方向性も直感と逆です。6人段として計算すると、1台のシングル核マシンは1秒あたり0.51個の証明を出せ、2核マシンは1秒あたり0.78個です。同じスループットを得るのに、2核マシンのほうがより多くの核が必要ですが、1件あたりの待ち時間は3分の1だけ短くなります。スループット追求ならシングル核のワークステーションを積むほうが省コスト、単一リクエストの遅延追求なら証明ごとにより多くの核を割り当てます。両方を同時に最適にはできません。
前回は証明関数だけ測っていて、サービス全体の処理は通していませんでした。そのため当時は、JSON解析とネットワークオーバーヘッドを未測項目として挙げました。
今回はサービスを実際にコンパイルして動かし、curlで本物のHTTPリクエストを送りました。サービス自身が区間ごとの計時を出しており、出力は次の通りです:リクエストのバインド0.1ミリ秒、パラメータ解析0.1ミリ秒、証明生成1,300ミリ秒、シリアライズはほぼ0。curlで測ったエンドツーエンドの中央値は1.314秒で、サービス側内部の合計は1.300秒です。差は1〜14ミリ秒で、リクエスト全体の約1%ほどです。
結論はとても素朴です。この経路に関しては、証明生成時間はほぼエンドツーエンド遅延に等しい。HTTPの層は無視できる。前回は2つを分けて未測項目にしましたが、今回は統合できます。
さらに、前回でまったく触れていなかったことも測れました:コールドスタート。各段の最初のリクエストは2.5〜4.5秒かかり、その後ようやく安定します。サービスが、6〜12MBの証明鍵をディスクからメモリに読み込んでキャッシュする必要があるからです。必要に応じてスケールアウトするデプロイの場合、この時間はキャパシティ計画に織り込むべきで、定常状態だけを見てはいけません。
体積に関する補足ももう1つあります。証明そのものは固定で164バイトで、5段すべて同じです。証明と一緒に公開されるデータは線形に増え、2人段では588バイト、6人段では1,612バイトです。参加者が1人増えるごとにちょうど256バイト増えます。
ウィンドウ内の平均レートで計算すると、CHAPSは日次平均210,483件で、1秒あたり4.87件。シングル核ワークステーションなら約9.5個の核が必要です。Fedwireは日次平均869,187件で、1秒あたり10.97件。必要核数は約21.4個です。イングランド銀行が記録しているCHAPSの1日あたり件数の記録は2018年3月29日の320,034件で、同じウィンドウ換算では1秒あたり7.41件、約14.5個の核になります。
対比すれば、取り扱い定義(口径)がいかに重要かが分かります。CHAPSは24時間で平準化すれば必要な核は4.8個、実際の12時間ウィンドウなら9.5個で、ちょうど2倍違います。Fedwireはもともと窓がほぼ一日分に近いので、2つのアルゴリズムの差はわずか9%です。
まだ計算に入れていない項目がいくつかあります。読者のみなさんはご自身で追加できます:ウィンドウ内の日中のピークは平均より高い、各機関の負荷は均等に分割されていない、決済チェーンには証明以外の工程がある。そして証明は送信者が各自で生成するため、負荷は自然に分散し、1台のマシンに集中しません。
今回確認できたこと、まだないこと
確認できたのは以下です:5段の証明時間と検証時間、シングル核とデュアル核の加速比、計算規模の境界をまたぐ際のコスト、エンドツーエンドと証明生成の差、コールドスタート時間、証明と公開データの体積、ジェネレータが公式の2組のデータを再現できること、わざと誤りを入れたデータが拒否されること。これらは、スクリーンショット内のコマンドどおりに実行すれば再度回せます。
まだない点:送金回路だけを測定しました。預入・出金、DvPは別の種類で、さらに核数(2核)はサンプルがとても小さいので、より多い核のカーブがどんな形状かについてはデータがありません。1台のマシンでのみ測定しており、ハードウェア基盤を替えると結果が変わります。生成された3つの段(3レンジ)は同じ1つの取引に共通するパラメータを使っています。決済チェーン全体のうち、証明以外の部分は触っていません。前回指摘された文言の1か所も、ここで訂正しました:本機密鍵と公式ビルド生成物のサイズは一致しており、言えるのはコンパイルされた規模が同じということであって、回路ロジックが同じことまでは示せません。
私の見解
今回のいちばん有用な収穫は、特定の数値そのものではありません。3つの推測を3つの再現可能な結果に置き換えられたことです。そのうち1つは、自分の測定によって自分で修正されました。多核はより速い、というのは正しいのですが、速くなるのは1.64倍であって、思い込みの2倍ではありません。
読者が検証可能な判断基準を提示します。次に、どんなプライバシー方式の性能数字を見たときも、まず次の3点を聞いてください。匿名集合(または参加者規模)はどれくらいか、何核で動かしたのか、その数字は証明そのものの性能か、それともエンドツーエンドか。3つすべて答えられる数字だけを、キャパシティ計画に使ってください。これら3項目は、この文章が自分で回答している3項目とも一致しており、コマンドはスクリーンショット内にあります。
参照元:GitHub raylsnetwork/rayls-sovereign-gnark-api、コミット67c4c26(2026年9月30日に読み込み、実測);Rayls公式ブログ(Privacy has a price: the honest math behind confidential settlement at scale)(2026年9月19日);米連邦準備制度理事会 Fedwire Funds Service 年次統計(2026年1月26日更新);イングランド銀行 Payment and settlement statistics、(A brief introduction to RTGS and CHAPS)と2026年5月の決済時間延長に関する協議文書。