
AIはすでに、質問に答える段階を超えています。
より大きな変化は、AIシステムが行動を起こせるようになったときに起こります。
エージェントは、ブラウズし、調査し、ファイルを扱い、外部ツールを使い、さまざまなチャネルを通じて通信し、各個別の手順を逐一指示されなくてもタスクを継続できます。
それは別のインフラ上の問題を生み出します。
ソフトウェアがあなたの代わりに行動できるようになると、能力だけでは不十分です。エージェントに何を許可するのか、その判断と実際の行動の間に何があるのか、そして何か問題が起きたときにどうなるのかも把握する必要があります。
それが、@NEAR Protocol のエコシステム内で開発された IronClaw 1.0 が、別のアーキテクチャ方針を取る場所です。
エージェントは外の世界へ直接つながるべきではない
多くの人は、AI エージェントを「ツールの集合に接続されたモデル」として考えます。
IronClaw は、その接続を境界を必要とするものとして扱います。
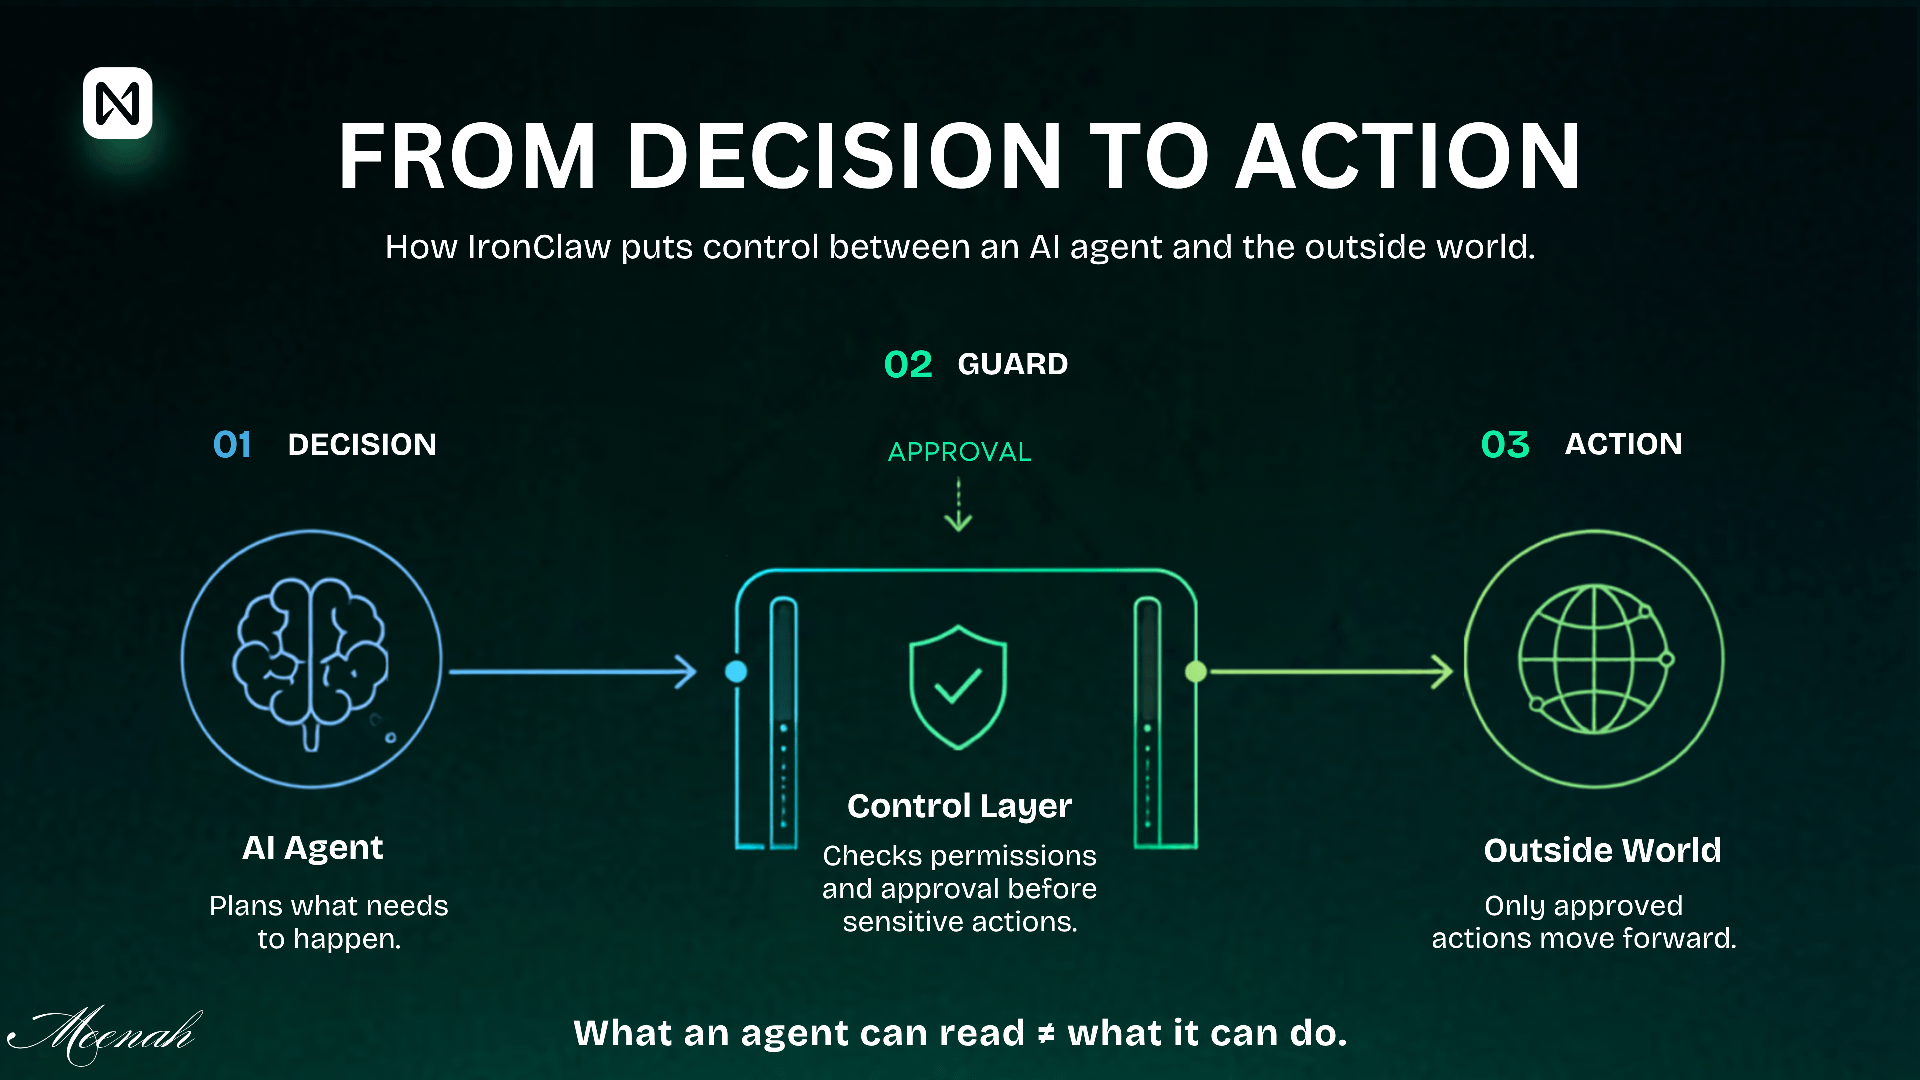
そのアーキテクチャは、決定する部分と実行する部分を分離し、「ガード(Guard)」と呼ばれる協調レイヤーによって分けています。
考える → ガード → 行動する
エージェントは、目標を達成するために必要な手順を判断できます。しかし、それらの決定が外部へのアクションになる前に、ガード(Guard)を通過します。
機密性の高いアクションには明示的な承認が必要になる場合があります。一方でシークレットは、デフォルトで単回使用となるよう設計されています。
これは重要です。なぜなら、エージェントはユーザーから供給された情報だけで動作するわけではないからです。
Webページ、メール、ドキュメント、またはツールの応答には、指示のように見える内容が含まれていることがあります。システムがその内容に、実際のユーザー指示と同じ権限を与えてしまうと、情報と許可の境界線が消え始めます。
NEAR AI は、この課題を「フィールド・コンテンツへの信頼(field-content trust)」として説明しています。
アーキテクチャ上の原則はシンプルです:
エージェントは、何かを読み取ったとしても、それを自動的に従うことを許可されるべきではありません。
それは、エージェントのセキュリティ設計のされ方における意味のある違いです。
能力と並行して、セキュリティも機能しなければならない
強く制限されたエージェントは、実際の仕事を完了できなければ役に立ちません。
IronClaw の報告された結果は、方程式の反対側を示しています。
同じ deepseek-v4-flash のベースモデルを使って、IronClaw は次を記録しました:
93.5% — PinchBench
88.6% — ClawBench
76.4% — OfficeQA
テストは意図的に異なります。
PinchBench は、スケジューリング、メールのトリアージ、コーディング、リサーチ、ファイル管理などを含む 147 の実タスクをカバーします。
ClawBench は、実運用の Web サイトをまたいだマルチステップ作業を評価します。
OfficeQA は、何百万もの数値を含む歴史的な米国財務省資料など、大規模なドキュメント集合にまたがる推論に焦点を当てています。
数字は重要ですが、より大きな教訓はその組み合わせです。
エージェントは、定義された境界の範囲内で動作しながら、適切にツールを使い、複雑なワークフローを扱い、そしてうまく推論する必要があります。
企業にとっては、それによって能力(capability)と制御(control)は同じ問題の両面になります。
実作業にもメモリが必要
ビジネス・プロセスは、たいてい中断されない 1 回のセッションで完了するわけではありません。
タスクの途中で承認が必要になる場合があります。システムが再起動されることもあります。ユーザーがあるインターフェースから別のインターフェースに切り替えることもあります。
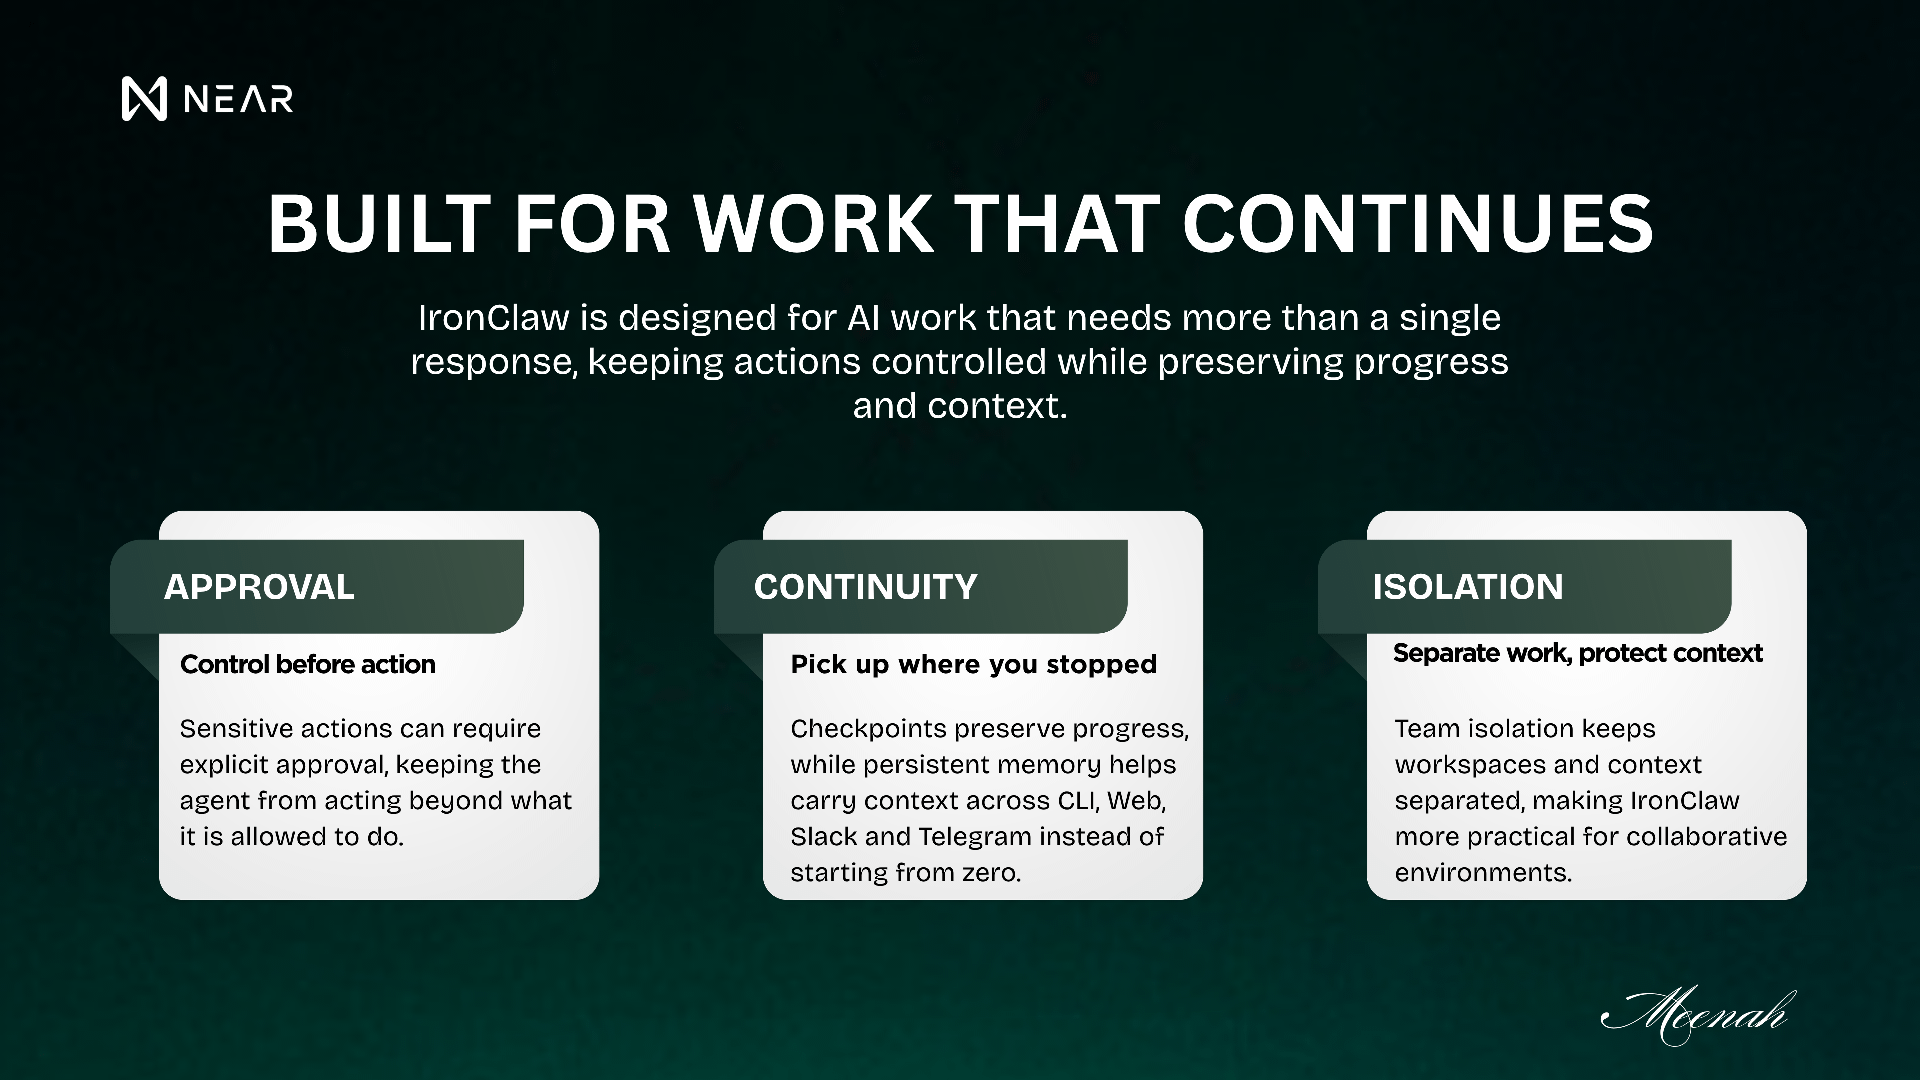
IronClaw は、継続的なチェックポイントと永続的な状態を使うため、中断があっても、すでに完了した作業を失うとは限りません。
そのメモリと安全ルールは、CLI、Web、Slack、Telegram にもまたがって適用されます。
それは AI エージェントの役割を変えます。
もはや単にプロンプトに答えて消えるものではありません。継続中のワークフローの一部になり得ます。
組織にとっては、継続性が重要です。作業を再起動すると、重複した労力、整合しない結果、不要な人的介入が生まれ得るからです。
IronClaw は、マルチテナントのデプロイと、完全に分離されたシングルテナントのオプションによってチーム環境もサポートします。これにより組織は、分離やアクセスを管理するさまざまな方法を選べます。
エージェントは、信頼モデルの全てではない
エージェントの下には、もう一つの問いがあります。
計算はどこで行われているのか?
ここに #NEARAI が登場します。
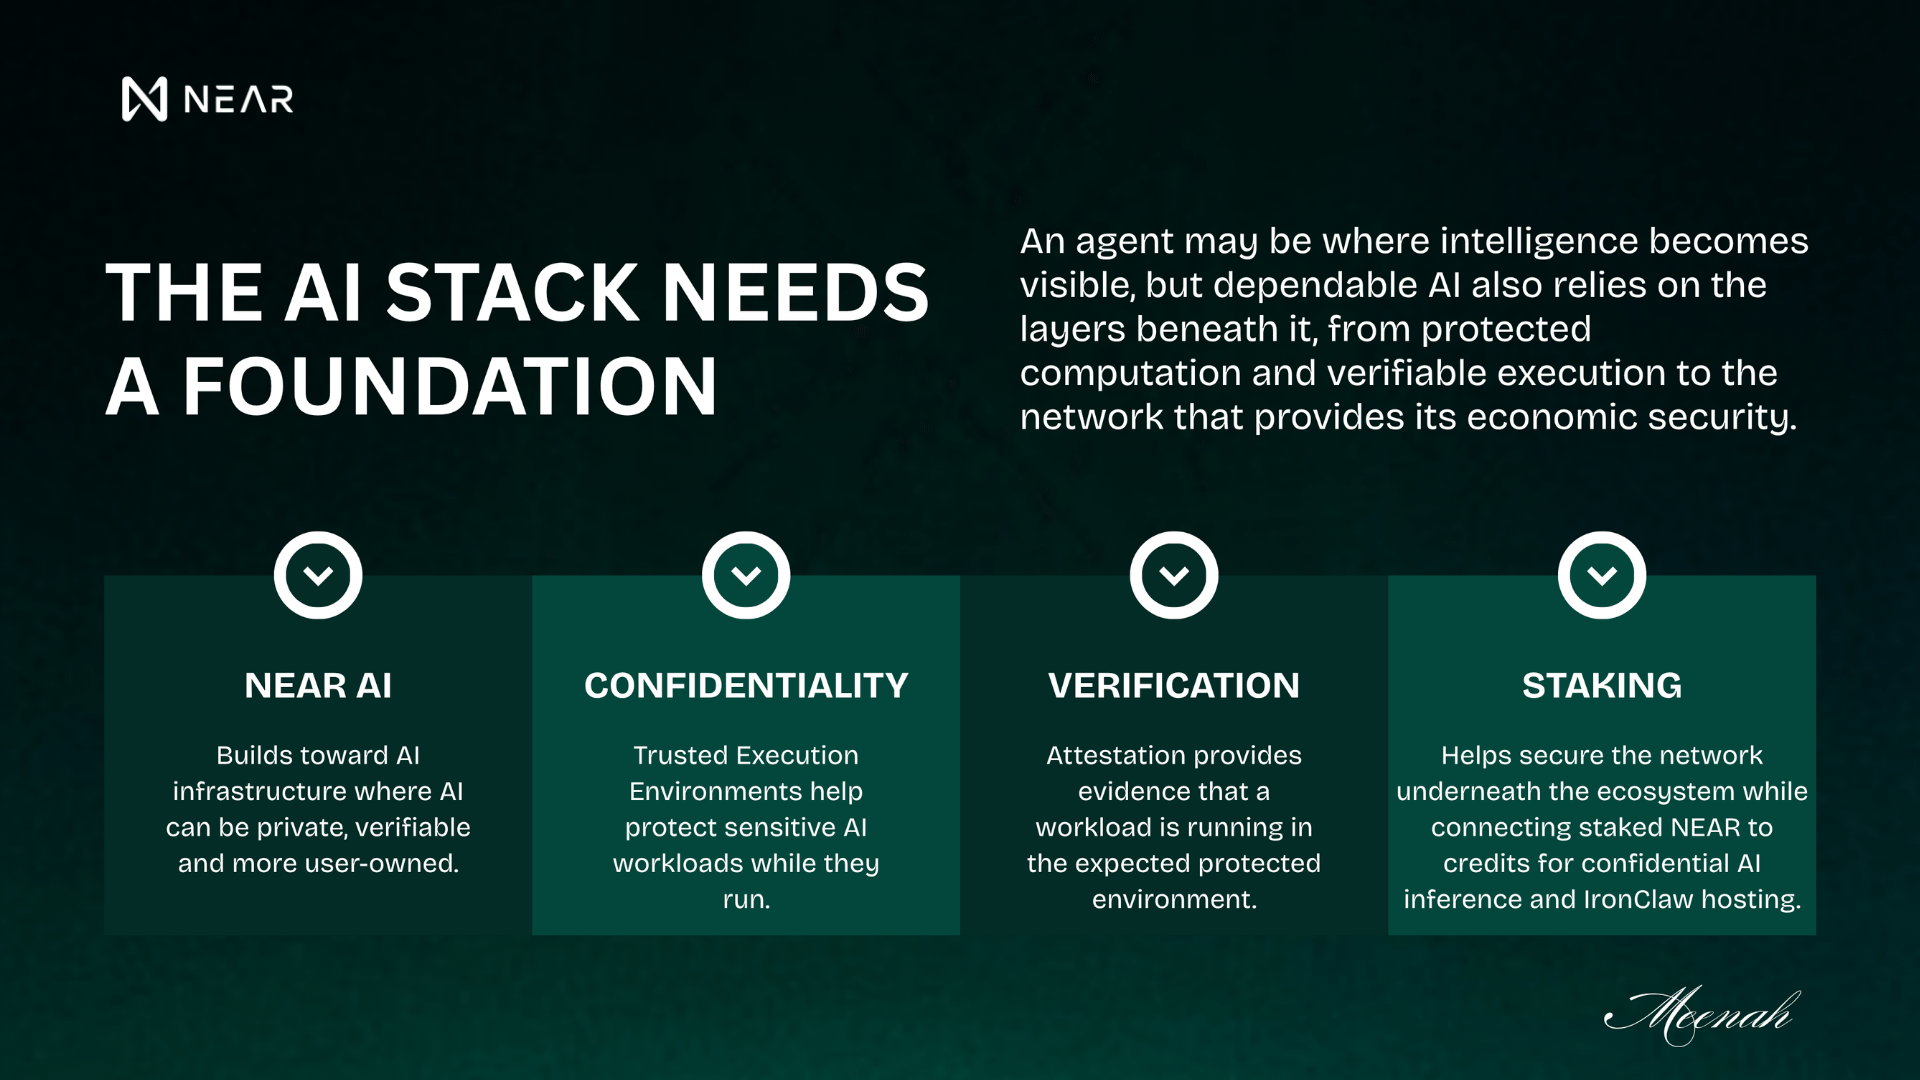
NEAR AI は、負荷(ワークロード)がハードウェアで強制された Trusted Execution Environments(TEE)内で実行できる、機密性のある AI インフラを構築しています。
Intel Trust Authority との統合により独立したアテステーションが追加されるため、ユーザーは単にインフラ運用者を信頼するのではなく、保護された実行環境を検証する手段を持てます。
それにより、層化されたアプローチが生まれます:
ガード(Guard)はアクションを制御します。
機密(コンフィデンシャル)コンピューティングは実行を保護します。
アテステーションは環境の検証を助けます。
そしてそれらの層の下にはネットワークがあります。
なぜステーキングが AI スタックに重要なのか
NEAR は Proof-of-Stake を採用しており、委任されたステークがネットワークを保護する責任を負うバリデーターを支えます。
それにより、ステーキングはリターンをめぐる会話の外にも役割を持ちます。アプリケーションやサービスの下にある基盤の経済的セキュリティに貢献します。
NEAR AI のステーキングモデルは、ネットワークと AI インフラの間に別の接続を追加します。
ユーザーは NEAR をステークして、機密推論や IronClaw ホスティングなどのサービスに対するクレジットを受け取れます。ステーク額は、利用可能なサービス予算とエージェントの処理能力に影響します。
つまり関係は、単に次のようなものではありません:
stake → return
次のようにも理解できます。
stake → ネットワークセキュリティ + AI インフラへのアクセス
それは、ステーキングだけで AI エージェントが信頼できるようになるという意味ではありません。意味するのは、ネットワークを支える経済レイヤーが、AI サービスにアクセスできるインフラと結びついているということです。
この接続は、より広い NEAR AI モデルの重要な一部です。
より大きなシフトは「制御されたエージェンシー(agency)」にある
#IronClaw で重要なのは、AI エージェントが単にできることが増えることだけではありません。
問題は、エージェントが実行する際にどれだけの権限を持つべきかについて、より多くの検討がなされている点です。
アーキテクチャは、意思決定をアクションから分離します。
チェックポイント(Checkpointing)が継続性を守ります。
永続メモリがコンテキストを生き続けます。
機密コンピューティングは機密性の高いワークロードを保護します。
アテステーションは、環境を検証する方法を提供します。
ステーキングは、基盤となるネットワークに経済的なセキュリティをもたらし、ユーザーを AI インフラへと接続します。
これらの層のどれも、単独では信頼の問題を解決しません。
しかし、これらは一緒に見れば、エージェント型 AI のための別のモデルを指し示しています。
AI の未来は、エージェントに無制限の自由を与えることで定義されるとは限りません。
境界の中で、強制および検証可能な有用な権限を与えることで定義できるかもしれません。
いったん AI があなたの代わりに行動できるようになると、最も重要な問いはもはや次ではなくなります:
「エージェントはどれほど賢いのか?」
それは次のことです:
「どれくらい信頼して、それを任せればいいのか?」
そしてそれは、突き詰めるとアーキテクチャの問題です。