
Di paragraf sebelumnya, saya sudah menjalankan kode bukti yang dipublikasikan Rayls, dan mengukur bahwa tier anonimitas 6 orang membutuhkan 1,96 detik per bukti. Namun di artikel itu ada tiga kalimat yang bersifat inferensi, bukan pengukuran; saya tahu itu. Minggu ini saya ganti mesinnya menjadi 2 core, menambahkan beberapa tier data, dan dengan itu saya kembali untuk melengkapi tiga kalimat tersebut.
Pertama jelaskan hubungan artikel ini dengan paragraf sebelumnya, agar pembaca tidak mengira ini kiriman ulang yang sama. Paragraf sebelumnya mengukur waktu pembuatan bukti untuk tier 2 orang dan tier 6 orang di lingkungan single-core; dua angka itu kali ini diukur ulang dan hampir tidak berubah. Konten baru artikel ini adalah tiga hal yang di paragraf sebelumnya tidak bisa diukur dan hanya bisa disimpulkan.
Tiga hal tersebut adalah: apakah multi-core lebih cepat, mengapa partisipan ke-6 khususnya mahal, dan seberapa besar porsi pembuktian dalam latensi end-to-end. Di bawah ini, yang saya tulis dengan frasa “paragraf sebelumnya menginferensikan” adalah pernyataan saya saat itu; yang saya tulis dengan frasa “kali ini terukur” adalah hasil kali ini.
Pertama jelaskan sumber data pengujian
Repositori layanan pembuktian Rayls sudah menyertakan data uji, tetapi hanya ada dua set: tier 2 orang dan tier 6 orang. Tier 3, 4, dan 5 tidak ada—itulah sebabnya paragraf sebelumnya tidak bisa mengukur nilai di tengah. Tidak boleh sekadar membuat satu set asal-asalan. Rangkaian akan menolak saat itu juga; kalaupun benar bisa dibuat agar lolos, pembaca tidak punya alasan untuk percaya.
Jadi saya menulis sebuah generator. Kondisi batas rangkaiannya dituliskan di common-checks.go di repositori; setiap poin bisa dibalik untuk mendapatkan aturannya: kunci rahasia bersama pengirim adalah hash Poseidon dari bilangan acak putaran sebelumnya dan kunci privat, lalu dimodulo orde subgrup BabyJubJub; kunci publik adalah hasil self-hash kunci privat lalu dimodulo orde. Faktor acak: penerima mengambil nilai negatif dari hash masing-masing, pengirim mengambil penjumlahan dari nilai untuk penerima; komitmen transaksi adalah komitmen Pedersen dari jumlah dan faktor acak. Generator ini mengimplementasikan aturan-aturan tersebut menggunakan fungsi native milik repositori.
Intinya adalah bagaimana membuktikan bahwa generator ini tidak salah tulis. Cara saya: pertama gunakan generator itu untuk mereplikasi dua set data resmi. Ambil semua field yang terkekang di data resmi, kosongkan semuanya, hanya biarkan seed dan input publik dari partisipan lainnya, lalu jalankan generator untuk menghitung ulang, kemudian bandingkan per field. Hasilnya: semua field pada tier 6 orang dan tier 2 orang benar-benar sama.
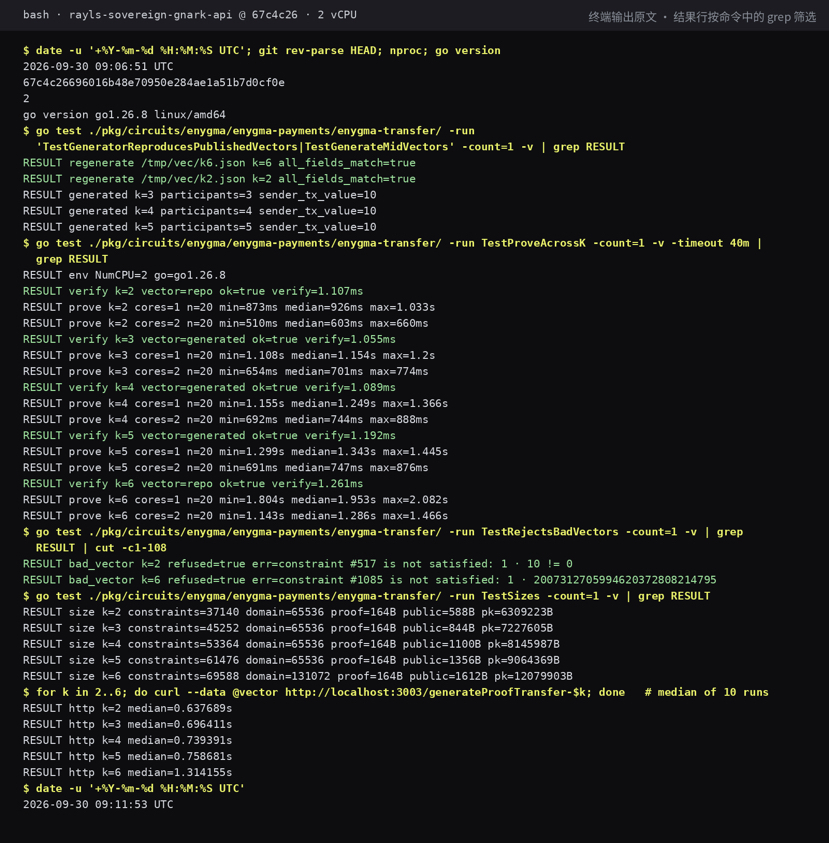
Dua set data ini dipublikasikan Rayls secara independen masing-masing: kunci privat, nomor blok, saldo, dan jumlah transfer semuanya berbeda, tetapi semuanya bisa direproduksi. Ini menunjukkan bahwa implementasi generator memang tepat sesuai aturan yang diminta oleh rangkaian. Setelah itu barulah saya memakai logika yang sama: menggunakan seed tier 6 orang untuk menghasilkan tier 3, 4, dan 5; untuk setiap tier, saya hasilkan pembuktian dulu, lalu memverifikasi dengan kunci verifikasi yang sesuai, dan semuanya lolos.
Ada satu hal yang perlu dijelaskan: tiga tier ini menggunakan jumlah transfer dan pihak yang terlibat yang sama seperti tier 6 orang, sehingga yang diukur adalah biaya untuk transaksi yang sama pada ukuran himpunan anonim yang berbeda, bukan tiga transaksi bisnis yang berbeda.
Tier 6 orang, yang membuatnya paling mahal itu di bagian mana
Di paragraf sebelumnya, saya melihat skala perhitungan tier 6 orang adalah 131.072, sedangkan tier 2 sampai 5 adalah 65.536. Maka saya menyimpulkan bahwa biaya saat berpindah dari tier 5 ke tier 6 akan lebih besar daripada perpindahan antar tier sebelumnya. Saat itu belum ada data tier tengah, jadi hanya bisa berhenti pada kesimpulan.
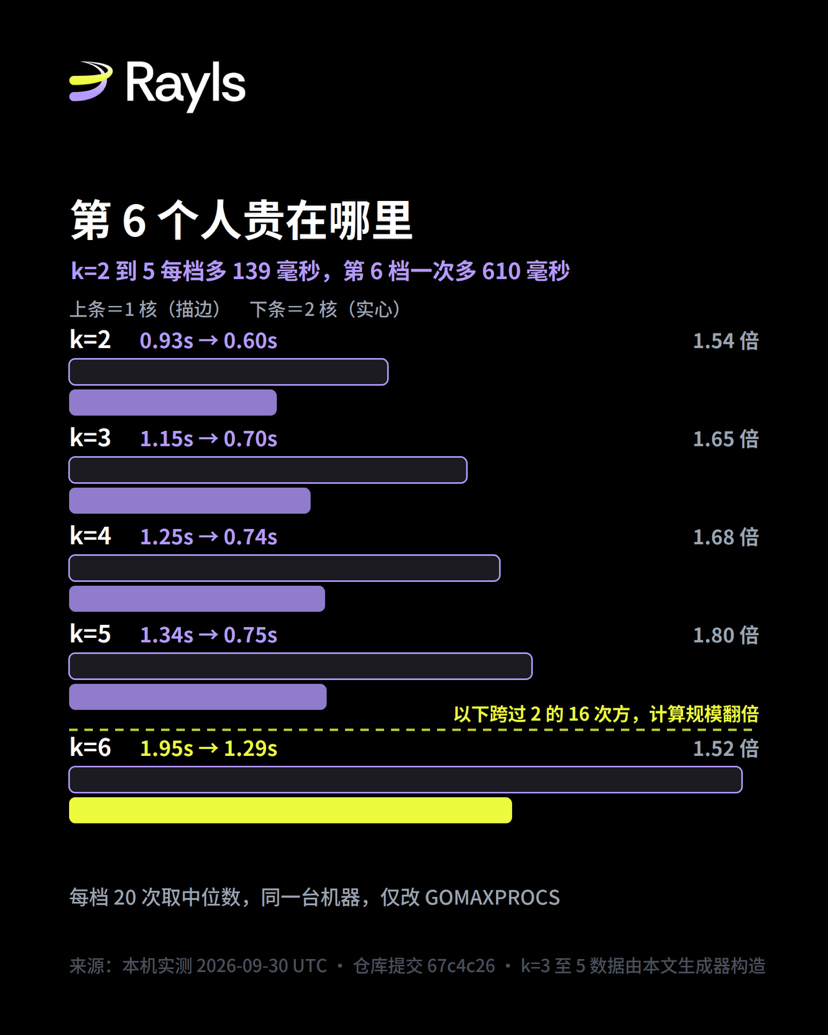
Median single-core kali ini adalah: tier 2 orang 0,93 detik, tier 3 orang 1,15 detik, tier 4 orang 1,25 detik, tier 5 orang 1,34 detik, tier 6 orang 1,95 detik. Rata-rata, tiap tier di antara empat tier pertama bertambah 139 ms; tetapi dari tier 5 ke tier 6 naik 610 ms sekali—4,4 kali lipat dari yang sebelumnya.
Ukuran kunci pembuktian berada pada tangga yang sama: pada tier 2 sampai 5, setiap tier naik stabil sekitar 918 KB; pada tier 6, naik sekitar 3,0 MB sekaligus. Jumlah constraint sendiri benar-benar seragam: setiap tambah satu partisipan selalu menambah 8.112 constraint, dari 37.140 menjadi 69.588; dari sisi jalur ini tidak terlihat adanya “tangga”.
Jadi tangga itu bukan pada jumlah constraint, melainkan pada ruang komputasi yang diberikan sistem pembuktian ke rangkaian: ia melakukan pembulatan ke kelipatan pangkat 2; tier 6 orang tepat melewati 65.536. Waktu dan ukuran kunci melompat di posisi yang sama, sesuai dengan penjelasan ini. Saya menuliskannya sebagai “konsisten dengan penjelasan” bukan menuliskannya sebagai “bukti”. Kali ini yang saya ukur hanya waktu dan volume; saya tidak memecah biaya tiap tahap di dalam proses pembuktian secara terpisah.
Maknanya bagi pengguna sangat langsung: jika ukuran himpunan anonim bisa dikonfigurasi, jarak antara 5 dan 6 bukanlah langkah kecil yang seragam. Entah berhenti di 5, atau menerima loncatan sekali jadi; tidak ada titik kompromi di tengah.
Multi-core hanya lebih cepat 1,64 kali
Di paragraf sebelumnya, saya pernah menulis: server institusi biasanya multi-core, sehingga waktu lebih rendah daripada hasil single-core. Alasannya adalah kode pembuktian gnark membagi tugas multi-skalar tersibuk berdasarkan jumlah core. Arah kalimat ini benar, tetapi saat itu mesinnya hanya punya 1 core, jadi saya tidak bisa menyebut berapa kelipatannya.
Mesin kali ini memiliki 2 core; di mesin yang sama hanya mengubah GOMAXPROCS, sisanya semuanya tidak berubah. Perbandingan percepatan untuk lima tier masing-masing adalah 1,54; 1,65; 1,68; 1,80; 1,52 kali, rata-rata 1,64 kali, tidak sampai 2 kali.
Mengapa tidak sampai 2 kali—di kode bisa terlihat sebagian penyebabnya: multi-skalar multiplication memang membagi tugas berdasarkan jumlah core, tetapi proses pembuktian masih punya tahap-tahap seperti penyelesaian witness dan beberapa langkah serial yang tidak dipersingkat oleh penambahan core. Saya hanya bisa mengatakan hasil observasi konsisten dengan ini, tanpa memverifikasi dengan pemecahan per tahap.
Kelipatan ini berpengaruh pada pilihan skema deployment, dan arahnya juga berlawanan dengan intuisi. Mengacu tier 6 orang: pada satu mesin single-core bisa menghasilkan 0,51 bukti per detik, sedangkan pada mesin dual-core 0,78 bukti per detik. Untuk throughput yang sama, justru mesin dual-core membutuhkan lebih banyak core, tetapi waktu tunggu per bukti berkurang sepertiga. Jika mengejar throughput, menumpuk mesin single-core lebih hemat; jika mengejar latensi per bukti, tambahkan core untuk setiap bukti; keduanya tidak bisa optimal sekaligus.
Di paragraf sebelumnya saya hanya menguji fungsi pembuktian, tidak menjalankan layanan lengkap, jadi saat itu saya mencatat parsing JSON dan overhead jaringan sebagai item yang belum diuji.
Kali ini saya benar-benar mengompilasi layanan, menjalankannya, dan mengirim permintaan HTTP nyata dengan curl. Layanan melakukan pencatatan waktu per segmen sendiri, dan output-nya: request binding 0,1 ms, parsing parameter 0,1 ms, pembuatan bukti 1.300 ms, serialisasi mendekati 0. Median end-to-end yang diukur curl adalah 1,314 detik; total internal server adalah 1,300 detik; selisihnya berada di kisaran 1 sampai 14 ms, sekitar satu persen dari keseluruhan permintaan.
Kesimpulannya sesederhana ini: untuk jalur ini, waktu pembuatan pembuktian pada dasarnya sama dengan latensi end-to-end; lapisan HTTP bisa diabaikan. Paragraf sebelumnya memisahkan keduanya sebagai item yang akan diuji, sekarang bisa digabungkan.
Selain itu saya mengukur satu hal yang sama sekali tidak disebutkan di paragraf sebelumnya: cold start. Permintaan pertama di setiap tier memakan 2,5 sampai 4,5 detik, baru kemudian stabil, karena layanan harus membaca kunci pembuktian 6 sampai 12 MB dari disk ke memori dan meng-cache. Untuk deployment yang memakai scaling berdasarkan kebutuhan, waktu ini harus masuk ke perencanaan kapasitas, bukan hanya melihat kondisi steady-state.
Tambahan soal ukuran: ukuran pembuktian itu sendiri tetap 164 byte, dan sama untuk semua lima tier; data yang dipublikasikan bersama pembuktian bertumbuh secara linear, dari 588 byte pada tier 2 orang sampai 1.612 byte pada tier 6 orang; setiap tambah satu partisipan menambah tepat 256 byte.
Hitung berdasarkan laju rata-rata dalam jendela: CHAPS mencatat rata-rata 210.483 transaksi per hari, setara 4,87 transaksi per detik; untuk itu butuh sekitar 9,5 core jika memakai single-core work machine. Fedwire rata-rata 869.187 transaksi per hari, yaitu 10,97 transaksi per detik, butuh sekitar 21,4 core. Rekor jumlah transaksi harian CHAPS yang dicatat Bank of England adalah 320.034 pada 29 Maret 2018; jika dilipatkan ke jendela yang sama menjadi 7,41 transaksi per detik, sekitar 14,5 core.
Bandingkan saja untuk tahu seberapa penting istilah yang dipakai: CHAPS merata-ratakan per 24 jam hanya butuh 4,8 core; tetapi jika memakai jendela 12 jam yang sebenarnya butuh 9,5 core—tepat dua kali lipat. Fedwire karena jendelanya memang mendekati sepanjang hari, selisih antara dua algoritma hanya 9%.
Beberapa hal yang belum dihitung: pembaca bisa menambah sendiri—puncak intraday dalam jendela lebih tinggi daripada rata-rata jendela, beban tiap institusi tidak dibagi rata, masih ada tahapan lain di rantai penyelesaian selain pembuktian, dan pembuktian dibuat sendiri-sendiri oleh pihak pengirim, sehingga beban secara alami terdistribusi dan tidak terkonsentrasi pada satu mesin.
Kali ini dikonfirmasi apa saja, dan yang belum ada
Yang dikonfirmasi adalah: waktu pembuktian tier 5, waktu verifikasi tier 5, rasio percepatan single-core vs dual-core, biaya saat melintasi batas skala perhitungan, selisih antara end-to-end dan pembuatan bukti, waktu cold start, ukuran pembuktian dan data publik, bahwa generator bisa mereproduksi dua set data resmi, dan bahwa data yang sengaja diubah pasti ditolak. Semua bisa diulang dengan perintah yang sama seperti di screenshot.
Belum ada: saya baru menguji rangkaian transfer; penyimpanan, penarikan, dan DvP adalah jenis lain; sampel untuk 2 core masih sangat kecil, saya tidak punya data bentuk kurva untuk jumlah core yang lebih banyak; saya menguji hanya pada satu mesin, mengganti platform perangkat keras akan mengubah hasil; parameter untuk tiga tier yang dihasilkan memakai transaksi yang sama; dalam seluruh rantai penyelesaian, bagian selain pembuktian tidak saya sentuh. Di paragraf sebelumnya, ada satu bagian yang dikoreksi redaksinya, dan saya perbaiki juga di sini: ukuran kunci rahasia lokal dan hasil build resmi sama; yang dapat dijelaskan adalah skala yang dikompilasi juga sama, bukan berarti logika rangkaiannya juga sama.
Menurut saya
Hasil paling bermanfaat kali ini bukan angka spesifik apa pun, melainkan mengubah tiga kalimat kesimpulan menjadi tiga hasil yang bisa direproduksi, dan salah satunya juga dikoreksi oleh pengukuran saya sendiri: benar bahwa multi-core lebih cepat, tetapi hanya 1,64 kali, bukan 2 kali seperti perkiraan.
Berikan pembaca standar penilaian yang bisa diverifikasi: lain kali melihat angka performa dari skema privasi apa pun, tanya dulu tiga hal: ukuran himpunan anonim atau ukuran partisipan berapa, berjalan di berapa core, dan angka itu adalah waktu pembuktian itu sendiri atau end-to-end. Hanya angka yang bisa menjawab ketiga hal itu yang bisa dipakai untuk perencanaan kapasitas. Tiga poin ini juga sekaligus dijawab oleh artikel ini sendiri, dan perintahnya ada di screenshot.
Sumber referensi: GitHub raylsnetwork/rayls-sovereign-gnark-api, commit 67c4c26 (dibaca dan diuji langsung pada 30 Sep 2026); Blog resmi Rayls (Privacy has a price: the honest math behind confidential settlement at scale) (19 Sep 2026); statistik tahunan Fedwire Funds Service dari Federal Reserve (update 26 Jan 2026); statistik pembayaran dan penyelesaian dari Bank of England, (A brief introduction to RTGS and CHAPS) serta dokumen konsultasi perpanjangan waktu penyelesaian pada Mei 2026.