

#inference
inference
1,600 penayangan
32 Berdiskusi
Populer
Terbaru

⚡ MODAL INSTITUSIONAL MENGONSOLIDASIKAN INFRASTRUKTUR AI SEIRING PERGESERAN KECEPATAN INFERENSI KE ARAH $TAO 🔍
Akuisisi Moondream oleh Prime Intellect menandakan pergeseran institusional menuju inferensi berkeefisiensian tinggi dan eksekusi multimodal. 🦈 Dengan mengamankan mesin Photon—yang mampu menghasilkan lebih dari 60 inferensi per detik pada satu unit perangkat keras—para investor cerdas secara aktif memangkas latensi di seluruh alur kerja agen yang kompleks. 📊
Langkah ini menandai transisi struktural dari model berukuran besar yang mengandalkan kekuatan komputasi mentah menuju kapasitas operasional yang ramping dan efisien. 💡 Seiring percepatan inferensi menjadi lapisan likuiditas utama yang mendukung penerapan AI di dunia nyata, modal sudah mengambil posisi lebih awal. 🌊
🤔 Akankah kecepatan inferensi yang dioptimalkan memicu terobosan berkelanjutan berikutnya bagi protokol AI, atau apakah keterbatasan perangkat keras fisik masih dinilai terlalu rendah? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
⚡ MODAL INSTITUSIONAL MENGONSOLIDASIKAN INFRASTRUKTUR AI SEIRING PERGESERAN KECEPATAN INFERENSI KE ARAH $TAO 🔍
Akuisisi Moondream oleh Prime Intellect menandakan pergeseran institusional menuju inferensi berkeefisiensian tinggi dan eksekusi multimodal. 🦈 Dengan mengamankan mesin Photon—yang mampu menghasilkan lebih dari 60 inferensi per detik pada satu unit perangkat keras—para investor cerdas secara aktif memangkas latensi di seluruh alur kerja agen yang kompleks. 📊
Langkah ini menandai transisi struktural dari model berukuran besar yang mengandalkan kekuatan komputasi mentah menuju kapasitas operasional yang ramping dan efisien. 💡 Seiring percepatan inferensi menjadi lapisan likuiditas utama yang mendukung penerapan AI di dunia nyata, modal sudah mengambil posisi lebih awal. 🌊
🤔 Akankah kecepatan inferensi yang dioptimalkan memicu terobosan berkelanjutan berikutnya bagi protokol AI, atau apakah keterbatasan perangkat keras fisik masih dinilai terlalu rendah? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
Akuisisi Moondream oleh Prime Intellect menandakan pergeseran institusional menuju inferensi berkeefisiensian tinggi dan eksekusi multimodal. 🦈 Dengan mengamankan mesin Photon—yang mampu menghasilkan lebih dari 60 inferensi per detik pada satu unit perangkat keras—para investor cerdas secara aktif memangkas latensi di seluruh alur kerja agen yang kompleks. 📊
Langkah ini menandai transisi struktural dari model berukuran besar yang mengandalkan kekuatan komputasi mentah menuju kapasitas operasional yang ramping dan efisien. 💡 Seiring percepatan inferensi menjadi lapisan likuiditas utama yang mendukung penerapan AI di dunia nyata, modal sudah mengambil posisi lebih awal. 🌊
🤔 Akankah kecepatan inferensi yang dioptimalkan memicu terobosan berkelanjutan berikutnya bagi protokol AI, atau apakah keterbatasan perangkat keras fisik masih dinilai terlalu rendah? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #TAO #ArtificialIntelligence #Inference #CryptoNarratives
🎯 🦈
1

·
--
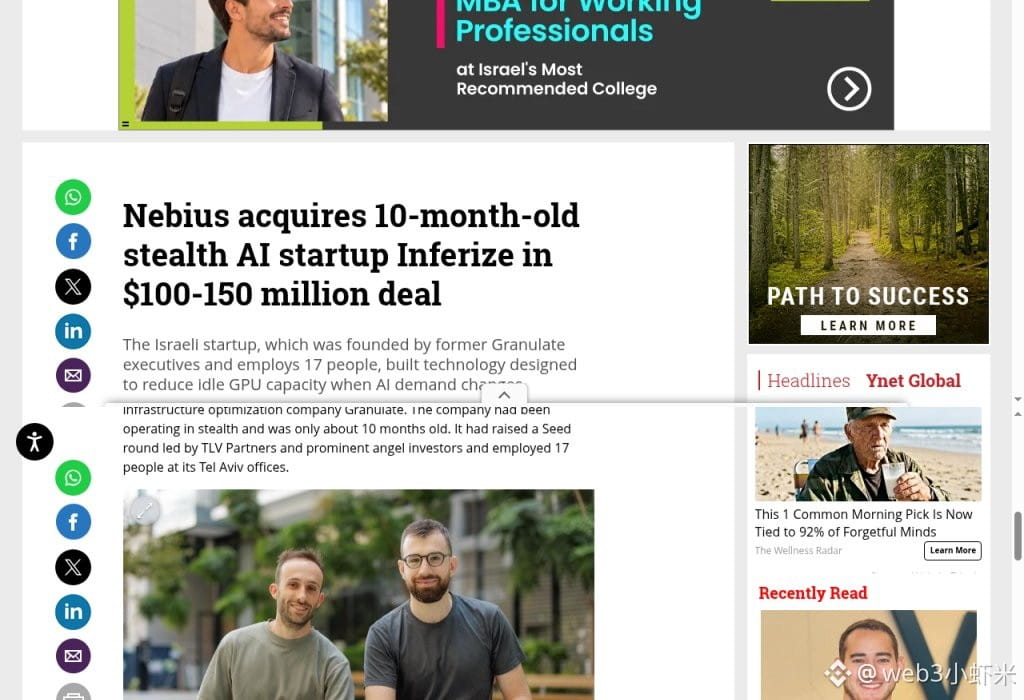
Menemukan berita CTech/Nebius: Nebius ($NBIS), perusahaan cloud AI yang tercatat di Nasdaq, mengakuisisi Inferize, startup Israel yang mengoptimalkan inferensi dan baru berdiri sekitar 10 bulan. Ketentuan transaksi tidak diungkapkan secara resmi; CTech memperkirakan nilainya sekitar US$100–150 juta.
Fokusnya sangat spesifik—menghapus “pajak GPU menganggur” saat model baru mulai dijalankan. GPU sering tidak terpakai saat bobot model dimuat, kapasitas ditingkatkan, atau bobot diganti di tengah proses reinforcement learning. Inferize ingin menyesuaikan kapasitas komputasi dengan kebutuhan nyata, sehingga utilisasi kapasitas Token Factory meningkat dan biaya per token turun. Timnya beranggotakan sekitar 17 orang; pendirinya pernah memimpin Granulate, yang diakuisisi Intel. Nebius mengatakan bahwa tim dan teknologinya akan diintegrasikan ke platform inferensi. Sebelumnya, kemampuan terkait Eigen AI dan Clarifai juga telah ditambahkan.
AI beralih dari gelombang pelatihan ke tahap penerapan, dan penyedia cloud mulai melengkapi lapisan perangkat lunak satu per satu. Akuisisi infrastruktur yang kecil tetapi substansial seperti ini lebih menarik daripada sekadar menjual cerita.
$NBIS #AI #Inference #Nebius
Menemukan berita CTech/Nebius: Nebius ($NBIS ), perusahaan cloud AI yang tercatat di Nasdaq, mengakuisisi Inferize, startup Israel yang mengoptimalkan inferensi dan baru berdiri sekitar 10 bulan. Ketentuan transaksi tidak diungkapkan secara resmi; CTech memperkirakan nilainya sekitar US$100–150 juta.
Fokusnya sangat spesifik—menghapus “pajak GPU menganggur” saat model baru mulai dijalankan. GPU sering tidak terpakai saat bobot model dimuat, kapasitas ditingkatkan, atau bobot diganti di tengah proses reinforcement learning. Inferize ingin menyesuaikan kapasitas komputasi dengan kebutuhan nyata, sehingga utilisasi kapasitas Token Factory meningkat dan biaya per token turun. Timnya beranggotakan sekitar 17 orang; pendirinya pernah memimpin Granulate, yang diakuisisi Intel. Nebius mengatakan bahwa tim dan teknologinya akan diintegrasikan ke platform inferensi. Sebelumnya, kemampuan terkait Eigen AI dan Clarifai juga telah ditambahkan.
AI beralih dari gelombang pelatihan ke tahap penerapan, dan penyedia cloud mulai melengkapi lapisan perangkat lunak satu per satu. Akuisisi infrastruktur yang kecil tetapi substansial seperti ini lebih menarik daripada sekadar menjual cerita.
$NBIS #AI #Inference #Nebius
Fokusnya sangat spesifik—menghapus “pajak GPU menganggur” saat model baru mulai dijalankan. GPU sering tidak terpakai saat bobot model dimuat, kapasitas ditingkatkan, atau bobot diganti di tengah proses reinforcement learning. Inferize ingin menyesuaikan kapasitas komputasi dengan kebutuhan nyata, sehingga utilisasi kapasitas Token Factory meningkat dan biaya per token turun. Timnya beranggotakan sekitar 17 orang; pendirinya pernah memimpin Granulate, yang diakuisisi Intel. Nebius mengatakan bahwa tim dan teknologinya akan diintegrasikan ke platform inferensi. Sebelumnya, kemampuan terkait Eigen AI dan Clarifai juga telah ditambahkan.
AI beralih dari gelombang pelatihan ke tahap penerapan, dan penyedia cloud mulai melengkapi lapisan perangkat lunak satu per satu. Akuisisi infrastruktur yang kecil tetapi substansial seperti ini lebih menarik daripada sekadar menjual cerita.
$NBIS #AI #Inference #Nebius
407

·
--
$OPG INFERENCE RUNS AHEAD OF THE REVIEW QUEUE 🔥
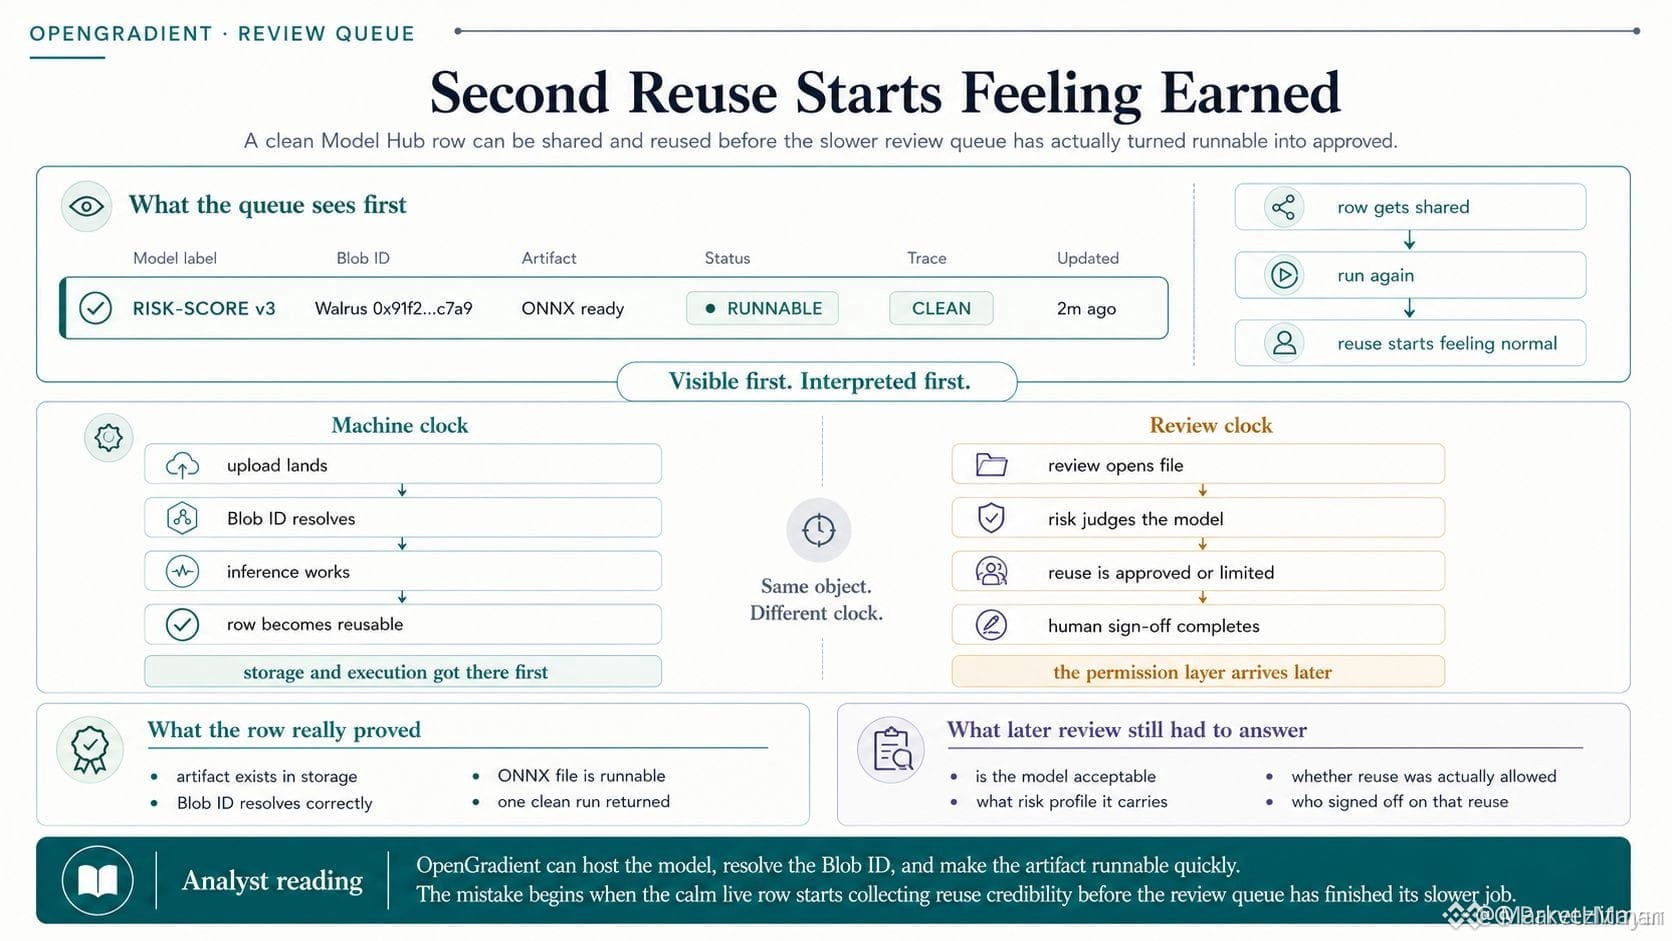
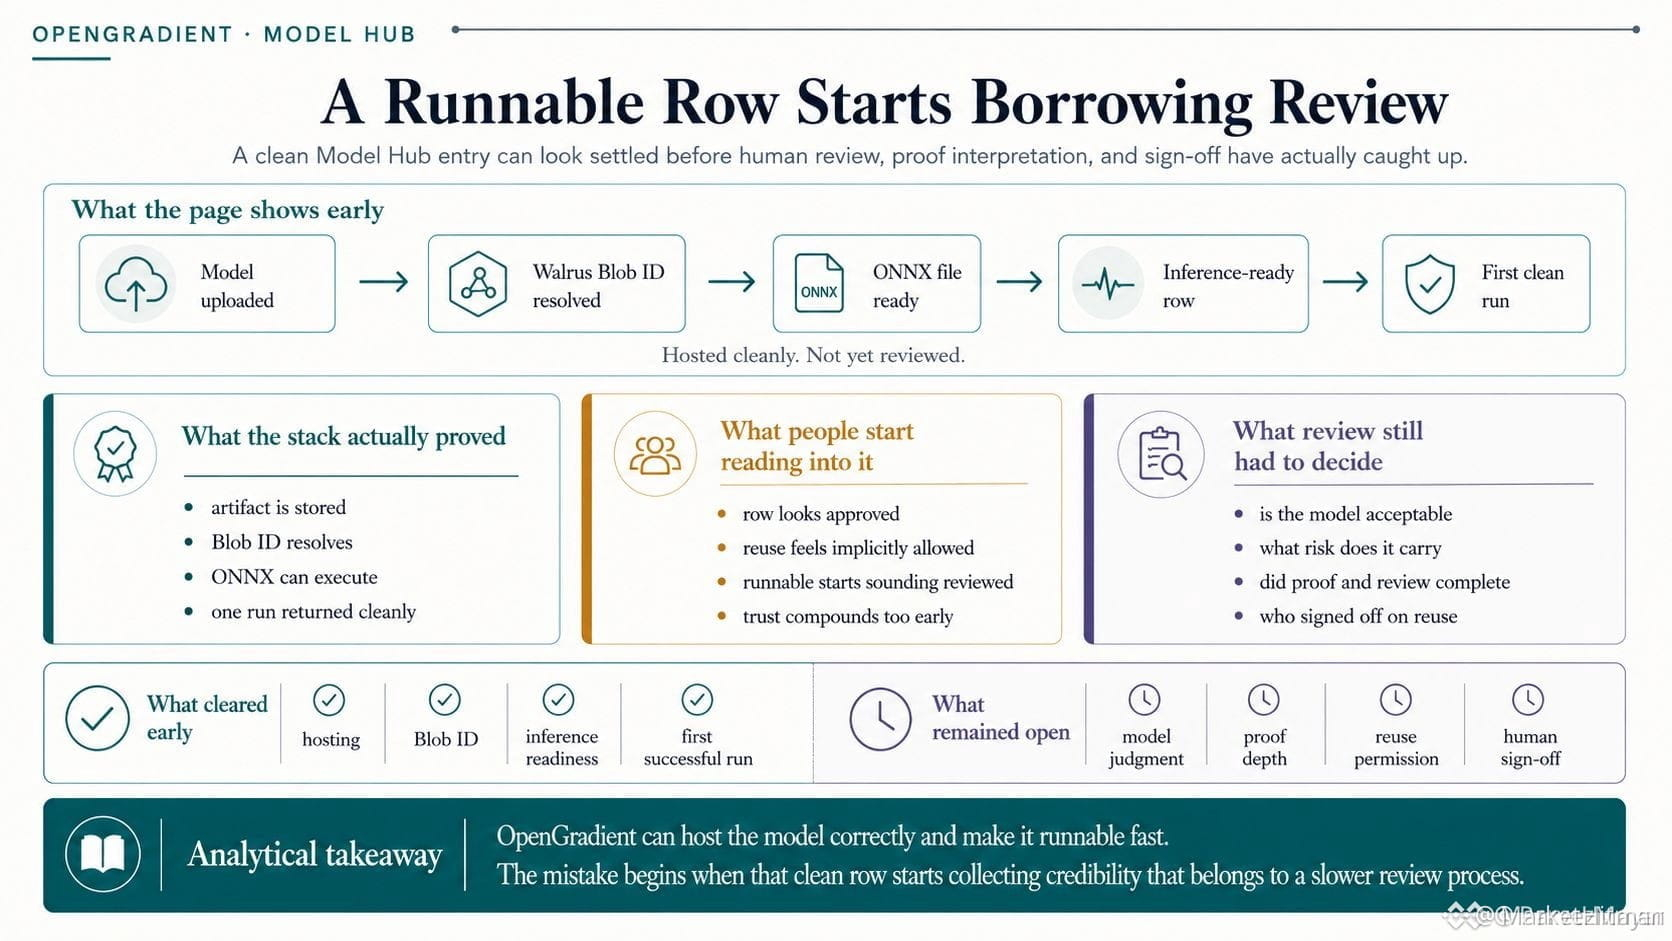
Satu baris model di OpenGradient Model Hub diverifikasi dalam hitungan detik—jejak bersih, ID blob Walrus siap, file ONNX sudah live. Tapi peninjauan manusia tertinggal. Pada penggunaan ulang ke-3, baris itu mulai terlihat sudah ditinjau sebelum pernah memperoleh tanda persetujuan. Sistemnya bekerja sempurna. Prosesnya tidak.
Kesenjangan antara efisiensi mesin dan pengawasan manusia menciptakan titik buta. Modelnya sudah bagus, tapi apakah benar-benar sudah divalidasi? Mengutamakan kecepatan daripada urutan adalah keunggulan yang sunyi—atau kebocoran yang sunyi.
Apakah Anda menjalankan model yang lolos mesin tapi melewati gerbang pemeriksaan manusia?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#OPG #ModelHub #Inference #CryptoAI
🔥
$OPG INFERENCE RUNS AHEAD OF THE REVIEW QUEUE 🔥
Satu baris model di OpenGradient Model Hub diverifikasi dalam hitungan detik—jejak bersih, ID blob Walrus siap, file ONNX sudah live. Tapi peninjauan manusia tertinggal. Pada penggunaan ulang ke-3, baris itu mulai terlihat sudah ditinjau sebelum pernah memperoleh tanda persetujuan. Sistemnya bekerja sempurna. Prosesnya tidak.
Kesenjangan antara efisiensi mesin dan pengawasan manusia menciptakan titik buta. Modelnya sudah bagus, tapi apakah benar-benar sudah divalidasi? Mengutamakan kecepatan daripada urutan adalah keunggulan yang sunyi—atau kebocoran yang sunyi.
Apakah Anda menjalankan model yang lolos mesin tapi melewati gerbang pemeriksaan manusia?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#OPG #ModelHub #Inference #CryptoAI
🔥
Satu baris model di OpenGradient Model Hub diverifikasi dalam hitungan detik—jejak bersih, ID blob Walrus siap, file ONNX sudah live. Tapi peninjauan manusia tertinggal. Pada penggunaan ulang ke-3, baris itu mulai terlihat sudah ditinjau sebelum pernah memperoleh tanda persetujuan. Sistemnya bekerja sempurna. Prosesnya tidak.
Kesenjangan antara efisiensi mesin dan pengawasan manusia menciptakan titik buta. Modelnya sudah bagus, tapi apakah benar-benar sudah divalidasi? Mengutamakan kecepatan daripada urutan adalah keunggulan yang sunyi—atau kebocoran yang sunyi.
Apakah Anda menjalankan model yang lolos mesin tapi melewati gerbang pemeriksaan manusia?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#OPG #ModelHub #Inference #CryptoAI
🔥
19

$AI INFERENCE MEMORY DAPAT MENJADI BOTTLENECK BESAR BERIKUTNYA DALAM KRIPTO AI 💎
Analis Critini Research Jukan membantah pandangan bearish tentang masa depan Micron, dengan menyatakan bahwa pada tahap inferensi AI, menambahkan memori lebih bernilai daripada menambahkan GPU. Masalahnya sederhana: menumpuk GPU NVIDIA tidak meningkatkan kinerja inferensi karena GPU sering kali menganggur akibat bottleneck memori. ROI akhir untuk inferensi lebih bergantung pada memori daripada GPU.
Ini menggeser narasi dari komputasi ke memori—dan di sinilah proyek kripto yang berfokus pada penyimpanan terdesentralisasi serta bandwidth memori bisa melihat pergeseran paradigma dalam nilai. Apakah Anda sudah siap menghadapi pergeseran fase ini?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#AI #Memory #Inference #CryptoNarratives
💎
$AI INFERENCE MEMORY DAPAT MENJADI BOTTLENECK BESAR BERIKUTNYA DALAM KRIPTO AI 💎
Analis Critini Research Jukan membantah pandangan bearish tentang masa depan Micron, dengan menyatakan bahwa pada tahap inferensi AI, menambahkan memori lebih bernilai daripada menambahkan GPU. Masalahnya sederhana: menumpuk GPU NVIDIA tidak meningkatkan kinerja inferensi karena GPU sering kali menganggur akibat bottleneck memori. ROI akhir untuk inferensi lebih bergantung pada memori daripada GPU.
Ini menggeser narasi dari komputasi ke memori—dan di sinilah proyek kripto yang berfokus pada penyimpanan terdesentralisasi serta bandwidth memori bisa melihat pergeseran paradigma dalam nilai. Apakah Anda sudah siap menghadapi pergeseran fase ini?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#AI #Memory #Inference #CryptoNarratives
💎
Analis Critini Research Jukan membantah pandangan bearish tentang masa depan Micron, dengan menyatakan bahwa pada tahap inferensi AI, menambahkan memori lebih bernilai daripada menambahkan GPU. Masalahnya sederhana: menumpuk GPU NVIDIA tidak meningkatkan kinerja inferensi karena GPU sering kali menganggur akibat bottleneck memori. ROI akhir untuk inferensi lebih bergantung pada memori daripada GPU.
Ini menggeser narasi dari komputasi ke memori—dan di sinilah proyek kripto yang berfokus pada penyimpanan terdesentralisasi serta bandwidth memori bisa melihat pergeseran paradigma dalam nilai. Apakah Anda sudah siap menghadapi pergeseran fase ini?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#AI #Memory #Inference #CryptoNarratives
💎
29
·
--
Semua orang mengira ekosistem $BNB hanya bergerak pada peningkatan di chain.
Diplomasi global di Timur Tengah secara diam-diam mengalihkan kekuatan komputasi dari klaster node. Ketika startup AI menghadapi gesekan dalam rantai pasok, jaringan terdesentralisasi memperebutkan bagian silikon yang sama. Perhatikan biaya node RPC sebagai indikator utama untuk tekanan pada perangkat keras lokal.
$BNB $ETH #CryptoInfra #TechTrends #Inference
Semua orang mengira ekosistem $BNB hanya bergerak pada peningkatan di chain.
Diplomasi global di Timur Tengah secara diam-diam mengalihkan kekuatan komputasi dari klaster node. Ketika startup AI menghadapi gesekan dalam rantai pasok, jaringan terdesentralisasi memperebutkan bagian silikon yang sama. Perhatikan biaya node RPC sebagai indikator utama untuk tekanan pada perangkat keras lokal.
$BNB $ETH #CryptoInfra #TechTrends #Inference
Diplomasi global di Timur Tengah secara diam-diam mengalihkan kekuatan komputasi dari klaster node. Ketika startup AI menghadapi gesekan dalam rantai pasok, jaringan terdesentralisasi memperebutkan bagian silikon yang sama. Perhatikan biaya node RPC sebagai indikator utama untuk tekanan pada perangkat keras lokal.
$BNB $ETH #CryptoInfra #TechTrends #Inference
57
·
--
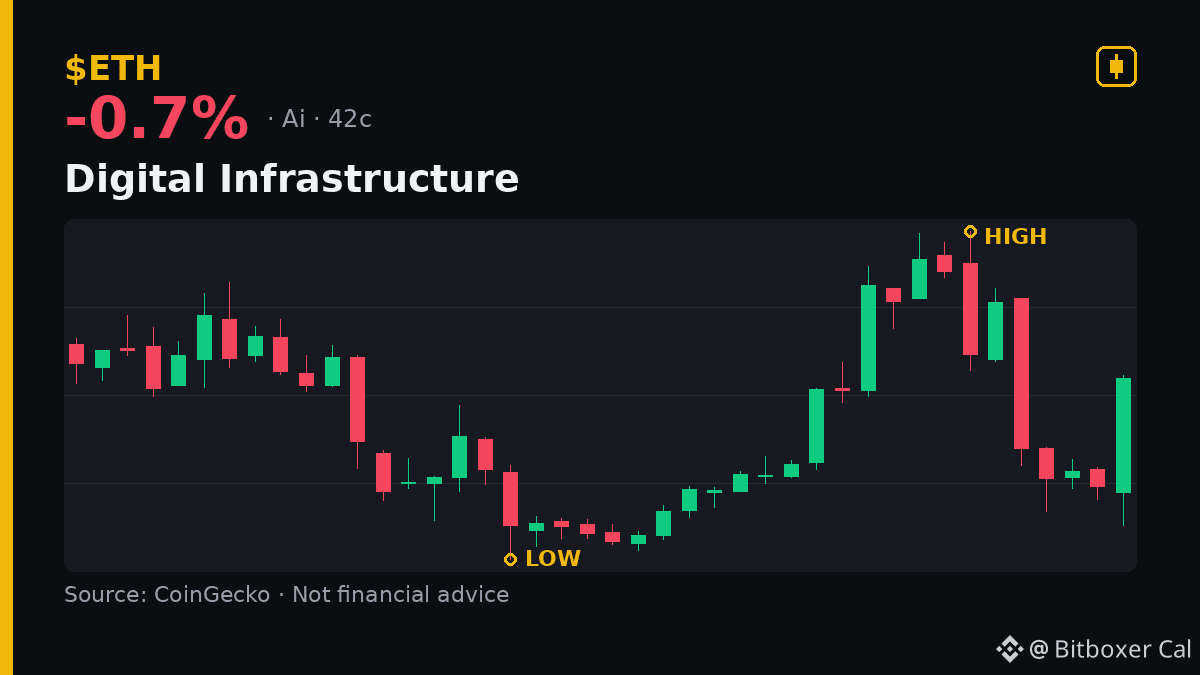
Kami diberi tahu bahwa AI hanyalah perlombaan senjata berbasis perangkat keras.
Itu hanya gangguan. Perusahaan seperti Mandela Digital membuktikan bahwa ketahanan perangkat lunak lebih penting daripada kekuatan komputasi mentah. Sama seperti mesin berat memerlukan rangka yang kokoh, aplikasi keuangan di ETH atau BTC membutuhkan data yang dapat diprediksi—baik saat dijalankan pada chip mutakhir maupun perangkat keras yang sudah menua.
$ETH $BTC #AI #CryptoAI #Inference
Kami diberi tahu bahwa AI hanyalah perlombaan senjata berbasis perangkat keras.
Itu hanya gangguan. Perusahaan seperti Mandela Digital membuktikan bahwa ketahanan perangkat lunak lebih penting daripada kekuatan komputasi mentah. Sama seperti mesin berat memerlukan rangka yang kokoh, aplikasi keuangan di ETH atau BTC membutuhkan data yang dapat diprediksi—baik saat dijalankan pada chip mutakhir maupun perangkat keras yang sudah menua.
$ETH $BTC #AI #CryptoAI #Inference
Itu hanya gangguan. Perusahaan seperti Mandela Digital membuktikan bahwa ketahanan perangkat lunak lebih penting daripada kekuatan komputasi mentah. Sama seperti mesin berat memerlukan rangka yang kokoh, aplikasi keuangan di ETH atau BTC membutuhkan data yang dapat diprediksi—baik saat dijalankan pada chip mutakhir maupun perangkat keras yang sudah menua.
$ETH $BTC #AI #CryptoAI #Inference
69
·
--
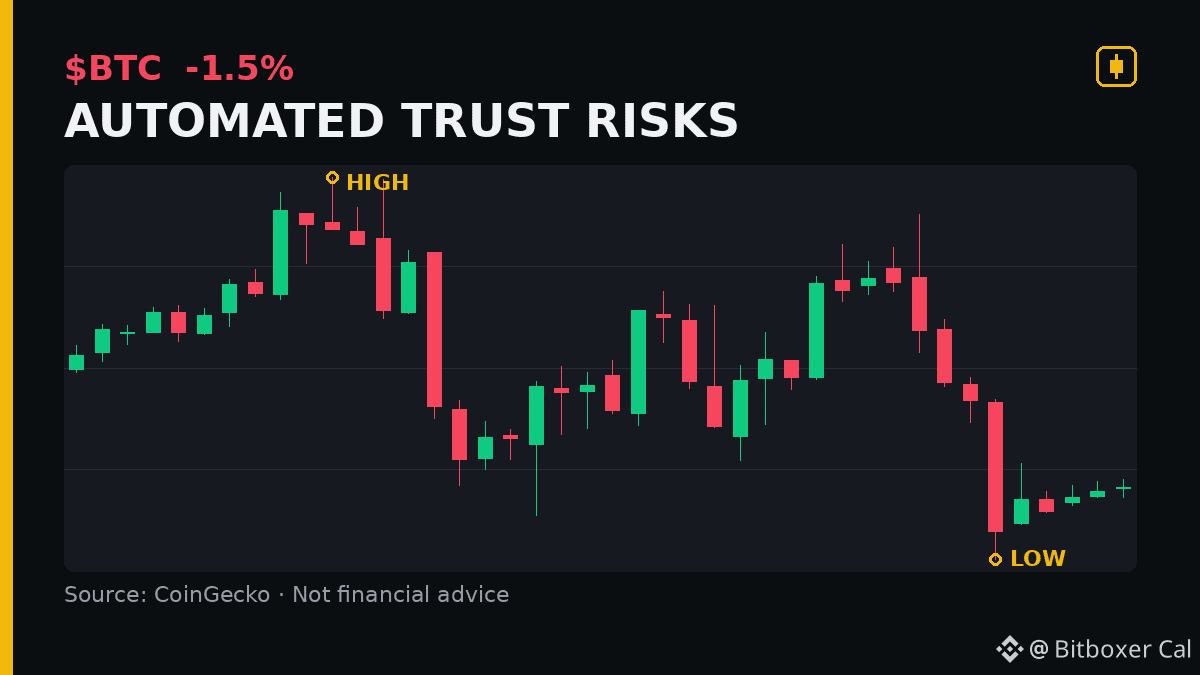
Optimis ingin algoritme mengelola perbendaharaan Bitcoin nasional karena mereka percaya matematika kebal dari ego.
Mereka lupa bahwa kode tidak memiliki neraca untuk melunasi utang ketika sesuatu rusak. Mempercayai alur logika yang buram dan tidak dapat dipatch hanyalah mengganti kesalahan manusia dengan mesin yang tidak bisa dimintai pertanggungjawaban. Jika model melakukan halusinasi, entitas yang bergantung pada ekosistem akan ditinggalkan tanpa apa pun selain kegagalan sistem.
$BTC $BNB #cryptoeducation #AI #Inference
Optimis ingin algoritme mengelola perbendaharaan Bitcoin nasional karena mereka percaya matematika kebal dari ego.
Mereka lupa bahwa kode tidak memiliki neraca untuk melunasi utang ketika sesuatu rusak. Mempercayai alur logika yang buram dan tidak dapat dipatch hanyalah mengganti kesalahan manusia dengan mesin yang tidak bisa dimintai pertanggungjawaban. Jika model melakukan halusinasi, entitas yang bergantung pada ekosistem akan ditinggalkan tanpa apa pun selain kegagalan sistem.
$BTC $BNB #cryptoeducation #AI #Inference
Mereka lupa bahwa kode tidak memiliki neraca untuk melunasi utang ketika sesuatu rusak. Mempercayai alur logika yang buram dan tidak dapat dipatch hanyalah mengganti kesalahan manusia dengan mesin yang tidak bisa dimintai pertanggungjawaban. Jika model melakukan halusinasi, entitas yang bergantung pada ekosistem akan ditinggalkan tanpa apa pun selain kegagalan sistem.
$BTC $BNB #cryptoeducation #AI #Inference
78

·
--
🚀 $AI RIPL MEMANGKAS LATENSI INFERENSI HINGGA 14X – MENGUBAH DEFINISI KOMPUTASI EDGE REAL-TIME! 📈
📊 Mesin RIPL dari Liquid AI memangkas latensi LFM2.5 dengan 1,2B parameter menjadi 34,6 ms pada satu NVIDIA B200, dengan melayani 95% dari 1.000 permintaan RPS dalam rentang waktu tersebut. ⚡ Dibandingkan dengan 498 ms milik vLLM, selisihnya melebar hingga 14,4×, menandakan keunggulan kecepatan di edge yang sangat penting untuk pemeringkatan pencarian dan pengendalian risiko pembayaran.
🦈 Akselerasi ini mengubah model bahasa menjadi aset lini depan yang tangkas, sehingga institusi dapat memanfaatkan likuiditas sebelum arus order stabil. 💡 Nantikan gelombang adopsi yang pesat seiring perusahaan mengejar keunggulan latensi untuk mengungguli pesaing dalam siklus pengambilan keputusan real-time. 💬 Bagaimana keunggulan kecepatan ini akan mengubah strategi AI real-time Anda? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
🚀 $AI RIPL MEMANGKAS LATENSI INFERENSI HINGGA 14X – MENGUBAH DEFINISI KOMPUTASI EDGE REAL-TIME! 📈
📊 Mesin RIPL dari Liquid AI memangkas latensi LFM2.5 dengan 1,2B parameter menjadi 34,6 ms pada satu NVIDIA B200, dengan melayani 95% dari 1.000 permintaan RPS dalam rentang waktu tersebut. ⚡ Dibandingkan dengan 498 ms milik vLLM, selisihnya melebar hingga 14,4×, menandakan keunggulan kecepatan di edge yang sangat penting untuk pemeringkatan pencarian dan pengendalian risiko pembayaran.
🦈 Akselerasi ini mengubah model bahasa menjadi aset lini depan yang tangkas, sehingga institusi dapat memanfaatkan likuiditas sebelum arus order stabil. 💡 Nantikan gelombang adopsi yang pesat seiring perusahaan mengejar keunggulan latensi untuk mengungguli pesaing dalam siklus pengambilan keputusan real-time. 💬 Bagaimana keunggulan kecepatan ini akan mengubah strategi AI real-time Anda? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
📊 Mesin RIPL dari Liquid AI memangkas latensi LFM2.5 dengan 1,2B parameter menjadi 34,6 ms pada satu NVIDIA B200, dengan melayani 95% dari 1.000 permintaan RPS dalam rentang waktu tersebut. ⚡ Dibandingkan dengan 498 ms milik vLLM, selisihnya melebar hingga 14,4×, menandakan keunggulan kecepatan di edge yang sangat penting untuk pemeringkatan pencarian dan pengendalian risiko pembayaran.
🦈 Akselerasi ini mengubah model bahasa menjadi aset lini depan yang tangkas, sehingga institusi dapat memanfaatkan likuiditas sebelum arus order stabil. 💡 Nantikan gelombang adopsi yang pesat seiring perusahaan mengejar keunggulan latensi untuk mengungguli pesaing dalam siklus pengambilan keputusan real-time. 💬 Bagaimana keunggulan kecepatan ini akan mengubah strategi AI real-time Anda? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
4
·
--
PRIME INFERENCE MENGUNGKAP TEROBOSAN LATENSI 1 TRILIUN TOKEN UNTUK INFRASTRUKTUR $AI ⚡ 📊
Prime Intellect telah meluncurkan Prime Inference, memproses hampir 1 triliun token setiap hari sambil memangkas p90 inter-token latency sebesar 40% untuk beban kerja agen yang kompleks. 📊 Dengan memisahkan pemrosesan prompt dan generasi respons di berbagai GPU, sistem ini mengoptimalkan efisiensi komputasi pada skala institusional.
Dengan ekspansi 50% pada kapasitas KV cache hingga 1,63M token per decoder, tumpukan open-source ini menghubungkan pelatihan model dengan eksekusi real-time secara mulus. 💡 Data operasional terus-menerus berputar kembali ke dalam pipeline reinforcement learning, sehingga efisiensi mentah inferensi menjadi metrik kompetitif yang menentukan. 🔍
💬 Menurut Anda, optimasi inferensi berbasis open-source akan mempercepat penerapan agen terdesentralisasi, atau apakah hub komputasi proprietary akan tetap unggul? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
PRIME INFERENCE MENGUNGKAP TEROBOSAN LATENSI 1 TRILIUN TOKEN UNTUK INFRASTRUKTUR $AI ⚡ 📊
Prime Intellect telah meluncurkan Prime Inference, memproses hampir 1 triliun token setiap hari sambil memangkas p90 inter-token latency sebesar 40% untuk beban kerja agen yang kompleks. 📊 Dengan memisahkan pemrosesan prompt dan generasi respons di berbagai GPU, sistem ini mengoptimalkan efisiensi komputasi pada skala institusional.
Dengan ekspansi 50% pada kapasitas KV cache hingga 1,63M token per decoder, tumpukan open-source ini menghubungkan pelatihan model dengan eksekusi real-time secara mulus. 💡 Data operasional terus-menerus berputar kembali ke dalam pipeline reinforcement learning, sehingga efisiensi mentah inferensi menjadi metrik kompetitif yang menentukan. 🔍
💬 Menurut Anda, optimasi inferensi berbasis open-source akan mempercepat penerapan agen terdesentralisasi, atau apakah hub komputasi proprietary akan tetap unggul? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
Prime Intellect telah meluncurkan Prime Inference, memproses hampir 1 triliun token setiap hari sambil memangkas p90 inter-token latency sebesar 40% untuk beban kerja agen yang kompleks. 📊 Dengan memisahkan pemrosesan prompt dan generasi respons di berbagai GPU, sistem ini mengoptimalkan efisiensi komputasi pada skala institusional.
Dengan ekspansi 50% pada kapasitas KV cache hingga 1,63M token per decoder, tumpukan open-source ini menghubungkan pelatihan model dengan eksekusi real-time secara mulus. 💡 Data operasional terus-menerus berputar kembali ke dalam pipeline reinforcement learning, sehingga efisiensi mentah inferensi menjadi metrik kompetitif yang menentukan. 🔍
💬 Menurut Anda, optimasi inferensi berbasis open-source akan mempercepat penerapan agen terdesentralisasi, atau apakah hub komputasi proprietary akan tetap unggul? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #ArtificialIntelligence #Inference #Tech #Crypto
⚡ 💎
93
·
--
$CRBR SET TO LAUNCH GPT-5.6 AT 750 TOKENS/S IN JULY 🚀
Entry: $170 🔥
Konfirmasi Serenity bahwa OpenAI akan menerapkan model frontier GPT-5.6 Sol di perangkat keras Cerebras menjadi katalis langsung bagi saham tersebut. Kecepatan inferensi 750 token/detik menciptakan keunggulan kompetitif yang nyata dibanding arsitektur berbasis GPU. Pembelian Serenity di harga $170 menunjukkan keyakinan, namun mereka juga menyoroti valuasi saat ini sedikit lebih tinggi dibanding rekan seperti JBL.
Pertanyaan utamanya adalah apakah pasar sudah sepenuhnya memasukkan premi dari kemitraan, atau apakah volume yang berkelanjutan dapat mendorong saham ke kisaran baru. Target Anda di sini—$200 atau penarikan dulu?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#CRBR #AI #Hardware #Inference #Breakout
🎯
$CRBR SET TO LAUNCH GPT-5.6 AT 750 TOKENS/S IN JULY 🚀
Entry: $170 🔥
Konfirmasi Serenity bahwa OpenAI akan menerapkan model frontier GPT-5.6 Sol di perangkat keras Cerebras menjadi katalis langsung bagi saham tersebut. Kecepatan inferensi 750 token/detik menciptakan keunggulan kompetitif yang nyata dibanding arsitektur berbasis GPU. Pembelian Serenity di harga $170 menunjukkan keyakinan, namun mereka juga menyoroti valuasi saat ini sedikit lebih tinggi dibanding rekan seperti JBL.
Pertanyaan utamanya adalah apakah pasar sudah sepenuhnya memasukkan premi dari kemitraan, atau apakah volume yang berkelanjutan dapat mendorong saham ke kisaran baru. Target Anda di sini—$200 atau penarikan dulu?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#CRBR #AI #Hardware #Inference #Breakout
🎯
Entry: $170 🔥
Konfirmasi Serenity bahwa OpenAI akan menerapkan model frontier GPT-5.6 Sol di perangkat keras Cerebras menjadi katalis langsung bagi saham tersebut. Kecepatan inferensi 750 token/detik menciptakan keunggulan kompetitif yang nyata dibanding arsitektur berbasis GPU. Pembelian Serenity di harga $170 menunjukkan keyakinan, namun mereka juga menyoroti valuasi saat ini sedikit lebih tinggi dibanding rekan seperti JBL.
Pertanyaan utamanya adalah apakah pasar sudah sepenuhnya memasukkan premi dari kemitraan, atau apakah volume yang berkelanjutan dapat mendorong saham ke kisaran baru. Target Anda di sini—$200 atau penarikan dulu?
Bukan nasihat keuangan. Selalu kelola risiko Anda.
#CRBR #AI #Hardware #Inference #Breakout
🎯
17
$NVDA Permintaan inferensi AI masih tinggi ⚡
Citigroup mengatakan kelangkaan tidak hanya tentang chip terbaru. Sekarang ini juga merembet ke GPU yang lebih tua, pusat data, akses daya, dan lapisan routing yang menentukan model dan perangkat keras mana yang akan digunakan.
Ini penting karena langkah selanjutnya dalam nilai AI mungkin tidak hanya berada di komputasi. Pasar mulai mempricing tumpukan infrastruktur yang lebih luas, dari jaringan optik hingga lapisan cloud dan aplikasi.
Bukan saran finansial. Kelola risiko Anda.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
$NVDA Permintaan inferensi AI masih tinggi ⚡
Citigroup mengatakan kelangkaan tidak hanya tentang chip terbaru. Sekarang ini juga merembet ke GPU yang lebih tua, pusat data, akses daya, dan lapisan routing yang menentukan model dan perangkat keras mana yang akan digunakan.
Ini penting karena langkah selanjutnya dalam nilai AI mungkin tidak hanya berada di komputasi. Pasar mulai mempricing tumpukan infrastruktur yang lebih luas, dari jaringan optik hingga lapisan cloud dan aplikasi.
Bukan saran finansial. Kelola risiko Anda.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
Citigroup mengatakan kelangkaan tidak hanya tentang chip terbaru. Sekarang ini juga merembet ke GPU yang lebih tua, pusat data, akses daya, dan lapisan routing yang menentukan model dan perangkat keras mana yang akan digunakan.
Ini penting karena langkah selanjutnya dalam nilai AI mungkin tidak hanya berada di komputasi. Pasar mulai mempricing tumpukan infrastruktur yang lebih luas, dari jaringan optik hingga lapisan cloud dan aplikasi.
Bukan saran finansial. Kelola risiko Anda.
#NVDA #AI #DataCenters #CloudComputing #Inference
⚡
16
$CEREBRAS DI $170 ADALAH ENTRI INSIDER—SEKARANG OPENAI KONFIRMASI 🔥
Entri: 170 🔥
OpenAI akan meluncurkan GPT‑5.6 pada perangkat keras Cerebras bulan depan, mencapai 750 token per detik. Itu bukan rumor—ini validasi langsung dari inference stack mereka. Serenity, yang membeli di $170, masih melihat potensi jangka panjang meski harga saat ini sedang premium.
Narasi infrastruktur sedang memanas, dan Cerebras berada di pusatnya. Pertanyaannya sekarang: apakah pasar sudah sepenuhnya menghargai katalis ini atau masih ada ruang untuk naik lagi. Kamu sedang menunggu koreksi atau malah menambah posisi di sini?
Bukan nasihat keuangan. Selalu kelola risiko kamu.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
$CEREBRAS DI $170 ADALAH ENTRI INSIDER—SEKARANG OPENAI KONFIRMASI 🔥
Entri: 170 🔥
OpenAI akan meluncurkan GPT‑5.6 pada perangkat keras Cerebras bulan depan, mencapai 750 token per detik. Itu bukan rumor—ini validasi langsung dari inference stack mereka. Serenity, yang membeli di $170, masih melihat potensi jangka panjang meski harga saat ini sedang premium.
Narasi infrastruktur sedang memanas, dan Cerebras berada di pusatnya. Pertanyaannya sekarang: apakah pasar sudah sepenuhnya menghargai katalis ini atau masih ada ruang untuk naik lagi. Kamu sedang menunggu koreksi atau malah menambah posisi di sini?
Bukan nasihat keuangan. Selalu kelola risiko kamu.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
Entri: 170 🔥
OpenAI akan meluncurkan GPT‑5.6 pada perangkat keras Cerebras bulan depan, mencapai 750 token per detik. Itu bukan rumor—ini validasi langsung dari inference stack mereka. Serenity, yang membeli di $170, masih melihat potensi jangka panjang meski harga saat ini sedang premium.
Narasi infrastruktur sedang memanas, dan Cerebras berada di pusatnya. Pertanyaannya sekarang: apakah pasar sudah sepenuhnya menghargai katalis ini atau masih ada ruang untuk naik lagi. Kamu sedang menunggu koreksi atau malah menambah posisi di sini?
Bukan nasihat keuangan. Selalu kelola risiko kamu.
#CEREBRAS #AI #OpenAI #Inference #Crypto
🔥
28

AMAZON MENAIKKAN CAPEX KE $220B — MOMEN PERMINTAAN INFERENCE SEBENARNYA ADALAH MOMEN $FET 🦈 💥
Siklus AI baru saja beralih fase. Training adalah pemanasan — inference adalah tempat komputasi sesungguhnya dikonsumsi. Kepala cloud Amazon mengatakan klien mereka sudah selesai bereksperimen; mereka menghubungkan model langsung ke alur kerja produksi. Itu kurva permintaan yang sedang melengkung ke atas. 📊
Kini AWS menaikkan batas capex-nya menjadi $220B pada 2026. Ini bukan sekadar angka pembulatan — ini adalah para hyperscaler yang memasang taruhan infrastruktur terbesar dekade ini untuk memberi makan mesin inference. Saat raksasa web2 berebut kelangkaan komputasi, narasi AI terdesentralisasi mendapatkan kursi di meja. 💡
Pasar masih sedang menilai ulang token mana yang mewarisi permintaan ini. Momentum cenderung tertinggal dari narasi sampai terobosan besar pertama mengonfirmasikannya. 🔍 Proyek AI mana di portofolio Anda yang paling kuat cerita inference-nya di dunia nyata? 💬
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
AMAZON MENAIKKAN CAPEX KE $220B — MOMEN PERMINTAAN INFERENCE SEBENARNYA ADALAH MOMEN $FET 🦈 💥
Siklus AI baru saja beralih fase. Training adalah pemanasan — inference adalah tempat komputasi sesungguhnya dikonsumsi. Kepala cloud Amazon mengatakan klien mereka sudah selesai bereksperimen; mereka menghubungkan model langsung ke alur kerja produksi. Itu kurva permintaan yang sedang melengkung ke atas. 📊
Kini AWS menaikkan batas capex-nya menjadi $220B pada 2026. Ini bukan sekadar angka pembulatan — ini adalah para hyperscaler yang memasang taruhan infrastruktur terbesar dekade ini untuk memberi makan mesin inference. Saat raksasa web2 berebut kelangkaan komputasi, narasi AI terdesentralisasi mendapatkan kursi di meja. 💡
Pasar masih sedang menilai ulang token mana yang mewarisi permintaan ini. Momentum cenderung tertinggal dari narasi sampai terobosan besar pertama mengonfirmasikannya. 🔍 Proyek AI mana di portofolio Anda yang paling kuat cerita inference-nya di dunia nyata? 💬
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
Siklus AI baru saja beralih fase. Training adalah pemanasan — inference adalah tempat komputasi sesungguhnya dikonsumsi. Kepala cloud Amazon mengatakan klien mereka sudah selesai bereksperimen; mereka menghubungkan model langsung ke alur kerja produksi. Itu kurva permintaan yang sedang melengkung ke atas. 📊
Kini AWS menaikkan batas capex-nya menjadi $220B pada 2026. Ini bukan sekadar angka pembulatan — ini adalah para hyperscaler yang memasang taruhan infrastruktur terbesar dekade ini untuk memberi makan mesin inference. Saat raksasa web2 berebut kelangkaan komputasi, narasi AI terdesentralisasi mendapatkan kursi di meja. 💡
Pasar masih sedang menilai ulang token mana yang mewarisi permintaan ini. Momentum cenderung tertinggal dari narasi sampai terobosan besar pertama mengonfirmasikannya. 🔍 Proyek AI mana di portofolio Anda yang paling kuat cerita inference-nya di dunia nyata? 💬
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #FET #AI #Inference #DePIN #Crypto
🦈 ⚡
135
·
--
ZHIPU MENGHANCURKAN HAMBATAN KECEPATAN DENGAN GLM-5.3-FLASHX, MENYULUT RALLY INFRASTRUKTUR BERIKUTNYA $AI ! ⚡ 🚀
Penskalaan komputasi AI baru saja masuk mode hyperdrive saat Zhipu meluncurkan GLM-5.3-FlashX, melepaskan throughput luar biasa sebesar 200 token per detik. ⚡ Didukung oleh Infra Agents internal yang mengoptimalkan lebih dari 100.000 chip khusus, kecepatan pemrosesan end-to-end meningkat tiga kali lipat dalam waktu kurang dari dua minggu.
Akselerasi throughput mentah ini menandakan pergeseran besar menuju eksekusi model yang sangat efisien di seluruh lanskap kecerdasan terdesentralisasi. 📊 Saat kecepatan inferensi mentah menjadi moat utama, modal cerdas diam-diam lebih dulu mengambil posisi pada tesis hambatan infrastruktur. 💡
💬 Apakah mesin inferensi berkecepatan tinggi akan memicu kenaikan valuasi besar berikutnya untuk token AI pada kuartal ini? 👇
⚠️ Bukan nasihat finansial. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
ZHIPU MENGHANCURKAN HAMBATAN KECEPATAN DENGAN GLM-5.3-FLASHX, MENYULUT RALLY INFRASTRUKTUR BERIKUTNYA $AI ! ⚡ 🚀
Penskalaan komputasi AI baru saja masuk mode hyperdrive saat Zhipu meluncurkan GLM-5.3-FlashX, melepaskan throughput luar biasa sebesar 200 token per detik. ⚡ Didukung oleh Infra Agents internal yang mengoptimalkan lebih dari 100.000 chip khusus, kecepatan pemrosesan end-to-end meningkat tiga kali lipat dalam waktu kurang dari dua minggu.
Akselerasi throughput mentah ini menandakan pergeseran besar menuju eksekusi model yang sangat efisien di seluruh lanskap kecerdasan terdesentralisasi. 📊 Saat kecepatan inferensi mentah menjadi moat utama, modal cerdas diam-diam lebih dulu mengambil posisi pada tesis hambatan infrastruktur. 💡
💬 Apakah mesin inferensi berkecepatan tinggi akan memicu kenaikan valuasi besar berikutnya untuk token AI pada kuartal ini? 👇
⚠️ Bukan nasihat finansial. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
Penskalaan komputasi AI baru saja masuk mode hyperdrive saat Zhipu meluncurkan GLM-5.3-FlashX, melepaskan throughput luar biasa sebesar 200 token per detik. ⚡ Didukung oleh Infra Agents internal yang mengoptimalkan lebih dari 100.000 chip khusus, kecepatan pemrosesan end-to-end meningkat tiga kali lipat dalam waktu kurang dari dua minggu.
Akselerasi throughput mentah ini menandakan pergeseran besar menuju eksekusi model yang sangat efisien di seluruh lanskap kecerdasan terdesentralisasi. 📊 Saat kecepatan inferensi mentah menjadi moat utama, modal cerdas diam-diam lebih dulu mengambil posisi pada tesis hambatan infrastruktur. 💡
💬 Apakah mesin inferensi berkecepatan tinggi akan memicu kenaikan valuasi besar berikutnya untuk token AI pada kuartal ini? 👇
⚠️ Bukan nasihat finansial. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #ArtificialIntelligence #Crypto #Inference #Tech
⚡ 🎯
55
PENGHEMATAN BIAYA 70% YANG MEMBALIK KODING AI DARI SEWA MENJADI ASET YANG DIMILIKI — $AMD 🦈 💥
AMD baru saja menembakkan tumpukan paket langsung ke level enterprise: chip EPYC, GPU Instinct, server Supermicro, PaletteAI dari Spectro Cloud, dan GLM-5.2 — satu di antaranya telah terintegrasi sebelumnya sebagai copilot on-prem dalam satu kotak. 🎯 Angka utama yang penting: hingga 70% lebih rendah total biaya dibanding model frontier cloud, dengan masa balik modal sesingkat enam bulan.
Langkah tajam ini adalah routing berbasis kebijakan — PaletteAI otomatis beralih antara inferensi on-prem dan model cloud Anthropic, OpenAI, Google, atau xAI sesuai kebutuhan, lengkap dengan kuota token, jejak audit, dan dasbor Grafana yang menampilkan celah biaya yang sebenarnya secara real-time. 🔍
Ini adalah pergeseran coding AI dari sistem sewa berbasis pemakaian menjadi infrastruktur yang bisa diprediksi — sebuah langkah kedaulatan yang bergema dengan pola pikir self-custody. 💬 Apakah perusahaan akan terus menyewa model frontier atau mulai memiliki komputasinya? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
PENGHEMATAN BIAYA 70% YANG MEMBALIK KODING AI DARI SEWA MENJADI ASET YANG DIMILIKI — $AMD 🦈 💥
AMD baru saja menembakkan tumpukan paket langsung ke level enterprise: chip EPYC, GPU Instinct, server Supermicro, PaletteAI dari Spectro Cloud, dan GLM-5.2 — satu di antaranya telah terintegrasi sebelumnya sebagai copilot on-prem dalam satu kotak. 🎯 Angka utama yang penting: hingga 70% lebih rendah total biaya dibanding model frontier cloud, dengan masa balik modal sesingkat enam bulan.
Langkah tajam ini adalah routing berbasis kebijakan — PaletteAI otomatis beralih antara inferensi on-prem dan model cloud Anthropic, OpenAI, Google, atau xAI sesuai kebutuhan, lengkap dengan kuota token, jejak audit, dan dasbor Grafana yang menampilkan celah biaya yang sebenarnya secara real-time. 🔍
Ini adalah pergeseran coding AI dari sistem sewa berbasis pemakaian menjadi infrastruktur yang bisa diprediksi — sebuah langkah kedaulatan yang bergema dengan pola pikir self-custody. 💬 Apakah perusahaan akan terus menyewa model frontier atau mulai memiliki komputasinya? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
AMD baru saja menembakkan tumpukan paket langsung ke level enterprise: chip EPYC, GPU Instinct, server Supermicro, PaletteAI dari Spectro Cloud, dan GLM-5.2 — satu di antaranya telah terintegrasi sebelumnya sebagai copilot on-prem dalam satu kotak. 🎯 Angka utama yang penting: hingga 70% lebih rendah total biaya dibanding model frontier cloud, dengan masa balik modal sesingkat enam bulan.
Langkah tajam ini adalah routing berbasis kebijakan — PaletteAI otomatis beralih antara inferensi on-prem dan model cloud Anthropic, OpenAI, Google, atau xAI sesuai kebutuhan, lengkap dengan kuota token, jejak audit, dan dasbor Grafana yang menampilkan celah biaya yang sebenarnya secara real-time. 🔍
Ini adalah pergeseran coding AI dari sistem sewa berbasis pemakaian menjadi infrastruktur yang bisa diprediksi — sebuah langkah kedaulatan yang bergema dengan pola pikir self-custody. 💬 Apakah perusahaan akan terus menyewa model frontier atau mulai memiliki komputasinya? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AMD #AIInfrastructure #EnterpriseTech #Inference #CryptoAI
🔥 💎
90
·
--
🚨 $NVDA SHIFTS INSTITUTIONAL FOCUS TO AGENTIC AI INFERENCE EFFICIENCY! 🧠
Nvidia secara resmi telah memicu produksi massal untuk akselerator Groq 3 LPX, menandai rotasi struktural penting dari pelatihan model murni menuju eksekusi berkelanjutan. 🦈 Operator infrastruktur besar tengah langsung berbenturan dengan batas daya, sehingga memaksa modal yang cerdas untuk beralih ke arsitektur berefisiensi tinggi untuk beban kerja AI agentik multi-langkah. 📊
Transisi ini menggeser tolok ukur operasional dari kapasitas pemrosesan mentah ke efisiensi compute-per-watt yang dioptimalkan. 🔍 Saat inferensi live yang terus-menerus menggantikan pelatihan model statis, desain perangkat keras yang hemat energi menjadi keunggulan penentu bagi skala institusional. 💡
🤔 Apakah keterbatasan daya akan memaksa penilaian ulang valuasi besar di seluruh sektor komputasi performa tinggi tahun ini? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
🚨 $NVDA SHIFTS INSTITUTIONAL FOCUS TO AGENTIC AI INFERENCE EFFICIENCY! 🧠
Nvidia secara resmi telah memicu produksi massal untuk akselerator Groq 3 LPX, menandai rotasi struktural penting dari pelatihan model murni menuju eksekusi berkelanjutan. 🦈 Operator infrastruktur besar tengah langsung berbenturan dengan batas daya, sehingga memaksa modal yang cerdas untuk beralih ke arsitektur berefisiensi tinggi untuk beban kerja AI agentik multi-langkah. 📊
Transisi ini menggeser tolok ukur operasional dari kapasitas pemrosesan mentah ke efisiensi compute-per-watt yang dioptimalkan. 🔍 Saat inferensi live yang terus-menerus menggantikan pelatihan model statis, desain perangkat keras yang hemat energi menjadi keunggulan penentu bagi skala institusional. 💡
🤔 Apakah keterbatasan daya akan memaksa penilaian ulang valuasi besar di seluruh sektor komputasi performa tinggi tahun ini? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
Nvidia secara resmi telah memicu produksi massal untuk akselerator Groq 3 LPX, menandai rotasi struktural penting dari pelatihan model murni menuju eksekusi berkelanjutan. 🦈 Operator infrastruktur besar tengah langsung berbenturan dengan batas daya, sehingga memaksa modal yang cerdas untuk beralih ke arsitektur berefisiensi tinggi untuk beban kerja AI agentik multi-langkah. 📊
Transisi ini menggeser tolok ukur operasional dari kapasitas pemrosesan mentah ke efisiensi compute-per-watt yang dioptimalkan. 🔍 Saat inferensi live yang terus-menerus menggantikan pelatihan model statis, desain perangkat keras yang hemat energi menjadi keunggulan penentu bagi skala institusional. 💡
🤔 Apakah keterbatasan daya akan memaksa penilaian ulang valuasi besar di seluruh sektor komputasi performa tinggi tahun ini? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #NVDA #AI #Inference #Tech #MarketStructure
🎯 🦈
18
·
--
🚨 $AI INFERENCE SHIFT: €200M TARUH LAGI MELAWAN MONOPOLI GPU ⚡
Euclyd senilai €200M Seri A, dipimpin bersama oleh Samsung, EQT, dan Somerset, adalah suara struktural untuk AI inference sebagai bottleneck berikutnya. 📊 Proyeksi roadmap 2028 exaflop dan 16.384 prosesor in-memory menargetkan lapisan efisiensi daya tempat GPU mungkin rentan.
⚡ Perangkapnya: klaim efisiensi 100x Nvidia masih berupa proyeksi, bukan bukti komersial. Kesenjangan antara ambisi dan verifikasi itulah yang dipantau “uang pintar” untuk mencari katalis. 💬 Apakah ini awal dari siklus perangkat keras AI baru, atau masih narasi yang belum terbukti? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
🚨 $AI INFERENCE SHIFT: €200M TARUH LAGI MELAWAN MONOPOLI GPU ⚡
Euclyd senilai €200M Seri A, dipimpin bersama oleh Samsung, EQT, dan Somerset, adalah suara struktural untuk AI inference sebagai bottleneck berikutnya. 📊 Proyeksi roadmap 2028 exaflop dan 16.384 prosesor in-memory menargetkan lapisan efisiensi daya tempat GPU mungkin rentan.
⚡ Perangkapnya: klaim efisiensi 100x Nvidia masih berupa proyeksi, bukan bukti komersial. Kesenjangan antara ambisi dan verifikasi itulah yang dipantau “uang pintar” untuk mencari katalis. 💬 Apakah ini awal dari siklus perangkat keras AI baru, atau masih narasi yang belum terbukti? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
Euclyd senilai €200M Seri A, dipimpin bersama oleh Samsung, EQT, dan Somerset, adalah suara struktural untuk AI inference sebagai bottleneck berikutnya. 📊 Proyeksi roadmap 2028 exaflop dan 16.384 prosesor in-memory menargetkan lapisan efisiensi daya tempat GPU mungkin rentan.
⚡ Perangkapnya: klaim efisiensi 100x Nvidia masih berupa proyeksi, bukan bukti komersial. Kesenjangan antara ambisi dan verifikasi itulah yang dipantau “uang pintar” untuk mencari katalis. 💬 Apakah ini awal dari siklus perangkat keras AI baru, atau masih narasi yang belum terbukti? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #AI #Euclyd #Inference #Hardware #Crypto
🦈 💡
39
·
--
Laporan SpaceX yang akan datang lebih dari sekadar berita korporat; laporan itu menyoroti benturan antara kotak hitam milik swasta dan etos $ETH and $BTC .
Perusahaan tersentral menuntut kepercayaan buta pada perhitungan ruang dewan. Protokol yang terdesentralisasi memaksa kode untuk membuktikan setiap klaim. Audit independen atas neraca keuangan milik Anda sendiri adalah satu-satunya cara untuk memastikan keamanan yang sesungguhnya di pasar ini.
$ETH $BTC #Web3 #Inference #DeFi
Laporan SpaceX yang akan datang lebih dari sekadar berita korporat; laporan itu menyoroti benturan antara kotak hitam milik swasta dan etos $ETH and $BTC .
Perusahaan tersentral menuntut kepercayaan buta pada perhitungan ruang dewan. Protokol yang terdesentralisasi memaksa kode untuk membuktikan setiap klaim. Audit independen atas neraca keuangan milik Anda sendiri adalah satu-satunya cara untuk memastikan keamanan yang sesungguhnya di pasar ini.
$ETH $BTC #Web3 #Inference #DeFi
Perusahaan tersentral menuntut kepercayaan buta pada perhitungan ruang dewan. Protokol yang terdesentralisasi memaksa kode untuk membuktikan setiap klaim. Audit independen atas neraca keuangan milik Anda sendiri adalah satu-satunya cara untuk memastikan keamanan yang sesungguhnya di pasar ini.
$ETH $BTC #Web3 #Inference #DeFi
65

·
--
⚡ $FET AI INFERENCE BOTTLENECK PIVOTS TO MEMORY BANDWIDTH AS INSTITUTIONS RESTRUCTURE INFRASTRUCTURE! 📊
Kebutuhan komputasi institusional kini bergeser secara dramatis dari kapasitas memori mentah menuju orkestrasi bandwidth yang sangat efisien. 📊 Seiring arsitektur MoE mendominasi, kecepatan routing di antara pipeline Prefill dan Decode telah menjadi bottleneck utama bagi infrastruktur perangkat keras generasi berikutnya.
Penjadwalan tiered KV cache dan throughput bandwidth sekarang menentukan efisiensi klaster, bukan sekadar kepadatan perangkat keras. 🔍 Modal cerdas menempatkan diri pada protokol infrastruktur yang mengoptimalkan overhead pemindahan data sebelum ekspansi penskalaan berikutnya.
💡 Arsitektur node terdisagregasi memaksa perombakan total dalam strategi alokasi perangkat keras institusional. 💬 Apakah protokol optimasi bandwidth akan menangkap rotasi struktural berikutnya dalam komputasi terdesentralisasi? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
⚡ $FET AI INFERENCE BOTTLENECK PIVOTS TO MEMORY BANDWIDTH AS INSTITUTIONS RESTRUCTURE INFRASTRUCTURE! 📊
Kebutuhan komputasi institusional kini bergeser secara dramatis dari kapasitas memori mentah menuju orkestrasi bandwidth yang sangat efisien. 📊 Seiring arsitektur MoE mendominasi, kecepatan routing di antara pipeline Prefill dan Decode telah menjadi bottleneck utama bagi infrastruktur perangkat keras generasi berikutnya.
Penjadwalan tiered KV cache dan throughput bandwidth sekarang menentukan efisiensi klaster, bukan sekadar kepadatan perangkat keras. 🔍 Modal cerdas menempatkan diri pada protokol infrastruktur yang mengoptimalkan overhead pemindahan data sebelum ekspansi penskalaan berikutnya.
💡 Arsitektur node terdisagregasi memaksa perombakan total dalam strategi alokasi perangkat keras institusional. 💬 Apakah protokol optimasi bandwidth akan menangkap rotasi struktural berikutnya dalam komputasi terdesentralisasi? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
Kebutuhan komputasi institusional kini bergeser secara dramatis dari kapasitas memori mentah menuju orkestrasi bandwidth yang sangat efisien. 📊 Seiring arsitektur MoE mendominasi, kecepatan routing di antara pipeline Prefill dan Decode telah menjadi bottleneck utama bagi infrastruktur perangkat keras generasi berikutnya.
Penjadwalan tiered KV cache dan throughput bandwidth sekarang menentukan efisiensi klaster, bukan sekadar kepadatan perangkat keras. 🔍 Modal cerdas menempatkan diri pada protokol infrastruktur yang mengoptimalkan overhead pemindahan data sebelum ekspansi penskalaan berikutnya.
💡 Arsitektur node terdisagregasi memaksa perombakan total dalam strategi alokasi perangkat keras institusional. 💬 Apakah protokol optimasi bandwidth akan menangkap rotasi struktural berikutnya dalam komputasi terdesentralisasi? 👇
⚠️ Bukan nasihat keuangan. Selalu kelola risiko Anda. 🛡️
🏷️ #FET #AI #Inference #Crypto #Compute
🔥 ⚡
239

·
--
$AI Biaya Infrastruktur Meningkat seiring Permintaan Inference yang Meluas ⚡
Citigroup mengatakan permintaan inference AI masih sangat tinggi, dan tekanan tidak lagi terbatas pada chip terbaru. Kelangkaan sedang bergerak di seluruh GPU, pusat data, akses daya, dan lapisan routing, yang berarti pasar sekarang mematok seluruh tumpukan, bukan hanya semikonduktor.
Intinya adalah struktural: vendor model monetisasi lebih cepat, sementara kemacetan infrastruktur menjadi batasan yang nyata. Jika tren ini berlanjut, nilai mungkin terus berputar menuju lapisan yang membantu mengurangi biaya inference dan mengalokasikan komputasi dengan lebih efisien.
Bukan nasihat keuangan. Kelola risiko Anda.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
$AI Biaya Infrastruktur Meningkat seiring Permintaan Inference yang Meluas ⚡
Citigroup mengatakan permintaan inference AI masih sangat tinggi, dan tekanan tidak lagi terbatas pada chip terbaru. Kelangkaan sedang bergerak di seluruh GPU, pusat data, akses daya, dan lapisan routing, yang berarti pasar sekarang mematok seluruh tumpukan, bukan hanya semikonduktor.
Intinya adalah struktural: vendor model monetisasi lebih cepat, sementara kemacetan infrastruktur menjadi batasan yang nyata. Jika tren ini berlanjut, nilai mungkin terus berputar menuju lapisan yang membantu mengurangi biaya inference dan mengalokasikan komputasi dengan lebih efisien.
Bukan nasihat keuangan. Kelola risiko Anda.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
Citigroup mengatakan permintaan inference AI masih sangat tinggi, dan tekanan tidak lagi terbatas pada chip terbaru. Kelangkaan sedang bergerak di seluruh GPU, pusat data, akses daya, dan lapisan routing, yang berarti pasar sekarang mematok seluruh tumpukan, bukan hanya semikonduktor.
Intinya adalah struktural: vendor model monetisasi lebih cepat, sementara kemacetan infrastruktur menjadi batasan yang nyata. Jika tren ini berlanjut, nilai mungkin terus berputar menuju lapisan yang membantu mengurangi biaya inference dan mengalokasikan komputasi dengan lebih efisien.
Bukan nasihat keuangan. Kelola risiko Anda.
#AI #Inference #DataCenters #CloudInfrastructure #Tech
⚡
64
Masuk untuk menjelajahi konten lainnya
Bergabunglah dengan pengguna kripto global di Binance Square
⚡️ Dapatkan informasi terbaru dan berguna tentang kripto.
💬 Dipercayai oleh bursa kripto terbesar di dunia.
👍 Temukan wawasan nyata dari kreator terverifikasi.
Email/Nomor Ponsel
Topik Sedang Tren
1
#BinanceProcesses$4.65BWithdrawals
49,997 penayangan
201 Berdiskusi
2
#WithdrawalsBack: 15 networks live
10,976 penayangan
158 Berdiskusi
3
#EthereumSurpasses$2300
157 penayangan
26 Berdiskusi
4
#BitcoinSpotETFsPost$203MWeeklyOutflow
266 penayangan
9 Berdiskusi
5
#SouthKoreanLawmakerProposesReviewOfAllListedDigitalAssets
328 penayangan
12 Berdiskusi
6
#BrazilVirtualAssetLicenseDeadlineDrawsAbout40Firms
12,205 penayangan
214 Berdiskusi
7
#BTCPayServerUrgesOperatorsToShutDownInstances
10,729 penayangan
195 Berdiskusi
8
#BankOfKoreaSurveysFinancialFirmsOnVirtualAssetRisks
447 penayangan
12 Berdiskusi
9
#BinanceUpdatesProofofReservesAddresses
187,257 penayangan
1,895 Berdiskusi
10
#StudyFindsCircleAIAgentWalletLimitsCanBeBypassed
5,217 penayangan
110 Berdiskusi