

Not 歸藏
59 Publications

Not 歸藏
Signaler
Bloquer l’utilisateur
0 Suivis
2 Abonnés
3 J’aime
Publications
Tous
Vidéos
·
--
Voir la traduction
Muse 用法+1,每天早上帮我生成一个 AI 资讯早报视频
写一下实践的步骤:
1. 基于我日常的内容渠道和喜好先整理文案来源到 Notion 和聊天里面
2. 查找下载相关内容的图片和视频素材
3. 在虚拟机里面通过 Pi 调用我的 K3 和 GLM 5.3 模型利用 guizang-product-video-skill 将所有的信息组装成视频
4. 通过 Muesli 聊天发给我
Muse 用法+1,每天早上帮我生成一个 AI 资讯早报视频
写一下实践的步骤:
1. 基于我日常的内容渠道和喜好先整理文案来源到 Notion 和聊天里面
2. 查找下载相关内容的图片和视频素材
3. 在虚拟机里面通过 Pi 调用我的 K3 和 GLM 5.3 模型利用 guizang-product-video-skill 将所有的信息组装成视频
4. 通过 Muesli 聊天发给我
写一下实践的步骤:
1. 基于我日常的内容渠道和喜好先整理文案来源到 Notion 和聊天里面
2. 查找下载相关内容的图片和视频素材
3. 在虚拟机里面通过 Pi 调用我的 K3 和 GLM 5.3 模型利用 guizang-product-video-skill 将所有的信息组装成视频
4. 通过 Muesli 聊天发给我
52
·
--
Voir la traduction
Muse 用法+1,每天早上帮我生成一个 AI 资讯早报视频
写一下实践的步骤:
1. 基于我日常的内容渠道和喜好先整理文案来源到 Notion 和聊天里面
2. 查找下载相关内容的图片和视频素材
3. 在虚拟机里面通过 Pi 调用我的 K3 和 GLM 5.3 模型利用 guizang-product-video-skill 将所有的信息组装成视频
4. 通过 Mues 聊天界面发给我
Muse 用法+1,每天早上帮我生成一个 AI 资讯早报视频
写一下实践的步骤:
1. 基于我日常的内容渠道和喜好先整理文案来源到 Notion 和聊天里面
2. 查找下载相关内容的图片和视频素材
3. 在虚拟机里面通过 Pi 调用我的 K3 和 GLM 5.3 模型利用 guizang-product-video-skill 将所有的信息组装成视频
4. 通过 Mues 聊天界面发给我
写一下实践的步骤:
1. 基于我日常的内容渠道和喜好先整理文案来源到 Notion 和聊天里面
2. 查找下载相关内容的图片和视频素材
3. 在虚拟机里面通过 Pi 调用我的 K3 和 GLM 5.3 模型利用 guizang-product-video-skill 将所有的信息组装成视频
4. 通过 Mues 聊天界面发给我
78
·
--
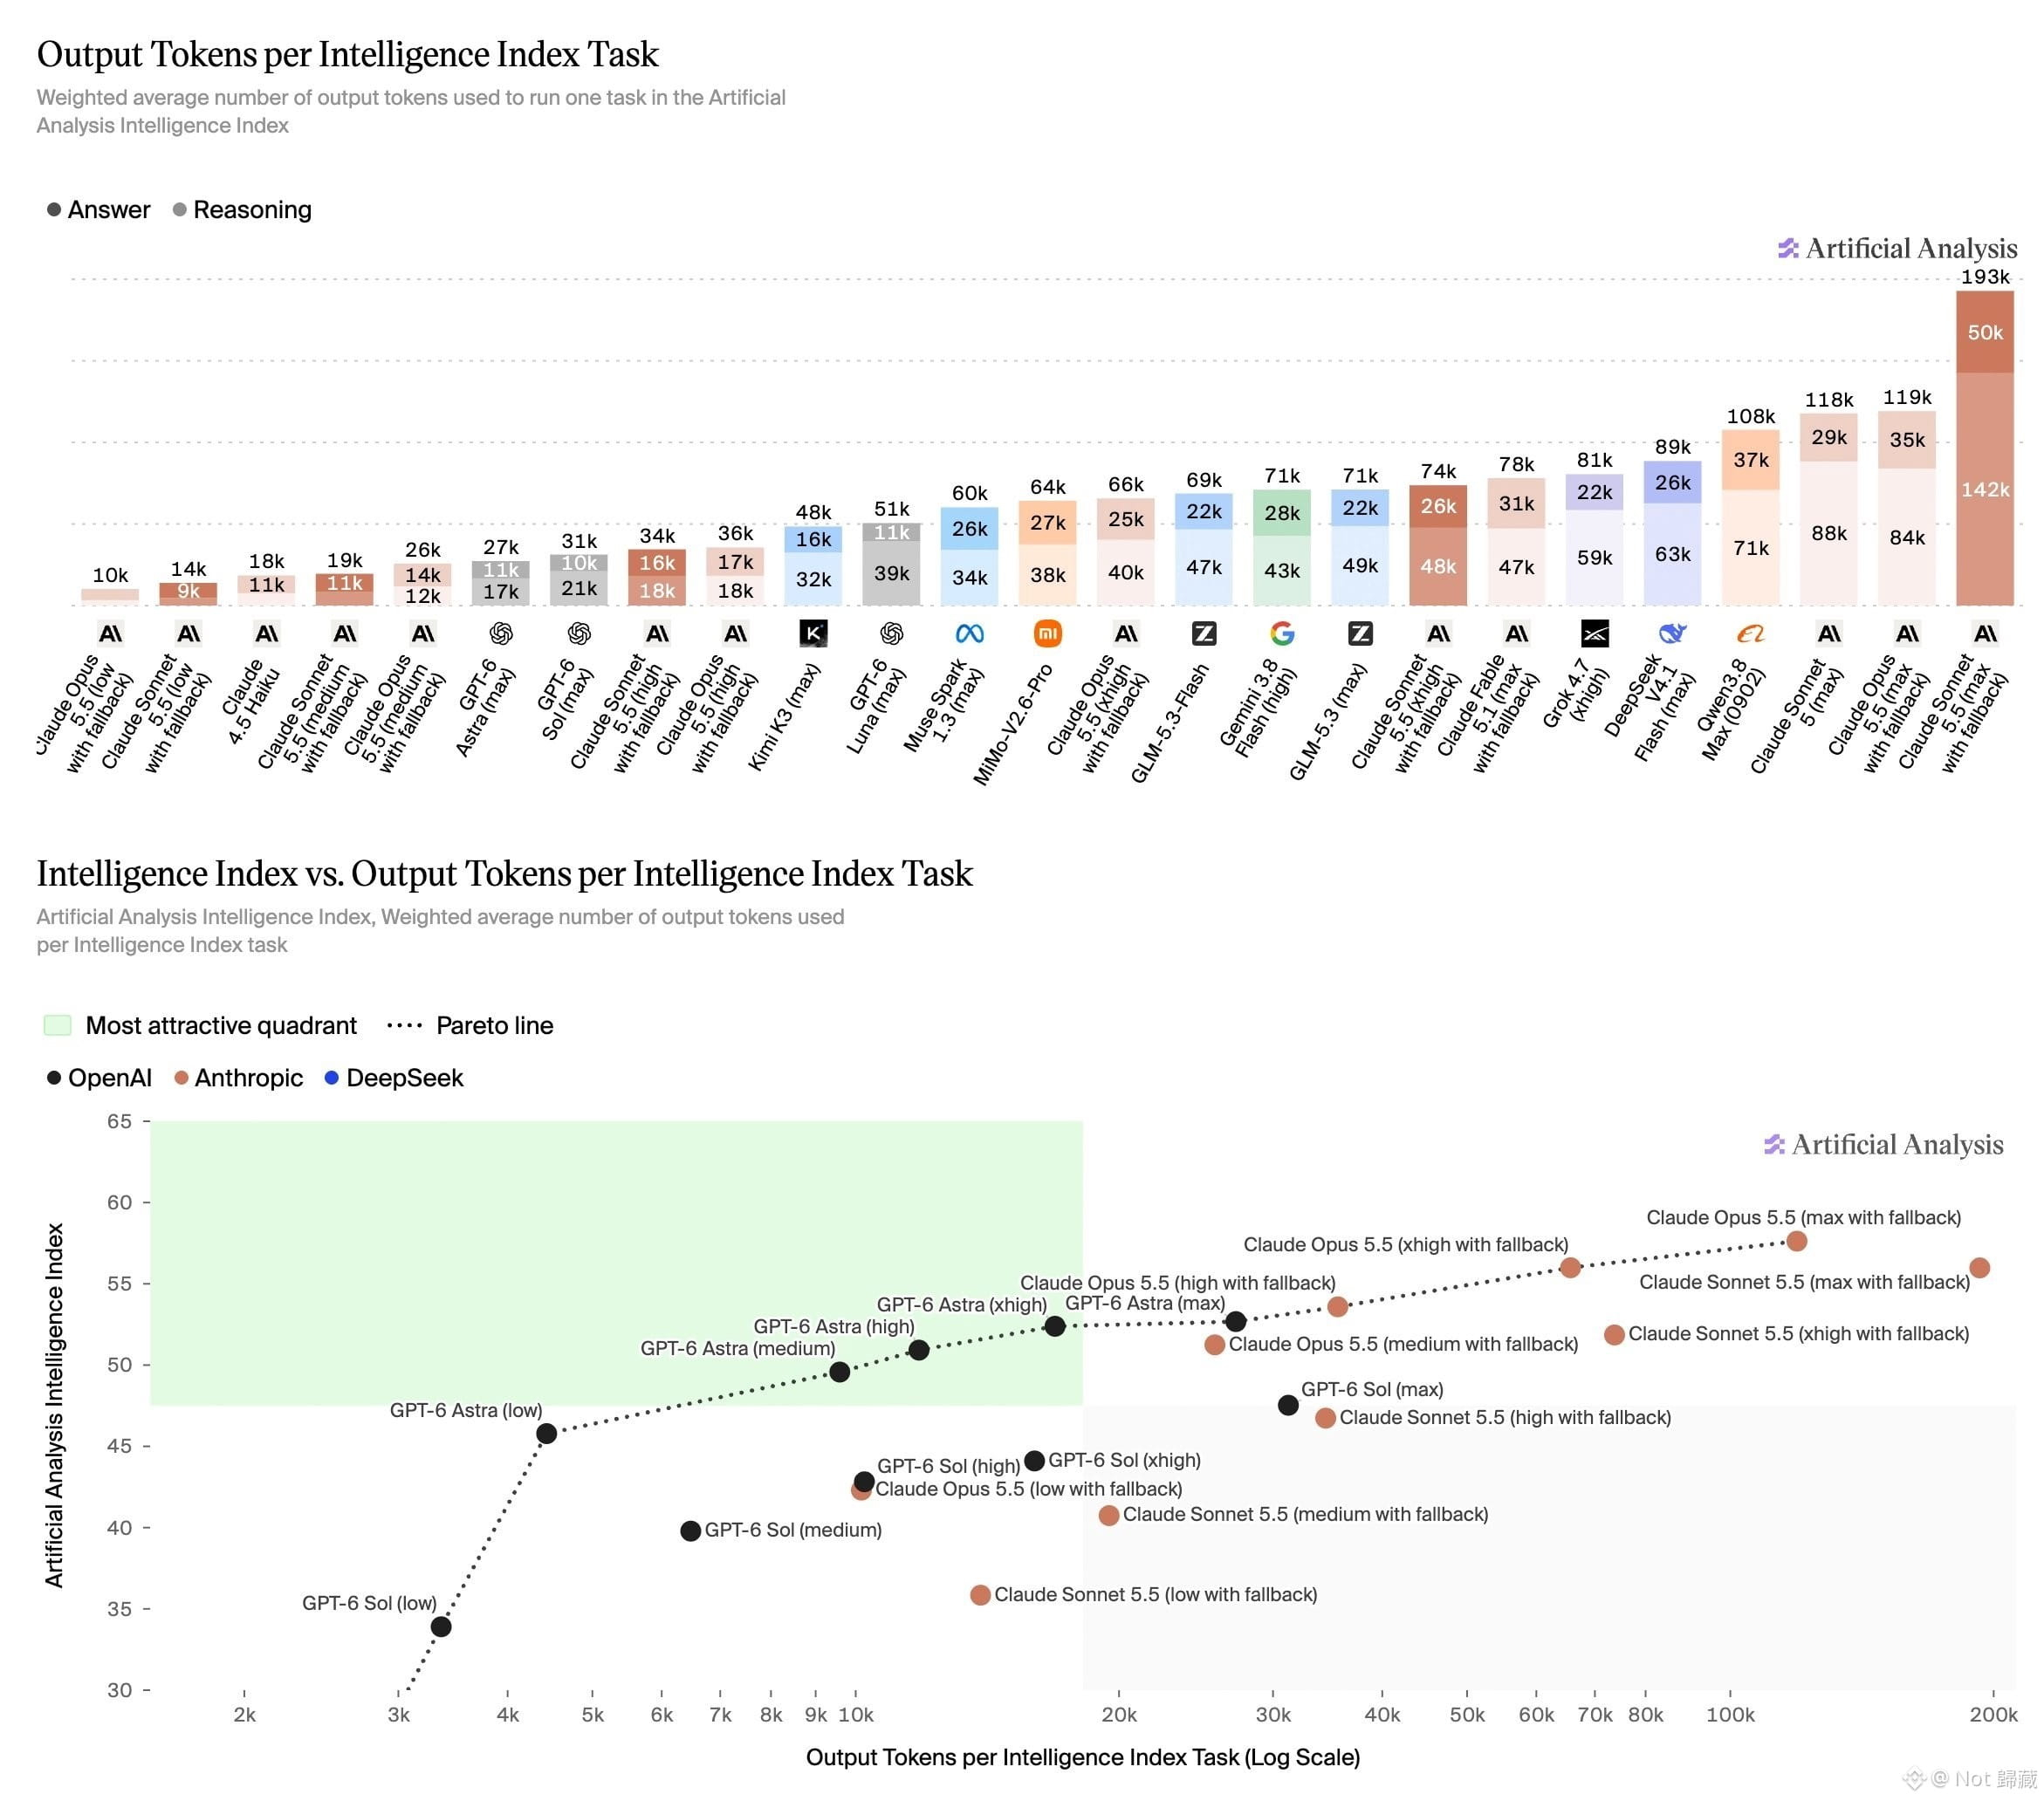
La version Sonnet 5.5 est sortie, et ce modèle est vraiment impressionnant : il obtient un score supérieur de 4 points à celui d’Opus 5.5 sur les tests de codage agentique.
Niveau tarification aussi, c’est très avantageux : le prix par million de tokens d’entrée et de sortie est respectivement de 2 $ et 10 $, comme pour GPT-6 Sol. De plus, sa vitesse d’exécution est 30 % plus rapide que celle de Sonnet 5, et Claude indique officiellement que ses coûts ont également baissé de 30 %.
Quant à la raison pour laquelle ses performances en codage agentique sont similaires à celles d’Opus 5.5, voire meilleures, jetez un œil aux tests de prix.
Avec Sonnet 5.5, au niveau « max » (effort maximal), pour la même tâche, le coût est beaucoup plus élevé que celui d’Opus 5.5 : on est presque au même niveau, voire légèrement au-dessus. C’est peut-être pour cela qu’il obtient un score aussi élevé.
Donc, quand vous utilisez Opus 5.5 ou Sonnet 5.5, surtout ne mettez pas « max » : sur certaines tâches complexes, il peut générer un prix extrêmement élevé, presque au niveau de Claude Fable 5.1.
369
·
--
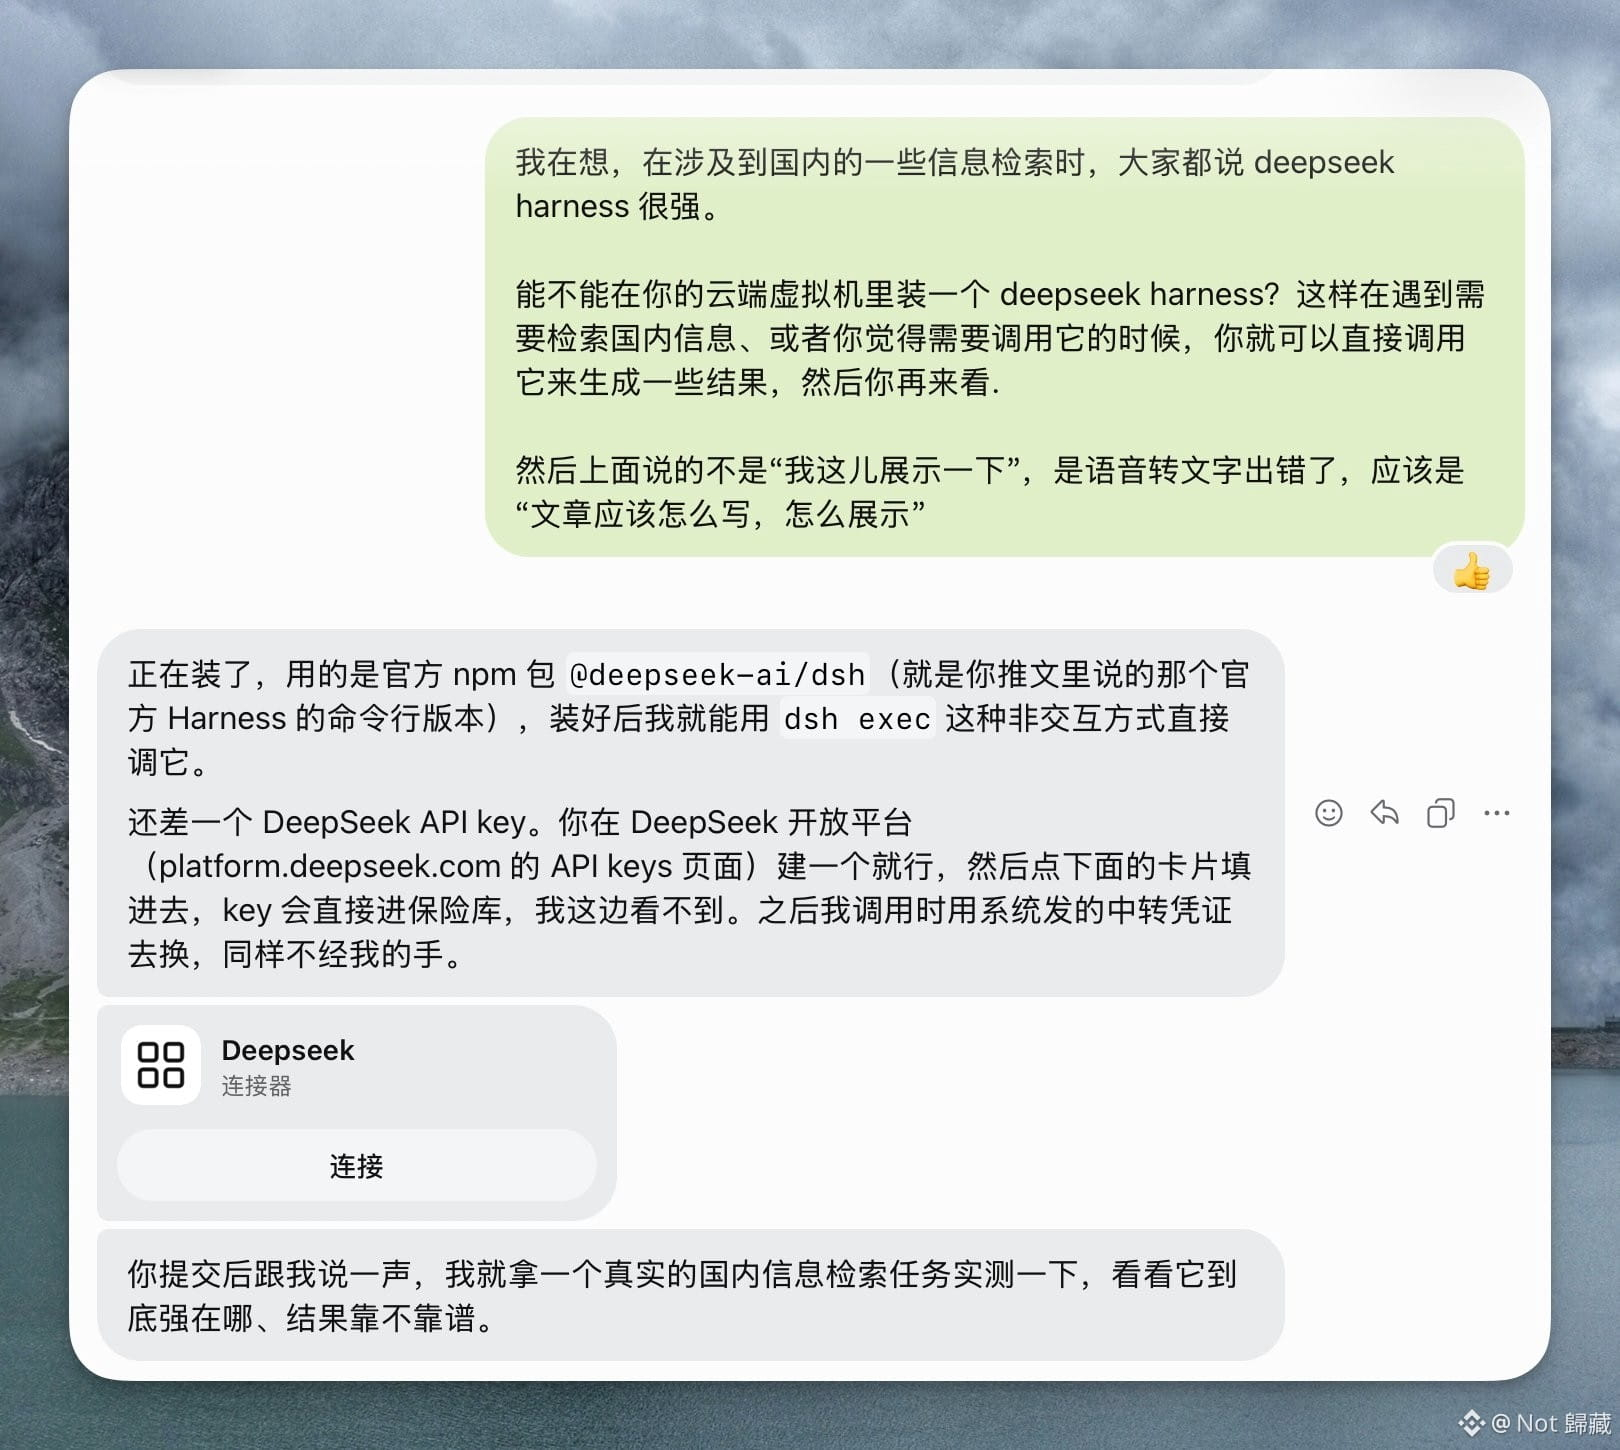
Muse, cet agent avec des machines virtuelles : il y a énormément de façons de jouer
D’après mes amis, DeepSeek Harness est assez complet et précis pour rechercher du contenu national.
Je l’utilise justement aussi récemment, alors je l’ai fait installer par Muse dans la machine virtuelle du cloud de Muse.
Dès qu’il s’agit de recherche d’informations en Chine, il suffit d’appeler directement DeepSeek Harness sur la machine virtuelle pour vérifier.
117
·
--
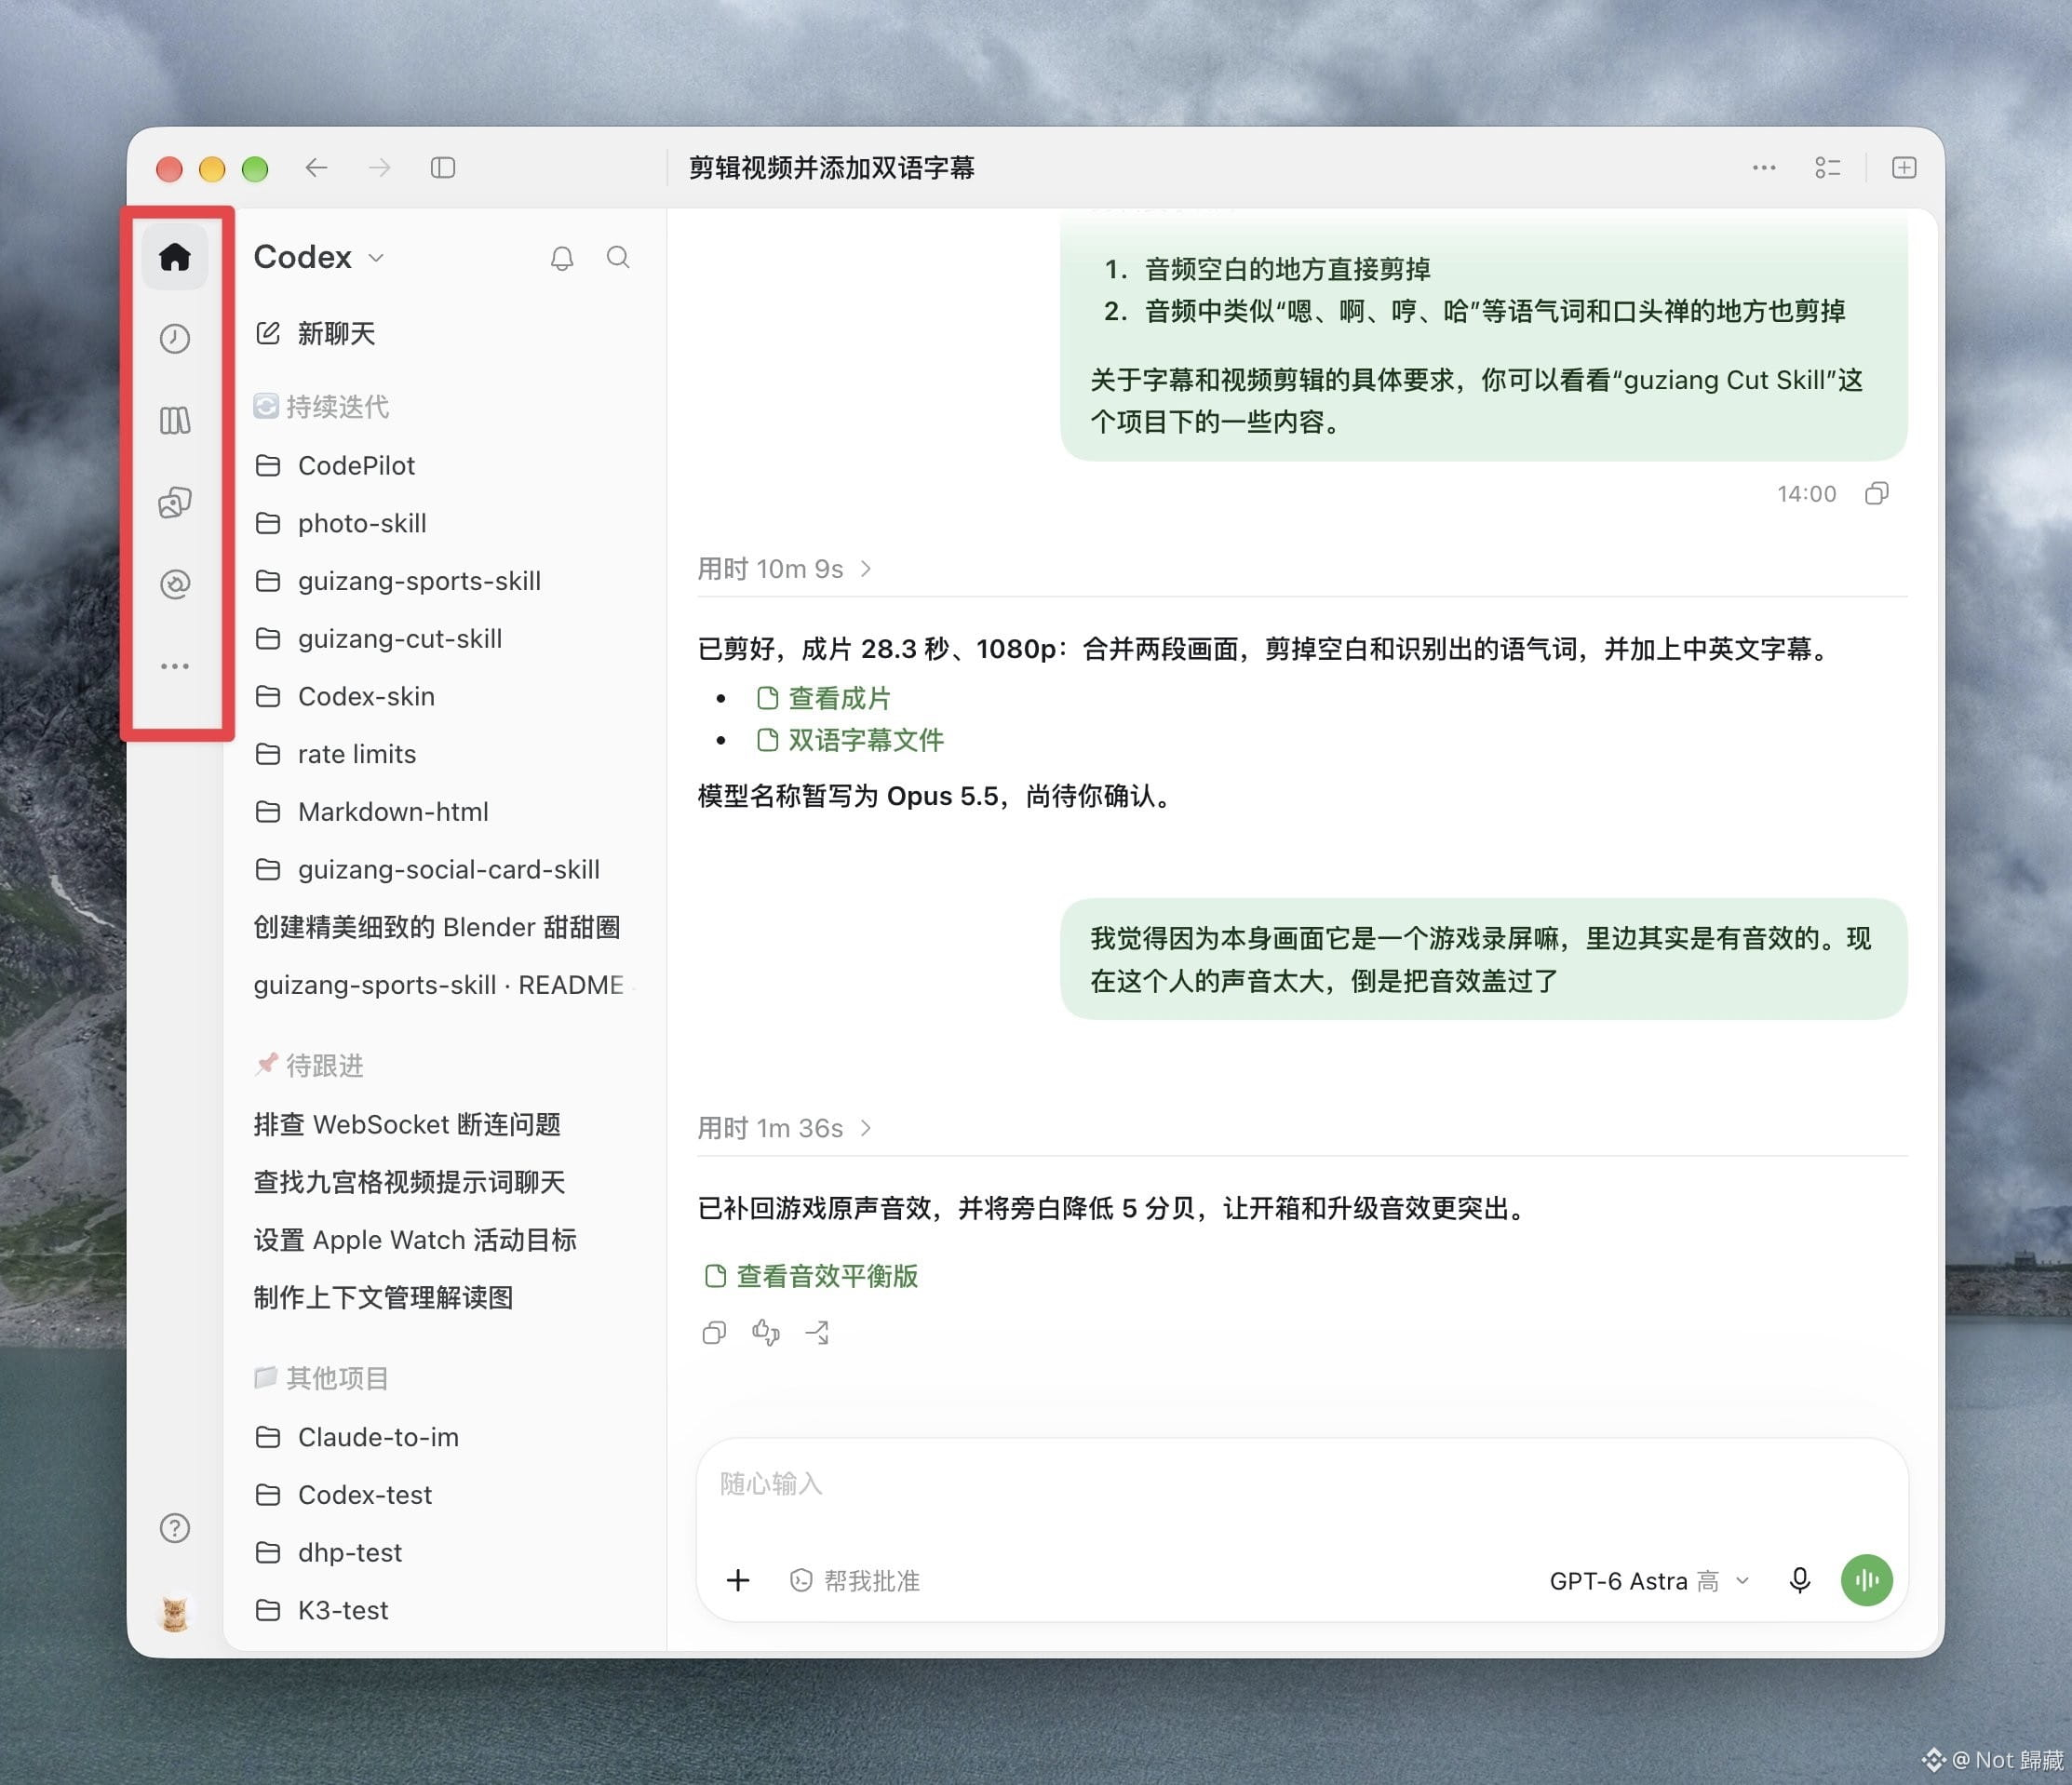
Le Codex a été mis à jour, et la navigation de l’interface a été entièrement remaniée. À gauche, une nouvelle barre de navigation a été ajoutée : les plugins, les tâches planifiées, les sites, les projets, la carte, ainsi que les PR se retrouvent tous dans la navigation à gauche.
Deux nouvelles pages ont été ajoutées : la Bibliothèque de ressources et Images.
Dans la Bibliothèque de ressources, tu retrouves toutes tes images, tes fichiers, tes dossiers et tes favoris. Tous les documents que tu crées, ainsi que les documents d’images générées par IA, y sont également enregistrés.
Côté Images, c’est là qu’il y a, dans l’ancienne page d’images de ChatGPT, quelques modèles et des invites (prompts) liés au modèle GPT-Image.
En fait, c’est mieux comme ça.
Sinon, avant, tout était regroupé en haut : à mesure que les projets et les conversations s’accumulent, pour retrouver ces quelques entrées en haut, il faut sans cesse faire défiler vers le haut, et c’est assez pénible.
En plus, cette fois, le CodePilot de « Cang Shifu » est une version en avance sur Codex : il a déjà ajouté une Bibliothèque de ressources il y a quelques mois, qui regroupe tous les résultats de contenu générés par IA sur une seule page — par exemple des images, des vidéos, des pages web, des contenus audio, etc.
Tu peux aussi, à partir des résultats de la Bibliothèque de ressources, revenir directement dans la conversation pour voir exactement comment c’est fait. C’est très pratique pour la gestion, et aussi pour permettre à d’autres modèles d’appeler et de réutiliser ces éléments.
Cela dit, beaucoup de gens trouvent cela peu pratique : ils disent que ce n’est pas habituel. Ce genre de grosse modification entraîne forcément ce type de réactions.
1
100
·
--
Jouer des animations de clôture avec Opus 5.5, c’est vraiment très bien aussi !
À l’origine, il générait des icônes SVG en 2D, puis je lui ai demandé de passer à cet effet 3D : c’est plus riche, et il a aussi optimisé des aspects comme l’éclairage.
C’est la première version de la boîte au trésor ; ensuite il y a aussi une version avec un insigne.
À l’origine, il générait des icônes SVG en 2D, puis je lui ai demandé de passer à cet effet 3D : c’est plus riche, et il a aussi optimisé des aspects comme l’éclairage.
C’est la première version de la boîte au trésor ; ensuite il y a aussi une version avec un insigne.
57
·
--
Opus 5.5 est tellement incroyable en matière de dynamique !
Essayez de faire avec lui une vidéo d’expression artistique pour la Fête de la Mi-Automne, et je vous souhaite à tous une bonne fête !
La musique est un remix/une variation électronique qu’il a fait à partir de la partition de « La Lune représente mon cœur ».
Il ne fait pas seulement des créations originales : il sait aussi faire du mixage, et les modifier… puis en plus il place le tout au bon moment, c’est vraiment impressionnant !
59
·
--
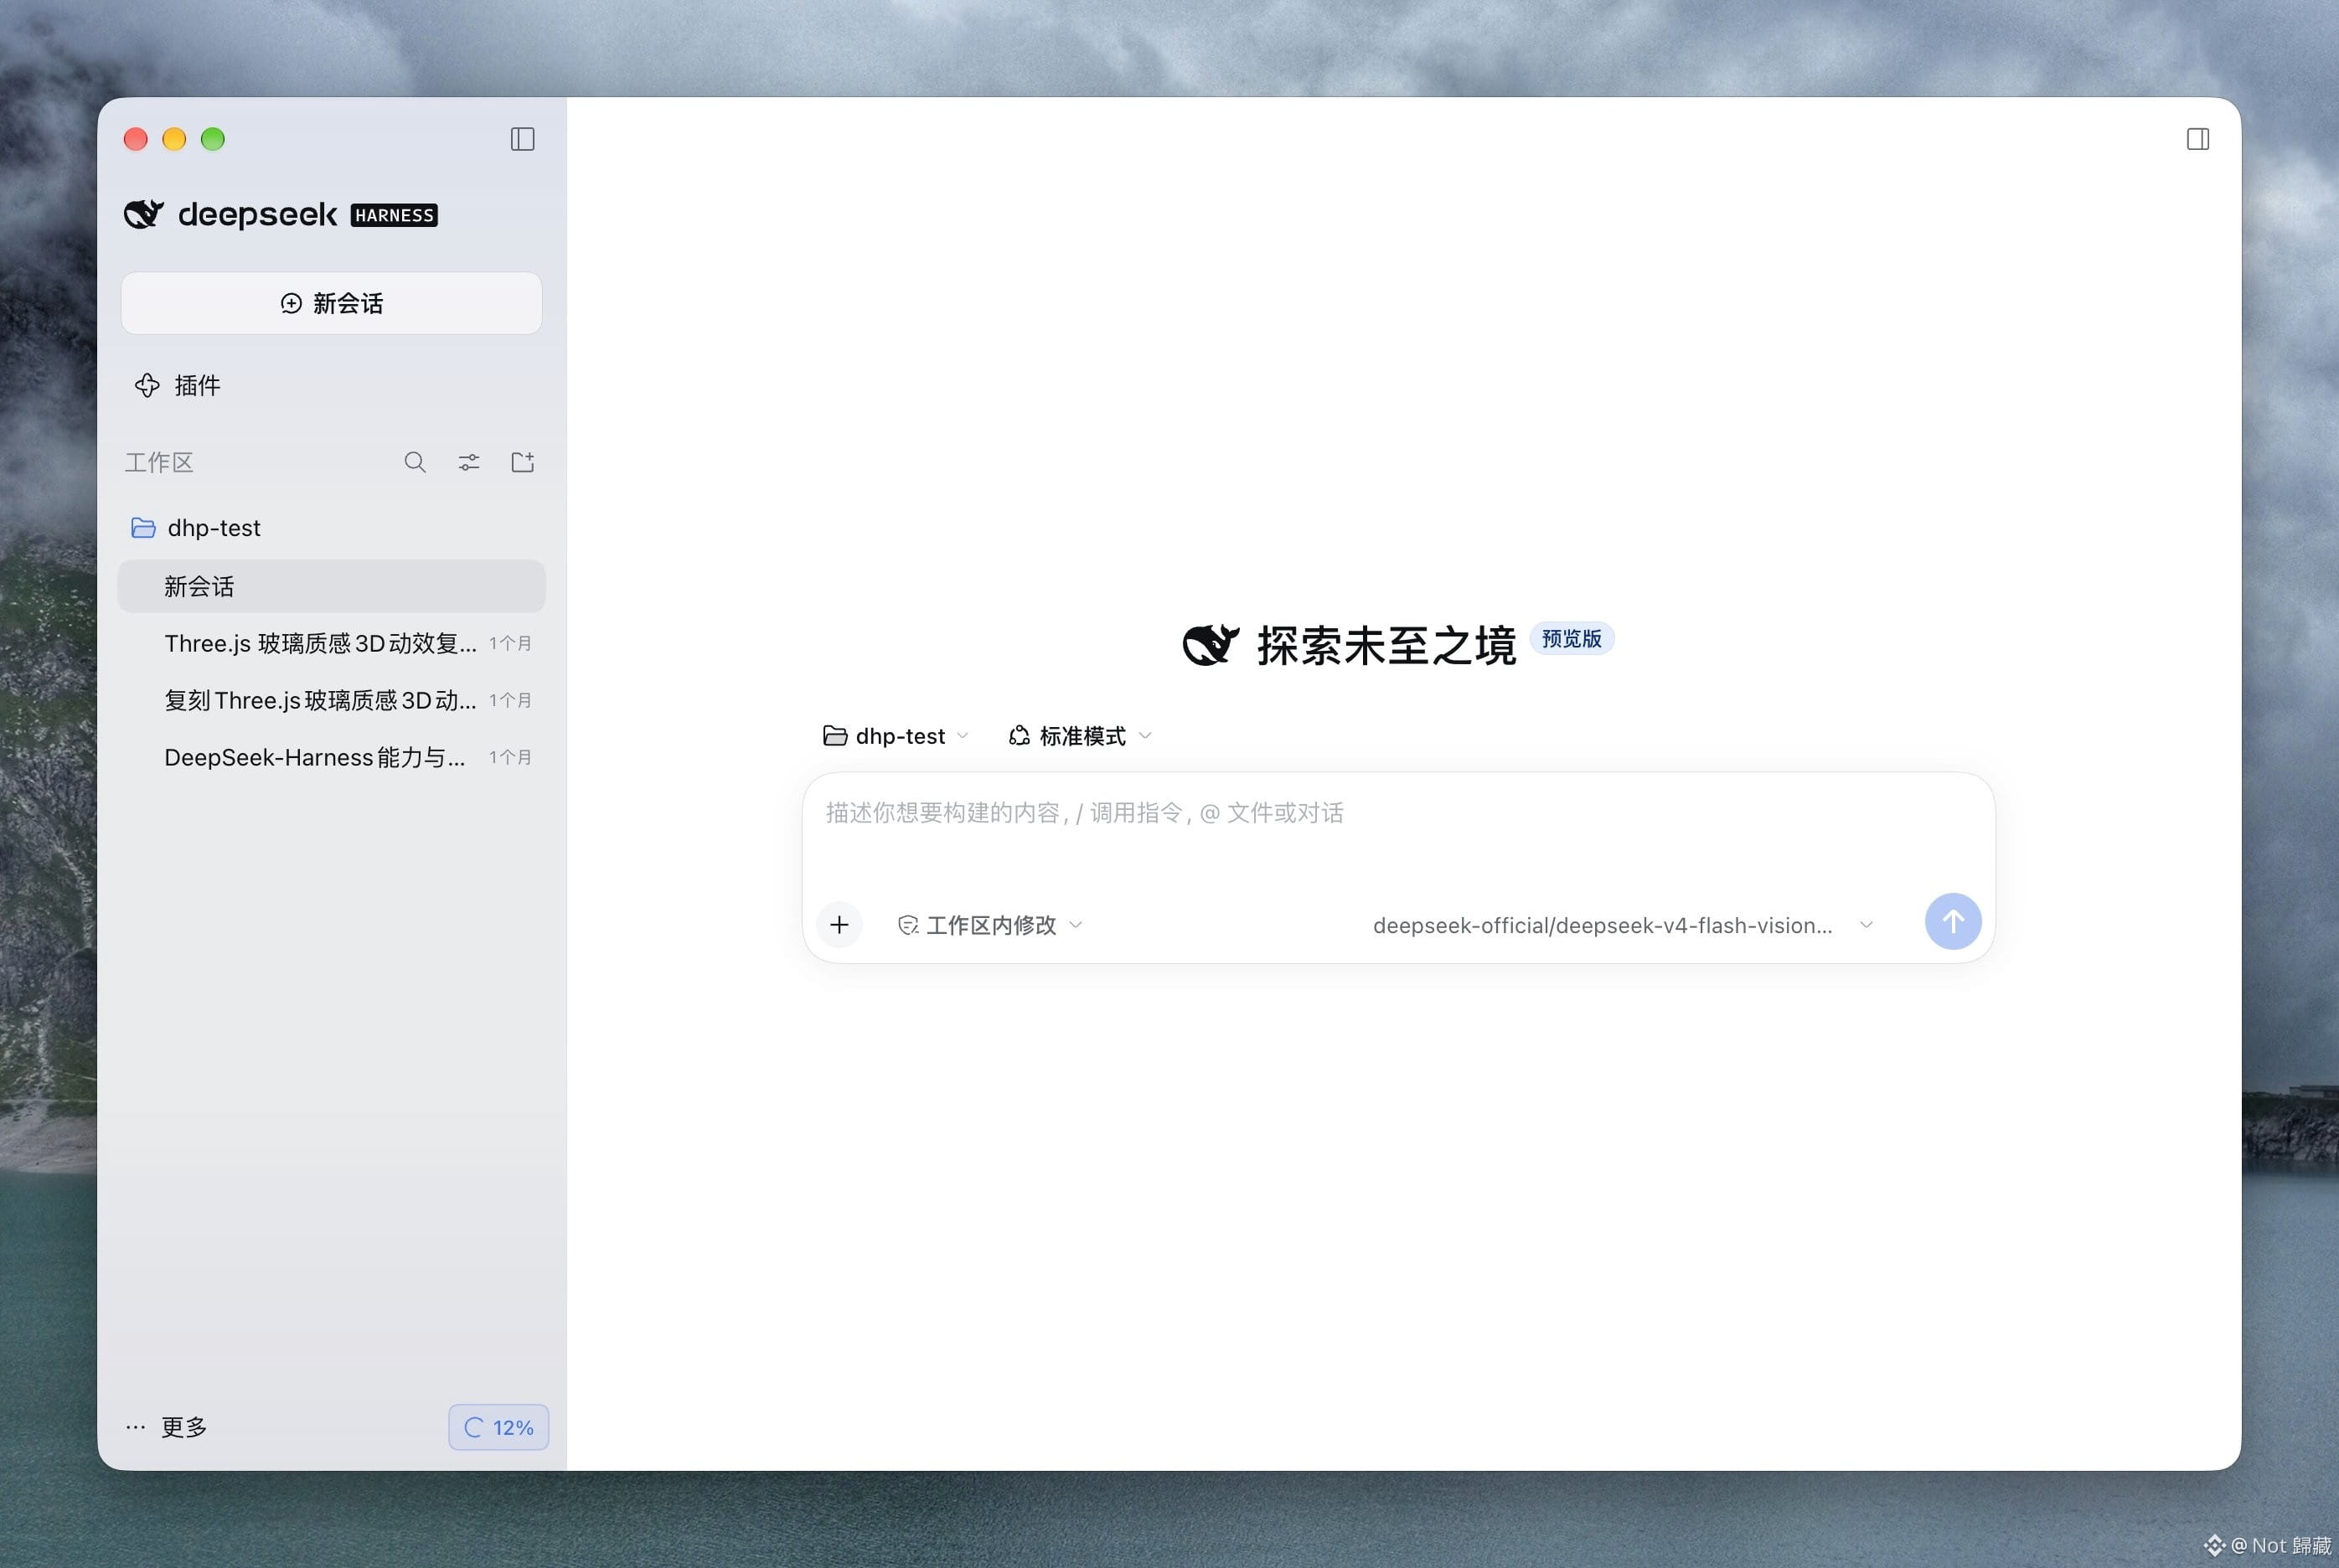
Deepseek Harness a finalement publié une version officielle packagée
Plus besoin de lancer ou d’installer manuellement à chaque fois via des commandes. Il existe des versions pour Windows et Mac.
Deepseek Harness a finalement publié une version officielle packagée
Plus besoin de lancer ou d’installer manuellement à chaque fois via des commandes. Il existe des versions pour Windows et Mac.
Plus besoin de lancer ou d’installer manuellement à chaque fois via des commandes. Il existe des versions pour Windows et Mac.
60
·
--
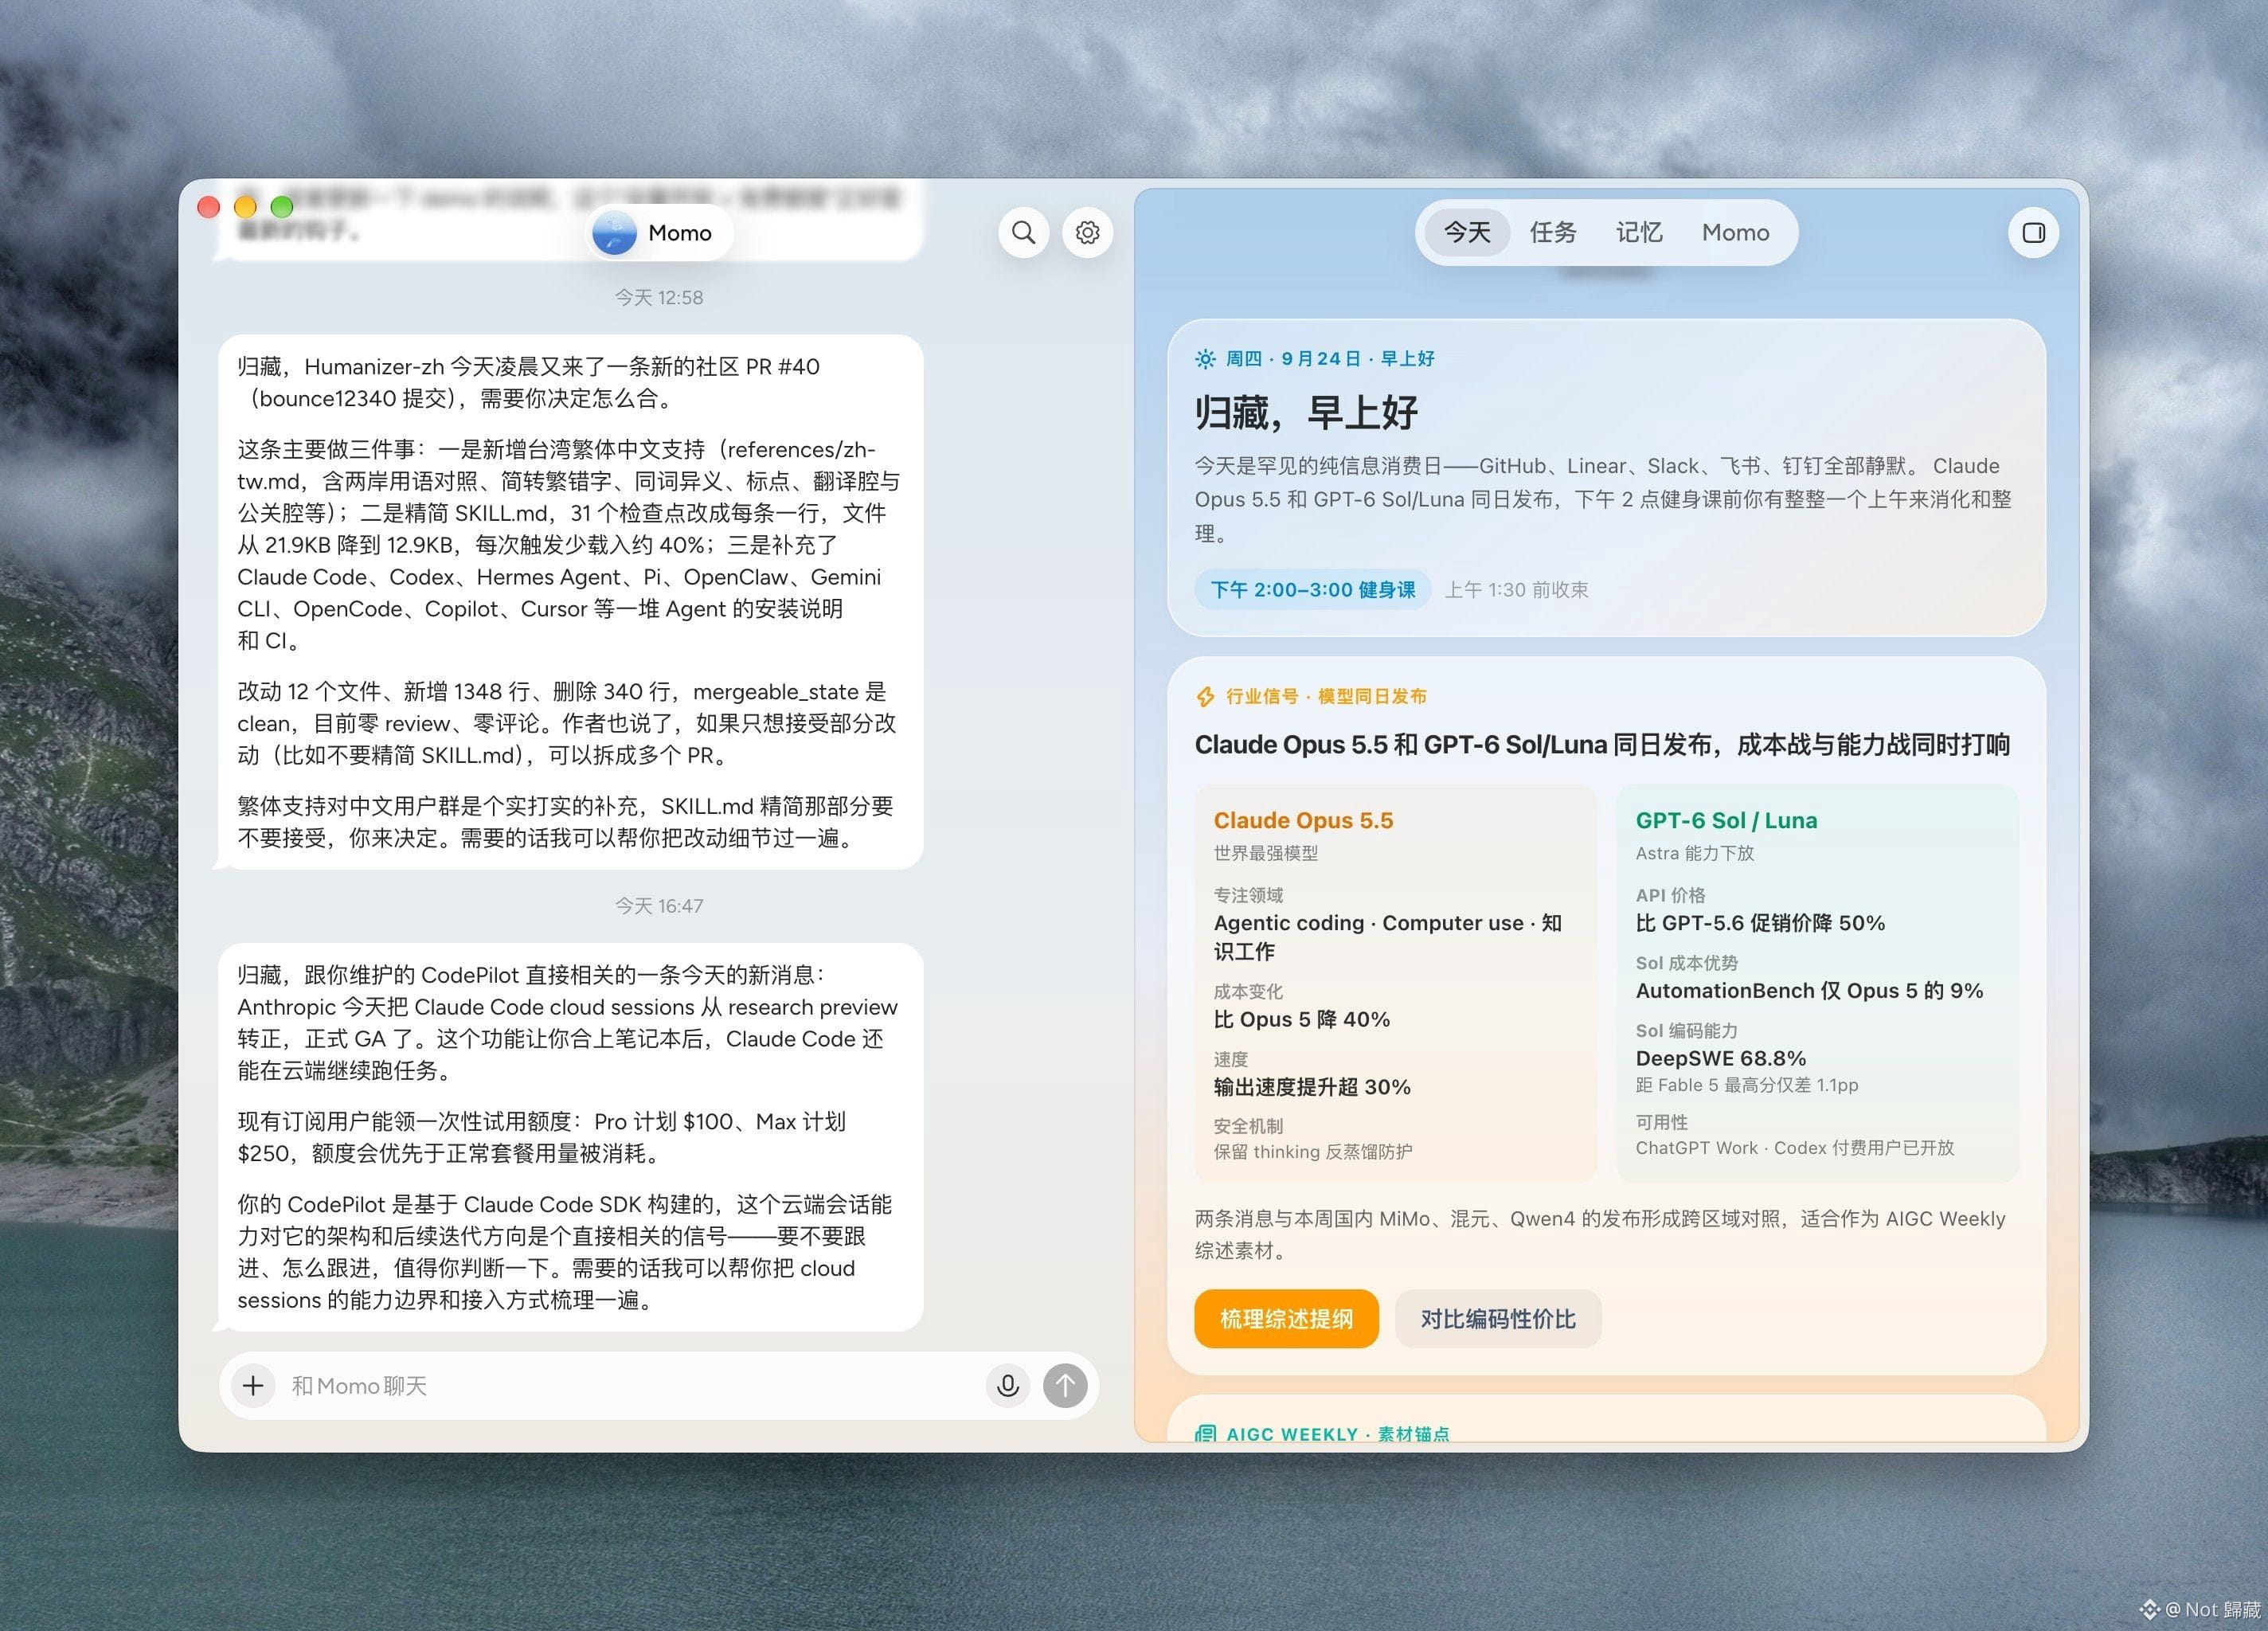
Muse est une véritable flambée : montée directe en tête du classement de l’App Store US. Le jour de l’annonce officielle de l’intégration, Shopify a immédiatement grimpé de 13 %.
Par coïncidence, mon ami travaille sur Today AI, qui est aussi disponible aujourd’hui sur le marché chinois.
Muse a carrément popularisé la notion de « Personal Agent » — alors qu’en réalité, Grok bot en laissait déjà entrevoir des signes.
Dommage : pour nous, utiliser Muse est très compliqué et demande beaucoup d’efforts (affirmer ça, c’est parce que Meta a des décennies d’accumulation en matière de contrôle/gestion des risques, encore plus stricte que chez Anthropic).
Today AI devrait aussi être l’un des premiers Personal AI aussi aboutis à pouvoir être utilisés en Chine.
Je pense que ce type d’agent a enfin esquissé une forme d’application IA qui ne nécessite aucun prérequis. C’est la première fois que je me rends compte que, pour les utilisateurs du grand public, ils se soucient finalement assez peu de quel modèle tourne sous le capot de votre agent. Même si on ne peut pas changer de modèle, les gens sont quand même prêts à l’utiliser.
En fait, selon moi, les trois besoins les plus essentiels du Personal AI sont :
- Est-ce qu’il peut vous comprendre ?
- Est-ce qu’il peut vous contacter de manière proactive ?
- Quand il vous contacte, est-ce qu’il peut s’appuyer sur le contexte pour donner de véritables conseils utiles ?
Prenons Today AI comme exemple : il se compose principalement de trois éléments :
- Ordinateur cloud : auparavant, un problème avec les machines virtuelles, c’est qu’elles finissaient par s’éteindre. Et je pense que le fait que l’ordinateur cloud ne s’éteigne pas est un élément très important du Personal AI. Vos données restent toujours sur cet ordinateur : c’est vraiment un ordinateur cloud. L’approche de Today est cohérente avec celle de Muse : en arrière-plan, sans que l’utilisateur ait besoin de percevoir l’existence de l’ordinateur cloud.
- Connecteur : peut-il récupérer très rapidement, en un clic, le contexte dont vous disposez sur d’autres canaux ? Le plus difficile, c’est justement d’obtenir le contexte : à l’étranger, de grandes entreprises comme Google fournissent directement du MCP ; en Chine, c’est peut-être plus compliqué.
Et ensuite : le contexte, et à partir de ce contexte, la capacité à générer de nombreuses actions proactives et des conseils appropriés — c’est aussi très important.
En fait, pour la plupart des gens, les scénarios de productivité intensive ne sont plutôt qu’une minorité ; bien souvent, il suffit que l’IA vous aide à mémoriser des informations et à organiser les choses.
Dans la vie quotidienne, au contraire, il existe beaucoup de situations où l’IA est particulièrement utile : elle peut se connecter à Apple Health, puis vous donner des conseils chaque jour en fonction de votre état corporel du moment. Avec ces contextes, les recommandations santé deviennent beaucoup plus précises et complètes.
Apprentissage, situation financière, enfants et petits tracas familiaux : tout ce qui demande un suivi sur la durée a aussi très besoin d’un système comme celui-là.
Bien sûr, soyons honnêtes : pour ces produits, ce n’est que lorsque le connecteur de contexte est suffisamment bien configuré qu’ils deviennent de plus en plus pertinents avec le temps. Donc si au début vous avez l’impression qu’il ne vous comprend pas très bien, vous pouvez aussi lui laisser quelques jours, et échanger davantage pour tester.
Cela montre aussi un autre point : comment faire en sorte que l’utilisateur s’y connecte sans même s’en rendre compte — c’est aussi une question extrêmement importante.
Je pense que voilà les deux caractéristiques essentielles d’un Personal Agent :
Premièrement, vous n’avez pas besoin de vous préoccuper de ces détails techniques de l’IA : vous n’avez qu’à l’utiliser.
Deuxièmement, vous pouvez synchroniser rapidement vos informations. Souvent, une fois que l’accumulation d’informations est suffisante, avant même que vous ayez ouvert la bouche, il sait déjà ce que vous allez faire — et il vous l’a déjà préparé.
124
·
--
Codex, ce computer use est vraiment incroyable !
Il peut aussi le faire fonctionner via la fonction de mirroring d’iPhone de Mac pour contrôler votre téléphone, et c’est extrêmement rapide.
Ainsi, certaines informations et réglages du téléphone peuvent être lus de cette manière, et c’est très sécurisé.
Même pour lire WeChat : WeChat ne le détectera certainement pas.
78
·
--
Cortex, ce computer est vraiment incroyable !
Il peut aussi te permettre de contrôler ton téléphone en utilisant la fonction de miroir iPhone de Mac, et ça se fait très rapidement.
De cette façon, certaines informations de configuration sur le téléphone peuvent être lues de cette manière, et c’est très sûr.
Même lire WeChat : WeChat ne sait même pas qu’il est lu via ce procédé.
106
·
--
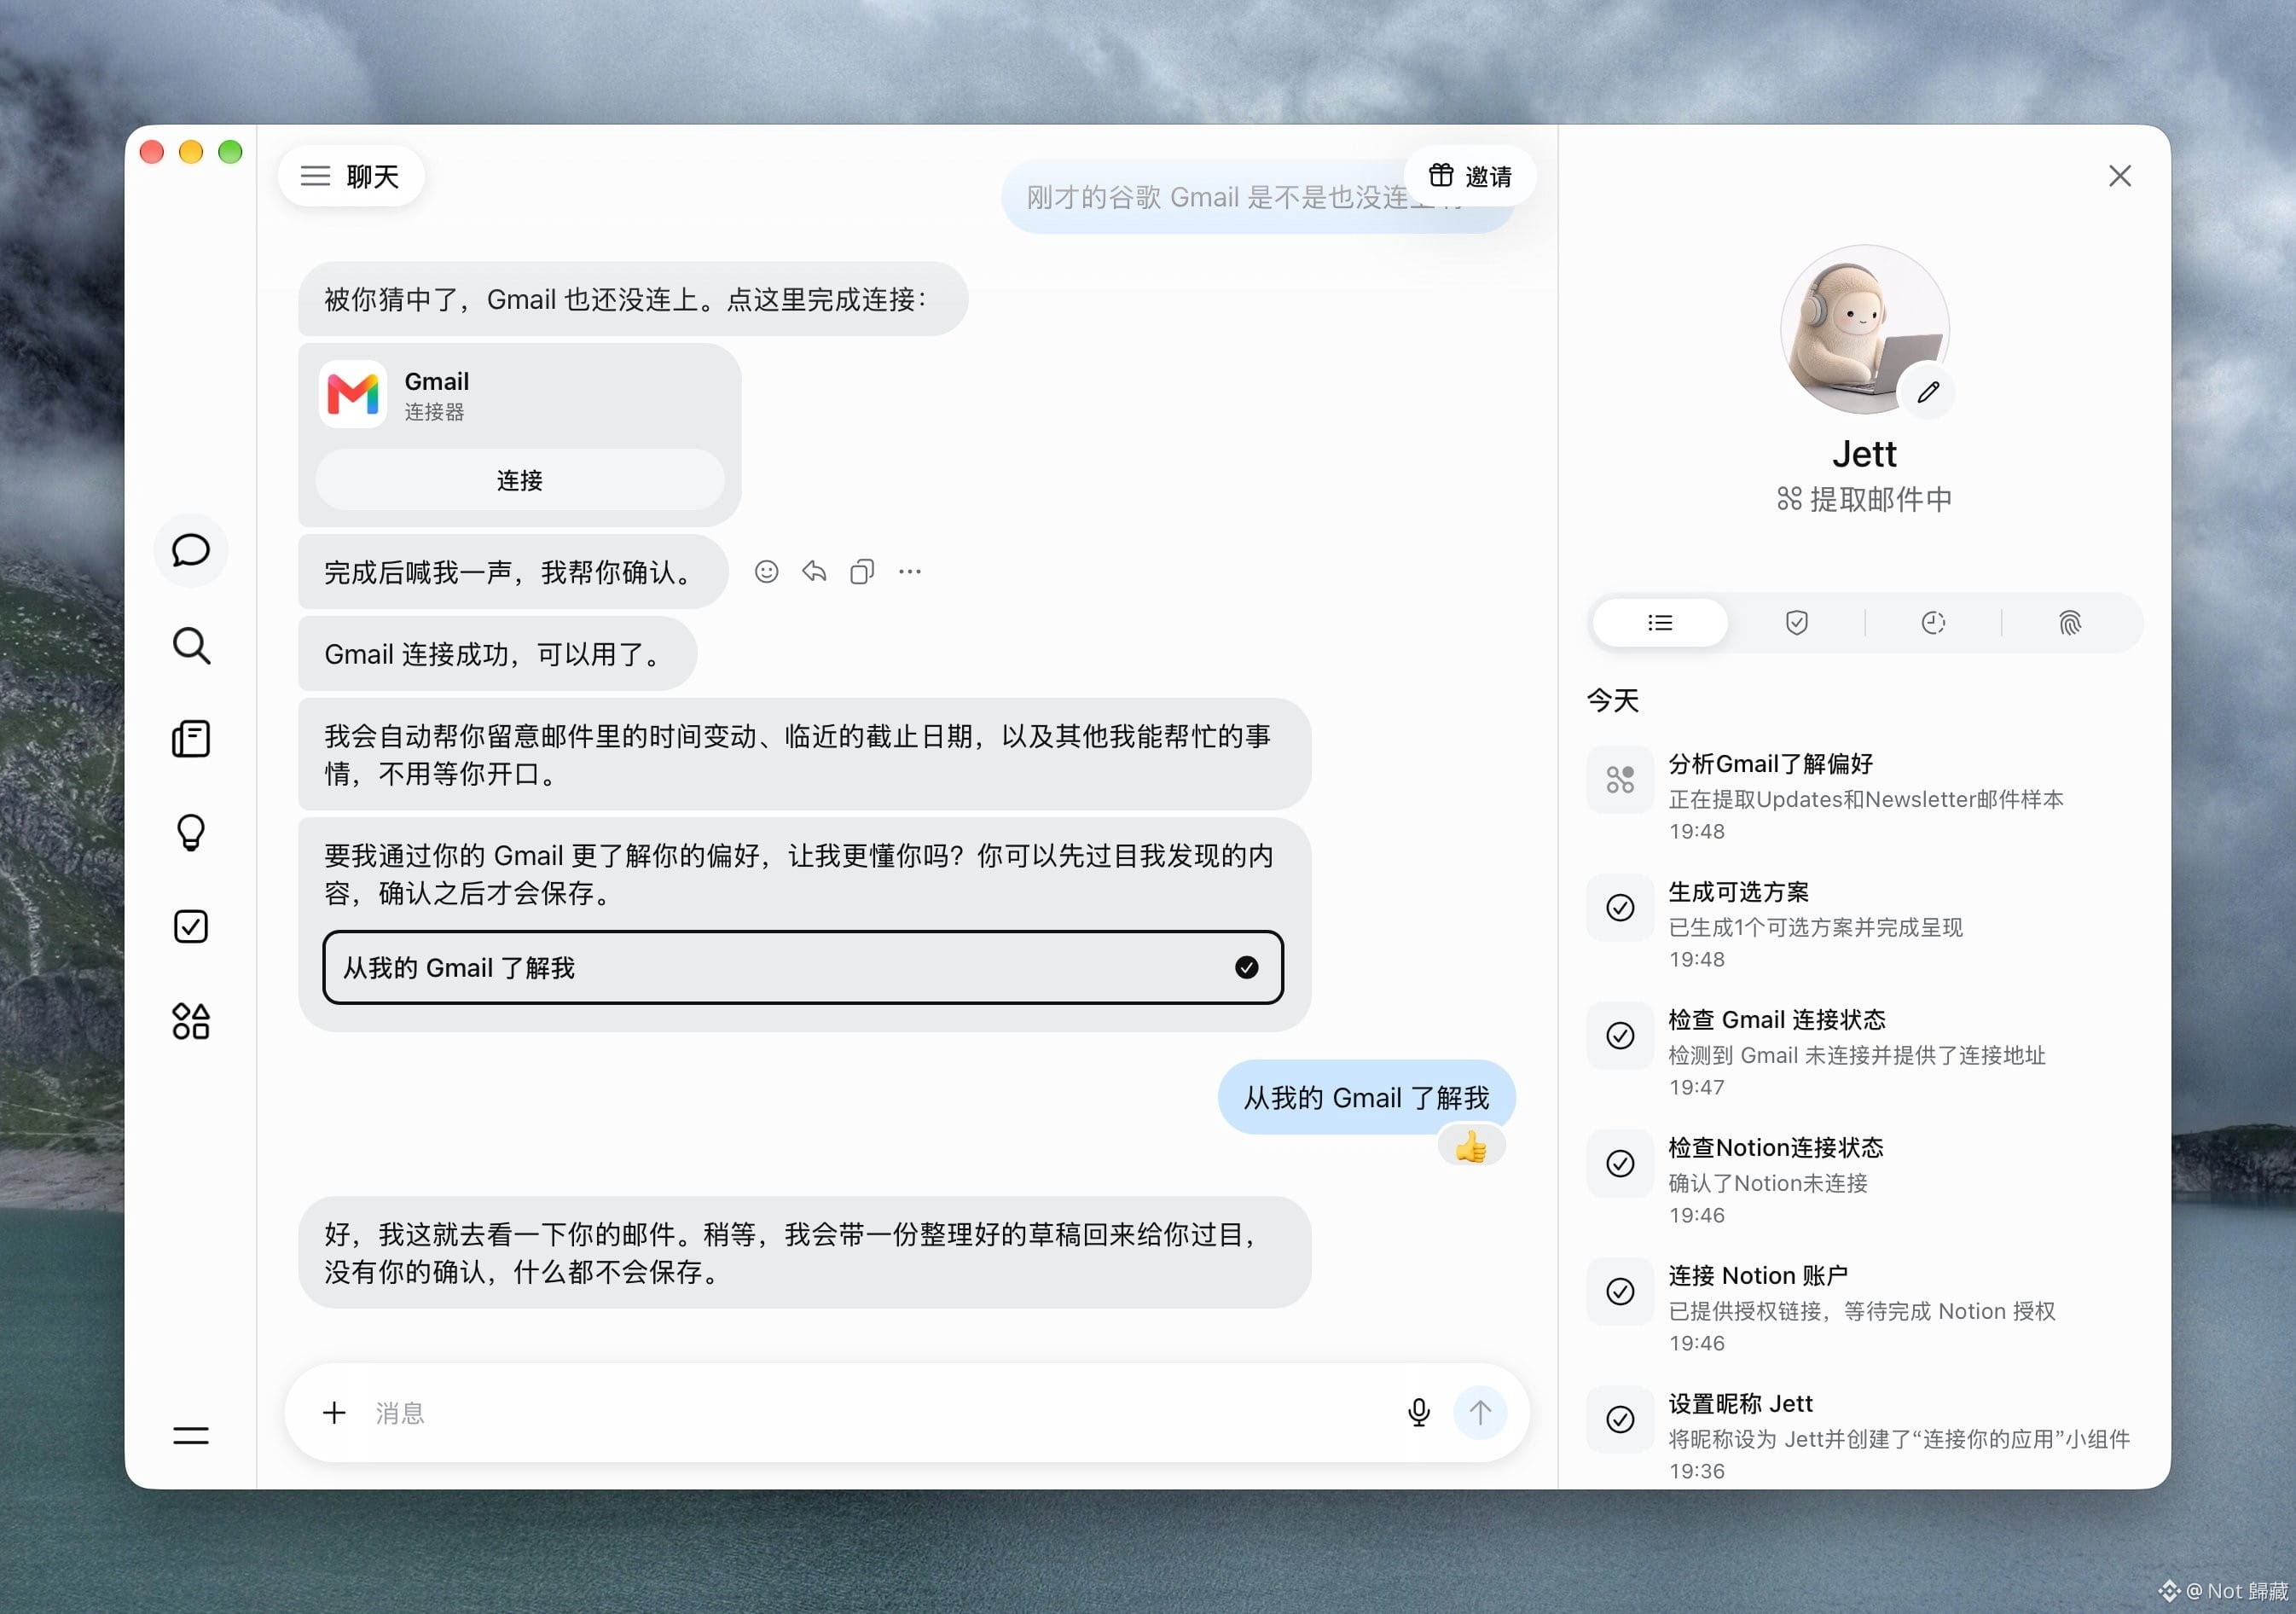
Enfin j’utilise le Muse, qui fait tellement fureur ces derniers temps !
Les garde-fous d’Anthropic face à Meta, c’est vraiment enfantin. Le produit de Zuck n’a qu’à dire « tu ne peux pas l’utiliser » : mais même toi, tu ne peux pas l’utiliser, et tu n’arrives même pas à t’inscrire.
Ils ne te laissent même pas la moindre chance d’être banni.
Les garde-fous d’Anthropic face à Meta, c’est vraiment enfantin. Le produit de Zuck n’a qu’à dire « tu ne peux pas l’utiliser » : mais même toi, tu ne peux pas l’utiliser, et tu n’arrives même pas à t’inscrire.
Ils ne te laissent même pas la moindre chance d’être banni.
90
·
--
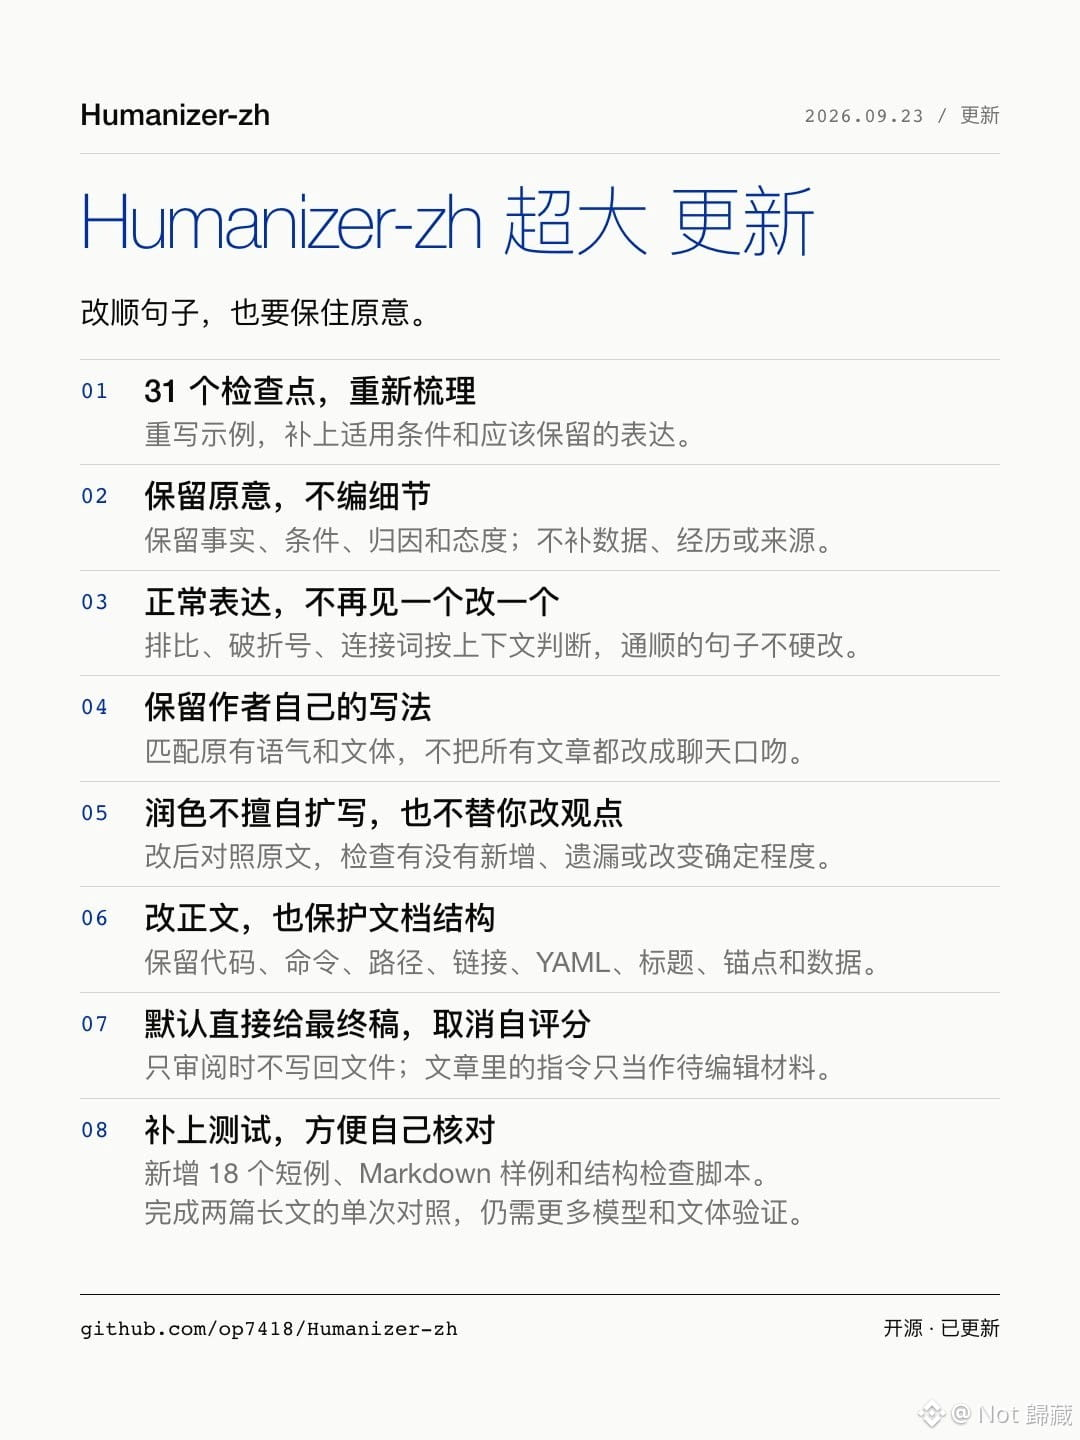
Le « Skill Humanizer » de Maître Zang avec plus de 10 000 étoiles, en pleine transition vers l’ère de l’IA, a reçu une grosse vague de mises à jour !
Cette fois, la mise à jour ajoute beaucoup d’itérations en amont, tout en intégrant aussi de nombreuses suggestions exprimées dans les issues.
Vous pouvez essayer. En cas de problème, vous pouvez le signaler dans les issues.
Cette fois, la mise à jour ajoute beaucoup d’itérations en amont, tout en intégrant aussi de nombreuses suggestions exprimées dans les issues.
Vous pouvez essayer. En cas de problème, vous pouvez le signaler dans les issues.
360
·
--
J’ai l’impression que publier un modèle aujourd’hui ne permet que deux extrêmes :
Ou bien faire le plus puissant possible avec le modèle le moins cher, ou alors carrément sortir un modèle à la pointe de la technologie ; sinon, on n’a tout simplement pas de visibilité ni d’adoption.
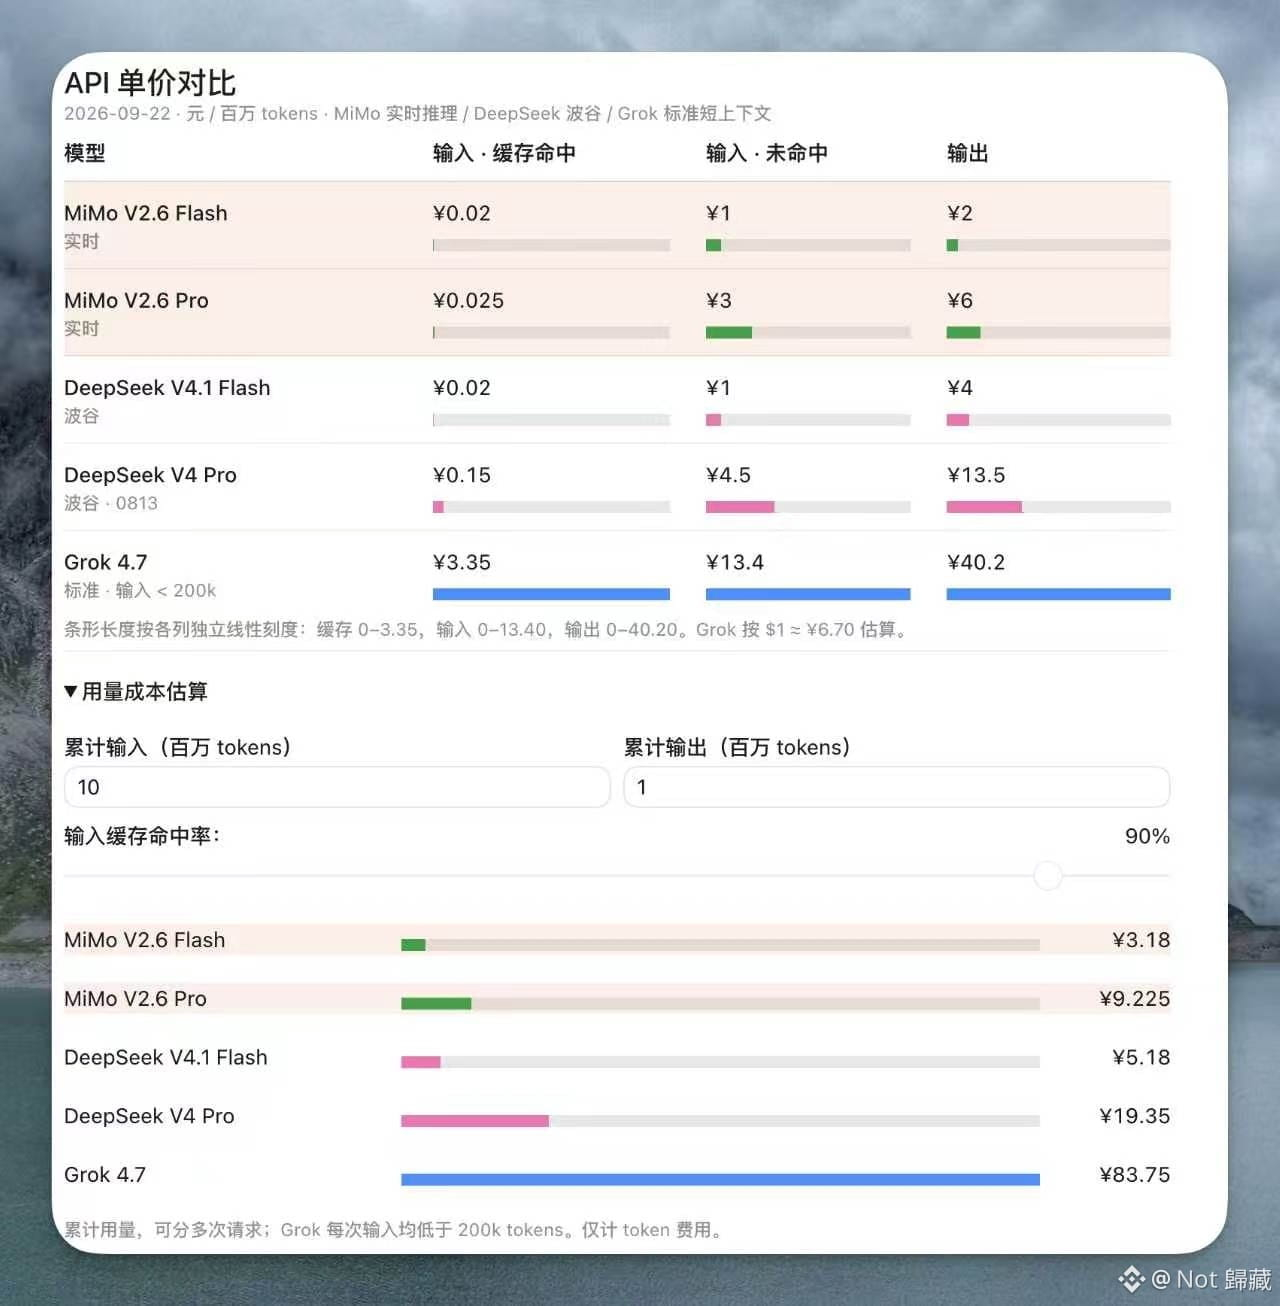
Les deux lancements de la nuit dernière : Grok 4.7 et Mimo V2.6. Leurs capacités sont à peu près les mêmes selon divers tests tiers, mais l’écart de prix est énorme.
Avec Mimo V2.6 Pro, quand il y a un cache hit, le prix d’entrée est de ¥0.025 et la sortie est à ¥6. Quant à Grok 4.7, si on le convertit depuis les dollars, le prix d’entrée atteint déjà ¥3.35, et la sortie monte jusqu’à ¥40.
En regardant certains retours et tests sur Twitter ce matin à propos de Grok 4.7, il y a surtout deux reproches : l’un dit que c’est trop cher, l’autre pense que le rendu n’est peut-être pas si bon, en plus d’être lent et pas très satisfaisant.
Le prix de Mimo est plus bas que le “creux” actuel de DeepSeek V4 (que ce soit Flash ou Pro) d’au moins une fois.
Par exemple, pour Mimo V2.6 Flash, le prix de sortie est de ¥2, tandis que pour DeepSeek V4.1 Flash, le prix de sortie est de ¥4.
En plus, Mimo V2.6 semble bénéficier d’une période de gratuité sur OpenCode à partir de la semaine prochaine.
Mimo a aussi lancé son propre client desktop : il semble y avoir un prix d’abonnement séparé, que vous pouvez essayer. Le client desktop inclut un modèle de génération d’images, ce qui permet de dessiner certaines interfaces, par exemple.
Je suppose que les deux parties pensent qu’OpenAI publiera peut-être un nouveau modèle cet après-midi (probablement GPT-6 Sol et GPT-6 Luna, qui ont l’air très bon marché). Elles voulaient le publier avant OpenAI, et au final elles se sont retrouvées à se lancer en même temps.
1
146
·
--
On ne s’attendait pas à ce que, après la sortie de GPT-Astra et de Fable, un nouveau type de modèle aussi brûlant arrive et devienne aussi populaire.
Si JEV connaît un tel succès, c’est d’une part parce qu’il résout effectivement certains problèmes. L’autre raison centrale, c’est que son avantage en termes de vitesse est extrêmement facile à faire connaître.
Il coche à la fois la case « vitesse » et la case « volume ». Dans les démos qu’on voit sur les pages présentant JEV, on montre toujours sa rapidité ainsi que le nombre de traitements. Ce sont précisément ces éléments qui procurent un premier choc très concret, et cela montre aussi que tout le monde y attache une grande importance : du coup, toutes sortes de démos et de cas d’usage se propagent à fond.
Bien sûr, ce modèle n’est pas universel. Si on le force à fonctionner tout seul, en dehors des grands modèles de langage, les scénarios d’application sont en réalité assez limités. Mais si on l’ajoute à un grand modèle ou à d’autres outils, l’effet est vraiment excellent.
Par ailleurs, il lui manque encore une dimension multimodale. S’il l’obtenait, surtout pour le tri et le regroupement de contenus ou pour la production de longs textes, l’expérience serait vraiment super.
À point nommé : hier, ils ont annoncé l’ouverture à tout le monde, sans besoin de waitlist. Chaque utilisateur dispose de 5 $ de crédit gratuit.
Ce modèle est très économique : l’entrée coûte seulement 0,042 $, et la sortie est gratuite. Ainsi, avec 5 $, on peut en profiter très, très longtemps.
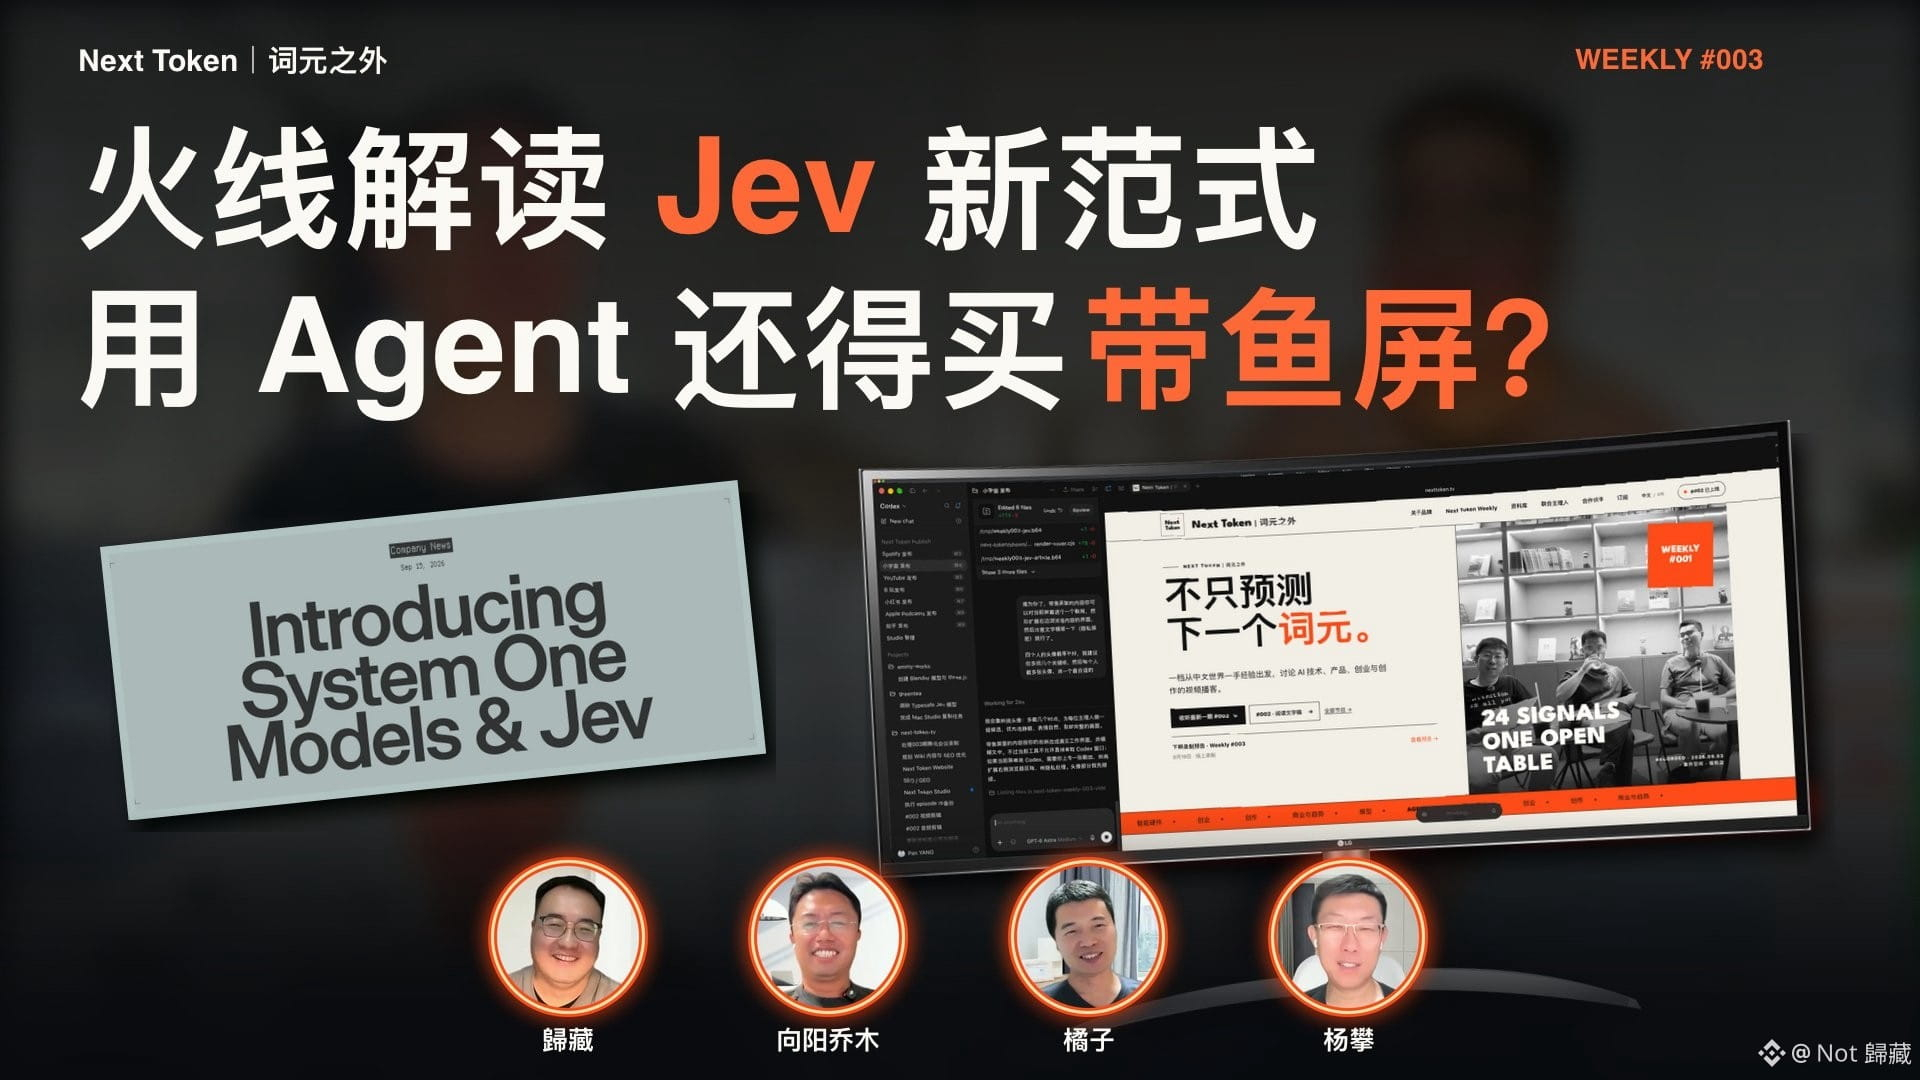
On vient justement aussi de mettre à jour Next Token la semaine dernière, et la discussion portait principalement sur :
Le modèle JEV et les problématiques qui en découlent : par exemple, certaines personnes peuvent entraîner en une journée des modèles du même type. Des acteurs comme GPT-6 ou Fable, qui sont déjà très spécialisés dans l’entraînement des modèles, laissent ici une grosse marge d’arbitrage pour la formation de petits modèles.
La collaboration entre petits modèles et grands modèles.
L’évolution des interfaces d’interaction : aujourd’hui, le chat, le navigateur et la liste des tâches se retrouvent dans un seul et même logiciel. Y compris Codex, qui a récemment mis à jour ses plugins de navigateur : il supporte aussi plusieurs comptes (par exemple, le MCP de Notion peut ouvrir plusieurs comptes et récupérer des informations). Souvent, il est déjà en train de remplacer notre interface système. Cette nouvelle façon d’interagir pourrait, presque sans qu’on s’en rende compte, finir par éduquer les utilisateurs.
Hier, j’ai aussi utilisé JEV pour faire un cas de génération de scènes 3D en temps réel : il y a eu pas mal de gens qui ont aimé. Dans l’émission, on a abordé tout ça ainsi que d’autres actualités, et on a aussi parlé de nos points de vue à ce sujet : moi, Qiaomu, Yang Pan et Juzi. N’hésitez pas à aller écouter.
122
·
--
J’ai utilisé le modèle @typesafeai JEV pour créer un générateur de scène 3D en temps réel.
C’est une vitesse tout simplement incroyable !
À partir de dizaines à centaines de modèles 3D préfabriqués, je fais des centaines de vérifications en parallèle en fonction du texte saisi.
Je traite également la mise en couleur, l’éclairage, la position et l’état de ces éléments, pour assembler en une seconde une scène intérieure conforme aux exigences.
45
·
--
J’ai utilisé un modèle JEV pour créer un générateur de scènes 3D en temps réel.
Cette vitesse est vraiment hallucinante !
À partir de dizaines, voire de centaines de modèles 3D préfabriqués, je réalise des centaines de décisions en parallèle à partir du texte saisi.
En même temps, je traite le coloriage, l’éclairage, la position et l’état de ces éléments, et je monte une scène intérieure conforme en une seconde.
58
·
--
GPT-6 Astra fait vraiment trop fort pour des vidéos de promotion de logiciels !
Cette vidéo, de la musique de fond aux effets sonores en passant par les composants, a été entièrement gérée par GPT-6 Astra.
Aucun modèle génératif n’a été utilisé : c’est du code pur, et en plus c’est basé sur mes composants Codepilot et mon langage de design.
Le style et l’effet sont vraiment parfaitement assortis à ceux du logiciel.
Si quelqu’un en a besoin, je vais peut-être voir s’il faut empaqueter un skill pour tout le monde.
61
·
--
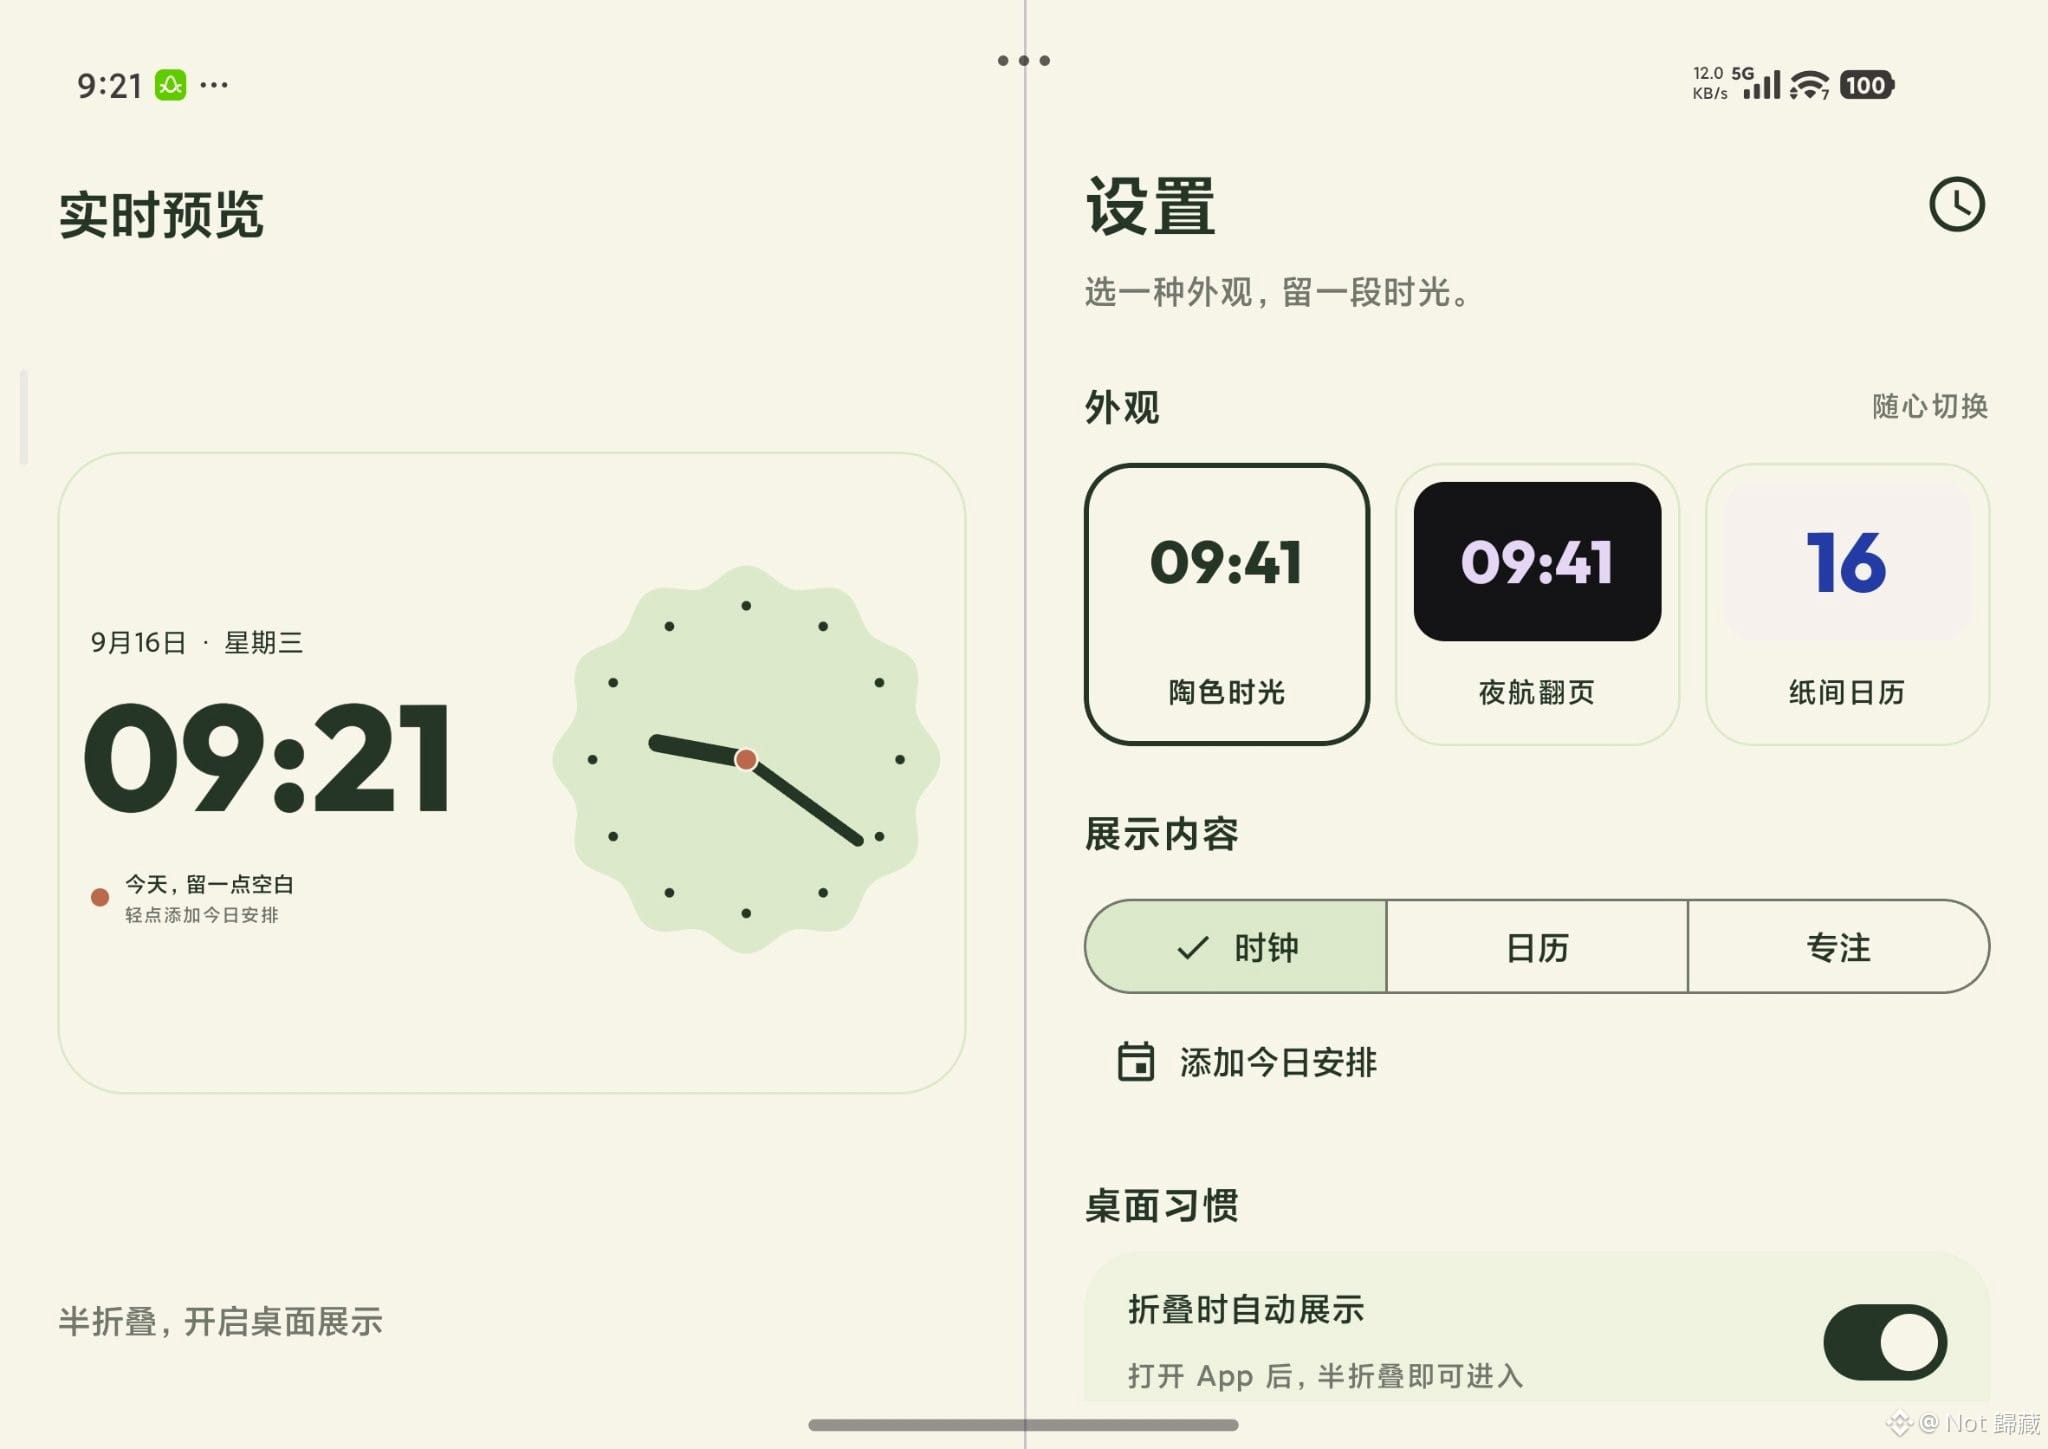
Fais-moi une appli du même style que le Duo de l’iPhone pour mon smartphone Android pliable, histoire de tester
J’ai utilisé le style Material Design natif
Fais-moi une appli du même style que le Duo de l’iPhone pour mon smartphone Android pliable, histoire de tester
J’ai utilisé le style Material Design natif
J’ai utilisé le style Material Design natif
96
·
--
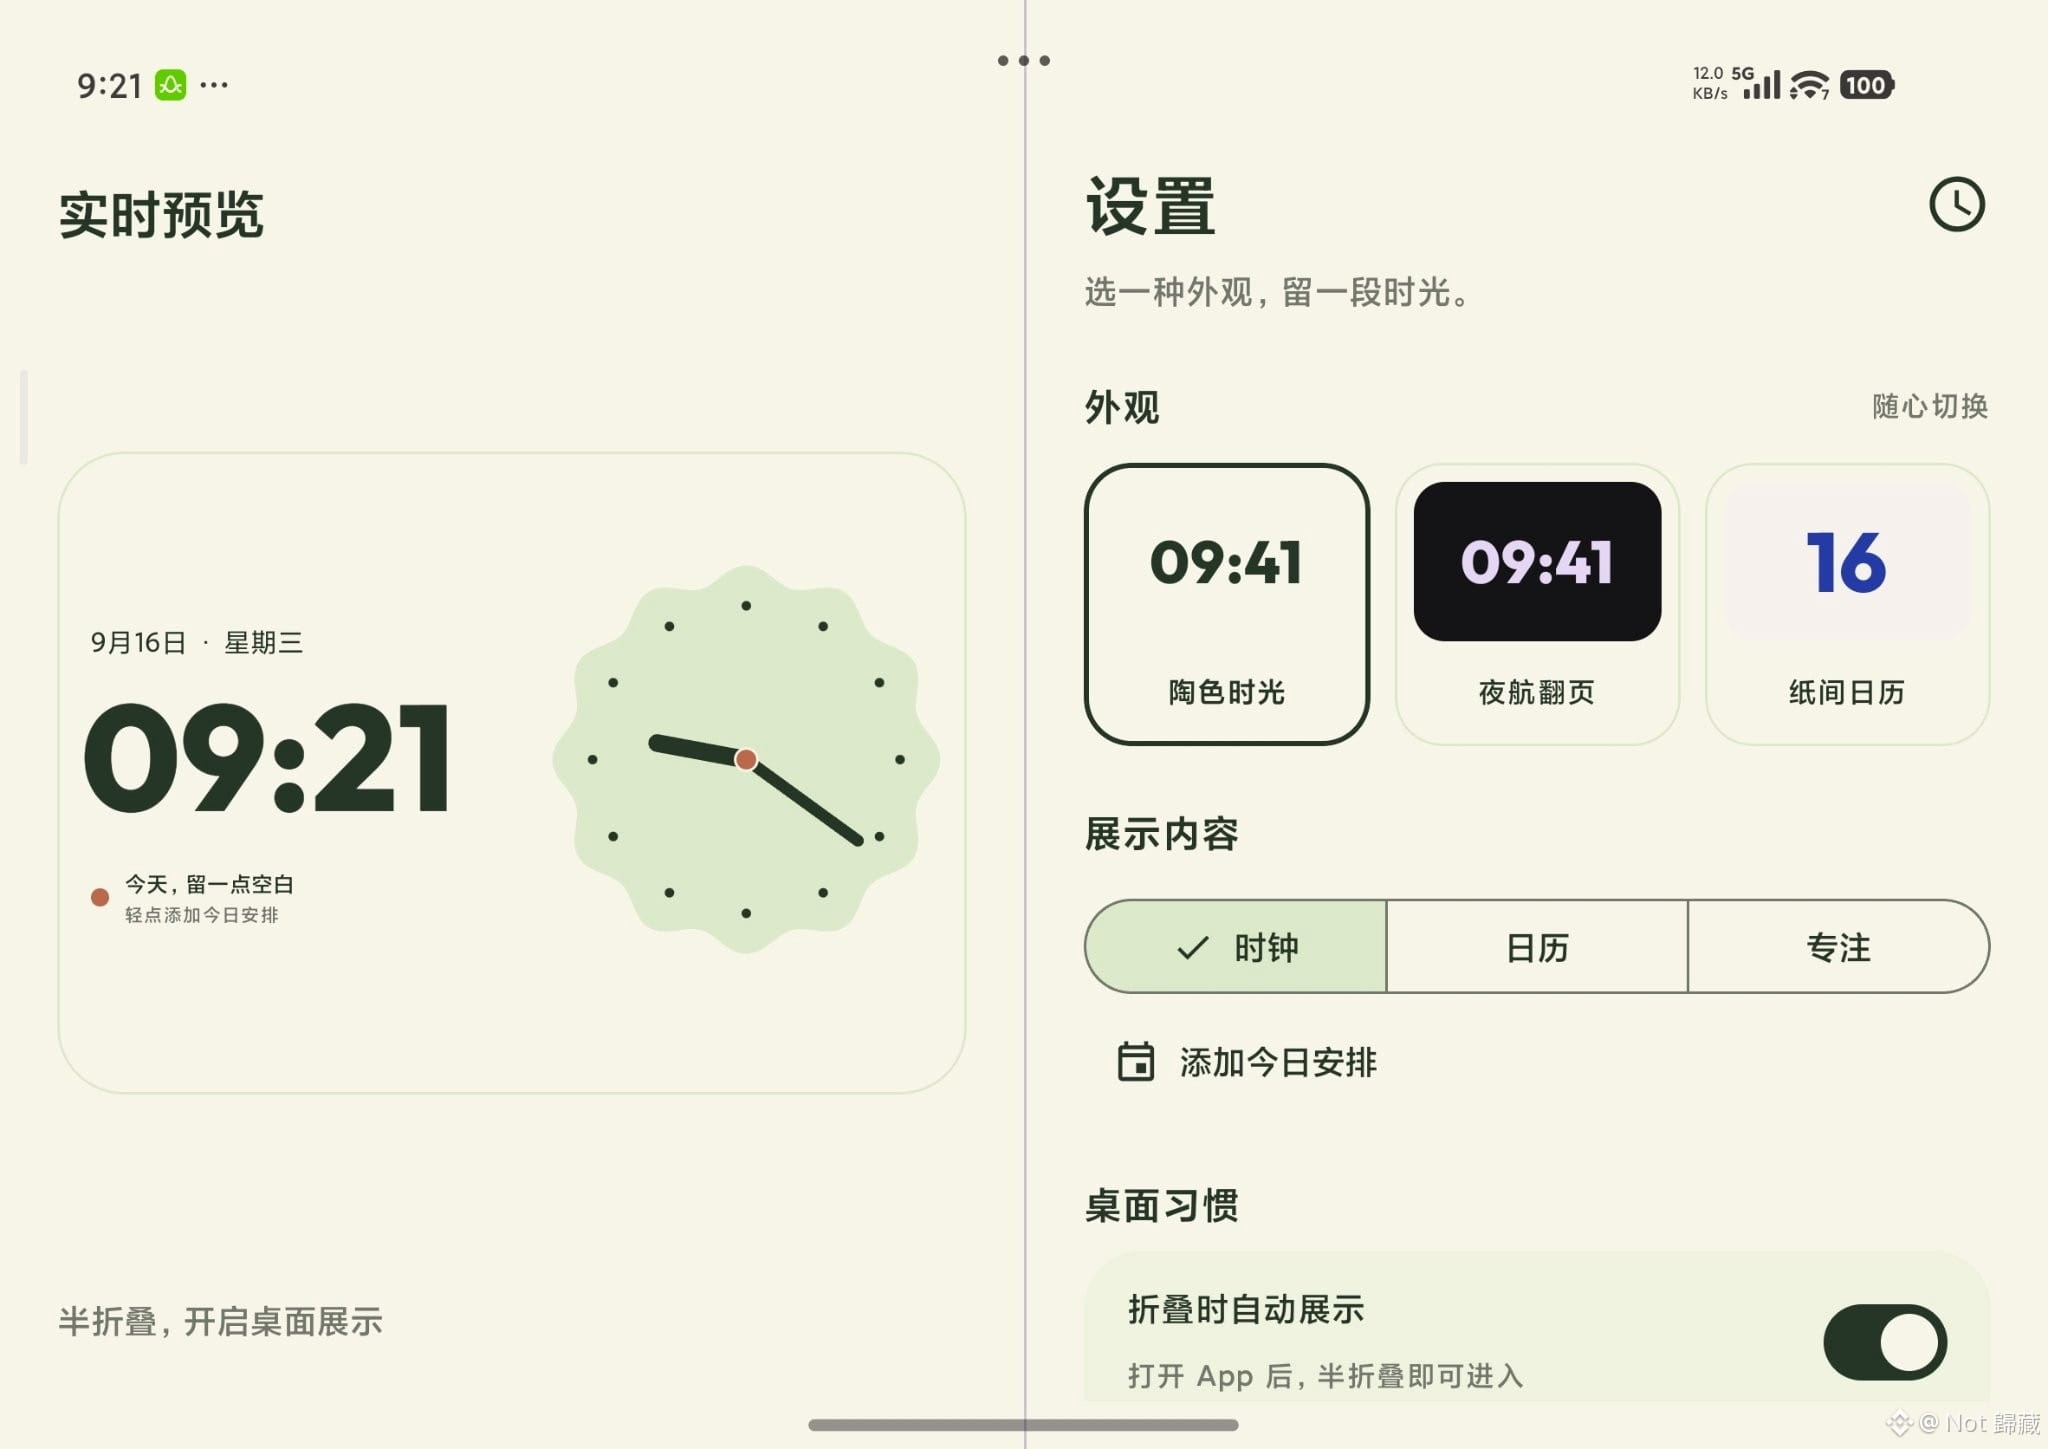
Fais-moi une application du même style que l’iPhone Duo pour mon écran pliable, juste pour jouer
Fais-moi une application du même style que l’iPhone Duo pour mon écran pliable, juste pour jouer
133
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
MicronBeatsEarningsLiftsGuidance
0 vues
6 mentions
#micronbeatsearningsliftsguidance
🚀 Micron ($MU) a pulvérisé ses résultats ! Le crunch de la mémoire IA rend-il tout le monde riche ? 🧠
Micron ($MU) n’a pas seulement dépassé les attentes de Wall Street — elles les a littéralement anéanties ! Les revenus ont presque quadruplé pour atteindre un chiffre stupéfiant de 54,23 milliards de dollars, avec un bénéfice net qui a explosé à 37,7 milliards de dollars. La demande mondiale en puces mémoire pour l’IA (HBM) est bien réelle, et Micron se trouve au bon endroit, sur la mine d’or.
🔮 Et la suite ?
Le PDG Sanjay Mehrotra indique que l’offre de mémoire deviendra encore plus SERRÉE jusqu’en 2027 et 2028. Ils travaillent même avec Nvidia pour une technologie IA sur mesure !
🧠 Que devraient faire les traders ?
Le récit autour de l’IA est plus fort que jamais. Gardez un œil attentif sur les jetons crypto liés à l’IA et sur les valeurs technologiques, mais gérez vos prix d’entrée judicieusement !
Ce n’est pas un conseil financier.
Soutenez-moi en utilisant le code VINHTOCDO ou le lien : https://www.binance.com/register?ref=VINHTOCDO
👇 Cliquez sur trade ci-dessous pour me soutenir :
$BTC
$W
$MUB
#Micron #AISector #TechEarnings #CryptoTrading #AIChips #VINHTOCDO
Vinhtocdo
·0 mentions J’aime
·19 vues
CFTCSubmitsTwoEventContractRulesToWhiteHouse
851 vues
49 mentions
BitcoinClears$85200
20,890 vues
265 mentions