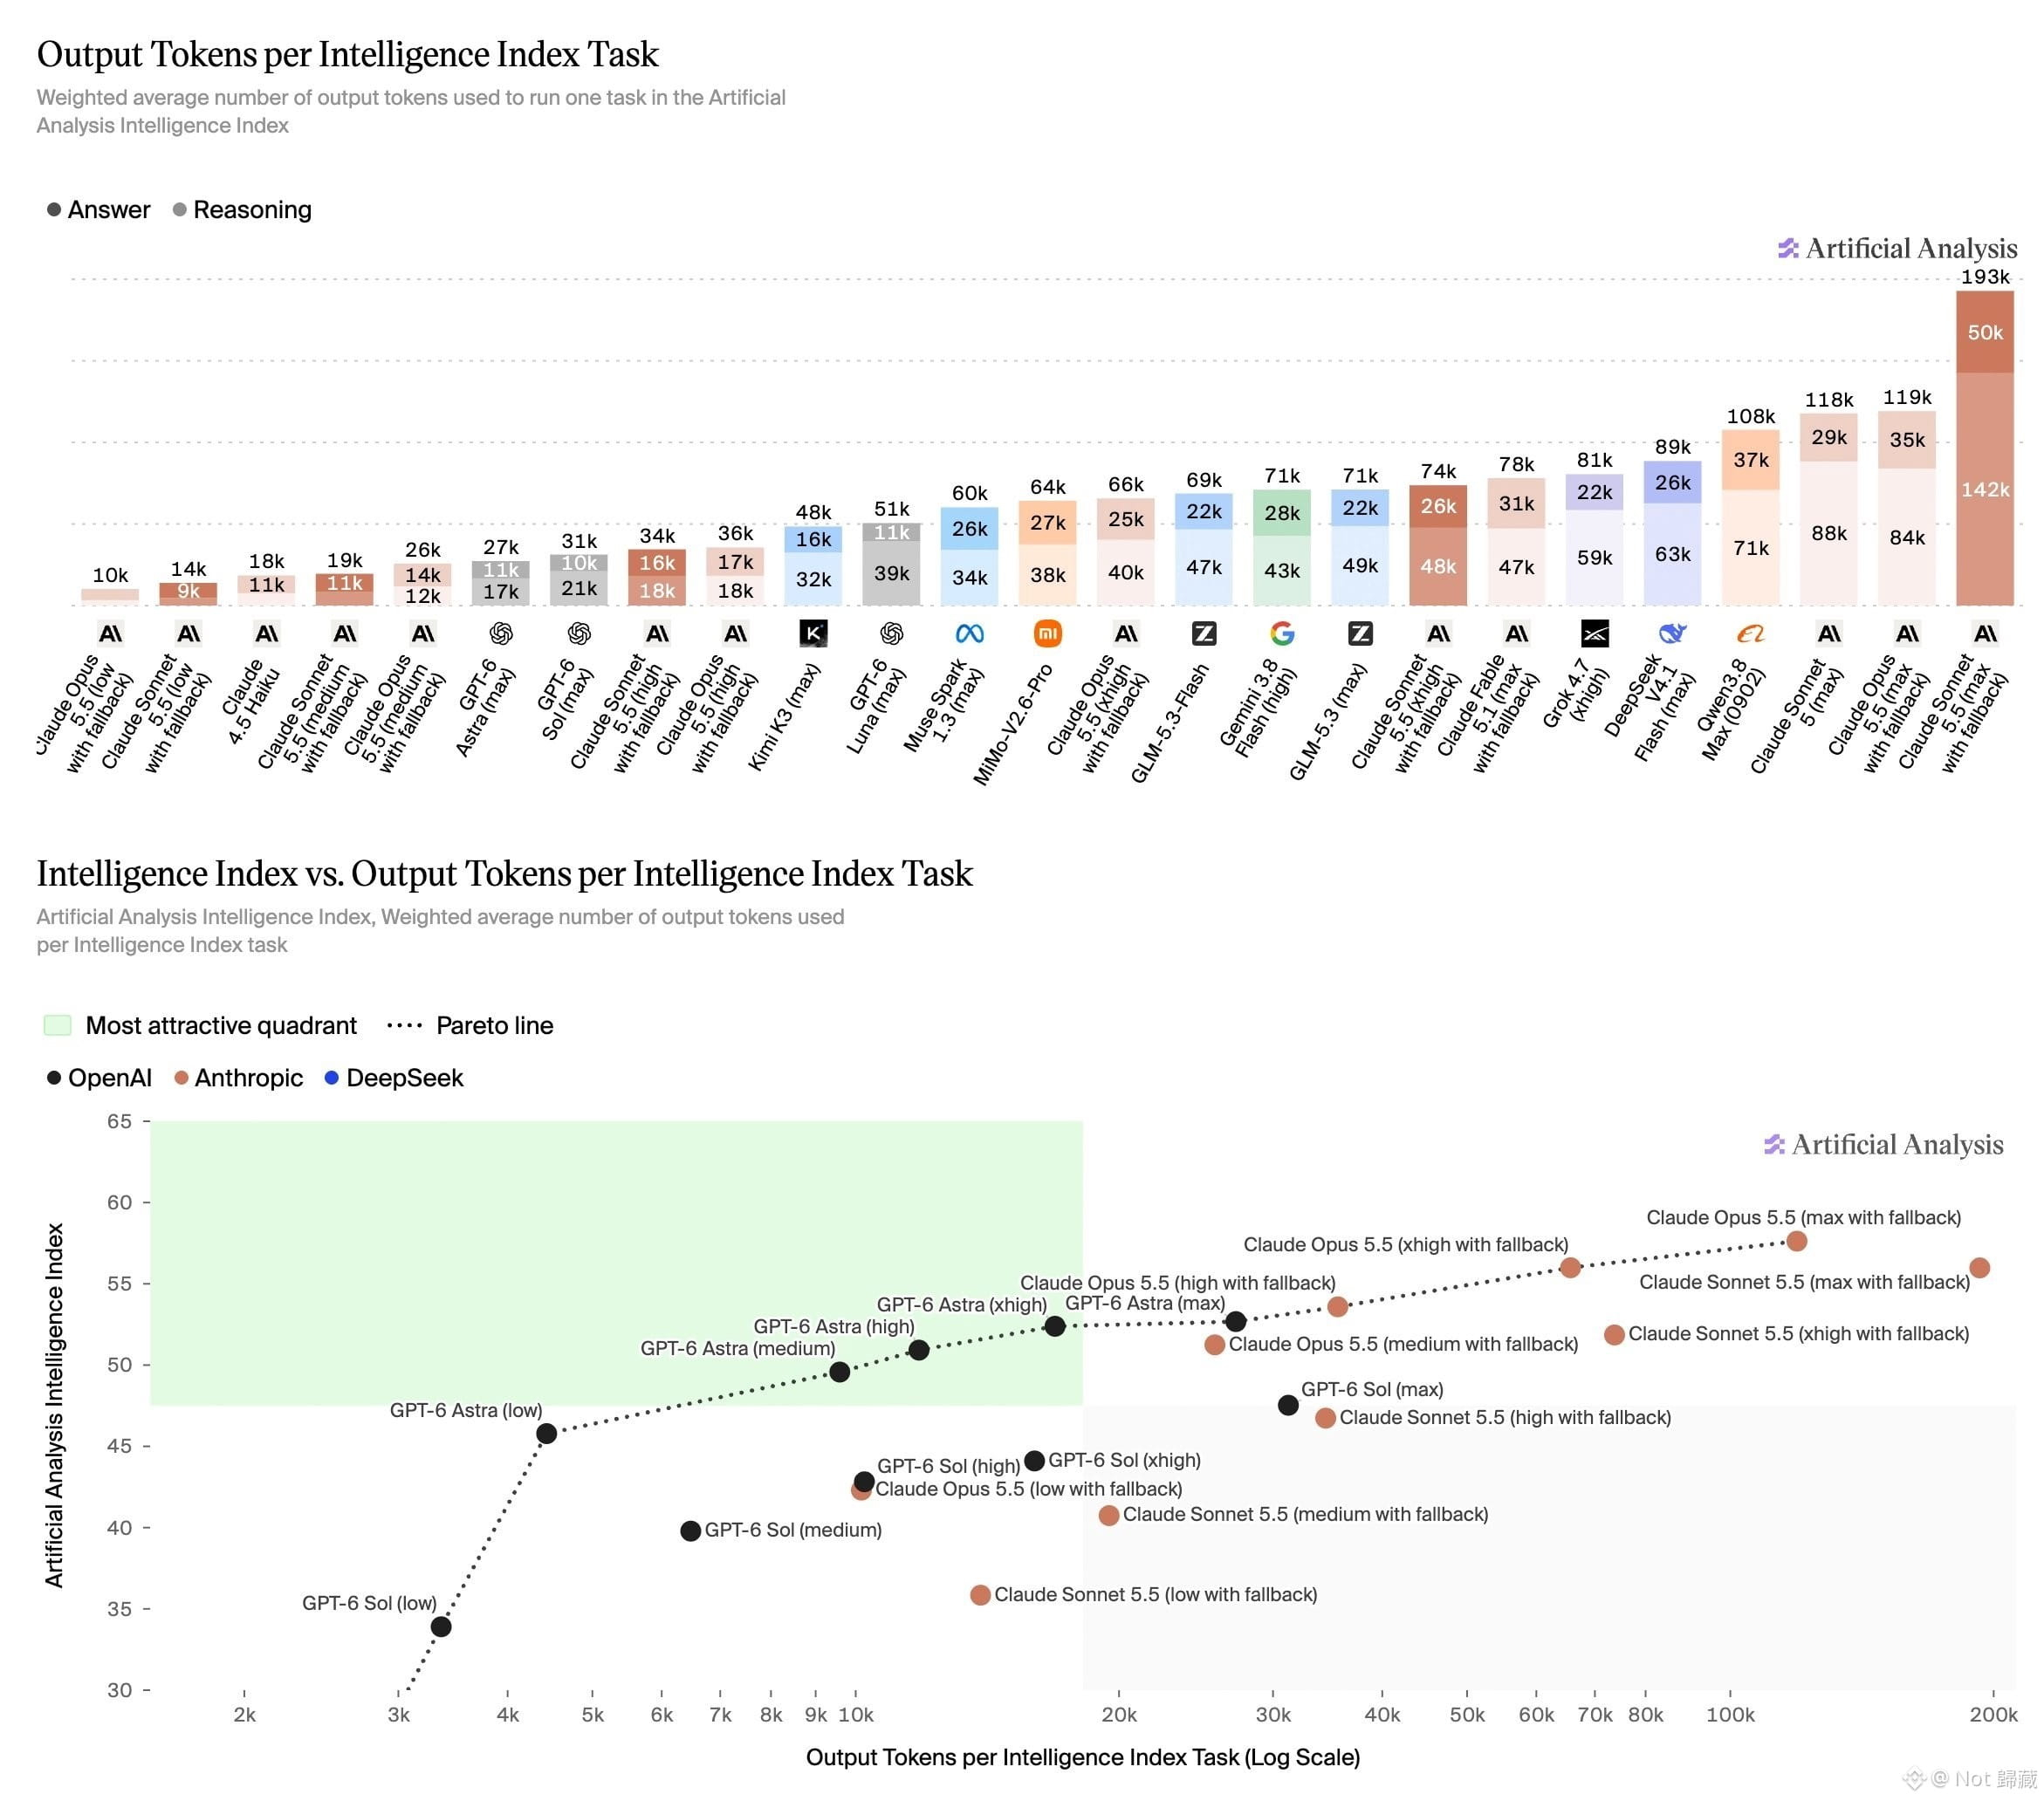
La version Sonnet 5.5 est sortie, et ce modèle est vraiment impressionnant : il obtient un score supérieur de 4 points à celui d’Opus 5.5 sur les tests de codage agentique.
Niveau tarification aussi, c’est très avantageux : le prix par million de tokens d’entrée et de sortie est respectivement de 2 $ et 10 $, comme pour GPT-6 Sol. De plus, sa vitesse d’exécution est 30 % plus rapide que celle de Sonnet 5, et Claude indique officiellement que ses coûts ont également baissé de 30 %.
Quant à la raison pour laquelle ses performances en codage agentique sont similaires à celles d’Opus 5.5, voire meilleures, jetez un œil aux tests de prix.
Avec Sonnet 5.5, au niveau « max » (effort maximal), pour la même tâche, le coût est beaucoup plus élevé que celui d’Opus 5.5 : on est presque au même niveau, voire légèrement au-dessus. C’est peut-être pour cela qu’il obtient un score aussi élevé.
Donc, quand vous utilisez Opus 5.5 ou Sonnet 5.5, surtout ne mettez pas « max » : sur certaines tâches complexes, il peut générer un prix extrêmement élevé, presque au niveau de Claude Fable 5.1.