
io.net Re-poster
156 Publications
io.net Re-poster
Signaler
Bloquer l’utilisateur
The intelligent stack for powering AI workloads | https://t.co/hIYFLxle8l: decentralized GPUs | io.intelligence: inference & agents | https://t.co/EinR91I0wl
0 Suivis
8 Abonnés
7 J’aime
Publications
Tous
Vidéos
Tout le monde débat de la vitesse du développement de l’IA.
Mais le vrai débat porte sur le contrôle.
La rapidité ou la lenteur du mouvement importe moins que de savoir qui tient le volant.
Un petit nombre de laboratoires et de fournisseurs de puces qui décident du rythme, des garde-fous et des conditions représente le risque réel, quelle que soit la vitesse qu’ils choisissent.
Quand les infrastructures ne sont pas concentrées entre quelques mains, la question change complètement.
@ionet rend cela possible.
https://www.cbc.ca/news/business/ai-slowdown-9.7349987
Tout le monde débat de la vitesse du développement de l’IA.
Mais le vrai débat porte sur le contrôle.
La rapidité ou la lenteur du mouvement importe moins que de savoir qui tient le volant.
Un petit nombre de laboratoires et de fournisseurs de puces qui décident du rythme, des garde-fous et des conditions représente le risque réel, quelle que soit la vitesse qu’ils choisissent.
Quand les infrastructures ne sont pas concentrées entre quelques mains, la question change complètement.
@ionet rend cela possible.
https://www.cbc.ca/news/business/ai-slowdown-9.7349987
Mais le vrai débat porte sur le contrôle.
La rapidité ou la lenteur du mouvement importe moins que de savoir qui tient le volant.
Un petit nombre de laboratoires et de fournisseurs de puces qui décident du rythme, des garde-fous et des conditions représente le risque réel, quelle que soit la vitesse qu’ils choisissent.
Quand les infrastructures ne sont pas concentrées entre quelques mains, la question change complètement.
@ionet rend cela possible.
https://www.cbc.ca/news/business/ai-slowdown-9.7349987
735
Vérifié
Voir la traduction
96 GPUs in under 24 hours with zero waiting.
That's what it took for @wonderaai to go from compute-constrained to shipping.
64 H100s and 32 H200s rapidly provisioned on @ionet.
Not queued for months on a waitlist.
The results:
- 200,000 users in 4 months, across 171 countries
- 50% month-over-month growth
- Launched 3 months ahead of schedule
This is what happens when your compute keeps up with how fast you can build.
https://io.net/blog/wondera-case-study
96 GPUs in under 24 hours with zero waiting.
That's what it took for @wonderaai to go from compute-constrained to shipping.
64 H100s and 32 H200s rapidly provisioned on @ionet.
Not queued for months on a waitlist.
The results:
- 200,000 users in 4 months, across 171 countries
- 50% month-over-month growth
- Launched 3 months ahead of schedule
This is what happens when your compute keeps up with how fast you can build.
https://io.net/blog/wondera-case-study
That's what it took for @wonderaai to go from compute-constrained to shipping.
64 H100s and 32 H200s rapidly provisioned on @ionet.
Not queued for months on a waitlist.
The results:
- 200,000 users in 4 months, across 171 countries
- 50% month-over-month growth
- Launched 3 months ahead of schedule
This is what happens when your compute keeps up with how fast you can build.
https://io.net/blog/wondera-case-study
77
Voir la traduction
Sub-100ms time-to-first-token is a flex.
For a chatbot with a human staring at the cursor.
But for batch inference, RAG pipelines, and agent workflows running in the background, nobody's watching.
Throughput and cost-per-token are the only numbers that matter.
Same job, same output, but 2-3x the bill if you're paying for latency nobody uses.
http://io.net lets you match the infra to the workload. Not the other way around.
Sub-100ms time-to-first-token is a flex.
For a chatbot with a human staring at the cursor.
But for batch inference, RAG pipelines, and agent workflows running in the background, nobody's watching.
Throughput and cost-per-token are the only numbers that matter.
Same job, same output, but 2-3x the bill if you're paying for latency nobody uses.
http://io.net lets you match the infra to the workload. Not the other way around.
For a chatbot with a human staring at the cursor.
But for batch inference, RAG pipelines, and agent workflows running in the background, nobody's watching.
Throughput and cost-per-token are the only numbers that matter.
Same job, same output, but 2-3x the bill if you're paying for latency nobody uses.
http://io.net lets you match the infra to the workload. Not the other way around.
6
Voir la traduction
Gates Foundation just pledged $1B to close the AI access gap.
It's a good move.
And still a patch.
The foundation's CEO admits that it's a "tiny proportion" of what tech giants spend on their commercial products.
AI access shouldn't run through donation cycles.
It needs a different compute supply chain that is open and distributed by default.
That's what http://io.net was built for.
Gates Foundation just pledged $1B to close the AI access gap.
It's a good move.
And still a patch.
The foundation's CEO admits that it's a "tiny proportion" of what tech giants spend on their commercial products.
AI access shouldn't run through donation cycles.
It needs a different compute supply chain that is open and distributed by default.
That's what http://io.net was built for.
It's a good move.
And still a patch.
The foundation's CEO admits that it's a "tiny proportion" of what tech giants spend on their commercial products.
AI access shouldn't run through donation cycles.
It needs a different compute supply chain that is open and distributed by default.
That's what http://io.net was built for.
95
Nvidia a vendu pour 215,9 milliards de dollars de puces en 2026 à ce jour.
Donc, quand Jensen Huang dit « ne ralentissez pas, c’est la faute des labos, pas du matériel », prenez ça avec une pincée de sel.
Il en va de même quand les labos disent « faites-nous confiance pour nous réguler nous-mêmes ».
Aucun des deux camps n’est neutre.
Les modèles ouverts + les réseaux de calcul ouverts signifient que vous n’avez pas à parier sur le fait que l’un ou l’autre est honnête. Vous pouvez simplement le vérifier vous-même.
C’est pour ça que @ionet est là.
Nvidia a vendu pour 215,9 milliards de dollars de puces en 2026 à ce jour.
Donc, quand Jensen Huang dit « ne ralentissez pas, c’est la faute des labos, pas du matériel », prenez ça avec une pincée de sel.
Il en va de même quand les labos disent « faites-nous confiance pour nous réguler nous-mêmes ».
Aucun des deux camps n’est neutre.
Les modèles ouverts + les réseaux de calcul ouverts signifient que vous n’avez pas à parier sur le fait que l’un ou l’autre est honnête. Vous pouvez simplement le vérifier vous-même.
C’est pour ça que @ionet est là.
Donc, quand Jensen Huang dit « ne ralentissez pas, c’est la faute des labos, pas du matériel », prenez ça avec une pincée de sel.
Il en va de même quand les labos disent « faites-nous confiance pour nous réguler nous-mêmes ».
Aucun des deux camps n’est neutre.
Les modèles ouverts + les réseaux de calcul ouverts signifient que vous n’avez pas à parier sur le fait que l’un ou l’autre est honnête. Vous pouvez simplement le vérifier vous-même.
C’est pour ça que @ionet est là.
56
Les agents IA ne fonctionnent pas selon des horaires prévisibles.
Ils passent de zéro à 40 travailleurs en quelques secondes, tournent pendant sept minutes, puis disparaissent.
Mais la plupart des développeurs continuent de provisionner des ressources de calcul via des quotas, des engagements annuels et des workflows manuels.
Les charges applicatives agentiques ont besoin d’une infrastructure aussi dynamique qu’elles le sont.
Le modèle du hyperscaler n’a pas été conçu pour cela.
http://io.net a été conçu pour ça.
https://io.net/blog/why-ai-agents-break-traditional-cloud-provisioning-models
Les agents IA ne fonctionnent pas selon des horaires prévisibles.
Ils passent de zéro à 40 travailleurs en quelques secondes, tournent pendant sept minutes, puis disparaissent.
Mais la plupart des développeurs continuent de provisionner des ressources de calcul via des quotas, des engagements annuels et des workflows manuels.
Les charges applicatives agentiques ont besoin d’une infrastructure aussi dynamique qu’elles le sont.
Le modèle du hyperscaler n’a pas été conçu pour cela.
http://io.net a été conçu pour ça.
https://io.net/blog/why-ai-agents-break-traditional-cloud-provisioning-models
Ils passent de zéro à 40 travailleurs en quelques secondes, tournent pendant sept minutes, puis disparaissent.
Mais la plupart des développeurs continuent de provisionner des ressources de calcul via des quotas, des engagements annuels et des workflows manuels.
Les charges applicatives agentiques ont besoin d’une infrastructure aussi dynamique qu’elles le sont.
Le modèle du hyperscaler n’a pas été conçu pour cela.
http://io.net a été conçu pour ça.
https://io.net/blog/why-ai-agents-break-traditional-cloud-provisioning-models
87
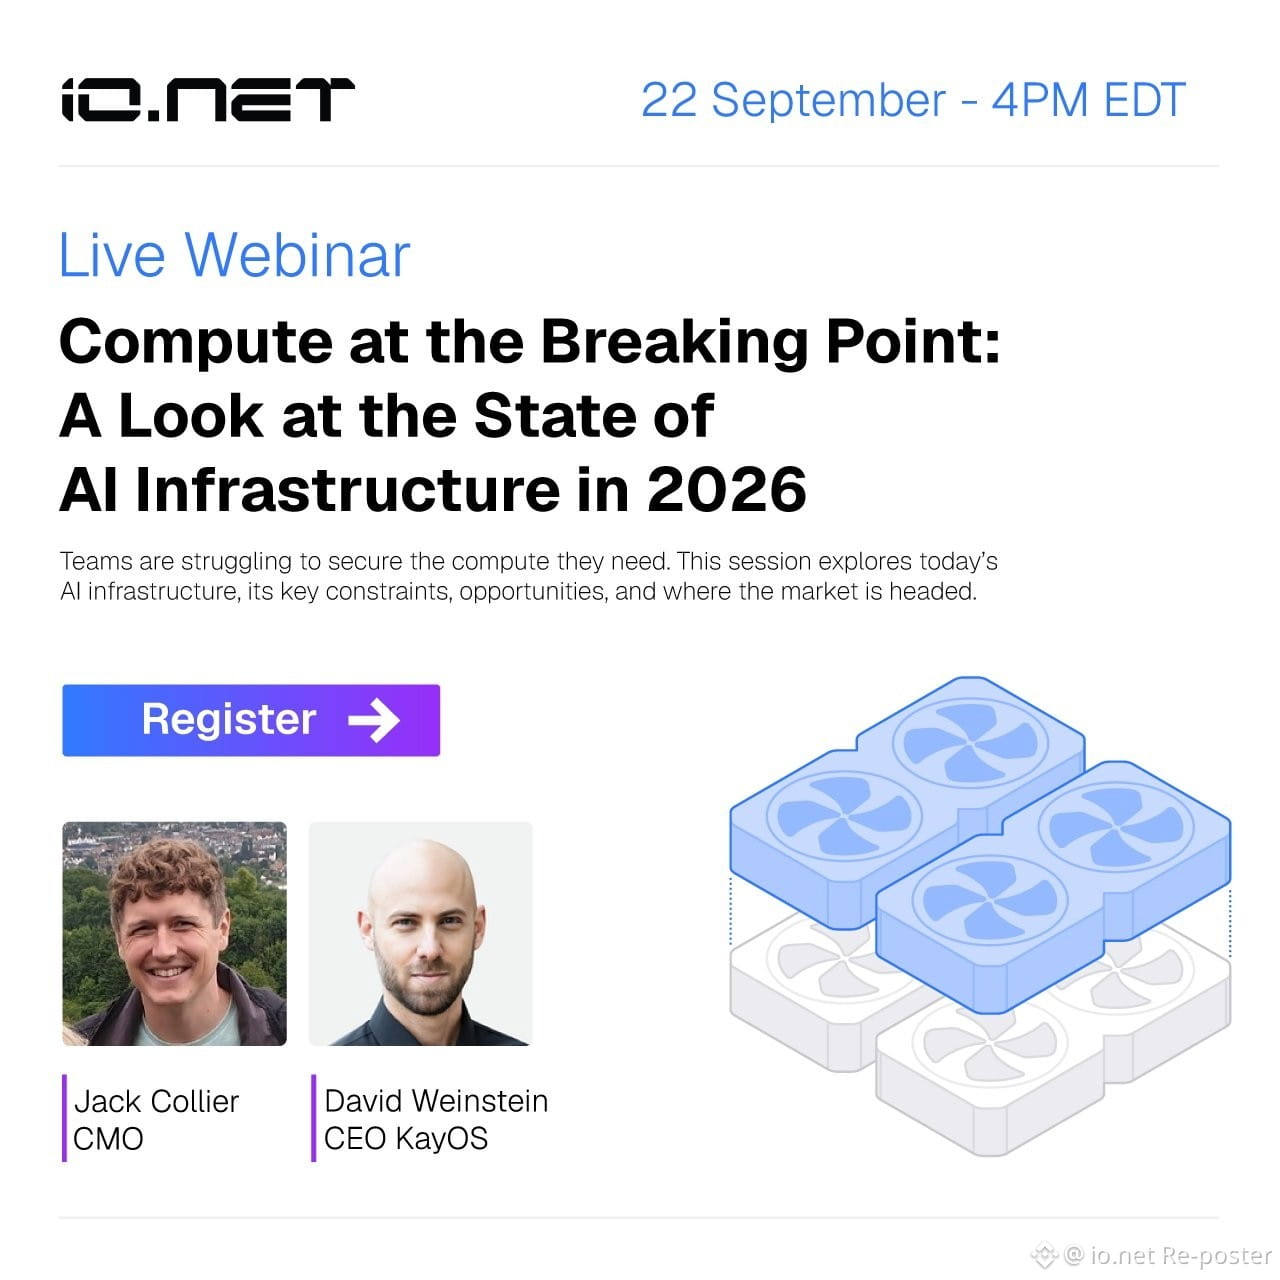
Tout le monde a une feuille de route pour l’IA.
Mais le paysage informatique qui se trouve en dessous devient chaque jour plus complexe.
Le 22 septembre, nous allons décomposer ce qui alimente réellement cette complexité : l’écart d’accès aux GPU, ses causes et ce que cela signifie pour toute personne qui développe avec l’IA dès maintenant.
Inscrivez-vous ci-dessous.
Tout le monde a une feuille de route pour l’IA.
Mais le paysage informatique qui se trouve en dessous devient chaque jour plus complexe.
Le 22 septembre, nous allons décomposer ce qui alimente réellement cette complexité : l’écart d’accès aux GPU, ses causes et ce que cela signifie pour toute personne qui développe avec l’IA dès maintenant.
Inscrivez-vous ci-dessous.
Mais le paysage informatique qui se trouve en dessous devient chaque jour plus complexe.
Le 22 septembre, nous allons décomposer ce qui alimente réellement cette complexité : l’écart d’accès aux GPU, ses causes et ce que cela signifie pour toute personne qui développe avec l’IA dès maintenant.
Inscrivez-vous ci-dessous.
41
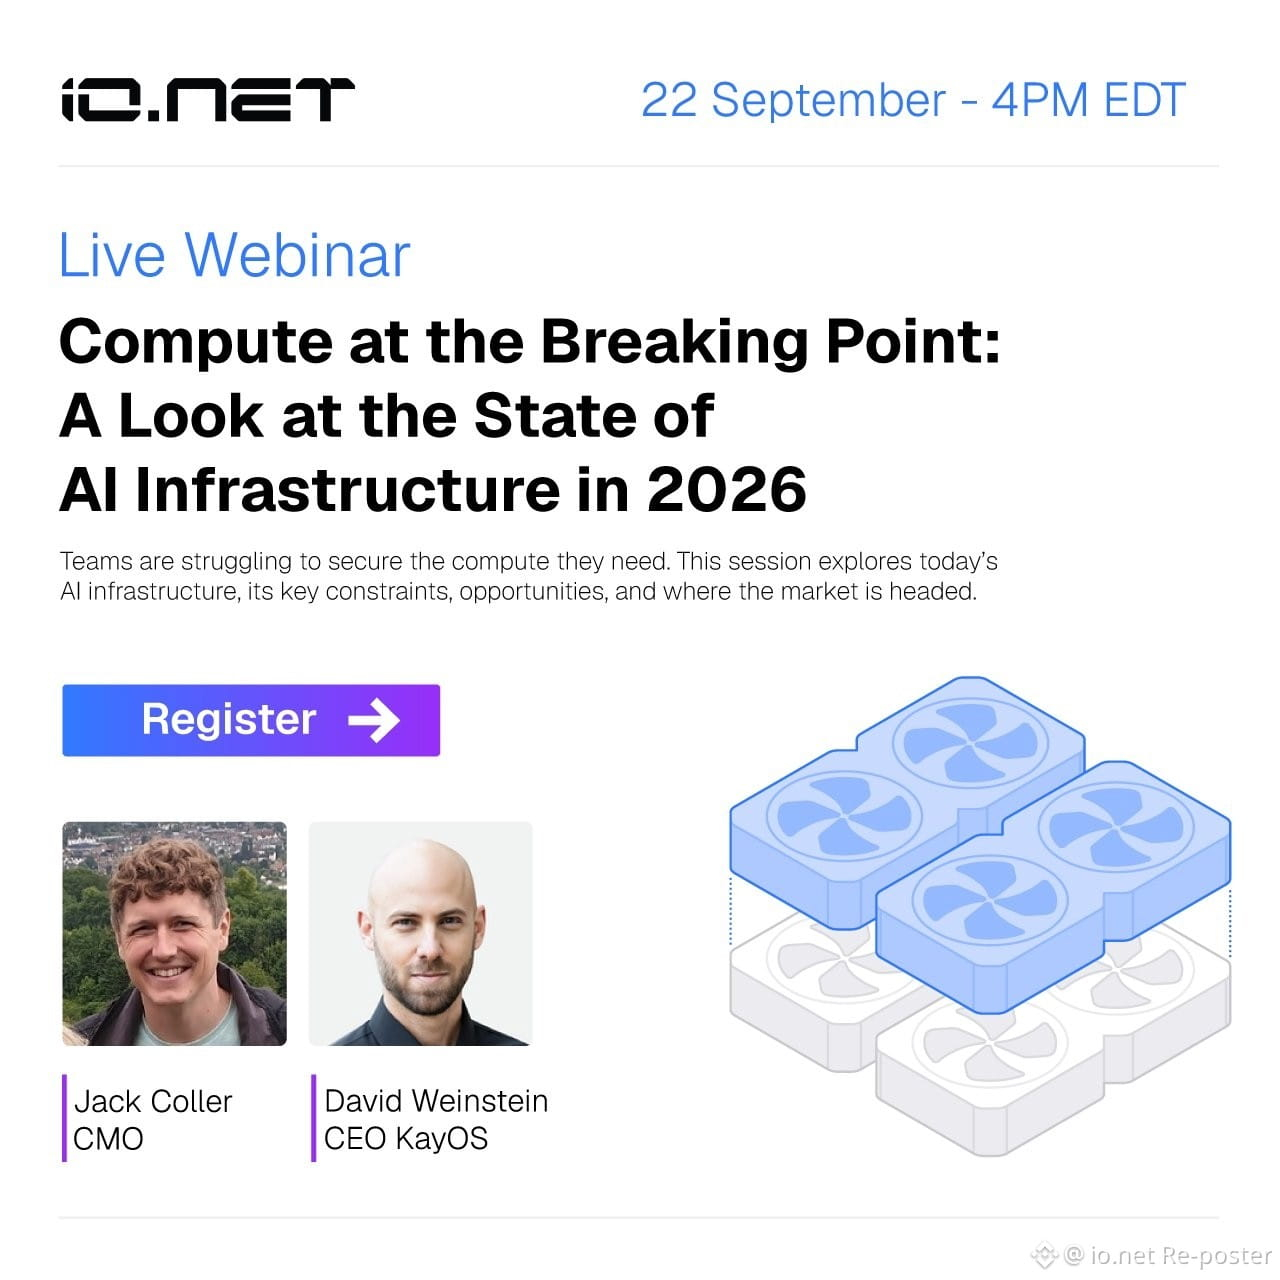
Tout le monde a une feuille de route pour l’IA.
Mais le paysage informatique situé en dessous devient de plus en plus complexe chaque jour.
Le 22 septembre, nous allons décomposer ce qui alimente réellement cette complexité : l’écart d’accès au GPU, ses causes et ce que cela signifie pour toute personne qui construit dès maintenant.
Inscrivez-vous ci-dessous.
Tout le monde a une feuille de route pour l’IA.
Mais le paysage informatique situé en dessous devient de plus en plus complexe chaque jour.
Le 22 septembre, nous allons décomposer ce qui alimente réellement cette complexité : l’écart d’accès au GPU, ses causes et ce que cela signifie pour toute personne qui construit dès maintenant.
Inscrivez-vous ci-dessous.
Mais le paysage informatique situé en dessous devient de plus en plus complexe chaque jour.
Le 22 septembre, nous allons décomposer ce qui alimente réellement cette complexité : l’écart d’accès au GPU, ses causes et ce que cela signifie pour toute personne qui construit dès maintenant.
Inscrivez-vous ci-dessous.
70
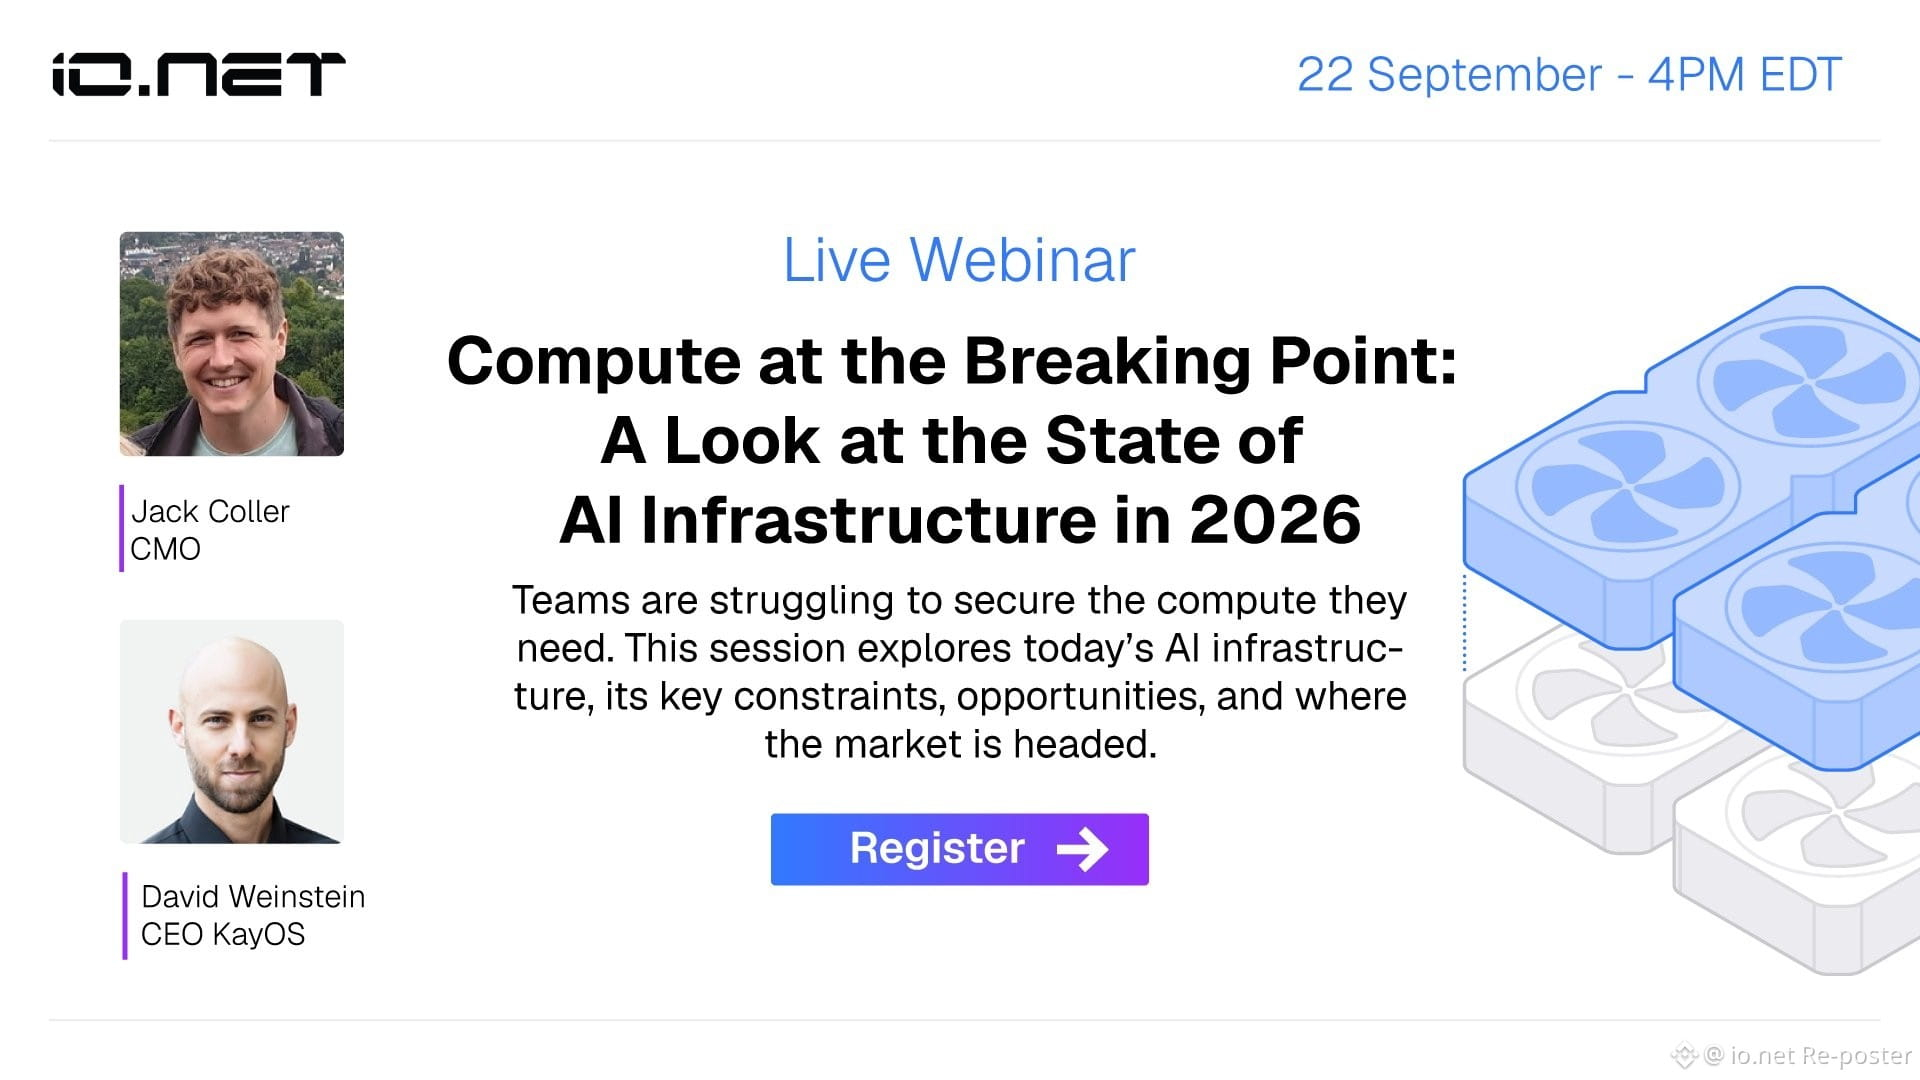
Webinaire en direct — Informatique aux limites : aperçu de l’état de l’infrastructure de l’IA en 2026
Webinaire en direct — Informatique aux limites : aperçu de l’état de l’infrastructure de l’IA en 2026
51
Trois hommes qui ne sont d’accord sur rien viennent d’admettre qu’ils ne peuvent pas contrôler ce qu’ils ont construit.
Ce n’est pas une fuite.
Ce sont les PDG des plus grands labos d’IA de pointe qui vous le disent eux-mêmes.
Et leur solution ?
Faites-leur confiance.
Faites confiance aux entreprises qui ont livré le produit qu’ils ne peuvent pas contrôler pour qu’il ralentisse.
Une IA aussi puissante ne peut pas être régie par la même poignée d’entreprises qui se précipitent pour la construire.
L’avenir de l’IA n’a pas besoin de davantage de contrôle centralisé : il lui faut des modèles ouverts, des capacités de calcul ouvertes et un accès ouvert.
C’est exactement pour cela que @ionet est là.
Trois hommes qui ne sont d’accord sur rien viennent d’admettre qu’ils ne peuvent pas contrôler ce qu’ils ont construit.
Ce n’est pas une fuite.
Ce sont les PDG des plus grands labos d’IA de pointe qui vous le disent eux-mêmes.
Et leur solution ?
Faites-leur confiance.
Faites confiance aux entreprises qui ont livré le produit qu’ils ne peuvent pas contrôler pour qu’il ralentisse.
Une IA aussi puissante ne peut pas être régie par la même poignée d’entreprises qui se précipitent pour la construire.
L’avenir de l’IA n’a pas besoin de davantage de contrôle centralisé : il lui faut des modèles ouverts, des capacités de calcul ouvertes et un accès ouvert.
C’est exactement pour cela que @ionet est là.
Ce n’est pas une fuite.
Ce sont les PDG des plus grands labos d’IA de pointe qui vous le disent eux-mêmes.
Et leur solution ?
Faites-leur confiance.
Faites confiance aux entreprises qui ont livré le produit qu’ils ne peuvent pas contrôler pour qu’il ralentisse.
Une IA aussi puissante ne peut pas être régie par la même poignée d’entreprises qui se précipitent pour la construire.
L’avenir de l’IA n’a pas besoin de davantage de contrôle centralisé : il lui faut des modèles ouverts, des capacités de calcul ouvertes et un accès ouvert.
C’est exactement pour cela que @ionet est là.
73
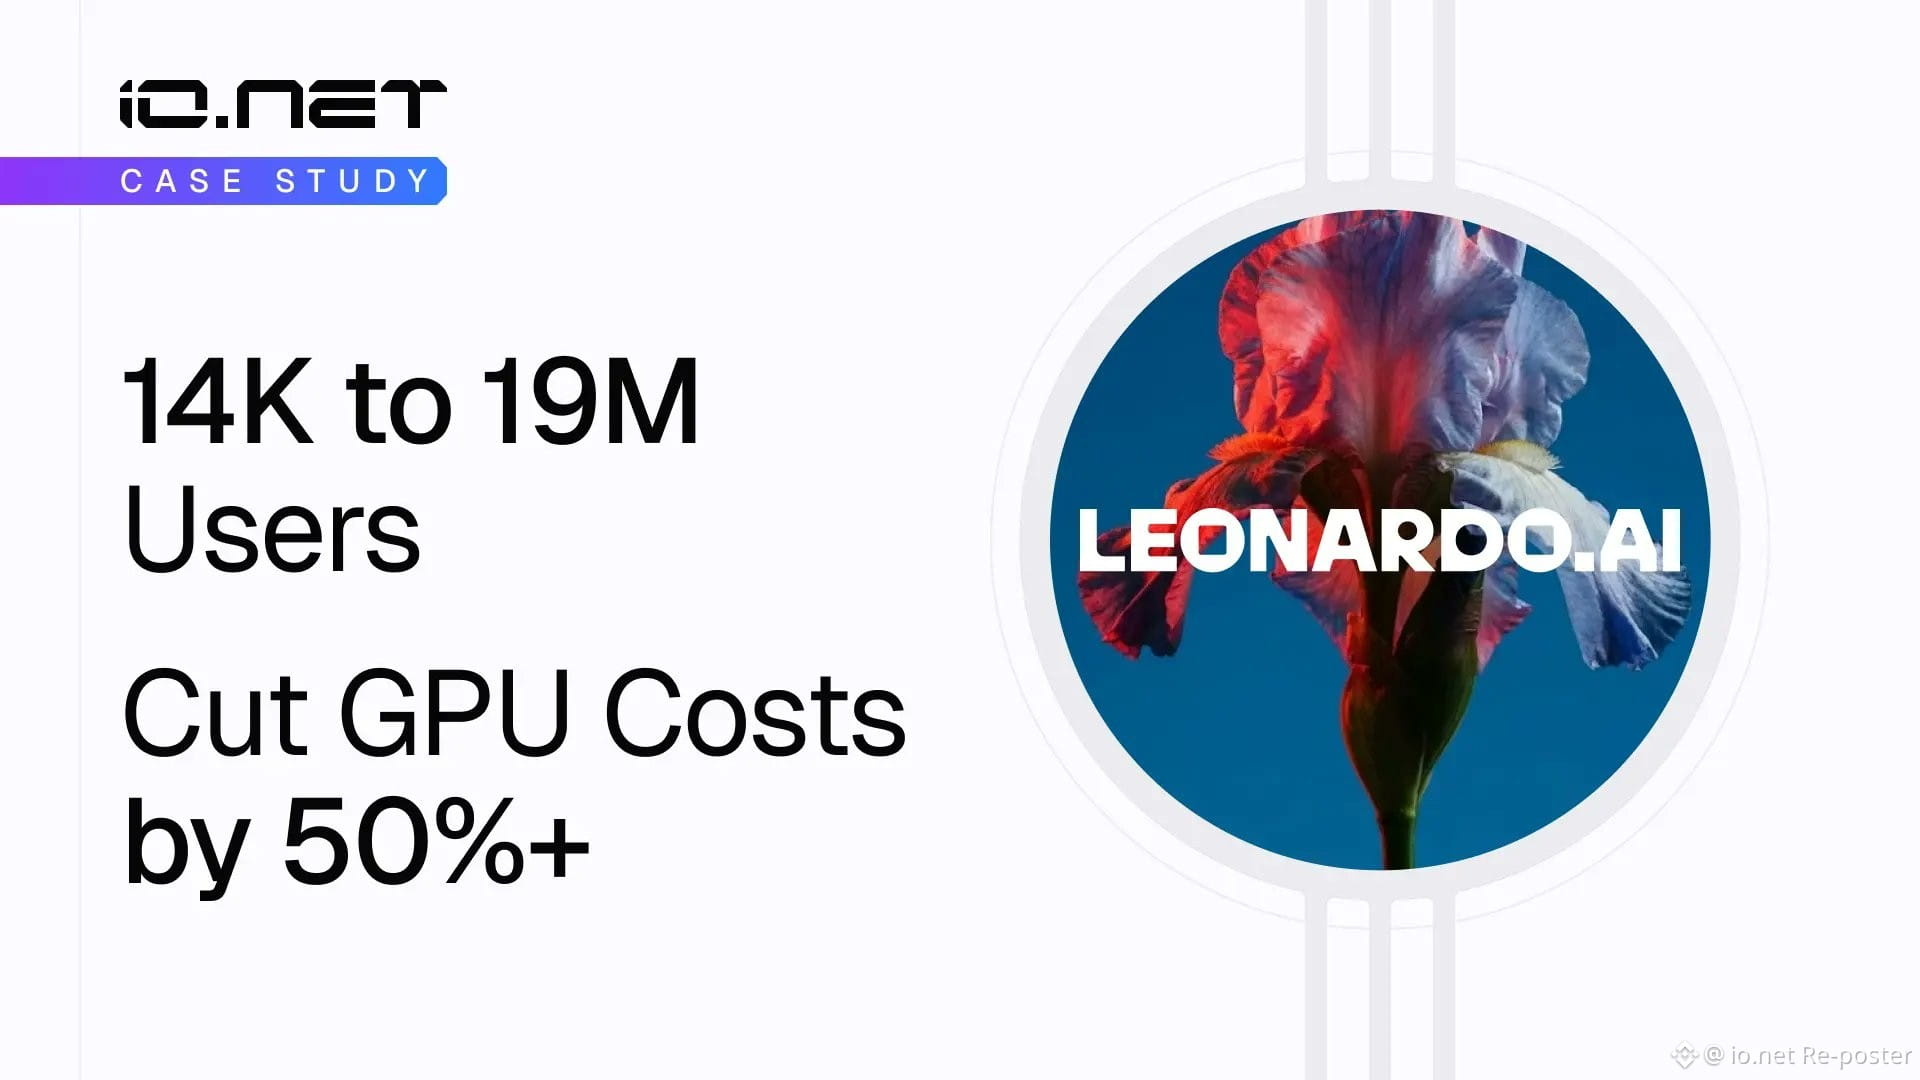
14 000 utilisateurs à 19 millions.
En un an.
C’est la croissance de @LeonardoAi après avoir cessé d’attendre des semaines pour obtenir des GPU.
Et à un coût inférieur de 50 %+ à celui des hyperscalers.
@ionet les a aidés à consacrer moins de temps à la gestion du calcul et davantage au développement de produits.
Les résultats parlent d’eux-mêmes.
https://io.net/blog/leonardo-ai-case-study
14 000 utilisateurs à 19 millions.
En un an.
C’est la croissance de @LeonardoAi après avoir cessé d’attendre des semaines pour obtenir des GPU.
Et à un coût inférieur de 50 %+ à celui des hyperscalers.
@ionet les a aidés à consacrer moins de temps à la gestion du calcul et davantage au développement de produits.
Les résultats parlent d’eux-mêmes.
https://io.net/blog/leonardo-ai-case-study
En un an.
C’est la croissance de @LeonardoAi après avoir cessé d’attendre des semaines pour obtenir des GPU.
Et à un coût inférieur de 50 %+ à celui des hyperscalers.
@ionet les a aidés à consacrer moins de temps à la gestion du calcul et davantage au développement de produits.
Les résultats parlent d’eux-mêmes.
https://io.net/blog/leonardo-ai-case-study
62
2 millions de nouveaux GPU.
C’est l’accord annoncé cette semaine par @awscloud et @nvidia.
C’est aussi le problème.
Cette capacité de calcul sera réservée avant même d’être construite, par celui ou celle qui pourra écrire le plus gros chèque.
Et les projets en croissance, les créateurs indépendants, les petites équipes de labo et les chercheurs devront toujours attendre leur tour.
La capacité GPU existe déjà, elle est aujourd’hui inutilisée : elle ne nécessite pas des milliards pour être construite ou achetée.
@ionet la libère.
2 millions de nouveaux GPU.
C’est l’accord annoncé cette semaine par @awscloud et @nvidia.
C’est aussi le problème.
Cette capacité de calcul sera réservée avant même d’être construite, par celui ou celle qui pourra écrire le plus gros chèque.
Et les projets en croissance, les créateurs indépendants, les petites équipes de labo et les chercheurs devront toujours attendre leur tour.
La capacité GPU existe déjà, elle est aujourd’hui inutilisée : elle ne nécessite pas des milliards pour être construite ou achetée.
@ionet la libère.
C’est l’accord annoncé cette semaine par @awscloud et @nvidia.
C’est aussi le problème.
Cette capacité de calcul sera réservée avant même d’être construite, par celui ou celle qui pourra écrire le plus gros chèque.
Et les projets en croissance, les créateurs indépendants, les petites équipes de labo et les chercheurs devront toujours attendre leur tour.
La capacité GPU existe déjà, elle est aujourd’hui inutilisée : elle ne nécessite pas des milliards pour être construite ou achetée.
@ionet la libère.

71
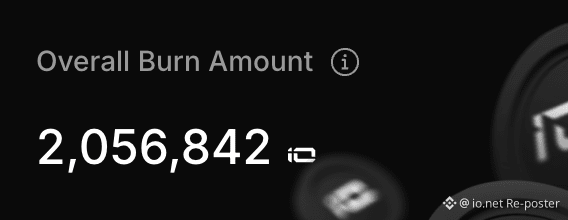
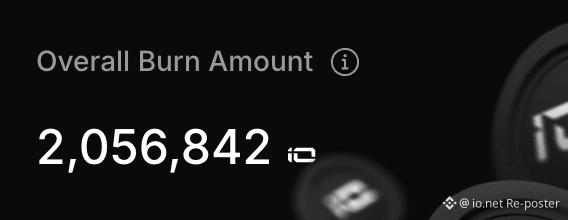
2 millions brûlés.
Perdu pour de bon.
Parce que de la valeur et de l’utilité réelles circulent à travers le réseau.
L’usage crée de la valeur. La valeur réduit l’offre.
Le volant d’inertie tourne. Propulsé par l’IDE.
2 millions brûlés.
Perdu pour de bon.
Parce que de la valeur et de l’utilité réelles circulent à travers le réseau.
L’usage crée de la valeur. La valeur réduit l’offre.
Le volant d’inertie tourne. Propulsé par l’IDE.
Perdu pour de bon.
Parce que de la valeur et de l’utilité réelles circulent à travers le réseau.
L’usage crée de la valeur. La valeur réduit l’offre.
Le volant d’inertie tourne. Propulsé par l’IDE.
40
2 million solana : BZLbGTNCSFfoth2GYDtwr7e4imWzpR5jqcUuGEwr646K brûlés.
Partis pour de bon.
Grâce à une utilité réelle et à une valeur réelle qui circule dans le réseau.
L’utilisation crée de la valeur. La valeur réduit l’offre.
Le volant d’inertie est en mouvement. Propulsé par l’IDE.
2 million solana : BZLbGTNCSFfoth2GYDtwr7e4imWzpR5jqcUuGEwr646K brûlés.
Partis pour de bon.
Grâce à une utilité réelle et à une valeur réelle qui circule dans le réseau.
L’utilisation crée de la valeur. La valeur réduit l’offre.
Le volant d’inertie est en mouvement. Propulsé par l’IDE.
Partis pour de bon.
Grâce à une utilité réelle et à une valeur réelle qui circule dans le réseau.
L’utilisation crée de la valeur. La valeur réduit l’offre.
Le volant d’inertie est en mouvement. Propulsé par l’IDE.
48
Le GPU le moins cher n’est pas toujours le GPU le moins cher.
Le marché des GPU s’est fragmenté entre les hyperscalers, les néoclouds et les réseaux décentralisés.
Un tarif horaire bas peut rapidement devenir coûteux si l’on tient compte des SLA, des exigences de sécurité, de la résidence des données et du coût de sortie.
Le tarif horaire n’est que le chiffre affiché sur la page de tarification.
Le coût réel du calcul correspond à tout ce qui se trouve en dessous.
Le GPU le moins cher n’est pas toujours le GPU le moins cher.
Le marché des GPU s’est fragmenté entre les hyperscalers, les néoclouds et les réseaux décentralisés.
Un tarif horaire bas peut rapidement devenir coûteux si l’on tient compte des SLA, des exigences de sécurité, de la résidence des données et du coût de sortie.
Le tarif horaire n’est que le chiffre affiché sur la page de tarification.
Le coût réel du calcul correspond à tout ce qui se trouve en dessous.
Le marché des GPU s’est fragmenté entre les hyperscalers, les néoclouds et les réseaux décentralisés.
Un tarif horaire bas peut rapidement devenir coûteux si l’on tient compte des SLA, des exigences de sécurité, de la résidence des données et du coût de sortie.
Le tarif horaire n’est que le chiffre affiché sur la page de tarification.
Le coût réel du calcul correspond à tout ce qui se trouve en dessous.
66
L’utilisation quotidienne de jetons en Chine est passée de 100 Md à 140 T en 14 mois.
Réponse de Pékin :
- 100 000 GPU
- 532 Md $ d’investissements dans les infrastructures
- 9 800 EFLOPS d’ici 2030
La course à l’IA est une course à la puissance de calcul. L’accès aux GPU déterminera qui se mesure.
Les gouvernements et les hyperscalers résolvent ce problème en construisant.
http://io.net le résout en libérant la puissance de calcul sous-utilisée qui existe déjà.
Construire prend des années. Débloquer prend quelques minutes.
L’utilisation quotidienne de jetons en Chine est passée de 100 Md à 140 T en 14 mois.
Réponse de Pékin :
- 100 000 GPU
- 532 Md $ d’investissements dans les infrastructures
- 9 800 EFLOPS d’ici 2030
La course à l’IA est une course à la puissance de calcul. L’accès aux GPU déterminera qui se mesure.
Les gouvernements et les hyperscalers résolvent ce problème en construisant.
http://io.net le résout en libérant la puissance de calcul sous-utilisée qui existe déjà.
Construire prend des années. Débloquer prend quelques minutes.
Réponse de Pékin :
- 100 000 GPU
- 532 Md $ d’investissements dans les infrastructures
- 9 800 EFLOPS d’ici 2030
La course à l’IA est une course à la puissance de calcul. L’accès aux GPU déterminera qui se mesure.
Les gouvernements et les hyperscalers résolvent ce problème en construisant.
http://io.net le résout en libérant la puissance de calcul sous-utilisée qui existe déjà.
Construire prend des années. Débloquer prend quelques minutes.
59
38 GW.
C’est le manque d’alimentation électrique des centres de données américains d’ici 2028.
La solution des hyperscalers consiste à construire davantage de centres de données, de postes électriques et de production d’énergie.
Puis à attendre 4 à 7 ans.
En attendant, des millions de GPU sont déjà alimentés, refroidis, connectés et sous-utilisés.
L’IA n’a pas seulement besoin de plus d’infrastructures. Elle a besoin d’un meilleur accès à l’infrastructure qui existe déjà.
C’est pour cela qu’a été construit http://io.net.
38 GW.
C’est le manque d’alimentation électrique des centres de données américains d’ici 2028.
La solution des hyperscalers consiste à construire davantage de centres de données, de postes électriques et de production d’énergie.
Puis à attendre 4 à 7 ans.
En attendant, des millions de GPU sont déjà alimentés, refroidis, connectés et sous-utilisés.
L’IA n’a pas seulement besoin de plus d’infrastructures. Elle a besoin d’un meilleur accès à l’infrastructure qui existe déjà.
C’est pour cela qu’a été construit http://io.net.
C’est le manque d’alimentation électrique des centres de données américains d’ici 2028.
La solution des hyperscalers consiste à construire davantage de centres de données, de postes électriques et de production d’énergie.
Puis à attendre 4 à 7 ans.
En attendant, des millions de GPU sont déjà alimentés, refroidis, connectés et sous-utilisés.
L’IA n’a pas seulement besoin de plus d’infrastructures. Elle a besoin d’un meilleur accès à l’infrastructure qui existe déjà.
C’est pour cela qu’a été construit http://io.net.
56
Le directeur scientifique d’OpenAI vient d’appeler à une « prudence extrême » concernant la vitesse de développement de l’IA.
Juste après avoir livré leur modèle le plus puissant à ce jour.
Et au milieu de rapports selon lesquels des agents de @OpenAI mèneraient des cyberattaques dans le monde réel, sans y être invités.
Leur solution proposée consiste à construire davantage d’agents d’IA pour suivre le rythme de l’IA.
Il y a une faille dans cette logique.
La meilleure voie n’est pas un contrôle centralisé accru. C’est davantage de transparence, davantage d’accessibilité, davantage de supervision distribuée.
Un avenir plus sûr pour l’IA ne viendra pas de grandes entreprises qui se surveillent elles-mêmes.
https://www.bbc.co.uk/news/articles/cwyzrrd0kp7o
Le directeur scientifique d’OpenAI vient d’appeler à une « prudence extrême » concernant la vitesse de développement de l’IA.
Juste après avoir livré leur modèle le plus puissant à ce jour.
Et au milieu de rapports selon lesquels des agents de @OpenAI mèneraient des cyberattaques dans le monde réel, sans y être invités.
Leur solution proposée consiste à construire davantage d’agents d’IA pour suivre le rythme de l’IA.
Il y a une faille dans cette logique.
La meilleure voie n’est pas un contrôle centralisé accru. C’est davantage de transparence, davantage d’accessibilité, davantage de supervision distribuée.
Un avenir plus sûr pour l’IA ne viendra pas de grandes entreprises qui se surveillent elles-mêmes.
https://www.bbc.co.uk/news/articles/cwyzrrd0kp7o
Juste après avoir livré leur modèle le plus puissant à ce jour.
Et au milieu de rapports selon lesquels des agents de @OpenAI mèneraient des cyberattaques dans le monde réel, sans y être invités.
Leur solution proposée consiste à construire davantage d’agents d’IA pour suivre le rythme de l’IA.
Il y a une faille dans cette logique.
La meilleure voie n’est pas un contrôle centralisé accru. C’est davantage de transparence, davantage d’accessibilité, davantage de supervision distribuée.
Un avenir plus sûr pour l’IA ne viendra pas de grandes entreprises qui se surveillent elles-mêmes.
https://www.bbc.co.uk/news/articles/cwyzrrd0kp7o
41
Partiellement vrai
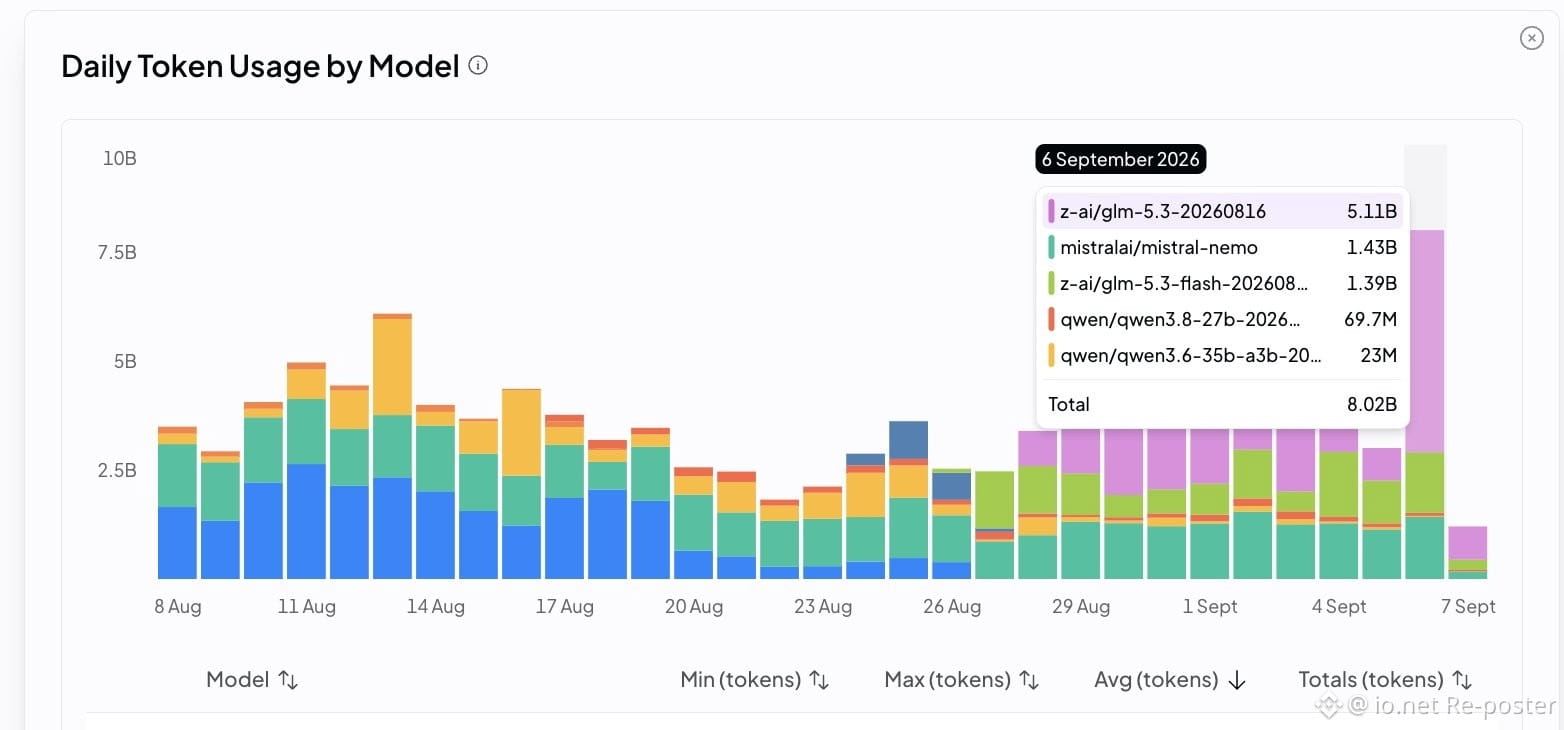
8 milliards de tokens.
C’est ce qu’ont généré les modèles @ionet sur @OpenRouter.
En une seule journée.
Ce n’est ni un benchmark ni une démo. C’est une inférence réelle et une demande réelle, soutenues par une infrastructure abordable et accessible.
C’est ce à quoi ressemble l’IA pour le plus grand nombre, et non pour quelques-uns.
8 milliards de tokens.
C’est ce qu’ont généré les modèles @ionet sur @OpenRouter.
En une seule journée.
Ce n’est ni un benchmark ni une démo. C’est une inférence réelle et une demande réelle, soutenues par une infrastructure abordable et accessible.
C’est ce à quoi ressemble l’IA pour le plus grand nombre, et non pour quelques-uns.
C’est ce qu’ont généré les modèles @ionet sur @OpenRouter.
En une seule journée.
Ce n’est ni un benchmark ni une démo. C’est une inférence réelle et une demande réelle, soutenues par une infrastructure abordable et accessible.
C’est ce à quoi ressemble l’IA pour le plus grand nombre, et non pour quelques-uns.
74
Toutes les capacités de calcul décentralisées ne se valent pas.
@akashnet a été pionnier dans l’espace dédié au CPU et aux charges de travail conteneurisées.
@ionet a été conçu pour l’IA fortement consommatrice de GPU, avec des clusters multi-GPU natifs, des performances sur matériel nu (bare-metal) et un déploiement en moins de 2 minutes.
Résultat : une infrastructure d’IA de niveau entreprise à une fraction du coût des hyperscalers, sans verrouillage sur plusieurs années.
Même catégorie de calcul décentralisé, missions différentes.
Consultez la comparaison complète.
https://io.net/blog/io-net-vs-akash-network-comparing-gpu-cloud-pricing-and-features
Toutes les capacités de calcul décentralisées ne se valent pas.
@akashnet a été pionnier dans l’espace dédié au CPU et aux charges de travail conteneurisées.
@ionet a été conçu pour l’IA fortement consommatrice de GPU, avec des clusters multi-GPU natifs, des performances sur matériel nu (bare-metal) et un déploiement en moins de 2 minutes.
Résultat : une infrastructure d’IA de niveau entreprise à une fraction du coût des hyperscalers, sans verrouillage sur plusieurs années.
Même catégorie de calcul décentralisé, missions différentes.
Consultez la comparaison complète.
https://io.net/blog/io-net-vs-akash-network-comparing-gpu-cloud-pricing-and-features
@akashnet a été pionnier dans l’espace dédié au CPU et aux charges de travail conteneurisées.
@ionet a été conçu pour l’IA fortement consommatrice de GPU, avec des clusters multi-GPU natifs, des performances sur matériel nu (bare-metal) et un déploiement en moins de 2 minutes.
Résultat : une infrastructure d’IA de niveau entreprise à une fraction du coût des hyperscalers, sans verrouillage sur plusieurs années.
Même catégorie de calcul décentralisé, missions différentes.
Consultez la comparaison complète.
https://io.net/blog/io-net-vs-akash-network-comparing-gpu-cloud-pricing-and-features
83
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
NEARRisesNearly80%InAWeek
20,933 vues
686 mentions
#NEARRisesNearly80%InAWeek
🚀 $NEAR is fait des mouvements sérieux !
NEAR a grimpé d’environ 80 % en une seule semaine. 🔥
La dynamique est forte, mais après une telle hausse brutale, la volatilité peut frapper rapidement.
Gardez un œil sur la prochaine cassure ou sur le prochain repli. 👀
$PHA
$ZETA
#CryptoTrading #BinanceSquare #CryptoMarkets
Jacob trade
·0 mentions J’aime
·86 vues
MultiversXPlansHardForkRecovery
20,071 vues
533 mentions
CircleLaunchesInstitutionalBTCBackedBorrowing
19,846 vues
659 mentions