


Titre original : (la licorne d’IA juridique valorisée à 11 milliards de dollars, financée par OpenAI, commence à « encapsuler » les modèles open source chinois)
Auteur de l’original : Dongcha Beating
Le 20 août, Harvey, la société d’IA juridique financée par OpenAI, a publié Tenet. Cette entreprise, fondée en 2022, est aujourd’hui valorisée à 11 milliards de dollars : c’est la société d’IA juridique la plus valorisée au monde. Elle sert des milliers d’institutions ; dans son registre d’actionnaires figurent également Sequoia, a16z et GIC.
Tenet est son premier ensemble de modèles maison ; la base utilise les pondérations ouvertes de Kimi K3 de juillet, provenant de « Moteur obscur de la Lune ». Tenet est encore à l’étape de prévisualisation de la recherche, et Harvey prévoit d’intégrer progressivement, dans le produit, les capacités qui auront été validées.
Le fondateur de Harvey, Winston Weinberg, était à l’origine avocat en contentieux chez O’Melveny & Myers ; Gabe Pereyra a travaillé sur des recherches de modèles de grande taille chez Google Brain et Meta. OpenAI y a investi très tôt ; par la suite, les deux parties ont aussi entraîné ensemble un modèle de jurisprudence. Elles ont ajouté des données de jurisprudence américaines d’environ 10 milliards de tokens à l’entraînement. Parmi les cas clients publiés par OpenAI à l’époque, Pereyra a déclaré que Harvey avait évalué différentes options et n’avait finalement fait confiance qu’à la solution réalisée conjointement avec OpenAI pour ce sur-mesure.
Ces dernières années, il a presque toujours été le client le plus typique des modèles en boîte noire dans le secteur des services professionnels, capable d’appeler les meilleurs modèles en boîte noire du monde. Mais lorsqu’il a décidé pour la première fois d’écrire réellement ses tâches juridiques, ses critères de notation d’avocat et sa puissance de calcul de deux mois dans un ensemble de poids, la base choisie n’était pas un modèle en boîte noire, mais un modèle ouvert provenant de Chine.
Une fois qu’un modèle est publié, l’industrie apprend rapidement deux choses : à quel point il est intelligent, et combien ces capacités valent en termes de prix. En quelques heures, les classements des benchmarks se mettent à jour, ceux d’Arena changent, et diverses cartes coordonnées entre intelligence et prix commencent à circuler. Un modèle entraîné pendant plusieurs mois et consommant énormément de puissance de calcul est finalement compressé en un simple point sur un graphique.
Pour la plupart des développeurs, cette méthode reste valable. Le postulat derrière tout cela est que, lorsque le modèle est remis à l’utilisateur, les capacités sont déjà largement figées. Quand les API en boîte noire dominent, ce postulat tient. Les entreprises de modèles terminent le pré-entraînement et l’entraînement après coup, puis encapsulent les capacités dans une interface. Les entreprises en aval peuvent modifier les instructions, faire de la recherche ou construire des agents, mais il leur est difficile de modifier le modèle lui-même.
Les poids ouverts brisent cette hypothèse. Après avoir reçu les poids, les entreprises peuvent continuer à intégrer leurs propres données et retours d’experts, en apportant les vraies tâches et les vrais critères d’évaluation dans l’entraînement. Deux modèles peuvent être publiés avec le même score de 90 à la base ; en poursuivant l’entraînement avec les mêmes données et la même puissance de calcul, l’un s’arrête à 91, tandis que l’autre peut monter jusqu’à 97. Pour les entreprises prêtes à investir plusieurs mois de temps, de puissance de calcul et de ressources d’experts, publier le même score de 90, c’est déjà un monde de différence.
Mais il y a une condition préalable. Les entreprises doivent être prêtes à investir des mois de temps et un lot de puissance de calcul pour continuer à entraîner : d’abord, il leur faut un ensemble de poids qui vaille la peine d’être entraîné. Ces dernières années, une distance persistait entre les modèles ouverts et les modèles propriétaires les plus avancés : pour la question-réponse générale et la rédaction de code au quotidien, l’écart n’était pas si grand. Mais dès qu’on entre dans des scénarios professionnels où le coût d’une erreur est élevé, cette distance s’amplifie. Le droit fait partie des domaines qui exigent le plus : dans le passé, pour réellement accéder au cœur des activités de sociétés comme Harvey, il fallait pratiquement être parmi les meilleurs modèles en boîte noire de l’époque. Les poids ouverts sont certes plus faciles à contrôler et à modifier, mais si même les tâches professionnelles les plus basiques ne peuvent pas être accomplies, alors l’espace d’entraînement en aval devient inexistant.
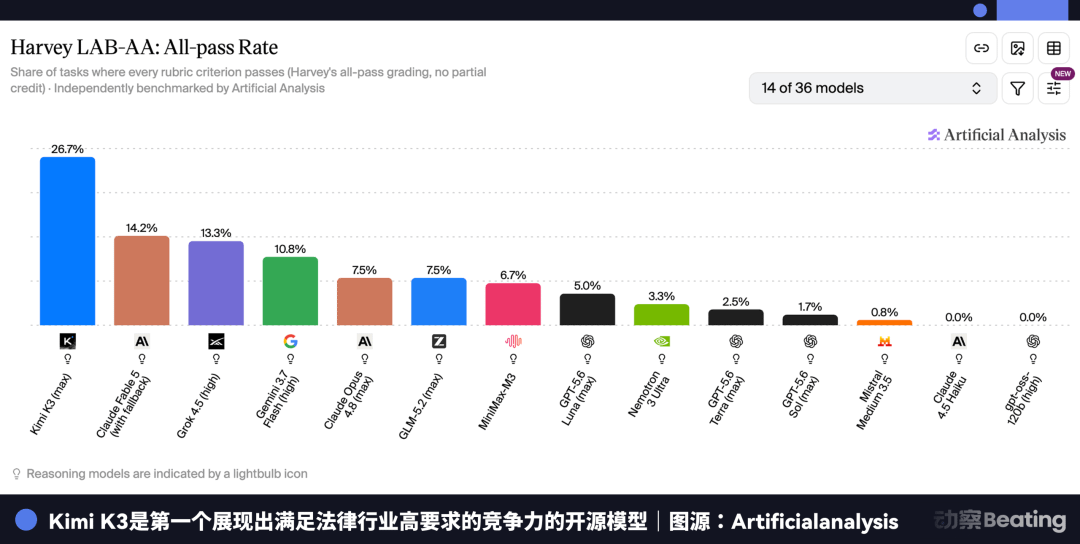
Kimi K3 franchit pour la première fois ce seuil de longue date. Avec un total de 2,8 billions de paramètres, il prend en charge un contexte de 1 million de tokens, et possède déjà de bonnes bases pour les tâches de longue durée, l’utilisation d’outils et le raisonnement complexe. Pour Harvey, les modèles à poids ouverts cessent pour la première fois d’être seulement une option moins coûteuse et offrant davantage de contrôle : ils entrent désormais dans une zone où ils peuvent être évalués sérieusement avec les modèles de pointe.
Elles ont donc commencé à s’intéresser à une question rarement discutée séparément auparavant : ces poids sont-ils faciles à continuer d’entraîner ?
Quand Cursor a entraîné Composer 2, il n’a pas sélectionné de modèle en suivant les classements d’agents de programmation courants. Son raisonnement est que les capacités des agents et celles des tâches longues changent énormément pendant l’apprentissage par renforcement ; le classement avant entraînement ne prédit pas nécessairement le résultat final. Par rapport aux scores des classements, Cursor valorise davantage les connaissances de programmation du modèle, sa capacité de suivi d’état, son perplexité sur le code base interne, ainsi que son efficacité d’exécution sur l’infrastructure maison. La base finalement choisie est le modèle Kimi K2.5.
Cognition, derrière Devin, a aussi fait le même constat. Après l’ouverture de K3, elle a rapidement intégré le modèle à Devin Desktop et à CLI ; sur sa FrontierCode 1.1 Extended, K3 obtient 58,2 % de score et 63,6 % de taux de réussite. Ce test évalue de véritables tâches d’ingénierie : est-ce que le code finit par être intégré dans la branche principale, et la qualité est-elle suffisante ? Tout compte. Cognition a aussi mentionné que K3 excelle particulièrement à reproduire des bugs et à gérer son propre environnement d’exécution : ce sont précisément les maillons les plus susceptibles de casser dans les tâches de programmation sur de longues séquences. Cognition a ensuite fait un entraînement après coup sur ces mêmes poids.
La vraie denrée rare, ce n’est pas la donnée juridique
Harvey connaît une croissance très rapide. En mars de cette année, il servait environ 1 300 organisations et plus de 100 000 avocats ; cinq mois plus tard, le nombre de clients a presque doublé, couvrant 70 pays. Plus des trois quarts des cabinets AmLaw 100 utilisent Harvey.
Les projets de services juridiques sont coûteux, et la tolérance aux erreurs y est très faible. Un rapport de due diligence en cas de fusion-acquisition peut nécessiter de retrouver des clauses de changement de contrôle dans des centaines voire des milliers de documents, déterminer si la transaction est déclenchée, puis identifier les risques en les reliant aux preuves textuelles originales. Entre les deux, il existe souvent des dizaines de jugements qui doivent être valides en chaîne ; il suffit d’en laisser passer un qui a un vrai impact sur la transaction, et une grande partie du travail fait correctement n’a plus vraiment de valeur.
À mesure que le nombre de cabinets de services augmente, Harvey a aussi accumulé une catégorie de données de base difficiles à obtenir pour une entreprise de modèles elle-même. Elle sait comment les avocats vont structurer une tâche, et elle sait où les associés vont ensuite chercher des erreurs dans les résultats.
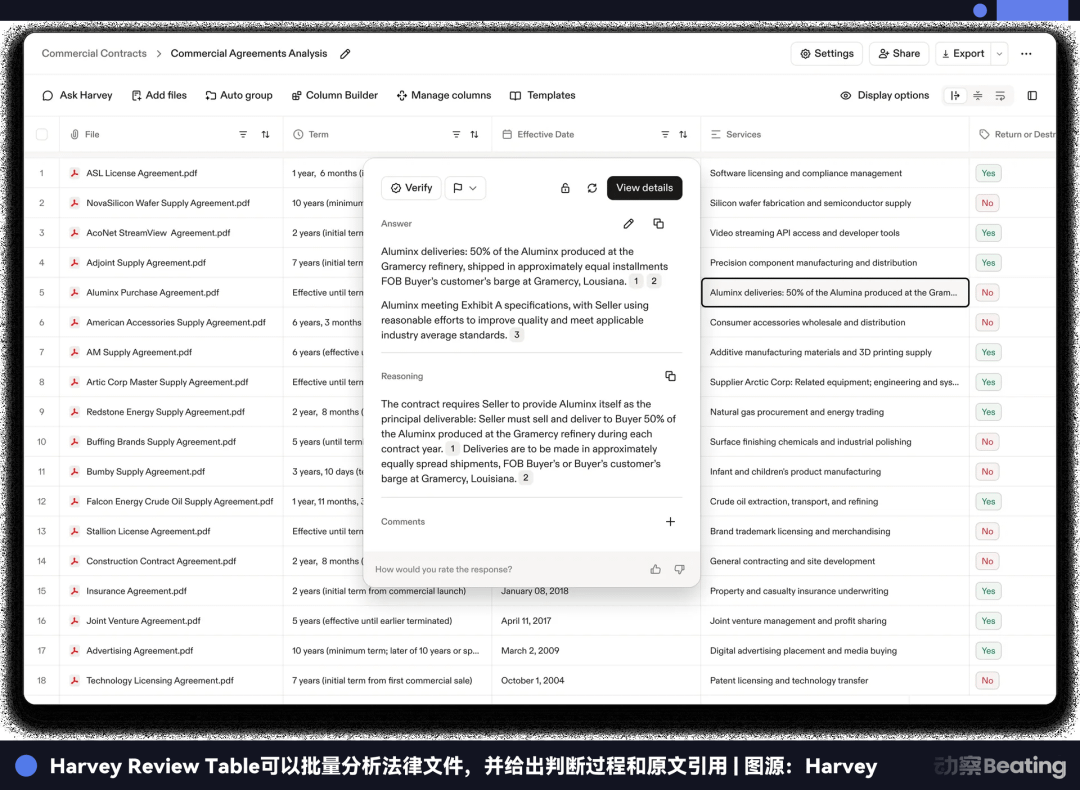
Ces expériences ont ensuite été transformées en Legal Agent Benchmark. Il contient plus de 1 200 tâches juridiques sur de longues séquences, couvrant 24 domaines d’exercice. Chaque tâche est décrite en moyenne par seulement une cinquantaine de mots, puis le modèle évolue dans un environnement fermé relatif au dossier client. Des documents pertinents et une grande quantité de matériel sans rapport sont mélangés : le modèle doit donc rechercher, lire, juger, puis produire un résultat de travail vérifiable point par point.
Chaque tâche a en moyenne environ 50 critères d’évaluation ; des tâches complexes peuvent en comporter plusieurs centaines. On décompose tout : est-ce que les faits ont été trouvés au complet, le raisonnement permet-il de conclure correctement, les citations correspondent-elles au texte original, le niveau de risque et les recommandations sont-ils appropriés. Une tâche peut durer au maximum plus de 1 000 tours, et consomme des dizaines de milliers de tokens.
Après quelques années, les jeunes avocats finissent par comprendre progressivement ce qui inquiète réellement les clients, et ils se souviennent aussi de ces clauses qui paraissent anodines mais qu’il ne faut jamais laisser passer. Ces expériences étaient autrefois difficiles à consigner complètement dans des manuels ; elles restaient le plus souvent dans les modifications des associés, dans les habitudes de travail internes des équipes, et dans des documents déjà livrés.
Harvey a transformé une partie de ces éléments en tâches, documents et critères de notation. À chaque fois que le modèle termine un travail, le processus génère ainsi un retour qui peut être calculé et comparé.
Les instructions et la recherche indiquent au modèle où trouver les informations ; les critères d’évaluation commencent alors à répondre à une autre question : à quel niveau un travail juridique est-il réellement « terminé » ? Ces dernières années, Harvey a accumulé, en plus des clients et des données juridiques, tout un système d’évaluation professionnelle directement utilisable pour l’entraînement des modèles.
Écrire l’expérience juridique dans les poids
Ces tâches et critères d’évaluation entrent alors vraiment dans le processus d’entraînement : les données proviennent de documents juridiques publics, de données synthétiques et de données d’experts humains. Des avocats en exercice participent à la construction des tâches, à la notation et à la relecture/validation des données synthétiques. Harvey a préparé au total environ 1 750 environnements de tâches pour des agents juridiques.
Une fois que le modèle entre dans un espace de travail doté de documents et d’outils, il doit lire les fichiers lui-même, appeler les outils et soumettre les résultats. Le système vérifie ensuite, selon les critères définis par les avocats, l’ensemble de la trajectoire de travail : à quel niveau les exigences spécifiques sont-elles respectées, dans quelle mesure le problème juridique est résolu. Si toutes les exigences clés sont validées, il reçoit aussi une récompense supplémentaire.
Chaque cycle d’entraînement produit plus de dix mille trajectoires de tâches. Harvey utilise une stratégie d’ordonnancement des séquences pour optimiser, c’est-à-dire la GSPO, ce qui amène le modèle à produire plusieurs façons de faire sur la même tâche, puis à mettre à jour les poids en fonction des écarts de qualité entre les résultats. Lorsque les scores de deux trajectoires se ressemblent trop, le système peut aussi les re-noter, afin de réduire l’impact du bruit dans l’évaluation sur l’entraînement.
L’ensemble du processus a duré environ deux mois, en utilisant quelque 150 cartes NVIDIA B300. Pré-entraîner un modèle de pointe mobilise généralement des dizaines de milliers de cartes ; la puissance de calcul engagée par Harvey est d’un autre ordre de grandeur. Harvey utilise un rank-64 LoRA, couvrant les couches d’attention de Kimi K3, le réseau feed-forward et les poids de routage des experts, soit environ 500 000 tenseurs d’experts.
L’entraînement sur de longues trajectoires rencontre aussi un problème d’ingénierie. Une tâche juridique peut durer des centaines de tours : pendant que le modèle génère la trajectoire, les poids côté entraînement sont mis à jour. Quand l’entraîneur revient ensuite recalculer cette trajectoire, si les états des modèles des deux côtés ne correspondent pas, la probabilité associée à chaque action à ce moment-là change, et la récompense est alors difficile à attribuer précisément à la décision d’origine.
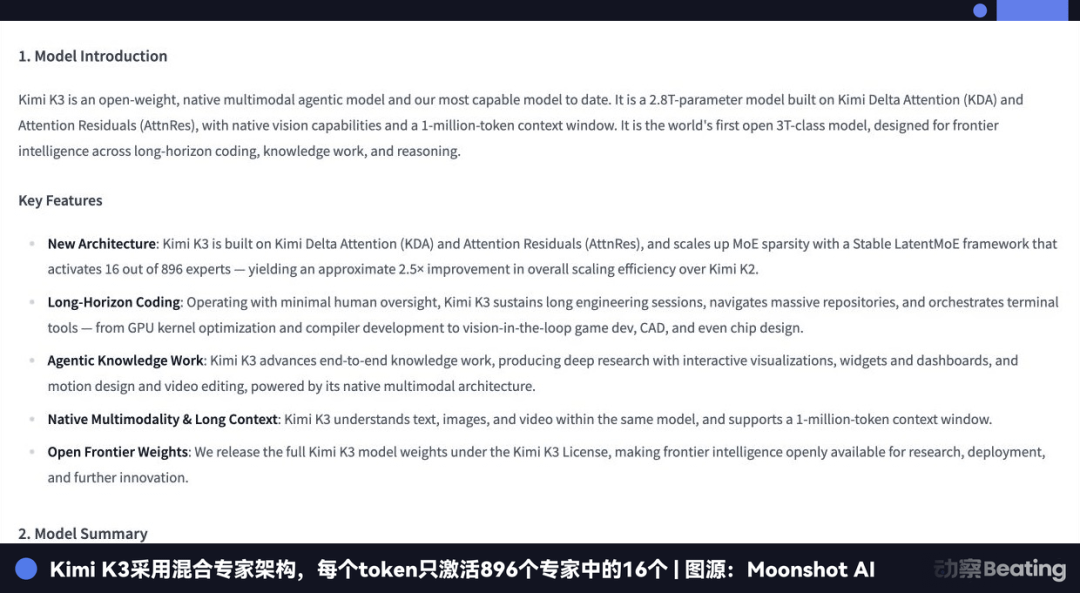
La structure d’experts mixtes de Kimi K3 rend cette question plus complexe. Après qu’un token entre dans le modèle, le routeur sélectionne 16 experts parmi 896 pour participer au calcul. Si des différences minimes existent entre l’entraînement et l’exécution en termes de précision numérique ou de manière de batcher, le même token peut être attribué à des experts différents, et la trajectoire originale devient alors difficile à reproduire entièrement.
Harvey et ses fournisseurs ont donc aligné numériquement l’entraîneur et l’environnement d’exécution au niveau du noyau. À chaque mise à jour des poids, ils se chargent directement à chaud dans l’environnement d’exécution, sans avoir besoin d’arrêter et de régénérer la tâche à répétition. Le système enregistre aussi les résultats de routage des experts correspondant aux tokens, afin que lors du recalcul, l’entraîneur puisse revenir au maximum sur la trajectoire suivie au moment où le modèle l’a générée.
Arrivé à ce niveau, Tenet ressemble moins à un ajustement fin standard consistant simplement à injecter du corpus juridique dans un modèle. Harvey met en place une procédure d’entraînement exécutable de manière répétée. Les tâches juridiques entrent continuellement dans l’environnement : le modèle effectue le travail ; les avocats évaluent l’ensemble de la trajectoire selon des standards définis ; les poids sont ensuite mis à jour ; le nouveau modèle revient alors dans l’environnement pour exécuter la tâche suivante.
La question de savoir si Kimi K3 peut être entraîné de façon stable et continue est aussi vérifiée en pratique dans ce genre de boucle.
Après entraînement, il ressemble davantage à un agent juridique
Ce que Harvey cherche vraiment à améliorer, c’est la capacité du modèle à effectuer des tâches juridiques sur de longues séquences. Il adopte une définition très stricte du « all-pass » : tous les critères de notation essentiels d’une tâche doivent être validés. D’après les résultats internes publiés par Harvey, sur l’ensemble LAB de réserve non utilisé pour l’entraînement, le nombre de tâches complétées de bout en bout par Tenet est proche du double de celui du Kimi K3 initial, et le taux all-pass passe d’environ 11 % à 19,7 %, soit une hausse d’environ 9 points de pourcentage.
Dans les LAB spécialisés dans la rédaction, la vérification et la négociation de contrats, le nombre de tâches complétées augmente d’environ 20 %, le taux all-pass atteint 11,3 %, soit une hausse d’environ 2 points. D’après le propre classement de Harvey, Tenet est classé n°1 dans LAB Contracts et n°2 dans l’ensemble complet de LAB.
Il a ensuite intégré Tenet dans deux batteries de tests externes : l’APEX Agents Corporate Law de Mercor et le Redline Bench de Crosby. Le premier teste des tâches professionnelles longues séquences dans un environnement simulant le travail ; le second exige que le modèle modifie en continu un contrat, puis qu’il soit noté selon des critères définis par des avocats.
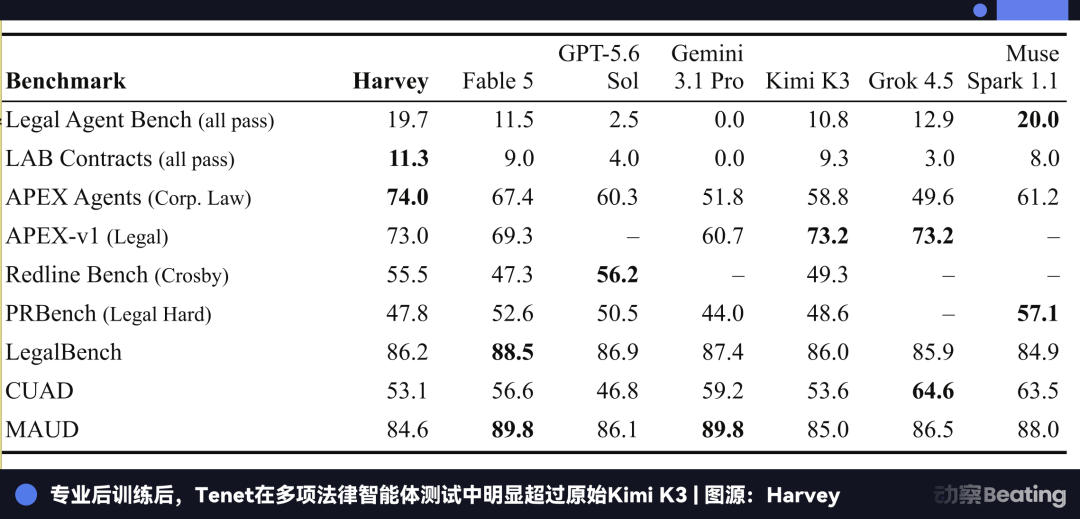
Tenet n’a pas eu accès aux données d’entraînement de ces deux jeux de tests ; ses résultats restent néanmoins nettement supérieurs à ceux du Kimi K3 initial, ce qui indique que les capacités acquises dans l’environnement de tâches de Harvey peuvent être transférées vers de nouvelles tâches juridiques.
Mais l’autre problème, c’est qu’un entraînement spécialisé après coup rend souvent le modèle de plus en plus compétent pour un type de tâches, tout en lui faisant perdre une partie de ses connaissances d’origine et de ses capacités de raisonnement.
Sur LegalBench, CUAD et MAUD, Tenet ne montre pas de recul apparent. Dans les sous-difficultés du Scale Professional Reasoning Benchmark, le score passe même légèrement de 36,0 % à 36,8 %. Au moins au vu de cet ensemble de résultats, après que Kimi K3 est devenu plus fort sur les tâches juridiques, il n’y a pas de problème évident d’oubli des capacités.
La conception de la récompense de Harvey favorise des trajectoires plus courtes lorsque la qualité des résultats se ressemble : chaque lecture supplémentaire d’un document ou appel d’outil par un agent juridique augmente la consommation de tokens et le temps d’attente. Après entraînement, Tenet réduit une partie des étapes inutiles : la qualité des tâches augmente, tandis que le coût pour terminer le travail reste globalement stable.
Cette fois, ce que l’entraînement après coup a modifié davantage, c’est la manière dont Kimi K3 traite le travail juridique complexe. Il planifie mieux les étapes, appelle davantage les outils, et il omet aussi beaucoup moins les exigences clés présentes dans les tâches.
Harvey a commencé dès 2025 à adopter une stratégie multi-modèles. Cette année encore, il continue à intégrer de nouveaux modèles d’OpenAI et d’Anthropic. Tenet permet enfin, dans cette architecture, d’ajouter pour la première fois un modèle à poids ouverts entraîné et contrôlé par Harvey lui-même.
Il lui faut un modèle dont la base est déjà validée. Les tâches juridiques de Harvey peuvent traiter大量 de documents, exécuter des centaines voire un millier de tours consécutifs, et le modèle doit maintenir un état pendant un travail très long. L’entraînement après coup peut continuer à façonner la manière dont il traite le juridique, mais il est difficile de rattraper entièrement, depuis zéro, des capacités que la base ne possédait même pas au départ.
Une autre condition, c’est le contrôle. Harvey peut appeler GPT et Claude via une API, mais ne peut pas continuer à écrire 1 750 environnements de tâches juridiques et les critères d’évaluation des avocats dans ces modèles en boîte noire. Les poids ouverts lui permettent de décider par lui-même comment entraîner, comment concevoir les récompenses, et aussi de conserver les capacités professionnelles obtenues dans les poids qu’il contrôle.
Mais après avoir obtenu les poids, il faut encore évaluer si ce modèle convient à un entraînement continu. Peut-on faire tourner de façon stable l’apprentissage par renforcement sur de longues trajectoires ? Le routage des experts mixtes peut-il reproduire fidèlement ? Après amélioration des capacités professionnelles, risque-t-on de perdre les connaissances d’origine ? Peut-on encore contrôler le coût du raisonnement dans la plage utilisable en production ? Il faut vraiment essayer pour le savoir.
Après avoir exécuté Tenet sur deux mois, Kimi K3 a fourni la réponse de cette phase. Le processus d’entraînement pouvait tourner de façon stable : les capacités sur les tâches juridiques ont augmenté de manière nette. Aucun oubli significatif des capacités n’a été observé, et les coûts n’ont pas dérivé en même temps que la performance.
Pour Harvey, ces résultats sont plus importants que « l’ouverture des poids » en elle-même. Les poids peuvent être téléchargés : cela signifie seulement que l’entreprise a le droit de continuer à entraîner. C’est le nombre de capacités conservées après entraînement qui détermine si cette série de modèles mérite qu’on y investisse encore de la puissance de calcul, des données et du temps d’experts.
Une autre activité de l’entreprise de modèles
Harvey dit que son objectif est de permettre aux cabinets d’avocats d’entraîner leurs propres modèles propriétaires sur des poids ouverts, tout en possédant les capacités formées après entraînement. Ce que Tenet livre n’est pas tant un modèle qu’une méthode.
Auparavant, le business des entreprises de modèles se faisait surtout via l’utilisation après publication du modèle. Les poids ouverts apportent une relation différente : une entreprise peut récupérer un modèle de base existant, le continuer à entraîner, garder les connaissances de son secteur dans les poids, puis obtenir un modèle plus proche de ses propres activités.
Ce type de besoin était auparavant difficile à transformer en un véritable marché. Quand les capacités des modèles généraux ne sont pas assez fortes, les entreprises verticales, même avec les poids, ont du mal à combler uniquement par un entraînement spécialisé après coup le raisonnement sur de longues séquences, l’appel d’outils et la gestion des tâches complexes. En pré-entraînement complet, c’est trop coûteux, et dans la plupart des cas, les entreprises n’en voient pas l’intérêt.
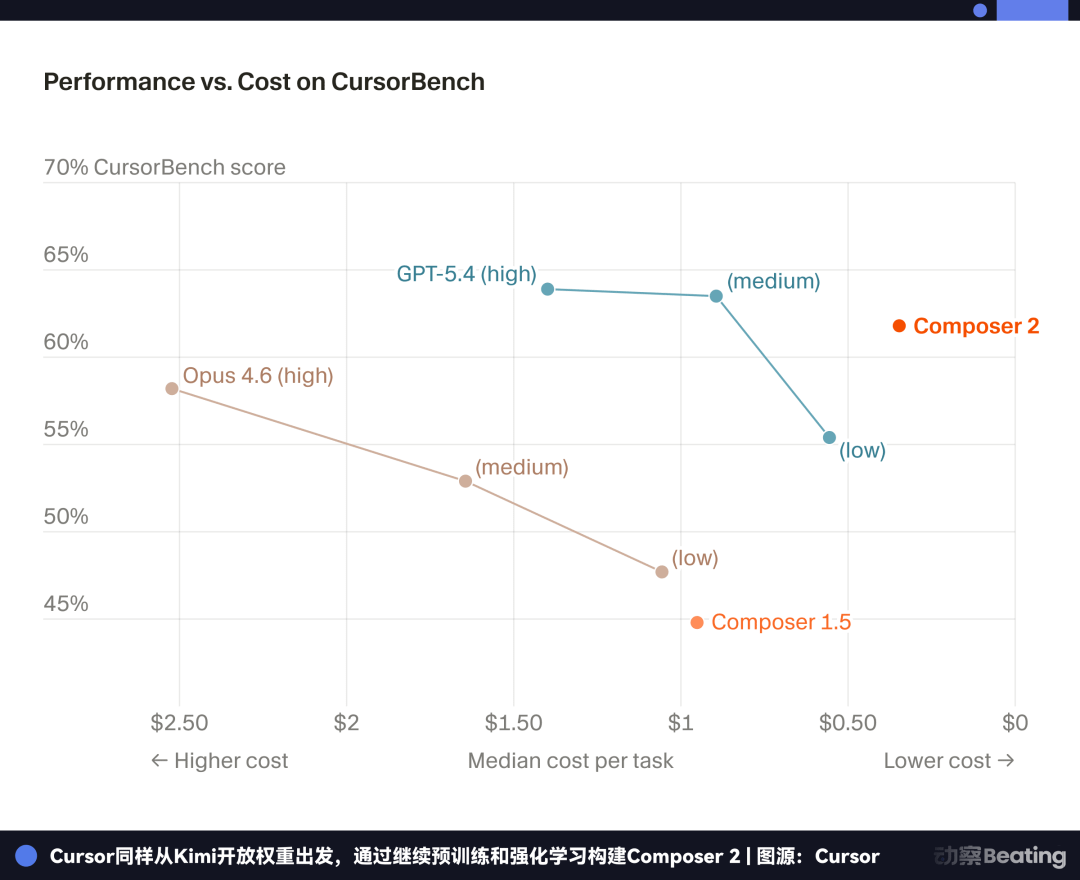
Dans la programmation, Cursor a entraîné Composer 2 ; Cognition a ensuite continué l’entraînement du modèle utilisé par Devin sur les mêmes poids ; puis Harvey a fait Tenet dans le domaine juridique. La programmation et le droit sont très éloignés, mais tous deux ont choisi de partir des capacités générales déjà entraînées par Kimi, puis d’y incorporer les tâches professionnelles les plus familières.
Tenet rend aussi ce problème plus concret. En deux mois, avec environ 150 cartes, plus un ensemble de critères d’évaluation définis par des avocats en exercice, une entreprise peut pousser des poids généraux jusqu’au niveau de pointe de son secteur. Le seuil de puissance de calcul a déjà baissé d’un ordre de grandeur ; la partie plus difficile à reproduire a commencé à se déplacer de ce côté : qui peut clairement dire jusqu’à quel point un travail professionnel est considéré comme « terminé » ?
Le développement logiciel et le droit ne sont que deux exemples déjà apparus. La finance, le conseil, la pharmacie, la comptabilité, ainsi que de nombreuses autres professions de services spécialisés, disposent toutes de leurs propres données, de leurs processus de travail et du jugement de leurs experts. Ce sont, à elles seules, des marchés du travail intellectuel à l’échelle de plusieurs milliers de milliards de dollars. Les entreprises tout en haut n’entraînent peut-être pas elles-mêmes des modèles de base à partir de zéro, mais elles ont de plus en plus les moyens de continuer à entraîner, sur un ensemble de poids déjà mature, leurs propres modèles.
Si ce parcours continue d’être valide, le marché auquel fait face Kimi ne se résumera plus au nombre de personnes qui l’appellent. La suite mérite surtout d’être surveillée : après Harvey, Cursor et Devin, combien d’autres entreprises choisiront de continuer à entraîner leurs propres modèles sur Kimi ?
Lien vers la source