


Titre original : (DeepSeek publie un modèle de compréhension visuelle, les « Big Blue Whales » et d’autres n’arrivent que plus tard…)
Auteur de l’article original : 动察Beating
Le 21 août 2026, DeepSeek a lancé un tout nouveau modèle de compréhension visuelle, deepseek-v4-flash-vision-exp, et a officiellement ouvert l’API multimodale. Pour la première fois, les développeurs peuvent envoyer des images directement dans l’interface officielle de DeepSeek.
Le modèle conserve le contexte de 1 million de tokens et la sortie maximale de 384 000 tokens de V4 Flash. Il prend en charge JSON Output, Tool Calls et l’API Responses, et est également compatible avec l’API d’Anthropic.
Les prix suivent également entièrement ceux de V4 Flash. Pour 1 million de tokens en entrée, lorsque le cache n’est pas utilisé, le tarif est de 3 yuans en période de pointe et de 1,5 yuan en période creuse ; lorsque le cache est utilisé, les tarifs sont respectivement de 0,1 yuan et de 0,05 yuan. Pour la sortie, le tarif est de 9 yuans en période de pointe et de 4,5 yuans en période creuse. À Pékin, de 9 h à 12 h et de 14 h à 18 h chaque jour sont considérés comme la période de pointe ; les 17 autres heures bénéficient du tarif à moitié prix.
Les images sont aussi facturées en tokens. Avant d’entrer dans le modèle, chaque image est redimensionnée automatiquement selon sa taille : les images de moins d’environ 384×384 pixels sont agrandies, et les grandes images sont compressées à une quantité totale de pixels d’environ 800×800 pixels. Une image peut au maximum occuper 384 tokens. Une image de 2000×2000 et une image de 5000×5000 peuvent finir par consommer exactement le même nombre de tokens.
Selon une limite de 384 tokens, en période de pointe et avec une entrée sans cache, le coût par image est d’environ 0,001152 yuan. Pour traiter 1 000 images de ce type, le coût lié uniquement à l’entrée image n’est que d’environ 1,152 yuan ; le texte et la sortie du modèle se calculent séparément.
Il y avait aussi Files API lancé en même temps. Les développeurs peuvent téléverser des images à l’avance, puis insérer le file_id dans la requête. Une seule transmission suffit pour la même image ; ensuite, elle peut être réutilisée à maintes reprises dans différentes requêtes.
Cette API n’est pas payante en soi. Un fichier maximal fait 64 Mio, et par utilisateur on peut stocker jusqu’à 25 Gio, soit 10 000 fichiers au maximum. Les fichiers peuvent expirer entre 1 heure et 30 jours ; si aucune durée de validité n’est définie, ils peuvent être conservés indéfiniment. Pour l’instant, l’officiel ne fournit pas d’interface pour télécharger le contenu des fichiers. Les développeurs peuvent téléverser, consulter et supprimer ; le modèle peut les lire. C’est plutôt une bibliothèque d’images gratuite, préparée pour l’inférence, qu’un simple cloud drive.
Mais en fait, ce qui est étrange, ce n’est pas que DeepSeek ne fasse du vision que jusqu’à aujourd’hui.
Deux lignes temporelles
Si on ne regarde que la recherche, la vision de DeepSeek n’est pas en retard.
Si on regarde seulement le produit et l’API, alors oui, c’est en retard depuis longtemps.
Le 11 mars 2024, DeepSeek-VL a été open-source.
Il existe deux versions, 1,3B et 7B : elles peuvent voir des images naturelles, des pages web, des formules, des graphiques et des documents. En octobre, Janus apparaît : il place la compréhension d’image et la génération dans le même cadre auto-régressif. Le 13 novembre, JanusFlow suit. En décembre, DeepSeek-VL2 est publié : il remplace le tout par une architecture de mixture d’experts, avec trois paliers de paramètres, 3B, 16B et 27B.
À l’aube du 28 janvier 2025, jour de la veille du Nouvel An lunaire, Janus-Pro a été open-source. Le dépôt officiel le date au 27 janvier en UTC.
La version 7B obtient 0,80 à l’évaluation GenEval sur les consignes de génération d’image en langage, dépassant le 0,67 de DALL-E 3 listé dans l’article. Il a des poids open-source, peut être déployé localement, et dispose aussi de démonstrations publiques.
DeepSeek ne l’a pas intégré à sa propre API hébergée.
Juste la semaine précédente, R1 avait déjà mis DeepSeek sous les projecteurs. Janus est resté sur GitHub et Hugging Face. Pour la grande majorité des utilisateurs ordinaires, il a ensuite rapidement disparu de la vue.
Le 20 octobre 2025, DeepSeek-OCR a été open-source, compressant les longs documents grâce à des tokens de vision. Le 27 janvier 2026, OCR 2 est publié.
En comptant à partir de DeepSeek-VL, sur ces deux années, au moins sept traces publiques peuvent être retrouvées : DeepSeek-VL, Janus, JanusFlow, VL2, Janus-Pro, OCR et OCR 2.
La recherche en vision a toujours été menée et diffusée au fil du temps.
Ce qui manquait, c’était juste ce point d’accès : il n’a pas été donné aux développeurs ordinaires.
De l’autre côté, en mars 2024, les interfaces de développeurs de plusieurs concurrents majeurs étaient déjà capables de recevoir des images. OpenAI a ouvert en novembre 2023 GPT-4 Turbo with Vision : les images pouvaient entrer directement dans l’API Chat Completions ; un mois plus tard, Google a lancé l’API Gemini Pro Vision ; en mars 2024, Claude 3, toute la gamme, a ajouté des capacités visuelles.
Le 25 avril 2025, lors du Baidu Create Summit, Li Yanhong a déclaré : « DeepSeek n’est pas non plus omniscient ». Parmi les problèmes listés ensuite, il y avait aussi ceux liés à la modalité unique.
Son avis, c’est que le multimodal deviendra un standard des modèles de base, tandis que le marché des modèles purement texte deviendra de plus en plus petit.
À l’époque, DeepSeek avait déjà fait un an de recherche en vision.
À l’aube
Les 7 et 8 avril 2026, certains utilisateurs ont ouvert DeepSeek : trois entrées sont soudain apparues dans l’interface.
« Rapide », « expert », « visuel ».
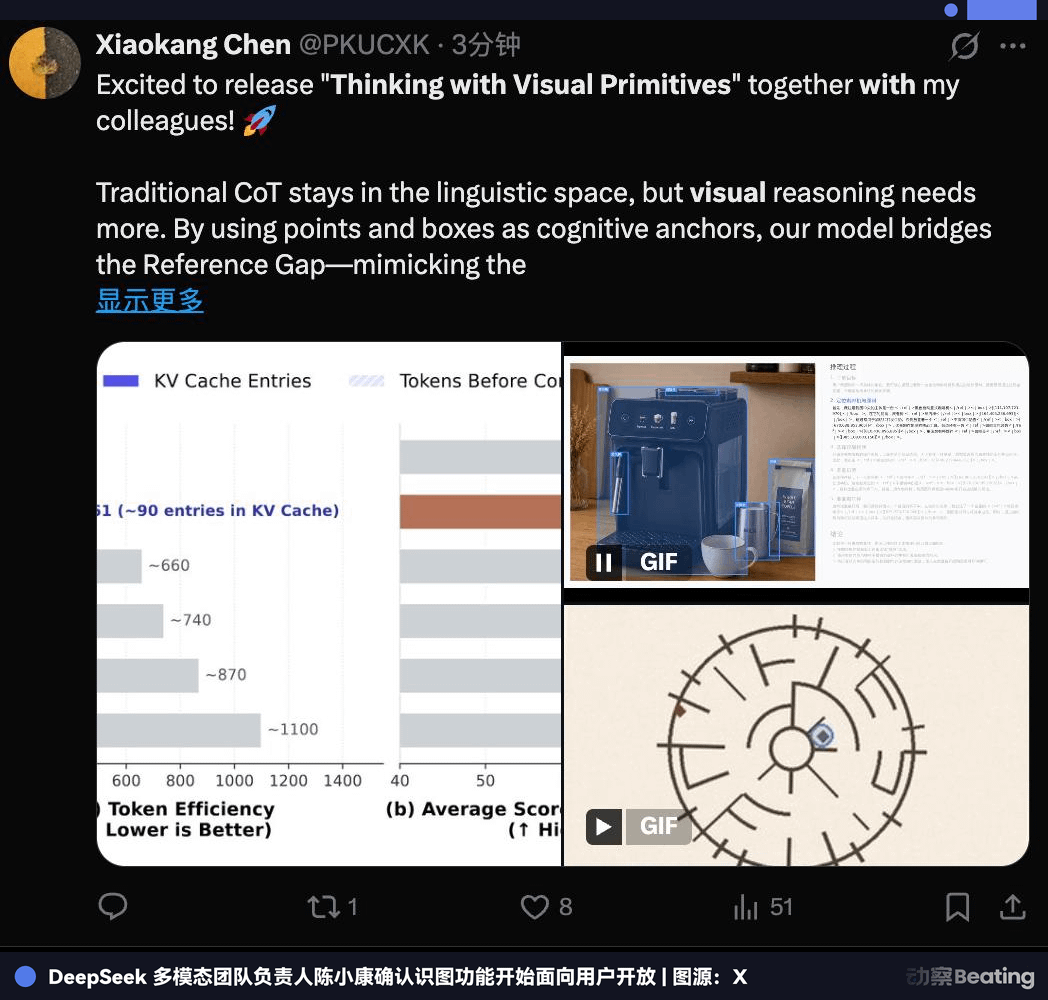
Le 29 avril, Chen Xiaokang, responsable de l’équipe multimodale de DeepSeek, a confirmé que la fonctionnalité de reconnaissance d’images commençait un déploiement progressif auprès de certains utilisateurs. Puis, un chercheur senior de DeepSeek a écrit : « Le petit poisson-baleine peut désormais voir ». Le South China Morning Post a carrément mis cette phrase dans le titre.
Les yeux de DeepSeek se sont pour la première fois vraiment montrés à l’extérieur de l’interface produit.
Le lendemain, DeepSeek a mis (Thinking with Visual Primitives) sur GitHub. Quelques heures plus tard, le dépôt et l’article ont été retirés. Le 1er mai, l’adresse originale renvoyait déjà 404. DeepSeek n’a pas expliqué ; il ne restait en ligne que des miroirs de l’article et des reformulations par les médias.
L’article de recherche porte sur un problème très précis.
Après avoir vu une image très chargée, le modèle sait souvent de quoi il parle, mais ne parvient pas à dire précisément lequel des individus ou quelle des lignes il évoque. L’équipe a intégré directement les coordonnées des points et les bounding boxes dans le processus d’inférence : le modèle peut ainsi pointer l’emplacement tout en continuant sa réflexion.
Une image de 756×756 passe d’abord par un encodeur visuel pour devenir 2916 tokens de blocs d’image, puis subit une compression spatiale 3×3 pour n’en faire plus que 324 tokens. L’attention clairsemée de V4 Flash compresse davantage le cache, et à la fin il ne reste que 81 entrées KV visuelles.
L’équipe a aussi généré plus de 40 millions d’échantillons d’entraînement pour cette méthode, incluant des données spécialement entraînées pour la navigation dans des labyrinthes et le suivi de trajectoire.
Ce que cet article a demandé beaucoup d’efforts pour résoudre, c’est en réalité « indiquer du doigt ».
Le modèle doit d’abord voir, puis savoir où il est en train de regarder. Ce n’est qu’ainsi qu’il peut continuer à raisonner en aval.
Cette fois, DeepSeek n’a pas expliqué si Vision Exp reprend intégralement cette solution de Visual Primitives. Mais plus important encore, cette recherche a pour la première fois exposé au grand public la manière dont DeepSeek comprend la « raisonnement visuel ».
Le 18 juin, le mode « prise d’image » sur le web et dans l’application a été lancé officiellement. Le lendemain, des médias ont téléversé des photos de Liang Wenfeng pour des tests : DeepSeek l’a reconnu deux fois de suite comme Zhang Yiming. Dans une autre conversation, il l’a de nouveau reconnu comme Chen Tianshi, le fondateur de Cambrian.
Il sait lire des captures d’écran en anglais, et aussi transformer des pages web en code.
Devant un visage, et pourtant même son propre patron ne le reconnaît pas.
Le 19 août, DeepSeek Harness a laissé une note technique datée et très précise. Les adaptateurs officiels savent déjà sérialiser une séquence d’images en image_url. La documentation précise aussi que le répertoire de modèles par défaut n’affichera pas pour l’instant deepseek-v4-flash-vision-exp : il faut attendre que l’endpoint d’API correspondant soit disponible.
Le 20 août, des développeurs ont aussi confirmé par test qu’en envoyant une image au nom de ce modèle qui n’était pas encore ouvert, on ne recevait que l’erreur 400.
Le 21 août, cette restriction a été supprimée. Harness a ajouté deepseek-v4-flash-vision-exp au répertoire de modèles par défaut, et la soumission fusionnée correspondante affichait directement « publish the vision model ». Ensuite, la documentation de l’API officielle DeepSeek et la page公众号 ont annoncé en même temps le lancement de Vision Exp.
Les deux lignes ont fini par se rejoindre.
Agent
Dans une transcription d’un enregistrement lors d’une rencontre avec des investisseurs en mai de cette année-là, Liang Wenfeng a réparti la route vers l’AGI telle qu’il la comprend en plusieurs marches : modèles de langage, chaîne de pensée, Agents, apprentissage continu, auto-itération, puis intelligence incarnée.
Il a placé le multimodal à l’endroit des composants, un peu comme la recherche.
Quand on parle de génération vidéo, dans la transcription il y a une phrase :
Sur le plan commercial, c’est une bonne affaire. Mais cela n’a pas grand-chose à voir avec l’intelligence.
Son avis, c’est que le lien entre la génération vidéo et les modèles du monde, à ce stade actuel, et l’« upper bound » d’intelligence, n’est pas si déterminant. Ce qui est plus urgent, c’est l’entraînement de l’IA et, après l’entraînement, l’apprentissage continu.
La différence du multimodal, c’est que même s’il est aussi placé dans la catégorie « composants », c’est un composant dont DeepSeek a dit clairement qu’il serait réalisé. Liang Wenfeng l’avait aussi mentionné à l’époque : V4 et les versions suivantes supporteraient le multimodal natif.
Dans la feuille de route de DeepSeek, la vision a toujours eu une place, mais pas tout en haut.
Quand la feuille de route atteint la troisième étape, celle des Agents, la situation commence à être un peu différente.
DeepSeek n’a jamais dit publiquement que cette API Vision a été lancée « pour les Agents ». Mais si on met ensemble le jugement de Liang Wenfeng sur la feuille de route et l’annonce d’aujourd’hui, les deux lignes sont déjà difficiles à dissocier complètement.
Un Agent doit lire l’écran, regarder les graphiques, et traiter les captures renvoyées par les outils. Il ne peut pas vivre éternellement dans un monde purement texte. Ces capacités visuelles, développées depuis deux ans, finissent enfin par passer des articles, des dépôts et des pages de tests jusqu’à l’API.
Les trois exemples présentés aujourd’hui par DeepSeek pour Vision Exp ne sont pas non plus de simples « dire ce qu’on voit » : un Agent fabrique pour un client haut de gamme un PowerPoint pour un road trip au Tibet, un autre re-conçoit le site web de DeepSeek Harness, et un dernier produit une démo front-end avec des effets dynamiques à partir d’exigences visuelles.
Elles ont toutes besoin que le modèle traite à répétition des informations visuelles dans des tâches de longue durée.
La conception de l’API évolue aussi dans ce sens. L’API Responses accepte également input_image : après qu’un Agent navigateur a obtenu une capture d’écran de la page, il peut la renvoyer à un tour d’inférence suivant ; un Agent de code peut vérifier le résultat rendu, et les graphiques, les scan et les interfaces logicielles peuvent devenir directement un contexte.
Files API résout une autre question : la même image n’a pas besoin d’être téléversée à nouveau à chaque tour de requêtes. Un fichier peut y rester longtemps, et l’Agent n’a qu’à transmettre à répétition le file_id. Par requête unique, on peut aussi placer jusqu’à 600 images. Avec un lien externe ou Base64, la limite par image est de 32 Mio ; une fois référencée via Files API, elle peut aller jusqu’à 64 Mio.
Ce n’est déjà plus vraiment comme si on ajoutait un bouton « téléverser une image » dans une zone de chat.
C’est plutôt comme s’il comblait l’infrastructure de base dont les Agents ont besoin pour utiliser la vision.
Les quatre comparaisons d’Agents multimodaux publiées par DeepSeek sont aussi très peu orientées vers ce qu’on appelle au sens traditionnel « dire ce qu’on voit ».
ApexBench s’intéresse aux tâches de longue durée dans les domaines des banques d’investissement, du conseil et du droit. Agents' Last Exam provient de travaux réels issus de 55 domaines professionnels. Chartography évalue spécifiquement les courbes de Kaplan-Meier, les graphiques en bougies, les courbes de niveau, les diagrammes en ruban (sankey) et les graphiques de Porter. ZeroBench teste ensuite le raisonnement visuel multi-étapes via 100 problèmes difficiles conçus manuellement.
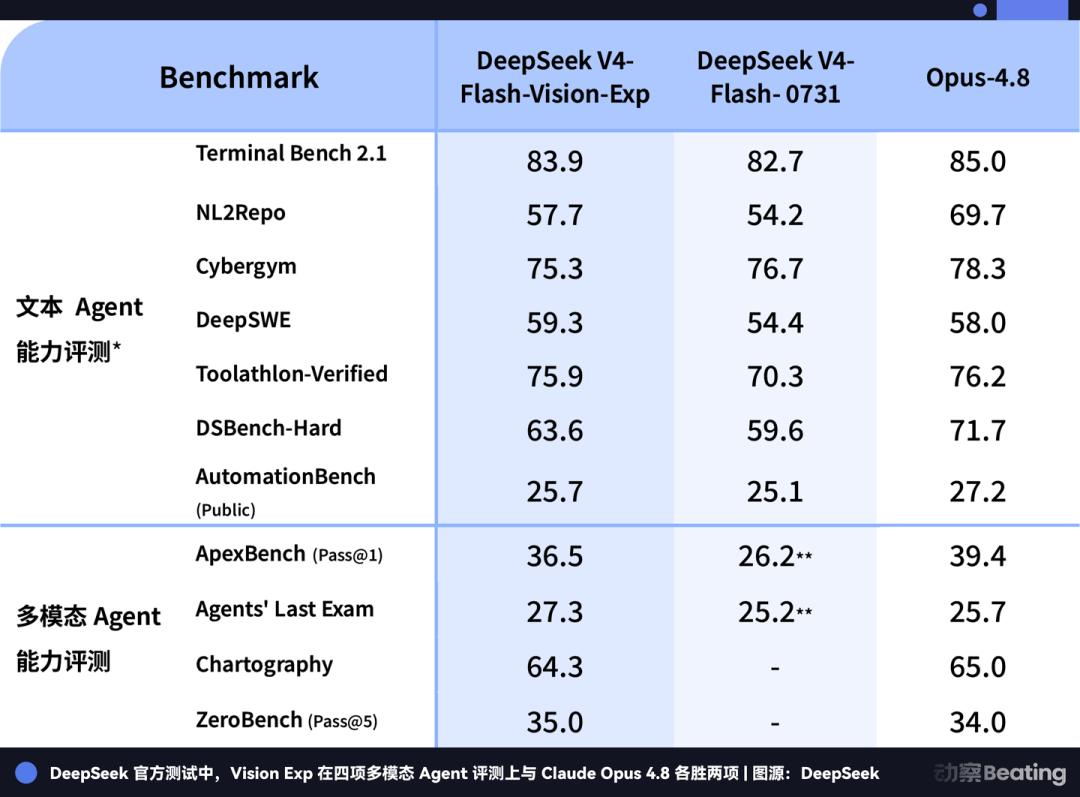
Vision Exp obtient deux victoires et deux défaites contre Claude Opus 4.8.
Agents' Last Exam : 27,3 contre 25,7. ZeroBench : 35,0 contre 34,0. ApexBench : 36,5 contre 39,4. Chartography : 64,3 contre 65,0. L’écart sur les quatre catégories ne dépasse pas 3 points.
Ce qui est encore plus intéressant, c’est qu’avec la vision, les capacités des anciens Agents texte n’ont pas nettement diminué.
En comparant point par point avec le V4 Flash purement texte publié le 31 juillet, le site web fournit aussi cinq évaluations pour des Agents texte — et toutes les notes augmentent, avant comme après.
Terminal Bench 2.1 passe de 82,7 à 83,9. NL2Repo de 54,2 à 57,7. DeepSWE de 54,4 à 59,3. DSBench-Hard de 59,6 à 63,6. AutomationBench de 25,1 à 25,7. Le 59,3 de DeepSWE dépasse aussi le 58,0 d’Opus 4.8 sur l’image.
Cependant, ces chiffres proviennent des propres tests de DeepSeek. L’officiel précise que, pour les tâches de texte d’Agents Code publiées, les modèles de la série DeepSeek utilisent le mode minimal de DeepSeek Harness, et le niveau d’inférence est réglé sur max. Ils sont donc plus adaptés pour observer les changements de Vision Exp par rapport au propre V4 Flash, plutôt que d’être utilisés directement comme classement indépendant de tierces parties.
L’« exp » derrière le nom du modèle n’a pas encore été retiré.
DeepSeek l’a clairement classée comme modèle expérimental ; la version peut encore évoluer. Pour le moment, l’interface ne fait que de la compréhension d’image, et la sortie reste du texte. La génération d’images et la vidéo n’ont pas été ouvertes ; Files API n’accepte que JPEG, PNG, GIF et WebP ; les PDF ne peuvent pas être intégrés directement.
En 2024, quand les développeurs voulaient envoyer une image à DeepSeek, l’API officielle ne savait pas encore la gérer.
Le 21 août 2026, cette image est enfin entrée.
Les yeux de DeepSeek se sont effectivement ouverts tard.
Quand elle a fini par vraiment ouvrir les yeux, le chemin devant elle n’autorisait plus qu’elle continue à avancer les yeux fermés.
Lien original