
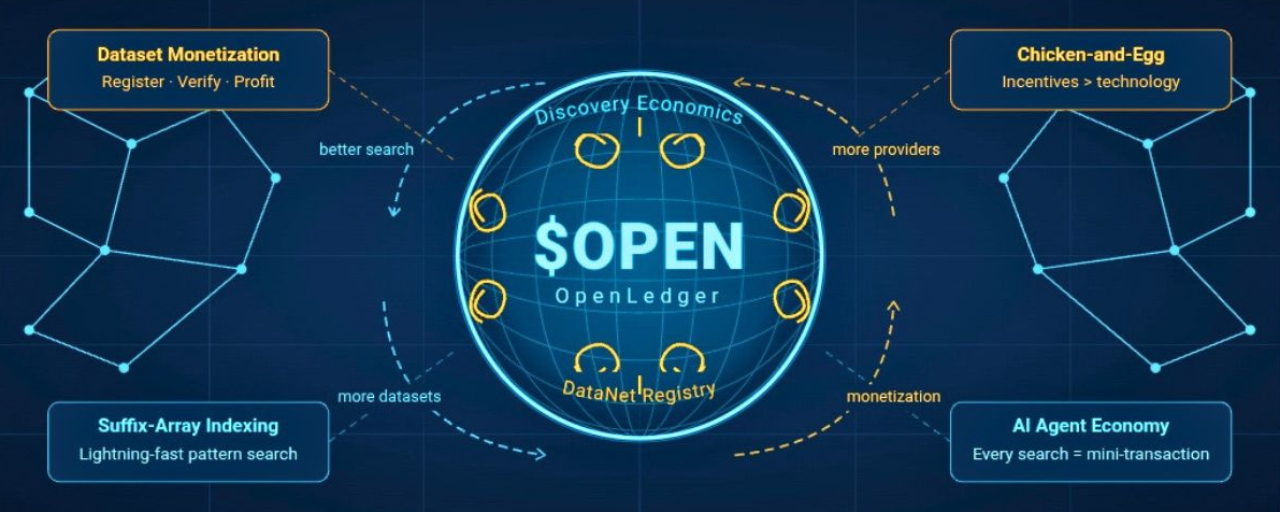


La première fois que j'ai ouvert le registre DataNet d'OpenLedger, je m'attendais à une autre histoire d'infrastructure AI. Au lieu de cela, ça m'a fait réfléchir aux bases de données.
D'habitude, quand les gens parlent d'infrastructure AI, on entend parler des modèles. Des modèles plus gros. Une inférence plus rapide. Des résultats plus flashy. Mais ce qui fait ou défait discrètement un système AI, ce ne sont pas les modèles ; c'est comment tu organises les données sous le capot.
La différence, du moins d'après ce que je vois, c'est que OpenLedger se concentre sur la découverte - pas seulement le stockage.
Pas les données elles-mêmes. Juste… la façon dont on les trouve.
Cette différence frappe plus fort que beaucoup de gens ne le réalisent.
Plus j’y regardais, plus ça ressemblait à des “économies de la découvrabilité”—l’idée que trouver des données pourrait devenir plus précieux que les stocker.
Ce qui m’a vraiment accroché, c’est de voir que l’indexation de type suffix-array était directement intégrée dans leur architecture. Si vous ne vous êtes jamais “nerdé” sur les suffix arrays auparavant, j’en ai découvert en bidouillant il y a des années pour de l’optimisation de recherche. Le principe est simple, mais c’est quand même un peu fou : ça vous permet d’organiser l’information de sorte que la détection de motifs s’enclenche littéralement, en ultra-rapide.
Ça sonne technique, oui, mais l’impact réel est économique.
Parce que lorsque ces agents d’IA commencent à tourner en autonomie, chaque recherche devient une mini-transaction. Chaque seconde supplémentaire passée à chercher, c’est de la friction. Chaque requête sans issue ? Un calcul vide, une énergie gaspillée. Quand les agents commencent à prendre des décisions à grande échelle, ces petites inefficacités s’accumulent à une vitesse folle.
C’est à ce moment-là que DataNet Registry a commencé à m’intéresser.
Au lieu de simplement jeter des ensembles de données sur Internet comme des fichiers statiques, elle les traite davantage comme des actifs que l’on peut découvrir et même monétiser. Le système ne se contente pas de les ranger dans un tiroir : il fournit des rails structurés pour enregistrer, vérifier, trouver, et peut-être tirer profit des jeux de données. Le tout sous un même toit.
Une meilleure efficacité de recherche améliore la productivité des agents. Des agents plus productifs consomment davantage d’ensembles de données. Une utilisation accrue des données crée des opportunités de monétisation, ce qui attire d’autres fournisseurs et renforce le réseau. C’est la logique de base derrière ce que j’ai commencé à appeler les “économies de la découvrabilité”.
En regardant en arrière, honnêtement, les couches de découverte ont tendance à éclipser le contenu lui-même. Les moteurs de recherche sont devenus plus importants que les sites web. Les stores d’apps ont dépassé la plupart des applications individuelles. Les places de marché gagnent parce qu’elles réduisent le plus gros casse-tête : faire correspondre ce dont les gens ont besoin avec ce qui est offert.
Je me dis sans arrêt—est-ce que ça pourrait arriver aussi avec des ensembles de données pour l’IA ? Surtout vu la façon dont les choses changent en ce moment.
On a l’impression que le marché glisse à nouveau vers le discours sur l’infrastructure. L’IA passe au premier plan, bien sûr, mais les investisseurs semblent davantage accrochés aux “tuyaux” et à la plomberie qui la soutiennent, plutôt qu’aux modèles qui font le spectacle. La crypto a déjà vécu ces rotations : d’abord, une excitation folle pour les applis… puis tout le monde poursuit les rails en dessous.
Parfois ? Cette deuxième phase capte bien plus de valeur que la première.
Mais les réseaux de données se heurtent à ce problème agaçant d’amorçage. Un registre ne fonctionne que lorsqu’il existe suffisamment de jeux de données “juteux” à l’intérieur. Et des jeux de données “juteux” n’apparaissent que si la découvrabilité et la capacité à en tirer de l’argent fonctionnent déjà.
Un vrai problème de poule et d’œuf.
La crypto ne cesse de trébucher sur ça. Qu’il s’agisse de pools de liquidité, de réseaux d’oracles, de stockage décentralisé—tout finit par tomber sur des variantes du même problème de tête.
Ce sont les incitations qui comptent plus que la technologie.
Beau registre ? Mais ça ne veut pas dire que les gens vont affluer. Les gens veulent de vraies raisons de partager des données, de les garder propres et de pouvoir faire confiance au système. Sinon, vous vous retrouvez avec une étagère sophistiquée pour des infos inutiles—un véritable désert numérique.
Honnêtement, c’est exactement ce avec quoi je me débat encore.
L’architecture est cool : elle marie l’informatique “à l’ancienne” avec de nouvelles recettes d’incitations basées sur la blockchain. Mais l’histoire me rappelle constamment ceci : la brillance technique et la durabilité dans le monde réel ne se manifestent pas toujours ensemble.
Peut-être que l’étincelle ne vient pas de la magie de l’indexation, mais du fait de rendre la découvrabilité elle-même un moteur économique natif pour l’IA.
Ou peut-être—ce n’est vraiment que de la fumée et des miroirs.
On dirait qu’on est au début, honnêtement. Difficile de distinguer ce qui relève vraiment de l’infrastructure de ce qui n’est qu’une histoire habillée pour faire croire à de l’infrastructure.
L’économie ne fonctionne que si la qualité des ensembles de données s’accroît en même temps que leur quantité. Croître ne suffit pas.
C’est peut-être ça que les économies de la découvrabilité testent vraiment : pas de savoir si les données ont de la valeur, mais si la découvrabilité peut devenir un marché à elle seule.
Si la découvrabilité devient une couche économique à part entière, DataNet Registry pourrait finir par être plus important que les jeux de données eux-mêmes. Sinon, ce n’est qu’un autre registre que personne n’utilise.
#OpenLedger @OpenLedger $OPEN
