
 Une chose que je pense que le marché comprend encore mal au sujet de l'intelligence artificielle, c'est que les entreprises n'optimisent pas réellement pour l'intelligence.
Ils optimisent pour la survie.
Ça semble cynique jusqu'à ce que tu vois comment les décisions technologiques en entreprise sont réellement prises.
Les conseils d'administration ne se soucient pas de savoir si un modèle est philosophiquement impressionnant. Les départements juridiques ne se soucient pas de savoir si l'architecture est élégante. Les équipes de conformité ne se réveillent pas excitées par les normes de raisonnement à la frontière. La plupart des entreprises se soucient finalement d'une seule chose :
Ce système peut-il créer de la valeur sans créer, plus tard, une exposition incontrôlable ?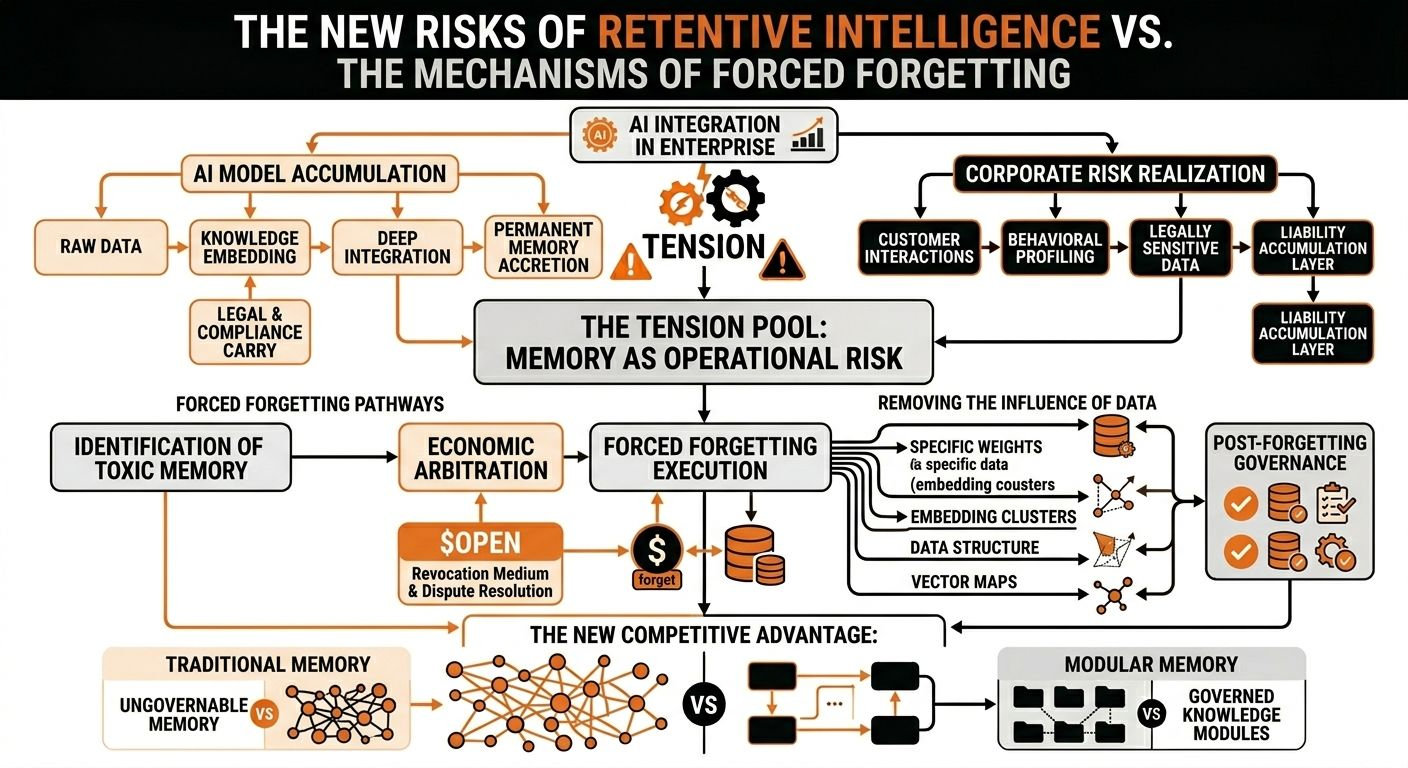
C’est pourquoi OpenLedger devient pour moi de plus en plus intéressant, au fur et à mesure que je réfléchis à la direction que prend l’IA d’entreprise.
La plupart des gens voient encore OpenLedger à travers l’objectif familier de l’IA décentralisée. Contributeurs de données, systèmes d’attribution, Datanets, coordination des modèles, incitations par jetons via $OPEN. D’accord. Cette interprétation de surface existe.
Mais je suspecte de plus en plus que la couche la plus importante est quelque chose d’autre entièrement.
OpenLedger pourrait en fait se positionner autour d’un futur où l’ignorance sélective devient stratégiquement économique.
Parce qu’à l’heure actuelle, le marché de l’IA est encore piégé dans une psychologie d’accumulation. Chaque entreprise pense que son avantage concurrentiel vient de la conservation de la plus grande quantité d’informations possible. Plus d’interactions clients. Plus de schémas comportementaux. Plus de dossiers historiques. Plus de contexte propriétaire.
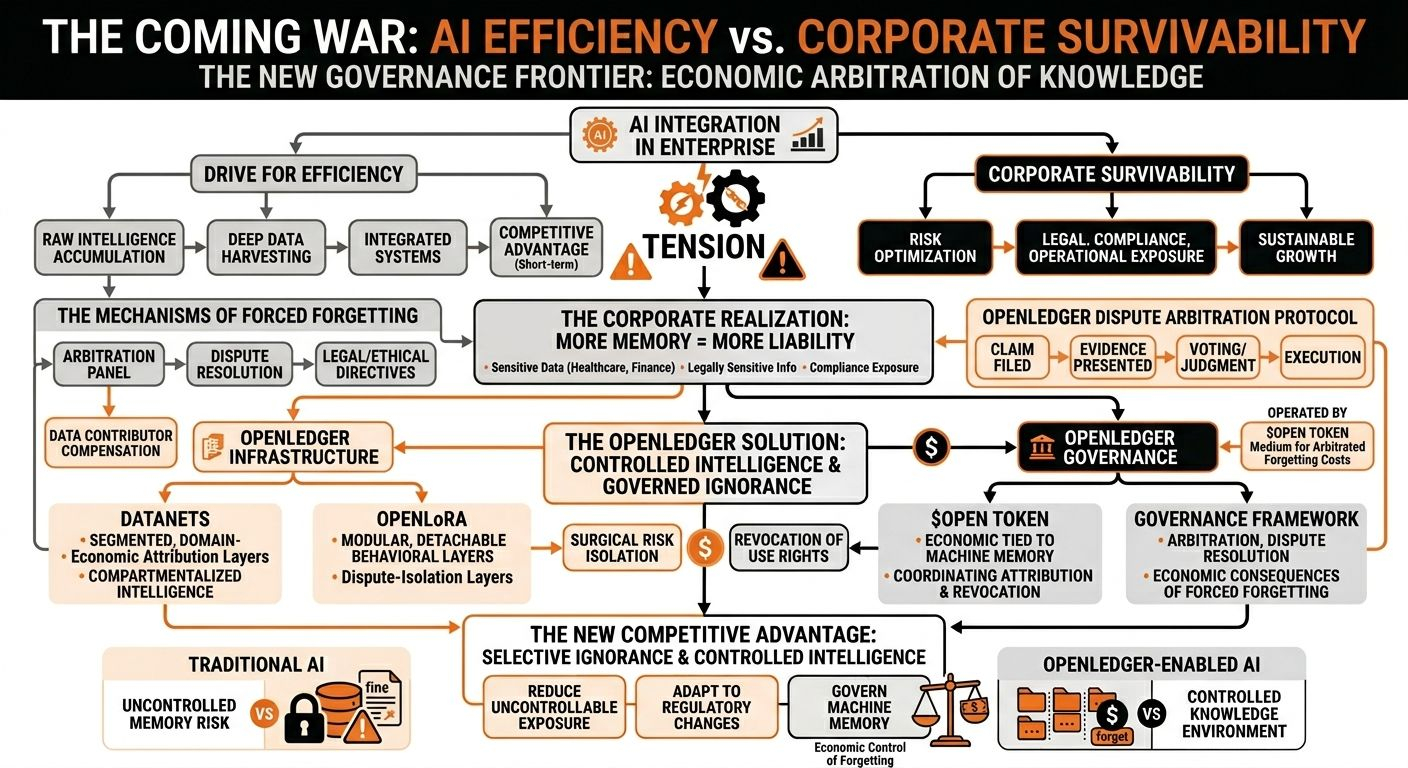
L’hypothèse qui sous-tend cette stratégie est simple : plus de mémoire = meilleure intelligence.
Mais cette logique se brise silencieusement dès que la mémoire elle-même commence à générer plus vite des risques juridiques, opérationnels et financiers que de valeur.
Et honnêtement, je pense que de nombreuses entreprises sont bien plus proches de cette prise de conscience que ce que le marché public comprend.
Pour l’instant, la plupart des systèmes d’IA d’entreprise fonctionnent encore dans des environnements relativement contrôlés. Assistants internes. Renforcement du service client. Automatisation des flux de travail. Support d’analytique. Mais plus l’IA pénètre des secteurs régulés et des infrastructures critiques pour la prise de décision, plus l’intelligence conservée devient dangereuse.
Parce que la « mémoire d’entreprise » n’est pas neutre.
Un modèle de santé qui conserve un contexte diagnostique sensible n’est pas seulement « intelligent ». Il porte une responsabilité (liability). Un système de conseil financier entraîné sur des années de données comportementales de clients n’est pas seulement personnalisé. Il accumule une exposition à la conformité. Un agent d’entreprise qui absorbe des communications internes peut involontairement devenir une archive permanente d’informations légalement sensibles.
Et la partie vraiment inconfortable, c’est ceci :
La plupart des systèmes d’IA sont structurellement incapables d’oublier proprement.
Cela crée un avenir étrange où les entreprises pourraient finir par moins se concurrencer sur la quantité de connaissances que possèdent leurs systèmes…
et à la manière exacte dont elles peuvent contrôler ce que ces systèmes sont autorisés à continuer de savoir.
Cette distinction semble aujourd’hui fortement sous-évaluée.
Parce qu’une fois que les données sont intégrées à travers des couches affinées, des systèmes de récupération, des espaces vectoriels et même le comportement du modèle lui-même, la suppression ne fonctionne plus comme une suppression logicielle traditionnelle. Les entreprises découvrent lentement que « supprimer les données » et « supprimer l’influence des données » sont deux problèmes d’ingénierie totalement différents.
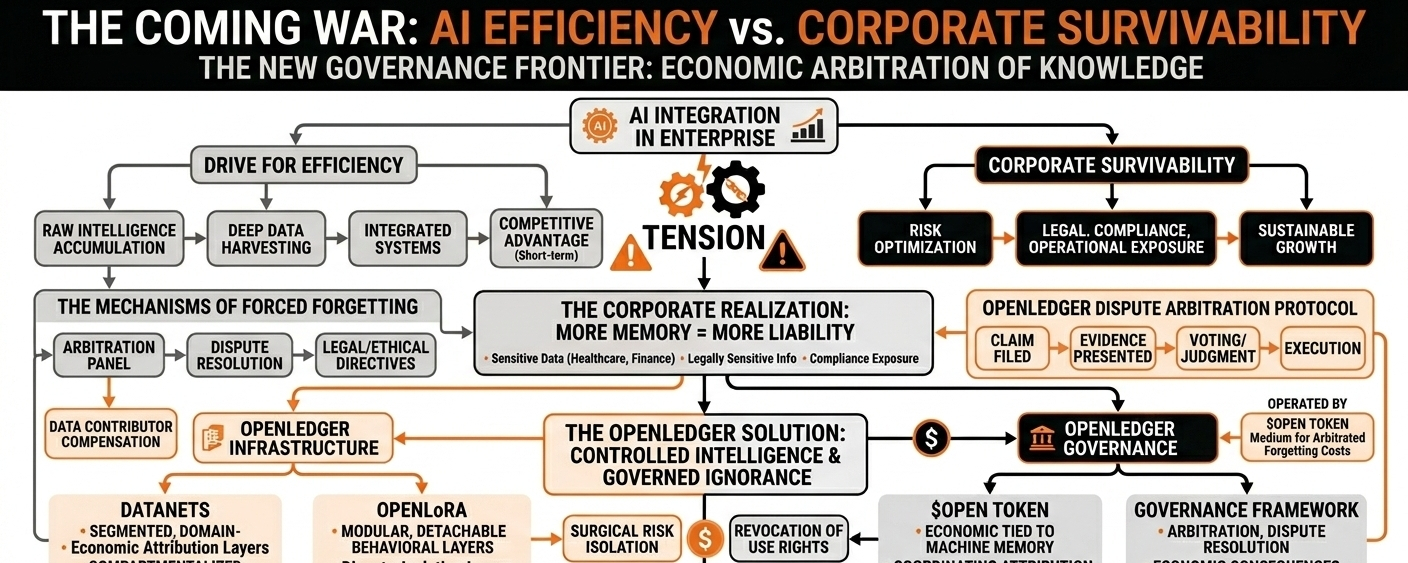
C’est là qu’OpenLedger commence à ressembler moins à un marché de données décentralisé et davantage à une infrastructure de cloisonnement du risque corporate.
L’architecture Datanet est intéressante précisément pour cette raison. Au lieu de traiter l’intelligence comme un seul vaste pool de mémoire indifférencié, la structure pousse vers des environnements de connaissances segmentés et spécifiques à un domaine, liés à l’attribution et à la responsabilité économique.
À première vue, cela ressemble à quelque chose d’inefficace par rapport à l’accumulation brute d’IA centralisée.
À long terme, cela pourrait même devenir opérationnellement nécessaire.
Parce que l’intelligence cloisonnée est plus facile à gouverner que la mémoire généralisée permanente.
C’est aussi pourquoi OpenLoRA me paraît beaucoup plus important que ce que la plupart des gens ne réalisent actuellement. Le marché a tendance à le présenter comme une couche d’efficacité pour déployer à moindre coût des adaptations de modèles légers. Mais l’implication plus profonde est une flexibilité architecturale.
Si l’intelligence peut être modularisée, elle peut aussi être détachée.
Cela change toute l’économie du risque de l’IA d’entreprise.
Une entreprise n’a plus besoin de réentraîner un système fondationnel entier à chaque fois qu’un cadre réglementaire change ou qu’un jeu de données devient problématique. Des couches comportementales spécifiques peuvent théoriquement être isolées, déconnectées, remplacées, ou dépréciées économiquement.
En d’autres termes, OpenLoRA ne fait pas seulement aider l’IA à se spécialiser.
Il aide l’IA à devenir jetable, mais de manière sélective.
Cela pourrait finir par devenir incroyablement précieux plus tard.
Surtout parce que les entreprises optimisent rarement pour l’idéalisme. Elles optimisent pour une exposition contrôlable. La capacité d’isoler chirurgicalement le risque opérationnel sans faire s’effondrer l’ensemble de la pile système est quelque chose pour lequel les entreprises paient historiquement des primes énormes.
Ce qui me ramène à $OPEN lui-même.
Je pense que la plupart des gens évaluent encore le jeton selon la logique standard des infrastructures crypto : plus d’usage, plus de transactions, plus d’activité dans l’écosystème, plus de demande.
Peut-être.
Mais la possibilité la plus intéressante est que $OPEN devienne économiquement liée à la gouvernance de la mémoire des machines elle-même. Pas seulement faciliter les flux d’intelligence, mais coordonner le coût, l’attribution, la persistance et la suppression éventuelle de couches d’intelligence qui opèrent à travers les systèmes de l’entreprise.
C’est un marché bien plus étrange que ce que les gens réalisent.
Parce qu’une fois que la mémoire porte un poids financier et juridique, l’infrastructure IA cesse d’être purement technique.
Cela devient politique.
Qui contrôle les droits de révocation ?
Qui arbitre les litiges entre contributeurs et entreprises ?
Qui décide quand l’intelligence conservée devient dangereuse ?
Qui absorbe les conséquences économiques de l’oubli imposé ?
Ces conflits n’ont pas de réponses claires.
Et honnêtement, c’est précisément pour cela que ce domaine semble être structurellement important.
Le marché de l’IA se comporte encore comme si l’intelligence brute restait la ressource rare.
Je pense de plus en plus que l’intelligence contrôlée deviendra plus rare.
Cela change quelles couches d’infrastructure comptent le plus.
OpenLedger peut tout à fait échouer. La plupart des protocoles d’infrastructure aussi. La seule complexité opérationnelle est déjà un défi sérieux. Les entreprises pourraient continuer à préférer une opacité centralisée simplement parce que c’est plus facile et plus rapide.
Mais si, à terme, les systèmes d’IA s’intègrent si profondément à la vie économique que la mémoire incontrôlée se transforme en risque institutionnel…
alors les entreprises capables de gouverner l’ignorance des machines pourraient devenir plus précieuses que celles qui ne font que construire des machines plus intelligentes.
Et OpenLedger donne de plus en plus l’impression d’être l’un des rares projets à déjà construire autour de cette tension, avant que le marché ne la voie pleinement.
#OpenLedger #openledger $BSB @OpenLedger
#BitcoinBreaksBelow75KAsWarshTakesFedHelm #FenwickWestSettlesFTXFor54M #SECHaltsInnovationExemption