

#openledger
openledger
17.3M vues
202,843 mentions
Populaire
Récents
·
--
Haussier
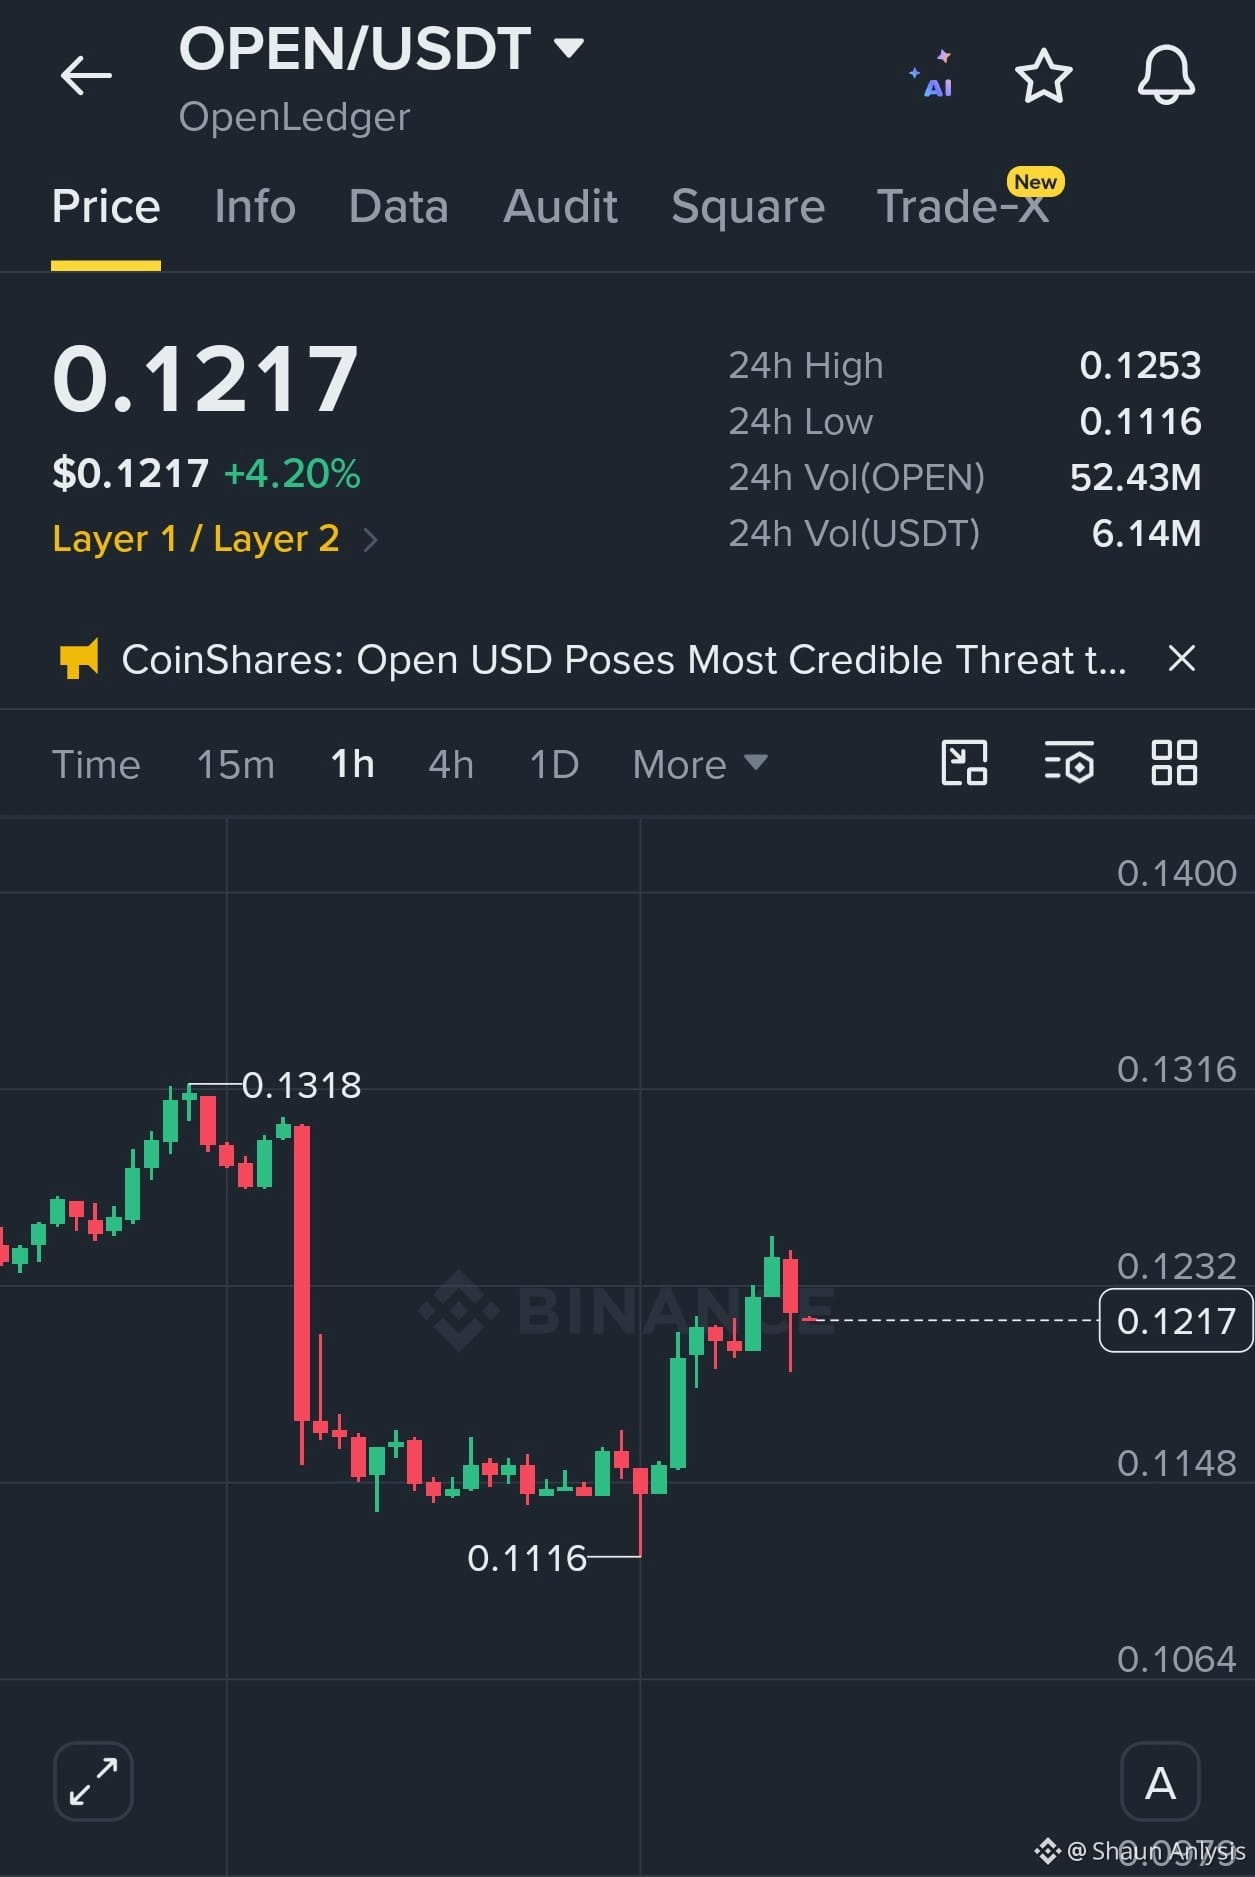
#OpenLedger vient d’imprimer un manuel de récupération en forme de V—ne manquez pas la prochaine étape à la hausse.
Après une forte purge jusqu’à 0.1116, $OPEN a rebondi durement, reprenant le niveau de 0.12 et se situe actuellement à 0.1217 (+4.20% sur la journée). Le graphique 1H montre un changement net de momentum : les acheteurs défendent les plus bas et reprennent vers le plus haut 24H à 0.1253.
Haussier
Entrée : 0.1180 – 0.1220
SL : 0.1100
TP1 : 0.1318
{future}(OPENUSDT)
#OpenLedger vient d’imprimer un manuel de récupération en forme de V—ne manquez pas la prochaine étape à la hausse.
Après une forte purge jusqu’à 0.1116, $OPEN a rebondi durement, reprenant le niveau de 0.12 et se situe actuellement à 0.1217 (+4.20% sur la journée). Le graphique 1H montre un changement net de momentum : les acheteurs défendent les plus bas et reprennent vers le plus haut 24H à 0.1253.
Haussier
Entrée : 0.1180 – 0.1220
SL : 0.1100
TP1 : 0.1318
1
94
·
--
Haussier
Partiellement vrai
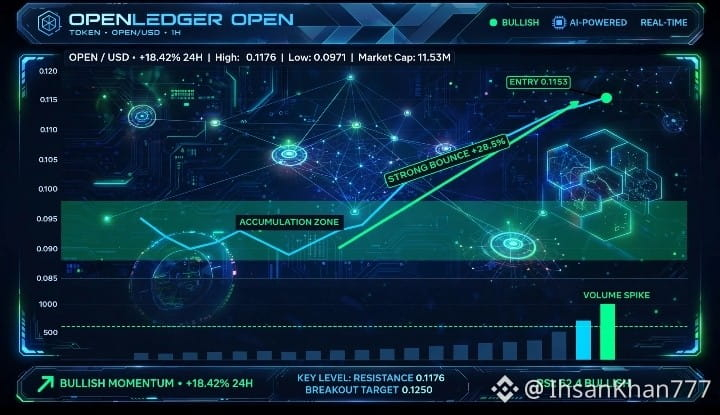
*OUVERT : Une opportunité d’IA silencieuse tout en bas*
Alors que beaucoup se concentrent sur les cryptos IA les plus populaires, OpenLedger (OPEN) se négocie près de son plus bas prix jamais atteint.
De 1,84 $ à 0,11 $, une correction massive de 94 %. Est-ce un point bas ?
Voici ce qui rend OpenLedger intéressant :
OpenLedger construit une infrastructure pour l’IA, où les données, les modèles et les agents d’IA reçoivent des paiements automatiquement. Imaginez des agents d’IA qui paient pour des données vérifiées en chaîne. On appelle cela les paiements agentiques, et OpenLedger vise à mener ce secteur.
La capitalisation boursière est d’environ 43 M$, tandis que le volume atteint 31 M$. Soit plus de 71 % de rotation, ce qui montre un fort intérêt et une accumulation active.
Des déblocages de tokens ont lieu. Environ 612 000 tokens par jour autour du 8 octobre. De petits déblocages créent une pression à court terme, mais aussi une opportunité à long terme.
Il est listé sur de grandes plateformes comme Upbit, Bithumb et Binance, avec une liquidité solide.
J’ai acheté OPEN à 0,1153 près de la zone basse. Ceci n’est pas un conseil financier, mais une infrastructure en début de cycle ressemble souvent à quelque chose de calme avant la croissance.
#OpenLedger
#OpenAI
#BestTimeToBuy
#Market_Update
#BullRunTips
$OPEN
$BTC
$BNB
@XG297174
@dengshen
@eggtartcake_grape
@haoge666
@Square-Creator-f92ceb7e7882c
@Square-Creator-d4cc116ea2fe
@SGD852568
@Square-Creator-f0c9a305b41a7
@z12123444
@Square-Creator-9bd28167d172
@NUTS_btc
@heyi
@CZ
@Openledger
@Biswap_Dex
@MagVerse
@EASY7777
@KZG6886
@Z0628
@JavierDot
@oanicai
*OUVERT : Une opportunité d’IA silencieuse tout en bas*
Alors que beaucoup se concentrent sur les cryptos IA les plus populaires, OpenLedger (OPEN) se négocie près de son plus bas prix jamais atteint.
De 1,84 $ à 0,11 $, une correction massive de 94 %. Est-ce un point bas ?
Voici ce qui rend OpenLedger intéressant :
OpenLedger construit une infrastructure pour l’IA, où les données, les modèles et les agents d’IA reçoivent des paiements automatiquement. Imaginez des agents d’IA qui paient pour des données vérifiées en chaîne. On appelle cela les paiements agentiques, et OpenLedger vise à mener ce secteur.
La capitalisation boursière est d’environ 43 M$, tandis que le volume atteint 31 M$. Soit plus de 71 % de rotation, ce qui montre un fort intérêt et une accumulation active.
Des déblocages de tokens ont lieu. Environ 612 000 tokens par jour autour du 8 octobre. De petits déblocages créent une pression à court terme, mais aussi une opportunité à long terme.
Il est listé sur de grandes plateformes comme Upbit, Bithumb et Binance, avec une liquidité solide.
J’ai acheté OPEN à 0,1153 près de la zone basse. Ceci n’est pas un conseil financier, mais une infrastructure en début de cycle ressemble souvent à quelque chose de calme avant la croissance.
#OpenLedger
#OpenAI
#BestTimeToBuy
#Market_Update
#BullRunTips
$OPEN
$BTC
$BNB
@K线人生飞哥
@比特币预言家
@Eggtartcake夕
@交易员张张子
@华尔街倩倩子
@猩火Bro
@Flash闪光灯
@乐天eth
@加密大格格
@klxmBobo
@Nuts坚果
@Yi He
@CZ
@OpenLedger
@Qordman crypto
@MagVerse
@EASY喊單哥
@KZG Crypto 口罩哥
@Whale韭阴针鲸0628
@_WHALE_
@Oanic AI
4
863
·
--
📉 $OPEN
— Pause / refroidissement OpenLedger
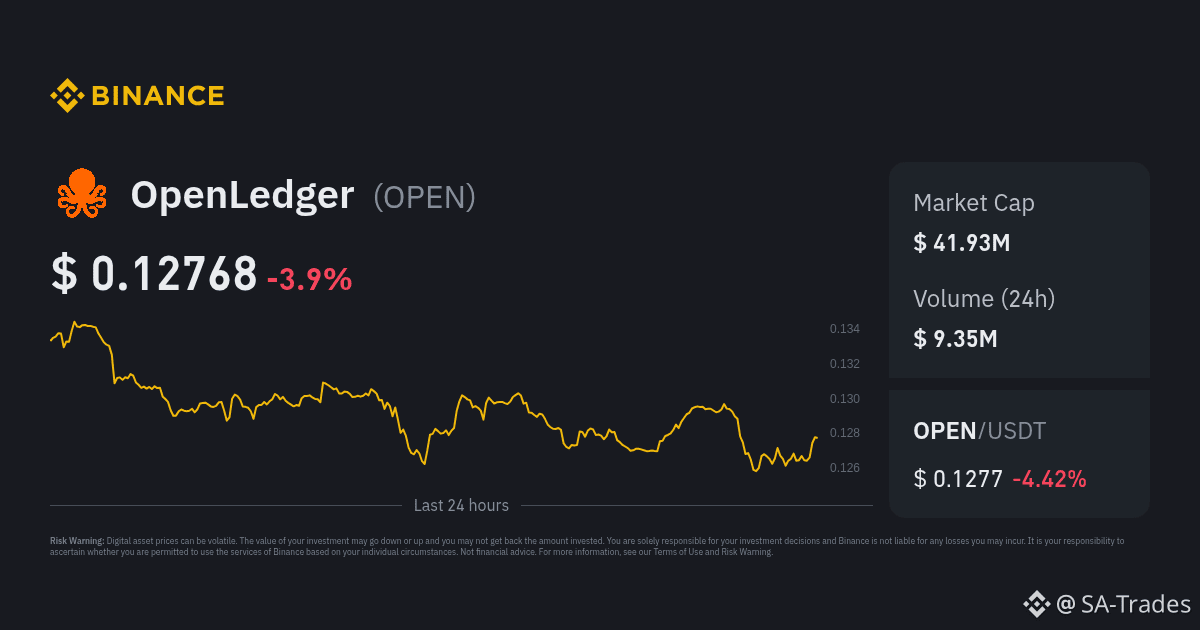
OpenLedger (OPEN) en baisse de -3,9% aujourd’hui, maintenant à 0,1277 $.
📊 Capitalisation boursière : 41,93 M$
📊 Volume sur 24h : 9,35 M$
Mouvements de prix chaotiques sur les dernières 24h — des vendeurs interviennent après ne pas avoir réussi à maintenir des niveaux plus élevés.
Zone d’accumulation ou baisse supplémentaire ? 👀
Trade $OPEN ici
{future}(OPENUSDT)
#OPEN #OpenLedger #BinanceSquare #crypto
📉 $OPEN
— Pause / refroidissement OpenLedger
OpenLedger (OPEN) en baisse de -3,9% aujourd’hui, maintenant à 0,1277 $.
📊 Capitalisation boursière : 41,93 M$
📊 Volume sur 24h : 9,35 M$
Mouvements de prix chaotiques sur les dernières 24h — des vendeurs interviennent après ne pas avoir réussi à maintenir des niveaux plus élevés.
Zone d’accumulation ou baisse supplémentaire ? 👀
Trade $OPEN ici
#OPEN #OpenLedger #BinanceSquare #crypto
2
4
263
·
--
Jeunes gens $OPEN sous pression… Y a-t-il un rebond ?
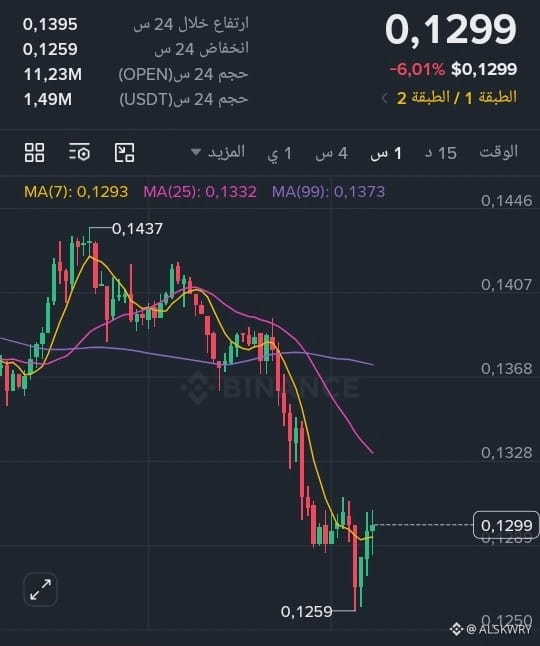
La crypto-monnaie OpenLedger (OPEN) bouge actuellement sous une pression de vente, et le prix se situe autour de 0,1299 $ après une baisse d’environ 6 % sur 24 heures.
📉 Niveaux clés :
🟢 Support : 0,1260 $
🔴 Résistance : 0,1328 – 0,1330 $
🔴 Résistance plus forte : 0,1368 – 0,1375 $
Si le prix parvient à tenir 0,126 et commence à former des plus bas plus hauts, nous pourrions assister à une tentative de rebond. En revanche, s’il la casse clairement, cela pourrait ouvrir la voie à des niveaux plus bas.
👀 OPEN mérite d’être surveillée, pas achetée juste parce que le prix a baissé.
Pensez-vous qu’OPEN va rebondir ou poursuivre sa baisse ?
⚠️ Ce n’est pas un conseil financier, uniquement une analyse et un partage pour lancer la discussion.
#OpenLedger #cryptouniverseofficial #BinanceSquare #trading
1
1
229
Un registre ouvert est un système de record partagé et transparent où chaque transaction est visible publiquement et vérifiable par quiconque. Contrairement aux bases de données privées, il élimine le besoin d'une autorité centrale car la confiance provient d'un consensus distribué. Utilisé principalement dans la technologie blockchain, un registre ouvert enregistre les entrées de manière chronologique, les rendant à l'épreuve des falsifications une fois confirmées. Cette transparence réduit la fraude, augmente la responsabilité et permet des audits indépendants sans permission. Les entreprises, les gouvernements et les systèmes financiers utilisent des registres ouverts pour suivre les actifs, les contrats et les paiements de manière transparente. Bien que cela renforce la confiance, la confidentialité doit être gérée avec soin puisque les données sont publiques. Dans l'ensemble, les registres ouverts promeuvent l'équité en donnant à tous les participants un accès égal aux mêmes informations véridiques.
#openledger $OPEN @Openledger
Un registre ouvert est un système de record partagé et transparent où chaque transaction est visible publiquement et vérifiable par quiconque. Contrairement aux bases de données privées, il élimine le besoin d'une autorité centrale car la confiance provient d'un consensus distribué. Utilisé principalement dans la technologie blockchain, un registre ouvert enregistre les entrées de manière chronologique, les rendant à l'épreuve des falsifications une fois confirmées. Cette transparence réduit la fraude, augmente la responsabilité et permet des audits indépendants sans permission. Les entreprises, les gouvernements et les systèmes financiers utilisent des registres ouverts pour suivre les actifs, les contrats et les paiements de manière transparente. Bien que cela renforce la confiance, la confidentialité doit être gérée avec soin puisque les données sont publiques. Dans l'ensemble, les registres ouverts promeuvent l'équité en donnant à tous les participants un accès égal aux mêmes informations véridiques.
#openledger $OPEN @OpenLedger
#openledger $OPEN @OpenLedger
121
·
--
Avant, ce que je redoutais le plus en matière de cross-chain, ce n'était pas la lenteur, mais plutôt ce moment où "tu penses que tout est tranquille, et d'un coup tu cliques à nouveau", transformant une seule action en deux. Quand ça arrive, c'est difficile de l'admettre lors de ton analyse : est-ce que c'est le système qui n'a pas clarifié l'état, ou est-ce que c'est toi qui as craqué ? Plus tu veux automatiser le processus de pontage, plus ce piège devient mortel, parce que la répétition n'est pas juste une "petite perte", ça perturbe directement la logique.
C'est pourquoi aujourd'hui, quand je regarde le Bridge EVM de @Openledger , je vais utiliser un standard plutôt basique pour l'évaluer : est-ce que cette étape de pontage peut devenir un checkpoint clair, au lieu d'une action "sans limite visible" ? Quand OctoClaw génère une action, si c'est un cross-chain, j'espère qu'il pourra lier "ce pontage" à une référence unique : si tu déclenches à nouveau la même action, le système ne doit pas simplement la répéter en silence, mais te dire clairement — cette transaction est en cours/terminée/interdite à la répétition. En tant qu'agent de trading, tu peux continuer à taffer sur la chaîne, pas de souci, mais pour des actions de pontage à haut risque, il faut d'abord éliminer le risque de "réexécution", sinon plus l'automatisation avance, plus ça ressemble à une zone minée.
Aujourd'hui, je ne garde qu'un seul critère d'acceptation : quand la même action de pontage est déclenchée à nouveau, est-ce que le système peut directement renvoyer la même référence d'exécution et fournir un état clair (en cours/terminé), tout en refusant de créer un deuxième pontage ? Si ça peut être fait, alors je considère le Bridge comme une capacité d'exécution ; sinon, je préfère laisser cette étape à une confirmation manuelle.
@Openledger $OPEN #OpenLedger
Avant, ce que je redoutais le plus en matière de cross-chain, ce n'était pas la lenteur, mais plutôt ce moment où "tu penses que tout est tranquille, et d'un coup tu cliques à nouveau", transformant une seule action en deux. Quand ça arrive, c'est difficile de l'admettre lors de ton analyse : est-ce que c'est le système qui n'a pas clarifié l'état, ou est-ce que c'est toi qui as craqué ? Plus tu veux automatiser le processus de pontage, plus ce piège devient mortel, parce que la répétition n'est pas juste une "petite perte", ça perturbe directement la logique.
C'est pourquoi aujourd'hui, quand je regarde le Bridge EVM de @OpenLedger , je vais utiliser un standard plutôt basique pour l'évaluer : est-ce que cette étape de pontage peut devenir un checkpoint clair, au lieu d'une action "sans limite visible" ? Quand OctoClaw génère une action, si c'est un cross-chain, j'espère qu'il pourra lier "ce pontage" à une référence unique : si tu déclenches à nouveau la même action, le système ne doit pas simplement la répéter en silence, mais te dire clairement — cette transaction est en cours/terminée/interdite à la répétition. En tant qu'agent de trading, tu peux continuer à taffer sur la chaîne, pas de souci, mais pour des actions de pontage à haut risque, il faut d'abord éliminer le risque de "réexécution", sinon plus l'automatisation avance, plus ça ressemble à une zone minée.
Aujourd'hui, je ne garde qu'un seul critère d'acceptation : quand la même action de pontage est déclenchée à nouveau, est-ce que le système peut directement renvoyer la même référence d'exécution et fournir un état clair (en cours/terminé), tout en refusant de créer un deuxième pontage ? Si ça peut être fait, alors je considère le Bridge comme une capacité d'exécution ; sinon, je préfère laisser cette étape à une confirmation manuelle.
@OpenLedger $OPEN #OpenLedger
187
·
--
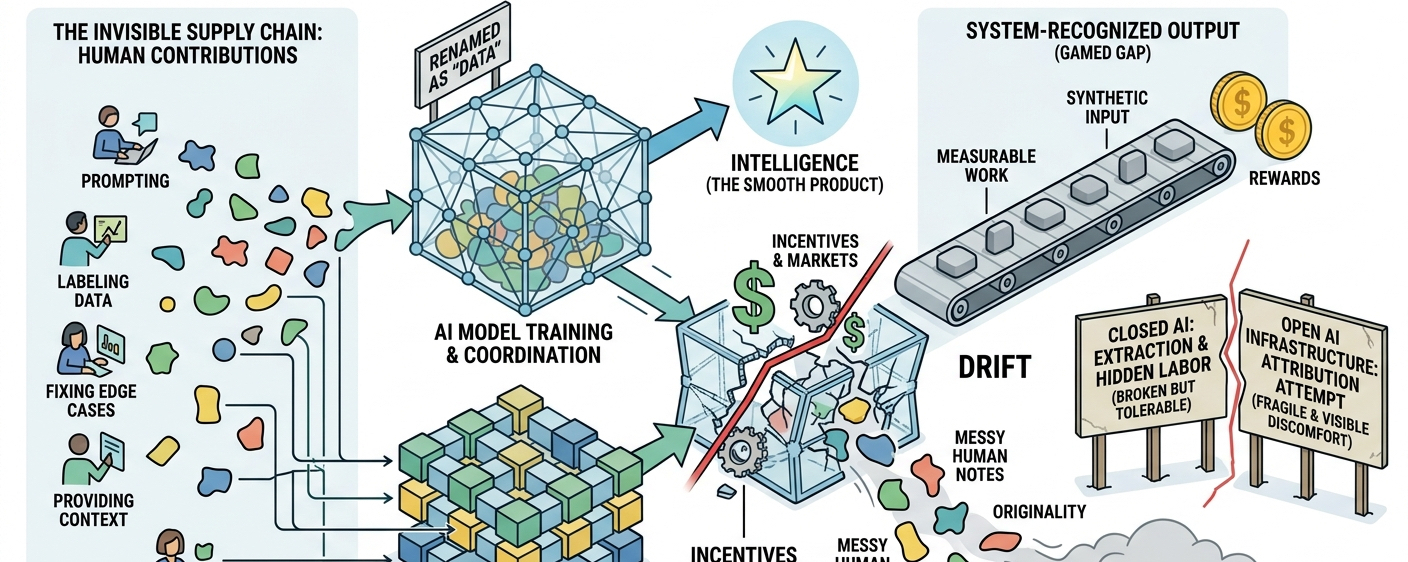
Article
L'infrastructure se casse là où la mémoire devient précieuseAu début, je ne l'ai pas pris au sérieux.
Pas parce qu'OpenLedger semblait vide, mais parce que j'ai vu assez de cycles d'infrastructure crypto pour savoir à quelle vitesse des idées sérieuses peuvent être aplaties en récits. Un mois, c'est la coordination. Ensuite, la propriété. Puis la vérification. Ensuite, tout devient 'ouvert'. Et pendant un moment, le langage semble suffisamment clair pour y croire.
Puis le système rencontre des incitations.
Et les incitations ne sont jamais claires.
Peut-être que c'est trop dur. Peut-être que je suis juste fatigué de voir des protocoles devenir lentement moins axés sur leur problème initial et plus sur les marchés qui se forment autour d'eux. Mais cette fatigue est difficile à éteindre, surtout avec tout ce qui se trouve entre l'IA, les données, la propriété et les récompenses économiques.
L'infrastructure se casse là où la mémoire devient précieuse
Au début, je ne l'ai pas pris au sérieux.
Pas parce qu'OpenLedger semblait vide, mais parce que j'ai vu assez de cycles d'infrastructure crypto pour savoir à quelle vitesse des idées sérieuses peuvent être aplaties en récits. Un mois, c'est la coordination. Ensuite, la propriété. Puis la vérification. Ensuite, tout devient 'ouvert'. Et pendant un moment, le langage semble suffisamment clair pour y croire.
Puis le système rencontre des incitations.
Et les incitations ne sont jamais claires.
Peut-être que c'est trop dur. Peut-être que je suis juste fatigué de voir des protocoles devenir lentement moins axés sur leur problème initial et plus sur les marchés qui se forment autour d'eux. Mais cette fatigue est difficile à éteindre, surtout avec tout ce qui se trouve entre l'IA, les données, la propriété et les récompenses économiques.
2
1
138

·
--
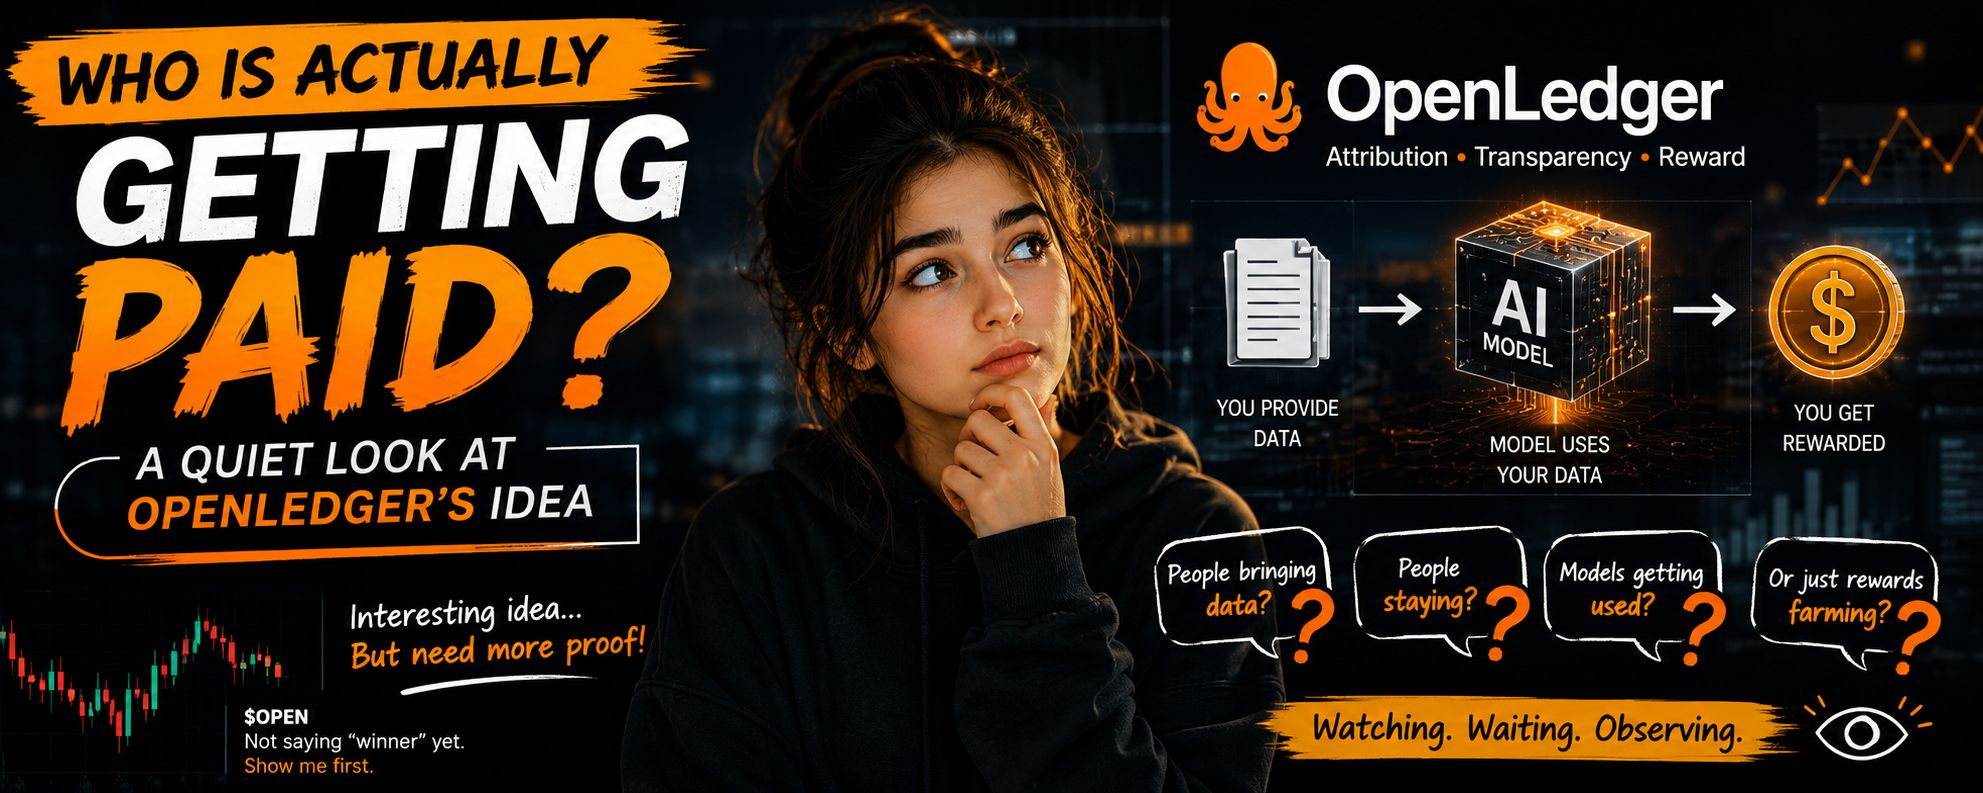
Article
Qui est réellement payé ? Un regard discret sur l'idée d'OpenLedger. @Openledger .. J'ai déjà vu ça… peut-être il y a quelques mois. Le graphique faisait juste son truc habituel… haut bas haut bas. Mais mon esprit est resté bloqué sur une question étrange.
Qui est réellement payé ?
Non non sérieusement… tout le monde parle des données IA, des modèles, de la grande vision future. D'accord, c'est juste. De beaux mots. Mais si tout ça fonctionne vraiment… alors qui gagne réellement de l'argent ? Je regarde ça, mais la réponse ne semble pas si claire.
Puis j'ai vu #OpenLedger et cette idée d'"attribution". Ça sonne comme un mot sophistiqué… mais peut-être que c'est simple à la base.
Qui est réellement payé ? Un regard discret sur l'idée d'OpenLedger.
@OpenLedger .. J'ai déjà vu ça… peut-être il y a quelques mois. Le graphique faisait juste son truc habituel… haut bas haut bas. Mais mon esprit est resté bloqué sur une question étrange.
Qui est réellement payé ?
Non non sérieusement… tout le monde parle des données IA, des modèles, de la grande vision future. D'accord, c'est juste. De beaux mots. Mais si tout ça fonctionne vraiment… alors qui gagne réellement de l'argent ? Je regarde ça, mais la réponse ne semble pas si claire.
Puis j'ai vu #OpenLedger et cette idée d'"attribution". Ça sonne comme un mot sophistiqué… mais peut-être que c'est simple à la base.
14
5
297
#openledger $OPEN La campagne OpenLedger crée un véritable engouement au sein de la communauté crypto, et pour de bonnes raisons. Alors que la technologie blockchain continue d'évoluer, OpenLedger se positionne comme un projet axé sur l'innovation, la transparence et la croissance pilotée par la communauté.
Participer à la campagne OpenLedger de Binance, c'est plus que de simples tâches à compléter et des récompenses à gagner—c'est une chance de faire partie d'un écosystème en pleine croissance avant que l'adoption à grande échelle ne se produise. Les premiers soutiens acquièrent souvent une expérience précieuse, établissent des connexions plus solides au sein de la communauté et se positionnent pour de futures opportunités.
Ce qui rend cette campagne encore plus attrayante, c'est la combinaison d'apprentissage, d'engagement et de récompenses. Que vous soyez un passionné de crypto chevronné ou un nouveau venu explorant le Web3, OpenLedger offre une excellente manière de rester actif et informé tout en bénéficiant potentiellement de la croissance du projet.
Ne vous contentez pas de regarder depuis les lignes de touche—rejoignez la conversation, complétez les activités de la campagne et découvrez pourquoi tant d'utilisateurs gardent un œil attentif sur OpenLedger. La prochaine grande opportunité pourrait être plus proche que vous ne le pensez ! 🔥
#OpenLedger #BinanceSquare #Crypto #Web3 #Airdrop #Blockchain #BinanceCampaign #CryptoCommunity
81
·
--
#openledger $OPEN @Openledger
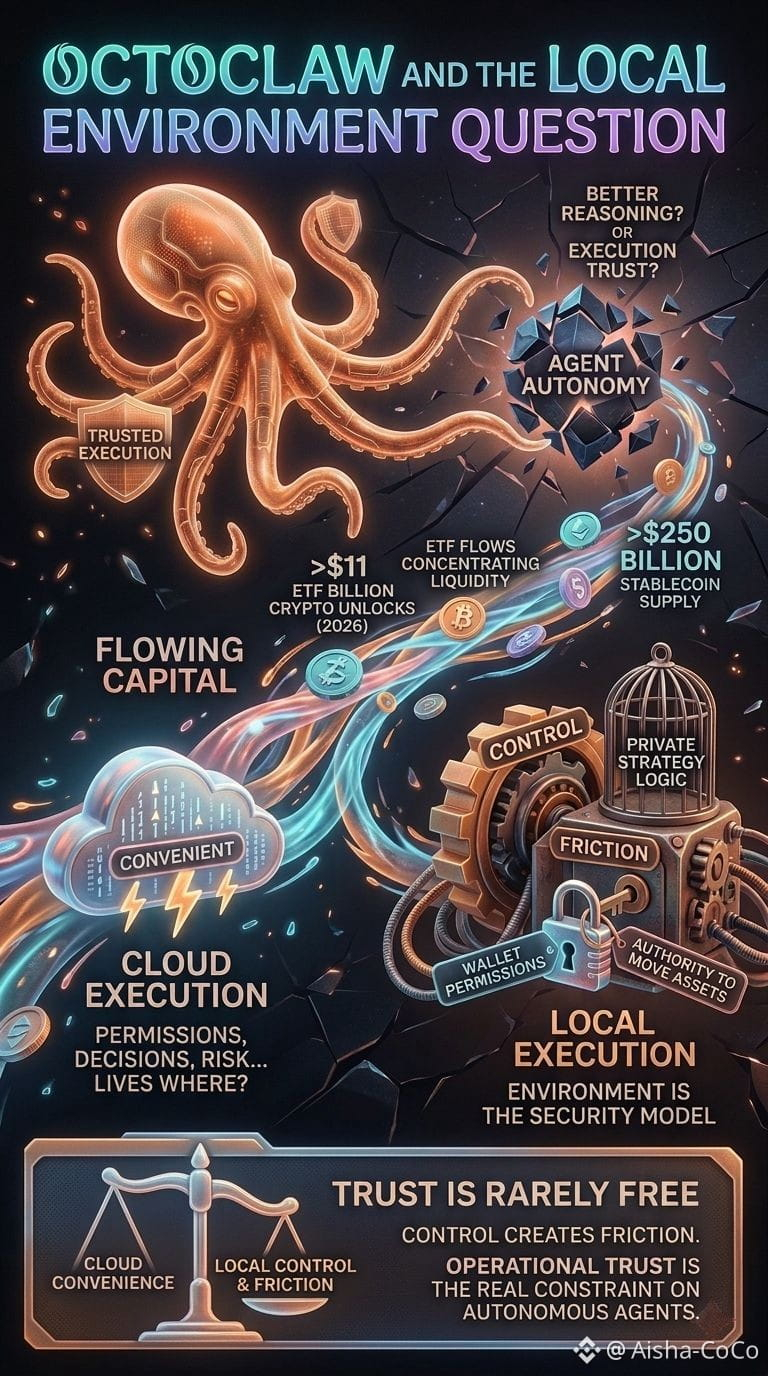
Je me dis que des agents IA plus performants ont principalement besoin d'un meilleur raisonnement. Plus je regardais des systèmes comme OctoClaw, moins j'étais convaincu.
Mon avis est simple : l'autonomie des agents compte moins que la confiance dans l'exécution. En surface, l'opération locale ressemble à une fonctionnalité de confidentialité. En réalité, cela change où se trouvent les décisions, les permissions et le risque. Si un agent gère les permissions de portefeuille, c'est-à-dire l'autorité de déplacer des actifs ou de gérer la logique stratégique privée, l'environnement qui exécute ces actions devient partie intégrante du modèle de sécurité.
Cela semble de plus en plus pertinent alors que plus de 11 milliards de dollars en déblocages de tokens crypto sont attendus d'ici 2026, que les flux ETF continuent de concentrer la liquidité, et que l'offre de stablecoins a dépassé les 250 milliards de dollars. Ces chiffres indiquent des pools de capitaux plus importants et un comportement plus automatisé, pas nécessairement un meilleur jugement.
Le compromis est évident. L'exécution dans le cloud est pratique ; l'exécution locale offre plus de contrôle. Mais le contrôle crée des frictions. La confiance opérationnelle n'est rarement gratuite, et cela pourrait être la véritable contrainte sur les agents autonomes.
{future}(OPENUSDT)
#openledger $OPEN @OpenLedger
Je me dis que des agents IA plus performants ont principalement besoin d'un meilleur raisonnement. Plus je regardais des systèmes comme OctoClaw, moins j'étais convaincu.
Mon avis est simple : l'autonomie des agents compte moins que la confiance dans l'exécution. En surface, l'opération locale ressemble à une fonctionnalité de confidentialité. En réalité, cela change où se trouvent les décisions, les permissions et le risque. Si un agent gère les permissions de portefeuille, c'est-à-dire l'autorité de déplacer des actifs ou de gérer la logique stratégique privée, l'environnement qui exécute ces actions devient partie intégrante du modèle de sécurité.
Cela semble de plus en plus pertinent alors que plus de 11 milliards de dollars en déblocages de tokens crypto sont attendus d'ici 2026, que les flux ETF continuent de concentrer la liquidité, et que l'offre de stablecoins a dépassé les 250 milliards de dollars. Ces chiffres indiquent des pools de capitaux plus importants et un comportement plus automatisé, pas nécessairement un meilleur jugement.
Le compromis est évident. L'exécution dans le cloud est pratique ; l'exécution locale offre plus de contrôle. Mais le contrôle crée des frictions. La confiance opérationnelle n'est rarement gratuite, et cela pourrait être la véritable contrainte sur les agents autonomes.
7
8
384
·
--
Il y a quelques jours, mon cousin qui fait du e-commerce est venu me voir avec une poignée d’articles élogieux bien ficelés, brandissant #OpenLedger , en me disant que si on injectait un peu de données sur les comportements utilisateurs, on pouvait échanger contre $OPEN , et que c’était inévitablement rentable, sans perte. Je n’ai pas tout de suite versé de l’eau froide. D’abord, j’ai injecté dans DataNet une partie des flux de transactions de boutiques que j’avais désensibilisés, histoire de tester. À première vue, la confirmation d’identité et l’attribution sur la chaîne, c’est vraiment carré : chaque extrait de contenu valide est bien étiqueté avec des tags d’attribution, et le grand livre calcule tout de façon claire et nette. Mais après avoir bouclé un cycle complet, je n’ai pas tardé à en saisir le vrai goût : tu n’as tout simplement aucun pouvoir de fixation des prix.
Le plus vicieux, c’est que la valeur de tes données, en fin de compte, n’est pas ce que toi tu décides. Tout dépend de savoir si les grands modèles terminaux digèrent réellement les paramètres que tu as injectés. Mes données de préférences de consommation, que je croyais extrêmement lucratives, n’ont justement pas tapé dans les tendances où les modèles ont été ajustés. Résultat : les tokens distribués par la chaîne se sont fragmentés de façon dérisoire, au point de ne même pas couvrir les frais de bande passante pour faire tourner les nœuds. À l’inverse, le gars à côté qui a déversé sans vergogne des corpus open-source de mauvaise qualité s’en est mieux sorti : parce que ça tombait précisément sur une période de pics d’appel, sa part de revenus était plus présentable que la mienne. Ce n’est pas un partage basé sur la contribution : c’est juste parier sur la chance, en fonction de la “gueule” du modèle. $LAB
Et le plus glaçant, c’est qu’une fois tes données exclusives emballées et soumises, le dépôt principal du réseau conserve par contrainte des instantanés des caractéristiques. Autrement dit, ta petite cargaison confidentielle est, de fait, étalée au vu de tout le monde sur le réseau. Les autorités utilisent des preuves à connaissance nulle comme paravent en disant que les données ne quittent jamais localement, mais si je pousse la logique de soumission plus loin, les caractéristiques des métadonnées doivent être téléversées quand même. Tu crois verrouiller la souveraineté : en réalité, l’information essentielle a déjà été subtilisée.
À titre honnête, l’idée de tamponner les efforts humains avec une “signature” anti-contrefaçon via la cryptographie, c’est effectivement solide, et le mécanisme d’attribution ouvre aussi une petite porte pour que les investisseurs particuliers puissent enfin s’asseoir à table. Mais tant que le nœud — le pouvoir de fixation des prix, fermement entre les mains des algorithmes et des gros — ne sera pas desserré, les contributeurs de base ne seront toujours que des consommables bon marché que la faim du modèle exploite. Je conseille à mon cousin de ne pas se lancer à corps perdu. Qu’il fasse plutôt quelques essais avec un peu d’argent disponible, qu’il teste les interactions pour comprendre le terrain. Une fois que les données d’usage réelles issues du réseau principal auront tourné et montré clairement qui fixe les prix, il sera toujours temps de re-parier. #BTC
#OpenLedger $OPEN @Openledger
{alpha}(560x7ec43cf65f1663f820427c62a5780b8f2e25593a)
{spot}(OPENUSDT)
Il y a quelques jours, mon cousin qui fait du e-commerce est venu me voir avec une poignée d’articles élogieux bien ficelés, brandissant #OpenLedger , en me disant que si on injectait un peu de données sur les comportements utilisateurs, on pouvait échanger contre $OPEN , et que c’était inévitablement rentable, sans perte. Je n’ai pas tout de suite versé de l’eau froide. D’abord, j’ai injecté dans DataNet une partie des flux de transactions de boutiques que j’avais désensibilisés, histoire de tester. À première vue, la confirmation d’identité et l’attribution sur la chaîne, c’est vraiment carré : chaque extrait de contenu valide est bien étiqueté avec des tags d’attribution, et le grand livre calcule tout de façon claire et nette. Mais après avoir bouclé un cycle complet, je n’ai pas tardé à en saisir le vrai goût : tu n’as tout simplement aucun pouvoir de fixation des prix.
Le plus vicieux, c’est que la valeur de tes données, en fin de compte, n’est pas ce que toi tu décides. Tout dépend de savoir si les grands modèles terminaux digèrent réellement les paramètres que tu as injectés. Mes données de préférences de consommation, que je croyais extrêmement lucratives, n’ont justement pas tapé dans les tendances où les modèles ont été ajustés. Résultat : les tokens distribués par la chaîne se sont fragmentés de façon dérisoire, au point de ne même pas couvrir les frais de bande passante pour faire tourner les nœuds. À l’inverse, le gars à côté qui a déversé sans vergogne des corpus open-source de mauvaise qualité s’en est mieux sorti : parce que ça tombait précisément sur une période de pics d’appel, sa part de revenus était plus présentable que la mienne. Ce n’est pas un partage basé sur la contribution : c’est juste parier sur la chance, en fonction de la “gueule” du modèle. $LAB
Et le plus glaçant, c’est qu’une fois tes données exclusives emballées et soumises, le dépôt principal du réseau conserve par contrainte des instantanés des caractéristiques. Autrement dit, ta petite cargaison confidentielle est, de fait, étalée au vu de tout le monde sur le réseau. Les autorités utilisent des preuves à connaissance nulle comme paravent en disant que les données ne quittent jamais localement, mais si je pousse la logique de soumission plus loin, les caractéristiques des métadonnées doivent être téléversées quand même. Tu crois verrouiller la souveraineté : en réalité, l’information essentielle a déjà été subtilisée.
À titre honnête, l’idée de tamponner les efforts humains avec une “signature” anti-contrefaçon via la cryptographie, c’est effectivement solide, et le mécanisme d’attribution ouvre aussi une petite porte pour que les investisseurs particuliers puissent enfin s’asseoir à table. Mais tant que le nœud — le pouvoir de fixation des prix, fermement entre les mains des algorithmes et des gros — ne sera pas desserré, les contributeurs de base ne seront toujours que des consommables bon marché que la faim du modèle exploite. Je conseille à mon cousin de ne pas se lancer à corps perdu. Qu’il fasse plutôt quelques essais avec un peu d’argent disponible, qu’il teste les interactions pour comprendre le terrain. Une fois que les données d’usage réelles issues du réseau principal auront tourné et montré clairement qui fixe les prix, il sera toujours temps de re-parier. #BTC
#OpenLedger $OPEN @OpenLedger
数据定价权到底归谁说了算
0%
归因标签是馅饼还是陷阱
100%
1 Votes • Vote fermé
1
115
·
--
Haussier
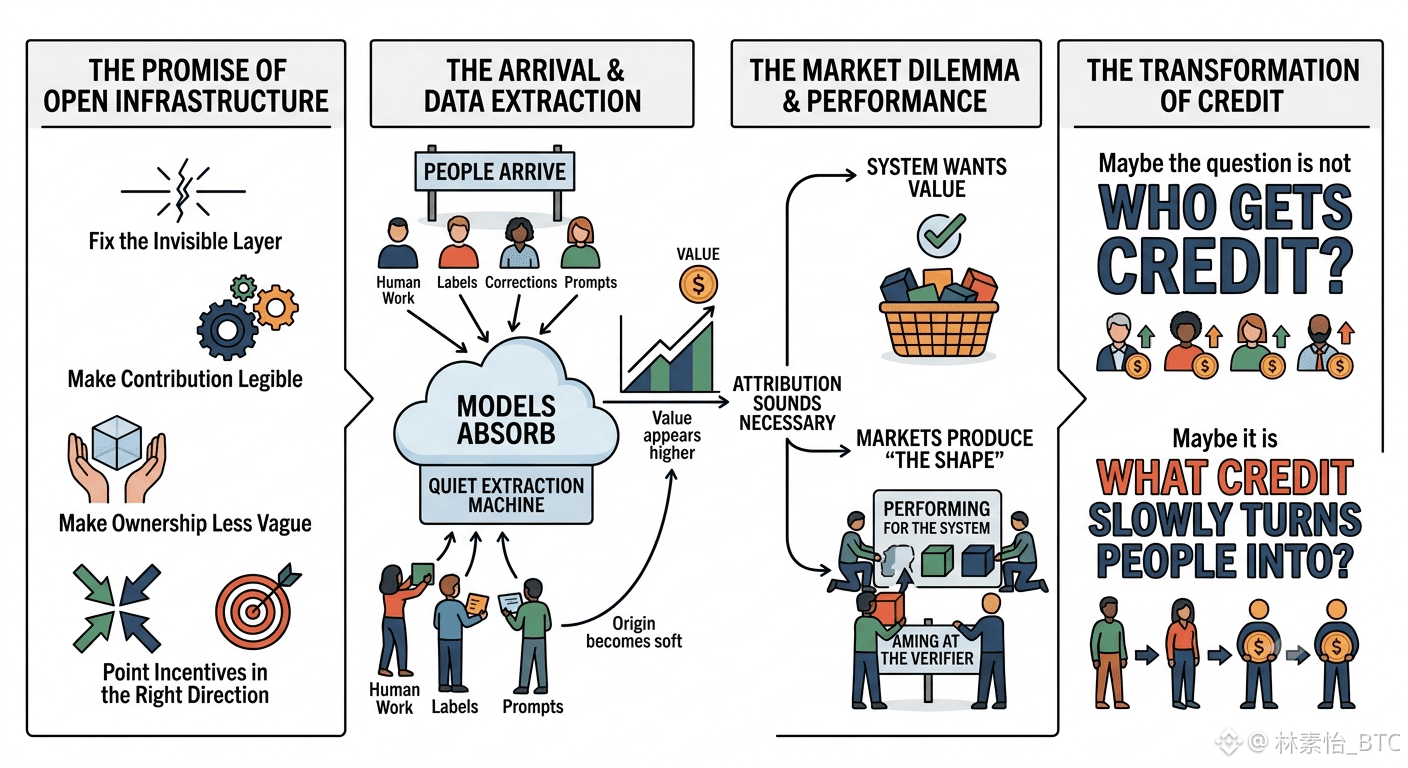
Au début, je ne le prenais pas au sérieux.
C'est généralement là que je commence maintenant, après avoir observé suffisamment de cycles d'infrastructure faire la même promesse avec un accent différent. Fixez la couche invisible. Rendez la contribution lisible. Rendez la propriété moins vague. Orientez les incitations dans la bonne direction.
Puis les gens arrivent.
Et les gens trouvent toujours les failles.
OpenLedger est difficile à ignorer car les données de l'IA ressemblent déjà à une machine d'extraction silencieuse avec un langage poli autour. Le travail humain entre sous forme d'étiquettes, de corrections, de prompts, d'exemples, de préférences de retour d'expérience, de jugements. Des petits morceaux, éparpillés partout. Puis les modèles les absorbent, de la valeur apparaît quelque part plus haut, et l'origine devient suffisamment floue pour cesser de se défendre.
Donc, l'attribution semble nécessaire.
Peut-être que c'est pourquoi je ne lui fais pas totalement confiance.
C'est là que les choses commencent à devenir inconfortables. Une fois que la contribution devient financière, la contribution commence à performer pour le système. Les gens visent le vérificateur. Ils apprennent ce qui compte. Ils créent ce qui semble utile, original, suffisamment humain. Le système veut reconnaître la valeur, mais les marchés sont très doués pour produire la forme de la valeur sans la substance.
Cela fonctionne en théorie. La plupart des choses le font.
Le problème n'est pas vraiment la technologie. Ou peut-être que la technologie devient le problème une fois que la confiance est compressée en preuves, scores, tableaux de bord, normes et routes de liquidité. Les systèmes ouverts se recentralisent rarement bruyamment. Ils se restreignent par commodité, par défaut, par interfaces, et par qui peut définir la validité sous pression.
Peut-être que c'est trop sévère.
Mais j'y reviens toujours.
Si l'attribution devient une infrastructure, peut-être que la question n'est pas qui reçoit le crédit.
Peut-être que c'est ce que le crédit transforme lentement les gens.
$OPEN @Openledger #openledger
{spot}(OPENUSDT)
Au début, je ne le prenais pas au sérieux.
C'est généralement là que je commence maintenant, après avoir observé suffisamment de cycles d'infrastructure faire la même promesse avec un accent différent. Fixez la couche invisible. Rendez la contribution lisible. Rendez la propriété moins vague. Orientez les incitations dans la bonne direction.
Puis les gens arrivent.
Et les gens trouvent toujours les failles.
OpenLedger est difficile à ignorer car les données de l'IA ressemblent déjà à une machine d'extraction silencieuse avec un langage poli autour. Le travail humain entre sous forme d'étiquettes, de corrections, de prompts, d'exemples, de préférences de retour d'expérience, de jugements. Des petits morceaux, éparpillés partout. Puis les modèles les absorbent, de la valeur apparaît quelque part plus haut, et l'origine devient suffisamment floue pour cesser de se défendre.
Donc, l'attribution semble nécessaire.
Peut-être que c'est pourquoi je ne lui fais pas totalement confiance.
C'est là que les choses commencent à devenir inconfortables. Une fois que la contribution devient financière, la contribution commence à performer pour le système. Les gens visent le vérificateur. Ils apprennent ce qui compte. Ils créent ce qui semble utile, original, suffisamment humain. Le système veut reconnaître la valeur, mais les marchés sont très doués pour produire la forme de la valeur sans la substance.
Cela fonctionne en théorie. La plupart des choses le font.
Le problème n'est pas vraiment la technologie. Ou peut-être que la technologie devient le problème une fois que la confiance est compressée en preuves, scores, tableaux de bord, normes et routes de liquidité. Les systèmes ouverts se recentralisent rarement bruyamment. Ils se restreignent par commodité, par défaut, par interfaces, et par qui peut définir la validité sous pression.
Peut-être que c'est trop sévère.
Mais j'y reviens toujours.
Si l'attribution devient une infrastructure, peut-être que la question n'est pas qui reçoit le crédit.
Peut-être que c'est ce que le crédit transforme lentement les gens.
$OPEN @OpenLedger #openledger
1
117
·
--
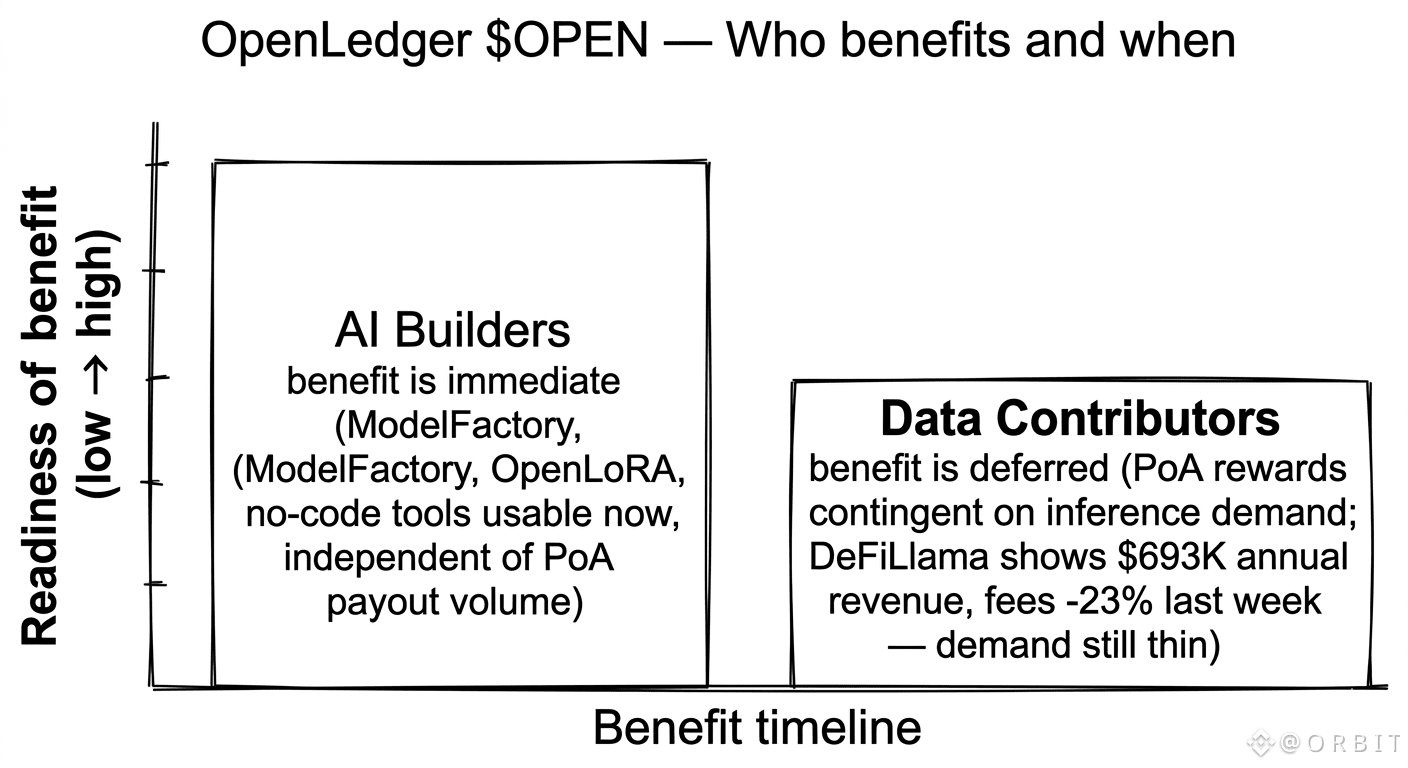
La partie qui m'est restée de la tâche OpenLedger $OPEN #OpenLedger @Openledger , c'est comment les deux groupes de bénéficiaires — les constructeurs d'IA et les contributeurs de données — sont sur des timelines très différentes, même si le pitch les présente comme arrivant ensemble. Les constructeurs obtiennent une utilité immédiate : ModelFactory fonctionne aujourd'hui, le fine-tuning sans code fonctionne aujourd'hui, OpenLoRA déploie des modèles sans lourdes charges d'infrastructure. Cette valeur est préchargée et ne dépend pas de la rotation du flywheel de la preuve d'attribution. Les contributeurs, eux, c'est différent. Leurs récompenses ne se matérialisent que lorsque les modèles construits sur leurs Datanets sont réellement interrogés à grande échelle — mais DeFiLlama montre des revenus annuels de protocole s'élevant à 693K $ avec des frais en baisse de 23 % au cours de la dernière semaine, ce qui suggère que la demande d'inférence est encore faible. Le design est cohérent ; la séquence compte juste plus que ce que le cadre admet. Les constructeurs arrivent, construisent sur l'infrastructure, les modèles restent en attente. Les contributeurs ont déjà téléchargé, déjà contribué, déjà gagné leurs enregistrements d'attribution… et attendent maintenant une demande qui n'est pas encore complètement arrivée. Que cet écart se réduise dépend entièrement de savoir si les constructeurs qui se sont présentés livrent réellement des produits que les gens utilisent.
La partie qui m'est restée de la tâche OpenLedger $OPEN #OpenLedger @OpenLedger , c'est comment les deux groupes de bénéficiaires — les constructeurs d'IA et les contributeurs de données — sont sur des timelines très différentes, même si le pitch les présente comme arrivant ensemble. Les constructeurs obtiennent une utilité immédiate : ModelFactory fonctionne aujourd'hui, le fine-tuning sans code fonctionne aujourd'hui, OpenLoRA déploie des modèles sans lourdes charges d'infrastructure. Cette valeur est préchargée et ne dépend pas de la rotation du flywheel de la preuve d'attribution. Les contributeurs, eux, c'est différent. Leurs récompenses ne se matérialisent que lorsque les modèles construits sur leurs Datanets sont réellement interrogés à grande échelle — mais DeFiLlama montre des revenus annuels de protocole s'élevant à 693K $ avec des frais en baisse de 23 % au cours de la dernière semaine, ce qui suggère que la demande d'inférence est encore faible. Le design est cohérent ; la séquence compte juste plus que ce que le cadre admet. Les constructeurs arrivent, construisent sur l'infrastructure, les modèles restent en attente. Les contributeurs ont déjà téléchargé, déjà contribué, déjà gagné leurs enregistrements d'attribution… et attendent maintenant une demande qui n'est pas encore complètement arrivée. Que cet écart se réduise dépend entièrement de savoir si les constructeurs qui se sont présentés livrent réellement des produits que les gens utilisent.
1
340
·
--
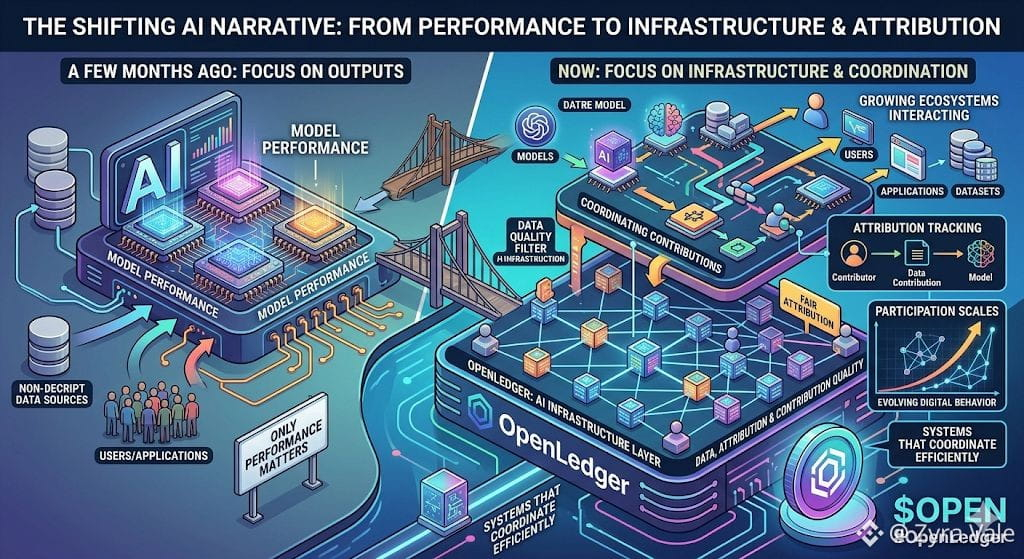
On dirait que le récit autour de l'IA change lentement ces derniers temps.
Il y a quelques mois, la plupart des gens ne se souciaient que de la performance des modèles.
Maintenant, je remarque plus de discussions autour des données, de l'attribution et de la qualité des contributions aussi.
C'est en partie pourquoi OpenLedger a commencé à se démarquer pour moi récemment.
Le projet semble axé sur une couche d'infrastructure IA qui deviendra probablement plus importante à mesure que les écosystèmes se développent.
Surtout une fois que plus d'utilisateurs, d'applications et de jeux de données commenceront à interagir à travers les réseaux.
La crypto a déjà montré à quelle vitesse le comportement numérique évolue une fois que la participation s'échelle.
Donc, les systèmes qui peuvent coordonner les contributions et l'attribution de manière plus efficace pourraient finir par devenir une partie assez importante de l'écosystème IA plus tard.
C'est encore tôt, évidemment.
Mais on dirait que le marché commence progressivement à prêter plus attention à l'infrastructure sous-jacente de l'IA au lieu de ne se concentrer que sur les résultats.
C'est principalement pourquoi j'ai surveillé $OPEN récemment.
#openledger $OPEN @Openledger
On dirait que le récit autour de l'IA change lentement ces derniers temps.
Il y a quelques mois, la plupart des gens ne se souciaient que de la performance des modèles.
Maintenant, je remarque plus de discussions autour des données, de l'attribution et de la qualité des contributions aussi.
C'est en partie pourquoi OpenLedger a commencé à se démarquer pour moi récemment.
Le projet semble axé sur une couche d'infrastructure IA qui deviendra probablement plus importante à mesure que les écosystèmes se développent.
Surtout une fois que plus d'utilisateurs, d'applications et de jeux de données commenceront à interagir à travers les réseaux.
La crypto a déjà montré à quelle vitesse le comportement numérique évolue une fois que la participation s'échelle.
Donc, les systèmes qui peuvent coordonner les contributions et l'attribution de manière plus efficace pourraient finir par devenir une partie assez importante de l'écosystème IA plus tard.
C'est encore tôt, évidemment.
Mais on dirait que le marché commence progressivement à prêter plus attention à l'infrastructure sous-jacente de l'IA au lieu de ne se concentrer que sur les résultats.
C'est principalement pourquoi j'ai surveillé $OPEN récemment.
#openledger $OPEN @OpenLedger
2
183
·
--
Haussier
Je surveille OpenLedger avec un esprit calme parce que j'ai vu assez de cycles crypto pour savoir qu'une narrative solide peut attirer l'attention très rapidement, mais l'attention seule ne rend pas un projet important.
OpenLedger semble intéressant car il essaie de s'attaquer à un vrai problème dans l'IA. Les données, les modèles, les agents et l'apport humain créent de la valeur partout, mais la valeur n'est pas toujours suivie clairement. Beaucoup de gens contribuent aux systèmes d'IA de différentes manières, mais la plupart de ces contributions restent invisibles. OpenLedger veut rendre ces contributions plus utiles, plus traçables et plus monétisables.
Cette idée a du sens pour moi.
Mais je ne me précipite pas pour l'appeler un gagnant.
La vraie question n'est pas de savoir si OpenLedger sonne bien. La vraie question est de savoir si les gens en ont réellement besoin.
Les développeurs construisent-ils dessus parce que cela résout un vrai problème ?
Les contributeurs de données apportent-ils des données précieuses, ou ne poursuivent-ils que des récompenses ?
Les modèles et les agents créent-ils une véritable activité économique, ou la plupart des activités sont-elles encore poussées par le hype ?
Est-ce que l'OPEN est utilisé parce que le réseau en a besoin, ou parce que les traders suivent la narrative de l'IA ?
Ce sont les questions qui m'importent.
J'ai déjà vu le DeFi, le GameFi, les tokens de métavers, les chaînes modulaires, les pièces d'IA, et de nombreuses autres narratives venir et disparaître. Chaque cycle apporte des projets qui semblent puissants au début. Certains deviennent de vraies infrastructures. La plupart s'estompent lorsque les incitations disparaissent et que l'attention se déplace ailleurs.
C'est pourquoi je regarde OpenLedger de près.
Le projet a du potentiel car l'IA aura besoin de meilleurs systèmes pour l'attribution, la propriété des données, la confiance et la coordination. Si OpenLedger peut aider les contributeurs de données, les constructeurs de modèles et les agents d'IA à travailler ensemble dans une véritable économie, alors cela pourrait devenir plus qu'un simple token.
Mais le potentiel n'est pas une preuve.
#OpenLedger @Openledger $OPEN
{future}(OPENUSDT)
Je surveille OpenLedger avec un esprit calme parce que j'ai vu assez de cycles crypto pour savoir qu'une narrative solide peut attirer l'attention très rapidement, mais l'attention seule ne rend pas un projet important.
OpenLedger semble intéressant car il essaie de s'attaquer à un vrai problème dans l'IA. Les données, les modèles, les agents et l'apport humain créent de la valeur partout, mais la valeur n'est pas toujours suivie clairement. Beaucoup de gens contribuent aux systèmes d'IA de différentes manières, mais la plupart de ces contributions restent invisibles. OpenLedger veut rendre ces contributions plus utiles, plus traçables et plus monétisables.
Cette idée a du sens pour moi.
Mais je ne me précipite pas pour l'appeler un gagnant.
La vraie question n'est pas de savoir si OpenLedger sonne bien. La vraie question est de savoir si les gens en ont réellement besoin.
Les développeurs construisent-ils dessus parce que cela résout un vrai problème ?
Les contributeurs de données apportent-ils des données précieuses, ou ne poursuivent-ils que des récompenses ?
Les modèles et les agents créent-ils une véritable activité économique, ou la plupart des activités sont-elles encore poussées par le hype ?
Est-ce que l'OPEN est utilisé parce que le réseau en a besoin, ou parce que les traders suivent la narrative de l'IA ?
Ce sont les questions qui m'importent.
J'ai déjà vu le DeFi, le GameFi, les tokens de métavers, les chaînes modulaires, les pièces d'IA, et de nombreuses autres narratives venir et disparaître. Chaque cycle apporte des projets qui semblent puissants au début. Certains deviennent de vraies infrastructures. La plupart s'estompent lorsque les incitations disparaissent et que l'attention se déplace ailleurs.
C'est pourquoi je regarde OpenLedger de près.
Le projet a du potentiel car l'IA aura besoin de meilleurs systèmes pour l'attribution, la propriété des données, la confiance et la coordination. Si OpenLedger peut aider les contributeurs de données, les constructeurs de modèles et les agents d'IA à travailler ensemble dans une véritable économie, alors cela pourrait devenir plus qu'un simple token.
Mais le potentiel n'est pas une preuve.
#OpenLedger @OpenLedger $OPEN
1
134
·
--
J'ai récemment conçu un processus d'automatisation avec plusieurs agents coopératifs, et plus j'avance, plus je trouve que le rêve de "des milliers d'agents s'appelant et se réglant automatiquement" (@Openledger ) sonne sexy, mais en réalité, il cache un risque d'ingénierie mortel : la propagation en cascade des pannes.
D'abord, parlons de mon scénario réel. J'ai trois microservices : A qui récupère les données on-chain, B qui nettoie ces données en rapports structurés, et C qui prend des décisions basées sur ces rapports. Dans un système centralisé, je peux ajouter des timeouts, des retries, et des circuit breakers à chaque étape. Si A tombe, C peut immédiatement le détecter et se dégrader, évitant ainsi de travailler avec des données sales. Ce mécanisme de tolérance aux pannes, j'ai mis du temps à le stabiliser localement.
Maintenant, si je déplace cela sur le réseau décentralisé d'OpenLedger, la difficulté devient incontrôlable. Lorsque l'agent C achète automatiquement un rapport à l'agent B, qui paie ensuite automatiquement A pour les frais de données, toute la chaîne d'appels est entièrement automatisée et sans surveillance. Le problème surgit : que se passe-t-il si le nœud A subit une coupure de courant, une perte de connexion ou un crash ?
La situation la plus terrible serait que A ne soit pas complètement hors service, mais retourne un résultat "qui semble normal, mais qui est en réalité des données sales". B ne remettra pas en question ce résultat et nettoiera ces données en rapport, tandis que C exécutera sans hésitation une transaction en argent réel sur la chaîne basée sur ce rapport de données sales. Quand vous vous rendrez compte du problème, la perte sera déjà faite, et comme tout est exécuté automatiquement, personne ne pourra appuyer sur le bouton pause à temps. $LAB
Dans un système centralisé, je peux toujours surveiller, interrompre ou annuler. Mais dans un réseau décentralisé, entièrement automatisé et en boîte noire, personne ne peut "opérer" cette chaîne en pleine vitesse. Même si le système pénalise A en confisquant son dépôt (Slash) pour compenser, mon activité se retrouvera déjà à l'arrêt catastrophique à cause de cette panne en cascade.
Donc, objectivement, la direction de la combinabilité des agents d'OpenLedger est correcte et touche effectivement à la tendance de l'économie machine. Mais "perdre des données peut coûter cher" n'est pas suffisant ; pour un usage commercial sérieux, il faut que "la chaîne ne puisse pas se tromper une seconde". Ne vous concentrez pas uniquement sur l'automatisation sexy, mais examinez également le véritable design concernant la tolérance aux pannes et la prévention des cascades. Restez neutre, faites vos propres recherches. #BTC
#OpenLedger $OPEN @Openledger
{future}(LABUSDT)
{spot}(OPENUSDT)
J'ai récemment conçu un processus d'automatisation avec plusieurs agents coopératifs, et plus j'avance, plus je trouve que le rêve de "des milliers d'agents s'appelant et se réglant automatiquement" (@OpenLedger ) sonne sexy, mais en réalité, il cache un risque d'ingénierie mortel : la propagation en cascade des pannes.
D'abord, parlons de mon scénario réel. J'ai trois microservices : A qui récupère les données on-chain, B qui nettoie ces données en rapports structurés, et C qui prend des décisions basées sur ces rapports. Dans un système centralisé, je peux ajouter des timeouts, des retries, et des circuit breakers à chaque étape. Si A tombe, C peut immédiatement le détecter et se dégrader, évitant ainsi de travailler avec des données sales. Ce mécanisme de tolérance aux pannes, j'ai mis du temps à le stabiliser localement.
Maintenant, si je déplace cela sur le réseau décentralisé d'OpenLedger, la difficulté devient incontrôlable. Lorsque l'agent C achète automatiquement un rapport à l'agent B, qui paie ensuite automatiquement A pour les frais de données, toute la chaîne d'appels est entièrement automatisée et sans surveillance. Le problème surgit : que se passe-t-il si le nœud A subit une coupure de courant, une perte de connexion ou un crash ?
La situation la plus terrible serait que A ne soit pas complètement hors service, mais retourne un résultat "qui semble normal, mais qui est en réalité des données sales". B ne remettra pas en question ce résultat et nettoiera ces données en rapport, tandis que C exécutera sans hésitation une transaction en argent réel sur la chaîne basée sur ce rapport de données sales. Quand vous vous rendrez compte du problème, la perte sera déjà faite, et comme tout est exécuté automatiquement, personne ne pourra appuyer sur le bouton pause à temps. $LAB
Dans un système centralisé, je peux toujours surveiller, interrompre ou annuler. Mais dans un réseau décentralisé, entièrement automatisé et en boîte noire, personne ne peut "opérer" cette chaîne en pleine vitesse. Même si le système pénalise A en confisquant son dépôt (Slash) pour compenser, mon activité se retrouvera déjà à l'arrêt catastrophique à cause de cette panne en cascade.
Donc, objectivement, la direction de la combinabilité des agents d'OpenLedger est correcte et touche effectivement à la tendance de l'économie machine. Mais "perdre des données peut coûter cher" n'est pas suffisant ; pour un usage commercial sérieux, il faut que "la chaîne ne puisse pas se tromper une seconde". Ne vous concentrez pas uniquement sur l'automatisation sexy, mais examinez également le véritable design concernant la tolérance aux pannes et la prévention des cascades. Restez neutre, faites vos propres recherches. #BTC
#OpenLedger $OPEN @OpenLedger
自动调用链断了怎么办
50%
Agent 协作扛得住故障吗
50%
2 Votes • Vote fermé
2
1
452
·
--
Le Flywheel de Valeur d'OpenLedgerLors de l'évaluation de la viabilité à long terme d'un Réseau d'Infrastructure Physique Décentralisée (DePIN), le modèle de tokenomics doit être suffisamment solide pour soutenir les contributions matérielles physiques. Un projet ne peut pas compter uniquement sur le battage médiatique ; il nécessite une boucle autosuffisante. C'est précisément pourquoi le plan économique de @Openledger suscite un intérêt considérable de la part des développeurs.
La relation entre le réseau et son actif natif, le $OPEN token, est fondée sur une réelle utilité. Alors que les applications décentralisées et les entreprises exploitent le réseau pour le stockage de données sécurisé et le calcul vérifiable, elles utilisent activement $OPEN pour régler les frais de transaction et sécuriser la bande passante opérationnelle. Cette demande continue récompense les fournisseurs de nœuds qui maintiennent l'infrastructure sécurisée, formant ainsi une boucle de croissance saine. Alors que la création de données mondiales continue de croître de manière exponentielle, établir un marché décentralisé pour le traitement de ces données positionne ce protocole à l'avant-garde de l'innovation Web3. #OpenLedger
Le Flywheel de Valeur d'OpenLedger
Lors de l'évaluation de la viabilité à long terme d'un Réseau d'Infrastructure Physique Décentralisée (DePIN), le modèle de tokenomics doit être suffisamment solide pour soutenir les contributions matérielles physiques. Un projet ne peut pas compter uniquement sur le battage médiatique ; il nécessite une boucle autosuffisante. C'est précisément pourquoi le plan économique de @OpenLedger suscite un intérêt considérable de la part des développeurs.
La relation entre le réseau et son actif natif, le $OPEN token, est fondée sur une réelle utilité. Alors que les applications décentralisées et les entreprises exploitent le réseau pour le stockage de données sécurisé et le calcul vérifiable, elles utilisent activement $OPEN pour régler les frais de transaction et sécuriser la bande passante opérationnelle. Cette demande continue récompense les fournisseurs de nœuds qui maintiennent l'infrastructure sécurisée, formant ainsi une boucle de croissance saine. Alors que la création de données mondiales continue de croître de manière exponentielle, établir un marché décentralisé pour le traitement de ces données positionne ce protocole à l'avant-garde de l'innovation Web3. #OpenLedger
La relation entre le réseau et son actif natif, le $OPEN token, est fondée sur une réelle utilité. Alors que les applications décentralisées et les entreprises exploitent le réseau pour le stockage de données sécurisé et le calcul vérifiable, elles utilisent activement $OPEN pour régler les frais de transaction et sécuriser la bande passante opérationnelle. Cette demande continue récompense les fournisseurs de nœuds qui maintiennent l'infrastructure sécurisée, formant ainsi une boucle de croissance saine. Alors que la création de données mondiales continue de croître de manière exponentielle, établir un marché décentralisé pour le traitement de ces données positionne ce protocole à l'avant-garde de l'innovation Web3. #OpenLedger
1
85
·
--
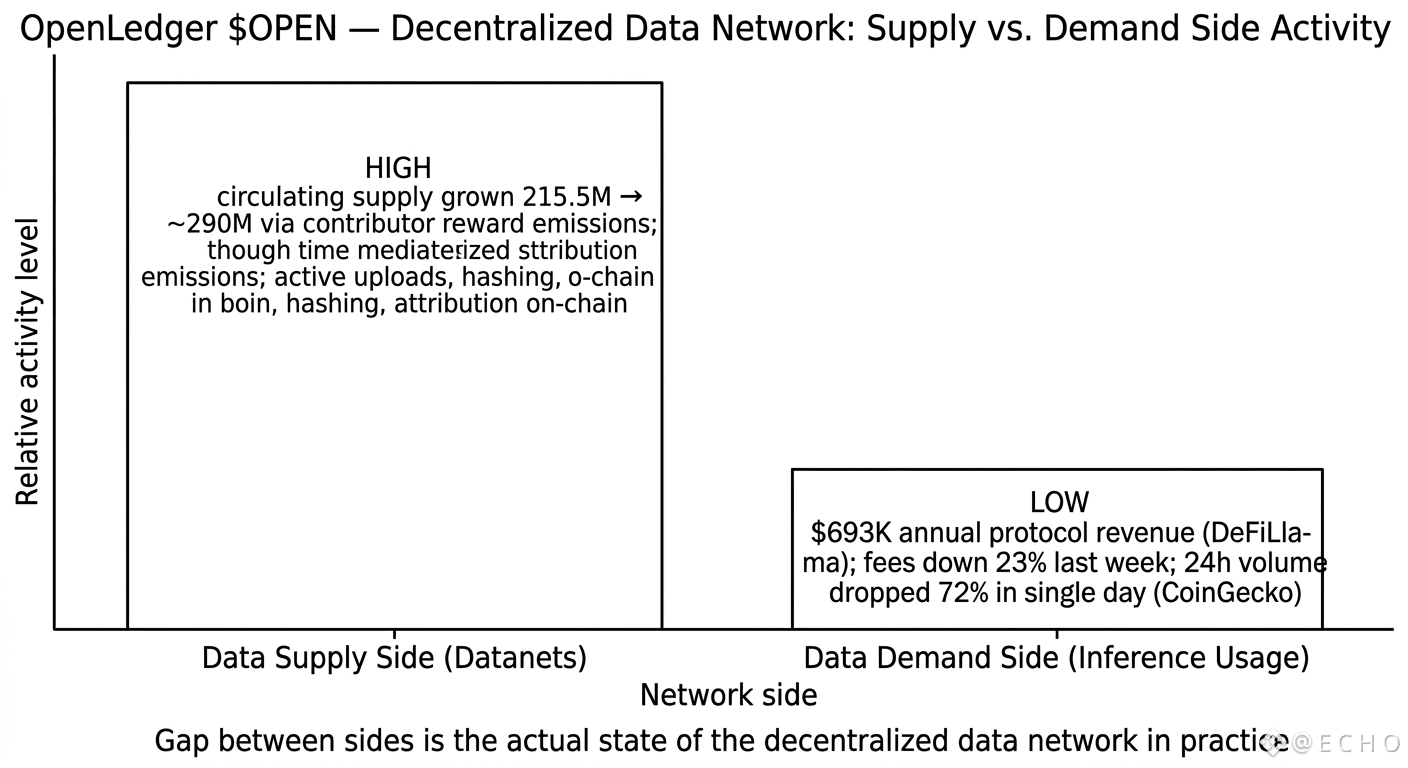
Ce qui m'a marqué pendant la tâche OpenLedger $OPEN #OpenLedger @Openledger , ce n'était pas l'infrastructure — c'est vraiment intéressant — mais c'était de voir quelle moitié du réseau de données fonctionne réellement. Les Datanets sont en pleine expansion. Les contributeurs téléchargent, taguent, hachent. Le côté offre de l'histoire des données décentralisées est actif et se fait récompenser via des émissions de tokens — l'offre en circulation est passée de 215,5M à environ 290M OPEN depuis le TGE, selon CoinMarketCap. Cette croissance est réelle et cela montre que les gens sont présents.
Le côté demande est une autre paire de manches. DeFiLlama évalue les revenus annuels des protocoles à 693K $, avec des frais en baisse de 23% au cours de la semaine dernière. Et CoinGecko montre que le volume de trading sur 24 heures a chuté de 72% en une seule journée récemment, ce qui est volatil même selon les normes crypto. Les Datanets existent, les données y sont attribuées et hachées, mais la demande d'inférence qui était censée circuler et compenser les contributeurs proportionnellement… n'est pas encore arrivée à grande échelle.
Je n'arrêtais pas de penser aux premières années d'Ocean Protocol. Même type de problème — riche en infrastructure d'offre, attendant la demande. La question à laquelle OpenLedger n'a pas encore répondu n'est pas de savoir si les réseaux de données décentralisées comptent. C'est ce qui attire réellement les builders à interroger ces Datanets spécifiques plutôt que des alternatives centralisées moins chères et plus rapides.
Ce qui m'a marqué pendant la tâche OpenLedger $OPEN #OpenLedger @OpenLedger , ce n'était pas l'infrastructure — c'est vraiment intéressant — mais c'était de voir quelle moitié du réseau de données fonctionne réellement. Les Datanets sont en pleine expansion. Les contributeurs téléchargent, taguent, hachent. Le côté offre de l'histoire des données décentralisées est actif et se fait récompenser via des émissions de tokens — l'offre en circulation est passée de 215,5M à environ 290M OPEN depuis le TGE, selon CoinMarketCap. Cette croissance est réelle et cela montre que les gens sont présents.
Le côté demande est une autre paire de manches. DeFiLlama évalue les revenus annuels des protocoles à 693K $, avec des frais en baisse de 23% au cours de la semaine dernière. Et CoinGecko montre que le volume de trading sur 24 heures a chuté de 72% en une seule journée récemment, ce qui est volatil même selon les normes crypto. Les Datanets existent, les données y sont attribuées et hachées, mais la demande d'inférence qui était censée circuler et compenser les contributeurs proportionnellement… n'est pas encore arrivée à grande échelle.
Je n'arrêtais pas de penser aux premières années d'Ocean Protocol. Même type de problème — riche en infrastructure d'offre, attendant la demande. La question à laquelle OpenLedger n'a pas encore répondu n'est pas de savoir si les réseaux de données décentralisées comptent. C'est ce qui attire réellement les builders à interroger ces Datanets spécifiques plutôt que des alternatives centralisées moins chères et plus rapides.
1
415
·
--
#openledger $OPEN Les données ouvertes et l’IA décentralisée peuvent ouvrir de nouvelles opportunités à travers l’industrie de la blockchain. @OpenLedger construit une infrastructure qui aide à connecter les fournisseurs de données et les applications d’IA, créant une utilité réelle pour l’écosystème. Hâte de voir l’avenir de $OPEN. #OpenLedger
#openledger $OPEN Les données ouvertes et l’IA décentralisée peuvent ouvrir de nouvelles opportunités à travers l’industrie de la blockchain. @OpenLedger construit une infrastructure qui aide à connecter les fournisseurs de données et les applications d’IA, créant une utilité réelle pour l’écosystème. Hâte de voir l’avenir de $OPEN . #OpenLedger
61
·
--
@Openledger Dans cette croissance, ce qui m'excite le plus, ce n'est pas combien de portefeuilles actifs ont augmenté, mais à quel point sa croissance n'est pas "uniforme". $LAB
Cette semaine, j'ai passé en revue les données d'appel de chaque Datanet, et les écarts sont ridiculement énormes. Les données financières et les données on-chain sont largement en tête en termes de fréquence d'appel, tandis que beaucoup d'autres directions sont aussi désertes qu'une ville fantôme, laissées là sans personne pour les remarquer. #BTC
Au début, je pensais que c'était un problème, puis je me suis rendu compte — cette extrême inégalité est en fait un vrai signal de santé. Le marché vote avec de l'argent réel : ceux dont les données sont recherchées attirent les contributeurs. Ce n'est pas une prospérité artificielle poussée par les équipes de projet avec des ressources, mais le résultat d'un tri naturel, cruel mais authentique.
La logique de partage des revenus de Proof of Attribution force l'attention des contributeurs à se détourner de "la manipulation de volume" pour se concentrer sur ce qui est "réellement utile", grâce à des intérêts économiques flagrants, pas à des slogans de communauté. Si tu balances une montagne de données inutiles que personne n'appelle, la récompense que tu reçois est quasiment de @Openledger ; si les données que tu fournis sont appelées fréquemment, les récompenses affluent. L'efficacité des deux mécanismes est à des années-lumière l'un de l'autre, et la plupart des projets ne comprennent toujours pas ce point.
Mais ce qui me préoccupe le plus en ce moment, c'est cette épine de la qualité des données.
Le problème de la disparité des Datanets, je n'ai pas encore vu de solution efficace. Des données de mauvaise qualité mélangées ici et là vont lentement détruire la réputation de toute la plateforme. Si un appelant se prend plusieurs pièges à la suite, il y a de fortes chances qu'il parte et ne revienne jamais. C'est cela mon plus grand souci — ce n'est pas le prix des tokens à court terme, mais si la qualité moyenne des données peut supporter l'expansion de l'échelle.
De plus, il y a un cercle vicieux : plus un Datanet est inconnu, moins il y a d'appels, moins il y a d'appels, moins il y a de gens prêts à fournir des données de qualité, et finalement, il ne reste que des déchets qui pourrissent là. Les directions populaires attirent toute l'attention, tandis que les directions de longue traîne meurent de faim.
$OPEN Ce que je veux, c'est un marché libre des données, mais un marché libre tend naturellement à se polariser.
Au cours des six prochains mois, le véritable taux d'élimination des Datanets sera plus révélateur que n'importe quel nombre de portefeuilles actifs. Trouver un équilibre entre "tri naturel" et "flétrissement de la longue traîne" est un obstacle qu'elle ne peut pas éviter.
#OpenLedger
{alpha}(560x7ec43cf65f1663f820427c62a5780b8f2e25593a)
{spot}(OPENUSDT)
@OpenLedger Dans cette croissance, ce qui m'excite le plus, ce n'est pas combien de portefeuilles actifs ont augmenté, mais à quel point sa croissance n'est pas "uniforme". $LAB
Cette semaine, j'ai passé en revue les données d'appel de chaque Datanet, et les écarts sont ridiculement énormes. Les données financières et les données on-chain sont largement en tête en termes de fréquence d'appel, tandis que beaucoup d'autres directions sont aussi désertes qu'une ville fantôme, laissées là sans personne pour les remarquer. #BTC
Au début, je pensais que c'était un problème, puis je me suis rendu compte — cette extrême inégalité est en fait un vrai signal de santé. Le marché vote avec de l'argent réel : ceux dont les données sont recherchées attirent les contributeurs. Ce n'est pas une prospérité artificielle poussée par les équipes de projet avec des ressources, mais le résultat d'un tri naturel, cruel mais authentique.
La logique de partage des revenus de Proof of Attribution force l'attention des contributeurs à se détourner de "la manipulation de volume" pour se concentrer sur ce qui est "réellement utile", grâce à des intérêts économiques flagrants, pas à des slogans de communauté. Si tu balances une montagne de données inutiles que personne n'appelle, la récompense que tu reçois est quasiment de @OpenLedger ; si les données que tu fournis sont appelées fréquemment, les récompenses affluent. L'efficacité des deux mécanismes est à des années-lumière l'un de l'autre, et la plupart des projets ne comprennent toujours pas ce point.
Mais ce qui me préoccupe le plus en ce moment, c'est cette épine de la qualité des données.
Le problème de la disparité des Datanets, je n'ai pas encore vu de solution efficace. Des données de mauvaise qualité mélangées ici et là vont lentement détruire la réputation de toute la plateforme. Si un appelant se prend plusieurs pièges à la suite, il y a de fortes chances qu'il parte et ne revienne jamais. C'est cela mon plus grand souci — ce n'est pas le prix des tokens à court terme, mais si la qualité moyenne des données peut supporter l'expansion de l'échelle.
De plus, il y a un cercle vicieux : plus un Datanet est inconnu, moins il y a d'appels, moins il y a d'appels, moins il y a de gens prêts à fournir des données de qualité, et finalement, il ne reste que des déchets qui pourrissent là. Les directions populaires attirent toute l'attention, tandis que les directions de longue traîne meurent de faim.
$OPEN Ce que je veux, c'est un marché libre des données, mais un marché libre tend naturellement à se polariser.
Au cours des six prochains mois, le véritable taux d'élimination des Datanets sera plus révélateur que n'importe quel nombre de portefeuilles actifs. Trouver un équilibre entre "tri naturel" et "flétrissement de la longue traîne" est un obstacle qu'elle ne peut pas éviter.
#OpenLedger
不均衡到底是好是坏
50%
数据质量这关怎么过
0%
冷门方向会被饿死吗
0%
我也想上传数据试试
50%
2 Votes • Vote fermé
2
1
229
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
1
#BinancePick
3.4M vues
164,640 mentions
2
#EarningsSeason
5.5M vues
26,872 mentions
3
#StrategySkipsBitcoinPurchasesSpends$205MOnSTRCBuybacks
823 vues
25 mentions
4
#BitmineAdds10452ETH
9,612 vues
222 mentions
5
#SouthKoreaConsidersEducationTaxOnCryptoExchanges
7,508 vues
204 mentions
6
#OCCUrgesCommunityBanksToEnterStablecoinPayments
7,513 vues
129 mentions
7
#RippleWinsFullApprovalAsNationalTrustBank
6,634 vues
131 mentions
8
#AkashSelectsSolanaAsMigrationTarget
4,252 vues
61 mentions
9
#OndoToOpenSubscriptionsForOpenAIPreIPOTokenizedNotes
283 vues
17 mentions
10
#AnthropicTTMRevenueGrewAbout1200%
59,610 vues
602 mentions