

花儿不在
17 Publicaciones
花儿不在
Denunciar
Bloquear usuario
2 Siguiendo
5 Seguidores
3 Me gusta
Publicaciones
·
--
#opg $OPG
Hoy tenemos que hablar de OpenGradient: no porque prometa cosas demasiado bonitas, sino porque el airdrop de HODLers de Binance acaba de salir hoy. Me pasé la tarde entera leyendo el whitepaper y descubrí que el proyecto sí tiene algo
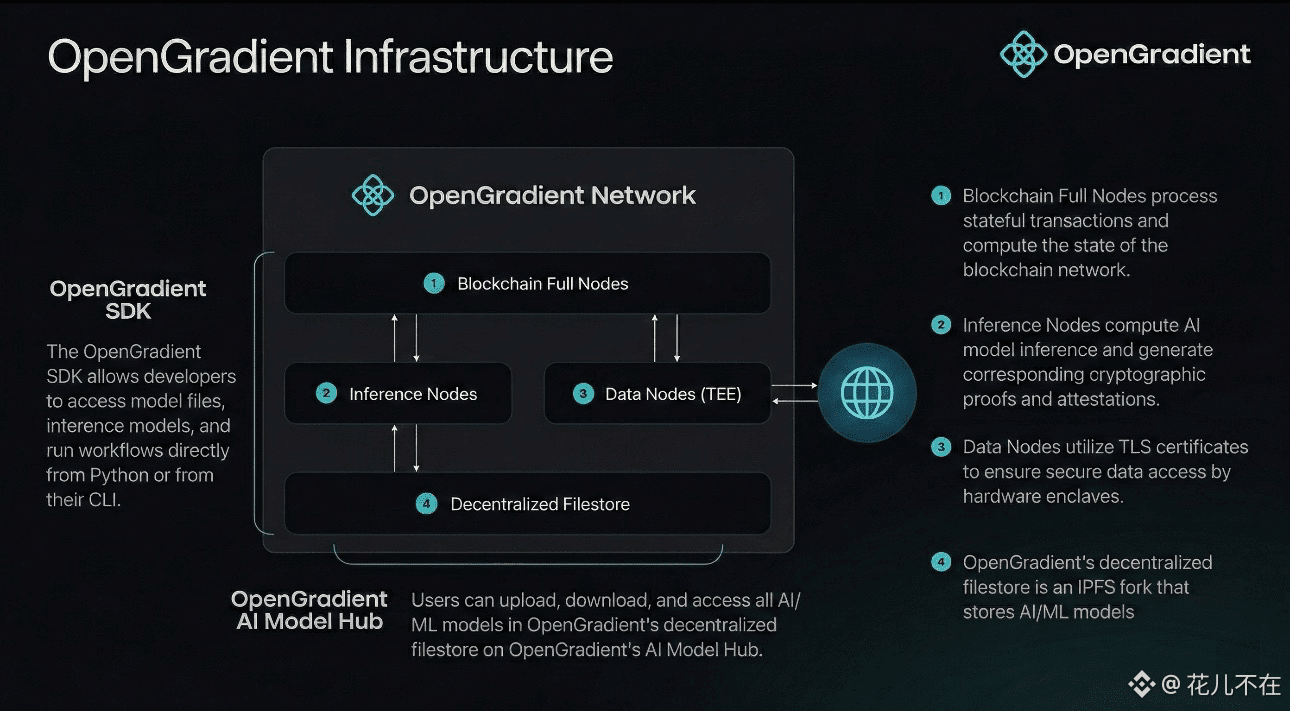
Primero, hablemos de tecnología. Si cada nodo de la cadena tuviera que ejecutar un modelo de IA por su cuenta, la red se colapsaría. En el whitepaper de OpenGradient hay una frase muy directa: “Hacer que cada nodo verificador ejecute de forma independiente la inferencia del modelo no es realista”. Por eso desarrollaron un sistema de arquitectura de computación híbrida para IA (HACA), separando por completo “ejecución” y “verificación”. Los nodos de inferencia usan GPU y TEE para correr el modelo y hacer el trabajo pesado; los nodos completos solo se encargan de verificar la autenticación del TEE y las pruebas ZKML, y de llevar el registro. No necesitas volver a ejecutar el modelo: solo necesitas verificar que se ejecutó correctamente. Los nodos verificadores pueden ser muy ligeros; con ese simple cambio de mentalidad, resuelven tanto el rendimiento como la confianza
Ahora, el producto. Su Opg Chat puede usar directamente modelos como ChatGPT, Claude, Gemini y Grok, además de generar imágenes y archivos. Lo clave es el cifrado en el lado del dispositivo: la información se cifra localmente antes de salir del navegador, y las claves solo están en tu dispositivo. Al pasar por el reenvío de Oblivious HTTP, el relay solo puede ver tu IP, pero solo tiene el texto cifrado; el gateway aguas abajo ve el texto plano, pero nunca puede ver tu IP. Luego, en el gateway aislado con TEE, se descifra para procesar. Además, el TEE incluye autenticación remota, para que puedas verificar por tu cuenta estas promesas de privacidad. Es como si te asignaran un camión blindado y totalmente cerrado de transporte de dinero: salvo tú mismo, nadie sabe qué hay dentro. Opg Chat ya lleva dos semanas en línea: está dando servicio a más de 2 millones de usuarios, y ha procesado más de 2 millones de veces de inferencia verificable. En el Model Hub también integraron más de 2000 modelos.
Y cuando hago números de economía: el suministro total de OPG es de 1,000,000,000 de monedas; en circulación hay aproximadamente 198 millones. a16z crypto lideró la ronda, y junto con Coinbase Ventures, SV Angel, Foresight Ventures y otras 24 instituciones invirtieron acumuladamente 9.5 millones de dólares. El airdrop de HODLers del programa 66 de Binance acaba de lanzarse hoy. Pero también tengo que decirlo claro: el airdrop es una oportunidad, pero no te quedes solo mirando los caramelos y olvides las espinas bajo tus pies. El precio actual está alrededor de 0.15 dólares; el valor de mercado totalmente diluido (FDV) es de más de 150 millones de dólares, y el 80% de los tokens aún no ha sido desbloqueado. El proyecto todavía está en fase de testnet, así que la tecnología no ha sido validada a gran escala
Mi conclusión es muy simple: la narrativa técnica funciona, la oportunidad del airdrop es real, pero los tokens que aún no se han desbloqueado (80%) son una espada colgando sobre tu cabeza @OpenGradient
1
127
·
--
Anoche estuve leyendo la documentación de OpenGradient hasta la una de la madrugada. Cuando vi las cuatro palabras "verificación asíncrona", reaccioné por reflejo y presioné Ctrl+F, escribí "verificación fallida".
0 resultados.
También probé "failure", "settlement" y "rollback". No funcionó ninguna.
El diseño de HACA es realmente inteligente. Las cadenas de bloques tradicionales hacen que cada validador vuelva a ejecutar cada transacción, y además el razonamiento de la IA es caro y no es determinista: simplemente no se puede ejecutar. La solución de OpenGradient consiste en separar la ejecución de la verificación: los nodos de inferencia ejecutan el modelo y devuelven resultados en milisegundos; el nodo completo valida de forma asíncrona pruebas de TEE. Los nodos de validación no necesitan saber cuál es el prompt ni qué modelo se usa; solo necesitan confirmar que el código no ha sido manipulado dentro del enclave.
El problema está precisamente aquí. La documentación oficial lo explica con claridad: la prueba de TEE verifica que el "enclave no fue manipulado", no si el resultado en sí es correcto. El nodo de inferencia puede ejecutar el modelo "correctamente" dentro del TEE y devolver igualmente un resultado erróneo: la prueba aun así pasaría. El documento admite una "brecha temporal de confianza", pero no dice ni una palabra sobre cómo se cubre esa brecha. $OPG
Gate Academy tiene un artículo que menciona: "verificación fallida, el resultado será rechazado o recalculado". ¿Quién paga el dinero del recalculo? ¿Cómo se revierte una transacción que ya se ejecutó? Ni siquiera dejan un TODO en la documentación oficial.
Mira DeFi: cuando falla la verificación hay mecanismos de compensación mediante liquidación y confiscación como respaldo; mira Optimistic Rollup: tiene un período de desafío y pruebas de fraude. OpenGradient convierte en gancho el "entregar primero el resultado y verificar después", pero ¿quién se encarga de recoger el desastre? Por lo que se ve, el costo lo asume el usuario. #OPG
La dirección del diseño está bien. Pero antes de que el modelo económico de la red principal se publique por completo y el manejo de la verificación fallida se escriba en la documentación, tengo que calcular esta cuenta con claridad primero. @OpenGradient
1
78
·
--
No adivines si el gran modelo te cambió en segundo plano por una versión destilada; yo ya caí en ese problema. Probé y ajusté el prompt durante dos semanas y, después del despliegue, el resultado iba de alto a bajo. La plataforma juraba y perjuraba que la versión era la misma, y ni siquiera tenías un método para demostrar tu inocencia.
La solución con la que OpenGradient rompe el bloqueo no juega a lo falso: encierra la inferencia dentro de una zona segura de CPU mediante TEE y la ejecuta ahí. ¿Qué tiene de duro esa “jaula de hierro”? Cuando la potencia de cómputo se pone en marcha, ni siquiera el root de un proveedor en la nube puede abrir el telón de datos: la entrada y la salida quedan aisladas a nivel físico durante todo el proceso. Pero esto solo resuelve la mitad del problema: ¿cómo garantizas que lo que se ejecuta es GPT-4 y no GPT-3.5? Escribe de antemano el hash de los pesos del modelo, fijándolo en la Registry sobre la cadena; al terminar la inferencia, el hardware emite una firma como credencial. Si ambas partes no coinciden la clave secreta, la solicitud se invalida. Ejecución, ejecución; auditoría, auditoría: revisión por dos personas, y si falta una, se cae el sistema. $OPG
En este circuito cerrado, OPG funciona como un “taxímetro”. Cada llamada usa el protocolo x402 para descontar automáticamente los cargos; el desarrollador solo conecta un Python SDK y se olvida de todo el rollo de validación de firmas y demás, solo se ocupa del negocio. Que OPG no sea “caro” no es el punto. La lógica de valoración es así: si la red procesa 100.000 inferencias hoy, entonces hace circular 100.000 veces el coste; si procesa 1.000.000, entonces se duplica y se vuelve moneda dura. Esta valoración es mucho más “hardcore” que la de las MEME coin que se venden en slides. #OPG
Compáralo con el mercado: las APIs centralizadas dependen pura y exclusivamente de la confianza; la verificación con zkML toma tres segundos y ya. Para uso comercial, directamente te echan para atrás. OpenGradient eligió una ruta intermedia: sacrificó al extremo la descentralización para conseguir una verificabilidad a nivel de milisegundos. No me vendas historias sobre la “idealización” de una IA descentralizada; cuando esta cosa realmente empiece a tramitar préstamos por personas o a gestionar private equity, “verificable” deja de ser un extra y se convierte en el pase para tocar la puerta. Quien tenga primero la prueba de inocencia a nivel de hardware en la mano, quien bloquee el cuello de la próxima generación de IA financiera. Si solo vienes a inflar conceptos, quédate a un lado. @OpenGradient
82
·
--
99%的人把质押当存钱罐,但@OpenGradient 白皮书第4.3节有一行被划过去的“魔鬼细节”——错误证明罚没(Slash)。读到这里我后背发凉:质押根本不是生息工具,而是AI推理的“信用保险金”。
验证者质押OPG,不是在挖矿,是在给网络写“欠条”:我对这次验证负责,错了,真金白银赔。OpenGradient每一次AI推理返回结果,背后都有人在用资产担保它的准确性。
对比传统AI就扎心了。 OpenAI、Claude、Gemini,全建立在“无成本证词”之上——模型没篡改?硬件没问题?全靠口头承诺。OpenGradient把道德约束换成了经济约束,把“我相信你”变成了“你不敢骗我,因为骗我有成本”。
这引出一个多数人没算过的供应侧推论:
质押中的OPG退出需要解绑期,Slash风险悬顶时,轻率退出的机会成本比留着更高。所以链上那批OPG,不是因为持有人看好,是因为被机制焊死在那里——被动锁仓和主动持有,是两码事。
如果Slash真实运行,OPG的供需模型将彻底重构:网络越繁荣→验证者需求越多→被责任锁死的筹码比例越高→自由流通盘越稀缺。这是一个非线性的通缩斜率。
当然,风险也摆在那: 验证者节点是否真实增长?Slash是否真实发生?这两组数据目前还是黑盒。但市场往往在“看不清”的时候定价最狠。
当别人还在卷TEE和ZKML技术名词时,聪明钱已经开始计算罚没机制带来的天然买盘压力。质押量决定网络的安全上限,而安全上限决定估值天花板——这个叙事,比单纯的AI Meme硬核十倍。
方向对了,数据会说话。静待验证者地址公开的那天。$OPG #opg @OpenGradient
1
94
·
--
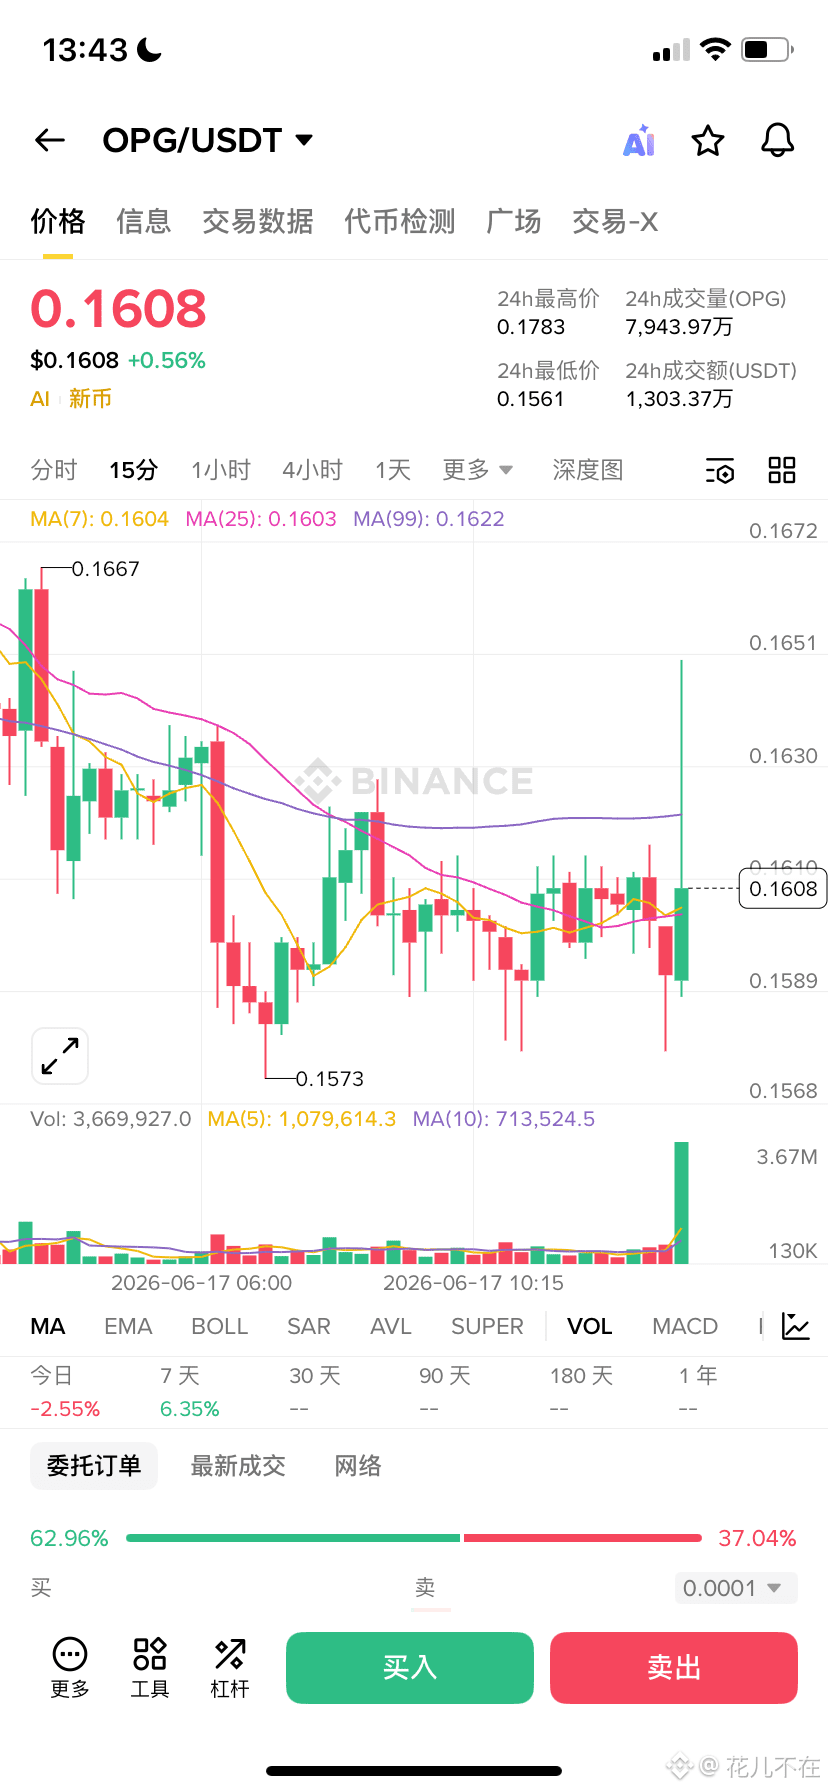
#opg $OPG Fin de semana en una cafetería: el personal me recomendó un “menú oculto”. Con mucha ilusión pedí una taza… pero era solo un latte normal al que le habían agregado un jarabe de caramelo. Esto me recordó a esos proyectos del mundo cripto que presumen de “revolución con IA”; en la mayoría de los casos, solo le ponen una “capa” de tokens a un modelo grande. Pero después de una experiencia en profundidad con @OpenGradient, de verdad me hizo cambiar de opinión.
Su arquitectura híbrida de cómputo de IA, HACA, rompe el estereotipo de que “blockchain + IA = lento”. Las cadenas tradicionales ejecutan la misma transacción en cada nodo validador para llegar a un consenso, y ejecutar modelos a gran escala en términos de cómputo es completamente inviable. HACA divide la red en tres roles especializados: los nodos de inferencia ejecutan el modelo y generan pruebas verificables; los nodos completos solo verifican la validez criptográfica de esas pruebas; y los nodos de datos obtienen entradas externas confiables. El usuario obtiene primero el resultado, mientras que la verificación y el asentamiento se completan de forma asíncrona: así se mantiene la velocidad nivel Web2 y, al mismo tiempo, se “congela” la confianza en cadena.
Lo que más me hace sentir que “realmente es diferente” es su diseño de privacidad. Al usar OpenGradient Chat para procesar información sensible, el cifrado se realiza ya en el lado del navegador; las claves solo existen en tu dispositivo. Luego, mediante un anonimato relay con Oblivious HTTP, se descifra y procesa en un entorno TEE confiable: la parte operadora ni puede ver quién eres ni puede entender el contenido. En comparación con el truco de ChatGPTs de alimentar al modelo con conversaciones, esta es una privacidad verdaderamente “a nivel de arquitectura”.
Los datos confirman la puesta en marcha: desde el lanzamiento en Base en abril, ya ha alojado más de 2000 modelos, verificado más de 500.000 pruebas y procesado más de 2 millones de inferencias. Pero en el fondo sigo con una duda: la “ilusión de caja negra” de la IA choca de forma natural con el “contrato transparente” de blockchain. Si la inferencia del modelo falla, ¿quién asume el riesgo de la toma de decisiones automática en cadena? Por ahora solo participo con una pequeña posición para observar: ni apuesto a ciegas, ni quiero perderme la oportunidad.
Si la IA puede ofrecer servicio a gran velocidad y, a la vez, bloquear la privacidad, ¿será el rival de los gigantes o una apuesta tecnológica a lo grande? Veamos cómo resuelve el próximo paso la pregunta @OpenGradient
88
·
--
#opg $OPG El costo de la liquidación asíncrona@OpenGradient Bajo el mecanismo OpenGradient x402, el riesgo de eficiencia del capital de los nodos que se transfiere
El protocolo de pago x402 de Opg suele empaquetarse como una experiencia de “baja latencia a nivel Web2”, pero su mecanismo central contiene defectos estructurales: el modo de liquidación asíncrona transfiere por completo la eficiencia del capital y el riesgo de fluctuación de precios a los nodos de cómputo. En escenarios comerciales de inferencia masiva, existe una incompatibilidad innata
Desglose del mecanismo: la autorización previa ≠ la liquidación inmediata. Antes de que el usuario inicie la inferencia, completa una autorización previa on-chain mediante Permit2 y aprueba un límite de OPG para el contrato de liquidación. Después de que los nodos consuman la potencia de cómputo GPU y devuelvan resultados, el cargo y la transferencia formales de los tokens OPG se completan de manera asíncrona en la Base chain. La ejecución y la liquidación quedan separadas por completo en el espacio-tiempo: los nodos “primero trabajan” y el dinero “llega después”
Comparación de referencia: conflicto de paradigmas entre el cobro anticipado vs. la liquidación posterior. Plataformas cloud principales como AWS, GCP, etc., ejecutan “dinero disponible, cómputo inicia”, o precongelan saldos, o aplican cargos en tiempo real. Los competidores descentralizados también suelen imponer restricciones rígidas: recargas prepago, cobro por segundo y apagado cuando el saldo se agota. La autorización previa Permit2 de x402 solo resuelve “evitar que el usuario ejecute por fuera”, pero elude el problema del periodo de cuentas (“el dinero está en camino”) y el riesgo de pérdidas por tipo de cambio. En esencia, obliga un apalancamiento de liquidez directamente al proveedor de hardware
Perspectiva cuantitativa: erosión del beneficio bajo triple presión. Para inferencia masiva B2B: la congestión en la liquidación de la Base chain prolonga la ventana de recepción del capital a 12-15 bloques (≈3-5 minutos). Dentro de esta ventana, las fluctuaciones del precio de OPG generan un deslizamiento implícito del 0,5%-2%. Un nodo mediano con 100.000 inferencias al mes: la porción de capital no liquidado se acumula en promedio unos 5.000 OPG diarios. Convertido a costos de préstamo on-chain, cada mes se erosiona más del 4% de la utilidad neta. La electricidad del GPU y la depreciación son gastos rígidos, mientras que los ingresos tienen una demora incierta; el margen de seguridad del flujo de caja del nodo se comprime continuamente
Escenario para romper el bloqueo: el “antídoto” que debe completar la capa del protocolo. Para mantener el suministro de cómputo estable, x402 debe introducir un mecanismo de anclaje de tipo de cambio dinámico (por ejemplo, liquidar por el precio promedio TWAP de 5 minutos), o establecer un fondo de provisión de liquidez en el lado de los nodos para compensar el riesgo del periodo de cuentas. De lo contrario, entre la velocidad de respuesta de Web2 y la fricción de liquidación de Web3, el sistema terminará formando un “pozo sin fondo” de costos que desangran el suministro de cómputo. Primero servir, después liquidar: aunque parece proteger la experiencia del usuario, en realidad transfiere íntegramente el riesgo financiero. Esta sostenibilidad económica a largo plazo merece que cada proveedor de cómputo la reevalúe con prudencia
1
1
80
·
--
#opg $OPG
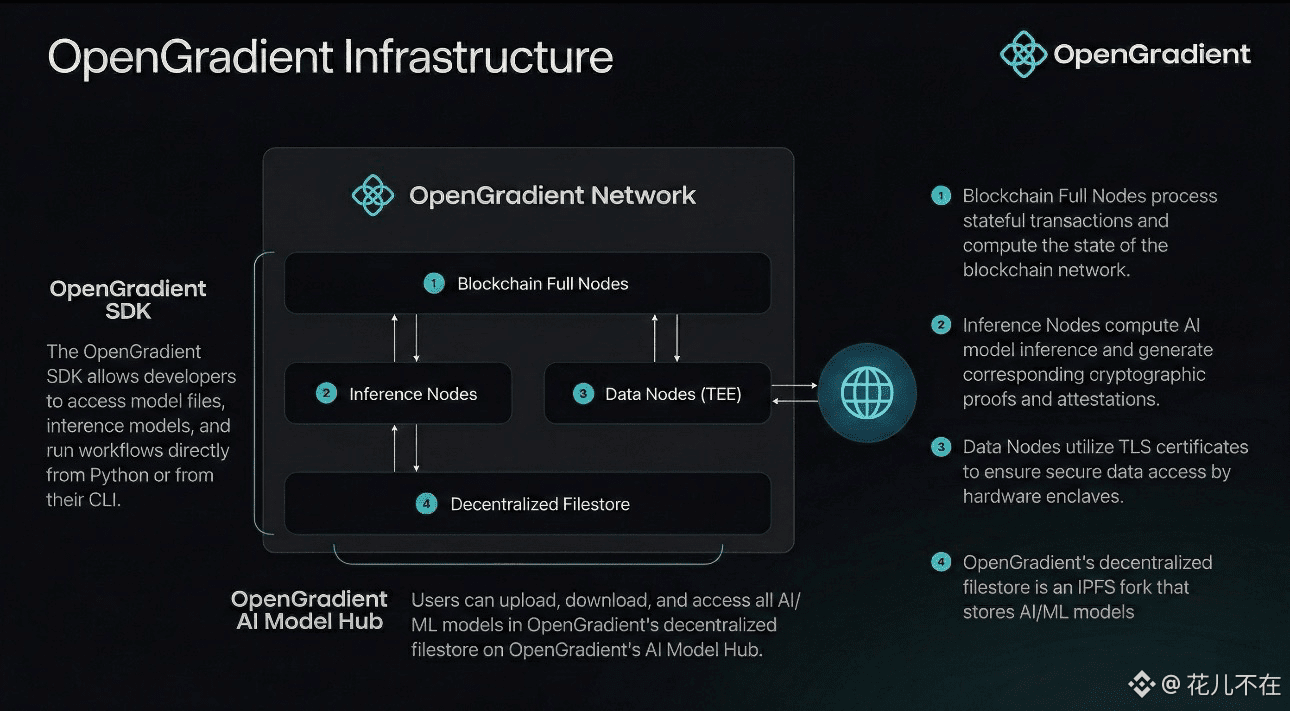
No andemos con rodeos. Lo de OpenGradient, en serio, recién ahora lo entendí. Antes, cuando veía cosas como nodos completos y pruebas de conocimiento cero, me daba dolor de cabeza; sentía que estaba demasiado lejos de nosotros. Pero con paciencia le eché un vistazo a cómo funciona por debajo y, bueno, en pocas palabras es como un grupo de contables meticulosos que te hacen de porteros. En la red, cualquier máquina que ejecute un modelo de IA, ya sea para inferencia o para entrenamiento, si obtiene un resultado, tiene que entregar el “libro” a esos nodos completos. Ellos tienen fórmulas de criptografía y reportes de hardware TEE; una por una te las revisan. ¿No coinciden? Entonces nada de sutilezas: lo anuncian a voz en grito por toda la red, dejando tu truco de hacer trampa al descubierto. Y además, entre ellos se llaman para cuadrar cuentas, por miedo a que se les escape algún detalle.
Las grandes empresas de antes, si el dato sale mal, a lo sumo mandan una carta de disculpa y te piden que les creas por “buena fe”. ¿Aquí? La buena fe no sirve. Si las matemáticas dicen que no cumple, tú puedes llorarle a quien sea, pero los nodos completos no lo “sellan” y listo, no se ejecuta.
Seguro preguntarás: ¿y si los nodos completos hacen trampa ellos mismos? No son tontos. Tienen que poner colateral: para entrar tienen que bloquear una gran cantidad de tokens OPG. El sistema está vigilando todo el tiempo. Si alguien se dedica a hacer trampas aprovechándose o a holgazanear, cuando los detecten le confiscan las apuestas, ¿te duele en el alma, no? En cambio, si revisan bien y sacan rápidamente a los que se hacen pasar por honestos, el sistema premia con OPG: todo con precio claro y visible. ¿A quién le vas a dejar pasar si el objetivo es el dinero? Lo inteligente de este juego es que deja de lado el “cuánto me caes” y lo basa en intereses y matemáticas que se encajan entre sí. Los usuarios comunes ni siquiera tienen que gastar decenas de miles para montar máquinas “de gama alta” como nodos: tú solo haces la llamada desde el front-end y, allá abajo, esos tipos testarudos se encargan de mantenerlo bajo control. Da tranquilidad. Yo lo probé varias veces: no tienes que rogar “por favor, padre nuestro”, solo llamas y los resultados salen clavados.
A partir de ahora, cuando la IA procese datos sensibles, mejor apoyarse en estos nodos que se aferran a los detalles y los mantienen bajo resguardo, como respaldo, mucho más firme que lo que haga cualquier CEO con el pecho. Sellar con matemáticas en lugar de compromisos de boca. Y además, como estos nodos quieren ganar OPG, revisan más que nadie. ¿Quieres engañar? Ni hablar. Me encanta esa eficiencia y limpieza: no tienes que mirar caras, todo depende de algoritmos y de que el hardware sea estricto. ¿Tú sabes? Esto supera con creces a esos proyectos que todo el día gritan “transparencia” pero no puedes ver nada. Total, en adelante usaré IA y me quedo con esta base de abajo: con eso el corazón se queda tranquilo. @OpenGradient
67
·
--
#opg $OPG ¿Alguna vez has pensado que, cuando llamas a un modelo de IA de riesgo, el verdadero peligro no es que “lea” tu entrada, sino el instante en que va al backend a obtener datos?
He trabajado en operaciones y mantenimiento de sistemas, y he visto demasiados registros con el ID de usuario, el saldo de la cuenta y las razones que activaron las últimas transacciones a plena vista. Para depurar problemas, no queda más remedio que revisar parámetros de las solicitudes y los resultados de las respuestas; pero mientras vas pasando páginas, algunas cosas que no deberías ver se te meten en los ojos. No es que alguien sea “malicioso”: es que la propia arquitectura no trata la “consulta de datos” como algo serio. El servidor de la aplicación tiene los permisos del acceso y al mismo tiempo le entrega los datos al modelo; entre medio, todas las huellas se quedan en logs normales. Cuantas más fuentes de datos externos haya, más se vuelve turbia esta situación, y el personal de operaciones, sin darse cuenta, termina convirtiéndose en un observador invisible de la privacidad.
Los Data Nodes de OpenGradient resuelven justo esta entrada. No es simplemente añadir un proxy: aísla la acción de “recuperar datos” por separado, metiéndola en un entorno de ejecución aislado. La tarea solo le dice “qué consultar” y “con qué reglas consultar”; la lectura real se completa dentro de TEE. Ese entorno ni siquiera deja que el sistema operativo del host se meta; ¿el operador del nodo quiere revisar los logs? Lo que verá será puro galimatías.
Pero aún no es suficiente. Lo que más me preocupa es cómo demuestra que no “cambió el material”. Cuando un Data Node devuelve los datos, adjunta un comprobante de autenticación remota: una especie de “orden de entrega” cifrada que indica que estos datos se obtuvieron en un momento específico, dentro de un entorno especificado, bajo condiciones especificadas. Los nodos de inferencia posteriores usan los datos para trabajar; los nodos de verificación solo comprueban si esa orden es auténtica. ¿Intentar cambiar los datos? Si la orden no coincide, toda la cadena se rechaza. La parte que verifica no necesita ver el texto en claro en ningún momento: así se cierra el circuito.
Este conjunto de soluciones resuelve un dilema muy real: cuanto más se usa tiempo real para los datos, más grande es el espacio para falsificar; y cuanto más concentrados están los permisos, más frágil es la confianza. Antes confiábamos en “creer que el personal de operaciones no mirará”; ahora sustituimos esa confianza por un proceso verificable: la consulta de datos tiene aislamiento, el resultado tiene prueba y la rendición de cuentas tiene fundamento. La privacidad deja de ser una promesa y pasa a ser una condición rígida incrustada en la arquitectura. Así de simple@OpenGradient
81
·
--
#opg $OPG la última vez que dejé que la IA me calculara las ganancias de una inversión periódica, salió y se inventó una tasa anual doble; casi me entra un ataque de impulso y me meto todo de golpe. Luego caí en cuenta: ¿cómo demonios lo calculan realmente? No tengo dónde verificarlo, parece una caja negra. Por eso, cuando vi que OpenGradient va a romper la caja para hacerla transparente, mi primer impulso fue aplaudir.
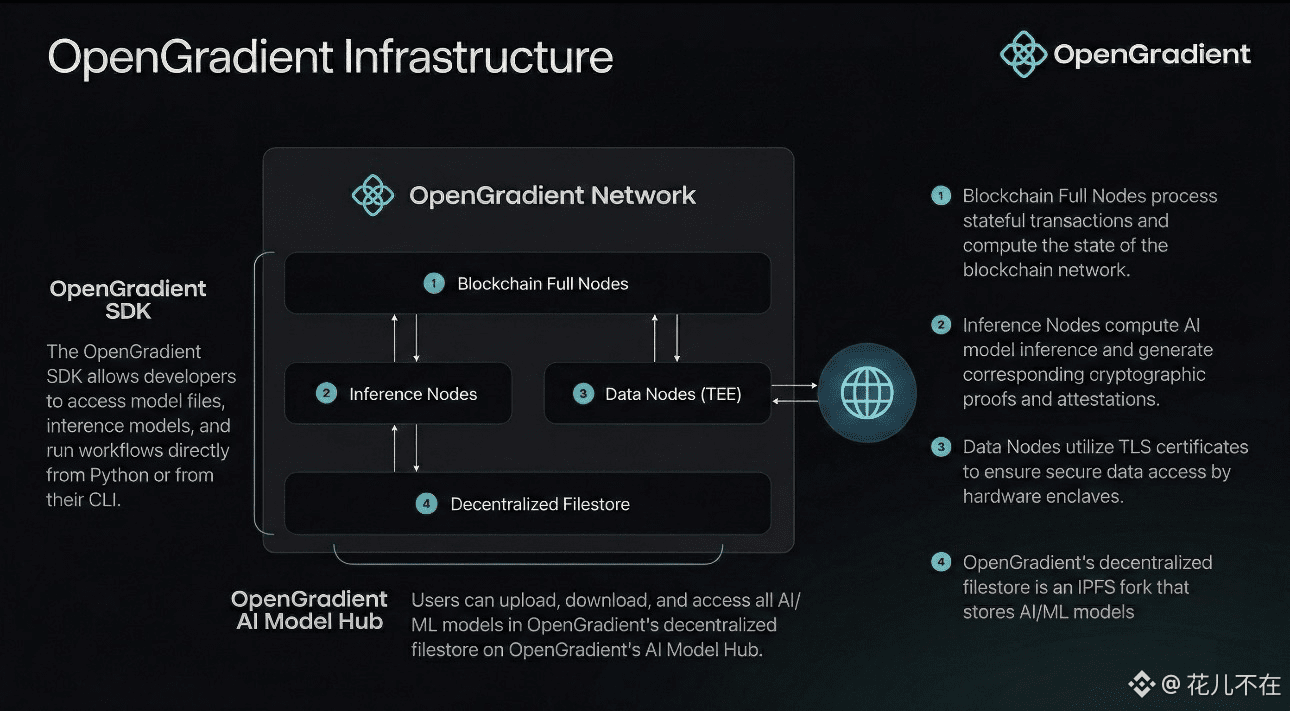
No es como esas grandes empresas que solo se dedican a ajustar parámetros y a hacer videos más “creíbles”. El núcleo es hacer una sola cosa: convertir el proceso de inferencia de la IA en un “libro contable público” que cualquiera pueda consultar. ¿Cómo lo hacen? Desarmando su arquitectura híbrida de cómputo de IA (HACA). En simple: separar la ejecución y la verificación.
Antes, lograr que la IA se suba a la cadena era un callejón sin salida: hacer que 100 nodos vuelvan a ejecutar el mismo modelo una y otra vez para llegar a un consenso cuesta un dineral; además, el modelo viene con un “coeficiente de temperatura”, así que cada respuesta no es exactamente igual, y ni así se logra consenso. HACA cambia el enfoque: los nodos de inferencia primero ejecutan el modelo para generar resultados rápido (ruta rápida), mientras en paralelo generan asíncronamente una prueba criptográfica (ruta lenta), usando un entorno confiable TEE o pruebas de conocimiento cero mediante ZKML. Los nodos de toda la cadena no vuelven a ejecutar el modelo: solo gastan unos milisegundos en verificar si esa prueba es válida. En la capa inferior usan consenso CometBFT para ratificar en cadena, de modo que nadie pueda manipularlo. Con esta combinación, en la cadena ya se han gestionado más de 4400 modelos, se han realizado más de 2 millones de veces de inferencia verificable y se han producido más de 500 mil pruebas, todo con datos reales on-chain.
Así que el “combustible” para que esta “monitorización transparente” funcione son los tokens OPG. Nosotros, los pequeños inversores, usamos OPG para llamar a la inferencia; los nodos ganan con comisiones por servicio. Para ser nodo, tienes que hacer staking de OPG. Si te atreves a jugar con los datos, el colateral se te confisca. Esta mecánica de “paga por hacer el trabajo; si haces trampa, pierdes” convierte el “no hacer el mal” en una contabilidad económica, mil veces más fiable que confiar en la bondad del corazón de las grandes empresas.
A partir de ahora, cuando use IA, me quedaré con la que permite comprobar la monitorización. Una máquina inteligente pero con mil trucos, como la mía de nuevo novato, no me da para tanto. @OpenGradient
99
·
--
#opg $OPG El whitepaper de OpenGradient es un tema recurrente, la capa de liquidación x402 es el verdadero obstáculo a superar. Esto se dedica a la lógica de AI sobre la cadena, $OPG se usa para pagar Gas y hacer staking. Pero el enfoque no está en la tecnología, sino en las tres opciones que le dan a los desarrolladores: —PRIVATE, BATCH_HASHED, INDIVIDUAL_FULL— parece un gesto considerado, pero en realidad es una bomba de compliance que te ponen en las manos, y tú decides cuándo hacerla estallar.
PRIVATE: No deja rastro en la cadena. Se mantiene la privacidad, pero la etiqueta de 'AI verificable' se hace trizas. Si llega la regulación a auditar, ¿qué prueba tienes de que el agente no hizo trampa? ¿El aire?
INDIVIDUAL_FULL: Registros completos quedan en la cadena para siempre. El whitepaper dice que es adecuado para 'Agentes DeFi auditables públicamente', traducido a lo simple: el límite de préstamo del usuario, el umbral de liquidación, la lógica de estrategias están completamente expuestos. Cualquier oponente que escanee la cadena puede apuntar a tu posición con precisión, mejor que el insider trading.
BATCH_HASHED: Agregación Merkle, opción predeterminada. Bajo costo, validación factible, privacidad aceptable—pero esto es un compromiso que no toca nada. Si la regulación dice 'presenta los registros originales', tú das un hash, ¿el juez lo acepta?
Te cuento un caso real: imagina que gestionas un agente de préstamos, eliges el modo FULL, y algún usuario consulta 'cuánto es el máximo que puede pedir prestado' y todo el proceso de razonamiento queda en la cadena, el oponente calcula su exposición al riesgo y se lleva la liquidación. Pierdes dinero real, y el usuario te demanda por violación de privacidad. OpenGradient ya se lavó las manos—un parámetro settlement_mode en el SDK, el desarrollador elige, si algo sale mal, no busques al proyecto.
Estrategia en mi trading real, sin tonterías: en los tres meses posteriores al lanzamiento de la mainnet, solo operar negocios no centrales, forzando BATCH_HASHED. Al mismo tiempo, monitoreo dos indicadores: la frecuencia de solicitudes de auditoría en la cadena y el volumen de quejas en cada modo. Al final del tercer mes, el modo con menor tasa de incidentes y menor fricción regulatoria será el que decida cuánta lógica de negocio trasladar. Hasta entonces, toda la lógica central de razonamiento se completa localmente, solo subo el hash de validación a la cadena.
Recuerda: los registros de lógica de AI en la cadena no son más seguros mientras más se almacenen, sino que se almacenan justo para auto-justificarse y no violar normativas. Esa línea nadie la dibuja por ti, debes probar con tu propia posición. Pero antes de probar, asegúrate de trazar claramente tu línea de vida—si no tienes claro el destino de los datos, no apuestes todo a la vez @OpenGradient
2
91
·
--
#opg $OPG
Hablemos de OpenGradient: primero, no te vayas por las ramas con narrativas extravagantes; vamos a fijarnos en su arquitectura HACA.
¿Cuál es el problema de las blockchains tradicionales? Que cada nodo tiene que volver a ejecutar las transacciones. Tú transfieres y todo bien, pero ¿y si le pides a 100 nodos que ejecuten un modelo grande de 70B una y otra vez? Los costos se multiplican por 100, el tiempo no alcanza y, además, el resultado puede no ser el esperado. La propuesta de OpenGradient consiste en separar la ejecución de la verificación: los nodos de inferencia trabajan con GPU; al final, entregan una certificación TEE o una prueba ZKML. El resto de nodos solo valida la prueba, sin necesidad de volver a ejecutar el modelo a lo tonto.
La verdad, esta idea no tiene fallos en términos técnicos. El sistema se divide en cuatro tipos de nodos: los nodos de inferencia ejecutan el modelo; los nodos completos registran y verifican las pruebas; los nodos de datos alimentan información externa; y el almacenamiento lo manejan en Walrus. Pero ¿dónde está el problema? Para los nodos TEE, el registro requiere una certificación de hardware sólida. Esto no lo puede ejecutar cualquier computadora doméstica. ¿Quién paga por comprar un H100? ¿Quién paga la electricidad del centro de datos?
Revisé con cuidado el modelo económico del whitepaper. El suministro total es de 1.000 millones de tokens; las recompensas por staking solo representan una décima parte, y la liberación es lineal en 96 meses. ¿Qué significa 96 meses? Ocho años. Según la valoración actual de OPG ($OPG), la cantidad promedio liberada cada mes, ¿alcanza para pagar el aire acondicionado de unas cuantas máquinas? La operación de nodos no es caridad: cuando se acaben los subsidios, el cómputo seguirá siendo más rápido que el de cualquiera, pero los costos recaén en ellos.
El equipo del proyecto dice que en la mainnet ya se ejecutaron 2 millones de inferencias. Pero cuántos nodos de inferencia hay y con qué configuración, hasta ahora no se ha publicado. ¿La narrativa técnica es atractiva? Sí. Pero si las cuentas económicas realmente cuadran, la verdad yo de momento lo único que hice fue guardar el listado de nodos en favoritos; dentro de tres meses vuelvo a comprobar el balance. ¿Entrar ahora? Lo pienso: vuelvo a mirar @OpenGradient
#opg $OPG
Hablemos de OpenGradient: primero, no te vayas por las ramas con narrativas extravagantes; vamos a fijarnos en su arquitectura HACA.
¿Cuál es el problema de las blockchains tradicionales? Que cada nodo tiene que volver a ejecutar las transacciones. Tú transfieres y todo bien, pero ¿y si le pides a 100 nodos que ejecuten un modelo grande de 70B una y otra vez? Los costos se multiplican por 100, el tiempo no alcanza y, además, el resultado puede no ser el esperado. La propuesta de OpenGradient consiste en separar la ejecución de la verificación: los nodos de inferencia trabajan con GPU; al final, entregan una certificación TEE o una prueba ZKML. El resto de nodos solo valida la prueba, sin necesidad de volver a ejecutar el modelo a lo tonto.
La verdad, esta idea no tiene fallos en términos técnicos. El sistema se divide en cuatro tipos de nodos: los nodos de inferencia ejecutan el modelo; los nodos completos registran y verifican las pruebas; los nodos de datos alimentan información externa; y el almacenamiento lo manejan en Walrus. Pero ¿dónde está el problema? Para los nodos TEE, el registro requiere una certificación de hardware sólida. Esto no lo puede ejecutar cualquier computadora doméstica. ¿Quién paga por comprar un H100? ¿Quién paga la electricidad del centro de datos?
Revisé con cuidado el modelo económico del whitepaper. El suministro total es de 1.000 millones de tokens; las recompensas por staking solo representan una décima parte, y la liberación es lineal en 96 meses. ¿Qué significa 96 meses? Ocho años. Según la valoración actual de OPG ($OPG ), la cantidad promedio liberada cada mes, ¿alcanza para pagar el aire acondicionado de unas cuantas máquinas? La operación de nodos no es caridad: cuando se acaben los subsidios, el cómputo seguirá siendo más rápido que el de cualquiera, pero los costos recaén en ellos.
El equipo del proyecto dice que en la mainnet ya se ejecutaron 2 millones de inferencias. Pero cuántos nodos de inferencia hay y con qué configuración, hasta ahora no se ha publicado. ¿La narrativa técnica es atractiva? Sí. Pero si las cuentas económicas realmente cuadran, la verdad yo de momento lo único que hice fue guardar el listado de nodos en favoritos; dentro de tres meses vuelvo a comprobar el balance. ¿Entrar ahora? Lo pienso: vuelvo a mirar @OpenGradient
1
94
·
--
#opg $OPG Probé durante cuatro días el chat OpenGradient; antes y después, unas setenta u ochenta conversaciones, desde preguntas simples y respuestas hasta razonamiento lógico de múltiples turnos. Probé de todo y te comparto algunas sensaciones prácticas.
Lo primero que noté es que es rápido. Probé tanto a las once de la noche como a las dos o tres de la tarde; incluso en horas pico no hubo cortes evidentes. Después de preguntar, básicamente empezaba a escribir en unos dos segundos. En el segundo capítulo del “libro blanco”, separan el razonamiento y la verificación en dos rutas: —nodos GPU solo ejecutan el modelo, y el resultado de verificación se procesa por un camino aparte con cifrado. En la experiencia real, sí se percibe la diferencia. No como algunos proyectos: el razonamiento se acelera, pero la verificación se queda atrás; o bien, si la verificación se hace completa, la respuesta se ralentiza y se desinfla.
Pero también hubo tropiezos. El tercer día, por un problema de seguridad de un contrato, el razonamiento salió muy rápido: tres segundos para dar resultado. Sin embargo, la verificación se atascó casi diez segundos; el estado seguía en “pending” y casi pensé que se había cortado la conexión. Luego revisé registros on-chain: fue porque a algún nodo de verificación se le hizo lento producir el bloque. El libro blanco no va a escribir esos detalles, pero en la práctica sucede: esa es, en el fondo, la IA en cadena real.
Hablemos de la distribución de nodos. Quise hablar con dos personas que han ejecutado nodos OPG; hicieron números y me dijeron algo así: con el precio actual de OPG, metiendo el costo de la electricidad y la depreciación del equipo, el periodo de recuperación es casi el doble de lo que dice oficialmente. Una de ellas lo expresó así: “A menos que el precio de la moneda se duplique, ampliar máquinas es apostar”. Ahora mismo, en toda la red, los nodos de inferencia no son tantos; los primeros concentran gran parte del cómputo. Esto me dejó un poco en duda.
Mi conclusión: úsalo como herramienta de IA centralizada y la experiencia está a la altura, incluso se siente bien. Pero en la parte de verificación on-chain, por ahora no ampliaré el capital. Voy a reevaluar cuando la dispersión de nodos baje de la actual concentración en los “top” a menos del 60%. El límite inferior de OpenGradient es que la ruta de verificación puede atascarse en casos extremos; el límite superior depende de si los incentivos a los nodos pueden sostenerse. Son dos cosas distintas usarlo con gusto y apostar con seguridad: ahora mismo miro directamente el gráfico de distribución de nodos.
@OpenGradient
102
·
--
Con verificación
#opg ¿Vale la pena tener el token OPG? Hablemos claro
Primero la conclusión: OPG no es ese tipo de cripto que simplemente compras a lo loco, pero su lógica de valor es más sólida que la de la mayoría de los proyectos de IA.
Mucha gente llega preguntando por el precio, te digo, el 16 de junio OPG estaba a 0.1618 dólares, con una capitalización de mercado de poco más de 30 millones. Pero eso no es lo importante. Primero, tienes que aclarar una cosa: ¿este token realmente se está usando?
¿La demanda es real o falsa?
OpenGradient ha ejecutado más de 2 millones de inferencias de IA verificables, soportando más de 2000 modelos. Cada vez que se llama a una inferencia se necesita gastar OPG. Esto no son datos inflados por el equipo del proyecto, son registros verificables en la cadena.
Binance listó OPG en el mercado spot el 22 de mayo, y Upbit en Corea del Sur también lo siguió. En pocas palabras, si grandes exchanges están dispuestos a aceptar, significa que han hecho la debida diligencia, no es aire.
La distribución del token tiene su truco
La cantidad total es de 1 mil millones, y actualmente hay menos de 190 millones en circulación, alrededor del 19%. A primera vista parece que hay presión por desbloquear, ¿verdad? Pero si miras de cerca: el 40% para el ecosistema se liberará lentamente durante 60 meses, y el 25% para contribuyentes e inversores está bloqueado por 12 meses antes de empezar a liberar, y una vez que comienza, lo hace durante 36 meses. ¿Qué significa esto? Las grandes posiciones están controladas, no habrá dump a corto plazo.
Cuatro niveles de captura de valor
OPG no es un token de gobernanza vacío. Es una herramienta de pago, si quieres ajustar un modelo de IA, necesitas gastar OPG; los nodos deben hacer staking de OPG para trabajar, si hacen trampa, se les puede incautar; los desarrolladores también pueden ganar OPG al subir modelos. Estos cuatro niveles de demanda juntos son mucho más sólidos que esos tokens aéreos que solo sirven para votar.
También hay que aclarar los riesgos
TEE depende de AWS, lo cual es un riesgo de centralización. El equipo del proyecto lo sabe, pero no hay opción mejor a corto plazo que Nitro. Además, el conjunto de ZKML es demasiado caro para LLM, la mayoría de los escenarios todavía dependen de TEE.
Y para ser sincero $OPG
La verdadera prueba en este sector es: cuando la inferencia de IA verificable se convierta en una necesidad, ¿podrá la velocidad de consumo de OPG superar el desbloqueo del token? Ahora el mercado es pequeño, la volatilidad es alta, así que piénsalo bien. @OpenGradient
1
1
439
·
--
#opg $OPG Primero una conclusión contraintuitiva: OpenGradient no busca resolver “que la IA no sea lo suficientemente potente”, sino “que la IA no sea confiable”. Los consejos de inversión o las señales de trading generadas por un LLM no pueden verificarse de forma independiente por el usuario; no se puede comprobar si el proceso de cálculo fue manipulado. La idea central del libro blanco es convertir ese proceso en una “computación auditable”.
I. HACA: desacoplar ejecución y verificación
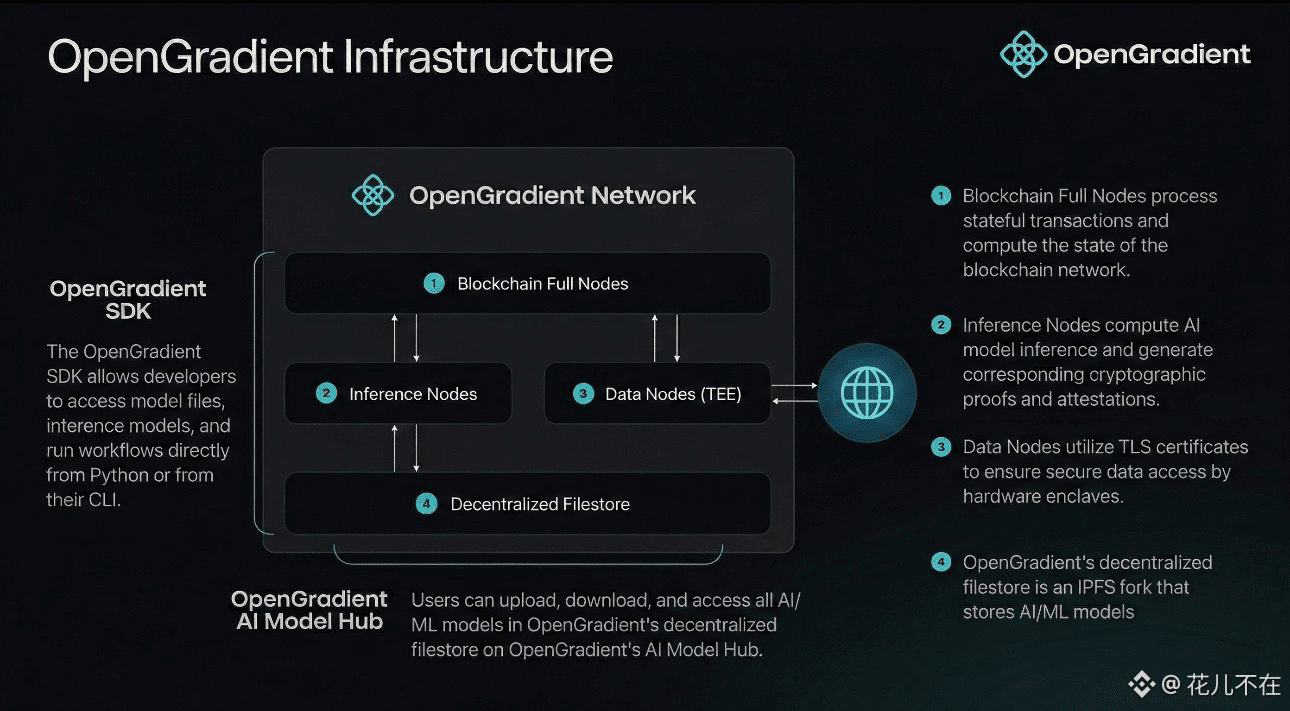
Las blockchains tradicionales requieren que cada nodo verificador vuelva a ejecutar cada transacción, lo cual no es realista para inferencias de IA. La arquitectura HACA de OpenGradient divide la red en tres capas: nodos de inferencia (GPU+TEE ejecutan el modelo, devuelven resultados, y la blockchain no está en la ruta crítica), nodos completos (verifican pruebas de TEE/ZKML y, al mismo tiempo, usan CometBFT para mantener el libro contable), y nodos de datos (obtienen datos externos de forma segura dentro del TEE). Los nodos verificadores no ejecutan modelos: solo comprueban pruebas; ahí está el núcleo de la optimización del rendimiento.
II. Marco de verificación: menú de niveles de confianza
El libro blanco propone tres rutas de verificación: TEE (AWS Nitro Enclaves; certifica que el entorno de ejecución no fue manipulado con documentos de certificación, cubriendo LLM y la mayor parte de escenarios ML), ZKML (pruebas de conocimiento cero; determinismo a nivel matemático, pero con costes altos, solo para inferencias ML de alto riesgo), y Vanilla (sin pruebas, para escenarios con requisitos bajos). El protocolo de pago x402 está integrado en cada instancia de TEE, eliminando intermediarios centralizados; admite liquidación asíncrona y, tras precargar, las solicitudes de inferencia no quedan bloqueadas en la cadena.
III. Tokens y situación actual
El suministro total de OPG es de 1.000 millones de monedas; el TGE de abril de 2026 se realizará en la red Base, y actualmente la circulación ronda el 19%. Los tokens se usan para pagar tarifas de inferencia, penalizaciones por staking y votaciones de gobernanza. La porción para ecosistema, contribuyentes e inversores está sujeta a bloqueos a largo plazo (cliff de 12 meses + liberación lineal de 36 meses); la presión vendedora de corto plazo está controlada. La red aún se encuentra en fase de testnet: ya ha procesado 2 millones+ de inferencias verificables, aloja 2000+ modelos y genera 500.000+ pruebas.
Riesgos a vigilar: el TEE depende de AWS Nitro; la descentralización existe con tensión de centralización. ZKML para LLM todavía no es realista; el intercambio “coste-seguridad” de la verificación lo asumen los desarrolladores. Además, la liberación de oferta continúa durante los próximos dos años: será necesario que el crecimiento de ingresos de la red lo acompañe.
Cuando “verificabilidad” se convierta en el requisito por defecto para las salidas de IA, las decisiones de arquitectura de OpenGradient tendrán una verdadera ventaja competitiva.
#OPG $OPG @OpenGradient
113
·
--
#opg $OPG Hablemos de cosas reales. Mucha gente se fija en el precio del token OPG, pero no entiende qué está resolviendo realmente la arquitectura subyacente HACA.
Las cadenas de bloques tradicionales no se llevan bien con la IA, por una razón muy simple. El modelo de Ethereum es así: cada nodo verificador vuelve a ejecutar la misma transacción, y si el resultado coincide, se llega a un consenso. Transferir fondos funciona, pero ¿y la inferencia de IA? Ejecutar un modelo grande con 70.000 millones de parámetros requiere GPU y tiempo, y además cada salida no es idéntica. ¿Hacer que 100 nodos verificadores lo ejecuten una vez cada uno? Coste 100 veces, y el tiempo se dispara. Hay quien trata la IA como un “oráculo” e introduce datos; eso equivale a trasladar la confianza del proveedor de IA al proveedor del oráculo. Cambias el envoltorio, pero no el fondo.
La idea de OpenGradient se resume en una palabra: descomponer. El núcleo de HACA es separar la ejecución y la verificación. Tres tipos de nodos hacen cada uno lo suyo:
· Nodos de inferencia — GPU ejecuta el modelo; el resultado se lo envían directamente al usuario, con una latencia similar a la de ChatGPT.
· Nodos completos — no ejecutan el modelo; solo verifican las pruebas criptográficas enviadas por los nodos de inferencia (TEE o ZKML). Si la verificación pasa, se registra en la cadena. No hace falta saber cuáles fueron las instrucciones, el modelo o el resultado: es operación 100% criptográfica.
· Nodos de datos — se encargan de obtener datos del exterior; trabajan en TEE para asegurar que los datos no hayan sido manipulados.
¿Dónde está lo genial del diseño? La inferencia sigue una “ruta rápida”: tú envías la solicitud, la GPU calcula y el resultado vuelve en seguida; la cadena de bloques no se mete. La verificación sigue una “ruta lenta”: envío asíncrono de pruebas, validación por nodos completos y registro en cadena. La velocidad es nivel Web2, la confianza es nivel Web3. Cuantos más nodos de inferencia haya, mayor el throughput, y la carga de la capa de verificación no sube: verificar pruebas es de milisegundos, da igual si tu modelo tardó 5 segundos o 50.
En palabras simples: obtienes el resultado con la misma rapidez que usando ChatGPT, pero cada resultado puede validarse de forma independiente y quedar trazado para siempre; no tienes que confiar en nadie.
A día de hoy, la red principal ya ejecuta más de 2,0 millones de inferencias verificables, más de 500.000 pruebas y más de 2.000 modelos. a16z y Coinbase Ventures ya se han subido al tren. Esta mecánica convierte la “IA de caja negra” en una “línea de producción transparente”; la dirección es correcta. Lo demás depende de si el ecosistema puede despegar @OpenGradient
95
·
--
#bedrock $BR En el círculo actual, la promoción de la liquidez en toda la cadena de Bedrock se ve en todas partes, los airdrops y los altos rendimientos siguen estimulando el mercado. Muchos traders minoristas siguen la corriente pidiendo préstamos y haciendo interacciones, tratando de ganar recompensas para obtener ganancias. Después de experimentar en vivo durante medio mes, me salto el empaque publicitario y desde la perspectiva de un inversor común, hablo sobre la verdadera cara del proyecto.
El sistema de generación de ingresos cruzados basado en uniBTC es el principal atractivo del proyecto. Antes, para mover activos de BTC entre múltiples ecosistemas de inversión, era necesario hacer múltiples transferencias a través de puentes, lo que no solo consume tiempo, sino que también suma múltiples tarifas en la cadena. Ahora, con un staking en un solo punto, se pueden generar certificados de liquidez, y los activos pueden moverse de manera flexible entre varios protocolos de rendimiento, con una eficiencia de rotación de fondos que supera con creces los productos de staking tradicionales en el mercado, y el diseño de la estructura es muy amigable para grandes capitales.
Pero para simplificar la operación, el proyecto ha encapsulado internamente la gestión de nodos de base, el control de riesgos de activos y las reglas de agregación de fondos. Los usuarios solo pueden ver los rendimientos en la interfaz, no pueden consultar de manera autónoma los detalles del custodia de los activos subyacentes, lo cual es un riesgo difícil de ignorar para los jugadores veteranos que valoran la transparencia en la cadena.
En este momento, muchos traders minoristas, con cantidades de cientos de U, están siguiendo el ciclo de staking para completar tareas. Todo el modelo económico tiende a favorecer a las ballenas. Las tarifas de Gas y el deslizamiento en el intercambio provocados por operaciones frecuentes con pequeños capitales irán consumiendo lentamente las escasas recompensas del ecosistema, y la mayoría de los participantes no logrará obtener ganancias, sino que, al contrario, elevarán indirectamente el TVL del proyecto.
Recomendación práctica: mantén una mentalidad tranquila, abandona la idea de enriquecerse rápidamente con airdrops, y considera el proyecto solo como una herramienta de liquidez. Usa los certificados obtenidos de staking junto con DeFi consolidado para una configuración sólida, considerando los airdrops como una sorpresa adicional. Espera a que el fervor del mercado disminuya, observa la retención real de fondos en el ecosistema y luego planifica la inversión futura.
#Bedrock #btcfire @Bedrock
65
·
--
#bedrock $BR meses en la comunidad, cada vez hay más gente mostrando sus puntos BR, un amigo incluso puso un screenshot de los primeros 10 en su foto de perfil y no para de decir "esta es la verdadera habilidad de BTCFi". Para ser sincero, casi me suelta la risa en ese momento—después de seis años en el mundo DeFi, desde MakerDAO hasta el actual sector de re-staking, he visto esta jugada de envolver el "umbral de inversión" como "incentivo para los usuarios" más de diez veces.
En pocas palabras, lo que permite a Bedrock destacar en el sector de BTCFi no es simplemente hacer que BTC cruce cadenas. ¿Te has dado cuenta de que su verdadera fortaleza es ese modelo de reducción de puntos no lineal que parece justo? El equipo del proyecto es bastante astuto, no pone en claro un "no molestar a quienes no tienen suficiente capital", sino que utiliza la fórmula de puntos para completar discretamente la clasificación del capital: al apostar un BTC, el gran inversor que bloquea su capital por un año genera puntos que superan la suma de un pequeño inversor que entra y sale frecuentemente en tres meses. Dos tipos de capital, dos sistemas de descuento, con una cúpula de ingresos que nunca se puede atravesar.
Esta estructura tiene beneficios obvios para el protocolo: el TVL explotó de 500 millones a 3 mil millones, la adhesión del capital se ha encerrado en contratos enredados, ni siquiera las ballenas se atreven a salir fácilmente. Pero el costo lo asumen los pequeños inversores—he visto con mis propios ojos a alguien en el grupo que ponía tres alarmas cada día, se levantaba a las dos de la mañana para cambiar de pool y acumular puntos, gastando miles de U en comisiones, y su ranking de puntos no se movía ni un milímetro. ¿Por qué? Porque en ese modelo, donde el tiempo de depósito y el volumen de capital son factores determinantes, el capital de giro de los pequeños siempre será superado por los activos dormidos de los grandes.
Lo más irónico es que la plataforma también está creando intencionadamente la ilusión de que "trabajar duro puede aumentar tus ingresos". Pasas el día observando las fluctuaciones del APY, moviendo tu capital entre diferentes pools por ese 0.01% extra de puntos, sintiéndote satisfecho, pero ¿realmente es una participación justa? Solo hemos migrado de ser los de abajo en la cadena de valor de las finanzas tradicionales a ser los súbditos en el sistema de puntos en la cadena. Cada uno de esos $BR puntos que son recogidos a precio de oro por instituciones, tiene como base incontables pequeños capitales diluidos por el tiempo y la escala, un costo hundido que nadie ve.
#bedrock $BR @Bedrock
104
Inicia sesión para explorar más contenidos
Únete a usuarios de criptomonedas de todo el mundo en Binance Square
⚡️ Obtén la información más reciente y útil sobre criptomonedas.
💬 Confía en el mayor exchange de criptomonedas del mundo.
👍 Descubre opiniones reales de creadores verificados.
Correo electrónico/número de teléfono
Temas en tendencia
ADAGains10%Above$0.27
8,281 visualizaciones
142 participa(n) en el debate
#ADAGains10%Above$0.27
El precio de Cardano (ADA) registró un explosivo rally del 11% en las últimas 24 horas, superando con fuerza la barrera psicológica de los 0,27 dólares y posicionándose como el activo de mayor rendimiento entre las principales criptomonedas del mercado. Este repentino despertar alcista, que llevó al token a registrar su nivel más alto desde el pasado mes de julio, estuvo acompañado por un impresionante volumen de transacciones de 1.160 millones de dólares, cifra que duplica holgadamente su promedio mensual. Analistas de la industria asocian este fuerte impulso con el creciente optimismo minorista en torno al desarrollo de su ecosistema de finanzas del mundo real (RealFi) y las expectativas técnicas por la futura actualización de escalabilidad conocida como Dijkstra, logrando que la zona entre los $0,258 y $0,260 se consolide como el nuevo soporte clave a defender para mantener intacto el camino hacia el objetivo de los $0,30.#writetoearn #Write2Earn $ADA $USDC
WorldWideWeb The World ARPANET Archie EFF
·1 «Me gusta»
·1.1k visualizaciones
ETHUp70%InQ3ButLiquidityFalls
97,163 visualizaciones
871 participa(n) en el debate
EthStakingExitQueueHits2026High
36,251 visualizaciones
644 participa(n) en el debate